
Python - 100天从新手到大师
作者:骆昊 说明1:最近有一个非常火的岗位叫做 FDE(前沿部署工程师),国内首套 FDE 实战课已经为大家准备好了,请点击传送门。 说明2:如果访问 GitHub 比较慢的话,可以关注我的知乎账号(Python-Jack),上面的“从零开始学Python”专栏比较适合初学者,其他的专栏如“数据思维和统计思维”、“基于Python的数据分析”、“说走就走的AI之旅”、“AI智能体开发”等也在持续创作和更新中,欢迎大家关注、点赞和评论。如果有一起打卡学习或付费咨询的需求,可以加入付费交流群,新用户可以通过下方二维码付费之后添加我的私人微信(微信号:jackfrued),然后邀请大家进入付费学习打卡群,添加微信时请备注好自己的称呼和需求,我会为大家提供力所能及的帮助。说明3:本项目对应的部分视频已经同步到 Bilibili,有兴趣的小伙伴可以点赞、投币、关注,一键三连支持一下!
Python应用领域和职业发展分析
简单的说,Python是一个“优雅”、“明确”、“简单”的编程语言。
- 学习曲线低,非专业人士也能上手
- 开源系统,拥有强大的生态圈
- 解释型语言,完美的平台可移植性
- 动态类型语言,支持面向对象和函数式编程
- 代码规范程度高,可读性强
Python在以下领域都有用武之地。
- 后端开发 - Python / Java / Go / PHP
- DevOps - Python / Shell / Ruby
- 数据采集 - Python / C++ / Java
- 量化交易 - Python / C++ / R
- 数据科学 - Python / R / Julia / Matlab
- 机器学习 - Python / R / C++ / Julia
- 自动化测试 - Python / Shell
作为一名Python开发者,根据个人的喜好和职业规划,可以选择的就业领域也非常多。
- Python后端开发工程师(服务器、云平台、数据接口)
- Python运维工程师(自动化运维、SRE、DevOps)
- Python数据分析师(数据分析、商业智能、数字化运营)
- Python数据科学家(机器学习、深度学习、算法专家)
- Python爬虫工程师(不推荐此赛道!!!)
- Python测试工程师(自动化测试、测试开发)
说明:目前,数据科学赛道是非常热门的方向,因为不管是互联网行业还是传统行业都已经积累了大量的数据,各行各业都需要数据科学家从已有的数据中发现更多的商业价值,从而为企业的决策提供数据的支撑,这就是所谓的数据驱动决策。
给初学者的几个建议:
- Make English as your working language. (让英语成为你的工作语言)
- Practice makes perfect. (熟能生巧)
- All experience comes from the mistakes you've made. (所有的经验都源于犯过的错误)
- Don't be a freeloader. (学会分享,不要只当伸手党)
- Embrace AI to boost your productivity.(拥抱AI,提升效率)
Day01~20 - Python语言基础
Day01 - 初识Python
- Python简介
- Python编年史
- Python优缺点
- Python应用领域- 安装Python环境
- Windows环境
- macOS环境
Day02 - 第一个Python程序
- 编写代码的工具
- 你好世界
- 注释你的代码
Day03 - Python语言中的变量
- 一些常识
- 变量和类型
- 变量命名
- 变量的使用
Day04 - Python语言中的运算符
- 算术运算符
- 赋值运算符
- 比较运算符和逻辑运算符
- 运算符和表达式应用
- 华氏和摄氏温度转换
- 计算圆的周长和面积
- 判断闰年
Day05 - 分支结构
- 使用if和else构造分支结构
- 使用match和case构造分支结构
- 分支结构的应用
- 分段函数求值
- 百分制成绩转换成等级
- 计算三角形的周长和面积
Day06 - 循环结构
- for-in循环
- while循环
- break和continue
- 嵌套的循环结构
- 循环结构的应用
- 判断素数
- 最大公约数
- 猜数字游戏
Day07 - 分支和循环结构实战
- 例子1:100以内的素数
- 例子2:斐波那契数列
- 例子3:寻找水仙花数
- 例子4:百钱百鸡问题
- 例子5:CRAPS赌博游戏
Day08 - 常用数据结构之列表-1
- 创建列表
- 列表的运算
- 元素的遍历
Day09 - 常用数据结构之列表-2
- 列表的方法
- 添加和删除元素
- 元素位置和频次
- 元素排序和反转- 列表生成式
- 嵌套列表
- 列表的应用
Day10 - 常用数据结构之元组
- 元组的定义和运算
- 打包和解包操作
- 交换变量的值
- 元组和列表的比较
Day11 - 常用数据结构之字符串
- 字符串的定义
- 转义字符
- 原始字符串
- 字符的特殊表示- 字符串的运算
- 拼接和重复
- 比较运算
- 成员运算
- 获取字符串长度
- 索引和切片- 字符的遍历
- 字符串的方法
- 大小写相关操作
- 查找操作
- 性质判断
- 格式化
- 修剪操作
- 替换操作
- 拆分与合并
- 编码与解码
- 其他方法
Day12 - 常用数据结构之集合
- 创建集合
- 元素的变量
- 集合的运算
- 成员运算
- 二元运算
- 比较运算- 集合的方法
- 不可变集合
Day13 - 常用数据结构之字典
- 创建和使用字典
- 字典的运算
- 字典的方法
- 字典的应用
Day14 - 函数和模块
- 定义函数
- 函数的参数
- 位置参数和关键字参数
- 参数的默认值
- 可变参数- 用模块管理函数
- 标准库中的模块和函数
Day15 - 函数应用实战
- 例子1:随机验证码
- 例子2:判断素数
- 例子3:最大公约数和最小公倍数
- 例子4:数据统计
- 例子5:双色球随机选号
Day16 - 函数使用进阶
- 高阶函数
- Lambda函数
- 偏函数
Day17 - 函数高级应用
- 装饰器
- 递归调用
Day18 - 面向对象编程入门
- 类和对象
- 定义类
- 创建和使用对象
- 初始化方法
- 面向对象的支柱
- 面向对象案例
- 例子1:数字时钟
- 例子2:平面上的点
Day19 - 面向对象编程进阶
- 可见性和属性装饰器
- 动态属性
- 静态方法和类方法
- 继承和多态
Day20 - 面向对象编程应用
- 扑克游戏
- 工资结算系统
Day21~30 - Python语言应用
Day21 - 文件读写和异常处理
- 打开和关闭文件
- 读写文本文件
- 异常处理机制
- 上下文管理器语法
- 读写二进制文件
Day22 - 对象的序列化和反序列化
- JSON概述
- 读写JSON格式的数据
- 包管理工具pip
- 使用网络API获取数据
Day23 - Python读写CSV文件
- CSV文件介绍
- 将数据写入CSV文件
- 从CSV文件读取数据
Day24 - Python读写Excel文件-1
- Excel简介
- 读Excel文件
- 写Excel文件
- 调整样式
- 公式计算
Day25 - Python读写Excel文件-2
- Excel简介
- 读Excel文件
- 写Excel文件
- 调整样式
- 生成统计图表
Day26 - Python操作Word和PowerPoint文件
- 操作Word文档
- 生成PowerPoint
Day27 - Python操作PDF文件
- 从PDF中提取文本
- 旋转和叠加页面
- 加密PDF文件
- 批量添加水印
- 创建PDF文件
Day28 - Python处理图像
- 入门知识
- 用Pillow处理图像
- 使用Pillow绘图
Day29 - Python发送邮件和短信
- 发送电子邮件
- 发送短信
Day30 - 正则表达式的应用
- 正则表达式相关知识
- Python对正则表达式的支持
- 例子1:输入验证
- 例子2:内容提取
- 例子3:内容替换
- 例子4:长句拆分
Day31~35 - 其他相关内容
Python语言进阶
- 重要知识点
- 数据结构和算法
- 函数的使用方式
- 面向对象相关知识
- 迭代器和生成器
- 并发编程
Web前端入门
- 用HTML标签承载页面内容
- 用CSS渲染页面
- 用JavaScript处理交互式行为
- Vue.js入门
- Element的使用
- Bootstrap的使用
玩转Linux操作系统
- 操作系统发展史和Linux概述
- Linux基础命令
- Linux中的实用程序
- Linux的文件系统
- Vim编辑器的应用
- 环境变量和Shell编程
- 软件的安装和服务的配置
- 网络访问和管理
- 其他相关内容
Day36~45 - 数据库基础和进阶
Day36 - 关系型数据库和MySQL概述
- 关系型数据库概述
- MySQL简介
- 安装MySQL
- MySQL基本命令
Day37 - SQL详解之DDL
- 建库建表
- 删除表和修改表
Day38 - SQL详解之DML
- insert操作
- delete操作
- update操作
Day39 - SQL详解之DQL
- 投影和别名
- 筛选数据
- 空值处理
- 去重
- 排序
- 聚合函数
- 嵌套查询
- 分组操作
- 表连接
- 笛卡尔积
- 内连接
- 自然连接
- 外连接- 窗口函数
- 定义窗口
- 排名函数
- 取数函数
Day40 - SQL详解之DCL
- 创建用户
- 授予权限
- 召回权限
Day41 - MySQL新特性
- JSON类型
- 窗口函数
- 公共表表达式
Day42 - 视图、函数和过程
- 视图
- 使用场景
- 创建视图
- 使用限制- 函数
- 内置函数
- 用户自定义函数(UDF)- 过程
- 创建过程
- 调用过程
Day43 - 索引
- 执行计划
- 索引的原理
- 创建索引
- 普通索引
- 唯一索引
- 前缀索引
- 复合索引- 注意事项
Day44 - Python接入MySQL数据库
- 安装三方库
- 创建连接
- 获取游标
- 执行SQL语句
- 通过游标抓取数据
- 事务提交和回滚
- 释放连接
- 编写ETL脚本
Day45 - Hive实战
- Hive概述
- 环境搭建
- 常用命令
- 基本语法
- 建表操作
- 写入数据
- 常用函数
- 分组聚合
- 抽样操作
- 排序操作
- 横向展开
- 性能优化
Day46~60 - 实战Django
Day46 - Django快速上手
- Web应用工作机制
- HTTP请求和响应
- Django框架概述
- 5分钟快速上手
Day47 - 深入模型
- 关系型数据库配置
- 使用ORM完成对模型的CRUD操作
- 管理后台的使用
- Django模型最佳实践
- 模型定义参考
Day48 - 静态资源和Ajax请求
- 加载静态资源
- Ajax概述
- 用Ajax实现投票功能
Day49 - Cookie和Session
- 实现用户跟踪
- cookie和session的关系
- Django框架对session的支持
- 视图函数中的cookie读写操作
Day50 - 报表和日志
- 通过
HttpResponse修改响应头 - 使用
StreamingHttpResponse处理大文件 - 使用
xlwt生成Excel报表 - 使用
reportlab生成PDF报表 - 使用ECharts生成前端图表
Day51 - 日志和调试工具栏
- 配置日志
- 配置Django-Debug-Toolbar
- 优化ORM代码
Day52 - 中间件的应用
- 什么是中间件
- Django框架内置的中间件
- 自定义中间件及其应用场景
Day53 - 前后端分离开发入门
- 返回JSON格式的数据
- 用Vue.js渲染页面
Day54 - RESTful架构和DRF入门
- REST概述
- DRF库使用入门
- 前后端分离开发
- JWT的应用
Day55 - RESTful架构和DRF进阶
- 使用CBV
- 数据分页
- 数据筛选
Day56 - 使用缓存
- 网站优化第一定律
- 在Django项目中使用Redis提供缓存服务
- 在视图函数中读写缓存
- 使用装饰器实现页面缓存
- 为数据接口提供缓存服务
Day57 - 接入三方平台
- 文件上传表单控件和图片文件预览
- 服务器端如何处理上传的文件
Day58 - 异步任务和定时任务
- 网站优化第二定律
- 配置消息队列服务
- 在项目中使用Celery实现任务异步化
- 在项目中使用Celery实现定时任务
Day59 - 单元测试
Day60 - 项目上线
- Python中的单元测试
- Django框架对单元测试的支持
- 使用版本控制系统
- 配置和使用uWSGI
- 动静分离和Nginx配置
- 配置HTTPS
- 配置域名解析
Day61~65 - 网络数据采集
Day61 - 网络数据采集概述
- 网络爬虫的概念及其应用领域
- 网络爬虫的合法性探讨
- 开发网络爬虫的相关工具
- 一个爬虫程序的构成
Day62 - 数据抓取和解析
- 正则表达式解析
- XPath解析
- CSS选择器解析
Day63 - Python中的并发编程
Day64 - 使用Selenium抓取网页动态内容
- 安装Selenium
- 加载页面
- 查找元素和模拟用户行为
- 隐式等待和显示等待
- 执行JavaScript代码
- Selenium反爬破解
- 设置无头浏览器
Day65 - 爬虫框架Scrapy简介
- Scrapy核心组件
- Scrapy工作流程
- 安装Scrapy和创建项目
- 编写蜘蛛程序
- 编写中间件和管道程序
- Scrapy配置文件
Day66~80 - Python数据分析
Day66 - 数据分析概述
- 数据分析师的职责
- 数据分析师的技能栈
- 数据分析相关库
Day67 - 环境准备
- 安装和使用anaconda
- conda相关命令- 安装和使用jupyter-lab
- 安装和启动
- 使用小技巧
Day68 - NumPy的应用-1
- 创建数组对象
- 数组对象的属性
- 数组对象的索引运算
- 普通索引
- 花式索引
- 布尔索引
- 切片索引- 案例:使用数组处理图像
Day69 - NumPy的应用-2
- 数组对象的相关方法
- 获取描述性统计信息
- 其他相关方法
Day70 - NumPy的应用-3
- 数组的运算
- 数组跟标量的运算
- 数组跟数组的运算- 通用一元函数
- 通用二元函数
- 广播机制
- Numpy常用函数
Day71 - NumPy的应用-4
- 向量
- 行列式
- 矩阵
- 多项式
Day72 - 深入浅出pandas-1
- 创建Series对象
- Series对象的运算
- Series对象的属性和方法
Day73 - 深入浅出pandas-2
- 创建DataFrame对象
- DataFrame对象的属性和方法
- 读写DataFrame中的数据
Day74 - 深入浅出pandas-3
- 数据重塑
- 数据拼接
- 数据合并- 数据清洗
- 缺失值
- 重复值
- 异常值
- 预处理
Day75 - 深入浅出pandas-4
- 数据透视
- 获取描述性统计信息
- 排序和头部值
- 分组聚合
- 透视表和交叉表- 数据呈现
Day76 - 深入浅出pandas-5
- 计算同比环比
- 窗口计算
- 相关性判定
Day77 - 深入浅出pandas-6
- 索引的使用
- 范围索引
- 分类索引
- 多级索引
- 间隔索引
- 日期时间索引
Day78 - 数据可视化-1
- 安装和导入matplotlib
- 创建画布
- 创建坐标系
- 绘制图表
- 折线图
- 散点图
- 柱状图
- 饼状图
- 直方图
- 箱线图- 显示和保存图表
Day79 - 数据可视化-2
- 高阶图表
- 气泡图
- 面积图
- 雷达图
- 玫瑰图
- 3D图表
Day80 - 数据可视化-3
- Seaborn
- Pyecharts
Day81~90 - 机器学习
Day81 - 浅谈机器学习
- 人工智能发展史
- 什么是机器学习
- 机器学习应用领域
- 机器学习的分类
- 机器学习的步骤
- 第一次机器学习
Day82 - k最近邻算法
- 距离的度量
- 数据集介绍
- kNN分类的实现
- 模型评估
- 参数调优
- kNN回归的实现
Day83 - 决策树和随机森林
- 决策树的构建
- 特征选择
- 数据分裂
- 树的剪枝- 实现决策树模型
- 随机森林概述
Day84 - 朴素贝叶斯算法
- 贝叶斯定理
- 朴素贝叶斯
- 算法原理
- 训练阶段
- 预测阶段
- 代码实现- 算法优缺点
Day85 - 回归模型
- 回归模型的分类
- 回归系数的计算
- 新数据集介绍
- 线性回归代码实现
- 回归模型的评估
- 引入正则化项
- 线性回归另一种实现
- 多项式回归
- 逻辑回归
Day86 - K-Means聚类算法
- 算法原理
- 数学描述
- 代码实现
Day87 - 集成学习算法
- 算法分类
- AdaBoost
- GBDT
- XGBoost
- LightGBM
Day88 - 神经网络模型
- 基本构成
- 工作原理
- 代码实现
- 模型优缺点
Day89 - 自然语言处理入门
- 词袋模型
- 词向量
- NPLM和RNN
- Seq2Seq
- Transformer
Day90 - 机器学习实战
- 数据探索
- 特征工程
- 模型训练
- 模型评估
- 模型部署
Day91~99 - 团队项目开发
第91天:团队项目开发的问题和解决方案
- 软件过程模型
- 经典过程模型(瀑布模型)
 - 可行性分析(研究做还是不做),输出《可行性分析报告》。
 - 需求分析(研究做什么),输出《需求规格说明书》和产品界面原型图。
 - 概要设计和详细设计,输出概念模型图(ER图)、物理模型图、类图、时序图等。
 - 编码 / 测试。
- 上线 / 维护。 瀑布模型最大的缺点是无法拥抱需求变化,整套流程结束后才能看到产品,团队士气低落。- 敏捷开发(Scrum)- 产品所有者、Scrum Master、研发人员 - Sprint
 - 产品的Backlog(用户故事、产品原型)。
 - 计划会议(评估和预算)。
 - 日常开发(站立会议、番茄工作法、结对编程、测试先行、代码重构……)。
 - 修复bug(问题描述、重现步骤、测试人员、被指派人)。
 - 发布版本。
 - 评审会议(Showcase,用户需要参与)。
 - 回顾会议(对当前迭代周期做一个总结)。
> 补充:敏捷软件开发宣言
>
> - **个体和互动** 高于 流程和工具
> - **工作的软件** 高于 详尽的文档
> - **客户合作** 高于 合同谈判
> - **响应变化** 高于 遵循计划 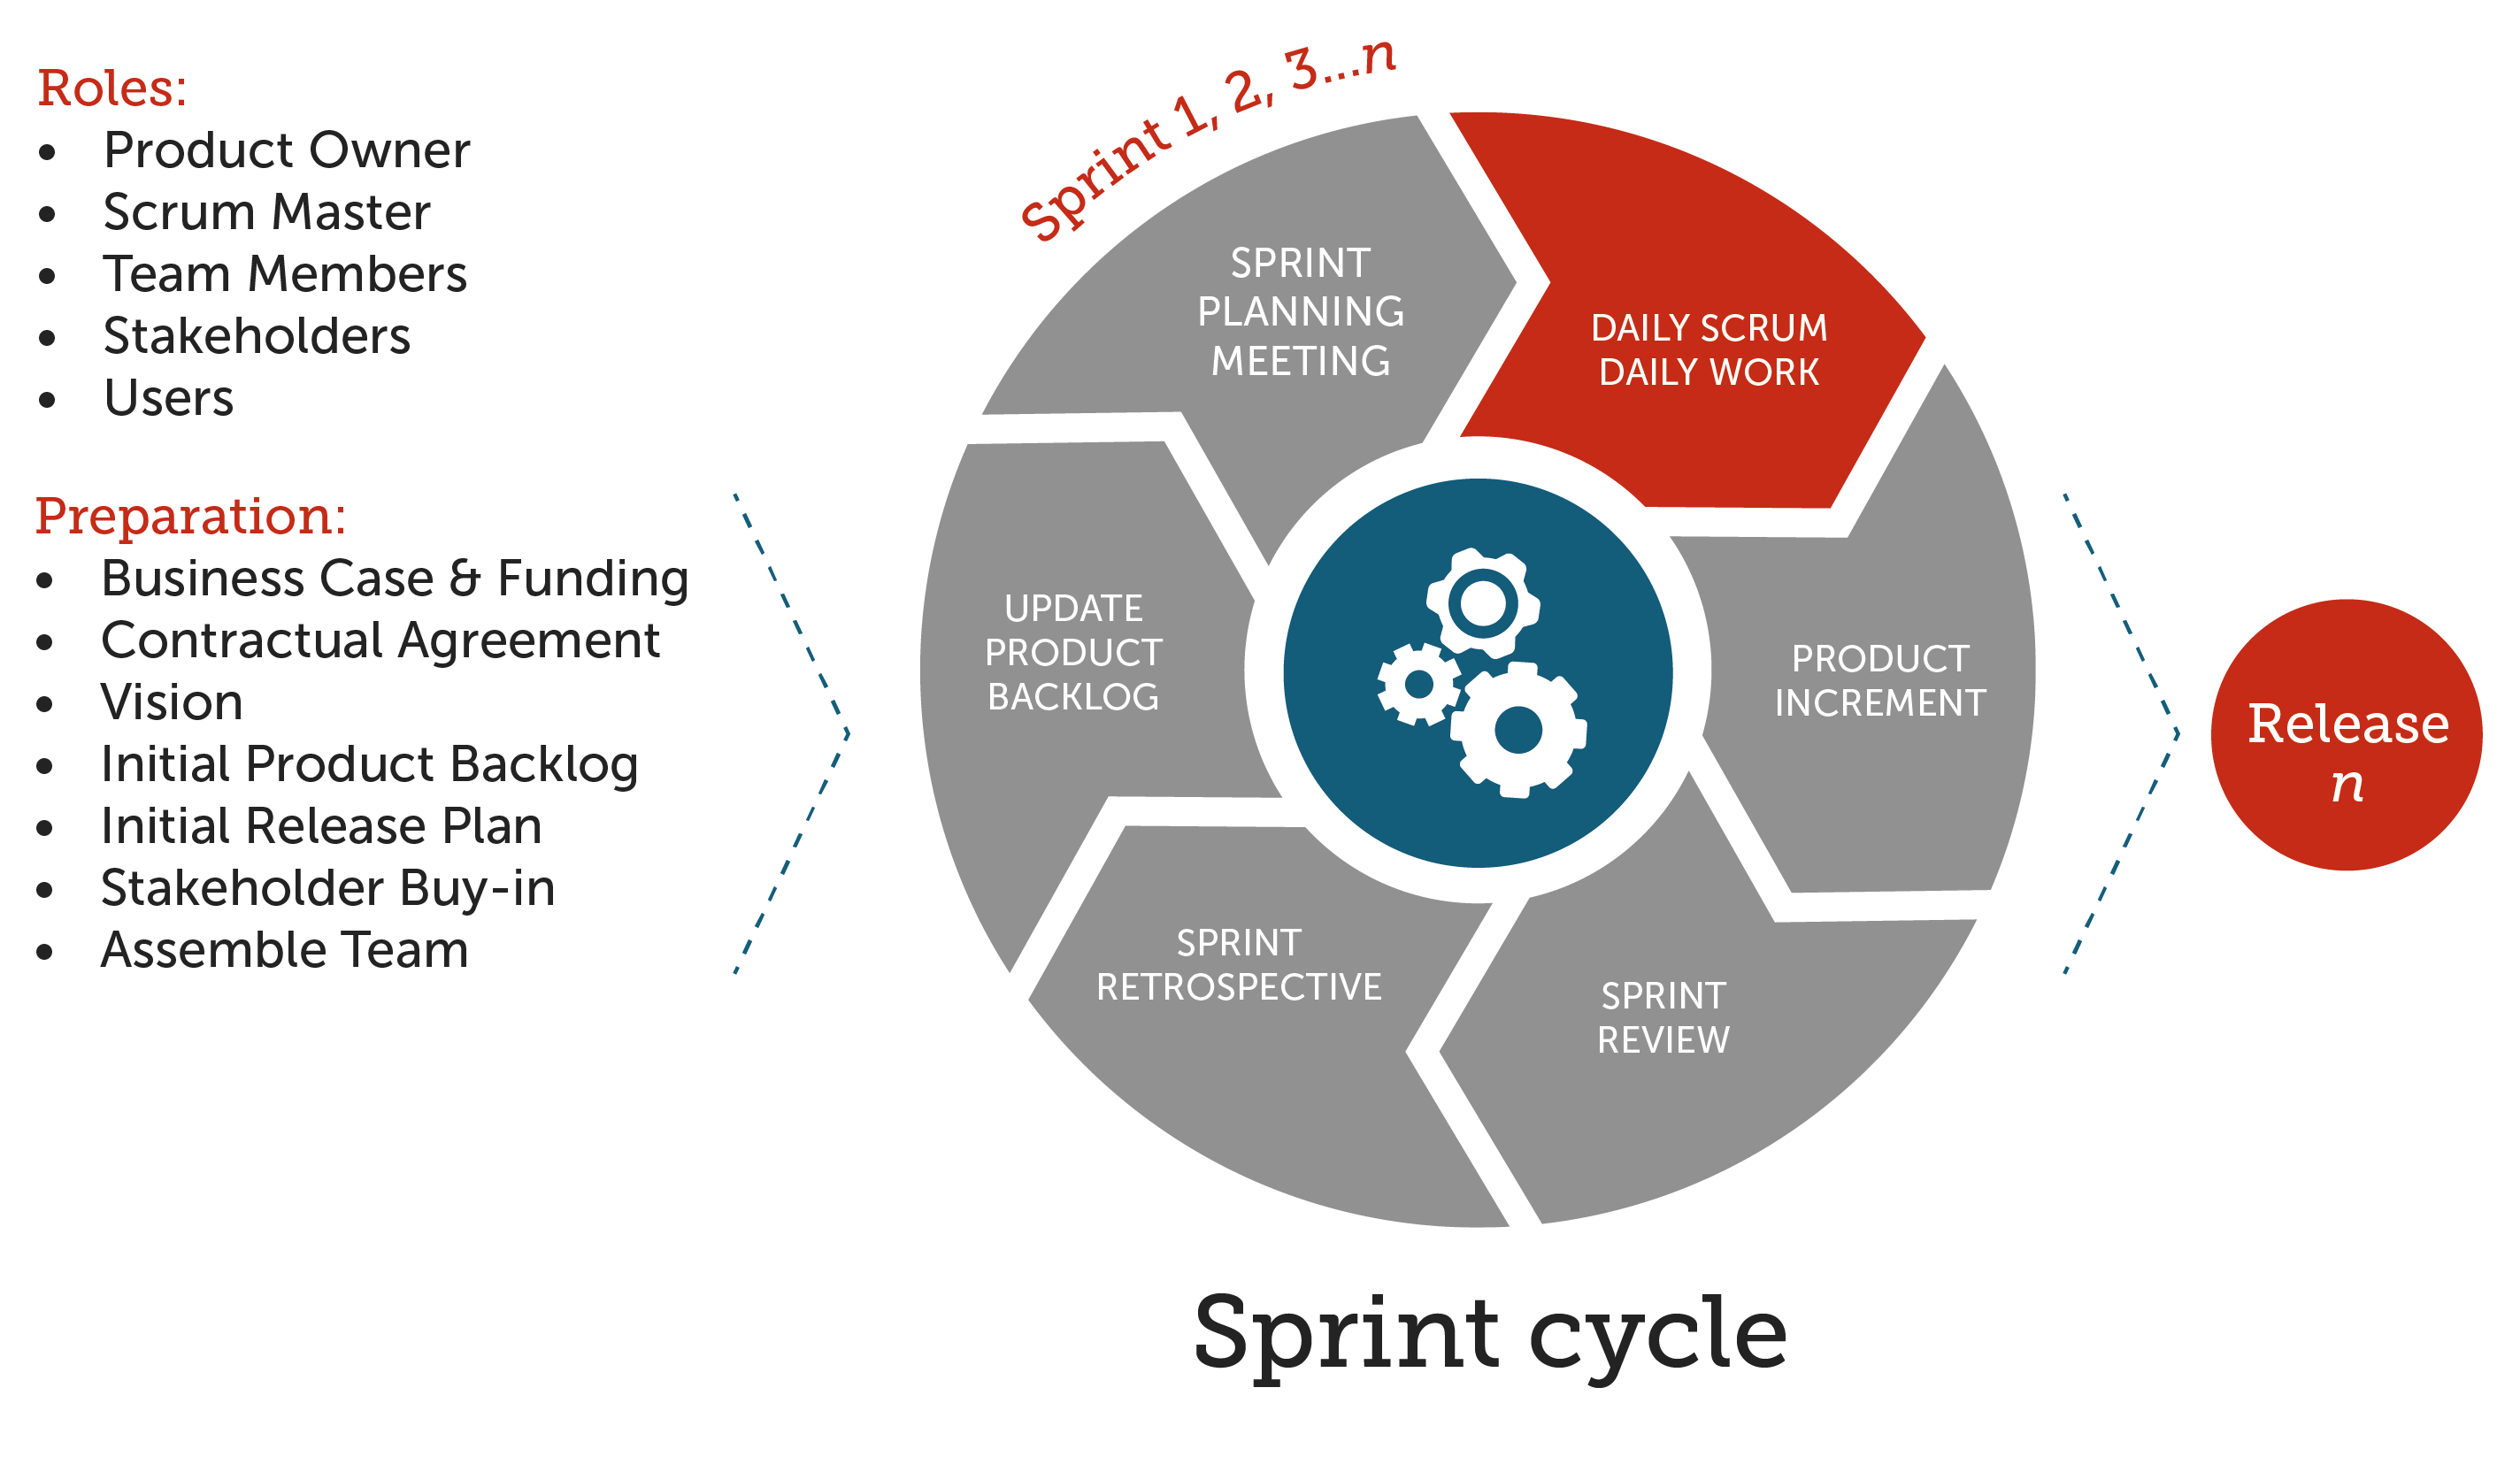 > 角色:产品所有者(决定做什么,能对需求拍板的人)、团队负责人(解决各种问题,专注如何更好的工作,屏蔽外部对开发团队的影响)、开发团队(项目执行人员,具体指开发人员和测试人员)。 > 准备工作:商业案例和资金、合同、憧憬、初始产品需求、初始发布计划、入股、组建团队。 > 敏捷团队通常人数为8-10人。 > 工作量估算:将开发任务量化,包括原型、Logo设计、UI设计、前端开发等,尽量把每个工作分解到最小任务量,最小任务量标准为工作时间不能超过两天,然后估算总体项目时间。把每个任务都贴在看板上面,看板上分三部分:to do(待完成)、in progress(进行中)和done(已完成)。- 项目团队组建
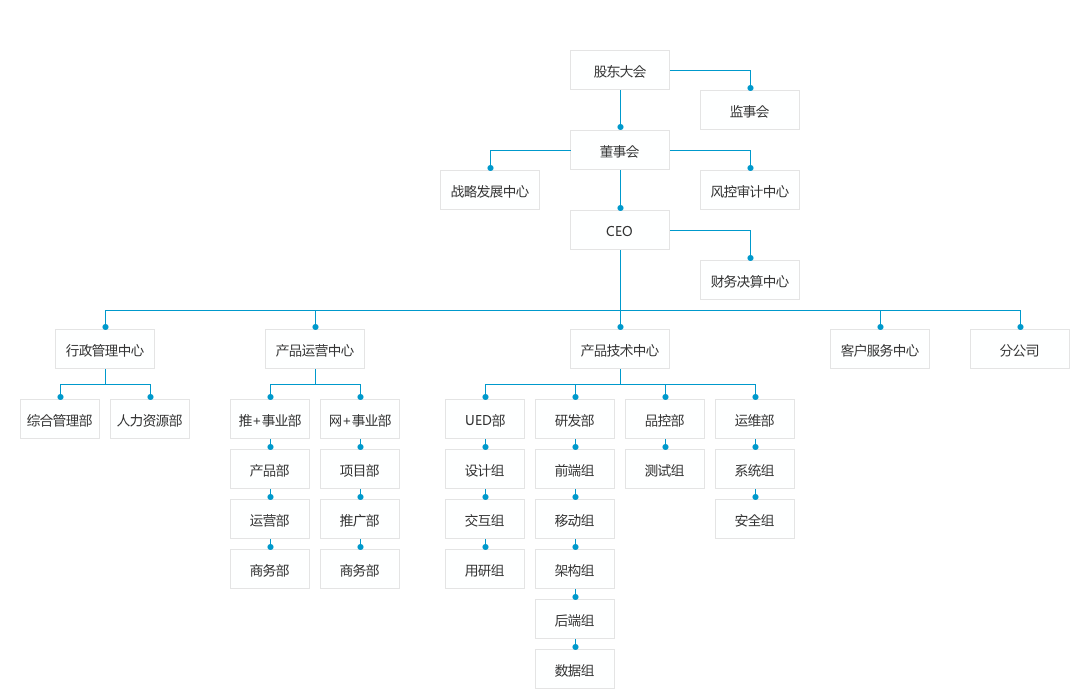
- 团队的构成和角色
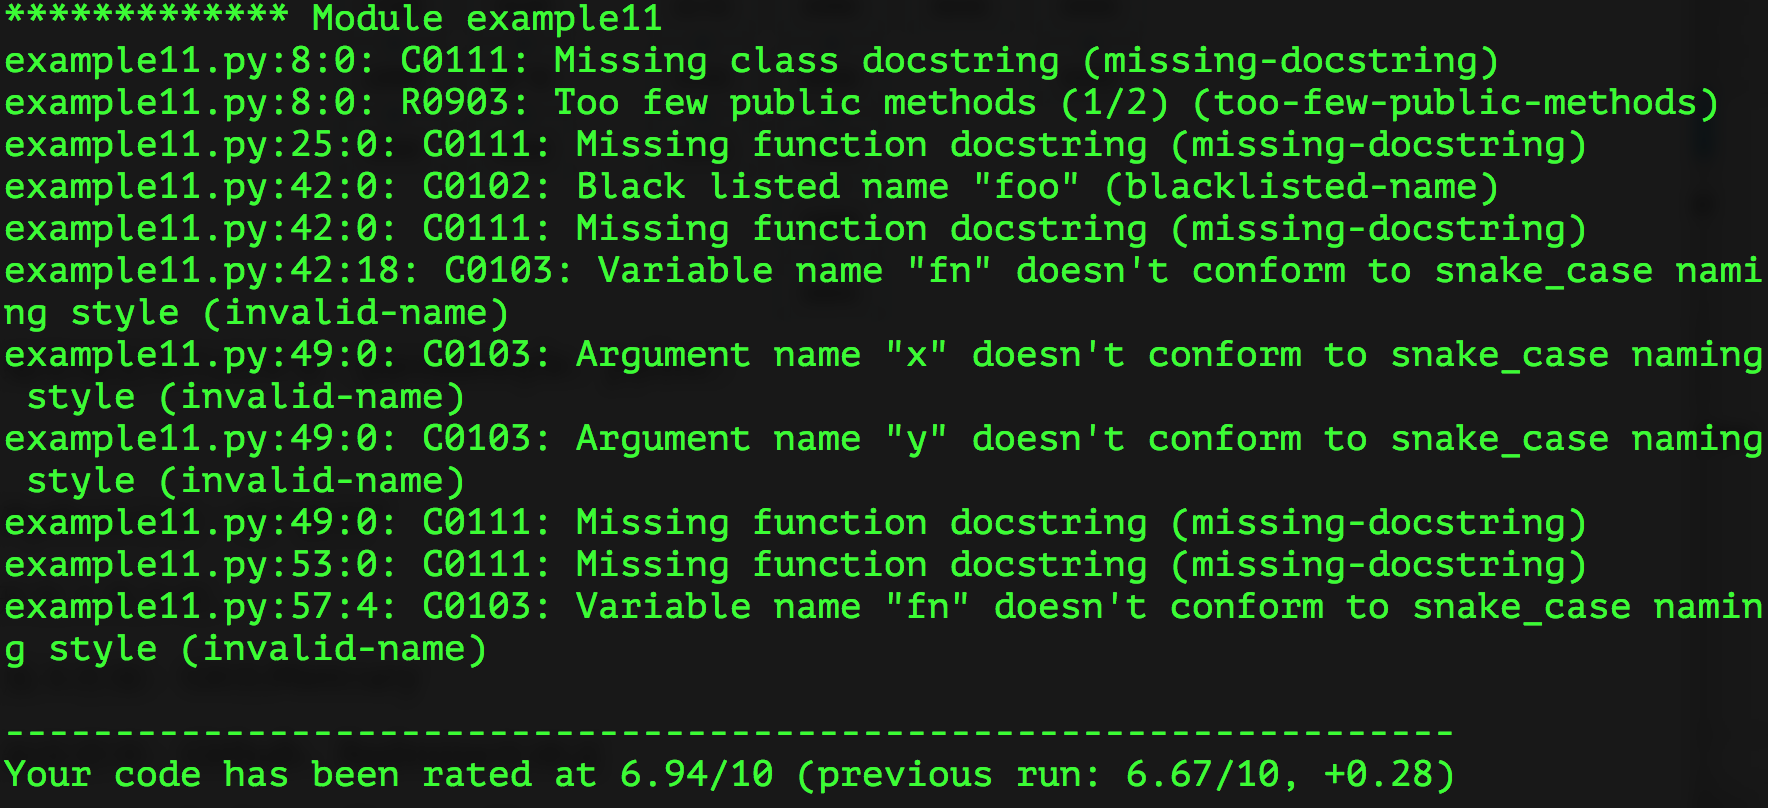
- 编程规范和代码审查(
flake8、pylint)
- Python中的一些“惯例”(请参考《Python惯例-如何编写Pythonic的代码》)
- 影响代码可读性的原因:
 - 代码注释太少或者没有注释
 - 代码破坏了语言的最佳实践
- 反模式编程(意大利面代码、复制-黏贴编程、自负编程、……)请参考《团队项目开发的问题和解决方案》。
项目选题和理解业务
- 选题范围设定
- CMS(用户端):新闻聚合网站、问答/分享社区、影评/书评网站等。
- MIS(用户端+管理端):KMS、KPI考核系统、HRS、CRM系统、供应链系统、仓储管理系统等。
- App后台(管理端+数据接口):二手交易类、报刊杂志类、小众电商类、新闻资讯类、旅游类、社交类、阅读类等。
- 其他类型:自身行业背景和工作经验、业务容易理解和把控。
- 需求理解、模块划分和任务分配
- 需求理解:头脑风暴和竞品分析。
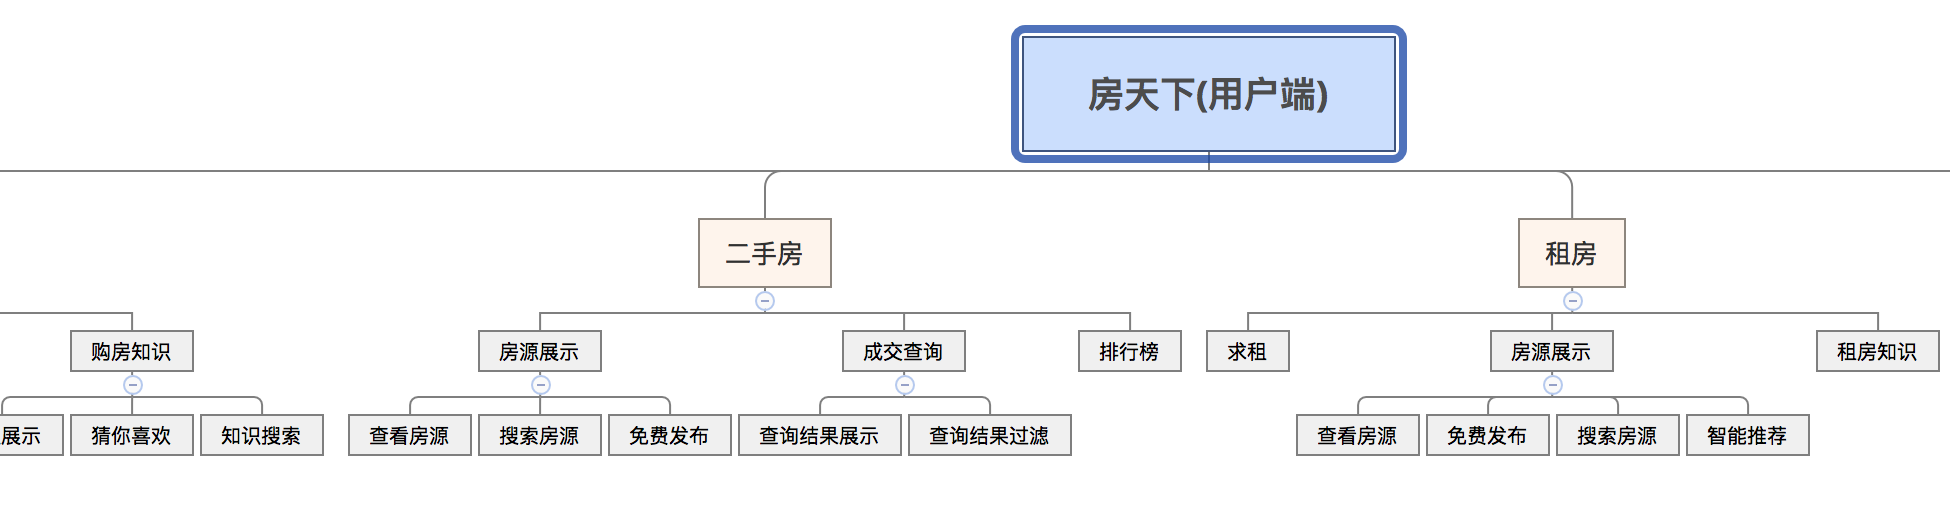
- 模块划分:画思维导图(XMind),每个模块是一个枝节点,每个具体的功能是一个叶节点(用动词表述),需要确保每个叶节点无法再生出新节点,确定每个叶子节点的重要性、优先级和工作量。
- 任务分配:由项目负责人根据上面的指标为每个团队成员分配任务。
- 制定项目进度表(每日更新)
| 模块 | 功能 | 人员 | 状态 | 完成 | 工时 | 计划开始 | 实际开始 | 计划结束 | 实际结束 | 备注 |
|---|---|---|---|---|---|---|---|---|---|---|
| 评论 | 添加评论 | 王大锤 | 正在进行 | 50% | 4 | 2018/8/7 | 2018/8/7 | |||
| 删除评论 | 王大锤 | 等待 | 0% | 2 | 2018/8/7 | 2018/8/7 | ||||
| 查看评论 | 白元芳 | 正在进行 | 20% | 4 | 2018/8/7 | 2018/8/7 | 需要进行代码审查 | |||
| 评论投票 | 白元芳 | 等待 | 0% | 4 | 2018/8/8 | 2018/8/8 |
- OOAD和数据库设计
- UML(统一建模语言)的类图
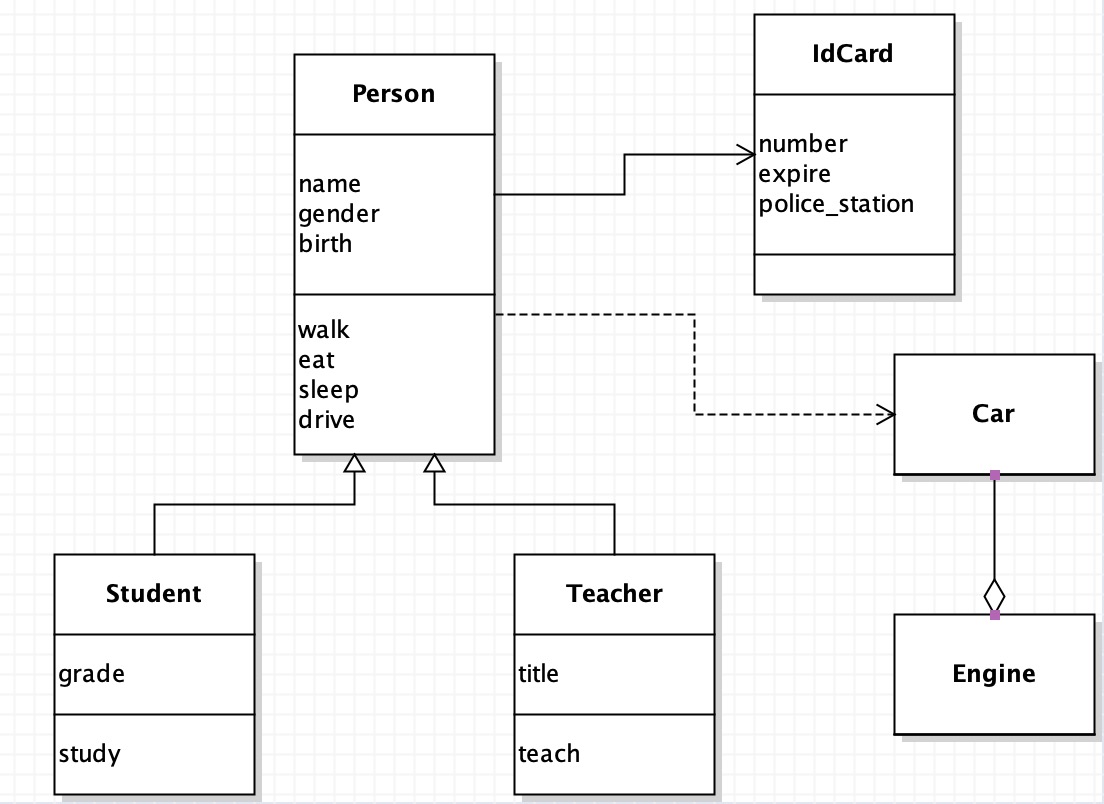- 通过模型创建表(正向工程),例如在Django项目中可以通过下面的命令创建二维表。
    python manage.py makemigrations app
python manage.py migrate- 使用PowerDesigner绘制物理模型图。
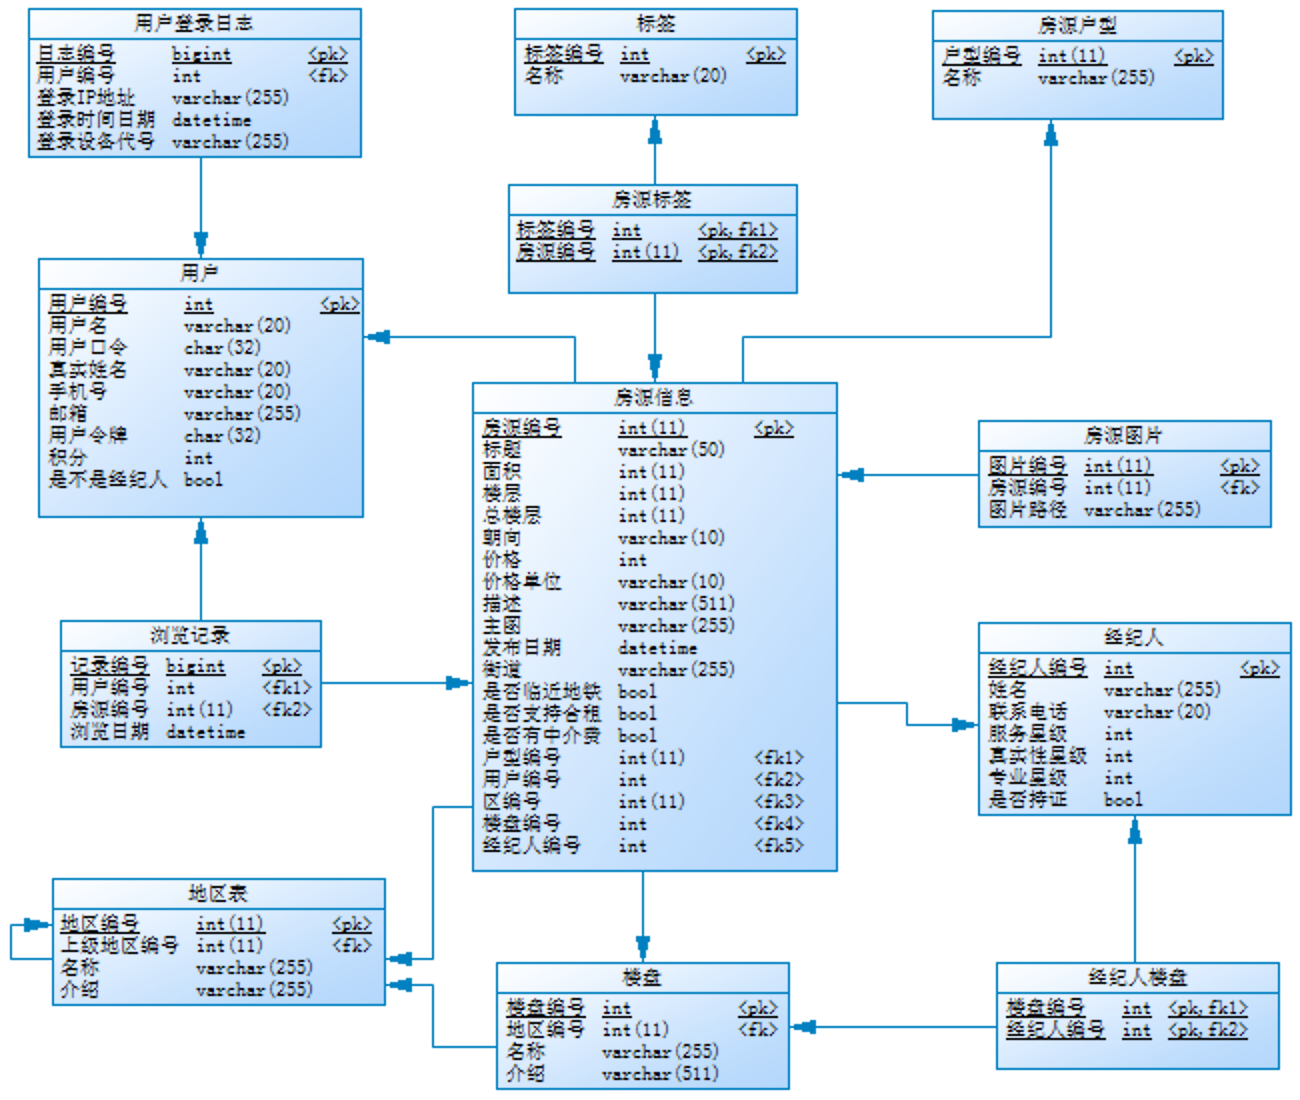- 通过数据表创建模型(反向工程),例如在Django项目中可以通过下面的命令生成模型。
python manage.py inspectdb > app/models.py第92天:Docker容器技术详解
- Docker简介
- 安装Docker
- 使用Docker创建容器(Nginx、MySQL、Redis、Gitlab、Jenkins)
- 构建Docker镜像(Dockerfile的编写和相关指令)
- 容器编排(Docker-compose)
- 集群管理(Kubernetes)
第93天:MySQL性能优化
- 基本原则
- InnoDB引擎
- 索引的使用和注意事项
- 数据分区
- SQL优化
- 配置优化
- 架构优化
第94天:网络API接口设计
- 设计原则
- 关键问题
- 其他问题- 文档撰写
第95天:[使用Django开发商业项目](./Day91-100/95.使用Django开发商业项 目.md)
项目开发中的公共问题
- 数据库的配置(多数据库、主从复制、数据库路由)
- 缓存的配置(分区缓存、键设置、超时设置、主从复制、故障恢复(哨兵))
- 日志的配置
- 分析和调试(Django-Debug-ToolBar)
- 好用的Python模块(日期计算、图像处理、数据加密、三方API)
REST API设计
- RESTful架构
- API接口文档的撰写
- django-REST-framework的应用
项目中的重点难点剖析
- 使用缓存缓解数据库压力 - Redis
- 使用消息队列做解耦合和削峰 - Celery + RabbitMQ
第96天:软件测试和自动化测试
单元测试
- 测试的种类
- 编写单元测试(
unittest、pytest、nose2、tox、ddt、……) - 测试覆盖率(
coverage)
Django项目部署
- 部署前的准备工作
- 关键设置(SECRET_KEY / DEBUG / ALLOWED_HOSTS / 缓存 / 数据库)
- HTTPS / CSRF_COOKIE_SECUR / SESSION_COOKIE_SECURE
- 日志相关配置
- Linux常用命令回顾
- Linux常用服务的安装和配置
- uWSGI/Gunicorn和Nginx的使用
- Gunicorn和uWSGI的比较
 - 对于不需要大量定制化的简单应用程序,Gunicorn是一个不错的选择,uWSGI的学习曲线比Gunicorn要陡峭得多,Gunicorn的默认参数就已经能够适应大多数应用程序。
 - uWSGI支持异构部署。
 - 由于Nginx本身支持uWSGI,在线上一般都将Nginx和uWSGI捆绑在一起部署,而且uWSGI属于功能齐全且高度定制的WSGI中间件。
- 在性能上,Gunicorn和uWSGI其实表现相当。- 使用虚拟化技术(Docker)部署测试环境和生产环境
性能测试
- AB的使用
- SQLslap的使用
- sysbench的使用
自动化测试
- 使用Shell和Python进行自动化测试
- 使用Selenium实现自动化测试
- Selenium IDE
- Selenium WebDriver
- Selenium Remote Control
- 测试工具Robot Framework介绍
第97天:电商网站技术要点剖析
- 商业模式和需求要点
- 物理模型设计
- 第三方登录
- 缓存预热和查询缓存
- 购物车的实现
- 支付功能集成
- 秒杀和超卖问题
- 静态资源管理
- 全文检索方案
第98天:项目部署上线和性能调优
- MySQL数据库调优
- Web服务器性能优化
- Nginx负载均衡配置
- Keepalived实现高可用
- 代码性能调优
- 多线程
- 异步化
- 静态资源访问优化
- 云存储
- CDN
第99天:面试中的公共问题
- 计算机基础
- Python基础
- Web框架相关
- 爬虫相关问题
- 数据分析
- 项目相关
第100天 - 补充内容
- 面试宝典
- Python 面试宝典
- SQL 面试宝典(数据分析师)
- 商业分析面试宝典
- 机器学习面试宝典- 机器学习数学基础
- 深度学习
- 计算机视觉
- 大语言模型
第一个Python程序
第一个Python程序
在上一课中,我们对 Python 语言的过去现在有了一些了解,我们准备好了运行 Python 程序所需要的解释器环境。相信大家已经迫不及待的想开始自己的 Python 编程之旅了,但是新问题来了,我们应该在什么地方书写 Python 程序,然后又怎么运行它呢?
编写代码的工具
下面我们为大家讲解几种可以编写和运行 Python 代码的工具,大家可以根据自己的需求来选择合适的工具。当然,对于初学者,我个人比较推荐使用 PyCharm,因为它不需要太多的配置也非常的强大,对新手还是很友好的。如果你也听说过或者喜欢 PyCharm,可以直接跳过下面对其他工具的介绍,直接快进到讲解 PyCharm 的地方。
默认的交互式环境
我们打开 Windows 的“命令提示符”或“PowerShell”工具,输入python然后按下Enter键,这个命令会把我们带到一个交互式环境中。所谓交互式环境,就是我们输入一行代码并按下Enter键,代码马上会被执行,如果代码有产出结果,那么结果会被显示在窗口中,如下所示。
Python 3.10.10
Type "help", "copyright", "credits" or "license" for more information.
>>> 2 * 3
6
>>> 2 + 3
5
>>>说明:使用 macOS 系统的用户需要打开“终端”工具,输入python3进入交互式环境。
如果希望退出交互式环境,可以在交互式环境中输入quit(),如下所示。
>>> quit()更好的交互式环境 - IPython
上面说的交互式环境用户体验并不怎么好,大家使用一下就能感受到。我们可以用 IPython 来替换掉它,因为 IPython 提供了更为强大的编辑和交互功能。我们可以在命令提示符或终端中使用 Python 的包管理工具pip来安装 IPython,如下所示。
pip install ipython提示:在使用上面的命令安装 IPython 之前,可以先通过pip config set global.index-url https://pypi.doubanio.com/simple命令或pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple/将下载源修改为国内的豆瓣镜像或清华镜像,否则下载安装的过程可能会非常的缓慢。
接下来可以使用下面的命令启动 IPython,进入交互式环境。
ipython说明:还有一个网页版的 IPython 名叫 Jupyter,我们在用得着它的地方再为大家介绍。
文本编辑神器 - Visual Studio Code
Visual Studio Code 是由微软开发能够在 Windows、 Linux 和 macOS 等操作系统上运行的代码编辑神器。它支持语法高亮、自动补全、多点编辑、运行调试等一系列便捷功能,而且能够支持多种编程语言。如果大家要选择一款高级文本编辑工具,强烈推荐 Visual Studio Code,关于它的下载、安装和使用,有兴趣的读者可以自行研究。

集成开发环境 - PyCharm
如果用 Python 语言开发商业项目,我们推荐大家使用更为专业的工具 PyCharm。PyCharm 是由捷克一家名为 JetBrains 的公司针对 Python 语言提供的集成开发环境(IDE)。所谓集成开发环境,通常是指提供了编写代码、运行代码、调试代码、分析代码、版本控制等一系列强大功能和便捷操作的开发工具,因此特别适合用于商业项目的开发。我们可以在 JetBrains 公司的官方网站上找到 PyCharm 的下载链接,如下图所示。

官方提供了两个 PyCharm 的版本,一个是免费的社区版(Community Edition),功能相对弱小,但对于初学者来说是完全够用的;另一个是付费的专业版(Professional Edition),功能非常强大,但需要按年或按月支付费用,新用户可以免费试用30天时间。PyCharm 的安装没有任何难度,运行下载的安装程序,几乎全部使用默认设置进行安装就可以了。对于使用 Windows 系统的小伙伴,其中有一个步骤可以按照下图所示勾选“创建桌面快捷方式”和“在右键菜单中添加"Open Folder as Project"”就可以了。

第一次运行 PyCharm 时,在提示你导入 PyCharm 设置的界面上直接选择“Do not import settings”,然后我们就可以看到如下图所示的欢迎界面。此处,我们可以先点击“Customize”选项对 PyCharm 做一些个性化的设置。

接下来,我们可以在“Projects”选项中点击“New Project”来创建一个新的项目,此处还可以“打开已有项目”或“从版本控制服务器(VCS)获取项目”,如下图所示。

创建项目的时候需要指定项目的路径并创建”虚拟环境“,我们建议每个 Python 都在自己专属的虚拟环境中运行。如果你的系统上还没 Python 环境,那么 PyCharm 会提供官网的下载链接,当你点击“Create”按钮创建项目时,它会联网下载 Python 解释器,如下图所示。

当然,我们并不推荐这么做,因为我们在上一课已经安装过 Python 环境了。在系统有 Python 环境的情况下,PyCharm 通常会自动发现 Python 解释器的位置并以此为基础创建虚拟环境,所以大家看到的画面应该如下图所示。

说明:上面的截图来自于 Windows 系统,如果使用 macOS 系统,你看到的项目路径和 Python 解释器路径会跟上面有所不同。
创建好项目后会出现如下图所示的画面,我们可以通过在项目文件夹上点击鼠标右键,选择“New”菜单下的“Python File”来创建一个 Python 文件,在给文件命名时建议使用英文字母和下划线的组合,创建好的 Python 文件会自动打开,进入可编辑的状态。

接下来,我们可以在代码窗口编写我们的 Python 代码。写好代码后,可以在窗口中点击鼠标右键,选择“Run”菜单项来运行代码,下面的“Run”窗口会显示代码的执行结果,如下图所示。

到这里,我们的第一个 Python 程序已经运转起来了,很酷吧!对了,PyCharm 有一个叫“每日小贴士”的弹窗,会教给你一些使用 PyCharm 的小技巧,如下图所示。如果不需要,直接关闭就可以了;如果不希望它再次出现,在关闭前可以勾选“Don't show tips on startup”。

你好世界
按照行业惯例,我们学习任何一门编程语言写的第一个程序都是输出hello, world,因为这段代码是伟大的丹尼斯·里奇(C 语言之父,和肯·汤普森一起开发了 Unix 操作系统)和布莱恩·柯尼汉(awk 语言的发明者)在他们的不朽著作《The C Programming Language》中写的第一段代码,下面是对应的 Python 语言的版本。
print('hello, world')注意:上面代码中的圆括号、单引号都是在英文输入法状态下输入的,如果不小心写成了中文的圆括号或单引号,运行代码时会出现SyntaxError: invalid character '(' (U+FF08)或SyntaxError: invalid character '‘' (U+2018)这样的错误提示。
上面的代码只有一个语句,在这个语句中,我们用到了一个名为print的函数,它可以帮助我们输出指定的内容;print函数圆括号中的'hello, world'是一个字符串,它代表了一段文本内容;在 Python 语言中,我们可以用单引号或双引号来表示一个字符串。不同于 C、C++ 或 Java 这样的编程语言,Python 代码中的语句不需要用分号来表示结束,也就是说,如果我们想再写一条语句,只需要回车换行即可,代码如下所示。此外,Python 代码也不需要通过编写名为main的入口函数来使其运行,提供入口函数是编写可执行的 C、C++ 或 Java 代码必须要做的事情,这一点很多程序员都不陌生,但是在 Python 语言中它并不是必要的。
print('hello, world')
print('goodbye, world')
如果不使用 PyCharm 这样的集成开发环境,我们也可以直接调用 Python 解释器来运行 Python 程序。我们可以将上面的代码保存成一个名为example01.py的文件,对于Windows 系统,我们假设该文件在C:\code目录下,我们打开“命令提示符”或“PowerShell”并输入下面的命令就可以运行它。
python C:\code\example01.py对于 macOS 系统,假设我们的文件在/Users/Hao目录下,那么可以在终端中输入下面的命令来运行程序。
python3 /Users/Hao/example01.py提示:如果路径比较长,不愿意手动输入,我们可以通过拖拽的方式将文件直接拖到“命令提示符”或“终端”中,这样会自动输入完整的文件路径。
大家可以试着修改上面的代码,比如将单引号中的hello, world换成其他内容或者多写几个这样的语句,看看会运行出怎样的结果。需要提醒大家的是,写 Python 代码时,最好每一行只写一条语句。虽然,我们可以使用;作为分隔将多个语句写在一行中,但是这样做会让代码变得非常难看,不再具备良好的可读性。
注释你的代码
注释是编程语言的一个重要组成部分,用于在代码中解释代码的作用,从而达到增强代码可读性的目标。当然,我们也可以将代码中暂时不需要运行的代码段通过添加注释来去掉,这样当你需要重新使用这些代码的时候,去掉注释符号就可以了。简单的说,注释会让代码更容易看懂但不会影响代码的执行结果。
Python 中有两种形式的注释:
- 单行注释:以
#和空格开头,可以注释掉从#开始后面一整行的内容。 - 多行注释:三个引号(通常用双引号)开头,三个引号结尾,通常用于添加多行说明性内容。
"""
第一个Python程序 - hello, world

Version: 1.0
Author: 骆昊
"""
# print('hello, world')
print("你好,世界!")
总结
到此,我们已经把第一个 Python 程序运行起来了,是不是很有成就感?!只要你坚持学习下去,再过一段时间,我们就可以用 Python 语言做更多更酷的事情。今时今日,编程就跟英语一样,对很多人来说都是一项必须要掌握的技能。
Python语言中的变量
Python语言中的变量
对于想学习编程的新手来说,有两个问题可能是他们很想知道的,其一是“什么是(计算机)程序”,其二是“写(计算机)程序能做什么”。先说说我对这两个问题的理解:程序是数据和指令的有序集合,写程序就是用数据和指令控制计算机做我们想让它做的事情。今时今日,为什么有那么多人选择用 Python 语言来写程序,因为 Python 语言足够简单和强大。相较于 C、C++、Java 这样的编程语言,Python 对初学者和非专业人士更加友好,很多问题在 Python 语言中都能找到简单优雅的解决方案。接下来,我们就从最基础的语言元素开始,带大家认识和使用 Python 语言。
一些常识
在开始系统的学习 Python 编程之前,我们先来科普一些计算机的基础知识。计算机的硬件系统通常由五大部件构成,包括:运算器、控制器、存储器、输入设备和输出设备。其中,运算器和控制器放在一起就是我们常说的中央处理器(CPU),它的功能是执行各种运算和控制指令。刚才我们提到过,程序是指令的集合,写程序就是将一系列的指令按照某种方式组织到一起,然后通过这些指令去控制计算机做我们想让它做的事情。存储器可以分为内部存储器和外部存储器,前者就是我们常说的内存,它是中央处理器可以直接寻址的存储空间,程序在执行的过程中,对应的数据和指令需要加载到内存中。输入设备和输出设备经常被统称为 I/O 设备,键盘、鼠标、麦克风、摄像头是典型的输入设备,而显示器、打印机、扬声器等则是典型的输出设备。目前,我们使用的计算机基本大多是遵循“冯·诺依曼体系结构”的计算机,这种计算机有两个关键点:一是将存储器与中央处理器分开;二是将数据以二进制方式编码。
二进制是一种“逢二进一”的计数法,跟人类使用的“逢十进一”的计数法本质是一样的。人类因为有十根手指,所以使用了十进制计数法,在计数时十根手指用完之后,就只能用进位的方式来表示更大的数值。当然凡事都有例外,玛雅人可能是因为长年光着脚的原因,把脚趾头也都用上了,于是他们使用了二十进制的计数法。基于这样的计数方式,玛雅人使用的历法跟我们平常使用的历法就产生了差异。按照玛雅人的历法,2012 年是上一个所谓的“太阳纪”的最后一年,而 2013 年则是新的“太阳纪”的开始。后来这件事情还被以讹传讹的方式误传为“2012 年是玛雅人预言的世界末日”的荒诞说法。今天有很多人猜测,玛雅文明之所以发展缓慢跟使用了二十进制是有关系的。对于计算机来说,二进制在物理器件上最容易实现的,因为可以用高电压表示 1,用低电压表示 0。不是所有写程序的人都需要熟悉二进制,熟悉十进制与二进制、八进制、十六进制的转换,大多数时候我们即便不了解这些知识也能写程序。但是,我们必须知道,计算机是使用二进制计数的,不管什么样的数据,到了计算机内存中都是以二进制形态存在的。
说明:关于二进制计数法以及它与其他进制如何相互转换,大家可以翻翻名为《计算机导论》或《计算机文化》的书,都能找到相应的知识,此处就不再进行赘述了,不清楚的读者可以自行研究。
变量和类型
要想在计算机的内存中保存数据,首先得说一说变量这个概念。在编程语言中,变量是数据的载体,简单的说就是一块用来保存数据的内存空间,变量的值可以被读取和修改,这是所有运算和控制的基础。计算机能处理的数据有很多种类型,最常见的就是数值,除了数值之外还有文本、图像、音频、视频等各种各样的数据类型。虽然数据在计算机中都是以二进制形态存在的,但是我们可以用不同类型的变量来表示数据类型的差异。Python 语言中预设了多种数据类型,也允许我们自定义新的数据类型,这一点在后面会讲到。我们首先来了解几种 Python 中最为常用的数据类型。
- 整型(
int):Python 中可以处理任意大小的整数,而且支持二进制(如0b100,换算成十进制是4)、八进制(如0o100,换算成十进制是64)、十进制(100)和十六进制(0x100,换算成十进制是256)的表示法。运行下面的代码,看看会输出什么。
    print(0b100)  # 二进制整数
    print(0o100)  # 八进制整数
    print(100)    # 十进制整数
print(0x100) # 十六进制整数- 浮点型(
float):浮点数也就是小数,之所以称为浮点数,是因为按照科学记数法表示时,一个浮点数的小数点位置是可变的,浮点数除了数学写法(如123.456)之外还支持科学计数法(如1.23456e2,表示$\small{1.23456 \times 10^{2}}$)。运行下面的代码,看看会输出什么。
    print(123.456)    # 数学写法
print(1.23456e2) # 科学计数法- 字符串型(
str):字符串是以单引号或双引号包裹起来的任意文本,比如'hello'和"hello"。
- 布尔型(
bool):布尔型只有True、False两种值,要么是True,要么是False,可以用来表示现实世界中的“是”和“否”,命题的“真”和“假”,状况的“好”与“坏”,水平的“高”与“低”等等。如果一个变量的值只有两种状态,我们就可以使用布尔型。
变量命名
对于每个变量,我们都需要给它取一个名字,就如同我们每个人都有自己的名字一样。在 Python 中,变量命名需要遵循以下的规则和惯例。
- 规则部分:
- 规则1:变量名由字母、数字和下划线构成,数字不能开头。需要说明的是,这里说的字母指的是 Unicode 字符,Unicode 称为万国码,囊括了世界上大部分的文字系统,这也就意味着中文、日文、希腊字母等都可以作为变量名中的字符,但是一些特殊字符(如:
!、@、#等)是不能出现在变量名中的。我们强烈建议大家把这里说的字母理解为尽可能只使用英文字母。 - 规则2:Python 是大小写敏感的编程语言,简单的说就是大写的
A和小写的a是两个不同的变量,这一条其实并不算规则,而是需要大家注意的地方。 - 规则3:变量名不要跟 Python 的关键字重名,尽可能避开 Python 的保留字。这里的关键字是指在 Python 程序中有特殊含义的单词(如:
is、if、else、for、while、True、False等),保留字主要指 Python 语言内置函数、内置模块等的名字(如:int、print、input、str、math、os等)。
- 规则1:变量名由字母、数字和下划线构成,数字不能开头。需要说明的是,这里说的字母指的是 Unicode 字符,Unicode 称为万国码,囊括了世界上大部分的文字系统,这也就意味着中文、日文、希腊字母等都可以作为变量名中的字符,但是一些特殊字符(如:
- 惯例部分:
- 惯例1:变量名通常使用小写英文字母,多个单词用下划线进行连接。
- 惯例2:受保护的变量用单个下划线开头。
- 惯例3:私有的变量用两个下划线开头。
惯例2和惯例3大家暂时不用管,讲到后面自然会明白的。当然,作为一个专业的程序员,给变量命名时做到见名知意也是非常重要,这彰显了一个程序员的专业气质,很多开发岗位的面试也非常看重这一点。
变量的使用
下面通过例子来说明变量的类型和变量的使用。
"""
使用变量保存数据并进行加减乘除运算

Version: 1.0
Author: 骆昊
"""
a = 45        # 定义变量a,赋值45
b = 12        # 定义变量b,赋值12
print(a, b)   # 45 12
print(a + b)  # 57
print(a - b)  # 33
print(a * b)  # 540
print(a / b)  # 3.75
在 Python 中可以使用type函数对变量的类型进行检查。程序设计中函数的概念跟数学上函数的概念非常类似,数学上的函数相信大家并不陌生,它包括了函数名、自变量和因变量。如果暂时不理解函数这个概念也不要紧,我们会在后续的内容中专门讲解函数的定义和使用。
"""
使用type函数检查变量的类型

Version: 1.0
Author: 骆昊
"""
a = 100
b = 123.45
c = 'hello, world'
d = True
print(type(a))  # <class 'int'>
print(type(b))  # <class 'float'>
print(type(c))  # <class 'str'>
print(type(d))  # <class 'bool'>
可以通过 Python 内置的函数来改变变量的类型,下面是一些常用的和变量类型相关的函数。
int():将一个数值或字符串转换成整数,可以指定进制。float():将一个字符串(在可能的情况下)转换成浮点数。str():将指定的对象转换成字符串形式,可以指定编码方式。chr():将整数(字符编码)转换成对应的(一个字符的)字符串。ord():将(一个字符的)字符串转换成对应的整数(字符编码)。
下面的例子为大家演示了 Python 中类型转换的操作。
"""
变量的类型转换操作

Version: 1.0
Author: 骆昊
"""
a = 100
b = 123.45
c = '123'
d = '100'
e = '123.45'
f = 'hello, world'
g = True
print(float(a))         # int类型的100转成float,输出100.0
print(int(b))           # float类型的123.45转成int,输出123
print(int(c))           # str类型的'123'转成int,输出123
print(int(c, base=16))  # str类型的'123'按十六进制转成int,输出291
print(int(d, base=2))   # str类型的'100'按二进制转成int,输出4
print(float(e))         # str类型的'123.45'转成float,输出123.45
print(bool(f))          # str类型的'hello, world'转成bool,输出True
print(int(g))           # bool类型的True转成int,输出1
print(chr(a))           # int类型的100转成str,输出'd'
print(ord('d')) # str类型的'd'转成int,输出100说明:str类型转int类型时可以通过base参数来指定进制,可以将字符串视为对应进制的整数进行转换。str类型转成bool类型时,只要字符串有内容,不是''或"",对应的布尔值都是True。bool类型转int类型时,True会变成1,False会变成0。在 ASCII 字符集和 Unicode 字符集中, 字符'd'对应的编码都是100。
总结
在 Python 程序中,我们可以使用变量来保存数据,变量有不同的类型,常用的类型有int、float、str和bool。在有需要的情况下,可以通过 Python 内置的函数对变量进行类型转换。变量是可以做运算的,这是解决很多问题的先决条件,我们会在下一课中为大家详细介绍变量的运算。
Python语言中的运算符
Python语言中的运算符
Python 语言支持很多种运算符,下面的表格按照运算符的优先级从高到低,对 Python 中的运算符进行了罗列。有了变量和运算符,我们就可以构造各种各样的表达式来解决实际问题。在计算机科学中,表达式是计算机程序中的句法实体,它由一个或多个常量、变量、函数和运算符组合而成,编程语言可以对其进行解释和计算以得到另一个值。不理解这句话没有关系,但是一定要知道,不管使用什么样的编程语言,构造表达式都是非常重要的。
| 运算符 | 描述 | |
|---|---|---|
[]、[:] | 索引、切片 | |
** | 幂 | |
~、+、- | 按位取反、正号、负号 | |
*、/、%、// | 乘、除、模、整除 | |
+、- | 加、减 | |
>>、<< | 右移、左移 | |
& | 按位与 | |
^、` | ` | 按位异或、按位或 |
<=、<、>、>= | 小于等于、小于、大于、大于等于 | |
==、!= | 等于、不等于 | |
is、is not | 身份运算符 | |
in、not in | 成员运算符 | |
not、or、and | 逻辑运算符 | |
=、+=、-=、*=、/=、%=、//=、**=、&=、`\ | =、^=、>>=、<<=` | 赋值运算符 |
说明: 所谓优先级就是在一个运算的表达式中,如果出现了多个运算符,应该先执行什么再执行什么的顺序。编写代码的时候,如果搞不清楚一个表达式中运算符的优先级,可以使用圆括号(小括号)来确保运算的执行顺序。
算术运算符
Python 中的算术运算符非常丰富,除了大家最为熟悉的加、减、乘、除之外,还有整除运算符、求模(求余数)运算符和求幂运算符。下面的例子为大家展示了算术运算符的使用。
"""
算术运算符

Version: 1.0
Author: 骆昊
"""
print(321 + 12)     # 加法运算,输出333
print(321 - 12)     # 减法运算,输出309
print(321 * 12)     # 乘法运算,输出3852
print(321 / 12)     # 除法运算,输出26.75
print(321 // 12)    # 整除运算,输出26
print(321 % 12)     # 求模运算,输出9
print(321 ** 12)    # 求幂运算,输出1196906950228928915420617322241
算术运算需要先乘除后加减,这一点跟数学课本中讲的知识没有区别,也就是说乘除法的运算优先级是高于加减法的。如果还有求幂运算,求幂运算的优先级是高于乘除法的。如果想改变算术运算的执行顺序,可以使用英文输入法状态下的圆括号(小括号),写在圆括号中的表达式会被优先执行,如下面的例子所示。
"""
算术运算的优先级

Version: 1.0
Author: 骆昊
"""
print(2 + 3 * 5)           # 17
print((2 + 3) * 5)         # 25
print((2 + 3) * 5 ** 2)    # 125
print(((2 + 3) * 5) ** 2)  # 625
赋值运算符
赋值运算符应该是最为常见的运算符,它的作用是将右边的值赋给左边的变量。赋值运算符还可以跟上面的算术运算符放在一起,组合成复合赋值运算符,例如:a += b相当于a = a + b,a *= a + 2相当于a = a * (a + 2)。下面的例子演示了赋值运算符和复合赋值运算符的使用。
"""
赋值运算符和复合赋值运算符

Version: 1.0
Author: 骆昊
"""
a = 10
b = 3
a += b        # 相当于:a = a + b
a *= a + 2    # 相当于:a = a * (a + 2)
print(a) # 大家算一下这里会输出什么赋值运算构成的表达式本身不产生任何值,也就是说,如果你把一个赋值表达式放到print函数中试图输出表达式的值,将会产生语法错误。为了解决这个问题,Python 3.8 中引入了一个新的赋值运算符:=,我们称之为海象运算符,大家可以猜一猜它为什么叫这个名字。海象运算符也是将运算符右侧的值赋值给左边的变量,与赋值运算符不同的是,运算符右侧的值也是整个表达式的值,看看下面的代码大家就明白了。
"""
海象运算符

Version: 1.0
Author: 骆昊
"""
# SyntaxError: invalid syntax
# print((a = 10))
# 海象运算符
print((a := 10))  # 10
print(a) # 10提示:上面第 8 行代码如果不注释掉,运行代码会看到SyntaxError: invalid syntax错误信息,注意,这行代码中我们给a = 10加上了圆括号,如果不小心写成了print(a = 10),会看到TypeError: 'a' is an invalid keyword argument for print()错误信息,后面讲到函数的时候,大家就会明白这个错误提示是什么意思了。
比较运算符和逻辑运算符
比较运算符也称为关系运算符,包括==、!=、<、>、<=、>=,我相信大家一看就能懂。需要提醒的是比较相等用的是==,请注意这里是两个等号,因为=是赋值运算符,我们在上面刚刚讲到过。比较不相等用的是!=,跟数学课本中使用的$\small{\neq}$并不相同,Python 2 中曾经使用过<>来表示不等于,在 Python 3 中使用<>会引发SyntaxError(语法错误)。比较运算符会产生布尔值,要么是True,要么是False。
逻辑运算符有三个,分别是and、or和not。and字面意思是“而且”,所以and运算符会连接两个布尔值或者产生布尔值的表达式,如果两边的布尔值都是True,那么运算的结果就是True;左右两边的布尔值有一个是False,最终的运算结果就是False。当然,如果and运算符左边的布尔值是False,不管右边的布尔值是什么,最终的结果都是False,这时运算符右边的布尔值会被跳过(专业的说法叫短路处理,如果and右边是一个表达式,那么这个表达式不会执行)。or字面意思是“或者”,所以or运算符也会连接两个布尔值或产生布尔值的表达式,如果两边的布尔值有任意一个是True,那么最终的结果就是True。当然,or运算符也是有短路功能的,当它左边的布尔值为True的情况下,右边的布尔值会被短路(如果or右边是一个表达式,那么这个表达式不会执行)。not运算符的后面可以跟一个布尔值,如果not后面的布尔值或表达式是True,那么运算的结果就是False;如果not后面的布尔值或表达式是False,那么运算的结果就是True。
"""
比较运算符和逻辑运算符的使用

Version: 1.0
Author: 骆昊
"""
flag0 = 1 == 1
flag1 = 3 > 2
flag2 = 2 < 1
flag3 = flag1 and flag2
flag4 = flag1 or flag2
flag5 = not flag0
print('flag0 =', flag0)     # flag0 = True
print('flag1 =', flag1)     # flag1 = True
print('flag2 =', flag2)     # flag2 = False
print('flag3 =', flag3)     # flag3 = False
print('flag4 =', flag4)     # flag4 = True
print('flag5 =', flag5)     # flag5 = False
print(flag1 and not flag2)  # True
print(1 > 2 or 2 == 3) # False说明:比较运算符的优先级高于赋值运算符,所以上面的flag0 = 1 == 1先做1 == 1产生布尔值True,再将这个值赋值给变量flag0。,进行分隔,输出的内容默认以空格分开。
运算符和表达式应用
例子1:华氏温度转摄氏温度
要求:输入华氏温度将其转换为摄氏温度,华氏温度到摄氏温度的转换公式为: $\small{C = (F - 32) / 1.8}$ 。
"""
将华氏温度转换为摄氏温度

Version: 1.0
Author: 骆昊
"""
f = float(input('请输入华氏温度: '))
c = (f - 32) / 1.8
print('%.1f华氏度 = %.1f摄氏度' % (f, c))说明:上面代码中的input函数用于从键盘接收用户输入,由于输入的都是字符串,如果想处理成浮点小数来做后续的运算,可以用我们上一课讲解的类型转换的方法,用float函数将str类型处理成float类型。
上面的代码中,我们对print函数输出的内容进行了格式化处理,print输出的字符串中有两个%.1f占位符,这两个占位符会被%之后的(f, c)中的两个float类型的变量值给替换掉,浮点数小数点后保留1位有效数字。如果字符串中有%d占位符,那么我们会用int类型的值替换掉它,如果字符串中有%s占位符,那么它会被str类型的值替换掉。
除了上面格式化输出的方式外,Python 中还可以用下面的办法来格式化输出,我们给出一个带占位符的字符串,字符串前面的f表示这个字符串是需要格式化处理的,其中的{f:.1f}和{c:.1f}可以先看成是{f}和{c},表示输出时会用变量f和变量c的值替换掉这两个占位符,后面的:.1f表示这是一个浮点数,小数点后保留1位有效数字。
"""
将华氏温度转换为摄氏温度

Version: 1.1
Author: 骆昊
"""
f = float(input('请输入华氏温度: '))
c = (f - 32) / 1.8
print(f'{f:.1f}华氏度 = {c:.1f}摄氏度')
例子2:计算圆的周长和面积
要求:输入一个圆的半径($\small{r}$),计算出它的周长( $\small{2 \pi r}$ )和面积( $\small{\pi r^{2}}$ )。
"""
输入半径计算圆的周长和面积

Version: 1.0
Author: 骆昊
"""
radius = float(input('请输入圆的半径: '))
perimeter = 2 * 3.1416 * radius
area = 3.1416 * radius * radius
print('周长: %.2f' % perimeter)
print('面积: %.2f' % area)
Python 中有一个名为math 的内置模块,该模块中定义了名为pi的变量,它的值就是圆周率。如果要使用 Python 内置的这个pi,我们可以对上面的代码稍作修改。
"""
输入半径计算圆的周长和面积

Version: 1.1
Author: 骆昊
"""
import math

radius = float(input('请输入圆的半径: '))
perimeter = 2 * math.pi * radius
area = math.pi * radius ** 2
print(f'周长: {perimeter:.2f}')
print(f'面积: {area:.2f}')说明:上面代码中的import math表示导入math模块,导入该模块以后,才能用math.pi得到圆周率的值。
这里其实还有一种格式化输出的方式,是 Python 3.8 中增加的新特性,大家直接看下面的代码就明白了。
"""
输入半径计算圆的周长和面积

Version: 1.2
Author: 骆昊
"""
import math

radius = float(input('请输入圆的半径: '))  # 输入: 5.5
perimeter = 2 * math.pi * radius
area = math.pi * radius ** 2
print(f'{perimeter = :.2f}')  # 输出:perimeter = 34.56
print(f'{area = :.2f}') # 输出:area = 95.03说明:假如变量a的值是9.87,那么字符串f'{a = }'的值是a = 9.87;而字符串f'{a = :.1f}'的值是a = 9.9。这种格式化输出的方式会同时输出变量名和变量值。
例子3:判断闰年
要求:输入一个 1582 年以后的年份,判断该年份是不是闰年。
"""
输入年份,闰年输出True,平年输出False

Version: 1.0
Author: 骆昊
"""
year = int(input('请输入年份: '))
is_leap = year % 4 == 0 and year % 100 != 0 or year % 400 == 0
print(f'{is_leap = }')说明:对于格里历(Gregorian calendar),即今天我们使用的公历,判断闰年的规则是:1. 公元年份非 4 的倍数是平年;2. 公元年份为 4 的倍数但非 100 的倍数是闰年;3. 公元年份为 400 的倍数是闰年。格里历是由教皇格里高利十三世在 1582 年 10 月引入的,作为对儒略历(Julian calendar)的修改和替代,我们在输入年份时要注意这一点。上面的代码通过%来判断year是不是4的倍数、100的倍数、400的倍数,然后用and和or运算符将三个条件组装在一起,前两个条件要同时满足,第三个条件跟前两个条件的组合只需满足其中之一。
总结
通过上面的讲解和例子,相信大家已经感受到了运算符和表达式的力量。实际编程中的很多问题,都需通过构造表达式来解决,所以变量、运算符、表达式对于任何一门编程语言都是极为重要的基础。如果本节课的内容有什么不理解的地方,一定不要着急进入下一课,先在评论区留言讨论,我会及时解答大家的问题。
分支结构
分支结构
迄今为止,我们写的 Python 程序都是一条一条语句按顺序向下执行的,这种代码结构叫做顺序结构。然而仅有顺序结构并不能解决所有的问题,比如我们设计一个游戏,游戏第一关的过关条件是玩家获得 1000 分,那么在第一关完成后,我们要根据玩家得到的分数来决定是进入第二关,还是告诉玩家“Game Over”(游戏结束)。在这种场景下,我们的代码就会产生两个分支,而且只有一个会被执行。类似的场景还有很多,我们将这种结构称之为“分支结构”或“选择结构”。给大家一分钟的时间,你应该可以想到至少 5 个以上类似的例子,赶紧试一试吧!
使用if和else构造分支结构
在 Python 中,构造分支结构最常用的是if、elif和else三个关键字。所谓关键字就是编程语言中有特殊含义的单词,很显然你不能够使用它作为变量名。当然,我们并不是每次构造分支结构都会把三个关键字全部用上,我们通过例子加以说明。例如我们要写一个身体质量指数(BMI)的计算器。身体质量质数也叫体质指数,是国际上常用的衡量人体胖瘦程度以及是否健康的一个指标,计算公式如下所示。通常认为 $\small{18.5 \le BMI < 24}$ 是正常范围, $\small{BMI < 18.5}$ 说明体重过轻, $\small{BMI \ge 24}$ 说明体重过重, $\small{BMI \ge 27}$ 就属于肥胖的范畴了。
$$ BMI = \frac{体重}{身高^{2}} $$
说明:上面公式中的体重以千克(kg)为单位,身高以米(m)为单位。
"""
BMI计算器

Version: 1.0
Author: 骆昊
"""
height = float(input('身高(cm):'))
weight = float(input('体重(kg):'))
bmi = weight / (height / 100) ** 2
print(f'{bmi = :.1f}')
if 18.5 <= bmi < 24:
print('你的身材很棒!')提示:if语句的最后面有一个:,它是用英文输入法输入的冒号;程序中输入的'、"、=、(、)等特殊字符,都是在英文输入法状态下输入的,这一点之前已经提醒过大家了。很多初学者经常会忽略这一点,等到执行代码时,就会看到一大堆错误提示。当然,认真读一下错误提示还是很容易发现哪里出了问题,但是强烈建议大家在写代码的时候切换到英文输入法,这样可以避免很多不必要的麻烦。
上面的代码中,我们在计算和输出 BMI 之后,加上了一段分支结构,如果满足 $\small{18.5 \le BMI < 24}$ ,程序会输出“你的身材很棒!”,但是如果不满足条件,这段输出就没有了。这就是刚才提到的,代码可以有不同的执行路径,有些代码不一定会执行到。我们在if关键字的后面给出了一个表达式18.5 <= bmi < 24,之前我们说过,关系运算会产生布尔值,如果if后面的布尔值为True,那么if语句下方,有四个空格缩进的print('你的身材很棒!')就会被执行。我们先输入几组数据运行上面的代码,如下所示。
第一组输入:
身高(cm):175
体重(kg):68
bmi = 22.2
你的身材很棒!
第二组输入:
身高(cm):175
体重(kg):95
bmi = 31.0
第三组输入:
身高(cm):175
体重(kg):50
bmi = 16.3
只有第一组输入的身高和体重计算出的 BMI 在 18.5 到 24 这个范围值内,所以触发了if条件,输出了“你的身材很棒”。需要说明的是,不同于 C、C++、Java 等编程语言,Python 中没有用花括号来构造代码块而是使用缩进的方式来表示代码的层次结构,如果if条件成立的情况下需要执行多条语句,只要保持多条语句具有相同的缩进就可以了。换句话说,若干行连续的语句如果保持了相同的缩进,那么它们就属于同一个代码块,相当于是一个执行的整体。缩进可以使用任意数量的空格,但通常使用4个空格,强烈建议大家不要使用制表键(Tab键)来缩进代码,如果你已经习惯了这么做,可以设置你的代码编辑器自动将 1 个制表键变成 4 个空格,很多代码编辑器都支持这项功能,PyCharm 中默认也是这样设定的。还有一点,在 C、C++、Java 等编程语言中,18.5 <= bmi < 24要写成两个条件bmi >= 18.5和bmi < 24,然后把两个条件用与运算符连接起来,Python 中也可以这么做,例如刚才的if语句也可以写成if bmi >= 18.5 and bmi < 24:,但是没有必要,难道if 18.5 <= bmi < 24:这个写法它不香吗?下面用 Java 代码做了同样的事情,看不懂 Java 代码没关系,感受一下它和 Python 语法的区别就可以了。
import java.util.Scanner;

class Test {

    public static void main(String[] args) {
        try (Scanner sc = new Scanner(System.in)) {
            System.out.print("身高(cm): ");
            double height = sc.nextDouble();
            System.out.print("体重(kg): ");
            double weight = sc.nextDouble();
            double bmi = weight / Math.pow(height / 100, 2);
            System.out.printf("bmi = %.1f\n", bmi);
            if (bmi >= 18.5 && bmi < 24) {
                System.out.println("你的身材很棒!");
            }
        }
    }
}说明:上面就是 BMI 计算器 1.0 版本对应的 Java 代码,很多人喜欢 Python 语言不是没有道理的,通常它都能用更少的代码解决同样的问题。
接下来,我们对上面的代码稍作修改,在 BMI 不满足 $\small{18.5 \le BMI < 24}$ 的情况下,也给出相信的提示信息。我们可以在if代码块的后面增加一个else代码块,它会在if语句给出的条件没有达成时执行,如下所示。很显然,if下面的print('你的身材很棒!')和else下面的print('你的身材不够标准哟!')只有一个会被执行到。
"""
BMI计算器

Version: 1.1
Author: 骆昊
"""
height = float(input('身高(cm):'))
weight = float(input('体重(kg):'))
bmi = weight / (height / 100) ** 2
print(f'{bmi = :.1f}')
if 18.5 <= bmi < 24:
    print('你的身材很棒!')
else:
print('你的身材不够标准哟!')如果要给出更为准确的提示信息,我们可以再次修改上面的代码,通过elif关键字为上面的分支结构增加更多的分支,如下所示。
"""
BMI计算器

Version: 1.2
Author: 骆昊
"""
height = float(input('身高(cm):'))
weight = float(input('体重(kg):'))
bmi = weight / (height / 100) ** 2
print(f'{bmi = :.1f}')
if bmi < 18.5:
    print('你的体重过轻!')
elif bmi < 24:
    print('你的身材很棒!')
elif bmi < 27:
    print('你的体重过重!')
elif bmi < 30:
    print('你已轻度肥胖!')
elif bmi < 35:
    print('你已中度肥胖!')
else:
    print('你已重度肥胖!')
我们再用刚才的三组数据来测试下上面的代码,看看会得到怎样的结果。
第一组输入:
身高(cm):175
体重(kg):68
bmi = 22.2
你的身材很棒!
第二组输入:
身高(cm):175
体重(kg):95
bmi = 31.0
你已中度肥胖!
第三组输入:
身高(cm):175
体重(kg):50
bmi = 16.3
你的体重过轻!
使用match和case构造分支结构
Python 3.10 中增加了一种新的构造分支结构的方式,通过使用match和case 关键字,我们可以轻松的构造出多分支结构。Python 的官方文档在介绍这个新语法时,举了一个 HTTP 响应状态码识别的例子(根据 HTTP 响应状态输出对应的描述),非常有意思。如果不知道什么是 HTTP 响应状态吗,可以看看 MDN 上面的文档。下面我们对官方文档上的示例稍作修改,为大家讲解这个语法,先看看下面用if-else结构实现的代码。
status_code = int(input('响应状态码: '))
if status_code == 400:
    description = 'Bad Request'
elif status_code == 401:
    description = 'Unauthorized'
elif status_code == 403:
    description = 'Forbidden'
elif status_code == 404:
    description = 'Not Found'
elif status_code == 405:
    description = 'Method Not Allowed'
elif status_code == 418:
    description = 'I am a teapot'
elif status_code == 429:
    description = 'Too many requests'
else:
    description = 'Unknown status Code'
print('状态码描述:', description)
运行结果:
响应状态码: 403
状态码描述: Forbidden下面是使用match-case语法实现的代码,虽然作用完全相同,但是代码显得更加简单优雅。
status_code = int(input('响应状态码: '))
match status_code:
    case 400: description = 'Bad Request'
    case 401: description = 'Unauthorized'
    case 403: description = 'Forbidden'
    case 404: description = 'Not Found'
    case 405: description = 'Method Not Allowed'
    case 418: description = 'I am a teapot'
    case 429: description = 'Too many requests'
    case _: description = 'Unknown Status Code'
print('状态码描述:', description)说明:带有_的case语句在代码中起到通配符的作用,如果前面的分支都没有匹配上,代码就会来到case _。case _的是可选的,并非每种分支结构都要给出通配符选项。如果分支中出现了case _,它只能放在分支结构的最后面,如果它的后面还有其他的分支,那么这些分支将是不可达的。
当然,match-case语法还有很多高级玩法,其中有一个合并模式可以先教给大家。例如,我们要将响应状态码401、403和404归入一个分支,400和405归入到一个分支,其他保持不变,代码还可以这么写。
status_code = int(input('响应状态码: '))
match status_code:
    case 400 | 405: description = 'Invalid Request'
    case 401 | 403 | 404: description = 'Not Allowed'
    case 418: description = 'I am a teapot'
    case 429: description = 'Too many requests'
    case _: description = 'Unknown Status Code'
print('状态码描述:', description)
运行结果:
响应状态码: 403
状态码描述: Not Allowed
分支结构的应用
例子1:分段函数求值
有如下所示的分段函数,要求输入x,计算出y。
$$ y = \begin{cases} 3x - 5, & (x \gt 1) \\\\ x + 2, & (-1 \le x \le 1) \\\\ 5x + 3, & (x \lt -1) \end{cases} $$
"""
分段函数求值

Version: 1.0
Author: 骆昊
"""
x = float(input('x = '))
if x > 1:
    y = 3 * x - 5
elif x >= -1:
    y = x + 2
else:
    y = 5 * x + 3
print(f'{y = }')根据实际开发的需要,分支结构是可以嵌套的,也就是说在分支结构的if、elif或else代码块中还可以再次引入分支结构。例如if条件成立表示玩家过关,但过关以后还要根据你获得宝物或者道具的数量对你的表现给出评价(比如点亮一颗、两颗或三颗星星),那么我们就需要在if的内部再构造一个新的分支结构。同理,我们在elif和else中也可以构造新的分支,我们称之为嵌套的分支结构。按照这样的思路,上面的分段函数求值也可以用下面的代码来实现。
"""
分段函数求值

Version: 1.1
Author: 骆昊
"""
x = float(input('x = '))
if x > 1:
    y = 3 * x - 5
else:
    if x >= -1:
        y = x + 2
    else:
        y = 5 * x + 3
print(f'{y = }')说明:大家可以自己感受和评判一下上面两种写法哪一种更好。在“Python 之禅”中有这么一句话:“Flat is better than nested”。之所以认为“扁平化”的代码更好,是因为代码嵌套的层次如果很多,会严重的影响代码的可读性。所以,我个人更推荐大家使用第一种写法。
例子2:百分制成绩转换成等级
要求:如果输入的成绩在90分以上(含90分),则输出A;输入的成绩在80分到90分之间(不含90分),则输出B;输入的成绩在70分到80分之间(不含80分),则输出C;输入的成绩在60分到70分之间(不含70分),则输出D;输入的成绩在60分以下,则输出E。
"""
百分制成绩转换为等级制成绩

Version: 1.0
Author: 骆昊
"""
score = float(input('请输入成绩: '))
if score >= 90:
    grade = 'A'
elif score >= 80:
    grade = 'B'
elif score >= 70:
    grade = 'C'
elif score >= 60:
    grade = 'D'
else:
    grade = 'E'
print(f'{grade = }')
例子3:计算三角形的周长和面积。
要求:输入三条边的长度,如果能构成三角形就计算周长和面积;否则给出“不能构成三角形”的提示。
"""
计算三角形的周长和面积

Version: 1.0
Author: 骆昊
"""
a = float(input('a = '))
b = float(input('b = '))
c = float(input('c = '))
if a + b > c and a + c > b and b + c > a:
    perimeter = a + b + c
    print(f'周长: {perimeter}')
    s = perimeter / 2
    area = (s * (s - a) * (s - b) * (s - c)) ** 0.5
    print(f'面积: {area}')
else:
    print('不能构成三角形')
说明: 上面的if条件表示任意两边之和大于第三边,这是构成三角形的必要条件。当这个条件成立时,我们要计算并输出周长和面积,所以if下方有五条语句都保持了相同的缩进,它们是一个整体,只要if条件成立,它们都会被执行,这就是我们之前提到的代码块的概念。另外,上面计算三角形面积的公式叫做海伦公式,假设有一个三角形,边长分别为 $\small{a}$ 、 $\small{b}$ 、 $\small{c}$ ,那么三角的面积 $\small{A}$ 可以由公式 $\small{A = \sqrt{s(s-a)(s-b)(s-c)}}$ 得到,其中, $s=\frac{a + b + c}{2}$ 表示半周长。
总结
学会了 Python 中的分支结构和循环结构,我们就可以解决很多实际的问题了。这一节课相信已经帮助大家掌握了构造分支结构的方法,下一节课我们为大家介绍循环结构,学完这两次课你一定会发现,你能写出很多很有意思的代码,继续加油吧!
循环结构
循环结构
我们在写程序的时候,极有可能遇到需要重复执行某条或某些指令的场景,例如我们需要每隔1秒钟在屏幕上输出一次“hello, world”并持续输出一个小时。如下所示的代码可以完成一次这样的操作,如果要持续输出一个小时,我们就需要把这段代码写3600遍,你愿意这么做吗?
import time

print('hello, world')
time.sleep(1)说明:Python 内置time模块的sleep函数可以实现程序的休眠,参数1表示休眠的秒数,可以使用int或float类型,例如0.05表示50毫秒。关于函数和模块的知识,我们在后续的课程中会为大家讲解。
为了应对上述场景中的问题,我们可以在 Python 程序中使用循环结构。所谓循环结构,就是程序中控制某条或某些指令重复执行的结构。有了这样的结构,刚才的代码就不需要写 3600 遍,而是写一遍然后放到循环结构中重复 3600 次。在 Python 语言中构造循环结构有两种做法,一种是for-in循环,另一种是while循环。
for-in循环
如果明确知道循环执行的次数,我们推荐使用for-in循环,例如上面说的那个重复 3600 次的场景,我们可以用下面的代码来实现。 注意,被for-in循环控制的代码块也是通过缩进的方式来构造,这一点跟分支结构中构造代码块的做法是一样的。我们被for-in循环控制的代码块称为循环体,通常循环体中的语句会根据循环的设定被重复执行。
"""
每隔1秒输出一次“hello, world”,持续1小时

Author: 骆昊
Version: 1.0
"""
import time

for i in range(3600):
    print('hello, world')
time.sleep(1)需要说明的是,上面代码中的range(3600)可以构造出一个从0到3599的范围,当我们把这样一个范围放到for-in循环中,就可以通过前面的循环变量i依次取出从0到3599的整数,这就会让for-in代码块中的语句重复 3600 次。当然,range的用法非常灵活,下面的清单给出了使用range函数的例子:
range(101):可以用来产生0到100范围的整数,需要注意的是取不到101。range(1, 101):可以用来产生1到100范围的整数,相当于是左闭右开的设定,即[1, 101)。range(1, 101, 2):可以用来产生1到100的奇数,其中2是步长(跨度),即每次递增的值,101取不到。range(100, 0, -2):可以用来产生100到1的偶数,其中-2是步长(跨度),即每次递减的值,0取不到。
大家可能已经注意到了,上面代码的输出操作和休眠操作都没有用到循环变量i,对于不需要用到循环变量的for-in循环结构,按照 Python 的编程惯例,我们通常把循环变量命名为_,修改后的代码如下所示。虽然结果没什么变化,但是这样写显得你更加专业,逼格瞬间拉满。
"""
每隔1秒输出一次“hello, world”,持续1小时

Author: 骆昊
Version: 1.1
"""
import time

for _ in range(3600):
    print('hello, world')
    time.sleep(1)
上面的代码要执行一个小时,如果想提前结束程序,在 PyCharm 中可以点击运行窗口上的停止按钮,如下图所示。如果在命令提示符或终端中运行代码,可以使用组合键ctrl+c来终止程序。

下面,我们用for-in循环实现从 1 到 100 的整数求和,即 $\small{\sum_{n=1}^{100}{n}}$ 。
"""
从1到100的整数求和

Version: 1.0
Author: 骆昊
"""
total = 0
for i in range(1, 101):
    total += i
print(total)上面的代码中,变量total的作用是保存累加的结果。在循环的过程中,循环变量i的值会从 1 一直取到 100。对于变量i的每个取值,我们都执行了total += i,它相当于total = total + i,这条语句实现了累加操作。所以,当循环结束,我们输出变量total 的值,它的值就是从 1 累加到 100 的结果 5050。注意,print(total)这条语句前是没有缩进的,它不受for-in循环的控制,不会重复执行。
我们再来写一个从1到100偶数求和的代码,如下所示。
"""
从1到100的偶数求和

Version: 1.0
Author: 骆昊
"""
total = 0
for i in range(1, 101):
    if i % 2 == 0:
        total += i
print(total)说明:上面的for-in循环中我们使用了分支结构来判断循环变量i是不是偶数。
我们也可以修改range函数的参数,将起始值和跨度修改为2,用更为简单的代码实现从 1 到 100 的偶数求和。
"""
从1到100的偶数求和

Version: 1.1
Author: 骆昊
"""
total = 0
for i in range(2, 101, 2):
    total += i
print(total)
当然, 更为简单的办法是使用 Python 内置的sum函数求和,这样我们连循环结构都省掉了。
"""
从1到100的偶数求和

Version: 1.2
Author: 骆昊
"""
print(sum(range(2, 101, 2)))
while循环
如果要构造循环结构但是又不能确定循环重复的次数,我们推荐使用while循环。while循环通过布尔值或能产生布尔值的表达式来控制循环,当布尔值或表达式的值为True时,循环体(while语句下方保持相同缩进的代码块)中的语句就会被重复执行,当表达式的值为False时,结束循环。
下面我们用while循环来实现从 1 到 100 的整数求和,代码如下所示。
"""
从1到100的整数求和

Version: 1.1
Author: 骆昊
"""
total = 0
i = 1
while i <= 100:
    total += i
    i += 1
print(total)相较于for-in循环,上面的代码我们在循环开始前增加了一个变量i,我们使用这个变量来控制循环,所以while后面给出了i <= 100的条件。在while的循环体中,我们除了做累加,还需要让变量i的值递增,所以我们添加了i += 1这条语句,这样i的值就会依次取到1、2、3、……,直到 101。当i变成 101 时,while循环的条件不再成立,代码会离开while循环,此时我们输出变量total的值,它就是从 1 到 100 求和的结果 5050。
如果要实现从 1 到 100 的偶数求和,我们可以对上面的代码稍作修改。
"""
从1到100的偶数求和

Version: 1.3
Author: 骆昊
"""
total = 0
i = 2
while i <= 100:
    total += i
    i += 2
print(total)
break和continue
如果把while循环的条件设置为True,即让条件恒成立会怎么样呢?我们看看下面的代码,还是使用while构造循环结构,计算 1 到 100 的偶数和。
"""
从1到100的偶数求和

Version: 1.4
Author: 骆昊
"""
total = 0
i = 2
while True:
    total += i
    i += 2
    if i > 100:
        break
print(total) 上面的代码中使用while True构造了一个条件恒成立的循环,也就意味着如果不做特殊处理,循环是不会结束的,这就是我们常说的“死循环”。为了在i的值超过 100 后让循环停下来,我们使用了break关键字,它的作用是终止循环结构的执行。需要注意的是,break只能终止它所在的那个循环,这一点在使用嵌套循环结构时需要引起注意,后面我们会讲到什么是嵌套的循环结构。除了break之外,还有另一个在循环结构中可以使用的关键字continue,它可以用来放弃本次循环后续的代码直接让循环进入下一轮,代码如下所示。
"""
从1到100的偶数求和

Version: 1.5
Author: 骆昊
"""
total = 0
for i in range(1, 101):
    if i % 2 != 0:
        continue
    total += i
print(total)说明:上面的代码使用continue关键字跳过了i是奇数的情况,只有在i是偶数的前提下,才会执行到total += i。
嵌套的循环结构
和分支结构一样,循环结构也是可以嵌套的,也就是说在循环结构中还可以构造循环结构。下面的例子演示了如何通过嵌套的循环来输出一个乘法口诀表(九九表)。
"""
打印乘法口诀表

Version: 1.0
Author: 骆昊
"""
for i in range(1, 10):
    for j in range(1, i + 1):
        print(f'{i}×{j}={i * j}', end='\t')
print()上面的代码中,for-in循环的循环体中又用到了for-in循环,外面的循环用来控制产生i行的输出,而里面的循环则用来控制在一行中输出j列。显然,里面的for-in循环的输出就是乘法口诀表中的一整行。所以在里面的循环完成时,我们用了一个print()来实现换行的效果,让下面的输出重新另起一行,最后的输出如下所示。
1×1=1
2×1=2	2×2=4
3×1=3	3×2=6	3×3=9
4×1=4	4×2=8	4×3=12	4×4=16
5×1=5	5×2=10	5×3=15	5×4=20	5×5=25
6×1=6	6×2=12	6×3=18	6×4=24	6×5=30	6×6=36
7×1=7	7×2=14	7×3=21	7×4=28	7×5=35	7×6=42	7×7=49
8×1=8	8×2=16	8×3=24	8×4=32	8×5=40	8×6=48	8×7=56	8×8=64
9×1=9	9×2=18	9×3=27	9×4=36	9×5=45	9×6=54	9×7=63	9×8=72	9×9=81
循环结构的应用
例子1:判断素数
要求:输入一个大于 1 的正整数,判断它是不是素数。
提示:素数指的是只能被 1 和自身整除的大于 1 的整数。例如对于正整数 $\small{n}$,我们可以通过在 2 到 $\small{n - 1}$ 之间寻找有没有 $\small{n}$ 的因子,来判断它到底是不是一个素数。当然,循环不用从 2 开始到 $\small{n - 1}$ 结束,因为对于大于 1 的正整数,因子应该都是成对出现的,所以循环到 $\small{\sqrt{n}}$ 就可以结束了。
"""
输入一个大于1的正整数判断它是不是素数

Version: 1.0
Author: 骆昊
"""
num = int(input('请输入一个正整数: '))
end = int(num ** 0.5)
is_prime = True
for i in range(2, end + 1):
    if num % i == 0:
        is_prime = False
        break
if is_prime:
    print(f'{num}是素数')
else:
print(f'{num}不是素数')说明:上面的代码中我们用了布尔型的变量is_prime,我们先将它赋值为True,假设num是一个素数;接下来,我们在 2 到num ** 0.5的范围寻找num的因子,如果找到了num的因子,那么它一定不是素数,此时我们将is_prime赋值为False,同时使用break关键字终止循环结构;最后,我们根据is_prime的值是True还是False来给出不同的输出。
例子2:最大公约数
要求:输入两个大于 0 的正整数,求两个数的最大公约数。
提示:两个数的最大公约数是两个数的公共因子中最大的那个数。
"""
输入两个正整数求它们的最大公约数

Version: 1.0
Author: 骆昊
"""
x = int(input('x = '))
y = int(input('y = '))
for i in range(x, 0, -1):
    if x % i == 0 and y % i == 0:
        print(f'最大公约数: {i}')
break说明:上面代码中for-in循环的循环变量值是从大到小的,这样我们找到的能够同时整除x和y的因子i,就是x和y的最大公约数,此时我们用break终止循环。如果x和y互质,那么循环会执行到i变成 1,因为 1 是所有正整数的因子,此时x和y的最大公约数就是 1。
用上面代码的找最大公约数在执行效率是有问题的。假如x的值是999999999998,y的值是999999999999,很显然两个数是互质的,最大公约数为 1。但是我们使用上面的代码,循环会重复999999999998次,这通常是难以接受的。我们可以使用欧几里得算法来找最大公约数,它能帮我们更快的得到想要的结果,代码如下所示。
"""
输入两个正整数求它们的最大公约数

Version: 1.1
Author: 骆昊
"""
x = int(input('x = '))
y = int(input('y = '))
while y % x != 0:
    x, y = y % x, x
print(f'最大公约数: {x}')说明:解决问题的方法和步骤可以称之为算法,对于同一个问题,我们可以设计出不同的算法,不同的算法在存储空间的占用和执行效率上都会存在差别,而这些差别就代表了算法的优劣。大家可以对比上面的两段待会,体会一下为什么我们说欧几里得算法是更好的选择。上面的代码中x, y = y % x, x语句表示将y % x的值赋给x,将x原来的值赋给y。
例子3:猜数字游戏
要求:计算机出一个 1 到 100 之间的随机数,玩家输入自己猜的数字,计算机给出对应的提示信息“大一点”、“小一点”或“猜对了”,如果玩家猜中了数字,计算机提示用户一共猜了多少次,游戏结束,否则游戏继续。
"""
猜数字小游戏

Version: 1.0
Author: 骆昊
"""
import random

answer = random.randrange(1, 101)
counter = 0
while True:
    counter += 1
    num = int(input('请输入: '))
    if num < answer:
        print('大一点.')
    elif num > answer:
        print('小一点.')
    else:
        print('猜对了.')
        break
print(f'你一共猜了{counter}次.')说明:上面的代码使用import random导入了 Python 标准库的random模块,该模块的randrange函数帮助我们生成了 1 到 100 范围的随机数。变量counter用来记录循环执行的次数,也就是用户一共猜了几次,每循环一次counter的值都会加 1。
总结
学会了 Python 中的分支结构和循环结构,我们就可以解决很多实际的问题了。通过这节课的学习,大家应该已经知道了可以用for和while关键字来构造循环结构。如果事先知道循环结构重复的次数,我们通常使用for循环;如果循环结构的重复次数不能确定,可以用while循环。此外,我们可以在循环结构中使用break终止循环,也可以在循环结构中使用continue关键字让循环结构直接进入下一轮次。
分支和循环结构实战
分支和循环结构实战
通过前面两节课的学习,大家对 Python 中的分支结构和循环结构已经有了初步的认知。分支结构和循环结构是构造程序逻辑的基础,它们的重要性不言而喻,但是对于初学者来说这也是比较困难的部分。很多人对分支结构和循环结构的语法是能够理解的,但是遇到实际问题的时候又无法下手;看懂别人的代码很容易,但是要自己写出类似的代码却又很难。如果你也有同样的问题和困惑,千万不要沮丧,这只是因为你的编程之旅才刚刚开始,你的练习量还没有达到让你可以随心所欲写出代码的程度,只要加强编程练习,通过量的积累来产生质的变化,这个问题迟早都会解决的。
例子1:100以内的素数
说明:素数指的是只能被 1 和自身整除的正整数(不包括 1),之前我们写过判断素数的代码,这里相当于是一个升级版本。
"""
输出100以内的素数

Version: 1.0
Author: 骆昊
"""
for num in range(2, 100):
    is_prime = True
    for i in range(2, int(num ** 0.5) + 1):
        if num % i == 0:
            is_prime = False
            break
    if is_prime:
        print(num)
例子2:斐波那契数列
要求:输出斐波那契数列中的前 20 个数。
说明:斐波那契数列(Fibonacci sequence),通常也被称作黄金分割数列,是意大利数学家莱昂纳多·斐波那契(Leonardoda Fibonacci)在《计算之书》中研究理想假设条件下兔子成长率问题而引入的数列,因此这个数列也常被戏称为“兔子数列”。斐波那契数列的特点是数列的前两个数都是 1,从第三个数开始,每个数都是它前面两个数的和。按照这个规律,斐波那契数列的前 10 个数是:1, 1, 2, 3, 5, 8, 13, 21, 34, 55。斐波那契数列在现代物理、准晶体结构、化学等领域都有直接的应用。
"""
输出斐波那契数列中的前20个数

Version: 1.0
Author: 骆昊
"""

a, b = 0, 1
for _ in range(20):
    a, b = b, a + b
print(a)说明:上面循环中的a, b = b, a + b表示将变量b的值赋给a,把a + b的值赋给b。通过这个递推公式,我们可以依次获得斐波那契数列中的数。
例子3:寻找水仙花数
要求:找出 100 到 999 范围内的所有水仙花数。
提示:在数论中,水仙花数(narcissistic number)也被称为超完全数字不变数、自恋数、自幂数、阿姆斯特朗数,它是一个 $\small{N}$ 位非负整数,其各位数字的 $\small{N}$ 次方和刚好等于该数本身,例如: $\small{153 = 1^{3} + 5^{3} + 3^{3}}$ ,所以 153 是一个水仙花数; $\small{1634 = 1^{4} + 6^{4} + 3^{4} + 4^{4}}$ ,所以 1634 也是一个水仙花数。对于三位数,解题的关键是将它拆分为个位、十位、百位,再判断是否满足水仙花数的要求,这一点利用 Python 中的//和%运算符其实很容易做到。
"""
找出100到999范围内的水仙花数

Version: 1.0
Author: 骆昊
"""
for num in range(100, 1000):
    low = num % 10
    mid = num // 10 % 10
    high = num // 100
    if num == low ** 3 + mid ** 3 + high ** 3:
print(num)上面利用//和%拆分一个数的小技巧在写代码的时候还是很常用的。我们要将一个不知道有多少位的正整数进行反转,例如将 12389 变成 98321,也可以利用这两个运算来实现,代码如下所示。
"""
正整数的反转

Version: 1.0
Author: 骆昊
"""
num = int(input('num = '))
reversed_num = 0
while num > 0:
    reversed_num = reversed_num * 10 + num % 10
    num //= 10
print(reversed_num)
例子4:百钱百鸡问题
说明:百钱百鸡是我国古代数学家张丘建在《算经》一书中提出的数学问题:鸡翁一值钱五,鸡母一值钱三,鸡雏三值钱一。百钱买百鸡,问鸡翁、鸡母、鸡雏各几何?翻译成现代文是:公鸡 5 元一只,母鸡 3 元一只,小鸡 1 元三只,用 100 块钱买一百只鸡,问公鸡、母鸡、小鸡各有多少只?
"""
百钱百鸡问题

Version: 1.0
Author: 骆昊
"""
for x in range(0, 21):
    for y in range(0, 34):
        for z in range(0, 100, 3):
            if x + y + z == 100 and 5 * x + 3 * y + z // 3 == 100:
print(f'公鸡: {x}只, 母鸡: {y}只, 小鸡: {z}只')上面使用的方法叫做穷举法,也称为暴力搜索法,这种方法通过一项一项的列举备选解决方案中所有可能的候选项,并检查每个候选项是否符合问题的描述,最终得到问题的解。上面的代码中,我们使用了嵌套的循环结构,假设公鸡有x只,显然x的取值范围是 0 到 20,假设母鸡有y只,它的取值范围是 0 到 33,假设小鸡有z只,它的取值范围是 0 到 99 且取值是 3 的倍数。这样,我们设置好 100 只鸡的条件x + y + z == 100,设置好 100 块钱的条件5 * x + 3 * y + z // 3 == 100,当两个条件同时满足时,就是问题的正确答案,我们用print函数输出它。这种方法看起来比较笨拙,但对于运算能力非常强大的计算机来说,通常都是一个可行的甚至是不错的选择,只要问题的解存在就能够找到它。
事实上,上面的代码还有更好的写法,既然我们已经假设公鸡有x只,母鸡有y只,那么小鸡的数量就应该是100 - x - y,这样减少一个条件,我们就可以把上面三层嵌套的for-in循环改写为两层嵌套的for-in循环。循环次数减少了,代码的执行效率就有了显著的提升,如下所示。
"""
百钱百鸡问题

Version: 1.1
Author: 骆昊
"""
for x in range(0, 21):
    for y in range(0, 34):
        z = 100 - x - y
        if z % 3 == 0 and 5 * x + 3 * y + z // 3 == 100:
print(f'公鸡: {x}只, 母鸡: {y}只, 小鸡: {z}只')说明:上面代码中的z % 3 == 0是为了确保小鸡的数量是 3 的倍数。
例子5:CRAPS赌博游戏
说明:CRAPS又称花旗骰,是美国拉斯维加斯非常受欢迎的一种的桌上赌博游戏。该游戏使用两粒骰子,玩家通过摇两粒骰子获得点数进行游戏。简化后的规则是:玩家第一次摇骰子如果摇出了 7 点或 11 点,玩家胜;玩家第一次如果摇出 2 点、3 点或 12 点,庄家胜;玩家如果摇出其他点数则游戏继续,玩家重新摇骰子,如果玩家摇出了 7 点,庄家胜;如果玩家摇出了第一次摇的点数,玩家胜;其他点数玩家继续摇骰子,直到分出胜负。为了增加代码的趣味性,我们设定游戏开始时玩家有 1000 元的赌注,每局游戏开始之前,玩家先下注,如果玩家获胜就可以获得对应下注金额的奖励,如果庄家获胜,玩家就会输掉自己下注的金额。游戏结束的条件是玩家破产(输光所有的赌注)。
"""
Craps赌博游戏

Version: 1.0
Author: 骆昊
"""
import random

money = 1000
while money > 0:
    print(f'你的总资产为: {money}元')
    # 下注金额必须大于0且小于等于玩家的总资产
    while True:
        debt = int(input('请下注: '))
        if 0 < debt <= money:
            break
    # 用两个1到6均匀分布的随机数相加模拟摇两颗色子得到的点数
    first_point = random.randrange(1, 7) + random.randrange(1, 7)
    print(f'\n玩家摇出了{first_point}点')
    if first_point == 7 or first_point == 11:
        print('玩家胜!\n')
        money += debt
    elif first_point == 2 or first_point == 3 or first_point == 12:
        print('庄家胜!\n')
        money -= debt
    else:
        # 如果第一次摇色子没有分出胜负,玩家需要重新摇色子
        while True:
            current_point = random.randrange(1, 7) + random.randrange(1, 7)
            print(f'玩家摇出了{current_point}点')
            if current_point == 7:
                print('庄家胜!\n')
                money -= debt
                break
            elif current_point == first_point:
                print('玩家胜!\n')
                money += debt
                break
print('你破产了, 游戏结束!')
总结
分支结构和循环结构都非常重要,是构造程序逻辑的基础,一定要通过大量的练习来达到融会贯通。我们可以用上面讲的花旗骰游戏作为一个标准,如果你能够很顺利的完成这段代码,那么分支结构和循环结构的知识你就已经很好的掌握了。
常用数据结构之列表 1
常用数据结构之列表-1
在开始本节课的内容之前,我们先给大家一个编程任务,将一颗色子掷 6000 次,统计每种点数出现的次数。这个任务对大家来说应该是非常简单的,我们可以用 1 到 6 均匀分布的随机数来模拟掷色子,然后用 6 个变量分别记录每个点数出现的次数,相信通过前面的学习,大家都能比较顺利的写出下面的代码。
"""
将一颗色子掷6000次,统计每种点数出现的次数

Author: 骆昊
Version: 1.0
"""
import random

f1 = 0
f2 = 0
f3 = 0
f4 = 0
f5 = 0
f6 = 0
for _ in range(6000):
    face = random.randrange(1, 7)
    if face == 1:
        f1 += 1
    elif face == 2:
        f2 += 1
    elif face == 3:
        f3 += 1
    elif face == 4:
        f4 += 1
    elif face == 5:
        f5 += 1
    else:
        f6 += 1
print(f'1点出现了{f1}次')
print(f'2点出现了{f2}次')
print(f'3点出现了{f3}次')
print(f'4点出现了{f4}次')
print(f'5点出现了{f5}次')
print(f'6点出现了{f6}次')
上面的代码非常有多么“丑陋”相信就不用我多说了。当然,更为可怕的是,如果我们要掷两颗或者掷更多的色子,然后统计每种点数出现的次数,那就需要定义更多的变量,写更多的分支结构,大家想想都会感到恶心。讲到这里,相信大家心中已经有一个疑问了:有没有办法用一个变量来保存多个数据,有没有办法用统一的代码对多个数据进行操作?答案是肯定的,在 Python 语言中我们可以通过容器型变量来保存和操作多个数据,我们首先为大家介绍列表(list)这种新的数据类型。
创建列表
在 Python 中,列表是由一系列元素按特定顺序构成的数据序列,这就意味着如果我们定义一个列表类型的变量,可以用它来保存多个数据。在 Python 中,可以使用[]字面量语法来定义列表,列表中的多个元素用逗号进行分隔,代码如下所示。
items1 = [35, 12, 99, 68, 55, 35, 87]
items2 = ['Python', 'Java', 'Go', 'Kotlin']
items3 = [100, 12.3, 'Python', True]
print(items1)  # [35, 12, 99, 68, 55, 35, 87]
print(items2)  # ['Python', 'Java', 'Go', 'Kotlin']
print(items3) # [100, 12.3, 'Python', True]说明:列表中可以有重复元素,例如items1中的35;列表中可以有不同类型的元素,例如items3中有int类型、float类型、str类型和bool类型的元素,但是我们通常并不建议将不同类型的元素放在同一个列表中,主要是操作起来极为不便。
我们可以使用type函数来查看变量的类型,有兴趣的小伙伴可以自行查看上面的变量items1到底是什么类型。因为列表可以保存多个元素,它是一种容器型的数据类型,所以我们在给列表类型的变量起名字时,变量名通常用复数形式的单词。
除此以外,还可以通过 Python 内置的list函数将其他序列变成列表。准确的说,list并不是一个普通的函数,它是创建列表对象的构造器,后面的课程会为大家介绍对象和构造器这些概念。
items4 = list(range(1, 10))
items5 = list('hello')
print(items4)  # [1, 2, 3, 4, 5, 6, 7, 8, 9]
print(items5) # ['h', 'e', 'l', 'l', 'o']说明:range(1, 10)会产生1到9的整数序列,给到list构造器中,会创建出由1到9的整数构成的列表。字符串是字符构成的序列,上面的list('hello')用字符串hello的字符作为列表元素,创建了列表对象。
列表的运算
我们可以使用+运算符实现两个列表的拼接,拼接运算会将两个列表中的元素连接起来放到一个列表中,代码如下所示。
items5 = [35, 12, 99, 45, 66]
items6 = [45, 58, 29]
items7 = ['Python', 'Java', 'JavaScript']
print(items5 + items6)  # [35, 12, 99, 45, 66, 45, 58, 29]
print(items6 + items7)  # [45, 58, 29, 'Python', 'Java', 'JavaScript']
items5 += items6
print(items5) # [35, 12, 99, 45, 66, 45, 58, 29]我们可以使用*运算符实现列表的重复运算,*运算符会将列表元素重复指定的次数,我们在上面的代码中增加两行,如下所示。
print(items6 * 3)  # [45, 58, 29, 45, 58, 29, 45, 58, 29]
print(items7 * 2) # ['Python', 'Java', 'JavaScript', 'Python', 'Java', 'JavaScript']我们可以使用in或not in运算符判断一个元素在不在列表中,我们在上面的代码代码中再增加两行,如下所示。
print(29 in items6)  # True
print(99 in items6)  # False
print('C++' not in items7)     # True
print('Python' not in items7) # False由于列表中有多个元素,而且元素是按照特定顺序放在列表中的,所以当我们想操作列表中的某个元素时,可以使用[]运算符,通过在[]中指定元素的位置来访问该元素,这种运算称为索引运算。需要说明的是,[]的元素位置可以是0到N - 1的整数,也可以是-1到-N的整数,分别称为正向索引和反向索引,其中N代表列表元素的个数。对于正向索引,[0]可以访问列表中的第一个元素,[N - 1]可以访问最后一个元素;对于反向索引,[-1]可以访问列表中的最后一个元素,[-N]可以访问第一个元素,代码如下所示。
items8 = ['apple', 'waxberry', 'pitaya', 'peach', 'watermelon']
print(items8[0])   # apple
print(items8[2])   # pitaya
print(items8[4])   # watermelon
items8[2] = 'durian'
print(items8)      # ['apple', 'waxberry', 'durian', 'peach', 'watermelon']
print(items8[-5])  # 'apple'
print(items8[-4])  # 'waxberry'
print(items8[-1])  # watermelon
items8[-4] = 'strawberry'
print(items8) # ['apple', 'strawberry', 'durian', 'peach', 'watermelon']在使用索引运算的时候要避免出现索引越界的情况,对于上面的items8,如果我们访问items8[5]或items8[-6],就会引发IndexError错误,导致程序崩溃,对应的错误信息是:list index out of range,翻译成中文就是“数组索引超出范围”。因为对于只有五个元素的列表items8,有效的正向索引是0到4,有效的反向索引是-1到-5。
如果希望一次性访问列表中的多个元素,我们可以使用切片运算。切片运算是形如[start:end:stride]的运算符,其中start代表访问列表元素的起始位置,end代表访问列表元素的终止位置(终止位置的元素无法访问),而stride则代表了跨度,简单的说就是位置的增量,比如我们访问的第一个元素在start位置,那么第二个元素就在start + stride位置,当然start + stride要小于end。我们给上面的代码增加下面的语句,来使用切片运算符访问列表元素。
print(items8[1:3:1])     # ['strawberry', 'durian']
print(items8[0:3:1])     # ['apple', 'strawberry', 'durian']
print(items8[0:5:2])     # ['apple', 'durian', 'watermelon']
print(items8[-4:-2:1])   # ['strawberry', 'durian']
print(items8[-2:-6:-1]) # ['peach', 'durian', 'strawberry', 'apple']提醒:大家可以看看上面代码中的最后一行,想一想当跨度为负数时,切片运算是如何访问元素的。
如果start值等于0,那么在使用切片运算符时可以将其省略;如果end值等于N,N代表列表元素的个数,那么在使用切片运算符时可以将其省略;如果stride值等于1,那么在使用切片运算符时也可以将其省略。所以,下面的代码跟上面的代码作用完全相同。
print(items8[1:3])     # ['strawberry', 'durian']
print(items8[:3:1])    # ['apple', 'strawberry', 'durian']
print(items8[::2])     # ['apple', 'durian', 'watermelon']
print(items8[-4:-2])   # ['strawberry', 'durian']
print(items8[-2::-1])  # ['peach', 'durian', 'strawberry', 'apple']
事实上,我们还可以通过切片操作修改列表中的元素,例如我们给上面的代码再加上一行,大家可以看看这里的输出。
items8[1:3] = ['x', 'o']
print(items8)  # ['apple', 'x', 'o', 'peach', 'watermelon']
两个列表还可以做关系运算,我们可以比较两个列表是否相等,也可以给两个列表比大小,代码如下所示。
nums1 = [1, 2, 3, 4]
nums2 = list(range(1, 5))
nums3 = [3, 2, 1]
print(nums1 == nums2)  # True
print(nums1 != nums2)  # False
print(nums1 <= nums3)  # True
print(nums2 >= nums3) # False说明:上面的nums1和nums2对应元素完全相同,所以==运算的结果是True。nums2和nums3的比较,由于nums2的第一个元素1小于nums3的第一个元素3,所以nums2 >= nums3比较的结果是False。两个列表的关系运算在实际工作并不那么常用,如果实在不理解就跳过吧,不用纠结。
元素的遍历
如果想逐个取出列表中的元素,可以使用for-in循环的,有以下两种做法。
方法一:在循环结构中通过索引运算,遍历列表元素。
languages = ['Python', 'Java', 'C++', 'Kotlin']
for index in range(len(languages)):
    print(languages[index])
输出:
Python
Java
C++
Kotlin说明:上面的len函数可以获取列表元素的个数N,而range(N)则构成了从0到N-1的范围,刚好可以作为列表元素的索引。
方法二:直接对列表做循环,循环变量就是列表元素的代表。
languages = ['Python', 'Java', 'C++', 'Kotlin']
for language in languages:
    print(language)
输出:
Python
Java
C++
Kotlin
总结
讲到这里,我们可以用列表的知识来重构上面“掷色子统计每种点数出现次数”的代码。
"""
将一颗色子掷6000次,统计每种点数出现的次数

Author: 骆昊
Version: 1.1
"""
import random

counters = [0] * 6
# 模拟掷色子记录每种点数出现的次数
for _ in range(6000):
    face = random.randrange(1, 7)
    counters[face - 1] += 1
# 输出每种点数出现的次数
for face in range(1, 7):
print(f'{face}点出现了{counters[face - 1]}次')上面的代码中,我们用counters列表中的六个元素分别表示 1 到 6 点出现的次数,最开始的时候六个元素的值都是 0。接下来,我们用 1 到 6 均匀分布的随机数模拟掷色子,如果摇出 1 点,counters[0]的值加 1,如果摇出 2 点,counters[1]的值加 1,以此类推。大家感受一下,由于使用了列表类型加上循环结构,我们对数据的处理是批量性的,这就使得修改后的代码比之前的代码要简单优雅得多。
常用数据结构之列表 2
常用数据结构之列表-2
列表的方法
列表类型的变量拥有很多方法可以帮助我们操作一个列表,假设我们有名为foos的列表,列表有名为bar的方法,那么使用列表方法的语法是:foos.bar(),这是一种通过对象引用调用对象方法的语法。后面我们讲面向对象编程的时候,还会对这种语法进行详细的讲解,这种语法也称为给对象发消息。
添加和删除元素
列表是一种可变容器,可变容器指的是我们可以向容器中添加元素、可以从容器移除元素,也可以修改现有容器中的元素。我们可以使用列表的append方法向列表中追加元素,使用insert方法向列表中插入元素。追加指的是将元素添加到列表的末尾,而插入则是在指定的位置添加新元素,大家可以看看下面的代码。
languages = ['Python', 'Java', 'C++']
languages.append('JavaScript')
print(languages)  # ['Python', 'Java', 'C++', 'JavaScript']
languages.insert(1, 'SQL')
print(languages) # ['Python', 'SQL', 'Java', 'C++', 'JavaScript']我们可以用列表的remove方法从列表中删除指定元素,需要注意的是,如果要删除的元素并不在列表中,会引发ValueError错误导致程序崩溃,所以建议大家在删除元素时,先用之前讲过的成员运算做一个判断。我们还可以使用pop方法从列表中删除元素,pop方法默认删除列表中的最后一个元素,当然也可以给一个位置,删除指定位置的元素。在使用pop方法删除元素时,如果索引的值超出了范围,会引发IndexError异常,导致程序崩溃。除此之外,列表还有一个clear方法,可以清空列表中的元素,代码如下所示。
languages = ['Python', 'SQL', 'Java', 'C++', 'JavaScript']
if 'Java' in languages:
    languages.remove('Java')
if 'Swift' in languages:
    languages.remove('Swift')
print(languages)  # ['Python', 'SQL', C++', 'JavaScript']
languages.pop()
temp = languages.pop(1)
print(temp)       # SQL
languages.append(temp)
print(languages)  # ['Python', C++', 'SQL']
languages.clear()
print(languages) # []说明:pop方法删除元素时会得到被删除的元素,上面的代码中,我们将pop方法删除的元素赋值给了名为temp的变量。当然如果你愿意,还可以把这个元素再次加入到列表中,正如上面的代码languages.append(temp)所做的那样。
这里还有一个小问题,例如languages列表中有多个'Python',那么我们用languages.remove('Python')是删除所有的'Python',还是删除第一个'Python',大家可以先猜一猜,然后再自己动手尝试一下。
从列表中删除元素其实还有一种方式,就是使用 Python 中的del关键字后面跟要删除的元素,这种做法跟使用pop方法指定索引删除元素没有实质性的区别,但后者会返回删除的元素,前者在性能上略优,因为del对应的底层字节码指令是DELETE_SUBSCR,而pop对应的底层字节码指令是CALL_METHOD和POP_TOP,如果不理解就不用管它了。
items = ['Python', 'Java', 'C++']
del items[1]
print(items)  # ['Python', 'C++']
元素位置和频次
列表的index方法可以查找某个元素在列表中的索引位置,如果找不到指定的元素,index方法会引发ValueError错误;列表的count方法可以统计一个元素在列表中出现的次数,代码如下所示。
items = ['Python', 'Java', 'Java', 'C++', 'Kotlin', 'Python']
print(items.index('Python'))     # 0
# 从索引位置1开始查找'Python'
print(items.index('Python', 1))  # 5
print(items.count('Python'))     # 2
print(items.count('Kotlin'))     # 1
print(items.count('Swfit'))      # 0
# 从索引位置3开始查找'Java'
print(items.index('Java', 3))    # ValueError: 'Java' is not in list
元素排序和反转
列表的sort操作可以实现列表元素的排序,而reverse操作可以实现元素的反转,代码如下所示。
items = ['Python', 'Java', 'C++', 'Kotlin', 'Swift']
items.sort()
print(items)  # ['C++', 'Java', 'Kotlin', 'Python', 'Swift']
items.reverse()
print(items)  # ['Swift', 'Python', 'Kotlin', 'Java', 'C++']
列表生成式
在 Python 中,列表还可以通过一种特殊的字面量语法来创建,这种语法叫做生成式。下面,我们通过例子来说明使用列表生成式创建列表到底有什么好处。
场景一:创建一个取值范围在1到99且能被3或者5整除的数字构成的列表。
items = []
for i in range(1, 100):
    if i % 3 == 0 or i % 5 == 0:
        items.append(i)
print(items)
使用列表生成式做同样的事情,代码如下所示。
items = [i for i in range(1, 100) if i % 3 == 0 or i % 5 == 0]
print(items)场景二:有一个整数列表nums1,创建一个新的列表nums2,nums2中的元素是nums1中对应元素的平方。
nums1 = [35, 12, 97, 64, 55]
nums2 = []
for num in nums1:
    nums2.append(num ** 2)
print(nums2)
使用列表生成式做同样的事情,代码如下所示。
nums1 = [35, 12, 97, 64, 55]
nums2 = [num ** 2 for num in nums1]
print(nums2)
场景三: 有一个整数列表nums1,创建一个新的列表nums2,将nums1中大于50的元素放到nums2中。
nums1 = [35, 12, 97, 64, 55]
nums2 = []
for num in nums1:
    if num > 50:
        nums2.append(num)
print(nums2)
使用列表生成式做同样的事情,代码如下所示。
nums1 = [35, 12, 97, 64, 55]
nums2 = [num for num in nums1 if num > 50]
print(nums2)使用列表生成式创建列表不仅代码简单优雅,而且性能上也优于使用for-in循环和append方法向空列表中追加元素的方式。为什么说生成式有更好的性能呢,那是因为 Python 解释器的字节码指令中有专门针对生成式的指令(LIST_APPEND指令);而for循环是通过方法调用(LOAD_METHOD和CALL_METHOD指令)的方式为列表添加元素,方法调用本身就是一个相对比较耗时的操作。对这一点不理解也没有关系,记住“强烈建议用生成式语法来创建列表”这个结论就可以了。
嵌套列表
Python 语言没有限定列表中的元素必须是相同的数据类型,也就是说一个列表中的元素可以任意的数据类型,当然也包括列表本身。如果列表中的元素也是列表,那么我们可以称之为嵌套的列表。嵌套的列表可以用来表示表格或数学上的矩阵,例如:我们想保存5个学生3门课程的成绩,可以用如下所示的列表。
scores = [[95, 83, 92], [80, 75, 82], [92, 97, 90], [80, 78, 69], [65, 66, 89]]
print(scores[0])
print(scores[0][1])对于上面的嵌套列表,每个元素相当于就是一个学生3门课程的成绩,例如[95, 83, 92],而这个列表中的83代表了这个学生某一门课的成绩,如果想访问这个值,可以使用两次索引运算scores[0][1],其中scores[0]可以得到[95, 83, 92]这个列表,再次使用索引运算[1]就可以获得该列表中的第二个元素。
如果想通过键盘输入的方式来录入5个学生3门课程的成绩并保存在列表中,可以使用如下所示的代码。
scores = []
for _ in range(5):
    temp = []
    for _ in range(3):
        score = int(input('请输入: '))
        temp.append(score)
    scores.append(temp)
print(scores)
如果想通过产生随机数的方式来生成5个学生3门课程的成绩并保存在列表中,我们可以使用列表生成式,代码如下所示。
import random

scores = [[random.randrange(60, 101) for _ in range(3)] for _ in range(5)]
print(scores)说明:上面的代码[random.randrange(60, 101) for _ in range(3)] 可以产生由3个随机整数构成的列表,我们把这段代码又放在了另一个列表生成式中作为列表的元素,这样的元素一共生成5个,最终得到了一个嵌套列表。
列表的应用
下面我们通过一个双色球随机选号的例子为大家讲解列表的应用。双色球是由中国福利彩票发行管理中心发售的乐透型彩票,每注投注号码由6个红色球和1个蓝色球组成。红色球号码从1到33中选择,蓝色球号码从1到16中选择。每注需要选择6个红色球号码和1个蓝色球号码,如下所示。

提示:知乎上有一段对国内各种形式的彩票本质的论述相当精彩,这里分享给大家:“虚构一个不劳而获的人,去忽悠一群想不劳而获的人,最终养活一批真正不劳而获的人”。很多对概率没有概念的人,甚至认为彩票中与不中的概率都是 50%;还有很多人认为如果中奖的概率是 1%,那么买 100 次就一定可以中奖,这些都是非常荒唐的想法。所以,珍爱生命,远离赌博,尤其是你对概率一无所知的情况下!
下面,我们通过 Python 程序来生成一组随机号码。
"""
双色球随机选号程序

Author: 骆昊
Version: 1.0
"""
import random

red_balls = list(range(1, 34))
selected_balls = []
# 添加6个红色球到选中列表
for _ in range(6):
    # 生成随机整数代表选中的红色球的索引位置
    index = random.randrange(len(red_balls))
    # 将选中的球从红色球列表中移除并添加到选中列表
    selected_balls.append(red_balls.pop(index))
# 对选中的红色球排序
selected_balls.sort()
# 输出选中的红色球
for ball in selected_balls:
    print(f'\033[031m{ball:0>2d}\033[0m', end=' ')
# 随机选择1个蓝色球
blue_ball = random.randrange(1, 17)
# 输出选中的蓝色球
print(f'\033[034m{blue_ball:0>2d}\033[0m')说明:上面代码中print(f'\033[0m...\033[0m')是为了控制输出内容的颜色,红色球输出成红色,蓝色球输出成蓝色。其中省略号代表我们要输出的内容,\033[0m是一个控制码,表示关闭所有属性,也就是说之前的控制码将会失效,你也可以将其简单的理解为一个定界符,m前面的0表示控制台的显示方式为默认值,0可以省略,1表示高亮,5表示闪烁,7表示反显等。在0和m的中间,我们可以写上代表颜色的数字,比如30代表黑色,31代表红色,32代表绿色,33代表黄色,34代表蓝色等。
我们还可以利用random模块提供的sample和choice函数来简化上面的代码,前者可以实现无放回随机抽样,后者可以实现随机抽取一个元素,修改后的代码如下所示。
"""
双色球随机选号程序

Author: 骆昊
Version: 1.1
"""
import random

red_balls = [i for i in range(1, 34)]
blue_balls = [i for i in range(1, 17)]
# 从红色球列表中随机抽出6个红色球(无放回抽样)
selected_balls = random.sample(red_balls, 6)
# 对选中的红色球排序
selected_balls.sort()
# 输出选中的红色球
for ball in selected_balls:
    print(f'\033[031m{ball:0>2d}\033[0m', end=' ')
# 从蓝色球列表中随机抽出1个蓝色球
blue_ball = random.choice(blue_balls)
# 输出选中的蓝色球
print(f'\033[034m{blue_ball:0>2d}\033[0m')如果要实现随机生成N注号码,我们只需要将上面的代码放到一个N次的循环中,如下所示。
"""
双色球随机选号程序

Author: 骆昊
Version: 1.2
"""
import random

n = int(input('生成几注号码: '))
red_balls = [i for i in range(1, 34)]
blue_balls = [i for i in range(1, 17)]
for _ in range(n):
    # 从红色球列表中随机抽出6个红色球(无放回抽样)
    selected_balls = random.sample(red_balls, 6)
    # 对选中的红色球排序
    selected_balls.sort()
    # 输出选中的红色球
    for ball in selected_balls:
        print(f'\033[031m{ball:0>2d}\033[0m', end=' ')
    # 从蓝色球列表中随机抽出1个蓝色球
    blue_ball = random.choice(blue_balls)
    # 输出选中的蓝色球
    print(f'\033[034m{blue_ball:0>2d}\033[0m')
我们在 PyCharm 中运行上面的代码,输入5,运行效果如下图所示。

这里顺便给大家介绍一个名为 rich 的 Python 三方库,它可以帮助我们用最简单的方式产生最漂亮的输出,你可以在终端中使用 Python 包管理工具 pip 来安装这个三方库,对于使用 PyCharm 的用户,当然要在 PyCharm 的终端窗口使用 pip 命令将 rich 安装到项目的虚拟环境中,命令如下所示。
pip install rich
如上图所示,rich 安装成功后,我们可以用如下所示的代码来控制输出。
"""
双色球随机选号程序

Author: 骆昊
Version: 1.3
"""
import random

from rich.console import Console
from rich.table import Table

# 创建控制台
console = Console()

n = int(input('生成几注号码: '))
red_balls = [i for i in range(1, 34)]
blue_balls = [i for i in range(1, 17)]

# 创建表格并添加表头
table = Table(show_header=True)
for col_name in ('序号', '红球', '蓝球'):
    table.add_column(col_name, justify='center')

for i in range(n):
    selected_balls = random.sample(red_balls, 6)
    selected_balls.sort()
    blue_ball = random.choice(blue_balls)
    # 向表格中添加行(序号,红色球,蓝色球)
    table.add_row(
        str(i + 1),
        f'[red]{" ".join([f"{ball:0>2d}" for ball in selected_balls])}[/red]',
        f'[blue]{blue_ball:0>2d}[/blue]'
    )

# 通过控制台输出表格
console.print(table)说明:上面代码第 31 行使用了列表生成式语法将红色球号码处理成字符串并保存在一个列表中," ".join([...])是将列表中的多个字符串用空格拼接成一个完整的字符串,如果不理解可以先放放。字符串中的[red]...[/red]用来设置输出颜色为红色,第 32 行的[blue]...[/blue]用来设置输出颜色为蓝色。更多关于 rich 库的知识,可以参考官方文档。
最终的输出如下图所示,看着这样的输出,是不是心情更美好了一些。

总结
Python 中的列表底层是一个可以动态扩容的数组,列表元素在计算机内存中是连续存储的,所以可以实现随机访问(通过一个有效的索引获取对应的元素且操作时间与列表元素个数无关)。我们可以暂时不去触碰这些底层的存储细节,也不需要大家理解列表每个方法的渐近时间复杂度(执行方法耗费的时间跟列表元素个数之间的关系),大家先学会用列表解决工作中的问题,我想这一点更为重要。
常用数据结构之元组
常用数据结构之元组
前面的两节课,我们为大家讲解了 Python 中的列表,它是一种容器型的数据类型,通过列表类型的变量,我们可以保存多个数据并通过循环实现对数据的批量操作。当然,Python 中还有其他容器型的数据类型,接下来我们就为大家讲解另一种容器型的数据类型,它的名字叫元组(tuple)。
元组的定义和运算
在 Python 语言中,元组也是多个元素按照一定顺序构成的序列。元组和列表的不同之处在于,元组是不可变类型,这就意味着元组类型的变量一旦定义,其中的元素不能再添加或删除,而且元素的值也不能修改。如果试图修改元组中的元素,将引发TypeError错误,导致程序崩溃。定义元组通常使用形如(x, y, z)的字面量语法,元组类型支持的运算符跟列表是一样的,我们可以看看下面的代码。
# 定义一个三元组
t1 = (35, 12, 98)
# 定义一个四元组
t2 = ('骆昊', 45, True, '四川成都')

# 查看变量的类型
print(type(t1))  # <class 'tuple'>
print(type(t2))  # <class 'tuple'>

# 查看元组中元素的数量
print(len(t1))  # 3
print(len(t2))  # 4

# 索引运算
print(t1[0])    # 35
print(t1[2])    # 98
print(t2[-1])   # 四川成都

# 切片运算
print(t2[:2])   # ('骆昊', 45)
print(t2[::3])  # ('骆昊', '四川成都')

# 循环遍历元组中的元素
for elem in t1:
    print(elem)

# 成员运算
print(12 in t1)         # True
print(99 in t1)         # False
print('Hao' not in t2)  # True

# 拼接运算
t3 = t1 + t2
print(t3)  # (35, 12, 98, '骆昊', 45, True, '四川成都')

# 比较运算
print(t1 == t3)            # False
print(t1 >= t3)            # False
print(t1 <= (35, 11, 99)) # False一个元组中如果有两个元素,我们就称之为二元组;一个元组中如果五个元素,我们就称之为五元组。需要提醒大家注意的是,()表示空元组,但是如果元组中只有一个元素,需要加上一个逗号,否则()就不是代表元组的字面量语法,而是改变运算优先级的圆括号,所以('hello', )和(100, )才是一元组,而('hello')和(100)只是字符串和整数。我们可以通过下面的代码来加以验证。
a = ()
print(type(a))  # <class 'tuple'>
b = ('hello')
print(type(b))  # <class 'str'>
c = (100)
print(type(c))  # <class 'int'>
d = ('hello', )
print(type(d))  # <class 'tuple'>
e = (100, )
print(type(e))  # <class 'tuple'>
打包和解包操作
当我们把多个用逗号分隔的值赋给一个变量时,多个值会打包成一个元组类型;当我们把一个元组赋值给多个变量时,元组会解包成多个值然后分别赋给对应的变量,如下面的代码所示。
# 打包操作
a = 1, 10, 100
print(type(a))  # <class 'tuple'>
print(a)        # (1, 10, 100)
# 解包操作
i, j, k = a
print(i, j, k) # 1 10 100在解包时,如果解包出来的元素个数和变量个数不对应,会引发ValueError异常,错误信息为:too many values to unpack(解包的值太多)或not enough values to unpack(解包的值不足)。
a = 1, 10, 100, 1000
# i, j, k = a             # ValueError: too many values to unpack (expected 3)
# i, j, k, l, m, n = a    # ValueError: not enough values to unpack (expected 6, got 4)
有一种解决变量个数少于元素的个数方法,就是使用星号表达式。通过星号表达式,我们可以让一个变量接收多个值,代码如下所示。需要注意两点:首先,用星号表达式修饰的变量会变成一个列表,列表中有0个或多个元素;其次,在解包语法中,星号表达式只能出现一次。
a = 1, 10, 100, 1000
i, j, *k = a
print(i, j, k)        # 1 10 [100, 1000]
i, *j, k = a
print(i, j, k)        # 1 [10, 100] 1000
*i, j, k = a
print(i, j, k)        # [1, 10] 100 1000
*i, j = a
print(i, j)           # [1, 10, 100] 1000
i, *j = a
print(i, j)           # 1 [10, 100, 1000]
i, j, k, *l = a
print(i, j, k, l)     # 1 10 100 [1000]
i, j, k, l, *m = a
print(i, j, k, l, m) # 1 10 100 1000 []需要说明一点,解包语法对所有的序列都成立,这就意味着我们之前讲的列表、range函数构造的范围序列甚至字符串都可以使用解包语法。大家可以尝试运行下面的代码,看看会出现怎样的结果。
a, b, *c = range(1, 10)
print(a, b, c)
a, b, c = [1, 10, 100]
print(a, b, c)
a, *b, c = 'hello'
print(a, b, c)
交换变量的值
交换变量的值是写代码时经常用到的一个操作,但是在很多编程语言中,交换两个变量的值都需要借助一个中间变量才能做到,如果不用中间变量就需要使用比较晦涩的位运算来实现。在 Python 中,交换两个变量a和b的值只需要使用如下所示的代码。
a, b = b, a同理,如果要将三个变量a、b、c的值互换,即b的值赋给a,c的值赋给b,a的值赋给c,也可以如法炮制。
a, b, c = b, c, a需要说明的是,上面的操作并没有用到打包和解包语法,Python 的字节码指令中有ROT_TWO和ROT_THREE这样的指令可以直接实现这个操作,效率是非常高的。但是如果有多于三个变量的值要依次互换,这个时候是没有直接可用的字节码指令的,需要通过打包解包的方式来完成变量之间值的交换。
元组和列表的比较
这里还有一个非常值得探讨的问题,Python 中已经有了列表类型,为什么还需要元组这样的类型呢?这个问题对于初学者来说似乎有点困难,不过没有关系,我们先抛出观点,大家可以一边学习一边慢慢体会。
- 元组是不可变类型,不可变类型更适合多线程环境,因为它降低了并发访问变量的同步化开销。关于这一点,我们会在后面讲解并发编程的时候跟大家一起探讨。
- 元组是不可变类型,通常不可变类型在创建时间上优于对应的可变类型。我们可以使用
timeit模块的timeit函数来看看创建保存相同元素的元组和列表各自花费的时间,timeit函数的number参数表示代码执行的次数。下面的代码中,我们分别创建了保存1到9的整数的列表和元组,每个操作执行10000000次,统计运行时间。
   import timeit

   print('%.3f 秒' % timeit.timeit('[1, 2, 3, 4, 5, 6, 7, 8, 9]', number=10000000))
   print('%.3f 秒' % timeit.timeit('(1, 2, 3, 4, 5, 6, 7, 8, 9)', number=10000000))
输出:
   0.635 秒
0.078 秒说明:上面代码的执行结果因软硬件系统而异,在我目前使用的电脑上,执行10000000次创建列表的操作时间是0.635秒,而执行10000000次创建元组的操作时间是0.078秒,显然创建元组更快且二者时间上有数量级的差别。大家可以在自己的电脑上执行这段代码,把你的执行结果放到评论区,看看谁的电脑更厉害。
当然,Python 中的元组和列表类型是可以相互转换的,我们可以通过下面的代码来完成该操作。
infos = ('骆昊', 45, True, '四川成都')
# 将元组转换成列表
print(list(infos))  # ['骆昊', 45, True, '四川成都']

frts = ['apple', 'banana', 'orange']
# 将列表转换成元组
print(tuple(frts))  # ('apple', 'banana', 'orange')
总结
列表和元组都是容器型的数据类型,即一个变量可以保存多个数据,而且它们都是按一定顺序组织元素的有序容器。列表是可变数据类型,元组是不可变数据类型,所以列表可以添加元素、删除元素、清空元素、排序反转,但这些操作对元组来说是不成立的。列表和元组都可以支持拼接运算、成员运算、索引运算、切片运算等操作,后面我们要讲到的字符串类型也支持这些运算,因为字符串就是字符按一定顺序构成的序列,在这一点上三者并没有什么区别。我们推荐大家使用列表的生成式语法来创建列表,它不仅好用而且效率很高,是 Python 语言中非常有特色的语法。
常用数据结构之字符串
常用数据结构之字符串
第二次世界大战促使了现代电子计算机的诞生,世界上的第一台通用电子计算机名叫 ENIAC(电子数值积分计算机),诞生于美国的宾夕法尼亚大学,占地 167 平米,重量约 27 吨,每秒钟大约能够完成约 5000 次浮点运算,如下图所示。ENIAC 诞生之后被应用于导弹弹道的计算,而数值计算也是现代电子计算机最为重要的一项功能。

随着时间的推移,虽然数值运算仍然是计算机日常工作中最为重要的组成部分,但是今天的计算机还要处理大量的以文本形式存在的信息。如果我们希望通过 Python 程序来操作本这些文本信息,就必须要先了解字符串这种数据类型以及与它相关的运算和方法。
字符串的定义
所谓字符串,就是由零个或多个字符组成的有限序列,一般记为:
$$ s = a_1a_2 \cdots a_n \,\,\,\,\, (0 \le n \le \infty) $$
在 Python 程序中,我们把单个或多个字符用单引号或者双引号包围起来,就可以表示一个字符串。字符串中的字符可以是特殊符号、英文字母、中文字符、日文的平假名或片假名、希腊字母、Emoji 字符(如:💩、🐷、🀄️)等。
s1 = 'hello, world!'
s2 = "你好,世界!❤️"
s3 = '''hello,
wonderful
world!'''
print(s1)
print(s2)
print(s3)
转义字符
我们可以在字符串中使用\(反斜杠)来表示转义,也就是说\后面的字符不再是它原来的意义,例如:\n不是代表字符\和字符n,而是表示换行;\t也不是代表字符\和字符t,而是表示制表符。所以如果字符串本身又包含了'、"、\这些特殊的字符,必须要通过\进行转义处理。例如要输出一个带单引号或反斜杠的字符串,需要用如下所示的方法。
s1 = '\'hello, world!\''
s2 = '\\hello, world!\\'
print(s1)
print(s2)
原始字符串
Python 中有一种以r或R开头的字符串,这种字符串被称为原始字符串,意思是字符串中的每个字符都是它本来的含义,没有所谓的转义字符。例如,在字符串'hello\n'中,\n表示换行;而在r'hello\n'中,\n不再表示换行,就是字符\和字符n。大家可以运行下面的代码,看看会输出什么。
s1 = '\it \is \time \to \read \now'
s2 = r'\it \is \time \to \read \now'
print(s1)
print(s2)说明:上面的变量s1中,\t、\r和\n都是转义字符。\t是制表符(table),\n是换行符(new line),\r是回车符(carriage return)相当于让输出回到了行首。对比一下两个
字符的特殊表示
Python 中还允许在\后面还可以跟一个八进制或者十六进制数来表示字符,例如\141和\x61都代表小写字母a,前者是八进制的表示法,后者是十六进制的表示法。另外一种表示字符的方式是在\u后面跟 Unicode 字符编码,例如\u9a86\u660a代表的是中文“骆昊”。运行下面的代码,看看输出了什么。
s1 = '\141\142\143\x61\x62\x63'
s2 = '\u9a86\u660a'
print(s1)
print(s2)
字符串的运算
Python 语言为字符串类型提供了非常丰富的运算符,有很多运算符跟列表类型的运算符作用类似。例如,我们可以使用+运算符来实现字符串的拼接,可以使用*运算符来重复一个字符串的内容,可以使用in和not in来判断一个字符串是否包含另外一个字符串,我们也可以用[]和[:]运算符从字符串取出某个字符或某些字符。
拼接和重复
下面的例子演示了使用+和*运算符来实现字符串的拼接和重复操作。
s1 = 'hello' + ', ' + 'world'
print(s1)    # hello, world
s2 = '!' * 3
print(s2)    # !!!
s1 += s2
print(s1)    # hello, world!!!
s1 *= 2
print(s1) # hello, world!!!hello, world!!!用*实现字符串的重复是非常有意思的一个运算符,在很多编程语言中,要表示一个有10个a的字符串,你只能写成'aaaaaaaaaa',但是在 Python 中,你可以写成'a' * 10。你可能觉得'aaaaaaaaaa'这种写法也没有什么不方便的,但是请想一想,如果字符a要重复100次或者1000次又会如何呢?
比较运算
对于两个字符串类型的变量,可以直接使用比较运算符来判断两个字符串的相等性或比较大小。需要说明的是,因为字符串在计算机内存中也是以二进制形式存在的,那么字符串的大小比较比的是每个字符对应的编码的大小。例如A的编码是65, 而a的编码是97,所以'A' < 'a'的结果相当于就是65 < 97的结果,这里很显然是True;而'boy' < 'bad',因为第一个字符都是'b'比不出大小,所以实际比较的是第二个字符的大小,显然'o' < 'a'的结果是False,所以'boy' < 'bad'的结果是False。如果不清楚两个字符对应的编码到底是多少,可以使用ord函数来获得,之前我们有提到过这个函数。例如ord('A')的值是65,而ord('昊')的值是26122。下面的代码展示了字符串的比较运算,请大家仔细看看。
s1 = 'a whole new world'
s2 = 'hello world'
print(s1 == s2)             # False
print(s1 < s2)              # True
print(s1 == 'hello world')  # False
print(s2 == 'hello world')  # True
print(s2 != 'Hello world')  # True
s3 = '骆昊'
print(ord('骆'))            # 39558
print(ord('昊'))            # 26122
s4 = '王大锤'
print(ord('王'))            # 29579
print(ord('大'))            # 22823
print(ord('锤'))            # 38180
print(s3 >= s4)             # True
print(s3 != s4)             # True
成员运算
Python 中可以用in和not in判断一个字符串中是否包含另外一个字符或字符串,跟列表类型一样,in和not in称为成员运算符,会产生布尔值True或False,代码如下所示。
s1 = 'hello, world'
s2 = 'goodbye, world'
print('wo' in s1)      # True
print('wo' not in s2)  # False
print(s2 in s1)        # False
获取字符串长度
获取字符串长度跟获取列表元素个数一样,使用内置函数len,代码如下所示。
s = 'hello, world'
print(len(s))                 # 12
print(len('goodbye, world'))  # 14
索引和切片
字符串的索引和切片操作跟列表、元组几乎没有区别,因为字符串也是一种有序序列,可以通过正向或反向的整数索引访问其中的元素。但是有一点需要注意,因为字符串是不可变类型,所以不能通过索引运算修改字符串中的字符。
s = 'abc123456'
n = len(s)
print(s[0], s[-n])    # a a
print(s[n-1], s[-1])  # 6 6
print(s[2], s[-7])    # c c
print(s[5], s[-4])    # 3 3
print(s[2:5])         # c12
print(s[-7:-4])       # c12
print(s[2:])          # c123456
print(s[:2])          # ab
print(s[::2])         # ac246
print(s[::-1]) # 654321cba需要再次提醒大家注意的是,在进行索引运算时,如果索引越界,会引发IndexError异常,错误提示信息为:string index out of range(字符串索引超出范围)。
字符的遍历
如果希望遍历字符串中的每个字符,可以使用for-in循环,有如下所示的两种方式。
方式一:
s = 'hello'
for i in range(len(s)):
    print(s[i])
方式二:
s = 'hello'
for elem in s:
    print(elem)
字符串的方法
在 Python 中,我们可以通过字符串类型自带的方法对字符串进行操作和处理,假设我们有名为foo的字符串,字符串有名为bar的方法,那么使用字符串方法的语法是:foo.bar(),这是一种通过对象引用调用对象方法的语法,跟前面使用列表方法的语法是一样的。
大小写相关操作
下面的代码演示了和字符串大小写变换相关的方法。
s1 = 'hello, world!'
# 字符串首字母大写
print(s1.capitalize())  # Hello, world!
# 字符串每个单词首字母大写
print(s1.title())       # Hello, World!
# 字符串变大写
print(s1.upper())       # HELLO, WORLD!
s2 = 'GOODBYE'
# 字符串变小写
print(s2.lower())       # goodbye
# 检查s1和s2的值
print(s1)               # hello, world
print(s2) # GOODBYE说明:由于字符串是不可变类型,使用字符串的方法对字符串进行操作会产生新的字符串,但是原来变量的值并没有发生变化。所以上面的代码中,当我们最后检查s1和s2两个变量的值时,s1和s2的值并没有发生变化。
查找操作
如果想在一个字符串中从前向后查找有没有另外一个字符串,可以使用字符串的find或index方法。在使用find和index方法时还可以通过方法的参数来指定查找的范围,也就是查找不必从索引为0的位置开始。
s = 'hello, world!'
print(s.find('or'))      # 8
print(s.find('or', 9))   # -1
print(s.find('of'))      # -1
print(s.index('or'))     # 8
print(s.index('or', 9)) # ValueError: substring not found说明:find方法找不到指定的字符串会返回-1,index方法找不到指定的字符串会引发ValueError错误。
find和index方法还有逆向查找(从后向前查找)的版本,分别是rfind和rindex,代码如下所示。
s = 'hello world!'
print(s.find('o'))       # 4
print(s.rfind('o'))      # 7
print(s.rindex('o'))     # 7
# print(s.rindex('o', 8))  # ValueError: substring not found
性质判断
可以通过字符串的startswith、endswith来判断字符串是否以某个字符串开头和结尾;还可以用is开头的方法判断字符串的特征,这些方法都返回布尔值,代码如下所示。
s1 = 'hello, world!'
print(s1.startswith('He'))   # False
print(s1.startswith('hel'))  # True
print(s1.endswith('!'))      # True
s2 = 'abc123456'
print(s2.isdigit())  # False
print(s2.isalpha())  # False
print(s2.isalnum()) # True说明:上面的isdigit用来判断字符串是不是完全由数字构成的,isalpha用来判断字符串是不是完全由字母构成的,这里的字母指的是 Unicode 字符但不包含 Emoji 字符,isalnum用来判断字符串是不是由字母和数字构成的。
格式化
在 Python 中,字符串类型可以通过center、ljust、rjust方法做居中、左对齐和右对齐的处理。如果要在字符串的左侧补零,也可以使用zfill方法。
s = 'hello, world'
print(s.center(20, '*'))  # ****hello, world****
print(s.rjust(20))        #         hello, world
print(s.ljust(20, '~'))   # hello, world~~~~~~~~
print('33'.zfill(5))      # 00033
print('-33'.zfill(5)) # -0033我们之前讲过,在用print函数输出字符串时,可以用下面的方式对字符串进行格式化。
a = 321
b = 123
print('%d * %d = %d' % (a, b, a * b))当然,我们也可以用字符串的format方法来完成字符串的格式,代码如下所示。
a = 321
b = 123
print('{0} * {1} = {2}'.format(a, b, a * b))
从 Python 3.6 开始,格式化字符串还有更为简洁的书写方式,就是在字符串前加上f来格式化字符串,在这种以f打头的字符串中,{变量名}是一个占位符,会被变量对应的值将其替换掉,代码如下所示。
a = 321
b = 123
print(f'{a} * {b} = {a * b}')
如果需要进一步控制格式化语法中变量值的形式,可以参照下面的表格来进行字符串格式化操作。
| 变量值 | 占位符 | 格式化结果 | 说明 |
|---|---|---|---|
3.1415926 | {:.2f} | '3.14' | 保留小数点后两位 |
3.1415926 | {:+.2f} | '+3.14' | 带符号保留小数点后两位 |
-1 | {:+.2f} | '-1.00' | 带符号保留小数点后两位 |
3.1415926 | {:.0f} | '3' | 不带小数 |
123 | {:0>10d} | '0000000123' | 左边补0,补够10位 |
123 | {:x<10d} | '123xxxxxxx' | 右边补x ,补够10位 |
123 | {:>10d} | ' 123' | 左边补空格,补够10位 |
123 | {:<10d} | '123 ' | 右边补空格,补够10位 |
123456789 | {:,} | '123,456,789' | 逗号分隔格式 |
0.123 | {:.2%} | '12.30%' | 百分比格式 |
123456789 | {:.2e} | '1.23e+08' | 科学计数法格式 |
修剪操作
字符串的strip方法可以帮我们获得将原字符串修剪掉左右两端指定字符之后的字符串,默认是修剪空格字符。这个方法非常有实用价值,可以用来将用户输入时不小心键入的头尾空格等去掉,strip方法还有lstrip和rstrip两个版本,相信从名字大家已经猜出来这两个方法是做什么用的。
s1 = '   jackfrued@126.com  '
print(s1.strip())      # jackfrued@126.com
s2 = '~你好,世界~'
print(s2.lstrip('~'))  # 你好,世界~
print(s2.rstrip('~'))  # ~你好,世界
替换操作
如果希望用新的内容替换字符串中指定的内容,可以使用replace方法,代码如下所示。replace方法的第一个参数是被替换的内容,第二个参数是替换后的内容,还可以通过第三个参数指定替换的次数。
s = 'hello, good world'
print(s.replace('o', '@'))     # hell@, g@@d w@rld
print(s.replace('o', '@', 1))  # hell@, good world
拆分与合并
可以使用字符串的split方法将一个字符串拆分为多个字符串(放在一个列表中),也可以使用字符串的join方法将列表中的多个字符串连接成一个字符串,代码如下所示。
s = 'I love you'
words = s.split()
print(words)            # ['I', 'love', 'you']
print('~'.join(words)) # I~love~you需要说明的是,split方法默认使用空格进行拆分,我们也可以指定其他的字符来拆分字符串,而且还可以指定最大拆分次数来控制拆分的效果,代码如下所示。
s = 'I#love#you#so#much'
words = s.split('#')
print(words)  # ['I', 'love', 'you', 'so', 'much']
words = s.split('#', 2)
print(words)  # ['I', 'love', 'you#so#much']
编码和解码
Python 中除了字符串str类型外,还有一种表示二进制数据的字节串类型(bytes)。所谓字节串,就是由零个或多个字节组成的有限序列。通过字符串的encode方法,我们可以按照某种编码方式将字符串编码为字节串,我们也可以使用字节串的decode方法,将字节串解码为字符串,代码如下所示。
a = '骆昊'
b = a.encode('utf-8')
c = a.encode('gbk')
print(b)                  # b'\xe9\xaa\x86\xe6\x98\x8a'
print(c)                  # b'\xc2\xe6\xea\xbb'
print(b.decode('utf-8'))  # 骆昊
print(c.decode('gbk')) # 骆昊注意,如果编码和解码的方式不一致,会导致乱码问题(无法再现原始的内容)或引发UnicodeDecodeError错误,导致程序崩溃。
其他方法
对于字符串类型来说,还有一个常用的操作是对字符串进行匹配检查,即检查字符串是否满足某种特定的模式。例如,一个网站对用户注册信息中用户名和邮箱的检查,就属于模式匹配检查。实现模式匹配检查的工具叫做正则表达式,Python 语言通过标准库中的re模块提供了对正则表达式的支持,我们会在后续的课程中为大家讲解这个知识点。
总结
知道如何表示和操作字符串对程序员来说是非常重要的,因为我们经常需要处理文本信息,Python 中操作字符串可以用拼接、索引、切片等运算符,也可以使用字符串类型提供的非常丰富的方法。
常用数据结构之集合
常用数据结构之集合
在学习了列表和元组之后,我们再来学习一种容器型的数据类型,它的名字叫集合(set)。说到集合这个词大家一定不会陌生,在数学课本上就有这个概念。如果我们把一定范围的、确定的、可以区别的事物当作一个整体来看待,那么这个整体就是集合,集合中的各个事物称为集合的元素。通常,集合需要满足以下要求:
- 无序性:一个集合中,每个元素的地位都是相同的,元素之间是无序的。
- 互异性:一个集合中,任何两个元素都是不相同的,即元素在集合中只能出现一次。
- 确定性:给定一个集合和一个任意元素,该元素要么属这个集合,要么不属于这个集合,二者必居其一,不允许有模棱两可的情况出现。
Python 程序中的集合跟数学上的集合没有什么本质区别,需要强调的是上面所说的无序性和互异性。无序性说明集合中的元素并不像列中的元素那样存在某种次序,可以通过索引运算就能访问任意元素,集合并不支持索引运算。另外,集合的互异性决定了集合中不能有重复元素,这一点也是集合区别于列表的地方,我们无法将重复的元素添加到一个集合中。集合类型必然是支持in和not in成员运算的,这样就可以确定一个元素是否属于集合,也就是上面所说的集合的确定性。集合的成员运算在性能上要优于列表的成员运算,这是集合的底层存储特性决定的,此处我们暂时不做讨论,大家记住这个结论即可。
说明:集合底层使用了哈希存储(散列存储),对哈希存储不了解的读者可以先看看“Hello 算法”网站对哈希表的讲解,感谢作者的开源精神。
创建集合
在 Python 中,创建集合可以使用{}字面量语法,{}中需要至少有一个元素,因为没有元素的{}并不是空集合而是一个空字典,字典类型我们会在下一节课中为大家介绍。当然,也可以使用 Python 内置函数set来创建一个集合,准确的说set并不是一个函数,而是创建集合对象的构造器,这个知识点会在后面讲解面向对象编程的地方为大家介绍。我们可以使用set函数创建一个空集合,也可以用它将其他序列转换成集合,例如:set('hello')会得到一个包含了4个字符的集合(重复的字符l只会在集合中出现一次)。除了这两种方式,还可以使用生成式语法来创建集合,就像我们之前用生成式语法创建列表那样。
set1 = {1, 2, 3, 3, 3, 2}
print(set1)

set2 = {'banana', 'pitaya', 'apple', 'apple', 'banana', 'grape'}
print(set2)

set3 = set('hello')
print(set3)

set4 = set([1, 2, 2, 3, 3, 3, 2, 1])
print(set4)

set5 = {num for num in range(1, 20) if num % 3 == 0 or num % 7 == 0}
print(set5)需要提醒大家,集合中的元素必须是hashable类型,所谓hashable类型指的是能够计算出哈希码的数据类型,通常不可变类型都是hashable类型,如整数(int)、浮点小数(float)、布尔值(bool)、字符串(str)、元组(tuple)等。可变类型都不是hashable类型,因为可变类型无法计算出确定的哈希码,所以它们不能放到集合中。例如:我们不能将列表作为集合中的元素;同理,由于集合本身也是可变类型,所以集合也不能作为集合中的元素。我们可以创建出嵌套列表(列表的元素也是列表),但是我们不能创建出嵌套的集合,这一点在使用集合的时候一定要引起注意。
温馨提示:如果不理解上面提到的哈希码、哈希存储这些概念,可以先放放,因为它并不影响你继续学习和使用 Python 语言。当然,如果是计算机专业的小伙伴,不理解哈希存储是很难被原谅的,要赶紧去补课了。
元素的遍历
我们可以通过len函数来获得集合中有多少个元素,但是我们不能通过索引运算来遍历集合中的元素,因为集合元素并没有特定的顺序。当然,要实现对集合元素的遍历,我们仍然可以使用for-in循环,代码如下所示。
set1 = {'Python', 'C++', 'Java', 'Kotlin', 'Swift'}
for elem in set1:
print(elem)提示:大家看看上面代码的运行结果,通过单词输出的顺序体会一下集合的无序性。
集合的运算
Python 为集合类型提供了非常丰富的运算,主要包括:成员运算、交集运算、并集运算、差集运算、比较运算(相等性、子集、超集)等。
成员运算
可以通过成员运算in和not in 检查元素是否在集合中,代码如下所示。
set1 = {11, 12, 13, 14, 15}
print(10 in set1)      # False
print(15 in set1)      # True
set2 = {'Python', 'Java', 'C++', 'Swift'}
print('Ruby' in set2)  # False
print('Java' in set2)  # True
二元运算
集合的二元运算主要指集合的交集、并集、差集、对称差等运算,这些运算可以通过运算符来实现,也可以通过集合类型的方法来实现,代码如下所示。

set1 = {1, 2, 3, 4, 5, 6, 7}
set2 = {2, 4, 6, 8, 10}

# 交集
print(set1 & set2)                      # {2, 4, 6}
print(set1.intersection(set2))          # {2, 4, 6}

# 并集
print(set1 | set2)                      # {1, 2, 3, 4, 5, 6, 7, 8, 10}
print(set1.union(set2))                 # {1, 2, 3, 4, 5, 6, 7, 8, 10}

# 差集
print(set1 - set2)                      # {1, 3, 5, 7}
print(set1.difference(set2))            # {1, 3, 5, 7}

# 对称差
print(set1 ^ set2)                      # {1, 3, 5, 7, 8, 10}
print(set1.symmetric_difference(set2)) # {1, 3, 5, 7, 8, 10}通过上面的代码可以看出,对两个集合求交集,&运算符和intersection方法的作用是完全相同的,使用运算符的方式显然更直观且代码也更简短。需要说明的是,集合的二元运算还可以跟赋值运算一起构成复合赋值运算,例如:set1 |= set2相当于set1 = set1 | set2,跟|=作用相同的方法是update;set1 &= set2相当于set1 = set1 & set2,跟&=作用相同的方法是intersection_update,代码如下所示。
set1 = {1, 3, 5, 7}
set2 = {2, 4, 6}
set1 |= set2
# set1.update(set2)
print(set1)  # {1, 2, 3, 4, 5, 6, 7}
set3 = {3, 6, 9}
set1 &= set3
# set1.intersection_update(set3)
print(set1)  # {3, 6}
set2 -= set1
# set2.difference_update(set1)
print(set2)  # {2, 4}
比较运算
两个集合可以用==和!=进行相等性判断,如果两个集合中的元素完全相同,那么==比较的结果就是True,否则就是False。如果集合A的任意一个元素都是集合B的元素,那么集合A称为集合B的子集,即对于 $\small{\forall{a} \in {A}}$ ,均有 $\small{{a} \in {B}}$ ,则 $\small{{A} \subseteq {B}}$ ,A是B的子集,反过来也可以称B是A的超集。如果A是B的子集且A不等于B,那么A就是B的真子集。Python 为集合类型提供了判断子集和超集的运算符,其实就是我们非常熟悉的<、<=、>、>=这些运算符。当然,我们也可以通过集合类型的方法issubset和issuperset来判断集合之间的关系,代码如下所示。
set1 = {1, 3, 5}
set2 = {1, 2, 3, 4, 5}
set3 = {5, 4, 3, 2, 1}

print(set1 < set2)   # True
print(set1 <= set2)  # True
print(set2 < set3)   # False
print(set2 <= set3)  # True
print(set2 > set1)   # True
print(set2 == set3)  # True

print(set1.issubset(set2))    # True
print(set2.issuperset(set1)) # True说明:上面的代码中,set1 < set2判断set1是不是set2的真子集,set1 <= set2判断set1是不是set2的子集,set2 > set1判断set2是不是set1的超集。当然,我们也可以通过set1.issubset(set2)判断set1是不是set2的子集;通过set2.issuperset(set1)判断set2是不是set1的超集。
集合的方法
刚才我们说过,Python 中的集合是可变类型,我们可以通过集合的方法向集合添加元素或从集合中删除元素。
set1 = {1, 10, 100}

# 添加元素
set1.add(1000)
set1.add(10000)
print(set1)  # {1, 100, 1000, 10, 10000}

# 删除元素
set1.discard(10)
if 100 in set1:
    set1.remove(100)
print(set1)  # {1, 1000, 10000}

# 清空元素
set1.clear()
print(set1) # set()说明:删除元素的remove方法在元素不存在时会引发KeyError错误,所以上面的代码中我们先通过成员运算判断元素是否在集合中。集合类型还有一个pop方法可以从集合中随机删除一个元素,该方法在删除元素的同时会返回(获得)被删除的元素,而remove和discard方法仅仅是删除元素,不会返回(获得)被删除的元素。
集合类型还有一个名为isdisjoint的方法可以判断两个集合有没有相同的元素,如果没有相同元素,该方法返回True,否则该方法返回False,代码如下所示。
set1 = {'Java', 'Python', 'C++', 'Kotlin'}
set2 = {'Kotlin', 'Swift', 'Java', 'Dart'}
set3 = {'HTML', 'CSS', 'JavaScript'}
print(set1.isdisjoint(set2))  # False
print(set1.isdisjoint(set3))  # True
不可变集合
Python 中还有一种不可变类型的集合,名字叫frozenset。set跟frozenset的区别就如同list跟tuple的区别,frozenset由于是不可变类型,能够计算出哈希码,因此它可以作为set中的元素。除了不能添加和删除元素,frozenset在其他方面跟set是一样的,下面的代码简单的展示了frozenset的用法。
fset1 = frozenset({1, 3, 5, 7})
fset2 = frozenset(range(1, 6))
print(fset1)          # frozenset({1, 3, 5, 7})
print(fset2)          # frozenset({1, 2, 3, 4, 5})
print(fset1 & fset2)  # frozenset({1, 3, 5})
print(fset1 | fset2)  # frozenset({1, 2, 3, 4, 5, 7})
print(fset1 - fset2)  # frozenset({7})
print(fset1 < fset2)  # False
总结
Python 中的集合类型是一种无序容器,不允许有重复运算,由于底层使用了哈希存储,集合中的元素必须是hashable类型。集合与列表最大的区别在于集合中的元素没有顺序、所以不能够通过索引运算访问元素、但是集合可以执行交集、并集、差集等二元运算,也可以通过关系运算符检查两个集合是否存在超集、子集等关系。
常用数据结构之字典
常用数据结构之字典
迄今为止,我们已经为大家介绍了 Python 中的三种容器型数据类型(列表、元组、集合),但是这些数据类型仍然不足以帮助我们解决所有的问题。例如,我们需要一个变量来保存一个人的多项信息,包括:姓名、年龄、身高、体重、家庭住址、本人手机号、紧急联系人手机号,此时你会发现,我们之前学过的列表、元组和集合类型都不够好使。
person1 = ['王大锤', 55, 168, 60, '成都市武侯区科华北路62号1栋101', '13122334455', '13800998877']
person2 = ('王大锤', 55, 168, 60, '成都市武侯区科华北路62号1栋101', '13122334455', '13800998877')
person3 = {'王大锤', 55, 168, 60, '成都市武侯区科华北路62号1栋101', '13122334455', '13800998877'}
集合肯定是最不合适的,因为集合中不能有重复元素,如果一个人的年龄和体重刚好相同,那么集合中就会少一项信息;同理,如果这个人的手机号和紧急联系人手机号是相同的,那么集合中又会少一项信息。另一方面,虽然列表和元组可以把一个人的所有信息都保存下来,但是当你想要获取这个人的手机号或家庭住址时,你得先知道他的手机号是列表或元组中的第几个元素。总之,在遇到上述的场景时,列表、元组、集合都不是最合适的选择,此时我们需要字典(dictionary)类型,这种数据类型最适合把相关联的信息组装到一起,可以帮助我们解决 Python 程序中为真实事物建模的问题。
说到字典这个词,大家一定不陌生,读小学的时候,每个人手头基本上都有一本《新华字典》,如下图所示。

Python 程序中的字典跟现实生活中的字典很像,它以键值对(键和值的组合)的方式把数据组织到一起,我们可以通过键找到与之对应的值并进行操作。就像《新华字典》中,每个字(键)都有与它对应的解释(值)一样,每个字和它的解释合在一起就是字典中的一个条目,而字典中通常包含了很多个这样的条目。
创建和使用字典
Python 中创建字典可以使用{}字面量语法,这一点跟上一节课讲的集合是一样的。但是字典的{}中的元素是以键值对的形式存在的,每个元素由:分隔的两个值构成,:前面是键,:后面是值,代码如下所示。
xinhua = {
    '麓': '山脚下',
    '路': '道,往来通行的地方;方面,地区:南~货,外~货;种类:他俩是一~人',
    '蕗': '甘草的别名',
    '潞': '潞水,水名,即今山西省的浊漳河;潞江,水名,即云南省的怒江'
}
print(xinhua)
person = {
    'name': '王大锤',
    'age': 55,
    'height': 168,
    'weight': 60,
    'addr': '成都市武侯区科华北路62号1栋101',
    'tel': '13122334455',
    'emergence contact': '13800998877'
}
print(person)通过上面的代码,相信大家已经看出来了,用字典来保存一个人的信息远远优于使用列表或元组,因为我们可以用:前面的键来表示条目的含义,而:后面就是这个条目所对应的值。
当然,如果愿意,我们也可以使用内置函数dict或者是字典的生成式语法来创建字典,代码如下所示。
# dict函数(构造器)中的每一组参数就是字典中的一组键值对
person = dict(name='王大锤', age=55, height=168, weight=60, addr='成都市武侯区科华北路62号1栋101')
print(person)  # {'name': '王大锤', 'age': 55, 'height': 168, 'weight': 60, 'addr': '成都市武侯区科华北路62号1栋101'}

# 可以通过Python内置函数zip压缩两个序列并创建字典
items1 = dict(zip('ABCDE', '12345'))
print(items1)  # {'A': '1', 'B': '2', 'C': '3', 'D': '4', 'E': '5'}
items2 = dict(zip('ABCDE', range(1, 10)))
print(items2)  # {'A': 1, 'B': 2, 'C': 3, 'D': 4, 'E': 5}

# 用字典生成式语法创建字典
items3 = {x: x ** 3 for x in range(1, 6)}
print(items3) # {1: 1, 2: 8, 3: 27, 4: 64, 5: 125}想知道字典中一共有多少组键值对,仍然是使用len函数;如果想对字典进行遍历,可以用for循环,但是需要注意,for循环只是对字典的键进行了遍历,不过没关系,在学习了字典的索引运算后,我们可以通过字典的键访问它对应的值。
person = {
    'name': '王大锤',
    'age': 55,
    'height': 168,
    'weight': 60,
    'addr': '成都市武侯区科华北路62号1栋101'
}
print(len(person))  # 5
for key in person:
    print(key)
字典的运算
对于字典类型来说,成员运算和索引运算肯定是很重要的,前者可以判定指定的键在不在字典中,后者可以通过键访问对应的值或者向字典中添加新的键值对。值得注意的是,字典的索引不同于列表的索引,列表中的元素因为有属于自己有序号,所以列表的索引是一个整数;字典中因为保存的是键值对,所以字典需要用键去索引对应的值。需要特别提醒大家注意的是,字典中的键必须是不可变类型,例如整数(int)、浮点数(float)、字符串(str)、元组(tuple)等类型,这一点跟集合类型对元素的要求是一样的;很显然,之前我们讲的列表(list)和集合(set)不能作为字典中的键,字典类型本身也不能再作为字典中的键,因为字典也是可变类型,但是列表、集合、字典都可以作为字典中的值,例如:
person = {
    'name': '王大锤',
    'age': 55,
    'height': 168,
    'weight': 60,
    'addr': ['成都市武侯区科华北路62号1栋101', '北京市西城区百万庄大街1号'],
    'car': {
        'brand': 'BMW X7',
        'maxSpeed': '250',
        'length': 5170,
        'width': 2000,
        'height': 1835,
        'displacement': 3.0
    }
}
print(person)
大家可以看看下面的代码,了解一下字典的成员运算和索引运算。
person = {'name': '王大锤', 'age': 55, 'height': 168, 'weight': 60, 'addr': '成都市武侯区科华北路62号1栋101'}

# 成员运算
print('name' in person)  # True
print('tel' in person)   # False

# 索引运算
print(person['name'])
print(person['addr'])
person['age'] = 25
person['height'] = 178
person['tel'] = '13122334455'
person['signature'] = '你的男朋友是一个盖世垃圾,他会踏着五彩祥云去迎娶你的闺蜜'
print(person)

# 循环遍历
for key in person:
print(f'{key}:\t{person[key]}')需要注意,在通过索引运算获取字典中的值时,如指定的键没有在字典中,将会引发KeyError异常。
字典的方法
字典类型的方法基本上都跟字典的键值对操作相关,其中get方法可以通过键来获取对应的值。跟索引运算不同的是,get方法在字典中没有指定的键时不会产生异常,而是返回None或指定的默认值,代码如下所示。
person = {'name': '王大锤', 'age': 25, 'height': 178, 'addr': '成都市武侯区科华北路62号1栋101'}
print(person.get('name'))       # 王大锤
print(person.get('sex'))        # None
print(person.get('sex', True)) # True如果需要获取字典中所有的键,可以使用keys方法;如果需要获取字典中所有的值,可以使用values方法。字典还有一个名为items的方法,它会将键和值组装成二元组,通过该方法来遍历字典中的元素也是非常方便的。
person = {'name': '王大锤', 'age': 25, 'height': 178}
print(person.keys())    # dict_keys(['name', 'age', 'height'])
print(person.values())  # dict_values(['王大锤', 25, 178])
print(person.items())   # dict_items([('name', '王大锤'), ('age', 25), ('height', 178)])
for key, value in person.items():
print(f'{key}:\t{value}')字典的update方法实现两个字典的合并操作。例如,有两个字典x和y,当执行x.update(y)操作时,x跟y相同的键对应的值会被y中的值更新,而y中有但x中没有的键值对会直接添加到x中,代码如下所示。
person1 = {'name': '王大锤', 'age': 55, 'height': 178}
person2 = {'age': 25, 'addr': '成都市武侯区科华北路62号1栋101'}
person1.update(person2)
print(person1)  # {'name': '王大锤', 'age': 25, 'height': 178, 'addr': '成都市武侯区科华北路62号1栋101'}
如果使用 Python 3.9 及以上的版本,也可以使用|运算符来完成同样的操作,代码如下所示。
person1 = {'name': '王大锤', 'age': 55, 'height': 178}
person2 = {'age': 25, 'addr': '成都市武侯区科华北路62号1栋101'}
person1 |= person2
print(person1) # {'name': '王大锤', 'age': 25, 'height': 178, 'addr': '成都市武侯区科华北路62号1栋101'}可以通过pop或popitem方法从字典中删除元素,前者会返回(获得)键对应的值,但是如果字典中不存在指定的键,会引发KeyError错误;后者在删除元素时,会返回(获得)键和值组成的二元组。字典的clear方法会清空字典中所有的键值对,代码如下所示。
person = {'name': '王大锤', 'age': 25, 'height': 178, 'addr': '成都市武侯区科华北路62号1栋101'}
print(person.pop('age'))  # 25
print(person)             # {'name': '王大锤', 'height': 178, 'addr': '成都市武侯区科华北路62号1栋101'}
print(person.popitem())   # ('addr', '成都市武侯区科华北路62号1栋101')
print(person)             # {'name': '王大锤', 'height': 178}
person.clear()
print(person) # {}跟列表一样,从字典中删除元素也可以使用del关键字,在删除元素的时候如果指定的键索引不到对应的值,一样会引发KeyError错误,具体的做法如下所示。
person = {'name': '王大锤', 'age': 25, 'height': 178, 'addr': '成都市武侯区科华北路62号1栋101'}
del person['age']
del person['addr']
print(person)  # {'name': '王大锤', 'height': 178}
字典的应用
我们通过几个简单的例子来看看如何使用字典类型解决一些实际的问题。
例子1:输入一段话,统计每个英文字母出现的次数,按出现次数从高到低输出。
sentence = input('请输入一段话: ')
counter = {}
for ch in sentence:
    if 'A' <= ch <= 'Z' or 'a' <= ch <= 'z':
        counter[ch] = counter.get(ch, 0) + 1
sorted_keys = sorted(counter, key=counter.get, reverse=True)
for key in sorted_keys:
    print(f'{key} 出现了 {counter[key]} 次.')
输入:
Man is distinguished, not only by his reason, but by this singular passion from other animals, which is a lust of the mind, that by a perseverance of delight in the continued and indefatigable generation of knowledge, exceeds the short vehemence of any carnal pleasure.输出:
e 出现了 27 次.
n 出现了 21 次.
a 出现了 18 次.
i 出现了 18 次.
s 出现了 16 次.
t 出现了 16 次.
o 出现了 14 次.
h 出现了 13 次.
r 出现了 10 次.
d 出现了 9 次.
l 出现了 9 次.
g 出现了 6 次.
u 出现了 6 次.
f 出现了 6 次.
c 出现了 6 次.
y 出现了 5 次.
b 出现了 5 次.
m 出现了 4 次.
p 出现了 3 次.
w 出现了 2 次.
v 出现了 2 次.
M 出现了 1 次.
k 出现了 1 次.
x 出现了 1 次.例子2:在一个字典中保存了股票的代码和价格,找出股价大于100元的股票并创建一个新的字典。
说明:可以用字典的生成式语法来创建这个新字典。
stocks = {
    'AAPL': 191.88,
    'GOOG': 1186.96,
    'IBM': 149.24,
    'ORCL': 48.44,
    'ACN': 166.89,
    'FB': 208.09,
    'SYMC': 21.29
}
stocks2 = {key: value for key, value in stocks.items() if value > 100}
print(stocks2)
输出:
{'AAPL': 191.88, 'GOOG': 1186.96, 'IBM': 149.24, 'ACN': 166.89, 'FB': 208.09}总结
Python 程序中的字典跟现实生活中字典非常像,允许我们以键值对的形式保存数据,再通过键访问对应的值。字典是一种非常有利于数据检索的数据类型,但是需要再次提醒大家,字典中的键必须是不可变类型,列表、集合、字典等类型的数据都不能作为字典的键。
函数和模块
函数和模块
在讲解本节课的内容之前,我们先来研究一道数学题,请说出下面的方程有多少组正整数解。
$$ x_{1} + x_{2} + x_{3} + x_{4} = 8 $$
你可能已经想到了,这个问题其实等同于将 8 个苹果分成四组且每组至少一个苹果有多少种方案,也等价于在分隔 8 个苹果的 7 个间隙之间放入三个隔断将苹果分成四组有多少种方案,所以答案是 $\small{C_{7}^{3} = 35}$ ,其中 $\small{C_{7}^{3}}$ 代表 7 选 3 的组合数,其计算公式如下所示。
$$ C_m^n = \frac {m!} {n!(m-n)!} $$
根据之前学习的知识,我们可以用循环做累乘的方式分别计算出 $\small{m!}$ 、 $\small{n!}$ 和 $\small{(m-n)!}$ ,然后再通过除法运算得到组合数 $\small{C_{m}^{n}}$ ,代码如下所示。
"""
输入m和n,计算组合数C(m,n)的值

Version: 1.0
Author: 骆昊
"""

m = int(input('m = '))
n = int(input('n = '))
# 计算m的阶乘
fm = 1
for num in range(1, m + 1):
    fm *= num
# 计算n的阶乘
fn = 1
for num in range(1, n + 1):
    fn *= num
# 计算m-n的阶乘
fk = 1
for num in range(1, m - n + 1):
    fk *= num
# 计算C(M,N)的值
print(fm // fn // fk)
输入:
m = 7
n = 3
输出:
35不知大家是否注意到,上面的代码中我们做了三次求阶乘的操作,虽然 $\small{m}$ 、 $\small{n}$ 、 $\small{m - n}$ 的值各不相同,但是三段代码并没有实质性的区别,属于重复代码。世界级的编程大师Martin Fowler曾经说过:“代码有很多种坏味道,重复是最坏的一种!”。要写出高质量的代码,首先就要解决重复代码的问题。对于上面的代码来说,我们可以将求阶乘的功能封装到一个称为“函数”的代码块中,在需要计算阶乘的地方,我们只需“调用函数”即可实现对求阶乘功能的复用。
定义函数
数学上的函数通常形如 $\small{y = f(x)}$ 或者 $\small{z = g(x, y)}$ 这样的形式,在 $\small{y = f(x)}$ 中, $\small{f}$ 是函数的名字, $\small{x}$ 是函数的自变量, $\small{y}$ 是函数的因变量;而在 $\small{z = g(x, y)}$ 中, $\small{g}$ 是函数名, $\small{x}$ 和 $\small{y}$ 是函数的自变量, $\small{z}$ 是函数的因变量。Python 中的函数跟这个结构是一致的,每个函数都有自己的名字、自变量和因变量。我们通常把 Python 函数的自变量称为函数的参数,而因变量称为函数的返回值。
Python 中可以使用def关键字来定义函数,和变量一样每个函数也应该有一个漂亮的名字,命名规则跟变量的命名规则是一样的(大家赶紧想想我们之前讲过的变量的命名规则)。在函数名后面的圆括号中可以设置函数的参数,也就是我们刚才说的函数的自变量,而函数执行完成后,我们会通过return关键字来返回函数的执行结果,这就是我们刚才说的函数的因变量。如果函数中没有return语句,那么函数会返回代表空值的None。另外,函数也可以没有自变量(参数),但是函数名后面的圆括号是必须有的。一个函数要做的事情(要执行的代码),是通过代码缩进的方式放到函数定义行之后,跟之前分支和循环结构的代码块类似,如下图所示。

下面,我们将之前代码中求阶乘的操作放到一个函数中,通过这种方式来重构上面的代码。所谓重构,是在不影响代码执行结果的前提下对代码的结构进行调整,重构之后的代码如下所示。
"""
输入m和n,计算组合数C(m,n)的值

Version: 1.1
Author: 骆昊
"""


# 通过关键字def定义求阶乘的函数
# 自变量(参数)num是一个非负整数
# 因变量(返回值)是num的阶乘
def fac(num):
    result = 1
    for n in range(2, num + 1):
        result *= n
    return result


m = int(input('m = '))
n = int(input('n = '))
# 计算阶乘的时候不需要写重复的代码而是直接调用函数
# 调用函数的语法是在函数名后面跟上圆括号并传入参数
print(fac(m) // fac(n) // fac(m - n))大家可以感受下,上面的代码是不是比之前的版本更加简单优雅。更为重要的是,我们定义的求阶乘函数fac还可以在其他需要求阶乘的代码中重复使用。所以,使用函数可以帮助我们将功能上相对独立且会被重复使用的代码封装起来,当我们需要这些的代码,不是把重复的代码再编写一遍,而是通过调用函数实现对既有代码的复用。事实上,Python 标准库的math模块中,已经有一个名为factorial的函数实现了求阶乘的功能,我们可以直接用import math导入math模块,然后使用math.factorial来调用求阶乘的函数;我们也可以通过from math import factorial直接导入factorial函数来使用它,代码如下所示。
"""
输入m和n,计算组合数C(m,n)的值

Version: 1.2
Author: 骆昊
"""
from math import factorial

m = int(input('m = '))
n = int(input('n = '))
print(factorial(m) // factorial(n) // factorial(m - n))
将来我们使用的函数,要么是自定义的函数,要么是 Python 标准库或者三方库中提供的函数,如果已经有现成的可用的函数,我们就没有必要自己去定义,“重复发明轮子”是一件非常糟糕的事情。对于上面的代码,如果你觉得factorial这个名字太长,书写代码的时候不是特别方便,我们在导入函数的时候还可以通过as关键字为其别名。在调用函数的时候,我们可以用函数的别名,而不再使用它之前的名字,代码如下所示。
"""
输入m和n,计算组合数C(m,n)的值

Version: 1.3
Author: 骆昊
"""
from math import factorial as f

m = int(input('m = '))
n = int(input('n = '))
print(f(m) // f(n) // f(m - n))
函数的参数
位置参数和关键字参数
我们再来写一个函数,根据给出的三条边的长度判断是否可以构成三角形,如果可以构成三角形则返回True,否则返回False,代码如下所示。
def make_judgement(a, b, c):
    """判断三条边的长度能否构成三角形"""
return a + b > c and b + c > a and a + c > b上面make_judgement函数有三个参数,这种参数叫做位置参数,在调用函数时通常按照从左到右的顺序依次传入,而且传入参数的数量必须和定义函数时参数的数量相同,如下所示。
print(make_judgement(1, 2, 3)) # False
print(make_judgement(4, 5, 6)) # True如果不想按照从左到右的顺序依次给出a、b、c 三个参数的值,也可以使用关键字参数,通过“参数名=参数值”的形式为函数传入参数,如下所示。
print(make_judgement(b=2, c=3, a=1)) # False
print(make_judgement(c=6, b=4, a=5)) # True在定义函数时,我们可以在参数列表中用/设置强制位置参数(positional-only arguments),用*设置命名关键字参数。所谓强制位置参数,就是调用函数时只能按照参数位置来接收参数值的参数;而命名关键字参数只能通过“参数名=参数值”的方式来传递和接收参数,大家可以看看下面的例子。
# /前面的参数是强制位置参数
def make_judgement(a, b, c, /):
"""判断三条边的长度能否构成三角形"""
return a + b > c and b + c > a and a + c > b
# 下面的代码会产生TypeError错误,错误信息提示“强制位置参数是不允许给出参数名的”
# TypeError: make_judgement() got some positional-only arguments passed as keyword arguments
# print(make_judgement(b=2, c=3, a=1))说明:强制位置参数是 Python 3.8 引入的新特性,在使用低版本的 Python 解释器时需要注意。
# *后面的参数是命名关键字参数
def make_judgement(*, a, b, c):
"""判断三条边的长度能否构成三角形"""
return a + b > c and b + c > a and a + c > b
# 下面的代码会产生TypeError错误,错误信息提示“函数没有位置参数但却给了3个位置参数”
# TypeError: make_judgement() takes 0 positional arguments but 3 were given
# print(make_judgement(1, 2, 3))参数的默认值
Python 中允许函数的参数拥有默认值,我们可以把之前讲过的一个例子“CRAPS赌博游戏”(《第07课:分支和循环结构的应用》)中摇色子获得点数的功能封装到函数中,代码如下所示。
from random import randrange
# 定义摇色子的函数
# 函数的自变量(参数)n表示色子的个数,默认值为2
# 函数的因变量(返回值)表示摇n颗色子得到的点数
def roll_dice(n=2):
total = 0
for _ in range(n):
total += randrange(1, 7)
return total
# 如果没有指定参数,那么n使用默认值2,表示摇两颗色子
print(roll_dice())
# 传入参数3,变量n被赋值为3,表示摇三颗色子获得点数
print(roll_dice(3))我们再来看一个更为简单的例子。
def add(a=0, b=0, c=0):
"""三个数相加求和"""
return a + b + c
# 调用add函数,没有传入参数,那么a、b、c都使用默认值0
print(add()) # 0
# 调用add函数,传入一个参数,该参数赋值给变量a, 变量b和c使用默认值0
print(add(1)) # 1
# 调用add函数,传入两个参数,分别赋值给变量a和b,变量c使用默认值0
print(add(1, 2)) # 3
# 调用add函数,传入三个参数,分别赋值给a、b、c三个变量
print(add(1, 2, 3)) # 6需要注意的是,带默认值的参数必须放在不带默认值的参数之后,否则将产生SyntaxError错误,错误消息是:non-default argument follows default argument,翻译成中文的意思是“没有默认值的参数放在了带默认值的参数后面”。
可变参数
Python 语言中可以通过星号表达式语法让函数支持可变参数。所谓可变参数指的是在调用函数时,可以向函数传入0个或任意多个参数。将来我们以团队协作的方式开发商业项目时,很有可能要设计函数给其他人使用,但有的时候我们并不知道函数的调用者会向该函数传入多少个参数,这个时候可变参数就能派上用场。
下面的代码演示了如何使用可变位置参数实现对任意多个数求和的add函数,调用函数时传入的参数会保存到一个元组,通过对该元组的遍历,可以获取传入函数的参数。
# 用星号表达式来表示args可以接收0个或任意多个参数
# 调用函数时传入的n个参数会组装成一个n元组赋给args
# 如果一个参数都没有传入,那么args会是一个空元组
def add(*args):
total = 0
# 对保存可变参数的元组进行循环遍历
for val in args:
# 对参数进行了类型检查(数值型的才能求和)
if type(val) in (int, float):
total += val
return total
# 在调用add函数时可以传入0个或任意多个参数
print(add()) # 0
print(add(1)) # 1
print(add(1, 2, 3)) # 6
print(add(1, 2, 'hello', 3.45, 6)) # 12.45如果我们希望通过“参数名=参数值”的形式传入若干个参数,具体有多少个参数也是不确定的,我们还可以给函数添加可变关键字参数,把传入的关键字参数组装到一个字典中,代码如下所示。
# 参数列表中的**kwargs可以接收0个或任意多个关键字参数
# 调用函数时传入的关键字参数会组装成一个字典(参数名是字典中的键,参数值是字典中的值)
# 如果一个关键字参数都没有传入,那么kwargs会是一个空字典
def foo(*args, **kwargs):
print(args)
print(kwargs)
foo(3, 2.1, True, name='骆昊', age=43, gpa=4.95)输出:
(3, 2.1, True)
{'name': '骆昊', 'age': 43, 'gpa': 4.95}用模块管理函数
不管用什么样的编程语言来写代码,给变量、函数起名字都是一个让人头疼的问题,因为我们会遇到命名冲突这种尴尬的情况。最简单的场景就是在同一个.py文件中定义了两个同名的函数,如下所示。
def foo():
print('hello, world!')
def foo():
print('goodbye, world!')
foo() # 大家猜猜调用foo函数会输出什么当然上面的这种情况我们很容易就能避免,但是如果项目是团队协作多人开发的时候,团队中可能有多个程序员都定义了名为foo的函数,这种情况下怎么解决命名冲突呢?答案其实很简单,Python 中每个文件就代表了一个模块(module),我们在不同的模块中可以有同名的函数,在使用函数的时候,我们通过import关键字导入指定的模块再使用完全限定名(模块名.函数名)的调用方式,就可以区分到底要使用的是哪个模块中的foo函数,代码如下所示。
module1.py
def foo():
print('hello, world!')module2.py
def foo():
print('goodbye, world!')test.py
import module1
import module2
# 用“模块名.函数名”的方式(完全限定名)调用函数,
module1.foo() # hello, world!
module2.foo() # goodbye, world!在导入模块时,还可以使用as关键字对模块进行别名,这样我们可以使用更为简短的完全限定名。
test.py
import module1 as m1
import module2 as m2
m1.foo() # hello, world!
m2.foo() # goodbye, world!上面两段代码,我们导入的是定义函数的模块,我们也可以使用from...import...语法从模块中直接导入需要使用的函数,代码如下所示。
test.py
from module1 import foo
foo() # hello, world!
from module2 import foo
foo() # goodbye, world!但是,如果我们如果从两个不同的模块中导入了同名的函数,后面导入的函数会替换掉之前的导入,就像下面的代码,调用foo会输出goodbye, world!,因为我们先导入了module1的foo,后导入了module2的foo 。如果两个from...import...反过来写,那就是另外一番光景了。
test.py
from module1 import foo
from module2 import foo
foo() # goodbye, world!如果想在上面的代码中同时使用来自两个模块的foo函数还是有办法的,大家可能已经猜到了,还是用as关键字对导入的函数进行别名,代码如下所示。
test.py
from module1 import foo as f1
from module2 import foo as f2
f1() # hello, world!
f2() # goodbye, world!标准库中的模块和函数
Python 标准库中提供了大量的模块和函数来简化我们的开发工作,我们之前用过的random模块就为我们提供了生成随机数和进行随机抽样的函数;而time模块则提供了和时间操作相关的函数;我们之前用到过的math模块中还包括了计算正弦、余弦、指数、对数等一系列的数学函数。随着我们深入学习 Python 语言,我们还会用到更多的模块和函数。
Python 标准库中还有一类函数是不需要import就能够直接使用的,我们将其称之为内置函数,这些内置函数不仅有用而且还很常用,下面的表格列出了一部分的内置函数。
| 函数 | 说明 |
|---|---|
abs | 返回一个数的绝对值,例如:abs(-1.3)会返回1.3。 |
bin | 把一个整数转换成以'0b'开头的二进制字符串,例如:bin(123)会返回'0b1111011'。 |
chr | 将Unicode编码转换成对应的字符,例如:chr(8364)会返回'€'。 |
hex | 将一个整数转换成以'0x'开头的十六进制字符串,例如:hex(123)会返回'0x7b'。 |
input | 从输入中读取一行,返回读到的字符串。 |
len | 获取字符串、列表等的长度。 |
max | 返回多个参数或一个可迭代对象中的最大值,例如:max(12, 95, 37)会返回95。 |
min | 返回多个参数或一个可迭代对象中的最小值,例如:min(12, 95, 37)会返回12。 |
oct | 把一个整数转换成以'0o'开头的八进制字符串,例如:oct(123)会返回'0o173'。 |
open | 打开一个文件并返回文件对象。 |
ord | 将字符转换成对应的Unicode编码,例如:ord('€')会返回8364。 |
pow | 求幂运算,例如:pow(2, 3)会返回8;pow(2, 0.5)会返回1.4142135623730951。 |
print | 打印输出。 |
range | 构造一个范围序列,例如:range(100)会产生0到99的整数序列。 |
round | 按照指定的精度对数值进行四舍五入,例如:round(1.23456, 4)会返回1.2346。 |
sum | 对一个序列中的项从左到右进行求和运算,例如:sum(range(1, 101))会返回5050。 |
type | 返回对象的类型,例如:type(10)会返回int;而 type('hello')会返回str。 |
总结
函数是对功能相对独立且会重复使用的代码的封装。学会使用定义和使用函数,就能够写出更为优质的代码。当然,Python 语言的标准库中已经为我们提供了大量的模块和常用的函数,用好这些模块和函数就能够用更少的代码做更多的事情;如果这些模块和函数不能满足我们的要求,可能就需要自定义函数,然后再通过模块的概念来管理这些自定义函数。
函数应用实战
函数应用实战
例子1:随机验证码
设计一个生成随机验证码的函数,验证码由数字和英文大小写字母构成,长度可以通过参数设置。
import random
import string
ALL_CHARS = string.digits + string.ascii_letters
def generate_code(*, code_len=4):
"""
生成指定长度的验证码
:param code_len: 验证码的长度(默认4个字符)
:return: 由大小写英文字母和数字构成的随机验证码字符串
"""
return ''.join(random.choices(ALL_CHARS, k=code_len))说明1:string模块的digits代表0到9的数字构成的字符串'0123456789',string模块的ascii_letters代表大小写英文字母构成的字符串'abcdefghijklmnopqrstuvwxyzABCDEFGHIJKLMNOPQRSTUVWXYZ'。 说明2:random模块的sample和choices函数都可以实现随机抽样,sample实现无放回抽样,这意味着抽样取出的元素是不重复的;choices实现有放回抽样,这意味着可能会重复选中某些元素。这两个函数的第一个参数代表抽样的总体,而参数k代表样本容量,需要说明的是choices函数的参数k是一个命名关键字参数,在传参时必须指定参数名。
可以用下面的代码生成5组随机验证码来测试上面的函数。
for _ in range(5):
print(generate_code()) 输出:
59tZ
QKU5
izq8
IBBb
jIfX或者
for _ in range(5):
print(generate_code(code_len=6))输出:
FxJucw
HS4H9G
0yyXfz
x7fohf
ReO22w说明:我们设计的generate_code函数的参数是命名关键字参数,由于它有默认值,可以不给它传值,使用默认值4。如果需要给函数传入参数,必须指定参数名code_len。
例子2:判断素数
设计一个判断给定的大于1的正整数是不是质数的函数。质数是只能被1和自身整除的正整数(大于1),如果一个大于 1 的正整数 $\small{N}$ 是质数,那就意味着在 2 到 $\small{N-1}$ 之间都没有它的因子。
def is_prime(num: int) -> bool:
"""
判断一个正整数是不是质数
:param num: 大于1的正整数
:return: 如果num是质数返回True,否则返回False
"""
for i in range(2, int(num ** 0.5) + 1):
if num % i == 0:
return False
return True说明1:上面is_prime函数的参数num后面的: int用来标注参数的类型,虽然它对代码的执行结果不产生任何影响,但是很好的增强了代码的可读性。同理,参数列表后面的-> bool用来标注函数返回值的类型,它也不会对代码的执行结果产生影响,但是却让我们清楚的知道,调用函数会得到一个布尔值,要么是True,要么是False。 说明2:上面的循环并不需要从 2 循环到 $\small{N-1}$ ,因为如果循环进行到 $\small{\sqrt{N}}$ 时,还没有找到$\small{N}$的因子,那么 $\small{\sqrt{N}}$ 之后也不会出现 $\small{N}$ 的因子,大家可以自己想一想这是为什么。
例子3:最大公约数和最小公倍数
设计计算两个正整数最大公约数和最小公倍数的函数。 $\small{x}$ 和 $\small{y}$ 的最大公约数是能够同时整除 $\small{x}$ 和 $\small{y}$ 的最大整数,如果 $\small{x}$ 和 $\small{y}$ 互质,那么它们的最大公约数为 1; $\small{x}$ 和 $\small{y}$ 的最小公倍数是能够同时被 $\small{x}$ 和 $\small{y}$ 整除的最小正整数,如果 $\small{x}$ 和 $\small{y}$ 互质,那么它们的最小公倍数为 $\small{x \times y}$ 。需要提醒大家注意的是,计算最大公约数和最小公倍数是两个不同的功能,应该设计成两个函数,而不是把两个功能放到同一个函数中。
def lcm(x: int, y: int) -> int:
"""求最小公倍数"""
return x * y // gcd(x, y)
def gcd(x: int, y: int) -> int:
"""求最大公约数"""
while y % x != 0:
x, y = y % x, x
return x说明:函数之间可以相互调用,上面求最小公倍数的lcm函数调用了求最大公约数的gcd函数,通过 $\frac{x \times y}{ gcd(x, y)}$ 来计算最小公倍数。
例子4:数据统计
假设样本数据保存一个列表中,设计计算样本数据描述性统计信息的函数。描述性统计信息通常包括:算术平均值、中位数、极差(最大值和最小值的差)、方差、标准差、变异系数等,计算公式如下所示。
样本均值(sample mean):
$$ \bar{x} = \frac{\sum_{i=1}^{n}x_{i}}{n} = \frac{x_{1}+x_{2}+\cdots +x_{n}}{n} $$
样本方差(sample variance):
$$ s^2 = \frac {\sum_{i=1}^{n}(x_i - \bar{x})^2} {n-1} $$
样本标准差(sample standard deviation):
$$ s = \sqrt{\frac{\sum_{i=1}^{n}(x_i - \bar{x})^2}{n-1}} $$
变异系数(coefficient of sample variation):
$$ CV = \frac{s}{\bar{x}} $$
def ptp(data):
"""极差(全距)"""
return max(data) - min(data)
def mean(data):
"""算术平均"""
return sum(data) / len(data)
def median(data):
"""中位数"""
temp, size = sorted(data), len(data)
if size % 2 != 0:
return temp[size // 2]
else:
return mean(temp[size // 2 - 1:size // 2 + 1])
def var(data, ddof=1):
"""方差"""
x_bar = mean(data)
temp = [(num - x_bar) ** 2 for num in data]
return sum(temp) / (len(temp) - ddof)
def std(data, ddof=1):
"""标准差"""
return var(data, ddof) ** 0.5
def cv(data, ddof=1):
"""变异系数"""
return std(data, ddof) / mean(data)
def describe(data):
"""输出描述性统计信息"""
print(f'均值: {mean(data)}')
print(f'中位数: {median(data)}')
print(f'极差: {ptp(data)}')
print(f'方差: {var(data)}')
print(f'标准差: {std(data)}')
print(f'变异系数: {cv(data)}')说明1:中位数是将数据按照升序或降序排列后位于中间的数,它描述了数据的中等水平。中位数的计算分两种情况:当数据体量$n$为奇数时,中位数是位于 $\frac{n + 1}{2}$ 位置的元素;当数据体量 $\small{n}$ 为偶数时,中位数是位于 $\frac{n}{2}$ 和 $\frac{n}{2} + 1$ 两个位置元素的均值。 说明2:计算方差和标准差的函数中有一个名为ddof的参数,它代表了可以调整的自由度,默认值为 1。在计算样本方差和样本标准差时,需要进行自由度校正;如果要计算总体方差和总体标准差,可以将ddof参数赋值为 0,即不需要进行自由度校正。 说明3:describe函数将上面封装好的统计函数组装到一起,用于输出数据的描述性统计信息。事实上,Python 标准库中有一个名为statistics的模块,它已经把获取描述性统计信息的函数封装好了,有兴趣的读者可以自行了解。
例子5:双色球随机选号
我们用函数重构之前讲过的双色球随机选号的例子(《第09课:常用数据结构之列表-2》),将生成随机号码和输出一组号码的功能分别封装到两个函数中,然后通过调用函数实现机选N注号码的功能。
"""
双色球随机选号程序
Author: 骆昊
Version: 1.3
"""
import random
RED_BALLS = [i for i in range(1, 34)]
BLUE_BALLS = [i for i in range(1, 17)]
def choose():
"""
生成一组随机号码
:return: 保存随机号码的列表
"""
selected_balls = random.sample(RED_BALLS, 6)
selected_balls.sort()
selected_balls.append(random.choice(BLUE_BALLS))
return selected_balls
def display(balls):
"""
格式输出一组号码
:param balls: 保存随机号码的列表
"""
for ball in balls[:-1]:
print(f'\033[031m{ball:0>2d}\033[0m', end=' ')
print(f'\033[034m{balls[-1]:0>2d}\033[0m')
n = int(input('生成几注号码: '))
for _ in range(n):
display(choose())说明:大家看看display(choose())这行代码,这里我们先通过choose函数获得一组随机号码,然后把choose函数的返回值作为display函数的参数,通过display函数将选中的随机号码显示出来。重构之后的代码逻辑非常清晰,代码的可读性更强了。如果有人为你封装了这两个函数,你仅仅是函数的调用者,其实你根本不用关心choose函数和display函数的内部实现,你只需要知道调用choose函数可以生成一组随机号码,而调用display函数传入一个列表,就可以输出这组号码。将来我们使用各种各样的 Python 三方库时,我们也根本不关注它们的底层实现,我们需要知道的仅仅是调用哪个函数可以解决问题。
总结
在写代码尤其是开发商业项目的时候,一定要有意识的将相对独立且重复使用的功能封装成函数,这样不管是自己还是团队的其他成员都可以通过调用函数的方式来使用这些功能,减少工作中那些重复且乏味的劳动。
函数使用进阶
函数使用进阶
我们继续探索定义和使用函数的相关知识。通过前面的学习,我们知道了函数有自变量(参数)和因变量(返回值),自变量可以是任意的数据类型,因变量也可以是任意的数据类型,那么这里就有一个小问题,我们能不能用函数作为函数的参数,用函数作为函数的返回值?这里我们先说结论:Python 中的函数是“一等函数”,所谓“一等函数”指的就是函数可以赋值给变量,函数可以作为函数的参数,函数也可以作为函数的返回值。把一个函数作为其他函数的参数或返回值的用法,我们通常称之为“高阶函数”。
高阶函数
我们回到之前讲过的一个例子,设计一个函数,传入任意多个参数,对其中int类型或float类型的元素实现求和操作。我们对之前的代码稍作调整,让整个代码更加紧凑一些,如下所示。
def calc(*args, **kwargs):
items = list(args) + list(kwargs.values())
result = 0
for item in items:
if type(item) in (int, float):
result += item
return result如果我们希望上面的calc函数不仅仅可以做多个参数的求和,还可以实现更多的甚至是自定义的二元运算,我们该怎么做呢?上面的代码只能求和是因为函数中使用了+=运算符,这使得函数跟加法运算形成了耦合关系,如果能解除这种耦合关系,函数的通用性和灵活性就会更好。解除耦合的办法就是将+运算符变成函数调用,并将其设计为函数的参数,代码如下所示。
def calc(init_value, op_func, *args, **kwargs):
items = list(args) + list(kwargs.values())
result = init_value
for item in items:
if type(item) in (int, float):
result = op_func(result, item)
return result注意,上面的函数增加了两个参数,其中init_value代表运算的初始值,op_func代表二元运算函数,为了调用修改后的函数,我们先定义做加法和乘法运算的函数,代码如下所示。
def add(x, y):
return x + y
def mul(x, y):
return x * y如果要做求和的运算,我们可以按照下面的方式调用calc函数。
print(calc(0, add, 1, 2, 3, 4, 5)) # 15如果要做求乘积运算,我们可以按照下面的方式调用calc函数。
print(calc(1, mul, 1, 2, 3, 4, 5)) # 120 上面的calc函数通过将运算符变成函数的参数,实现了跟加法运算的解耦合,这是一种非常高明和实用的编程技巧,但对于最初学者来说可能会觉得难以理解,建议大家细品一下。需要注意上面的代码中,将函数作为参数传入其他函数和直接调用函数是有显著的区别的,调用函数需要在函数名后面跟上圆括号,而把函数作为参数时只需要函数名即可**。
如果我们没有提前定义好add和mul函数,也可以使用 Python 标准库中的operator模块提供的add和mul函数,它们分别代表了做加法和做乘法的二元运算,我们拿过来直接使用即可,代码如下所示。
import operator
print(calc(0, operator.add, 1, 2, 3, 4, 5)) # 15
print(calc(1, operator.mul, 1, 2, 3, 4, 5)) # 120Python 内置函数中有不少高阶函数,我们前面提到过的filter和map函数就是高阶函数,前者可以实现对序列中元素的过滤,后者可以实现对序列中元素的映射,例如我们要去掉一个整数列表中的奇数,并对所有的偶数求平方得到一个新的列表,就可以直接使用这两个函数来做到,具体的做法是如下所示。
def is_even(num):
"""判断num是不是偶数"""
return num % 2 == 0
def square(num):
"""求平方"""
return num ** 2
old_nums = [35, 12, 8, 99, 60, 52]
new_nums = list(map(square, filter(is_even, old_nums)))
print(new_nums) # [144, 64, 3600, 2704]当然,要完成上面代码的功能,也可以使用列表生成式,列表生成式的做法更为简单优雅。
old_nums = [35, 12, 8, 99, 60, 52]
new_nums = [num ** 2 for num in old_nums if num % 2 == 0]
print(new_nums) # [144, 64, 3600, 2704]我们再来讨论一个内置函数sorted,它可以实现对容器型数据类型(如:列表、字典等)元素的排序。我们之前讲过list类型的sort方法,它实现了对列表元素的排序,sorted函数从功能上来讲跟列表的sort方法没有区别,但它会返回排序后的列表对象,而不是直接修改原来的列表,这一点我们称为函数的无副作用设计,也就是说调用函数除了产生返回值以外,不会对程序的状态或外部环境产生任何其他的影响。使用sorted函数排序时,可以通过高阶函数的形式自定义排序的规则,我们通过下面的例子加以说明。
old_strings = ['in', 'apple', 'zoo', 'waxberry', 'pear']
new_strings = sorted(old_strings)
print(new_strings) # ['apple', 'in', 'pear', waxberry', 'zoo']上面的代码对大家来说并不陌生,但是如果希望根据字符串的长度而不是字母表顺序对列表元素排序,我们可以向sorted函数传入一个名为key的参数,将key参数赋值为获取字符串长度的函数len,这个函数我们在之前的课程中讲到过,代码如下所示。
old_strings = ['in', 'apple', 'zoo', 'waxberry', 'pear']
new_strings = sorted(old_strings, key=len)
print(new_strings) # ['in', 'zoo', 'pear', 'apple', 'waxberry']说明:列表类型的sort方法也有同样的key参数,有兴趣的读者可以自行尝试。
Lambda函数
在使用高阶函数的时候,如果作为参数或者返回值的函数本身非常简单,一行代码就能够完成,也不需要考虑对函数的复用,那么我们可以使用 lambda 函数。Python 中的 lambda 函数是没有的名字函数,所以很多人也把它叫做匿名函数,lambda 函数只能有一行代码,代码中的表达式产生的运算结果就是这个匿名函数的返回值。之前的代码中,我们写的is_even和square函数都只有一行代码,我们可以考虑用 lambda 函数来替换掉它们,代码如下所示。
old_nums = [35, 12, 8, 99, 60, 52]
new_nums = list(map(lambda x: x ** 2, filter(lambda x: x % 2 == 0, old_nums)))
print(new_nums) # [144, 64, 3600, 2704]通过上面的代码可以看出,定义 lambda 函数的关键字是lambda,后面跟函数的参数,如果有多个参数用逗号进行分隔;冒号后面的部分就是函数的执行体,通常是一个表达式,表达式的运算结果就是 lambda 函数的返回值,不需要写return 关键字。
前面我们说过,Python 中的函数是“一等函数”,函数是可以直接赋值给变量的。在学习了 lambda 函数之后,前面我们写过的一些函数就可以用一行代码来实现它们了,大家可以看看能否理解下面的求阶乘和判断素数的函数。
import functools
import operator
# 用一行代码实现计算阶乘的函数
fac = lambda n: functools.reduce(operator.mul, range(2, n + 1), 1)
# 用一行代码实现判断素数的函数
is_prime = lambda x: all(map(lambda f: x % f, range(2, int(x ** 0.5) + 1)))
# 调用Lambda函数
print(fac(6)) # 720
print(is_prime(37)) # True提示1:上面使用的reduce函数是 Python 标准库functools模块中的函数,它可以实现对一组数据的归约操作,类似于我们之前定义的calc函数,第一个参数是代表运算的函数,第二个参数是运算的数据,第三个参数是运算的初始值。很显然,reduce函数也是高阶函数,它和filter函数、map函数一起构成了处理数据中非常关键的三个动作:过滤、映射和归约。 提示2:上面判断素数的 lambda 函数通过range函数构造了从 2 到 $\small{\sqrt{x}}$ 的范围,检查这个范围有没有x的因子。all函数也是 Python 内置函数,如果传入的序列中所有的布尔值都是True,all函数返回True,否则all函数返回False。
偏函数
偏函数是指固定函数的某些参数,生成一个新的函数,这样就无需在每次调用函数时都传递相同的参数。在 Python 语言中,我们可以使用functools模块的partial函数来创建偏函数。例如,int函数在默认情况下可以将字符串视为十进制整数进行类型转换,如果我们修改它的base参数,就可以定义出三个新函数,分别用于将二进制、八进制、十六进制字符串转换为整数,代码如下所示。
import functools
int2 = functools.partial(int, base=2)
int8 = functools.partial(int, base=8)
int16 = functools.partial(int, base=16)
print(int('1001')) # 1001
print(int2('1001')) # 9
print(int8('1001')) # 513
print(int16('1001')) # 4097不知大家是否注意到,partial函数的第一个参数和返回值都是函数,它将传入的函数处理成一个新的函数返回。通过构造偏函数,我们可以结合实际的使用场景将原函数变成使用起来更为便捷的新函数,不知道大家有没有觉得这波操作很有意思。
总结
Python 中的函数是一等函数,可以赋值给变量,也可以作为函数的参数和返回值,这也就意味着我们可以在 Python 中使用高阶函数。高阶函数的概念对新手并不友好,但它却带来了函数设计上的灵活性。如果我们要定义的函数非常简单,只有一行代码,而且不需要函数名来复用它,我们可以使用 lambda 函数。