
【Java面试+Java后端技术学习指南】
【Java面试+Java后端技术学习指南】:一份通向理想互联网公司的面试指南,包括 Java,技术面试必备基础知识、Leetcode、计算机操作系统、计算机网络、系统设计、分布式、数据库(MySQL、Redis)、Java 项目实战等
JavaInterview 是本人在备战春招及这几年学习的知识沉淀,这里面有很多都是自己的原创文章,同时,也有很多是本在备战春招的过程中觉得对面试特别有帮助的文章,JavaInterview 不一定可以帮助你进入到 BAT 等大厂,但是,如果你认真研究,仔细思考,我相信你也可以跟我一样幸运的进入到大厂。
本人经常在 CSDN 写博客,累计原创博客 400+,拥有访问量251W+,CSDN 博客专家,CSDN博客地址:https://sihai.blog.csdn.net,春招目前拿到了大厂offer。
如果觉得有帮助,给个 star 好不好,哈哈(目前还不是很完善,后面会一一补充)。
一起冲!!!
👉 如果你不知道该学习什么的话,请看 Java 学习线路图是怎样的? (原创不易,欢迎点赞),这是 2021 最新最完善的 Java 学习路线!
👉 Java学习资源汇总(个人总结)
- Java基础到Java实战全套学习视频教程,包括多个企业级实战项目
- 面试算法资料,这是总结的算法资料,学完基本可以应付80%大厂
- 大厂面试资料,一年时间总结,覆盖Java所有技术点
- 面试思维导图,手打总结
👉 Java各种电子书:各种技术相关的电子书
👉 Java面试思维导图(手打),我靠这些导图拿到了一线互联网公司的offer,关注公众号,回复:思维导图;
划重点:获取上面的资源,请关注我的公众号 程序员的技术圈子,微信扫描下面二维码,回复:Java资料,获取思维导图,绿色通道关注福利,等你拿。
目录(ctrl + f 查找更香:不能点击的,还在写)
- [基础容器](#基础容器)
- [阻塞容器](#阻塞容器)- [MySQL(优化思路)](#mysql优化思路)- [Spring](#spring)
- [SpringBoot](#springboot)个人经验
- 应届生如何准备校招,用我这一年的校招经历告诉你
- 【大学到研究生自学Java的学习路线】这是一份最适合普通大众、非科班的路线,帮你快速找到一份满意的工作
- 两个月的面试真实经历,告诉大家如何能够进入大厂工作?
项目准备
面试知识点
公司面经
Java
基础
这几篇文章虽然是基础,但是确实深入理解基础,如果你能很好的理解这些基础,那么对于Java基础面试题也是没有什么问题的,背面试题不如理解原理,很重要。
- Java基础思维导图
- Java基础(一) 深入解析基本类型
- Java基础(二) 自增自减与贪心规则
- Java基础(三) 加强型for循环与Iterator
- Java基础(四) java运算顺序的深入解析
- Java基础(五) String性质深入解析
- Java基础(六) switch语句的深入解析
- Java基础(七) 深入解析java四种访问权限
- Java基础(八) 深入解析常量池与装拆箱机制
- Java基础(九) 可变参数列表介绍
- Java基础(十) 深入理解数组类型
- Java基础(十一) 枚举类型
- 类与接口(二)java的四种内部类详解
- 类与接口(三)java中的接口与嵌套接口
- 类与接口(四)方法重载解析
- 类与接口(五)java多态、方法重写、隐藏
容器(包括juc)
基础容器
- ArrayList源码分析及真实大厂面试题精讲
- LinkedList源码分析及真实大厂面试题精讲
- HashMap源码分析及真实大厂面试题精讲
- TreeMap源码分析及真实大厂面试题精讲
- TreeSet源码分析及真实大厂面试题精讲
- LinkedHashMap源码分析及真实大厂面试题精讲
阻塞容器
- ConcurrentHashMap源码分析及真实大厂面试题精讲
- ArrayBlockingQueue源码分析及真实大厂面试题精讲
- LinkedBlockingQueue源码分析及真实大厂面试题精讲
- PriorityBlockingQueue源码分析及真实大厂面试题精讲
并发
JVM
- 深入理解Java虚拟机系列
- 深入理解Java虚拟机系列--完全解决面试问题
- 深入理解Java虚拟机-Java内存区域透彻分析
- 深入理解Java虚拟机-JVM内存分配与回收策略原理,从此告别JVM内存分配文盲
- 深入理解Java虚拟机-常用vm参数分析
- 深入理解Java虚拟机-如何利用JDK自带的命令行工具监控上百万的高并发的虚拟机性能
- 深入理解Java虚拟机-如何利用VisualVM对高并发项目进行性能分析
- 深入理解Java虚拟机-你了解GC算法原理吗
- 几个面试官常问的垃圾回收器,下次面试就拿这篇文章怼回去!
- 面试官100%会严刑拷打的 CMS 垃圾回收器,下次面试就拿这篇文章怼回去!
- JVM 面试题 87 题详解
Java8
- Java8 Stream:2万字20个实例,玩转集合的筛选、归约、分组、聚合
- 利用Java8新特征,重构传统设计模式,你学会了吗?
- Java8 之 lambda 表达式、方法引用、函数式接口、默认方式、静态方法
- Java8之Consumer、Supplier、Predicate和Function攻略
- Java8 的 Stream 流式操作之王者归来
- Java11-17的最新特性
计算机网络
- http面试问题全解析
- 计算机网络常见面试题
- 关于tcp、udp网络模型的问题,这篇文章告诉你
- http、https还不了解,别慌!
- 面试官问我计算机网络的问题,我一个问题给他讲半个小时
计算机操作系统
Linux
- java工程师linux命令,这篇文章就够了
- linux常见面试题(基础版)
- linux高频面试题
- 常问的几个Linux面试题,通通解决它
数据结构与算法
数据结构
- 跳表这种数据结构,你真的清楚吗,面试官可能会问这些问题!
- 红黑树你了解多少,不会肯定会被面试官怼坏
- B树,B+树,你了解多少,面试官问那些问题?
- 这篇文章带你彻底理解红黑树
- 二叉树、二叉搜索树、二叉平衡树、红黑树、B树、B+树
算法
- 从大学入门到研究生拿大厂offer,必须看的数据结构与算法书籍推荐,不好不推荐!
- 2021年面试高频算法题题解
- 2021年最新剑指offer难题解析
- 关于贪心算法的leetcode题目,这篇文章可以帮你解决80%
- dfs题目这样去接题,秒杀leetcode题目
- 回溯算法不会,这篇文章一定得看
- 动态规划你了解多少,我来帮你入个们
- 链表的题目真的不难,看了这篇文章你就知道有多简单了
- 还在怕二叉树的题目吗?
= 栈和队列的题目可以这样出题型,你掌握了吗
- 数组中常用的几种leetcode解题技巧!
数据库
MySQL
- InnoDB与MyISAM等存储引擎对比
- MySQL:从B树到B+树到索引再到存储引擎
- MySQL全文索引最强教程
- MySQL的又一神器-锁,MySQL面试必备
- MySQL事务,这篇文章就够了
- mysqldump工具命令参数大全
- 看完这篇MySQL备份的文章,再也不用担心删库跑路了
- 关于MySQL索引,面试中面试官会怎么为难你,一定得注意
- MySQL中的乐观锁、悲观锁,JDK中的乐观锁、悲观锁?
MySQL(优化思路)
系统设计
秒杀系统相关
前后端分离
单点登录
常用框架
Spring
SpringBoot
分布式
dubbo
zookeeper
RocketMQ
RabbitMQ
kafka
消息中间件
redis
分布式系统
线上问题调优(虚拟机,tomcat)
- 垃圾收集器ZGC
- jvm系列文章
- 一次JVM FullGC的背后,竟隐藏着惊心动魄的线上生产事故!
- 深入理解Java虚拟机-如何利用JDK自带的命令行工具监控上百万的高并发的虚拟机性能
- 深入理解Java虚拟机-如何利用VisualVM对高并发项目进行性能分析
- JVM性能调优
- 百亿吞吐量服务的JVM性能调优实战
- 一次线上JVM调优实践,FullGC40次/天到10天一次的优化过程
- JVM调优工具
面试指南
工具
Git
Docker
其他
权限控制(设计、shiro)
Java学习资源
Java书籍推荐
实战项目推荐
小心翼翼的告诉你,上面的资源当中就有很多企业级项目,没有项目一点不用怕,因为你看到了这个。
程序人生
说明
JavaInterview介绍
目的很简单,写这些文章,以及整个github的资料,都是为了面试而准备的,只希望能够给面试提供一些帮助,都能够进大厂最好了。
关于转载
如果你需要转载本仓库的一些文章到自己的博客的话,记得注明原文地址就可以了。
如何对该开源文档进行贡献
- 里面很多都是我的原创,能力有限,欢迎指正。
- 很多知识点我可能没有涉及到,所以你可以对其他知识点进行补充。
- 现有的知识点难免存在不完善或者错误,所以你可以对已有知识点进行修改/补充。
为什么要做这个开源文档?
初始想法源于自己的个人那一段比较迷茫的学习经历。主要目的是为了通过这个开源平台来帮助一些在学习 Java 或者面试过程中遇到问题的小伙伴。
投稿
由于我个人能力有限,很多知识点我可能没有涉及到,所以你可以对其他知识点进行补充。
联系我
添加我的微信备注 github, 即可入群。
公众号
如果大家想要实时关注我更新的文章以及分享的干货的话,关注我的公众号 程序员的技术圈子。
自我介绍和项目介绍
自我介绍
面试官,您好,我叫XXX,我是XXX21届应届毕业生,在校的专业是计算机技术。
研究生加入实验室后,在研一这一年中,做了一个####项目,然后在去年的5月份到9月份,去了####实习了几个月,由于那里做的项目不是Java的,所以在简历中没有体现。
从大学开始学习计算机专业之后,对技术挺有热情的,喜欢记录自己学过的技术,分享技术,在CSDN博客平台,通过这几年的时间,陆陆续续写了400多篇博客了,同时也获得了CSDN博客专家的称号,博客访问量有150W了。
最后,我通过这几年的学习,对于计算机的基础知识掌握的还可以,对于计算机网络,Java相关的技术,数据库等方面有深入学习,我也特别想去贵公司,自己也特别适合这个岗位,谢谢您给我这个机会!
项目一介绍
这个项目项目基于SSM框架开发,采用前后端分离,主要为电厂开发一套人员管理及人事审批的OA系统,实现电厂人员管理、电源审批、栈道审批、工器具审批等功能。
在项目中除了用到了ssm技术之外,还有activiti工作流框架,数据库使用的是mysql,缓存框架使用的是redis,权限控制框架使用的是shiro。
在这个项目中我担任的角色是项目负责人,负责整个项目的管理工作,同时,我还负责了以下几块工作: 1、搭建项目环境 2、实现用户的单点登录系统SSO 3、项目的权限控制 4、开发电源管理和栈道管理模块 5、系统性能调优
项目二介绍
项目基于SSM框架开发的综合性电商网站,实现会员商城浏览下单、商家入驻商城出售商品、管理员后台管理商品、订单、搜索及会员等功能,同时,系统可以发起抢购活动功能。
在项目中用到的技术主要包括ssm框架,数据库用的是mysql,缓存用的是redis,消息队列用的是rocketMQ,微服务分布式项目用到了dubbo框架,对于处理分布式的一些问题,用到了zookeeper框架。
在这个项目中我主要责任是 1、搭建dubbo的分布式的项目(怎么分层) 2、利用redis提供缓存服务 3、利用RocketMQ消息队列做消息处理 4、对数据库性能进行调优 5、开发抢购活动功能模块(业务需求)
2019年5月–2019年9月,在中国空间技术研究院钱学森空间技术实验室实习,参加了脉冲星导航的项目开发工作。项目的背景是,现在深空探索的研究越来越热,这个项目就是研究及开发脉冲星导航的相关问题,而脉冲星导航的能够解决深空探索航天器的位置问题,这个就是项目的研究目标。 负责工作: 1、开发一个脉冲星导航仿真软件 2、实现相关算法对航天器上的部件精度进行控制 3、航天器相关的数据进行数据显示 4、近地卫星轨道5星编队仿真实现 个人收获: 通过这个项目的开发,学习到了许多以前没有接触到的航天知识,对于这方面的知识,个人有了很大的提高,同时,由于时间关系,开发的时间非常紧张,对于自己的有了很大的锻炼,不管是从抗压能力还是学习能力,都是得到了一定得锻炼的。
Tip:本来有很多我准备的资料的,但是都是外链,或者不合适的分享方式,所以大家去公众号回复【资料】好了。

现在免费送给大家,在我的公众号 好好学java 回复 资料 即可获取。
有收获?希望老铁们来个三连击,给更多的人看到这篇文章
1、老铁们,关注我的原创微信公众号「好好学java」,专注于Java、数据结构和算法、微服务、中间件等技术分享,保证你看完有所收获。

2、给俺一个 star 呗,可以让更多的人看到这篇文章,顺便激励下我继续写作,嘻嘻。
秒杀项目总结
1 介绍项目
1)项目整体设计的感受(可以画架构图) 2)你负责了什么,承担了什么角色,做了什么 3)项目描述,最好体现自己的综合素质:如何协调开发,遇到问题如何解决,用什么技术实现了什么功能
2 缓存雪崩
3 问题:秒杀地址不应该爆漏给用户
写脚本,LRU缓存控制请求数量
4 不同数据库的数据读写
分布式锁,消息队列(提高性能,降低耦合度,流量削峰)
5 分布式事物解决方案
6 数据库与redis缓存如何保持一致性
7 秒杀多个步骤如何保证线程安全性
客观锁,悲观锁
8 用的什么测试工具
Redis缓存服务
缓存商品和商品详情信息,如果不存在,则从数据库查询,并且加入到redis缓存,如果存在,直接返回。
RabbitMQ
1)异步订单 2)异步支付 3)订单超时处理(quartz)
缓存的信息:商品信息,商品详情信息,订单信息
查询订单优化
面杀系统架构设计思路
面试经验相关
- https://github.com/AobingJava/JavaFamily
- 互联网公司的面试官是如何360°无死角考察候选人的?(上篇)
- 互联网公司面试官是如何360°无死角考察候选人的?(下篇)
- 记一位朋友斩获BAT技术专家Offer的面试经历
秒杀系统相关
秒杀架构设计
项目技术点
ssm
activiti
lombok、日志log4j
分布式相关
ehcache
Redis
其他
dubbo
zookeeper
消息队列
- 为什么要用消息队列?
- * 你们的系统架构中为什么要引入消息中间件?
- 哥们,那你说说系统架构引入消息中间件有什么缺点?
- 哥们,消息中间件在你们项目里是如何落地的?
- 消息中间件集群崩溃,如何保证百万生产数据不丢失?
RocketMQ
RabbitMQ
kafka
分布式解决方案
- 如果20万用户同时访问一个热点缓存,如何优化你的缓存架构?
- 高并发场景下,如何保证生产者投递到消息中间件的消息不丢失?
- 从团队自研的百万并发中间件系统的内核设计看Java并发性能优化
- 支撑日活百万用户的高并发系统,应该如何设计其数据库架构?
- 支撑百万连接的系统应该如何设计其高并发架构?
- 如何保证消息中间件全链路数据100%不丢失(1)
- 如何保证消息中间件全链路数据100%不丢失(2)
- 消息中间件如何实现消费吞吐量的百倍优化?
- 优雅的告诉面试官消息中间件该如何实现高可用架构?
- 消息中间件如何实现每秒几十万的高并发写入?
- 请谈谈写入消息中间件的数据,如何保证不丢失?
- 如果让你设计一个消息中间件,如何将其网络通信性能优化10倍以上?
分布式锁
分布式事务
微服务
- 拜托!面试请不要再问我Spring Cloud底层原理
- 微服务注册中心如何承载大型系统的千万级访问?
- 每秒上万并发下的Spring Cloud参数优化实战
- 微服务架构如何保障双11狂欢下的99.99%高可用
分布式session
https://blog.csdn.net/qq_35620501/article/details/95047642
分库分表
读写分离
亿级流量架构设计方案
- 分布式主键算法
- 分布式系统的唯一id生成算法你了解吗?
- 用大白话给你讲小白都能看懂的分布式系统容错架构
- 亿级流量系统架构之如何支撑百亿级数据的存储与计算
- 亿级流量系统架构之如何设计高容错分布式计算系统
- 亿级流量系统架构之如何设计承载百亿流量的高性能架构
- 亿级流量系统架构之如何设计每秒十万查询的高并发架构
- 亿级流量系统架构之如何设计全链路99.99%高可用架构
- 亿级流量系统架构之如何在上万并发场景下设计可扩展架构(上)?
- 亿级流量系统架构之如何在上万并发场景下设计可扩展架构(中)?
- 亿级流量系统架构之如何在上万并发场景下设计可扩展架构(下)?
- 亿级流量系统架构之如何保证百亿流量下的数据一致性(上)
- 亿级流量系统架构之如何保证百亿流量下的数据一致性(中)?
- 亿级流量系统架构之如何保证百亿流量下的数据一致性(下)?
项目工具
git
maven
项目功能点
单点登录
前后端分离
mysql(优化)
生成数据工具:mockaroo
1、如果有子查询,改为连接语句 2、在where条件建立索引:user的id 3、如果有连接关键词,也建立索引:user的id 4、如果有分组或者排序,建立索引:order by time 5、同时也可以建立联合索引
需求1 某个部门查看审核人员的所有审批信息:先查询某个部门所有的审核人员,根据审批建议、审批时间及审批人查询审批信息(审批数据70w)
select u.* , c.* from user u inner join checklog c
on c.uid == u.id
where u.deptmentId = 1
and time > {1} and time < {2}
and desc like ' %'
①子查询:先查询部门的用户id然后再查询相关的审批信息 ②没有加索引:70w数据查询用了3w s。 ③给user的id建立索引,时间减少到了1.003s ④然后考虑到子查询,所以,改成连接操作,时间变为0.057s ⑤再给连接字段建立索引,时间变为0.001s ⑥模拟数据增加到300w时间增加到了0.016s,在部门id和用户id建立联合索引,时间降到了0.005s。 ⑦用时间进行排序,建立时间索引。
权限控制(设计、shiro)
线上问题调优(虚拟机,tomcat)
- 垃圾收集器ZGC
- jvm系列文章
- * 一次JVM FullGC的背后,竟隐藏着惊心动魄的线上生产事故!
- Java虚拟机调优文章
- 利用VisualVM对高并发项目进行性能分析
- JVM性能调优
- 百亿吞吐量服务的JVM性能调优实战
- 一次线上JVM调优实践,FullGC40次/天到10天一次的优化过程
- JVM调优工具
性能优化
架构设计
并发问题
Tip:本来有很多我准备的资料的,但是都是外链,或者不合适的分享方式,所以大家去公众号回复【资料】好了。
现在免费送给大家,在我的公众号 好好学java 回复 资料 即可获取。
有收获?希望老铁们来个三连击,给更多的人看到这篇文章
1、老铁们,关注我的原创微信公众号「好好学java」,专注于Java、数据结构和算法、微服务、中间件等技术分享,保证你看完有所收获。
2、给俺一个 star 呗,可以让更多的人看到这篇文章,顺便激励下我继续写作,嘻嘻。
各大公司面经
京东
京东一面
1、Java中的乐观锁悲观锁
https://segmentfault.com/a/1190000016611415
2、单点登录 3、集合的问题 4、反转链表 5、二分查找 6、堆排序 7、JUC 8、Java中如何实现线程安全 9、ArrayList和linkedList区别 10、数组和链表区别 11、volitale
秋招一面
1、数据库死锁及解决方案
https://blog.csdn.net/cbjcry/article/details/84920174
2、数据库分库分表后的分页查询及相关操作怎么解决
https://crossoverjie.top/2019/07/24/framework-design/sharding-db-03/ https://juejin.im/entry/6844903478171533320 https://tech.meituan.com/2016/11/18/dianping-order-db-sharding.html
秋招二面
1、UML https://www.jianshu.com/p/28200121a33d 2、超时确认,快速重传原理,快速重传重传几次,3次 https://blog.csdn.net/u010710458/article/details/79968648 https://www.cnblogs.com/postw/p/9678454.html 3、singleThreadThreadPool相对于ThreadPoolExecutor的优势 4、可重复读机制 https://www.pianshen.com/article/11361872925/
阿里
笔试两道算法题
- https://www.nowcoder.com/discuss/389676?type=post&order=time&pos=&page=1
- https://www.nowcoder.com/discuss/394432?type=post&order=time&pos=&page=1
钉钉一面
1、final、finnaly 2、重写重载 3、jvm的fullGC排查问题 4、多线程ArrayBlockingQueue、LinkedBlockingQueue的源码分析,如果用100w数据进行插入,哪个更快(Array) 5、linux:如果查找一个文件中的一个指定的字符串出现的数量、如何查找被占用的端口、如何查看cpu的load(使用率) 6、数据库的一个表有name、id、gender、age字段,设置一个联合索引id、name、gender,查询100w的数据用name做where查询,会不会全表查询 7、git:git如何合并分支、git add、git commit、git push的区别。 8、maven:如何查找重复的jar包问题 9、单点登录如何做的,如果保证安全性
缺点:linux实战的不懂
钉钉二面
1、项目有什么难点:应该不管是什么项目都是数据库优化跟JVM问题排查 2、操作系统内存交换方式 3、tcp7层模型 4、平时学习方法 5、自己博客写的好的进行介绍
缺点:重点不突出、操作系统不清楚。
腾讯
pcg一面
1、接口设计原则 2、mvc设计原则,如何设计 3、微服务rpc调用接口如何设计 4、微服务接口调用出现问题,如何设计接口,使得更好定位bug 5、springboot、spring、springcloud的区别 6、数据库如何设计 7、数据量大的时候,数据库表应该怎么设计,怎么插入、怎么查询,提高效率,单表的数据量能支持多大
单表数据量1000W
8、spring AOP 9、spring的动态代理,区别,静态代理,动态代理,cglib 10、dubbo设计架构 11、解耦合的设计模式有哪些?应用场景,却别是什么? 观察者模式等
12、JVM垃圾回收的过程 13、多线程如何实现,区别,怎么设计多线程 14、多线程与多进程的应用场景,多进程的应用场景 15、list和set的区别,集合其他相关,时间复杂度等等 16、tcp如何保证可靠性传输,滑动窗口
- https://blog.csdn.net/liuchenxia8/article/details/80428157
- https://juejin.im/post/5c9f1dd651882567b4339bce
17、linux的alias命令 18、linux的递归查询文件 19、回文字符串,最长回文字符串 20、reverse方法时间复杂度
pcg二面
1、tcp可靠性 2、项目 3、不包含重复的最长连续子串
pcg三面
1、项目 2、长连接短连接,应用场景 3、不用循环查找最大值
百度
滴滴
头条
一面
1、多线程调度原理 https://zhuanlan.zhihu.com/p/58846439 2、select、poll、epoll 3、多线程原理与操作系统 https://www.zhihu.com/question/25527028 4、redis的单线程模型:单核会有多线程切换吗 https://blog.csdn.net/qq_27185561/article/details/82900426 5、算法、算法、算法、算法。 6、线程池用到的数据结构 7、最长上升子序列的个数 8、为什么myisam快:非聚集索引,B+树,为什么用B+树和B树的区别。为什么B+树IO次数少 9、MyISAM与InnoDB 的区别 https://www.cnblogs.com/fwqblogs/p/6645274.html 10、事务隔离级别:可重复读会发生幻读吗?会
二面
1、hashmap解决冲突方法 2、hashmap扩容机制 3、jvm的jstack作用 4、最长不重复子串 5、https
拼多多
美团
一面
1、多线程相关(如何实现线程、线程池的相关参数) 2、hashmap和hashtable的区别,hashmap的getSize方法需要加锁吗 3、concurrenthashmap的put的过程 4、jvm内存模型、垃圾回收器 5、哪些可以作为GCRoot 6、new一个对象的过程
https://www.cnblogs.com/JackPn/p/9386182.html
7、fullGC的原因,如何排查 8、cpu内存使用过高如何排查 9、spring的AOP 10、spring的IOC 11、redis的删除策略 12、redis如何实现数据一致性 13、dubbo的原理 14、dubbo如何实现远程调用 15、项目介绍 16、单点登录 17、数据库如何调优 18、联合索引abc,哪些情况会出现索引失效 19、分布式项目请求操作经历的过程
二面
1、场景题:4亿用户,访问10个商品,保证等概率,且每个用户每次显示同样的3个商品,不能用数据库,不能用文件保存,不能用redis等框架
思路:用concurrentHashMap,分段锁,然后用多台机器,再限流,保证数据一致性
2、项目介绍
小米
网易
华为
快手
1、项目 2、两数之和等于target 3、http介绍 4、输入网址的过程 5、dubbo原理 6、http和dubbo协议的区别
缺点:写算法还不熟练
Tip:本来有很多我准备的资料的,但是都是外链,或者不合适的分享方式,所以大家去公众号回复【资料】好了。
现在免费送给大家,在我的公众号 好好学java 回复 资料 即可获取。
有收获?希望老铁们来个三连击,给更多的人看到这篇文章
1、老铁们,关注我的原创微信公众号「好好学java」,专注于Java、数据结构和算法、微服务、中间件等技术分享,保证你看完有所收获。
2、给俺一个 star 呗,可以让更多的人看到这篇文章,顺便激励下我继续写作,嘻嘻。
面试常见问题分类汇总
- 一 Java基础
- 一致性hash算法
- sleep和wait
- 强软弱虚引用
- Arrays.sort原理
- 创建对象的方式
- 若hashcode方法永远返回1会产生什么结果
- 解决hash冲突的三种方法
- 为什么要重写hashCode()方法和equals()方法以及如何进行重写
- 动态代理
- sleep和wait的区别
- java 地址和值传递的例子
- Java序列化
- java NIO,java 多线程、线程池,java 网络编程解决并发量
- JDBC 连接的过程 ,手写 jdbc 连接过程
- 说出三个遇到过的程序报异常的情况
- socket 是靠什么协议支持的
- java io 用到什么设计模式
- serviable 的序列化,其中 uuid 的作用
- 什么情景下会用到反射
- 浅克隆与深克隆有什么区别,如何实现深克隆
- 反射能够使用私有的方法属性吗和底层原理?
- 处理器指令优化有些什么考虑?
- object 对象的常用方法
- Stack 和 ArrayList 的区别
- statement 和 prestatement 的区别
- 手写模拟实现一个阻塞队列
- util 包下有哪几种接口
- 很常见的 Nullpointerexception ,你是怎么排查的,怎么解决的;
- 静态内部类和非静态内部类的区别是什么?
- 怎么创建静态内部类和非静态内部类?
- Xml 解析方式,原理优缺点
- 静态变量和全局变量的区别
- 二 Java集合
- [还了解除 util 其他包下的 List 吗?](#还了解除-util-其他包下的-list-吗)
- [CopyOnWriteArrayList](#copyonwritearraylist)- ConcurrentHashMap 和 LinkedHashMap 差异和适用情形
- ConcurrentHashMap分段锁是如何实现,ConcurrentHashmap jdk1.8 访问的时候是怎么加锁的,插入的时候是怎么加锁的 访问不加 锁插入的时候对头结点加锁
- ArrayDeque 的使用场景
- ArrayBlockingQueue 源码
- hashmap 和 treemap 的区别
- [hashmap](#hashmap)
- [treemap](#treemap)- [Java 8 函数式编程 回调函数](#java-8-函数式编程-回调函数)一 Java基础
一致性hash算法
https://blog.csdn.net/qq_40551994/article/details/100991581
sleep和wait
https://blog.csdn.net/qq_20009015/article/details/89980966 https://blog.csdn.net/lengyue309/article/details/79639245
强软弱虚引用
https://blog.csdn.net/junjunba2689/article/details/80601729
Arrays.sort原理
https://www.cnblogs.com/baichunyu/p/11935995.html
创建对象的方式
https://blog.csdn.net/w410589502/article/details/56489294
若hashcode方法永远返回1会产生什么结果
https://blog.csdn.net/cnq2328/article/details/50436175
解决hash冲突的三种方法
https://blog.csdn.net/qq_32595453/article/details/80660676
为什么要重写hashCode()方法和equals()方法以及如何进行重写
https://blog.csdn.net/xlgen157387/article/details/63683882
动态代理
https://segmentfault.com/a/1190000011291179
sleep和wait的区别
https://blog.csdn.net/u012050154/article/details/50903326
java 地址和值传递的例子
https://www.cnblogs.com/zhangyu317/p/11226105.html
Java序列化
https://juejin.im/post/5ce3cdc8e51d45777b1a3cdf
java NIO,java 多线程、线程池,java 网络编程解决并发量
Java Nio使用:https://blog.csdn.net/forezp/article/details/88414741 Java Nio原理:https://www.cnblogs.com/crazymakercircle/p/10225159.html 线程池:http://cmsblogs.com/?p=2448 为什么nio快:https://blog.csdn.net/yaogao000/article/details/47972143
JDBC 连接的过程 ,手写 jdbc 连接过程
https://blog.csdn.net/qq_44971038/article/details/103204217
说出三个遇到过的程序报异常的情况
https://www.cnblogs.com/winnie-man/p/10471338.html
socket 是靠什么协议支持的
TCP/IP,协议。socket用于 通信,在实际应用中有im等,因此需要可靠的网络协议,UDP则是不可靠的协议,且服务端与客户端不链接,UDP用于广播,视频流等
java io 用到什么设计模式
装饰模式和适配器模式
serviable 的序列化,其中 uuid 的作用
相当于快递的打包和拆包,里面的东西要保持一致,不能人为的去改变他,不然就交易不成功。序列化与反序列化也是一样,而版本号的存在就是要是里面内容要是不一致,不然就报错。像一个防伪码一样。
什么情景下会用到反射
注解、Spring 配置文件、动态代理、jdbc
浅克隆与深克隆有什么区别,如何实现深克隆
浅拷贝:仅仅克隆基本类型变量,而不克隆引用类型的变量 深克隆:既克隆基本类型变量,也克隆引用类型变量
1.浅克隆:只复制基本类型的数据,引用类型的数据只复制了引用的地址,引用的对象并没有复制,在新的对象中修改引用类型的数据会影响原对象中的引用。直接使用clone方法,再嵌套的还是浅克隆,因为有些引用类型不能直接克隆。 2.深克隆:是在引用类型的类中也实现了clone,是clone的嵌套,并且在clone方法中又对没有clone方法的引用类型又做差异化复制,克隆后的对象与原对象之间完全不会影响,但是内容完全相同。
反射能够使用私有的方法属性吗和底层原理?
https://blog.51cto.com/4247649/2109128
处理器指令优化有些什么考虑?
禁止重排序
object 对象的常用方法
Stack 和 ArrayList 的区别
statement 和 prestatement 的区别
1、Statement用于执行静态SQL语句,在执行时,必须指定一个事先准备好的SQL语句。 2、PrepareStatement是预编译的SQL语句对象,sql语句被预编译并保存在对象中。被封装的sql语句代表某一类操作,语句中可以包含动态参数“?”,在执行时可以为“?”动态设置参数值。 3、使用PrepareStatement对象执行sql时,sql被数据库进行解析和编译,然后被放到命令缓冲区,每当执行同一个PrepareStatement对象时,它就会被解析一次,但不会被再次编译。在缓冲区可以发现预编译的命令,并且可以重用。 4、PrepareStatement可以减少编译次数提高数据库性能。
手写模拟实现一个阻塞队列
https://www.cnblogs.com/keeya/p/9713686.html
util 包下有哪几种接口
很常见的 Nullpointerexception ,你是怎么排查的,怎么解决的;
静态内部类和非静态内部类的区别是什么?
怎么创建静态内部类和非静态内部类?
https://blog.csdn.net/qq_38366777/article/details/78088386
Xml 解析方式,原理优缺点
https://segmentfault.com/a/1190000013504078?utm_source=tag-newest
静态变量和全局变量的区别
二 Java集合
hashmap的jdk1.7和jdk1.8区别
https://juejin.im/post/5aa5d8d26fb9a028d2079264
https://blog.csdn.net/qq_36520235/article/details/82417949
concurrenthashmap的jdk1.7和jdk1.8区别
https://juejin.im/post/5df8d7346fb9a015ff64eaf9
HashMap 实现原理,扩容因子过大过小的缺点,扩容过程 采用什么方法能保证每个 bucket 中的数据更均匀 解决冲突的方式,还有没有其他方式(全域哈希)
扩容:https://www.jianshu.com/p/5730bff593ed
https://www.cnblogs.com/peizhe123/p/5790252.html
Collection 集合类中只能在 Iterator 中删除元素的原因
在Iterator的内部有个expectedModCount 变量, 该变量每次初始化Iterator的时候等于ArrayList的modCount,modCount记录了对ArrayList的结构修改次数, 在通过Iterator对ArrayList进行结构的修改的时候都会将expectedModCount 与modCount同步,但是如果在通过Iterator访问的时候同时又通过索引的方式去修改ArrayList的结构的话,由于通过索引的方式只会修改modCount不会同步修改expectedModCount 就会导致modCount和expectedModCount 不相等就会抛ConcurrentModificationException, 这也就是Iterator的fail-fast,快速失效的。所以只要采取一种方式操作ArrayList就不会出问题, 当然ArrayList不是线程安全的,此处不讨论对线程问题。
更加详细的解释 https://blog.csdn.net/yanshuanche3765/article/details/78917507
ArrayList、LinkedList、Vector
https://blog.csdn.net/zhangqiluGrubby/article/details/72870493
还了解除 util 其他包下的 List 吗?
CopyOnWriteArrayList
(1)CopyOnWriteArrayList使用ReentrantLock重入锁加锁,保证线程安全; (2)CopyOnWriteArrayList的写操作都要先拷贝一份新数组,在新数组中做修改,修改完了再用新数组替换老数组,所以空间复杂度是O(n),性能比较低下; (3)CopyOnWriteArrayList的读操作支持随机访问,时间复杂度为O(1); (4)CopyOnWriteArrayList采用读写分离的思想,读操作不加锁,写操作加锁,且写操作占用较大内存空间,所以适用于读多写少的场合; (5)CopyOnWriteArrayList只保证最终一致性,不保证实时一致性;
ConcurrentHashMap 和 LinkedHashMap 差异和适用情形
哈希表的原理:https://blog.csdn.net/yyyljw/article/details/80903391
可以以下方面进行回答 (1)使用的数据结构? (2)添加元素、删除元素的基本逻辑? (3)是否是fail-fast的? (4)是否需要扩容?扩容规则? (5)是否有序?是按插入顺序还是自然顺序还是访问顺序? (6)是否线程安全? (7)使用的锁? (8)优点?缺点? (9)适用的场景? (10)时间复杂度? (11)空间复杂度?
ConcurrentHashMap分段锁是如何实现,ConcurrentHashmap jdk1.8 访问的时候是怎么加锁的,插入的时候是怎么加锁的 访问不加 锁插入的时候对头结点加锁
jdk1.8;https://blog.csdn.net/weixin_42130471/article/details/89813248
ArrayDeque 的使用场景
1、用数组实现的双端队列 2、线程不是安全的 3、可以用来实现栈
ArrayBlockingQueue 源码
(1)ArrayBlockingQueue不需要扩容,因为是初始化时指定容量,并循环利用数组; (2)ArrayBlockingQueue利用takeIndex和putIndex循环利用数组; (3)入队和出队各定义了四组方法为满足不同的用途; (4)利用重入锁和两个条件保证并发安全:lock、notEmpty、notFull
hashmap 和 treemap 的区别
hashmap
(1)HashMap是一种散列表,采用(数组 + 链表 + 红黑树)的存储结构; (2)HashMap的默认初始容量为16(1<<4),默认装载因子为0.75f,容量总是2的n次方; (3)HashMap扩容时每次容量变为原来的两倍; (4)当桶的数量小于64时不会进行树化,只会扩容; (5)当桶的数量大于64且单个桶中元素的数量大于8时,进行树化; (6)当单个桶中元素数量小于6时,进行反树化; (7)HashMap是非线程安全的容器; (8)HashMap查找添加元素的时间复杂度都为O(1);
treemap
(1)TreeMap的存储结构只有一颗红黑树; (2)TreeMap中的元素是有序的,按key的顺序排列; (3)TreeMap比HashMap要慢一些,因为HashMap前面还做了一层桶,寻找元素要快很多; (4)TreeMap没有扩容的概念; (5)TreeMap的遍历不是采用传统的递归式遍历; (6)TreeMap可以按范围查找元素,查找最近的元素;
rehash 过程
https://www.jianshu.com/p/dde9b12343c1
HashMap 的负载因子,为什么容量为2^n
HashMap为了存取高效,要尽量较少碰撞,就是要尽量把数据分配均匀,每个链表长度大致相同,这个实现就在把数据存到哪个链表中的算法; 这个算法实际就是取模,hash%length,计算机中直接求余效率不如位移运算,源码中做了优化hash&(length-1), hash%length==hash&(length-1)的前提是length是2的n次方; 为什么这样能均匀分布减少碰撞呢?2的n次方实际就是1后面n个0,2的n次方-1 实际就是n个1; 例如长度为9时候,3&(9-1)=0 2&(9-1)=0 ,都在0上,碰撞了; 例如长度为8时候,3&(8-1)=3 2&(8-1)=2 ,不同位置上,不碰撞; 其实就是按位“与”的时候,每一位都能 &1 ,也就是和1111……1111111进行与运算
list,map,set 之间的区别
https://blog.csdn.net/u012102104/article/details/79235938
什么时候会用到 HashMap
常见的线程安全的集合类
三 JVM
反射在jvm层面的实现
https://www.jianshu.com/p/b6cb4c694951
jvm的方法区存什么?
https://www.jianshu.com/p/10584345b10a
JDK1.8 JVM方法区变成了什么,为什么这样做
https://blog.csdn.net/u011665991/article/details/107141348/
oom出现的原因
https://blog.csdn.net/iteye_9584/article/details/82583093
Class.forName和ClassLoader的区别
https://blog.csdn.net/qq_27093465/article/details/52262340
java对象信息分配
https://blog.csdn.net/u014520047/article/details/81940447
java虚拟机ZGC详解
https://vimsky.com/article/4162.html
java虚拟机CMS详解
https://juejin.im/post/5c7262a15188252f30484351
java虚拟机G1详解
https://zhuanlan.zhihu.com/p/59861022
JVM tomcat 容器启动,jvm 加载情况描述
tomcat请求流程:http://objcoding.com/2017/06/12/Tomcat-structure-and-processing-request-process/
其实就是jvm的类加载情况,非常相似 https://blog.csdn.net/lduzhenlin/article/details/83013143 https://blog.csdn.net/xlgen157387/article/details/53521928
四 多线程并发
volitale使用场景
https://blog.csdn.net/vking_wang/article/details/9982709
可重入锁,实现原理
ReetrantLock:https://www.jianshu.com/p/f8f6ac49830e
Java 无锁原理
https://blog.csdn.net/qq_39291929/article/details/81501829
讲讲多线程,多线程的同步方法
synchronized原理
https://www.jianshu.com/p/d53bf830fa09
reetrantlock
java 线程安全都体现在哪些方面
如果维护线程安全 如果想实现一个线程安全的队列,可以怎么实现?
JUC 包里的 ArrayBlockingQueue 还有 LinkedBlockingQueue 啥的又结合源码说了一通。
Java多线程通信方式
https://blog.csdn.net/u011514810/article/details/77131296 https://blog.csdn.net/xiaokang123456kao/article/details/77331878
CountDownLatch、CyclicBarrier、Semaphore 用法总结
https://segmentfault.com/a/1190000012234469
juc下的内容
https://blog.csdn.net/sixabs/article/details/98471709
AOS等并发相关面试题
https://cloud.tencent.com/developer/article/1471770 https://zhuanlan.zhihu.com/p/96544118 https://zhuanlan.zhihu.com/p/48295486
threadlocal
https://juejin.im/post/5ac2eb52518825555e5e06ee
java 线程池达到提交上限的具体情况 ,线程池用法,Java 多线程,线程池有哪几类,每一类的差别
https://blog.csdn.net/github_37130188/article/details/89504500
要你设计的话,如何实现一个线程池
http://www.vcchar.com/thread-29098-1-1.html
线程池的类型,固定大小的线程池内部是如何实现的,等待队列是用了哪一个队列实现 线程池种类和工作流程
重点讲 newcached 线程池 线程池工作原理 比如 corePoolSize 和maxPoolSize 这两个参数该怎么调
线程池使用了什么设计模式
线程池使用时一般要考虑哪些问题
https://juejin.im/post/5d1882b1f265da1ba84aa676#heading-14
线程池的配置
Excutor 以及 Connector 的配置
https://www.cnblogs.com/kismetv/p/7806063.html
五 Java框架(ssm)
hibernate
Hibernate 的生成策略
主要说了 native 、uuid
https://blog.csdn.net/itmyhome1990/article/details/54863822
Hibernate 与 Mybatis 区别
https://blog.csdn.net/wangpeng047/article/details/17038659
Mybatis原理
https://www.javazhiyin.com/34438.html
mybatis执行select的过程
https://www.jianshu.com/p/ae2bda8f9d84 https://blog.csdn.net/qwesxd/article/details/90049863
mybatis有哪些executors
https://blog.csdn.net/weixin_42495773/article/details/106799280 https://blog.csdn.net/weixin_34025051/article/details/92405286
mybatis插件原理
https://www.cnblogs.com/qdhxhz/p/11390778.html
mybatis二级缓存
https://blog.csdn.net/csdnliuxin123524/article/details/78874261
spring&springmvc
面试题: https://mp.weixin.qq.com/s/2Y5X11TycreHgO0R3agK2A https://mp.weixin.qq.com/s/IdjCxumDleLqdU8MgQnrLQ
spring中的设计模式
https://juejin.im/post/5ce69379e51d455d877e0ca0
spring中bean的作用域
https://blog.csdn.net/weidaoyouwen/article/details/80503575
BeanFactory和FactoryBean区别
https://blog.csdn.net/weixin_38361347/article/details/92852611
aspect的种类
https://blog.csdn.net/StubbornAccepted/article/details/70767014
spring aop的实际应用
https://blog.csdn.net/zzh_spring/article/details/107207025
spring实现多线程安全
https://www.cnblogs.com/tiancai/p/9627109.html
spring的bean的高并发安全问题
https://blog.csdn.net/songzehao/article/details/103365494/
ioc aop总结(概述性)
https://juejin.im/post/5b040cf66fb9a07ab7748c8b https://juejin.im/post/5b06bf2df265da0de2574ee1
Spring 的加载流程,Spring 的源码中 Bean 的构造的流程
spring ioc系列文章:http://cmsblogs.com/?p=2806 加载流程(概述):https://www.jianshu.com/p/5fd1922ccab1 循环依赖问题:https://blog.csdn.net/u010853261/article/details/77940767 https://blog.csdn.net/a15119273009/article/details/108007864
Spring 事务源码,IOC 源码,AOP 源码
https://juejin.im/post/5c525968e51d453f5e6b744b
ioc、aop系列源码: https://segmentfault.com/a/1190000015319623 http://www.tianxiaobo.com/2018/05/30/Spring-IOC-%E5%AE%B9%E5%99%A8%E6%BA%90%E7%A0%81%E5%88%86%E6%9E%90%E7%B3%BB%E5%88%97%E6%96%87%E7%AB%A0%E5%AF%BC%E8%AF%BB/
spring 的作用及理解 事务怎么配置
https://www.jianshu.com/p/e7d59ebf41a3
spring事务失效情况
https://blog.csdn.net/luo4105/article/details/79733338
Spring 的 annotation 如何实现
https://segmentfault.com/a/1190000013258647
SpringMVC 工作原理
https://blog.csdn.net/cswhale/article/details/16941281
了解 SpringMVC 与 Struct2 区别
https://blog.csdn.net/chenleixing/article/details/44570681
springMVC 和 spring 是什么关系
项目中 Spring 的 IOC 和 AOP 具体怎么使用的
https://www.cnblogs.com/xdp-gacl/p/4249939.html https://juejin.im/post/5b06bf2df265da0de2574ee1
spring mvc 底层实现原理
https://blog.csdn.net/weixin_42323802/article/details/84038765
动态代理的原理
https://juejin.im/post/5a3284a75188252970793195
如果使用 spring mvc,那 post 请求跟 put 请求有什么区别啊; 然后开始问 springmvc:描述从 tomcat 开始到 springmvc 返回到前端显示的整个流程,接着问 springmvc 中的 handlerMapping 的内部实现,然后又问 spring 中从载入 xml 文件到 getbean 整个流程,描述一遍
六 微服务(springboot等)
springboot
springcloud
七 数据结构
二叉树相关
https://www.jianshu.com/p/655d83f9ba7b https://www.jianshu.com/p/ff4b93b088eb
红黑树
https://www.jianshu.com/p/e136ec79235c https://zhuanlan.zhihu.com/p/31805309
八 数据库
MySQL
数据库死锁问题
https://blog.csdn.net/cbjcry/article/details/84920174
hash索引和B+树索引的区别
https://www.cnblogs.com/heiming/p/5865101.html
可重复的原理MVCC
https://www.cnblogs.com/wade-luffy/p/8686883.html https://blog.csdn.net/weixin_42041027/article/details/100587435 https://www.jianshu.com/p/8845ddca3b23
count(1)、count(*)、count(列名)
https://blog.csdn.net/iFuMI/article/details/77920767
mysql的undo、redo、binlog的区别
https://mp.weixin.qq.com/s/0z6GmUp0Lb1hDUo0EyYiUg
explain解释
https://segmentfault.com/a/1190000010293791
mysql分页查询优化
https://blog.csdn.net/hanchao5272/article/details/102790490
sql注入
https://blog.csdn.net/github_36032947/article/details/78442189
为什么用B+树
https://blog.csdn.net/xlgen157387/article/details/79450295
sql执行流程
https://juejin.im/post/5b7036de6fb9a009c40997eb
聚集索引与非聚集索引
https://juejin.im/post/5cdd701ee51d453a36384939
覆盖索引
https://www.jianshu.com/p/77eaad62f974
sql总结
https://juejin.im/post/5d3f9cc1f265da03a31d1192
有人建议给每张表都建一个自增主键,这样做有什么优点跟缺点
https://blog.csdn.net/yixuandong9010/article/details/72286029
对 MySQL 的了解,和 oracle 的区别
https://juejin.im/post/5cbdbb455188250ab224802d
500万数字排序,内存只能容纳5万个,如何排序,如何优化?
参考文章:https://juejin.im/entry/5a27cb796fb9a045104a5e8c
平时怎么写数据库的模糊查询(由字典树扯到模糊查询,前缀查询,例如“abc%”,还是索引策略的问题)
数据库里有 10000000 条用户信息,需要给每位用户发送信息(必须发送成功),要求节省内存
项目中如何实现事务
数据库设计一般设计成第几范式
https://blog.csdn.net/hsd2012/article/details/51018631
mysql 用的什么版本 5.7 跟 5.6 有啥区别
提升 MySQL 安全性
https://blog.csdn.net/listen_for/article/details/53907270
问了一个这样的表(三个字段:姓名,id,分数)要求查出平均分大于 80 的 id 然后分数降序排序,然后经过提示用聚合函数 avg。
select id from table group by id having avg(score) > 80 order by avg(score) desc。
为什么 mysql 事务能保证失败回滚
主键索引底层的实现原理
B+树
经典的01索引问题?
如何在长文本中快捷的筛选出你的名字?
全文索引
多列索引及最左前缀原则和其他使用场景
事务隔离级别
索引的最左前缀原则
数据库悲观锁怎么实现的
https://www.jianshu.com/p/f5ff017db62a
建表的原则
索引的内涵和用法
给了两条 SQL 语句,让根据这两条语句建索引(个人想法:主要考虑复合索引只能匹配前缀列的特点)
那么我们来聊一下数据库。A 和 B 两个表做等值连接(Inner join) 怎么优化
https://blog.csdn.net/hguisu/article/details/5731880
哈希
数据库连接池的理解和优化
Sql语句分组排序
SQL语句的5个连接概念
数据库优化和架构(主要是主从分离和分库分表相关)
分库分表
跨库join实现
探讨主从分离和分库分表相关
数据库中间件
读写分离在中间件的实现
限流 and 熔断
行锁适用场景
https://cloud.tencent.com/developer/article/1104098
Redis
redis为什么快?
https://zhuanlan.zhihu.com/p/57089960
Redis 数据结构原理
https://blog.csdn.net/jackFXX/article/details/82318080
Redis 持久化机制
Redis 的一致性哈希算法
redis了解多少
redis五种数据类型,当散列类型的 value 值非常大的时候怎么进行压缩
用redis怎么实现摇一摇与附近的人功能
https://blog.csdn.net/smartwu_sir/article/details/80254733
redis 主从复制过程
Redis 如何解决 key 冲突
redis 是怎么存储数据的
redis 使用场景
九 计算机网络
cookie 禁用怎么办
https://segmentfault.com/q/1010000007715137
Netty new 实例化过程
socket 实现过程,具体用的方法;怎么实现异步 socket.
https://blog.csdn.net/charjay_lin/article/details/81810922
浏览器的缓存机制
说明计算机网络的知识还没有记住
https://www.cnblogs.com/yangyangxxb/p/10218871.html
http相关问题
https://mp.weixin.qq.com/s/xSGD3rWdboeeQvaS8jEchw
TCP三次握手第三次握手时ACK丢失怎么办
https://www.cnblogs.com/wuyepeng/p/9801470.html
dns属于udp还是tcp,原因
https://www.zhihu.com/question/310145373
http的幂等性
https://www.cnblogs.com/weidagang2046/archive/2011/06/04/idempotence.html
建立连接的过程客户端跟服务端会交换什么信息(参考 TCP 报文结构)
丢包如何解决重传的消耗
https://cloud.tencent.com/developer/article/1195037
traceroute 实现原理
https://zhuanlan.zhihu.com/p/36811672
IO多路复用
https://sanyuesha.com/python-server-tutorial/book/ch05.html
select 和 poll 区别?
好文:https://www.jianshu.com/p/dfd940e7fca2
在不使用 WebSocket 情况下怎么实现服务器推送的一种方法
服务器推送:https://juejin.im/post/5c20e5766fb9a049b13e387b
可以使用客户端定时刷新请求或者和 TCP 保持心跳连接实现。
查看磁盘读写吞吐量?
https://www.cnblogs.com/ggjucheng/archive/2013/01/13/2858810.html
PING 位于哪一层
ping命令本身相当于一个应用程序,位于应用层,虽然它使用的是ICMP协议,就好像HTTP位于应用层,但是也是使用的TCP协议
网络重定向,说下流程
https://developer.mozilla.org/zh-CN/docs/Web/HTTP/Redirections
controller 怎么处理的请求:路由
IP 地址分为几类,每类都代表什么,私网是哪些
https://zhuanlan.zhihu.com/p/54593244
十 操作系统
Java I/O 底层细节,注意是底层细节,而不是怎么用
可以从Java IO底层、JavaIO模型(阻塞、异步等) https://www.cnblogs.com/crazymakercircle/p/10225159.html
Java IO 模型(BIO,NIO 等) ,Tomcat 用的哪一种模型
tomcat支持:https://blog.csdn.net/fd2025/article/details/80007435
当获取第一个获取锁之后,条件不满足需要释放锁应当怎么做?
https://www.jianshu.com/p/eb112b25b848
手写一个线程安全的生产者与消费者。
https://blog.csdn.net/u010983881/article/details/78554671
进程和线程调度方法
https://www.jianshu.com/p/91c8600cb2ae
linux
linux查找命令
https://blog.51cto.com/whylinux/2043871
项目部署常见linux命令
https://blog.csdn.net/u010938610/article/details/79625988
进程文件里有哪些信息
sed 和 awk 的区别
awk用法:https://www.cnblogs.com/isykw/p/6258781.html
其实sed和awk都是每次读入一行来处理的,区别是:sed 适合简单的文本替换和搜索;而awk除了自动给你分列之外,里面丰富的函数大大增强了awk的功能。数据统计,正则表达式搜索,逻辑处理,前后置脚本等。因此基本上sed能做的,awk可以全部完成并且做的更好。
作者:哩掉掉 链接:https://www.zhihu.com/question/297858714/answer/572046422
linux查看进程并杀死的命令
https://blog.csdn.net/qingmu0803/article/details/38271077
有一个文件被锁住,如何查看锁住它的线程?
如何查看一个文件第100行到150行的内容
https://blog.csdn.net/zmx19951103/article/details/78575265
如何查看进程消耗的资源
https://www.cnblogs.com/freeweb/p/5407105.html
如何查看每个进程下的线程?
https://blog.csdn.net/inuyashaw/article/details/55095545
linux 如何查找文件
linux命令:https://juejin.im/post/5d3857eaf265da1bd04f2437
select epoll等问题
https://juejin.im/post/5b624f4d518825068302aee9#heading-13
十一 框架其他
Servlet 的 Filter 用的什么设计模式
https://www.jianshu.com/p/e4197a54828d
zookeeper 的常用功能,自己用它来做什么
redis 的操作是不是原子操作
https://juejin.im/entry/58f9e22044d9040069d40dca
秒杀业务场景设计
如何设计淘宝秒杀系统(重点关注架构,比如数据一致性,数据库集群一致性哈希,缓存, 分库分表等等)
对后台的优化有了解吗?比如负载均衡
我给面试官说了 Ngix+Tomcat 负载均 衡,异步处理(消息缓冲服务器),缓存(Redis, Memcache), NoSQL,数据库优化,存储索引优化
对 Restful 了解 Restful 的认识,优点,以及和 soap 的区别
https://www.ruanyifeng.com/blog/2011/09/restful.html
lrucache 的基本原理
十二 设计模式
Java常见设计模式
- https://www.jianshu.com/p/61b67ca754a3
- 单例模式(双检锁模式)、简单工厂、观察者模式、适配器模式、职责链模式等等
- 享元模式模式 选两个画下 UML 图
- 手写单例
写的是静态内部类的单例,然后他问我这个地方为什么用 private,这儿为啥用 static, 这就考察你的基本功啦
- 静态类与单例模式的区别
- 单例模式 double check 单例模式都有什么,都是否线程安全,怎么改进(从 synchronized 到 双重检验锁 到 枚举 Enum)
- 基本的设计模式及其核心思想
- 来,我们写一个单例模式的实现
十三 分布式
dubbo中的dubbo协议和http协议有什么区别?
https://blog.csdn.net/wjw_77/article/details/99696757
负载均衡
https://juejin.im/post/5b39eea0e51d4558c1010e36
分布式锁的实现方式及优缺点
https://zhuanlan.zhihu.com/p/62158041
CAP
https://www.jianshu.com/p/8025e3346734
如何实现分布式缓存
redis如何实现分布式缓存 https://stor.51cto.com/art/201912/607229.htm
十四 其他
Java 8 函数式编程 回调函数
函数式编程,面向对象之间区别
Java 8 中 stream 迭代的优势和区别?
同步等于可见性吗?
保证了可见性不等于正确同步,因为还有原子性没考虑。
git底层数据结构
https://blog.csdn.net/leo187/article/details/106233706
安全加密
http://www.ruanyifeng.com/blog/2011/08/what_is_a_digital_signature.html https://yq.aliyun.com/articles/54155
web安全问题
https://juejin.im/post/5da44c5de51d45783a772a22
http面试问题全解析
HTTP协议定义了浏览器怎么向万维网服务器请求万维网文档,以及服务器怎么样把文档传送给浏览器。
举个例子来说,用户单击鼠标后发生的事件按顺序如下(以访问清华大学为例):
- 浏览器分析链接指向页面的URL。
- 浏览器向DNS请求解析www.tsinghua.edu.c的IP地址。
- DNS解析出该IP地址。
- 浏览器与该服务器建立TCP链接(默认port:80)。
- 浏览器发出HTTP请求:GET/chn/index.htm(HTTP请求通过TCP套接字,发送请求报文,该请求报文作为TCP三次握手第三个报文数据发送给服务器)。
- 服务器通过HTTP响应把文件index.html发送给服务器。
- TCP连接释放(释放连接若connection若为close,服务端主动关闭,客户端被动关闭,若为keepalive,则该连接会保持一段事件,该时间内可以继续接收请求)。
- 浏览器将文件进行解析,并将Web页面显示给用户(先解析状态行,看状态码是否请求成功,然后解析每一个响应头,告知编码规范,对其进行格式化,有脚本还要加载脚本)。
HTTP 状态码含义:
- 200 OK 服务器已经成功处理了请求并提供了请求的网页。
- 202 Accpted 已经接受请求,但处理尚未完成。
- 204 No Content 没有新文档,浏览器应该继续显示原来的文档。
- 206 Partial Content 客户端进行了范围请求。响应报文中由Content-Range指定实体内容的范围。实现断点续传
- 301 Moved Permanently 永久性重定向。请求的网页已永久移动到新位置。
- 302(307) Moved Temporatily 临时性重定向。
- 304 Not Moidfied 未修改。自上次请求后,请求的内容未修改过。
- 401 Unauthorized 客户试图未经授权访问受密码保护的页面。该应答中会包含一个WWW-Authenticate头,浏览器由此显示login框,填写合适Authorization头以后再次发出请求。
- 403 Forbidden 服务器拒绝请求。
- 404 Not Found 服务器不存在客户机所请求的资源。
- 500 Intern Server Error 服务器遇到一个错误,使其无法为请求提供服务。
HTTP的请求方法
- GET 向指定的资源发出显示请求,使用GET方法应该只用于在读取数据。
- HEAD 与GET方法一样,都是向服务器发出指定资源的请求。只不过HEAD不包含有呈现数据,而仅仅是头部信息(关于该资源的信息)。
- PUT 向指定资源位置上传最新位置(与POST相比,PUT指定了存放位置,而PSOT由服务器指定)。
- DELETE请求服务器删除某一个资源
- POST 向指定资源提交数据,请求服务器进行处理(例如提交表单或者上传文件)。
- TRACE 请求服务器回送收到的请求信息,主要用于测试和诊断。
- OPTIONS 使服务器传回该资源所支持的所有HTTP请求方法。若请求成功,则会在HTTP头中包含一个名为“Allow”的头,值是支持的方法,如“GET,POST”。
GET和POST的区别:
- 对资源的影响:GET一般用于获取或者查询资源信息,意味着对同一个URL的多个请求返回的结果一样(幂等),没有修改资源的状态(安全);而POST一般用于更新资源信息,POST既不是安全的也不是幂等的
- 传递的信息量:采用GET方法时,客户端把发送的数据添加到URL后面(即HTTP协议头中),使用“?”连接,各个变量用“&”连接,但是由于有些浏览器和服务器对URL的长度和字符格式存在限制,所以传递的信息有限;POST则把需要传递的数据放到请求报文的消息体中,HTTP协议对此没有限制,因此可以传递更多信息。
- 安全性:GET提交的数据,消息以明文出现在URL上,如密码等信息可能被浏览器缓存,从而从历史记录中得到;POST把消息存放在消息体中,安全性高,但是也存在被抓包软件抓取看到内容。
cookie 和 session :
HTTP协议是无状态:无状态是指协议对于事务处理没有记忆能力,简单来说,即使第一次和服务器连接后并且登陆成功后,第二次请求服务器依然不知道当前请求是哪个用户。为此,cookie和session的使用为此提供了解决方案。
cookie:
以文件的形式存在硬盘中的永久性cookie(设置了一定的时限)和停留在浏览器内存中的临时性cookie,当用户访问网站时,浏览器就会在本地寻找相关cookie。如果该cookie存在,浏览器就会将其与页面请求一起通过报头信息发送到站点。
session:
session与cookie的作用有点类似,不同的时cookie存储在本地,而session存储在服务器。当程序需要为某个客户端的请求创建一个session的时候,服务器首先会检查这个客户端的请求里是否包含了一个session标识session-id,如果已经包含一个session-id则为此客户端创建过session,服务器就按照session-id把这个session检索出来,如果不包含,就创建一个新的键值对
浏览器提供了三种方式来保存ssesion-id:
- cookie
- url重写(把session-id附加在url后面,即使用GET)
- 增加隐藏域(使用POST)
session什么时候被创建?事实上session并不是在有客户端访问的时候被创建,而是知道某sever端程序调用类似function getSession()方法时才会创建。
HTTP请求报文结构和响应报文结构
HTTP请求报文结构如下:
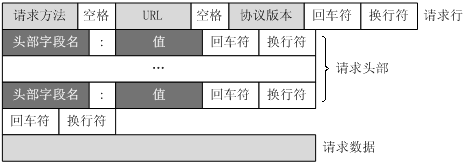
- 请求行:
- 请求头:为请求报文添加了一些附加信息,如 Host(接受请求的服务器地址 ip;port 或者 域名 等) / User-Agent / Connection(连接属性,如Keep-Alive) / Accept-Charset / Accpet-Encoding / Accept-Language
- 空行:请求头的最后一行会有一个空行,表示请求头部结束,接下俩的请求为正文。
- 请求正文:可选部分,如GET就没有请求正文
一个报文实体例子如下:
GET /562f25980001b1b106000338.jpg HTTP/1.1
Host    img.mukewang.com
User-Agent    Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/51.0.2704.106 Safari/537.36
Accept    image/webp,image/*,*/*;q=0.8
Referer    http://www.imooc.com/
Accept-Encoding    gzip, deflate, sdch
Accept-Language    zh-CN,zh;q=0.8
HTTP响应报文
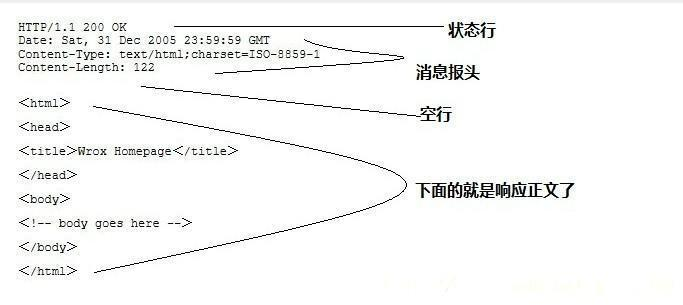
- 状态行:协议版本,状态码等
- 响应头:与请求头类似,为响应报文添加了一些附加信息。
- 空行
- 响应正文
一个报文实体例子如下:
HTTP/1.1 200 OK
Server: nginx
Date: Mon, 20 Feb 2017 09:13:59 GMT
Content-Type: text/plain;charset=UTF-8
Vary: Accept-Encoding
Cache-Control: no-store
Pragrma: no-cache
Expires: Thu, 01 Jan 1970 00:00:00 GMT
Cache-Control: no-cache
Content-Encoding: gzip
Transfer-Encoding: chunked
Proxy-Connection: Keep-alive

{"code":200,"notice":0,"follow":0,"forward":0,"msg":0,"comment":0,"pushMsg":null,"friend":{"snsCount":0,"count":0,"celebrityCount":0},"lastPrivateMsg":null,"event":0,"newProgramCount":0,"createDJRadioCount":0,"newTheme":true}
参考文章:
http详解
https://www.cnblogs.com/an-wen/p/11180076.html
cookie和sessions
https://www.cnblogs.com/xxtalhr/p/9053906.html
关于HTTP协议
https://www.cnblogs.com/ranyonsue/p/5984001.html
Tip:本来有很多我准备的资料的,但是都是外链,或者不合适的分享方式,所以大家去公众号回复【资料】好了。
现在免费送给大家,在我的公众号 好好学java 回复 资料 即可获取。
有收获?希望老铁们来个三连击,给更多的人看到这篇文章
1、老铁们,关注我的原创微信公众号「好好学java」,专注于Java、数据结构和算法、微服务、中间件等技术分享,保证你看完有所收获。
2、给俺一个 star 呗,可以让更多的人看到这篇文章,顺便激励下我继续写作,嘻嘻。
操作系统、计算机网络相关知识
Tip:本来有很多我准备的资料的,但是都是外链,或者不合适的分享方式,所以大家去公众号回复【资料】好了。
现在免费送给大家,在我的公众号 好好学java 回复 资料 即可获取。
有收获?希望老铁们来个三连击,给更多的人看到这篇文章
1、老铁们,关注我的原创微信公众号「好好学java」,专注于Java、数据结构和算法、微服务、中间件等技术分享,保证你看完有所收获。
2、给俺一个 star 呗,可以让更多的人看到这篇文章,顺便激励下我继续写作,嘻嘻。
linux高频面试题
linux查找命令
https://blog.51cto.com/whylinux/2043871 项目部署常见linux命令
https://blog.csdn.net/u010938610/article/details/79625988 进程文件里有哪些信息 sed 和 awk 的区别
awk用法:https://www.cnblogs.com/isykw/p/6258781.html
其实sed和awk都是每次读入一行来处理的,区别是:sed 适合简单的文本替换和搜索;而awk除了自动给你分列之外,里面丰富的函数大大增强了awk的功能。数据统计,正则表达式搜索,逻辑处理,前后置脚本等。因此基本上sed能做的,awk可以全部完成并且做的更好。
作者:哩掉掉 链接:https://www.zhihu.com/question/297858714/answer/572046422 linux查看进程并杀死的命令
https://blog.csdn.net/qingmu0803/article/details/38271077 有一个文件被锁住,如何查看锁住它的线程? 如何查看一个文件第100行到150行的内容
https://blog.csdn.net/zmx19951103/article/details/78575265 如何查看进程消耗的资源
https://www.cnblogs.com/freeweb/p/5407105.html 如何查看每个进程下的线程?
https://blog.csdn.net/inuyashaw/article/details/55095545 linux 如何查找文件
linux命令:https://juejin.im/post/5d3857eaf265da1bd04f2437
select epoll等问题 https://juejin.im/post/5b624f4d518825068302aee9#heading-13
消息中间件面试题
1 消息中间件
面试官:你在系统里用过消息队列吗?(面试官在随和的语气中展开了面试)
候选人:用过的(此时感觉没啥)
面试官:那你说一下你们在项目里是怎么用消息队列的?
候选人:巴拉巴拉,我们啥啥系统发送个啥啥消息到队列,别的系统来消费啥啥的(很多同学在这里会进入一个误区,就是你仅仅就是知道以及回答你们是怎么用这个消息队列的,用这个消息队列来干了个什么事情?)
比如我们有个订单系统,订单系统会每次下一个新的订单的时候,就会发送时一条消息到ActiveMQ里面去,后台有个库存系统负责获取了消息然后更新库存。
面试官:那你们为什么使用消息队列啊?
(你的订单系统不发送消息到MQ,直接订单系统调用库存系统一个接口,咔嚓一下,直接就调用成功能了,库存就更新了)
候选人:额。。。(楞了一下,为什么?我没怎么仔细想过啊,老大让用就用了),硬着头皮胡言乱语了几句
(面试官此时听你楞了一下,然后听你胡言乱语了几句,开始心里觉得有点儿那什么了,怀疑你之前就压根儿没思考过这问题)
面试官:那你说说用消息队列都有什么优点和缺点?
(面试官此时心里想的是,你的MQ在项目里为啥要用?你没考虑过,那我稍微简单点儿,我问问你消息队列你之前有没有考虑过如果用的话,优点和缺点分别是啥?)
候选人:这个。。。(确实平时没怎么考虑过这个问题啊。。。胡言乱语了)
(面试官此时心里已经更觉得你这哥儿们不行,平时都没什么思考)
面试官:kafka、activemq、rabbitmq、rocketmq都有什么区别?
(面试官问你这个问题,就是说,绕过比较虚的话题,直接看看你对各种MQ中间件是否了解,是否做过功课,是否做过调研)
候选人:我们就用过activemq,所以别的没用过。。。区别,也不太清楚
(面试官此时却是觉得你这哥儿们平时就是瞎用,根本就没什么思考,觉得不行)
为什么使用消息队列啊?消息队列有什么优点和缺点啊?kafka、activemq、rabbitmq、rocketmq都有什么区别以及适合哪些场景?
2、面试官心理分析
其实面试官主要是想看看:
(1)第一,你知道不知道你们系统里为什么要用消息队列这个东西?
我之前面试就见过大量的候选人,说自己项目里用了redis、mq,但是其实他并不知道自己为什么要用这个东西。其实说白了,就是为了用而用,或者是别人设计的架构,他从头到尾没思考过。
没有对自己的架构问过为什么的人,一定是平时没有思考的人,面试官对这类候选人印象通常很不好。因为进了团队担心你就木头木脑的干呆活儿,不会自己思考。
(2)第二,你既然用了消息队列这个东西,你知道不知道用了有什么好处?
系统中引入消息队列之后会不会有什么坏处?你要是没考虑过这个,那你盲目弄个MQ进系统里,后面出了问题你是不是就自己溜了给公司留坑?你要是没考虑过引入一个技术可能存在的弊端和风险,面试官把这类候选人招进来了,基本可能就是挖坑型选手。
就怕你干1年挖一堆坑,自己跳槽了,给公司留下后患无穷
(3)第三,既然你用了MQ,可能是某一种MQ,那么你当时做没做过调研啊?
你别傻乎乎的自己拍脑袋看个人喜好就瞎用了一个MQ,比如kafka。甚至都从没调研过业界到底流行的MQ有哪几种?每一个MQ的优点和缺点是什么?每一个MQ没有绝对的好坏,但是就是看用在哪个场景可以扬长避短,利用其优势,规避其劣势。
如果是一个不考虑技术选型的候选人招进了团队,面试官交给他一个任务,去设计个什么系统,他在里面用一些技术,可能都没考虑过选型,最后选的技术可能并不一定合适,一样是留坑
3、额外的友情提示
同学啊,如果你看到这里,连activemq、rabbitmq、rocketmq、kafka是什么都不知道?连个hello world demo都没写过?那你。。。
通过网上查阅技术资料和博客,用于快速入门,是比较合适的,但是如果要比如系统梳理你的面试技术体系,或者是系统的深入的研究和学习一些东西,看博客实际上是不太合适的
那也没事,我们这个课程的定位是不会去讲这些的,建议你马上暂停一下课程,然后上百度搜一下,这4个东西是什么?每个东西找一个教你hello world的博客,自己跟着做一遍。我保证你1个小时之内就可以快速入门这几个东西。
等你先知道这几个东西是什么,同时写过hello world之后,你再来继续看我们的课程
4、面试题剖析
(1)为什么使用消息队列啊?
其实就是问问你消息队列都有哪些使用场景,然后你项目里具体是什么场景,说说你在这个场景里用消息队列是什么
面试官问你这个问题,期望的一个回答是说,你们公司有个什么业务场景,这个业务场景有个什么技术挑战,如果不用MQ可能会很麻烦,但是你现在用了MQ之后带给了你很多的好处
先说一下消息队列的常见使用场景吧,其实场景有很多,但是比较核心的有3个:解耦、异步、削峰
解耦:现场画个图来说明一下,A系统发送个数据到BCD三个系统,接口调用发送,那如果E系统也要这个数据呢?那如果C系统现在不需要了呢?现在A系统又要发送第二种数据了呢?A系统负责人濒临崩溃中。。。再来点更加崩溃的事儿,A系统要时时刻刻考虑BCDE四个系统如果挂了咋办?我要不要重发?我要不要把消息存起来?头发都白了啊。。。

面试技巧:你需要去考虑一下你负责的系统中是否有类似的场景,就是一个系统或者一个模块,调用了多个系统或者模块,互相之间的调用很复杂,维护起来很麻烦。但是其实这个调用是不需要直接同步调用接口的,如果用MQ给他异步化解耦,也是可以的,你就需要去考虑在你的项目里,是不是可以运用这个MQ去进行系统的解耦。在简历中体现出来这块东西,用MQ作解耦。

异步:现场画个图来说明一下,A系统接收一个请求,需要在自己本地写库,还需要在BCD三个系统写库,自己本地写库要3ms,BCD三个系统分别写库要300ms、450ms、200ms。最终请求总延时是3 + 300 + 450 + 200 = 953ms,接近1s,用户感觉搞个什么东西,慢死了慢死了。


削峰:每天0点到11点,A系统风平浪静,每秒并发请求数量就100个。结果每次一到11点~1点,每秒并发请求数量突然会暴增到1万条。但是系统最大的处理能力就只能是每秒钟处理1000个请求啊。。。尴尬了,系统会死。。。


(2)消息队列有什么优点和缺点啊?
优点上面已经说了,就是在特殊场景下有其对应的好处,解耦、异步、削峰
缺点呢?显而易见的

系统可用性降低:系统引入的外部依赖越多,越容易挂掉,本来你就是A系统调用BCD三个系统的接口就好了,人ABCD四个系统好好的,没啥问题,你偏加个MQ进来,万一MQ挂了咋整?MQ挂了,整套系统崩溃了,你不就完了么。
系统复杂性提高:硬生生加个MQ进来,你怎么保证消息没有重复消费?怎么处理消息丢失的情况?怎么保证消息传递的顺序性?头大头大,问题一大堆,痛苦不已
一致性问题:A系统处理完了直接返回成功了,人都以为你这个请求就成功了;但是问题是,要是BCD三个系统那里,BD两个系统写库成功了,结果C系统写库失败了,咋整?你这数据就不一致了。
所以消息队列实际是一种非常复杂的架构,你引入它有很多好处,但是也得针对它带来的坏处做各种额外的技术方案和架构来规避掉,最好之后,你会发现,妈呀,系统复杂度提升了一个数量级,也许是复杂了10倍。但是关键时刻,用,还是得用的。。。
(3)kafka、activemq、rabbitmq、rocketmq都有什么优点和缺点啊?
常见的MQ其实就这几种,别的还有很多其他MQ,但是比较冷门的,那么就别多说了
作为一个码农,你起码得知道各种mq的优点和缺点吧,咱们来画个表格看看
特性 ActiveMQ RabbitMQ RocketMQ Kafka 单机吞吐量 万级,吞吐量比RocketMQ和Kafka要低了一个数量级 万级,吞吐量比RocketMQ和Kafka要低了一个数量级 10万级,RocketMQ也是可以支撑高吞吐的一种MQ 10万级别,这是kafka最大的优点,就是吞吐量高。
一般配合大数据类的系统来进行实时数据计算、日志采集等场景 topic数量对吞吐量的影响 topic可以达到几百,几千个的级别,吞吐量会有较小幅度的下降
这是RocketMQ的一大优势,在同等机器下,可以支撑大量的topic topic从几十个到几百个的时候,吞吐量会大幅度下降
所以在同等机器下,kafka尽量保证topic数量不要过多。如果要支撑大规模topic,需要增加更多的机器资源 时效性 ms级 微秒级,这是rabbitmq的一大特点,延迟是最低的 ms级 延迟在ms级以内 可用性 高,基于主从架构实现高可用性 高,基于主从架构实现高可用性 非常高,分布式架构 非常高,kafka是分布式的,一个数据多个副本,少数机器宕机,不会丢失数据,不会导致不可用 消息可靠性 有较低的概率丢失数据 经过参数优化配置,可以做到0丢失 经过参数优化配置,消息可以做到0丢失 功能支持 MQ领域的功能极其完备 基于erlang开发,所以并发能力很强,性能极其好,延时很低 MQ功能较为完善,还是分布式的,扩展性好 功能较为简单,主要支持简单的MQ功能,在大数据领域的实时计算以及日志采集被大规模使用,是事实上的标准 优劣势总结 非常成熟,功能强大,在业内大量的公司以及项目中都有应用
偶尔会有较低概率丢失消息
而且现在社区以及国内应用都越来越少,官方社区现在对ActiveMQ 5.x维护越来越少,几个月才发布一个版本
而且确实主要是基于解耦和异步来用的,较少在大规模吞吐的场景中使用
erlang语言开发,性能极其好,延时很低;吞吐量到万级,MQ功能比较完备
而且开源提供的管理界面非常棒,用起来很好用
社区相对比较活跃,几乎每个月都发布几个版本分
在国内一些互联网公司近几年用rabbitmq也比较多一些
但是问题也是显而易见的,RabbitMQ确实吞吐量会低一些,这是因为他做的实现机制比较重。
而且erlang开发,国内有几个公司有实力做erlang源码级别的研究和定制?如果说你没这个实力的话,确实偶尔会有一些问题,你很难去看懂源码,你公司对这个东西的掌控很弱,基本职能依赖于开源社区的快速维护和修复bug。
而且rabbitmq集群动态扩展会很麻烦,不过这个我觉得还好。其实主要是erlang语言本身带来的问题。很难读源码,很难定制和掌控。 接口简单易用,而且毕竟在阿里大规模应用过,有阿里品牌保障
日处理消息上百亿之多,可以做到大规模吞吐,性能也非常好,分布式扩展也很方便,社区维护还可以,可靠性和可用性都是ok的,还可以支撑大规模的topic数量,支持复杂MQ业务场景
而且一个很大的优势在于,阿里出品都是java系的,我们可以自己阅读源码,定制自己公司的MQ,可以掌控
社区活跃度相对较为一般,不过也还可以,文档相对来说简单一些,然后接口这块不是按照标准JMS规范走的有些系统要迁移需要修改大量代码
还有就是阿里出台的技术,你得做好这个技术万一被抛弃,社区黄掉的风险,那如果你们公司有技术实力我觉得用RocketMQ挺好的 kafka的特点其实很明显,就是仅仅提供较少的核心功能,但是提供超高的吞吐量,ms级的延迟,极高的可用性以及可靠性,而且分布式可以任意扩展
同时kafka最好是支撑较少的topic数量即可,保证其超高吞吐量
而且kafka唯一的一点劣势是有可能消息重复消费,那么对数据准确性会造成极其轻微的影响,在大数据领域中以及日志采集中,这点轻微影响可以忽略
这个特性天然适合大数据实时计算以及日志收集
综上所述,各种对比之后,我个人倾向于是:
一般的业务系统要引入MQ,最早大家都用ActiveMQ,但是现在确实大家用的不多了,没经过大规模吞吐量场景的验证,社区也不是很活跃,所以大家还是算了吧,我个人不推荐用这个了;
后来大家开始用RabbitMQ,但是确实erlang语言阻止了大量的java工程师去深入研究和掌控他,对公司而言,几乎处于不可控的状态,但是确实人是开源的,比较稳定的支持,活跃度也高;
不过现在确实越来越多的公司,会去用RocketMQ,确实很不错,但是我提醒一下自己想好社区万一突然黄掉的风险,对自己公司技术实力有绝对自信的,我推荐用RocketMQ,否则回去老老实实用RabbitMQ吧,人是活跃开源社区,绝对不会黄
所以中小型公司,技术实力较为一般,技术挑战不是特别高,用RabbitMQ是不错的选择;大型公司,基础架构研发实力较强,用RocketMQ是很好的选择
如果是大数据领域的实时计算、日志采集等场景,用Kafka是业内标准的,绝对没问题,社区活跃度很高,绝对不会黄,何况几乎是全世界这个领域的事实性规范
如何保证消息队列的高可用啊?
2、面试官心理分析
如果有人问到你MQ的知识,高可用是必问的,因为MQ的缺点,我刚才已经说过了,有好多,导致系统可用性降低,等等。所以只要你用了MQ,接下来问的一些要点肯定就是围绕着MQ的那些缺点怎么来解决了。
要是你傻乎乎的就干用了一个MQ,各种问题从来没考虑过,那你就杯具了,面试官对你的印象就是,只会简单实用一些技术,没任何思考,马上对你的印象就不太好了。这样的同学招进来要是做个20k薪资以内的普通小弟还凑合。如果招进来做薪资20多k的高工,那就惨了,让你设计个系统,里面肯定一堆坑,出了事故公司受损失,团队一起背锅。
去年的事儿,非常大的互联网公司,非常核心的系统,就是疏忽了MQ,没考虑MQ如何保证高可用,如果MQ挂了怎么办,导致几个小时系统不可用,公司损失几千万,team背锅,你闹的祸,你老大帮你一起背锅
3、面试题剖析
这个问题这么问是很好的,因为不能问你kafka的高可用性怎么保证啊?ActiveMQ的高可用性怎么保证啊?一个面试官要是这么问就显得很没水平,人家可能用的就是RabbitMQ,没用过Kafka,你上来问人家kafka干什么?这不是摆明了刁难人么。
所以有水平的面试官,问的是MQ的高可用性怎么保证?这样就是你用过哪个MQ,你就说说你对那个MQ的高可用性的理解。
(1)RabbitMQ的高可用性
RabbitMQ是比较有代表性的,因为是基于主从做高可用性的,我们就以他为例子讲解第一种MQ的高可用性怎么实现。
rabbitmq有三种模式:单机模式,普通集群模式,镜像集群模式
1)单机模式
就是demo级别的,一般就是你本地启动了玩玩儿的,没人生产用单机模式
2)普通集群模式
意思就是在多台机器上启动多个rabbitmq实例,每个机器启动一个。但是你创建的queue,只会放在一个rabbtimq实例上,但是每个实例都同步queue的元数据。完了你消费的时候,实际上如果连接到了另外一个实例,那么那个实例会从queue所在实例上拉取数据过来。
这种方式确实很麻烦,也不怎么好,没做到所谓的分布式,就是个普通集群。因为这导致你要么消费者每次随机连接一个实例然后拉取数据,要么固定连接那个queue所在实例消费数据,前者有数据拉取的开销,后者导致单实例性能瓶颈。
而且如果那个放queue的实例宕机了,会导致接下来其他实例就无法从那个实例拉取,如果你开启了消息持久化,让rabbitmq落地存储消息的话,消息不一定会丢,得等这个实例恢复了,然后才可以继续从这个queue拉取数据。
所以这个事儿就比较尴尬了,这就没有什么所谓的高可用性可言了,这方案主要是提高吞吐量的,就是说让集群中多个节点来服务某个queue的读写操作。

3)镜像集群模式

这种模式,才是所谓的rabbitmq的高可用模式,跟普通集群模式不一样的是,你创建的queue,无论元数据还是queue里的消息都会存在于多个实例上,然后每次你写消息到queue的时候,都会自动把消息到多个实例的queue里进行消息同步。
这样的话,好处在于,你任何一个机器宕机了,没事儿,别的机器都可以用。坏处在于,第一,这个性能开销也太大了吧,消息同步所有机器,导致网络带宽压力和消耗很重!第二,这么玩儿,就没有扩展性可言了,如果某个queue负载很重,你加机器,新增的机器也包含了这个queue的所有数据,并没有办法线性扩展你的queue
那么怎么开启这个镜像集群模式呢?我这里简单说一下,避免面试人家问你你不知道,其实很简单rabbitmq有很好的管理控制台,就是在后台新增一个策略,这个策略是镜像集群模式的策略,指定的时候可以要求数据同步到所有节点的,也可以要求就同步到指定数量的节点,然后你再次创建queue的时候,应用这个策略,就会自动将数据同步到其他的节点上去了。
(2)kafka的高可用性

kafka一个最基本的架构认识:多个broker组成,每个broker是一个节点;你创建一个topic,这个topic可以划分为多个partition,每个partition可以存在于不同的broker上,每个partition就放一部分数据。
这就是天然的分布式消息队列,就是说一个topic的数据,是分散放在多个机器上的,每个机器就放一部分数据。
实际上rabbitmq之类的,并不是分布式消息队列,他就是传统的消息队列,只不过提供了一些集群、HA的机制而已,因为无论怎么玩儿,rabbitmq一个queue的数据都是放在一个节点里的,镜像集群下,也是每个节点都放这个queue的完整数据。
kafka 0.8以前,是没有HA机制的,就是任何一个broker宕机了,那个broker上的partition就废了,没法写也没法读,没有什么高可用性可言。
kafka 0.8以后,提供了HA机制,就是replica副本机制。每个partition的数据都会同步到吉他机器上,形成自己的多个replica副本。然后所有replica会选举一个leader出来,那么生产和消费都跟这个leader打交道,然后其他replica就是follower。写的时候,leader会负责把数据同步到所有follower上去,读的时候就直接读leader上数据即可。只能读写leader?很简单,要是你可以随意读写每个follower,那么就要care数据一致性的问题,系统复杂度太高,很容易出问题。kafka会均匀的将一个partition的所有replica分布在不同的机器上,这样才可以提高容错性。
这么搞,就有所谓的高可用性了,因为如果某个broker宕机了,没事儿,那个broker上面的partition在其他机器上都有副本的,如果这上面有某个partition的leader,那么此时会重新选举一个新的leader出来,大家继续读写那个新的leader即可。这就有所谓的高可用性了。
写数据的时候,生产者就写leader,然后leader将数据落地写本地磁盘,接着其他follower自己主动从leader来pull数据。一旦所有follower同步好数据了,就会发送ack给leader,leader收到所有follower的ack之后,就会返回写成功的消息给生产者。(当然,这只是其中一种模式,还可以适当调整这个行为)
消费的时候,只会从leader去读,但是只有一个消息已经被所有follower都同步成功返回ack的时候,这个消息才会被消费者读到。
实际上这块机制,讲深了,是可以非常之深入的,但是我还是回到我们这个课程的主题和定位,聚焦面试,至少你听到这里大致明白了kafka是如何保证高可用机制的了,对吧?不至于一无所知,现场还能给面试官画画图。要遇上面试官确实是kafka高手,深挖了问,那你只能说不好意思,太深入的你没研究过。
但是大家一定要明白,这个事情是要权衡的,你现在是要快速突击常见面试题体系,而不是要深入学习kafka,要深入学习kafka,你是没那么多时间的。你只能确保,你之前也许压根儿不知道这块,但是现在你知道了,面试被问到,你大概可以说一说。然后很多其他的候选人,也许还不如你,没看过这个,被问到了压根儿答不出来,相比之下,你还能说点出来,大概就是这个意思了。
如何保证消息不被重复消费啊(如何保证消息消费时的幂等性)?
2、面试官心里分析
其实这个很常见的一个问题,这俩问题基本可以连起来问。既然是消费消息,那肯定要考虑考虑会不会重复消费?能不能避免重复消费?或者重复消费了也别造成系统异常可以吗?这个是MQ领域的基本问题,其实本质上还是问你使用消息队列如何保证幂等性,这个是你架构里要考虑的一个问题。
面试官问你,肯定是必问的,这是你要考虑的实际生产上的系统设计问题。
3、面试题剖析
回答这个问题,首先你别听到重复消息这个事儿,就一无所知吧,你先大概说一说可能会有哪些重复消费的问题。
首先就是比如rabbitmq、rocketmq、kafka,都有可能会出现消费重复消费的问题,正常。因为这问题通常不是mq自己保证的,是给你保证的。然后我们挑一个kafka来举个例子,说说怎么重复消费吧。

kafka实际上有个offset的概念,就是每个消息写进去,都有一个offset,代表他的序号,然后consumer消费了数据之后,每隔一段时间,会把自己消费过的消息的offset提交一下,代表我已经消费过了,下次我要是重启啥的,你就让我继续从上次消费到的offset来继续消费吧。
但是凡事总有意外,比如我们之前生产经常遇到的,就是你有时候重启系统,看你怎么重启了,如果碰到点着急的,直接kill进程了,再重启。这会导致consumer有些消息处理了,但是没来得及提交offset,尴尬了。重启之后,少数消息会再次消费一次。
其实重复消费不可怕,可怕的是你没考虑到重复消费之后,怎么保证幂等性。
给你举个例子吧。假设你有个系统,消费一条往数据库里插入一条,要是你一个消息重复两次,你不就插入了两条,这数据不就错了?但是你要是消费到第二次的时候,自己判断一下已经消费过了,直接扔了,不就保留了一条数据?
一条数据重复出现两次,数据库里就只有一条数据,这就保证了系统的幂等性
幂等性,我通俗点说,就一个数据,或者一个请求,给你重复来多次,你得确保对应的数据是不会改变的,不能出错。
那所以第二个问题来了,怎么保证消息队列消费的幂等性?
其实还是得结合业务来思考,我这里给几个思路:

(1)比如你拿个数据要写库,你先根据主键查一下,如果这数据都有了,你就别插入了,update一下好吧
(2)比如你是写redis,那没问题了,反正每次都是set,天然幂等性
(3)比如你不是上面两个场景,那做的稍微复杂一点,你需要让生产者发送每条数据的时候,里面加一个全局唯一的id,类似订单id之类的东西,然后你这里消费到了之后,先根据这个id去比如redis里查一下,之前消费过吗?如果没有消费过,你就处理,然后这个id写redis。如果消费过了,那你就别处理了,保证别重复处理相同的消息即可。
还有比如基于数据库的唯一键来保证重复数据不会重复插入多条,我们之前线上系统就有这个问题,就是拿到数据的时候,每次重启可能会有重复,因为kafka消费者还没来得及提交offset,重复数据拿到了以后我们插入的时候,因为有唯一键约束了,所以重复数据只会插入报错,不会导致数据库中出现脏数据
如何保证MQ的消费是幂等性的,需要结合具体的业务来看
如何保证消息的可靠性传输(如何处理消息丢失的问题)?
2、面试官心里分析
这个是肯定的,用mq有个基本原则,就是数据不能多一条,也不能少一条,不能多,就是刚才说的重复消费和幂等性问题。不能少,就是说这数据别搞丢了。那这个问题你必须得考虑一下。
如果说你这个是用mq来传递非常核心的消息,比如说计费,扣费的一些消息,因为我以前设计和研发过一个公司非常核心的广告平台,计费系统,计费系统是很重的一个业务,操作是很耗时的。所以说广告系统整体的架构里面,实际上是将计费做成异步化的,然后中间就是加了一个MQ。
我们当时为了确保说这个MQ传递过程中绝对不会把计费消息给弄丢,花了很多的精力。广告主投放了一个广告,明明说好了,用户点击一次扣费1块钱。结果要是用户动不动点击了一次,扣费的时候搞的消息丢了,我们公司就会不断的少几块钱,几块钱,积少成多,这个就对公司是一个很大的损失。
3、面试题剖析
这个丢数据,mq一般分为两种,要么是mq自己弄丢了,要么是我们消费的时候弄丢了。咱们从rabbitmq和kafka分别来分析一下吧
rabbitmq这种mq,一般来说都是承载公司的核心业务的,数据是绝对不能弄丢的
(1)rabbitmq

1)生产者弄丢了数据
生产者将数据发送到rabbitmq的时候,可能数据就在半路给搞丢了,因为网络啥的问题,都有可能。
此时可以选择用rabbitmq提供的事务功能,就是生产者发送数据之前开启rabbitmq事务(channel.txSelect),然后发送消息,如果消息没有成功被rabbitmq接收到,那么生产者会收到异常报错,此时就可以回滚事务(channel.txRollback),然后重试发送消息;如果收到了消息,那么可以提交事务(channel.txCommit)。但是问题是,rabbitmq事务机制一搞,基本上吞吐量会下来,因为太耗性能。
所以一般来说,如果你要确保说写rabbitmq的消息别丢,可以开启confirm模式,在生产者那里设置开启confirm模式之后,你每次写的消息都会分配一个唯一的id,然后如果写入了rabbitmq中,rabbitmq会给你回传一个ack消息,告诉你说这个消息ok了。如果rabbitmq没能处理这个消息,会回调你一个nack接口,告诉你这个消息接收失败,你可以重试。而且你可以结合这个机制自己在内存里维护每个消息id的状态,如果超过一定时间还没接收到这个消息的回调,那么你可以重发。
事务机制和cnofirm机制最大的不同在于,事务机制是同步的,你提交一个事务之后会阻塞在那儿,但是confirm机制是异步的,你发送个消息之后就可以发送下一个消息,然后那个消息rabbitmq接收了之后会异步回调你一个接口通知你这个消息接收到了。
所以一般在生产者这块避免数据丢失,都是用confirm机制的。
2)rabbitmq弄丢了数据
就是rabbitmq自己弄丢了数据,这个你必须开启rabbitmq的持久化,就是消息写入之后会持久化到磁盘,哪怕是rabbitmq自己挂了,恢复之后会自动读取之前存储的数据,一般数据不会丢。除非极其罕见的是,rabbitmq还没持久化,自己就挂了,可能导致少量数据会丢失的,但是这个概率较小。
设置持久化有两个步骤,第一个是创建queue的时候将其设置为持久化的,这样就可以保证rabbitmq持久化queue的元数据,但是不会持久化queue里的数据;第二个是发送消息的时候将消息的deliveryMode设置为2,就是将消息设置为持久化的,此时rabbitmq就会将消息持久化到磁盘上去。必须要同时设置这两个持久化才行,rabbitmq哪怕是挂了,再次重启,也会从磁盘上重启恢复queue,恢复这个queue里的数据。
而且持久化可以跟生产者那边的confirm机制配合起来,只有消息被持久化到磁盘之后,才会通知生产者ack了,所以哪怕是在持久化到磁盘之前,rabbitmq挂了,数据丢了,生产者收不到ack,你也是可以自己重发的。
哪怕是你给rabbitmq开启了持久化机制,也有一种可能,就是这个消息写到了rabbitmq中,但是还没来得及持久化到磁盘上,结果不巧,此时rabbitmq挂了,就会导致内存里的一点点数据会丢失。
3)消费端弄丢了数据
rabbitmq如果丢失了数据,主要是因为你消费的时候,刚消费到,还没处理,结果进程挂了,比如重启了,那么就尴尬了,rabbitmq认为你都消费了,这数据就丢了。
这个时候得用rabbitmq提供的ack机制,简单来说,就是你关闭rabbitmq自动ack,可以通过一个api来调用就行,然后每次你自己代码里确保处理完的时候,再程序里ack一把。这样的话,如果你还没处理完,不就没有ack?那rabbitmq就认为你还没处理完,这个时候rabbitmq会把这个消费分配给别的consumer去处理,消息是不会丢的。
(2)kafka

唯一可能导致消费者弄丢数据的情况,就是说,你那个消费到了这个消息,然后消费者那边自动提交了offset,让kafka以为你已经消费好了这个消息,其实你刚准备处理这个消息,你还没处理,你自己就挂了,此时这条消息就丢咯。
这不是一样么,大家都知道kafka会自动提交offset,那么只要关闭自动提交offset,在处理完之后自己手动提交offset,就可以保证数据不会丢。但是此时确实还是会重复消费,比如你刚处理完,还没提交offset,结果自己挂了,此时肯定会重复消费一次,自己保证幂等性就好了。
生产环境碰到的一个问题,就是说我们的kafka消费者消费到了数据之后是写到一个内存的queue里先缓冲一下,结果有的时候,你刚把消息写入内存queue,然后消费者会自动提交offset。
然后此时我们重启了系统,就会导致内存queue里还没来得及处理的数据就丢失了
2)kafka弄丢了数据
这块比较常见的一个场景,就是kafka某个broker宕机,然后重新选举partiton的leader时。大家想想,要是此时其他的follower刚好还有些数据没有同步,结果此时leader挂了,然后选举某个follower成leader之后,他不就少了一些数据?这就丢了一些数据啊。
生产环境也遇到过,我们也是,之前kafka的leader机器宕机了,将follower切换为leader之后,就会发现说这个数据就丢了
所以此时一般是要求起码设置如下4个参数:
给这个topic设置replication.factor参数:这个值必须大于1,要求每个partition必须有至少2个副本
在kafka服务端设置min.insync.replicas参数:这个值必须大于1,这个是要求一个leader至少感知到有至少一个follower还跟自己保持联系,没掉队,这样才能确保leader挂了还有一个follower吧
在producer端设置acks=all:这个是要求每条数据,必须是写入所有replica之后,才能认为是写成功了
在producer端设置retries=MAX(很大很大很大的一个值,无限次重试的意思):这个是要求一旦写入失败,就无限重试,卡在这里了
我们生产环境就是按照上述要求配置的,这样配置之后,至少在kafka broker端就可以保证在leader所在broker发生故障,进行leader切换时,数据不会丢失
3)生产者会不会弄丢数据
如果按照上述的思路设置了ack=all,一定不会丢,要求是,你的leader接收到消息,所有的follower都同步到了消息之后,才认为本次写成功了。如果没满足这个条件,生产者会自动不断的重试,重试无限次。
如何保证消息的顺序性?
2、面试官心里分析
其实这个也是用MQ的时候必问的话题,第一看看你了解不了解顺序这个事儿?第二看看你有没有办法保证消息是有顺序的?这个生产系统中常见的问题。
3、面试题剖析
我举个例子,我们以前做过一个mysql binlog同步的系统,压力还是非常大的,日同步数据要达到上亿。mysql -> mysql,常见的一点在于说大数据team,就需要同步一个mysql库过来,对公司的业务系统的数据做各种复杂的操作。
你在mysql里增删改一条数据,对应出来了增删改3条binlog,接着这三条binlog发送到MQ里面,到消费出来依次执行,起码得保证人家是按照顺序来的吧?不然本来是:增加、修改、删除;你楞是换了顺序给执行成删除、修改、增加,不全错了么。
本来这个数据同步过来,应该最后这个数据被删除了;结果你搞错了这个顺序,最后这个数据保留下来了,数据同步就出错了。
先看看顺序会错乱的俩场景

(1)rabbitmq:一个queue,多个consumer,这不明显乱了

(2)kafka:一个topic,一个partition,一个consumer,内部多线程,这不也明显乱了
那如何保证消息的顺序性呢?简单简单
(1)rabbitmq:拆分多个queue,每个queue一个consumer,就是多一些queue而已,确实是麻烦点;或者就一个queue但是对应一个consumer,然后这个consumer内部用内存队列做排队,然后分发给底层不同的worker来处理

(2)kafka:一个topic,一个partition,一个consumer,内部单线程消费,写N个内存queue,然后N个线程分别消费一个内存queue即可

如何解决消息队列的延时以及过期失效问题?消息队列满了以后该怎么处理?有几百万消息持续积压几小时,说说怎么解决?
2、面试官心里分析
你看这问法,其实本质针对的场景,都是说,可能你的消费端出了问题,不消费了,或者消费的极其极其慢。接着就坑爹了,可能你的消息队列集群的磁盘都快写满了,都没人消费,这个时候怎么办?或者是整个这就积压了几个小时,你这个时候怎么办?或者是你积压的时间太长了,导致比如rabbitmq设置了消息过期时间后就没了怎么办?
所以就这事儿,其实线上挺常见的,一般不出,一出就是大case,一般常见于,举个例子,消费端每次消费之后要写mysql,结果mysql挂了,消费端hang那儿了,不动了。或者是消费端出了个什么叉子,导致消费速度极其慢。
3、面试题分析
关于这个事儿,我们一个一个来梳理吧,先假设一个场景,我们现在消费端出故障了,然后大量消息在mq里积压,现在事故了,慌了
(1)大量消息在mq里积压了几个小时了还没解决

几千万条数据在MQ里积压了七八个小时,从下午4点多,积压到了晚上很晚,10点多,11点多
这个是我们真实遇到过的一个场景,确实是线上故障了,这个时候要不然就是修复consumer的问题,让他恢复消费速度,然后傻傻的等待几个小时消费完毕。这个肯定不能在面试的时候说吧。
一个消费者一秒是1000条,一秒3个消费者是3000条,一分钟是18万条,1000多万条
所以如果你积压了几百万到上千万的数据,即使消费者恢复了,也需要大概1小时的时间才能恢复过来
一般这个时候,只能操作临时紧急扩容了,具体操作步骤和思路如下:
1)先修复consumer的问题,确保其恢复消费速度,然后将现有cnosumer都停掉 2)新建一个topic,partition是原来的10倍,临时建立好原先10倍或者20倍的queue数量 3)然后写一个临时的分发数据的consumer程序,这个程序部署上去消费积压的数据,消费之后不做耗时的处理,直接均匀轮询写入临时建立好的10倍数量的queue 4)接着临时征用10倍的机器来部署consumer,每一批consumer消费一个临时queue的数据 5)这种做法相当于是临时将queue资源和consumer资源扩大10倍,以正常的10倍速度来消费数据 6)等快速消费完积压数据之后,得恢复原先部署架构,重新用原先的consumer机器来消费消息
(2)这里我们假设再来第二个坑
假设你用的是rabbitmq,rabbitmq是可以设置过期时间的,就是TTL,如果消息在queue中积压超过一定的时间就会被rabbitmq给清理掉,这个数据就没了。那这就是第二个坑了。这就不是说数据会大量积压在mq里,而是大量的数据会直接搞丢。
这个情况下,就不是说要增加consumer消费积压的消息,因为实际上没啥积压,而是丢了大量的消息。我们可以采取一个方案,就是批量重导,这个我们之前线上也有类似的场景干过。就是大量积压的时候,我们当时就直接丢弃数据了,然后等过了高峰期以后,比如大家一起喝咖啡熬夜到晚上12点以后,用户都睡觉了。
这个时候我们就开始写程序,将丢失的那批数据,写个临时程序,一点一点的查出来,然后重新灌入mq里面去,把白天丢的数据给他补回来。也只能是这样了。
假设1万个订单积压在mq里面,没有处理,其中1000个订单都丢了,你只能手动写程序把那1000个订单给查出来,手动发到mq里去再补一次
(3)然后我们再来假设第三个坑
如果走的方式是消息积压在mq里,那么如果你很长时间都没处理掉,此时导致mq都快写满了,咋办?这个还有别的办法吗?没有,谁让你第一个方案执行的太慢了,你临时写程序,接入数据来消费,消费一个丢弃一个,都不要了,快速消费掉所有的消息。然后走第二个方案,到了晚上再补数据吧。
如果让你写一个消息队列,该如何进行架构设计啊?说一下你的思路
2、面试官心里分析
其实聊到这个问题,一般面试官要考察两块:
(1)你有没有对某一个消息队列做过较为深入的原理的了解,或者从整体了解把握住一个mq的架构原理
(2)看看你的设计能力,给你一个常见的系统,就是消息队列系统,看看你能不能从全局把握一下整体架构设计,给出一些关键点出来
说实话,我一般面类似问题的时候,大部分人基本都会蒙,因为平时从来没有思考过类似的问题,大多数人就是平时埋头用,从来不去思考背后的一些东西。类似的问题,我经常问的还有,如果让你来设计一个spring框架你会怎么做?如果让你来设计一个dubbo框架你会怎么做?如果让你来设计一个mybatis框架你会怎么做?
3、面试题剖析
其实回答这类问题,说白了,起码不求你看过那技术的源码,起码你大概知道那个技术的基本原理,核心组成部分,基本架构构成,然后参照一些开源的技术把一个系统设计出来的思路说一下就好
比如说这个消息队列系统,我们来从以下几个角度来考虑一下
(1)首先这个mq得支持可伸缩性吧,就是需要的时候快速扩容,就可以增加吞吐量和容量,那怎么搞?设计个分布式的系统呗,参照一下kafka的设计理念,broker -> topic -> partition,每个partition放一个机器,就存一部分数据。如果现在资源不够了,简单啊,给topic增加partition,然后做数据迁移,增加机器,不就可以存放更多数据,提供更高的吞吐量了?
(2)其次你得考虑一下这个mq的数据要不要落地磁盘吧?那肯定要了,落磁盘,才能保证别进程挂了数据就丢了。那落磁盘的时候怎么落啊?顺序写,这样就没有磁盘随机读写的寻址开销,磁盘顺序读写的性能是很高的,这就是kafka的思路。
(3)其次你考虑一下你的mq的可用性啊?这个事儿,具体参考我们之前可用性那个环节讲解的kafka的高可用保障机制。多副本 -> leader & follower -> broker挂了重新选举leader即可对外服务。
(4)能不能支持数据0丢失啊?可以的,参考我们之前说的那个kafka数据零丢失方案
其实一个mq肯定是很复杂的,面试官问你这个问题,其实是个开放题,他就是看看你有没有从架构角度整体构思和设计的思维以及能力。确实这个问题可以刷掉一大批人,因为大部分人平时不思考这些东西。
2 Redis
在项目中缓存是如何使用的?缓存如果使用不当会造成什么后果?
2、面试官心里分析
这个问题,互联网公司必问,要是一个人连缓存都不太清楚,那确实比较尴尬
只要问到缓存,上来第一个问题,肯定能是先问问你项目哪里用了缓存?为啥要用?不用行不行?如果用了以后可能会有什么不良的后果?
这就是看看你对你用缓存这个东西背后,有没有思考,如果你就是傻乎乎的瞎用,没法给面试官一个合理的解答。那我只能说,面试官对你印象肯定不太好,觉得你平时思考太少,就知道干活儿。
3、面试题剖析
一个一个来看
(1)在项目中缓存是如何使用的?
这个,你结合你自己项目的业务来,你如果用了那恭喜你,你如果没用那不好意思,你硬加也得加一个场景吧
(2)为啥在项目里要用缓存呢?
用缓存,主要是俩用途,高性能和高并发
1)高性能

假设这么个场景,你有个操作,一个请求过来,吭哧吭哧你各种乱七八糟操作mysql,半天查出来一个结果,耗时600ms。但是这个结果可能接下来几个小时都不会变了,或者变了也可以不用立即反馈给用户。那么此时咋办?
缓存啊,折腾600ms查出来的结果,扔缓存里,一个key对应一个value,下次再有人查,别走mysql折腾600ms了。直接从缓存里,通过一个key查出来一个value,2ms搞定。性能提升300倍。
这就是所谓的高性能。
就是把你一些复杂操作耗时查出来的结果,如果确定后面不咋变了,然后但是马上还有很多读请求,那么直接结果放缓存,后面直接读缓存就好了。
2)高并发

mysql这么重的数据库,压根儿设计不是让你玩儿高并发的,虽然也可以玩儿,但是天然支持不好。mysql单机支撑到2000qps也开始容易报警了。
所以要是你有个系统,高峰期一秒钟过来的请求有1万,那一个mysql单机绝对会死掉。你这个时候就只能上缓存,把很多数据放缓存,别放mysql。缓存功能简单,说白了就是key-value式操作,单机支撑的并发量轻松一秒几万十几万,支撑高并发so easy。单机承载并发量是mysql单机的几十倍。
3)所以你要结合这俩场景考虑一下,你为啥要用缓存?
一般很多同学项目里没啥高并发场景,那就别折腾了,直接用高性能那个场景吧,就思考有没有可以缓存结果的复杂查询场景,后续可以大幅度提升性能,优化用户体验,有,就说这个理由,没有??那你也得编一个出来吧,不然你不是在搞笑么
(3)用了缓存之后会有啥不良的后果?
呵呵。。。你要是没考虑过这个问题,那你就尴尬了,面试官会觉得你头脑简单,四肢也不发达。你别光是傻用一个东西,多考虑考虑背后的一些事儿。
常见的缓存问题有仨(当然其实有很多,我这里就说仨,你能说出来也可以了)
1)缓存与数据库双写不一致 2)缓存雪崩 3)缓存穿透 4)缓存并发竞争
这仨问题是常见面试题,后面我要讲,大家看到后面自然就知道了,但是人要是问你,你至少自己能说出来,并且给出对应的解决方案
redis和memcached有什么区别?redis的线程模型是什么?为什么单线程的redis比多线程的memcached效率要高得多(为什么redis是单线程的但是还可以支撑高并发)?
https://www.jianshu.com/p/6264fa82ac33
2、面试官心里分析
这个是问redis的时候,最基本的问题吧,redis最基本的一个内部原理和特点,就是redis实际上是个单线程工作模型,你要是这个都不知道,那后面玩儿redis的时候,出了问题岂不是什么都不知道?
还有可能面试官会问问你redis和memcached的区别,不过说实话,最近这两年,我作为面试官都不太喜欢这么问了,memched是早些年各大互联网公司常用的缓存方案,但是现在近几年基本都是redis,没什么公司用memcached了
3、额外的友情提示
同学,你要是现在还不知道redis和memcached是啥?那你赶紧百度一下redis入门和memcahced入门,简单启动一下,然后试一下几个简单操作,先感受一下。接着回来继续听课,我觉得1小时以内你就搞定了。
另外一个友情提示,要听明白redis的线程模型,你需要了解socket网络相关的基本知识,如果不懂。。。那我觉得你java没学好吧。初学者都该学习java的socket网络通信相关知识的。。。
4、面试题剖析
(1)redis和memcached有啥区别
这个事儿吧,你可以比较出N多个区别来,但是我还是采取redis作者给出的几个比较吧
1)Redis支持服务器端的数据操作:Redis相比Memcached来说,拥有更多的数据结构和并支持更丰富的数据操作,通常在Memcached里,你需要将数据拿到客户端来进行类似的修改再set回去。这大大增加了网络IO的次数和数据体积。在Redis中,这些复杂的操作通常和一般的GET/SET一样高效。所以,如果需要缓存能够支持更复杂的结构和操作,那么Redis会是不错的选择。
2)内存使用效率对比:使用简单的key-value存储的话,Memcached的内存利用率更高,而如果Redis采用hash结构来做key-value存储,由于其组合式的压缩,其内存利用率会高于Memcached。
3)性能对比:由于Redis只使用单核,而Memcached可以使用多核,所以平均每一个核上Redis在存储小数据时比Memcached性能更高。而在100k以上的数据中,Memcached性能要高于Redis,虽然Redis最近也在存储大数据的性能上进行优化,但是比起Memcached,还是稍有逊色。
4)集群模式:memcached没有原生的集群模式,需要依靠客户端来实现往集群中分片写入数据;但是redis目前是原生支持cluster模式的,redis官方就是支持redis cluster集群模式的,比memcached来说要更好
(2)redis的线程模型

1)文件事件处理器
redis基于reactor模式开发了网络事件处理器,这个处理器叫做文件事件处理器,file event handler。这个文件事件处理器,是单线程的,redis才叫做单线程的模型,采用IO多路复用机制同时监听多个socket,根据socket上的事件来选择对应的事件处理器来处理这个事件。
如果被监听的socket准备好执行accept、read、write、close等操作的时候,跟操作对应的文件事件就会产生,这个时候文件事件处理器就会调用之前关联好的事件处理器来处理这个事件。
文件事件处理器是单线程模式运行的,但是通过IO多路复用机制监听多个socket,可以实现高性能的网络通信模型,又可以跟内部其他单线程的模块进行对接,保证了redis内部的线程模型的简单性。
文件事件处理器的结构包含4个部分:多个socket,IO多路复用程序,文件事件分派器,事件处理器(命令请求处理器、命令回复处理器、连接应答处理器,等等)。
多个socket可能并发的产生不同的操作,每个操作对应不同的文件事件,但是IO多路复用程序会监听多个socket,但是会将socket放入一个队列中排队,每次从队列中取出一个socket给事件分派器,事件分派器把socket给对应的事件处理器。
然后一个socket的事件处理完之后,IO多路复用程序才会将队列中的下一个socket给事件分派器。文件事件分派器会根据每个socket当前产生的事件,来选择对应的事件处理器来处理。
2)文件事件
当socket变得可读时(比如客户端对redis执行write操作,或者close操作),或者有新的可以应答的sccket出现时(客户端对redis执行connect操作),socket就会产生一个AE_READABLE事件。
当socket变得可写的时候(客户端对redis执行read操作),socket会产生一个AE_WRITABLE事件。
IO多路复用程序可以同时监听AE_REABLE和AE_WRITABLE两种事件,要是一个socket同时产生了AE_READABLE和AE_WRITABLE两种事件,那么文件事件分派器优先处理AE_REABLE事件,然后才是AE_WRITABLE事件。
3)文件事件处理器
如果是客户端要连接redis,那么会为socket关联连接应答处理器 如果是客户端要写数据到redis,那么会为socket关联命令请求处理器 如果是客户端要从redis读数据,那么会为socket关联命令回复处理器
4)客户端与redis通信的一次流程
在redis启动初始化的时候,redis会将连接应答处理器跟AE_READABLE事件关联起来,接着如果一个客户端跟redis发起连接,此时会产生一个AE_READABLE事件,然后由连接应答处理器来处理跟客户端建立连接,创建客户端对应的socket,同时将这个socket的AE_READABLE事件跟命令请求处理器关联起来。
当客户端向redis发起请求的时候(不管是读请求还是写请求,都一样),首先就会在socket产生一个AE_READABLE事件,然后由对应的命令请求处理器来处理。这个命令请求处理器就会从socket中读取请求相关数据,然后进行执行和处理。
接着redis这边准备好了给客户端的响应数据之后,就会将socket的AE_WRITABLE事件跟命令回复处理器关联起来,当客户端这边准备好读取响应数据时,就会在socket上产生一个AE_WRITABLE事件,会由对应的命令回复处理器来处理,就是将准备好的响应数据写入socket,供客户端来读取。
命令回复处理器写完之后,就会删除这个socket的AE_WRITABLE事件和命令回复处理器的关联关系。
(3)为啥redis单线程模型也能效率这么高?
1)纯内存操作 2)核心是基于非阻塞的IO多路复用机制 3)单线程反而避免了多线程的频繁上下文切换问题(百度)
redis都有哪些数据类型?分别在哪些场景下使用比较合适?
2、面试官心里分析
除非是我感觉看你简历,就是工作3年以内的比较初级的一个同学,可能对技术没有很深入的研究过,我才会问这类问题,在宝贵的面试时间里,我实在是不想多问
其实问这个问题呢。。。主要就俩原因
第一,看看你到底有没有全面的了解redis有哪些功能,一般怎么来用,啥场景用什么,就怕你别就会最简单的kv操作
第二,看看你在实际项目里都怎么玩儿过redis
要是你回答的不好,没说出几种数据类型,也没说什么场景,你完了,面试官对你印象肯定不好,觉得你平时就是做个简单的set和get。
3、面试题剖析
(1)string
这是最基本的类型了,没啥可说的,就是普通的set和get,做简单的kv缓存
(2)hash
这个是类似map的一种结构,这个一般就是可以将结构化的数据,比如一个对象(前提是这个对象没嵌套其他的对象)给缓存在redis里,然后每次读写缓存的时候,可以就操作hash里的某个字段。
key=150
value={ “id”: 150, “name”: “zhangsan”, “age”: 20 }
hash类的数据结构,主要是用来存放一些对象,把一些简单的对象给缓存起来,后续操作的时候,你可以直接仅仅修改这个对象中的某个字段的值
value={ “id”: 150, “name”: “zhangsan”, “age”: 21 }
(3)list
有序列表,这个是可以玩儿出很多花样的
微博,某个大v的粉丝,就可以以list的格式放在redis里去缓存
key=某大v
value=[zhangsan, lisi, wangwu]
比如可以通过list存储一些列表型的数据结构,类似粉丝列表了、文章的评论列表了之类的东西
比如可以通过lrange命令,就是从某个元素开始读取多少个元素,可以基于list实现分页查询,这个很棒的一个功能,基于redis实现简单的高性能分页,可以做类似微博那种下拉不断分页的东西,性能高,就一页一页走
比如可以搞个简单的消息队列,从list头怼进去,从list尾巴那里弄出来
(4)set
无序集合,自动去重
直接基于set将系统里需要去重的数据扔进去,自动就给去重了,如果你需要对一些数据进行快速的全局去重,你当然也可以基于jvm内存里的HashSet进行去重,但是如果你的某个系统部署在多台机器上呢?
得基于redis进行全局的set去重
可以基于set玩儿交集、并集、差集的操作,比如交集吧,可以把两个人的粉丝列表整一个交集,看看俩人的共同好友是谁?对吧
把两个大v的粉丝都放在两个set中,对两个set做交集
(5)sorted set
排序的set,去重但是可以排序,写进去的时候给一个分数,自动根据分数排序,这个可以玩儿很多的花样,最大的特点是有个分数可以自定义排序规则
比如说你要是想根据时间对数据排序,那么可以写入进去的时候用某个时间作为分数,人家自动给你按照时间排序了
排行榜:将每个用户以及其对应的什么分数写入进去,zadd board score username,接着zrevrange board 0 99,就可以获取排名前100的用户;zrank board username,可以看到用户在排行榜里的排名
zadd board 85 zhangsan zadd board 72 wangwu zadd board 96 lisi zadd board 62 zhaoliu
96 lisi 85 zhangsan 72 wangwu 62 zhaoliu
zrevrange board 0 3
获取排名前3的用户
96 lisi 85 zhangsan 72 wangwu
zrank board zhaoliu
redis的过期策略都有哪些?内存淘汰机制都有哪些?手写一下LRU代码实现?
2、面试官心里分析
1)老师啊,我往redis里写的数据怎么没了?
之前有同学问过我,说我们生产环境的redis怎么经常会丢掉一些数据?写进去了,过一会儿可能就没了。我的天,同学,你问这个问题就说明redis你就没用对啊。redis是缓存,你给当存储了是吧?
啥叫缓存?用内存当缓存。内存是无限的吗,内存是很宝贵而且是有限的,磁盘是廉价而且是大量的。可能一台机器就几十个G的内存,但是可以有几个T的硬盘空间。redis主要是基于内存来进行高性能、高并发的读写操作的。
那既然内存是有限的,比如redis就只能用10个G,你要是往里面写了20个G的数据,会咋办?当然会干掉10个G的数据,然后就保留10个G的数据了。那干掉哪些数据?保留哪些数据?当然是干掉不常用的数据,保留常用的数据了。
所以说,这是缓存的一个最基本的概念,数据是会过期的,要么是你自己设置个过期时间,要么是redis自己给干掉。
set key value 过期时间(1小时) set进去的key,1小时之后就没了,就失效了
2)老师,我的数据明明都过期了,怎么还占用着内存啊?
还有一种就是如果你设置好了一个过期时间,你知道redis是怎么给你弄成过期的吗?什么时候删除掉?如果你不知道,之前有个学员就问了,为啥好多数据明明应该过期了,结果发现redis内存占用还是很高?那是因为你不知道redis是怎么删除那些过期key的。
redis 内存一共是10g,你现在往里面写了5g的数据,结果这些数据明明你都设置了过期时间,要求这些数据1小时之后都会过期,结果1小时之后,你回来一看,redis机器,怎么内存占用还是50%呢?5g数据过期了,我从redis里查,是查不到了,结果过期的数据还占用着redis的内存。
如果你连这个问题都不知道,上来就懵了,回答不出来,那线上你写代码的时候,想当然的认为写进redis的数据就一定会存在,后面导致系统各种漏洞和bug,谁来负责?
3、面试题剖析
(1)设置过期时间
我们set key的时候,都可以给一个expire time,就是过期时间,指定这个key比如说只能存活1个小时?10分钟?这个很有用,我们自己可以指定缓存到期就失效。
如果假设你设置一个一批key只能存活1个小时,那么接下来1小时后,redis是怎么对这批key进行删除的?
答案是:定期删除+惰性删除
所谓定期删除,指的是redis默认是每隔100ms就随机抽取一些设置了过期时间的key,检查其是否过期,如果过期就删除。假设redis里放了10万个key,都设置了过期时间,你每隔几百毫秒,就检查10万个key,那redis基本上就死了,cpu负载会很高的,消耗在你的检查过期key上了。注意,这里可不是每隔100ms就遍历所有的设置过期时间的key,那样就是一场性能上的灾难。实际上redis是每隔100ms随机抽取一些key来检查和删除的。
但是问题是,定期删除可能会导致很多过期key到了时间并没有被删除掉,那咋整呢?所以就是惰性删除了。这就是说,在你获取某个key的时候,redis会检查一下 ,这个key如果设置了过期时间那么是否过期了?如果过期了此时就会删除,不会给你返回任何东西。
并不是key到时间就被删除掉,而是你查询这个key的时候,redis再懒惰的检查一下
通过上述两种手段结合起来,保证过期的key一定会被干掉。
很简单,就是说,你的过期key,靠定期删除没有被删除掉,还停留在内存里,占用着你的内存呢,除非你的系统去查一下那个key,才会被redis给删除掉。
但是实际上这还是有问题的,如果定期删除漏掉了很多过期key,然后你也没及时去查,也就没走惰性删除,此时会怎么样?如果大量过期key堆积在内存里,导致redis内存块耗尽了,咋整?
答案是:走内存淘汰机制。
(2)内存淘汰
如果redis的内存占用过多的时候,此时会进行内存淘汰,有如下一些策略:
redis 10个key,现在已经满了,redis需要删除掉5个key
1个key,最近1分钟被查询了100次 1个key,最近10分钟被查询了50次 1个key,最近1个小时倍查询了1次
1)noeviction:当内存不足以容纳新写入数据时,新写入操作会报错,这个一般没人用吧,实在是太恶心了 2)allkeys-lru:当内存不足以容纳新写入数据时,在键空间中,移除最近最少使用的key(这个是最常用的) 3)allkeys-random:当内存不足以容纳新写入数据时,在键空间中,随机移除某个key,这个一般没人用吧,为啥要随机,肯定是把最近最少使用的key给干掉啊 4)volatile-lru:当内存不足以容纳新写入数据时,在设置了过期时间的键空间中,移除最近最少使用的key(这个一般不太合适) 5)volatile-random:当内存不足以容纳新写入数据时,在设置了过期时间的键空间中,随机移除某个key 6)volatile-ttl:当内存不足以容纳新写入数据时,在设置了过期时间的键空间中,有更早过期时间的key优先移除
百度,问题啊,网上鱼龙混杂
如果百度一些api操作,入门的知识,ok的,随便找一个博客都可以
一些高级别的,redis单线程模型
很简单,你写的数据太多,内存满了,或者触发了什么条件,redis lru,自动给你清理掉了一些最近很少使用的数据
(3)要不你手写一个LRU算法?
我确实有时会问这个,因为有些候选人如果确实过五关斩六将,前面的问题都答的很好,那么其实让他写一下LRU算法,可以考察一下编码功底
你可以现场手写最原始的LRU算法,那个代码量太大了,我觉得不太现实
public class LRUCache<K, V> extends LinkedHashMap<K, V> {

private final int CACHE_SIZE;

    // 这里就是传递进来最多能缓存多少数据
    public LRUCache(int cacheSize) {
        super((int) Math.ceil(cacheSize / 0.75) + 1, 0.75f, true); // 这块就是设置一个hashmap的初始大小,同时最后一个true指的是让linkedhashmap按照访问顺序来进行排序,最近访问的放在头,最老访问的就在尾
        CACHE_SIZE = cacheSize;
    }

    @Override
    protected boolean removeEldestEntry(Map.Entry eldest) {
        return size() > CACHE_SIZE; // 这个意思就是说当map中的数据量大于指定的缓存个数的时候,就自动删除最老的数据
    }

}
我给你看上面的代码,是告诉你最起码你也得写出来上面那种代码,不求自己纯手工从底层开始打造出自己的LRU,但是起码知道如何利用已有的jdk数据结构实现一个java版的LRU
如何保证Redis的高并发和高可用?redis的主从复制原理能介绍一下么?redis的哨兵原理能介绍一下么?
1、redis高并发跟整个系统的高并发之间的关系
redis,你要搞高并发的话,不可避免,要把底层的缓存搞得很好
mysql,高并发,做到了,那么也是通过一系列复杂的分库分表,订单系统,事务要求的,QPS到几万,比较高了
要做一些电商的商品详情页,真正的超高并发,QPS上十万,甚至是百万,一秒钟百万的请求量
光是redis是不够的,但是redis是整个大型的缓存架构中,支撑高并发的架构里面,非常重要的一个环节
首先,你的底层的缓存中间件,缓存系统,必须能够支撑的起我们说的那种高并发,其次,再经过良好的整体的缓存架构的设计(多级缓存架构、热点缓存),支撑真正的上十万,甚至上百万的高并发
2、redis不能支撑高并发的瓶颈在哪里?
单机
3、如果redis要支撑超过10万+的并发,那应该怎么做?
单机的redis几乎不太可能说QPS超过10万+,除非一些特殊情况,比如你的机器性能特别好,配置特别高,物理机,维护做的特别好,而且你的整体的操作不是太复杂
单机在几万
读写分离,一般来说,对缓存,一般都是用来支撑读高并发的,写的请求是比较少的,可能写请求也就一秒钟几千,一两千
大量的请求都是读,一秒钟二十万次读
读写分离
主从架构 -> 读写分离 -> 支撑10万+读QPS的架构
4、接下来要讲解的一个topic
redis replication
redis主从架构 -> 读写分离架构 -> 可支持水平扩展的读高并发架构
课程大纲
1、图解redis replication基本原理 2、redis replication的核心机制 3、master持久化对于主从架构的安全保障的意义
redis replication -> 主从架构 -> 读写分离 -> 水平扩容支撑读高并发
redis replication的最最基本的原理,铺垫
1、图解redis replication基本原理
2、redis replication的核心机制
(1)redis采用异步方式复制数据到slave节点,不过redis 2.8开始,slave node会周期性地确认自己每次复制的数据量 (2)一个master node是可以配置多个slave node的 (3)slave node也可以连接其他的slave node (4)slave node做复制的时候,是不会block master node的正常工作的 (5)slave node在做复制的时候,也不会block对自己的查询操作,它会用旧的数据集来提供服务; 但是复制完成的时候,需要删除旧数据集,加载新数据集,这个时候就会暂停对外服务了 (6)slave node主要用来进行横向扩容,做读写分离,扩容的slave node可以提高读的吞吐量
slave,高可用性,有很大的关系
3、master持久化对于主从架构的安全保障的意义
如果采用了主从架构,那么建议必须开启master node的持久化!
不建议用slave node作为master node的数据热备,因为那样的话,如果你关掉master的持久化,可能在master宕机重启的时候数据是空的,然后可能一经过复制,salve node数据也丢了
master -> RDB和AOF都关闭了 -> 全部在内存中
master宕机,重启,是没有本地数据可以恢复的,然后就会直接认为自己IDE数据是空的
master就会将空的数据集同步到slave上去,所有slave的数据全部清空
100%的数据丢失
master节点,必须要使用持久化机制
第二个,master的各种备份方案,要不要做,万一说本地的所有文件丢失了; 从备份中挑选一份rdb去恢复master; 这样才能确保master启动的时候,是有数据的
即使采用了后续讲解的高可用机制,slave node可以自动接管master node,但是也可能sentinal还没有检测到master failure,master node就自动重启了,还是可能导致上面的所有slave node数据清空故障
课程大纲
1、主从架构的核心原理
当启动一个slave node的时候,它会发送一个PSYNC命令给master node
如果这是slave node重新连接master node,那么master node仅仅会复制给slave部分缺少的数据; 否则如果是slave node第一次连接master node,那么会触发一次full resynchronization
开始full resynchronization的时候,master会启动一个后台线程,开始生成一份RDB快照文件,同时还会将从客户端收到的所有写命令缓存在内存中。RDB文件生成完毕之后,master会将这个RDB发送给slave,slave会先写入本地磁盘,然后再从本地磁盘加载到内存中。然后master会将内存中缓存的写命令发送给slave,slave也会同步这些数据。
slave node如果跟master node有网络故障,断开了连接,会自动重连。master如果发现有多个slave node都来重新连接,仅仅会启动一个rdb save操作,用一份数据服务所有slave node。
2、主从复制的断点续传
从redis 2.8开始,就支持主从复制的断点续传,如果主从复制过程中,网络连接断掉了,那么可以接着上次复制的地方,继续复制下去,而不是从头开始复制一份
master node会在内存中常见一个backlog,master和slave都会保存一个replica offset还有一个master id,offset就是保存在backlog中的。如果master和slave网络连接断掉了,slave会让master从上次的replica offset开始继续复制
但是如果没有找到对应的offset,那么就会执行一次resynchronization
3、无磁盘化复制
master在内存中直接创建rdb,然后发送给slave,不会在自己本地落地磁盘了
repl-diskless-sync repl-diskless-sync-delay,等待一定时长再开始复制,因为要等更多slave重新连接过来
4、过期key处理
slave不会过期key,只会等待master过期key。如果master过期了一个key,或者通过LRU淘汰了一个key,那么会模拟一条del命令发送给slave。
1、复制的完整流程
(1)slave node启动,仅仅保存master node的信息,包括master node的host和ip,但是复制流程没开始
master host和ip是从哪儿来的,redis.conf里面的slaveof配置的
(2)slave node内部有个定时任务,每秒检查是否有新的master node要连接和复制,如果发现,就跟master node建立socket网络连接 (3)slave node发送ping命令给master node (4)口令认证,如果master设置了requirepass,那么salve node必须发送masterauth的口令过去进行认证 (5)master node第一次执行全量复制,将所有数据发给slave node (6)master node后续持续将写命令,异步复制给slave node
2、数据同步相关的核心机制
指的就是第一次slave连接msater的时候,执行的全量复制,那个过程里面你的一些细节的机制
(1)master和slave都会维护一个offset
master会在自身不断累加offset,slave也会在自身不断累加offset slave每秒都会上报自己的offset给master,同时master也会保存每个slave的offset
这个倒不是说特定就用在全量复制的,主要是master和slave都要知道各自的数据的offset,才能知道互相之间的数据不一致的情况
(2)backlog
master node有一个backlog,默认是1MB大小 master node给slave node复制数据时,也会将数据在backlog中同步写一份 backlog主要是用来做全量复制中断候的增量复制的
(3)master run id
info server,可以看到master run id 如果根据host+ip定位master node,是不靠谱的,如果master node重启或者数据出现了变化,那么slave node应该根据不同的run id区分,run id不同就做全量复制 如果需要不更改run id重启redis,可以使用redis-cli debug reload命令
(4)psync
从节点使用psync从master node进行复制,psync runid offset master node会根据自身的情况返回响应信息,可能是FULLRESYNC runid offset触发全量复制,可能是CONTINUE触发增量复制
3、全量复制
(1)master执行bgsave,在本地生成一份rdb快照文件 (2)master node将rdb快照文件发送给salve node,如果rdb复制时间超过60秒(repl-timeout),那么slave node就会认为复制失败,可以适当调节大这个参数 (3)对于千兆网卡的机器,一般每秒传输100MB,6G文件,很可能超过60s (4)master node在生成rdb时,会将所有新的写命令缓存在内存中,在salve node保存了rdb之后,再将新的写命令复制给salve node (5)client-output-buffer-limit slave 256MB 64MB 60,如果在复制期间,内存缓冲区持续消耗超过64MB,或者一次性超过256MB,那么停止复制,复制失败 (6)slave node接收到rdb之后,清空自己的旧数据,然后重新加载rdb到自己的内存中,同时基于旧的数据版本对外提供服务 (7)如果slave node开启了AOF,那么会立即执行BGREWRITEAOF,重写AOF
rdb生成、rdb通过网络拷贝、slave旧数据的清理、slave aof rewrite,很耗费时间
如果复制的数据量在4G~6G之间,那么很可能全量复制时间消耗到1分半到2分钟
4、增量复制
(1)如果全量复制过程中,master-slave网络连接断掉,那么salve重新连接master时,会触发增量复制 (2)master直接从自己的backlog中获取部分丢失的数据,发送给slave node,默认backlog就是1MB (3)msater就是根据slave发送的psync中的offset来从backlog中获取数据的
5、heartbeat
主从节点互相都会发送heartbeat信息
master默认每隔10秒发送一次heartbeat,salve node每隔1秒发送一个heartbeat
6、异步复制
master每次接收到写命令之后,现在内部写入数据,然后异步发送给slave node
1、哨兵的介绍
sentinal,中文名是哨兵
哨兵是redis集群架构中非常重要的一个组件,主要功能如下
(1)集群监控,负责监控redis master和slave进程是否正常工作 (2)消息通知,如果某个redis实例有故障,那么哨兵负责发送消息作为报警通知给管理员 (3)故障转移,如果master node挂掉了,会自动转移到slave node上 (4)配置中心,如果故障转移发生了,通知client客户端新的master地址
哨兵本身也是分布式的,作为一个哨兵集群去运行,互相协同工作
(1)故障转移时,判断一个master node是宕机了,需要大部分的哨兵都同意才行,涉及到了分布式选举的问题 (2)即使部分哨兵节点挂掉了,哨兵集群还是能正常工作的,因为如果一个作为高可用机制重要组成部分的故障转移系统本身是单点的,那就很坑爹了
目前采用的是sentinal 2版本,sentinal 2相对于sentinal 1来说,重写了很多代码,主要是让故障转移的机制和算法变得更加健壮和简单
2、哨兵的核心知识
(1)哨兵至少需要3个实例,来保证自己的健壮性 (2)哨兵 + redis主从的部署架构,是不会保证数据零丢失的,只能保证redis集群的高可用性 (3)对于哨兵 + redis主从这种复杂的部署架构,尽量在测试环境和生产环境,都进行充足的测试和演练
3、为什么redis哨兵集群只有2个节点无法正常工作?
哨兵集群必须部署2个以上节点
如果哨兵集群仅仅部署了个2个哨兵实例,quorum=1
+----+ +----+ | M1 |---------| R1 | | S1 | | S2 | +----+ +----+
Configuration: quorum = 1
master宕机,s1和s2中只要有1个哨兵认为master宕机就可以还行切换,同时s1和s2中会选举出一个哨兵来执行故障转移
同时这个时候,需要majority,也就是大多数哨兵都是运行的,2个哨兵的majority就是2(2的majority=2,3的majority=2,5的majority=3,4的majority=2),2个哨兵都运行着,就可以允许执行故障转移
但是如果整个M1和S1运行的机器宕机了,那么哨兵只有1个了,此时就没有majority来允许执行故障转移,虽然另外一台机器还有一个R1,但是故障转移不会执行
4、经典的3节点哨兵集群
   +----+
   | M1 |
   | S1 |
   +----+
      |
+----+ | +----+ | R2 |----+----| R3 | | S2 | | S3 | +----+ +----+
Configuration: quorum = 2,majority
如果M1所在机器宕机了,那么三个哨兵还剩下2个,S2和S3可以一致认为master宕机,然后选举出一个来执行故障转移
同时3个哨兵的majority是2,所以还剩下的2个哨兵运行着,就可以允许执行故障转移
课程大纲
1、两种数据丢失的情况 2、解决异步复制和脑裂导致的数据丢失
1、两种数据丢失的情况
主备切换的过程,可能会导致数据丢失
(1)异步复制导致的数据丢失
因为master -> slave的复制是异步的,所以可能有部分数据还没复制到slave,master就宕机了,此时这些部分数据就丢失了
(2)脑裂导致的数据丢失
脑裂,也就是说,某个master所在机器突然脱离了正常的网络,跟其他slave机器不能连接,但是实际上master还运行着
此时哨兵可能就会认为master宕机了,然后开启选举,将其他slave切换成了master
这个时候,集群里就会有两个master,也就是所谓的脑裂
此时虽然某个slave被切换成了master,但是可能client还没来得及切换到新的master,还继续写向旧master的数据可能也丢失了
因此旧master再次恢复的时候,会被作为一个slave挂到新的master上去,自己的数据会清空,重新从新的master复制数据
2、解决异步复制和脑裂导致的数据丢失
min-slaves-to-write 1 min-slaves-max-lag 10
要求至少有1个slave,数据复制和同步的延迟不能超过10秒
如果说一旦所有的slave,数据复制和同步的延迟都超过了10秒钟,那么这个时候,master就不会再接收任何请求了
上面两个配置可以减少异步复制和脑裂导致的数据丢失
(1)减少异步复制的数据丢失
有了min-slaves-max-lag这个配置,就可以确保说,一旦slave复制数据和ack延时太长,就认为可能master宕机后损失的数据太多了,那么就拒绝写请求,这样可以把master宕机时由于部分数据未同步到slave导致的数据丢失降低的可控范围内
(2)减少脑裂的数据丢失
如果一个master出现了脑裂,跟其他slave丢了连接,那么上面两个配置可以确保说,如果不能继续给指定数量的slave发送数据,而且slave超过10秒没有给自己ack消息,那么就直接拒绝客户端的写请求
这样脑裂后的旧master就不会接受client的新数据,也就避免了数据丢失
上面的配置就确保了,如果跟任何一个slave丢了连接,在10秒后发现没有slave给自己ack,那么就拒绝新的写请求
因此在脑裂场景下,最多就丢失10秒的数据
1、sdown和odown转换机制
sdown和odown两种失败状态
sdown是主观宕机,就一个哨兵如果自己觉得一个master宕机了,那么就是主观宕机
odown是客观宕机,如果quorum数量的哨兵都觉得一个master宕机了,那么就是客观宕机
sdown达成的条件很简单,如果一个哨兵ping一个master,超过了is-master-down-after-milliseconds指定的毫秒数之后,就主观认为master宕机
sdown到odown转换的条件很简单,如果一个哨兵在指定时间内,收到了quorum指定数量的其他哨兵也认为那个master是sdown了,那么就认为是odown了,客观认为master宕机
2、哨兵集群的自动发现机制
哨兵互相之间的发现,是通过redis的pub/sub系统实现的,每个哨兵都会往__sentinel__:hello这个channel里发送一个消息,这时候所有其他哨兵都可以消费到这个消息,并感知到其他的哨兵的存在
每隔两秒钟,每个哨兵都会往自己监控的某个master+slaves对应的__sentinel__:hello channel里发送一个消息,内容是自己的host、ip和runid还有对这个master的监控配置
每个哨兵也会去监听自己监控的每个master+slaves对应的__sentinel__:hello channel,然后去感知到同样在监听这个master+slaves的其他哨兵的存在
每个哨兵还会跟其他哨兵交换对master的监控配置,互相进行监控配置的同步
3、slave配置的自动纠正
哨兵会负责自动纠正slave的一些配置,比如slave如果要成为潜在的master候选人,哨兵会确保slave在复制现有master的数据; 如果slave连接到了一个错误的master上,比如故障转移之后,那么哨兵会确保它们连接到正确的master上
4、slave->master选举算法
如果一个master被认为odown了,而且majority哨兵都允许了主备切换,那么某个哨兵就会执行主备切换操作,此时首先要选举一个slave来
会考虑slave的一些信息
(1)跟master断开连接的时长 (2)slave优先级 (3)复制offset (4)run id
如果一个slave跟master断开连接已经超过了down-after-milliseconds的10倍,外加master宕机的时长,那么slave就被认为不适合选举为master
(down-after-milliseconds * 10) + milliseconds_since_master_is_in_SDOWN_state
接下来会对slave进行排序
(1)按照slave优先级进行排序,slave priority越低,优先级就越高 (2)如果slave priority相同,那么看replica offset,哪个slave复制了越多的数据,offset越靠后,优先级就越高 (3)如果上面两个条件都相同,那么选择一个run id比较小的那个slave
5、quorum和majority
每次一个哨兵要做主备切换,首先需要quorum数量的哨兵认为odown,然后选举出一个哨兵来做切换,这个哨兵还得得到majority哨兵的授权,才能正式执行切换
如果quorum < majority,比如5个哨兵,majority就是3,quorum设置为2,那么就3个哨兵授权就可以执行切换
但是如果quorum >= majority,那么必须quorum数量的哨兵都授权,比如5个哨兵,quorum是5,那么必须5个哨兵都同意授权,才能执行切换
6、configuration epoch
哨兵会对一套redis master+slave进行监控,有相应的监控的配置
执行切换的那个哨兵,会从要切换到的新master(salve->master)那里得到一个configuration epoch,这就是一个version号,每次切换的version号都必须是唯一的
如果第一个选举出的哨兵切换失败了,那么其他哨兵,会等待failover-timeout时间,然后接替继续执行切换,此时会重新获取一个新的configuration epoch,作为新的version号
7、configuraiton传播
哨兵完成切换之后,会在自己本地更新生成最新的master配置,然后同步给其他的哨兵,就是通过之前说的pub/sub消息机制
这里之前的version号就很重要了,因为各种消息都是通过一个channel去发布和监听的,所以一个哨兵完成一次新的切换之后,新的master配置是跟着新的version号的
其他的哨兵都是根据版本号的大小来更新自己的master配置的
redis的持久化有哪几种方式?不同的持久化机制都有什么优缺点?持久化机制具体底层是如何实现的?
课程大纲
1、故障发生的时候会怎么样 2、如何应对故障的发生
很多同学,自己也看过一些redis的资料和书籍,当然可能也看过一些redis视频课程
所有的资料,其实都会讲解redis持久化,但是有个问题,我到目前为止,没有看到有人很仔细的去讲解,redis的持久化意义
redis的持久化,RDB,AOF,区别,各自的特点是什么,适合什么场景
redis的企业级的持久化方案是什么,是用来跟哪些企业级的场景结合起来使用的???
redis持久化的意义,在于故障恢复
比如你部署了一个redis,作为cache缓存,当然也可以保存一些较为重要的数据
如果没有持久化的话,redis遇到灾难性故障的时候,就会丢失所有的数据
如果通过持久化将数据搞一份儿在磁盘上去,然后定期比如说同步和备份到一些云存储服务上去,那么就可以保证数据不丢失全部,还是可以恢复一部分数据回来的
课程大纲
1、RDB和AOF两种持久化机制的介绍 2、RDB持久化机制的优点 3、RDB持久化机制的缺点 4、AOF持久化机制的优点 5、AOF持久化机制的缺点 6、RDB和AOF到底该如何选择
我们已经知道对于一个企业级的redis架构来说,持久化是不可减少的
企业级redis集群架构:海量数据、高并发、高可用
持久化主要是做灾难恢复,数据恢复,也可以归类到高可用的一个环节里面去
比如你redis整个挂了,然后redis就不可用了,你要做的事情是让redis变得可用,尽快变得可用
重启redis,尽快让它对外提供服务,但是就像上一讲说,如果你没做数据备份,这个时候redis启动了,也不可用啊,数据都没了
很可能说,大量的请求过来,缓存全部无法命中,在redis里根本找不到数据,这个时候就死定了,缓存雪崩问题,所有请求,没有在redis命中,就会去mysql数据库这种数据源头中去找,一下子mysql承接高并发,然后就挂了
mysql挂掉,你都没法去找数据恢复到redis里面去,redis的数据从哪儿来?从mysql来。。。
具体的完整的缓存雪崩的场景,还有企业级的解决方案,到后面讲
如果你把redis的持久化做好,备份和恢复方案做到企业级的程度,那么即使你的redis故障了,也可以通过备份数据,快速恢复,一旦恢复立即对外提供服务
redis的持久化,跟高可用,是有关系的,企业级redis架构中去讲解
redis持久化:RDB,AOF
1、RDB和AOF两种持久化机制的介绍
RDB持久化机制,对redis中的数据执行周期性的持久化
AOF机制对每条写入命令作为日志,以append-only的模式写入一个日志文件中,在redis重启的时候,可以通过回放AOF日志中的写入指令来重新构建整个数据集
如果我们想要redis仅仅作为纯内存的缓存来用,那么可以禁止RDB和AOF所有的持久化机制
通过RDB或AOF,都可以将redis内存中的数据给持久化到磁盘上面来,然后可以将这些数据备份到别的地方去,比如说阿里云,云服务
如果redis挂了,服务器上的内存和磁盘上的数据都丢了,可以从云服务上拷贝回来之前的数据,放到指定的目录中,然后重新启动redis,redis就会自动根据持久化数据文件中的数据,去恢复内存中的数据,继续对外提供服务
如果同时使用RDB和AOF两种持久化机制,那么在redis重启的时候,会使用AOF来重新构建数据,因为AOF中的数据更加完整
2、RDB持久化机制的优点
(1)RDB会生成多个数据文件,每个数据文件都代表了某一个时刻中redis的数据,这种多个数据文件的方式,非常适合做冷备,可以将这种完整的数据文件发送到一些远程的安全存储上去,比如说Amazon的S3云服务上去,在国内可以是阿里云的ODPS分布式存储上,以预定好的备份策略来定期备份redis中的数据
(2)RDB对redis对外提供的读写服务,影响非常小,可以让redis保持高性能,因为redis主进程只需要fork一个子进程,让子进程执行磁盘IO操作来进行RDB持久化即可
(3)相对于AOF持久化机制来说,直接基于RDB数据文件来重启和恢复redis进程,更加快速
3、RDB持久化机制的缺点
(1)如果想要在redis故障时,尽可能少的丢失数据,那么RDB没有AOF好。一般来说,RDB数据快照文件,都是每隔5分钟,或者更长时间生成一次,这个时候就得接受一旦redis进程宕机,那么会丢失最近5分钟的数据
(2)RDB每次在fork子进程来执行RDB快照数据文件生成的时候,如果数据文件特别大,可能会导致对客户端提供的服务暂停数毫秒,或者甚至数秒
4、AOF持久化机制的优点
(1)AOF可以更好的保护数据不丢失,一般AOF会每隔1秒,通过一个后台线程执行一次fsync操作,最多丢失1秒钟的数据
(2)AOF日志文件以append-only模式写入,所以没有任何磁盘寻址的开销,写入性能非常高,而且文件不容易破损,即使文件尾部破损,也很容易修复
(3)AOF日志文件即使过大的时候,出现后台重写操作,也不会影响客户端的读写。因为在rewrite log的时候,会对其中的指导进行压缩,创建出一份需要恢复数据的最小日志出来。再创建新日志文件的时候,老的日志文件还是照常写入。当新的merge后的日志文件ready的时候,再交换新老日志文件即可。
(4)AOF日志文件的命令通过非常可读的方式进行记录,这个特性非常适合做灾难性的误删除的紧急恢复。比如某人不小心用flushall命令清空了所有数据,只要这个时候后台rewrite还没有发生,那么就可以立即拷贝AOF文件,将最后一条flushall命令给删了,然后再将该AOF文件放回去,就可以通过恢复机制,自动恢复所有数据
5、AOF持久化机制的缺点
(1)对于同一份数据来说,AOF日志文件通常比RDB数据快照文件更大
(2)AOF开启后,支持的写QPS会比RDB支持的写QPS低,因为AOF一般会配置成每秒fsync一次日志文件,当然,每秒一次fsync,性能也还是很高的
(3)以前AOF发生过bug,就是通过AOF记录的日志,进行数据恢复的时候,没有恢复一模一样的数据出来。所以说,类似AOF这种较为复杂的基于命令日志/merge/回放的方式,比基于RDB每次持久化一份完整的数据快照文件的方式,更加脆弱一些,容易有bug。不过AOF就是为了避免rewrite过程导致的bug,因此每次rewrite并不是基于旧的指令日志进行merge的,而是基于当时内存中的数据进行指令的重新构建,这样健壮性会好很多。
6、RDB和AOF到底该如何选择
(1)不要仅仅使用RDB,因为那样会导致你丢失很多数据
(2)也不要仅仅使用AOF,因为那样有两个问题,第一,你通过AOF做冷备,没有RDB做冷备,来的恢复速度更快; 第二,RDB每次简单粗暴生成数据快照,更加健壮,可以避免AOF这种复杂的备份和恢复机制的bug
(3)综合使用AOF和RDB两种持久化机制,用AOF来保证数据不丢失,作为数据恢复的第一选择; 用RDB来做不同程度的冷备,在AOF文件都丢失或损坏不可用的时候,还可以使用RDB来进行快速的数据恢复
redis集群模式的工作原理能说一下么?在集群模式下,redis的key是如何寻址的?分布式寻址都有哪些算法?了解一致性hash算法吗?
讲解分布式数据存储的核心算法,数据分布的算法
hash算法 -> 一致性hash算法(memcached) -> redis cluster,hash slot算法
用不同的算法,就决定了在多个master节点的时候,数据如何分布到这些节点上去,解决这个问题
1、redis cluster介绍
redis cluster
(1)自动将数据进行分片,每个master上放一部分数据 (2)提供内置的高可用支持,部分master不可用时,还是可以继续工作的
在redis cluster架构下,每个redis要放开两个端口号,比如一个是6379,另外一个就是加10000的端口号,比如16379
16379端口号是用来进行节点间通信的,也就是cluster bus的东西,集群总线。cluster bus的通信,用来进行故障检测,配置更新,故障转移授权
cluster bus用了另外一种二进制的协议,主要用于节点间进行高效的数据交换,占用更少的网络带宽和处理时间
2、最老土的hash算法和弊端(大量缓存重建)

3、一致性hash算法(自动缓存迁移)+虚拟节点(自动负载均衡)

4、redis cluster的hash slot算法

redis cluster有固定的16384个hash slot,对每个key计算CRC16值,然后对16384取模,可以获取key对应的hash slot
redis cluster中每个master都会持有部分slot,比如有3个master,那么可能每个master持有5000多个hash slot
hash slot让node的增加和移除很简单,增加一个master,就将其他master的hash slot移动部分过去,减少一个master,就将它的hash slot移动到其他master上去
移动hash slot的成本是非常低的
客户端的api,可以对指定的数据,让他们走同一个hash slot,通过hash tag来实现
一、节点间的内部通信机制
1、基础通信原理

(1)redis cluster节点间采取gossip协议进行通信
跟集中式不同,不是将集群元数据(节点信息,故障,等等)集中存储在某个节点上,而是互相之间不断通信,保持整个集群所有节点的数据是完整的
维护集群的元数据用得,集中式,一种叫做gossip
集中式:好处在于,元数据的更新和读取,时效性非常好,一旦元数据出现了变更,立即就更新到集中式的存储中,其他节点读取的时候立即就可以感知到; 不好在于,所有的元数据的跟新压力全部集中在一个地方,可能会导致元数据的存储有压力
gossip:好处在于,元数据的更新比较分散,不是集中在一个地方,更新请求会陆陆续续,打到所有节点上去更新,有一定的延时,降低了压力; 缺点,元数据更新有延时,可能导致集群的一些操作会有一些滞后
我们刚才做reshard,去做另外一个操作,会发现说,configuration error,达成一致
(2)10000端口
每个节点都有一个专门用于节点间通信的端口,就是自己提供服务的端口号+10000,比如7001,那么用于节点间通信的就是17001端口
每隔节点每隔一段时间都会往另外几个节点发送ping消息,同时其他几点接收到ping之后返回pong
(3)交换的信息
故障信息,节点的增加和移除,hash slot信息,等等
2、gossip协议
gossip协议包含多种消息,包括ping,pong,meet,fail,等等
meet: 某个节点发送meet给新加入的节点,让新节点加入集群中,然后新节点就会开始与其他节点进行通信
redis-trib.rb add-node
其实内部就是发送了一个gossip meet消息,给新加入的节点,通知那个节点去加入我们的集群
ping: 每个节点都会频繁给其他节点发送ping,其中包含自己的状态还有自己维护的集群元数据,互相通过ping交换元数据
每个节点每秒都会频繁发送ping给其他的集群,ping,频繁的互相之间交换数据,互相进行元数据的更新
pong: 返回ping和meet,包含自己的状态和其他信息,也可以用于信息广播和更新
fail: 某个节点判断另一个节点fail之后,就发送fail给其他节点,通知其他节点,指定的节点宕机了
3、ping消息深入
ping很频繁,而且要携带一些元数据,所以可能会加重网络负担
每个节点每秒会执行10次ping,每次会选择5个最久没有通信的其他节点
当然如果发现某个节点通信延时达到了cluster_node_timeout / 2,那么立即发送ping,避免数据交换延时过长,落后的时间太长了
比如说,两个节点之间都10分钟没有交换数据了,那么整个集群处于严重的元数据不一致的情况,就会有问题
所以cluster_node_timeout可以调节,如果调节比较大,那么会降低发送的频率
每次ping,一个是带上自己节点的信息,还有就是带上1/10其他节点的信息,发送出去,进行数据交换
至少包含3个其他节点的信息,最多包含总节点-2个其他节点的信息
二、面向集群的jedis内部实现原理
开发,jedis,redis的java client客户端,redis cluster,jedis cluster api
jedis cluster api与redis cluster集群交互的一些基本原理
1、基于重定向的客户端
redis-cli -c,自动重定向
(1)请求重定向
客户端可能会挑选任意一个redis实例去发送命令,每个redis实例接收到命令,都会计算key对应的hash slot
如果在本地就在本地处理,否则返回moved给客户端,让客户端进行重定向
cluster keyslot mykey,可以查看一个key对应的hash slot是什么
用redis-cli的时候,可以加入-c参数,支持自动的请求重定向,redis-cli接收到moved之后,会自动重定向到对应的节点执行命令
(2)计算hash slot
计算hash slot的算法,就是根据key计算CRC16值,然后对16384取模,拿到对应的hash slot
用hash tag可以手动指定key对应的slot,同一个hash tag下的key,都会在一个hash slot中,比如set mykey1:{100}和set mykey2:{100}
(3)hash slot查找
节点间通过gossip协议进行数据交换,就知道每个hash slot在哪个节点上
2、smart jedis
(1)什么是smart jedis
基于重定向的客户端,很消耗网络IO,因为大部分情况下,可能都会出现一次请求重定向,才能找到正确的节点
所以大部分的客户端,比如java redis客户端,就是jedis,都是smart的
本地维护一份hashslot -> node的映射表,缓存,大部分情况下,直接走本地缓存就可以找到hashslot -> node,不需要通过节点进行moved重定向
(2)JedisCluster的工作原理
在JedisCluster初始化的时候,就会随机选择一个node,初始化hashslot -> node映射表,同时为每个节点创建一个JedisPool连接池
每次基于JedisCluster执行操作,首先JedisCluster都会在本地计算key的hashslot,然后在本地映射表找到对应的节点
如果那个node正好还是持有那个hashslot,那么就ok; 如果说进行了reshard这样的操作,可能hashslot已经不在那个node上了,就会返回moved
如果JedisCluter API发现对应的节点返回moved,那么利用该节点的元数据,更新本地的hashslot -> node映射表缓存
重复上面几个步骤,直到找到对应的节点,如果重试超过5次,那么就报错,JedisClusterMaxRedirectionException
jedis老版本,可能会出现在集群某个节点故障还没完成自动切换恢复时,频繁更新hash slot,频繁ping节点检查活跃,导致大量网络IO开销
jedis最新版本,对于这些过度的hash slot更新和ping,都进行了优化,避免了类似问题
(3)hashslot迁移和ask重定向
如果hash slot正在迁移,那么会返回ask重定向给jedis
jedis接收到ask重定向之后,会重新定位到目标节点去执行,但是因为ask发生在hash slot迁移过程中,所以JedisCluster API收到ask是不会更新hashslot本地缓存
已经可以确定说,hashslot已经迁移完了,moved是会更新本地hashslot->node映射表缓存的
三、高可用性与主备切换原理
redis cluster的高可用的原理,几乎跟哨兵是类似的
1、判断节点宕机
如果一个节点认为另外一个节点宕机,那么就是pfail,主观宕机
如果多个节点都认为另外一个节点宕机了,那么就是fail,客观宕机,跟哨兵的原理几乎一样,sdown,odown
在cluster-node-timeout内,某个节点一直没有返回pong,那么就被认为pfail
如果一个节点认为某个节点pfail了,那么会在gossip ping消息中,ping给其他节点,如果超过半数的节点都认为pfail了,那么就会变成fail
2、从节点过滤
对宕机的master node,从其所有的slave node中,选择一个切换成master node
检查每个slave node与master node断开连接的时间,如果超过了cluster-node-timeout * cluster-slave-validity-factor,那么就没有资格切换成master
这个也是跟哨兵是一样的,从节点超时过滤的步骤
3、从节点选举
哨兵:对所有从节点进行排序,slave priority,offset,run id
每个从节点,都根据自己对master复制数据的offset,来设置一个选举时间,offset越大(复制数据越多)的从节点,选举时间越靠前,优先进行选举
所有的master node开始slave选举投票,给要进行选举的slave进行投票,如果大部分master node(N/2 + 1)都投票给了某个从节点,那么选举通过,那个从节点可以切换成master
从节点执行主备切换,从节点切换为主节点
4、与哨兵比较
整个流程跟哨兵相比,非常类似,所以说,redis cluster功能强大,直接集成了replication和sentinal的功能
没有办法去给大家深入讲解redis底层的设计的细节,核心原理和设计的细节,那个除非单独开一门课,redis底层原理深度剖析,redis源码
对于咱们这个架构课来说,主要关注的是架构,不是底层的细节,对于架构来说,核心的原理的基本思路,是要梳理清晰的
了解什么是redis的雪崩和穿透?redis崩溃之后会怎么样?系统该如何应对这种情况?如何处理redis的穿透?
2、面试官心里分析
其实这是问到缓存必问的,因为缓存雪崩和穿透,那是缓存最大的两个问题,要么不出现,一旦出现就是致命性的问题。所以面试官一定会问你。
3、面试题剖析
缓存雪崩发生的现象 缓存雪崩的事前事中事后的解决方案

事前:redis高可用,主从+哨兵,redis cluster,避免全盘崩溃 事中:本地ehcache缓存 + hystrix限流&降级,避免MySQL被打死 事后:redis持久化,快速恢复缓存数据

缓存穿透的现象 缓存穿透的解决方法

如何保证缓存与数据库的双写一致性?
最经典的缓存+数据库读写的模式,cache aside pattern
1、Cache Aside Pattern
(1)读的时候,先读缓存,缓存没有的话,那么就读数据库,然后取出数据后放入缓存,同时返回响应
(2)更新的时候,先删除缓存,然后再更新数据库
2、为什么是删除缓存,而不是更新缓存呢?
原因很简单,很多时候,复杂点的缓存的场景,因为缓存有的时候,不简单是数据库中直接取出来的值
商品详情页的系统,修改库存,只是修改了某个表的某些字段,但是要真正把这个影响的最终的库存计算出来,可能还需要从其他表查询一些数据,然后进行一些复杂的运算,才能最终计算出
现在最新的库存是多少,然后才能将库存更新到缓存中去
比如可能更新了某个表的一个字段,然后其对应的缓存,是需要查询另外两个表的数据,并进行运算,才能计算出缓存最新的值的
更新缓存的代价是很高的
是不是说,每次修改数据库的时候,都一定要将其对应的缓存去跟新一份?也许有的场景是这样的,但是对于比较复杂的缓存数据计算的场景,就不是这样了
如果你频繁修改一个缓存涉及的多个表,那么这个缓存会被频繁的更新,频繁的更新缓存
但是问题在于,这个缓存到底会不会被频繁访问到???
举个例子,一个缓存涉及的表的字段,在1分钟内就修改了20次,或者是100次,那么缓存跟新20次,100次; 但是这个缓存在1分钟内就被读取了1次,有大量的冷数据
28法则,黄金法则,20%的数据,占用了80%的访问量
实际上,如果你只是删除缓存的话,那么1分钟内,这个缓存不过就重新计算一次而已,开销大幅度降低
每次数据过来,就只是删除缓存,然后修改数据库,如果这个缓存,在1分钟内只是被访问了1次,那么只有那1次,缓存是要被重新计算的,用缓存才去算缓存
其实删除缓存,而不是更新缓存,就是一个lazy计算的思想,不要每次都重新做复杂的计算,不管它会不会用到,而是让它到需要被使用的时候再重新计算
mybatis,hibernate,懒加载,思想
查询一个部门,部门带了一个员工的list,没有必要说每次查询部门,都里面的1000个员工的数据也同时查出来啊
80%的情况,查这个部门,就只是要访问这个部门的信息就可以了
先查部门,同时要访问里面的员工,那么这个时候只有在你要访问里面的员工的时候,才会去数据库里面查询1000个员工
1、最初级的缓存不一致问题以及解决方案
问题:先修改数据库,再删除缓存,如果删除缓存失败了,那么会导致数据库中是新数据,缓存中是旧数据,数据出现不一致
解决思路

先删除缓存,再修改数据库,如果删除缓存成功了,如果修改数据库失败了,那么数据库中是旧数据,缓存中是空的,那么数据不会不一致
因为读的时候缓存没有,则读数据库中旧数据,然后更新到缓存中

2、比较复杂的数据不一致问题分析

数据发生了变更,先删除了缓存,然后要去修改数据库,此时还没修改
一个请求过来,去读缓存,发现缓存空了,去查询数据库,查到了修改前的旧数据,放到了缓存中
数据变更的程序完成了数据库的修改
完了,数据库和缓存中的数据不一样了。。。。
3、为什么上亿流量高并发场景下,缓存会出现这个问题?
只有在对一个数据在并发的进行读写的时候,才可能会出现这种问题
其实如果说你的并发量很低的话,特别是读并发很低,每天访问量就1万次,那么很少的情况下,会出现刚才描述的那种不一致的场景
但是问题是,如果每天的是上亿的流量,每秒并发读是几万,每秒只要有数据更新的请求,就可能会出现上述的数据库+缓存不一致的情况
高并发了以后,问题是很多的
4、数据库与缓存更新与读取操作进行异步串行化

更新数据的时候,根据数据的唯一标识,将操作路由之后,发送到一个jvm内部的队列中
读取数据的时候,如果发现数据不在缓存中,那么将重新读取数据+更新缓存的操作,根据唯一标识路由之后,也发送同一个jvm内部的队列中
一个队列对应一个工作线程
每个工作线程串行拿到对应的操作,然后一条一条的执行
这样的话,一个数据变更的操作,先执行,删除缓存,然后再去更新数据库,但是还没完成更新
此时如果一个读请求过来,读到了空的缓存,那么可以先将缓存更新的请求发送到队列中,此时会在队列中积压,然后同步等待缓存更新完成
这里有一个优化点,一个队列中,其实多个更新缓存请求串在一起是没意义的,因此可以做过滤,如果发现队列中已经有一个更新缓存的请求了,那么就不用再放个更新请求操作进去了,直接等待前面的更新操作请求完成即可
待那个队列对应的工作线程完成了上一个操作的数据库的修改之后,才会去执行下一个操作,也就是缓存更新的操作,此时会从数据库中读取最新的值,然后写入缓存中
如果请求还在等待时间范围内,不断轮询发现可以取到值了,那么就直接返回; 如果请求等待的时间超过一定时长,那么这一次直接从数据库中读取当前的旧值
5、高并发的场景下,该解决方案要注意的问题
(1)读请求长时阻塞
由于读请求进行了非常轻度的异步化,所以一定要注意读超时的问题,每个读请求必须在超时时间范围内返回
该解决方案,最大的风险点在于说,可能数据更新很频繁,导致队列中积压了大量更新操作在里面,然后读请求会发生大量的超时,最后导致大量的请求直接走数据库
务必通过一些模拟真实的测试,看看更新数据的频繁是怎样的
另外一点,因为一个队列中,可能会积压针对多个数据项的更新操作,因此需要根据自己的业务情况进行测试,可能需要部署多个服务,每个服务分摊一些数据的更新操作
如果一个内存队列里居然会挤压100个商品的库存修改操作,每隔库存修改操作要耗费10ms区完成,那么最后一个商品的读请求,可能等待10 * 100 = 1000ms = 1s后,才能得到数据
这个时候就导致读请求的长时阻塞
一定要做根据实际业务系统的运行情况,去进行一些压力测试,和模拟线上环境,去看看最繁忙的时候,内存队列可能会挤压多少更新操作,可能会导致最后一个更新操作对应的读请求,会hang多少时间,如果读请求在200ms返回,如果你计算过后,哪怕是最繁忙的时候,积压10个更新操作,最多等待200ms,那还可以的
如果一个内存队列可能积压的更新操作特别多,那么你就要加机器,让每个机器上部署的服务实例处理更少的数据,那么每个内存队列中积压的更新操作就会越少
其实根据之前的项目经验,一般来说数据的写频率是很低的,因此实际上正常来说,在队列中积压的更新操作应该是很少的
针对读高并发,读缓存架构的项目,一般写请求相对读来说,是非常非常少的,每秒的QPS能到几百就不错了
一秒,500的写操作,5份,每200ms,就100个写操作
单机器,20个内存队列,每个内存队列,可能就积压5个写操作,每个写操作性能测试后,一般在20ms左右就完成
那么针对每个内存队列中的数据的读请求,也就最多hang一会儿,200ms以内肯定能返回了
写QPS扩大10倍,但是经过刚才的测算,就知道,单机支撑写QPS几百没问题,那么就扩容机器,扩容10倍的机器,10台机器,每个机器20个队列,200个队列
大部分的情况下,应该是这样的,大量的读请求过来,都是直接走缓存取到数据的
少量情况下,可能遇到读跟数据更新冲突的情况,如上所述,那么此时更新操作如果先入队列,之后可能会瞬间来了对这个数据大量的读请求,但是因为做了去重的优化,所以也就一个更新缓存的操作跟在它后面
等数据更新完了,读请求触发的缓存更新操作也完成,然后临时等待的读请求全部可以读到缓存中的数据
(2)读请求并发量过高
这里还必须做好压力测试,确保恰巧碰上上述情况的时候,还有一个风险,就是突然间大量读请求会在几十毫秒的延时hang在服务上,看服务能不能抗的住,需要多少机器才能抗住最大的极限情况的峰值
但是因为并不是所有的数据都在同一时间更新,缓存也不会同一时间失效,所以每次可能也就是少数数据的缓存失效了,然后那些数据对应的读请求过来,并发量应该也不会特别大
按1:99的比例计算读和写的请求,每秒5万的读QPS,可能只有500次更新操作
如果一秒有500的写QPS,那么要测算好,可能写操作影响的数据有500条,这500条数据在缓存中失效后,可能导致多少读请求,发送读请求到库存服务来,要求更新缓存
一般来说,1:1,1:2,1:3,每秒钟有1000个读请求,会hang在库存服务上,每个读请求最多hang多少时间,200ms就会返回
在同一时间最多hang住的可能也就是单机200个读请求,同时hang住
单机hang200个读请求,还是ok的
1:20,每秒更新500条数据,这500秒数据对应的读请求,会有20 * 500 = 1万
1万个读请求全部hang在库存服务上,就死定了
(3)多服务实例部署的请求路由
可能这个服务部署了多个实例,那么必须保证说,执行数据更新操作,以及执行缓存更新操作的请求,都通过nginx服务器路由到相同的服务实例上
(4)热点商品的路由问题,导致请求的倾斜
万一某个商品的读写请求特别高,全部打到相同的机器的相同的队列里面去了,可能造成某台机器的压力过大
就是说,因为只有在商品数据更新的时候才会清空缓存,然后才会导致读写并发,所以更新频率不是太高的话,这个问题的影响并不是特别大
但是的确可能某些机器的负载会高一些
redis的并发竞争问题是什么?如何解决这个问题?了解Redis事务的CAS方案吗?

生产环境中的redis是怎么部署的?
2、面试官心里分析
看看你了解不了解你们公司的redis生产集群的部署架构,如果你不了解,那么确实你就很失职了,你的redis是主从架构?集群架构?用了哪种集群方案?有没有做高可用保证?有没有开启持久化机制确保可以进行数据恢复?线上redis给几个G的内存?设置了哪些参数?压测后你们redis集群承载多少QPS?
兄弟,这些你必须是门儿清的,否则你确实是没好好思考过
3、面试题剖析
redis cluster,10台机器,5台机器部署了redis主实例,另外5台机器部署了redis的从实例,每个主实例挂了一个从实例,5个节点对外提供读写服务,每个节点的读写高峰qps可能可以达到每秒5万,5台机器最多是25万读写请求/s。
机器是什么配置?32G内存+8核CPU+1T磁盘,但是分配给redis进程的是10g内存,一般线上生产环境,redis的内存尽量不要超过10g,超过10g可能会有问题。
5台机器对外提供读写,一共有50g内存。
因为每个主实例都挂了一个从实例,所以是高可用的,任何一个主实例宕机,都会自动故障迁移,redis从实例会自动变成主实例继续提供读写服务
你往内存里写的是什么数据?每条数据的大小是多少?商品数据,每条数据是10kb。100条数据是1mb,10万条数据是1g。常驻内存的是200万条商品数据,占用内存是20g,仅仅不到总内存的50%。
目前高峰期每秒就是3500左右的请求量
比如我们吧,大型的公司,其实基础架构的team,会负责缓存集群的运维
Dubbo分布式系统
为什么要进行系统拆分?如何进行系统拆分?拆分后不用dubbo可以吗?
(1)为什么要将系统进行拆分?
网上查查,答案极度零散和复杂,很琐碎,原因一大坨。但是我这里给大家直观的感受:
1)要是不拆分,一个大系统几十万行代码,20个人维护一份代码,简直是悲剧啊。代码经常改着改着就冲突了,各种代码冲突和合并要处理,非常耗费时间;经常我改动了我的代码,你调用了我,导致你的代码也得重新测试,麻烦的要死;然后每次发布都是几十万行代码的系统一起发布,大家得一起提心吊胆准备上线,几十万行代码的上线,可能每次上线都要做很多的检查,很多异常问题的处理,简直是又麻烦又痛苦;而且如果我现在打算把技术升级到最新的spring版本,还不行,因为这可能导致你的代码报错,我不敢随意乱改技术。
假设一个系统是20万行代码,其中小A在里面改了1000行代码,但是此时发布的时候是这个20万行代码的大系统一块儿发布。就意味着20万上代码在线上就可能出现各种变化,20个人,每个人都要紧张地等在电脑面前,上线之后,检查日志,看自己负责的那一块儿有没有什么问题。
小A就检查了自己负责的1万行代码对应的功能,确保ok就闪人了;结果不巧的是,小A上线的时候不小心修改了线上机器的某个配置,导致另外小B和小C负责的2万行代码对应的一些功能,出错了
几十个人负责维护一个几十万行代码的单块应用,每次上线,准备几个礼拜,上线 -> 部署 -> 检查自己负责的功能
最近从2013年到现在,5年的时间里,2013年以前,基本上都是BAT的天下;2013年开始,有几个小巨头开始快速的发展,上市,几百亿美金,估值都几百亿美金;2015年,出现了除了BAT以外,又有几个互联网行业的小巨头出现。
BAT工作,在市值几百亿美金的小巨头工作
有某一个小巨头,现在估值几百亿美金的小巨头,5年前刚开始搞的时候,核心的业务,几十个人,维护一个单块的应用
维护单块的应用,在从0到1的环节里,是很合适的,因为那个时候,是系统都没上线,没什么技术挑战,大家有条不紊的开发。ssh + mysql + tomcat,可能会部署几台机器吧。
结果不行了,后来系统上线了,业务快速发展,10万用户 -> 100万用户 -> 1000万用户 -> 上亿用户了。
2)拆分了以后,整个世界清爽了,几十万行代码的系统,拆分成20个服务,平均每个服务就1~2万行代码,每个服务部署到单独的机器上。20个工程,20个git代码仓库里,20个码农,每个人维护自己的那个服务就可以了,是自己独立的代码,跟别人没关系。再也没有代码冲突了,爽。每次就测试我自己的代码就可以了,爽。每次就发布我自己的一个小服务就可以了,爽。技术上想怎么升级就怎么升级,保持接口不变就可以了,爽。
所以简单来说,一句话总结,如果是那种代码量多达几十万行的中大型项目,团队里有几十个人,那么如果不拆分系统,开发效率极其低下,问题很多。但是拆分系统之后,每个人就负责自己的一小部分就好了,可以随便玩儿随便弄。分布式系统拆分之后,可以大幅度提升复杂系统大型团队的开发效率。
但是同时,也要提醒的一点是,系统拆分成分布式系统之后,大量的分布式系统面临的问题也是接踵而来,所以后面的问题都是在围绕分布式系统带来的复杂技术挑战在说。
(2)如何进行系统拆分?
这个问题说大可以很大,可以扯到领域驱动模型设计上去,说小了也很小,我不太想给大家太过于学术的说法,因为你也不可能背这个答案,过去了直接说吧。还是说的简单一点,大家自己到时候知道怎么回答就行了。
系统拆分分布式系统,拆成多个服务,拆成微服务的架构,拆很多轮的。上来一个架构师第一轮就给拆好了,第一轮;团队继续扩大,拆好的某个服务,刚开始是1个人维护1万行代码,后来业务系统越来越复杂,这个服务是10万行代码,5个人;第二轮,1个服务 -> 5个服务,每个服务2万行代码,每人负责一个服务
如果是多人维护一个服务,<=3个人维护这个服务;最理想的情况下,几十个人,1个人负责1个或2~3个服务;某个服务工作量变大了,代码量越来越多,某个同学,负责一个服务,代码量变成了10万行了,他自己不堪重负,他现在一个人拆开,5个服务,1个人顶着,负责5个人,接着招人,2个人,给那个同学带着,3个人负责5个服务,其中2个人每个人负责2个服务,1个人负责1个服务
我个人建议,一个服务的代码不要太多,1万行左右,两三万撑死了吧
大部分的系统,是要进行多轮拆分的,第一次拆分,可能就是将以前的多个模块该拆分开来了,比如说将电商系统拆分成订单系统、商品系统、采购系统、仓储系统、用户系统,等等吧。
但是后面可能每个系统又变得越来越复杂了,比如说采购系统里面又分成了供应商管理系统、采购单管理系统,订单系统又拆分成了购物车系统、价格系统、订单管理系统。
扯深了实在很深,所以这里先给大家举个例子,你自己感受一下,核心意思就是根据情况,先拆分一轮,后面如果系统更复杂了,可以继续分拆。你根据自己负责系统的例子,来考虑一下就好了。
(3)拆分后不用dubbo可以吗?
当然可以了,大不了最次,就是各个系统之间,直接基于spring mvc,就纯http接口互相通信呗,还能咋样。但是这个肯定是有问题的,因为http接口通信维护起来成本很高,你要考虑超时重试、负载均衡等等各种乱七八糟的问题,比如说你的订单系统调用商品系统,商品系统部署了5台机器,你怎么把请求均匀地甩给那5台机器?这不就是负载均衡?你要是都自己搞那是可以的,但是确实很痛苦。
所以dubbo说白了,是一种rpc框架,就是本地就是进行接口调用,但是dubbo会代理这个调用请求,跟远程机器网络通信,给你处理掉负载均衡了、服务实例上下线自动感知了、超时重试了,等等乱七八糟的问题。那你就不用自己做了,用dubbo就可以了。
说一下的dubbo的工作原理?注册中心挂了可以继续通信吗?说说一次rpc请求的流程?
MQ、ES、Redis、Dubbo,上来先问你一些思考的问题,原理(kafka高可用架构原理、es分布式架构原理、redis线程模型原理、Dubbo工作原理),生产环境里可能会碰到的一些问题(每种技术引入之后生产环境都可能会碰到一些问题),系统设计(设计MQ,设计搜索引擎,设计一个缓存,设计rpc框架)
当然比如说,hard面试官,死扣,结合项目死扣细节,百度(深入底层,基础性),阿里(结合项目死扣细节,扣很深的技术底层),小米(数据结构和算法)。
(1)dubbo工作原理

第一层:service层,接口层,给服务提供者和消费者来实现的 第二层:config层,配置层,主要是对dubbo进行各种配置的 第三层:proxy层,服务代理层,透明生成客户端的stub和服务单的skeleton 第四层:registry层,服务注册层,负责服务的注册与发现 第五层:cluster层,集群层,封装多个服务提供者的路由以及负载均衡,将多个实例组合成一个服务 第六层:monitor层,监控层,对rpc接口的调用次数和调用时间进行监控 第七层:protocol层,远程调用层,封装rpc调用 第八层:exchange层,信息交换层,封装请求响应模式,同步转异步 第九层:transport层,网络传输层,抽象mina和netty为统一接口 第十层:serialize层,数据序列化层
工作流程:
1)第一步,provider向注册中心去注册 2)第二步,consumer从注册中心订阅服务,注册中心会通知consumer注册好的服务 3)第三步,consumer调用provider 4)第四步,consumer和provider都异步的通知监控中心
(2)注册中心挂了可以继续通信吗?
可以,因为刚开始初始化的时候,消费者会将提供者的地址等信息拉取到本地缓存,所以注册中心挂了可以继续通信
dubbo支持哪些通信协议?支持哪些序列化协议?
2、面试官心里分析
上一个问题,说说dubbo的基本工作原理,那是你必须知道的,至少知道dubbo分成哪些层,然后平时怎么发起rpc请求的,注册、发现、调用,这些是基本的。
接着就可以针对底层进行深入的问问了,比如第一步就可以先问问序列化协议这块,就是平时rpc的时候怎么走的?
3、面试题剖析
(1)dubbo支持不同的通信协议
1)dubbo协议
dubbo://192.168.0.1:20188
默认就是走dubbo协议的,单一长连接,NIO异步通信,基于hessian作为序列化协议
适用的场景就是:传输数据量很小(每次请求在100kb以内),但是并发量很高
为了要支持高并发场景,一般是服务提供者就几台机器,但是服务消费者有上百台,可能每天调用量达到上亿次!此时用长连接是最合适的,就是跟每个服务消费者维持一个长连接就可以,可能总共就100个连接。然后后面直接基于长连接NIO异步通信,可以支撑高并发请求。
否则如果上亿次请求每次都是短连接的话,服务提供者会扛不住。
而且因为走的是单一长连接,所以传输数据量太大的话,会导致并发能力降低。所以一般建议是传输数据量很小,支撑高并发访问。
2)rmi协议
走java二进制序列化,多个短连接,适合消费者和提供者数量差不多,适用于文件的传输,一般较少用
3)hessian协议
走hessian序列化协议,多个短连接,适用于提供者数量比消费者数量还多,适用于文件的传输,一般较少用
4)http协议
走json序列化
5)webservice
走SOAP文本序列化
(2)dubbo支持的序列化协议
所以dubbo实际基于不同的通信协议,支持hessian、java二进制序列化、json、SOAP文本序列化多种序列化协议。但是hessian是其默认的序列化协议。
dubbo负载均衡策略和集群容错策略都有哪些?动态代理策略呢?
2、面试官心里分析
继续深问吧,这些都是用dubbo必须知道的一些东西,你得知道基本原理,知道序列化是什么协议,还得知道具体用dubbo的时候,如何负载均衡,如何高可用,如何动态代理。
说白了,就是看你对dubbo熟悉不熟悉:
(1)dubbo工作原理:服务注册,注册中心,消费者,代理通信,负载均衡 (2)网络通信、序列化:dubbo协议,长连接,NIO,hessian序列化协议 (3)负载均衡策略,集群容错策略,动态代理策略:dubbo跑起来的时候一些功能是如何运转的,怎么做负载均衡?怎么做集群容错?怎么生成动态代理? (4)dubbo SPI机制:你了解不了解dubbo的SPI机制?如何基于SPI机制对dubbo进行扩展?
3、面试题剖析
(1)dubbo负载均衡策略
1)random loadbalance
默认情况下,dubbo是random load balance随机调用实现负载均衡,可以对provider不同实例设置不同的权重,会按照权重来负载均衡,权重越大分配流量越高,一般就用这个默认的就可以了。
2)roundrobin loadbalance
还有roundrobin loadbalance,这个的话默认就是均匀地将流量打到各个机器上去,但是如果各个机器的性能不一样,容易导致性能差的机器负载过高。所以此时需要调整权重,让性能差的机器承载权重小一些,流量少一些。
跟运维同学申请机器,有的时候,我们运气,正好公司资源比较充足,刚刚有一批热气腾腾,刚刚做好的一批虚拟机新鲜出炉,配置都比较高。8核+16g,机器,2台。过了一段时间,我感觉2台机器有点不太够,我去找运维同学,哥儿们,你能不能再给我1台机器,4核+8G的机器。我还是得要。
3)leastactive loadbalance
这个就是自动感知一下,如果某个机器性能越差,那么接收的请求越少,越不活跃,此时就会给不活跃的性能差的机器更少的请求
4)consistanthash loadbalance
一致性Hash算法,相同参数的请求一定分发到一个provider上去,provider挂掉的时候,会基于虚拟节点均匀分配剩余的流量,抖动不会太大。如果你需要的不是随机负载均衡,是要一类请求都到一个节点,那就走这个一致性hash策略。
(2)dubbo集群容错策略
1)failover cluster模式
失败自动切换,自动重试其他机器,默认就是这个,常见于读操作
2)failfast cluster模式 一次调用失败就立即失败,常见于写操作
3)failsafe cluster模式
出现异常时忽略掉,常用于不重要的接口调用,比如记录日志
4)failbackc cluster模式
失败了后台自动记录请求,然后定时重发,比较适合于写消息队列这种
5)forking cluster
并行调用多个provider,只要一个成功就立即返回
6)broadcacst cluster
逐个调用所有的provider
(3)dubbo动态代理策略
默认使用javassist动态字节码生成,创建代理类
但是可以通过spi扩展机制配置自己的动态代理策略
dubbo的spi思想是什么?
2、面试官心里分析
继续深入问呗,前面一些基础性的东西问完了,确定你应该都ok了解dubbo的一些基本东西,那么问个稍微难一点点的问题,就是spi,先问问你spi是啥?然后问问你dubbo的spi是怎么实现的?
其实就是看看你对dubbo的掌握如何
3、面试题剖析
spi,简单来说,就是service provider interface,说白了是什么意思呢,比如你有个接口,现在这个接口有3个实现类,那么在系统运行的时候对这个接口到底选择哪个实现类呢?这就需要spi了,需要根据指定的配置或者是默认的配置,去找到对应的实现类加载进来,然后用这个实现类的实例对象。
接口A -> 实现A1,实现A2,实现A3
配置一下,接口A = 实现A2
在系统实际运行的时候,会加载你的配置,用实现A2实例化一个对象来提供服务
比如说你要通过jar包的方式给某个接口提供实现,然后你就在自己jar包的META-INF/services/目录下放一个跟接口同名的文件,里面指定接口的实现里是自己这个jar包里的某个类。ok了,别人用了一个接口,然后用了你的jar包,就会在运行的时候通过你的jar包的那个文件找到这个接口该用哪个实现类。
这是jdk提供的一个功能。
比如说你有个工程A,有个接口A,接口A在工程A里是没有实现类的 -> 系统在运行的时候,怎么给接口A选择一个实现类呢?
你就可以自己搞一个jar包,META-INF/services/,放上一个文件,文件名就是接口名,接口A,接口A的实现类=com.zhss.service.实现类A2。让工程A来依赖你的这个jar包,然后呢在系统运行的时候,工程A跑起来,对接口A,就会扫描自己依赖的所有的jar包,在每个jar里找找,有没有META-INF/services文件夹,如果有,在里面找找,有没有接口A这个名字的文件,如果有在里面找一下你指定的接口A的实现是你的jar包里的哪个类?
SPI机制,一般来说用在哪儿?插件扩展的场景,比如说你开发的是一个给别人使用的开源框架,如果你想让别人自己写个插件,插到你的开源框架里面来,扩展某个功能。
经典的思想体现,大家平时都在用,比如说jdbc
java定义了一套jdbc的接口,但是java是没有提供jdbc的实现类
但是实际上项目跑的时候,要使用jdbc接口的哪些实现类呢?一般来说,我们要根据自己使用的数据库,比如msyql,你就将mysql-jdbc-connector.jar,引入进来;oracle,你就将oracle-jdbc-connector.jar,引入进来。
在系统跑的时候,碰到你使用jdbc的接口,他会在底层使用你引入的那个jar中提供的实现类
但是dubbo也用了spi思想,不过没有用jdk的spi机制,是自己实现的一套spi机制。
Protocol protocol = ExtensionLoader.getExtensionLoader(Protocol.class).getAdaptiveExtension();Protocol接口,dubbo要判断一下,在系统运行的时候,应该选用这个Protocol接口的哪个实现类来实例化对象来使用呢?
他会去找一个你配置的Protocol,他就会将你配置的Protocol实现类,加载到jvm中来,然后实例化对象,就用你的那个Protocol实现类就可以了
微内核,可插拔,大量的组件,Protocol负责rpc调用的东西,你可以实现自己的rpc调用组件,实现Protocol接口,给自己的一个实现类即可。
这行代码就是dubbo里大量使用的,就是对很多组件,都是保留一个接口和多个实现,然后在系统运行的时候动态根据配置去找到对应的实现类。如果你没配置,那就走默认的实现好了,没问题。
@SPI("dubbo")
public interface Protocol {

    int getDefaultPort();

    @Adaptive
    <T> Exporter<T> export(Invoker<T> invoker) throws RpcException;

    @Adaptive
    <T> Invoker<T> refer(Class<T> type, URL url) throws RpcException;

    void destroy();

}
在dubbo自己的jar里,在/META_INF/dubbo/internal/com.alibaba.dubbo.rpc.Protocol文件中:
dubbo=com.alibaba.dubbo.rpc.protocol.dubbo.DubboProtocol
http=com.alibaba.dubbo.rpc.protocol.http.HttpProtocol
hessian=com.alibaba.dubbo.rpc.protocol.hessian.HessianProtocol
所以说,这就看到了dubbo的spi机制默认是怎么玩儿的了,其实就是Protocol接口,@SPI(“dubbo”)说的是,通过SPI机制来提供实现类,实现类是通过dubbo作为默认key去配置文件里找到的,配置文件名称与接口全限定名一样的,通过dubbo作为key可以找到默认的实现了就是com.alibaba.dubbo.rpc.protocol.dubbo.DubboProtocol。
dubbo的默认网络通信协议,就是dubbo协议,用的DubboProtocol
如果想要动态替换掉默认的实现类,需要使用@Adaptive接口,Protocol接口中,有两个方法加了@Adaptive注解,就是说那俩接口会被代理实现。
啥意思呢?
比如这个Protocol接口搞了俩@Adaptive注解标注了方法,在运行的时候会针对Protocol生成代理类,这个代理类的那俩方法里面会有代理代码,代理代码会在运行的时候动态根据url中的protocol来获取那个key,默认是dubbo,你也可以自己指定,你如果指定了别的key,那么就会获取别的实现类的实例了。
通过这个url中的参数不通,就可以控制动态使用不同的组件实现类
好吧,那下面来说说怎么来自己扩展dubbo中的组件
自己写个工程,要是那种可以打成jar包的,里面的src/main/resources目录下,搞一个META-INF/services,里面放个文件叫:com.alibaba.dubbo.rpc.Protocol,文件里搞一个my=com.zhss.MyProtocol。自己把jar弄到nexus私服里去。
然后自己搞一个dubbo provider工程,在这个工程里面依赖你自己搞的那个jar,然后在spring配置文件里给个配置:
<dubbo:protocol name=”my” port=”20000” />这个时候provider启动的时候,就会加载到我们jar包里的my=com.zhss.MyProtocol这行配置里,接着会根据你的配置使用你定义好的MyProtocol了,这个就是简单说明一下,你通过上述方式,可以替换掉大量的dubbo内部的组件,就是扔个你自己的jar包,然后配置一下即可。
dubbo里面提供了大量的类似上面的扩展点,就是说,你如果要扩展一个东西,只要自己写个jar,让你的consumer或者是provider工程,依赖你的那个jar,在你的jar里指定目录下配置好接口名称对应的文件,里面通过key=实现类。
然后对对应的组件,用类似
如何基于dubbo进行服务治理、服务降级、失败重试以及超时重试?
2、面试官心里分析
服务治理,这个问题如果问你,其实就是看看你有没有服务治理的思想,因为这个是做过复杂微服务的人肯定会遇到的一个问题。
服务降级,这个是涉及到复杂分布式系统中必备的一个话题,因为分布式系统互相来回调用,任何一个系统故障了,你不降级,直接就全盘崩溃?那就太坑爹了吧
失败重试,分布式系统中网络请求如此频繁,要是因为网络问题不小心失败了一次,是不是要重试?
超时重试,同上,如果不小心网络慢一点,超时了,如何重试?
(1)dubbo工作原理:服务注册,注册中心,消费者,代理通信,负载均衡 (2)网络通信、序列化:dubbo协议,长连接,NIO,hessian序列化协议 (3)负载均衡策略,集群容错策略,动态代理策略:dubbo跑起来的时候一些功能是如何运转的,怎么做负载均衡?怎么做集群容错?怎么生成动态代理? (4)dubbo SPI机制:你了解不了解dubbo的SPI机制?如何基于SPI机制对dubbo进行扩展? (5)dubbo的服务治理、降级、重试
3、面试题剖析
(1)服务治理
1)调用链路自动生成
一个大型的分布式系统,或者说是用现在流行的微服务架构来说吧,分布式系统由大量的服务组成。那么这些服务之间互相是如何调用的?调用链路是啥?说实话,几乎到后面没人搞的清楚了,因为服务实在太多了,可能几百个甚至几千个服务。
那就需要基于dubbo做的分布式系统中,对各个服务之间的调用自动记录下来,然后自动将各个服务之间的依赖关系和调用链路生成出来,做成一张图,显示出来,大家才可以看到对吧。
服务A -> 服务B -> 服务C
           -> 服务E
  -> 服务D
           -> 服务F
 -> 服务W
2)服务访问压力以及时长统计
需要自动统计各个接口和服务之间的调用次数以及访问延时,而且要分成两个级别。一个级别是接口粒度,就是每个服务的每个接口每天被调用多少次,TP50,TP90,TP99,三个档次的请求延时分别是多少;第二个级别是从源头入口开始,一个完整的请求链路经过几十个服务之后,完成一次请求,每天全链路走多少次,全链路请求延时的TP50,TP90,TP99,分别是多少。
这些东西都搞定了之后,后面才可以来看当前系统的压力主要在哪里,如何来扩容和优化啊
3)其他的
服务分层(避免循环依赖),调用链路失败监控和报警,服务鉴权,每个服务的可用性的监控(接口调用成功率?几个9?)99.99%,99.9%,99%
(2)服务降级
比如说服务A调用服务B,结果服务B挂掉了,服务A重试几次调用服务B,还是不行,直接降级,走一个备用的逻辑,给用户返回响应
public interface HelloService {

   void sayHello();

}

public class HelloServiceImpl implements HelloService {

    public void sayHello() {
        System.out.println("hello world......");
    }

}
<?xml version="1.0" encoding="UTF-8"?>
<beans xmlns="http://www.springframework.org/schema/beans"
xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xmlns:dubbo="http://code.alibabatech.com/schema/dubbo"
xsi:schemaLocation="http://www.springframework.org/schema/beans http://www.springframework.org/schema/beans/spring-beans.xsd http://code.alibabatech.com/schema/dubbo http://code.alibabatech.com/schema/dubbo/dubbo.xsd">
<dubbo:application name="dubbo-provider" />
<dubbo:registry address="zookeeper://127.0.0.1:2181" />
<dubbo:protocol name="dubbo" port="20880" />
<dubbo:service interface="com.zhss.service.HelloService" ref="helloServiceImpl" timeout="10000" />
<bean id="helloServiceImpl" class="com.zhss.service.HelloServiceImpl" />
</beans><?xml version="1.0" encoding="UTF-8"?>
<beans xmlns="http://www.springframework.org/schema/beans"
xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
xmlns:dubbo="http://code.alibabatech.com/schema/dubbo"
xsi:schemaLocation="http://www.springframework.org/schema/beans http://www.springframework.org/schema/beans/spring-beans.xsd http://code.alibabatech.com/schema/dubbo http://code.alibabatech.com/schema/dubbo/dubbo.xsd">
<dubbo:application name="dubbo-consumer" />
<dubbo:registry address="zookeeper://127.0.0.1:2181" />
<dubbo:reference id="fooService" interface="com.test.service.FooService" timeout="10000" check="false" mock="return null">
</dubbo:reference>
</beans>现在就是mock,如果调用失败统一返回null
但是可以将mock修改为true,然后在跟接口同一个路径下实现一个Mock类,命名规则是接口名称加Mock后缀。然后在Mock类里实现自己的降级逻辑。
public class HelloServiceMock implements HelloService {

public void sayHello() {
// 降级逻辑
}

}
(3)失败重试和超时重试
所谓失败重试,就是consumer调用provider要是失败了,比如抛异常了,此时应该是可以重试的,或者调用超时了也可以重试。
<dubbo:reference id="xxxx" interface="xx" check="true" async="false" retries="3" timeout="2000"/>某个服务的接口,要耗费5s,你这边不能干等着,你这边配置了timeout之后,我等待2s,还没返回,我直接就撤了,不能干等你
如果是超时了,timeout就会设置超时时间;如果是调用失败了自动就会重试指定的次数
你就结合你们公司的具体的场景来说说你是怎么设置这些参数的,timeout,一般设置为200ms,我们认为不能超过200ms还没返回
retries,3次,设置retries,还一般是在读请求的时候,比如你要查询个数据,你可以设置个retries,如果第一次没读到,报错,重试指定的次数,尝试再次读取2次
分布式服务接口的幂等性如何设计(比如不能重复扣款)?
2、面试官心里分析
从这个问题开始,面试官就已经进入了实际的生产问题的面试了
一个分布式系统中的某个接口,要保证幂等性,该如何保证?这个事儿其实是你做分布式系统的时候必须要考虑的一个生产环境的技术问题。啥意思呢?
你看,假如你有个服务提供一个接口,结果这服务部署在了5台机器上,接着有个接口就是付款接口。然后人家用户在前端上操作的时候,不知道为啥,总之就是一个订单不小心发起了两次支付请求,然后这俩请求分散在了这个服务部署的不同的机器上,好了,结果一个订单扣款扣两次?尴尬了。。。
或者是订单系统调用支付系统进行支付,结果不小心因为网络超时了,然后订单系统走了前面我们看到的那个重试机制,咔嚓给你重试了一把,好,支付系统收到一个支付请求两次,而且因为负载均衡算法落在了不同的机器上,尴尬了。。。
所以你肯定得知道这事儿,否则你做出来的分布式系统恐怕容易埋坑
网络问题很常见,100次请求,都ok;1万次,可能1次是超时会重试;10万,10次;100万,100次;如果有100个请求重复了,你没处理,导致订单扣款2次,100个订单都扣错了;每天被100个用户投诉;一个月被3000个用户投诉
我们之前生产就遇到过,是往数据库里写入数据,重复的请求,就导致我们的数据经常会错,出现一些重复数据,就会导致一些问题
3、面试题剖析
这个不是技术问题,这个没有通用的一个方法,这个是结合业务来看应该如何保证幂等性的,你的经验。
所谓幂等性,就是说一个接口,多次发起同一个请求,你这个接口得保证结果是准确的,比如不能多扣款,不能多插入一条数据,不能将统计值多加了1。这就是幂等性,不给大家来学术性词语了。
其实保证幂等性主要是三点:
(1)对于每个请求必须有一个唯一的标识,举个例子:订单支付请求,肯定得包含订单id,一个订单id最多支付一次,对吧
(2)每次处理完请求之后,必须有一个记录标识这个请求处理过了,比如说常见的方案是在mysql中记录个状态啥的,比如支付之前记录一条这个订单的支付流水,而且支付流水采
(3)每次接收请求需要进行判断之前是否处理过的逻辑处理,比如说,如果有一个订单已经支付了,就已经有了一条支付流水,那么如果重复发送这个请求,则此时先插入支付流水,orderId已经存在了,唯一键约束生效,报错插入不进去的。然后你就不用再扣款了。
(4)上面只是给大家举个例子,实际运作过程中,你要结合自己的业务来,比如说用redis用orderId作为唯一键。只有成功插入这个支付流水,才可以执行实际的支付扣款。
要求是支付一个订单,必须插入一条支付流水,order_id建一个唯一键,unique key
所以你在支付一个订单之前,先插入一条支付流水,order_id就已经进去了
你就可以写一个标识到redis里面去,set order_id payed,下一次重复请求过来了,先查redis的order_id对应的value,如果是payed就说明已经支付过了,你就别重复支付了
然后呢,你再重复支付这个订单的时候,你写尝试插入一条支付流水,数据库给你报错了,说unique key冲突了,整个事务回滚就可以了
来保存一个是否处理过的标识也可以,服务的不同实例可以一起操作redis。
分布式服务接口请求的顺序性如何保证?

2、面试官心里分析
其实分布式系统接口的调用顺序,也是个问题,一般来说是不用保证顺序的。但是有的时候可能确实是需要严格的顺序保证。给大家举个例子,你服务A调用服务B,先插入再删除。好,结果俩请求过去了,落在不同机器上,可能插入请求因为某些原因执行慢了一些,导致删除请求先执行了,此时因为没数据所以啥效果也没有;结果这个时候插入请求过来了,好,数据插入进去了,那就尴尬了。
本来应该是先插入 -> 再删除,这条数据应该没了,结果现在先删除 -> 再插入,数据还存在,最后你死都想不明白是怎么回事。
所以这都是分布式系统一些很常见的问题
3、面试题剖析
首先,一般来说,我个人给你的建议是,你们从业务逻辑上最好设计的这个系统不需要这种顺序性的保证,因为一旦引入顺序性保障,会导致系统复杂度上升,而且会带来效率低下,热点数据压力过大,等问题。
下面我给个我们用过的方案吧,简单来说,首先你得用dubbo的一致性hash负载均衡策略,将比如某一个订单id对应的请求都给分发到某个机器上去,接着就是在那个机器上因为可能还是多线程并发执行的,你可能得立即将某个订单id对应的请求扔一个内存队列里去,强制排队,这样来确保他们的顺序性。
但是这样引发的后续问题就很多,比如说要是某个订单对应的请求特别多,造成某台机器成热点怎么办?解决这些问题又要开启后续一连串的复杂技术方案。。。曾经这类问题弄的我们头疼不已,所以,还是建议什么呢?
最好是比如说刚才那种,一个订单的插入和删除操作,能不能合并成一个操作,就是一个删除,或者是什么,避免这种问题的产生。
如何自己设计一个类似dubbo的rpc框架?
2、面试官心里分析
说实话,就这问题,其实就跟问你,如何自己设计一个MQ,一样的道理,就考两个:
(1)你有没有对某个rpc框架原理有非常深入的理解 (2)你能不能从整体上来思考一下,如何设计一个rpc框架,考考你的系统设计能力
3、面试题剖析
其实一般问到你这问题,你起码不能认怂,因为既然咱们这个课程是短期的面试突击训练课程,那我不可能给你深入讲解什么kafka源码剖析,dubbo源码剖析,何况我就算讲了,你要真的消化理解和吸收,起码个把月以后了。
所以我给大家一个建议,遇到这类问题,起码从你了解的类似框架的原理入手,自己说说参照dubbo的原理,你来设计一下,举个例子,dubbo不是有那么多分层么?而且每个分层是干啥的,你大概是不是知道?那就按照这个思路大致说一下吧,起码你不能懵逼,要比那些上来就懵,啥也说不出来的人要好一些
举个例子,我给大家说个最简单的回答思路:
(1)上来你的服务就得去注册中心注册吧,你是不是得有个注册中心,保留各个服务的信心,可以用zookeeper来做,对吧 (2)然后你的消费者需要去注册中心拿对应的服务信息吧,对吧,而且每个服务可能会存在于多台机器上 (3)接着你就该发起一次请求了,咋发起?蒙圈了是吧。当然是基于动态代理了,你面向接口获取到一个动态代理,这个动态代理就是接口在本地的一个代理,然后这个代理会找到服务对应的机器地址 (4)然后找哪个机器发送请求?那肯定得有个负载均衡算法了,比如最简单的可以随机轮询是不是 (5)接着找到一台机器,就可以跟他发送请求了,第一个问题咋发送?你可以说用netty了,nio方式;第二个问题发送啥格式数据?你可以说用hessian序列化协议了,或者是别的,对吧。然后请求过去了。。 (6)服务器那边一样的,需要针对你自己的服务生成一个动态代理,监听某个网络端口了,然后代理你本地的服务代码。接收到请求的时候,就调用对应的服务代码,对吧。
这就是一个最最基本的rpc框架的思路,先不说你有多牛逼的技术功底,哪怕这个最简单的思路你先给出来行不行?好,突击课程,那就到这儿结束了,我这课程定位是帮你快速梳理一遍,扫清盲点,不是打通你任督二脉,给你九阳神功的。
zk都有哪些使用场景?
大致来说,zk的使用场景如下,我就举几个简单的,大家能说几个就好了:
(1)分布式协调:这个其实是zk很经典的一个用法,简单来说,就好比,你A系统发送个请求到mq,然后B消息消费之后处理了。那A系统如何知道B系统的处理结果?用zk就可以实现分布式系统之间的协调工作。A系统发送请求之后可以在zk上对某个节点的值注册个监听器,一旦B系统处理完了就修改zk那个节点的值,A立马就可以收到通知,完美解决。

(2)分布式锁:对某一个数据连续发出两个修改操作,两台机器同时收到了请求,但是只能一台机器先执行另外一个机器再执行。那么此时就可以使用zk分布式锁,一个机器接收到了请求之后先获取zk上的一把分布式锁,就是可以去创建一个znode,接着执行操作;然后另外一个机器也尝试去创建那个znode,结果发现自己创建不了,因为被别人创建了。。。。那只能等着,等第一个机器执行完了自己再执行。

(3)元数据/配置信息管理:zk可以用作很多系统的配置信息的管理,比如kafka、storm等等很多分布式系统都会选用zk来做一些元数据、配置信息的管理,包括dubbo注册中心不也支持zk么

(4)HA高可用性:这个应该是很常见的,比如hadoop、hdfs、yarn等很多大数据系统,都选择基于zk来开发HA高可用机制,就是一个重要进程一般会做主备两个,主进程挂了立马通过zk感知到切换到备用进程

一般实现分布式锁都有哪些方式?使用redis如何设计分布式锁?使用zk来设计分布式锁可以吗?这两种分布式锁的实现方式哪种效率比较高?
(1)redis分布式锁

官方叫做RedLock算法,是redis官方支持的分布式锁算法。
这个分布式锁有3个重要的考量点,互斥(只能有一个客户端获取锁),不能死锁,容错(大部分redis节点或者这个锁就可以加可以释放)
第一个最普通的实现方式,如果就是在redis里创建一个key算加锁
SET my:lock 随机值 NX PX 30000,这个命令就ok,这个的NX的意思就是只有key不存在的时候才会设置成功,PX 30000的意思是30秒后锁自动释放。别人创建的时候如果发现已经有了就不能加锁了。
释放锁就是删除key,但是一般可以用lua脚本删除,判断value一样才删除:
关于redis如何执行lua脚本,自行百度
if redis.call("get",KEYS[1]) == ARGV[1] then
return redis.call("del",KEYS[1])
else
    return 0
end
为啥要用随机值呢?因为如果某个客户端获取到了锁,但是阻塞了很长时间才执行完,此时可能已经自动释放锁了,此时可能别的客户端已经获取到了这个锁,要是你这个时候直接删除key的话会有问题,所以得用随机值加上面的lua脚本来释放锁。
但是这样是肯定不行的。因为如果是普通的redis单实例,那就是单点故障。或者是redis普通主从,那redis主从异步复制,如果主节点挂了,key还没同步到从节点,此时从节点切换为主节点,别人就会拿到锁。
第二个问题,RedLock算法

这个场景是假设有一个redis cluster,有5个redis master实例。然后执行如下步骤获取一把锁:
1)获取当前时间戳,单位是毫秒 2)跟上面类似,轮流尝试在每个master节点上创建锁,过期时间较短,一般就几十毫秒 3)尝试在大多数节点上建立一个锁,比如5个节点就要求是3个节点(n / 2 +1) 4)客户端计算建立好锁的时间,如果建立锁的时间小于超时时间,就算建立成功了 5)要是锁建立失败了,那么就依次删除这个锁 6)只要别人建立了一把分布式锁,你就得不断轮询去尝试获取锁
(2)zk分布式锁

zk分布式锁,其实可以做的比较简单,就是某个节点尝试创建临时znode,此时创建成功了就获取了这个锁;这个时候别的客户端来创建锁会失败,只能注册个监听器监听这个锁。释放锁就是删除这个znode,一旦释放掉就会通知客户端,然后有一个等待着的客户端就可以再次重新枷锁。
/**
 * ZooKeeperSession
 * @author Administrator
 *
 */
public class ZooKeeperSession {

	private static CountDownLatch connectedSemaphore = new CountDownLatch(1);

	private ZooKeeper zookeeper;
private CountDownLatch latch;

	public ZooKeeperSession() {
		try {
			this.zookeeper = new ZooKeeper(
					"192.168.31.187:2181,192.168.31.19:2181,192.168.31.227:2181",
					50000,
					new ZooKeeperWatcher());
			try {
				connectedSemaphore.await();
			} catch(InterruptedException e) {
				e.printStackTrace();
			}

			System.out.println("ZooKeeper session established......");
		} catch (Exception e) {
			e.printStackTrace();
		}
	}

	/**
	 * 获取分布式锁
	 * @param productId
	 */
	public Boolean acquireDistributedLock(Long productId) {
		String path = "/product-lock-" + productId;

		try {
			zookeeper.create(path, "".getBytes(),
					Ids.OPEN_ACL_UNSAFE, CreateMode.EPHEMERAL);
return true;
		} catch (Exception e) {
while(true) {
				try {
Stat stat = zk.exists(path, true); // 相当于是给node注册一个监听器,去看看这个监听器是否存在
if(stat != null) {
this.latch = new CountDownLatch(1);
this.latch.await(waitTime, TimeUnit.MILLISECONDS);
this.latch = null;
}
zookeeper.create(path, "".getBytes(),
						Ids.OPEN_ACL_UNSAFE, CreateMode.EPHEMERAL);
return true;
} catch(Exception e) {
continue;
}
}

// 很不优雅,我呢就是给大家来演示这么一个思路
// 比较通用的,我们公司里我们自己封装的基于zookeeper的分布式锁,我们基于zookeeper的临时顺序节点去实现的,比较优雅的
		}
return true;
	}

	/**
	 * 释放掉一个分布式锁
	 * @param productId
	 */
	public void releaseDistributedLock(Long productId) {
		String path = "/product-lock-" + productId;
		try {
			zookeeper.delete(path, -1);
			System.out.println("release the lock for product[id=" + productId + "]......");
		} catch (Exception e) {
			e.printStackTrace();
		}
	}

	/**
	 * 建立zk session的watcher
	 * @author Administrator
	 *
	 */
	private class ZooKeeperWatcher implements Watcher {

		public void process(WatchedEvent event) {
			System.out.println("Receive watched event: " + event.getState());

			if(KeeperState.SyncConnected == event.getState()) {
				connectedSemaphore.countDown();
			}

if(this.latch != null) {
this.latch.countDown();
}
		}

	}

	/**
	 * 封装单例的静态内部类
	 * @author Administrator
	 *
	 */
	private static class Singleton {

		private static ZooKeeperSession instance;

		static {
			instance = new ZooKeeperSession();
		}

		public static ZooKeeperSession getInstance() {
			return instance;
		}

	}

	/**
	 * 获取单例
	 * @return
	 */
	public static ZooKeeperSession getInstance() {
		return Singleton.getInstance();
	}

	/**
	 * 初始化单例的便捷方法
	 */
	public static void init() {
		getInstance();
	}

}
(3)redis分布式锁和zk分布式锁的对比
redis分布式锁,其实需要自己不断去尝试获取锁,比较消耗性能
zk分布式锁,获取不到锁,注册个监听器即可,不需要不断主动尝试获取锁,性能开销较小
另外一点就是,如果是redis获取锁的那个客户端bug了或者挂了,那么只能等待超时时间之后才能释放锁;而zk的话,因为创建的是临时znode,只要客户端挂了,znode就没了,此时就自动释放锁
redis分布式锁大家每发现好麻烦吗?遍历上锁,计算时间等等。。。zk的分布式锁语义清晰实现简单
所以先不分析太多的东西,就说这两点,我个人实践认为zk的分布式锁比redis的分布式锁牢靠、而且模型简单易用
集群部署时的分布式session如何实现?
session是啥?浏览器有个cookie,在一段时间内这个cookie都存在,然后每次发请求过来都带上一个特殊的jsessionid cookie,就根据这个东西,在服务端可以维护一个对应的session域,里面可以放点儿数据。
一般只要你没关掉浏览器,cookie还在,那么对应的那个session就在,但是cookie没了,session就没了。常见于什么购物车之类的东西,还有登录状态保存之类的。
这个不多说了,懂java的都该知道这个。
但是你单块系统的时候这么玩儿session没问题啊,但是你要是分布式系统了呢,那么多的服务,session状态在哪儿维护啊?
其实方法很多,但是常见常用的是两种:
(1)tomcat + redis
这个其实还挺方便的,就是使用session的代码跟以前一样,还是基于tomcat原生的session支持即可,然后就是用一个叫做Tomcat RedisSessionManager的东西,让所有我们部署的tomcat都将session数据存储到redis即可。
在tomcat的配置文件中,配置一下
<Valve className="com.orangefunction.tomcat.redissessions.RedisSessionHandlerValve" />

<Manager className="com.orangefunction.tomcat.redissessions.RedisSessionManager"
         host="{redis.host}"
         port="{redis.port}"
         database="{redis.dbnum}"
         maxInactiveInterval="60"/>
搞一个类似上面的配置即可,你看是不是就是用了RedisSessionManager,然后指定了redis的host和 port就ok了。
<Valve className="com.orangefunction.tomcat.redissessions.RedisSessionHandlerValve" />
<Manager className="com.orangefunction.tomcat.redissessions.RedisSessionManager"
	 sentinelMaster="mymaster"
	 sentinels="<sentinel1-ip>:26379,<sentinel2-ip>:26379,<sentinel3-ip>:26379"
	 maxInactiveInterval="60"/>
还可以用上面这种方式基于redis哨兵支持的redis高可用集群来保存session数据,都是ok的
(2)spring session + redis
分布式会话的这个东西重耦合在tomcat中,如果我要将web容器迁移成jetty,难道你重新把jetty都配置一遍吗?
因为上面那种tomcat + redis的方式好用,但是会严重依赖于web容器,不好将代码移植到其他web容器上去,尤其是你要是换了技术栈咋整?比如换成了spring cloud或者是spring boot之类的。还得好好思忖思忖。
所以现在比较好的还是基于java一站式解决方案,spring了。人家spring基本上包掉了大部分的我们需要使用的框架了,spirng cloud做微服务了,spring boot做脚手架了,所以用sping session是一个很好的选择。
pom.xml
<dependency>
  <groupId>org.springframework.session</groupId>
  <artifactId>spring-session-data-redis</artifactId>
  <version>1.2.1.RELEASE</version>
</dependency>
<dependency>
  <groupId>redis.clients</groupId>
  <artifactId>jedis</artifactId>
  <version>2.8.1</version>
</dependency>
spring配置文件中
<bean id="redisHttpSessionConfiguration"
     class="org.springframework.session.data.redis.config.annotation.web.http.RedisHttpSessionConfiguration">
    <property name="maxInactiveIntervalInSeconds" value="600"/>
</bean>

<bean id="jedisPoolConfig" class="redis.clients.jedis.JedisPoolConfig">
    <property name="maxTotal" value="100" />
    <property name="maxIdle" value="10" />
</bean>

<bean id="jedisConnectionFactory"
      class="org.springframework.data.redis.connection.jedis.JedisConnectionFactory" destroy-method="destroy">
    <property name="hostName" value="${redis_hostname}"/>
    <property name="port" value="${redis_port}"/>
    <property name="password" value="${redis_pwd}" />
    <property name="timeout" value="3000"/>
    <property name="usePool" value="true"/>
    <property name="poolConfig" ref="jedisPoolConfig"/>
</bean>
web.xml
<filter>
    <filter-name>springSessionRepositoryFilter</filter-name>
    <filter-class>org.springframework.web.filter.DelegatingFilterProxy</filter-class>
</filter>
<filter-mapping>
    <filter-name>springSessionRepositoryFilter</filter-name>
    <url-pattern>/*</url-pattern>
</filter-mapping>
示例代码
@Controller
@RequestMapping("/test")
public class TestController {

@RequestMapping("/putIntoSession")
@ResponseBody
    public String putIntoSession(HttpServletRequest request, String username){
        request.getSession().setAttribute("name",  “leo”);

        return "ok";
    }

@RequestMapping("/getFromSession")
@ResponseBody
    public String getFromSession(HttpServletRequest request, Model model){
        String name = request.getSession().getAttribute("name");
        return name;
    }
}
上面的代码就是ok的,给sping session配置基于redis来存储session数据,然后配置了一个spring session的过滤器,这样的话,session相关操作都会交给spring session来管了。接着在代码中,就用原生的session操作,就是直接基于spring sesion从redis中获取数据了。
实现分布式的会话,有很多种很多种方式,我说的只不过比较常见的两种方式,tomcat + redis早期比较常用;近些年,重耦合到tomcat中去,通过spring session来实现。
分布式事务了解吗?你们如何解决分布式事务问题的?
分布式系统里的事务

(1)两阶段提交方案/XA方案
两阶段提交方案

也叫做两阶段提交事务方案,这个举个例子,比如说咱们公司里经常tb是吧(就是团建),然后一般会有个tb主席(就是负责组织团建的那个人)。
tb,team building,团建
第一个阶段,一般tb主席会提前一周问一下团队里的每个人,说,大家伙,下周六我们去滑雪+烧烤,去吗?这个时候tb主席开始等待每个人的回答,如果所有人都说ok,那么就可以决定一起去这次tb。如果这个阶段里,任何一个人回答说,我有事不去了,那么tb主席就会取消这次活动。
第二个阶段,那下周六大家就一起去滑雪+烧烤了
所以这个就是所谓的XA事务,两阶段提交,有一个事务管理器的概念,负责协调多个数据库(资源管理器)的事务,事务管理器先问问各个数据库你准备好了吗?如果每个数据库都回复ok,那么就正式提交事务,在各个数据库上执行操作;如果任何一个数据库回答不ok,那么就回滚事务。
这种分布式事务方案,比较适合单块应用里,跨多个库的分布式事务,而且因为严重依赖于数据库层面来搞定复杂的事务,效率很低,绝对不适合高并发的场景。如果要玩儿,那么基于spring + JTA就可以搞定,自己随便搜个demo看看就知道了。
这个方案,我们很少用,一般来说某个系统内部如果出现跨多个库的这么一个操作,是不合规的。我可以给大家介绍一下, 现在微服务,一个大的系统分成几百个服务,几十个服务。一般来说,我们的规定和规范,是要求说每个服务只能操作自己对应的一个数据库。
如果你要操作别的服务对应的库,不允许直连别的服务的库,违反微服务架构的规范,你随便交叉胡乱访问,几百个服务的话,全体乱套,这样的一套服务是没法管理的,没法治理的,经常数据被别人改错,自己的库被别人写挂。
如果你要操作别人的服务的库,你必须是通过调用别的服务的接口来实现,绝对不允许你交叉访问别人的数据库!
(2)TCC方案
TCC方案

TCC的全程是:Try、Confirm、Cancel。
这个其实是用到了补偿的概念,分为了三个阶段:
1)Try阶段:这个阶段说的是对各个服务的资源做检测以及对资源进行锁定或者预留 2)Confirm阶段:这个阶段说的是在各个服务中执行实际的操作 3)Cancel阶段:如果任何一个服务的业务方法执行出错,那么这里就需要进行补偿,就是执行已经执行成功的业务逻辑的回滚操作
给大家举个例子吧,比如说跨银行转账的时候,要涉及到两个银行的分布式事务,如果用TCC方案来实现,思路是这样的:
1)Try阶段:先把两个银行账户中的资金给它冻结住就不让操作了 2)Confirm阶段:执行实际的转账操作,A银行账户的资金扣减,B银行账户的资金增加 3)Cancel阶段:如果任何一个银行的操作执行失败,那么就需要回滚进行补偿,就是比如A银行账户如果已经扣减了,但是B银行账户资金增加失败了,那么就得把A银行账户资金给加回去
这种方案说实话几乎很少用人使用,我们用的也比较少,但是也有使用的场景。因为这个事务回滚实际上是严重依赖于你自己写代码来回滚和补偿了,会造成补偿代码巨大,非常之恶心。
比如说我们,一般来说跟钱相关的,跟钱打交道的,支付、交易相关的场景,我们会用TCC,严格严格保证分布式事务要么全部成功,要么全部自动回滚,严格保证资金的正确性,在资金上出现问题
比较适合的场景:这个就是除非你是真的一致性要求太高,是你系统中核心之核心的场景,比如常见的就是资金类的场景,那你可以用TCC方案了,自己编写大量的业务逻辑,自己判断一个事务中的各个环节是否ok,不ok就执行补偿/回滚代码。
而且最好是你的各个业务执行的时间都比较短。
但是说实话,一般尽量别这么搞,自己手写回滚逻辑,或者是补偿逻辑,实在太恶心了,那个业务代码很难维护。
(3)本地消息表
本地消息表方案

国外的ebay搞出来的这么一套思想
这个大概意思是这样的
1)A系统在自己本地一个事务里操作同时,插入一条数据到消息表 2)接着A系统将这个消息发送到MQ中去 3)B系统接收到消息之后,在一个事务里,往自己本地消息表里插入一条数据,同时执行其他的业务操作,如果这个消息已经被处理过了,那么此时这个事务会回滚,这样保证不会重复处理消息 4)B系统执行成功之后,就会更新自己本地消息表的状态以及A系统消息表的状态 5)如果B系统处理失败了,那么就不会更新消息表状态,那么此时A系统会定时扫描自己的消息表,如果有没处理的消息,会再次发送到MQ中去,让B再次处理 6)这个方案保证了最终一致性,哪怕B事务失败了,但是A会不断重发消息,直到B那边成功为止
这个方案说实话最大的问题就在于严重依赖于数据库的消息表来管理事务啥的???这个会导致如果是高并发场景咋办呢?咋扩展呢?所以一般确实很少用
(4)可靠消息最终一致性方案
可靠消息最终一致性方案

这个的意思,就是干脆不要用本地的消息表了,直接基于MQ来实现事务。比如阿里的RocketMQ就支持消息事务。
大概的意思就是: 1)A系统先发送一个prepared消息到mq,如果这个prepared消息发送失败那么就直接取消操作别执行了 2)如果这个消息发送成功过了,那么接着执行本地事务,如果成功就告诉mq发送确认消息,如果失败就告诉mq回滚消息 3)如果发送了确认消息,那么此时B系统会接收到确认消息,然后执行本地的事务 4)mq会自动定时轮询所有prepared消息回调你的接口,问你,这个消息是不是本地事务处理失败了,所有没发送确认消息?那是继续重试还是回滚?一般来说这里你就可以查下数据库看之前本地事务是否执行,如果回滚了,那么这里也回滚吧。这个就是避免可能本地事务执行成功了,别确认消息发送失败了。 5)这个方案里,要是系统B的事务失败了咋办?重试咯,自动不断重试直到成功,如果实在是不行,要么就是针对重要的资金类业务进行回滚,比如B系统本地回滚后,想办法通知系统A也回滚;或者是发送报警由人工来手工回滚和补偿
这个还是比较合适的,目前国内互联网公司大都是这么玩儿的,要不你举用RocketMQ支持的,要不你就自己基于类似ActiveMQ?RabbitMQ?自己封装一套类似的逻辑出来,总之思路就是这样子的
(5)最大努力通知方案
最大努力通知方案

这个方案的大致意思就是:
1)系统A本地事务执行完之后,发送个消息到MQ 2)这里会有个专门消费MQ的最大努力通知服务,这个服务会消费MQ然后写入数据库中记录下来,或者是放入个内存队列也可以,接着调用系统B的接口 3)要是系统B执行成功就ok了;要是系统B执行失败了,那么最大努力通知服务就定时尝试重新调用系统B,反复N次,最后还是不行就放弃
(6)你们公司是如何处理分布式事务的?
这个,说真的,确实我们这个课程没法带着大家来实战,因为定位不是这个。但是如果你真的被问到,你可以这么说,我们某某特别严格的场景,用的是TCC来保证强一致性;然后其他的一些场景基于了阿里的RocketMQ来实现了分布式事务。
你找一个严格资金要求绝对不能错的场景,你可以说你是用的TCC方案;如果是一般的分布式事务场景,订单插入之后要调用库存服务更新库存,库存数据没有资金那么的敏感,可以用可靠消息最终一致性方案
友情提示一下,rocketmq 3.2.6之前的版本,是可以按照上面的思路来的,但是之后接口做了一些改变,我这里不再赘述了。
当然如果你愿意,你可以参考可靠消息最终一致性方案来自己实现一套分布式事务,比如基于rabbitmq来玩儿。
如何设计一个高并发系统?
高并发系统的架构组成

其实所谓的高并发,如果你要理解这个问题呢,其实就得从高并发的根源出发,为啥会有高并发?为啥高并发就很牛逼?
我说的浅显一点,很简单,就是因为刚开始系统都是连接数据库的,但是要知道数据库支撑到每秒并发两三千的时候,基本就快完了。所以才有说,很多公司,刚开始干的时候,技术比较low,结果业务发展太快,有的时候系统扛不住压力就挂了。
当然会挂了,凭什么不挂?你数据库如果瞬间承载每秒5000,8000,甚至上万的并发,一定会宕机,因为比如mysql就压根儿扛不住这么高的并发量。
所以为啥高并发牛逼?就是因为现在用互联网的人越来越多,很多app、网站、系统承载的都是高并发请求,可能高峰期每秒并发量几千,很正常的。如果是什么双十一了之类的,每秒并发几万几十万都有可能。
那么如此之高的并发量,加上原本就如此之复杂的业务,咋玩儿?真正厉害的,一定是在复杂业务系统里玩儿过高并发架构的人,但是你没有,那么我给你说一下你该怎么回答这个问题:
(1)系统拆分,将一个系统拆分为多个子系统,用dubbo来搞。然后每个系统连一个数据库,这样本来就一个库,现在多个数据库,不也可以抗高并发么。
(2)缓存,必须得用缓存。大部分的高并发场景,都是读多写少,那你完全可以在数据库和缓存里都写一份,然后读的时候大量走缓存不就得了。毕竟人家redis轻轻松松单机几万的并发啊。没问题的。所以你可以考虑考虑你的项目里,那些承载主要请求的读场景,怎么用缓存来抗高并发。
(3)MQ,必须得用MQ。可能你还是会出现高并发写的场景,比如说一个业务操作里要频繁搞数据库几十次,增删改增删改,疯了。那高并发绝对搞挂你的系统,你要是用redis来承载写那肯定不行,人家是缓存,数据随时就被LRU了,数据格式还无比简单,没有事务支持。所以该用mysql还得用mysql啊。那你咋办?用MQ吧,大量的写请求灌入MQ里,排队慢慢玩儿,后边系统消费后慢慢写,控制在mysql承载范围之内。所以你得考虑考虑你的项目里,那些承载复杂写业务逻辑的场景里,如何用MQ来异步写,提升并发性。MQ单机抗几万并发也是ok的,这个之前还特意说过。
(4)分库分表,可能到了最后数据库层面还是免不了抗高并发的要求,好吧,那么就将一个数据库拆分为多个库,多个库来抗更高的并发;然后将一个表拆分为多个表,每个表的数据量保持少一点,提高sql跑的性能。
(5)读写分离,这个就是说大部分时候数据库可能也是读多写少,没必要所有请求都集中在一个库上吧,可以搞个主从架构,主库写入,从库读取,搞一个读写分离。读流量太多的时候,还可以加更多的从库。
(6)Elasticsearch,可以考虑用es。es是分布式的,可以随便扩容,分布式天然就可以支撑高并发,因为动不动就可以扩容加机器来抗更高的并发。那么一些比较简单的查询、统计类的操作,可以考虑用es来承载,还有一些全文搜索类的操作,也可以考虑用es来承载。
上面的6点,基本就是高并发系统肯定要干的一些事儿,大家可以仔细结合之前讲过的知识考虑一下,到时候你可以系统的把这块阐述一下,然后每个部分要注意哪些问题,之前都讲过了,你都可以阐述阐述,表明你对这块是有点积累的。
分库分表
为什么要分库分表?(设计高并发系统的时候,数据库层面该如何设计?)
01_分库分表的由来

说白了,分库分表是两回事儿,大家可别搞混了,可能是光分库不分表,也可能是光分表不分库,都有可能。我先给大家抛出来一个场景。
假如我们现在是一个小创业公司(或者是一个BAT公司刚兴起的一个新部门),现在注册用户就20万,每天活跃用户就1万,每天单表数据量就1000,然后高峰期每秒钟并发请求最多就10。。。天,就这种系统,随便找一个有几年工作经验的,然后带几个刚培训出来的,随便干干都可以。
结果没想到我们运气居然这么好,碰上个CEO带着我们走上了康庄大道,业务发展迅猛,过了几个月,注册用户数达到了2000万!每天活跃用户数100万!每天单表数据量10万条!高峰期每秒最大请求达到1000!同时公司还顺带着融资了两轮,紧张了几个亿人民币啊!公司估值达到了惊人的几亿美金!这是小独角兽的节奏!
好吧,没事,现在大家感觉压力已经有点大了,为啥呢?因为每天多10万条数据,一个月就多300万条数据,现在咱们单表已经几百万数据了,马上就破千万了。但是勉强还能撑着。高峰期请求现在是1000,咱们线上部署了几台机器,负载均衡搞了一下,数据库撑1000 QPS也还凑合。但是大家现在开始感觉有点担心了,接下来咋整呢。。。。。。
再接下来几个月,我的天,CEO太牛逼了,公司用户数已经达到1亿,公司继续融资几十亿人民币啊!公司估值达到了惊人的几十亿美金,成为了国内今年最牛逼的明星创业公司!天,我们太幸运了。
但是我们同时也是不幸的,因为此时每天活跃用户数上千万,每天单表新增数据多达50万,目前一个表总数据量都已经达到了两三千万了!扛不住啊!数据库磁盘容量不断消耗掉!高峰期并发达到惊人的5000~8000!别开玩笑了,哥。我跟你保证,你的系统支撑不到现在,已经挂掉了!
好吧,所以看到你这里你差不多就理解分库分表是怎么回事儿了,实际上这是跟着你的公司业务发展走的,你公司业务发展越好,用户就越多,数据量越大,请求量越大,那你单个数据库一定扛不住。
比如你单表都几千万数据了,你确定你能抗住么?绝对不行,单表数据量太大,会极大影响你的sql执行的性能,到了后面你的sql可能就跑的很慢了。一般来说,就以我的经验来看,单表到几百万的时候,性能就会相对差一些了,你就得分表了。
分表是啥意思?就是把一个表的数据放到多个表中,然后查询的时候你就查一个表。比如按照用户id来分表,将一个用户的数据就放在一个表中。然后操作的时候你对一个用户就操作那个表就好了。这样可以控制每个表的数据量在可控的范围内,比如每个表就固定在200万以内。
分库是啥意思?就是你一个库一般我们经验而言,最多支撑到并发2000,一定要扩容了,而且一个健康的单库并发值你最好保持在每秒1000左右,不要太大。那么你可以将一个库的数据拆分到多个库中,访问的时候就访问一个库好了。
这就是所谓的分库分表,为啥要分库分表?你明白了吧
用过哪些分库分表中间件?不同的分库分表中间件都有什么优点和缺点?
这个其实就是看看你了解哪些分库分表的中间件,各个中间件的优缺点是啥?然后你用过哪些分库分表的中间件。
比较常见的包括:cobar、TDDL、atlas、sharding-jdbc、mycat
cobar:阿里b2b团队开发和开源的,属于proxy层方案。早些年还可以用,但是最近几年都没更新了,基本没啥人用,差不多算是被抛弃的状态吧。而且不支持读写分离、存储过程、跨库join和分页等操作。
TDDL:淘宝团队开发的,属于client层方案。不支持join、多表查询等语法,就是基本的crud语法是ok,但是支持读写分离。目前使用的也不多,因为还依赖淘宝的diamond配置管理系统。
atlas:360开源的,属于proxy层方案,以前是有一些公司在用的,但是确实有一个很大的问题就是社区最新的维护都在5年前了。所以,现在用的公司基本也很少了。
sharding-jdbc:当当开源的,属于client层方案。确实之前用的还比较多一些,因为SQL语法支持也比较多,没有太多限制,而且目前推出到了2.0版本,支持分库分表、读写分离、分布式id生成、柔性事务(最大努力送达型事务、TCC事务)。而且确实之前使用的公司会比较多一些(这个在官网有登记使用的公司,可以看到从2017年一直到现在,是不少公司在用的),目前社区也还一直在开发和维护,还算是比较活跃,个人认为算是一个现在也可以选择的方案。
mycat:基于cobar改造的,属于proxy层方案,支持的功能非常完善,而且目前应该是非常火的而且不断流行的数据库中间件,社区很活跃,也有一些公司开始在用了。但是确实相比于sharding jdbc来说,年轻一些,经历的锤炼少一些。
所以综上所述,现在其实建议考量的,就是sharding-jdbc和mycat,这两个都可以去考虑使用。
sharding-jdbc这种client层方案的优点在于不用部署,运维成本低,不需要代理层的二次转发请求,性能很高,但是如果遇到升级啥的需要各个系统都重新升级版本再发布,各个系统都需要耦合sharding-jdbc的依赖;
mycat这种proxy层方案的缺点在于需要部署,自己及运维一套中间件,运维成本高,但是好处在于对于各个项目是透明的,如果遇到升级之类的都是自己中间件那里搞就行了。
通常来说,这两个方案其实都可以选用,但是我个人建议中小型公司选用sharding-jdbc,client层方案轻便,而且维护成本低,不需要额外增派人手,而且中小型公司系统复杂度会低一些,项目也没那么多;
但是中大型公司最好还是选用mycat这类proxy层方案,因为可能大公司系统和项目非常多,团队很大,人员充足,那么最好是专门弄个人来研究和维护mycat,然后大量项目直接透明使用即可。
我们,数据库中间件都是自研的,也用过proxy层,后来也用过client层
你们具体是如何对数据库如何进行垂直拆分或水平拆分的?
02_数据库如何拆分

水平拆分的意思,就是把一个表的数据给弄到多个库的多个表里去,但是每个库的表结构都一样,只不过每个库表放的数据是不同的,所有库表的数据加起来就是全部数据。水平拆分的意义,就是将数据均匀放更多的库里,然后用多个库来抗更高的并发,还有就是用多个库的存储容量来进行扩容。
垂直拆分的意思,就是把一个有很多字段的表给拆分成多个表,或者是多个库上去。每个库表的结构都不一样,每个库表都包含部分字段。一般来说,会将较少的访问频率很高的字段放到一个表里去,然后将较多的访问频率很低的字段放到另外一个表里去。因为数据库是有缓存的,你访问频率高的行字段越少,就可以在缓存里缓存更多的行,性能就越好。这个一般在表层面做的较多一些。
这个其实挺常见的,不一定我说,大家很多同学可能自己都做过,把一个大表拆开,订单表、订单支付表、订单商品表。
还有表层面的拆分,就是分表,将一个表变成N个表,就是让每个表的数据量控制在一定范围内,保证SQL的性能。否则单表数据量越大,SQL性能就越差。一般是200万行左右,不要太多,但是也得看具体你怎么操作,也可能是500万,或者是100万。你的SQL越复杂,就最好让单表行数越少。
好了,无论是分库了还是分表了,上面说的那些数据库中间件都是可以支持的。就是基本上那些中间件可以做到你分库分表之后,中间件可以根据你指定的某个字段值,比如说userid,自动路由到对应的库上去,然后再自动路由到对应的表里去。
你就得考虑一下,你的项目里该如何分库分表?一般来说,垂直拆分,你可以在表层面来做,对一些字段特别多的表做一下拆分;水平拆分,你可以说是并发承载不了,或者是数据量太大,容量承载不了,你给拆了,按什么字段来拆,你自己想好;分表,你考虑一下,你如果哪怕是拆到每个库里去,并发和容量都ok了,但是每个库的表还是太大了,那么你就分表,将这个表分开,保证每个表的数据量并不是很大。
而且这儿还有两种分库分表的方式,一种是按照range来分,就是每个库一段连续的数据,这个一般是按比如时间范围来的,但是这种一般较少用,因为很容易产生热点问题,大量的流量都打在最新的数据上了;或者是按照某个字段hash一下均匀分散,这个较为常用。
range来分,好处在于说,后面扩容的时候,就很容易,因为你只要预备好,给每个月都准备一个库就可以了,到了一个新的月份的时候,自然而然,就会写新的库了;缺点,但是大部分的请求,都是访问最新的数据。实际生产用range,要看场景,你的用户不是仅仅访问最新的数据,而是均匀的访问现在的数据以及历史的数据
hash分法,好处在于说,可以平均分配没给库的数据量和请求压力;坏处在于说扩容起来比较麻烦,会有一个数据迁移的这么一个过程
现在有一个未分库分表的系统,未来要分库分表,如何设计才可以让系统从未分库分表动态切换到分库分表上?
假设,你现有有一个单库单表的系统,在线上在跑,假设单表有600万数据
3个库,每个库里分了4个表,每个表要放50万的数据量
假设你已经选择了一个分库分表的数据库中间件,sharding-jdbc,mycat,都可以
你怎么把线上系统平滑地迁移到分库分表上面去
sharding-jdbc:自己上官网,找一个官网最基本的例子,自己写一下,试一下,跑跑看,是非常简单的
mycat:自己上官网,找一个官网最基本的例子,自己写一下,试一下看看
1个小时以内就可以搞定了
3、面试题剖析
这个其实从low到高大上有好几种方案,我们都玩儿过,我都给你说一下
(1)停机迁移方案
01_长时间停机分库分表

我先给你说一个最low的方案,就是很简单,大家伙儿凌晨12点开始运维,网站或者app挂个公告,说0点到早上6点进行运维,无法访问。。。。。。
接着到0点,停机,系统挺掉,没有流量写入了,此时老的单库单表数据库静止了。然后你之前得写好一个导数的一次性工具,此时直接跑起来,然后将单库单表的数据哗哗哗读出来,写到分库分表里面去。
导数完了之后,就ok了,修改系统的数据库连接配置啥的,包括可能代码和SQL也许有修改,那你就用最新的代码,然后直接启动连到新的分库分表上去。
验证一下,ok了,完美,大家伸个懒腰,看看看凌晨4点钟的北京夜景,打个滴滴回家吧
但是这个方案比较low,谁都能干,我们来看看高大上一点的方案
(2)双写迁移方案
02_不停机双写方案

这个是我们常用的一种迁移方案,比较靠谱一些,不用停机,不用看北京凌晨4点的风景
简单来说,就是在线上系统里面,之前所有写库的地方,增删改操作,都除了对老库增删改,都加上对新库的增删改,这就是所谓双写,同时写俩库,老库和新库。
然后系统部署之后,新库数据差太远,用之前说的导数工具,跑起来读老库数据写新库,写的时候要根据gmt_modified这类字段判断这条数据最后修改的时间,除非是读出来的数据在新库里没有,或者是比新库的数据新才会写。
接着导万一轮之后,有可能数据还是存在不一致,那么就程序自动做一轮校验,比对新老库每个表的每条数据,接着如果有不一样的,就针对那些不一样的,从老库读数据再次写。反复循环,直到两个库每个表的数据都完全一致为止。
接着当数据完全一致了,就ok了,基于仅仅使用分库分表的最新代码,重新部署一次,不就仅仅基于分库分表在操作了么,还没有几个小时的停机时间,很稳。所以现在基本玩儿数据迁移之类的,都是这么干了。
如何设计可以动态扩容缩容的分库分表方案?
01_分库分表扩容方案

(1)停机扩容
这个方案就跟停机迁移一样,步骤几乎一致,唯一的一点就是那个导数的工具,是把现有库表的数据抽出来慢慢倒入到新的库和表里去。但是最好别这么玩儿,有点不太靠谱,因为既然分库分表就说明数据量实在是太大了,可能多达几亿条,甚至几十亿,你这么玩儿,可能会出问题。
从单库单表迁移到分库分表的时候,数据量并不是很大,单表最大也就两三千万
写个工具,多弄几台机器并行跑,1小时数据就导完了
3个库+12个表,跑了一段时间了,数据量都1亿~2亿了。光是导2亿数据,都要导个几个小时,6点,刚刚导完数据,还要搞后续的修改配置,重启系统,测试验证,10点才可以搞完
(2)优化后的方案
一开始上来就是32个库,每个库32个表,1024张表
我可以告诉各位同学说,这个分法,第一,基本上国内的互联网肯定都是够用了,第二,无论是并发支撑还是数据量支撑都没问题
每个库正常承载的写入并发量是1000,那么32个库就可以承载32 1000 = 32000的写并发,如果每个库承载1500的写并发,32 1500 = 48000的写并发,接近5万/s的写入并发,前面再加一个MQ,削峰,每秒写入MQ 8万条数据,每秒消费5万条数据。
有些除非是国内排名非常靠前的这些公司,他们的最核心的系统的数据库,可能会出现几百台数据库的这么一个规模,128个库,256个库,512个库
1024张表,假设每个表放500万数据,在MySQL里可以放50亿条数据
每秒的5万写并发,总共50亿条数据,对于国内大部分的互联网公司来说,其实一般来说都够了
谈分库分表的扩容,第一次分库分表,就一次性给他分个够,32个库,1024张表,可能对大部分的中小型互联网公司来说,已经可以支撑好几年了
一个实践是利用32 * 32来分库分表,即分为32个库,每个库里一个表分为32张表。一共就是1024张表。根据某个id先根据32取模路由到库,再根据32取模路由到库里的表。
刚开始的时候,这个库可能就是逻辑库,建在一个数据库上的,就是一个mysql服务器可能建了n个库,比如16个库。后面如果要拆分,就是不断在库和mysql服务器之间做迁移就可以了。然后系统配合改一下配置即可。
比如说最多可以扩展到32个数据库服务器,每个数据库服务器是一个库。如果还是不够?最多可以扩展到1024个数据库服务器,每个数据库服务器上面一个库一个表。因为最多是1024个表么。
这么搞,是不用自己写代码做数据迁移的,都交给dba来搞好了,但是dba确实是需要做一些库表迁移的工作,但是总比你自己写代码,抽数据导数据来的效率高得多了。
哪怕是要减少库的数量,也很简单,其实说白了就是按倍数缩容就可以了,然后修改一下路由规则。
对2 ^ n取模
orderId 模 32 = 库 orderId / 32 模 32 = 表
259 3 8 1189 5 5 352 0 11 4593 17 15
1、设定好几台数据库服务器,每台服务器上几个库,每个库多少个表,推荐是32库 * 32表,对于大部分公司来说,可能几年都够了
2、路由的规则,orderId 模 32 = 库,orderId / 32 模 32 = 表
3、扩容的时候,申请增加更多的数据库服务器,装好mysql,倍数扩容,4台服务器,扩到8台服务器,16台服务器
4、由dba负责将原先数据库服务器的库,迁移到新的数据库服务器上去,很多工具,库迁移,比较便捷
5、我们这边就是修改一下配置,调整迁移的库所在数据库服务器的地址
6、重新发布系统,上线,原先的路由规则变都不用变,直接可以基于2倍的数据库服务器的资源,继续进行线上系统的提供服务
分库分表之后,id主键如何处理?
(1)数据库自增id
这个就是说你的系统里每次得到一个id,都是往一个库的一个表里插入一条没什么业务含义的数据,然后获取一个数据库自增的一个id。拿到这个id之后再往对应的分库分表里去写入。
这个方案的好处就是方便简单,谁都会用;缺点就是单库生成自增id,要是高并发的话,就会有瓶颈的;如果你硬是要改进一下,那么就专门开一个服务出来,这个服务每次就拿到当前id最大值,然后自己递增几个id,一次性返回一批id,然后再把当前最大id值修改成递增几个id之后的一个值;但是无论怎么说都是基于单个数据库。
适合的场景:你分库分表就俩原因,要不就是单库并发太高,要不就是单库数据量太大;除非是你并发不高,但是数据量太大导致的分库分表扩容,你可以用这个方案,因为可能每秒最高并发最多就几百,那么就走单独的一个库和表生成自增主键即可。
并发很低,几百/s,但是数据量大,几十亿的数据,所以需要靠分库分表来存放海量的数据
(2)uuid
好处就是本地生成,不要基于数据库来了;不好之处就是,uuid太长了,作为主键性能太差了,不适合用于主键。
适合的场景:如果你是要随机生成个什么文件名了,编号之类的,你可以用uuid,但是作为主键是不能用uuid的。
UUID.randomUUID().toString().replace(“-”, “”) -> sfsdf23423rr234sfdaf
(3)获取系统当前时间
这个就是获取当前时间即可,但是问题是,并发很高的时候,比如一秒并发几千,会有重复的情况,这个是肯定不合适的。基本就不用考虑了。
适合的场景:一般如果用这个方案,是将当前时间跟很多其他的业务字段拼接起来,作为一个id,如果业务上你觉得可以接受,那么也是可以的。你可以将别的业务字段值跟当前时间拼接起来,组成一个全局唯一的编号,订单编号,时间戳 + 用户id + 业务含义编码
(4)snowflake算法
twitter开源的分布式id生成算法,就是把一个64位的long型的id,1个bit是不用的,用其中的41 bit作为毫秒数,用10 bit作为工作机器id,12 bit作为序列号
1 bit:不用,为啥呢?因为二进制里第一个bit为如果是1,那么都是负数,但是我们生成的id都是正数,所以第一个bit统一都是0
41 bit:表示的是时间戳,单位是毫秒。41 bit可以表示的数字多达2^41 - 1,也就是可以标识2 ^ 41 - 1个毫秒值,换算成年就是表示69年的时间。
10 bit:记录工作机器id,代表的是这个服务最多可以部署在2^10台机器上哪,也就是1024台机器。但是10 bit里5个bit代表机房id,5个bit代表机器id。意思就是最多代表2 ^ 5个机房(32个机房),每个机房里可以代表2 ^ 5个机器(32台机器)。
12 bit:这个是用来记录同一个毫秒内产生的不同id,12 bit可以代表的最大正整数是2 ^ 12 - 1 = 4096,也就是说可以用这个12bit代表的数字来区分同一个毫秒内的4096个不同的id
64位的long型的id,64位的long -> 二进制
0 | 0001100 10100010 10111110 10001001 01011100 00 | 10001 | 1 1001 | 0000 00000000
2018-01-01 10:00:00 -> 做了一些计算,再换算成一个二进制,41bit来放 -> 0001100 10100010 10111110 10001001 01011100 00
机房id,17 -> 换算成一个二进制 -> 10001
机器id,25 -> 换算成一个二进制 -> 11001
snowflake算法服务,会判断一下,当前这个请求是否是,机房17的机器25,在2175/11/7 12:12:14时间点发送过来的第一个请求,如果是第一个请求
假设,在2175/11/7 12:12:14时间里,机房17的机器25,发送了第二条消息,snowflake算法服务,会发现说机房17的机器25,在2175/11/7 12:12:14时间里,在这一毫秒,之前已经生成过一个id了,此时如果你同一个机房,同一个机器,在同一个毫秒内,再次要求生成一个id,此时我只能把加1
0 | 0001100 10100010 10111110 10001001 01011100 00 | 10001 | 1 1001 | 0000 00000001
比如我们来观察上面的那个,就是一个典型的二进制的64位的id,换算成10进制就是910499571847892992。
public class IdWorker{

    private long workerId;
    private long datacenterId;
    private long sequence;

    public IdWorker(long workerId, long datacenterId, long sequence){
        // sanity check for workerId
// 这儿不就检查了一下,要求就是你传递进来的机房id和机器id不能超过32,不能小于0
        if (workerId > maxWorkerId || workerId < 0) {
            throw new IllegalArgumentException(String.format("worker Id can't be greater than %d or less than 0",maxWorkerId));
        }
        if (datacenterId > maxDatacenterId || datacenterId < 0) {
            throw new IllegalArgumentException(String.format("datacenter Id can't be greater than %d or less than 0",maxDatacenterId));
        }
        System.out.printf("worker starting. timestamp left shift %d, datacenter id bits %d, worker id bits %d, sequence bits %d, workerid %d",
                timestampLeftShift, datacenterIdBits, workerIdBits, sequenceBits, workerId);

        this.workerId = workerId;
        this.datacenterId = datacenterId;
        this.sequence = sequence;
    }

    private long twepoch = 1288834974657L;

    private long workerIdBits = 5L;
    private long datacenterIdBits = 5L;
    private long maxWorkerId = -1L ^ (-1L << workerIdBits); // 这个是二进制运算,就是5 bit最多只能有31个数字,也就是说机器id最多只能是32以内
    private long maxDatacenterId = -1L ^ (-1L << datacenterIdBits); // 这个是一个意思,就是5 bit最多只能有31个数字,机房id最多只能是32以内
    private long sequenceBits = 12L;

    private long workerIdShift = sequenceBits;
    private long datacenterIdShift = sequenceBits + workerIdBits;
    private long timestampLeftShift = sequenceBits + workerIdBits + datacenterIdBits;
    private long sequenceMask = -1L ^ (-1L << sequenceBits);

    private long lastTimestamp = -1L;

    public long getWorkerId(){
        return workerId;
    }

    public long getDatacenterId(){
        return datacenterId;
    }

    public long getTimestamp(){
        return System.currentTimeMillis();
    }

public synchronized long nextId() {
// 这儿就是获取当前时间戳,单位是毫秒
        long timestamp = timeGen();

        if (timestamp < lastTimestamp) {
            System.err.printf("clock is moving backwards.  Rejecting requests until %d.", lastTimestamp);
            throw new RuntimeException(String.format("Clock moved backwards.  Refusing to generate id for %d milliseconds",
                    lastTimestamp - timestamp));
        }

// 0
// 在同一个毫秒内,又发送了一个请求生成一个id,0 -> 1

        if (lastTimestamp == timestamp) {
            sequence = (sequence + 1) & sequenceMask; // 这个意思是说一个毫秒内最多只能有4096个数字,无论你传递多少进来,这个位运算保证始终就是在4096这个范围内,避免你自己传递个sequence超过了4096这个范围
            if (sequence == 0) {
                timestamp = tilNextMillis(lastTimestamp);
            }
        } else {
            sequence = 0;
        }

// 这儿记录一下最近一次生成id的时间戳,单位是毫秒
        lastTimestamp = timestamp;

// 这儿就是将时间戳左移,放到41 bit那儿;将机房id左移放到5 bit那儿;将机器id左移放到5 bit那儿;将序号放最后10 bit;最后拼接起来成一个64 bit的二进制数字,转换成10进制就是个long型
        return ((timestamp - twepoch) << timestampLeftShift) |
                (datacenterId << datacenterIdShift) |
                (workerId << workerIdShift) |
                sequence;
    }

0 | 0001100 10100010 10111110 10001001 01011100 00 | 10001 | 1 1001 | 0000 00000000


    private long tilNextMillis(long lastTimestamp) {
        long timestamp = timeGen();
        while (timestamp <= lastTimestamp) {
            timestamp = timeGen();
        }
        return timestamp;
    }

    private long timeGen(){
        return System.currentTimeMillis();
    }

    //---------------测试---------------
    public static void main(String[] args) {
        IdWorker worker = new IdWorker(1,1,1);
        for (int i = 0; i < 30; i++) {
            System.out.println(worker.nextId());
        }
    }

}
怎么说呢,大概这个意思吧,就是说41 bit,就是当前毫秒单位的一个时间戳,就这意思;然后5 bit是你传递进来的一个机房id(但是最大只能是32以内),5 bit是你传递进来的机器id(但是最大只能是32以内),剩下的那个10 bit序列号,就是如果跟你上次生成id的时间还在一个毫秒内,那么会把顺序给你累加,最多在4096个序号以内。
所以你自己利用这个工具类,自己搞一个服务,然后对每个机房的每个机器都初始化这么一个东西,刚开始这个机房的这个机器的序号就是0。然后每次接收到一个请求,说这个机房的这个机器要生成一个id,你就找到对应的Worker,生成。
他这个算法生成的时候,会把当前毫秒放到41 bit中,然后5 bit是机房id,5 bit是机器id,接着就是判断上一次生成id的时间如果跟这次不一样,序号就自动从0开始;要是上次的时间跟现在还是在一个毫秒内,他就把seq累加1,就是自动生成一个毫秒的不同的序号。
这个算法那,可以确保说每个机房每个机器每一毫秒,最多生成4096个不重复的id。
利用这个snowflake算法,你可以开发自己公司的服务,甚至对于机房id和机器id,反正给你预留了5 bit + 5 bit,你换成别的有业务含义的东西也可以的。
这个snowflake算法相对来说还是比较靠谱的,所以你要真是搞分布式id生成,如果是高并发啥的,那么用这个应该性能比较好,一般每秒几万并发的场景,也足够你用了。
你们有没有做MySQL读写分离?如何实现mysql的读写分离?MySQL主从复制原理的是啥?如何解决mysql主从同步的延时问题?
01_为什么MySQL要读写分离

(1)如何实现mysql的读写分离?
02_MySQL主从复制原理

其实很简单,就是基于主从复制架构,简单来说,就搞一个主库,挂多个从库,然后我们就单单只是写主库,然后主库会自动把数据给同步到从库上去。
(2)MySQL主从复制原理的是啥?
主库将变更写binlog日志,然后从库连接到主库之后,从库有一个IO线程,将主库的binlog日志拷贝到自己本地,写入一个中继日志中。接着从库中有一个SQL线程会从中继日志读取binlog,然后执行binlog日志中的内容,也就是在自己本地再次执行一遍SQL,这样就可以保证自己跟主库的数据是一样的。
这里有一个非常重要的一点,就是从库同步主库数据的过程是串行化的,也就是说主库上并行的操作,在从库上会串行执行。所以这就是一个非常重要的点了,由于从库从主库拷贝日志以及串行执行SQL的特点,在高并发场景下,从库的数据一定会比主库慢一些,是有延时的。所以经常出现,刚写入主库的数据可能是读不到的,要过几十毫秒,甚至几百毫秒才能读取到。
而且这里还有另外一个问题,就是如果主库突然宕机,然后恰好数据还没同步到从库,那么有些数据可能在从库上是没有的,有些数据可能就丢失了。
所以mysql实际上在这一块有两个机制,一个是半同步复制,用来解决主库数据丢失问题;一个是并行复制,用来解决主从同步延时问题。
这个所谓半同步复制,semi-sync复制,指的就是主库写入binlog日志之后,就会将强制此时立即将数据同步到从库,从库将日志写入自己本地的relay log之后,接着会返回一个ack给主库,主库接收到至少一个从库的ack之后才会认为写操作完成了。
所谓并行复制,指的是从库开启多个线程,并行读取relay log中不同库的日志,然后并行重放不同库的日志,这是库级别的并行。 1)主从复制的原理 2)主从延迟问题产生的原因 3)主从复制的数据丢失问题,以及半同步复制的原理 4)并行复制的原理,多库并发重放relay日志,缓解主从延迟问题
(3)mysql主从同步延时问题(精华)
03_MySQL主从延迟导致的生产环境的问题

线上确实处理过因为主从同步延时问题,导致的线上的bug,小型的生产事故
show status,Seconds_Behind_Master,你可以看到从库复制主库的数据落后了几ms
其实这块东西我们经常会碰到,就比如说用了mysql主从架构之后,可能会发现,刚写入库的数据结果没查到,结果就完蛋了。。。。
所以实际上你要考虑好应该在什么场景下来用这个mysql主从同步,建议是一般在读远远多于写,而且读的时候一般对数据时效性要求没那么高的时候,用mysql主从同步
所以这个时候,我们可以考虑的一个事情就是,你可以用mysql的并行复制,但是问题是那是库级别的并行,所以有时候作用不是很大
所以这个时候。。通常来说,我们会对于那种写了之后立马就要保证可以查到的场景,采用强制读主库的方式,这样就可以保证你肯定的可以读到数据了吧。其实用一些数据库中间件是没问题的。
一般来说,如果主从延迟较为严重
1、分库,将一个主库拆分为4个主库,每个主库的写并发就500/s,此时主从延迟可以忽略不计 2、打开mysql支持的并行复制,多个库并行复制,如果说某个库的写入并发就是特别高,单库写并发达到了2000/s,并行复制还是没意义。28法则,很多时候比如说,就是少数的几个订单表,写入了2000/s,其他几十个表10/s。 3、重写代码,写代码的同学,要慎重,当时我们其实短期是让那个同学重写了一下代码,插入数据之后,直接就更新,不要查询 4、如果确实是存在必须先插入,立马要求就查询到,然后立马就要反过来执行一些操作,对这个查询设置直连主库。不推荐这种方法,你这么搞导致读写分离的意义就丧失了