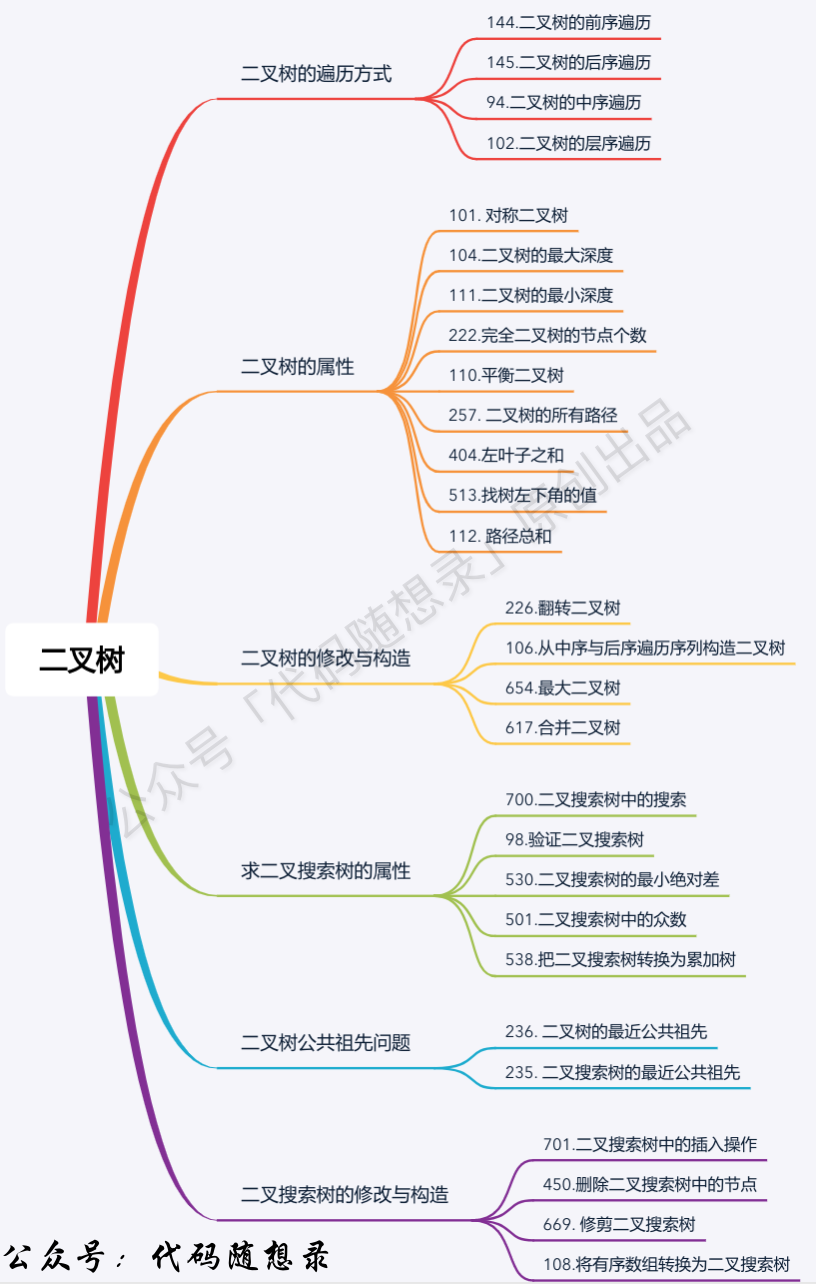
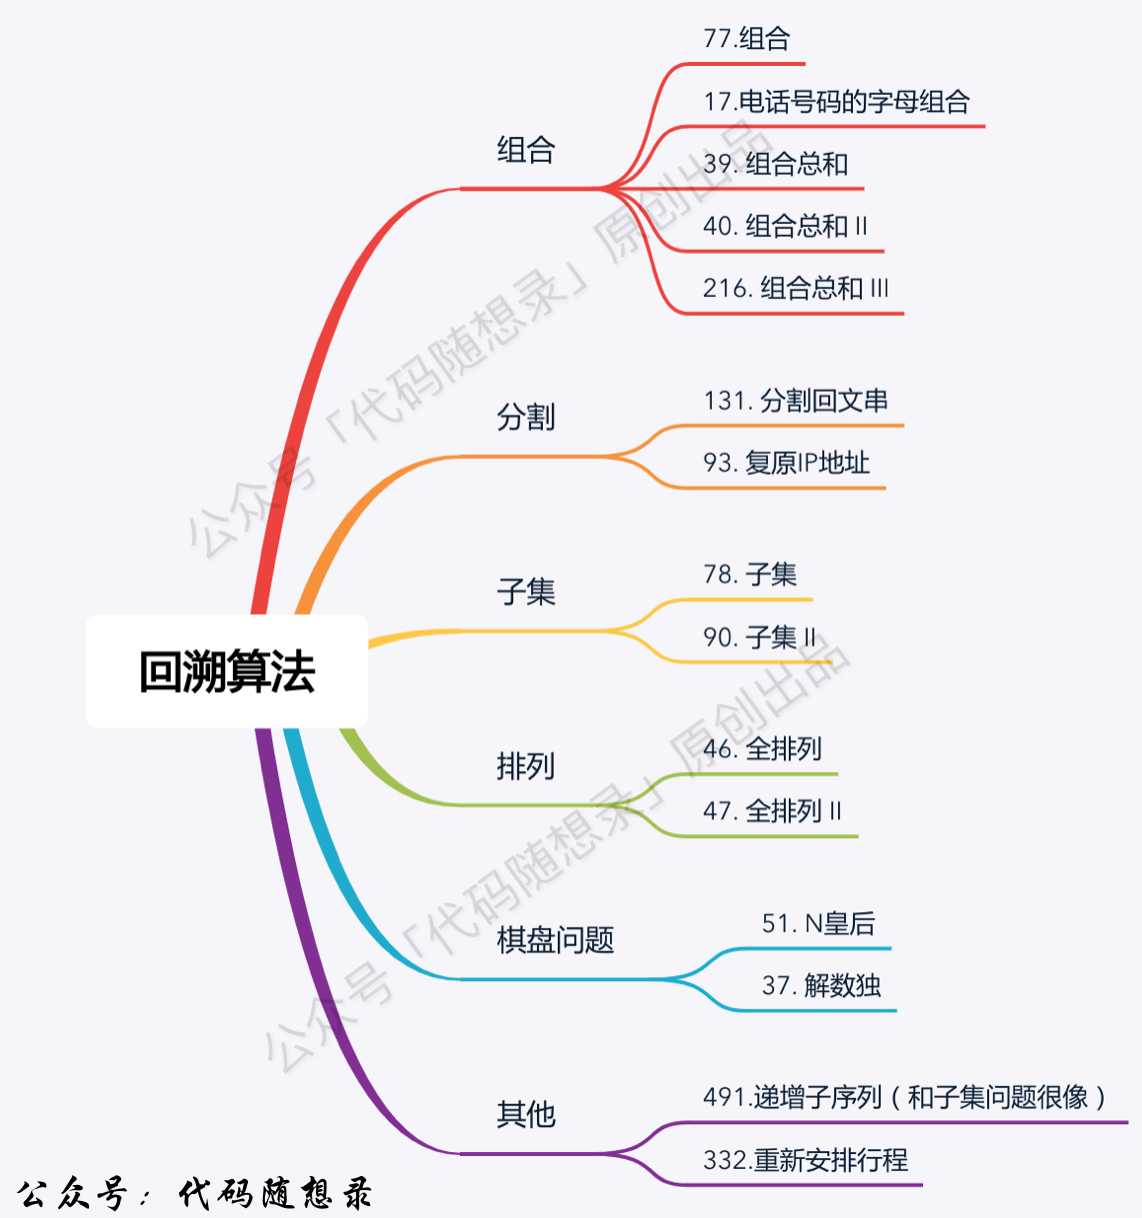
- 关于回溯算法,你该了解这些!
- 回溯算法:77.组合
- 回溯算法:77.组合优化
- 回溯算法:216.组合总和III
- 回溯算法:17.电话号码的字母组合
- 本周小结!(回溯算法系列一)
- 回溯算法:39.组合总和
- 回溯算法:40.组合总和II
- 回溯算法:131.分割回文串
- 回溯算法:93.复原IP地址
- 回溯算法:78.子集
- 本周小结!(回溯算法系列二)
- 回溯算法:90.子集II
- 回溯算法:491.递增子序列
- 回溯算法:46.全排列
- 回溯算法:47.全排列II
- 本周小结!(回溯算法系列三)
- 回溯算法去重问题的另一种写法
- 回溯算法:332.重新安排行程
- 回溯算法:51.N皇后
- 回溯算法:37.解数独
- 回溯算法总结篇
贪心算法
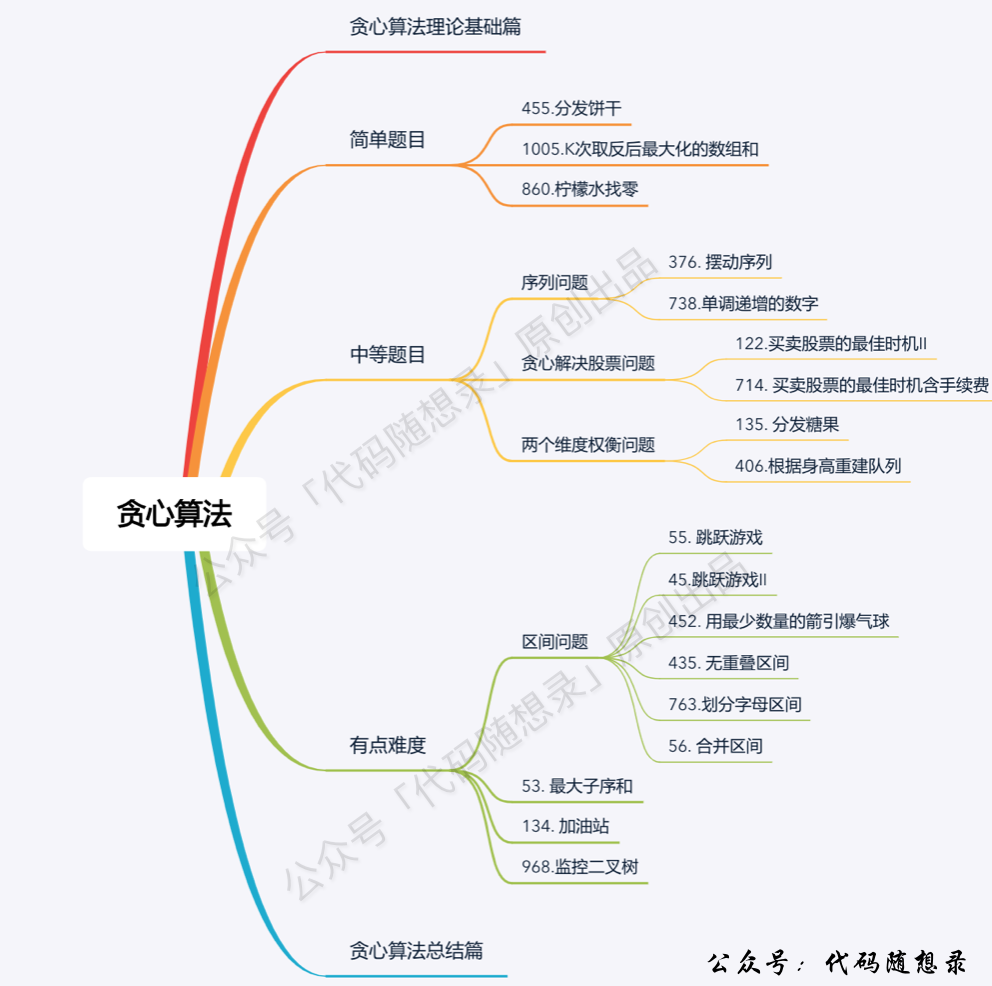
- 关于贪心算法,你该了解这些!
- 贪心算法:455.分发饼干
- 贪心算法:376.摆动序列
- 贪心算法:53.最大子序和
- 本周小结!(贪心算法系列一)
- 贪心算法:122.买卖股票的最佳时机II
- 贪心算法:55.跳跃游戏
- 贪心算法:45.跳跃游戏II
- 贪心算法:1005.K次取反后最大化的数组和
- 本周小结!(贪心算法系列二)
- 贪心算法:134.加油站
- 贪心算法:135.分发糖果
- 贪心算法:860.柠檬水找零
- 贪心算法:406.根据身高重建队列
- 本周小结!(贪心算法系列三)
- 贪心算法:406.根据身高重建队列(续集)
- 贪心算法:452.用最少数量的箭引爆气球
- 贪心算法:435.无重叠区间
- 贪心算法:763.划分字母区间
- 贪心算法:56.合并区间
- 本周小结!(贪心算法系列四)
- 贪心算法:738.单调递增的数字
- 贪心算法:968.监控二叉树
- 贪心算法:总结篇!(每逢总结必经典)
动态规划
动态规划专题已经开始啦,来不及解释了,小伙伴们上车别掉队!
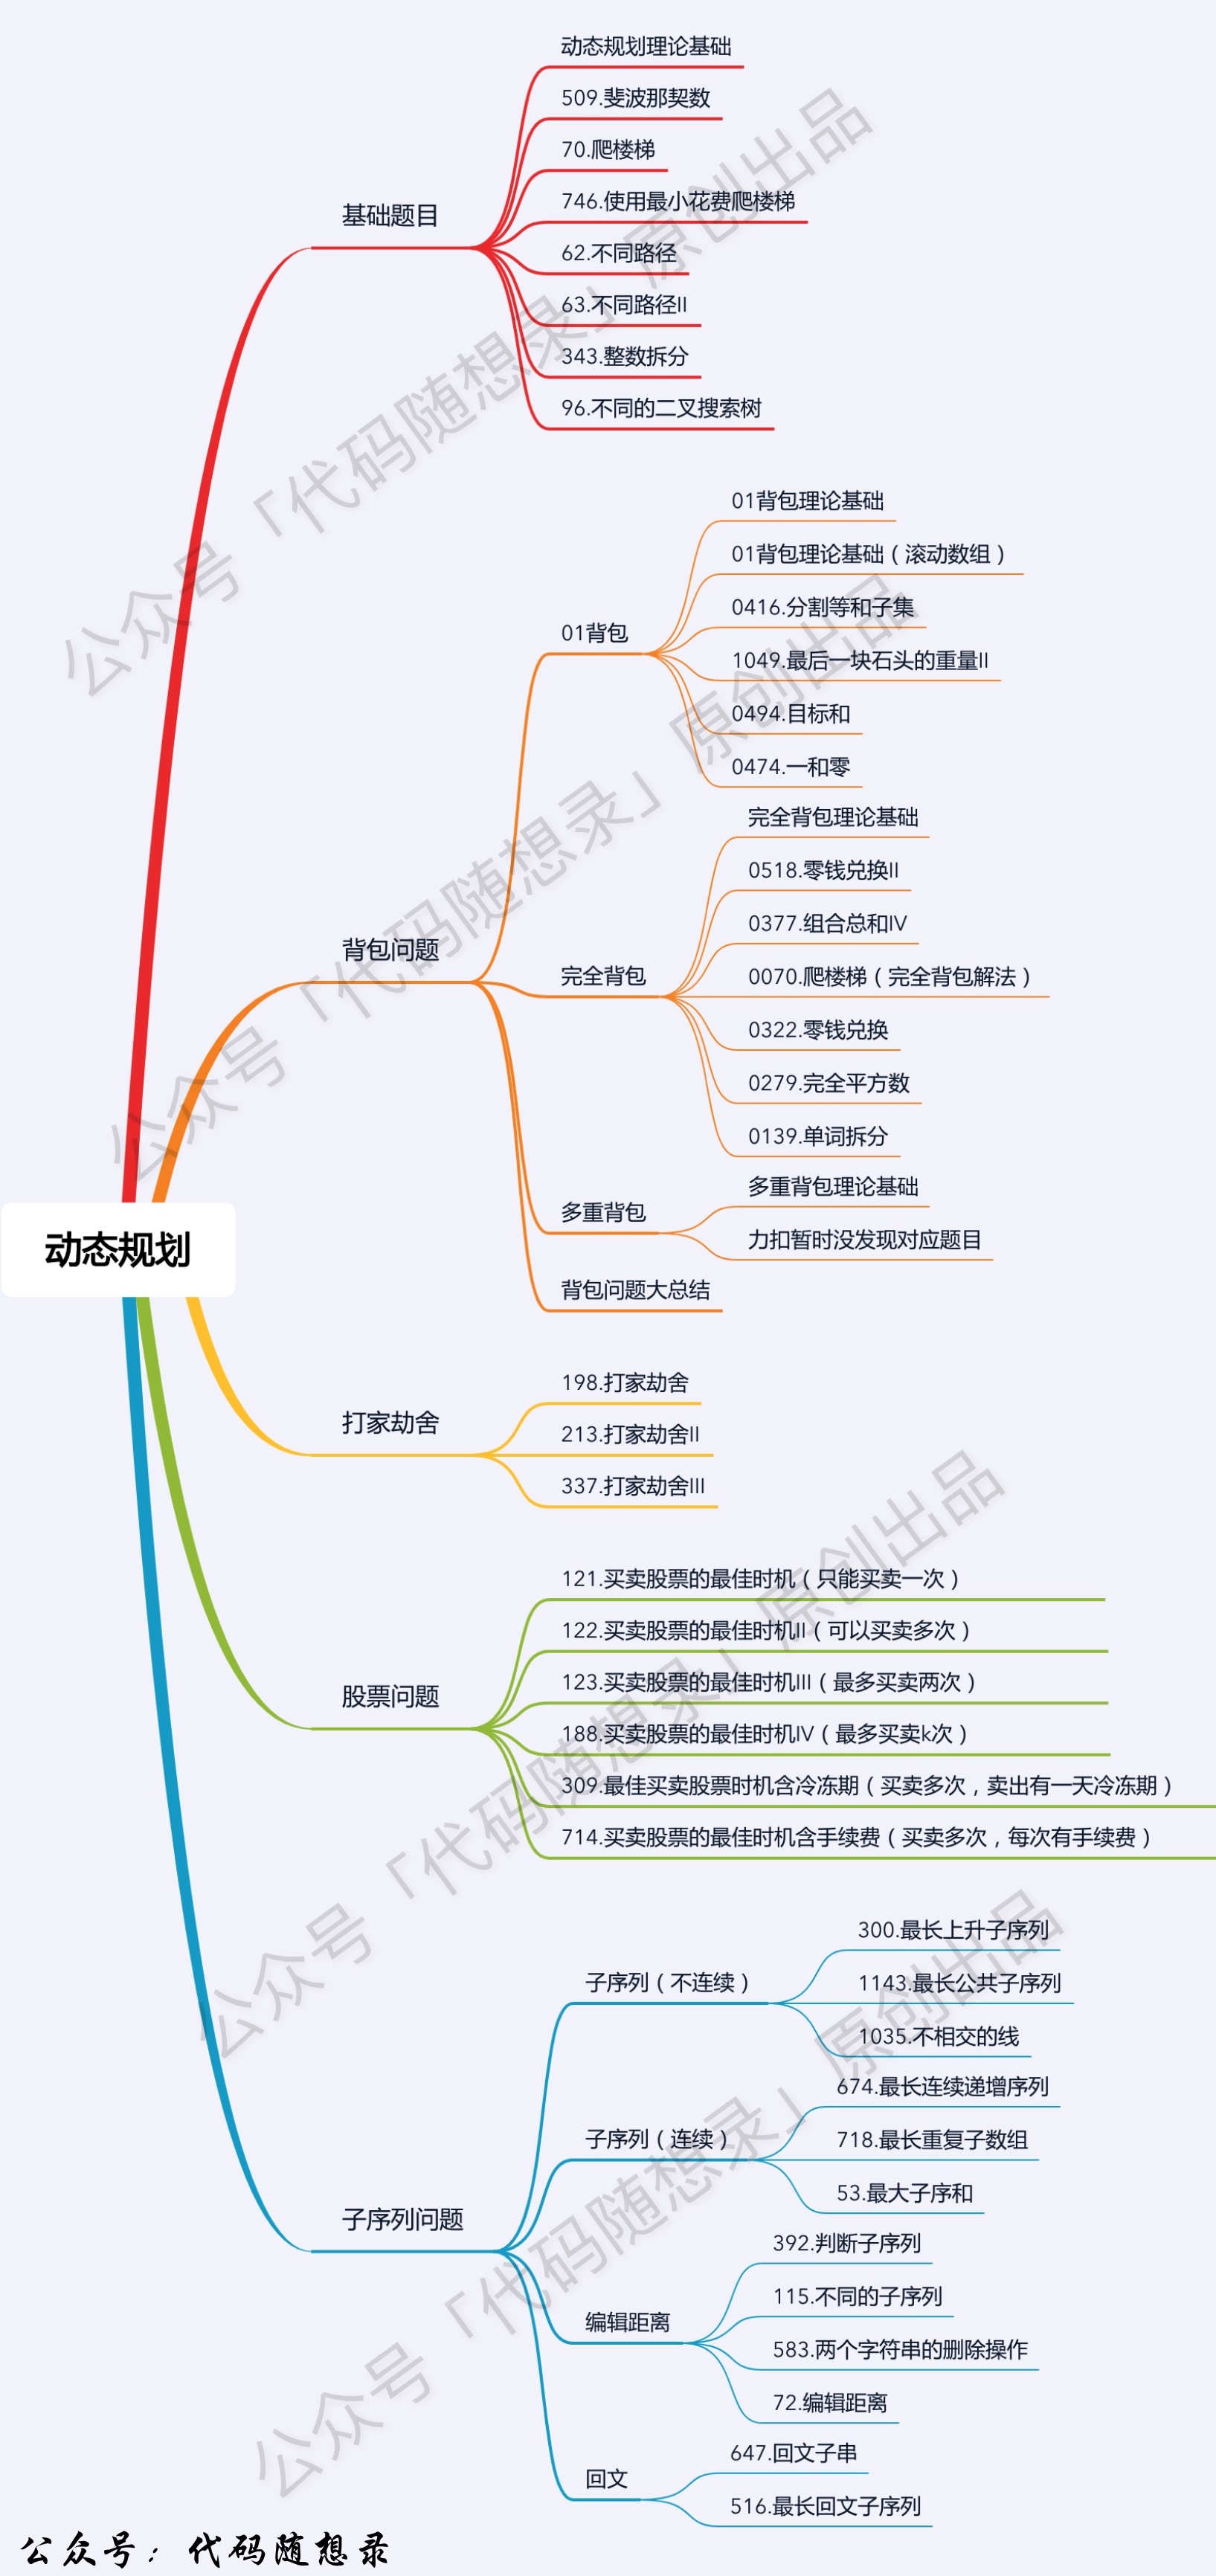 1. [关于动态规划,你该了解这些!](https://raw.githubusercontent.com/youngyangyang04/leetcode-master/HEAD/problems/动态规划理论基础.md)
2. [动态规划:509.斐波那契数](https://raw.githubusercontent.com/youngyangyang04/leetcode-master/HEAD/problems/0509.斐波那契数.md)
3. [动态规划:70.爬楼梯](https://raw.githubusercontent.com/youngyangyang04/leetcode-master/HEAD/problems/0070.爬楼梯.md)
4. [动态规划:746.使用最小花费爬楼梯](https://raw.githubusercontent.com/youngyangyang04/leetcode-master/HEAD/problems/0746.使用最小花费爬楼梯.md)
5. [本周小结!(动态规划系列一)](https://raw.githubusercontent.com/youngyangyang04/leetcode-master/HEAD/problems/周总结/20210107动规周末总结.md)
6. [动态规划:62.不同路径](https://raw.githubusercontent.com/youngyangyang04/leetcode-master/HEAD/problems/0062.不同路径.md)
7. [动态规划:63.不同路径II](https://raw.githubusercontent.com/youngyangyang04/leetcode-master/HEAD/problems/0063.不同路径II.md)
8. [动态规划:343.整数拆分](https://raw.githubusercontent.com/youngyangyang04/leetcode-master/HEAD/problems/0343.整数拆分.md)
9. [动态规划:96.不同的二叉搜索树](https://raw.githubusercontent.com/youngyangyang04/leetcode-master/HEAD/problems/0096.不同的二叉搜索树.md)
10. [本周小结!(动态规划系列二)](https://raw.githubusercontent.com/youngyangyang04/leetcode-master/HEAD/problems/周总结/20210114动规周末总结.md)
背包问题系列:
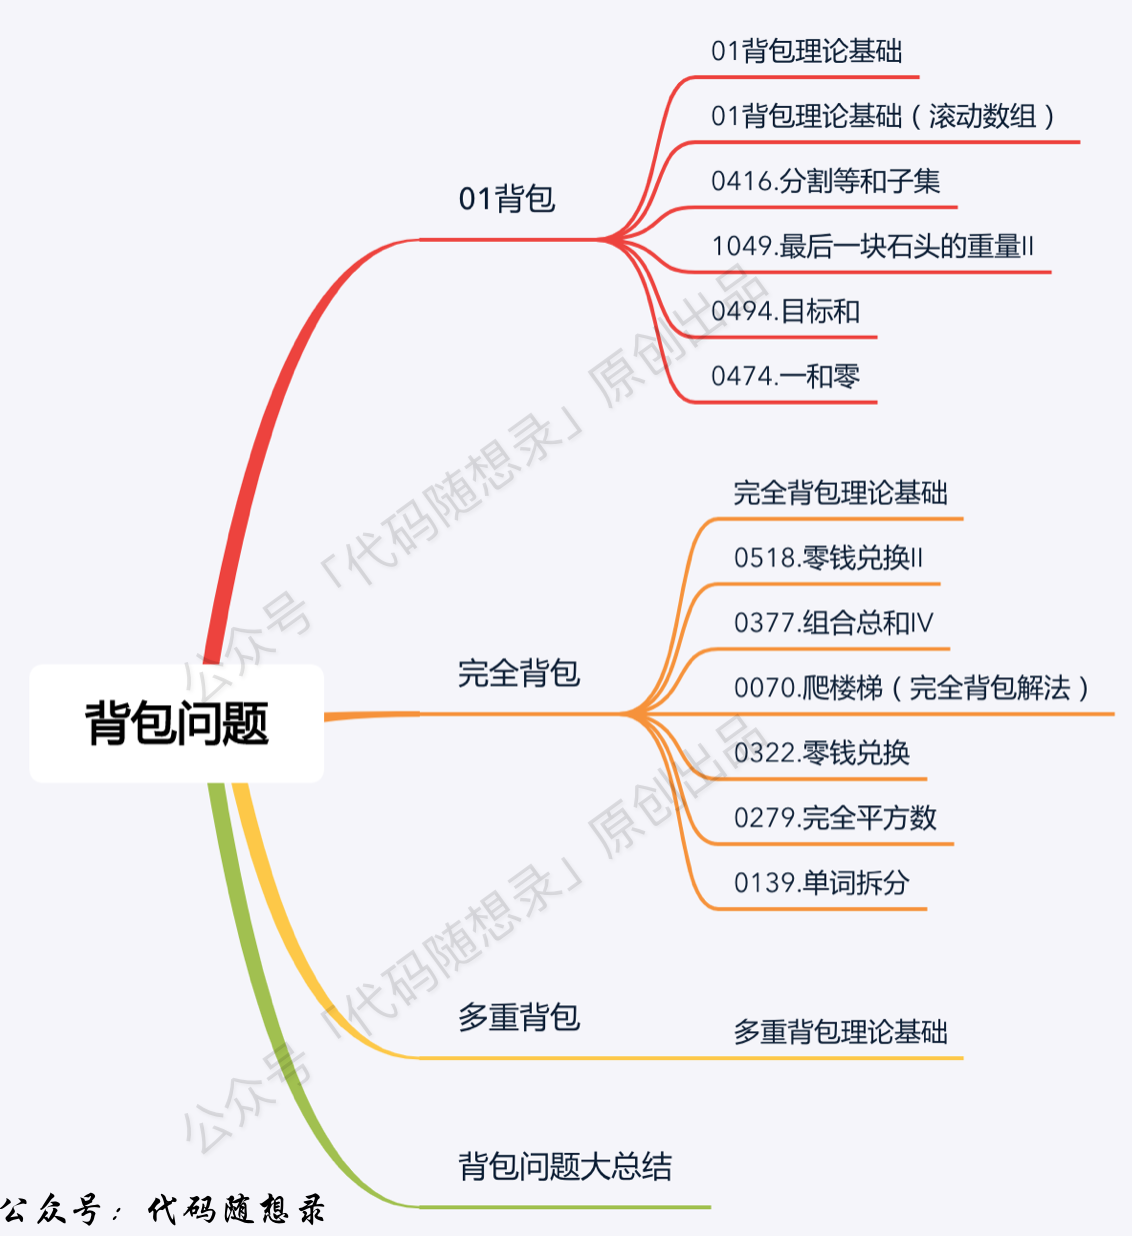
- 动态规划:01背包理论基础(二维dp数组)
- 动态规划:01背包理论基础(一维dp数组)
- 动态规划:416.分割等和子集
- 动态规划:1049.最后一块石头的重量II
- 本周小结!(动态规划系列三)
- 动态规划:494.目标和
- 动态规划:474.一和零
- 动态规划:完全背包理论基础(二维dp数组)
- 动态规划:完全背包理论基础(一维dp数组)
- 动态规划:518.零钱兑换II
- 本周小结!(动态规划系列四)
- 动态规划:377.组合总和Ⅳ
- 动态规划:70.爬楼梯(完全背包版本)
- 动态规划:322.零钱兑换
- 动态规划:279.完全平方数
- 本周小结!(动态规划系列五)
- 动态规划:139.单词拆分
- 动态规划:多重背包理论基础
- 背包问题总结篇
打家劫舍系列:
- 动态规划:198.打家劫舍
- 动态规划:213.打家劫舍II
- 动态规划:337.打家劫舍III
股票系列:
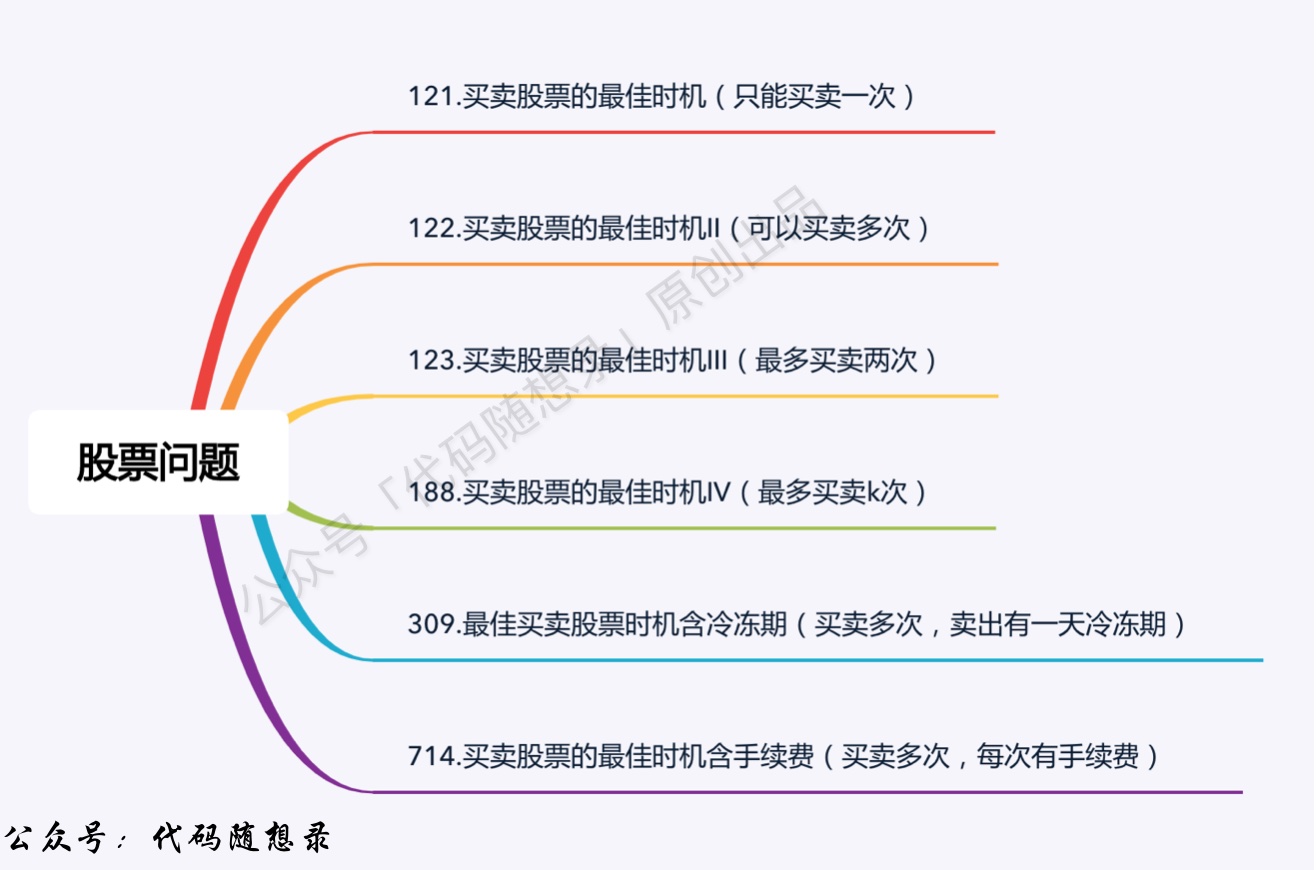
- 动态规划:121.买卖股票的最佳时机
- 动态规划:本周小结(系列六)
- 动态规划:122.买卖股票的最佳时机II
- 动态规划:123.买卖股票的最佳时机III
- 动态规划:188.买卖股票的最佳时机IV
- 动态规划:309.最佳买卖股票时机含冷冻期
- 动态规划:本周小结(系列七)
- 动态规划:714.买卖股票的最佳时机含手续费
- 动态规划:股票系列总结篇
子序列系列:
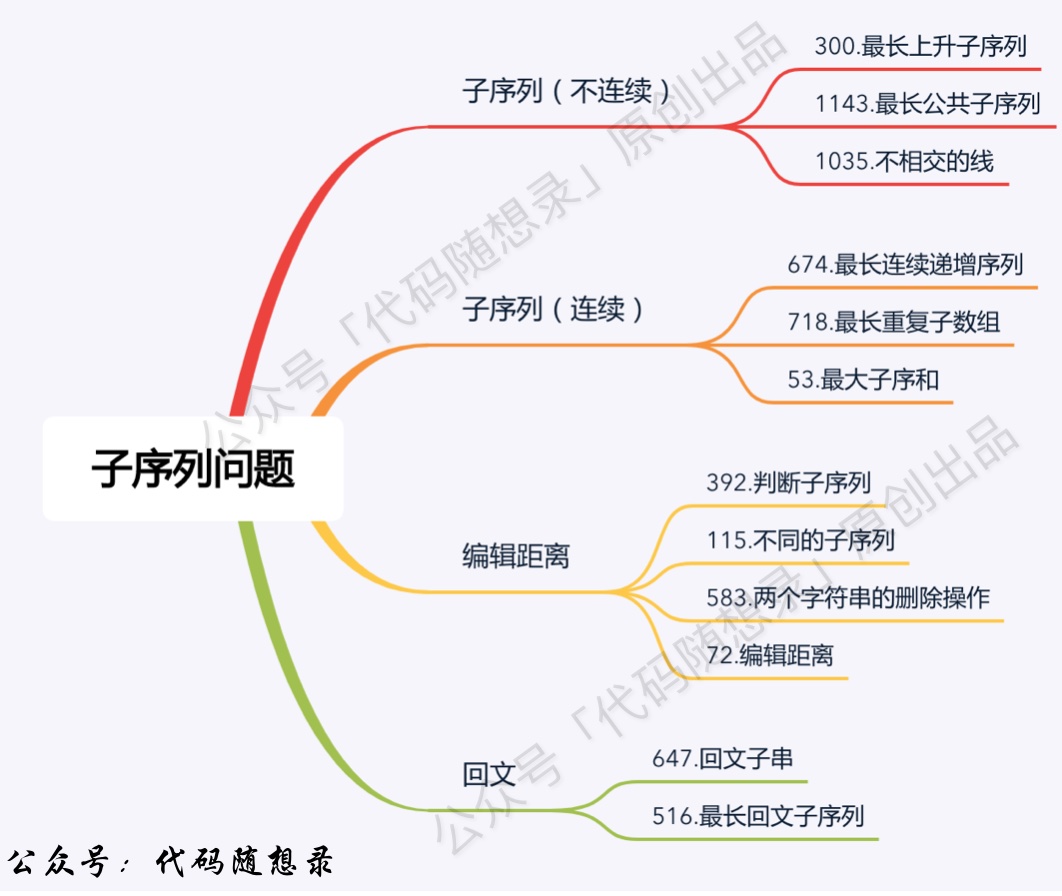
- 动态规划:300.最长递增子序列
- 动态规划:674.最长连续递增序列
- 动态规划:718.最长重复子数组
- 动态规划:1143.最长公共子序列
- 动态规划:1035.不相交的线
- 动态规划:53.最大子序和
- 动态规划:392.判断子序列
- 动态规划:115.不同的子序列
- 动态规划:583.两个字符串的删除操作
- 动态规划:72.编辑距离
- 编辑距离总结篇
- 动态规划:647.回文子串
- 动态规划:516.最长回文子序列
- 动态规划总结篇
单调栈
- 单调栈:739.每日温度
- 单调栈:496.下一个更大元素I
- 单调栈:503.下一个更大元素II
- 单调栈:42.接雨水
- 单调栈:84.柱状图中最大的矩形
图论
图论正式发布
- 图论:理论基础
- 图论:深度优先搜索理论基础
- 图论:所有可达路径
- 图论:广度优先搜索理论基础
- 图论:岛屿数量.深搜版
- 图论:岛屿数量.广搜版
- 图论:岛屿的最大面积
- 图论:孤岛的总面积
- 图论:沉没孤岛
- 图论:水流问题
- 图论:建造最大岛屿
- 图论:岛屿的周长
- 图论:字符串接龙
- 图论:有向图的完全可达性
- 图论:并查集理论基础
- 图论:寻找存在的路径
- 图论:冗余连接
- 图论:冗余连接II
- 图论:最小生成树之prim
- 图论:最小生成树之kruskal
- 图论:拓扑排序
- 图论:dijkstra(朴素版)
- 图论:dijkstra(堆优化版)
- 图论:Bellman_ford 算法
- 图论:Bellman_ford 队列优化算法(又名SPFA)
- 图论:Bellman_ford之判断负权回路
- 图论:Bellman_ford之单源有限最短路
- 图论:Floyd 算法
- 图论:A * 算法
- 图论:最短路算法总结篇
- 图论:图论总结篇
🧩 算法模板
🙌 参与贡献
⭐ Star 趋势

👨💻 关于作者
大家好,我是 程序员 Carl,哈工大师兄,先后在腾讯、百度从事后端与底层技术研发,著有《代码随想录》。
📥 PDF 下载与学习群
添加下方企业微信,自动获取 PDF 精讲,并可选择加入刷题群:
备注格式
- 在职:姓名-城市-岗位
- 学生:姓名-学校-年级(无备注不通过)
📜 版权说明
- 本仓库所有内容均为原创,引用需 注明出处与链接。
- 严禁恶意搬运与洗稿,侵权必究。
时间复杂度
关于时间复杂度,你不知道的都在这里!
相信每一位录友都接触过时间复杂度,但又对时间复杂度的认识处于一种朦胧的状态,所以是时候对时间复杂度来一个深度的剖析了。
本篇从如下六点进行分析:
- 究竟什么是时间复杂度
- 什么是大O
- 不同数据规模的差异
- 复杂表达式的化简
- O(log n)中的log是以什么为底?
- 举一个例子
这可能是你见过对时间复杂度分析最通透的一篇文章。
究竟什么是时间复杂度
时间复杂度是一个函数,它定性描述该算法的运行时间。
我们在软件开发中,时间复杂度就是用来方便开发者估算出程序运行的大体时间。
那么该如何估计程序运行时间呢,通常会估算算法的操作单元数量来代表程序消耗的时间,这里默认CPU的每个单元运行消耗的时间都是相同的。
假设算法的问题规模为n,那么操作单元数量便用函数f(n)来表示,随着数据规模n的增大,算法执行时间的增长率和f(n)的增长率相同,这称作为算法的渐近时间复杂度,简称时间复杂度,记为 O(f(n))。
什么是大O
这里的大O是指什么呢,说到时间复杂度,大家都知道O(n),O(n^2),却说不清什么是大O。
算法导论给出的解释:大O用来表示上界的,当用它作为算法的最坏情况运行时间的上界,就是对任意数据输入的运行时间的上界。
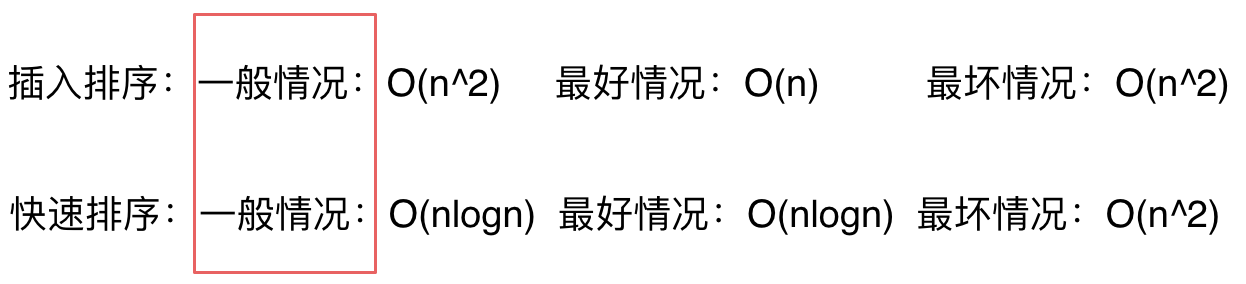
同样算法导论给出了例子:拿插入排序来说,插入排序的时间复杂度我们都说是O(n^2) 。
输入数据的形式对程序运算时间是有很大影响的,在数据本来有序的情况下时间复杂度是O(n),但如果数据是逆序的话,插入排序的时间复杂度就是O(n^2),也就对于所有输入情况来说,最坏是O(n^2) 的时间复杂度,所以称插入排序的时间复杂度为O(n^2)。
同样的同理再看一下快速排序,都知道快速排序是O(nlogn),但是当数据已经有序情况下,快速排序的时间复杂度是O(n^2) 的,所以严格从大O的定义来讲,快速排序的时间复杂度应该是O(n^2)。
但是我们依然说快速排序是O(nlogn)的时间复杂度,这个就是业内的一个默认规定,这里说的O代表的就是一般情况,而不是严格的上界。如图所示:
我们主要关心的还是一般情况下的数据形式。
面试中说的算法的时间复杂度是多少指的都是一般情况。但是如果面试官和我们深入探讨一个算法的实现以及性能的时候,就要时刻想着数据用例的不一样,时间复杂度也是不同的,这一点是一定要注意的。
不同数据规模的差异
如下图中可以看出不同算法的时间复杂度在不同数据输入规模下的差异。
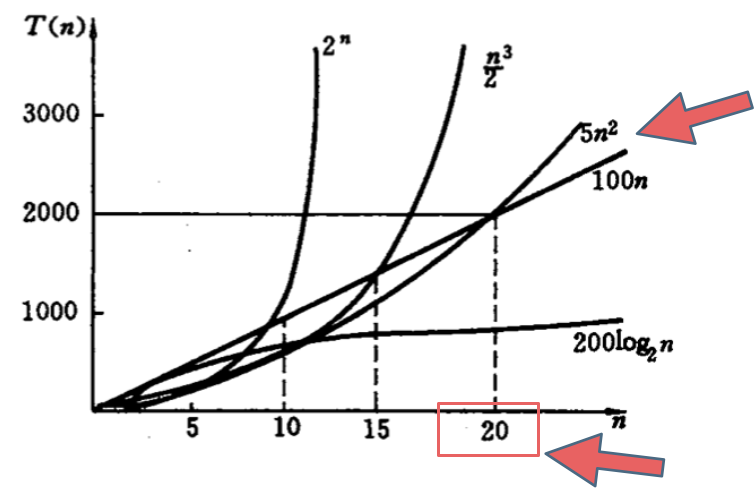
在决定使用哪些算法的时候,不是时间复杂越低的越好(因为简化后的时间复杂度忽略了常数项等等),要考虑数据规模,如果数据规模很小甚至可以用O(n^2)的算法比O(n)的更合适(在有常数项的时候)。
就像上图中 O(5n^2) 和 O(100n) 在n为20之前 很明显 O(5n^2)是更优的,所花费的时间也是最少的。
那为什么在计算时间复杂度的时候要忽略常数项系数呢,也就说O(100n) 就是O(n)的时间复杂度,O(5n^2) 就是O(n^2)的时间复杂度,而且要默认O(n) 优于O(n^2) 呢 ?
这里就又涉及到大O的定义,因为大O就是数据量级突破一个点且数据量级非常大的情况下所表现出的时间复杂度,这个数据量也就是常数项系数已经不起决定性作用的数据量。
例如上图中20就是那个点,n只要大于20 常数项系数已经不起决定性作用了。
所以我们说的时间复杂度都是省略常数项系数的,是因为一般情况下都是默认数据规模足够的大,基于这样的事实,给出的算法时间复杂度的一个排行如下所示:
O(1)常数阶 < O(logn)对数阶 < O(n)线性阶 < O(nlogn)线性对数阶 < O(n^2)平方阶 < O(n^3)立方阶 < O(2^n)指数阶
但是也要注意大常数,如果这个常数非常大,例如10^7 ,10^9 ,那么常数就是不得不考虑的因素了。
复杂表达式的化简
有时候我们去计算时间复杂度的时候发现不是一个简单的O(n) 或者O(n^2), 而是一个复杂的表达式,例如:
O(2*n^2 + 10*n + 1000)
那这里如何描述这个算法的时间复杂度呢,一种方法就是简化法。
去掉运行时间中的加法常数项 (因为常数项并不会因为n的增大而增加计算机的操作次数)。
O(2*n^2 + 10*n)
去掉常数系数(上文中已经详细讲过为什么可以去掉常数项的原因)。
O(n^2 + n)
只保留保留最高项,去掉数量级小一级的n (因为n^2 的数据规模远大于n),最终简化为:
O(n^2)
如果这一步理解有困难,那也可以做提取n的操作,变成O(n(n+1)) ,省略加法常数项后也就别变成了:
O(n^2)
所以最后我们说:这个算法的算法时间复杂度是O(n^2) 。
也可以用另一种简化的思路,其实当n大于40的时候, 这个复杂度会恒小于O(3 × n^2),
O(2 × n^2 + 10 × n + 1000) < O(3 × n^2),所以说最后省略掉常数项系数最终时间复杂度也是O(n^2)。
O(logn)中的log是以什么为底?
平时说这个算法的时间复杂度是logn的,那么一定是log 以2为底n的对数么?
其实不然,也可以是以10为底n的对数,也可以是以20为底n的对数,但我们统一说 logn,也就是忽略底数的描述。
为什么可以这么做呢?如下图所示:
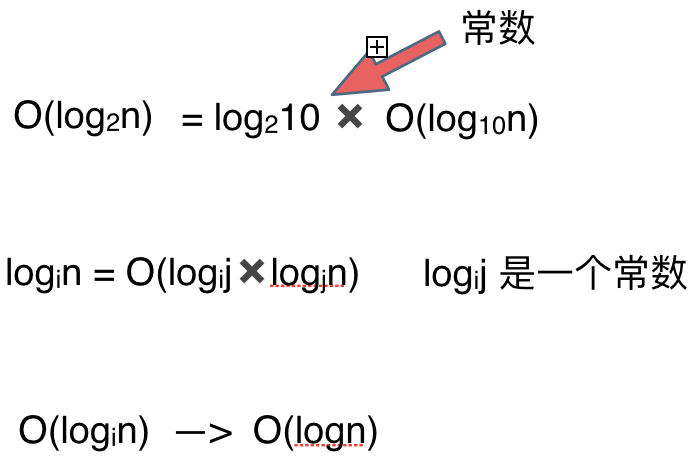
假如有两个算法的时间复杂度,分别是log以2为底n的对数和log以10为底n的对数,那么这里如果还记得高中数学的话,应该不难理解以2为底n的对数 = 以2为底10的对数 * 以10为底n的对数。
而以2为底10的对数是一个常数,在上文已经讲述了我们计算时间复杂度是忽略常数项系数的。
抽象一下就是在时间复杂度的计算过程中,log以i为底n的对数等于log 以j为底n的对数,所以忽略了i,直接说是logn。
这样就应该不难理解为什么忽略底数了。
举一个例子
通过这道面试题目,来分析一下时间复杂度。题目描述:找出n个字符串中相同的两个字符串(假设这里只有两个相同的字符串)。
如果是暴力枚举的话,时间复杂度是多少呢,是O(n^2)么?
这里一些同学会忽略了字符串比较的时间消耗,这里并不像int 型数字做比较那么简单,除了n^2 次的遍历次数外,字符串比较依然要消耗m次操作(m也就是字母串的长度),所以时间复杂度是O(m × n × n)。
接下来再想一下其他解题思路。
先排对n个字符串按字典序来排序,排序后n个字符串就是有序的,意味着两个相同的字符串就是挨在一起,然后在遍历一遍n个字符串,这样就找到两个相同的字符串了。
那看看这种算法的时间复杂度,快速排序时间复杂度为O(nlogn),依然要考虑字符串的长度是m,那么快速排序每次的比较都要有m次的字符比较的操作,就是O(m × n × log n) 。
之后还要遍历一遍这n个字符串找出两个相同的字符串,别忘了遍历的时候依然要比较字符串,所以总共的时间复杂度是 O(m × n × logn + n × m)。
我们对O(m × n × log n + n × m) 进行简化操作,把m × n提取出来变成 O(m × n × (logn + 1)),再省略常数项最后的时间复杂度是 O(m × n × log n)。
最后很明显O(m × n × logn) 要优于O(m × n × n)!
所以先把字符串集合排序再遍历一遍找到两个相同字符串的方法要比直接暴力枚举的方式更快。
这就是我们通过分析两种算法的时间复杂度得来的。
当然这不是这道题目的最优解,我仅仅是用这道题目来讲解一下时间复杂度。
总结
本篇讲解了什么是时间复杂度,复杂度是用来干什么,以及数据规模对时间复杂度的影响。
还讲解了被大多数同学忽略的大O的定义以及log究竟是以谁为底的问题。
再分析了如何简化复杂的时间复杂度,最后举一个具体的例子,把本篇的内容串起来。
相信看完本篇,大家对时间复杂度的认识会深刻很多!
算法超时
On的算法居然超时了,此时的n究竟是多大?
一些同学可能对计算机运行的速度还没有概念,就是感觉计算机运行速度应该会很快,那么在leetcode上做算法题目的时候为什么会超时呢?
计算机究竟1s可以执行多少次操作呢? 接下来探讨一下这个问题。
超时是怎么回事

大家在leetcode上练习算法的时候应该都遇到过一种错误是“超时”。
也就是说程序运行的时间超过了规定的时间,一般OJ(online judge)的超时时间就是1s,也就是用例数据输入后最多要1s内得到结果,暂时还不清楚leetcode的判题规则,下文为了方便讲解,暂定超时时间就是1s。
如果写出了一个 $O(n)$ 的算法 ,其实可以估算出来n是多大的时候算法的执行时间就会超过1s了。
如果n的规模已经足够让 $O(n)$ 的算法运行时间超过了1s,就应该考虑log(n)的解法了。
从硬件配置看计算机的性能
计算机的运算速度主要看CPU的配置,以2015年MacPro为例,CPU配置:2.7 GHz Dual-Core Intel Core i5 。
也就是 2.7 GHz 奔腾双核,i5处理器,GHz是指什么呢,1Hz = 1/s,1Hz 是CPU的一次脉冲(可以理解为一次改变状态,也叫时钟周期),称之为为赫兹,那么1GHz等于多少赫兹呢
- 1GHz(兆赫)= 1000MHz(兆赫)
- 1MHz(兆赫)= 1百万赫兹
所以 1GHz = 10亿Hz,表示CPU可以一秒脉冲10亿次(有10亿个时钟周期),这里不要简单理解一个时钟周期就是一次CPU运算。
例如1 + 2 = 3,cpu要执行四次才能完整这个操作,步骤一:把1放入寄存器,步骤二:把2放入寄存器,步骤三:做加法,步骤四:保存3。
而且计算机的cpu也不会只运行我们自己写的程序上,同时cpu也要执行计算机的各种进程任务等等,我们的程序仅仅是其中的一个进程而已。
所以我们的程序在计算机上究竟1s真正能执行多少次操作呢?
做个测试实验
在写测试程序测1s内处理多大数量级数据的时候,有三点需要注意:
- CPU执行每条指令所需的时间实际上并不相同,例如CPU执行加法和乘法操作的耗时实际上都是不一样的。
- 现在大多计算机系统的内存管理都有缓存技术,所以频繁访问相同地址的数据和访问不相邻元素所需的时间也是不同的。
- 计算机同时运行多个程序,每个程序里还有不同的进程线程在抢占资源。
尽管有很多因素影响,但是还是可以对自己程序的运行时间有一个大体的评估的。
引用算法4里面的一段话:
- 火箭科学家需要大致知道一枚试射火箭的着陆点是在大海里还是在城市中;
- 医学研究者需要知道一次药物测试是会杀死还是会治愈实验对象;
所以任何开发计算机程序的软件工程师都应该能够估计这个程序的运行时间是一秒钟还是一年。
这个是最基本的,所以以上误差就不算事了。
以下以C++代码为例:
测试硬件:2015年MacPro,CPU配置:2.7 GHz Dual-Core Intel Core i5
实现三个函数,时间复杂度分别是 $O(n)$ , $O(n^2)$ , $O(n\log n)$ ,使用加法运算来统一测试。
// O(n)
void function1(long long n) {
    long long k = 0;
    for (long long i = 0; i < n; i++) {
        k++;
    }
}
// O(n^2)
void function2(long long n) {
    long long k = 0;
    for (long long i = 0; i < n; i++) {
        for (long j = 0; j < n; j++) {
            k++;
        }
    }

}
// O(nlogn)
void function3(long long n) {
    long long k = 0;
    for (long long i = 0; i < n; i++) {
        for (long long j = 1; j < n; j = j*2) { // 注意这里j=1
            k++;
        }
    }
}
来看一下这三个函数随着n的规模变化,耗时会产生多大的变化,先测function1 ,就把 function2 和 function3 注释掉
int main() {
    long long n; // 数据规模
    while (1) {
        cout << "输入n:";
        cin >> n;
        milliseconds start_time = duration_cast<milliseconds >(
            system_clock::now().time_since_epoch()
        );
        function1(n);
//        function2(n);
//        function3(n);
        milliseconds end_time = duration_cast<milliseconds >(
            system_clock::now().time_since_epoch()
        );
        cout << "耗时:" << milliseconds(end_time).count() - milliseconds(start_time).count()
            <<" ms"<< endl;
    }
}
来看一下运行的效果,如下图:

O(n)的算法,1s内大概计算机可以运行 5 (10^8)次计算,可以推测一下 $O(n^2)$ 的算法应该1s可以处理的数量级的规模是 5 (10^8)开根号,实验数据如下。

O(n^2)的算法,1s内大概计算机可以运行 22500次计算,验证了刚刚的推测。
在推测一下 $O(n\log n)$ 的话, 1s可以处理的数据规模是什么呢?
理论上应该是比 $O(n)$ 少一个数量级,因为 $\log n$ 的复杂度 其实是很快,看一下实验数据。

$O(n\log n)$ 的算法,1s内大概计算机可以运行 2 * (10^7)次计算,符合预期。
这是在我个人PC上测出来的数据,不能说是十分精确,但数量级是差不多的,大家也可以在自己的计算机上测一下。
整体测试数据整理如下:

至于 $O(\log n)$ 和 $O(n^3)$ 等等这些时间复杂度在1s内可以处理的多大的数据规模,大家可以自己写一写代码去测一下了。
完整测试代码
#include <iostream>
#include <chrono>
#include <thread>
using namespace std;
using namespace chrono;
// O(n)
void function1(long long n) {
    long long k = 0;
    for (long long i = 0; i < n; i++) {
        k++;
    }
}

// O(n^2)
void function2(long long n) {
    long long k = 0;
    for (long long i = 0; i < n; i++) {
        for (long j = 0; j < n; j++) {
            k++;
        }
    }

}
// O(nlogn)
void function3(long long n) {
    long long k = 0;
    for (long long i = 0; i < n; i++) {
        for (long long j = 1; j < n; j = j*2) { // 注意这里j=1
            k++;
        }
    }
}
int main() {
    long long n; // 数据规模
    while (1) {
        cout << "输入n:";
        cin >> n;
        milliseconds start_time = duration_cast<milliseconds >(
            system_clock::now().time_since_epoch()
        );
        function1(n);
//        function2(n);
//        function3(n);
        milliseconds end_time = duration_cast<milliseconds >(
            system_clock::now().time_since_epoch()
        );
        cout << "耗时:" << milliseconds(end_time).count() - milliseconds(start_time).count()
            <<" ms"<< endl;
    }
}
Java版本
import java.util.Scanner;

public class TimeComplexity {
    // o(n)
    public static void function1(long n) {
        System.out.println("o(n)算法");
        long k = 0;
        for (long i = 0; i < n; i++) {
            k++;
        }
    }

    // o(n^2)
    public static void function2(long n) {
        System.out.println("o(n^2)算法");
        long k = 0;
        for (long i = 0; i < n; i++) {
            for (long j = 0; j < n; j++) {
                k++;
            }
        }
    }

    // o(nlogn)
    public static void function3(long n) {
        System.out.println("o(nlogn)算法");
        long k = 0;
        for (long i = 0; i < n; i++) {
            for (long j = 1; j < n; j = j * 2) { // 注意这里j=1
                k++;
            }
        }
    }

    public static void main(String[] args) {
        while(true) {
            Scanner in = new Scanner(System.in);
            System.out.print("输入n: ");
            int n = in.nextInt();
            long startTime = System.currentTimeMillis();

            function1(n);
            // function2(n);
            // function3(n);

            long endTime = System.currentTimeMillis();
            long costTime = endTime - startTime;
            System.out.println("算法耗时 == " + costTime + "ms");
        }
    }
}
总结
本文详细分析了在leetcode上做题程序为什么会有超时,以及从硬件配置上大体知道CPU的执行速度,然后亲自做一个实验来看看 $O(n)$ 的算法,跑一秒钟,这个n究竟是做大,最后给出不同时间复杂度,一秒内可以运算出来的n的大小。
建议录友们也都自己做一做实验,测一测,看看是不是和我的测出来的结果差不多。
这样,大家应该对程序超时时候的数据规模有一个整体的认识了。
就酱,如果感觉「代码随想录」很干货,就帮忙宣传一波吧,很多录友发现这里之后都感觉相见恨晚!
递归算法的时间复杂度
通过一道面试题目,讲一讲递归算法的时间复杂度!
本篇通过一道面试题,一个面试场景,来好好分析一下如何求递归算法的时间复杂度。
相信很多同学对递归算法的时间复杂度都很模糊,那么这篇来给大家通透的讲一讲。
同一道题目,同样使用递归算法,有的同学会写出了O(n)的代码,有的同学就写出了O(logn)的代码。
这是为什么呢?
如果对递归的时间复杂度理解的不够深入的话,就会这样!
那么我通过一道简单的面试题,模拟面试的场景,来带大家逐步分析递归算法的时间复杂度,最后找出最优解,来看看同样是递归,怎么就写成了O(n)的代码。
面试题:求x的n次方
想一下这么简单的一道题目,代码应该如何写呢。最直观的方式应该就是,一个for循环求出结果,代码如下:
int function1(int x, int n) {
    int result = 1;  // 注意 任何数的0次方等于1
    for (int i = 0; i < n; i++) {
        result = result * x;
    }
    return result;
}
时间复杂度为O(n),此时面试官会说,有没有效率更好的算法呢。
如果此时没有思路,不要说:我不会,我不知道了等等。
可以和面试官探讨一下,询问:“可不可以给点提示”。面试官提示:“考虑一下递归算法”。
那么就可以写出了如下这样的一个递归的算法,使用递归解决了这个问题。
int function2(int x, int n) {
    if (n == 0) {
        return 1; // return 1 同样是因为0次方是等于1的
    }
    return function2(x, n - 1) * x;
}
面试官问:“那么这个代码的时间复杂度是多少?”。
一些同学可能一看到递归就想到了O(log n),其实并不是这样,递归算法的时间复杂度本质上是要看: **递归的次数 每次递归中的操作次数*。
那再来看代码,这里递归了几次呢?
每次n-1,递归了n次时间复杂度是O(n),每次进行了一个乘法操作,乘法操作的时间复杂度一个常数项O(1),所以这份代码的时间复杂度是 n × 1 = O(n)。
这个时间复杂度就没有达到面试官的预期。于是又写出了如下的递归算法的代码:
int function3(int x, int n) {
    if (n == 0) return 1;
    if (n == 1) return x;

    if (n % 2 == 1) {
        return function3(x, n / 2) * function3(x, n / 2)*x;
    }
    return function3(x, n / 2) * function3(x, n / 2);
}
面试官看到后微微一笑,问:“这份代码的时间复杂度又是多少呢?” 此刻有些同学可能要陷入了沉思了。
我们来分析一下,首先看递归了多少次呢,可以把递归抽象出一棵满二叉树。刚刚同学写的这个算法,可以用一棵满二叉树来表示(为了方便表示,选择n为偶数16),如图:
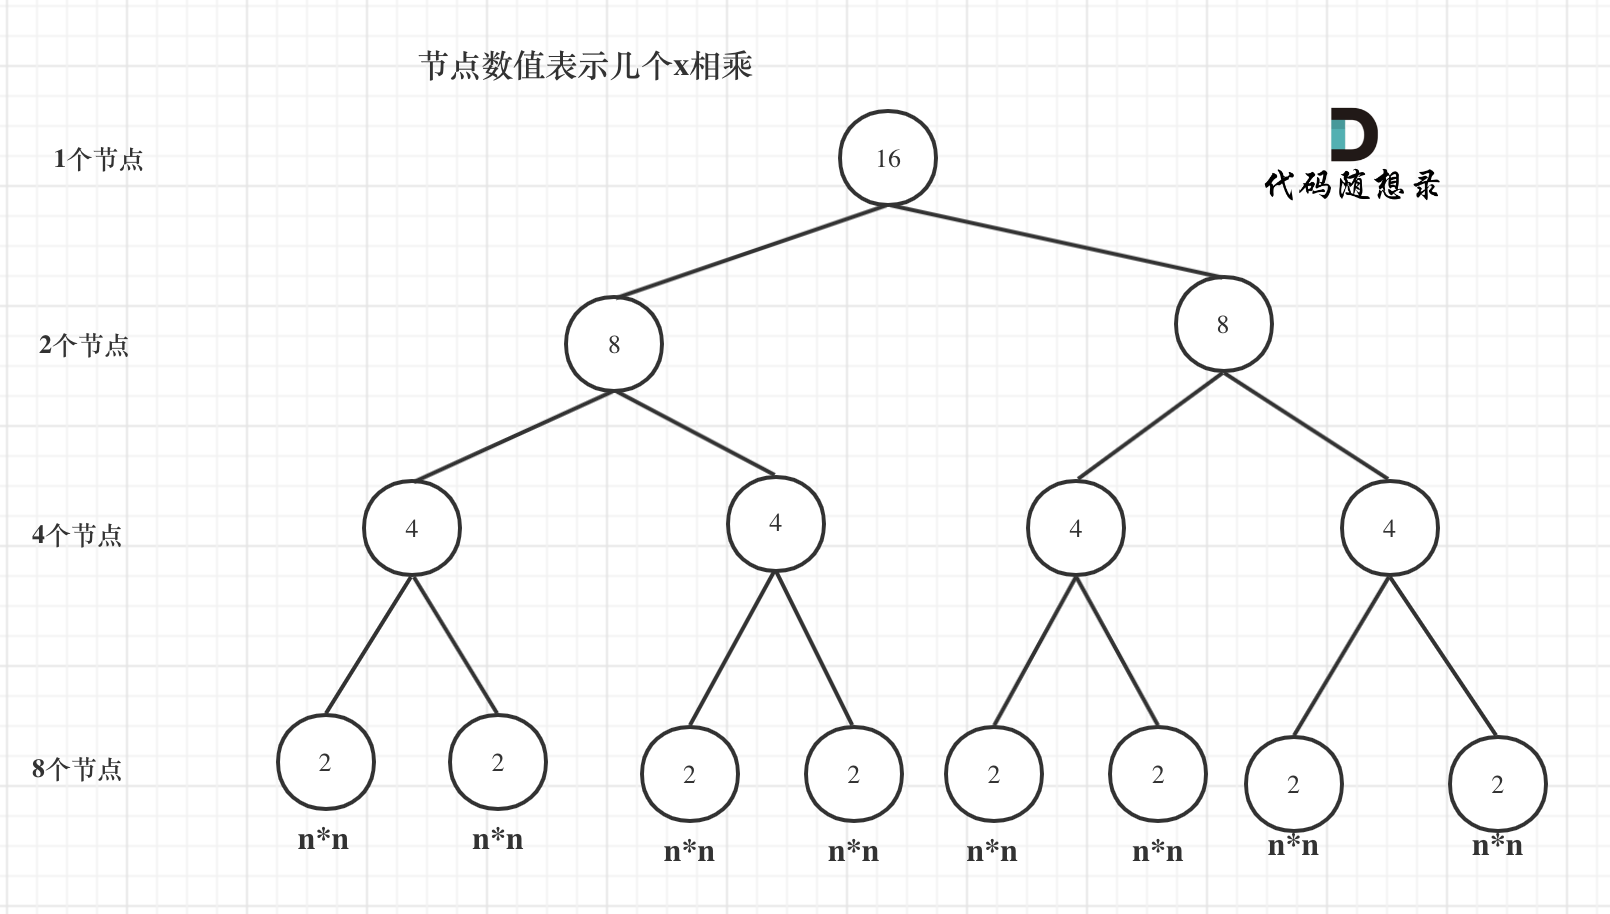
当前这棵二叉树就是求x的n次方,n为16的情况,n为16的时候,进行了多少次乘法运算呢?
这棵树上每一个节点就代表着一次递归并进行了一次相乘操作,所以进行了多少次递归的话,就是看这棵树上有多少个节点。
熟悉二叉树话应该知道如何求满二叉树节点数量,这棵满二叉树的节点数量就是2^3 + 2^2 + 2^1 + 2^0 = 15,可以发现:这其实是等比数列的求和公式,这个结论在二叉树相关的面试题里也经常出现。
这么如果是求x的n次方,这个递归树有多少个节点呢,如下图所示:(m为深度,从0开始)
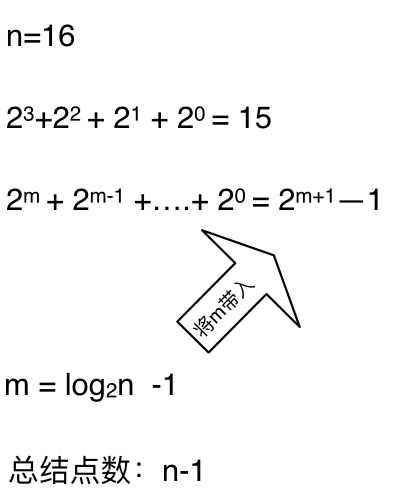
时间复杂度忽略掉常数项-1之后,这个递归算法的时间复杂度依然是O(n)。对,你没看错,依然是O(n)的时间复杂度!
此时面试官就会说:“这个递归的算法依然还是O(n)啊”, 很明显没有达到面试官的预期。
那么O(logn)的递归算法应该怎么写呢?
想一想刚刚给出的那份递归算法的代码,是不是有哪里比较冗余呢,其实有重复计算的部分。
于是又写出如下递归算法的代码:
int function4(int x, int n) {
    if (n == 0) return 1;
    if (n == 1) return x;
    int t = function4(x, n / 2);// 这里相对于function3,是把这个递归操作抽取出来
    if (n % 2 == 1) {
        return t * t * x;
    }
    return t * t;
}
再来看一下现在这份代码时间复杂度是多少呢?
依然还是看他递归了多少次,可以看到这里仅仅有一个递归调用,且每次都是n/2 ,所以这里我们一共调用了log以2为底n的对数次。
每次递归了做都是一次乘法操作,这也是一个常数项的操作,那么这个递归算法的时间复杂度才是真正的O(logn)。
此时大家最后写出了这样的代码并且将时间复杂度分析的非常清晰,相信面试官是比较满意的。
总结
对于递归的时间复杂度,毕竟初学者有时候会迷糊,刷过很多题的老手依然迷糊。
本篇我用一道非常简单的面试题目:求x的n次方,来逐步分析递归算法的时间复杂度,注意不要一看到递归就想到了O(logn)!
同样使用递归,有的同学可以写出O(logn)的代码,有的同学还可以写出O(n)的代码。
对于function3 这样的递归实现,很容易让人感觉这是O(log n)的时间复杂度,其实这是O(n)的算法!
int function3(int x, int n) {
    if (n == 0) return 1;
    if (n == 1) return x;
    if (n % 2 == 1) {
        return function3(x, n / 2) * function3(x, n / 2)*x;
    }
    return function3(x, n / 2) * function3(x, n / 2);
}
可以看出这道题目非常简单,但是又很考究算法的功底,特别是对递归的理解,这也是我面试别人的时候用过的一道题,所以整个情景我才写的如此逼真。
大厂面试的时候最喜欢用“简单题”来考察候选人的算法功底,注意这里的“简单题”可并不一定真的简单哦!
如果认真读完本篇,相信大家对递归算法的有一个新的认识的,同一道题目,同样是递归,效率可是不一样的!
空间复杂度
空间复杂度分析
那么一直还没有讲空间复杂度,所以打算陆续来补上,内容不难,大家可以读一遍文章就有整体的了解了。
什么是空间复杂度呢?
是对一个算法在运行过程中占用内存空间大小的量度,记做S(n)=O(f(n)。
空间复杂度(Space Complexity)记作S(n) 依然使用大O来表示。利用程序的空间复杂度,可以对程序运行中需要多少内存有个预先估计。
关注空间复杂度有两个常见的相关问题
- 空间复杂度是考虑程序(可执行文件)的大小么?
很多同学都会混淆程序运行时内存大小和程序本身的大小。这里强调一下空间复杂度是考虑程序运行时占用内存的大小,而不是可执行文件的大小。
- 空间复杂度是准确算出程序运行时所占用的内存么?
不要以为空间复杂度就已经精准的掌握了程序的内存使用大小,很多因素会影响程序真正内存使用大小,例如编译器的内存对齐,编程语言容器的底层实现等等这些都会影响到程序内存的开销。
所以空间复杂度是预先大体评估程序内存使用的大小。
说到空间复杂度,我想同学们在OJ(online judge)上应该遇到过这种错误,就是超出内存限制,一般OJ对程序运行时的所消耗的内存都有一个限制。
为了避免内存超出限制,这也需要我们对算法占用多大的内存有一个大体的预估。
同样在工程实践中,计算机的内存空间也不是无限的,需要工程师对软件运行时所使用的内存有一个大体评估,这都需要用到算法空间复杂度的分析。
来看一下例子,什么时候的空间复杂度是 $O(1)$ 呢,C++代码如下:
int j = 0;
for (int i = 0; i < n; i++) {
    j++;
}
第一段代码可以看出,随着n的变化,所需开辟的内存空间并不会随着n的变化而变化。即此算法空间复杂度为一个常量,所以表示为大O(1)。
什么时候的空间复杂度是O(n)?
当消耗空间和输入参数n保持线性增长,这样的空间复杂度为O(n),来看一下这段C++代码
int* a = new int(n);
for (int i = 0; i < n; i++) {
    a[i] = i;
}
我们定义了一个数组出来,这个数组占用的大小为n,虽然有一个for循环,但没有再分配新的空间,因此,这段代码的空间复杂度主要看第一行即可,随着n的增大,开辟的内存大小呈线性增长,即 O(n)。
其他的 O(n^2), O(n^3) 我想大家应该都可以以此例举出来了,那么思考一下 什么时候空间复杂度是 O(logn)呢?
空间复杂度是logn的情况确实有些特殊,其实是在递归的时候,会出现空间复杂度为logn的情况。
至于如何求递归的空间复杂度,我会在专门写一篇文章来介绍的,敬请期待!
递归算法的时间与空间复杂度分析
递归算法的时间与空间复杂度分析!
之前在通过一道面试题目,讲一讲递归算法的时间复杂度!中详细讲解了递归算法的时间复杂度,但没有讲空间复杂度。
本篇讲通过求斐波那契数列和二分法再来深入分析一波递归算法的时间和空间复杂度,细心看完,会刷新对递归的认知!
递归求斐波那契数列的性能分析
先来看一下求斐波那契数的递归写法。
int fibonacci(int i) {
       if(i <= 0) return 0;
       if(i == 1) return 1;
       return fibonacci(i-1) + fibonacci(i-2);
}
对于递归算法来说,代码一般都比较简短,从算法逻辑上看,所用的存储空间也非常少,但运行时需要内存可不见得会少。
时间复杂度分析
来看看这个求斐波那契的递归算法的时间复杂度是多少呢?
在讲解递归时间复杂度的时候,我们提到了递归算法的时间复杂度本质上是要看: **递归的次数 每次递归的时间复杂度*。
可以看出上面的代码每次递归都是O(1)的操作。再来看递归了多少次,这里将i为5作为输入的递归过程 抽象成一棵递归树,如图:
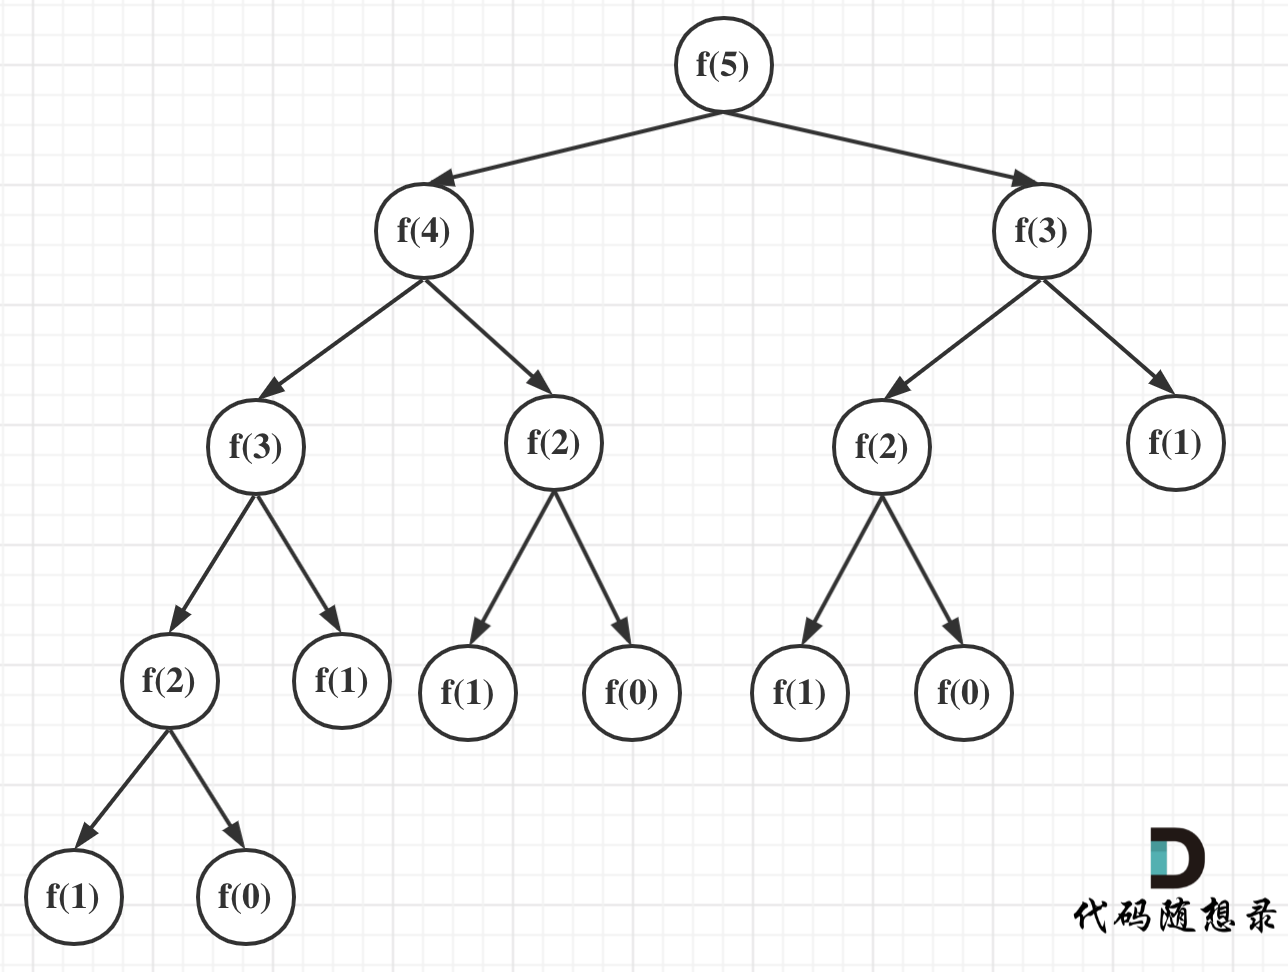
从图中,可以看出f(5)是由f(4)和f(3)相加而来,那么f(4)是由f(3)和f(2)相加而来 以此类推。
在这棵二叉树中每一个节点都是一次递归,那么这棵树有多少个节点呢?
我们之前也有说到,一棵深度(按根节点深度为1)为k的二叉树最多可以有 2^k - 1 个节点。
所以该递归算法的时间复杂度为O(2^n),这个复杂度是非常大的,随着n的增大,耗时是指数上升的。
来做一个实验,大家可以有一个直观的感受。
以下为C++代码,来测一下,让我们输入n的时候,这段递归求斐波那契代码的耗时。
#include <iostream>
#include <chrono>
#include <thread>
using namespace std;
using namespace chrono;
int fibonacci(int i) {
       if(i <= 0) return 0;
       if(i == 1) return 1;
       return fibonacci(i - 1) + fibonacci(i - 2);
}
void time_consumption() {
    int n;
    while (cin >> n) {
        milliseconds start_time = duration_cast<milliseconds >(
            system_clock::now().time_since_epoch()
        );

        fibonacci(n);

        milliseconds end_time = duration_cast<milliseconds >(
            system_clock::now().time_since_epoch()
        );
        cout << milliseconds(end_time).count() - milliseconds(start_time).count()
            <<" ms"<< endl;
    }
}
int main()
{
    time_consumption();
    return 0;
}
根据以上代码,给出几组实验数据:
测试电脑以2015版MacPro为例,CPU配置:2.7 GHz Dual-Core Intel Core i5
测试数据如下:
- n = 40,耗时:837 ms
- n = 50,耗时:110306 ms
可以看出,O(2^n)这种指数级别的复杂度是非常大的。
所以这种求斐波那契数的算法看似简洁,其实时间复杂度非常高,一般不推荐这样来实现斐波那契。
其实罪魁祸首就是这里的两次递归,导致了时间复杂度以指数上升。
return fibonacci(i-1) + fibonacci(i-2);
可不可以优化一下这个递归算法呢。 主要是减少递归的调用次数。
来看一下如下代码:
// 版本二
int fibonacci(int first, int second, int n) {
    if (n <= 0) {
        return 0;
    }
    if (n < 3) {
        return 1;
    }
    else if (n == 3) {
        return first + second;
    }
    else {
        return fibonacci(second, first + second, n - 1);
    }
}
这里相当于用first和second来记录当前相加的两个数值,此时就不用两次递归了。
因为每次递归的时候n减1,即只是递归了n次,所以时间复杂度是 O(n)。
同理递归的深度依然是n,每次递归所需的空间也是常数,所以空间复杂度依然是O(n)。
代码(版本二)的复杂度如下:
此时再来测一下耗时情况验证一下:
#include <iostream>
#include <chrono>
#include <thread>
using namespace std;
using namespace chrono;
int fibonacci_3(int first, int second, int n) {
    if (n <= 0) {
        return 0;
    }
    if (n < 3) {
        return 1;
    }
    else if (n == 3) {
        return first + second;
    }
    else {
        return fibonacci_3(second, first + second, n - 1);
    }
}

void time_consumption() {
    int n;
    while (cin >> n) {
        milliseconds start_time = duration_cast<milliseconds >(
            system_clock::now().time_since_epoch()
        );

        fibonacci_3(1, 1, n);

        milliseconds end_time = duration_cast<milliseconds >(
            system_clock::now().time_since_epoch()
        );
        cout << milliseconds(end_time).count() - milliseconds(start_time).count()
            <<" ms"<< endl;
    }
}
int main()
{
    time_consumption();
    return 0;
}
测试数据如下:
- n = 40,耗时:0 ms
- n = 50,耗时:0 ms
大家此时应该可以看出差距了!!
空间复杂度分析
说完了这段递归代码的时间复杂度,再看看如何求其空间复杂度呢,这里给大家提供一个公式:**递归算法的空间复杂度 = 每次递归的空间复杂度 递归深度*
为什么要求递归的深度呢?
因为每次递归所需的空间都被压到调用栈里(这是内存管理里面的数据结构,和算法里的栈原理是一样的),一次递归结束,这个栈就是就是把本次递归的数据弹出去。所以这个栈最大的长度就是递归的深度。
此时可以分析这段递归的空间复杂度,从代码中可以看出每次递归所需要的空间大小都是一样的,所以每次递归中需要的空间是一个常量,并不会随着n的变化而变化,每次递归的空间复杂度就是 $O(1)$ 。
在看递归的深度是多少呢?如图所示:
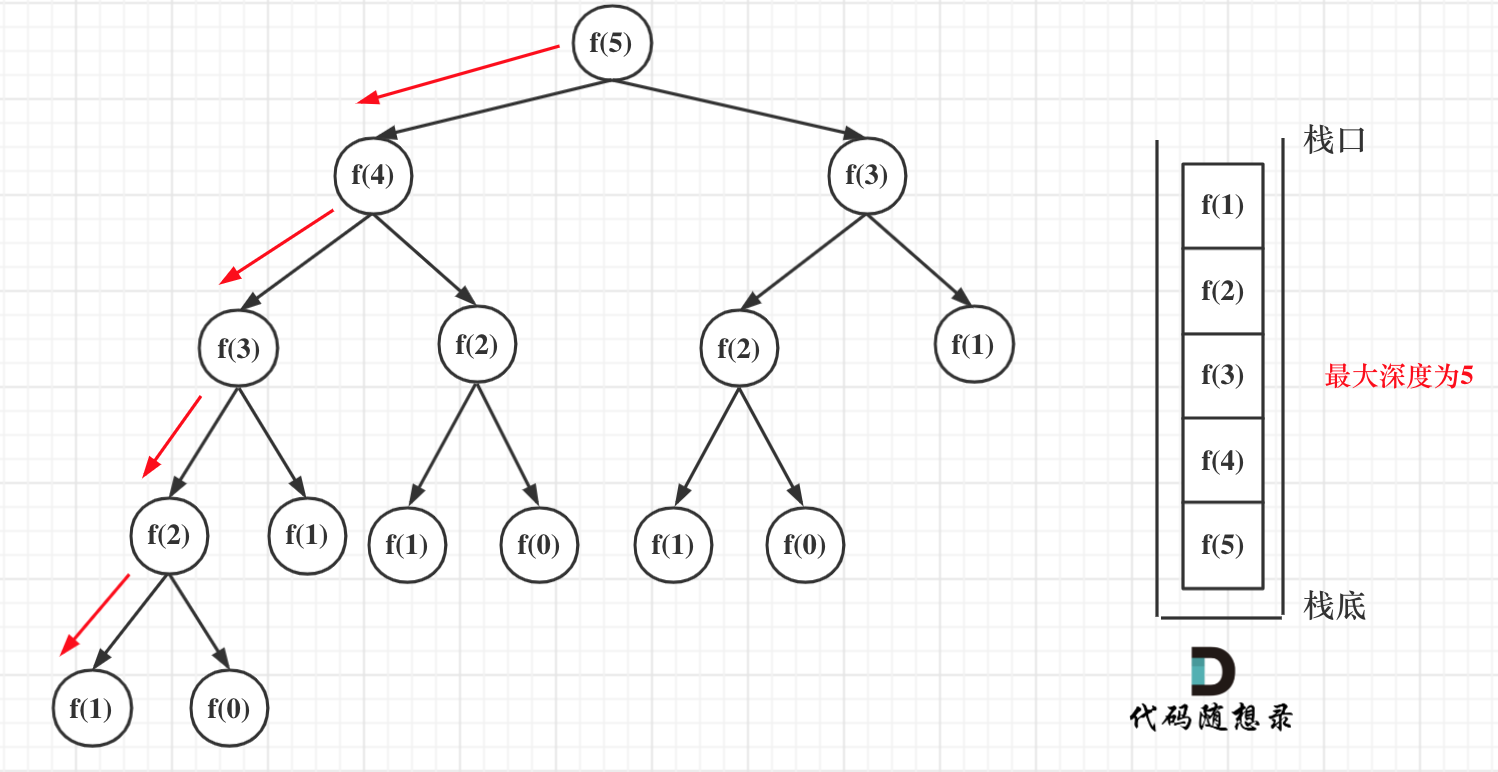
递归第n个斐波那契数的话,递归调用栈的深度就是n。
那么每次递归的空间复杂度是O(1), 调用栈深度为n,所以这段递归代码的空间复杂度就是O(n)。
int fibonacci(int i) {
       if(i <= 0) return 0;
       if(i == 1) return 1;
       return fibonacci(i-1) + fibonacci(i-2);
}
最后对各种求斐波那契数列方法的性能做一下分析,如题:
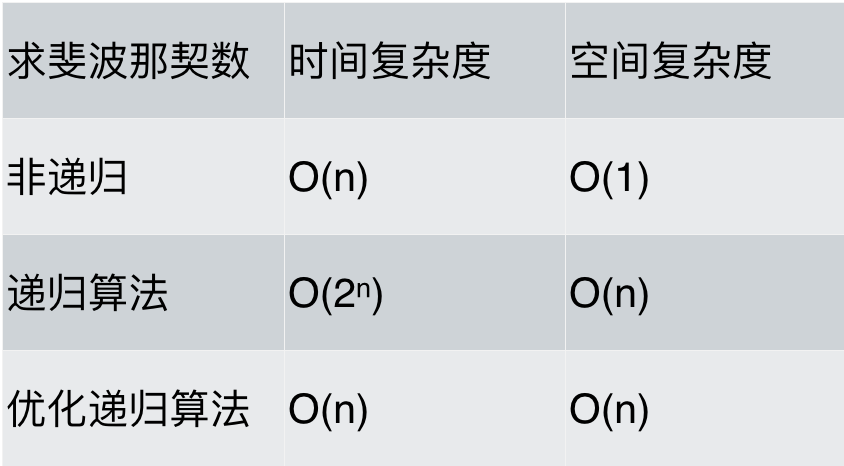
可以看出,求斐波那契数的时候,使用递归算法并不一定是在性能上是最优的,但递归确实简化的代码层面的复杂度。
二分法(递归实现)的性能分析
带大家再分析一段二分查找的递归实现。
int binary_search( int arr[], int l, int r, int x) {
    if (r >= l) {
        int mid = l + (r - l) / 2;
        if (arr[mid] == x)
            return mid;
        if (arr[mid] > x)
            return binary_search(arr, l, mid - 1, x);
        return binary_search(arr, mid + 1, r, x);
    }
    return -1;
}
都知道二分查找的时间复杂度是O(logn),那么递归二分查找的空间复杂度是多少呢?
我们依然看 每次递归的空间复杂度和递归的深度
每次递归的空间复杂度可以看出主要就是参数里传入的这个arr数组,但需要注意的是在C/C++中函数传递数组参数,不是整个数组拷贝一份传入函数而是传入的数组首元素地址。
也就是说每一层递归都是公用一块数组地址空间的,所以 每次递归的空间复杂度是常数即:O(1)。
再来看递归的深度,二分查找的递归深度是logn ,递归深度就是调用栈的长度,那么这段代码的空间复杂度为 1 * logn = O(logn)。
大家要注意自己所用的语言在传递函数参数的时,是拷贝整个数值还是拷贝地址,如果是拷贝整个数值那么该二分法的空间复杂度就是O(nlogn)。
总结
本章我们详细分析了递归实现的求斐波那契和二分法的空间复杂度,同时也对时间复杂度做了分析。
特别是两种递归实现的求斐波那契数列,其时间复杂度截然不容,我们还做了实验,验证了时间复杂度为O(2^n)是非常耗时的。
通过本篇大家应该对递归算法的时间复杂度和空间复杂度有更加深刻的理解了。
内存消耗
刷了这么多题,你了解自己代码的内存消耗么?
理解代码的内存消耗,最关键是要知道自己所用编程语言的内存管理。
不同语言的内存管理
不同的编程语言各自的内存管理方式。
- C/C++这种内存堆空间的申请和释放完全靠自己管理
- Java 依赖JVM来做内存管理,不了解jvm内存管理的机制,很可能会因一些错误的代码写法而导致内存泄漏或内存溢出
- Python内存管理是由私有堆空间管理的,所有的python对象和数据结构都存储在私有堆空间中。程序员没有访问堆的权限,只有解释器才能操作。
例如Python万物皆对象,并且将内存操作封装的很好,所以python的基本数据类型所用的内存会要远大于存放纯数据类型所占的内存,例如,我们都知道存储int型数据需要四个字节,但是使用Python 申请一个对象来存放数据的话,所用空间要远大于四个字节。
C++的内存管理
以C++为例来介绍一下编程语言的内存管理。
如果我们写C++的程序,就要知道栈和堆的概念,程序运行时所需的内存空间分为 固定部分,和可变部分,如下:

固定部分的内存消耗 是不会随着代码运行产生变化的, 可变部分则是会产生变化的
更具体一些,一个由C/C++编译的程序占用的内存分为以下几个部分:
- 栈区(Stack) :由编译器自动分配释放,存放函数的参数值,局部变量的值等,其操作方式类似于数据结构中的栈。
- 堆区(Heap) :一般由程序员分配释放,若程序员不释放,程序结束时可能由OS收回
- 未初始化数据区(Uninitialized Data): 存放未初始化的全局变量和静态变量
- 初始化数据区(Initialized Data):存放已经初始化的全局变量和静态变量
- 程序代码区(Text):存放函数体的二进制代码
代码区和数据区所占空间都是固定的,而且占用的空间非常小,那么看运行时消耗的内存主要看可变部分。
在可变部分中,栈区间的数据在代码块执行结束之后,系统会自动回收,而堆区间数据是需要程序员自己回收,所以也就是造成内存泄漏的发源地。
而Java、Python的话则不需要程序员去考虑内存泄漏的问题,虚拟机都做了这些事情。
如何计算程序占用多大内存
想要算出自己程序会占用多少内存就一定要了解自己定义的数据类型的大小,如下:

注意图中有两个不一样的地方,为什么64位的指针就占用了8个字节,而32位的指针占用4个字节呢?
1个字节占8个比特,那么4个字节就是32个比特,可存放数据的大小为2^32,也就是4G空间的大小,即:可以寻找4G空间大小的内存地址。
大家现在使用的计算机一般都是64位了,所以编译器也都是64位的。
安装64位的操作系统的计算机内存都已经超过了4G,也就是指针大小如果还是4个字节的话,就已经不能寻址全部的内存地址,所以64位编译器使用8个字节的指针才能寻找所有的内存地址。
注意2^64是一个非常巨大的数,对于寻找地址来说已经足够用了。
内存对齐
再介绍一下内存管理中另一个重要的知识点:内存对齐。
不要以为只有C/C++才会有内存对齐,只要可以跨平台的编程语言都需要做内存对齐,Java、Python都是一样的。
而且这是面试中面试官非常喜欢问到的问题,就是:为什么会有内存对齐?
主要是两个原因
- 平台原因:不是所有的硬件平台都能访问任意内存地址上的任意数据,某些硬件平台只能在某些地址处取某些特定类型的数据,否则抛出硬件异常。为了同一个程序可以在多平台运行,需要内存对齐。
- 硬件原因:经过内存对齐后,CPU访问内存的速度大大提升。
可以看一下这段C++代码输出的各个数据类型大小是多少?
struct node{
   int num;
   char cha;
}st;
int main() {
    int a[100];
    char b[100];
    cout << sizeof(int) << endl;
    cout << sizeof(char) << endl;
    cout << sizeof(a) << endl;
    cout << sizeof(b) << endl;
    cout << sizeof(st) << endl;
}
看一下和自己想的结果一样么, 我们来逐一分析一下。
其输出的结果依次为:
4
1
400
100
8
此时会发现,和单纯计算字节数的话是有一些误差的。
这就是因为内存对齐的原因。
来看一下内存对齐和非内存对齐产生的效果区别。
CPU读取内存不是一次读取单个字节,而是一块一块的来读取内存,块的大小可以是2,4,8,16个字节,具体取多少个字节取决于硬件。
假设CPU把内存划分为4字节大小的块,要读取一个4字节大小的int型数据,来看一下这两种情况下CPU的工作量:
第一种就是内存对齐的情况,如图:

一字节的char占用了四个字节,空了三个字节的内存地址,int数据从地址4开始。
此时,直接将地址4,5,6,7处的四个字节数据读取到即可。
第二种是没有内存对齐的情况如图:

char型的数据和int型的数据挨在一起,该int数据从地址1开始,那么CPU想要读这个数据的话来看看需要几步操作:
- 因为CPU是四个字节四个字节来寻址,首先CPU读取0,1,2,3处的四个字节数据
- CPU读取4,5,6,7处的四个字节数据
- 合并地址1,2,3,4处四个字节的数据才是本次操作需要的int数据
此时一共需要两次寻址,一次合并的操作。
大家可能会发现内存对齐岂不是浪费的内存资源么?
是这样的,但事实上,相对来说计算机内存资源一般都是充足的,我们更希望的是提高运行速度。
编译器一般都会做内存对齐的优化操作,也就是说当考虑程序真正占用的内存大小的时候,也需要认识到内存对齐的影响。
总结
不少同学对这方面的知识很欠缺,基本处于盲区,通过这一篇大家可以初步补齐一下这块。
之后也可以有意识的去学习自己所用的编程语言是如何管理内存的,这些也是程序员的内功。
数组理论基础
数组理论基础
数组是非常基础的数据结构,在面试中,考察数组的题目一般在思维上都不难,主要是考察对代码的掌控能力
也就是说,想法很简单,但实现起来 可能就不是那么回事了。
首先要知道数组在内存中的存储方式,这样才能真正理解数组相关的面试题
数组是存放在连续内存空间上的相同类型数据的集合。
数组可以方便的通过下标索引的方式获取到下标对应的数据。
举一个字符数组的例子,如图所示:
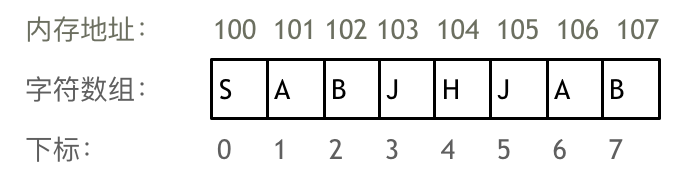
需要两点注意的是
- 数组下标都是从0开始的。
- 数组内存空间的地址是连续的
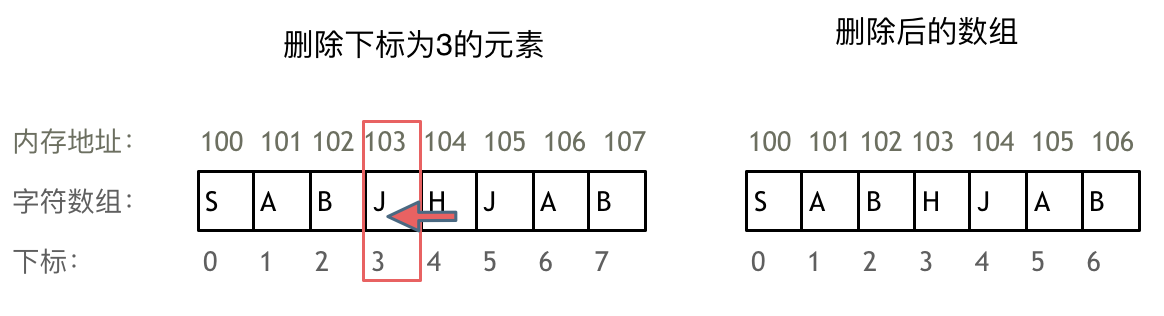
正是因为数组在内存空间的地址是连续的,所以我们在删除或者增添元素的时候,就难免要移动其他元素的地址。
例如删除下标为3的元素,需要对下标为3的元素后面的所有元素都要做移动操作,如图所示:
而且大家如果使用C++的话,要注意vector 和 array的区别,vector的底层实现是array,严格来讲vector是容器,不是数组。
数组的元素是不能删的,只能覆盖。
那么二维数组直接上图,大家应该就知道怎么回事了

那么二维数组在内存的空间地址是连续的么?
不同编程语言的内存管理是不一样的,以C++为例,在C++中二维数组是连续分布的。
我们来做一个实验,C++测试代码如下:
void test_arr() {
    int array[2][3] = {
		{0, 1, 2},
		{3, 4, 5}
    };
    cout << &array[0][0] << " " << &array[0][1] << " " << &array[0][2] << endl;
    cout << &array[1][0] << " " << &array[1][1] << " " << &array[1][2] << endl;
}

int main() {
    test_arr();
}
测试地址为
0x7ffee4065820 0x7ffee4065824 0x7ffee4065828
0x7ffee406582c 0x7ffee4065830 0x7ffee4065834
注意地址为16进制,可以看出二维数组地址是连续一条线的。
一些录友可能看不懂内存地址,我就简单介绍一下, 0x7ffee4065820 与 0x7ffee4065824 差了一个4,就是4个字节,因为这是一个int型的数组,所以两个相邻数组元素地址差4个字节。
0x7ffee4065828 与 0x7ffee406582c 也是差了4个字节,在16进制里8 + 4 = c,c就是12。
如图:

所以可以看出在C++中二维数组在地址空间上是连续的。
像Java是没有指针的,同时也不对程序员暴露其元素的地址,寻址操作完全交给虚拟机。
所以看不到每个元素的地址情况,这里我以Java为例,也做一个实验。
public static void test_arr() {
    int[][] arr = {{1, 2, 3}, {3, 4, 5}, {6, 7, 8}, {9,9,9}};
    System.out.println(arr[0]);
    System.out.println(arr[1]);
    System.out.println(arr[2]);
    System.out.println(arr[3]);
}
输出的地址为:
[I@7852e922
[I@4e25154f
[I@70dea4e
[I@5c647e05
这里的数值也是16进制,这不是真正的地址,而是经过处理过后的数值了,我们也可以看出,二维数组的每一行头结点的地址是没有规则的,更谈不上连续。
所以Java的二维数组可能是如下排列的方式:

这里面试中数组相关的理论知识就介绍完了。
二分查找
704. 二分查找
力扣题目链接
给定一个 n 个元素有序的(升序)整型数组 nums 和一个目标值 target ,写一个函数搜索 nums 中的 target,如果目标值存在返回下标,否则返回 -1。
示例 1:
输入: nums = [-1,0,3,5,9,12], target = 9
输出: 4
解释: 9 出现在 nums 中并且下标为 4
示例 2:
输入: nums = [-1,0,3,5,9,12], target = 2
输出: -1
解释: 2 不存在 nums 中因此返回 -1
提示:
- 你可以假设 nums 中的所有元素是不重复的。
- n 将在 [1, 10000]之间。
- nums 的每个元素都将在 [-9999, 9999]之间。
算法公开课
《代码随想录》算法视频公开课:手把手带你撕出正确的二分法,相信结合视频再看本篇题解,更有助于大家对本题的理解。
思路
这道题目的前提是数组为有序数组,同时题目还强调数组中无重复元素,因为一旦有重复元素,使用二分查找法返回的元素下标可能不是唯一的,这些都是使用二分法的前提条件,当大家看到题目描述满足如上条件的时候,可要想一想是不是可以用二分法了。
二分查找涉及的很多的边界条件,逻辑比较简单,但就是写不好。例如到底是 while(left < right) 还是 while(left <= right),到底是right = middle呢,还是要right = middle - 1呢?
大家写二分法经常写乱,主要是因为对区间的定义没有想清楚,区间的定义就是不变量。要在二分查找的过程中,保持不变量,就是在while寻找中每一次边界的处理都要坚持根据区间的定义来操作,这就是循环不变量规则。
写二分法,区间的定义一般为两种,左闭右闭即[left, right],或者左闭右开即[left, right)。
下面我用这两种区间的定义分别讲解两种不同的二分写法。
二分法第一种写法
第一种写法,我们定义 target 是在一个在左闭右闭的区间里,也就是[left, right] (这个很重要非常重要)。
区间的定义这就决定了二分法的代码应该如何写,因为定义target在[left, right]区间,所以有如下两点:
- while (left <= right) 要使用 <= ,因为left == right是有意义的,所以使用 <=
- if (nums[middle] > target) right 要赋值为 middle - 1,因为当前这个nums[middle]一定不是target,那么接下来要查找的左区间结束下标位置就是 middle - 1
例如在数组:1,2,3,4,7,9,10中查找元素2,如图所示:
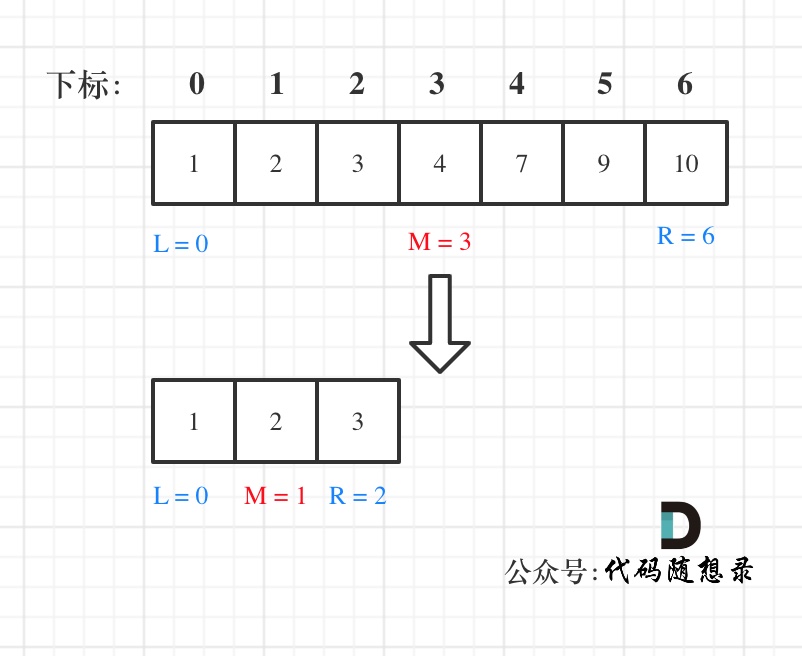
代码如下:(详细注释)
// 版本一
class Solution {
public:
    int search(vector<int>& nums, int target) {
        int left = 0;
        int right = nums.size() - 1; // 定义target在左闭右闭的区间里,[left, right]
        while (left <= right) { // 当left==right,区间[left, right]依然有效,所以用 <=
            int middle = left + ((right - left) / 2);// 防止溢出 等同于(left + right)/2
            if (nums[middle] > target) {
                right = middle - 1; // target 在左区间,所以[left, middle - 1]
            } else if (nums[middle] < target) {
                left = middle + 1; // target 在右区间,所以[middle + 1, right]
            } else { // nums[middle] == target
                return middle; // 数组中找到目标值,直接返回下标
            }
        }
        // 未找到目标值
        return -1;
    }
};
二分法第二种写法
如果说定义 target 是在一个在左闭右开的区间里,也就是[left, right) ,那么二分法的边界处理方式则截然不同。
有如下两点:
- while (left < right),这里使用 < ,因为left == right在区间[left, right)是没有意义的
- if (nums[middle] > target) right 更新为 middle,因为当前nums[middle]不等于target,去左区间继续寻找,而寻找区间是左闭右开区间,所以right更新为middle,即:下一个查询区间不会去比较nums[middle]
在数组:1,2,3,4,7,9,10中查找元素2,如图所示:(注意和方法一的区别)
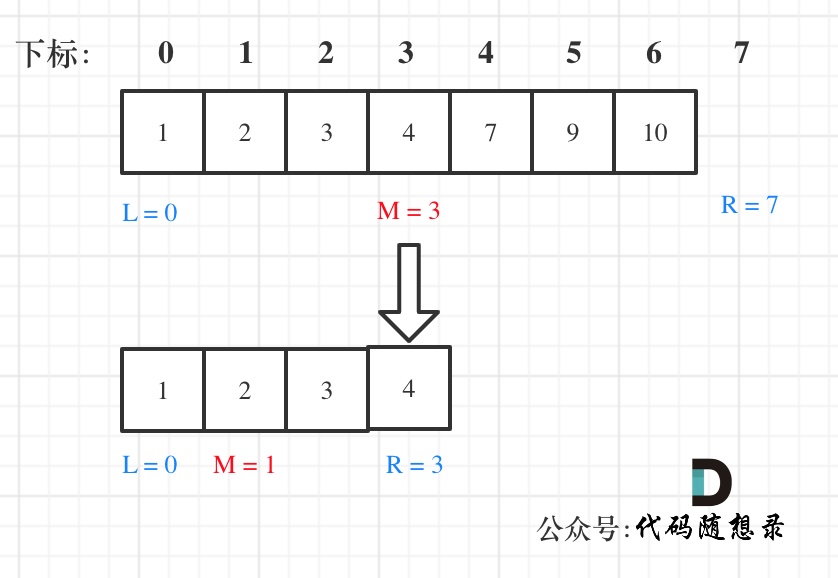
代码如下:(详细注释)
// 版本二
class Solution {
public:
    int search(vector<int>& nums, int target) {
        int left = 0;
        int right = nums.size(); // 定义target在左闭右开的区间里,即:[left, right)
        while (left < right) { // 因为left == right的时候,在[left, right)是无效的空间,所以使用 <
            int middle = left + ((right - left) >> 1);
            if (nums[middle] > target) {
                right = middle; // target 在左区间,在[left, middle)中
            } else if (nums[middle] < target) {
                left = middle + 1; // target 在右区间,在[middle + 1, right)中
            } else { // nums[middle] == target
                return middle; // 数组中找到目标值,直接返回下标
            }
        }
        // 未找到目标值
        return -1;
    }
};
总结
二分法是非常重要的基础算法,为什么很多同学对于二分法都是一看就会,一写就废?
其实主要就是对区间的定义没有理解清楚,在循环中没有始终坚持根据查找区间的定义来做边界处理。
区间的定义就是不变量,那么在循环中坚持根据查找区间的定义来做边界处理,就是循环不变量规则。
本篇根据两种常见的区间定义,给出了两种二分法的写法,每一个边界为什么这么处理,都根据区间的定义做了详细介绍。
相信看完本篇应该对二分法有更深刻的理解了。
相关题目推荐
其他语言版本
Java:
(版本一)左闭右闭区间
class Solution {
    public int search(int[] nums, int target) {
        // 避免当 target 小于nums[0] nums[nums.length - 1]时多次循环运算
        if (target < nums[0] || target > nums[nums.length - 1]) {
            return -1;
        }
        int left = 0, right = nums.length - 1;
        while (left <= right) {
            int mid = left + ((right - left) >> 1);
            if (nums[mid] == target) {
                return mid;
            }
            else if (nums[mid] < target) {
                left = mid + 1;
            }
            else { // nums[mid] > target
                right = mid - 1;
            }
        }
        // 未找到目标值
        return -1;
    }
}
(版本二)左闭右开区间
class Solution {
    public int search(int[] nums, int target) {
        int left = 0, right = nums.length;
        while (left < right) {
            int mid = left + ((right - left) >> 1);
            if (nums[mid] == target) {
                return mid;
            }
            else if (nums[mid] < target) {
                left = mid + 1;
            }
            else { // nums[mid] > target
                right = mid;
            }
        }
        // 未找到目标值
        return -1;
    }
}
Python:
(版本一)左闭右闭区间
class Solution:
    def search(self, nums: List[int], target: int) -> int:
        left, right = 0, len(nums) - 1  # 定义target在左闭右闭的区间里,[left, right]

        while left <= right:
            middle = left + (right - left) // 2

            if nums[middle] > target:
                right = middle - 1  # target在左区间,所以[left, middle - 1]
            elif nums[middle] < target:
                left = middle + 1  # target在右区间,所以[middle + 1, right]
            else:
                return middle  # 数组中找到目标值,直接返回下标
        return -1  # 未找到目标值
(版本二)左闭右开区间
class Solution:
    def search(self, nums: List[int], target: int) -> int:
        left, right = 0, len(nums)  # 定义target在左闭右开的区间里,即:[left, right)

        while left < right:  # 因为left == right的时候,在[left, right)是无效的空间,所以使用 <
            middle = left + (right - left) // 2

            if nums[middle] > target:
                right = middle  # target 在左区间,在[left, middle)中
            elif nums[middle] < target:
                left = middle + 1  # target 在右区间,在[middle + 1, right)中
            else:
                return middle  # 数组中找到目标值,直接返回下标
        return -1  # 未找到目标值
Go:
(版本一)左闭右闭区间
// 时间复杂度 O(logn)
func search(nums []int, target int) int {
	// 初始化左右边界
	left := 0
	right := len(nums) - 1

	// 循环逐步缩小区间范围
	for left <= right {
		// 求区间中点
		mid := left + (right-left)>>1

		// 根据 nums[mid] 和 target 的大小关系
		// 调整区间范围
		if nums[mid] == target {
			return mid
		} else if nums[mid] < target {
			left = mid + 1
		} else {
			right = mid - 1
		}
	}

	// 在输入数组内没有找到值等于 target 的元素
	return -1
}
(版本二)左闭右开区间
// 时间复杂度 O(logn)
func search(nums []int, target int) int {
	// 初始化左右边界
	left := 0
	right := len(nums)

	// 循环逐步缩小区间范围
	for left < right {
		// 求区间中点
		mid := left + (right-left)>>1

		// 根据 nums[mid] 和 target 的大小关系
		// 调整区间范围
		if nums[mid] == target {
			return mid
		} else if nums[mid] < target {
			left = mid + 1
		} else {
			right = mid
		}
	}

	// 在输入数组内没有找到值等于 target 的元素
	return -1
}
JavaScript:
(版本一)左闭右闭区间 [left, right]
/**
 * @param {number[]} nums
 * @param {number} target
 * @return {number}
 */
var search = function(nums, target) {
    // right是数组最后一个数的下标,num[right]在查找范围内,是左闭右闭区间
    let mid, left = 0, right = nums.length - 1;
    // 当left=right时,由于nums[right]在查找范围内,所以要包括此情况
    while (left <= right) {
        // 位运算 + 防止大数溢出
        mid = left + ((right - left) >> 1);
        // 如果中间数大于目标值,要把中间数排除查找范围,所以右边界更新为mid-1;如果右边界更新为mid,那中间数还在下次查找范围内
        if (nums[mid] > target) {
            right = mid - 1;  // 去左面闭区间寻找
        } else if (nums[mid] < target) {
            left = mid + 1;   // 去右面闭区间寻找
        } else {
            return mid;
        }
    }
    return -1;
};
(版本二)左闭右开区间 [left, right)
/**
 * @param {number[]} nums
 * @param {number} target
 * @return {number}
 */
var search = function(nums, target) {
    // right是数组最后一个数的下标+1,nums[right]不在查找范围内,是左闭右开区间
    let mid, left = 0, right = nums.length;
    // 当left=right时,由于nums[right]不在查找范围,所以不必包括此情况
    while (left < right) {
        // 位运算 + 防止大数溢出
        mid = left + ((right - left) >> 1);
        // 如果中间值大于目标值,中间值不应在下次查找的范围内,但中间值的前一个值应在;
        // 由于right本来就不在查找范围内,所以将右边界更新为中间值,如果更新右边界为mid-1则将中间值的前一个值也踢出了下次寻找范围
        if (nums[mid] > target) {
            right = mid;  // 去左区间寻找
        } else if (nums[mid] < target) {
            left = mid + 1;   // 去右区间寻找
        } else {
            return mid;
        }
    }
    return -1;
};
TypeScript
(版本一)左闭右闭区间
function search(nums: number[], target: number): number {
    let mid: number, left: number = 0, right: number = nums.length - 1;
    while (left <= right) {
        // 位运算 + 防止大数溢出
        mid = left + ((right - left) >> 1);
        if (nums[mid] > target) {
            right = mid - 1;
        } else if (nums[mid] < target) {
            left = mid + 1;
        } else {
            return mid;
        }
    }
    return -1;
};
(版本二)左闭右开区间
function search(nums: number[], target: number): number {
    let mid: number, left: number = 0, right: number = nums.length;
    while (left < right) {
        // 位运算 + 防止大数溢出
        mid = left +((right - left) >> 1);
        if (nums[mid] > target) {
            right = mid;
        } else if (nums[mid] < target) {
            left = mid + 1;
        } else {
            return mid;
        }
    }
    return -1;
};
Ruby:
# (版本一)左闭右闭区间

def search(nums, target)
  left, right = 0, nums.length - 1
  while left <= right	# 由于定义target在一个在左闭右闭的区间里,因此极限情况下存在left==right
    middle = (left + right) / 2
    if nums[middle] > target
      right = middle - 1
    elsif nums[middle] < target
      left = middle + 1
    else
      return middle	# return兼具返回与跳出循环的作用
    end
  end
  -1
end

# (版本二)左闭右开区间

def search(nums, target)
  left, right = 0, nums.length
  while left < right	# 由于定义target在一个在左闭右开的区间里,因此极限情况下right=left+1
    middle = (left + right) / 2
    if nums[middle] > target
      right = middle
    elsif nums[middle] < target
      left = middle + 1
    else
      return middle
    end
  end
  -1
end
Swift:
// (版本一)左闭右闭区间
func search(nums: [Int], target: Int) -> Int {
    // 1. 先定义区间。这里的区间是[left, right]
    var left = 0
    var right = nums.count - 1

    while left <= right {// 因为taeget是在[left, right]中,包括两个边界值,所以这里的left == right是有意义的
        // 2. 计算区间中间的下标(如果left、right都比较大的情况下,left + right就有可能会溢出)
        // let middle = (left + right) / 2
        // 防溢出:
         let middle = left + (right - left) / 2

        // 3. 判断
        if target < nums[middle] {
            // 当目标在区间左侧,就需要更新右边的边界值,新区间为[left, middle - 1]
            right = middle - 1
        } else if target > nums[middle] {
            // 当目标在区间右侧,就需要更新左边的边界值,新区间为[middle + 1, right]
            left = middle + 1
        } else {
            // 当目标就是在中间,则返回中间值的下标
            return middle
        }
    }

    // 如果找不到目标,则返回-1
    return -1
}

// (版本二)左闭右开区间
func search(nums: [Int], target: Int) -> Int {
    var left = 0
    var right = nums.count

    while left < right {
        let middle = left + ((right - left) >> 1)

        if target < nums[middle] {
            right = middle
        } else if target > nums[middle] {
            left = middle + 1
        } else {
            return middle
        }
    }

    return -1
}
Rust:
(版本一)左闭右闭区间
use std::cmp::Ordering;
impl Solution {
    pub fn search(nums: Vec<i32>, target: i32) -> i32 {
        let (mut left, mut right) = (0_i32, nums.len() as i32 - 1);
        while left <= right {
            let mid = (right + left) / 2;
            match nums[mid as usize].cmp(&target) {
                Ordering::Less => left = mid + 1,
                Ordering::Greater => right = mid - 1,
                Ordering::Equal => return mid,
            }
        }
        -1
    }
}
//(版本二)左闭右开区间
use std::cmp::Ordering;
impl Solution {
    pub fn search(nums: Vec<i32>, target: i32) -> i32 {
        let (mut left, mut right) = (0_i32, nums.len() as i32);
        while left < right {
            let mid = (right + left) / 2;
            match nums[mid as usize].cmp(&target) {
                Ordering::Less => left = mid + 1,
                Ordering::Greater => right = mid,
                Ordering::Equal => return mid,
            }
        }
        -1
    }
}
C:
// (版本一) 左闭右闭区间 [left, right]
int search(int* nums, int numsSize, int target){
    int left = 0;
    int right = numsSize-1;
    int middle = 0;
    //若left小于等于right,说明区间中元素不为0
    while(left<=right) {
        //更新查找下标middle的值
        middle = (left+right)/2;
        //此时target可能会在[left,middle-1]区间中
        if(nums[middle] > target) {
            right = middle-1;
        }
        //此时target可能会在[middle+1,right]区间中
        else if(nums[middle] < target) {
            left = middle+1;
        }
        //当前下标元素等于target值时,返回middle
        else if(nums[middle] == target){
            return middle;
        }
    }
    //若未找到target元素,返回-1
    return -1;
}
// (版本二) 左闭右开区间 [left, right)
int search(int* nums, int numsSize, int target){
    int length = numsSize;
    int left = 0;
    int right = length;	//定义target在左闭右开的区间里,即:[left, right)
    int middle = 0;
    while(left < right){  // left == right时,区间[left, right)属于空集,所以用 < 避免该情况
        int middle = left + (right - left) / 2;
        if(nums[middle] < target){
            //target位于(middle , right) 中为保证集合区间的左闭右开性,可等价为[middle + 1,right)
            left = middle + 1;
        }else if(nums[middle] > target){
            //target位于[left, middle)中
            right = middle ;
        }else{	// nums[middle] == target ,找到目标值target
            return middle;
        }
    }
    //未找到目标值,返回-1
    return -1;
}
PHP:
// 左闭右闭区间
class Solution {
    /**
     * @param Integer[] $nums
     * @param Integer $target
     * @return Integer
     */
    function search($nums, $target) {
        if (count($nums) == 0) {
            return -1;
        }
        $left = 0;
        $right = count($nums) - 1;
        while ($left <= $right) {
            $mid = floor(($left + $right) / 2);
            if ($nums[$mid] == $target) {
                return $mid;
            }
            if ($nums[$mid] > $target) {
                $right = $mid - 1;
            }
            else {
                $left = $mid + 1;
            }
        }
        return -1;
    }
}
C#:
//左闭右闭
public class Solution {
    public int Search(int[] nums, int target) {
        int left = 0;
        int right = nums.Length - 1;
        while(left <= right){
            int mid = (right - left ) / 2 + left;
            if(nums[mid] == target){
                return mid;
            }
            else if(nums[mid] < target){
                left = mid+1;
            }
            else if(nums[mid] > target){
                right = mid-1;
            }
        }
        return -1;
    }
}

//左闭右开
public class Solution{
    public int Search(int[] nums, int target){
        int left = 0;
        int right = nums.Length;
        while(left < right){
            int mid = (right - left) / 2 + left;
            if(nums[mid] == target){
                return mid;
            }
            else if(nums[mid] < target){
                left = mid + 1;
            }
            else if(nums[mid] > target){
                right = mid;
            }
        }
        return -1;
    }
}
Kotlin:
class Solution {
    fun search(nums: IntArray, target: Int): Int {
	// leftBorder
        var left:Int = 0
	// rightBorder
        var right:Int = nums.size - 1
	// 使用左闭右闭区间
        while (left <= right) {
            var middle:Int = left + (right - left)/2
	    // taget 在左边
            if (nums[middle] > target) {
                right = middle - 1
            }
            else {
		// target 在右边
                if (nums[middle] < target) {
                    left = middle + 1
                }
		// 找到了,返回
                else   return middle
                }
            }
	    // 没找到,返回
            return -1
        }
}
Kotlin:
// (版本一)左闭右开区间
class Solution {
    fun search(nums: IntArray, target: Int): Int {
        var left = 0
        var right = nums.size // [left,right) 右侧为开区间,right 设置为 nums.size
        while (left < right) {
            val mid = (left + right) / 2
            if (nums[mid] < target) left = mid + 1
            else if (nums[mid] > target) right = mid // 代码的核心,循环中 right 是开区间,这里也应是开区间
            else return mid
        }
        return -1 // 没有找到 target ,返回 -1
    }
}
// (版本二)左闭右闭区间
class Solution {
    fun search(nums: IntArray, target: Int): Int {
        var left = 0
        var right = nums.size - 1 // [left,right] 右侧为闭区间,right 设置为 nums.size - 1
        while (left <= right) {
            val mid = (left + right) / 2
            if (nums[mid] < target) left = mid + 1
            else if (nums[mid] > target) right = mid - 1 // 代码的核心,循环中 right 是闭区间,这里也应是闭区间
            else return mid
        }
        return -1 // 没有找到 target ,返回 -1
    }
}
Scala:
(版本一)左闭右闭区间
object Solution {
  def search(nums: Array[Int], target: Int): Int = {
    var left = 0
    var right = nums.length - 1
    while (left <= right) {
      var mid = left + ((right - left) / 2)
      if (target == nums(mid)) {
        return mid
      } else if (target < nums(mid)) {
        right = mid - 1
      } else {
        left = mid + 1
      }
    }
    -1
  }
}
(版本二)左闭右开区间
object Solution {
  def search(nums: Array[Int], target: Int): Int = {
    var left = 0
    var right = nums.length
    while (left < right) {
      val mid = left + (right - left) / 2
      if (target == nums(mid)) {
        return mid
      } else if (target < nums(mid)) {
        right = mid
      } else {
        left = mid + 1
      }
    }
    -1
  }
}
Dart:
(版本一)左闭右闭区间
class Solution {
  int search(List<int> nums, int target) {
    int left = 0;
    int right = nums.length - 1;
    while (left <= right) {
      int middle = ((left + right)/2).truncate();
      switch (nums[middle].compareTo(target)) {
        case 1:
          right = middle - 1;
          continue;
        case -1:
          left = middle + 1;
          continue;
        default:
          return middle;
      }
    }
    return -1;
  }
}

(版本二)左闭右开区间
class Solution {
  int search(List<int> nums, int target) {
    int left = 0;
    int right = nums.length;
    while (left < right) {
      int middle = left + ((right - left) >> 1);
      switch (nums[middle].compareTo(target)) {
        case 1:
          right = middle;
          continue;
        case -1:
          left = middle + 1;
          continue;
        default:
          return middle;
      }
    }
    return -1;
  }
}
移除元素
27. 移除元素
力扣题目链接
给你一个数组 nums 和一个值 val,你需要 原地 移除所有数值等于 val 的元素,并返回移除后数组的新长度。
不要使用额外的数组空间,你必须仅使用 O(1) 额外空间并原地修改输入数组。
元素的顺序可以改变。你不需要考虑数组中超出新长度后面的元素。
示例 1:
给定 nums = [3,2,2,3], val = 3,
函数应该返回新的长度 2, 并且 nums 中的前两个元素均为 2。
你不需要考虑数组中超出新长度后面的元素。
示例 2:
给定 nums = [0,1,2,2,3,0,4,2], val = 2,
函数应该返回新的长度 5, 并且 nums 中的前五个元素为 0, 1, 3, 0, 4。
你不需要考虑数组中超出新长度后面的元素。
算法公开课
《代码随想录》算法视频公开课:数组中移除元素并不容易!LeetCode:27. 移除元素,相信结合视频再看本篇题解,更有助于大家对本题的理解。
思路
有的同学可能说了,多余的元素,删掉不就得了。
要知道数组的元素在内存地址中是连续的,不能单独删除数组中的某个元素,只能覆盖。
数组的基础知识可以看这里程序员算法面试中,必须掌握的数组理论知识。
暴力解法
这个题目暴力的解法就是两层for循环,一个for循环遍历数组元素 ,第二个for循环更新数组。
删除过程如下:
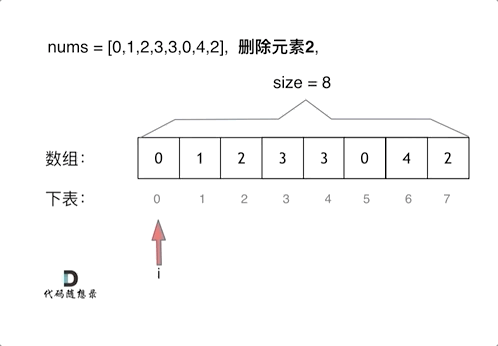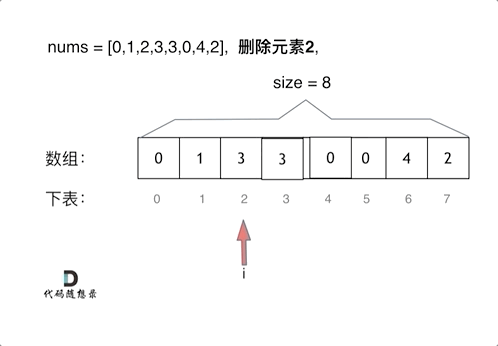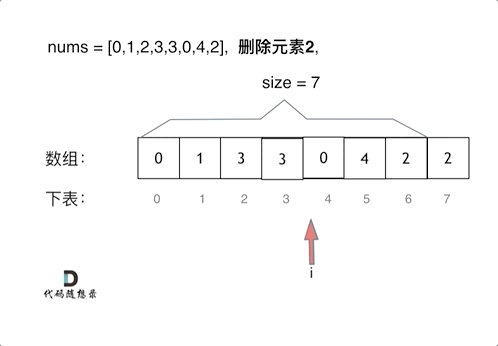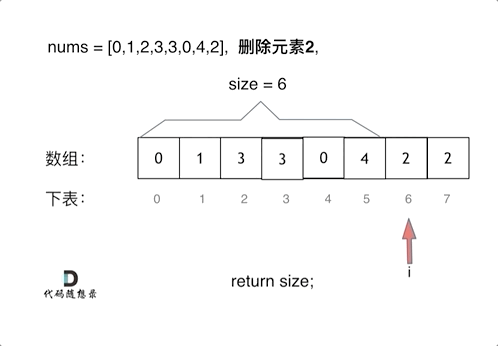
很明显暴力解法的时间复杂度是O(n^2),这道题目暴力解法在leetcode上是可以过的。
代码如下:
// 时间复杂度:O(n^2)
// 空间复杂度:O(1)
class Solution {
public:
    int removeElement(vector<int>& nums, int val) {
        int size = nums.size();
        for (int i = 0; i < size; i++) {
            if (nums[i] == val) { // 发现需要移除的元素,就将数组集体向前移动一位
                for (int j = i + 1; j < size; j++) {
                    nums[j - 1] = nums[j];
                }
                i--; // 因为下标i以后的数值都向前移动了一位,所以i也向前移动一位
                size--; // 此时数组的大小-1
            }
        }
        return size;

    }
};
双指针法
双指针法(快慢指针法): 通过一个快指针和慢指针在一个for循环下完成两个for循环的工作。
定义快慢指针
- 快指针:寻找新数组的元素 ,新数组就是不含有目标元素的数组
- 慢指针:指向更新 新数组下标的位置
很多同学这道题目做的很懵,就是不理解 快慢指针究竟都是什么含义,所以一定要明确含义,后面的思路就更容易理解了。
删除过程如下:
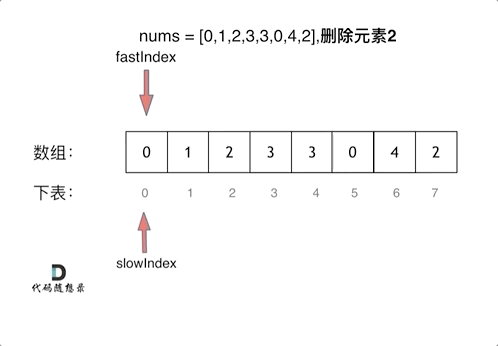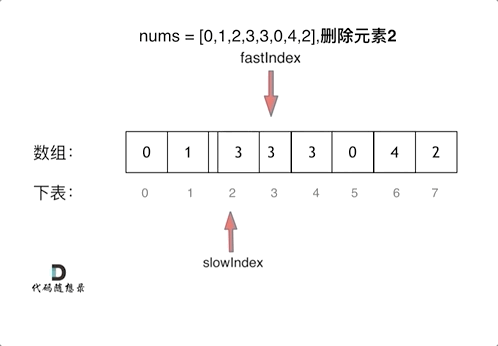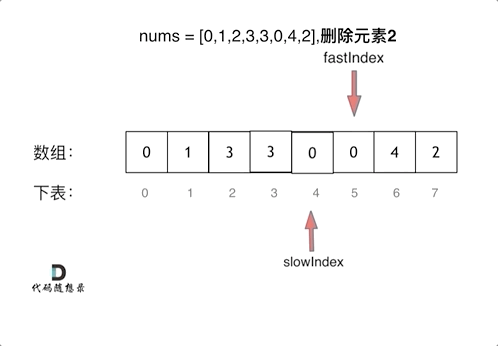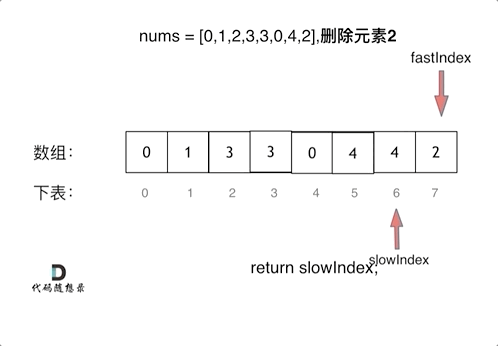
很多同学不了解
双指针法(快慢指针法)在数组和链表的操作中是非常常见的,很多考察数组、链表、字符串等操作的面试题,都使用双指针法。
后续都会一一介绍到,本题代码如下:
// 时间复杂度:O(n)
// 空间复杂度:O(1)
class Solution {
public:
    int removeElement(vector<int>& nums, int val) {
        int slowIndex = 0;
        for (int fastIndex = 0; fastIndex < nums.size(); fastIndex++) {
            if (val != nums[fastIndex]) {
                nums[slowIndex++] = nums[fastIndex];
            }
        }
        return slowIndex;
    }
};
注意这些实现方法并没有改变元素的相对位置!
相关题目推荐
其他语言版本
Java:
class Solution {
    public int removeElement(int[] nums, int val) {
	// 暴力法
        int n = nums.length;
        for (int i = 0; i < n; i++) {
            if (nums[i] == val) {
                for (int j = i + 1; j < n; j++) {
                    nums[j - 1] = nums[j];
                }
                i--;
                n--;
            }
        }
        return n;
    }
}
class Solution {
    public int removeElement(int[] nums, int val) {
        // 快慢指针
        int slowIndex = 0;
        for (int fastIndex = 0; fastIndex < nums.length; fastIndex++) {
            if (nums[fastIndex] != val) {
                nums[slowIndex] = nums[fastIndex];
                slowIndex++;
            }
        }
        return slowIndex;
    }
}
//相向双指针法
class Solution {
    public int removeElement(int[] nums, int val) {
        int left = 0;
        int right = nums.length - 1;
        while(right >= 0 && nums[right] == val) right--; //将right移到从右数第一个值不为val的位置
        while(left <= right) {
            if(nums[left] == val) { //left位置的元素需要移除
                //将right位置的元素移到left(覆盖),right位置移除
                nums[left] = nums[right];
                right--;
            }
            left++;
            while(right >= 0 && nums[right] == val) right--;
        }
        return left;
    }
}
// 相向双指针法(版本二)
class Solution {
    public int removeElement(int[] nums, int val) {
        int left = 0;
        int right = nums.length - 1;
        while(left <= right){
            if(nums[left] == val){
                nums[left] = nums[right];
                right--;
            }else {
                // 这里兼容了right指针指向的值与val相等的情况
                left++;
            }
        }
        return left;
    }
}
Python:
``` python 3
(版本一)快慢指针法
class Solution:
def removeElement(self, nums: List[int], val: int) -> int:
    # 快慢指针
    fast = 0  # 快指针
    slow = 0  # 慢指针
    size = len(nums)
    while fast < size:  # 不加等于是因为,a = size 时,nums[a] 会越界
        # slow 用来收集不等于 val 的值,如果 fast 对应值不等于 val,则把它与 slow 替换
        if nums[fast] != val:
            nums[slow] = nums[fast]
            slow += 1
        fast += 1
    return slow
python 3
(版本二)暴力法
class Solution:
def removeElement(self, nums: List[int], val: int) -> int:
    i, l = 0, len(nums)
    while i < l:
        if nums[i] == val: # 找到等于目标值的节点
            for j in range(i+1, l): # 移除该元素,并将后面元素向前平移
                nums[j - 1] = nums[j]
            l -= 1
            i -= 1
        i += 1
    return l
python 3
相向双指针法
时间复杂度 O(n)
空间复杂度 O(1)
class Solution:
def removeElement(self, nums: List[int], val: int) -> int:
    n = len(nums)
    left, right  = 0, n - 1
    while left <= right:
        while left <= right and nums[left] != val:
            left += 1
        while left <= right and nums[right] == val:
            right -= 1
        if left < right:
            nums[left] = nums[right]
            left += 1
            right -= 1
    return left
### Go:
go
// 暴力法
// 时间复杂度 O(n^2)
// 空间复杂度 O(1)
func removeElement(nums []int, val int) int {
size := len(nums)
for i := 0; i < size; i ++ {
    if nums[i] == val {
        for j := i + 1; j < size; j ++ {
            nums[j - 1] = nums[j]
        }
        i --
        size --
    }
}
return size
}
go
// 快慢指针法
// 时间复杂度 O(n)
// 空间复杂度 O(1)
func removeElement(nums []int, val int) int {
// 初始化慢指针 slow
slow := 0
// 通过 for 循环移动快指针 fast
// 当 fast 指向的元素等于 val 时,跳过
// 否则,将该元素写入 slow 指向的位置,并将 slow 后移一位
for fast := 0; fast < len(nums); fast++ {
	if nums[fast] == val {
		continue
	}
	nums[slow] = nums[fast]
	slow++
}
return slow
}
go
//相向双指针法
func removeElement(nums []int, val int) int {
// 有点像二分查找的左闭右闭区间 所以下面是<=
left := 0
right := len(nums) - 1
for left <= right {
	// 不断寻找左侧的val和右侧的非val 找到时交换位置 目的是将val全覆盖掉
	for left <= right && nums[left] != val {
		left++
	}
	for left <= right && nums[right] == val {
		right--
	}
	//各自找到后开始覆盖 覆盖后继续寻找
	if left < right {
		nums[left] = nums[right]
		left++
		right--
	}
}
return left
}
### JavaScript:
javascript
//时间复杂度:O(n)
//空间复杂度:O(1)
var removeElement = (nums, val) => {
let k = 0;
for(let i = 0;i < nums.length;i++){
    if(nums[i] != val){
        nums[k++] = nums[i]
    }
}
return k;
};
### TypeScript:
typescript
function removeElement(nums: number[], val: number): number {
let slowIndex: number = 0, fastIndex: number = 0;
while (fastIndex < nums.length) {
    if (nums[fastIndex] !== val) {
        nums[slowIndex++] = nums[fastIndex];
    }
    fastIndex++;
}
return slowIndex;
};
### Ruby:
ruby
def remove_element(nums, val)
i = 0
nums.each_index do |j|
    if nums[j] != val
        nums[i] = nums[j]
        i+=1
    end
end
i
end
### Rust:
rust
impl Solution {
pub fn remove_element(nums: &mut Vec<i32>, val: i32) -> i32 {
    let mut slowIdx = 0;
    for pos in (0..nums.len()) {
        if nums[pos]!=val {
            nums[slowIdx] = nums[pos];
            slowIdx += 1;
        }
    }
    return (slowIdx) as i32;
}
}
### Swift:
swift
func removeElement(_ nums: inout [Int], _ val: Int) -> Int {
var slowIndex = 0
for fastIndex in 0..<nums.count {
    if val != nums[fastIndex] {
            nums[slowIndex] = nums[fastIndex]
            slowIndex += 1
    }
}
return slowIndex
}
### PHP:
php
class Solution {
/**
 * @param Integer[] $nums
 * @param Integer $val
 * @return Integer
 */
function removeElement(&$nums, $val) {
    if (count($nums) == 0) {
        return 0;
    }
    // 快慢指针
    $slow = 0;
    for ($fast = 0; $fast < count($nums); $fast++) {
        if ($nums[$fast] != $val) {
            $nums[$slow] = $nums[$fast];
            $slow++;
        }
    }
    return $slow;
}
### C:
c
int removeElement(int* nums, int numsSize, int val){
int slow = 0;
for(int fast = 0; fast < numsSize; fast++) {
    //若快指针位置的元素不等于要删除的元素
    if(nums[fast] != val) {
        //将其挪到慢指针指向的位置,慢指针+1
        nums[slow++] = nums[fast];
    }
}
//最后慢指针的大小就是新的数组的大小
return slow;
}
### Kotlin:
kotlin
fun removeElement(nums: IntArray, val: Int): Int {
    var slowIndex = 0 // 初始化慢指针
    for (fastIndex in nums.indices) {
        if (nums[fastIndex] != `val`) nums[slowIndex++] = nums[fastIndex] // 在慢指针所在位置存储未被删除的元素
    }
    return slowIndex
}
### Scala:
scala
object Solution {
def removeElement(nums: Array[Int], val: Int): Int = {
var slow = 0
for (fast <- 0 until nums.length) {
  if (`val` != nums(fast)) {
    nums(slow) = nums(fast)
    slow += 1
  }
}
slow
}
}
### C#:
csharp
public class Solution {
public int RemoveElement(int[] nums, int val) {
    int slow = 0;
    for (int fast = 0; fast < nums.Length; fast++) {
        if (val != nums[fast]) {
            nums[slow++] = nums[fast];
        }
    }
    return slow;
}
}
###Dart:
dart
int removeElement(List nums, int val) {
//相向双指针法
var left = 0;
var right = nums.length - 1;
while (left <= right) {
//寻找左侧的val,将其被右侧非val覆盖
    if (nums[left] == val) {
        while (nums[right] == val&&left<=right) {
            right--;
        if (right < 0) {
            return 0;
    }
  }
  nums[left] = nums[right--];
} else {
  left++;
}
}
//覆盖后可以将0至left部分视为所需部分
return left;
}
---

## 有序数组的平方

* [做项目(多个C++、Java、Go、测开、前端项目)](https://www.programmercarl.com/other/kstar.html)
* [刷算法(两个月高强度学算法)](https://www.programmercarl.com/xunlian/xunlianying.html)
* [背八股(40天挑战高频面试题)](https://www.programmercarl.com/xunlian/bagu.html)

> 双指针风骚起来,也是无敌

# 977.有序数组的平方

[力扣题目链接](https://leetcode.cn/problems/squares-of-a-sorted-array/)

给你一个按 非递减顺序 排序的整数数组 nums,返回 每个数字的平方 组成的新数组,要求也按 非递减顺序 排序。

示例 1:
* 输入:nums = [-4,-1,0,3,10]
* 输出:[0,1,9,16,100]
* 解释:平方后,数组变为 [16,1,0,9,100],排序后,数组变为 [0,1,9,16,100]

示例 2:
* 输入:nums = [-7,-3,2,3,11]
* 输出:[4,9,9,49,121]

## 算法公开课

**[《代码随想录》算法视频公开课](https://programmercarl.com/other/gongkaike.html):[双指针法经典题目!LeetCode:977.有序数组的平方](https://www.bilibili.com/video/BV1QB4y1D7ep),相信结合视频再看本篇题解,更有助于大家对本题的理解**。


## 思路

### 暴力排序

最直观的想法,莫过于:每个数平方之后,排个序,代码如下:
CPP
class Solution {
public:
vector<int> sortedSquares(vector<int>& A) {
    for (int i = 0; i < A.size(); i++) {
        A[i] *= A[i];
    }
    sort(A.begin(), A.end()); // 快速排序
    return A;
}
};
这个时间复杂度是 O(n + nlogn), 可以说是O(nlogn)的时间复杂度,但为了和下面双指针法算法时间复杂度有鲜明对比,我记为 O(n + nlog n)。
### 双指针法
数组其实是有序的, 只不过负数平方之后可能成为最大数了。
那么数组平方的最大值就在数组的两端,不是最左边就是最右边,不可能是中间。
此时可以考虑双指针法了,i指向起始位置,j指向终止位置。
定义一个新数组result,和A数组一样的大小,让k指向result数组终止位置。
如果`A[i] * A[i] < A[j] * A[j]` 那么`result[k--] = A[j] * A[j];` 。
如果`A[i] * A[i] >= A[j] * A[j]` 那么`result[k--] = A[i] * A[i];` 。
如动画所示:

不难写出如下代码:
CPP
class Solution {
public:
vector<int> sortedSquares(vector<int>& A) {
    int k = A.size() - 1;
    vector<int> result(A.size(), 0);
    for (int i = 0, j = A.size() - 1; i <= j;) { // 注意这里要i <= j,因为最后要处理两个元素
        if (A[i] * A[i] < A[j] * A[j])  {
            result[k--] = A[j] * A[j];
            j--;
        }
        else {
            result[k--] = A[i] * A[i];
            i++;
        }
    }
    return result;
}
};
此时的时间复杂度为O(n),相对于暴力排序的解法O(n + nlog n)还是提升不少的。


**这里还是说一下,大家不必太在意leetcode上执行用时,打败多少多少用户,这个就是一个玩具,非常不准确。**

做题的时候自己能分析出来时间复杂度就可以了,至于leetcode上执行用时,大概看一下就行,只要达到最优的时间复杂度就可以了,

一样的代码多提交几次可能就击败百分之百了.....

## 其他语言版本

### Java:

排序法
Java
class Solution {
public int[] sortedSquares(int[] nums) {
    for (int i = 0; i < nums.length; i++) {
        nums[i] = nums[i] * nums[i];
    }
    Arrays.sort(nums);
    return nums;
}
}
Java
class Solution {
public int[] sortedSquares(int[] nums) {
    int right = nums.length - 1;
    int left = 0;
    int[] result = new int[nums.length];
    int index = result.length - 1;
    while (left <= right) {
        if (nums[left] * nums[left] > nums[right] * nums[right]) {
            // 正数的相对位置是不变的, 需要调整的是负数平方后的相对位置
            result[index--] = nums[left] * nums[left];
            ++left;
        } else {
            result[index--] = nums[right] * nums[right];
            --right;
        }
    }
    return result;
}
}
java
class Solution {
public int[] sortedSquares(int[] nums) {
    int l = 0;
    int r = nums.length - 1;
    int[] res = new int[nums.length];
    int j = nums.length - 1;
    while(l <= r){
        if(nums[l] * nums[l] > nums[r] * nums[r]){
            res[j--] = nums[l] * nums[l++];
        }else{
            res[j--] = nums[r] * nums[r--];
        }
    }
    return res;
}
}
### Python:
Python
(版本一)双指针法
class Solution:
def sortedSquares(self, nums: List[int]) -> List[int]:
    l, r, i = 0, len(nums)-1, len(nums)-1
    res = [float('inf')] * len(nums) # 需要提前定义列表,存放结果
    while l <= r:
        if nums[l] ** 2 < nums[r] ** 2: # 左右边界进行对比,找出最大值
            res[i] = nums[r] ** 2
            r -= 1 # 右指针往左移动
        else:
            res[i] = nums[l] ** 2
            l += 1 # 左指针往右移动
        i -= 1 # 存放结果的指针需要往前平移一位
    return res
Python
(版本二)暴力排序法
class Solution:
def sortedSquares(self, nums: List[int]) -> List[int]:
    for i in range(len(nums)):
        nums[i] *= nums[i]
    nums.sort()
    return nums
Python
(版本三)暴力排序法+列表推导法
class Solution:
def sortedSquares(self, nums: List[int]) -> List[int]:
    return sorted(x*x for x in nums)
Python
(版本四) 双指针+ 反转列表
class Solution:
def sortedSquares(self, nums: List[int]) -> List[int]:
    #根据list的先进排序在先原则
    #将nums的平方按从大到小的顺序添加进新的list
    #最后反转list
    new_list = []
    left, right = 0 , len(nums) -1
    while left <= right:
        if abs(nums[left]) <= abs(nums[right]):
            new_list.append(nums[right] ** 2)
            right -= 1
        else:
            new_list.append(nums[left] ** 2)
            left += 1
    return new_list[::-1]
python3
(双指针优化版本) 三步优化
class Solution:
def sortedSquares(self, nums: List[int]) -> List[int]:
    """
    整体思想:有序数组的绝对值最大值永远在两头,比较两头,平方大的插到新数组的最后
    优   化:1. 优化所有元素为非正或非负的情况
            2. 头尾平方的大小比较直接将头尾相加与0进行比较即可
            3. 新的平方排序数组的插入索引可以用倒序插入实现(针对for循环,while循环不适用)
    """
    # 特殊情况, 元素都非负(优化1)
    if nums[0] >= 0:
        return [num ** 2 for num in nums]  # 按顺序平方即可
    # 最后一个非正,全负有序的
    if nums[-1] <= 0:
        return [x ** 2 for x in nums[::-1]]  # 倒序平方后的数组

    # 一般情况, 有正有负
    i = 0  # 原数组头索引
    j = len(nums) - 1  # 原数组尾部索引
    new_nums = [0] * len(nums)  # 新建一个等长数组用于保存排序后的结果
    # end_index = len(nums) - 1  # 新的排序数组(是新数组)尾插索引, 每次需要减一(优化3优化了)
    for end_index in range(len(nums)-1, -1, -1): # (优化3,倒序,不用单独创建变量)
        # if nums[i] ** 2 >= nums[j] ** 2:
        if nums[i] + nums[j] <= 0:  # (优化2)
            new_nums[end_index] = nums[i] ** 2
            i += 1
            # end_index -= 1  (优化3)
        else:
            new_nums[end_index] = nums[j] ** 2
            j -= 1
            # end_index -= 1  (优化3)
    return new_nums
### Go:
Go
// 排序法
func sortedSquares(nums []int) []int {
for i, val := range nums {
    nums[i] *= val
}
sort.Ints(nums)
return nums
}
Go
// 双指针法
func sortedSquares(nums []int) []int {
n := len(nums)
i, j, k := 0, n-1, n-1
ans := make([]int, n)
for i <= j {
	lm, rm := nums[i]*nums[i], nums[j]*nums[j]
	if lm > rm {
		ans[k] = lm
		i++
	} else {
		ans[k] = rm
		j--
	}
	k--
}
return ans
}
### Rust:
rust
impl Solution {
pub fn sorted_squares(nums: Vec<i32>) -> Vec<i32> {
    let n = nums.len();
    let (mut i,mut j,mut k) = (0,n - 1,n);
    let mut ans = vec![0;n];
    while i <= j{
        if nums[i] * nums[i] < nums[j] * nums[j] {
            ans[k-1] = nums[j] * nums[j];
            j -= 1;
        }else{
            ans[k-1] = nums[i] * nums[i];
            i += 1;
        }
        k -= 1;
    }
    ans
}
}
### JavaScript:
Javascript
/**
- @param {number[]} nums
- @return {number[]}
*/
var sortedSquares = function(nums) {
let n = nums.length;
let res = new Array(n).fill(0);
let i = 0, j = n - 1, k = n - 1;
while (i <= j) {
    let left = nums[i] * nums[i],
        right = nums[j] * nums[j];
    if (left < right) {
        res[k--] = right;
        j--;
    } else {
        res[k--] = left;
        i++;
    }
}
return res;
};
### TypeScript:

双指针法:
typescript
function sortedSquares(nums: number[]): number[] {
const ans: number[] = [];
let left = 0,
    right = nums.length - 1;
while (left <= right) {
    // 右侧的元素不需要取绝对值,nums 为非递减排序的整数数组
    // 在同为负数的情况下,左侧的平方值一定大于右侧的平方值
    if (Math.abs(nums[left]) > nums[right]) {
        // 使用 Array.prototype.unshift() 直接在数组的首项插入当前最大值
        ans.unshift(nums[left] ** 2);
        left++;
    } else {
        ans.unshift(nums[right] ** 2);
        right--;
    }
}
return ans;
};
骚操作法(暴力思路):
typescript
function sortedSquares(nums: number[]): number[] {
return nums.map(i => i * i).sort((a, b) => a - b);
};
### Swift:
swift
func sortedSquares(_ nums: [Int]) -> [Int] {
// 指向新数组最后一个元素
var k = nums.count - 1
// 指向原数组第一个元素
var i = 0
// 指向原数组最后一个元素
var j = nums.count - 1
// 初始化新数组(用-1填充)
var result = Array<Int>(repeating: -1, count: nums.count)
for _ in 0..<nums.count {
    if nums[i] * nums[i] < nums[j] * nums[j] {
        result[k] = nums[j] * nums[j]
        j -= 1
    } else {
        result[k] = nums[i] * nums[i]
        i += 1
    }
    k -= 1
}
return result
}
### Ruby:
ruby
def sorted_squares(nums)
left, right, result = 0, nums.size - 1, []
while left <= right
if nums[left]**2 > nums[right]**2
  result << nums[left]**2
  left += 1
else
  result << nums[right]**2
  right -= 1
end
end
result.reverse
end
### C:
c
int sortedSquares(int nums, int numsSize, int* returnSize){
//返回的数组大小就是原数组大小
*returnSize = numsSize;
//创建两个指针,right指向数组最后一位元素,left指向数组第一位元素
int right = numsSize - 1;
int left = 0;
//最后要返回的结果数组
int* ans = (int*)malloc(sizeof(int) * numsSize);
int index;
for(index = numsSize - 1; index >= 0; index--) {
    //左指针指向元素的平方
    int lSquare = nums[left] * nums[left];
    //右指针指向元素的平方
    int rSquare = nums[right] * nums[right];
    //若左指针指向元素平方比右指针指向元素平方大,将左指针指向元素平方放入结果数组。左指针右移一位
    if(lSquare > rSquare) {
        ans[index] = lSquare;
        left++;
    }
    //若右指针指向元素平方比左指针指向元素平方大,将右指针指向元素平方放入结果数组。右指针左移一位
    else {
        ans[index] = rSquare;
        right--;
    }
}
//返回结果数组
return ans;
}
### PHP:
php
class Solution {
/**
 * @param Integer[] $nums
 * @return Integer[]
 */
function sortedSquares($nums) {
    // 双指针法
    $res = [];
    for ($i = 0; $i < count($nums); $i++) {
        $res[$i] = 0;
    }
    $k = count($nums) - 1;
    for ($i = 0, $j = count($nums) - 1; $i <= $j; ) {
        if ($nums[$i] ** 2 < $nums[$j] ** 2) {
            $res[$k--] = $nums[$j] ** 2;
            $j--;
        }
        else {
            $res[$k--] = $nums[$i] ** 2;
            $i++;
        }
    }
    return $res;
}
}
### Kotlin:

双指针法
kotlin
class Solution {
// 双指针法
fun sortedSquares(nums: IntArray): IntArray {
    var res = IntArray(nums.size)
    var left = 0 // 指向数组的最左端
    var right = nums.size - 1 // 指向数组端最右端
    // 选择平方数更大的那一个往 res 数组中倒序填充
    for (index in nums.size - 1 downTo 0) {
        if (nums[left] * nums[left] > nums[right] * nums[right]) {
            res[index] = nums[left] * nums[left]
            left++
        } else {
            res[index] = nums[right] * nums[right]
            right--
        }
    }
    return res
}
}
骚操作(暴力思路)
kotlin
class Solution {
fun sortedSquares(nums: IntArray): IntArray {
    // left 与 right 用来控制循环,类似于滑动窗口
    var left: Int = 0;
    var right: Int = nums.size - 1;
    // 将每个数字的平方经过排序后加入result数值
    var result: IntArray = IntArray(nums.size);
    var k: Int = nums.size - 1;
    while (left <= right) {
        // 从大到小,从后向前填满数组
        // [left, right] 控制循环
        if (nums[left] * nums[left] > nums[right] * nums[right]) {
            result[k--] = nums[left] * nums[left]
            left++
        }
        else {
            result[k--] = nums[right] * nums[right]
            right--
        }
    }
    return result
}
}
### Scala:

双指针:
scala
object Solution {
def sortedSquares(nums: Array[Int]): Array[Int] = {
val res: Array[Int] = new Array[Int](https://raw.githubusercontent.com/youngyangyang04/leetcode-master/HEAD/nums.length)
var top = nums.length - 1
var i = 0
var j = nums.length - 1
while (i <= j) {
  if (nums(i) * nums(i) <= nums(j) * nums(j)) {
    // 当左侧平方小于等于右侧,res数组顶部放右侧的平方,并且top下移,j左移
    res(top) = nums(j) * nums(j)
    top -= 1
    j -= 1
  } else {
    // 当左侧平方大于右侧,res数组顶部放左侧的平方,并且top下移,i右移
    res(top) = nums(i) * nums(i)
    top -= 1
    i += 1
  }
}
res
}
}
骚操作(暴力思路):
scala
object Solution {
def sortedSquares(nums: Array[Int]): Array[Int] = {
nums.map(x=>{x*x}).sortWith(_ < _)
}
}
### C#:
csharp
public class Solution {
public int[] SortedSquares(int[] nums) {
    int k = nums.Length - 1;
    int[] result = new int[nums.Length];
    for (int i = 0, j = nums.Length - 1;i <= j;){
        if (nums[i] * nums[i] < nums[j] * nums[j]) {
            result[k--] = nums[j] * nums[j];
            j--;
        } else {
            result[k--] = nums[i] * nums[i];
            i++;
        }
    }
    return result;
}
}
C# LINQ:
csharp
public class Solution {
public int[] SortedSquares(int[] nums) {
   return nums.Select(x => x * x).OrderBy(x => x).ToArray();
}
}
---

## 长度最小的子数组

* [做项目(多个C++、Java、Go、测开、前端项目)](https://www.programmercarl.com/other/kstar.html)
* [刷算法(两个月高强度学算法)](https://www.programmercarl.com/xunlian/xunlianying.html)
* [背八股(40天挑战高频面试题)](https://www.programmercarl.com/xunlian/bagu.html)


# 209.长度最小的子数组

[力扣题目链接](https://leetcode.cn/problems/minimum-size-subarray-sum/)

给定一个含有 n 个正整数的数组和一个正整数 s ,找出该数组中满足其和 ≥ s 的长度最小的 连续 子数组,并返回其长度。如果不存在符合条件的子数组,返回 0。

示例:

* 输入:s = 7, nums = [2,3,1,2,4,3]
* 输出:2
* 解释:子数组 [4,3] 是该条件下的长度最小的子数组。

提示:

* 1 <= target <= 10^9
* 1 <= nums.length <= 10^5
* 1 <= nums[i] <= 10^5

## 算法公开课

**[《代码随想录》算法视频公开课](https://programmercarl.com/other/gongkaike.html):[拿下滑动窗口! | LeetCode 209 长度最小的子数组](https://www.bilibili.com/video/BV1tZ4y1q7XE),相信结合视频再看本篇题解,更有助于大家对本题的理解**。


## 思路

### 暴力解法

这道题目暴力解法当然是 两个for循环,然后不断的寻找符合条件的子序列,时间复杂度很明显是O(n^2)。

代码如下:
CPP
class Solution {
public:
int minSubArrayLen(int s, vector<int>& nums) {
    int result = INT32_MAX; // 最终的结果
    int sum = 0; // 子序列的数值之和
    int subLength = 0; // 子序列的长度
    for (int i = 0; i < nums.size(); i++) { // 设置子序列起点为i
        sum = 0;
        for (int j = i; j < nums.size(); j++) { // 设置子序列终止位置为j
            sum += nums[j];
            if (sum >= s) { // 一旦发现子序列和超过了s,更新result
                subLength = j - i + 1; // 取子序列的长度
                result = result < subLength ? result : subLength;
                break; // 因为我们是找符合条件最短的子序列,所以一旦符合条件就break
            }
        }
    }
    // 如果result没有被赋值的话,就返回0,说明没有符合条件的子序列
    return result == INT32_MAX ? 0 : result;
}
};
* 时间复杂度:O(n^2)
* 空间复杂度:O(1)
后面力扣更新了数据,暴力解法已经超时了。
### 滑动窗口
接下来就开始介绍数组操作中另一个重要的方法:**滑动窗口**。
所谓滑动窗口,**就是不断的调节子序列的起始位置和终止位置,从而得出我们想要的结果**。
在暴力解法中,是一个for循环滑动窗口的起始位置,一个for循环为滑动窗口的终止位置,用两个for循环 完成了一个不断搜索区间的过程。
那么滑动窗口如何用一个for循环来完成这个操作呢。
首先要思考 如果用一个for循环,那么应该表示 滑动窗口的起始位置,还是终止位置。
如果只用一个for循环来表示 滑动窗口的起始位置,那么如何遍历剩下的终止位置?
此时难免再次陷入 暴力解法的怪圈。
所以 只用一个for循环,那么这个循环的索引,一定是表示 滑动窗口的终止位置。
那么问题来了, 滑动窗口的起始位置如何移动呢?
这里还是以题目中的示例来举例,s=7, 数组是 2,3,1,2,4,3,来看一下查找的过程:
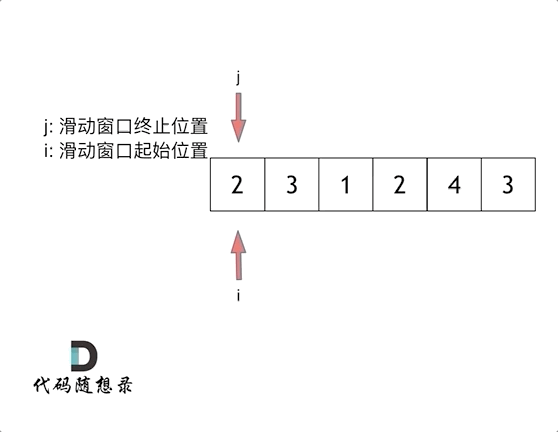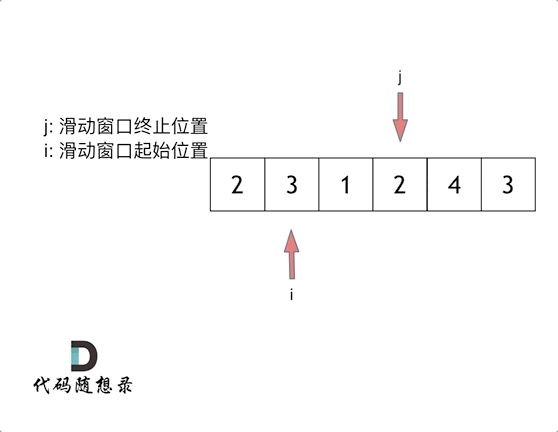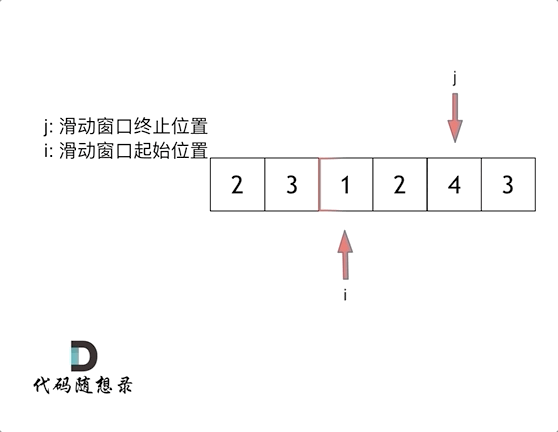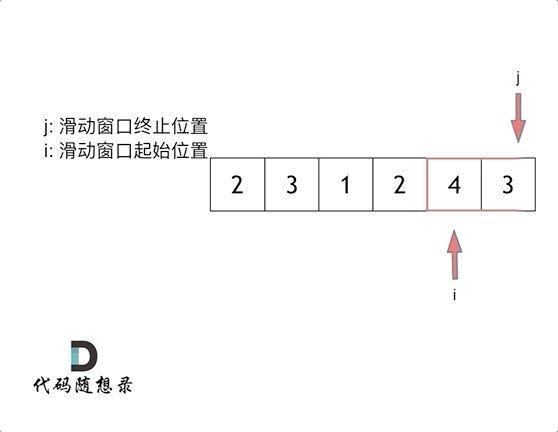
最后找到 4,3 是最短距离。
其实从动画中可以发现滑动窗口也可以理解为双指针法的一种!只不过这种解法更像是一个窗口的移动,所以叫做滑动窗口更适合一些。
在本题中实现滑动窗口,主要确定如下三点:
* 窗口内是什么?
* 如何移动窗口的起始位置?
* 如何移动窗口的结束位置?
窗口就是 满足其和 ≥ s 的长度最小的 连续 子数组。
窗口的起始位置如何移动:如果当前窗口的值大于等于s了,窗口就要向前移动了(也就是该缩小了)。
窗口的结束位置如何移动:窗口的结束位置就是遍历数组的指针,也就是for循环里的索引。
解题的关键在于 窗口的起始位置如何移动,如图所示:
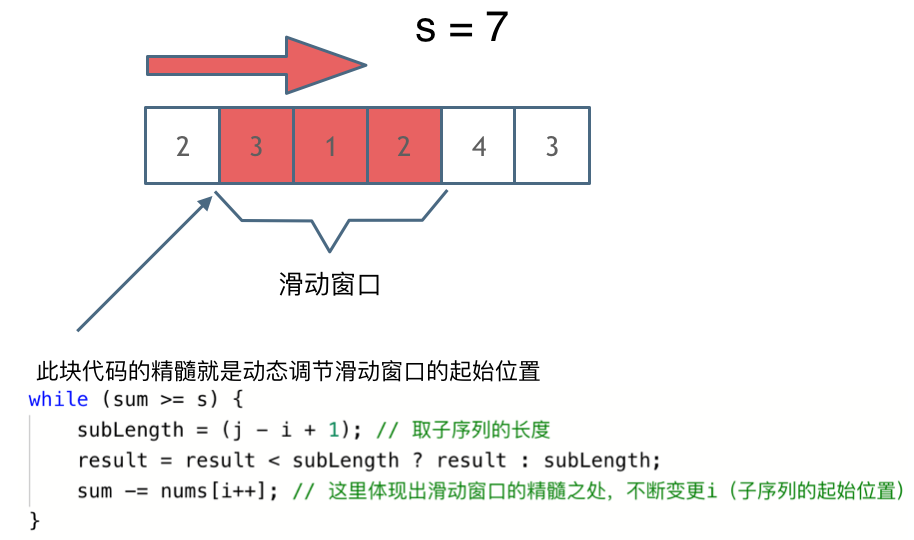
可以发现**滑动窗口的精妙之处在于根据当前子序列和大小的情况,不断调节子序列的起始位置。从而将O(n^2)暴力解法降为O(n)。**
C++代码如下:
CPP
class Solution {
public:
int minSubArrayLen(int s, vector<int>& nums) {
    int result = INT32_MAX;
    int sum = 0; // 滑动窗口数值之和
    int i = 0; // 滑动窗口起始位置
    int subLength = 0; // 滑动窗口的长度
    for (int j = 0; j < nums.size(); j++) {
        sum += nums[j];
        // 注意这里使用while,每次更新 i(起始位置),并不断比较子序列是否符合条件
        while (sum >= s) {
            subLength = (j - i + 1); // 取子序列的长度
            result = result < subLength ? result : subLength;
            sum -= nums[i++]; // 这里体现出滑动窗口的精髓之处,不断变更i(子序列的起始位置)
        }
    }
    // 如果result没有被赋值的话,就返回0,说明没有符合条件的子序列
    return result == INT32_MAX ? 0 : result;
}
};
* 时间复杂度:O(n)
* 空间复杂度:O(1)

**一些录友会疑惑为什么时间复杂度是O(n)**。

不要以为for里放一个while就以为是O(n^2)啊, 主要是看每一个元素被操作的次数,每个元素在滑动窗后进来操作一次,出去操作一次,每个元素都是被操作两次,所以时间复杂度是 2 × n 也就是O(n)。

## 相关题目推荐

* [904.水果成篮](https://leetcode.cn/problems/fruit-into-baskets/)
* [76.最小覆盖子串](https://leetcode.cn/problems/minimum-window-substring/)


## 其他语言版本

### Java:
java
class Solution {
// 滑动窗口
public int minSubArrayLen(int s, int[] nums) {
    int left = 0;
    int sum = 0;
    int result = Integer.MAX_VALUE;
    for (int right = 0; right < nums.length; right++) {
        sum += nums[right];
        while (sum >= s) {
            result = Math.min(result, right - left + 1);
            sum -= nums[left++];
        }
    }
    return result == Integer.MAX_VALUE ? 0 : result;
}
}
### Python:
python
(版本一)滑动窗口法
class Solution:
def minSubArrayLen(self, s: int, nums: List[int]) -> int:
    l = len(nums)
    left = 0
    right = 0
    min_len = float('inf')
    cur_sum = 0 #当前的累加值

    while right < l:
        cur_sum += nums[right]

        while cur_sum >= s: # 当前累加值大于目标值
            min_len = min(min_len, right - left + 1)
            cur_sum -= nums[left]
            left += 1

        right += 1

    return min_len if min_len != float('inf') else 0
python
(版本二)暴力法
class Solution:
def minSubArrayLen(self, s: int, nums: List[int]) -> int:
    l = len(nums)
    min_len = float('inf')

    for i in range(l):
        cur_sum = 0
        for j in range(i, l):
            cur_sum += nums[j]
            if cur_sum >= s:
                min_len = min(min_len, j - i + 1)
                break

    return min_len if min_len != float('inf') else 0
### Go:
go
func minSubArrayLen(target int, nums []int) int {
i := 0
l := len(nums)  // 数组长度
sum := 0        // 子数组之和
result := l + 1 // 初始化返回长度为l+1,目的是为了判断“不存在符合条件的子数组,返回0”的情况
for j := 0; j < l; j++ {
    sum += nums[j]
    for sum >= target {
        subLength := j - i + 1
        if subLength < result {
            result = subLength
        }
        sum -= nums[i]
        i++
    }
}
if result == l+1 {
    return 0
} else {
    return result
}
}
### JavaScript:
js
var minSubArrayLen = function(target, nums) {
let start, end
start = end = 0
let sum = 0
let len = nums.length
let ans = Infinity

while(end < len){
    sum += nums[end];
    while (sum >= target) {
        ans = Math.min(ans, end - start + 1);
        sum -= nums[start];
        start++;
    }
    end++;
}
return ans === Infinity ? 0 : ans
};
### TypeScript:
typescript
function minSubArrayLen(target: number, nums: number[]): number {
let left: number = 0,
res: number = Infinity,
subLen: number = 0,
sum: number = 0;
for (let right: number = 0; right < nums.length; right++) {
sum += nums[right];
while (sum >= target) {
  subLen = right - left + 1;
  res = Math.min(res, subLen);
  sum -= nums[left];
  left++;
}
}
return res === Infinity ? 0 : res;
}
### Swift:
swift
func minSubArrayLen(_ target: Int, _ nums: [Int]) -> Int {
var result = Int.max
var sum = 0
var starIndex = 0
for endIndex in 0..<nums.count {
    sum += nums[endIndex]
    while sum >= target {
        result = min(result, endIndex - starIndex + 1)
        sum -= nums[starIndex]
        starIndex += 1
    }
}
return result == Int.max ? 0 : result
}
### Rust:
rust
impl Solution {
pub fn min_sub_array_len(target: i32, nums: Vec<i32>) -> i32 {
    let (mut result, mut subLength): (i32, i32) = (i32::MAX, 0);
    let (mut sum, mut i) = (0, 0);
    for (pos, val) in nums.iter().enumerate() {
        sum += val;
        while sum >= target {
            subLength = (pos - i + 1) as i32;
            if result > subLength {
                result = subLength;
            }
            sum -= nums[i];
            i += 1;
        }
    }
    if result == i32::MAX {
        return 0;
    }
    result
}
}
### PHP:
php
// 双指针 - 滑动窗口
class Solution {
/**
 * @param Integer $target
 * @param Integer[] $nums
 * @return Integer
 */
function minSubArrayLen($target, $nums) {
    if (count($nums) < 1) {
        return 0;
    }
    $sum = 0;
    $res = PHP_INT_MAX;
    $left = 0;
    for ($right = 0; $right < count($nums); $right++) {
        $sum += $nums[$right];
        while ($sum >= $target) {
            $res = min($res, $right - $left + 1);
            $sum -= $nums[$left];
            $left++;
        }
    }
    return $res == PHP_INT_MAX ? 0 : $res;
}
}
### Ruby:
ruby
def min_sub_array_len(target, nums)
res = Float::INFINITY # 无穷大
i, sum = 0, 0
nums.length.times do |j|
sum	+= nums[j]
while sum >= target
  res = [res, j - i + 1].min
  sum -= nums[i]
  i	+= 1
end
end
res == Float::INFINITY ? 0 : res
end
### C:
暴力解法:
c
int minSubArrayLen(int target, int* nums, int numsSize){
//初始化最小长度为INT_MAX
int minLength = INT_MAX;
int sum;
int left, right;
for(left = 0; left < numsSize; ++left) {
    //每次遍历都清零sum,计算当前位置后和>=target的子数组的长度
    sum = 0;
    //从left开始,sum中添加元素
    for(right = left; right < numsSize; ++right) {
        sum += nums[right];
        //若加入当前元素后,和大于target,则更新minLength
        if(sum >= target) {
            int subLength = right - left + 1;
            minLength = minLength < subLength ? minLength : subLength;
        }
    }
}
//若minLength不为INT_MAX,则返回minLnegth
return minLength == INT_MAX ? 0 : minLength;
}
滑动窗口:
c
int minSubArrayLen(int target, int* nums, int numsSize){
//初始化最小长度为INT_MAX
int minLength = INT_MAX;
int sum = 0;
int left = 0, right = 0;
//右边界向右扩展
for(; right < numsSize; ++right) {
    sum += nums[right];
    //当sum的值大于等于target时,保存长度,并且收缩左边界
    while(sum >= target) {
        int subLength = right - left + 1;
        minLength = minLength < subLength ? minLength : subLength;
        sum -= nums[left++];
    }
}
//若minLength不为INT_MAX,则返回minLnegth
return minLength == INT_MAX ? 0 : minLength;
}
### Kotlin:
kotlin
class Solution {
fun minSubArrayLen(target: Int, nums: IntArray): Int {
    var start = 0
    var end = 0
    var ret = Int.MAX_VALUE
    var count = 0
    while (end < nums.size) {
        count += nums[end]
        while (count >= target) {
            ret = if (ret > (end - start + 1)) end - start + 1 else ret
            count -= nums[start++]
        }
        end++
    }
    return if (ret == Int.MAX_VALUE) 0 else ret
}
}
滑动窗口
kotlin
class Solution {
fun minSubArrayLen(target: Int, nums: IntArray): Int {
// 左边界 和 右边界
var left: Int = 0
var right: Int = 0
// sum 用来记录和
var sum: Int = 0
// result记录一个固定值,便于判断是否存在的这样的数组
var result: Int = Int.MAX_VALUE
// subLenth记录长度
var subLength = Int.MAX_VALUE
while (right < nums.size) {
    // 从数组首元素开始逐次求和
    sum += nums[right++]
    // 判断
    while (sum >= target) {
        var temp = right - left
        // 每次和上一次比较求出最小数组长度
        subLength = if (subLength > temp) temp else subLength
        // sum减少,左边界右移
        sum -= nums[left++]
    }
}
// 如果subLength为初始值,则说明长度为0,否则返回subLength
return if(subLength == result) 0 else subLength
}
}
### Scala:

滑动窗口:
scala
object Solution {
def minSubArrayLen(target: Int, nums: Array[Int]): Int = {
var result = Int.MaxValue // 返回结果,默认最大值
var left = 0 // 慢指针,当sum>=target,向右移动
var sum = 0 // 窗口值的总和
for (right <- 0 until nums.length) {
  sum += nums(right)
  while (sum >= target) {
    result = math.min(result, right - left + 1) // 产生新结果
    sum -= nums(left) // 左指针移动,窗口总和减去左指针的值
    left += 1 // 左指针向右移动
  }
}
// 相当于三元运算符,return关键字可以省略
if (result == Int.MaxValue) 0 else result
}
}
暴力解法:
scala
object Solution {
def minSubArrayLen(target: Int, nums: Array[Int]): Int = {
import scala.util.control.Breaks
var res = Int.MaxValue
var subLength = 0
for (i <- 0 until nums.length) {
  var sum = 0
  Breaks.breakable(
    for (j <- i until nums.length) {
      sum += nums(j)
      if (sum >= target) {
        subLength = j - i + 1
        res = math.min(subLength, res)
        Breaks.break()
      }
    }
  )
}
// 相当于三元运算符
if (res == Int.MaxValue) 0 else res
}
}
### C#:
csharp
public class Solution {
public int MinSubArrayLen(int s, int[] nums) {
    int n = nums.Length;
    int ans = int.MaxValue;
    int start = 0, end = 0;
    int sum = 0;
    while (end < n)  {
        sum += nums[end];
        while (sum >= s)
        {
            ans = Math.Min(ans, end - start + 1);
            sum -= nums[start];
            start++;
        }
        end++;
    }
    return ans == int.MaxValue ? 0 : ans;
}
}
---

## 区间和


# 58. 区间和

> 本题为代码随想录后续扩充题目,还没有视频讲解,顺便让大家练习一下ACM输入输出模式(笔试面试必备)

[题目链接](https://kamacoder.com/problempage.php?pid=1070)

题目描述

给定一个整数数组 Array,请计算该数组在每个指定区间内元素的总和。

输入描述

第一行输入为整数数组 Array 的长度 n,接下来 n 行,每行一个整数,表示数组的元素。随后的输入为需要计算总和的区间,直至文件结束。

输出描述

输出每个指定区间内元素的总和。

输入示例
5
1
2
3
4
5
0 1
1 3
输出示例
3
9
数据范围:

0 < n <= 100000

## 思路

本题我们来讲解 数组 上常用的解题技巧:前缀和

首先来看本题,我们最直观的想法是什么?

那就是给一个区间,然后 把这个区间的和都累加一遍不就得了,是一道简单不能再简单的题目。

代码如下:
CPP
#include
#include
using namespace std;
int main() {
int n, a, b;
cin >> n;
vector<int> vec(n);
for (int i = 0; i < n; i++) cin >> vec[i];
while (cin >> a >> b) {
    int sum = 0;
    // 累加区间 a 到 b 的和
    for (int i = a; i <= b; i++) sum += vec[i];
    cout << sum << endl;
}
}
代码一提交,发现超时了.....
我在制作本题的时候,特别制作了大数据量查询,卡的就是这种暴力解法。
来举一个极端的例子,如果我查询m次,每次查询的范围都是从0 到 n - 1
那么该算法的时间复杂度是 O(n * m) m 是查询的次数
如果查询次数非常大的话,这个时间复杂度也是非常大的。
接下来我们来引入前缀和,看看前缀和如何解决这个问题。
前缀和的思想是重复利用计算过的子数组之和,从而降低区间查询需要累加计算的次数。
**前缀和 在涉及计算区间和的问题时非常有用**!
前缀和的思路其实很简单,我给大家举个例子很容易就懂了。
例如,我们要统计 vec[i] 这个数组上的区间和。
我们先做累加,即 p[i] 表示 下标 0 到 i 的 vec[i] 累加 之和。
如图:

如果,我们想统计,在vec数组上 下标 2 到下标 5 之间的累加和,那是不是就用 p[5] - p[1] 就可以了。
为什么呢?
`p[1] = vec[0] + vec[1];`
`p[5] = vec[0] + vec[1] + vec[2] + vec[3] + vec[4] + vec[5];`
`p[5] - p[1] = vec[2] + vec[3] + vec[4] + vec[5];`
这不就是我们要求的 下标 2 到下标 5 之间的累加和吗。
如图所示:

`p[5] - p[1]` 就是 红色部分的区间和。
而 p 数组是我们之前就计算好的累加和,所以后面每次求区间和的之后 我们只需要 O(1) 的操作。
**特别注意**: 在使用前缀和求解的时候,要特别注意 求解区间。
如上图,如果我们要求 区间下标 [2, 5] 的区间和,那么应该是 p[5] - p[1],而不是 p[5] - p[2]。
**很多录友在使用前缀和的时候,分不清前缀和的区间,建议画一画图,模拟一下 思路会更清晰**。
本题C++代码如下:
CPP
#include
#include
using namespace std;
int main() {
int n, a, b;
cin >> n;
vector<int> vec(n);
vector<int> p(n);
int presum = 0;
for (int i = 0; i < n; i++) {
    cin >> vec[i];
    presum += vec[i];
    p[i] = presum;
}
while (cin >> a >> b) {
    int sum;
    if (a == 0) sum = p[b];
    else sum = p[b] - p[a - 1];
    cout << sum << endl;
}
}
C++ 代码 面对大量数据 读取 输出操作,最好用scanf 和 printf,耗时会小很多:
CPP
#include
#include
using namespace std;
int main() {
int n, a, b;
cin >> n;
vector<int> vec(n);
vector<int> p(n);
int presum = 0;
for (int i = 0; i < n; i++) {
    scanf("%d", &vec[i]);
    presum += vec[i];
    p[i] = presum;
}
while (~scanf("%d%d", &a, &b)) {
    int sum;
    if (a == 0) sum = p[b];
    else sum = p[b] - p[a - 1];
    printf("%d\n", sum);
}
}
## 其他语言版本

### Java
Java
import java.util.Scanner;
public class Main {
public static void main(String[] args) {
    Scanner scanner = new Scanner(System.in);
    int n = scanner.nextInt();
    int[] vec = new int[n];
    int[] p = new int[n];
    int presum = 0;
    for (int i = 0; i < n; i++) {
        vec[i] = scanner.nextInt();
        presum += vec[i];
        p[i] = presum;
    }
    while (scanner.hasNextInt()) {
        int a = scanner.nextInt();
        int b = scanner.nextInt();
        int sum;
        if (a == 0) {
            sum = p[b];
        } else {
            sum = p[b] - p[a - 1];
        }
        System.out.println(sum);
    }
    scanner.close();
}
}
### Python
python
import sys
input = sys.stdin.read
def main():
data = input().split()
index = 0
n = int(data[index])
index += 1
vec = []
for i in range(n):
    vec.append(int(data[index + i]))
index += n
p = [0] * n
presum = 0
for i in range(n):
    presum += vec[i]
    p[i] = presum
results = []
while index < len(data):
    a = int(data[index])
    b = int(data[index + 1])
    index += 2
    if a == 0:
        sum_value = p[b]
    else:
        sum_value = p[b] - p[a - 1]
results.append(sum_value)
for result in results:
    print(result)
if __name__ == "__main__":
main()
### JavaScript
JavaScript
function prefixSum() {
const readline = require('readline');
const rl = readline.createInterface({
    input: process.stdin,
    output: process.stdout
});
let inputLines = [];
rl.on('line', (line) => {
    inputLines.push(line.trim());
});
rl.on('close', () => {
    // 读取项数 n
    const n = parseInt(inputLines[0]);
    // 使用前缀和,复杂度控制在 O(1)
    let sum = new Array(n);
    sum[0] = parseInt(inputLines[1]);
    // 计算前缀和数组
    for (let i = 1; i < n; i++) {
        let value = parseInt(inputLines[i + 1]);
        sum[i] = sum[i - 1] + value;
    }
    // 处理区间和查询
    for (let i = n + 1; i < inputLines.length; i++) {
        let [left, right] = inputLines[i].split(' ').map(Number);
        if (left === 0) {
            console.log(sum[right]);
        } else {
            console.log(sum[right] - sum[left - 1]);
        }
    }
});
}
### C
C
#include
#include
int main(int argc, char *argv[])
{
int num;
// 读取数组长度
scanf("%d", &num);
// 使用动态内存分配而不是静态数组,以适应不同的输入大小
int *a = (int *)malloc((num + 1) * sizeof(int));
// 初始化前缀和数组的第一个元素为0
a[0] = 0;
// 读取数组元素并计算前缀和
for (int i = 1; i <= num; i++)
{
    int mm;
    scanf("%d", &mm);
    // 累加前缀和
    a[i] = a[i - 1] + mm;
}
int m, n;
// 循环读取区间并计算区间和,直到输入结束
// scanf()返回成功匹配和赋值的个数,到达文件末尾则返回 EOF
while (scanf("%d%d", &m, &n) == 2)
{
    // 输出区间和,注意区间是左闭右开,因此a[n+1]是包含n的元素的前缀和
    printf("%d\n", a[n+1] - a[m]);
}
// 释放之前分配的内存
free(a);
return 0;
}
### Go
go
package main
import (
"fmt"
"bufio"
"strconv"
"os"
)
func main() {
// bufio中读取数据的接口,因为数据卡的比较严,导致使用fmt.Scan会超时
scanner := bufio.NewScanner(os.Stdin)

// 获取数组大小
scanner.Scan()
n, _ := strconv.Atoi(scanner.Text())

// 获取数组元素的同时计算前缀和,一般建议切片开大一点防止各种越界问题
arr := make([]int, n + 1)
for i := 0; i < n; i++ {
    scanner.Scan()
    arr[i], _ = strconv.Atoi(scanner.Text())
    if i != 0 {
        arr[i] += arr[i - 1]
    }
}

/*
区间[l, r]的和可以使用区间[0, r]和[0, l - 1]相减得到,
在代码中即为arr[r]-arr[l-1]。这里需要注意l-1是否越界
*/
for {
    var l, r int
    scanner.Scan()
    _, err := fmt.Sscanf(scanner.Text(), "%d %d", &l, &r)
    if err != nil {
        return
    }

    if l > 0 {
        fmt.Println(arr[r] - arr[l - 1])
    } else {
        fmt.Println(arr[r])
    }
}
}
---

## 开发商购买土地


# 44. 开发商购买土地

> 本题为代码随想录后续扩充题目,还没有视频讲解,顺便让大家练习一下ACM输入输出模式(笔试面试必备)

[题目链接](https://kamacoder.com/problempage.php?pid=1044)

【题目描述】

在一个城市区域内,被划分成了n * m个连续的区块,每个区块都拥有不同的权值,代表着其土地价值。目前,有两家开发公司,A 公司和 B 公司,希望购买这个城市区域的土地。

现在,需要将这个城市区域的所有区块分配给 A 公司和 B 公司。

然而,由于城市规划的限制,只允许将区域按横向或纵向划分成两个子区域,而且每个子区域都必须包含一个或多个区块。

为了确保公平竞争,你需要找到一种分配方式,使得 A 公司和 B 公司各自的子区域内的土地总价值之差最小。

注意:区块不可再分。

【输入描述】

第一行输入两个正整数,代表 n 和 m。

接下来的 n 行,每行输出 m 个正整数。

输出描述

请输出一个整数,代表两个子区域内土地总价值之间的最小差距。

【输入示例】
3 3
1 2 3
2 1 3
1 2 3
【输出示例】

0

【提示信息】

如果将区域按照如下方式划分:
1 2 | 3
2 1 | 3
1 2 | 3
两个子区域内土地总价值之间的最小差距可以达到 0。

【数据范围】:

* 1 <= n, m <= 100;
* n 和 m 不同时为 1。

## 思路

看到本题,大家如果想暴力求解,应该是 n^3 的时间复杂度,

一个 for 枚举分割线, 嵌套 两个for 去累加区间里的和。

如果本题要求 任何两个行(或者列)之间的数值总和,大家在[0058.区间和](https://raw.githubusercontent.com/youngyangyang04/leetcode-master/HEAD/0058.区间和.md) 的基础上 应该知道怎么求。

就是前缀和的思路,先统计好,前n行的和 q[n],如果要求矩阵 a行 到 b行 之间的总和,那么就 q[b] - q[a - 1]就好。

至于为什么是 a - 1,大家去看 [0058.区间和](https://raw.githubusercontent.com/youngyangyang04/leetcode-master/HEAD/0058.区间和.md) 的分析,使用 前缀和 要注意 区间左右边的开闭情况。

本题也可以使用 前缀和的思路来求解,先将 行方向,和 列方向的和求出来,这样可以方便知道 划分的两个区间的和。

代码如下:
CPP
#include
#include
#include
using namespace std;
int main () {
int n, m;
cin >> n >> m;
int sum = 0;
vector<vector<int>> vec(n, vector<int>(m, 0)) ;
for (int i = 0; i < n; i++) {
    for (int j = 0; j < m; j++) {
        cin >> vec[i][j];
        sum += vec[i][j];
    }
}
// 统计横向
vector<int> horizontal(n, 0);
for (int i = 0; i < n; i++) {
    for (int j = 0 ; j < m; j++) {
        horizontal[i] += vec[i][j];
    }
}
// 统计纵向
vector<int> vertical(m , 0);
for (int j = 0; j < m; j++) {
    for (int i = 0 ; i < n; i++) {
        vertical[j] += vec[i][j];
    }
}
int result = INT_MAX;
int horizontalCut = 0;
for (int i = 0 ; i < n; i++) {
    horizontalCut += horizontal[i];
    result = min(result, abs(sum - horizontalCut - horizontalCut));
}
int verticalCut = 0;
for (int j = 0; j < m; j++) {
    verticalCut += vertical[j];
    result = min(result, abs(sum - verticalCut - verticalCut));
}
cout << result << endl;
}
时间复杂度: O(n^2)

其实本题可以在暴力求解的基础上,优化一下,就不用前缀和了,在行向遍历的时候,遇到行末尾就统一一下, 在列向遍历的时候,遇到列末尾就统计一下。

时间复杂度也是 O(n^2)

代码如下:
CPP
#include
#include
#include
using namespace std;
int main () {
int n, m;
cin >> n >> m;
int sum = 0;
vector<vector<int>> vec(n, vector<int>(m, 0)) ;
for (int i = 0; i < n; i++) {
    for (int j = 0; j < m; j++) {
        cin >> vec[i][j];
        sum += vec[i][j];
    }
}
int result = INT_MAX;
int count = 0; // 统计遍历过的行
for (int i = 0; i < n; i++) {
    for (int j = 0 ; j < m; j++) {
        count += vec[i][j];
        // 遍历到行末尾时候开始统计
        if (j == m - 1) result = min (result, abs(sum - count - count));
    }
}
count = 0; // 统计遍历过的列
for (int j = 0; j < m; j++) {
    for (int i = 0 ; i < n; i++) {
        count += vec[i][j];
        // 遍历到列末尾的时候开始统计
        if (i == n - 1) result = min (result, abs(sum - count - count));
    }
}
cout << result << endl;
}
## 其他语言版本

### Java

前缀和
Java
import java.util.Scanner;
public class Main {
public static void main(String[] args) {
    Scanner scanner = new Scanner(System.in);
    int n = scanner.nextInt();
    int m = scanner.nextInt();
    int sum = 0;
    int[][] vec = new int[n][m];
    for (int i = 0; i < n; i++) {
        for (int j = 0; j < m; j++) {
            vec[i][j] = scanner.nextInt();
            sum += vec[i][j];
        }
    }
    // 统计横向
    int[] horizontal = new int[n];
    for (int i = 0; i < n; i++) {
        for (int j = 0; j < m; j++) {
            horizontal[i] += vec[i][j];
        }
    }
    // 统计纵向
    int[] vertical = new int[m];
    for (int j = 0; j < m; j++) {
        for (int i = 0; i < n; i++) {
            vertical[j] += vec[i][j];
        }
    }
    int result = Integer.MAX_VALUE;
    int horizontalCut = 0;
    for (int i = 0; i < n; i++) {
        horizontalCut += horizontal[i];
        result = Math.min(result, Math.abs((sum - horizontalCut) - horizontalCut));
        // 更新result。其中,horizontalCut表示前i行的和,sum - horizontalCut表示剩下的和,作差、取绝对值,得到题目需要的“A和B各自的子区域内的土地总价值之差”。下同。
    }
    int verticalCut = 0;
    for (int j = 0; j < m; j++) {
        verticalCut += vertical[j];
        result = Math.min(result, Math.abs((sum - verticalCut) - verticalCut));
    }
    System.out.println(result);
    scanner.close();
}
}
优化暴力
Java
import java.util.Scanner;
public class Main {
public static void main(String[] args) {
    Scanner scanner = new Scanner(System.in);
    int n = scanner.nextInt();
    int m = scanner.nextInt();
    int sum = 0;
    int[][] vec = new int[n][m];
    for (int i = 0; i < n; i++) {
        for (int j = 0; j < m; j++) {
            vec[i][j] = scanner.nextInt();
            sum += vec[i][j];
        }
    }
    int result = Integer.MAX_VALUE;
    int count = 0; // 统计遍历过的行
    // 行切分
    for (int i = 0; i < n; i++) {
        for (int j = 0; j < m; j++) {
            count += vec[i][j];
            // 遍历到行末尾时候开始统计
            if (j == m - 1) {
                result = Math.min(result, Math.abs(sum - 2 * count));
            }
        }
    }
    count = 0;
    // 列切分
    for (int j = 0; j < m; j++) {
        for (int i = 0; i < n; i++) {
            count += vec[i][j];
            // 遍历到列末尾时候开始统计
            if (i == n - 1) {
                result = Math.min(result, Math.abs(sum - 2 * count));
            }
        }
    }
    System.out.println(result);
    scanner.close();
}
}
### python

前缀和
python
def main():
import sys
input = sys.stdin.read
data = input().split()
idx = 0
n = int(data[idx])
idx += 1
m = int(data[idx])
idx += 1
sum = 0
vec = []
for i in range(n):
row = []
for j in range(m):
num = int(data[idx])
idx += 1
row.append(num)
sum += num
vec.append(row)
# 统计横向
horizontal = [0] * n
for i in range(n):
for j in range(m):
horizontal[i] += vec[i][j]
# 统计纵向
vertical = [0] * m
for j in range(m):
for i in range(n):
vertical[j] += vec[i][j]
result = float('inf')
horizontalCut = 0
for i in range(n):
horizontalCut += horizontal[i]
result = min(result, abs(sum - 2 * horizontalCut))
verticalCut = 0
for j in range(m):
verticalCut += vertical[j]
result = min(result, abs(sum - 2 * verticalCut))
print(result)
if __name__ == "__main__":
main()
优化暴力
python
def main():
import sys
input = sys.stdin.read
data = input().split()
idx = 0
n = int(data[idx])
idx += 1
m = int(data[idx])
idx += 1
sum = 0
vec = []
for i in range(n):
row = []
for j in range(m):
num = int(data[idx])
idx += 1
row.append(num)
sum += num
vec.append(row)
result = float('inf')
count = 0
# 行切分
for i in range(n):
for j in range(m):
count += vec[i][j]
# 遍历到行末尾时候开始统计
if j == m - 1:
result = min(result, abs(sum - 2 * count))
count = 0
# 列切分
for j in range(m):
for i in range(n):
count += vec[i][j]
# 遍历到列末尾时候开始统计
if i == n - 1:
result = min(result, abs(sum - 2 * count))
print(result)
if __name__ == "__main__":
main()
### JavaScript
前缀和
js
function func() {
const readline = require('readline')
const rl = readline.createInterface({
input: process.stdin,
output: process.stdout
})
let inputLines = []
rl.on('line', function (line) {
inputLines.push(line.trim())
})
rl.on('close', function () {
let [n, m] = inputLines[0].split(" ").map(Number)
let c = new Array(n).fill(0)
let r = new Array(m).fill(0)
let arr = new Array(n)
let sum = 0//数组总和
let min = Infinity//设置最小值的初始值为无限大
//定义数组
for (let s = 0; s < n; s++) {
arr[s] = inputLines[s + 1].split(" ").map(Number)
}
//每一行的和
for (let i = 0; i < n; i++) {
for (let j = 0; j < m; j++) {
c[i] += arr[i][j]
sum += arr[i][j]
}
}
//每一列的和
for (let i = 0; i < n; i++) {
for (let j = 0; j < m; j++) {
r[j] += arr[i][j]
}
}
let sum1 = 0, sum2 = 0
//横向切割
for (let i = 0; i < n; i++) {
sum1 += c[i]
min = min < Math.abs(sum - 2 * sum1) ? min : Math.abs(sum - 2 * sum1)
}
//纵向切割
for (let j = 0; j < m; j++) {
sum2 += r[j]
min = min < Math.abs(sum - 2 * sum2) ? min : Math.abs(sum - 2 * sum2)
}
console.log(min);
})
}
### C
前缀和
c
#include
#include
int main()
{
int n = 0, m = 0, ret_ver = 0, ret_hor = 0;
// 读取行和列的值
scanf("%d%d", &n, &m);
// 动态分配数组a(横)和b(纵)的空间
int *a = (int *)malloc(sizeof(int) * n);
int *b = (int *)malloc(sizeof(int) * m);
// 初始化数组a和b
for (int i = 0; i < n; i++)
{
a[i] = 0;
}
for (int i = 0; i < m; i++)
{
b[i] = 0;
}
// 读取区块权值并计算每行和每列的总权值
for (int i = 0; i < n; i++)
{
for (int j = 0; j < m; j++)
{
int tmp;
scanf("%d", &tmp);
a[i] += tmp;
b[j] += tmp;
}
}
// 计算每列以及每行的前缀和
for (int i = 1; i < n; i++)
{
a[i] += a[i - 1];
}
for (int i = 1; i < m; i++)
{
b[i] += b[i - 1];
}
// 初始化ret_ver和ret_hor为最大可能值
ret_hor = a[n - 1];
ret_ver = b[m - 1];
// 计算按行划分的最小差异
int ret2 = 0;
while (ret2 < n)
{
ret_hor = (ret_hor > abs(a[n - 1] - 2 * a[ret2])) ? abs(a[n - 1] - 2 * a[ret2]) : ret_hor;
// 原理同列,但更高级
ret2++;
}
// 计算按列划分的最小差异
int ret1 = 0;
while (ret1 < m)
{
if (ret_ver > abs(b[m - 1] - 2 * b[ret1]))
{
ret_ver = abs(b[m - 1] - 2 * b[ret1]);
}
ret1++;
}
// 输出最小差异
printf("%d\n", (ret_ver <= ret_hor) ? ret_ver : ret_hor);
// 释放分配的内存
free(a);
free(b);
return 0;
}
### Go
前缀和
go
package main
import (
"fmt"
"os"
"bufio"
"strings"
"strconv"
"math"
)
func main() {
var n, m int
reader := bufio.NewReader(os.Stdin)
line, _ := reader.ReadString('\n')
line = strings.TrimSpace(line)
params := strings.Split(line, " ")
n, _ = strconv.Atoi(params[0])
m, _ = strconv.Atoi(params[1])//n和m读取完成
land := make([][]int, n)//土地矩阵初始化
for i := 0; i < n; i++ {
line, _ := reader.ReadString('\n')
line = strings.TrimSpace(line)
values := strings.Split(line, " ")
land[i] = make([]int, m)
for j := 0; j < m; j++ {
value, _ := strconv.Atoi(values[j])
land[i][j] = value
}
}//所有读取完成
//初始化前缀和矩阵
preMatrix := make([][]int, n+1)
for i := 0; i <= n; i++ {
preMatrix[i] = make([]int, m+1)
}
for a := 1; a < n+1; a++ {
for b := 1; b < m+1; b++ {
preMatrix[a][b] = land[a-1][b-1] + preMatrix[a-1][b] + preMatrix[a][b-1] - preMatrix[a-1][b-1]
}
}
totalSum := preMatrix[n][m]
minDiff := math.MaxInt32//初始化极大数,用于比较
//按行分割
for i := 1; i < n; i++ {
topSum := preMatrix[i][m]
bottomSum := totalSum - topSum
diff := int(math.Abs(float64(topSum - bottomSum)))
if diff < minDiff {
minDiff = diff
}
}
//按列分割
for j := 1; j < m; j++ {
topSum := preMatrix[n][j]
bottomSum := totalSum - topSum
diff := int(math.Abs(float64(topSum - bottomSum)))
if diff < minDiff {
minDiff = diff
}
}
fmt.Println(minDiff)
}
---
## 螺旋矩阵II
* [做项目(多个C++、Java、Go、测开、前端项目)](https://www.programmercarl.com/other/kstar.html)
* [刷算法(两个月高强度学算法)](https://www.programmercarl.com/xunlian/xunlianying.html)
* [背八股(40天挑战高频面试题)](https://www.programmercarl.com/xunlian/bagu.html)
# 59.螺旋矩阵II
[力扣题目链接](https://leetcode.cn/problems/spiral-matrix-ii/)
给定一个正整数 n,生成一个包含 1 到 n^2 所有元素,且元素按顺时针顺序螺旋排列的正方形矩阵。
示例:
输入: 3
输出:
[
[ 1, 2, 3 ],
[ 8, 9, 4 ],
[ 7, 6, 5 ]
]
## 算法公开课
**[《代码随想录》算法视频公开课](https://programmercarl.com/other/gongkaike.html):[拿下螺旋矩阵!LeetCode:59.螺旋矩阵II](https://www.bilibili.com/video/BV1SL4y1N7mV),相信结合视频再看本篇题解,更有助于大家对本题的理解**。
## 思路
这道题目可以说在面试中出现频率较高的题目,**本题并不涉及到什么算法,就是模拟过程,但却十分考察对代码的掌控能力。**
要如何画出这个螺旋排列的正方形矩阵呢?
相信很多同学刚开始做这种题目的时候,上来就是一波判断猛如虎。
结果运行的时候各种问题,然后开始各种修修补补,最后发现改了这里那里有问题,改了那里这里又跑不起来了。
大家还记得我们在这篇文章[数组:每次遇到二分法,都是一看就会,一写就废](https://programmercarl.com/0704.二分查找.html)中讲解了二分法,提到如果要写出正确的二分法一定要坚持**循环不变量原则**。
而求解本题依然是要坚持循环不变量原则。
模拟顺时针画矩阵的过程:
* 填充上行从左到右
* 填充右列从上到下
* 填充下行从右到左
* 填充左列从下到上
由外向内一圈一圈这么画下去。
可以发现这里的边界条件非常多,在一个循环中,如此多的边界条件,如果不按照固定规则来遍历,那就是**一进循环深似海,从此offer是路人**。
这里一圈下来,我们要画每四条边,这四条边怎么画,每画一条边都要坚持一致的左闭右开,或者左开右闭的原则,这样这一圈才能按照统一的规则画下来。
那么我按照左闭右开的原则,来画一圈,大家看一下:
这里每一种颜色,代表一条边,我们遍历的长度,可以看出每一个拐角处的处理规则,拐角处让给新的一条边来继续画。
这也是坚持了每条边左闭右开的原则。
一些同学做这道题目之所以一直写不好,代码越写越乱。
就是因为在画每一条边的时候,一会左开右闭,一会左闭右闭,一会又来左闭右开,岂能不乱。
代码如下,已经详细注释了每一步的目的,可以看出while循环里判断的情况是很多的,代码里处理的原则也是统一的左闭右开。
整体C++代码如下:
CPP
class Solution {
public:
vector<vector<int>> generateMatrix(int n) {
vector<vector<int>> res(n, vector<int>(n, 0)); // 使用vector定义一个二维数组
int startx = 0, starty = 0; // 定义每循环一个圈的起始位置
int loop = n / 2; // 每个圈循环几次,例如n为奇数3,那么loop = 1 只是循环一圈,矩阵中间的值需要单独处理
int mid = n / 2; // 矩阵中间的位置,例如:n为3, 中间的位置就是(1,1),n为5,中间位置为(2, 2)
int count = 1; // 用来给矩阵中每一个空格赋值
int offset = 1; // 需要控制每一条边遍历的长度,每次循环右边界收缩一位
int i,j;
while (loop --) {
i = startx;
j = starty;
// 下面开始的四个for就是模拟转了一圈
// 模拟填充上行从左到右(左闭右开)
for (j; j < n - offset; j++) {
res[i][j] = count++;
}
// 模拟填充右列从上到下(左闭右开)
for (i; i < n - offset; i++) {
res[i][j] = count++;
}
// 模拟填充下行从右到左(左闭右开)
for (; j > starty; j--) {
res[i][j] = count++;
}
// 模拟填充左列从下到上(左闭右开)
for (; i > startx; i--) {
res[i][j] = count++;
}
// 第二圈开始的时候,起始位置要各自加1, 例如:第一圈起始位置是(0, 0),第二圈起始位置是(1, 1)
startx++;
starty++;
// offset 控制每一圈里每一条边遍历的长度
offset += 1;
}
// 如果n为奇数的话,需要单独给矩阵最中间的位置赋值
if (n % 2) {
res[mid][mid] = count;
}
return res;
}
};
* 时间复杂度 O(n^2): 模拟遍历二维矩阵的时间
* 空间复杂度 O(1)
## 类似题目
* [54.螺旋矩阵](https://leetcode.cn/problems/spiral-matrix/)
* [剑指Offer 29.顺时针打印矩阵](https://leetcode.cn/problems/shun-shi-zhen-da-yin-ju-zhen-lcof/)
## 其他语言版本
### Java:
Java
class Solution {
public int[][] generateMatrix(int n) {
int[][] nums = new int[n][n];
int startX = 0, startY = 0; // 每一圈的起始点
int offset = 1;
int count = 1; // 矩阵中需要填写的数字
int loop = 1; // 记录当前的圈数
int i, j; // j 代表列, i 代表行;
while (loop <= n / 2) {
// 顶部
// 左闭右开,所以判断循环结束时, j 不能等于 n - offset
for (j = startY; j < n - offset; j++) {
nums[startX][j] = count++;
}
// 右列
// 左闭右开,所以判断循环结束时, i 不能等于 n - offset
for (i = startX; i < n - offset; i++) {
nums[i][j] = count++;
}
// 底部
// 左闭右开,所以判断循环结束时, j != startY
for (; j > startY; j--) {
nums[i][j] = count++;
}
// 左列
// 左闭右开,所以判断循环结束时, i != startX
for (; i > startX; i--) {
nums[i][j] = count++;
}
startX++;
startY++;
offset++;
loop++;
}
if (n % 2 == 1) { // n 为奇数时,单独处理矩阵中心的值
nums[startX][startY] = count;
}
return nums;
}
}
### python3:
python
class Solution:
def generateMatrix(self, n: int) -> List[List[int]]:
nums = [[0] * n for _ in range(n)]
startx, starty = 0, 0 # 起始点
loop, mid = n // 2, n // 2 # 迭代次数、n为奇数时,矩阵的中心点
count = 1 # 计数
for offset in range(1, loop + 1) : # 每循环一层偏移量加1,偏移量从1开始
for i in range(starty, n - offset) : # 从左至右,左闭右开
nums[startx][i] = count
count += 1
for i in range(startx, n - offset) : # 从上至下
nums[i][n - offset] = count
count += 1
for i in range(n - offset, starty, -1) : # 从右至左
nums[n - offset][i] = count
count += 1
for i in range(n - offset, startx, -1) : # 从下至上
nums[i][starty] = count
count += 1
startx += 1 # 更新起始点
starty += 1
if n % 2 != 0 : # n为奇数时,填充中心点
nums[mid][mid] = count
return nums
版本二:定义四个边界
python
class Solution(object):
def generateMatrix(self, n):
if n <= 0:
return []
# 初始化 n x n 矩阵
matrix = [[0]*n for _ in range(n)]
# 初始化边界和起始值
top, bottom, left, right = 0, n-1, 0, n-1
num = 1
while top <= bottom and left <= right:
# 从左到右填充上边界
for i in range(left, right + 1):
matrix[top][i] = num
num += 1
top += 1
# 从上到下填充右边界
for i in range(top, bottom + 1):
matrix[i][right] = num
num += 1
right -= 1
# 从右到左填充下边界
for i in range(right, left - 1, -1):
matrix[bottom][i] = num
num += 1
bottom -= 1
# 从下到上填充左边界
for i in range(bottom, top - 1, -1):
matrix[i][left] = num
num += 1
left += 1
return matrix
### JavaScript:
javascript
var generateMatrix = function(n) {
let startX = startY = 0; // 起始位置
let loop = Math.floor(n/2); // 旋转圈数
let mid = Math.floor(n/2); // 中间位置
let offset = 1; // 控制每一层填充元素个数
let count = 1; // 更新填充数字
let res = new Array(n).fill(0).map(() => new Array(n).fill(0));
while (loop--) {
let row = startX, col = startY;
// 上行从左到右(左闭右开)
for (; col < n - offset; col++) {
res[row][col] = count++;
}
// 右列从上到下(左闭右开)
for (; row < n - offset; row++) {
res[row][col] = count++;
}
// 下行从右到左(左闭右开)
for (; col > startY; col--) {
res[row][col] = count++;
}
// 左列做下到上(左闭右开)
for (; row > startX; row--) {
res[row][col] = count++;
}
// 更新起始位置
startX++;
startY++;
// 更新offset
offset += 1;
}
// 如果n为奇数的话,需要单独给矩阵最中间的位置赋值
if (n % 2 === 1) {
res[mid][mid] = count;
}
return res;
};
### TypeScript:
typescript
function generateMatrix(n: number): number[][] {
let loopNum: number = Math.floor(n / 2);
const resArr: number[][] = new Array(n).fill(1).map(i => new Array(n));
let chunkNum: number = n - 1;
let startX: number = 0;
let startY: number = 0;
let value: number = 1;
let x: number, y: number;
while (loopNum--) {
x = startX;
y = startY;
while (x < startX + chunkNum) {
resArr[y][x] = value;
x++;
value++;
}
while (y < startY + chunkNum) {
resArr[y][x] = value;
y++;
value++;
}
while (x > startX) {
resArr[y][x] = value;
x--;
value++;
}
while (y > startY) {
resArr[y][x] = value;
y--;
value++;
}
startX++;
startY++;
chunkNum -= 2;
}
if (n % 2 === 1) {
resArr[startX][startY] = value;
}
return resArr;
};
### Go:
go
package main
import "fmt"
func main() {
n := 3
fmt.Println(generateMatrix(n))
}
func generateMatrix(n int) [][]int {
startx, starty := 0, 0
var loop int = n / 2
var center int = n / 2
count := 1
offset := 1
res := make([][]int, n)
for i := 0; i < n; i++ {
res[i] = make([]int, n)
}
for loop > 0 {
i, j := startx, starty
//行数不变 列数在变
for j = starty; j < n-offset; j++ {
res[startx][j] = count
count++
}
//列数不变是j 行数变
for i = startx; i < n-offset; i++ {
res[i][j] = count
count++
}
//行数不变 i 列数变 j--
for ; j > starty; j-- {
res[i][j] = count
count++
}
//列不变 行变
for ; i > startx; i-- {
res[i][j] = count
count++
}
startx++
starty++
offset++
loop--
}
if n%2 == 1 {
res[center][center] = n * n
}
return res
}
go
func generateMatrix(n int) [][]int {
top, bottom := 0, n-1
left, right := 0, n-1
num := 1
tar := n * n
matrix := make([][]int, n)
for i := 0; i < n; i++ {
matrix[i] = make([]int, n)
}
for num <= tar {
for i := left; i <= right; i++ {
matrix[top][i] = num
num++
}
top++
for i := top; i <= bottom; i++ {
matrix[i][right] = num
num++
}
right--
for i := right; i >= left; i-- {
matrix[bottom][i] = num
num++
}
bottom--
for i := bottom; i >= top; i-- {
matrix[i][left] = num
num++
}
left++
}
return matrix
}
### Swift:
swift
func generateMatrix(_ n: Int) -> [[Int]] {
var result = [[Int]](repeating: [Int](repeating: 0, count: n), count: n)
var startRow = 0
var startColumn = 0
var loopCount = n / 2
let mid = n / 2
var count = 1
var offset = 1
var row: Int
var column: Int
while loopCount > 0 {
row = startRow
column = startColumn
for c in column ..< startColumn + n - offset {
result[startRow][c] = count
count += 1
column += 1
}
for r in row ..< startRow + n - offset {
result[r][column] = count
count += 1
row += 1
}
for _ in startColumn ..< column {
result[row][column] = count
count += 1
column -= 1
}
for _ in startRow ..< row {
result[row][column] = count
count += 1
row -= 1
}
startRow += 1
startColumn += 1
offset += 2
loopCount -= 1
}
if (n % 2) != 0 {
result[mid][mid] = count
}
return result
}
### Rust:
rust
impl Solution {
pub fn generate_matrix(n: i32) -> Vec<Vec<i32>> {
let mut res = vec![vec![0; n as usize]; n as usize];
let (mut startX, mut startY, mut offset): (usize, usize, usize) = (0, 0, 1);
let mut loopIdx = n/2;
let mid: usize = loopIdx as usize;
let mut count = 1;
let (mut i, mut j): (usize, usize) = (0, 0);
while loopIdx > 0 {
i = startX;
j = startY;
while j < (startY + (n as usize) - offset) {
res[i][j] = count;
count += 1;
j += 1;
}
while i < (startX + (n as usize) - offset) {
res[i][j] = count;
count += 1;
i += 1;
}
while j > startY {
res[i][j] = count;
count += 1;
j -= 1;
}
while i > startX {
res[i][j] = count;
count += 1;
i -= 1;
}
startX += 1;
startY += 1;
offset += 2;
loopIdx -= 1;
}
if(n % 2 == 1) {
res[mid][mid] = count;
}
res
}
}
### PHP:
php
class Solution {
/**
* @param Integer $n
* @return Integer[][]
*/
function generateMatrix($n) {
// 初始化数组
$res = array_fill(0, $n, array_fill(0, $n, 0));
$mid = $loop = floor($n / 2);
$startX = $startY = 0;
$offset = 1;
$count = 1;
while ($loop > 0) {
$i = $startX;
$j = $startY;
for (; $j < $startY + $n - $offset; $j++) {
$res[$i][$j] = $count++;
}
for (; $i < $startX + $n - $offset; $i++) {
$res[$i][$j] = $count++;
}
for (; $j > $startY; $j--) {
$res[$i][$j] = $count++;
}
for (; $i > $startX; $i--) {
$res[$i][$j] = $count++;
}
$startX += 1;
$startY += 1;
$offset += 2;
$loop--;
}
if ($n % 2 == 1) {
$res[$mid][$mid] = $count;
}
return $res;
}
}
### C:
c
int** generateMatrix(int n, int returnSize, int* returnColumnSizes){
//初始化返回的结果数组的大小
*returnSize = n;
*returnColumnSizes = (int*)malloc(sizeof(int) * n);
//初始化返回结果数组ans
int** ans = (int**)malloc(sizeof(int*) * n);
int i;
for(i = 0; i < n; i++) {
ans[i] = (int*)malloc(sizeof(int) * n);
(*returnColumnSizes)[i] = n;
}
//设置每次循环的起始位置
int startX = 0;
int startY = 0;
//设置二维数组的中间值,若n为奇数。需要最后在中间填入数字
int mid = n / 2;
//循环圈数
int loop = n / 2;
//偏移数
int offset = 1;
//当前要添加的元素
int count = 1;
while(loop) {
int i = startX;
int j = startY;
//模拟上侧从左到右
for(; j < startY + n - offset; j++) {
ans[startX][j] = count++;
}
//模拟右侧从上到下
for(; i < startX + n - offset; i++) {
ans[i][j] = count++;
}
//模拟下侧从右到左
for(; j > startY; j--) {
ans[i][j] = count++;
}
//模拟左侧从下到上
for(; i > startX; i--) {
ans[i][j] = count++;
}
//偏移值每次加2
offset+=2;
//遍历起始位置每次+1
startX++;
startY++;
loop--;
}
//若n为奇数需要单独给矩阵中间赋值
if(n%2)
ans[mid][mid] = count;
return ans;
}
### Scala:
scala
object Solution {
def generateMatrix(n: Int): Array[Array[Int]] = {
var res = Array.ofDim[Int](n, n) // 定义一个n*n的二维矩阵
var num = 1 // 标志当前到了哪个数字
var i = 0 // 横坐标
var j = 0 // 竖坐标
while (num <= n * n) {
// 向右:当j不越界,并且下一个要填的数字是空白时
while (j < n && res(i)(j) == 0) {
res(i)(j) = num // 当前坐标等于num
num += 1 // num++
j += 1 // 竖坐标+1
}
i += 1 // 下移一行
j -= 1 // 左移一列
// 剩下的都同上
// 向下
while (i < n && res(i)(j) == 0) {
res(i)(j) = num
num += 1
i += 1
}
i -= 1
j -= 1
// 向左
while (j >= 0 && res(i)(j) == 0) {
res(i)(j) = num
num += 1
j -= 1
}
i -= 1
j += 1
// 向上
while (i >= 0 && res(i)(j) == 0) {
res(i)(j) = num
num += 1
i -= 1
}
i += 1
j += 1
}
res
}
}
### C#:
csharp
public int[][] GenerateMatrix(int n)
{
// 参考Carl的代码随想录里面C++的思路
// https://www.programmercarl.com/0059.%E8%9E%BA%E6%97%8B%E7%9F%A9%E9%98%B5II.html#%E6%80%9D%E8%B7%AF
int startX = 0, startY = 0; // 定义每循环一个圈的起始位置
int loop = n / 2; // 每个圈循环几次,例如n为奇数3,那么loop = 1 只是循环一圈,矩阵中间的值需要单独处理
int count = 1; // 用来给矩阵每个空格赋值
int mid = n / 2; // 矩阵中间的位置,例如:n为3, 中间的位置就是(1,1),n为5,中间位置为(2, 2)
int offset = 1;// 需要控制每一条边遍历的长度,每次循环右边界收缩一位
// 构建result二维数组
int[][] result = new int[n][];
for (int k = 0; k < n; k++)
{
result[k] = new int[n];
}
int i = 0, j = 0; // [i,j]
while (loop > 0)
{
i = startX;
j = startY;
// 四个For循环模拟转一圈
// 第一排,从左往右遍历,不取最右侧的值(左闭右开)
for (; j < n - offset; j++)
{
result[i][j] = count++;
}
// 右侧的第一列,从上往下遍历,不取最下面的值(左闭右开)
for (; i < n - offset; i++)
{
result[i][j] = count++;
}
// 最下面的第一行,从右往左遍历,不取最左侧的值(左闭右开)
for (; j > startY; j--)
{
result[i][j] = count++;
}
// 左侧第一列,从下往上遍历,不取最左侧的值(左闭右开)
for (; i > startX; i--)
{
result[i][j] = count++;
}
// 第二圈开始的时候,起始位置要各自加1, 例如:第一圈起始位置是(0, 0),第二圈起始位置是(1, 1)
startX++;
startY++;
// offset 控制每一圈里每一条边遍历的长度
offset++;
loop--;
}
if (n % 2 == 1)
{
// n 为奇数
result[mid][mid] = count;
}
return result;
}
### Ruby:
ruby
def generate_matrix(n)
result = Array.new(n) { Array.new(n, 0) }
#循环次数
loop_times = 0
#步长
step = n - 1
val = 1
while loop_times < n / 2
#模拟从左向右
for i in 0..step - 1
#行数不变,列数变
result[loop_times][i+loop_times] = val
val += 1
end
#模拟从上到下
for i in 0..step - 1
#列数不变,行数变
result[i+loop_times][n-loop_times-1] = val
val += 1
end
#模拟从右到左
for i in 0..step - 1
#行数不变,列数变
result[n-loop_times-1][n-loop_times-i-1] = val
val += 1
end
#模拟从下到上
for i in 0..step - 1
#列数不变,行数变
result[n-loop_times-i-1][loop_times] = val
val += 1
end
loop_times += 1
step -= 2
end
#如果是奇数,则填充最后一个元素
result[n/2][n/2] = n**2 if n % 2
return result
end
---
## 数组总结篇
* [做项目(多个C++、Java、Go、测开、前端项目)](https://www.programmercarl.com/other/kstar.html)
* [刷算法(两个月高强度学算法)](https://www.programmercarl.com/xunlian/xunlianying.html)
* [背八股(40天挑战高频面试题)](https://www.programmercarl.com/xunlian/bagu.html)
# 数组总结篇
## 数组理论基础
数组是非常基础的数据结构,在面试中,考察数组的题目一般在思维上都不难,主要是考察对代码的掌控能力
也就是说,想法很简单,但实现起来 可能就不是那么回事了。
首先要知道数组在内存中的存储方式,这样才能真正理解数组相关的面试题
**数组是存放在连续内存空间上的相同类型数据的集合。**
数组可以方便的通过下标索引的方式获取到下标对应的数据。
举一个字符数组的例子,如图所示:
<img src='https://file1.kamacoder.com/i/algo/%E7%AE%97%E6%B3%95%E9%80%9A%E5%85%B3%E6%95%B0%E7%BB%84.png' width=600> </img></div>
需要两点注意的是
* **数组下标都是从0开始的。**
* **数组内存空间的地址是连续的**
正是**因为数组在内存空间的地址是连续的,所以我们在删除或者增添元素的时候,就难免要移动其他元素的地址。**
例如删除下标为3的元素,需要对下标为3的元素后面的所有元素都要做移动操作,如图所示:
<img src='https://file1.kamacoder.com/i/algo/%E7%AE%97%E6%B3%95%E9%80%9A%E5%85%B3%E6%95%B0%E7%BB%841.png' width=600> </img></div>
而且大家如果使用C++的话,要注意vector 和 array的区别,vector的底层实现是array,严格来讲vector是容器,不是数组。
**数组的元素是不能删的,只能覆盖。**
那么二维数组直接上图,大家应该就知道怎么回事了
<img src='https://file1.kamacoder.com/i/algo/%E7%AE%97%E6%B3%95%E9%80%9A%E5%85%B3%E6%95%B0%E7%BB%842.png' width=600> </img></div>
**那么二维数组在内存的空间地址是连续的么?**
我们来举一个Java的例子,例如: `int[][] rating = new int[3][4];` , 这个二维数组在内存空间可不是一个 `3*4` 的连续地址空间
看了下图,就应该明白了:
<img src='https://file1.kamacoder.com/i/algo/%E7%AE%97%E6%B3%95%E9%80%9A%E5%85%B3%E6%95%B0%E7%BB%843.png' width=600> </img></div>
所以**Java的二维数组在内存中不是 `3*4` 的连续地址空间,而是四条连续的地址空间组成!**
## 数组的经典题目
在面试中,数组是必考的基础数据结构。
其实数组的题目在思想上一般比较简单的,但是如果想高效,并不容易。
我们之前一共讲解了四道经典数组题目,每一道题目都代表一个类型,一种思想。
### 二分法
[数组:每次遇到二分法,都是一看就会,一写就废](https://programmercarl.com/0704.二分查找.html)
这道题目呢,考察数组的基本操作,思路很简单,但是通过率在简单题里并不高,不要轻敌。
可以使用暴力解法,通过这道题目,如果追求更优的算法,建议试一试用二分法,来解决这道题目
* 暴力解法时间复杂度:O(n)
* 二分法时间复杂度:O(logn)
在这道题目中我们讲到了**循环不变量原则**,只有在循环中坚持对区间的定义,才能清楚的把握循环中的各种细节。
**二分法是算法面试中的常考题,建议通过这道题目,锻炼自己手撕二分的能力**。
### 双指针法
* [数组:就移除个元素很难么?](https://programmercarl.com/0027.移除元素.html)
双指针法(快慢指针法):**通过一个快指针和慢指针在一个for循环下完成两个for循环的工作。**
* 暴力解法时间复杂度:O(n^2)
* 双指针时间复杂度:O(n)
这道题目迷惑了不少同学,纠结于数组中的元素为什么不能删除,主要是因为以下两点:
* 数组在内存中是连续的地址空间,不能释放单一元素,如果要释放,就是全释放(程序运行结束,回收内存栈空间)。
* C++中vector和array的区别一定要弄清楚,vector的底层实现是array,封装后使用更友好。
双指针法(快慢指针法)在数组和链表的操作中是非常常见的,很多考察数组和链表操作的面试题,都使用双指针法。
### 滑动窗口
* [数组:滑动窗口拯救了你](https://programmercarl.com/0209.长度最小的子数组.html)
本题介绍了数组操作中的另一个重要思想:滑动窗口。
* 暴力解法时间复杂度:O(n^2)
* 滑动窗口时间复杂度:O(n)
本题中,主要要理解滑动窗口如何移动 窗口起始位置,达到动态更新窗口大小的,从而得出长度最小的符合条件的长度。
**滑动窗口的精妙之处在于根据当前子序列和大小的情况,不断调节子序列的起始位置。从而将O(n^2)的暴力解法降为O(n)。**
如果没有接触过这一类的方法,很难想到类似的解题思路,滑动窗口方法还是很巧妙的。
### 模拟行为
* [数组:这个循环可以转懵很多人!](https://programmercarl.com/0059.螺旋矩阵II.html)
模拟类的题目在数组中很常见,不涉及到什么算法,就是单纯的模拟,十分考察大家对代码的掌控能力。
在这道题目中,我们再一次介绍到了**循环不变量原则**,其实这也是写程序中的重要原则。
相信大家有遇到过这种情况: 感觉题目的边界调节超多,一波接着一波的判断,找边界,拆了东墙补西墙,好不容易运行通过了,代码写的十分冗余,毫无章法,其实**真正解决题目的代码都是简洁的,或者有原则性的**,大家可以在这道题目中体会到这一点。
### 前缀和
> 代码随想录后续补充题目
* [数组:求取区间和](https://programmercarl.com/kamacoder/0058.区间和.html)
前缀和的思路其实很简单,但非常实用,如果没接触过的录友,也很难想到这个解法维度,所以 这是开阔思路 而难度又不高的好题。
## 总结

这个图是 [代码随想录知识星球](https://programmercarl.com/other/kstar.html) 成员:[海螺人](https://wx.zsxq.com/dweb2/index/footprint/844412858822412),所画,总结的非常好,分享给大家。
从二分法到双指针,从滑动窗口到螺旋矩阵,相信如果大家真的认真做了「代码随想录」每日推荐的题目,定会有所收获。
推荐的题目即使大家之前做过了,再读一遍文章,也会帮助你提炼出解题的精髓所在。
---
## 链表理论基础
* [做项目(多个C++、Java、Go、测开、前端项目)](https://www.programmercarl.com/other/kstar.html)
* [刷算法(两个月高强度学算法)](https://www.programmercarl.com/xunlian/xunlianying.html)
* [背八股(40天挑战高频面试题)](https://www.programmercarl.com/xunlian/bagu.html)
# 关于链表,你该了解这些!
什么是链表,链表是一种通过指针串联在一起的线性结构,每一个节点由两部分组成,一个是数据域一个是指针域(存放指向下一个节点的指针),最后一个节点的指针域指向null(空指针的意思)。
链表的入口节点称为链表的头结点也就是head。
如图所示:
## 链表的类型
接下来说一下链表的几种类型:
### 单链表
刚刚说的就是单链表。
### 双链表
单链表中的指针域只能指向节点的下一个节点。
双链表:每一个节点有两个指针域,一个指向下一个节点,一个指向上一个节点。
双链表 既可以向前查询也可以向后查询。
如图所示:
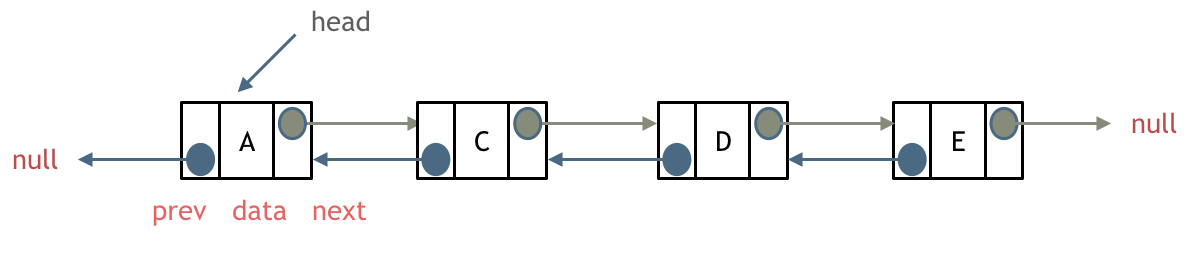
### 循环链表
循环链表,顾名思义,就是链表首尾相连。
循环链表可以用来解决约瑟夫环问题。
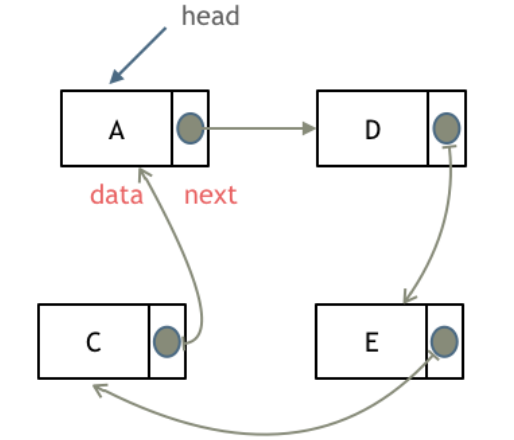
## 链表的存储方式
了解完链表的类型,再来说一说链表在内存中的存储方式。
数组是在内存中是连续分布的,但是链表在内存中可不是连续分布的。
链表是通过指针域的指针链接在内存中各个节点。
所以链表中的节点在内存中不是连续分布的 ,而是散乱分布在内存中的某地址上,分配机制取决于操作系统的内存管理。
如图所示:
这个链表起始节点为2, 终止节点为7, 各个节点分布在内存的不同地址空间上,通过指针串联在一起。
## 链表的定义
接下来说一说链表的定义。
链表节点的定义,很多同学在面试的时候都写不好。
这是因为平时在刷leetcode的时候,链表的节点都默认定义好了,直接用就行了,所以同学们都没有注意到链表的节点是如何定义的。
而在面试的时候,一旦要自己手写链表,就写的错漏百出。
这里我给出C/C++的定义链表节点方式,如下所示:
cpp
// 单链表
struct ListNode {
int val; // 节点上存储的元素
ListNode *next; // 指向下一个节点的指针
ListNode(int x) : val(x), next(NULL) {} // 节点的构造函数
};
有同学说了,我不定义构造函数行不行,答案是可以的,C++默认生成一个构造函数。
但是这个构造函数不会初始化任何成员变量,下面我来举两个例子:
通过自己定义构造函数初始化节点:
cpp
ListNode* head = new ListNode(5);
使用默认构造函数初始化节点:
cpp
ListNode* head = new ListNode();
head->val = 5;
所以如果不定义构造函数使用默认构造函数的话,在初始化的时候就不能直接给变量赋值!
## 链表的操作
### 删除节点
删除D节点,如图所示:
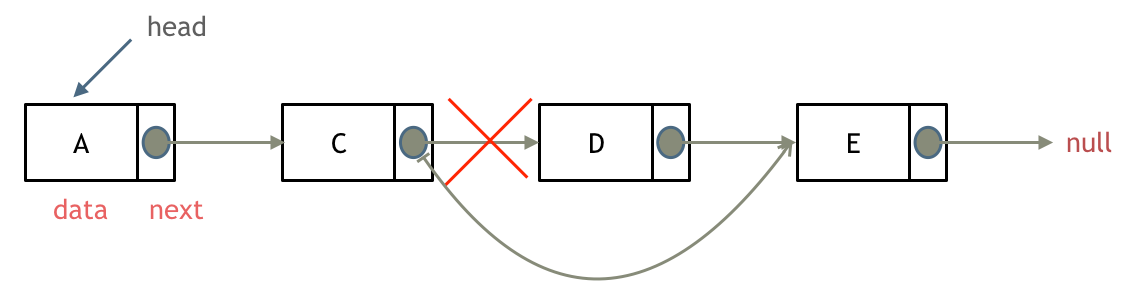
只要将C节点的next指针 指向E节点就可以了。
那有同学说了,D节点不是依然存留在内存里么?只不过是没有在这个链表里而已。
是这样的,所以在C++里最好是再手动释放这个D节点,释放这块内存。
其他语言例如Java、Python,就有自己的内存回收机制,就不用自己手动释放了。
### 添加节点
如图所示:
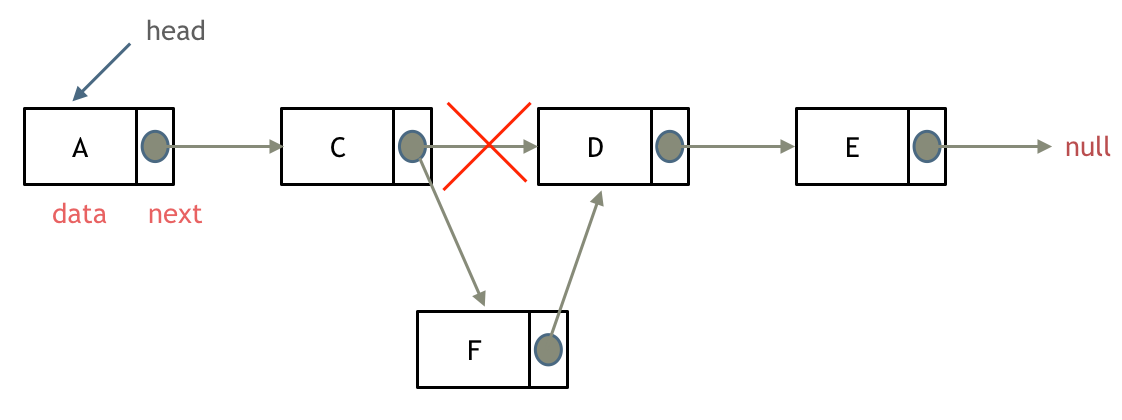
可以看出链表的增添和删除都是O(1)操作,也不会影响到其他节点。
但是要注意,要是删除第五个节点,需要从头节点查找到第四个节点通过next指针进行删除操作,查找的时间复杂度是O(n)。
## 性能分析
再把链表的特性和数组的特性进行一个对比,如图所示:
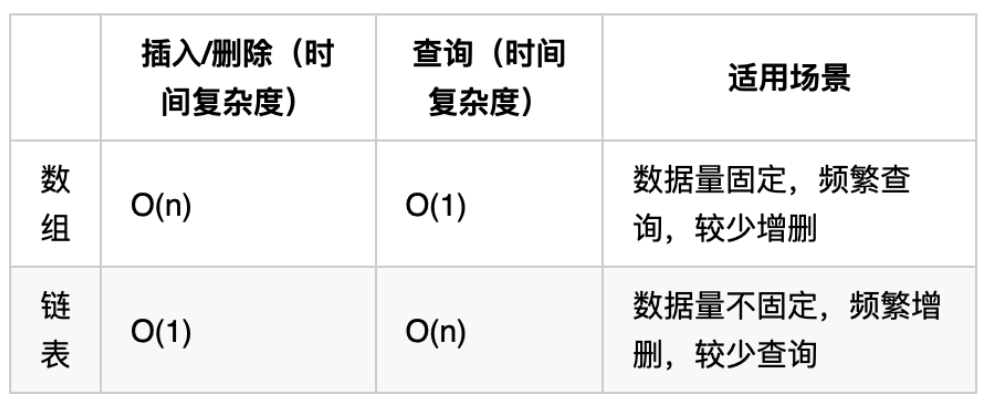
数组在定义的时候,长度就是固定的,如果想改动数组的长度,就需要重新定义一个新的数组。
链表的长度可以是不固定的,并且可以动态增删, 适合数据量不固定,频繁增删,较少查询的场景。
相信大家已经对链表足够的了解,后面我会讲解关于链表的高频面试题目,我们下期见!
## 其他语言版本
### Java:
java
public class ListNode {
// 结点的值
int val;
// 下一个结点
ListNode next;
// 节点的构造函数(无参)
public ListNode() {
}
// 节点的构造函数(有一个参数)
public ListNode(int val) {
this.val = val;
}
// 节点的构造函数(有两个参数)
public ListNode(int val, ListNode next) {
this.val = val;
this.next = next;
}
}
### JavaScript:
javascript
class ListNode {
val;
next = null;
constructor(value) {
this.val = value;
this.next = null;
}
}
### TypeScript:
typescript
class ListNode {
public val: number;
public next: ListNode|null = null;
constructor(value: number) {
this.val = value;
this.next = null;
}
}
### Python:
python
class ListNode:
def __init__(self, val, next=None):
self.val = val
self.next = next
### Go:
go
type ListNode struct {
Val int
Next *ListNode
}
### Scala:
scala
class ListNode(_x: Int = 0, _next: ListNode = null) {
var next: ListNode = _next
var x: Int = _x
}
### Rust:
rust
#[derive(PartialEq, Eq, Clone, Debug)]
pub struct ListNode {
pub val: T,
pub next: Option<Box<ListNode<T>>>,
}
impl ListNode {
#[inline]
fn new(val: T, node: Option<Box<ListNode<T>>>) -> Self {
ListNode { next: node, val }
}
}
### C:
c
typedef struct ListNodeT {
int val;
struct ListNodeT next;
} ListNode;
### C#
c#
public class Node
{
// 节点存储的数据
public T Data { get; set; }
// 指向下一个节点的引用
public Node<T> Next { get; set; }
// 节点的构造函数,用于初始化节点
public Node(T data)
{
Data = data;
Next = null; // 初始时没有下一个节点,因此设为 null
}
}
---
## 移除链表元素
* [做项目(多个C++、Java、Go、测开、前端项目)](https://www.programmercarl.com/other/kstar.html)
* [刷算法(两个月高强度学算法)](https://www.programmercarl.com/xunlian/xunlianying.html)
* [背八股(40天挑战高频面试题)](https://www.programmercarl.com/xunlian/bagu.html)
> 链表操作中,可以使用原链表来直接进行删除操作,也可以设置一个虚拟头结点再进行删除操作,接下来看一看哪种方式更方便。
# 203.移除链表元素
[力扣题目链接](https://leetcode.cn/problems/remove-linked-list-elements/)
题意:删除链表中等于给定值 val 的所有节点。
示例 1:
输入:head = [1,2,6,3,4,5,6], val = 6
输出:[1,2,3,4,5]
示例 2:
输入:head = [], val = 1
输出:[]
示例 3:
输入:head = [7,7,7,7], val = 7
输出:[]
## 算法公开课
**[《代码随想录》算法视频公开课](https://programmercarl.com/other/gongkaike.html):[链表基础操作| LeetCode:203.移除链表元素](https://www.bilibili.com/video/BV18B4y1s7R9),相信结合视频再看本篇题解,更有助于大家对本题的理解**。
## 思路
这里以链表 1 4 2 4 来举例,移除元素4。
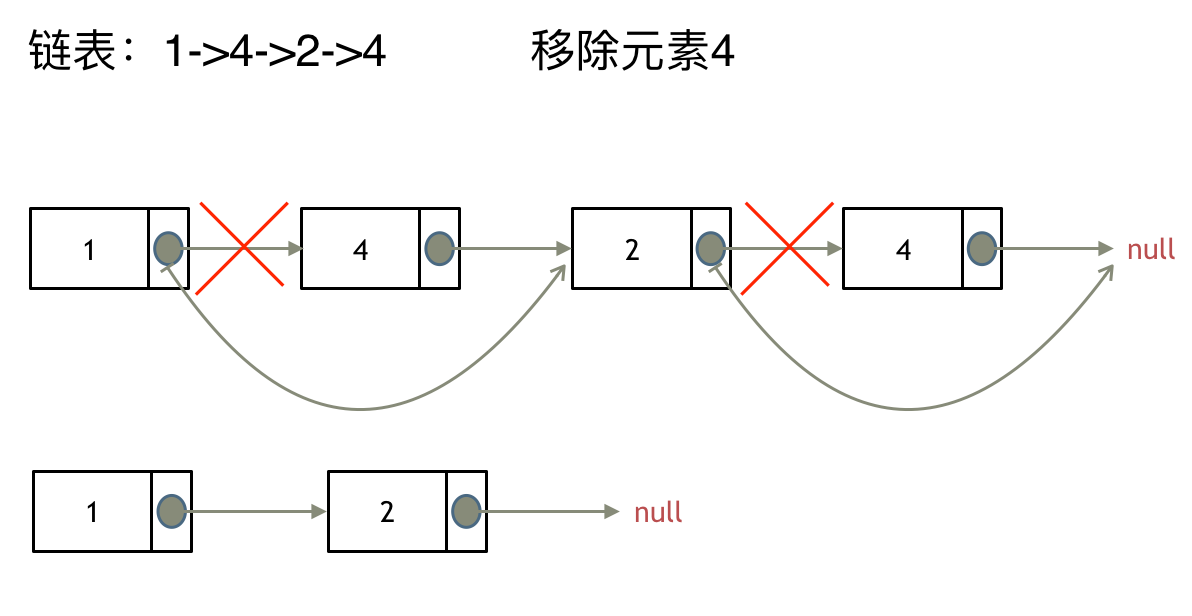
如果使用C,C++编程语言的话,不要忘了还要从内存中删除这两个移除的节点, 清理节点内存之后如图:
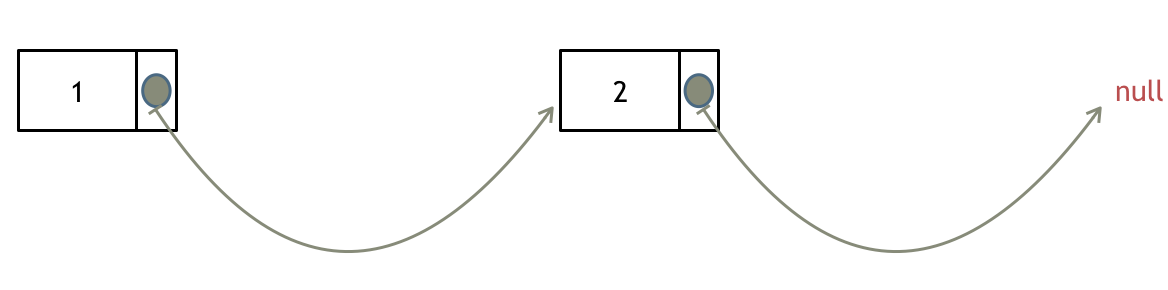
**当然如果使用java ,python的话就不用手动管理内存了。**
还要说明一下,就算使用C++来做leetcode,如果移除一个节点之后,没有手动在内存中删除这个节点,leetcode依然也是可以通过的,只不过,内存使用的空间大一些而已,但建议依然要养成手动清理内存的习惯。
这种情况下的移除操作,就是让节点next指针直接指向下下一个节点就可以了,
那么因为单链表的特殊性,只能指向下一个节点,刚刚删除的是链表的中第二个,和第四个节点,那么如果删除的是头结点又该怎么办呢?
这里就涉及如下链表操作的两种方式:
* **直接使用原来的链表来进行删除操作。**
* **设置一个虚拟头结点在进行删除操作。**
来看第一种操作:直接使用原来的链表来进行移除。
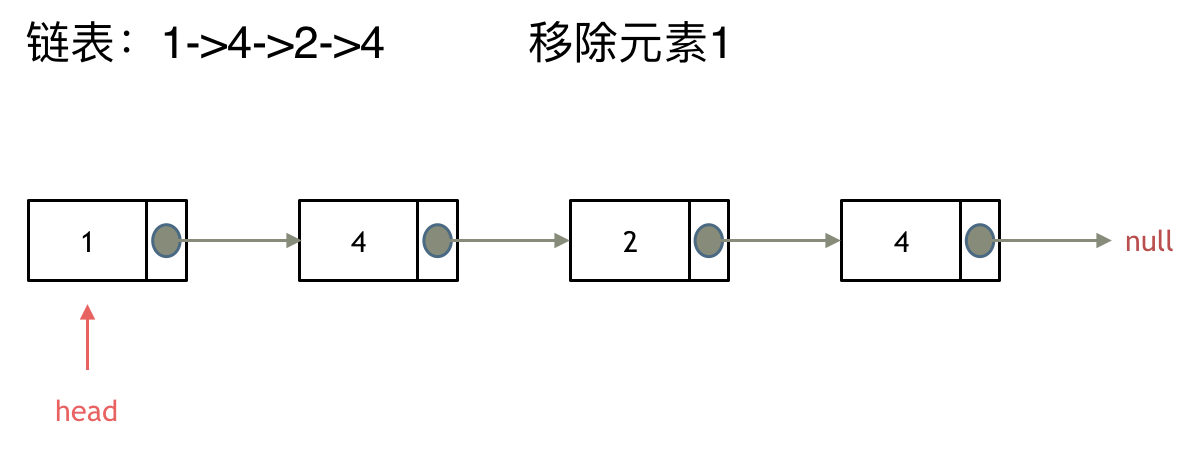
移除头结点和移除其他节点的操作是不一样的,因为链表的其他节点都是通过前一个节点来移除当前节点,而头结点没有前一个节点。
所以头结点如何移除呢,其实只要将头结点向后移动一位就可以,这样就从链表中移除了一个头结点。
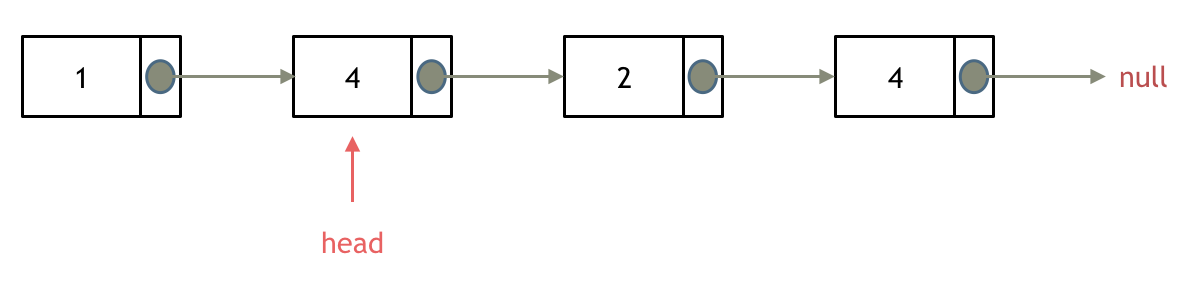
依然别忘将原头结点从内存中删掉。
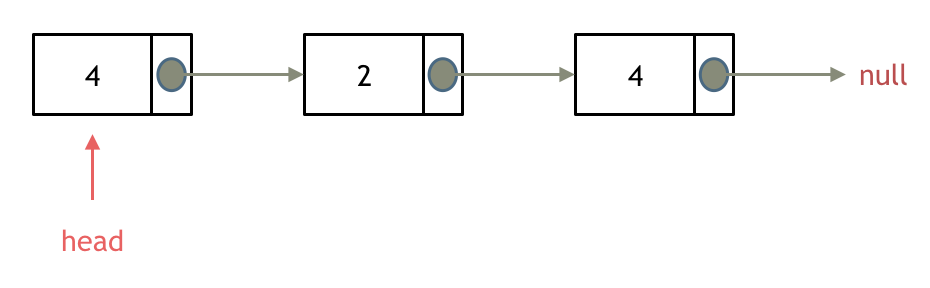
这样移除了一个头结点,是不是发现,在单链表中移除头结点 和 移除其他节点的操作方式是不一样,其实在写代码的时候也会发现,需要单独写一段逻辑来处理移除头结点的情况。
那么可不可以 以一种统一的逻辑来移除 链表的节点呢。
其实**可以设置一个虚拟头结点**,这样原链表的所有节点就都可以按照统一的方式进行移除了。
来看看如何设置一个虚拟头。依然还是在这个链表中,移除元素1。
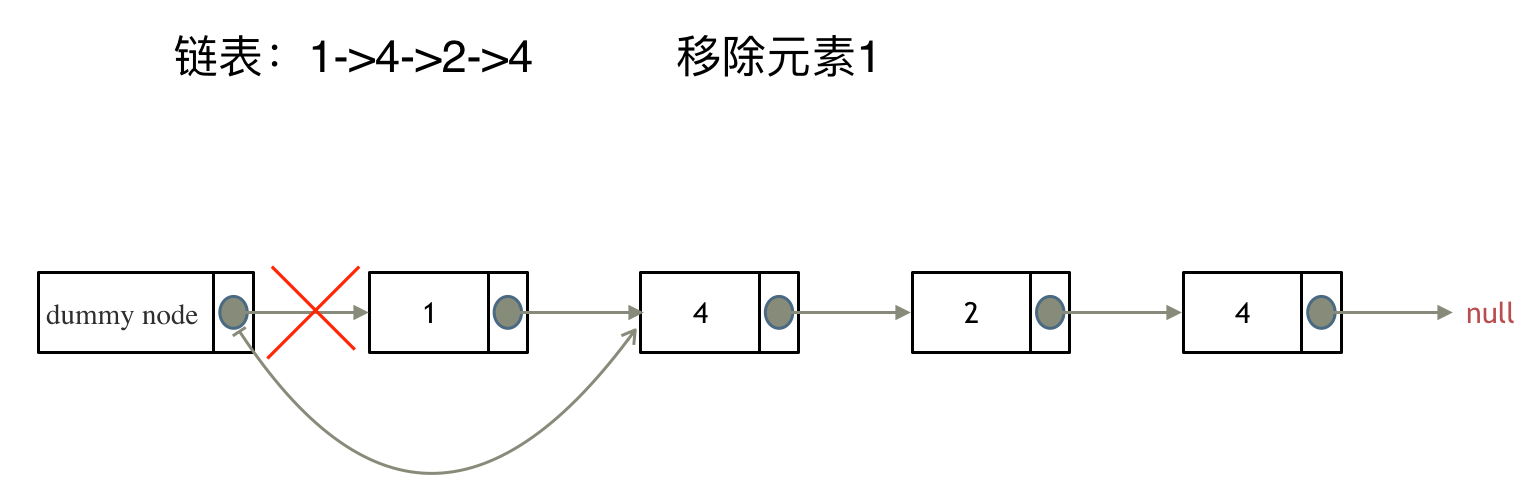
这里来给链表添加一个虚拟头结点为新的头结点,此时要移除这个旧头结点元素1。
这样是不是就可以使用和移除链表其他节点的方式统一了呢?
来看一下,如何移除元素1 呢,还是熟悉的方式,然后从内存中删除元素1。
最后呢在题目中,return 头结点的时候,别忘了 `return dummyNode->next;`, 这才是新的头结点
**直接使用原来的链表来进行移除节点操作:**
CPP
class Solution {
public:
ListNode* removeElements(ListNode* head, int val) {
// 删除头结点
while (head != NULL && head->val == val) { // 注意这里不是if
ListNode* tmp = head;
head = head->next;
delete tmp;
}
// 删除非头结点
ListNode* cur = head;
while (cur != NULL && cur->next!= NULL) {
if (cur->next->val == val) {
ListNode* tmp = cur->next;
cur->next = cur->next->next;
delete tmp;
} else {
cur = cur->next;
}
}
return head;
}
};
* 时间复杂度: O(n)
* 空间复杂度: O(1)
**设置一个虚拟头结点在进行移除节点操作:**
CPP
class Solution {
public:
ListNode* removeElements(ListNode* head, int val) {
ListNode* dummyHead = new ListNode(0); // 设置一个虚拟头结点
dummyHead->next = head; // 将虚拟头结点指向head,这样方便后面做删除操作
ListNode* cur = dummyHead;
while (cur->next != NULL) {
if(cur->next->val == val) {
ListNode* tmp = cur->next;
cur->next = cur->next->next;
delete tmp;
} else {
cur = cur->next;
}
}
head = dummyHead->next;
delete dummyHead;
return head;
}
};
* 时间复杂度: O(n)
* 空间复杂度: O(1)
**也可以通过递归的思路解决本题:**
基础情况:对于空链表,不需要移除元素。
递归情况:首先检查头节点的值是否为 val,如果是则移除头节点,答案即为在头节点的后续节点上递归的结果;如果头节点的值不为 val,则答案为头节点与在头节点的后续节点上递归得到的新链表拼接的结果。
CPP
class Solution {
public:
ListNode* removeElements(ListNode* head, int val) {
// 基础情况:空链表
if (head == nullptr) {
return nullptr;
}
// 递归处理
if (head->val == val) {
ListNode* newHead = removeElements(head->next, val);
delete head;
return newHead;
} else {
head->next = removeElements(head->next, val);
return head;
}
}
};
* 时间复杂度:O(n)
* 空间复杂度:O(n)
## 其他语言版本
### C:
用原来的链表操作:
c
struct ListNode removeElements(struct ListNode head, int val){
struct ListNode* temp;
// 当头结点存在并且头结点的值等于val时
while(head && head->val == val) {
temp = head;
// 将新的头结点设置为head->next并删除原来的头结点
head = head->next;
free(temp);
}
struct ListNode *cur = head;
// 当cur存在并且cur->next存在时
// 此解法需要判断cur存在因为cur指向head。若head本身为NULL或者原链表中元素都为val的话,cur也会为NULL
while(cur && (temp = cur->next)) {
// 若cur->next的值等于val
if(temp->val == val) {
// 将cur->next设置为cur->next->next并删除cur->next
cur->next = temp->next;
free(temp);
}
// 若cur->next不等于val,则将cur后移一位
else
cur = cur->next;
}
// 返回头结点
return head;
}
设置一个虚拟头结点:
c
/**
- Definition for singly-linked list.
- struct ListNode {
- int val;
- struct ListNode *next;
- };
*/
struct ListNode removeElements(struct ListNode head, int val){
typedef struct ListNode ListNode;
ListNode *shead;
shead = (ListNode *)malloc(sizeof(ListNode));
shead->next = head;
ListNode *cur = shead;
while(cur->next != NULL){
if (cur->next->val == val){
ListNode *tmp = cur->next;
cur->next = cur->next->next;
free(tmp);
}
else{
cur = cur->next;
}
}
head = shead->next;
free(shead);
return head;
}
### Java:
用原来的链表操作:
java
/**
- 方法1
- 时间复杂度 O(n)
- 空间复杂度 O(1)
- @param head
- @param val
- @return
*/
public ListNode removeElements(ListNode head, int val) {
while(head!=null && head.val==val) {
head = head.next;
}
ListNode curr = head;
while(curr!=null && curr.next !=null) {
if(curr.next.val == val){
curr.next = curr.next.next;
} else {
curr = curr.next;
}
}
return head;
}
/**
- 方法1
- 时间复杂度 O(n)
- 空间复杂度 O(1)
- @param head
- @param val
- @return
*/
public ListNode removeElements(ListNode head, int val) {
while (head != null && head.val == val) {
head = head.next;
}
// 已经为null,提前退出
if (head == null) {
return head;
}
// 已确定当前head.val != val
ListNode pre = head;
ListNode cur = head.next;
while (cur != null) {
if (cur.val == val) {
pre.next = cur.next;
} else {
pre = cur;
}
cur = cur.next;
}
return head;
}
设置一个虚拟头结点:
java
/**
- 时间复杂度 O(n)
- 空间复杂度 O(1)
- @param head
- @param val
- @return
*/
public ListNode removeElements(ListNode head, int val) {
// 设置一个虚拟的头结点
ListNode dummy = new ListNode();
dummy.next = head;
ListNode cur = dummy;
while (cur.next != null) {
if (cur.next.val == val) {
cur.next = cur.next.next;
} else {
cur = cur.next;
}
}
return dummy.next;
}
递归
java
/**
- 时间复杂度 O(n)
- 空间复杂度 O(n)
- @param head
- @param val
- @return
*/
class Solution {
public ListNode removeElements(ListNode head, int val) {
if (head == null) {
return head;
}
// 假设 removeElements() 返回后面完整的已经去掉val节点的子链表
// 在当前递归层用当前节点接住后面的子链表
// 随后判断当前层的node是否需要被删除,如果是,就返回
// 也可以先判断是否需要删除当前node,但是这样条件语句会比较不好想
head.next = removeElements(head.next, val);
if (head.val == val) {
return head.next;
}
return head;
// 实际上就是还原一个从尾部开始重新构建链表的过程
}
}
### Python:
python
(版本一)虚拟头节点法
Definition for singly-linked list.
class ListNode:
def __init__(self, val=0, next=None):
self.val = val
self.next = next
class Solution:
def removeElements(self, head: Optional[ListNode], val: int) -> Optional[ListNode]:
# 创建虚拟头部节点以简化删除过程
dummy_head = ListNode(next = head)
# 遍历列表并删除值为val的节点
current = dummy_head
while current.next:
if current.next.val == val:
current.next = current.next.next
else:
current = current.next
return dummy_head.next
### Go:
直接使用原链表
go
/**
- Definition for singly-linked list.
- type ListNode struct {
- Val int
- Next *ListNode
- }
*/
func removeElements(head ListNode, val int) ListNode {
//依旧是先定义逻辑
//如果原链表的头节点为val的话,head=head.next,且为持续过程,防止头节点后面的节点也为Val
//这里前置循环 并且要判定head 是否为nil,防止出错
for head != nil && head.Val == val {//由于leetcode代码运行方式,for循环条件判断前后顺序不能修改,下面的for循环也同样如此
head = head.Next
}
cur := head
for cur != nil && cur.Next != nil {
if cur.Next.Val == val {
cur.Next = cur.Next.Next
} else {
cur = cur.Next
}
}
return head
}
虚拟头节点方式:
go
/**
- Definition for singly-linked list.
- type ListNode struct {
- Val int
- Next *ListNode
- }
*/
func removeElements(head ListNode, val int) ListNode {
dummyHead := &ListNode{}
dummyHead.Next = head
cur := dummyHead
for cur != nil && cur.Next != nil {
if cur.Next.Val == val {
cur.Next = cur.Next.Next
} else {
cur = cur.Next
}
}
return dummyHead.Next
}
### JavaScript:
js
/**
- @param {ListNode} head
- @param {number} val
- @return {ListNode}
*/
var removeElements = function(head, val) {
const ret = new ListNode(0, head);
let cur = ret;
while(cur.next) {
if(cur.next.val === val) {
cur.next = cur.next.next;
continue;
}
cur = cur.next;
}
return ret.next;
};
### TypeScript:
版本一(在原链表上直接删除):
typescript
/**
- Definition for singly-linked list.
- class ListNode {
- val: number
- next: ListNode | null
- constructor(val?: number, next?: ListNode | null) {
- this.val = (val===undefined ? 0 : val)
- this.next = (next===undefined ? null : next)
- }
- }
*/
function removeElements(head: ListNode | null, val: number): ListNode | null {
// 删除头部节点
while (head !== null && head.val === val) {
head = head.next;
}
if (head === null) return head;
let pre: ListNode = head, cur: ListNode | null = head.next;
// 删除非头部节点
while (cur) {
if (cur.val === val) {
pre.next = cur.next;
} else {
//此处不加类型断言时:编译器会认为pre类型为ListNode, pre.next类型为ListNode | null
pre = pre.next as ListNode;
}
cur = cur.next;
}
return head;
};
版本二(虚拟头节点):
typescript
function removeElements(head: ListNode | null, val: number): ListNode | null {
// 添加虚拟节点
const data = new ListNode(0, head);
let pre = data, cur = data.next;
while (cur) {
if (cur.val === val) {
pre.next = cur.next
} else {
pre = cur;
}
cur = cur.next;
}
return data.next;
};
### Swift:
swift
/**
- Definition for singly-linked list.
- public class ListNode {
- public var val: Int
- public var next: ListNode?
- public init() { self.val = 0; self.next = nil; }
- public init(_ val: Int) { self.val = val; self.next = nil; }
- public init(_ val: Int, _ next: ListNode?) { self.val = val; self.next = next; }
- }
*/
func removeElements(_ head: ListNode?, _ val: Int) -> ListNode? {
let dummyNode = ListNode()
dummyNode.next = head
var currentNode = dummyNode
while let curNext = currentNode.next {
if curNext.val == val {
currentNode.next = curNext.next
} else {
currentNode = curNext
}
}
return dummyNode.next
}
### PHP:
php
/**
- Definition for a singly-linked list.
- class ListNode {
- public $val = 0;
- public $next = null;
- function __construct($val = 0, $next = null) {
- $this->val = $val;
- $this->next = $next;
- }
- }
*/
//版本一(在原链表上直接删除):
class Solution {
/**
* @param ListNode $head
* @param Integer $val
* @return ListNode
*/
function removeElements($head, $val)
{
if ($head == null) {
return null;
}
$now = $head;
while ($now->next != null) {
if ($now->next->val == $val) {
$now->next = $now->next->next;
} else {
$now = $now->next;
}
}
if ($head->val == $val) {
return $head->next;
}
return $head;
}
}
//版本二(虚拟头结点方式):
class Solution {
/**
* @param ListNode $head
* @param Integer $val
* @return ListNode
*/
function removeElements($head, $val)
{
$dummyHead = new ListNode(0, $head);
$now = $dummyHead;
while ($now->next != null){
if ($now->next->val == $val) {
$now->next = $now->next->next;
} else {
$now = $now->next;
}
}
return $dummyHead->next;
}
}
### Rust:
rust
// Definition for singly-linked list.
// #[derive(PartialEq, Eq, Clone, Debug)]
// pub struct ListNode {
// pub val: i32,
// pub next: Option>
// }
//
// impl ListNode {
// #[inline]
// fn new(val: i32) -> Self {
// ListNode {
// next: None,
// val
// }
// }
// }
impl Solution {
pub fn remove_elements(head: Option<Box<ListNode>>, val: i32) -> Option<Box<ListNode>> {
let mut dummyHead = Box::new(ListNode::new(0));
dummyHead.next = head;
let mut cur = dummyHead.as_mut();
// 使用take()替换std::mem::replace(&mut node.next, None)达到相同的效果,并且更普遍易读
while let Some(nxt) = cur.next.take() {
if nxt.val == val {
cur.next = nxt.next;
} else {
cur.next = Some(nxt);
cur = cur.next.as_mut().unwrap();
}
}
dummyHead.next
}
}
### Scala:
scala
/**
- Definition for singly-linked list.
- class ListNode(_x: Int = 0, _next: ListNode = null) {
- var next: ListNode = _next
- var x: Int = _x
- }
*/
object Solution {
def removeElements(head: ListNode, val: Int): ListNode = {
if (head == null) return head
var dummy = new ListNode(-1, head) // 定义虚拟头节点
var cur = head // cur 表示当前节点
var pre = dummy // pre 表示cur前一个节点
while (cur != null) {
if (cur.x == `val`) {
// 相等,就删除那么cur的前一个节点pre执行cur的下一个
pre.next = cur.next
} else {
// 不相等,pre就等于当前cur节点
pre = cur
}
// 向下迭代
cur = cur.next
}
// 最终返回dummy的下一个,就是链表的头
dummy.next
}
}
### Kotlin:
kotlin
/**
- Example:
- var li = ListNode(5)
- var v = li.
val - Definition for singly-linked list.
- class ListNode(var
val: Int) { - var next: ListNode? = null
- }
*/
class Solution {
fun removeElements(head: ListNode?, `val`: Int): ListNode? {
// 使用虚拟节点,令该节点指向head
var dummyNode = ListNode(-1)
dummyNode.next = head
// 使用cur遍历链表各个节点
var cur = dummyNode
// 判断下个节点是否为空
while (cur.next != null) {
// 符合条件,移除节点
if (cur.next.`val` == `val`) {
cur.next = cur.next.next
}
// 不符合条件,遍历下一节点
else {
cur = cur.next
}
}
// 注意:返回的不是虚拟节点
return dummyNode.next
}
}
### C#
CSharp
/**
- Definition for singly-linked list.
- public class ListNode {
- public int val;
- public ListNode next;
- public ListNode(int val=0, ListNode next=null) {
- this.val = val;
- this.next = next;
- }
- }
*/
public class Solution
{
public ListNode RemoveElements(ListNode head, int val)
{
ListNode dummyHead = new ListNode(0,head);
ListNode temp = dummyHead;
while(temp.next != null)
{
if(temp.next.val == val)
{
temp.next = temp.next.next;
}
else
{
temp = temp.next;
}
}
return dummyHead.next;
}
}
### Ruby#
ruby
定义链表节点
class ListNode
attr_accessor :val, :next
def initialize(val = 0, _next = nil)
@val = val
@next = _next
end
end
删除链表中值为 val 的节点
def remove_elements(head, val)
# 创建一个虚拟头节点,这样可以简化删除头节点的处理
# 虚拟头节点的值为 0,指向当前链表的头节点
dummy = ListNode.new(0)
dummy.next = head
# 初始化当前节点为虚拟头节点
current = dummy
# 遍历链表,直到当前节点的下一个节点为空
while current.next
# 如果当前节点的下一个节点的值等于 val
if current.next.val == val
# 跳过该节点,即将当前节点的 next 指向下一个节点的 next
current.next = current.next.next
else
# 否则继续遍历,当前节点向前移动
current = current.next
end
end
# 返回删除 val 后的新链表的头节点,虚拟头节点的 next 就是新的头节点
dummy.next
end
---
## 设计链表
* [做项目(多个C++、Java、Go、测开、前端项目)](https://www.programmercarl.com/other/kstar.html)
* [刷算法(两个月高强度学算法)](https://www.programmercarl.com/xunlian/xunlianying.html)
* [背八股(40天挑战高频面试题)](https://www.programmercarl.com/xunlian/bagu.html)
> 听说这道题目把链表常见的五个操作都覆盖了?
# 707.设计链表
[力扣题目链接](https://leetcode.cn/problems/design-linked-list/)
题意:
在链表类中实现这些功能:
* get(index):获取链表中第 index 个节点的值。如果索引无效,则返回-1。
* addAtHead(val):在链表的第一个元素之前添加一个值为 val 的节点。插入后,新节点将成为链表的第一个节点。
* addAtTail(val):将值为 val 的节点追加到链表的最后一个元素。
* addAtIndex(index,val):在链表中的第 index 个节点之前添加值为 val 的节点。如果 index 等于链表的长度,则该节点将附加到链表的末尾。如果 index 大于链表长度,则不会插入节点。如果index小于0,则在头部插入节点。
* deleteAtIndex(index):如果索引 index 有效,则删除链表中的第 index 个节点。
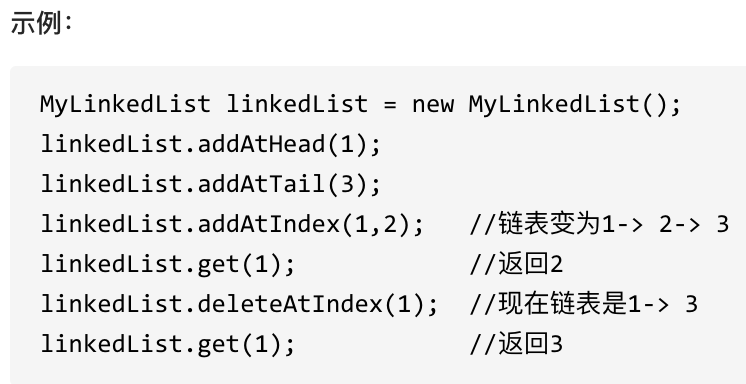
## 算法公开课
**[《代码随想录》算法视频公开课](https://programmercarl.com/other/gongkaike.html):[帮你把链表操作学个通透!LeetCode:707.设计链表](https://www.bilibili.com/video/BV1FU4y1X7WD),相信结合视频再看本篇题解,更有助于大家对本题的理解**。
## 思路
如果对链表的基础知识还不太懂,可以看这篇文章:[关于链表,你该了解这些!](https://programmercarl.com/链表理论基础.html)
如果对链表的虚拟头结点不清楚,可以看这篇文章:[链表:听说用虚拟头节点会方便很多?](https://programmercarl.com/0203.移除链表元素.html)
删除链表节点:
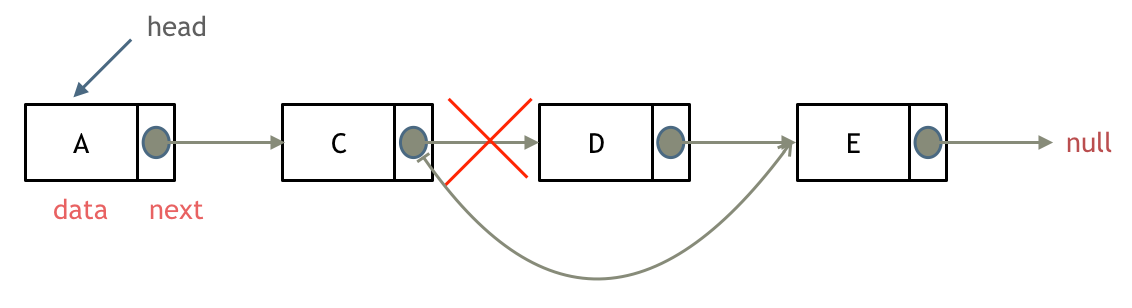
添加链表节点:
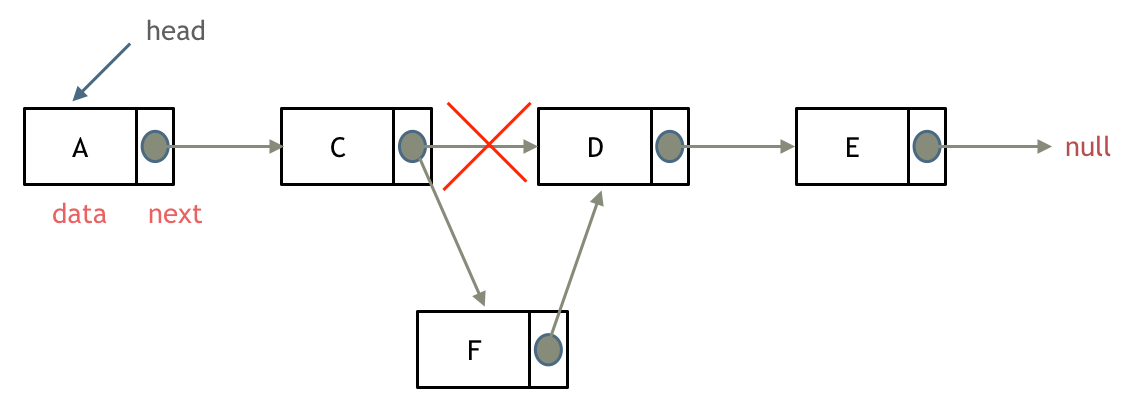
这道题目设计链表的五个接口:
* 获取链表第index个节点的数值
* 在链表的最前面插入一个节点
* 在链表的最后面插入一个节点
* 在链表第index个节点前面插入一个节点
* 删除链表的第index个节点
可以说这五个接口,已经覆盖了链表的常见操作,是练习链表操作非常好的一道题目
**链表操作的两种方式:**
1. 直接使用原来的链表来进行操作。
2. 设置一个虚拟头结点在进行操作。
下面采用的设置一个虚拟头结点(这样更方便一些,大家看代码就会感受出来)。
CPP
class MyLinkedList {
public:
// 定义链表节点结构体
struct LinkedNode {
int val;
LinkedNode* next;
LinkedNode(int val):val(val), next(nullptr){}
};
// 初始化链表
MyLinkedList() {
_dummyHead = new LinkedNode(0); // 这里定义的头结点 是一个虚拟头结点,而不是真正的链表头结点
_size = 0;
}
// 获取到第index个节点数值,如果index是非法数值直接返回-1, 注意index是从0开始的,第0个节点就是头结点
int get(int index) {
if (index > (_size - 1) || index < 0) {
return -1;
}
LinkedNode* cur = _dummyHead->next;
while(index--){ // 如果--index 就会陷入死循环
cur = cur->next;
}
return cur->val;
}
// 在链表最前面插入一个节点,插入完成后,新插入的节点为链表的新的头结点
void addAtHead(int val) {
LinkedNode* newNode = new LinkedNode(val);
newNode->next = _dummyHead->next;
_dummyHead->next = newNode;
_size++;
}
// 在链表最后面添加一个节点
void addAtTail(int val) {
LinkedNode* newNode = new LinkedNode(val);
LinkedNode* cur = _dummyHead;
while(cur->next != nullptr){
cur = cur->next;
}
cur->next = newNode;
_size++;
}
// 在第index个节点之前插入一个新节点,例如index为0,那么新插入的节点为链表的新头节点。
// 如果index 等于链表的长度,则说明是新插入的节点为链表的尾结点
// 如果index大于链表的长度,则返回空
// 如果index小于0,则在头部插入节点
void addAtIndex(int index, int val) {
if(index > _size) return;
if(index < 0) index = 0;
LinkedNode* newNode = new LinkedNode(val);
LinkedNode* cur = _dummyHead;
while(index--) {
cur = cur->next;
}
newNode->next = cur->next;
cur->next = newNode;
_size++;
}
// 删除第index个节点,如果index 大于等于链表的长度,直接return,注意index是从0开始的
void deleteAtIndex(int index) {
if (index >= _size || index < 0) {
return;
}
LinkedNode* cur = _dummyHead;
while(index--) {
cur = cur ->next;
}
LinkedNode* tmp = cur->next;
cur->next = cur->next->next;
delete tmp;
//delete命令指示释放了tmp指针原本所指的那部分内存,
//被delete后的指针tmp的值(地址)并非就是NULL,而是随机值。也就是被delete后,
//如果不再加上一句tmp=nullptr,tmp会成为乱指的野指针
//如果之后的程序不小心使用了tmp,会指向难以预想的内存空间
tmp=nullptr;
_size--;
}
// 打印链表
void printLinkedList() {
LinkedNode* cur = _dummyHead;
while (cur->next != nullptr) {
cout << cur->next->val << " ";
cur = cur->next;
}
cout << endl;
}
private:
int _size;
LinkedNode* _dummyHead;
};
* 时间复杂度: 涉及 `index` 的相关操作为 O(index), 其余为 O(1)
* 空间复杂度: O(n)
## 其他语言版本
### C++双链表法:
CPP
//采用循环虚拟结点的双链表实现
class MyLinkedList {
public:
// 定义双向链表节点结构体
struct DList {
int elem; // 节点存储的元素
DList *next; // 指向下一个节点的指针
DList *prev; // 指向上一个节点的指针
// 构造函数,创建一个值为elem的新节点
DList(int elem) : elem(elem), next(nullptr), prev(nullptr) {};
};
// 构造函数,初始化链表
MyLinkedList() {
sentinelNode = new DList(0); // 创建哨兵节点,不存储有效数据
sentinelNode->next = sentinelNode; // 哨兵节点的下一个节点指向自身,形成循环
sentinelNode->prev = sentinelNode; // 哨兵节点的上一个节点指向自身,形成循环
size = 0; // 初始化链表大小为0
}
// 获取链表中第index个节点的值
int get(int index) {
if (index > (size - 1) || index < 0) { // 检查索引是否超出范围
return -1; // 如果超出范围,返回-1
}
int num;
int mid = size >> 1; // 计算链表中部位置
DList *curNode = sentinelNode; // 从哨兵节点开始
if (index < mid) { // 如果索引小于中部位置,从前往后遍历
for (int i = 0; i < index + 1; i++) {
curNode = curNode->next; // 移动到目标节点
}
} else { // 如果索引大于等于中部位置,从后往前遍历
for (int i = 0; i < size - index; i++) {
curNode = curNode->prev; // 移动到目标节点
}
}
num = curNode->elem; // 获取目标节点的值
return num; // 返回节点的值
}
// 在链表头部添加节点
void addAtHead(int val) {
DList *newNode = new DList(val); // 创建新节点
DList *next = sentinelNode->next; // 获取当前头节点的下一个节点
newNode->prev = sentinelNode; // 新节点的上一个节点指向哨兵节点
newNode->next = next; // 新节点的下一个节点指向原来的头节点
size++; // 链表大小加1
sentinelNode->next = newNode; // 哨兵节点的下一个节点指向新节点
next->prev = newNode; // 原来的头节点的上一个节点指向新节点
}
// 在链表尾部添加节点
void addAtTail(int val) {
DList *newNode = new DList(val); // 创建新节点
DList *prev = sentinelNode->prev; // 获取当前尾节点的上一个节点
newNode->next = sentinelNode; // 新节点的下一个节点指向哨兵节点
newNode->prev = prev; // 新节点的上一个节点指向原来的尾节点
size++; // 链表大小加1
sentinelNode->prev = newNode; // 哨兵节点的上一个节点指向新节点
prev->next = newNode; // 原来的尾节点的下一个节点指向新节点
}
// 在链表中的第index个节点之前添加值为val的节点
void addAtIndex(int index, int val) {
if (index > size) { // 检查索引是否超出范围
return; // 如果超出范围,直接返回
}
if (index <= 0) { // 如果索引为0或负数,在头部添加节点
addAtHead(val);
return;
}
int num;
int mid = size >> 1; // 计算链表中部位置
DList *curNode = sentinelNode; // 从哨兵节点开始
if (index < mid) { // 如果索引小于中部位置,从前往后遍历
for (int i = 0; i < index; i++) {
curNode = curNode->next; // 移动到目标位置的前一个节点
}
DList *temp = curNode->next; // 获取目标位置的节点
DList *newNode = new DList(val); // 创建新节点
curNode->next = newNode; // 在目标位置前添加新节点
temp->prev = newNode; // 目标位置的节点的前一个节点指向新节点
newNode->next = temp; // 新节点的下一个节点指向目标位置的结点
newNode->prev = curNode; // 新节点的上一个节点指向当前节点
} else { // 如果索引大于等于中部位置,从后往前遍历
for (int i = 0; i < size - index; i++) {
curNode = curNode->prev; // 移动到目标位置的后一个节点
}
DList *temp = curNode->prev; // 获取目标位置的节点
DList *newNode = new DList(val); // 创建新节点
curNode->prev = newNode; // 在目标位置后添加新节点
temp->next = newNode; // 目标位置的节点的下一个节点指向新节点
newNode->prev = temp; // 新节点的上一个节点指向目标位置的节点
newNode->next = curNode; // 新节点的下一个节点指向当前节点
}
size++; // 链表大小加1
}
// 删除链表中的第index个节点
void deleteAtIndex(int index) {
if (index > (size - 1) || index < 0) { // 检查索引是否超出范围
return; // 如果超出范围,直接返回
}
int num;
int mid = size >> 1; // 计算链表中部位置
DList *curNode = sentinelNode; // 从哨兵节点开始
if (index < mid) { // 如果索引小于中部位置,从前往后遍历
for (int i = 0; i < index; i++) {
curNode = curNode->next; // 移动到目标位置的前一个节点
}
DList *next = curNode->next->next; // 获取目标位置的下一个节点
curNode->next = next; // 删除目标位置的节点
next->prev = curNode; // 目标位置的下一个节点的前一个节点指向当前节点
} else { // 如果索引大于等于中部位置,从后往前遍历
for (int i = 0; i < size - index - 1; i++) {
curNode = curNode->prev; // 移动到目标位置的后一个节点
}
DList *prev = curNode->prev->prev; // 获取目标位置的下一个节点
curNode->prev = prev; // 删除目标位置的节点
prev->next = curNode; // 目标位置的下一个节点的下一个节点指向当前节点
}
size--; // 链表大小减1
}
private:
int size; // 链表的大小
DList *sentinelNode; // 哨兵节点的指针
};
### C:
C
typedef struct Node {
int val;
struct Node* next;
} Node;
typedef struct {
int size;
Node* data;
} MyLinkedList;
/** Initialize your data structure here. */
MyLinkedList* myLinkedListCreate() {
MyLinkedList* obj = (MyLinkedList*)malloc(sizeof(MyLinkedList));
Node* head = (Node*)malloc(sizeof(Node));
head->next = (void*)0;
obj->data = head;
obj->size = 0;
return obj;
}
/** Get the value of the index-th node in the linked list. If the index is invalid, return -1. */
int myLinkedListGet(MyLinkedList* obj, int index) {
if (index < 0 || index >= obj->size) return -1;
Node* cur = obj->data;
while (index-- >= 0) {
cur = cur->next;
}
return cur->val;
}
/** Add a node of value val before the first element of the linked list. After the insertion, the new node will be the first node of the linked list. */
void myLinkedListAddAtHead(MyLinkedList* obj, int val) {
Node* node = (Node*)malloc(sizeof(Node));
node->val = val;
node->next = obj->data->next;
obj->data->next = node;
obj->size++;
}
/** Append a node of value val to the last element of the linked list. */
void myLinkedListAddAtTail(MyLinkedList* obj, int val) {
Node* cur = obj->data;
while (cur->next != ((void*)0)) {
cur = cur->next;
}
Node* tail = (Node*)malloc(sizeof(Node));
tail->val = val;
tail->next = (void*)0;
cur->next = tail;
obj->size++;
}
/** Add a node of value val before the index-th node in the linked list. If index equals to the length of linked list, the node will be appended to the end of linked list. If index is greater than the length, the node will not be inserted. */
void myLinkedListAddAtIndex(MyLinkedList* obj, int index, int val) {
if (index > obj->size) return;
Node* cur = obj->data;
while (index-- > 0) {
cur = cur->next;
}
Node* node = (Node*)malloc(sizeof(Node));
node->val = val;
node->next = cur->next;
cur->next = node;
obj->size++;
}
/** Delete the index-th node in the linked list, if the index is valid. */
void myLinkedListDeleteAtIndex(MyLinkedList* obj, int index) {
if (index < 0 || index >= obj->size) return;
Node* cur = obj->data;
while (index-- > 0) {
cur = cur->next;
}
Node* temp = cur->next;
cur->next = temp->next;
free(temp);
obj->size--;
}
void myLinkedListFree(MyLinkedList* obj) {
Node* tmp = obj->data;
while (tmp != NULL) {
Node* n = tmp;
tmp = tmp->next;
free(n);
}
free(obj);
}
/**
- Your MyLinkedList struct will be instantiated and called as such:
- MyLinkedList* obj = myLinkedListCreate();
- int param_1 = myLinkedListGet(obj, index);
- myLinkedListAddAtHead(obj, val);
- myLinkedListAddAtTail(obj, val);
- myLinkedListAddAtIndex(obj, index, val);
- myLinkedListDeleteAtIndex(obj, index);
*/
### Java:
Java
//单链表
class MyLinkedList {
class ListNode {
int val;
ListNode next;
ListNode(int val) {
this.val=val;
}
}
//size存储链表元素的个数
private int size;
//注意这里记录的是虚拟头结点
private ListNode head;
//初始化链表
public MyLinkedList() {
this.size = 0;
this.head = new ListNode(0);
}
//获取第index个节点的数值,注意index是从0开始的,第0个节点就是虚拟头结点
public int get(int index) {
//如果index非法,返回-1
if (index < 0 || index >= size) {
return -1;
}
ListNode cur = head;
//第0个节点是虚拟头节点,所以查找第 index+1 个节点
for (int i = 0; i <= index; i++) {
cur = cur.next;
}
return cur.val;
}
public void addAtHead(int val) {
ListNode newNode = new ListNode(val);
newNode.next = head.next;
head.next = newNode;
size++;
// 在链表最前面插入一个节点,等价于在第0个元素前添加
// addAtIndex(0, val);
}
public void addAtTail(int val) {
ListNode newNode = new ListNode(val);
ListNode cur = head;
while (cur.next != null) {
cur = cur.next;
}
cur.next = newNode;
size++;
// 在链表的最后插入一个节点,等价于在(末尾+1)个元素前添加
// addAtIndex(size, val);
}
// 在第 index 个节点之前插入一个新节点,例如index为0,那么新插入的节点为链表的新头节点。
// 如果 index 等于链表的长度,则说明是新插入的节点为链表的尾结点
// 如果 index 大于链表的长度,则返回空
public void addAtIndex(int index, int val) {
if (index < 0 || index > size) {
return;
}
//找到要插入节点的前驱
ListNode pre = head;
for (int i = 0; i < index; i++) {
pre = pre.next;
}
ListNode newNode = new ListNode(val);
newNode.next = pre.next;
pre.next = newNode;
size++;
}
public void deleteAtIndex(int index) {
if (index < 0 || index >= size) {
return;
}
//因为有虚拟头节点,所以不用对index=0的情况进行特殊处理
ListNode pre = head;
for (int i = 0; i < index ; i++) {
pre = pre.next;
}
pre.next = pre.next.next;
size--;
}
}
Java
//双链表
class MyLinkedList {
class ListNode{
int val;
ListNode next, prev;
ListNode(int val){
this.val = val;
}
}
//记录链表中元素的数量
private int size;
//记录链表的虚拟头结点和尾结点
private ListNode head, tail;
public MyLinkedList() {
//初始化操作
this.size = 0;
this.head = new ListNode(0);
this.tail = new ListNode(0);
//这一步非常关键,否则在加入头结点的操作中会出现null.next的错误!!!
this.head.next = tail;
this.tail.prev = head;
}
public int get(int index) {
//判断index是否有效
if(index < 0 || index >= size){
return -1;
}
ListNode cur = head;
//判断是哪一边遍历时间更短
if(index >= size / 2){
//tail开始
cur = tail;
for(int i = 0; i < size - index; i++){
cur = cur.prev;
}
}else{
for(int i = 0; i <= index; i++){
cur = cur.next;
}
}
return cur.val;
}
public void addAtHead(int val) {
//等价于在第0个元素前添加
addAtIndex(0, val);
}
public void addAtTail(int val) {
//等价于在最后一个元素(null)前添加
addAtIndex(size, val);
}
public void addAtIndex(int index, int val) {
//判断index是否有效
if(index < 0 || index > size){
return;
}
//找到前驱
ListNode pre = head;
for(int i = 0; i < index; i++){
pre = pre.next;
}
//新建结点
ListNode newNode = new ListNode(val);
newNode.next = pre.next;
pre.next.prev = newNode;
newNode.prev = pre;
pre.next = newNode;
size++;
}
public void deleteAtIndex(int index) {
//判断index是否有效
if(index < 0 || index >= size){
return;
}
//删除操作
ListNode pre = head;
for(int i = 0; i < index; i++){
pre = pre.next;
}
pre.next.next.prev = pre;
pre.next = pre.next.next;
size--;
}
}
/**
- Your MyLinkedList object will be instantiated and called as such:
- MyLinkedList obj = new MyLinkedList();
- int param_1 = obj.get(index);
- obj.addAtHead(val);
- obj.addAtTail(val);
- obj.addAtIndex(index,val);
- obj.deleteAtIndex(index);
*/
### Python:
python
(版本一)单链表法
class ListNode:
def __init__(self, val=0, next=None):
self.val = val
self.next = next
class MyLinkedList:
def __init__(self):
self.dummy_head = ListNode()
self.size = 0
def get(self, index: int) -> int:
if index < 0 or index >= self.size:
return -1
current = self.dummy_head.next
for i in range(index):
current = current.next
return current.val
def addAtHead(self, val: int) -> None:
self.dummy_head.next = ListNode(val, self.dummy_head.next)
self.size += 1
def addAtTail(self, val: int) -> None:
current = self.dummy_head
while current.next:
current = current.next
current.next = ListNode(val)
self.size += 1
def addAtIndex(self, index: int, val: int) -> None:
if index < 0 or index > self.size:
return
current = self.dummy_head
for i in range(index):
current = current.next
current.next = ListNode(val, current.next)
self.size += 1
def deleteAtIndex(self, index: int) -> None:
if index < 0 or index >= self.size:
return
current = self.dummy_head
for i in range(index):
current = current.next
current.next = current.next.next
self.size -= 1
Your MyLinkedList object will be instantiated and called as such:
obj = MyLinkedList()
param_1 = obj.get(index)
obj.addAtHead(val)
obj.addAtTail(val)
obj.addAtIndex(index,val)
obj.deleteAtIndex(index)
python
(版本二)双链表法
class ListNode:
def __init__(self, val=0, prev=None, next=None):
self.val = val
self.prev = prev
self.next = next
class MyLinkedList:
def __init__(self):
self.head = None
self.tail = None
self.size = 0
def get(self, index: int) -> int:
if index < 0 or index >= self.size:
return -1
if index < self.size // 2:
current = self.head
for i in range(index):
current = current.next
else:
current = self.tail
for i in range(self.size - index - 1):
current = current.prev
return current.val
def addAtHead(self, val: int) -> None:
new_node = ListNode(val, None, self.head)
if self.head:
self.head.prev = new_node
else:
self.tail = new_node
self.head = new_node
self.size += 1
def addAtTail(self, val: int) -> None:
new_node = ListNode(val, self.tail, None)
if self.tail:
self.tail.next = new_node
else:
self.head = new_node
self.tail = new_node
self.size += 1
def addAtIndex(self, index: int, val: int) -> None:
if index < 0 or index > self.size:
return
if index == 0:
self.addAtHead(val)
elif index == self.size:
self.addAtTail(val)
else:
if index < self.size // 2:
current = self.head
for i in range(index - 1):
current = current.next
else:
current = self.tail
for i in range(self.size - index):
current = current.prev
new_node = ListNode(val, current, current.next)
current.next.prev = new_node
current.next = new_node
self.size += 1
def deleteAtIndex(self, index: int) -> None:
if index < 0 or index >= self.size:
return
if index == 0:
self.head = self.head.next
if self.head:
self.head.prev = None
else:
self.tail = None
elif index == self.size - 1:
self.tail = self.tail.prev
if self.tail:
self.tail.next = None
else:
self.head = None
else:
if index < self.size // 2:
current = self.head
for i in range(index):
current = current.next
else:
current = self.tail
for i in range(self.size - index - 1):
current = current.prev
current.prev.next = current.next
current.next.prev = current.prev
self.size -= 1
Your MyLinkedList object will be instantiated and called as such:
obj = MyLinkedList()
param_1 = obj.get(index)
obj.addAtHead(val)
obj.addAtTail(val)
obj.addAtIndex(index,val)
obj.deleteAtIndex(index)
### Go:
go
//单链表实现
package main
import (
"fmt"
)
type SingleNode struct {
Val int // 节点的值
Next *SingleNode // 下一个节点的指针
}
type MyLinkedList struct {
dummyHead *SingleNode // 虚拟头节点
Size int // 链表大小
}
func main() {
list := Constructor() // 初始化链表
list.AddAtHead(100) // 在头部添加元素
list.AddAtTail(242) // 在尾部添加元素
list.AddAtTail(777) // 在尾部添加元素
list.AddAtIndex(1, 99999) // 在指定位置添加元素
list.printLinkedList() // 打印链表
}
/** Initialize your data structure here. */
func Constructor() MyLinkedList {
newNode := &SingleNode{ // 创建新节点
-999,
nil,
}
return MyLinkedList{ // 返回链表
dummyHead: newNode,
Size: 0,
}
}
/** Get the value of the index-th node in the linked list. If the index is
invalid, return -1. */
func (this *MyLinkedList) Get(index int) int {
/*if this != nil || index < 0 || index > this.Size {
return -1
}*/
if this == nil || index < 0 || index >= this.Size { // 如果索引无效则返回-1
return -1
}
// 让cur等于真正头节点
cur := this.dummyHead.Next // 设置当前节点为真实头节点
for i := 0; i < index; i++ { // 遍历到索引所在的节点
cur = cur.Next
}
return cur.Val // 返回节点值
}
/** Add a node of value val before the first element of the linked list. After
the insertion, the new node will be the first node of the linked list. */
func (this *MyLinkedList) AddAtHead(val int) {
// 以下两行代码可用一行代替
// newNode := new(SingleNode)
// newNode.Val = val
newNode := &SingleNode{Val: val} // 创建新节点
newNode.Next = this.dummyHead.Next // 新节点指向当前头节点
this.dummyHead.Next = newNode // 新节点变为头节点
this.Size++ // 链表大小增加1
}
/** Append a node of value val to the last element of the linked list. */
func (this *MyLinkedList) AddAtTail(val int) {
newNode := &SingleNode{Val: val} // 创建新节点
cur := this.dummyHead // 设置当前节点为虚拟头节点
for cur.Next != nil { // 遍历到最后一个节点
cur = cur.Next
}
cur.Next = newNode // 在尾部添加新节点
this.Size++ // 链表大小增加1
}
/** Add a node of value val before the index-th node in the linked list. If
index equals to the length of linked list, the node will be appended to the
end of linked list. If index is greater than the length, the node will not be
inserted. */
func (this *MyLinkedList) AddAtIndex(index int, val int) {
if index < 0 { // 如果索引小于0,设置为0
index = 0
} else if index > this.Size { // 如果索引大于链表长度,直接返回
return
}
newNode := &SingleNode{Val: val} // 创建新节点
cur := this.dummyHead // 设置当前节点为虚拟头节点
for i := 0; i < index; i++ { // 遍历到指定索引的前一个节点
cur = cur.Next
}
newNode.Next = cur.Next // 新节点指向原索引节点
cur.Next = newNode // 原索引的前一个节点指向新节点
this.Size++ // 链表大小增加1
}
/** Delete the index-th node in the linked list, if the index is valid. */
func (this *MyLinkedList) DeleteAtIndex(index int) {
if index < 0 || index >= this.Size { // 如果索引无效则直接返回
return
}
cur := this.dummyHead // 设置当前节点为虚拟头节点
for i := 0; i < index; i++ { // 遍历到要删除节点的前一个节点
cur = cur.Next
}
if cur.Next != nil {
cur.Next = cur.Next.Next // 当前节点直接指向下下个节点,即删除了下一个节点
}
this.Size-- // 注意删除节点后应将链表大小减一
}
// 打印链表
func (list *MyLinkedList) printLinkedList() {
cur := list.dummyHead // 设置当前节点为虚拟头节点
for cur.Next != nil { // 遍历链表
fmt.Println(cur.Next.Val) // 打印节点值
cur = cur.Next // 切换到下一个节点
}
}
go
//循环双链表
type MyLinkedList struct {
dummy *Node
}
type Node struct {
Val int
Next *Node
Pre *Node
}
//仅保存哑节点,pre-> rear, next-> head
/** Initialize your data structure here. */
func Constructor() MyLinkedList {
rear := &Node{
Val: -1,
Next: nil,
Pre: nil,
}
rear.Next = rear
rear.Pre = rear
return MyLinkedList{rear}
}
/** Get the value of the index-th node in the linked list. If the index is invalid, return -1. */
func (this *MyLinkedList) Get(index int) int {
head := this.dummy.Next
//head == this, 遍历完全
for head != this.dummy && index > 0 {
index--
head = head.Next
}
//否则, head == this, 索引无效
if 0 != index {
return -1
}
return head.Val
}
/** Add a node of value val before the first element of the linked list. After the insertion, the new node will be the first node of the linked list. */
func (this *MyLinkedList) AddAtHead(val int) {
dummy := this.dummy
node := &Node{
Val: val,
//head.Next指向原头节点
Next: dummy.Next,
//head.Pre 指向哑节点
Pre: dummy,
}
//更新原头节点
dummy.Next.Pre = node
//更新哑节点
dummy.Next = node
//以上两步不能反
}
/** Append a node of value val to the last element of the linked list. */
func (this *MyLinkedList) AddAtTail(val int) {
dummy := this.dummy
rear := &Node{
Val: val,
//rear.Next = dummy(哑节点)
Next: dummy,
//rear.Pre = ori_rear
Pre: dummy.Pre,
}
//ori_rear.Next = rear
dummy.Pre.Next = rear
//update dummy
dummy.Pre = rear
//以上两步不能反
}
/** Add a node of value val before the index-th node in the linked list. If index equals to the length of linked list, the node will be appended to the end of linked list. If index is greater than the length, the node will not be inserted. */
func (this *MyLinkedList) AddAtIndex(index int, val int) {
head := this.dummy.Next
//head = MyLinkedList[index]
for head != this.dummy && index > 0 {
head = head.Next
index--
}
if index > 0 {
return
}
node := &Node{
Val: val,
//node.Next = MyLinkedList[index]
Next: head,
//node.Pre = MyLinkedList[index-1]
Pre: head.Pre,
}
//MyLinkedList[index-1].Next = node
head.Pre.Next = node
//MyLinkedList[index].Pre = node
head.Pre = node
//以上两步不能反
}
/** Delete the index-th node in the linked list, if the index is valid. */
func (this *MyLinkedList) DeleteAtIndex(index int) {
//链表为空
if this.dummy.Next == this.dummy {
return
}
head := this.dummy.Next
//head = MyLinkedList[index]
for head.Next != this.dummy && index > 0 {
head = head.Next
index--
}
//验证index有效
if index == 0 {
//MyLinkedList[index].Pre = index[index-2]
head.Next.Pre = head.Pre
//MyLinedList[index-2].Next = index[index]
head.Pre.Next = head.Next
//以上两步顺序无所谓
}
}
### JavaScript:
js
class LinkNode {
constructor(val, next) {
this.val = val;
this.next = next;
}
}
/**
- Initialize your data structure here.
- 单链表 储存头尾节点 和 节点数量
*/
var MyLinkedList = function() {
this._size = 0;
this._tail = null;
this._head = null;
};
/**
- Get the value of the index-th node in the linked list. If the index is invalid, return -1.
- @param {number} index
- @return {number}
*/
MyLinkedList.prototype.getNode = function(index) {
if(index < 0 || index >= this._size) return null;
// 创建虚拟头节点
let cur = new LinkNode(0, this._head);
// 0 -> head
while(index-- >= 0) {
cur = cur.next;
}
return cur;
};
MyLinkedList.prototype.get = function(index) {
if(index < 0 || index >= this._size) return -1;
// 获取当前节点
return this.getNode(index).val;
};
/**
- Add a node of value val before the first element of the linked list. After the insertion, the new node will be the first node of the linked list.
- @param {number} val
- @return {void}
*/
MyLinkedList.prototype.addAtHead = function(val) {
const node = new LinkNode(val, this._head);
this._head = node;
this._size++;
if(!this._tail) {
this._tail = node;
}
};
/**
- Append a node of value val to the last element of the linked list.
- @param {number} val
- @return {void}
*/
MyLinkedList.prototype.addAtTail = function(val) {
const node = new LinkNode(val, null);
this._size++;
if(this._tail) {
this._tail.next = node;
this._tail = node;
return;
}
this._tail = node;
this._head = node;
};
/**
- Add a node of value val before the index-th node in the linked list. If index equals to the length of linked list, the node will be appended to the end of linked list. If index is greater than the length, the node will not be inserted.
- @param {number} index
- @param {number} val
- @return {void}
*/
MyLinkedList.prototype.addAtIndex = function(index, val) {
if(index > this._size) return;
if(index <= 0) {
this.addAtHead(val);
return;
}
if(index === this._size) {
this.addAtTail(val);
return;
}
// 获取目标节点的上一个的节点
const node = this.getNode(index - 1);
node.next = new LinkNode(val, node.next);
this._size++;
};
/**
- Delete the index-th node in the linked list, if the index is valid.
- @param {number} index
- @return {void}
*/
MyLinkedList.prototype.deleteAtIndex = function(index) {
if(index < 0 || index >= this._size) return;
if(index === 0) {
this._head = this._head.next;
// 如果删除的这个节点同时是尾节点,要处理尾节点
if(index === this._size - 1){
this._tail = this._head
}
this._size--;
return;
}
// 获取目标节点的上一个的节点
const node = this.getNode(index - 1);
node.next = node.next.next;
// 处理尾节点
if(index === this._size - 1) {
this._tail = node;
}
this._size--;
};
// MyLinkedList.prototype.out = function() {
// let cur = this._head;
// const res = [];
// while(cur) {
// res.push(cur.val);
// cur = cur.next;
// }
// };
/**
- Your MyLinkedList object will be instantiated and called as such:
- var obj = new MyLinkedList()
- var param_1 = obj.get(index)
- obj.addAtHead(val)
- obj.addAtTail(val)
- obj.addAtIndex(index,val)
- obj.deleteAtIndex(index)
*/
js
/**
定义双头节点的结构:同时包含前指针`prev`和后指针next`
*/
class Node {
constructor(val, prev, next) {
this.val = val
this.prev = prev
this.next = next
}
}
/**
双链表:维护 `head` 和 `tail` 两个哨兵节点,这样可以简化对于中间节点的操作
并且维护 `size`,使得能够以O(1)时间判断操作是否合法
*/
var MyLinkedList = function () {
this.tail = new Node(-1)
this.head = new Node(-1)
this.tail.prev = this.head
this.head.next = this.tail
this.size = 0
};
/**
*
- @param {number} index
- @return {number}
*
*/
MyLinkedList.prototype.get = function (index) {
// 当索引超出范围时,返回-1
if (index > this.size) {
return -1
}
let cur = this.head
for (let i = 0; i <= index; i++) {
cur = cur.next
}
return cur.val
};
/**
*
- @param {number} val
- @return {void}
- 时间复杂度: O(1)
- 空间复杂度: O(1)
*/
MyLinkedList.prototype.addAtHead = function (val) {
/**
head <-> [newNode] <-> originNode
*/
this.size++
const originNode = this.head.next
// 创建新节点,并建立连接
const newNode = new Node(val, this.head, originNode)
// 取消原前后结点的连接
this.head.next = newNode
originNode.prev = newNode
};
/**
*
- @param {number} val
- @return {void}
*
*/
MyLinkedList.prototype.addAtTail = function (val) {
/**
originNode <-> [newNode] <-> tail
*/
this.size++
const originNode = this.tail.prev
// 创建新节点,并建立连接
const newNode = new Node(val, originNode, this.tail)
// 取消原前后结点的连接
this.tail.prev = newNode
originNode.next = newNode
};
/**
*
- @param {number} index
- @param {number} val
- @return {void}
*
*/
MyLinkedList.prototype.addAtIndex = function (index, val) {
// 当索引超出范围时,直接返回
if (index > this.size) {
return
}
this.size++
let cur = this.head
for (let i = 0; i < index; i++) {
cur = cur.next
}
const new_next = cur.next
// 创建新节点,并建立连接
const node = new Node(val, cur, new_next)
// 取消原前后结点的连接
cur.next = node
new_next.prev = node
};
/**
*
- @param {number} index
- @return {void}
*
*/
MyLinkedList.prototype.deleteAtIndex = function (index) {
// 当索引超出范围时,直接返回
if (index >= this.size) {
return
}
this.size--
let cur = this.head
for (let i = 0; i < index; i++) {
cur = cur.next
}
const new_next = cur.next.next
// 取消原前后结点的连接
new_next.prev = cur
cur.next = new_next
};
### TypeScript:
TypeScript
class ListNode {
public val: number;
public next: ListNode | null;
constructor(val?: number, next?: ListNode | null) {
this.val = val === undefined ? 0 : val;
this.next = next === undefined ? null : next;
}
}
class MyLinkedList {
// 记录链表长度
private size: number;
private head: ListNode | null;
private tail: ListNode | null;
constructor() {
this.size = 0;
this.head = null;
this.tail = null;
}
// 获取链表中第 index个节点的值
get(index: number): number {
// 索引无效的情况
if (index < 0 || index >= this.size) {
return -1;
}
let curNode = this.getNode(index);
// 这里在前置条件下,理论上不会出现 null的情况
return curNode.val;
}
// 在链表的第一个元素之前添加一个值为 val的节点。插入后,新节点将成为链表的第一个节点。
addAtHead(val: number): void {
let node: ListNode = new ListNode(val, this.head);
this.head = node;
if (!this.tail) {
this.tail = node;
}
this.size++;
}
// 将值为 val 的节点追加到链表的最后一个元素。
addAtTail(val: number): void {
let node: ListNode = new ListNode(val, null);
if (this.tail) {
this.tail.next = node;
} else {
// 还没有尾节点,说明一个节点都还没有
this.head = node;
}
this.tail = node;
this.size++;
}
// 在链表中的第 index个节点之前添加值为 val的节点。
// 如果 index等于链表的长度,则该节点将附加到链表的末尾。如果 index大于链表长度,则不会插入节点。如果 index小于0,则在头部插入节点。
addAtIndex(index: number, val: number): void {
if (index === this.size) {
this.addAtTail(val);
return;
}
if (index > this.size) {
return;
}
// <= 0 的情况都是在头部插入
if (index <= 0) {
this.addAtHead(val);
return;
}
// 正常情况
// 获取插入位置的前一个 node
let curNode = this.getNode(index - 1);
let node: ListNode = new ListNode(val, curNode.next);
curNode.next = node;
this.size++;
}
// 如果索引 index有效,则删除链表中的第 index个节点。
deleteAtIndex(index: number): void {
if (index < 0 || index >= this.size) {
return;
}
// 处理头节点
if (index === 0) {
this.head = this.head!.next;
// 如果链表中只有一个元素,删除头节点后,需要处理尾节点
if (index === this.size - 1) {
this.tail = null
}
this.size--;
return;
}
// 索引有效
let curNode: ListNode = this.getNode(index - 1);
curNode.next = curNode.next!.next;
// 处理尾节点
if (index === this.size - 1) {
this.tail = curNode;
}
this.size--;
}
// 获取指定 Node节点
private getNode(index: number): ListNode {
// 这里不存在没办法获取到节点的情况,都已经在前置方法做过判断
// 创建虚拟头节点
let curNode: ListNode = new ListNode(0, this.head);
for (let i = 0; i <= index; i++) {
// 理论上不会出现 null
curNode = curNode.next!;
}
return curNode;
}
}
### Kotlin:
kotlin
class MyLinkedList {
var next: ListNode? = null
var size: Int = 0
fun get(index: Int): Int {
if (index + 1 > size) return -1
var cur = this.next
for (i in 0 until index) {
cur = cur?.next
}
return cur?.`val` ?: -1
}
fun addAtHead(`val`: Int) {
val head = ListNode(`val`)
head.next = this.next
this.next = head
size++
}
fun addAtTail(`val`: Int) {
val pre = ListNode(0)
pre.next = this.next
var cur: ListNode? = pre
while (cur?.next != null) {
cur = cur.next
}
cur?.next = ListNode(`val`)
this.next = pre.next
size++
}
fun addAtIndex(index: Int, `val`: Int) {
if (index > size) return
val pre = ListNode(0)
pre.next = this.next
var cur:ListNode? = pre
for (i in 0 until index) {
cur = cur?.next
}
val temp = cur?.next
cur?.next = ListNode(`val`)
cur?.next?.next = temp
this.next = pre.next
size++
}
fun deleteAtIndex(index: Int) {
if (index + 1 > size) return
val pre = ListNode(0)
pre.next = this.next
var cur: ListNode? = pre
for (i in 0 until index) {
cur = cur?.next
}
val temp = cur?.next?.next
cur?.next?.next = null
cur?.next = temp
this.next = pre.next
size--
}
}
### Swift:
swift
class MyLinkedList {
var dummyHead: ListNode<Int>?
var size: Int
init() {
dummyHead = ListNode(0)
size = 0
}
func get(_ index: Int) -> Int {
if index >= size || index < 0 {
return -1
}
var curNode = dummyHead?.next
var curIndex = index
while curIndex > 0 {
curNode = curNode?.next
curIndex -= 1
}
return curNode?.value ?? -1
}
func addAtHead(_ val: Int) {
let newHead = ListNode(val)
newHead.next = dummyHead?.next
dummyHead?.next = newHead
size += 1
}
func addAtTail(_ val: Int) {
let newNode = ListNode(val)
var curNode = dummyHead
while curNode?.next != nil {
curNode = curNode?.next
}
curNode?.next = newNode
size += 1
}
func addAtIndex(_ index: Int, _ val: Int) {
if index > size {
return
}
let newNode = ListNode(val)
var curNode = dummyHead
var curIndex = index
while curIndex > 0 {
curNode = curNode?.next
curIndex -= 1
}
newNode.next = curNode?.next
curNode?.next = newNode
size += 1
}
func deleteAtIndex(_ index: Int) {
if index >= size || index < 0 {
return
}
var curNode = dummyHead
for _ in 0..<index {
curNode = curNode?.next
}
curNode?.next = curNode?.next?.next
size -= 1
}
}
### Scala:
scala
class ListNode(_x: Int = 0, _next: ListNode = null) {
var next: ListNode = _next
var x: Int = _x
}
class MyLinkedList() {
var size = 0 // 链表尺寸
var dummy: ListNode = new ListNode(0) // 虚拟头节点
// 获取第index个节点的值
def get(index: Int): Int = {
if (index < 0 || index >= size) {
return -1;
}
var cur = dummy
for (i <- 0 to index) {
cur = cur.next
}
cur.x // 返回cur的值
}
// 在链表最前面插入一个节点
def addAtHead(val: Int) {
addAtIndex(0, `val`)
}
// 在链表最后面插入一个节点
def addAtTail(val: Int) {
addAtIndex(size, `val`)
}
// 在第index个节点之前插入一个新节点
// 如果index等于链表长度,则说明新插入的节点是尾巴
// 如果index等于0,则说明新插入的节点是头
// 如果index>链表长度,则说明为空
def addAtIndex(index: Int, val: Int) {
if (index > size) {
return
}
var loc = index // 因为参数index是val不可变类型,所以需要赋值给一个可变类型
if (index < 0) {
loc = 0
}
size += 1 //链表尺寸+1
var pre = dummy
for (i <- 0 until loc) {
pre = pre.next
}
val node: ListNode = new ListNode(`val`, pre.next)
pre.next = node
}
// 删除第index个节点
def deleteAtIndex(index: Int) {
if (index < 0 || index >= size) {
return
}
size -= 1
var pre = dummy
for (i <- 0 until index) {
pre = pre.next
}
pre.next = pre.next.next
}
}
### Rust:
rust
#[derive(Debug)]
pub struct MyLinkedList {
pub val: i32,
pub next: Option<Box<MyLinkedList>>,
}
impl MyLinkedList {
fn new() -> Self {
// 增加头节点
MyLinkedList { val: 0, next: None }
}
fn get(&self, index: i32) -> i32 {
if index < 0 {
return -1;
}
let mut i = 0;
let mut cur = &self.next;
while let Some(node) = cur {
if i == index {
return node.val;
}
i += 1;
cur = &node.next;
}
-1
}
fn add_at_head(&mut self, val: i32) {
let new_node = Box::new(MyLinkedList {
val,
next: self.next.take(),
});
self.next = Some(new_node);
}
fn add_at_tail(&mut self, val: i32) {
let new_node = Box::new(MyLinkedList { val, next: None });
let mut last_node = &mut self.next;
while let Some(node) = last_node {
last_node = &mut node.next;
}
*last_node = Some(new_node);
}
fn add_at_index(&mut self, index: i32, val: i32) {
if index <= 0 {
self.add_at_head(val);
} else {
let mut i = 0;
let mut cur = &mut self.next;
while let Some(node) = cur {
if i + 1 == index {
let new_node = Box::new(MyLinkedList {
val,
next: node.next.take(),
});
node.next = Some(new_node);
break;
}
i += 1;
cur = &mut node.next;
}
}
}
fn delete_at_index(&mut self, index: i32) {
if index < 0 {
return;
}
let mut i = 0;
let mut cur = self;
while let Some(node) = cur.next.take() {
if i == index {
cur.next = node.next;
break;
}
i += 1;
cur.next = Some(node);
cur = cur.next.as_mut().unwrap();
}
}
}
### C#
csharp
class ListNode
{
public int val;
public ListNode next;
public ListNode(int val) { this.val = val; }
}
public class MyLinkedList
{
ListNode dummyHead;
int count;
public MyLinkedList()
{
dummyHead = new ListNode(0);
count = 0;
}
public int Get(int index)
{
if (index < 0 || count <= index) return -1;
ListNode current = dummyHead;
for (int i = 0; i <= index; i++)
{
current = current.next;
}
return current.val;
}
public void AddAtHead(int val)
{
AddAtIndex(0, val);
}
public void AddAtTail(int val)
{
AddAtIndex(count, val);
}
public void AddAtIndex(int index, int val)
{
if (index > count) return;
index = Math.Max(0, index);
count++;
ListNode tmp1 = dummyHead;
for (int i = 0; i < index; i++)
{
tmp1 = tmp1.next;
}
ListNode tmp2 = new ListNode(val);
tmp2.next = tmp1.next;
tmp1.next = tmp2;
}
public void DeleteAtIndex(int index)
{
if (index >= count || index < 0) return;
var tmp1 = dummyHead;
for (int i = 0; i < index; i++)
{
tmp1 = tmp1.next;
}
tmp1.next = tmp1.next.next;
count--;
}
}
```