《大厂面试指北》
《大厂面试指北》——包括Java基础、JVM、数据库、mysql、redis、计算机网络、算法、数据结构、操作系统、设计模式、系统设计、框架原理。
《大厂面试指北》
最佳阅读地址:http://notfound9.github.io/interviewGuide/
Github项目主页:https://github.com/NotFound9/interviewGuide
作者博客地址:https://juejin.im/user/5b370a42e51d4558ce5eb969
为什么要做这个开源项目?
之前在业余时间阅读技术书籍时,发现只阅读而不产出,这样收效甚微。所以就在网上找了很多常见的技术问题,根据自己的技术积累,查阅书籍,阅读文档和博客等资料,尝试着用自己的话去写了很多原创解答,最终整理开源到Github。一方面是便于自己复习巩固,一方面是将这些自己写的解答开源出来分享给大家,希望可以帮助到大家,也欢迎大家一起来完善这个项目,为开源做贡献。

目录
- [1.Java中的多态是什么?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/JavaBasic.md#Java中的多态是什么?)
- [2.Java中变量,代码块,构造器之间执行顺序是怎么样的?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/JavaBasic.md#java中变量,代码块,构造器之间执行顺序是怎么样的?)
- [3.final关键字有哪些作用?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/JavaBasic.md#final关键字有哪些作用?)
- [4.Integer类会进行缓存吗?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/JavaBasic.md#Integer类会进行缓存吗?)
- [5.抽象类有哪些特点?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/JavaBasic.md#抽象类有哪些特点?)
- [6.String,StringBuffer和StringBuilder之间的区别是什么?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/JavaBasic.md#String,StringBuffer和StringBuilder之间的区别是什么?)
- [7.编译型编程语言,解释型编程语言,伪编译型语言的区别是什么?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/JavaBasic.md#编译型编程语言,解释型编程语言,伪编译型语言的区别是什么?)
- [8.Java中的访问控制符有哪些?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/JavaBasic.md#Java中的访问控制符有哪些?)
- [9.Java的构造器有哪些特点?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/JavaBasic.md#Java的构造器有哪些特点?)
- [10.Java中的内部类是怎么样的?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/JavaBasic.md#Java中的内部类是怎么样的?)
- [11.Java中的注解是什么?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/JavaBasic.md#Java中的注解是什么?)
- [12.为什么hashCode()和equal()方法要一起重写?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/JavaBasic.md#为什么hashCode()和equal()方法要一起重写?)
-  [13.Java中有哪些数据类型?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/JavaBasic.md#Java中有哪些数据类型?)
- [14.包装类型和基本类型的区别是什么?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/JavaBasic.md#包装类型和基本类型的区别是什么?)- 容器
- [ArrayList和LinkedList](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/ArrayList.md)
  - [1.ArrayList与LinkedList的区别是什么?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/ArrayList.md#ArrayList与LinkedList的区别是什么?)
  - [2.怎么使ArrayList,LinkedList变成线程安全的呢?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/ArrayList.md#怎么使ArrayList,LinkedList变成线程安全的呢?)
  - [3.ArrayList遍历时删除元素有哪些方法?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/ArrayList.md#ArrayList遍历时删除元素有哪些方法?)
  - [4.ConcurrentModificationException是什么?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/ArrayList.md#ConcurrentModificationException是什么?)
  - [5.java容器类的层次是怎么样的?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/ArrayList.md#java容器类的层次是怎么样的?)
- [HashMap和ConcurrentHashMap](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/HashMap.md)
  - [1.HashMap添加一个键值对的过程是怎么样的?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/HashMap.md#HashMap添加一个键值对的过程是怎么样的?)
  - [2.ConcurrentHashMap添加一个键值对的过程是怎么样的?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/HashMap.md#ConcurrentHashMap添加一个键值对的过程是怎么样的?)
  - [3.HashMap与HashTable,ConcurrentHashMap的区别是什么?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/HashMap.md#HashMap与HashTable,ConcurrentHashMap的区别是什么?)
  - [4.HashMap扩容后是否需要rehash?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/HashMap.md#HashMap扩容后是否需要rehash?)
  - [5.HashMap扩容是怎样扩容的,为什么都是2的N次幂的大小?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/HashMap.md#HashMap扩容是怎样扩容的,为什么都是2的N次幂的大小?)
  - [6.ConcurrentHashMap是怎么记录元素个数size的?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/HashMap.md#ConcurrentHashMap是怎么记录元素个数size的?)
  - [7.为什么ConcurrentHashMap,HashTable不支持key,value为null?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/HashMap.md#为什么ConcurrentHashMap,HashTable不支持key,value为null?)
  - [8.HashSet和HashMap的区别?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/HashMap.md#HashSet和HashMap的区别?)
- [9.HashMap遍历时删除元素的有哪些实现方法?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/HashMap.md#HashMap遍历时删除元素的有哪些实现方法?)- [1.进程与线程的区别是什么?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/JavaMultiThread.md#进程与线程的区别是什么?)
- [2.进程间如何通信?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/JavaMultiThread.md#进程间如何通信?)
- [3.Java中单例有哪些写法?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/JavaMultiThread.md#Java中单例有哪些写法?)
- [4.Java中创建线程有哪些方式?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/JavaMultiThread.md#Java中创建线程有哪些方式?)
- [5.如何解决序列化时可以创建出单例对象的问题?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/JavaMultiThread.md#如何解决序列化时可以创建出单例对象的问题?)
- [6.volatile关键字有什么用?怎么理解可见性,一般什么场景去用可见性?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/JavaMultiThread.md#volatile关键字有什么用?怎么理解可见性,一般什么场景去用可见性?)
- [7.Java中线程的状态是怎么样的?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/JavaMultiThread.md#Java中线程的状态是怎么样的?)
- [8.wait(),join(),sleep()方法有什么作用?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/JavaMultiThread.md#wait(),join(),sleep()方法有什么作用?)
- [9.Thread.sleep(),Object.wait(),LockSupport.park()有什么区别?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/JavaMultiThread.md#Thread.sleep(),Object.wait(),LockSupport.park()有什么区别?)
- [10.谈一谈你对线程中断的理解?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/JavaMultiThread.md#谈一谈你对线程中断的理解?)
- [11.线程间怎么通信?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/JavaMultiThread.md#线程间怎么通信?)
- [12.怎么实现实现一个生产者消费者?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/JavaMultiThread.md#怎么实现实现一个生产者消费者?)
- [13.谈一谈你对线程池的理解?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/JavaMultiThread.md#谈一谈你对线程池的理解?)
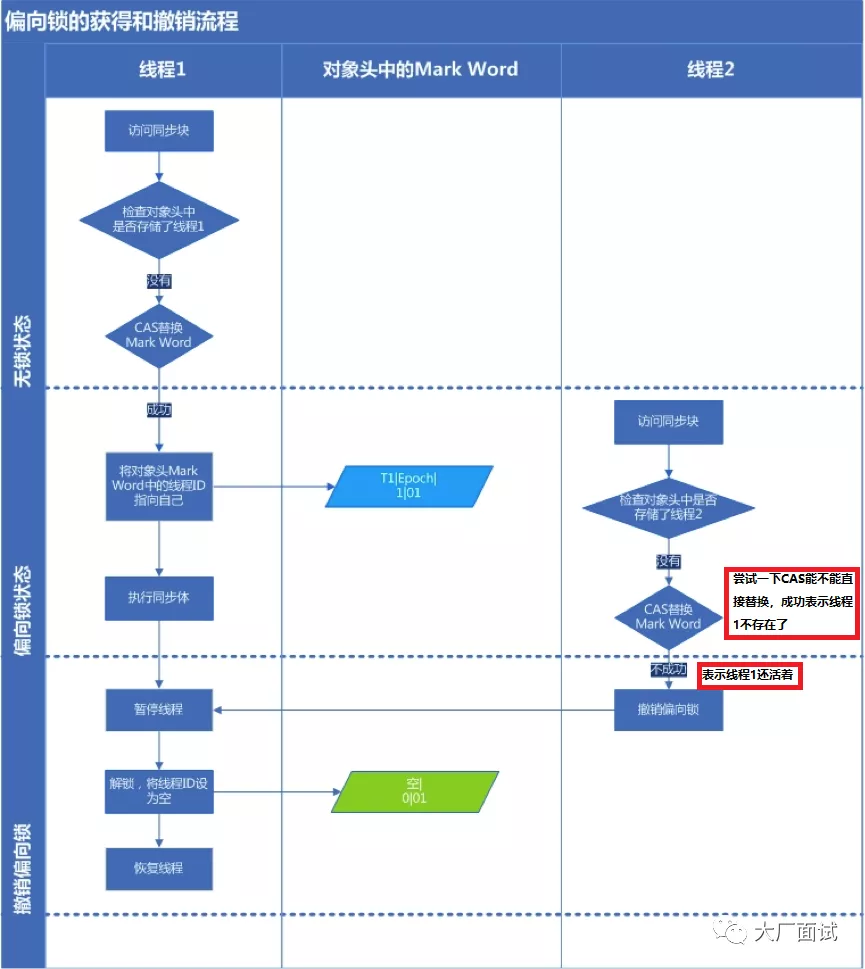
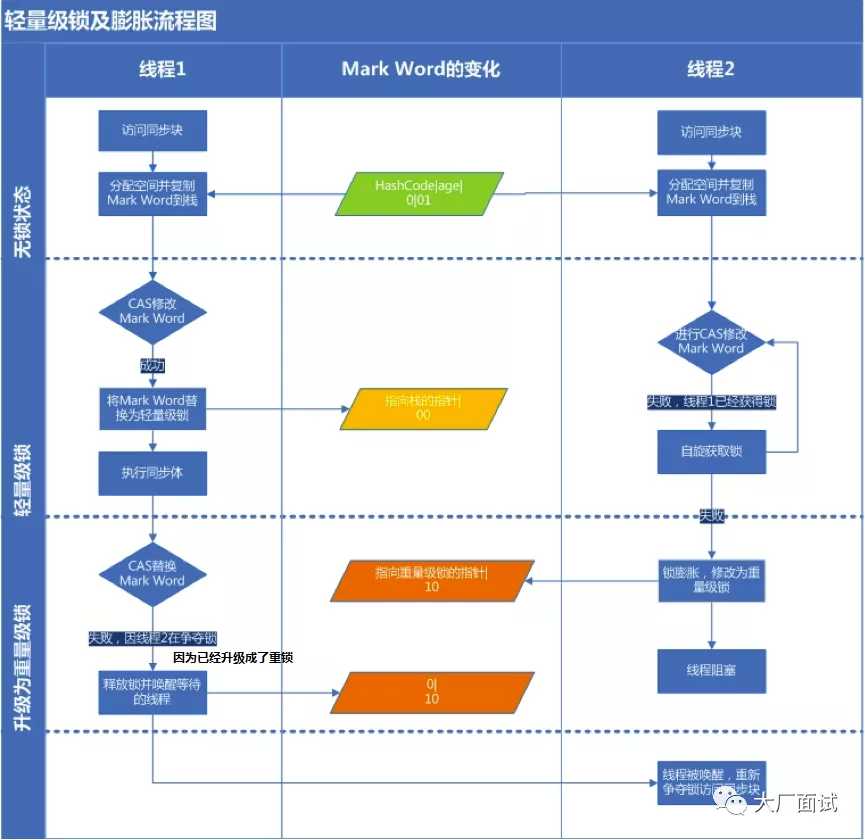
- [14.线程池有哪些状态?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/JavaMultiThread.md#线程池有哪些状态?)- [1.sychronize的实现原理是怎么样的?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/Lock.md#sychronize的实现原理是怎么样的?)
- [2.AbstractQueuedSynchronizer(缩写为AQS)是什么?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/Lock.md#AbstractQueuedSynchronizer(缩写为AQS)是什么?)
- [3.悲观锁和乐观锁是什么?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/Lock.md#悲观锁和乐观锁是什么?)- Redis
- [1.Redis是什么?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/RedisBasic.md#Redis是什么?)
- [2.Redis过期key是怎么样清理的?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/RedisBasic.md#Redis过期key是怎么样清理的?)
- [3.Redis为什么是单线程的?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/RedisBasic.md#Redis为什么是单线程的?)
- [4.Redis的性能为什么这么高?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/RedisBasic.md#Redis的性能为什么这么高?)
- [5.Linux中IO模型一共有哪些?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/RedisBasic.md#Linux中IO模型一共有哪些?)
- [6.同步与异步的区别是什么?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/RedisBasic.md#同步与异步的区别是什么?)
- [7.阻塞与非阻塞的区别是什么?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/RedisBasic.md#阻塞与非阻塞的区别是什么?)
- [8.如何解决Redis缓存穿透问题?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/RedisBasic.md#如何解决Redis缓存穿透问题?)
- [9.如何解决Redis缓存击穿问题?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/RedisBasic.md#如何解决Redis缓存击穿问题?)
- [10.如何解决Redis缓存雪崩问题?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/RedisBasic.md#如何解决Redis缓存雪崩问题?)
- [11.如何解决缓存与数据库的数据一致性问题?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/RedisBasic.md#如何解决缓存与数据库的数据一致性问题?)- [1.Redis常见的数据结构有哪些?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/RedisDataStruct.md#Redis常见的数据结构有哪些?)
- [2.谈一谈你对Redis中简单动态字符串的理解?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/RedisDataStruct.md#谈一谈你对Redis中简单动态字符串的理解?)
- [3.谈一谈你对Redis中hash对象的理解?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/RedisDataStruct.md#谈一谈你对Redis中hash对象的理解?)
- [4.谈一谈你对Redis中List的理解?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/RedisDataStruct.md#谈一谈你对Redis中List的理解?)
- [5.谈一谈你对Redis中Set的理解?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/RedisDataStruct.md#谈一谈你对Redis中Set的理解?)
- [6.谈一谈你对Redis中有序集合ZSet的理解?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/RedisDataStruct.md#谈一谈你对Redis中有序集合ZSet的理解?)
- [7.布隆过滤器是什么?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/RedisDataStruct.md#布隆过滤器是什么?)- [1.Redis的持久化是怎么实现的?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/RedisStore.md#Redis的持久化是怎么实现的?)
- [2.AOF和RDB的区别是什么?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/RedisStore.md#AOF和RDB的区别是什么?)
- [3.怎么防止AOF文件越来越大?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/RedisStore.md#怎么防止AOF文件越来越大?)
- [4.Redis持久化策略该如何进行选择?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/RedisStore.md#Redis持久化策略该如何进行选择?)- [1.Redis主从同步是怎么实现的?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/RedisUserful.md#Redis主从同步是怎么实现的?)
- [2.Redis中哨兵是什么?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/RedisUserful.md#Redis中哨兵是什么?)
- [3.客户端是怎么接入哨兵系统的?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/RedisUserful.md#客户端是怎么接入哨兵系统的?)
- [4.Redis哨兵系统是怎么实现自动故障转移的?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/RedisUserful.md#Redis哨兵系统是怎么实现自动故障转移的?)
- [5.谈一谈你对Redis Cluster的理解?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/RedisUserful.md#谈一谈你对RedisCluster的理解?)
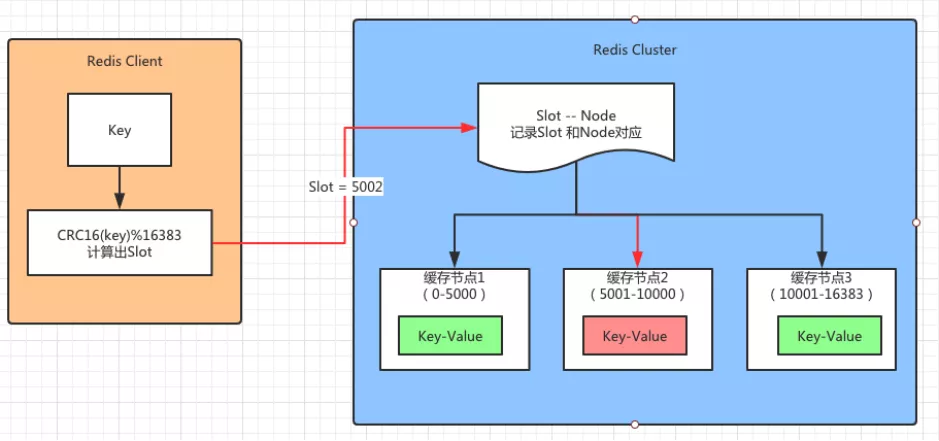
- [6.RedisCluster是怎么实现数据分片的?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/RedisUserful.md#RedisCluster是怎么实现数据分片的?)
- [7.RedisCluster是怎么做故障转移和发现的?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/RedisUserful.md#RedisCluster是怎么做故障转移和发现的?)- MySQL
- [1.一条MySQL更新语句的执行过程是什么样的?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/MySQLNote.md#一条MySQL更新语句的执行过程是什么样的?)
- [2.脏页是什么?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/MySQLNote.md#脏页是什么?)
- [3.Checkpoint是什么?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/MySQLNote.md#Checkpoint是什么?)
- [4.undo log,redo log,bin log是什么?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/MySQLNote.md#undolog,redolog,binlog是什么?)
- [5.MySQL中的事务是什么?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/MySQLNote.md#MySQL中的事务是什么?)
- [6.MySQL的隔离级别是怎么样的?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/MySQLNote.md#MySQL的隔离级别是怎么样的?)
- [7.MVCC的实现原理是怎么样的?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/MySQLNote.md#MVCC的实现原理是怎么样的?)
- [8.MySQL是怎么解决幻读的问题的?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/MySQLNote.md#MySQL是怎么解决幻读的问题的?)
- [9.MySQL中有哪些锁?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/MySQLNote.md#MySQL中有哪些锁?)
- [10.B树是什么?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/MySQLNote.md#B树是什么?)
- [11.B树与B+树的区别是什么?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/MySQLNote.md#B树与B+树的区别是什么?)
- [12.索引是什么?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/MySQLNote.md#索引是什么?)
- [13.字符串索引和数字类型索引的区别?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/MySQLNote.md#字符串索引和数字类型索引的区别?)
- [14.union和union all的区别是什么?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/MySQLNote.md#union和union)
- [15.Join的工作流程是怎么样的,怎么进行优化?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/MySQLNote.md#Join的工作流程是怎么样的,怎么进行优化)
- [16.聚集索引是什么?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/MySQLNote.md#聚集索引是什么?)
- [17.联合索引是什么?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/MySQLNote.md#联合索引是什么?)
- [18.覆盖索引是什么?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/MySQLNote.md#覆盖索引是什么?)
- [19.哪些情况不要建索引?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/MySQLNote.md#哪些情况不要建索引?)
- [20.主键,唯一性索引,普通索引的区别是什么?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/MySQLNote.md#主键,唯一性索引,普通索引的区别是什么?)
- [21.InnoDB和MyISAM的区别是什么?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/MySQLNote.md#InnoDB和MyISAM的区别是什么?)
- [22.什么是分库分表?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/MySQLNote.md#什么是分库分表?)
- [23.怎么实现跨库分页查询?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/MySQLNote.md#怎么实现跨库分页查询?)
- [24.MySQL主从复制的工作流程是什么样的?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/MySQLNote.md#MySQL主从复制的工作流程是什么样的?)
- [25.char类型与varchar类型的区别?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/MySQLNote.md#char类型与varchar类型的区别?)
- [26.查询数量SELECT Count(*)怎么优化?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/MySQLNote.md#怎么优化数量查询?)
- [27.如何优化MySQL慢查询?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/MySQLNote.md#如何优化MySQL慢查询?)
- [28.MySQL的join的实现是怎么样的?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/MySQLNote.md#MySQL的join的实现是怎么样的?)- [1.Java内存区域怎么划分的?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/JavaJVM.md#Java内存区域怎么划分的?)
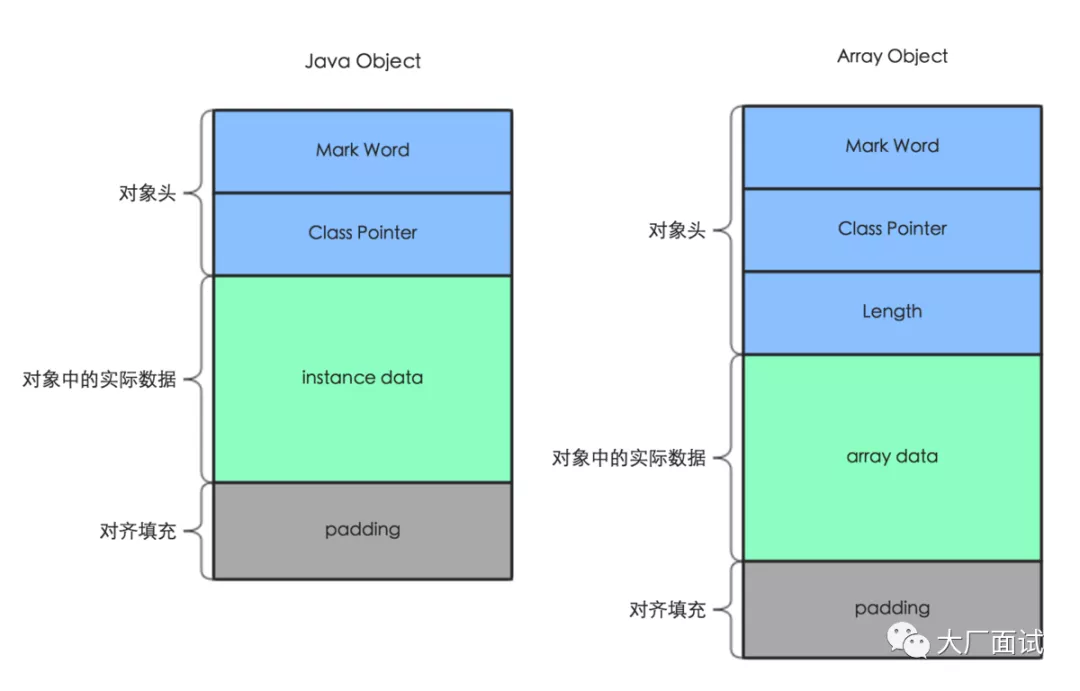
- [2.Java中对象的创建过程是怎么样的?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/JavaJVM.md#Java中对象的创建过程是怎么样的?)
- [3.Java对象的内存布局是怎么样的?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/JavaJVM.md#Java对象的内存布局是怎么样的?)
- [4.垃圾回收有哪些特点?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/JavaJVM.md#垃圾回收有哪些特点?)
- [5.在垃圾回收机制中,对象在内存中的状态有哪几种?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/JavaJVM.md#在垃圾回收机制中,对象在内存中的状态有哪几种?)
- [6.对象的强引用,软引用,弱引用和虚引用的区别是什么?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/JavaJVM.md#对象的强引用,软引用,弱引用和虚引用的区别是什么?)
- [7.双亲委派机制是什么?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/JavaJVM.md#双亲委派机制是什么?)
- [8.怎么自定义一个类加载器?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/JavaJVM.md#怎么自定义一个类加载器?)
- [9.垃圾回收算法有哪些?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/JavaJVM.md#垃圾回收算法有哪些?)
- [10.Minor GC和Full GC是什么?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/JavaJVM.md#MinorGC和FullGC是什么?)
- [11.如何确定一个对象可以回收?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/JavaJVM.md#如何确定一个对象是否可以被回收?)
- [12.目前通常使用的是什么垃圾收集器?](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/JavaJVM.md#目前通常使用的是什么垃圾收集器?)- [《剑指Offer》解题思考](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/CodingInterviews.md)
- [《LeetCode热门100题》解题思考(上)](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/LeetCode.md)
- [《LeetCode热门100题》解题思考(下)](https://raw.githubusercontent.com/NotFound9/interviewGuide/HEAD/docs/LeetCode1.md)- 大厂面试公众号文章系列
- 读书笔记
- 好书推荐
如何为这个开源项目做贡献?
如果你想一起参与这个项目,可以提Pull Request,可以扫上面的入群二维码进群,如果入群二维码失效了,也可以扫我的微信,我们一起聊聊!
关于我
我平时比较喜欢看书,写技术文章,也比较喜欢讨论技术。这是我的掘金主页,希望大家可以关注一下,谢谢了!大家如果有事需要联系我,或者想进技术群,一起讨论技术,也可以扫描主页中我的微信二维码加我,谢谢了!
关于转载
如果你需要转载本仓库的一些文章到自己的博客的话,记得注明原文地址就可以了。
JavaBasic
(PS:扫描首页里面的二维码进群,分享我自己在看的技术资料给大家,希望和大家一起学习进步!)
下面是主要是自己看了《疯狂Java讲义》后,学习到一些之前没掌握的技术点,写的解答,之后会继续更新和完善。
1.Java中的多态是什么?
2.Java中变量,代码块,构造器之间执行顺序是怎么样的?
3.final关键字有哪些作用?
4.Integer类会进行缓存吗?
5.抽象类有哪些特点?
6.String,StringBuffer和StringBuilder之间的区别是什么?
7.编译型编程语言,解释型编程语言,伪编译型语言的区别是什么?
8.Java中的访问控制符有哪些?
9.Java的构造器有哪些特点?
10.Java中的内部类是怎么样的?
11.Java中的注解是什么?
12.为什么hashCode()和equal()方法要一起重写?和equal()方法要一起重写?)
13.Java中有哪些数据类型?
14.包装类型和基本类型的区别是什么?
Java中的多态是什么?
多态指的是相同类型的变量在调用同一个方法时呈现出多种不同的行为特征。而造成这一现象的原因在于Java中的变量有两个类型:
- 编译时类型,由声明变量时的类型决定。
- 运行时类型,由实际赋值给变量的对象的类型决定,
当一个变量的两个类型不一致,就会出现多态。
//BaseClass是SubClass的父类
BaseClass a = new BaseClass();
BaseClass b = new SubClass();
a.baseMethod()//变量a调用baseMethod()方法,实际上会调用BaseClass的baseMethod()方法,会打印111
b.baseMethod()//变量b调用baseMethod方法,实际上会调用SubClass的重写baseMethod()方法,会打印222
Class BaseClass {
  void baseMethod() {
    System.out.println("111");
  }
}
Class SubClass {
  void baseMethod() {
    System.out.println("222");
  }
}
输出结果:
111
222
例如这个例子中,
对于变量a而言
a的编译类型是BaseClass,实际类型也是BaseClass,所以调用baseMethod()会执行BaseClass#baseMethod()方法,打印出111。
对于变量b而言
b的的编译类型是BaseClass,但是实际赋值时,给变量b赋值的是SubClass对象,所以b的实际类型是SubClass。而SubClass重写了父类BaseClass#baseMethod()方法,所以调用baseMethod()方法会调用SubClass#baseMethod(),从而打印出222。
a和b的编译类型相同,却展现出了不同的行为特征,这就是多态。
(PS:如果直接对b调用只有SubClass有的方法,编译时会报错,但是可以通过反射进行调用。)
Java中变量,代码块,构造器之间执行顺序是怎么样的?
Java程序中类中个元素的初始化顺序 初始化的原则是:
- 先初始化静态部分,再初始化动态部分,
- 先初始化父类部分,后初始化子类部分,
- 先初始化变量,再初始化代码块和构造器。
所以依照这个规则可以得出总体顺序是:
1.父类的静态成员变量(如果是第一次加载类)
2.父类的静态代码块(如果是第一次加载类)
3.子类的静态成员变量(如果是第一次加载类)
4.子类的静态代码块(如果是第一次加载类)
5.父类的普通成员变量
6.父类的动态代码块
7.父类的构造器方法
8.子类的普通成员变量
9.子类的动态代码块
10.子类的构造器方法
下面写了一个Demo进行验证:
public class Base {
    static Instance staticInstance = new Instance("1---Base类的静态成员变量staticInstance");
    static  {
        System.out.println("2---Base类的静态代码块执行了");
    }
    Instance instance = new Instance("5---Base类的普通成员变量instance");
    {
        System.out.println("6---Base类的动态代码块执行了");
    }
    Base() {
        System.out.println("7---Base类的构造器方法执行了");
    }
}

public class Child extends Base {
    static Instance staticInstance = new Instance("3---Child类的静态成员变量staticInstance");
    static  {
        System.out.println("4---Child类的静态代码块执行了");
    }
    Instance instance = new Instance("8---Child类的普通成员变量instance");
    {
        System.out.println("9----Child类的动态代码块执行了");
    }
    Child() {
        System.out.println("10---Child类的构造器方法执行了");
    }
    public static void main(String[] args) {
        Child child = new Child();
    }
}
输出结果如下:
1---Base类的静态成员变量staticInstance进行了初始化
2---Base类的静态代码块执行了
3---Child类的静态成员变量staticInstance进行了初始化
4---Child类的静态代码块执行了
5---Base类的普通成员变量instance进行了初始化
6---Base类的动态代码块执行了
7---Base类的构造器方法执行了
8---Child类的普通成员变量instance进行了初始化
9----Child类的动态代码块执行了
10---Child类的构造器方法执行了
说明确实是按照上面的执行顺序执行的。
final关键字有哪些作用?
修饰类
final修饰类时,类不能被继承,并且类中的所有方法都被隐式地使用final修饰。
修饰方法
final修饰方法时,有两个作用:
- 方法不能被子类重写。
- 可以让方法转换为内联调用,提升效率。(早期的Java版本是这样,最近的版本已经没有这些优化了,因为如果方法过大时,内嵌调用无法带来性能提升。)
- 修饰变量
final修饰的变量一旦初始化,就不能被修改。当final修饰实例变量时,可以在在定义变量时赋初值,也可以在定义时不赋值,在动态代码块,或构造器中赋初值。(只能赋值一次)。
如果final变量在声明时就指定了初始值,并且在编译时可以确定下来,那么在编译时,final变量本质上会变成一个宏变量,所有用到该变量的地方都直接替换成该变量的值。
Integer类会进行缓存吗?
Intger a =  new Integer(127);
Intger b = Interger.valueOf(127);
Intger c = Interger.valueOf(127);
Intger d = Interger.valueOf(128);
Intger e = Interger.valueOf(128);
System.out.println(a == b); //输出false
System.out.println(b == c); //输出true
System.out.println(d == e); //输出false
上面这种例子的原因是如果
- 通过new Interger()创建Interger对象,每次返回全新的Integer对象
- 通过Interger.valueOf()创建Interger对象,如果值在-128到127之间,会返回缓存的对象(初始化时)。
##### 实现原理
Integer类中有一个静态内部类IntegerCach,在加载Integer类时会同时加载IntegerCache类,IntegerCache类的静态代码块中会创建值为-128到127的Integer对象,缓存到cache数组中,之后调用Integer#valueOf方法时,判断使用有缓存的Integer对象,有则返回,无则调用new Integer()创建。
PS:(127是默认的边界值,也可以通过设置JVM参数java.lang.Integer.IntegerCache.high来进行自定义。)
public static Integer valueOf(int i) {
    if (i >= IntegerCache.low && i <= IntegerCache.high)
    		//cache是一个Integer数组,缓存了-128到127的Integer对象
        return IntegerCache.cache[i + (-IntegerCache.low)];
		return new Integer(i);
}

//IntegerCache是Integer类中的静态内部类,Integer类在加载时会同时加载IntegerCache类,IntegerCache类的静态代码块中会
private static class IntegerCache {
        static final int low = -128;
        static final int high;
        static final Integer cache[];

        static {
            // 127是默认的边界值,也可以通过设置JVM参数java.lang.Integer.IntegerCache.high来进行自定义。
            int h = 127;
            String integerCacheHighPropValue =            sun.misc.VM.getSavedProperty("java.lang.Integer.IntegerCache.high");
            if (integerCacheHighPropValue != null) {
                try {
                    int i = parseInt(integerCacheHighPropValue);
                    i = Math.max(i, 127);
                    // cache数组的长度不能超过Integer.MAX_VALUE
                    h = Math.min(i, Integer.MAX_VALUE - (-low) -1);
                } catch( NumberFormatException nfe) {
                    // If the property cannot be parsed into an int, ignore it.
                }
            }
            high = h;

            cache = new Integer[(high - low) + 1];
            int j = low;
            for(int k = 0; k < cache.length; k++)
                cache[k] = new Integer(j++);

            // high值必须大于等于127,不然会抛出异常
            assert IntegerCache.high >= 127;
        }

        private IntegerCache() {}
    }
抽象类有哪些特点?
从多个具体的类中抽象出来的父类叫做抽象类,抽象类就像是一个模板。抽象类使用abstract关键字修饰,抽象类可以拥有抽象方法(使用abstract修饰的方法,由子类来提供方法的实现)。抽象类的特点如下:
1.可以包含抽象方法
抽象方法与普通方法的区别在于,抽象类不提供抽象方法的实现,由继承抽象类的子类实现抽象方法。
2.不能实例化
也正因为包含抽象方法,抽象类不能被实例化。抽象类的构造器不能用于创建实例,是仅提供给子类调用的。除此以外,抽象类跟普通类一样,可以拥有成员变量,普通方法,构造器,初始化块,内部类,枚举等。
3.抽象类可以被继承
继承抽象类的子类如果实现了所有抽象方法,那么可以作为普通类使用,否则也只能作为抽象类。
String,StringBuffer和StringBuilder之间的区别是什么?
1.可变性
String是一个不可变类,任何对String改变都是会产生一个新的String对象,所以String类是使用final来进行修饰的。而StringBuffer和StringBuilder是可变类,对应的字符串的改变不会产生新的对象。
2.执行效率
当频繁对字符串进行修改时,使用String会生成一些临时对象,多一些附加操作,执行效率降低。
stringA = StringA + "2";
//实际上等价于
{
  StringBuffer buffer = new StringBuffer(stringA)
  buffer.append("2");
  return buffer.toString();
}
在对stringA进行修改时,实际上是先根据字符串创建一个StringBuffer对象,然后调用append()方法对字符串修改,再调用toString()返回一个字符串。
3.线程安全
StringBuffer的读写方法都使用了synchronized修饰,同一时间只有一个线程进行操作,所以是线程安全的,而StringBuilder不是线程安全的。
Object类有哪些自带方法?
registerNatives()
首先Object类有一个本地方法registerNatives(),会在类加载时调用,主要是将Object类中的一些本地方法绑定到指定的函数中去,便于之后调用。例如将hashCode和clone本地方法绑定到JVM_IHashCode和JVM_IHashCode函数。
    private static native void registerNatives();
    static {
        registerNatives();
    }
想深入了解的朋友可以看看这两篇文章:
Java之Thread源码registerNatives()深入理解
Object类中的registerNatives方法的作用深入介绍
getClass()
getClass()方法会返回对象的运行时类。
public final native Class<?> getClass();具体可以看下面这个例子:
有一个类Son,继承于Father类,instance的编译类型是Father,实际赋值的是一个Son对象,所以调用instance.getClass()获取的是instance对象的运行时类型,打印的类名是"com.test.Son"。
  package com.test;
  class Father {}

  class Son extends Father {}

  Father instance = new Son();
  Class class1 = instance.getClass();
  System.out.println("class1 is"class1);
输出结果:
class1 is class com.test.SonClasss.forName()
与getClass()类似的方法还有两个,一个是Class类中的forName()方法,也是在运行时,根据传入的类名去加载类,然后返回与类关联的Class对象。也正是因为是动态加载,在编译时可以没有这个类,也不会对类名进行检验,所以有可能抛出ClassNotFoundException异常。
public static Class<?> forName(String className)
                throws ClassNotFoundException {
        Class<?> caller = Reflection.getCallerClass();
        return forName0(className, true, ClassLoader.getClassLoader(caller), caller);
}
可以自己尝试运行一下这段代码
  Class class2 = null;
  try {
  	class2 = Class.forName("com.test.Son");//如果实际不存在com.test.Son这个类,那么会抛出ClassNotFoundException异常
  	System.out.println(class2);
  } catch (ClassNotFoundException e) {
  	e.printStackTrace();
  }
class2 is class com.test.Son类名+.class
还有一种方式是使用类名+.class来获取类关联的Class对象,与上面两种方法不同之处在于,它返回的是编译时类型,也就是在编译时,类加载器将类加载到JVM中,然后初始化一个Class对象返回。
  Class class3 = Son.class;
  System.out.println(class3);
输出结果:
class3 is class com.test.SonPS:无论是使用哪种方式来获取类关联的Class对象,类都是只会加载一次,如果获取Class对象时,不会重复加载类。
为什么hashCode()和equals()方法要一起重写?
hashCode()和equals()方法
可以看到Obejct类中的源码如下,可以看到equals()方法的默认实现是判断两个对象的内存地址是否相同来决定返回结果。
    public native int hashCode();

    public boolean equals(Object obj) {
        return (this == obj);
    }
网上很多博客说hashCode的默认实现是返回内存地址,其实不对,以OpenJDK为例,hashCode的默认计算方法有5种,有返回随机数的,有返回内存地址,具体采用哪一种计算方法取决于运行时库和JVM的具体实现。(可以理解Object类hashCode默认实现是对所有对象返回的值都不一样。)
感兴趣的朋友可以看看这篇博客
Java的Object.hashCode()的返回值到底是不是对象内存地址?
hashCode()方法的作用有哪些?
- 对对象做散列
为了将一组键值对均匀得存储在一个数组中,HashMap对key的hashCode进行计算得到一个hash值,用hash对数组长度取模,得到数组下标,将键值对存储在数组下标对应的链表下。
- 快速判断对象是否不相等
因为两个对象hashCode相等,调用equals()方法的结果不一定为true,
因为两个对象调用equals()方法相等,hashCode一定相等。
所以hashCode不相等可以作为两个对象不相等的快速判断条件。
在往HashMap中添加一个键值对时,计算得到数组下标后,会遍历数组下标下存储的链表中,拿key的hashCode与每个节点的hashCode进行比较,相等时,才调用equals()方法进行继续调用,节约时间。(在一些类的equal()方法的自定义实现中也会对hashCode进行判断)。
假如只重写hashCode()方法(结果:HashMap可以存在两个内存地址不相同,但是相等的对象,无法保证去重)
此时equals()方法的实现是默认实现,也就是当两个对象的内存地址相等时,equals()方法才返回true,假设两个键值对,它们的key类型都是TestObject,的值都是test,但是由于是使用new String()创建而成的字符串对象,key1和key2的内存地址不相等,所以key1==key2的结果会是false,TestObject的equals()方法默认实现是判断两个对象的内存地址,所以 key1.equals(key2)也会是false, 所以两个键值对可以重复地添加到hashMap中去。
public class TestObject {
    Integer a;
    public TestObject(Integer a) {
        this.a = a;
    }
    @Override
    public int hashCode() {
        return a;
    }

    public static void main(String[] args) {
        TestObject key1 = new TestObject(1);
        TestObject key2 = new TestObject(1);
        System.out.println("key1的hashCode为"+ key1 +"key2的hashCode为" + key2);
        System.out.println("key1.equals(key2)的结果为"+(key1.equals(key2)));

        HashMap<TestObject,String> map = new HashMap<TestObject,String>();
        map.put(key1,"value1");
        map.put(key2,"value2");
        System.out.println("HashMap是"+map.toString());
		}
}
输出结果:
key1的hashCode为com.test.TestObject@1
key2的hashCode为com.test.TestObject@1

key1.equals(key2)的结果为false

HashMap是
{com.test.TestObject@1=value1,
com.test.TestObject@1=value2}
假如只重写equals()方法(结果:相同的对象hashCode不同,从而映射到不同下标下,HashMap无法保证去重)
假设只equals()方法,hashCode方法会是默认实现,具体的计算方法取决于JVM,可能会导致两个相等的对象,它们的hashCode却不相同,从而计算得到的数组下标不相同,存储到hashMap中不同数组下标下的链表中,也会导致HashMap中存在重复元素。
public class TestObject {
    Integer a;
    public TestObject(Integer a) {
        this.a = a;
    }
    @Override
    public boolean equals(Object o) {
        if (this == o) return true;
        if (o == null || getClass() != o.getClass()) return false;
        TestObject that = (TestObject) o;
        return Objects.equals(a, that.a);
    }

    public static void main(String[] args) {
        TestObject key1 = new TestObject(1);
        TestObject key2 = new TestObject(1);
        System.out.println("key1的hashCode为"+ key1 +"key2的hashCode为" + key2);
        System.out.println("key1.equals(key2)的结果为"+(key1.equals(key2)));

        HashMap<TestObject,String> map = new HashMap<TestObject,String>();
        map.put(key1,"value1");
        map.put(key2,"value2");
        System.out.println("HashMap是"+map.toString());
		}
}
输出结果如下:
key1的hashCode为1288141870
key2的hashCode为2054881392

key1.equals(key2)的结果为true

HashMap是
{com.test.TestObject@4cc77c2e=value1, com.test.TestObject@7a7b0070=value2}
clone()方法
clone()方法会创建并返回当前对象的副本。副本与原对象的区别在于它们相等,但是存储在不同的内存位置中。
protected native Object clone() throws CloneNotSupportedException;要调用clone()方法必须实现Cloneable接口,否则调用默认的Object类的clone方法会抛出CloneNotSupportedException异常。默认clone()方法返回的对象是浅拷贝的。
toString()方法
返回类名+@+hashCode的16进制字符串
public String toString() {
    return getClass().getName() + "@" + Integer.toHexString(hashCode());
}
wait()方法和notify()方法
//timeout是超时时间,也就是等待的最大毫秒数,如果为0,代表会一直等待下去
public final native void wait(long timeout) throws InterruptedException;
public final native void notify();
public final native void notifyAll();
wait()
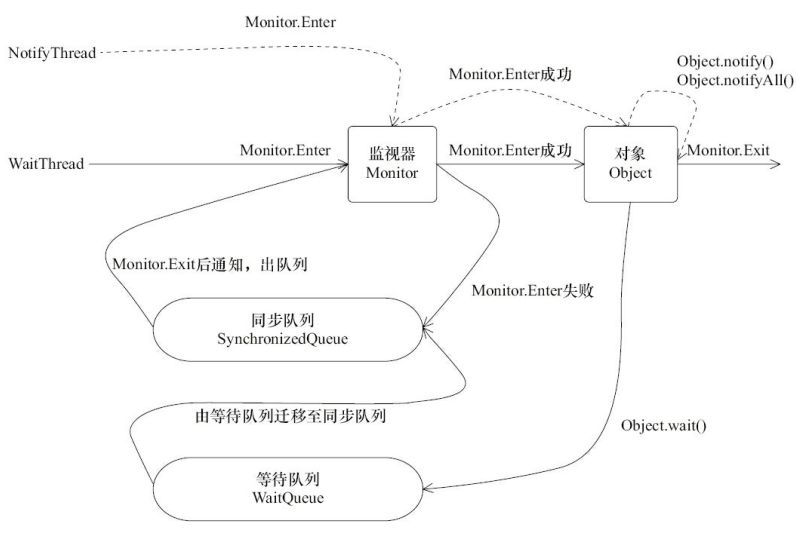
wait()方法可以让当前线程放弃对象的监视器(可以简单认为监视器就是一个锁),进入等待队列,进行等待,直到其他线程调用notify()或者notifyAll()后(或者过了超时时间),线程才会从等待队列,移动到同步队列,再次获得对象的监视器后才能继续执行。
notify()
notify()可以唤醒等待队列中的某一个线程,线程被唤醒后会从等待队列移动到同步队列,线程再次获得对象的监视器后才能继续执行。(然后调用notify()方法的线程会继续执行,在同步块中执行完毕后,会释放对象的监视器。)
notifyAll()
notifyAll()方法与notify()方法类似,只是会将等待队列中的所有线程唤醒。
可以看看这张图。
finalize
//默认为空的实现,子类可以重写这个方法
protected void finalize() throws Throwable { }
当垃圾回收器确认某个对象不被任何其他对象引用时(即对象处于可恢复状态),系统在回收对象时,会调用finalize()方法,可以在这个方法中清理资源,在这个方法中,也有可能让对象重新获得引用,从而变成可达状态。
编译型编程语言,解释型编程语言,伪编译型语言的区别是什么?
- 编译型编程语言
指的是用专门的编译器,对于针对特定平台将某种高级语言编写的源代码一次性编译成可在该平台硬件执行的机器码,并打包成该平台所能识别的可执行性程序的格式。优点是执行效率比较高,缺点是无法跨平台运行。需要移植到其他平台上运行,需要采用特定平台的编译器重新编译。C,C++,Objective-C,Swift,Kotlin都属于此类。
- 解释型编程语言
使用特定的解释器对源代码进行逐行解释并立即执行的的语言。缺点是因为每次执行都需进行编译,运行效率低,而且不能脱离解释器独立运行,优点是可以跨平台运行,只要在特定平台上提供特定的解释器就行了。JavaScript,Ruby,Python都属于此类。
- 伪编译型语言
编译时只编译成中间代码,将中间代码和解释器一起打包成可执行文件。然后执行时使用解释器将中间代码解析成二进制代码。Visual Basic属于此类。
Java Java是通过javac编译器将源代码编译成跟平台无关的字节码(也就是.class文件),然后由不同平台上的 JVM(Java虚拟机)对字节码解释执行,在一些Java虚拟机的实现中,还会将字节码转换为特定系统的机器码,提高执行效率。Java语言不属于上面的任何一类,因为目前的高级语言较为复杂,已经不能简单地以编译型编程语言,解释型编程语言,伪编译型语言进行划分了。
Java中的访问控制符有哪些?
在Java中使用访问控制符修饰成员变量,方法,构造方法时
| 访问范围 | private | default | protected | public |
|---|---|---|---|---|
| 本类中 | 允许 | 允许 | 允许 | 允许 |
| 同一包中 | 允许 | 允许 | 允许 | |
| 其他包中的子类 | 允许 | 允许 | ||
| 其他包中 | 允许 |
private 允许在类中访问。
default 允许在类中,同一包中访问。
protected 允许在类中,同一包中,其他包中的子类 访问。
public 只允许在所有地方访问。
注意事项:
如果某个类Father一个方法A是没有使用访问修饰符,那么子类Son如果是在其他包中,不能调用这个方法A。但是如果方法A是使用protected修饰的,那么在子类中可以调用。(但是不能使用父类去调用,就是不能在子类中去创建父类对象,然后用父类对象去调用。)
具体可以看看下面这个例子:
package com.one;
//假设有一个Father类在包com.one下
public class Father {
    void defalutTest() {}
    protected void protectedMothod() {}
}

package com.two;
import com.one.Father;
public class Son extends Father {
    public static void main(String[] args) {
        Father father = new Father();
        father.protectedMothod()//位置1.这句代码会报错,因为即便是protected修饰的方法,在其他包中的子类中,也不能用父类去调用,只能按位置2或者位置4那样去调用

        Son son = new Son();
        son.protectedMothod();//位置2
    }
    void someMethod() {
        this.defaultMethod();//位置3.这句代码会报错,因为默认的方法不允许在其他包中的子类调用的
        this.protectedMothod();//位置4.可以调用成功
    }
}
Java的构造器有哪些特点?
public class Test {
    String str;
    public Test(String str) {
        this.str = str;
  }
}
1.如果没有自定义构造器,系统会提供一个默认的无参数构造器。如果提供了自定义的构造器,系统就不会提供默认的无参数构造器。(也就是不能直接调用new Test()来创建一个对象了,除非自己自定义一个无参数构造器)。
2.在上面的代码中,其实在构造器Test(String str)调用之前,系统已经分配好空间,创建一个对象,然后执行构造器Test(String str)方法对对象进行初始化,然后返回。
3.构造器一般使用public修饰符修饰,也可以使用protected,private来限制访问。
4.构造器重载,指的是一个类可以有多个构造器,多个构造器的参数列表不同。
Java中的内部类是怎么样的?
内部类分为静态内部类和非静态内部类。静态内部类是与外部类相关的,而非静态内部类是与外部类的实例对象相关的。
静态内部类
静态内部类一般使用public static修饰,也可以使用private static使用,那样只能在外部类内部使用。在外部类以外的地方使用静态类时,需要带上外部类的包名,例如创建一个静态内部类对象:
OutClass.InnerClass object = new OutClass.InnerClass();非静态内部类
非静态内部类是跟外部类的实例对象绑定在一起的。外部类一般是由两种访问修饰符default(只能包内访问),public(所有位置可以访问)。而非静态内部类有private,default,protected,public四种访问修饰符。因为必须跟外部类的实例对象绑定在一起,所以非静态内部类不能有静态方法,静态成员变量,静态初始化块,在外面创建一个非静态内部类对象:
OutClass out = new OutClass();
OutClass.InnerClass object = out.new InnerClass();
Java中的注解是什么?
Java中的注解其实是继承于annotation接口的一个接口,根据@Retention修饰的作用范围,注解可以是作用于源码层面,字节码文件层面,运行时层面。
// 如果@Retention的值是RetentionPolicy.Source 那么在编译时注解就失效了,不会编译进class文件
// 如果@Retention的值是RetentionPolicy.CLASS 那么会编译进class文件,但是JVM加载class文件时就会丢弃这个注解,在运行时注解就失效了
// 如果@Retention的值是RetentionPolicy.RUNTIME 在运行时注解同样有效
根据@Retention的值,注解主要分为编译时扫描和运行时扫描,例如@Override注解是作用于源码层面的,只是在编译时,编译器会去检验method是否是真正重写了父类的某个方法。
@Override
public void method() {

}


@Target(ElementType.METHOD)
@Retention(RetentionPolicy.SOURCE)
public @interface Override {

}
除了几个JDK自带的注解以外,通常情况下,我们使用的注解都是运行时注解,在运行时,JVM在运行时会针对注解生成一个动态代理类,通过反射获取注解时,实际上返回的是Java运行时生成的动态代理对象$Proxy1,而Proxy类就是我们注解(接口)的具体实现类。
Java 异常体系是怎么样的?
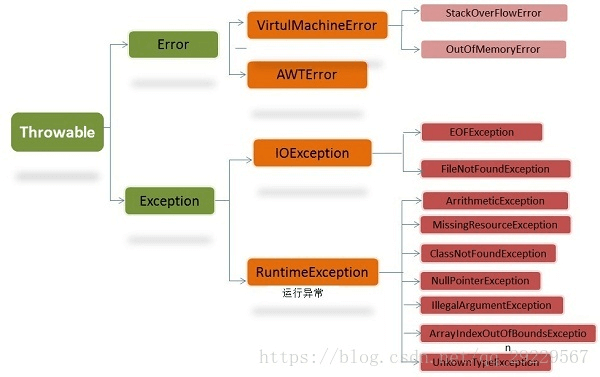
Throwable的子类为Error和Exception
Exception的子类为RuntimeException异常和RuntimeException以外的异常(例如IOException)。
主要分为Error,RuntimeException类及其子类的非受检异常和非受检异常以外的受检异常。
Error就是一些程序处理不了的错误,代表JVM出现了一些错误,应用程序无法处理。例如当 JVM 不再有继续执行操作所需的内存资源时,将出现 OutOfMemoryError。
RuntimeException异常就是应用程序运行时,可能会抛出的异常。这些异常是非受检异常,编译时Java编译器不会去检查,不会强制程序员添加处理异常的代码。程序中可以选择捕获处理,也可以不处理。如NullPointerException(空指针异常)、IndexOutOfBoundsException(下标越界异常)等。
非受检异常以外的异常可以认为是受检异常,从程序语法角度讲是必须进行处理的异常,编译时编译器就会要求有相关的异常捕获处理的代码逻辑。如IOException、SQLException,FileNotFoundException。
PS:
@Transaction默认检测异常为RuntimeException及其子类,如果有其他异常需要回滚事务的需要自己手动配置,例如:@Transactional(rollbackFor = Exception.class)
Java中有哪些基本数据类型?
| 类型 | 字节数 | 取值范围 |
|---|---|---|
| byte | 1字节 | -128~127,也就是-2的7次方到2的7次方减1 |
| short | 2字节 | -32768~32767,就是-2的15次方到2的15次方减1 |
| int | 4字节 | -2147483648~2147483647,-2的31次方到2的31次方减1,换算成十进制应该是有10位,也就是十亿的数量级。 |
| long | 8字节 | -2的63次方到2的64次方,换算成十进制的数,是有19位。 |
| boolean | 理论上1字节就可以满足需求,为了内存对齐一般是4字节 | |
| float | 4字节 | |
| double | 8字节 | |
| char | 2字节 | C语言的char类型其实是1字节,使用anscil编码,取值范围是0~127,有一个2进制位作为数据校验位。Java使用的是unicode编码,16个二进制位。取值范围会大一些,所以用的2字节,可以存汉字。 |
包装类型和基本类型的区别是什么?
最主要的区别是包装类型是对象,拥有字段和方法,可以很方便地调用一些基本的方法,初始值是null,而且可以使用null代表空值,而基本数据类型只能使用0来代表初始值。其次是基本数据类型是直接存储在栈中,而包装类型是一个对象,对象的引用变量是存储在栈中,存储了对象在堆中的地址,对象的数据是存在堆中。
JDK8 Stream与普通for循环的区别?
对于简单操作,比如最简单的遍历,Stream串行api性能明显差于显示迭代,但并行的Stream API能够发挥多核特性。
元素为整型时,普通for循环耗时:串行api耗时:双核CPU并行Stream API=1:2:1
元素为字符串型时,普通for循环耗时:串行api耗时:双核CPU并行Stream API=1:1.5:0.72。
https://blog.csdn.net/zhenghongcs/article/details/104305798
ArrayList
(PS:建了一个技术微信群,可以自由地讨论技术,工作和生活,也会分享一些我自己在看的技术资料,不定时发放红包福利,欢迎大家扫首页里面的二维码进群,希望和大家一起学习进步!大家如果想一起为这个项目做贡献的话,也可以进群大家聊一聊)
下面是主要是自己看了很多Java容器类相关的博客,以及很多面经中涉及到的Java容器相关的面试题后,自己全部手写的解答,也画了一些流程图,之后会继续更新这一部分。
1.ArrayList与LinkedList的区别是什么?
2.怎么使ArrayList,LinkedList变成线程安全的呢?
3.ArrayList遍历时删除元素有哪些方法?
4.ConcurrentModificationException是什么?
5.java容器类的层次是怎么样的?
ArrayList与LinkedList的区别是什么?
每次遇到一个好看的小姐姐,我们一般都是会去看她的外貌,身材,大小(咳咳,我们指的是年龄大小)等等。同样的,我们在分析Java容器之间的区别时,我们也可以从继承树,底层数据结构,线程安全,执行效率来进行分析。
1.底层使用的数据结构
- ArrayList 底层使用的是Object数组,初始化时就会指向的会是一个static修饰的空数组,数组长度一开始为0,插入第一个元素时数组长度会初始化为10,之后每次数组空间不够进行扩容时都是增加为原来的1.5倍。ArrayList的空间浪费主要体现在在list列表的结尾会预留一定的容量空间(为了避免添加元素时,数组空间不够频繁申请内存),而LinkedList的空间花费则体现在它的每一个元素都需要消耗比ArrayList更多的空间(因为要存放后继指针next和前驱指针pre以及数据)
- LinkedList 底层使用的数据结构是双向链表,每个节点保存了指向前驱节点和后继结点的指针。初始化时,不执行任何操作,添加第一个元素时,再去构造链表中的节点。
2.是否保证线程安全:
ArrayList 和 LinkedList 都是不同步的,也就是不保证线程安全。
因为ArrayList的插入元素的方法就是裸奔的,直接将原数组index及后面的元素拷贝到index+1及后面的位置上,然后将index位置设置为插入的值,并发修改时保证不了数据安全性,所以也不允许并发修改,一旦检测到并发修改,会抛出ConcurrentModificationException异常。
//ArrayList的插入元素的方法
public void add(int index, E element) {
        rangeCheckForAdd(index);
        ensureCapacityInternal(size + 1);  // Increments modCount!!
        System.arraycopy(elementData, index, elementData, index + 1,
                         size - index);//将原数组index之后的元素拷贝到原数组index+1后面的位置上
        elementData[index] = element;
        size++;
}
3.插入和删除的复杂度:
- ArrayList 采用数组存储,元素的物理存储地址是连续的,支持以O(1)的时间复杂度对元素快速访问。插入和删除元素后,需要将后面的元素进行移动,所以插入和删除元素的时间复杂度受元素位置的影响。复杂度是 O(n),
- LinkedList 采用链表存储,所以不能快速随机访问。所以首尾插入,删除元素时间复杂度不受元素位置的影响,都是近似 O(1)(如果是插入到中间位置还需要考虑寻找插入位置的时间复杂度)。而数组为近似 O(n)。
4.继承树
- ArrayList继承于AbstractList抽象类,实现了List, RandomAccess, Cloneable, java.io.Serializable接口 。
- LinkedList继承自AbstractSequentialList 实现List, Deque, Cloneable, java.io.Serializable接口。
AbstractSequentialList是AbstractList类的子类,实现了根据下标来访问元素的一些方法,主要是通过listIterator遍历获取特定元素。
List接口代表的是有序结合,与Set相反,List的元素是按照移动的顺序进行排列。
Cloneable接口代表类会重新父类Object的clone()方法,支持对实例对象的clone操作。
java.io.Serializable接口代表类支持序列化。
RandomAccess是一个标示性接口,代表ArrayList支持快速访问,而LinkedList不支持。
Deque接口是双端队列的意思,代表LinkedList支持两端元素插入和移除。
怎么使ArrayList,LinkedList变成线程安全的呢?
1.使用SynchronizedList
SynchronizedList是一个线程安全的包装类。继承于SynchronizedCollection,SynchronizedCollection实现了Collection接口,SynchronizedList包含一个List对象,对List的访问修改方法进行了一些封装,在封装的方法中会对list使用同步锁加锁,然后再进行存取和修改操作。
使用方法如下
LinkedList<Integer>    linkedList    = new LinkedList<Integer>();
//调用Collections的synchronizedList方法,传入一个linkedList,会返回一个SynchronizedList实例对象
List<Integer> synchronizedList =  Collections.synchronizedList(linkedList);

//调用Collections的synchronizedList方法,ArrayList,返回一个SynchronizedRandomAccessList实例对象
ArrayList<Integer>    arrayList    = new ArrayList<Integer>();
List<Integer> synchronizedRandomAccessList =  Collections.synchronizedList(linkedList);
(Collections.synchronizedList()方法会判断传入的对象是否实现了 RandomAccess接口,是的话,会返回一个SynchronizedRandomAccessList对象,SynchronizedRandomAccessList是SynchronizedList的子类,只是会多一个以线程安全的方式获取子数组的方法)。
SynchronizedList类的部分代码如下:
static class SynchronizedList<E>
        extends SynchronizedCollection<E>
        implements List<E> {
        final List<E> list;//源list
        final Object mutex;

        SynchronizedCollection(Collection<E> c) {
            this.c = Objects.requireNonNull(c);
            mutex = this;//mutex就是SynchronizedList实例自己,作为同步锁使用
        }

  			public E get(int index) {
            synchronized (mutex) {
            是父类中的成员变量,在父类中会将list赋值给mutex
            		return list.get(index);
            }
        }

        public E set(int index, E element) {
            synchronized (mutex) {return list.set(index, element);}
        }
}
2.使用CopyOnWriteArrayList
CopyOnWriteArrayList跟ArrayList类似,都是实现了List接口,只不过它的父类是Object,而不是AbstractList。CopyOnWriteArrayList与ArrayList的不同在于,
1.内部持有一个ReentrantLock类型的lock锁,用于控制并发访问
final transient ReentrantLock lock = new ReentrantLock();在对数组进行修改的方法中,都会先获取lock,获取成功才能进行修改,修改完释放锁,保证每次只允许一个线程对数组进行修改。
2.使用volatile修饰Object数组,使得变量具备内存可见性
   //CopyOnWriteArrayList
   private transient volatile Object[] array;

   //ArrayList
   private transient Object[] elementData;//transient
可以看到区别主要在于CopyOnWriteArrayList的Object是使用volatile来修饰的,volatile可以使变量具备内存可见性,一个线程在工作内存中对变量进行修改后,会立即更新到物理内存,并且使得其他线程中的这个变量缓存失效,其他线程在读取会去物理内存中读取最新的值。(volatile修饰的是指向数组的引用变量,所以对数组添加元素,删除元素不会改变引用,只有对数组变量array重新赋值才会改变。所以为了保证内存可见性,CopyOnWriteArrayList.add()方法在添加元素时,都是复制出一个新数组,进行修改操作后,再设置到就数组上)
注意事项:Object数组都使用transient修饰是因为transient修饰的属性不会参与序列化,ArrayList通过实现writeObject()和readObject()方法来自定义了序列化方法(基于反序列化时节约空间考虑,如果用默认的序列方法,源elementData数组长度为100,实际只有10个元素,反序列化时也会分配长度为100的数组,造成内存浪费。)
下面是CopyOnWriteArrayList的add()方法:
public boolean add(E e) {
    final ReentrantLock lock = this.lock;
	  //1. 使用Lock,保证写线程在同一时刻只有一个
    lock.lock();
    try {
		//2. 获取旧数组引用
        Object[] elements = getArray();
        int len = elements.length;
		//3. 创建新的数组,并将旧数组的数据复制到新数组中
        Object[] newElements = Arrays.copyOf(elements, len + 1);
		//4. 往新数组中添加新的数据
		newElements[len] = e;
		//5. 将旧数组引用指向新的数组
        setArray(newElements);
        return true;
    } finally {
        lock.unlock();
    }
}
SynchronizedList和CopyOnWriteArrayList优缺点
SynchronizedList:读写都加锁
SynchronizedList是通过对读写方法使用synchronized修饰来实现同步的,即便只是多个线程在读数据,也不能进行,如果是读比较多的场景下,会性能不高,所以适合读写均匀的情况。
CopyOnWriteArrayList:读不加锁,写加锁
而CopyOnWriteArrayList是读写分离的,只对写操作加锁,但是每次写操作(添加和删除元素等)时都会复制出一个新数组,完成修改后,然后将新数组设置到旧数组的引用上,所以在写比较多的情况下,会有很大的性能开销,所以适合读比较多的应用场景。
ArrayList遍历时删除元素有哪些方法?
首先结论如下:
第1种方法 - 普通for循环正序删除(结果:会漏掉元素判断)
第2种方法 - 普通for循环倒序删除(结果:正确删除)
第3种方法 - for-each循环删除(结果:抛出异常)
第4种方法 - Iterator遍历,使用ArrayList.remove()删除元素(结果:抛出异常)
第5种方法 - Iterator遍历,使用Iterator的remove删除元素(结果:正确删除)
下面让我们来详细探究一下原因吧!
首先初始化一个数组arrayList,假设我们要删除等于3的元素。
   public static void main(String[] args) {
        ArrayList<Integer> arrayList = new ArrayList();
        arrayList.add(1);
        arrayList.add(2);
        arrayList.add(3);
        arrayList.add(3);
        arrayList.add(4);
        arrayList.add(5);
        removeWayOne(arrayList);
    }
第1种方法 - 普通for循环正序删除(结果:会漏掉对后一个元素的判断)
for (int i = 0; i < arrayList.size(); i++) {
	if (arrayList.get(i) == 3) {//3是要删除的元素
		arrayList.remove(i);
		//解决方案: 加一行代码i = i - 1; 删除元素后,下标减1
	}
    System.out.println("当前arrayList是"+arrayList.toString());
}
//原ArrayList是[1, 2, 3, 3, 4, 5]
//删除后是[1, 2, 3, 4, 5]
输出结果:
当前arrayList是[1, 2, 3, 3, 4, 5]
当前arrayList是[1, 2, 3, 3, 4, 5]
当前arrayList是[1, 2, 3, 4, 5]
当前arrayList是[1, 2, 3, 4, 5]
当前arrayList是[1, 2, 3, 4, 5]
可以看到少删除了一个3,
原因在于调用remove删除元素时,remove方法调用System.arraycopy()方法将后面的元素移动到前面的位置,也就是第二个3会移动到数组下标为2的位置,而在下一次循环时,i+1之后,i会为3,不会对数组下标为2这个位置进行判断,所以这种写法,在删除元素时,被删除元素a的后一个元素b会移动a的位置,而i已经加1,会忽略对元素b的判断,所以如果是连续的重复元素,会导致少删除。
解决方案
可以在删除元素后,执行i=i-1,使得下次循环时再次对该数组下标进行判断。
第2种方法 - 普通for循环倒序删除(结果:正确删除)
 for (int i = arrayList.size() -1 ; i>=0; i--) {
    if (arrayList.get(i).equals(3)) {
        arrayList.remove(i);
    }
    System.out.println("当前arrayList是"+arrayList.toString());
}
输出结果:
当前arrayList是[1, 2, 3, 3, 4, 5]
当前arrayList是[1, 2, 3, 3, 4, 5]
当前arrayList是[1, 2, 3, 4, 5]
当前arrayList是[1, 2, 4, 5]
当前arrayList是[1, 2, 4, 5]
当前arrayList是[1, 2, 4, 5]
这种方法可以正确删除元素,因为调用remove删除元素时,remove方法调用System.arraycopy()将被删除元素a后面的元素向前移动,而不会影响元素a之前的元素,所以倒序遍历可以正常删除元素。
第3种方法 - for-each循环删除(结果:抛出异常)
抛出异常的根本原因在于for-each是使用Iterator来实现遍历的,调用ArrayList.remove()方法会将modCount+1,而Iterator内部的expectedModCount确没有更新,这样在进行下次循环时调用Iterator.next()会对modCount和expectedModCount进行比较,不一致就会抛出ConcurrentModificationException异常。
public static void removeWayThree(ArrayList<Integer> arrayList) {
    for (Integer value : arrayList) {
        if (value.equals(3)) {//3是要删除的元素
            arrayList.remove(value);
        }
    System.out.println("当前arrayList是"+arrayList.toString());
    }
}
输出结果:
当前arrayList是[1, 2, 3, 3, 4, 5]
当前arrayList是[1, 2, 3, 3, 4, 5]
当前arrayList是[1, 2, 3, 4, 5]
Exception in thread "main" java.util.ConcurrentModificationException
	at java.util.ArrayList$Itr.checkForComodification(ArrayList.java:901)
	at java.util.ArrayList$Itr.next(ArrayList.java:851)
	at com.test.ArrayListTest1.removeWayThree(ArrayListTest1.java:50)
	at com.test.ArrayListTest1.main(ArrayListTest1.java:24)
会抛出ConcurrentModificationException异常,主要在于for-each的底层实现是使用ArrayList.iterator的hasNext()方法和next()方法实现的,我们可以使用反编译进行验证,对包含上面的方法的类使用以下命令反编译验证
javac ArrayTest.java//生成ArrayTest.class文件
javap -c ArrayListTest.class//对class文件反编译
得到removeWayThree方法的反编译代码如下:
 public static void removeWayThree(java.util.ArrayList<java.lang.Integer>);
    Code:
       0: aload_0
       1: invokevirtual #12   // Method java/util/ArrayList.iterator:()Ljava/util/Iterator;
       4: astore_1
       5: aload_1
       6: invokeinterface #13,  1 // InterfaceMethod java/util/Iterator.hasNext:()Z   调用Iterator.hasNext()方法
      11: ifeq          44
      14: aload_1
      15: invokeinterface #14,  1 // InterfaceMethod java/util/Iterator.next:()Ljava/lang/Object;调用Iterator.next()方法
      20: checkcast     #9                  // class java/lang/Integer
      23: astore_2
      24: aload_2
      25: iconst_3
      26: invokestatic  #4                  // Method java/lang/Integer.valueOf:(I)Ljava/lang/Integer;
      29: invokevirtual #10                 // Method java/lang/Integer.equals:(Ljava/lang/Object;)Z
      32: ifeq          41
      35: aload_0
      36: aload_2
      37: invokevirtual #15                 // Method java/util/ArrayList.remove:(Ljava/lang/Object;)Z
      40: pop
      41: goto          5
      44: return
可以很清楚得看到Iterator.hasNext()来判断是否还有下一个元素,和Iterator.next()方法来获取下一个元素。而因为在删除元素时,remove()方法会调用fastRemove()方法,其中会对modCount+1,代表对数组进行了修改,将修改次数+1。
 public boolean remove(Object o) {
     if (o == null) {
         for (int index = 0; index < size; index++)
             if (elementData[index] == null) {
                 fastRemove(index);
             return true;
         }
     } else {
         for (int index = 0; index < size; index++)
             if (o.equals(elementData[index])) {
                 fastRemove(index);
                 return true;
             }
     }
 		return false;
}

private void fastRemove(int index) {
    modCount++;
    int numMoved = size - index - 1;
    if (numMoved > 0)
    			System.arraycopy(elementData, index+1, elementData, index,numMoved);
    elementData[--size] = null; // clear to let GC do its work
}而当删除完元素后,进行下一次循环时,会调用下面源码中Itr.next()方法获取下一个元素,会调用checkForComodification()方法对ArrayList进行校验,判断在遍历ArrayList是否已经被修改,由于之前对modCount+1,而Iterator中的expectedModCount还是初始化时ArrayList.Itr对象时赋的值,所以会不相等,然后抛出ConcurrentModificationException异常。
那么有什么办法可以让expectedModCount及时更新呢?
可以看到下面Itr的源码中,在Itr.remove()方法中删除元素后会对 expectedModCount更新,所以我们在使用删除元素时使用Itr.remove()方法来删除元素就可以保证expectedModCount的更新了,具体看第5种方法。
//使用Iterator遍历元素的方法
/*
Iterator遍历时使用next()方法返回下一个元素,主要通过将游标cursor+1,获得下一个元素

调用remove()删除元素时,主要删除lastRet下标对应的元素,并且将cursor设置为lastRet的值,因为后面的元素向前面的空位移动了一位

Iterator遍历过程中,在一次循环中也不能多次调用remove()方法,因为每次remove()后就会将lastRet设置为-1,本次循环中再remove就会抛异常,必须等调用next()方法后对lastRet重新赋值。
*/
public void tranverse() {
  ArrayList<Integer> list = new ArrayList<Integer>();
        list.add(1);
        list.add(2);
        list.add(3);
        list.add(3);
        list.add(4);
        list.add(5);
	Iterator<Integer> iterator = list.iterator();
  while (iterator.hasNext()) {
    Integer value = iterator.next();
    System.out.println(value);
    if (value.equals(3)) {
      iterator.remove();
      iterator.remove();//在循环中多次调用iterator的remove方法会抛出异常
      iterator.remove();
    }
  }
}
Iterator的源代码
private class Itr implements Iterator<E> {
        int cursor;       // 游标
        int lastRet = -1; // index of last element returned; -1 if no such
        int expectedModCount = modCount;//期待的modCount值

        public boolean hasNext() {
            return cursor != size;
        }

        @SuppressWarnings("unchecked")
        public E next() {
            checkForComodification();//判断expectedModCount与当前的modCount是否一致
            int i = cursor;
            if (i >= size)
                throw new NoSuchElementException();
            Object[] elementData = ArrayList.this.elementData;
            if (i >= elementData.length)
                throw new ConcurrentModificationException();
            cursor = i + 1;
            return (E) elementData[lastRet = i];
        }

        public void remove() {
            if (lastRet < 0)
                throw new IllegalStateException();
            checkForComodification();
            try {
                ArrayList.this.remove(lastRet);
                cursor = lastRet;
                lastRet = -1;
                expectedModCount = modCount;//更新expectedModCount
            } catch (IndexOutOfBoundsException ex) {
                throw new ConcurrentModificationException();
            }
        }

        final void checkForComodification() {
            if (modCount != expectedModCount)
                throw new ConcurrentModificationException();
        }
    }
第4种方法 - Iterator遍历,使用ArrayList.remove()删除元素(结果:抛出异常)
Iterator<Integer> iterator = arrayList.iterator();
while (iterator.hasNext()) {
    Integer value = iterator.next();
    if (value.equals(3)) {//3是要删除的元素
    		arrayList.remove(value);
    }
    System.out.println("当前arrayList是"+arrayList.toString());
}
输出结果:
当前arrayList是[1, 2, 3, 3, 4, 5]
当前arrayList是[1, 2, 3, 3, 4, 5]
当前arrayList是[1, 2, 3, 4, 5]
Exception in thread "main" java.util.ConcurrentModificationException
	at java.util.ArrayList$Itr.checkForComodification(ArrayList.java:901)
	at java.util.ArrayList$Itr.next(ArrayList.java:851)
	at com.test.ArrayListTest1.removeWayFour(ArrayListTest1.java:61)
at com.test.ArrayListTest1.main(ArrayListTest1.java:25)第4种方法其实是第3种方法在编译后的代码,所以第四种写法也会抛出ConcurrentModificationException异常。这种需要注意的是,每次调用iterator的next()方法,会导致游标向右移动,从而达到遍历的目的。所以在单次循环中不能多次调用next()方法,不然会导致每次循环时跳过一些元素,我在一些博客里面看到了一些错误的写法,比如这一篇《在ArrayList的循环中删除元素,会不会出现问题?》文章中:
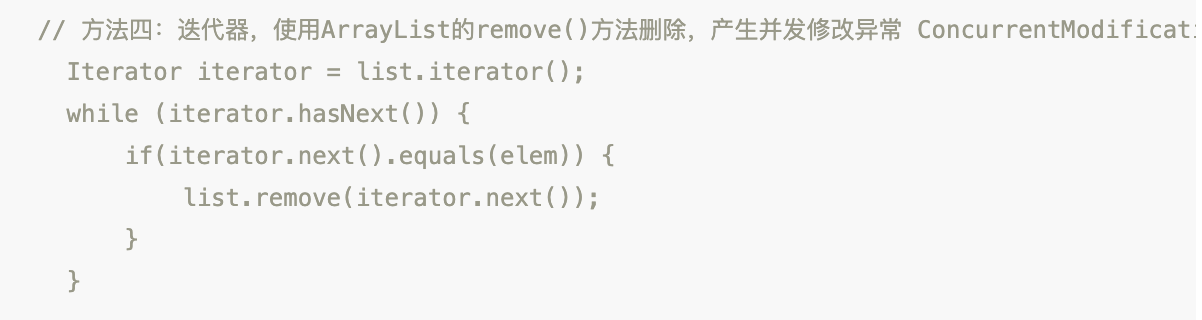
先调用iterator.next()获取元素,与elem进行比较,如果相等,再调用list.remove(iterator.next());来移除元素,这个时候的iterator.next()其实已经不是与elem相等的元素了,而是后一个元素了,我们可以写个demo来测试一下
ArrayList<Integer> arrayList = new ArrayList();
arrayList.add(1);
arrayList.add(2);
arrayList.add(3);
arrayList.add(4);
arrayList.add(5);
arrayList.add(6);
arrayList.add(7);

Integer elem = 3;
Iterator iterator = arrayList.iterator();
while (iterator.hasNext()) {
    System.out.println(arrayList);
    if(iterator.next().equals(elem)) {
    		arrayList.remove(iterator.next());
    }
}
输出结果如下:
[1, 2, 3, 4, 5, 6, 7]
[1, 2, 3, 4, 5, 6, 7]
[1, 2, 3, 4, 5, 6, 7]
[1, 2, 3, 5, 6, 7]
Exception in thread "main" java.util.ConcurrentModificationException
	at java.util.ArrayList$Itr.checkForComodification(ArrayList.java:901)
	at java.util.ArrayList$Itr.next(ArrayList.java:851)
	at com.test.ArrayListTest1.main(ArrayListTest1.java:29)
可以看到移除的元素其实不是3,而是3之后的元素,因为调用了两次next()方法,导致游标多移动了。所以应该使用Integer value = iterator.next();将元素取出进行判断。
第5种方法 - Iterator遍历,使用Iterator的remove删除元素(结果:正确删除)
Iterator<Integer> iterator = arrayList.iterator();
while (iterator.hasNext()) {
    Integer value = iterator.next();
    if (value.equals(3)) {//3是需要删除的元素
        iterator.remove();
    }
}
输出结果:
当前arrayList是[1, 2, 3, 3, 4, 5]
当前arrayList是[1, 2, 3, 3, 4, 5]
当前arrayList是[1, 2, 3, 4, 5]
当前arrayList是[1, 2, 4, 5]
当前arrayList是[1, 2, 4, 5]
当前arrayList是[1, 2, 4, 5]
可以正确删除元素。
跟第3种和第4种方法的区别在于是使用iterator.remove();来移除元素,而在remove()方法中会对iterator的expectedModCount变量进行更新,所以在下次循环调用iterator.next()方法时,expectedModCount与modCount相等,不会抛出异常。
ConcurrentModificationException是什么?
根据ConcurrentModificationException的文档介绍,一些对象不允许并发修改,当这些修改行为被检测到时,就会抛出这个异常。(例如一些集合不允许一个线程一边遍历时,另一个线程去修改这个集合)。
一些集合(例如Collection, Vector, ArrayList,LinkedList, HashSet, Hashtable, TreeMap, AbstractList, Serialized Form)的Iterator实现中,如果提供这种并发修改异常检测,那么这些Iterator可以称为是"fail-fast Iterator",意思是快速失败迭代器,就是检测到并发修改时,直接抛出异常,而不是继续执行,等到获取到一些错误值时在抛出异常。
异常检测主要是通过modCount和expectedModCount两个变量来实现的,
- modCount
集合被修改的次数,一般是被集合(ArrayList之类的)持有,每次调用add(),remove()方法会导致modCount+1
- expectedModCount
期待的modCount,一般是被Iterator(ArrayList.iterator()方法返回的iterator对象)持有,一般在Iterator初始化时会赋初始值,在调用Iterator的remove()方法时会对expectedModCount进行更新。(可以看看上面的ArrayList.Itr源码)
然后在Iterator调用next()遍历元素时,会调用checkForComodification()方法比较modCount和expectedModCount,不一致就抛出ConcurrentModificationException。
单线程操作Iterator不当时也会抛出ConcurrentModificationException异常。(上面的例子就是)
总结
因为ArrayList和HashMap的Iterator都是上面所说的“fail-fast Iterator”,Iterator在获取下一个元素,删除元素时,都会比较expectedModCount和modCount,不一致就会抛出异常。
所以当使用Iterator遍历元素(for-each遍历底层实现也是Iterator)时,需要删除元素,一定需要使用 Iterator的remove()方法 来删除,而不是直接调用ArrayList或HashMap自身的remove()方法,否则会导致Iterator中的expectedModCount没有及时更新,之后获取下一个元素或者删除元素时,expectedModCount和modCount不一致,然后抛出ConcurrentModificationException异常。
java容器类的层次是怎么样的?
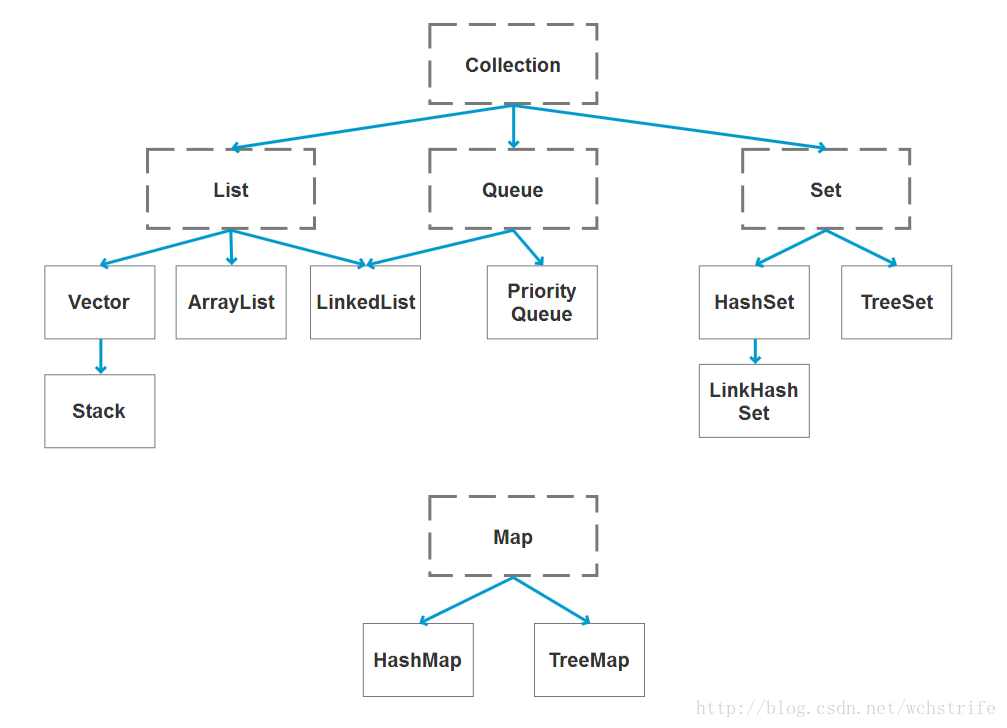
大致是这样一个图,Collection是一个接口,代表是集合,它有三个子接口,分别是有序集合List,队列Queue,无序集合Set。Map代表键值对。实际上关系会更加复杂一些,以ArrayList为例:
ArrayList不单是实现了List接口,而且还继承于AbstractList抽象类,同时实现了RandomAccess,Cloneable,Serializable接口。
HashMap不单是实现了Map接口,而且继承于AbstractMap抽象类,同时实现了Cloneable,Serializable接口。
HashMap
(PS:扫描首页里面的二维码进群,分享我自己在看的技术资料给大家,希望和大家一起学习进步!)
下面是主要是自己看了很多Java容器类相关的博客,以及很多面经中涉及到的Java容器相关的面试题后,自己全部手写的解答,也花了一些流程图,之后会继续更新这一部分。
1.HashMap添加一个键值对的过程是怎么样的?
2.ConcurrentHashMap添加一个键值对的过程是怎么样的?
3.HashMap与HashTable,ConcurrentHashMap的区别是什么?
4.HashMap扩容后是否需要rehash?
5.HashMap扩容是怎样扩容的,为什么都是2的N次幂的大小?
6.ConcurrentHashMap是怎么记录元素个数size的?
7.为什么ConcurrentHashMap,HashTable不支持key,value为null?
[8.HashSet和HashMap的区别?](#HashSet和HashMap的区别? )
9.HashMap遍历时删除元素的有哪些实现方法?
HashMap添加一个键值对的过程是怎么样的?
流程图如下:
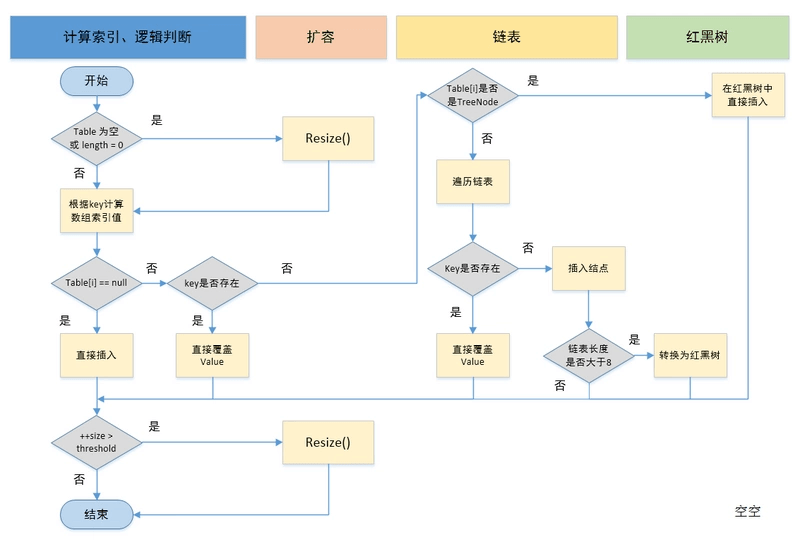
1.初始化table
判断table是否为空或为null,否则执行resize()方法(resize方法一般是扩容时调用,也可以调用来初始化table)。
2.计算hash值
根据键值key计算hash值。(因为hashCode是一个int类型的变量,是4字节,32位,所以这里会将hashCode的低16位与高16位进行一个异或运算,来保留高位的特征,以便于得到的hash值更加均匀分布)
static final int hash(Object key) {
    int h;
    return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16);
}
3.插入或更新节点
根据(n - 1) & hash计算得到插入的数组下标i,然后进行判断
3.1.数组为空(table[i]==null)
那么说明当前数组下标下,没有hash冲突的元素,直接新建节点添加。
3.2.等于下标首元素,table[i].hash == hash &&(table[i]== key || (key != null && key.equals(table[i].key)))
判断table[i]的首个元素是否和key一样,如果相同直接更新value。
3.3.数组下标存的是红黑树,table[i] instanceof TreeNode
判断table[i] 是否为treeNode,即table[i] 是否是红黑树,如果是红黑树,则直接在树中插入键值对。
3.4.数组下标存的是链表
上面的判断条件都不满足,说明table[i]存储的是一个链表,那么遍历链表,判断是否存在已有元素的key与插入键值对的key相等,如果是,那么更新value,如果没有,那么在链表末尾插入一个新节点。插入之后判断链表长度是否大于8,大于8的话把链表转换为红黑树。
4.扩容
插入成功后,判断实际存在的键值对数量size是否超多了最大容量threshold(一般是数组长度*负载因子0.75),如果超过,进行扩容。
源代码如下:
final V putVal(int hash, K key, V value, boolean onlyIfAbsent,
                   boolean evict) {
    Node<K,V>[] tab; Node<K,V> p; int n, i;
    // 1.tab为空则创建
    if ((tab = table) == null || (n = tab.length) == 0)
        n = (tab = resize()).length;
    // 2.计算index,并对null做处理
    // 3.插入元素
  //(n - 1) & hash 确定元素存放在哪个数组下标下
  //下标没有元素,新生成结点放入中(此时,这个结点是放在数组中)
    if ((p = tab[i = (n - 1) & hash]) == null)
        tab[i] = newNode(hash, key, value, null);
    // 下标中已经存在元素
    else {
        Node<K,V> e; K k;
        // 节点key存在,直接覆盖value
        // 比较桶中第一个元素(数组中的结点)的hash值相等,key相等
        if (p.hash == hash &&
            ((k = p.key) == key || (key != null && key.equals(k))))
                // 将第一个元素赋值给e,用e来记录
                e = p;
        // 判断该链为红黑树
        // hash值不相等,即key不相等;为红黑树结点
        else if (p instanceof TreeNode)
            // 放入树中
            e = ((TreeNode<K,V>)p).putTreeVal(this, tab, hash, key, value);
        // 该链为链表
        // 为链表结点
        else {
            // 在链表最末插入结点
            for (int binCount = 0; ; ++binCount) {
                // 到达链表的尾部
                if ((e = p.next) == null) {
                    // 在尾部插入新结点
                    p.next = newNode(hash, key, value, null);
                    // 结点数量达到阈值,转化为红黑树
                    if (binCount >= TREEIFY_THRESHOLD - 1) // -1 for 1st
                        treeifyBin(tab, hash);
                    // 跳出循环
                    break;
                }
                // 判断链表中结点的key值与插入的元素的key值是否相等
                if (e.hash == hash &&
                    ((k = e.key) == key || (key != null && key.equals(k))))
                    // 相等,跳出循环
                    break;
                // 用于遍历桶中的链表,与前面的e = p.next组合,可以遍历链表
                p = e;
            }
        }
        // 表示在桶中找到key值、hash值与插入元素相等的结点
        if (e != null) {
            // 记录e的value
            V oldValue = e.value;
            // onlyIfAbsent为false或者旧值为null
            if (!onlyIfAbsent || oldValue == null)
                //用新值替换旧值
                e.value = value;
            // 访问后回调
            afterNodeAccess(e);
            // 返回旧值
            return oldValue;
        }
    }
    ++modCount;
    // 超过最大容量 就扩容
    // 实际大小大于阈值则扩容
    if (++size > threshold)
        resize();
    // 插入后回调
    afterNodeInsertion(evict);
    return null;
}
ConcurrentHashMap添加一个键值对的过程是怎么样的?
这是我自己阅读源码后,比HashMap的会复杂很多,画的一个流程图如下所示:
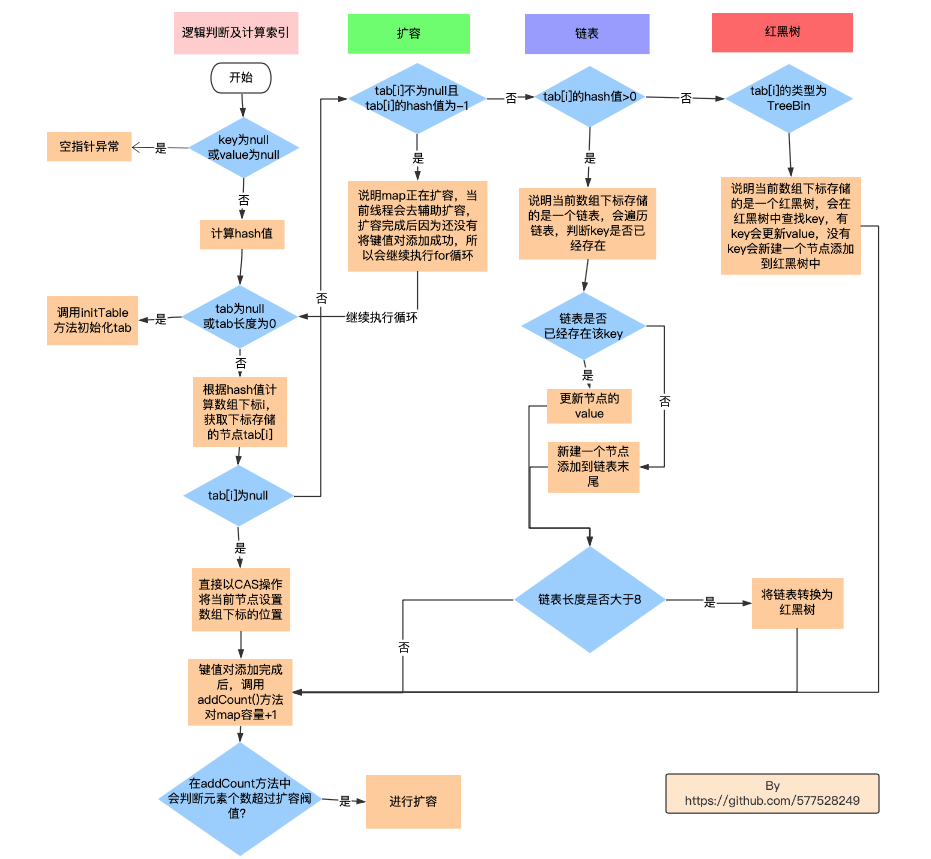
1.判断null值
判断key==null 或者 value == null,如果是,抛出空指针异常。
2.计算hash
根据key计算hash值(计算结果跟HashMap是一致的,写法不同)。
3.进入for循环,插入或更新元素
- ##### 3.1 如果 tab==null || tab.length==0,说明数组未初始化
说明当前数组tab还没有初始化。
那么调用initTable()方法初始化tab。(在initTable方法中,为了控制只有一个线程对table进行初始化,当前线程会通过CAS操作对SIZECTL变量赋值为-1,如果赋值成功,线程才能初始化table,否则会调用Thread.yield()方法让出时间片)。
- ##### 3.2 如果f ==null,说明当前下标没有哈希冲突的键值对
说明当前数组下标还没有哈希冲突的键值对。
Node
那么根据key和value创建一个Node,使用CAS操作设置在当前数组下标下,并且break出for循环。
- ##### 3.3 如果f != null && f.hash = -1,说明存储的是标志节点,表示在扩容
说明ConcurrentHashMap正在在扩容,当前的节点f是一个标志节点,当前下标存储的hash冲突的元素已经迁移了。
那么当前线程会调用helpTransfer()方法来辅助扩容,扩容完成后会将tab指向新的table,然后继续执行for循环。
- ##### 3.4 除上面三种以外情况,说明是下标存储链表或者是红黑树
说明f节点是一个链表的头结点或者是红黑树的根节点,那么对f加sychronize同步锁,然后进行以下判断:
- f.hash > 0
如果是f的hash值大于0,当前数组下标存储的是一个链表,f是链表的头结点。对链表进行遍历,如果有节点跟当前需要插入节点的hash值相同,那么对节点的value进行更新,否则根据key,value创建一个Node<K,V>,添加到链表末尾。- f instanceof TreeBin
如果f是TreeBin类型,那么说明当前数组下标存储的是一个红黑树,f是红黑树的根节点,调用putTreeVal方法,插入或更新节点。如果f是TreeBin类型,那么说明当前数组下标存储的是一个红黑树,f是红黑树的根节点,调用putTreeVal方法,插入或更新节点。- 插入完成后,判断binCount(数组下标存储是一个链表时,binCount是链表长度),当binCount超过8时,并且数组的长度大于64时,那么调用treeifyBin方法将链表转换为红黑树。最后break出for循环。
PS:
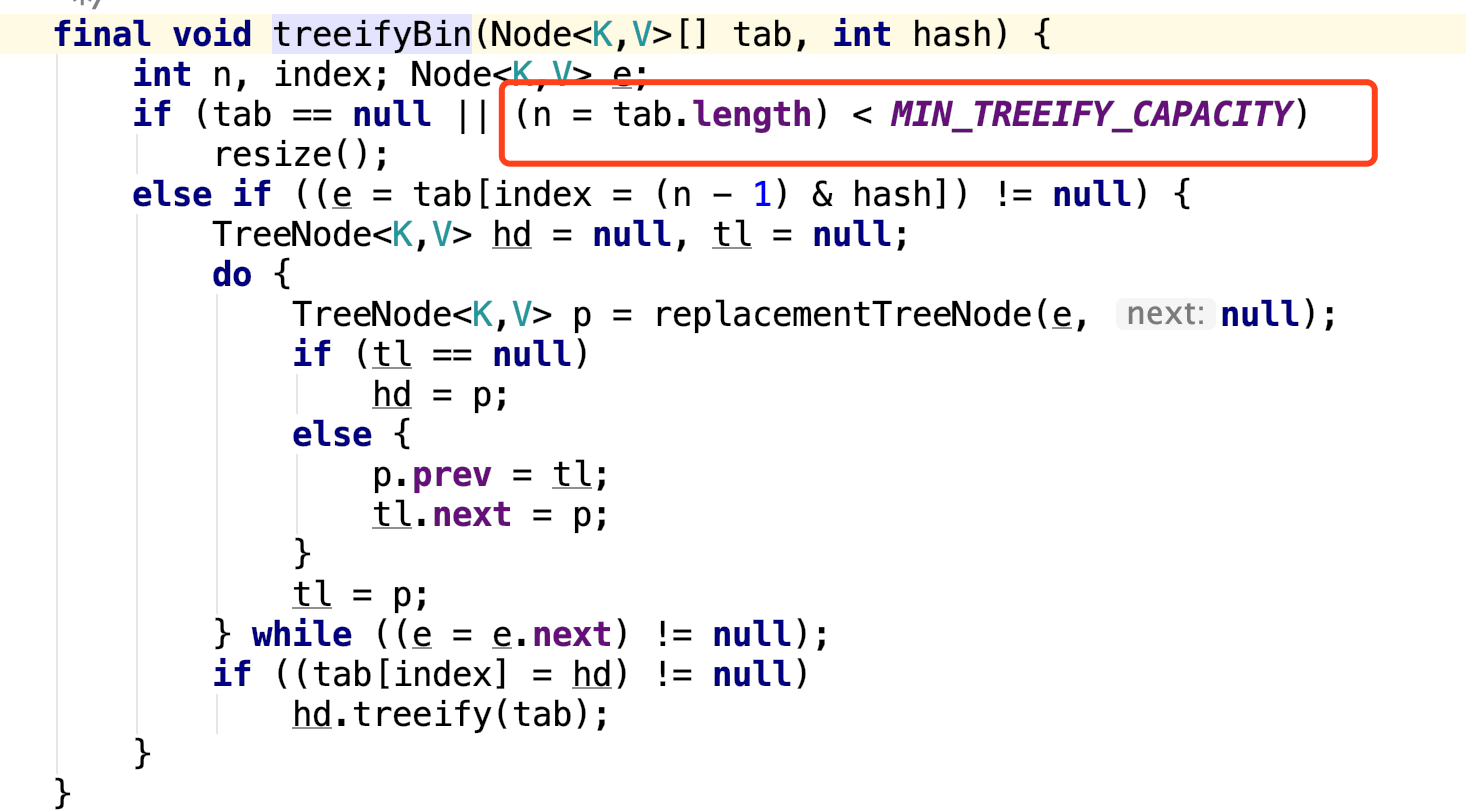
很多技术文章都是说链表长度大于8就转换为红黑树,我当时也没有注意这个细节,直到有个群里的朋友指正,当原来的链表长度超过8时,确实会调用treeifyBin方法,但是在treeifyBin方法中会判断当前tab是否为空,或者数组长度是否小于64,如果满足条件,那么调用resize方法对tab初始化或者扩容,就不会将链表转换为红黑树了。
添加键值对的putVal方法的源码:
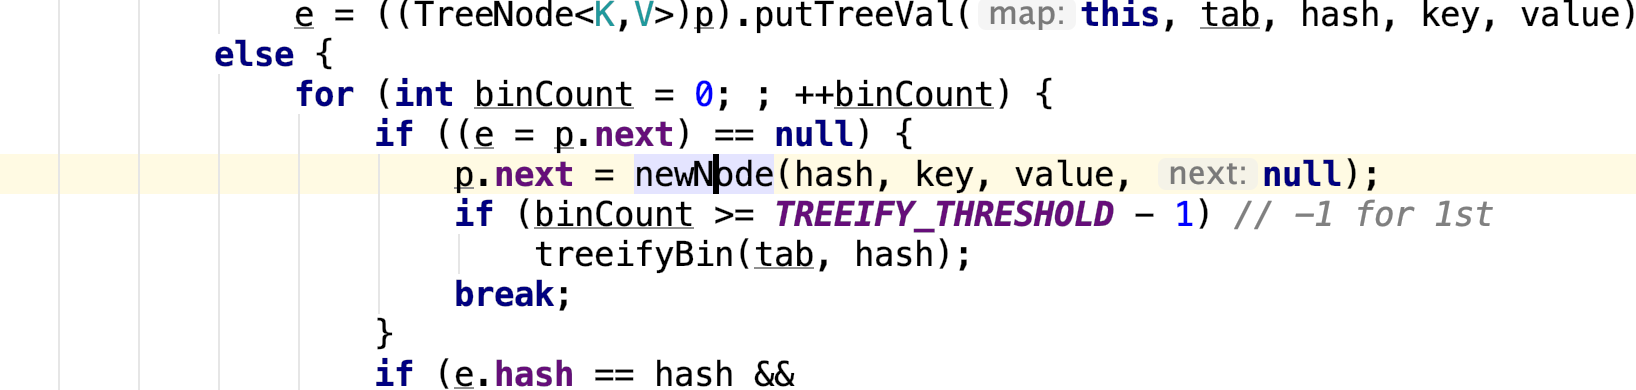
treeifyBin方法的源码: MIN_TREEIFY_CAPACITY是64
4.判断是否需要扩容
调用addCount()对当前数组长度加1,在addCount()方法中,会判断当前元素个数是否超过sizeCtl(扩容阈值,总长度*0.75),如果是,那么会进行扩容,如果正处于扩容过程中,当前线程会辅助扩容。
ConcurrentHashMap源码:
final V putVal(K key, V value, boolean onlyIfAbsent) {
  //ConcurrentHashMap不允许key和value为null,否则抛出异常
    if (key == null || value == null) throw new NullPointerException();
    int hash = spread(key.hashCode());//计算hash值
    int binCount = 0;
    for (Node<K,V>[] tab = table;;) {//进入循环
        Node<K,V> f; int n, i, fh;
        if (tab == null || (n = tab.length) == 0)//数组如果为空
            tab = initTable();//初始化数组
        else if ((f = tabAt(tab, i = (n - 1) & hash)) == null) {
            if (casTabAt(tab, i, null,
                         new Node<K,V>(hash, key, value, null)))//如果发现此数组下标下没有哈希冲突的元素,就直接使用CAS操作将Node设置到此下标下
                break;
        }
        else if ((fh = f.hash) == MOVED)//代表当前下标的头结点是标识节点,代表数组在扩容
            tab = helpTransfer(tab, f);//协助扩容
        else {//这种是普遍情况,存的是链表或者红黑树,进行插入
            V oldVal = null;
            synchronized (f) {//加同步锁,避免多线程进行插入
                if (tabAt(tab, i) == f) {
                    if (fh >= 0) {//头结点hash值大于0,此数组下标下代表存的是一个链表
                        binCount = 1;
                        for (Node<K,V> e = f;; ++binCount) {//遍历链表
                            K ek;
                            if (e.hash == hash &&
                                ((ek = e.key) == key ||
                                 (ek != null && key.equals(ek)))) {
                                oldVal = e.val;
                                if (!onlyIfAbsent)
                                    e.val = value;
                                break;
                            }
                            Node<K,V> pred = e;
                            if ((e = e.next) == null) {//键值对是新添加的,在链表尾部插入新节点
                                pred.next = new Node<K,V>(hash, key,
                                                          value, null);
                                break;
                            }
                        }
                    }
                    else if (f instanceof TreeBin) {//下标下存的是红黑树
                        Node<K,V> p;
                        binCount = 2;
                        if ((p = ((TreeBin<K,V>)f).putTreeVal(hash, key,
                                                       value)) != null) {
                            oldVal = p.val;
                            if (!onlyIfAbsent)
                                p.val = value;
                        }
                    }
                }
            }
            if (binCount != 0) {
                if (binCount >= TREEIFY_THRESHOLD)//链表长度>=8,转换为红黑树
                    treeifyBin(tab, i);
                if (oldVal != null)
                    return oldVal;
                break;
            }
        }
    }
    addCount(1L, binCount);
    return null;
}
HashMap与HashTable,ConcurrentHashMap的区别是什么?
主要从底层数据结构,线程安全,执行效率,是否允许Null值,初始容量及扩容,hash值计算来进行分析。
1.底层数据结构
transient Node<K,V>[] table; //HashMap

transient volatile Node<K,V>[] table;//ConcurrentHashMap

private transient Entry<?,?>[] table;//HashTable
HashMap=数组+链表+红黑树
HashMap的底层数据结构是一个数组+链表+红黑树,数组的每个元素存储是一个链表的头结点,链表中存储了一组哈希值冲突的键值对,通过链地址法来解决哈希冲突的。为了避免链表长度过长,影响查找元素的效率,当链表的长度>8时,会将链表转换为红黑树,链表的长度<6时,将红黑树转换为链表(但是红黑树转换为链表的时机不是在删除链表时,而是在扩容时,发现红黑树分解后的两个链表<6,就按链表处理,否则就建立两个小的红黑树,设置到扩容后的位置)。之所以临界点为8是因为红黑树的查找时间复杂度为logN,链表的平均时间查找复杂度为N/2,当N为8时,logN为3,是小于N/2的,正好可以通过转换为红黑树减少查找的时间复杂度。
ConcurrentHashMap=数组+链表+红黑树
ConcurrentHashMap底层数据结构跟HashMap一致,底层数据结构是一个数组+链表+红黑树。只不过使用了volatile来进行修饰它的属性,来保证内存可见性(一个线程修改了这些属性后,会使得其他线程中对于该属性的缓存失效,以便下次读取时取最新的值)。
Hashtable=数组+链表
Hashtable底层数据结构跟HashMap一致,底层数据结构是一个数组+链表,也是通过链地址法来解决冲突,只是链表过长时,不会转换为红黑树来减少查找时的时间复杂度。Hashtable属于历史遗留类,实际开发中很少使用。
2.线程安全
HashMap 非线程安全
HashMap是非线程安全的。(例如多个线程插入多个键值对,如果两个键值对的key哈希冲突,可能会使得两个线程在操作同一个链表中的节点,导致一个键值对的value被覆盖)
HashTable 线程安全
HashTable是线程安全的,主要通过使用synchronized关键字修饰大部分方法,使得每次只能一个线程对HashTable进行同步修改,性能开销较大。
ConcurrentHashMap 线程安全
ConcurrentHashMap是线程安全的,主要是通过CAS操作+synchronized来保证线程安全的。
CAS操作
往ConcurrentHashMap中插入新的键值对时,如果对应的数组下标元素为null,那么通过CAS操作原子性地将节点设置到数组中。
//这是添加新的键值对的方法
final V putVal(K key, V value, boolean onlyIfAbsent) {
...其他代码
  if ((f = tabAt(tab, i = (n - 1) & hash)) == null) {
    if (casTabAt(tab, i, null, new Node<K,V>(hash, key, value, null))) 				break; // 因为对应的数组下标元素为null,所以null作为预期值,new Node<K,V>(hash, key, value, null)作为即将更新的值,只有当内存中的值与即将预期值一致时,才会进行更新,保证原子性。
  }
...其他代码
}
static final <K,V> boolean casTabAt(Node<K,V>[] tab, int i,
                                        Node<K,V> c, Node<K,V> v) {
        return U.compareAndSwapObject(tab, ((long)i << ASHIFT) + ABASE, c, v);
}
synchronized锁
往ConcurrentHashMap中插入新的键值对时,如果对应的数组下标元素不为null,那么会对数组下标存储的元素(也就是链表的头节点)加synchronized锁, 然后进行插入操作,
Node<K,V> f = tabAt(tab, i = (n - 1) & hash));
synchronized (f) {//f就是数组下标存储的元素
    if (tabAt(tab, i) == f) {
        if (fh >= 0) {//当前下标存的是链表
            binCount = 1;
            for (Node<K,V> e = f;; ++binCount) {//遍历链表
                K ek;
                if (e.hash == hash &&
                    ((ek = e.key) == key ||
                     (ek != null && key.equals(ek)))) {
                    oldVal = e.val;
                    if (!onlyIfAbsent)
                        e.val = value;
                    break;
                }
                Node<K,V> pred = e;
                if ((e = e.next) == null) {
                    pred.next = new Node<K,V>(hash, key,
                                              value, null);
                    break;
                }
            }
        }
        else if (f instanceof TreeBin) {//当前下标存的是红黑树
            Node<K,V> p;
            binCount = 2;
            if ((p = ((TreeBin<K,V>)f).putTreeVal(hash, key,
                                           value)) != null) {
                oldVal = p.val;
                if (!onlyIfAbsent)
                    p.val = value;
            }
        }
    }
}
3.执行效率
因为HashMap是非线程安全的,执行效率会高一些,其次是ConcurrentHashMap,因为HashTable在进行修改和访问时是对整个HashTable加synchronized锁,多线程访问时,同一时间点,只有一个线程可以访问或者添加键值对,所以效率最低。
4.是否允许null值出现
HashMap的key和value都可以为null,如果key为null,那么计算的hash值会是0,最终计算得到的数组下标也会是0,所以key为null的键值对会存储在数组中的首元素的链表中。value为null的键值对也能正常插入,跟普通键值对插入过程一致。
static final int hash(Object key) {
	int h;
	return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16);
}
HashTable的键和值都不能为null,如果将HashTable的一个键值对的key设置为null,因为null值没法调用hashCode()方法获取哈希值,所以会抛出空指针异常。同样value为null时,在put方法中会进行判断,然后抛出空指针异常。
public synchronized V put(K key, V value) {
        // Make sure the value is not null
        if (value == null) {
            throw new NullPointerException();
        }
        Entry<?,?> tab[] = table;
        int hash = key.hashCode();
        //...其他代码
}
ConcurrentHashMap的键和值都不能为null,在putVal方法中会进行判断,为null会抛出空指针异常。
final V putVal(K key, V value, boolean onlyIfAbsent) {
    if (key == null || value == null) throw new NullPointerException();
    int hash = spread(key.hashCode());
    ...其他代码
}
5.初始容量及扩容
不指定初始容量
如果不指定初始容量,HashMap和ConcurrentHashMap默认会是16,HashTable的容量默认会是11。
指定初始容量
如果指定了初始容量,HashMap和ConcurrentHashMap的容量会是比初始容量稍微大一些的2的幂次方大小,HashTable会使用初始容量,
扩容
扩容时,如果远长度是N,HashMap和ConcurrentHashMap扩容时会是2N,HashTable则是2N+1。
6.hash值计算
HashTable会扩容为2N+1,HashTable之所以容量取11,及扩容时是是2N+1,是为了保证 HashTable的长度是一个素数,因为数组的下标是用key的hashCode与数组的长度取模进行计算得到的,而当数组的长度是素数时,可以保证计算得到的数组下标分布得更加均匀,可以看看这篇文章http://zhaox.github.io/algorithm/2015/06/29/hash
public synchronized V put(K key, V value) {
         ...其他代码
        // Makes sure the key is not already in the hashtable.
        Entry<?,?> tab[] = table;
        int hash = key.hashCode();
        int index = (hash & 0x7FFFFFFF) % tab.length;
        ...其他代码
}
HashMap和ConcurrentHashMap的hash值都是通过将key的hashCode()高16位与低16位进行异或运算(这样可以保留高位的特征,避免一些key的hashCode高位不同,低位相同,造成hash冲突),得到hash值,然后将hash&(n-1)计算得到数组下标。(n为数组的长度,因为当n为2的整数次幂时,hash mod n的结果在数学上等于hash&(n-1),而计算机进行&运算更快,所以这也是HashMap的长度总是设置为2的整数次幂的原因)
//HashMap计算hash值的方法
static int hash(Object key) {
    int h;
    return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16);
}
//ConcurrentHashMap计算hash值的方法
static  int spread(int h) {//h是对象的hashCode
    return (h ^ (h >>> 16)) & HASH_BITS;// HASH_BITS = 0x7fffffff;
}
HashMap扩容后是否需要rehash?
在JDK1.8以后,不需要rehash,因为键值对的Hash值主要是根据key的hashCode()的高16位与低16位进行异或计算后得到,根据hash%length,计算得到数组的下标index,因为length是2的整数次幂,当扩容后length变为原来的两倍时,hash%(2*length)的计算结果结果差别在于第length位的值是1还是0,如果是0,那么在新数组中的index与旧数组的一直,如果是1,在新数组中的index会是旧数组中的数组中的index+length。
HashMap扩容是怎样扩容的,为什么都是2的N次幂的大小?
触发扩容
在没有指定初始长度的情况下,HashMap数组的默认长度为16,在添加一个新的键值对时,会调用putVal()方法,在方法中,成功添加一个新的键值对以后,会判断当前的元素个数是否超过阀值(数组长度*负载因子0.75),如果超过那么调用resize方法进行扩容。具体的扩容步骤如下:
计算扩容后的长度
- ##### 如果当前table为null
那么直接初始化一个数组长度为16的数组返回。
- ##### 如果当前table的length已经大于HashMap指定的最大值2的30次方
那么直接返回旧table,不进行扩容。
- ##### 其他情况
将table的length扩容为2倍,然后计算新的扩容阀值(新数组长度*0.75)。
初始化新数组
会根据扩容后的数组长度初始化话一个新的数组,并且直接赋值给当前hashMap的成员变量table。
Node<K,V>[] newTab = (Node<K,V>[])new Node[newCap];
table = newTab;
这一步就很有意思,也是HashMap是非线程安全的表现之一,因为此时newTab还是一个空数组,如果有其他线程访问HashMap,根据key去newTab中找键值对,会返回null。实际上可能key是有对应的键值对的,只不过键值对都保存在旧table中,还没有迁移过来。
(与之相反,HashTable在解决扩容时其他线程访问的问题,是通过对大部分方法使用sychronized关键字修饰,也就是某个线程在执行扩容方法时,会对HashTable对象加锁,其他线程无法访问HashTable。ConcurrentHashMap在解决扩容时其他线程访问的问题,是通过设置ForwardingNode标识节点来解决的,扩容时,某个线程对数组中某个下标下所有Hash冲突的元素进行迁移时,那么会将数组下标的数组元素设置为一个标识节点ForwardingNode,之后其他线程在访问时,如果发现key的hash值映射的数组下标对应是一个标识节点ForwardingNode(ForwardingNode继承于普通Node,区别字啊呀这个节点的hash值会设置为-1,并且会多一个指向扩容过程中新tab的指针nextTable),那么会根据ForwardingNode中的nextTable变量,去新的tab中查找元素。(如果是添加新的键值对时发现是ForwardingNode,当前线程会进行辅助扩容或阻塞等待,扩容完成后去新数组中更新或插入元素)
迁移元素
因为HashMap的数组长度总是2的N次幂,扩容后也是变为原来的2倍,所以有一个数学公式,当length为2的N次幂时,
hash%length=hash&(length-1)而因为length是2的N次幂,length-1在二进制中其实是N个1。例如:
length为16,length用2进制表示是10000,
length-1是15,用2进制表示是1111,
2*length为32,length用2进制表示是100000,
2*length-1为31,length用2进制表示是11111,
所以hash&(length-1)的计算结果与hash&(2*length-1)的计算结果差别在于扩容后需要多看一位,也就是看第N位的1与hash值的&结果。
假设原数组长度为16,length-1二进制表示为1111。key1的hash值为9,二进制表示为01001,key2的hash值为25,11001,
所以hash&(length-1)的结果只要看低4位的结果,9和25的低4位都是1001,所以计算结果一致,计算结果都是9,所以在数组中处于数组下标为9的元素链表中。
扩容后数组长度为32,length-1二进制表示为11111,key1的hash值为9,二进制表示为01001,key2的hash值为25,11001,
所以hash&(2*length-1)的结果需要看低5位的结果,9和25的低4位都是1001,所以计算结果不一致,计算结果都是9和25,因为key2的hash值的第五位为1,key1的hash值的第五位为0,所以会多16,也就是原数组长度的大小。
所以原数组同一下标index下的链表存储的hash冲突的元素,扩容后在新数组中的下标newIndex要么为index,要么为index+length(去决定于hash值的第N位为1,还是0,也就是hash&length的结果,原数组长度length为2的N-1次幂)
所以会遍历链表(或者红黑树),然后对数组下标index下每个节点计算hash&length的结果,然后存放在两个不同的临时链表中,遍历完成后,hash&length结果为0的元素组成的临时链表会存储在新数组index位置,hash&length结果为1的元素组成的临时链表会存储在新数组index+length位置。
ConcurrentHashMap是怎么记录元素个数size的?
HashMap默认是非线程安全的,可以认为每次只有一个线程来执行操作,所以hashMap就使用一个很简单的int类型的size变量来记录HashMap键值对数量就行了。
HashMap记录键值对数量的实现如下:
transient int size;
public int size() {
	return size;
}
ConcurrentHashMap记录键值对数量的实现如下:
//size方法最大只能返回Integer.MAX_VALUE
public int size() {
    long n = sumCount();
    return ((n < 0L) ? 0 : (n > (long)Integer.MAX_VALUE) ?Integer.MAX_VALUE : (int)n);
}

//mappingCount方法可以返回long类型的最大值,
public long mappingCount() {
    long n = sumCount();
    return (n < 0L) ? 0L : n; // ignore transient negative values
}

private transient volatile long baseCount;
private transient volatile CounterCell[] counterCells;

//sumCount会返回sumCount加上CounterCells数组中每个元素as存储的value
final long sumCount() {
		CounterCell[] as = counterCells; CounterCell a;
		long sum = baseCount;
		if (as != null) {
				for (int i = 0; i < as.length; ++i) {
					if ((a = as[i]) != null)
							sum += a.value;
				}
		}
		return sum;
}

@sun.misc.Contended //这个注解可以避免伪共享,提升性能。加与不加,性能差距达到了 5 倍。在缓存系统中,由于一个缓存行是出于32-256个字节之间,常见的缓存行为64个字节。而一般的变量可能达不到那么多字节,所以会出现多个相互独立的变量存储在一个缓存行中的情况,此时即便多线程访问缓存行上相互独立变量时,也涉及到并发竞争,会有性能开销,加了@sun.misc.Contended这个注解,在jDK8中,会对对象前后都增加128字节的padding,使用2倍于大多数硬件缓存行的大小来避免相邻扇区预取导致的伪共享冲突。
static final class CounterCell {
    volatile long value;
    CounterCell(long x) { value = x; }
}
每次添加x个新的键值对后,会调用addCount()方法使用CAS操作对baseCount+x,如果操作失败,那么会新建一个CounterCell类型的对象,保存新增的数量x,并且将对象添加到CounterCells数组中去。
为什么ConcurrentHashMap,HashTable不支持key,value为null?
因为HashMap是非线程安全的,默认单线程环境中使用,如果get(key)为null,可以通过containsKey(key) 方法来判断这个key的value为null,还是不存在这个key,而ConcurrentHashMap,HashTable是线程安全的, 在多线程操作时,因为get(key)和containsKey(key)两个操作和在一起不是一个原子性操作,可能在containsKey(key)时发现存在这个键值对,但是get(key)时,有其他线程删除了键值对,导致get(key)返回的Node是null,然后执行方法时抛出异常。所以无法区分value为null还是不存在key。 至于ConcurrentHashMap,HashTable的key不能为null,主要是设计者的设计意图。
HashSet和HashMap的区别?
HashMap主要是用于存储非重复键值对,HashSet存储非重复的对象。虽然HashMap是继承于AbstractMap,实现了Map接口,HashSet继承于AbstractSet,实现了Set接口。但是由于它们都有去重的需求,所以HashSet主要实现都是基于HashMap的(如果需要复用一个类,我们可以使用继承模式,也可以使用组合模式。组合模式就是将一个类作为新类的组成部分,以此来达到复用的目的。)例如,在HashSet类中,有一个HashMap类型的成员变量map,这就是组合模式的应用。
    public class HashSet<E>
    extends AbstractSet<E>
    implements Set<E>, Cloneable, java.io.Serializable
{
    private transient HashMap<E,Object> map;
    private static final Object PRESENT = new Object();//占位对象
    public HashSet() {
        map = new HashMap<>();
    }
    public boolean add(E e) {
        return map.put(e, PRESENT)==null;//占位对象
    }
}
在HashSet的构造方法中,创建了一个HashMap,赋值给map属性,之后在添加元素时,就是将元素作为key添加到HashMap中,只不过value是一个占位对象PRESENT。除了 clone()、writeObject()、readObject()是 HashSet 自己不得不实现之外,其他方法都是直接调用 HashMap 中的方法。那么HashMap又是如何实现key不重复的呢?
在调用HashMap的putVal方法添加新的键值对时,会进行如下操作:
1.根据key计算hash值。
2.根据hash值映射数组下标,然后获取数组下标的对应的元素。
3.数组下标存储的是一个链表,链表包含了哈希冲突的元素,会对链表进行遍历,判断hash1==hash2,除此以外,还必须要key1==key2,或者key1.equals(key2)。
因为两个不同的对象的hashCode可能相等,但是相同的对象的hashCode肯定相等,
==是判断两个变量或实例是不是指向同一个内存地址,如果是同一个内存地址,对象肯定相等。
int hash = hash(key);//根据key计算hash值
p = tab[i = (n - 1) & hash];//根据hash值映射数组下标,然后获取数组下标的对应的元素。
for (int binCount = 0; ; ++binCount) {//数组下标存储的是一个链表,链表包含了哈希冲突的元素,会对链表进行遍历,判断每个节点的hash值与插入元素的hash值是否相等,并且是存储key对象的地址相等,或者key相等。
if (e.hash == hash &&
	((k = e.key) == key || (key != null && key.equals(k))))
		break;
		p = e;
}
HashMap遍历时删除元素的有哪些实现方法?
首先结论如下:
第1种方法 - for-each遍历HashMap.entrySet,使用HashMap.remove()删除(结果:抛出异常)。
第2种方法-for-each遍历HashMap.keySet,使用HashMap.remove()删除(结果:抛出异常)。
第3种方法-使用HashMap.entrySet().iterator()遍历删除(结果:正确删除)。
下面让我们来详细探究一下原因吧!
HashMap的遍历删除方法与ArrayList的大同小异,只是api的调用方式不同。首先初始化一个HashMap,我们要删除key包含"3"字符串的键值对。
HashMap<String,Integer> hashMap = new HashMap<String,Integer>();
hashMap.put("key1",1);
hashMap.put("key2",2);
hashMap.put("key3",3);
hashMap.put("key4",4);
hashMap.put("key5",5);
hashMap.put("key6",6);
第1种方法 - for-each遍历HashMap.entrySet,使用HashMap.remove()删除(结果:抛出异常)
for (Map.Entry<String,Integer> entry: hashMap.entrySet()) {
        String key = entry.getKey();
        if(key.contains("3")){
            hashMap.remove(entry.getKey());
        }
     System.out.println("当前HashMap是"+hashMap+" 当前entry是"+entry);

}
输出结果:
当前HashMap是{key1=1, key2=2, key5=5, key6=6, key3=3, key4=4} 当前entry是key1=1
当前HashMap是{key1=1, key2=2, key5=5, key6=6, key3=3, key4=4} 当前entry是key2=2
当前HashMap是{key1=1, key2=2, key5=5, key6=6, key3=3, key4=4} 当前entry是key5=5
当前HashMap是{key1=1, key2=2, key5=5, key6=6, key3=3, key4=4} 当前entry是key6=6
当前HashMap是{key1=1, key2=2, key5=5, key6=6, key4=4} 当前entry是key3=3
Exception in thread "main" java.util.ConcurrentModificationException
	at java.util.HashMap$HashIterator.nextNode(HashMap.java:1429)
	at java.util.HashMap$EntryIterator.next(HashMap.java:1463)
	at java.util.HashMap$EntryIterator.next(HashMap.java:1461)
	at com.test.HashMapTest.removeWayOne(HashMapTest.java:29)
	at com.test.HashMapTest.main(HashMapTest.java:22)
第2种方法-for-each遍历HashMap.keySet,使用HashMap.remove()删除(结果:抛出异常)
Set<String> keySet = hashMap.keySet();
for(String key : keySet){
    if(key.contains("3")){
        keySet.remove(key);
    }
    System.out.println("当前HashMap是"+hashMap+" 当前key是"+key);
}
输出结果如下:
当前HashMap是{key1=1, key2=2, key5=5, key6=6, key3=3, key4=4} 当前key是key1
当前HashMap是{key1=1, key2=2, key5=5, key6=6, key3=3, key4=4} 当前key是key2
当前HashMap是{key1=1, key2=2, key5=5, key6=6, key3=3, key4=4} 当前key是key5
当前HashMap是{key1=1, key2=2, key5=5, key6=6, key3=3, key4=4} 当前key是key6
当前HashMap是{key1=1, key2=2, key5=5, key6=6, key4=4} 当前key是key3
Exception in thread "main" java.util.ConcurrentModificationException
	at java.util.HashMap$HashIterator.nextNode(HashMap.java:1429)
	at java.util.HashMap$KeyIterator.next(HashMap.java:1453)
	at com.test.HashMapTest.removeWayTwo(HashMapTest.java:40)
	at com.test.HashMapTest.main(HashMapTest.java:23)
第3种方法-使用HashMap.entrySet().iterator()遍历删除(结果:正确删除)
Iterator<Map.Entry<String, Integer>> iterator  = hashMap.entrySet().iterator();
while (iterator.hasNext()) {
    Map.Entry<String, Integer> entry = iterator.next();
    if(entry.getKey().contains("3")){
        iterator.remove();
    }
    System.out.println("当前HashMap是"+hashMap+" 当前entry是"+entry);
}
输出结果:
当前HashMap是{key1=1, key2=2, key5=5, key6=6, key4=4, deletekey=3} 当前entry是key1=1
当前HashMap是{key1=1, key2=2, key5=5, key6=6, key4=4, deletekey=3} 当前entry是key2=2
当前HashMap是{key1=1, key2=2, key5=5, key6=6, key4=4, deletekey=3} 当前entry是key5=5
当前HashMap是{key1=1, key2=2, key5=5, key6=6, key4=4, deletekey=3} 当前entry是key6=6
当前HashMap是{key1=1, key2=2, key5=5, key6=6, key4=4, deletekey=3} 当前entry是key4=4
当前HashMap是{key1=1, key2=2, key5=5, key6=6, key4=4} 当前entry是deletekey=3
第1种方法和第2种方法抛出ConcurrentModificationException异常与上面ArrayList错误遍历-删除方法的原因一致,HashIterator也有一个expectedModCount,在遍历时获取下一个元素时,会调用next()方法,然后对 expectedModCount和modCount进行判断,不一致就抛出ConcurrentModificationException异常。
abstract class HashIterator {
    Node<K,V> next;        // next entry to return
    Node<K,V> current;     // current entry
    int expectedModCount;  // for fast-fail
    int index;             // current slot

    HashIterator() {
        expectedModCount = modCount;
        Node<K,V>[] t = table;
        current = next = null;
        index = 0;
        if (t != null && size > 0) { // advance to first entry
            do {} while (index < t.length && (next = t[index++]) == null);
        }
    }

    public final boolean hasNext() {
        return next != null;
    }

    final Node<K,V> nextNode() {
        Node<K,V>[] t;
        Node<K,V> e = next;
        if (modCount != expectedModCount)
            throw new ConcurrentModificationException();
        if (e == null)
            throw new NoSuchElementException();
        if ((next = (current = e).next) == null && (t = table) != null) {
            do {} while (index < t.length && (next = t[index++]) == null);
        }
        return e;
    }

    public final void remove() {
        Node<K,V> p = current;
        if (p == null)
            throw new IllegalStateException();
        if (modCount != expectedModCount)
            throw new ConcurrentModificationException();
        current = null;
        K key = p.key;
        removeNode(hash(key), key, null, false, false);
        expectedModCount = modCount;
    }
}
PS:ConcurrentModificationException是什么?
根据ConcurrentModificationException的文档介绍,一些对象不允许并发修改,当这些修改行为被检测到时,就会抛出这个异常。(例如一些集合不允许一个线程一边遍历时,另一个线程去修改这个集合)。
一些集合(例如Collection, Vector, ArrayList,LinkedList, HashSet, Hashtable, TreeMap, AbstractList, Serialized Form)的Iterator实现中,如果提供这种并发修改异常检测,那么这些Iterator可以称为是"fail-fast Iterator",意思是快速失败迭代器,就是检测到并发修改时,直接抛出异常,而不是继续执行,等到获取到一些错误值时在抛出异常。
异常检测主要是通过modCount和expectedModCount两个变量来实现的,
- modCount
集合被修改的次数,一般是被集合(ArrayList之类的)持有,每次调用add(),remove()方法会导致modCount+1
- expectedModCount
期待的modCount,一般是被Iterator(ArrayList.iterator()方法返回的iterator对象)持有,一般在Iterator初始化时会赋初始值,在调用Iterator的remove()方法时会对expectedModCount进行更新。(可以看看上面的ArrayList.Itr源码)
然后在Iterator调用next()遍历元素时,会调用checkForComodification()方法比较modCount和expectedModCount,不一致就抛出ConcurrentModificationException。
单线程操作Iterator不当时也会抛出ConcurrentModificationException异常。(上面的例子就是)
总结
因为ArrayList和HashMap的Iterator都是上面所说的“fail-fast Iterator”,Iterator在获取下一个元素,删除元素时,都会比较expectedModCount和modCount,不一致就会抛出异常。
所以当使用Iterator遍历元素(for-each遍历底层实现也是Iterator)时,需要删除元素,一定需要使用 Iterator的remove()方法 来删除,而不是直接调用ArrayList或HashMap自身的remove()方法,否则会导致Iterator中的expectedModCount没有及时更新,之后获取下一个元素或者删除元素时,expectedModCount和modCount不一致,然后抛出ConcurrentModificationException异常。
谈一谈你对LinkedHashMap的理解?
LinkedHashMap是HashMap的子类,与HashMap的实现基本一致,只是说在HashMap的基础上做了一些扩展,所有的节点都有一个before指针和after指针,根据插入顺序形成一个双向链表。默认accessOrder是false,也就是按照插入顺序来排序的,每次新插入的元素都是插入到链表的末尾。map.keySet().iterator().next()第一个元素是最早插入的元素的key。LinkedHashMap可以用来实现LRU算法。(accessOrder为true,会按照访问顺序来排序。)
 LRU算法实现:
//使用LinkedHashMap实现LRU算法(accessOrder为false的实现方式)
// LinkedHashMap默认的accessOrder为false,也就是会按照插入顺序排序,
// 所以在插入新的键值对时,总是添加在队列尾部,
// 如果是访问已存在的键值对,或者是put操作的键值对已存在,那么需要将键值对先移除再添加。
public class LRUCache{
    int capacity;
    Map<Integer, Integer> map;
    public LRUCache(int capacity) {
        this.capacity = capacity;
        map = new LinkedHashMap<>();
    }
    public int get(int key) {
        if (!map.containsKey(key)) { return -1; }
        //先删除旧的位置,再放入新位置
        Integer value = map.remove(key);
        map.put(key, value);
        return value;
    }
    public void put(int key, int value) {
        if (map.containsKey(key)) {
            map.remove(key);
            map.put(key, value);
            return;
        }
        //超出capacity,删除最久没用的,利用迭代器,删除第一个
        if (map.size() > capacity) {
  	map.remove(map.keySet().iterator().next());
        }
        map.put(key, value);
    }
}
下面是另外一种实现方法:
//使用LinkedHashMap实现LRU算法(accessOrder为true的实现方式)
//如果是将accessOrder设置为true,get和put已有键值对时就不需要删除key了
public static class LRUCache2 {
    int capacity;
    LinkedHashMap<Integer, Integer> linkedHashMap;
    LRUCache2(int capacity) {
      this.capacity = capacity;
      linkedHashMap = new LinkedHashMap<Integer, Integer>(16,0.75f,true);
    }
    public int get(int key) {
      Integer value = linkedHashMap.get(key);
      return value == null ? -1 : value;
    }
    public void put(int key, int val) {
      Integer value = linkedHashMap.get(key);
      linkedHashMap.put(key, val);
      if (linkedHashMap.size() > capacity) {
       linkedHashMap.remove(linkedHashMap.keySet().iterator().next());
      }
    }
}
LinkedHashMap是怎么保存节点的插入顺序或者访问顺序的呢?
默认accessOrder为false,保存的是插入顺序,插入时调用的还是父类HashMap的putVal()方法,在putVal()中创建新节点时是会调用newNode()方法来创建一个节点,在newNode()方法中会调用linkNodeLast()方法将节点添加到双向链表的尾部。
final V putVal(int hash, K key, V value, boolean onlyIfAbsent,
                   boolean evict) {
//省略了部分代码...
tab[i] = newNode(hash, key, value, null);
//省略了部分代码...
}
//创建新节点
Node<K,V> newNode(int hash, K key, V value, Node<K,V> e) {
		LinkedHashMap.Entry<K,V> p = new LinkedHashMap.Entry<K,V>(hash, key, value, e);
		linkNodeLast(p);
		return p;
}
//移动到双向链表尾部
private void linkNodeLast(LinkedHashMap.Entry<K,V> p) {
    LinkedHashMap.Entry<K,V> last = tail;
    tail = p;
    if (last == null) head = p;
    else {
    		p.before = last;
    		last.after = p;
    }
}
如果accessOrder为true,会保存访问顺序,在访问节点时,会调用afterNodeAccess()方法将节点先从双向链表移除,然后添加到链表尾部。
public class LinkedHashMap<K,V>
    extends HashMap<K,V>
    implements Map<K,V>
{
//头结点,指向最老的元素
    transient LinkedHashMap.Entry<K,V> head;
//尾节点,指向最新的元素
    transient LinkedHashMap.Entry<K,V> tail;
//如果accssOrder为true,代表节点需要按照访问顺序排列,每次访问了元素,会将元素移动到尾部(代表最新的节点)。
public V get(Object key) {
        Node<K,V> e;
        if ((e = getNode(hash(key), key)) == null)
            return null;
        if (accessOrder)
            afterNodeAccess(e);
        return e.value;
}
//将节点从双向链表中删除,移动到尾部。
void afterNodeAccess(Node<K,V> e) { // move node to last
        LinkedHashMap.Entry<K,V> last;
        if (accessOrder && (last = tail) != e) {
            LinkedHashMap.Entry<K,V> p =
                (LinkedHashMap.Entry<K,V>)e,
            b = p.before, a = p.after;
            p.after = null;
            if (b == null) head = a;
            else b.after = a;
            if (a != null) a.before = b;
            else last = b;
            if (last == null) head = p;
            else {
                p.before = last;
                last.after = p;
            }
            tail = p;
            ++modCount;
        }
    }
}
JDK1.7的HashMap链表成环是怎么造成的?
这是JDK1.7里面HashMap扩容相关的代码:
void transfer(Entry[] newTable, boolean rehash) {
    int newCapacity = newTable.length;
    for (Entry<K,V> e : table) {//遍历原数组的每一个下标
        while(null != e) {
        		//将数组下标下所有元素一个一个迁移到新数组,使用头插法
            Entry<K,V> next = e.next;
            if (rehash) {
                e.hash = null == e.key ? 0 : hash(e.key);
            }
            int i = indexFor(e.hash, newCapacity);
            e.next = newTable[i];
            newTable[i] = e;
            e = next;
        }
    }
}
JDK1.7版本的HashMap中,两个线程同时添加一个新的键值对,然后同时触发扩容时,两个线程都会进行扩容,就会造成前一个线程将某个数组下标的元素迁移过去后,另一个线程又进行迁移。假设原数组下标下有node1->node2->null,这样一个链表,线程A和线程B都在迁移,都拿到了node1,假设线程A先执行,将两个节点迁移到新的数组,假设node1和node2在新数组还是在同一下标下,那么迁移后的链表是node2->node1->null,此时如果线程B还在迁移,拿到node1又迁移,会让node1-next=node,从而让node1和node2形成环。
那么JDK1.8版本的HashMap是怎么解决的呢?
首先迁移时不是拿到一个键值对就迁移一个了,而是对一个数组下标下的链表进行遍历,根据hash值的不同,分成两个链表,然后将两个链表分别设置到新的数组的下标下。
if (oldTab != null) {
            for (int j = 0; j < oldCap; ++j) {
                Node<K,V> e;
                if ((e = oldTab[j]) != null) {
                    oldTab[j] = null;
                    if (e.next == null)
                        newTab[e.hash & (newCap - 1)] = e;
                    else if (e instanceof TreeNode)
                        ((TreeNode<K,V>)e).split(this, newTab, j, oldCap);
                    else { // preserve order
                        Node<K,V> loHead = null, loTail = null;
                        Node<K,V> hiHead = null, hiTail = null;
                        Node<K,V> next;
                        do {
                            next = e.next;
                            if ((e.hash & oldCap) == 0) {
                                if (loTail == null)
                                    loHead = e;
                                else
                                    loTail.next = e;
                                loTail = e;
                            }
                            else {
                                if (hiTail == null)
                                    hiHead = e;
                                else
                                    hiTail.next = e;
                                hiTail = e;
                            }
                        } while ((e = next) != null);
                        if (loTail != null) {
                            loTail.next = null;
                            newTab[j] = loHead;
                        }
                        if (hiTail != null) {
                            hiTail.next = null;
                            newTab[j + oldCap] = hiHead;
                        }
                    }
                }
            }
        }
https://zhuanlan.zhihu.com/p/111501405
JavaMultiThread
(PS:扫描首页里面的二维码进群,分享我自己在看的技术资料给大家,希望和大家一起学习进步!)
多线程专题
1.进程与线程的区别是什么?
2.进程间如何通信?
3.Java中单例有哪些写法?
4.Java中创建线程有哪些方式?
5.如何解决序列化时可以创建出单例对象的问题?
6.volatile关键字有什么用?怎么理解可见性,一般什么场景去用可见性?
7.Java中线程的状态是怎么样的?
8.wait(),join(),sleep()方法有什么作用?,join(),sleep()方法有什么作用?)
9.Thread.sleep(),Object.wait(),LockSupport.park()有什么区别?,Object.wait(),LockSupport.park()有什么区别?)
10.谈一谈你对线程中断的理解?
11.线程间怎么通信?
12.怎么实现实现一个生产者消费者?
13.谈一谈你对线程池的理解?
14.线程池有哪些状态?
进程与线程的区别是什么?
批处理操作系统
批处理操作系统就是把一系列需要操作的指令写下来,形成一个清单,一次性交给计算机。用户将多个需要执行的程序写在磁带上,然后交由计算机去读取并逐个执行这些程序,并将输出结果写在另一个磁带上。
批处理操作系统在一定程度上提高了计算机的效率,但是由于批处理操作系统的指令运行方式仍然是串行的,内存中始终只有一个程序在运行,后面的程序需要等待前面的程序执行完成后才能开始执行,而前面的程序有时会由于I/O操作、网络等原因阻塞,导致CPU闲置所以批处理操作效率也不高。
进程的提出
批处理操作系统的瓶颈在于内存中只存在一个程序,进程的提出,可以让内存中存在多个程序,每个程序对应一个进程,进程是操作系统资源分配的最小单位。CPU采用时间片轮转的方式运行进程:CPU为每个进程分配一个时间段,称作它的时间片。如果在时间片结束时进程还在运行,则暂停这个进程的运行,并且CPU分配给另一个进程(这个过程叫做上下文切换)。如果进程在时间片结束前阻塞或结束,则CPU立即进行切换,不用等待时间片用完。多进程的好处在于一个在进行IO操作时可以让出CPU时间片,让CPU执行其他进程的任务。
线程的提出
随着计算机的发展,对CPU的要求越来越高,进程之间的切换开销较大,已经无法满足越来越复杂的程序的要求了。于是就发明了线程,线程是程序执行中一个单一的顺序控制流程,是程序执行流的最小单元,是处理器调度和分派的基本单位。一个进程可以有一个或多个线程,各个线程之间共享程序的内存空间(也就是所在进程的内存空间)。
进程和线程的区别
进程是计算机中已运行程序的实体,进程是操作系统资源分配的最小单位。而线程是在进程中执行的一个任务,是CPU调度和执行的最小单位。他们两个本质的区别是是否单独占有内存地址空间及其它系统资源(比如I/O):
- 进程单独占有一定的内存地址空间,所以进程间存在内存隔离,数据是分开的,数据共享复杂但是同步简单,各个进程之间互不干扰;而线程共享所属进程占有的内存地址空间和资源,数据共享简单,但是同步复杂。
- 进程单独占有一定的内存地址空间,一个进程出现问题不会影响其他进程,不影响主程序的稳定性,可靠性高;一个线程崩溃可能影响整个程序的稳定性,可靠性较低。
- 进程单独占有一定的内存地址空间,进程的创建和销毁不仅需要保存寄存器和栈信息,还需要资源的分配回收以及页调度,开销较大;线程只需要保存寄存器和栈信息,开销较小。
另外一个重要区别是,进程是操作系统进行资源分配的基本单位,而线程是操作系统进行调度的基本单位,即CPU分配时间的单位 。
独立性
Linux系统会给每个进程分配4G的虚拟地址空间(0到3G是User地址空间,3到4G部分是kernel地址空间),进程具备私有的地址空间,未经允许,一个用户进程不能访问其他进程的地址空间。
动态性
程序是一个静态的指令集合,而进程是正在操作系统中运行的指令集合,进程有自己的生命周期和各种不同的状态。
五态模型一般指的是:
新建态(创建一个进程)
就绪态(已经获取到资源,准备好了,进入运行队列,一旦获得时间片可以立即执行)
运行态(获取到了时间片,执行程序)
阻塞态(运行过程中等待获取其他资源,I/O请求等)
终止态(进程被杀死了)
并发性
多个进程可以在CPU上并发执行。 线程是独立运行和调度的最小单位,线程会共享进程的虚拟空间,一个进程会对应多个线程。在Java中,线程拥有自己私有的程序计数器,虚拟机栈,本地方法栈。
PS:虚拟内存
虚拟内存是一种逻辑上扩充物理内存的技术。基本思想是用软、硬件技术把内存与外存这两级存储器当做一级存储器来用。虚拟内存技术的实现利用了自动覆盖和交换技术。简单的说就是将硬盘的一部分作为内存来使用。
PS:虚拟地址空间
每个进程有4G的地址空间,在运行程序时,只有一部分数据是真正加载到内存中的,内存管理单元将虚拟地址转换为物理地址,如果内存中不存在这部分数据,那么会使用页面置换方法,将内存页置换出来,然后将外存中的数据加入到内存中,使得程序正常运行。
进程间如何通信?
进程间通信的方式主要有管道,
管道
调用pipe函数在内存中开辟一块缓冲区,管道半双工的(即数据只能在一个方向上流动),具有固定的读端和写端,调用
#include <unistd.h>
int pipe(int pipefd[2]);
Java中创建线程有哪些方式?
第一种 继承Thread类,重写Run方法
这种方法就是通过自定义CustomThread类继承Thread类,重写run()方法,然后创建CustomThread的对象,然后调用start()方法,JVM会创建出一个新线程,并且为线程创建方法调用栈和程序计数器,此时线程处于就绪状态,当线程获取CPU时间片后,线程会进入到运行状态,会去调用run()方法。并且创建CustomThread类的对象的线程(这里的例子中是主线程)与调用run()方法的线程之间是并发的,也就是在执行run()方法时,主线程可以去执行其他操作。
class CustomThread extends Thread {
    public static void main(String[] args) {
        System.out.println(Thread.currentThread().getName()+"线程调用了main方法");
        for (int i = 0; i < 10; i++) {
            if (i == 1) {
                CustomThread customThread = new CustomThread();
                customThread.start();
                System.out.println(Thread.currentThread().getName()+"线程--i是"+i);
            }
        }
        System.out.println("main()方法执行完毕!");
    }
    void run() {
        System.out.println(Thread.currentThread().getName()+"线程调用了run()方法");
        for (int j = 0; j < 5; j++) {
            System.out.println(Thread.currentThread().getName()+"线程--j是"+j);
        }
        System.out.println("run()方法执行完毕!");
    }
}
输出结果如下:
main线程调用了main方法
Thread-0线程调用了run()方法
Thread-0线程--j是0
main线程--i是1
Thread-0线程--j是2
Thread-0线程--j是3
Thread-0线程--j是4
run()方法执行完毕!
main()方法执行完毕!
可以看到在创建一个CustomThread对象,调用start()方法后,Thread-0调用了run方法,进行for循环,对j进行打印,与此同时,main线程并没有被阻塞,而是继续执行for循环,对i进行打印。
执行原理
首先我们可以来看看start的源码,首先会判断threadStatus是否为0,如果不为0会抛出异常。然后会将当前对象添加到线程组,最后调用start0方法,因为是native方法,看不到源码,根据上面的执行结果来看,JVM新建了一个线程调用了run方法。
private native void start0();

public synchronized void start() {
   	//判断当前Thread对象是否是新建态,否则抛出异常
    if (threadStatus != 0)
        throw new IllegalThreadStateException();
    //将当前对象添加到线程组
    group.add(this);
    boolean started = false;
    try {
        start0();//这是一个native方法,调用后JVM会新建一个线程来调用run方法
        started = true;
    } finally {
        try {
            if (!started) {
                group.threadStartFailed(this);
            }
        } catch (Throwable ignore) {
            /* do nothing. If start0 threw a Throwable then
              it will be passed up the call stack */
        }
    }
}
扩展问题:多次调用Thread对象的start()方法会怎么样?
会抛出IllegalThreadStateException异常。其实在Thread#start()方法里面的的注释中有提到,多次调用start()方法是非法的,所以在上面的start()方法源码中一开始就是对threadStatus进行判断,不为0就会抛出IllegalThreadStateException异常。
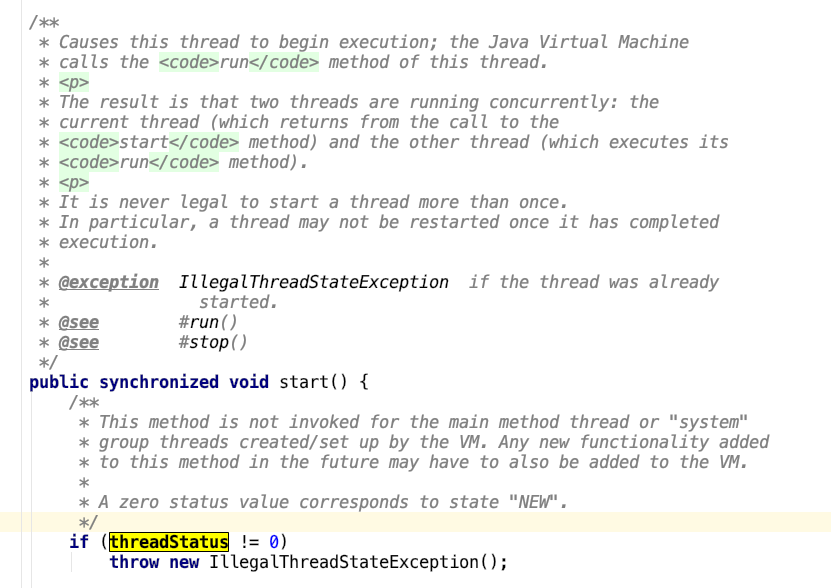
注意事项:
start()方法中判断threadStatus是否为0,是判断当前线程是否新建态,0是代表新建态(上图中的源码注释里面有提到),而不是就绪态,因为Java的Thread类中,Thread的Runnable状态包括了线程的就绪态和运行态,(Thread的state为RUNNABLE时(也就是threadStatus为4时),代表线程为就绪态或运行态)。执行start()方法的线程还不是JVM新建的线程,所以不是就绪态。有一些技术文章把这里弄错了,例如这一篇《深入浅出线程Thread类的start()方法和run()方法》
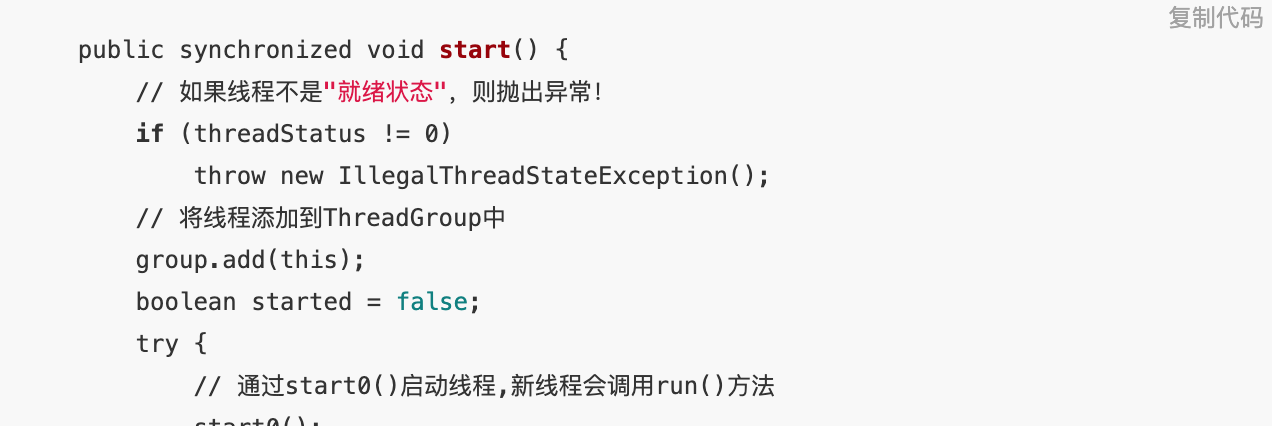
总结
这种方式的缺点很明显,就是需要继承Thread类,而且实际上我们的需求可能仅仅是希望某些操作被一个其他的线程来执行,所以有了第二种方法。
第二种 实现Runnable接口
这种方式就是创建一个类(例如下面代码中的Target类),实现Runnable接口的Run方法,然后将Target类的实例对象作为Thread的构造器入参target,实际的线程对象还是Thread实例,只不过线程Thread与线程执行体(Target类的run方法)分离了,耦合度更低一些。
class ThreadTarget implements Runnable {
    void run() {
        System.out.println(Thread.currentThread().getName()+"线程执行了run方法");
    }
    public static void main(String[] args) {
        System.out.println(Thread.currentThread().getName()+"线程执行了main方法");
        ThreadTarget target = new ThreadTarget();
        Thread thread = new Thread(target);
        thread.start();
    }
}
输出结果如下:

原理
之所以有这种实现方法,是因为Thread类的run()方法中会判断成员变量target是否为空,不为空就会调用target类的run方法。
private Runnable target;
public void run() {
    if (target != null) {
    		target.run();
    }
}
另外一种写法
这种实现方式也有其他的写法,可以不创建Target类。
匿名内部类
可以不创建Target类,可以使用匿名内部类的方式来实现,因此上面的代码也可以按以下方式写:
Thread thread = new Thread(new Runnable() {
    @Override
    public void run() {
      		System.out.println(Thread.currentThread().getName()+"线程执行了run方法");
    }
});
thread.start();
Lamda表达式
在Java8之后,使用了@FunctionalInterface注解来修饰Runnable接口,表明Runnable接口是一个函数式接口,有且只有一个抽象方法,可以Lambda方式来创建Runnable对象,比使用匿名类的方式更加简洁一些。
@FunctionalInterface
public interface Runnable {
    public abstract void run();
}
因此上面的代码也可以按以下方式写:
Thread thread = new Thread(()->{
      System.out.println(Thread.currentThread().getName()+"线程执行了run方法");
})
thread.start()
总结
这种写法不用继承Thread,但是同样也有缺点,就是线程方法体(也就是run方法)不能设置返回值。
第三种 实现Callable接口
Runnable接口中的run()方法是没有返回值,如果我们需要执行的任务带返回值就不能使用Runnable接口。创建一个类CallableTarget,实现Callable接口,实现带有返回值的call()方法,然后根据CallableTarget创建一个任务FutureTask,然后根据FutureTask来创建一个线程Thread,调用Thread的start方法可以执行任务。
public class CallableTarget implements Callable<Integer> {
    public Integer call() throws InterruptedException {
        System.out.println(Thread.currentThread().getName()+"线程执行了call方法");
        Thread.sleep(5000);
        return 1;
    }
    public static void main(String[] args) throws ExecutionException, InterruptedException {
        System.out.println(Thread.currentThread().getName()+"线程执行了main方法");
        CallableTarget callableTarget = new CallableTarget();
        FutureTask<Integer> task = new FutureTask<Integer>(callableTarget);
        Thread thread = new Thread(task);
        thread.start();
        Integer result = task.get();//当前线程会阻塞,一直等到结果返回。
        System.out.println("执行完毕,打印result="+result);
        System.out.println("执行完毕");
    }
}
原理就是Thread类默认的run()方法实现是会去调用自身实例变量target的run()方法,(target就是我们构造Thread传入的FutureTask),而FutureTask的run方法中就会调用Callable接口的实例的call()方法。
//Thread类的run方法实现
@Override
public void run() {
  if (target != null) {
    //这里target就是我们在创建Thread时传入的FutureTask实例变量
    target.run();
  }
}
//FutureTask类的run方法实现
public void run() {
  if (state != NEW ||
      !UNSAFE.compareAndSwapObject(this, runnerOffset,
                                   null, Thread.currentThread()))
    return;
  try {
    Callable<V> c = callable;
    if (c != null && state == NEW) {
      V result;
      boolean ran;
      try {
        //在这里会调用Callable实例的call方法
        result = c.call();
        ran = true;
      } catch (Throwable ex) {
        result = null;
        ran = false;
        setException(ex);
      }
      if (ran)
        set(result);
    }
  } finally {
    // runner must be non-null until state is settled to
    // prevent concurrent calls to run()
    runner = null;
    // state must be re-read after nulling runner to prevent
    // leaked interrupts
    int s = state;
    if (s >= INTERRUPTING)
      handlePossibleCancellationInterrupt(s);
  }
}
Java中的Runnable、Callable、Future、FutureTask的区别和联系?
最原始的通过新建线程执行任务的方法就是我们去新建一个类,继承Thread,然后去重写run()方法,但是这样限制太大了,Java也不支持多继承。所以有了Runnable。
Runnable
Runnable是一个接口,只需要新建一个类实现这个接口,然后重写run方法,将该类的实例作为创建Thread的入参,线程运行时就会调用该实例的run方法。
@FunctionalInterfacepublic interface Runnable {
 public abstract void run();
}
Thread.start()方法->Thread.run()方法->target.run()方法
Callable
Callable跟Runnable类似,也是一个接口。只不过它的call方法有返回值,可以供程序接收任务执行的结果。
@FunctionalInterfacepublic interface Callable<V> {
  V call() throws Exception;
}
Future
Future也是一个接口,Future就像是一个管理的容器一样,进一步对Runable和Callable的实例进行封装,定义了一些方法。取消任务的cancel()方法,查询任务是否完成的isDone()方法,获取执行结果的get()方法,带有超时时间来获取执行结果的get()方法。
public interface Future<V> {
  //mayInterruptIfRunning代表是否强制中断
  //为true,如果任务已经执行,那么会调用Thread.interrupt()方法设置中断标识
  //为false,如果任务已经执行,就只会将任务状态标记为取消,而不会去设置中断标识
 boolean cancel(boolean mayInterruptIfRunning);
 boolean isCancelled();
 boolean isDone();
 V get() throws InterruptedException, ExecutionException;
 V get(long timeout, TimeUnit unit)
   throws InterruptedException, ExecutionException, TimeoutException;
}
FutureTask
因为Future只是一个接口,并不能实例化,可以认为FutureTask就是Future接口的实现类,FutureTask实现了RunnableFuture接口,而RunnableFuture接口继承Runnable接口和Future接口。
public class FutureTask<V> implements RunnableFuture<V> {
...
}

public interface RunnableFuture<V> extends Runnable, Future<V> {
    void run();
}
使用案例
使用时,Runnable实现类的实例可以作为Thread的入参使用,而Callable只能使用FutureTask进行封装使用。
//Runnable配合Thread进行使用
Thread threadA = new Thread(new Runnable() {
   @Override
      public void run() {
			//任务的代码
      }
 });

//Callable使用FutureTask封装后,配合线程池进行使用
ExecutorService pool = Executors.newSingleThreadExecutor();
FutureTask task = new FutureTask(new Callable() {
        @Override
        public Object call() throws Exception {
          //任务的代码
          return null;
        }
});
pool.submit(task);

//Runnable使用FutureTask封装后,配合线程池进行使用
FutureTask task1 = new FutureTask(new Runnable() {
      @Override
      public void run() {
   				//任务的代码
      }
});
pool.submit(task1);
Java中单例有哪些写法?
正确并且可以做到延迟加载的写法其实就是三种:
1.使用volatile修饰变量并且双重校验的写法来实现。
2.使用静态内部类来实现(类A有一个静态内部类B,类B有一个静态变量instance,类A的getInstance()方法会返回类B的静态变量instance,因为只有调用getInstance()方法时才会加载静态内部类B,这种写法缺点是不能传参。)
3.使用枚举来实现
第1种 不加锁(裸奔写法)
多线程执行时,可能会在instance完成初始化之前,其他线性线程判断instance为null,从而也执行第二步的代码,导致初始化覆盖。
public class UnsafeLazyInitialization {
	private static Instance instance;
	public static Instance getInstance() {
    if (instance == null) //1
      instance = new Instance(); //2
    }
    return instance;
}
第2种-对方法加sychronize锁(俗称的懒汉模式)
初始化完成以后,每次调用getInstance()方法都需要获取同步锁,导致不必要的开销。
public class Singleton {
    private static Singleton instance;
    public synchronized static Singleton getInstance() {
        if (instance == null)
            instance = new Instance();
        return instance;
    }
}
第3种-使用静态变量(俗称的饿汉模式)
public class Singleton {
    private static Singleton instance = new Singleton();
    public static Singleton getInstance() {
        return instance;
    }
}
这种方法是缺点在于不能做到延时加载,在第一次调用getInstance()方法之前,如果Singleton类被使用到,那么就会对instance变量初始化。
第4种-使用双重检查锁定
代码如下:
public class Singleton {
    private static Singleton instance;
    public static Singleton getInstance() {
        if (instance == null) {
            synchronized (Singleton.class) {
                if (instance == null) { //双重检查存在的意义在于可能会有多个线程进入第一个判断,然后竞争同步锁,线程A得到了同步锁,创建了一个Singleton实例,赋值给instance,然后释放同步锁,此时线程B获得同步锁,又会创建一个Singleton实例,造成初始化覆盖。
                    instance = new Singleton();
                }
            }
        }
        return instance;
    }
}
instance = new Singleton();
这句代码在执行时会分解为三个步骤:
1.为对象分配内存空间。
2.执行初始化的代码。
3.将分配好的内存地址设置给instance引用。
但是编译器会对指令进行重排序,只能保证单线程执行时结果不会变化,也就是可能第3步会在第2步之前执行,某个线程A刚好执行完第3步,正在执行第2步时,此时如果有其他线程B进入if (instance == null)判断,会发现instance不为null,然后将instance返回,但是实际上instance还没有完成初始化,线程B会访问到一个未初始化完成的instance对象。所以需要像第5种解法一样使用volatile来修饰变量,防止重排序。
第5种 基于 volatile 的双重检查锁定的解决方案
代码如下:
public class Singleton {
    private volatile static Singleton instance;
    public static Singleton getInstance() {
        if (instance == null) {
            synchronized (Singleton.class) {
                if (instance == null)//双重检查存在的意义在于可能会有多个线程进入第一个判断,然后竞争同步锁,线程A得到了同步锁,创建了一个Singleton实例,赋值给instance,然后释放同步锁,此时线程B获得同步锁,又会创建一个Singleton实例,造成初始化覆盖。
                    instance = new Singleton();
            }
        }
        return instance;
    }
}
volatile可以保证变量的内存可见性及防止指令重排。
volatile修饰的变量在编译后,会多出一个lock前缀指令,lock前缀指令相当于一个内存屏障(内存栅栏),有三个作用:
- 确保指令重排序时,内存屏障前的指令不会排到后面去,内存屏障后的指令不会排到前面去。
- 强制对变量在线程工作内存中的修改操作立即写入到物理内存。
- 如果是写操作,会导致其他CPU中对这个变量的缓存失效,强制其他CPU中的线程在获取变量时从物理内存中获取更新后的值。
所以使用volatile修饰后不会出现第3种写法中由于指令重排序导致的问题。
第6种 - 使用静态内部类来实现
class Test {
    public static Signleton getInstance() {
        return Signleton.instance ;  // 只有调用getInstance()方法时,才会引用到静态内部类Signleton,从而会触发Signleton类的instance变量的初始化,以此实现懒加载的目的。
    }

     private static class Signleton {
        private static Signleton instance = new Signleton();
    }
}
因为JVM底层通过加锁实现,保证一个类只会被加载一次,多个线程在对类进行初始化时,只有一个线程会获得锁,然后对类进行初始化,其他线程会阻塞等待。所以可以使用上面的代码来保证instance只会被初始化一次,这种写法的问题在于创建单例时不能传参。
7.使用枚举来实现单例
public enum Singleton {
    //每个元素就是一个单例
    INSTANCE;
    //自定义的一些方法
    public void method(){}
}
这种写法比较简洁,但是不太便于阅读和理解,所以实际开发中应用得比较少,而且由于枚举类是不能通过反射来创建实例的(反射方法newInstance中判断是枚举类型,会抛出IllegalArgumentException异常),所以可以防止反射。而且由于枚举类型的反序列化是通过java.lang.Enum的valueOf方法来实现的,不能自定义序列化方法,可以防止通过序列化来创建多个单例。
如何解决序列化时可以创建出单例对象的问题?
如果将单例对象序列化成字节序列后,然后再反序列成对象,那么就可以创建出一个新的单例对象,从而导致单例不唯一,避免发生这种情况的解决方案是在单例类中实现readResolve()方法。
public class Singleton implements java.io.Serializable {

   private Object readResolve() {
         return INSTANCE;
    }
}
通过实现readResolve方法,ObjectInputStream实例对象在调用readObject()方法进行反序列化时,就会判断相应的类是否实现了readResolve()方法,如果实现了,就会调用readResolve()方法返回一个对象作为反序列化的结果,而不是去创建一个新的对象。
volatile关键字有什么用?怎么理解可见性,一般什么场景去用可见性?
当线程进行一个volatile变量的写操作时,JIT编译器生成的汇编指令会在写操作的指令后面加上一个“lock”指令。 Java代码如下:
instance = new Singleton(); // instance是volatile变量
转变成汇编代码,如下。
0x01a3de1d: movb $0×0,0×1104800(%esi);0x01a3de24: lock addl $0×0,(%esp);
“lock”有三个作用:
1.将当前CPU缓存行的数据会写回到系统内存。
2.这个写回内存的操作会使得其他CPU里缓存了该内存地址的数据无效。
3.确保指令重排序时,内存屏障前的指令不会排到后面去,内存屏障后的指令不会排到前面去。
可见性可以理解为一个线程的写操作可以立即被其他线程得知。为了提高CPU处理速度,CPU一般不直接与内存进行通信,而是将系统内存的数据读到内部缓存,再进行操作。对于普通的变量,修改完不知道何时会更新到系统内存。但是如果是对volatile修饰的变量进行写操作,JVM就会向处理器发送一条Lock前缀的指令,将这个变量所在的缓存行的数据立即写回到系统内存。但是即便写回到系统内存,其他CPU中的缓存行数据还是旧的,为了保证数据一致性,其他CPU会嗅探在总线上传播的数据来检查自己的缓存行的值是否过期,当CPU发现缓存行对应的内存地址被修改,那么就会将当前缓存行设置为无效,下次当CPU对这个缓存行上的数据进行修改时,会重新从系统内存中把数据读到处理器缓存里。
使用场景
读写锁
如果需要实现一个读写锁,每次只能一个线程去写数据,但是有多个线程来读数据,就synchronized同步锁来对set方法加锁,get方法不加锁, 使用volatile来修饰变量,保证内存可见性,不然多个线程可能会在变量修改后还读到一个旧值。
volatile Integer a;
//可以实现一写多读的场景,保证并发修改数据时的正确。
set(Integer c) {
  synchronized(this.a) {
		  this.a = c;

  }
}
get() {
	return a;
}
状态位
用于做状态位标志,如果多个线程去需要根据一个状态位来执行一些操作,使用volatile修饰可以保证内存可见性。
用于单例模式用于保证内存可见性,以及防止指令重排序。
Java中线程的状态是怎么样的?
在操作系统中,线程等同于轻量级的进程。
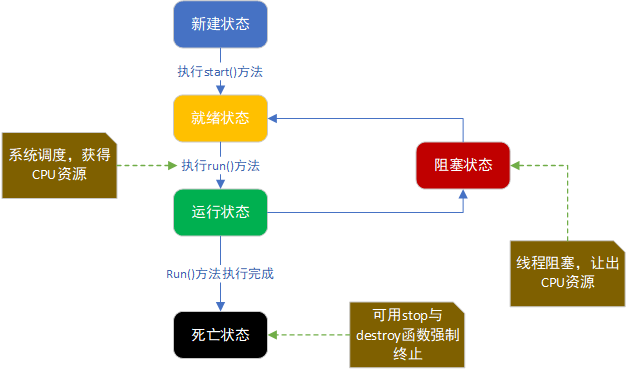
所以传统的操作系统线程一般有以下状态
- 新建状态: 使用 new 关键字和 Thread 类或其子类建立一个线程对象后,该线程对象就处于新建状态。它保持这个状态直到程序 start() 这个线程。
- 就绪状态: 当线程对象调用了start()方法之后,该线程就进入就绪状态。就绪状态的线程处于就绪队列中,要等待JVM里线程调度器的调度。
- 运行状态: 如果就绪状态的线程获取 CPU 资源,就可以执行 run(),此时线程便处于运行状态。处于运行状态的线程最为复杂,它可以变为阻塞状态、就绪状态和死亡状态。
- 阻塞状态:
如果一个线程执行了sleep(睡眠)、suspend(挂起)等方法,失去所占用资源之后,该线程就从运行状态进入阻塞状态。在睡眠时间已到或获得设备资源后可以重新进入就绪状态。可以分为三种:
- 等待阻塞:运行状态中的线程执行 wait() 方法,使线程进入到等待阻塞状态。
- 同步阻塞:线程在获取 synchronized同步锁失败(因为同步锁被其他线程占用)。
- 其他阻塞:通过调用线程的 sleep() 或 join() 发出了 I/O请求时,线程就会进入到阻塞状态。当sleep() 状态超时,join() 等待线程终止或超时,或者 I/O 处理完毕,线程重新转入就绪状态。
- 死亡状态: 一个运行状态的线程完成任务或者其他终止条件发生时,该线程就切换到终止状态。
但是Java中Thread对象的状态划分跟传统的操作系统线程状态有一些区别。
public enum State {
    NEW,//新建态
    RUNNABLE,//运行态
    BLOCKED,//阻塞态
    WAITING,//等待态
    TIMED_WAITING,//有时间限制的等待态
    TERMINATED;//死亡态
}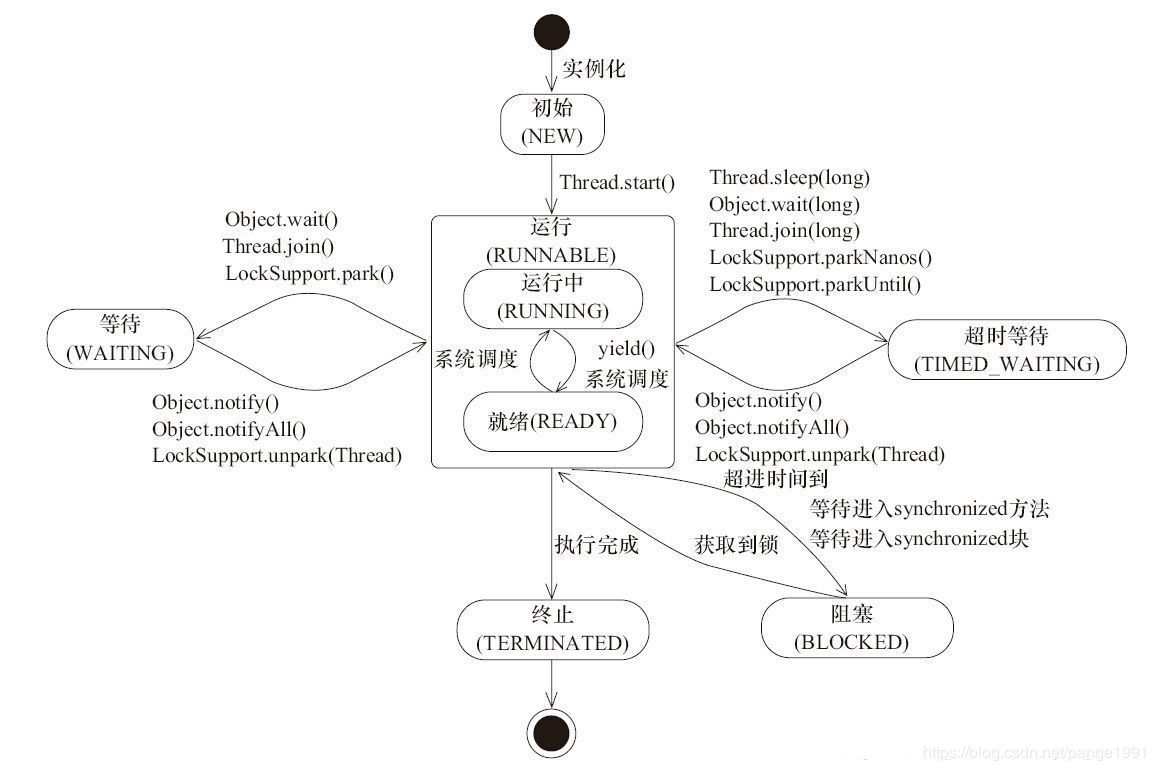
NEW 新建态
处于NEW状态的线程此时尚未启动,还没调用Thread实例的start()方法。
RUNNABLE 运行态
表示当前线程正在运行中。处于RUNNABLE状态的线程可能在Java虚拟机中运行,也有可能在等待其他系统资源(比如I/O)。
Java线程的RUNNABLE状态其实是包括了传统操作系统线程的ready和running两个状态的。
BLOCKED 阻塞态
阻塞状态。线程没有申请到synchronize同步锁,就会处于阻塞状态,等待锁的释放以进入同步区。
WAITING 等待态
等待状态。处于等待状态的线程变成RUNNABLE状态需要其他线程唤醒。
调用如下3个方法会使线程进入等待状态:
- Object.wait():使当前线程处于等待状态直到另一个线程调用notify唤醒它;
- Thread.join():等待线程执行完毕,底层调用的是Object实例的wait()方法;
- LockSupport.park():除非获得调用许可,否则禁用当前线程进行线程调度。
TIMED_WAITING 超时等待状态
超时等待状态。线程等待一个具体的时间,时间到后会被自动唤醒。
调用如下方法会使线程进入超时等待状态:
- Thread.sleep(long millis):使当前线程睡眠指定时间;
- Object.wait(long timeout):线程休眠指定时间,等待期间可以通过notify()/notifyAll()唤醒;
- Thread.join(long millis):等待当前线程最多执行millis毫秒,如果millis为0,则会一直执行;
- LockSupport.parkNanos(long nanos): 除非获得调用许可,否则禁用当前线程进行线程调度指定时间;
- LockSupport.parkUntil(long deadline):同上,也是禁止线程进行调度指定时间;
TERMINATED 终止态
终止状态。此时线程已执行完毕。
状态转换
1.BLOCKED与RUNNABLE状态的转换
处于BLOCKED状态的线程是因为在等待锁的释放,当获得锁之后就转换为RUNNABLE状态。
2.WAITING状态与RUNNABLE状态的转换
Object.wait(),Thread.join()和LockSupport.park()这3个方法可以使线程从RUNNABLE状态转为WAITING状态。
3.TIMED_WAITING与RUNNABLE状态转换
TIMED_WAITING与WAITING状态类似,只是TIMED_WAITING状态等待的时间是指定的。
调用Thread.sleep(long),Object.wait(long),Thread.join(long)会使得RUNNABLE状态转换为TIMED_WAITING状态
wait(),join(),sleep()方法有什么作用?
首先需要对wait(),join(),sleep()方法进行介绍。
Object.wait()方法是什么?
调用wait()方法前线程必须持有对象Object的锁。线程调用wait()方法后,会释放当前的Object锁,进入锁的monitor对象的等待队列,直到有其他线程调用notify()/notifyAll()方法唤醒等待锁的线程。
需要注意的是,其他线程调用notify()方法只会唤醒单个等待锁的线程,如果有多个线程都在等待这个锁的话,不一定会唤醒到之前调用wait()方法的线程。
同样,调用notifyAll()方法唤醒所有等待锁的线程之后,也不一定会马上把时间片分给刚才放弃锁的那个线程,具体要看系统的调度。
Thread.join()方法是什么?
join()方法是Thread类的一个实例方法。它的作用是让当前线程陷入“等待”状态,等join的这个线程threadA执行完成后,再继续执行当前线程。
实现原理是join()方法本身是一个sychronized修饰的方法,也就是调用join()这个方法需要先获取threadA的锁,获得锁之后再调用wait()方法来进行等待,一直到threadA执行完成后,threadA会调用notify_all()方法,唤醒所有等待的线程,当前线程才会结束等待。
Thread threadA = new Thread();
threadA.join();
join()方法的源码:
public final void join() throws InterruptedException {
    join(0);//0的话代表没有超时时间一直等下去
}
public final synchronized void join(long millis)
throws InterruptedException {
    long base = System.currentTimeMillis();
    long now = 0;

    if (millis < 0) {
        throw new IllegalArgumentException("timeout value is negative");
    }

    if (millis == 0) {
        while (isAlive()) {
            wait(0);
        }
    } else {
        while (isAlive()) {
            long delay = millis - now;
            if (delay <= 0) {
                break;
            }
            wait(delay);
            now = System.currentTimeMillis() - base;
        }
    }
}
这是jvm中Thead的源码,在线程执行结束后会调用notify_all来唤醒等待的线程。
//一个c++函数:
void JavaThread::exit(bool destroy_vm, ExitType exit_type) ;
//里面有一个贼不起眼的一行代码
ensure_join(this);

static void ensure_join(JavaThread* thread) {
  Handle threadObj(thread, thread->threadObj());

  ObjectLocker lock(threadObj, thread);

  thread->clear_pending_exception();

  java_lang_Thread::set_thread_status(threadObj(),        java_lang_Thread::TERMINATED);
  java_lang_Thread::set_thread(threadObj(), NULL);
  //同志们看到了没,别的不用看,就看这一句
  //thread就是当前线程,是啥?就是刚才例子中说的threadA线程
  lock.notify_all(thread);
  thread->clear_pending_exception();
}
sleep()方法是什么?
sleep方法是Thread类的一个静态方法。它的作用是让当前线程睡眠一段时间。:sleep方法是不会释放当前线程持有的锁,而wait方法会。
sleep与wait方法的区别:
- wait可以指定时间,也可以不指定;而sleep必须指定时间。
- wait释放cpu资源,同时释放锁;sleep释放cpu资源,但是不释放锁,所以易死锁。(调用join()方法也不会释放锁)
- wait必须放在同步块或同步方法中,而sleep可以再任意位置。
参考文章:
http://redspider.group:4000/article/01/4.html
https://www.jianshu.com/p/5d88b122a050
Thread.sleep(),Object.wait(),LockSupport.park()有什么区别?
1.这三个方法都会让线程挂起,释放CPU时间片,进入到阻塞态。但是Object.wait()需要释放锁,所以必须在synchronized同步锁中使用,同理配套的Object.notify()也是。而Thead.sleep(),LockSupport.park()不需要在synchronized同步锁中使用,并且在调用时也不会释放锁。
2.由于Thread.sleep()没有对应的唤醒线程的方法,所以必须指定超时时间,超过时间后,线程恢复。所以调用Thread.sleep()后的线程一般是出于TIME_WAITING状态,而调用了Object.wait(),LockSupport.park()的方法是进入到WAITING状态。
3.Object.wait()对应的唤醒方法为Object.notify(),LockSupport.park()对应的唤醒方法为LockSupport.unpark()。
4.在代码中必须能保证wait方法比notify方法先执行,如果notify方法比wait方法早执行的话,就会导致因wait方法进入休眠的线程接收不到唤醒通知的问题。而park、unpark则不会有这个问题,我们可以先调用unpark方法释放一个许可证,这样后面线程调用park方法时,发现已经许可证了,就可以直接获取许可证而不用进入休眠状态了。(LockSupport.park() 的实现原理是通过二元信号量做的阻塞,要注意的是,这个信号量最多只能加到1,也就是无论执行多少次unpark()方法,也最多只会有一个许可证。)
5.三种方法让线程进入阻塞态后,都可以响应中断,也就是调用Thread.interrupt()方法会设置中断标志位,之前执行Thread.sleep(),Object.wait()了的线程会抛出InterruptedException异常,然后需要代码进行处理。而调用了park()方法的线程在响应中断只会相当于一次正常的唤醒操作(等价于调用unpark()方法),让线程唤醒,继续执行后面的代码,不会抛出InterruptedException异常。
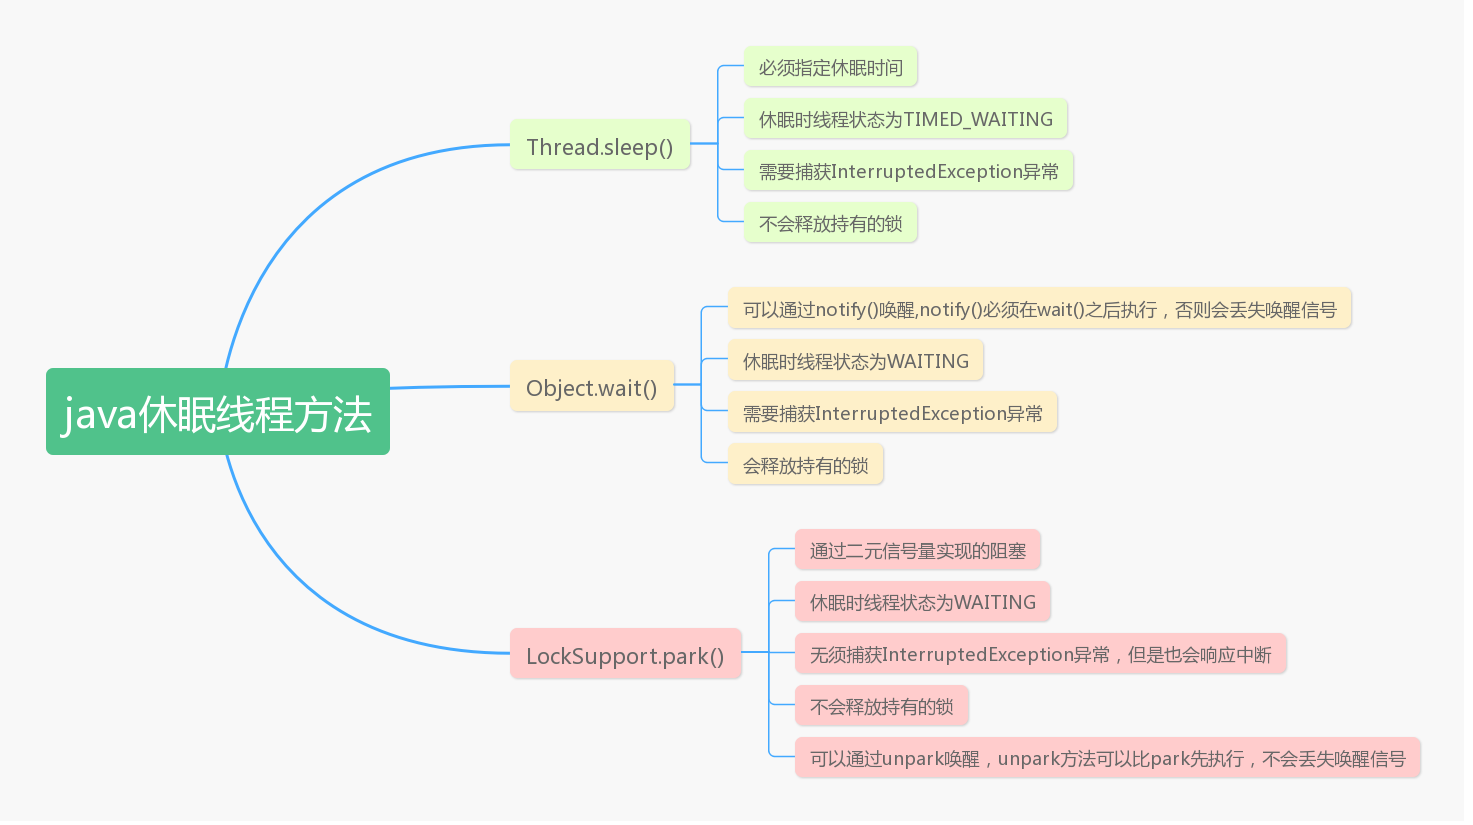
参考链接:
https://blog.csdn.net/u013332124/article/details/84647915
谈一谈你对线程中断的理解?
在Java中认为,一个线程不应该由其他线程来强制中断或者停止,所以一些会强制中断线程的方法Thread.stop(), Thread.suspend()方法都已经废弃了。所以一般是通过调用thread.interrupt();方法来设置线程的中断标识,
1.这样如果线程是处于阻塞状态,会抛出InterruptedException异常,代码可以进行捕获,进行一些处理。(例如Object#wait、Thread#sleep、BlockingQueue#put、BlockingQueue#take。其中BlockingQueue主要调用conditon.await()方法进行等待,底层通过LockSupport.park()实现)
2.如果线程是处于RUNNABLE状态,也就是正常运行,调用thread.interrupt();只是会设置中断标志位,不会有什么其他操作。
//将线程的中断标识设置为true
thread.interrupt();
//判断线程的中断标识是否为true
thread.isInterrupted()
//会返回当前的线程中断状态,并且重置线程的中断标识,将中断标识设置为false
thread.interrupted()
线程执行的任务可以终止吗?
1.设置中断
FutureTask提供了cancel(boolean mayInterruptIfRunning)方法来取消任务,并且
如果入参为false,如果任务已经在执行,那么任务就不会被取消。
如果入参为true,如果任务已经在执行,那么会调用Thread的interrupt()方法来设置线程的中断标识,如果线程处于阻塞状态,会抛出InterruptedException异常,如果正常状态只是设置标志位,修改interrupted变量的值。所以如果要取消任务只能在任务内部中调用thread.isInterrupted()方法获取当前线程的中断状态,自行取消。
2.线程的stop方法
线程的stop()方法可以让线程停止执行,释放所有的锁,抛出ThreadDeath这种Error。但是在释放锁之后,没有办法让受这些锁保护的资源,对象处于一个安全,一致的状态。(例如有一个变量a,本来的值是0,你的线程任务是将a++后然后再进行a--。正常情况下任务执行完之后,其他线程取到这个变量a的值应该是0,但是如果之前调用了Thread.stop方法时,正好是在a++之后,那么变量a就会是1,这样其他线程取到的a就是出于不一致的状态。)
让线程顺序执行有哪些方法?
1.主线程Join
就是调用threadA.start()方法让线程A先执行,然后主线程调用threadA.join()方法,然后主线程进入TIME_WAITING状态,直到threadA执行结束后,主线程才能继续往下执行,执行线程B的任务。(join方法的底层实现其实是调用了threadA的wait()方法,当线程A执行完毕后,会自动调用notifyAll()方法唤醒所有线程。)
示例代码如下:
Thread threadA = new Thread(new Runnable() {
      @Override
      public void run() {
        //执行threadA的任务
      }
});
Thread threadB= new Thread(new Runnable() {
      @Override
      public void run() {
        //执行threadB的任务
      }
});
//执行线程A任务
threadA.start();
//主线程进行等待
threadA.join();
//执行线程B的任务
threadB.start();
子线程Join
就是让线程B的任务在执行时,调用threadA.join()方法,这样就只有等线程A的任务执行完成后,才会执行线程B。
   Thread threadA = new Thread(new Runnable() {
        @Override
        public void run() {
        //执行threadA的任务
        }
    });
    Thread threadB= new Thread(new Runnable() {
        @Override
        public void run() {
          	//子线程进行等待,知道threadA任务执行完毕
    				threadA.join();
            //执行threadB的任务
        }
    });
		//执行线程A任务
    threadA.start();
		//执行线程B的任务
    threadB.start();
单线程池法
就是使用Executors.newSingleThreadExecutor()这个线程池,这个线程池的特点就是只有一个执行线程,可以保证任务按顺序执行。
ExecutorService pool = Executors.newSingleThreadExecutor();
//提交任务A
executorService.submit(taskA);
//提交任务B
executorService.submit(taskB);
等待通知法(wait和notify)
就是在线程B中调用Object.waiting()方法进行等待,线程A执行完毕后调用Object.notify()方法进行唤醒。(这种方法有两个缺点,一个是Object.waiting()和notify()方法必须在同步代码块中调用,第二个是如果线程A执行过快,先调用了object.notify()方法,就会导致线程B后面一直得不到唤醒。)
 		final Object object = new Object();
 		Thread threadA = new Thread(new Runnable() {
        @Override
        public void run() {
        //执行threadA的任务
          synchronized(object) {
             object.notify();
          }
        }
    });
    Thread threadB= new Thread(new Runnable() {
        @Override
        public void run() {
            synchronized(object) {
          	//子线程进行等待,知道threadA任务执行完毕
    						object.wait();
            //执行threadB的任务
            }
        }
    });
等待通知法(await和singal)
具体实现就是Reentrantlock可以创建出一个Condition实例queue,可以认为是一个等待队列,线程B调用queue.await()就会进行等待,直到线程A执行完毕调用queue.signal()来唤醒线程B。
 				final ReentrantLock lock   = new ReentrantLock();
        final Condition     queue1 = lock.newCondition();
        final Object object = new Object();
        final Thread threadA = new Thread(new Runnable() {
            @Override
            public void run() {
                //执行threadA的任务
                    lock.lock();
                    try {
                      //唤醒线程B的任务
                        queue1.signal();
                    } catch (InterruptedException e) {
                        e.printStackTrace();
                    }
                    System.out.println("执行了任务A2");
                    lock.unlock();
            }
        });
        final Thread threadB= new Thread(new Runnable() {
            @Override
            public void run() {
                lock.lock();
                //子线程进行等待,知道threadA任务执行完毕
                    try {
                        queue1.await();
                        System.out.println("执行了任务B2");

                    } catch (InterruptedException e) {
                        e.printStackTrace();
                    }
                    //执行threadB的任务
                lock.unlock();
            }
        });
        threadA.start();
        threadB.start();
参考链接:
http://cnblogs.com/wenjunwei/p/10573289.html
线程间怎么通信?
1.synchronized锁
通过synchronized锁来进行同步,让一次只能一个线程来执行。
2.等待/通知机制
//假设我们的需求是B执行结束后A才能执行
//线程A的代码
synchronized(对象) { while(条件不满足) {
    while(条件不满足) {
        对象.wait(); //线程A进行等待
    }
    //线程A执行相关的的逻辑
 }

//线程B的代码
 synchronized(对象) {
 		//线程B执行相关的的逻辑
 		//线程B唤醒线程A
 		对象.notifyAll();
 }
等待/通知机制,是指一个线程A调用了对象objectA的wait()方法进入等待状态,而另一个线程B调用了对象objectA的notify()或者notifyAll()方法,线程A收到通知后从对象objectA的wait()方法返回,进而执行后续操作。上述两个线程通过对象objectA来完成交互,而对象上的wait()和notify/notifyAll()的关系就如同开关信号一样,用来完成等待方和通知方之间的交互工作。
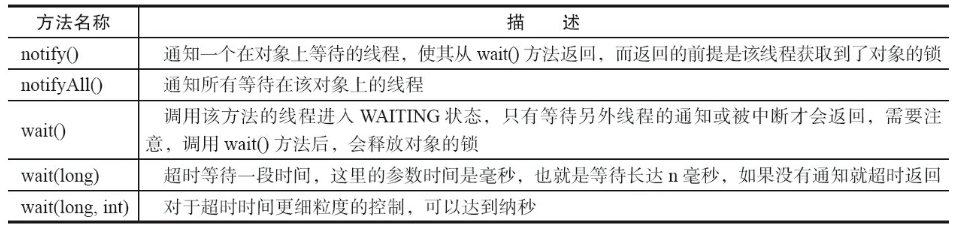
1)使用wait()、notify()和notifyAll()时需要先对调用对象加锁。
2)调用wait()方法后,线程状态由RUNNING变为WAITING,并将当前线程放置到对象的
等待队列。
3)notify()或notifyAll()方法调用后,等待线程依旧不会从wait()返回,因为等待线程只是从等待队列到了同步队列,需要调用notify()或 notifAll()的线程释放锁之后,等待线程获得锁,才能从同步队列中移除,才有机会从wait()返回,才能继续往下执行。
4)notify()方法将等待队列中的一个等待线程从等待队列中移到同步队列中,而notifyAll() 方法则是将等待队列中所有的线程全部移到同步队列,被移动的线程状态由WAITING变为 BLOCKED。
5)从wait()方法返回的前提是获得了调用对象的锁。
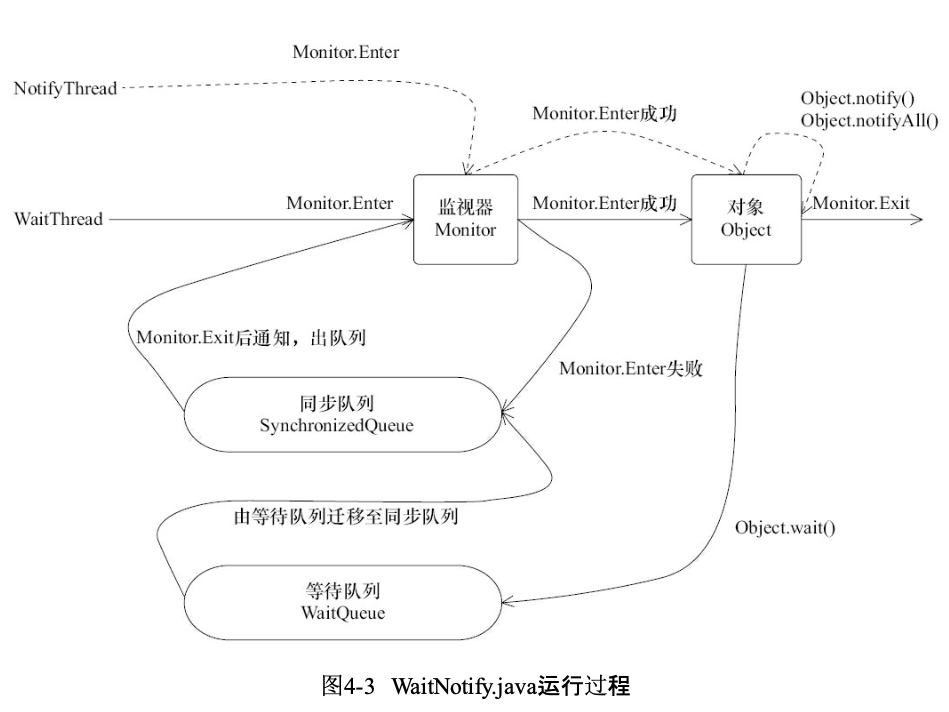
3.管道
管道输入/输出流 管道输入/输出流和普通的文件输入/输出流或者网络输入/输出流不同之处在于,它主要 用于线程之间的数据传输,而传输的媒介为内存。 管道输入/输出流主要包括了如下4种具体实现:PipedOutputStream、PipedInputStream、 PipedReader和PipedWriter,前两种面向字节,而后两种面向字符。
PipedReader和PipedWriter可以一个线程A调用PipedWriter实例的write()方法,往里面写数据,然后与PipedWriter实例建立连接的PipedReader实例可以读到数据,线程B可以通过PipedReader实例读到数据。
在代码清单4-12所示的例子中,创建了printThread,它用来接受main线程的输入,任何 main线程的输入均通过PipedWriter写入,而printThread在另一端通过PipedReader将内容读出并打印。
代码清单4-12 Piped.java
public class Piped {
       public static void main(String[] args) throws Exception {
          PipedWriter out = new PipedWriter();
          PipedReader in = new PipedReader();
          // 将输出流和输入流进行连接,否则在使用时会抛出IOException 											out.connect(in);
          Thread printThread = new Thread(new Print(in), "PrintThread"); printThread.start();
          int receive = 0;
          try {
							while ((receive = System.in.read()) != -1) { 				out.write(receive);
									}
					} finally {	out.close(); }
       }
       static class Print implements Runnable {
           private PipedReader in;
           public Print(PipedReader in) {
								this.in = in;
					}
				public void run() {
							int receive = 0;
							try {
									while ((receive = in.read()) != -1) { System.out.print((char) receive);
                   }
               } catch (IOException ex) {
       			}
     	}
		}
}
运行该示例,输入一组字符串,可以看到被printThread进行了原样输出。
Repeat my words. Repeat my words.
4.Thread.join
Thread.join()的使用如果一个线程A执行了thread.join()语句,当前线程A会一直等待thread线程终止之后才从thread.join()返回,向下执行。线程Thread除了提供join()方法之外,还提供了join(long millis)和join(long millis,int nanos)两个具备超时参数的方法。
5.ThreadLocal的使用
ThreadLocal,即线程变量,是一个以ThreadLocal对象为键、任意对象为值的存储结构。这 个结构被附带在线程上,也就是说一个线程可以根据一个ThreadLocal对象查询到绑定在这个 线程上的一个值。
public class Profiler {
    // 第一次get()方法调用时会进行初始化(如果set方法没有调用),每个线程会调用一次
    private static final ThreadLocal<Long> TIME_THREADLOCAL = new ThreadLocal<Long>() {
        protected Long initialValue() { return System.currentTimeMillis();}
    };
    public static final void begin() {
        TIME_THREADLOCAL.set(System.currentTimeMillis());
    }
    public static final long end() {
        return System.currentTimeMillis() - TIME_THREADLOCAL.get();
    }
    public static void main(String[] args) throws Exception {
        Profiler.begin();
        TimeUnit.SECONDS.sleep(1);
        System.out.println("Cost: " + Profiler.end() + " mills");
    }
}
Profiler可以被复用在方法调用耗时统计的功能上,在方法的入口前执行begin()方法,在
方法调用后执行end()方法,好处是两个方法的调用不用在一个方法或者类中,比如在AOP(面 向方面编程)中,可以在方法调用前的切入点执行begin()方法,而在方法调用后的切入点执行 end()方法,这样依旧可以获得方法的执行耗时。
怎么实现实现一个生产者消费者?
1.使用Object.wait()和Object.notify()实现
使用queue作为一个队列,存放数据,并且使用Synchronized同步锁,每次只能同时存在一个线程来生产或者消费数据,
生成线程发现队列容量>10,生产者线程就进入waiting状态,一旦成功往队列添加数据,那么就唤醒所有线程(主要是生产者线程起来消费)。
消费线程消费时,发现队列容量==0,也会主动进入waiting状态。
伪代码如下:
LinkedList<Integer> queue = new LinkedList<>();
void produce(Integer value) {
  synchronized(queue) {//加锁控制,保证同一时间点,只能有一个线程生成或者消费
    while(queue.size()>10) {
					queue.waiting();
    }
    queue.add(value);
    //唤醒消费者线程
    queue.notifyAll();
  }
}
Integer consumer() {
  synchronized(queue) {//加锁控制,保证同一时间点,只能有一个线程生成或者消费
    while(queue.size()==0) {
       queue.waiting();
    }
    Integer value = queue.poll();
    //唤醒生产者线程
    queue.notifyAll();
		return value;
  }
}
完整代码如下:
public static void main(String[] args) {
    Queue<Integer> queue    = new LinkedList<>();
    final Customer customer = new Customer(queue);
    final Producer producer = new Producer(queue);
    ExecutorService pool = Executors.newCachedThreadPool();
    for (int i = 0; i < 1000; i++) {
        pool.execute(new Runnable() {
            @Override
            public void run() {
                try {
                    Thread.sleep(1000);
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
                Integer a = customer.removeObject();
                System.out.println("消费了数据 "+a);
            }
        });
        pool.execute(new Runnable() {
            @Override
            public void run() {
                try {
                    Thread.sleep(1000);
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
                Random  random = new Random();
                Integer a      = random.nextInt(1000);
                System.out.println("生成了数据 "+a);
                producer.addObject(a);
            }
        });
    }
}
private static class Customer {
    Queue<Integer> queue;
    Customer(Queue<Integer> queue) { this.queue = queue; }
    public Integer removeObject() {
        synchronized (queue) {
            try {
                while (queue.size()==0) {
                    System.out.println("队列中没有元素了,进行等待");
                    queue.wait();
                }
            } catch (InterruptedException e) {
                e.printStackTrace();
            }
            Integer number = queue.poll();
            System.out.println("唤醒所有生产线程,当前queue大小是" + queue.size());
            queue.notifyAll();
            return number;
        }
    }
}
private static class Producer {
    Queue<Integer> queue;
    Producer(Queue<Integer> queue) { this.queue = queue; }
    public void addObject(Integer number) {
        synchronized (queue) {
            try {
                while (queue.size()>10) {
                    queue.wait();
                }
            } catch (InterruptedException e) {
                e.printStackTrace();
            }
            queue.add(number);
            queue.notifyAll();
            System.out.println("唤醒所有消费线程,当前queue大小是"+queue.size());
        }
    }
}
2.使用Lock和Condition来实现
调用Object.wait()方法可以让线程进入等待状态,被添加到Object的monitor监视器的等待队列中,Object.notifyAll()可以唤醒monitor监视器等待队列中的所有线程。
而调用lock的newCondition()方法,可以返回一个ConditionObject实例对象,每个ConditionObject包含一个链表,存储等待队列。可以认为一个ReentrantLock有一个同步队列(存放没有获得锁的线程),和多个等待队列(存放调用await()方法的线程)。使用Condition.singal()和Condition.singalAll()可以更加精准的唤醒线程,也就是唤醒的都是这个Condition对应的等待队列里面的线程,而Object.notify()和Object.notifyAll()只能唤醒等待队列中的所有的线程。
ReentrantLock lock = new ReentrantLock();
Condition customerQueue = lock.newCondition();
ReentrantLock的Condition相关的实现
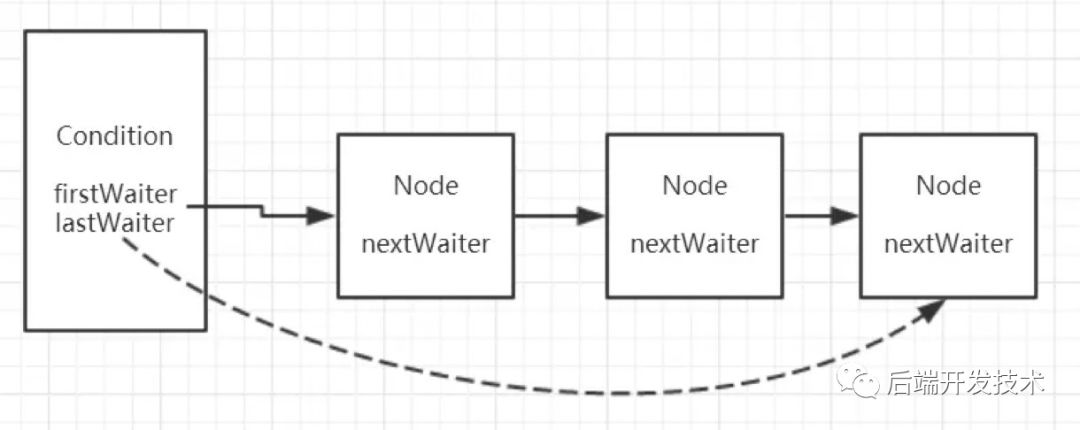
abstract static class Sync extends AbstractQueuedSynchronizer {
    final ConditionObject newCondition() {
        return new ConditionObject();
    }
}
//AQS内部类 ConditionObject
public class ConditionObject implements Condition, java.io.Serializable {
    private static final long serialVersionUID = 1173984872572414699L;
    //链表头结点
    private transient Node firstWaiter;
    //链表尾结点
    private transient Node lastWaiter;
    //真正的创建Condition对象
    public ConditionObject() { }
}
消费者-生产者实现
public static void main(String[] args) {
    ReentrantLock lock = new ReentrantLock();
    Condition customerQueue = lock.newCondition();
    Condition producerQueue = lock.newCondition();

    Queue<Integer>     queue    = new LinkedList<>();
    final Customer customer = new Customer(lock,customerQueue, producerQueue,queue);
    final Producer producer = new  Producer(lock,customerQueue, producerQueue,queue);

    ExecutorService    pool     = Executors.newCachedThreadPool();
    for (int i = 0; i < 1000; i++) {
        pool.execute(new Runnable() {
            @Override
            public void run() {
                try {
                    Thread.sleep(1000);
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
                Integer a = customer.take();
//                    System.out.println("消费了数据 "+a);
            }
        });
        pool.execute(new Runnable() {
            @Override
            public void run() {
                try {
                    Thread.sleep(1000);
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
                Random  random = new Random();
                Integer a      = random.nextInt(1000);
//                    System.out.println("生成了数据 "+a);
                producer.add(a);
            }
        });
    }
}

private static class Customer {
    private ReentrantLock lock;
    private Condition customer;
    private Condition producer;
    private Queue<Integer> queue;

    Customer(ReentrantLock lock, Condition customer, Condition producer,Queue<Integer> queue) {
        this.lock = lock;
        this.customer = customer;
        this.producer = producer;
        this.queue = queue;
    }

    public Integer take() {
        lock.lock();
        Integer element = null;
        try {
            while (queue.size() == 0) {
                customer.await();
            }
            element = queue.poll();
            System.out.println("消费者线程取出来元素"+element);
            producer.signalAll();
        } catch (InterruptedException e) {
            e.printStackTrace();
        } finally {
            lock.unlock();
        }
        return element;
    }
}

private static class Producer {
    private ReentrantLock lock;
    private Condition customer;
    private Condition producer;
    private Queue<Integer> queue;

    Producer(ReentrantLock lock, Condition customer, Condition producer,Queue<Integer> queue) {
        this.lock = lock;
        this.customer = customer;
        this.producer = producer;
        this.queue = queue;
    }

    public void add( Integer element) {
        lock.lock();
        try {
            while (queue.size() > 10) {
                producer.await();
            }
             queue.add(element);
            System.out.println("生成和线程添加元素"+element);
            customer.signalAll();
        } catch (InterruptedException e) {
            e.printStackTrace();
        } finally {
            lock.unlock();
        }
    }
}
3.使用BlockingQueue实现
利用阻塞队列BlockingQueue的特征进行生产和消费的同步(其实阻塞队列内部也是基于Lock,condition实现的 )
public class BlockQueueRepository<T> extends AbstractRepository<T> implements Repository<T> {
    public BlockQueueRepository(int cap) {
      //cap代表队列的最大容量
        products = new LinkedBlockingQueue<>(cap);
    }

    @Override
    public void put(T t) {
        if (isFull()) {
            log.info("repository is full, waiting for consume.....");
        }
        try {
          //如果队列长度已满,那么会阻塞等待
            ((BlockingQueue) products).put(t);
        } catch (InterruptedException e) {
            e.printStackTrace();
        }
    }

    @Override
    public T take() {
        T product = null;
        if (isEmpty()) {
            log.info("repository is empty, waiting for produce.....");
        }
        try {
            //如果队列元素为空,那么也会阻塞等待
            product = (T) ((BlockingQueue) products).take();
        } catch (InterruptedException e) {
            e.printStackTrace();
        }
        return product;
    }
}
谈一谈你对线程池的理解?
首先线程池有什么作用?
- 1.提高响应速度,如果线程池有空闲线程的话,可以直接复用这个线程执行任务,而不用去创建。
- 2.减少资源占用,每次都创建线程都需要申请资源,而使用线程池可以复用已创建的线程。
- 3.可以控制并发数,可以通过设置线程池的最大线程数量来控制最大并发数,如果每次都是创建新线程,来了大量的请求,可能会因为创建的线程过多,造成内存溢出。
- 4.更加方便来管理线程资源。
线程池有哪些参数?
public ThreadPoolExecutor(int corePoolSize,
                              int maximumPoolSize,
                              long keepAliveTime,
                              TimeUnit unit,
                              BlockingQueue<Runnable> workQueue,
                              ThreadFactory threadFactory) {
        this(corePoolSize, maximumPoolSize, keepAliveTime, unit, workQueue,
             threadFactory, defaultHandler);
    }
1.corePoolSize 核心线程数
该线程池中核心线程数最大值,添加任务时,即便有空闲线程,只要当前线程池线程数 从阻塞队列取任务时,如果阻塞队列为空: 核心线程的会一直卡在 在这个方法里会调用notEmpty队列(这是Condition实例)的await()方法一直阻塞并挂起,不会占用CPU资源。 非核心线程会调用workQueue.poll(keepAliveTime, TimeUnit.NANOSECONDS)方法取任务 ,这个poll方法每种等待队列的实现各不相同,以LinkedBlockingQueue为例, 在这个方法里面会调用notEmpty队列(这是Condition实例)的awaitNanos()方法进行超时等待,如果超过keepAliveTime时间后还没有新的任务,就会返回 该线程池中线程总数最大值 ,一般是用于当线程池中的线程都在执行任务,并且等待队列满了时,如果当前线程数 等待队列,一般是抽象类BlockingQueue的子类。 4.keepAliveTime:非核心线程闲置超时时长。 非核心线程如果处于闲置状态超过该值,就会被销毁。如果设置allowCoreThreadTimeOut(true),则会也作用于核心线程。 5.RejectedExecutionHandler 拒绝处理策略 拒绝处理策略,核心线程已经满了,等待队列也满了,并且线程数量大于最大线程数时,就会采用拒绝处理策略进行处理,四种拒绝处理的策略为 : ThreadFactory是一个接口,只有一个newThread()方法。(默认情况下ThreadPoolExecutor用的ThreadFactory默认都是Executors.defaultThreadFactory())。一般来说,你通过ThreadPoolExecutor来创建线程池,对于线程池中的线程你是无法直接接触到的,例如你为了更加方便得定位线程池的Bug,希望对线程池中线程设置跟业务相关的名称,那么就需要建一个类,实现ThreadFactory接口,编写newThread()方法的实现。 Executors提供四种线程池,分别为: 一句话总结就是:线程数固定,等待队列无限长。 创建一个线程池,核心线程数与最大线程数值都是传入参数nThreads。可控制线程最大并发数,超出的线程会在队列中等待(比较适合需要控制并发量的情况)。主要是通过将核心线程数设置为与最大线程数相等实现的。缺点是LinkedBlockingQueue队列的默认长度是Integer.MAX_VALUE,也存在内存溢出的风险。 与CachedThreadPool的区别: 一句话总结就是:单线程池,等待队列无限长。
创建一个单线程化的线程池,它只会用唯一的工作线程来执行任务,保证所有任务按照指定顺序(FIFO, LIFO, 优先级)执行。主要是通过将核心线程数和最大线程数都设置为1来实现。 创建一个可缓存线程池,如果线程池长度超过处理需要,可灵活回收空闲线程,若无可回收,则新建线程。但是由于最大线程数设置的是Integer.MAX_VALUE,存在内存溢出的风险。 一句话总结就是:最大线程数无限大,线程超时被回收 当需要执行很多短时间的任务时,CacheThreadPool的线程复用率比较高, 会显著的提高性能。而且线程60s后会回收,意味着即使没有任务进来,CacheThreadPool并不会占用很多资源。 创建一个定时执行的线程池,主要是通过DelayedWorkQueue来实现(该队列中的元素只有当其指定的延迟时间到了,才能够从队列中获取到该元素)。支持定时及周期性任务执行。但是由于最大线程数设置的是Integer.MAX_VALUE,存在内存溢出的风险。 一句话总结就是:线程数无限大,定时执行。 主要是newFixedThreadPool和newSingleThreadExecutor的等待队列是LinkedBlockingQueue,长度是Integer.MAX_VALUE,,可以认为是无限大的,如果创建的任务特别多,可能会造成内存溢出。而newCachedThreadPool和newScheduledThreadPool的最大线程数是Integer.MAX_VALUE,如果创建的任务过多,可能会导致创建的线程过多,从而导致内存溢出。 扩展资料: 线程池生命周期: 因为是计算密集型任务,可以理解为每个任务在执行期间基本没有IO操作,全部都在CPU时间片中执行。所以可以理解为CPU就是满载的,CPU利用率就是100%,其实线程数等于CPU数就可以的,但是由于需要考虑到计算密集型的线程恰好在某时因为发生一个页错误或者因其他原因而暂停,此时应该需要有一个“额外”的空闲线程来获得时间片,然后执行,可以确保在这种情况下CPU周期不会中断工作,充分利用CPU。 这种任务在执行时,需要进行一些IO操作,所以为了充分利用CPU,应该在线程进行IO操作时,就让出时间片,CPU进行上下文切换,执行其他线程的任务,保证CPU利用率尽可能达到100%。 如果任务有50%的时间需要CPU执行状态,其他时间进行IO操作,则程序所需线程数为CPU数量的1除以0.5,也就是2倍。如果任务有20%的时时间需要CPU执行,其他时间需要进行IO操作,最佳线程数也就是1除以0.2,也就是CPU数的5倍。
所以公式为 但是在实际线上运行的环境中,每个任务执行的时间是各不相同的,而且我们其实是不太方便去监测每个任务执行时需要的CPU执行时间,IO操作时间的,所以这种方法只是一种理论。 这种其实是美团他们做的一个线程池监测平台,主要把任务分成两种, 一种是追求响应时间的任务,例如使用线程池对发起多个网络请求,然后对结果进行计算。 这种任务的最大线程数需要设置大一点,然后队列使用同步队列,队列中不缓存任务,任务来了就会被执行。判断线程池资源不够用时,一般是发现活跃线程数/最大线程数>阀值(默认是0.8)时,或者是线程池抛出的RejectedExecut异常次数达到阀值,就会进行告警。然后程序员收到告警后,动态发送修改核心线程数,最大线程数,队列相关的指令,服务器进行动态修改。 假设说需要定期自动化生成一些报表,不需要考虑响应时间,只是希望如何使用有限的资源,尽可能在单位时间内处理更多的任务,也就是吞吐量优先的问题。
这种就是使用有界队列,对任务进行缓存,然后线程进行并发执行。判断线程池资源不够用时,一般是发现等待队列中的任务数量/等待队列的长度>阀值(默认是0.8)时,或者是线程池抛出的RejectedExecut异常次数达到阀值,就会进行告警。然后程序员收到告警后,动态发送修改核心线程数,最大线程数,队列相关的指令,服务器进行动态修改。 ThreadPoolExecutor提供了如下几个public的setter方法 调用corePoolSize方法之后,线程池会直接覆盖原来的corePoolSize值,并且基于当前值和原始值的比较结果采取不同的处理策略。(总得来说就是,多退少补的策略) 对于新corePoolSize<当前工作线程数的情况: 说明有多余的worker线程,此时会向当前idle状态的worker线程发起中断请求以实现回收,多余的worker在下次idel的时候也会被回收。 对于新corePoolSize>当前工作线程数且队列中有任务的情况: 如果当前队列中有待执行任务,则线程池会创建新的worker线程来执行队列任务。 setCorePoolSize的方法的执行流程入下图所示: 扩展资料:
Java并发(八)计算线程池最佳线程数 从字面意思上,ThreadLocal会被理解为线程本地存储,就是对于代码中的一个变量,每个线程拥有这个变量的一个副本,访问和修改它时都是对副本进行操作。 ThreadLocal 适用于每个线程需要自己独立的实例且该实例需要在多个方法中被使用,也即变量在线程间隔离而在方法或类间共享的场景。(例如:方法直接调用时传递的变量过多,为了代码简洁性,可以使用ThreadLocal,在前一个方法中,将变量进行存储,后一个方法中取,进行使用。) 就是每个Thread有一个ThreadLocalMap,类似于HashMap,当调用ThreadLocal#set()方法进行存值时,实际上是先获取到当前的线程,然后获取线程的map,是一个ThreadLocalMap类型,然后会在这个map中添加一个新的键值对,key就是我们ThreadLocal变量的地址,value就是我们存的值。ThreadLocalMap与HashMap不同的时,解决HashMap使用的是开放定址法,也就是当发现hashCode计算得到数组下标已经存储了元素后,会继续往后找,直到找到一个空的数组下标,存储键值对。 首先在上面类A的代码中,类A中有一个ThreadLocal类型的变量 它们的引用链如下: 可以看到ThreadLocal变量不仅被所在的类A的实例所引用,还被执行的线程所引用, 1.如果使用强引用,也就是线程对ThreadLocal变量是强引用,那么即便实例A被回收了,只要线程还没有被回收,线程的ThreadLocalMap还会引用这个key(也就是这个ThreadLocal遍历),导致这个key 没有被回收,造成内存泄露。 2.如果使用弱引用,不会影响key的回收,也就是不会影响引用了ThreadLocal的实例对象的回收。 但是即便使用弱引用,ThreadLocalMap对value的引用是强引用(一边value是局部变量,也不能用弱引用,那样在用到的时候就会被),但是value依然不会被回收,会造成内存泄露。 通常来说,value回收的时机有两个: 1.我们在用完ThreadLocal后,应该遵循规范手动调用ThreadLocal#remove()对键值对value释放,这样可以使value被回收。 2.此线程在其他对象中使用ThreadLocal对线程ThreadLocalMap进行set()和get()时,由于需要进行开放定址法进行探测,会对沿途过期的键值对(就是key为null的键值对)进行清除。以及set()方法触发的cleanSomeSlots()方法对过期键值对进行清除。 《一篇文章,从源码深入详解ThreadLocal内存泄漏问题》 首先在初始化Random实例的时候就会根据当前的时间戳生成一个种子数seed。 然后每次取随机数时是拿seed乘以一个固定值multiplier,作为随机数。 但是这样的话,多线程并发使用Math.random取随机数时,同一个时间点取到的随机数一样的概率会比较大。所以可以使用ThreadLocalRandom.current().nextInt()方法去取随机数。每个线程第一次调用ThreadLocalRandomd的current()方法时,会为这个线程生成一个线程独立的种子数seed,这样多线程并发读取随机数时,可以保证取到的随机数都是不一样的。 僵尸进程:通常来说,使用fork()系统调用从一个父进程创建出一个子进程,子进程退出,是需要父进程调用wait()或者是waitpid()函数来回收子进程的资源,如果父进程没有调用,子进程的信息就会一直在内存中,而不会被回收,变成僵尸进程。 孤儿进程:就是父进程先退出了,它的子进程会被init进程接管,由它来收集子进程的状态。(init进程是内核启动时,创建出来的进程,是一个以root身份运行的普通用户进程,是永远不会停止的。) 守护进程是脱离于终端并且在后台运行的进程,脱离终端是为了避免将在执行的过程中的信息打印在终端上,并且进程也不会被任何终端所产生的终端信息所打断。 https://www.cnblogs.com/tjudzj/p/4454490.html https://network.51cto.com/art/201911/606827.htm?mobile 当SyncTest.java被编译成class文件的时候, 对于 而对于 这是网上看到的一个流程图: 就是Java对象的内存布局其实由对象头+实例数据+对齐填充三部分组成,而对象头主要包含Mark Word+指向对象所属的类的指针组成。Mark Word主要用于存储对象自身的运行时数据,哈希码,GC分代年龄,锁标志等。 下面就是Mark Word的数据映射表 根据上面的表来看,Mark Word后三位为101时,加锁对象的状态为偏向锁,偏向锁的意义在于同一个线程访问sychronize代码块时不需要进行加锁,解锁操作,性能开销更低(HotSpot[1]的作者经过研究发现,大多数情况下,锁不仅不存在多线程竞争,而且总是由同一线程多次获得,为了让线程获得锁的代价更低而引入了偏向锁。) 因为正常情况下,当一个线程访问同步块并获取轻量级锁时,需要进行CAS操作将对象头的锁记录里指向当前线程的栈中的锁记录,执行完毕后需要释放轻量级锁。如果是同一个线程多次访问sychronize代码块,多次获取和释放轻量级,开销会偏大,所以会一开始判断对象是无锁状态,会将对象头设置为偏向锁,并且这个的线程ID添加到锁对象的Mark Word中,后续同一线程判断加锁标志是偏向锁,并且线程ID一致就可以直接执行。偏向锁的加锁过程: 线程发现是匿名偏向状态(也就是锁对象的Mark Word没有存储线程ID),则会用CAS指令,将 发现锁对象存储的线程ID就是当前线程的ID,会往当前线程的栈中添加一条 当没有获得锁的线程进入同步块时,发现当前是偏向锁状态,并且存储的是其他线程ID(也就是其他线程正在持有偏向锁),则会进入到撤销偏向锁的逻辑里,一般来说,会在 由此可见,偏向锁升级的时机为:当一个线程获得了偏向锁,在执行时,只要有另一个线程尝试获得偏向锁,并且当前持有偏向锁的线程还在同步块中执行,则该偏向锁就会升级成轻量级锁。 因此偏向锁的解锁很简单,其仅仅将线程的栈中的最近一条 重量级锁依赖于底层的操作系统的Mutex Lock来实现的,但是由于使用Mutex Lock需要将当前线程挂起并从用户态切换到内核态来执行,这种切换的代价是非常昂贵的,而在大部分时候可能并没有多线程竞争,只是多个线程交替执行,(例如:这段时间是线程A执行同步块,另外一段时间是线程B来执行同步块,仅仅是多线程交替执行,并不是同时执行,也没有竞争),如果采用重量级锁效率比较低。以及在重量级锁中,没有获得锁的线程会阻塞,获得锁之后线程会被唤醒,阻塞和唤醒的操作是比较耗时间的,如果同步块的代码执行比较快,等待锁的线程可以进行先进行自旋操作(就是不释放CPU,执行一些空指令或者是几次for循环),等待获取锁,这样效率比较高。所以轻量级锁天然瞄准不存在锁竞争的场景,如果存在锁竞争但不激烈,仍然可以用自旋锁优化,自旋失败后再升级为重量级锁。 JVM会为每个线程在当前线程的栈帧中创建用于存储锁记录的空间,我们称为Displaced Mark Word。如果一个线程获得锁的时候发现是轻量级锁,会把锁的Mark Word复制到自己的Displaced Mark Word里面。 然后线程尝试用CAS操作将自己线程栈中拷贝的锁记录的地址写入到锁对象的Mark Word中。如果成功,当前线程获得锁,如果失败,表示Mark Word已经被替换成了其他线程的锁记录,说明在与其它线程竞争锁,当前线程就尝试使用自旋来获取锁。 自旋:不断尝试去获取锁,一般用循环来实现。 自旋是需要消耗CPU的,如果一直获取不到锁的话,那该线程就一直处在自旋状态,白白浪费CPU资源。 JDK采用了适应性自旋,简单来说就是线程如果自旋成功了,则下次自旋时触发重量级锁的阀值会更高,如果自旋失败了,则自旋的次数就会减少。 自旋也不是一直进行下去的,如果自旋到一定程度(和JVM、操作系统相关),依然没有获取到锁,称为自旋失败,那么这个线程会阻塞。同时这个锁就会升级成重量级锁。 在释放锁时,当前线程会使用CAS操作将Displaced Mark Word的内容复制回锁的Mark Word里面。如果没有发生竞争,那么这个复制的操作会成功。如果有其他线程因为自旋多次导致轻量级锁升级成了重量级锁,那么CAS操作会失败,此时会释放锁并唤醒被阻塞的线程。轻量级锁的加锁解锁流程图: 每个对象都有一个监视器monitor对象,重量级锁就是由对象监视器monitor来实现的,当多个线程同时请求某个重量级锁时,重量级锁会设置几种状态用来区分请求的线程: Contention List 竞争队列:所有请求锁的线程将被首先放置到该竞争队列,我也不知道为什么网上的文章都叫它队列,其实这个队列是先进后出的,更像是栈,就是当Entry List为空时,Owner线程会直接从Contention List的队列尾部(后加入的线程中)取一个线程,让它成为OnDeck线程去竞争锁。(主要是刚来获取重量级锁的线程是会进行自旋操作来获取锁,获取不到才会进入Contention List,所以OnDeck线程主要与刚进来还在自旋,还没有进入到Contention List的线程竞争) Entry List 候选队列:Contention List中那些有资格成为候选人的线程被移到Entry List,主要是为了减少对Contention List的并发访问,因为既会添加新线程到队尾,也会从队尾取线程。 Wait Set 等待队列:那些调用wait()方法被阻塞的线程被放置到Wait Set。 OnDeck:任何时刻最多Entry List中只能有一个线程被选中,去竞争锁,该线程称为OnDeck线程。 Owner:获得锁的线程称为Owner。 !Owner:释放锁的线程。 流程图如下: 步骤1是线程在进入Contention List时阻塞等待之前,程会先尝试自旋使用CAS操作获取锁,如果获取不到就进入Contention List队列的尾部(所以不是公平锁)。 步骤2是Owner线程在解锁时,如果Entry List为空,那么会先将Contention List中队列尾部的部分线程移动到Entry List。(所以Contention List相当于是后进先出,所以也是不公平的) 步骤3是Owner线程在解锁时,如果Entry List不为空,从Entry List中取一个线程,让它成为OnDeck线程,Owner线程并不直接把锁传递给OnDeck线程,而是把锁竞争的权利交给OnDeck,OnDeck需要重新竞争锁,JVM中这种选择行为称为 “竞争切换”。(主要是与还没有进入到Contention List,还在自旋获取重量级锁的线程竞争) 步骤4就是OnDeck线程获取到锁,成为Owner线程进行执行。 等待和通知步骤(这是调用了wait()和notify()方法才有的步骤): 在同步块中,获得了锁的线程调用锁对象的Object.wait()方法,就是Owner线程调用锁对象的wait()方法进行等待,会移动到Wait Set中,并且会释放CPU资源,也同时释放锁, 就是当其他线程调用锁对象的Object.notify()方法,之前调用wait方法等待的这个线程才会从Wait Set移动到Entry List,等待获取锁。 偏向锁由于不涉及到多个线程竞争,所以谈不上公平不公平,轻量级锁获取锁的方式是多个线程进行自旋操作,然后使用用CAS操作将锁的Mark Word中存储的Lock Word替换为指向自己线程栈中拷贝的锁记录的指针,所以谁能获得锁就看运气,不看先后顺序。重量级锁不公平主要在于刚进入到重量级的锁的线程不会直接进入Contention List队列,而是自旋去获取锁,所以后进来的线程也有一定的几率先获得到锁,所以是不公平的。 因为那些处于ContetionList、EntryList、WaitSet中的线程均处于阻塞状态,阻塞操作由操作系统完成(在Linxu下通过pthreadmutexlock函数)。线程被阻塞后便进入内核(Linux)调度状态,这个会导致系统在用户态与内核态之间来回切换,严重影响锁的性能。如果同步块中代码比较少,执行比较快的话,后进来的线程先自旋获取锁,先执行,而不进入阻塞状态,减少额外的开销,可以提高系统吞吐量。 偏向锁升级为轻量级锁:就是有不同的线程竞争锁时。具体来看就是当一个线程发现当前锁状态是偏向锁,然后锁对象存储的Thread id是其他线程的id,并且去Thread id对应的线程栈查询到的lock record的obj字段不为null(代表当前持有偏向锁的线程还在执行同步块)。那么该偏向锁就会升级成轻量级锁。 轻量级锁升级为重量级锁:就是在轻量级锁中,没有获取到锁的线程进行自旋,自旋到一定次数还没有获取到锁就会进行锁升级,因为自旋也是占用CPU的,长时间自旋也是很耗性能的。 锁降级因为如果没有多线程竞争,还是使用重量级锁会造成额外的开销,所以当JVM进入SafePoint安全点(可以简单的认为安全点就是所有用户线程都停止的,只有JVM垃圾回收线程可以执行)的时候,会检查是否有闲置的Monitor,然后试图进行降级。 偏向锁:加锁解锁不需要进行CAS操作,适合一个线程多次访问同步块的场景。 轻量级锁:加锁和解锁使用CAS操作,没有像重量级锁那样底层操作系统的互斥量来加锁解锁,不涉及到用户态和内核态的切换和线程阻塞唤醒造成的线程上下文切换。没有获得锁的线程会自旋空耗CPU,造成一些开销。适合多线程竞争比较少,但是会有多线程交替执行的场景。 重量级锁:使用到了底层操作系统的互斥量来加锁解锁,但是会涉及到用户态和内核态的切换和线程阻塞和唤醒造成的线程上下文切换,但是不会自旋空耗CPU。 参考文章: AQS就是AbstractQueuedSynchronizer,抽象队列同步器,是一个可以用于实现基于先进先出等待队列的锁和同步器的框架。实现锁
ReentrantLock,CountDownLatch,Semaphore,ReentrantReadWriteLock,SynchronousQueue,FutureTask等等皆是基于AQS的。 ReentrantLock其实就是有一个变量sync,Sync父类是AbstractQueuedSynchronizer ReentrantLock的非公平锁与公平锁的区别在于非公平锁在CAS更新state失败后会调用tryAcquire()来判断是否需要进入同步队列,会再次判断state的值是否为0,为0会去CAS更新state值,更新成功就直接获得锁,否则就进入等待队列。(进等待队列之前会抢锁) 而公平锁首先判断state是否为0,为0并且等待队列为空,才会去使用CAS操作抢占锁,抢占成功就获得锁,没成功并且当前线程不是获得锁的线程,都会被加入到等待队列。 参考资料: 深入理解ReentrantLock的实现原理 相同点: 1.可重入性 两个锁都是可重入的,持有锁的线程再次申请锁时,会对锁的计数器+1。 不同点: 1.实现原理 synchronized是一个Java 关键字,是由JVM实现的,底层代码应该是C++代码。而ReentrantLock是JDK实现的,是Java提供的一个类库,代码是Java代码,源码实现更加方便阅读。 2.性能 在以前,synchronized锁的实现只有重量级锁一种模式,性能会比较差,后面引入了偏向锁和轻量级锁后就优化了很多。根据测试结果,在线程竞争不激烈的情况下,ReentrantLock与synchronized锁持平,竞争比较激烈的情况下,ReentrantLock会效率更高一些。 3.功能 synchronized只能修饰方法,或者用于代码块,而ReentrantLock的加锁和解锁是调用lock和unlock方法,更加灵活。 其次是synchronized的等待队列只有一个(调用wait()方法的线程会进入等待队列),而ReentrantLock可以有多个条件等待队列。可以分组唤醒需要唤醒的线程们,而不是像synchronized要么用notify方法随机唤醒一个线程要么用notifyAll方法唤醒全部线程。ReentrantLock 提供了一种能够中断等待锁的线程的机制,就是线程通过调用lock.lockInterruptibly()方法来加锁时,一旦线程被中断,就会停止等待。 ReentrantLock可以使用tryLock(long timeout, TimeUnit unit)方法来尝试申请锁,设置一个超时时间,超过超时时间,就会直接返回false,而不是一直等待锁。 ReentrantLock可以响应中断,而synchronized锁不行 4.公平性 synchronized锁是非公平锁,ReentrantLock有公平锁和非公平锁两种模式。 https://www.codercto.com/a/22884.html ReentrantLock非公平锁的加锁流程: 1.尝试着使用CAS操作将锁的状态state由0修改为1,修改成功则线程获得锁。 2.不成功就会再次尝试去抢锁,以及判断这个线程是否是当前持有锁的线程(如果是只需要将state+1,代表锁重入)。 3.抢锁没成功,也不是持有锁的线程,那么就会添加到等待队列然后调用Lock.Support.park()方法进行阻塞等待,然后被唤醒。 公平锁加锁过程: 1.如果当前锁没有被其他线程持有,并且等待队列中也没有其他线程等待,那么就使用CAS操作去抢锁。 2.或者线程就是当前持有锁的线程,那么就对state+1,代表锁重入。 3.以上情况都不是,就加入到等待队列进行等待。 非公平锁解锁流程 https://blog.csdn.net/qq_14996421/article/details/102967314 https://blog.csdn.net/fuyuwei2015/article/details/83719444 AQS是AbstractQueuedSynchronizer的缩写,是一个抽象同步队列类,可以基于它实现一个锁,例如ReentrantLock,只是需要实现tryAcquire()方法(也就是获取资源的方法,判断当前线程能否申请到独占锁)和tryRelease()方法(也就是释放资源的方法,在线程释放锁前对state进行更新),AQS会根据tryAcquire()的返回结果,来进行下一步的操作, 如果为true,代表线程获得锁了。 如果为false,代表线程没有获得锁,由AQS负责将线程添加到CLH等待队列中,并且进行阻塞等待。当前一个线程释放锁时,AQS对这个线程进行唤醒。 (不同的自定义同步器争用共享资源的方式也不同。自定义同步器在实现时只需要实现资源state的获取与释放方法即可,至于具体线程等待队列的维护(如获取资源失败入队/唤醒出队等),AQS已经在顶层实现好了) 公平锁加锁过程 加锁方法调用栈 对于加锁,ReentrantLock只需要去实现tryAcquire()方法,去根据state判断当前线程能不能获取锁,能获取就会返回true。不能获取就会返回false,然后由AQS来将未获得锁的线程添加到CLH队列尾部,然后等待被唤醒。(公平锁与非公平锁也就在于ReentrantLock的tryAcquire实现的区别,当锁被其他线程占用时,公平锁是只有当前等待队列没有其他线程时,才能去抢锁,而非公平锁则没有这个限制,在申请锁时就能去抢锁。) 可以看到AQS的acquire()方法中是会先去调用tryAcquire()去尝试着申请独占锁资源,AQS默认的tryAcquire()方法只有一行代码,会抛出UnsupportedOperationException异常(强制子类对这个方法进行实现)。所以ReentrantLock的FairSync对tryAcquire()方法进行了实现。 tryAcquire()返回true就代表获取独占锁资源成功: 1.等待队列没有其他线程且这个线程CAS操作设置state成功 2.当前线程就是持有锁的线程,那么只需要对state+1即可。 tryAcquire()返回false代表获取独占锁资源失败, 那么就调用AQS.addWaiter()方法申请失败就将线程添加到等待队列尾部,AQS.acquireQueued()方法让这个线程进入阻塞等待状态(在阻塞之前如果等待队列只有这一个线程,是会先尝试着获取锁,失败才会进入阻塞状态。) 公平锁解锁过程: 解锁方法调用栈 对于解锁,ReentrantLock的公平锁和非公平锁的实现是一样的,都是对state赋以最新的值,然后由AQS的unparkSuccessor方法负责对线程进行唤醒。 https://www.cnblogs.com/waterystone/p/4920797.html 就是假定在每次取数据的时候会修改这个数据,所以在取数据的时候就会进行加锁,这样其他调用者就不能取数据,阻塞等待,一直到获取到锁。Java中的同步锁sychronized和ReentrantLock就是悲观锁思想的实现。 悲观锁适合多写的场景 乐观锁适合多读的场景,这样只有读写冲突会发生的比较少,减少加锁的性能开销。但是如果是多写的场景,这样会导致上层应用一直重试,增加性能开销。 就是假定在每次取数据时不会修改这个数据,所以在取数据的时候不会加锁,只有在真正修改数据时才加锁。Java中的atomic原子变量类就是乐观锁的实现。 使用版本号来实现,对数据加上一个版本号,代表修改次数,每次修改后+1,修改数据时判断数据的版本号跟之前取的是否一致,一致才修改,不一致就重试,直到更新成功。 就是在更新数据时会传入之前取的值,在内存中判断当前内存中的值跟之前的值是否一致,一致再更新,(比较和更新都是在一个原子操作中)。 使用CAS更新是没法解决ABA的问题,就是其他调用方对数据修改成其他值后又改回原来的值。AtomicStampedReference的compareAndSet会先判断对象的引用是否相同,相同才进行CAS更新。实现原理主要是AtomicStampedReference会保存之前对象的的引用,及一个修改版本号,只有当引用和版本号都相等的情况下,才会进行CAS更新操作。 1.循环时间长开销大 自旋CAS操作如果不成功就一直循环执行直到成功,如果长时间不成功,会给CPU带来非常大的执行开销 2.CAS 只对单个共享变量有效 多个变量放在一个对象里来进行 CAS 操作.所以我们可以使用锁或者利用 原子类一共有以下四种 主要是对Integer的封装,提供了一些原子性的操作,因为如果是使用Integer来完成i=i+1;操作,在内存中是三个步骤,先将从内存中取出i,放到寄存器中,然后将寄存器中的值与1相加,然后将结果写入内存,一共是三个步骤,所以不是原子性的,并发时会造成数据不一致的问题。 主要实现原理是AtomicInteger类有一个unsafe属性,可以通过unsafe来调用Unsafe类的一些原子性的方法Unsafe.compareAndSwapInt来实现原子性的加减运算。 其次是使用volatile来修饰value属性,保证一个内存可见性 在Unsafe类中,compareAndSwapInt和getAndAddInt的区别在于,getAndAddInt会一直重试直到成功,compareAndSwapInt如果更新失败,只会返回false (PS:扫描首页里面的二维码进群,分享我自己在看的技术资料给大家,希望和大家一起学习进步!) 下面是主要是自己看完《Redis设计与实现》,《Redis深度历险:核心原理与应用实践》后,为了更好得掌握Redis,网上找了一些面试题,查阅书籍和资料后,写的解答。 Redis是一个开源的,基于内存的,也可进行持久化的,使用C语言编写的键值对存储数据库。 在访问key时,如果发现key已经过期,那么会将key删除。 Redis配置项hz定义了serverCron任务的执行周期,默认每次清理时间为25ms,每次清理会依次遍历所有DB,从db的expires字典(里面保存了设置了过期时间的键值对,key就是指向键对象,value是过期时间)中随机取出20个key,如果过期就删除,如果其中有5个key过期,说明过期率超过了25%,那么就继续对这个db进行清理,否则开始清理下一个db。 当执行写入命令时,如果发现内存不够,那么就会按照配置的淘汰策略清理内存,淘汰策略一般有6种,Redis4.0版本后又增加了2种,主要由分为三类 这种就是从设置了expires过期时间的结果集中选出一部分key淘汰,挑选的算法有: LRU算法的设计原则是如果一个数据近期没有被访问到,那么之后一段时间都不会被访问到。所以当元素个数达到限制的值时,优先移除距离上次使用时间最久的元素。 可以使用双向链表Node+HashMap PS:使用单向链表能不能实现呢,也可以,单向链表的节点虽然获取不到pre节点的信息,但是可以将下一个节点的key和value设置在当前节点上,然后把当前节点的next指针指向下下个节点,这样相当于把下一个节点删除了 LFU算法的设计原则时,如果一个数据在最近一段时间被访问的时次数越多,那么之后被访问的概率会越大,实现是每个数据都有一个引用计数,每次数据被访问后,引用计数加1,需要淘汰数据时,淘汰引用计数最小的数据。在Redis的实现中,每次key被访问后,引用计数是加一个介于0到1之间的数p,并且访问越频繁p值越大,而且在一定的时间间隔内,如果key没有被访问,引用计数会减少。 Redis官方FAQ回答: Redis是基于内存的操作,读取数据很快,不需要在某个线程读取数据时,切换到另一个线程来执行来提高CPU利用率,所以CPU不会成为瓶颈所在,Redis的瓶颈最有可能是机器内存的大小或者网络带宽。既然单线程容易实现,而且CPU不会成为瓶颈,那就顺理成章地采用单线程的方案了。
(这里的单线程指的是处理客户端发送的请求命令的文件处理器模块是单线程,其他模块不一定是单线程的。从Redis 4.0版本后,Redis又逐渐引入了多线程。) 1.Redis项目的代码会更加清晰,处理逻辑会更加简单。 2.不用考虑多个线程修改数据的情况,修改数据时不用加锁,解锁,也不会出现死锁的问题,导致性能消耗。 3.不存在多进程或者多线程导致的切换而造成的一些性能消耗。 1.无法充分发挥多核机器的优势,不过可以通过在机器上启动多个Redis实例来利用资源。(但是启动多个Redis实例可能会导致在进行AOF重写时,竞争IO资源,导致磁盘写入压力过大,所以可以使用脚本来触发实例的AOF重写,让所有实例的 AOF 串行执行。) 根据官网的介绍,Redis单机可以到到10W的QPS(每秒处理请求数),Redis这么快的原因主要有以下几点: 1.完全基于内存,数据全部存储在内存中,内存读取时没有磁盘IO,所以速度非常快。 2.Redis采用单线程的模型,没有上下文切换的开销,也没有竞态条件,不用去考虑各种锁的问题,不存在加锁释放锁操作,没有因为可能出现死锁而导致的性能消耗。 3.Redis项目中使用的数据结构都是专门设计的,例如SDS(简单动态字符串)是对C语言中的字符串频繁修改时,会频繁地进行内存分配,十分消耗性能,而SDS会使用空间预分配和惰性空间释放来避免这些问题的出现。
空间预分配技术: 对SDS进行修改时,如果修改后SDS实际使用长度为len, 当len<1M时,分配的空间会是2*len+1,也就是会预留len长度的未使用空间,其中1存储空字符 当len>1M时,分配的空间会是len+1+1M,也就是会预留1M长度的未使用空间,其中1存储空字符 4.采用多路复用IO模型,可以同时监测多个流的IO事件能力,在空闲时,会把当前线程阻塞掉,当有一个或多个流有I/O事件时,就从阻塞态唤醒,轮询那些真正发出了事件的流,并只依次顺序的处理就绪的流。可以让单个线程高效的处理多个连接请求(尽量减少网络 I/O 的时间消耗)。 IO模型主要由阻塞式I/O模型,非阻塞式I/O模型,I/O复用模型,信息驱动式I/O模型,异步I/O模型。 用户态进程发出一个IO请求时,会调用recvfrom系统调用去获取数据,如果当前内核中数据没有准备好,那么会让出CPU时间片,一直阻塞等待,不会进行其他操作。直到内核中的数据准备好,将数据拷贝到用户空间内存,然后recvfrom返回成功的信号,此时用户态进行才解除阻塞的状态,处理收到的数据。 在非阻塞式I/O模型中,当进程等待内核的数据,而当该数据未到达的时候,进程会不断询问内核,直到内核准备好数据。
用户态进程调用recvfrom接收数据,当前并没有数据报文产生,此时recvfrom返回EWOULDBLOCK,用户态进程会一直调用recvfrom询问内核,待内核准备好数据的时候,之后用户态进程不再询问内核,待数据从内核复制到用户空间,recvfrom成功返回,用户态进程开始处理数据。 I/O复用指的是多个I/O连接复用一个进程。 基础版的I/O复用模型 最初级的I/O复用,就是一个进程对应多个Socket连接,每次从头至尾进行遍历,判断是否有I/O事件准备好了,需要处理,有的话就进行处理,缺点是效率比较低,如果一直没有事件进来,会导致CPU空转。 升级版的I/O复用模型: select和poll 当没有I/O事件时,进程处于阻塞状态,当有I/O事件时,就会有一个代理去唤醒进程,对所有的文件描述符进行轮询(一个文件描述符对应一个Socket连接),来处理I/O事件。(这里的代理也就是select和poll,select只能观察1024个连接,poll可以观察无限个连接,因为poll是基于链表来实现的) epoll epoll是对select和poll的升级版,解决了很多问题,是线程安全的,而且可以通知进程是哪个Socket连接有I/O事件,不需要进行全部连接进行遍历,提高了查找效率。 epoll和select/poll最大区别是 (1)epoll内部使用了mmap共享了用户和内核的部分空间,避免了数据的来回拷贝。
(2)epoll基于事件驱动,epoll_wait只返回发生的事件避免了像select和poll对事件的整个轮寻操作(时间复杂度为O(N)),epoll时间复杂度为O(1)。 是非阻塞的,当需要等待数据时,用户态进程会给内核发送一个信号,告知自己需要的数据,然后就去执行其他任务了,内核准备好数据后,会给用户态发送一个信号,用户态进程收到之后,会立马调用recvfrom,等待数据从从内核空间复制到用户空间,待完成之后recvfrom返回成功指示,用户态进程才处理数据。 与信息驱动式I/O模型区别在于,是在数据从内核态拷贝到用户空间之后,内核才通知用户态进程来处理数据。在复制数据到用户空间这个时间段内,用户态进程也是不阻塞的。 参考链接: http://blog.csdn.net/lzb348110175/article/details/98941378 https://xie.infoq.cn/article/b3816e9fe3ac77684b4f29348 水平触发和边缘触发两种: 只会提示一次,直到下次再有数据流入之前都不会再提示,无论fd中是否还有数据可读。所以在ET模式下,read一个fd的时候一定要把它的buffer读完,即读到read返回值小于请求值或遇到EAGAIN错误 epoll使用“事件”的就绪通知方式,通过 同步与异步的区别在于调用结果的通知方式上。
同步执行一个方法后,需要等待结果返回轮询调用结果才能继续执行,然后继续执行下去。
异步执行一个方法后,不会等待结果的返回,被调用方在执行完成后通过回调来通知调用方继续执行。 阻塞与非阻塞的区别在于进程/线程在等待消息时,进程/线程是否是挂起状态。 在消息发出去后,消息返回之前,当前进程/线程会被挂起,直到有消息返回,当前进/线程才会被激活。 在消息发出去后,不会阻塞当前进/线程,而会立即返回,可以去执行其他任务。 一次IO的读操作分为等待就绪和IO操作两个阶段,等待就绪就是等待TCP RecvBuffer里面的数据就绪好,也就是发送方的数据全部发送到网卡里面来,操作就是CPU将数据从网卡拷贝到用户空间。 BIO(同步阻塞型) 以Java中的IO方式为例,BIO就是同步阻塞型的IO,当一个Socket连接发送数据过来以后,需要为这个Socket连接创建一个线程,由线程调用Socket的read()方法读取数据,需要先把数据从网卡拷贝到内核空间,再拷贝到用户态的内存空间,在数据读取完成前,线程都是阻塞的。这种IO方式就是比较消耗资源,假设有1000个活跃的Socket连接,需要创建出1000个线程来读取数据,读取时都是阻塞的,每个线程有自己独有的线程栈,默认大小是1M。 NIO(同步非阻塞型) nio就是多路io复用,就是一个线程来处理多个Socket连接,节省线程资源。以select为例,就是有一个长度为1024的数组,每个元素对应一个Socket连接,线程轮询这个数据,判断哪个Socket连接的数据是出于就绪状态,此时就将数据拷贝到用户空间然后进行处理。由于IO操作阶段是需要等待数据拷贝到用户空间完成才能返回,所以是同步的。由于每次判断内核中Socket缓冲区的数据是否就绪的函数是直接返回的,如果就绪就返回有数据,不是就绪就返回0,线程不需要阻塞等待,所以是非阻塞的。 AIO(异步非阻塞型) AIO就是NIO的升级版,在数据处于就绪状态时,也是异步将Socket缓冲区中的数据拷贝到用户空间,然后执行异步回调函数,所以在IO操作阶段也是异步的。 BIO里用户最关心“我要读”,NIO里用户最关心"我什么时候可以读了",在AIO模型里用户更需要关注的是“什么时候读完了,我可以直接进行处理了”。 https://zhuanlan.zhihu.com/p/23488863 https://www.cnblogs.com/sxkgeek/p/9488703.html https://blog.csdn.net/weixin_34378045/article/details/91930797 Redis 缓存穿透指的是攻击者故意大量请求一些Redis缓存中不存在key的数据,导致请
求打到数据库上,导致数据库压力过大。 1.做好参数校验,无效的请求直接返回,只能避免一部分情况,攻击者总是可以找到一些没有覆盖的情况。 2.对缓存中找不到的key,需要去数据库查找的key,缓存到Redis中,但是可能会导致Redis中缓存大量无效的key,可以设置一个很短的过期时间,例如1分钟。 3.也可以使用布隆过滤器,将所有可能的存在的数据通过去hash值的方式存入到一个足够大的bitmap中去,处理请求时,通过在bitmap中查找,可以将不存在的数据拦截掉。 缓存击穿主要指的是某个热点key失效,导致大量请求全部转向数据库,导致数据库压力过大。 1.对热点key设置永不过期。 2.加互斥锁,缓存中没有热点key对应的数据时,等待100ms,由获得锁的线程去读取数据库然后设置缓存。 缓存雪崩主要指的是短时间内大量key失效,导致所有请求全部转向数据库,导致数据库压力过大。 1.在给缓存设置失效时间时加一个随机值,避免集体失效。 2.双缓存机制,缓存A的失效时间为20分钟,缓存B的失效时间会比A长一些,从缓存A读取数据,缓存A中没有时,去缓存B中读取数据,并且启动一个异步线程来更新缓存A(如果已经有异步线程正在更新了,就不用重复更新了)。以及更新缓存B,以便延迟B的过期时间。 首先需要明白会导致缓存与数据库的数据不一致的几个诱因:
多个写请求的执行顺序不同导致脏数据。
更新时正好有读请求,读请求取到旧数据然后更新上。或者数据库是读写分离的,在主库更新完之后,需要一定的时间,从库才能更新。 1.两个写请求,写请求A,写请求B,A先更新数据库,B后更新数据库,但是可能B会先更新缓存,A后更新缓存,这样就会导致缓存里面的是旧数据。
2.更新缓存时失败也有可能导致缓存是旧数据。 1.删除缓存后,更新数据库之前假如正好有读请求,读请求把旧数据设置到缓存了。 1.更新后删除缓存时,网络不好,删除失败也有可能导致缓存是旧数据。 2.写请求A更新数据库然后删除缓存,读请求B读数据时发现缓存中没有数据,就从数据库拿到旧数据准备设置到缓存上去时,如果整个架构是读写分离的,写请求更新数据是在主库上更新,读请求B是去从库上读数据,如果此时主库上的新数据还没有同步到从库,这样读请求B在从库读到旧数据,设置到缓存上,导致缓存里面是旧数据。 将写请求更新之前先获取分布式锁,获得之后才能更新,这样实现写请求的串行化,但是会导致效率变低。 先更新数据库,异步删除缓存,删除缓存失败时,继续异步重试,或者将操作放到消息队列中,再进行删除操作。(如果数据库是读写分离的,那么删除缓存时需要延迟删除,否则可能会在删除缓存时,从库还没有收到更新后的数据,其他读请求就去从库读到旧数据然后设置到缓存中。) 业务项目直接更新数据库,然后其他项目订阅binlog,接收到更新数据库操作的消息后,更新缓存,更新缓存失败时,新建异步线程去重试或者将操作发到消息队列,然后后续进行处理。但是这种方案更新mysql后还是有一定延迟,缓冲中才是新值。 参考资料:https://www.cnblogs.com/rjzheng/p/9041659.html Redis中主要的数据结构有字符串,Hash哈希表,List列表,Set集合,ZSet有序集合。 Redis中的简单动态字符串其实是对C语言中的字符串的封装和优化, 1.不是二进制安全的(因为字符串以空字符作为结束的标志,字符串中间不能有空字符,Redis的简单动态字符串是一个结构体,有一个变量存储了字符串的长度,所以不需要以空字符作为结束的标志)。 从定义上来看,二进制安全是一种主要用于字符串操作函数相关的计算机编程术语。一个二进制安全功能(函数),其本质上将操作输入作为原始的、无任何特殊格式意义的数据流。对于每个字符都公平对待,不特殊处理某一个字符。 简单来说C语言使用\0字符来作为字符串结束符是不符合这种二进制安全的规范的。 2.频繁修改一个字符串时,会涉及到内存的重分配,比较消耗性能。(Redis中的简单动态字符串会有内存预分配和惰性空间释放)。 如果字符串实际使用长度len<1M,实际分配空间=len长度来存储字符串+1字节存末尾空字符+len长度的预分配空闲内存 如果字符串实际使用长度len>1M,实际分配空间=len长度来存储字符串+1字节存末尾空字符+1M长度的预分配空闲内存 所以Redis中的简单动态字符串结构,除了包含一个字符数组的属性,还包含数组的长度,数组的实际使用长度等属性,通过增加长度属性,可以保证字符串是二进制安全的,从而可以保存任意类型的数据,例如一张图片,对象序列化后的数据等等。 1.字符串可以保存一些字符串数据,也可以保存一些数字类型的数据,所以可以使用INCR, DECR, INCRBY对数字进行加减,所以可以把字符串当成计数器使用。 2.同时因为在C语言中,每个字符是一个字节,是8个二进制位,所以可以把简单动态字符串作为一个位数组来使用,通过setbit,getbit命令来对位数组进行赋值,取值,可以以很小的空间来保存用户一年的每日签到数据,以及Redis中的布隆过滤器也是通过位数组来实现的。 在Redis中,每一个Value都是一个Redis对象,对应的都是RedisObject结构,在RedisObject结构中,保存了对象的类型type,底层的编码encoding等一些属性,也拥有一个ptr指针,指向对象具体的存储地址。 在Redis中,字符串有两种存储方式,int编码,embstr编码和raw编码。 当value是一个整数,并且可以使用long类型(8字节)来表示时,那么会属于int编码,ptr直接存储数值。(并且Redis会进行优化,启动时创建0~9999的字符串对象作为共享变量。) 两种存储方式下,都RedisObject和SDS结构(简单动态字符串)来存储字符串,区别在于,embstr对象用于存储较短的字符串,embstr编码中RedisObject结构与ptr指向的SDS结构在内存中是连续的,内存分配次数和内存释放次数均是一次,而raw编码会分别调用两次内存分配函数来分别创建RedisObject结构和SDS结构。 在Redis中,value可以是一个hash表,底层编码可以是ziplist,也可以是hashtable(默认情况下,当元素小于512个时,底层使用ziplist存储数据) 元素保存的字符串长度较短且元素个数较少时(小于64字节,个数小于512),出于节约内存的考虑,hash表会使用ziplist作为的底层实现,ziplist是一块连续的内存,里面每一个节点保存了对应的key和value,然后每个节点很紧凑地存储在一起,优点是没有冗余空间,缺点插入新元素需要调用realloc扩展内存。(可能会进行内存重分配,将内容拷贝过去,也可能在原有地址上扩展)。 元素比较多时就会使用hashtable编码来作为底层实现,这个时候RedisObject的ptr指针会指向一个dict结构,dict结构中的ht数组保存了ht[0]和ht[1]两个元素,通常使用ht[0]保存键值对,ht[1]只在渐进式rehash时使用。hashtable是通过链地址法来解决冲突的,table数组存储的是链表的头结点(添加新元素,首先根据键计算出hash值,然后与数组长度取模之后得到数组下标,将元素添加到数组下标对应的链表中去)。 进行当负载因子>=1时,会进行哈希表扩展操作(如果是在执行BGSAVE或BGREWRITEAOF命令期间,那么需要>=5才会进行扩展)。 进行当负载因子<0.1时,会进行哈希表收缩操作。 因为直接一次性完成rehash会对性能产生影响,所以可以渐进式rehash,具体执行步骤是: 1.首先将对dict结构中ht[1]哈希表分配空间(大小取决于最接近实际使用空间的2的n次方幂),然后将rehashindex属性设置为0。 2.这种渐进式rehash转移元素不是全部转移,如果在rehash时全部转移,可能会导致rehash期间Redis实例无法处理后面的请求,所以采取的策略是每次用到某个下标下的键值对才进行转移这个下标下所有的键值对。然后每次对ht[0]中的元素查找,修改,添加时,除了执行指定操作外,还会将对应下标的所有键值对rehash到ht[1],并且会将rehashindex+1。 3.当ht[0]中所有键值对都是rehash到ht[1]中后,那么会ht[1]和ht[0]的指针值进行交换,将rehashindex设置为-1,代表rehash完成。
(整个rehash期间,查找,更新,删除会先去ht[0]中执行,没有才会到ht[1]中执行,新添加键值对是会被保存到ht[1]中)。 在Redis中,存储的value可以是一个列表List,跟Java中的LinkedList很像,底层数据结构是一个链表,插入和删除很快,随机访问较慢,时间复杂度是O(N)。Java中的列表数据进行缓存时一般是序列化成JSON,以字符串的形式存储在Redis上,而不是使用Redis中的List来进行存储。Redis中的List可以作为一个队列来使用,也可以作为一个栈来使用。在实际使用中,常用来做异步队列使用,将可以延时处理的任务序列化成字符串塞进Redis的列表,另外一个线程从列表中轮询数据进行处理 老版本中的Redis,元素较少时,使用ziplist来作为底层编码,元素较多时使用双向链表linkedList作为底层编码。因为链表每个节点需要prev,next指针,需要占用16字节,而且每个节点内存都是单独分配,加剧内存碎片化,所以新版本使用quiklist作为底层编码,quicklist的是一个双向链表,但是它的每一个节点是一个ziplist。(默认每个ziplist最大长度为8k字节) Set是一个无序的,不重复的字符串集合,底层编码有inset和hashtable两种。 当元素都为整数,且元素个数较少时会使用inset作为底层编码,inset结构中的有一个contents属性,content是是一个整数数组,从小到大保存了所有元素。 当元素个数较多时,Set使用hashtable来保存元素,元素的值作为key,value都是NULL。 Zset与Set的区别在于每一个元素都有一个Score属性,并且存储时会将元素按照Score从低到高排列。底层是通过跳跃表实现的。 当元素较少时(元素个数<128个,且每个元素的长度小于64字节),ZSet的底层编码使用ziplist实现,所有元素按照Score从低到高排序。 当元素较多时,使用skiplist+dict来实现。
skiplist存储元素的值和Score,并且将所有元素按照分值有序排列。便于以O(logN)的时间复杂度插入,删除,更新,及根据Score进行范围性查找。 dict存储元素的值和Score的映射关系,便于以O(1)的时间复杂度查找元素对应的分值。 布隆过滤器可以理解为一个有误差的set结构,使用布隆过滤器来判断元素是否存在其中时, 如果返回结果是存在,实际可能存在也可能不存在, 返回结果不存在时,实际结果肯定是不存在。 布隆过滤器实际上是一个大型的位数组,添加key时,通过几个hash函数对key计算得到多个hash值,将每个hash值与布隆过滤器的位数组的size取模得到下标,然后将数组中这些下标位置的值都设置为1。 创建key为userid的布隆过滤器,0.01是误判率,10000是初始大小 调用exist指令判断181920是否存在于布隆过滤器,如果返回0,不存在,那么说明一定不存在,如果返回1,代表可能存在,也可能不存在。 参考链接: https://blog.csdn.net/lifetragedy/article/details/103945885 就是单链表的查找的时间复杂度为O(N),为了提高查询效率,可增加一些索引节点,让查询时间复杂度降低为O(logN)。(只有底层单链表会保存节点数据,上层的节点之后保存几个索引项和分数,也就是向左指向前一个节点的索引,向右指向后一个节点的索引,向下指向上一级的索引。) 时间复杂度的推理过程可以认为,从每一级索引中两个节点中选一个节点作为下一级索引的节点,让下一级索引的节点数量为本级索引节点数量的一半。假设原始链表的长度为n,第一级索引节点个数为n/2,第二级为n/4,一直到最高层。 但是这种全索引的结构有缺点,就是之后在插入新节点时,是没有办法为新节点添加一些新的索引节点的。所以有可能会导致一个小区间内有很多个节点,查找时近似于单链表,这样时间复杂度就变成O(N)了,所以Redis对跳跃表做了一些优化,可以简单认为会计算出一个随机数,代表这个添加添加的索引层数,然后进行添加。同时假设节点拥有k层索引的概率f(k),节点拥有k-1层索引结构的概率为f(k-1),f(k) = f(k-1)P,假设p为1/2,那么也就是f(k)=f(k-1)\0.5,那么第k层的索引节点数也就是为k-1层的0.5倍。最终索引结构跟上面的这种全索引结构是类似的,只是索引节点不一定分布均匀。空间复杂度=每一层索引节点数=n+n/2+n/4….=2n。Redis做了优化,发现P取1/4时,时间复杂度跟P取1/2是一样的,并且空间复杂度更低。 Redis计算总层数的算法大致是,初始层数是1层,在while循环内,取一个随机数, 有1/4的概率,层数+1。 有3/4的概率,层数不变,结束循环。 要原因是因为作为一种动态的数据结构,其删除和添加的节点是不可预测的,而跳跃表又不能像平衡二叉树那样,可以通过染色或者旋转来维持平衡,如果严格按照两个节点之间建立一个索引,在删除和添加节点时,需要更新的索引太多了。所以在这种情况下,就需要一种概率随机化的方式来自动均衡跳跃表的多级索引,通过这种方式虽然不能完全保证跳跃表的均匀性,但总体上可以使得跳跃表趋于平衡,从而能够达到较高的综合性能。 新插入了很多节点后带来的问题: 时间复杂度与空间复杂度 空间复杂度的公式是 空间复杂度= 1/(1-P) 1.单key查找时,跳跃表和平衡树的时间复杂度为O(log(N)),哈希表的时间复杂度为O(1)。 2.范围查找时,跳跃表和平衡树可以Log(N)的复杂度进行范围查找,但是平衡树在找到指定范围的左区间后,还需要进行中序遍历以找到不超过右区间的节点,相对来说,实现会复杂一些。 3.在删除和插入节点后,平衡树需要进行左旋,右旋,进行调整保证平衡性。而跳跃表只需要修改相邻节点的指针,然后计算这个新增节点的层数,每一层指向相应的节点。 4.从内存占用上来说,skiplist比平衡树更灵活一些。一般来说,平衡树每个节点包含2个指针(分别指向左右子树),而skiplist每个节点包含的指针数目平均为1/(1-p),具体取决于参数p的大小。如果像Redis里的实现一样,取p=1/4,那么平均每个节点包含1.33个指针,比平衡树更有优势。 参考链接: https://www.cnblogs.com/Elliott-Su-Faith-change-our-life/p/7545940.html 首先MySQL的业务场景对应的数据量都是几千万数量级的,数据是不可能全部加载到内存中的,只能是部分数据加载到内存中。而Redis是个基于内存的数据库,数据是可以全部加入到内存中的。 磁盘IO的开销 对机械磁盘进行一次IO读取操作开销是非常大的,磁盘读取的速度大致是内存读取速度的几百分之一。所以操作系统做了一些优化,进行一次磁盘IO操作时,会进行一些预读,不仅是将当前磁盘地址的数据读取到内存中,而是把相邻数据也读取到内存缓存区。(因为局部性预读原理告诉我们,当计算机访问一个地址的数据的时候,与其相邻的数据也会很快被访问到。每一次IO读取的数据我们称之为一页(page)。具体一页有多大数据跟操作系统有关,一般为4k或8k,innodb中一页是16K。) 而一般innodb的B+树一般是2到4层,也就是最多进行2到4次磁盘IO,就可以查找到对应值所在的叶子节点,然后进行操作。而如果是跳跃表,查找一个Score对应的位置是需要进行Log(N)次的操作,如果跳跃表的索引节点都存在磁盘中,那么也就需要Log(N)次的磁盘IO。 之前说了平衡树的查找时间复杂度是O(log2N),已经很不错了,但还是不适合作为索引结构。主要是因为索引通常是很大的,因此无法一次将全部索引加载到内存当中,因此每次只能从磁盘中读取一个磁盘页的数据到内存中。而这个磁盘的读取的速度较内存中的读取速度而言是差了好几个级别。我们说的平衡二叉树结构,指的是逻辑结构上的平衡二叉树,其物理实现是数组。然后由于在逻辑结构上相近的节点在物理结构上可能会差很远。因此,每次读取的磁盘页的数据中有许多是用不上的。因此,查找过程中要进行许多次的磁盘读取操作。 而适合作为索引的结构应该是尽可能少的执行磁盘IO操作,因为执行磁盘IO操作非常的耗时。因此,平衡二叉树并不适合作为索引结构。 https://www.cnblogs.com/aspirant/p/9214485.html Zset是基于跳跃表+字典实现的,如果只是单key查询,那么就直接从字典中查询(字典的key就是保存了元素的值,value则是元素的分值score),这样可以用O(1)的时间复杂度完成查询。如果是根据分值score进行范围查询,就是去跳跃表中查询 跳跃表的查询 跳跃表中查找元素只需要通过节点的前进指针完成。 因为每个节点有多层前进指针,首先取第一个节点的最上层的前进指针level[i],比较指针level[i]跳转到的节点的score与查找的score的大小 如果大于,那么说明要查找的score就处于当前节点与当前的level[i]跳转的节点之间,不能跳转,直接下降一级,取level[i-1]的指针进行判断。如果level[i-1]是最下面的一层,也就是单链表的指针,那么就直接向后进行遍历查找,直到找到这个score或者第一个大于这个score的值(也就是范围查找的左边界)。 如果小于,说明说明要查找的score就处于当前节点与当前的level[i]跳转的节点的后面,跳转后,取跳转后的节点进行这个判断。 https://www.cnblogs.com/kexinxin/p/11699230.html https://blog.csdn.net/L597692583/article/details/53305044 (PS:扫描首页里面的二维码进群,分享我自己在看的技术资料给大家,希望和大家一起学习进步!) 下面是主要是自己看完《Redis设计与实现》,《Redis深度历险:核心原理与应用实践》后,为了更好得掌握Redis,网上找了一些面试题,查阅书籍和资料后,写的解答。 因为Redis是基于内存的数据库,一旦断电,所有实例都会关机,所有数据都会丢失,在运行期间,可以通过开启Redis的持久化功能,将数据写入磁盘,供实例重启时恢复数据。Redis的持久化主要通过AOF和RDB实现持久化。 AOF持久化主要是Redis在修改相关的命令后,将命令添加到aof_buf缓存区(aof_buf是Redis中的SDS结构,SDS结构可以认为是对C语言中字符串的扩展)的末尾,然后在每次事件循环结束时,根据appendfsync的配置(always是每次事件循环都将aof_buf缓冲区的内容写入,everysec是每秒写入,no是根据操作系统来决定何时写入),判断是否需要将aof_buf写入AOF文件。生产环境中一般用默认配置everysec,也就是每秒写入一次,一旦挂机会丢掉1分钟的数据。 RDB持久化指的是在满足一定的触发条件时(在一个的时间间隔内执行修改命令达到一定的数量,或者手动执行SAVE和BGSAVE命令),对这个时间点的数据库所有键值对信息生成一个压缩文件dump.rdb,然后将旧的删除,进行替换。(在Redis默认的配置下,RDB是开启的,AOF持久化是关闭的) 实现原理是fork一个子进程,然后对键值对进行遍历,生成rdb文件,在生成过程中,父进程会继续处理客户端发送的请求,当父进程要对数据进行修改时,会对相关的内存页进行拷贝,修改的是拷贝后的数据。(也就是COPY ON WRITE,写时复制技术,就是当多个调用者同时请求同一个资源,如内存或磁盘上的数据存储,他们会共用同一个指向资源的指针,指向相同的资源,只有当一个调用者试图修改资源的内容时,系统才会真正复制一份专用副本给这个调用者,其他调用者还是使用最初的资源,在CopyOnWriteArrayList的实现中,也有用到,添加或者插入一个新元素时过程是,加锁,对原数组进行复制,然后添加新元素,然后替代旧数组,解锁) AOF因为是保存了所有执行的修改命令,粒度更细,进行数据恢复时,恢复的数据更加完整,但是由于需要对所有命令执行一遍,效率比较低,同样因为是保存了所有的修改命令,同样的数据集,保存的文件会比RDB大,而且随着执行时间的增加,AOF文件可能会越来越大,所有会通过执行BGREWRITEAOF命令来重新生成AOF文件,减小文件大小。Redis服务器故障重启后,默认恢复数据的方式首选是通过AOF文件恢复,其次是通过RDB文件恢复。 RDB是保存某一个时间点的所有键值对信息,所以恢复时可能会丢失一部分数据,但是恢复效率会比较高。 为了防止AOF文件越来越大,可以通过执行BGREWRITEAOF命令进行AOF重写,会fork子进程出来,读取当前数据库的键值对信息,生成所需的写命令,写入新的AOF文件。在生成期间,父进程继续正常处理请求,执行修改命令后,不仅会将命令写入aof_buf缓冲区,还会写入重写aof_buf缓冲区。当新的AOF文件生成完毕后,子进程父进程发送信号,父进程将重写aof_buf缓冲区的修改命令写入新的AOF文件,写入完毕后,对新的AOF文件进行改名,原子地(atomic)地替换旧的AOF文件。 AOF重写命令可以手动执行,在满足一些条件时,Redis也会自动触发。自动触发的条件如下: RDB持久化的特点是:
文件小,恢复快,不影响性能,实时性低,兼容性差(老版本的Redis不兼容新版本的RDB文件)
AOF持久化的特点是:
文件大,恢复慢,性能影响大,实时性高。是目前持久化的主流(主要是当前项目开发不太能接受大量数据丢失的情况)。
需要了解的是持久化选项的开启必然会造成一定的性能消耗。 两种持久化方式的缺点: RDB持久化主要在于bgsave在进行fork操作时,会阻塞Redis的主线程。以及向硬盘写数据会有一定的I/O压力。 AOF持久化主要在于将aof_buf缓冲区的数据同步到磁盘时会有I/O压力,而且向硬盘写数据的频率会高很多。其次是,AOF文件重写跟RDB持久化类似,也会有fork时的阻塞和向硬盘写数据的压力。 那么不需要考虑持久化。 可以接受丢失十几分钟及更长时间的数据,可以选择RDB持久化,对性能影响小,如果只能接受秒级的数据丢失,只能选择AOF持久化。 因为主服务器在执行修改命令后,会将命令发送给从服务器,从服务进行执行后,与主服务器保持数据同步,实现数据热备份,在master宕掉后继续提供服务。同时也可以进行读写分离,分担Redis的读请求。 那么在从服务器进行数据热备份的情况下,是否还需要持久化呢?
需要持久化,因为不进行持久化,主服务器,从服务器同时出现故障时,会导致数据丢失。(例如:机房全部机器断电)。如果系统中有自动拉起机制(即检测到服务停止后重启该服务)将master自动重启,由于没有持久化文件,那么master重启后数据是空的,slave同步数据也变成了空的。应尽量避免“自动拉起机制”和“不做持久化”同时出现。 所以一般可以采用以下方案: 主服务器不开启持久化,使得主服务器性能更好。 从服务器开启AOF持久化,关闭RDB持久化,并且定时对AOF文件进行备份,以及在凌晨执行bgaofrewrite命令来进行AOF文件重写,减小AOF文件大小。(当然如果对数据丢失容忍度高也可以开启RDB持久化,关闭AOF持久化) 一般性的故障(停电,关机)不会影响到磁盘,但是一些灾难性的故障(地震,洪水)会影响到磁盘,所以需要定时把单机上或从服务器上的AOF文件,RDB文件备份到其他地区的机房。 修改命令添加到aof_buf之后,如果配置是everysec,那么会有一个线程每秒执行fsync操作,调用write写入磁盘一次,但是如果此时来了很多Redis请求,Redis主线程持续高速向aof_buf写入命令,硬盘的负载可能会越来越大,IO资源消耗更快,fsync操作可能会超过1s,aof_buf缓冲区堆积的命令会越来越多,所以Redis的处理逻辑是会对比上次fsync成功的时间,如果超过2s,则主线程阻塞直到fsync同步完成,所以最多可能丢失2s的数据,而不是1s。(每当 AOF 追加阻塞事件发生时,在 info Persistence 统计中,aof_delayed_fsync 指标会累加,查看这个指标方便定位 AOF 阻塞问题。) redis4.0相对与3.X版本其中一个比较大的变化是4.0添加了新的混合持久化方式。前面已经详细介绍了AOF持久化以及RDB持久化,这里介绍的混合持久化就是同时结合RDB持久化以及AOF持久化混合写入AOF文件。这样做的好处是可以结合 rdb 和 aof 的优点, 快速加载同时避免丢失过多的数据,缺点是 aof 里面的 rdb 部分就是压缩格式不再是 aof 格式,可读性差。 4.0版本的混合持久化默认关闭的,通过aof-use-rdb-preamble配置参数控制,yes则表示开启,no表示禁用,默认是禁用的,可通过config set修改。 了解了AOF持久化过程和RDB持久化过程以后,混合持久化过程就相对简单了。 混合持久化同样也是通过BGREWRITEAOF完成的,不同的是当开启混合持久化时,fork出的子进程先将共享的内存副本全量的以RDB方式写入aof文件,然后在将重写缓冲区的增量命令以AOF方式写入到文件,写入完成后通知主进程更新统计信息,并将新的含有RDB格式和AOF格式的AOF文件替换旧的的AOF文件。简单的说:新的AOF文件前半段是RDB格式的全量数据后半段是AOF格式的增量数据,如下图: 当我们开启了混合持久化时,启动redis依然优先加载aof文件,aof文件加载可能有两种情况如下: 优点: 缺点: (PS:扫描首页里面的二维码进群,分享我自己在看的技术资料给大家,希望和大家一起学习进步!) 下面是主要是自己看完《Redis设计与实现》,《Redis深度历险:核心原理与应用实践》后,为了更好得掌握Redis,网上找了一些面试题,查阅书籍和资料后,写的解答。 主从节点建立连接后,从节点会进行判断: 1.如果这是从节点之前没有同步过数据 属于初次复制,会进行全量重同步,那么从节点会向主节点发送PSYNC?-1 命令,请求主节点进行全量重同步。 2.如果从节点不是初次复制(例如出现掉线后重连)
这个时候从节点会将之前进行同步的Replication ID(一个随机字符串,标识主节点上的特定数据集)和offset(从服务器当前的复制偏移量)通过PSYNC id offset命令发送给主节点,主节点会进行判断, 主节点会执行BGSAVE命令,fork出一个子进程,在后台生成一个RDB持久化文件,完成后,发送给从服务器,从节点接受并载入RDB文件,使得从节点的数据库状态更新至主节点执行BGSAVE命令时的状态。并且在生成RDB文件期间,主节点也会使用一个缓冲区来记录这个期间执行的所有写命令,将这些命令发送给从节点,从节点执行命令将自己数据库状态更新至与主节点完全一致。 因为此时从节点只是落后主节点一小段时间的数据修改,并且偏移量在复制缓冲区buffer中可以找到,所以主节点把从节点落后的这部分数据修改命令发送给从节点,完成同步。 在执行全量重同步或者部分重同步以后,主从节点的数据库状态达到一致后,会进入到命令传播阶段。主节点执行修改命令后,会将修改命令添加到内存中的buffer缓冲区(是一个定长的环形数组,满了时就会覆盖前面的数据),然后异步地将buffer缓冲区的命令发送给从节点。 Redis中的哨兵服务器是一个运行在哨兵模式下的Redis服务器,核心功能是监测主节点和从节点的运行情况,在主节点出现故障后,完成自动故障转移,让某个从节点升级为主节点。 配置提供者:前者只负责存储当前最新的主从节点信息,供客户端获取。 代理:客户端所有请求都会经过哨兵节点。 首先Redis中的哨兵节点是一个配置提供者,而不是代理。因为客户端只是在首次连接时从哨兵节点获取主节点信息,后续直接与主节点进行连接,发送请求,接收请求结果。 具体流程: 在实际开发中,通过在客户端配置哨兵节点的地址+主节点的名称(哨兵系统可能会监控多个主从节点,名称用于区分)就可以与哨兵节点建立连接,获取到主节点信息,然后与主节点建立连接,并且订阅哨兵节点的频道,以便在主节点变化后,接受到通知。
上面的代码在底层实现是客户端向依次向哨兵节点发送"sentinel get-master-addr-by-name"命令,成功获得主节点信息就不向后面的哨兵节点发送命令。同时客户端会订阅哨兵节点的+switch-master频道,一旦主节点发送故障,哨兵服务器对主节点进行自动故障转移,会将从节点升级主节点,并且更新哨兵服务器中存储的主节点信息,会向+switch-master频道发送消息,客户端得到消息后重新从哨兵节点获取主节点信息,初始化连接池。 因为每隔2s,哨兵节点会给主节点发送PING命令,如果在一定时间间隔内,都没有收到回复,那么哨兵节点就认为主节点主观下线。 哨兵节点认定主节点主观下线后,会向其他哨兵节点发送sentinel is-master-down-by-addr命令,获取其他哨兵节点对该主节点的状态,当认定主节点下线的哨兵数量达到一定数值时(这个阀值是Sentinel配置中quorum参数的值,通常我们设置为哨兵总节点数的1/2),就认定主节点客观下线。 认定主节点客观下线后,各个哨兵之间相互通信,选举出一个领导者哨兵,由它来对主节点进行故障转移操作。 选举使用的是Raft算法,基本思路是所有哨兵节点A会先其他哨兵节点,发送命令,申请成为该哨兵节点B的领导者,如果B还没有同意过其他哨兵节点,那么就同意A成为领导者,最终得票超过半数以上的哨兵节点会赢得选举,如果本次投票,没有选举出领导者哨兵,那么就开始新一轮的选举,直到选举出哨兵节点(实际开发中,最先判定主节点客观下线的哨兵节点,一般就能成为领导者。) 领导者哨兵节点首先会从从节点中选出一个节点作为新的主节点。选择的规则是: 向这个从节点发送slaveof no one命令,让其成为主节点,通过slaveof 命令让其他从节点成为它的从节点,将已下线的主节点更新为新的主节点的从节点,将其他从节点的复制目标改完新的主节点,将旧的主服务器改为从服务器。 当需要存储的数据量特别大,单个Redis实例无法满足需求,所以需要分片,早期很多业务就是在业务中进行分片,通过自定义一些业务规则,将不同的数据存储在不同的Redis实例中。后来就有了官方推出的集群化方案Redis Cluster。 首先Redis Cluster设定了有16384个槽位,然后根据启动时集群的主节点数量进行均分,每个主节点得到一定数量的槽位,为了保证每个主节点挂掉之后,服务保持高可用,一般会为每个主节点配置几个从节点,从节点保存了主节点上同步过来的数据,一旦主节点挂掉,会有一个从节点会被选为主节点。客户端在与Redis Cluster建立连接时会获取到各槽位与主节点之间的映射关系,然后缓存到本地。 客户端执行命令的流程: 假设客户端需要发送一个查询请求时,首先会对key使用CRC16算法计算得到一个hash值,然后将hash值与16384(也就是2的14次方)进行取模(下面是网上找的图,应该是CRC16(key)%16384),得到一个槽位slot,然后根据本地缓存的槽位映射关系表,找到这个槽位slot对应的主节点,发送查询命令。主节点在收到命令后会有以下几种情况: 1.这个主节点确实负责这个槽位,且不在迁移中。 直接查询到这个键值对,返回给客户端。 2.这个主节点不负责这个槽位,或者已经确定转移到其他节点上去了(Moved指令) 可能是这个槽位已经迁移了,或者是客户端将指令发送到了错误的节点,或者是客户端缓存的槽位映射关系以前过期。主节点就会给客户端返回Moved指令及正确的节点信息,Moved指令相当于是一个永久重定向指令,用于纠正客户端缓存的错误槽位信息。客户端收到后会更新本地的槽位关系表,然后向正确的节点发送查询指令。 3.这个槽位正在迁移中(ASKING指令) 如果这个槽位之前是在这个主节点上,但是目前正在迁移(槽位状态为IMPORTING),那么如果现在主节点上存在这个可以,就成功处理请求。否则就返回ASKING指令+槽位所在的新节点,ASKING指令相当于是一个临时重定向指令,客户端收到之后不会更新本地的槽位关系表,只是将本次请求发送到新节点。 例如数据量太大了,原有的节点太少了,希望增加一些Redis实例,分担一些数据量。在Redis Cluster中,需要程序员手动执行命令,将节点添加到集群,并执行命令从其他的主节点上分配一些槽位到这个新节点上。 具体执行命令流程如下: 可以看到.使用addnode命令来添加节点,第一个参数是新节点的地址,第二个参数是任意一个已经存在的节点的IP和端口。 新节点现在已经连接上了集群, 成为集群的一份子, 并且可以对客户端的命令请求进行转向了, 但是和其他主节点相比, 新节点还有两点区别: 接下来, 只要使用 redis-trib 程序, 将集群中的某些哈希槽位移动到新节点里面, 新节点就会成为真正的主节点了。 槽位迁移需要执行的命令会比较的多,大家想了解的可以看看这篇文章: https://www.cnblogs.com/youngchaolin/archive/2004/01/13/12034660.html 在节点上执行 redis-trib.rb del-node{host:port} {donwNodeId} 通知其他的节点,自己下线,如果本节点是主节点,会安排对应的从节点阶梯主节点的位置。 当节点 1 向节点 2 例行发送 Ping 消息的时候,如果节点 2 正常工作就会返回 Pong 消息,同时会记录节点 1的相关信息,更新与节点2的最近通讯时间。如果节点 1的定时任务检测到与节点 2 上次通讯的时间超过了 cluster-node-timeout 的时候,就会更新本地节点状态,把节点 2 更新为主观下线。 由于 Redis Cluster 的节点不断地与集群内的节点进行通讯,下线信息也会通过 Gossip 消息传遍所有节点。 因此集群内的节点会不断收到下线报告,当半数以上持有槽的主节点标记了某个节点是主观下线时,便会认为节点2客观下线,执行后面的流程。 每个从节点都会检查与主节点断开的时间。如果这个时间超过了 cluster-node-timeout*cluster-slave-validity-factor(从节点有效因子,默认为 10),那么就没有故障转移的资格。也就是说这个从节点和主节点断开的太久了,很久没有同步主节点的数据了,不适合成为新的主节点,因为成为新的主节点以后,其他的从节点回同步它的数据。 通过资格的从节点都可以触发选举。但是触发选举是有先后顺序的,这里按照复制偏移量的大小来判断。 这个偏移量记录了执行命令的字节数。主服务器每次向从服务器传播 N 个字节时就会将自己的复制偏移量+N,从服务在接收到主服务器传送来的 N 个字节的命令时,就将自己的复制偏移量+N。 复制偏移量越大说明从节点延迟越低,也就是该从节点和主节点沟通更加频繁,该从节点上面的数据也会更新一些,因此复制偏移量大的从节点会率先发起选举。 首先每个主节点会去更新配置纪元(clusterNode.configEpoch),这个值是不断增加的整数。 在节点进行 Ping/Pong 消息交互时也会更新这个值,它们都会将最大的值更新到自己的配置纪元中。 这个值记录了每个节点的版本和整个集群的版本。每当发生重要事情的时候,例如:出现新节点,从节点精选。都会增加全局的配置纪元并且赋给相关的主节点,用来记录这个事件。 说白了更新这个值目的是,保证所有主节点对这件“大事”保持一致。大家都统一成一个配置纪元(一个整数),表示大家都知道这个“大事”了。 更新完配置纪元以后,每个从节点会向集群内发起广播选举的消息。 参与投票的只有主节点,从节点没有投票权。每个主节点在收到从节点请求投票的信息后,如果它还没有为其他从节点投票,那么就会把票投给从节点。(也就是主节点的票只会投给第一个请求它选票的从节点。) 超过半数的主节点通过某一个节点成为新的主节点时投票完成。 如果在 cluster-node-timeout*2 的时间内从节点没有获得足够数量的票数,本次选举作废,进行第二轮选举。 这里每个候选的从节点会收到其他主节点投的票。在第2步领先的从节点通常此时会获得更多的票,因为它触发选举的时间更早一些。 获得票的机会更大,也是由于它和原主节点延迟少,理论上数据会更加新一点。 当满足投票条件的从节点被选出来以后,会触发替换主节点的操作。新的主节点别选出以后,删除原主节点负责的槽数据,把这些槽数据添加到自己节点上。 并且广播让其他的节点都知道这件事情,新的主节点诞生了。 Redis集群的架构就是多个主节点,每个主节点负责一部分槽位,每个主节点拥有几个从节点,一旦主节点挂掉,会挑选一个从节点成为新的主节点,负责这部分槽位。如果某个主节点和它的所有从节点都挂掉了,那么这部分槽位就不可用。 CAP理论认为C一致性,A可用性,P分区容错性,一般最多只能满足两个,也就是只能满足CA和CP,而Redis Cluster的主从复制的模式是异步复制的模式,也就是主节点执行修改命令后,返回结果给客户端后,有一个异步线程会一直从aof_buf缓冲区里面取命令发送给从节点,所以不是一种强一致性,只满足CAP理论中的CA。 参考链接: http://www.redis.cn/topics/cluster-tutorial.html https://blog.csdn.net/g6u8w7p06dco99fq3/article/details/105336857 (PS:扫描首页里面的二维码进群,分享我自己在看的技术资料给大家,希望和大家一起学习进步!) 下面是主要是自己看了《高性能MySQL》及一些博客后,找了一些MySQL相关的面试题,通过翻书,查资料写的解答,之后会继续更新和完善这一部分内容。 客户端与MySQL Server建立连接,发送语句给MySQL Server,接收到后如果是查询语句会先去查询缓存中看,有的话就直接返回了,(新版本的MySQL已经废除了查询缓存,命中率太低了),如果是缓存没有或者是非查询语句,会创建一个解析树,然后进行优化,(解析器知道语句是要执行什么,会评估使用各种索引的代价,然后去使用索引,以及调节表的连接顺序)然后调用innodb引擎的接口来执行语句。 innodb 引擎首先开启事务,获得一个事务ID(是一直递增的),根据执行的语句生成一个反向的语句,(如果是INSERT会生成一条DELETE语句,如果UPDATE语句就会生成一个UPDATE成旧数据的语句),用于提交失败后回滚,将这条反向语句写入undo log,得到回滚指针,并且更新这个数据行的回滚指针和事务id。(事务提交后,Undo log并不能立马被删除,而是放入待清理的链表,由purge 线程判断是否有其他事务在使用undo 段中表的上一个事务之前的版本信息,决定是否可以清理undo log的日志空间,简单的说就是看之前的事务是否提交成功,这个事务及之前的事务都提交成功了,这部分undo log才能删除。) 根据索引去B+树中找到这一行数据(如果是普通索引,查到不符合条件的索引,会把所有数据查找出来,唯一性索引查到第一个数据就可以了) 判断数据页是否在内存中? 索引是普通索引还是唯一性索引? 直接更新内存中的数据页 判断更新后是否会数据冲突(不能破坏索引的唯一性),不会的话就更新内存中的数据页。 索引是普通索引还是唯一性索引? 将对数据页的更新操作记录到change buffer,暂时不更新到磁盘。change buffer会在空闲时异步更新到磁盘。 因为需要保证更新后的唯一性,所以不能延迟更新,必须把数据页从磁盘加载到内存,然后判断更新后是否会数据冲突,不会的话就更新数据页。 将对数据页的更改写入到redo log,此时redo log中这条事务的状态为prepare状态。 通知MySQL server已经更新操作写入到redo log 了,随时可以提交,将执行的SQL写入到bin log日志,将redo log 中这条事务的状态改成commit状态,事务提交成功。 https://www.cnblogs.com/yuyue2014/p/6121114.html 主要是保证事务的原子性,事务执行失败就回滚,用于在事务执行失败后,对数据回滚。 是逻辑日志,记录的是SQL语句。 在事务提交后,undo log日志不会立即删除,会放到一个待删除的链表中,有purge线程判断是否有其他事务在使用上一个事务之前的版本信息,然后决定是否可以清理,简单的来说就是前面的事务都提交成功了,这些undo才能删除。 (change buffer就是将更新数据页的操作缓存下来) 在更新数据时,如果数据行所在的数据页在内存中,直接更新内存中的数据页。 如果不在内存中,为了减少磁盘IO的次数,innodb会将这些更新操作缓存在change buffer中,在下一次查询时需要访问这个数据页时,在执行change buffer中的操作对数据页进行更新。(或者是在MySQL Server空闲时,会将change buffer中所有操作更新到磁盘,也就是俗称的‘刷页’。) 适合写多读少的场景,因为这样即便立即写了,也不太可能会被访问到,延迟更新可以减少磁盘I/O,只有普通索引会用到,因为唯一性索引,在更新时就需要判断唯一性,所以没有必要。 就是为了保证事务的持久性,在做数据更新操作时,先将对数据页的更改记录到redo log,然后再去更新内存中的数据页,在下次查询数据页或者空闲时间,将操作记录更新到磁盘。这样可以将随机I/O改为顺序I/O。 优点是减少磁盘I/O次数,即便发生故障也可以根据redo log来将数据恢复到最新状态。 缺点是会造成内存脏页,后台线程会自动对脏页刷盘,或者是淘汰数据页时刷盘,此时会暂时查询操作,影响查询。 更新时,先改内存中的数据页,将更新操作写入redo log日志,此时redo log进入prepare状态,然后通知MySQL Server执行完了,随时可以提交,MySQL Server将更新的SQL写入bin log,然后调用innodb接口将redo log设置为提交状态,更新完成。 如果只是写了bin log就提交,那么忽然发生故障,主节点可以根据redo log恢复数据到最新,但是主从同步时会丢掉这部分更新的数据。 如果只是写binlog,然后写redo log,如果忽然发生故障,主节点根据redo log恢复数据时就会丢掉这部分数据。 a. 如果是,则提交事务;
b. 否则,回滚事务。 参考资料: https://gsmtoday.github.io/2019/02/08/how-update-executes-in-mysql/ https://www.infoq.cn/article/M6g1yjZqK6HiTIl_9bex 就是内存数据页与磁盘内存页的内容不一致时的内存页叫做脏页。内存页数据写入磁盘后,数据一致了,就是干净页了。(其实就是将Change Buffer中缓存的更新写入到磁盘) 刷脏页的场景: 1.redo log 写满了,系统会停止所有更新操作,将checkpoint向前推进,将推进这部分日志的脏页更新到磁盘。 2.系统内存不够,需要将一部分数据页淘汰,如果是干净页,直接淘汰就行了,脏页的话,需要全部同步到磁盘。 3.MySQL自认为空闲时去刷脏页。 4.MySQL正常关闭之前,会将脏页刷入磁盘。 就是系统故障后,根据redo来恢复数据时,不需要重做所有日志,只需要重做checkpoint点之后的日志,因为redo log也不能无限大,所以当redo log空间不足时,redo log中那部分被更新到磁盘的日志可以覆盖重用。 1、缩短数据库的恢复时间; 2、缓冲池不够用时,将脏页刷新到磁盘; 3、重做日志空间不足时,刷新脏页。 undo log是一种逻辑日志,是旧数据的备份。有两个作用用于事务回滚和MVCC。 执行一条INSERT语句时,会记录一条相反的DELETE语句到日志,执行一条UPDATE语句时,会记录一条相反的UPDATE语句到日志中。 redo log用于保证数据的持久性。redo log记录的是数据页的物理变化,是物理日志,是新数据的备份,在事务提交前,将redo log 持久化就行,不需要将数据持久化,系统崩溃时,可以根据redo log将数据恢复到最新状态。 redo log只做顺序追加操作,当事务需要回滚时,在redo log中也不会删除之前的事务记录。 默认是每次事务提交时必须调用fsync操作将redo缓冲区的内容写入磁盘。 例如:将A=1修改为A=2,它的流程如下: 1.事务开始 2.将原始数据A=1从磁盘读取到内存,生成反向语句,写入undolog。 3.修改A=2, 4.生成一条redo log 写入到redo log 缓冲区 5.调用fsync操作将redo log 缓冲区的内容写入到磁盘,写入binlog 6.事务提交。 保存的是逻辑日志,主要是存储每一条会修改数据的SQL。 https://blog.csdn.net/qq_41652863/article/details/98800650 由一系列数据库操作组成的逻辑过程,可以是一个SQL查询,也可以是一组SQL查询。 具备四个特性,也就是acid。 原子性(Atomic):一个事务就是最小的工作单元,要么执行成功提交,要么执行失败回滚。 一致性(Consistence):就是事务的执行不会影响数据库的完整性,保证事务只能把数据库从一个有效(正确)的状态“转移”到另一个有效(正确)的状态,不能执行完一个事务后,使得数据库不符合数据库定义的规则,例如让某个有唯一性约束的字段存在两个相同的值,破坏了唯一性。 隔离性(isolation):就是事务在执行过程中,两个事务之间是隔离的,事务在执行成功之前,所做的修改对其他事务是不可见的。 持久性(durability):事务执行成功后,对数据的修改是永久的,即便发生故障重启也不会丢失数据。 事务还没有提交的修改,其他事务都可以读取到。可能会有脏读的问题,就是读到一些未提交的脏数据。 其他事务提交的修改,事务在执行过程中可以读取到,如果一个事务在执行过程中需要两次读取同一行数据,可能会不一致。一般发生在UPDATE和DELETE操作。(大部分数据库系统是采用的这个,但是mysql不是) 这个隔离级别下,读是不加锁的,写,更新,删除是加锁的,如果更新的行是可以通过索引查找到,那么是对这些行加行锁,否则会将所有行都加锁,然后返回给MySQL Server,让他来进行过滤,对于不满足条件的行解锁。 但是还是会有幻读的问题发生(幻读就是事务A在读取和写入符合的条件的记录时,其他事务又插入了一条符合条件的记录,此时事务A二次读取时会产生幻行,一般发生在INSERT操作。) 在事务开始时,记录当时的状态,在第二次读取同一行数据时,除非是本事务做的修改,否则读取的都是事务开始时的数据。可以解决脏读的问题,没法解决幻读的问题。这是MySQL的默认事务隔离级别。(MySQL在可重复读的隔离级别下,通过MVCC机制和Next-key Lock解决了幻读的问题。) 强制事务串行执行,会让读取每一行都加锁,读用读锁,写用写锁,读写锁互斥,可以解决幻读的问题。并发比较多的话可能会造成大量的超时等待和锁竞争。如果业务并发的特别少或者没有并发,同时又要求数据及时可靠的话 mvcc主要适用于可重复读,可以解决幻读的问题。 innodb在解决幻读的问题主要是通MVVC 多版本并发版本控制来实现的。 就是每一行数据中额外保存两个隐藏的列: 插入或上次更新该行的事务ID(删除也被认为是一次更新,只不过在代表删除的更新操作中,行中的特殊位被设置为将其标记为已删除。这个事务ID可以认为是数据行的修改版本号。) 回滚指针(指向undo log中用于事务回滚的日志记录)。 具体流程: 每次开始事务时,会对系统版本号+1作为当前事务的版本号。 插入数据后,将事务的版本号作为数据行的创建版本号。 在使用SQL语句删除行时,并不会立即将其从数据库中物理删除,只会将其标记为删除,并且修改更新该行的事务ID。( 将当前的事务版本号作为数据行的更新版本号。 数据行要被查询出来必须满足两个条件, 数据行没有标记为删除或者标记为删除但是删除的事务ID>当前事务ID的数据(否则数据已经被标记删除了) 更新事务ID<=当前事务ID的数据(否则数据是后面的事务创建出来的,或者是被修改过的,那么需要去undo log中找上次的快照数据。) 如果查询时,该行数据被加了X锁,那么读数据的事务不会进行等待,而是会根据该行数据中的回滚指针undo log日志中读之前版本的数据(这里存储的数据本身是用于回滚的),在可重复读的隔离级别下,从undo log中读取的数据总是事务开始时的快照数据(也就是版本号小于当前事务id的数据),在提交读的隔离级别下,从undo log中读取的总是最新的快照数据。 参考文档: https://dev.mysql.com/doc/refman/5.7/en/innodb-multi-versioning.html https://blog.csdn.net/qq_41652863/article/details/98800650 幻读就是事务执行过程中,在查询一个范围的数据时,有新的数据插入到这个范围,导致两次查询的数据不一致。因为读分为快照读和实时读, 快照读 我们普通的SELECT语句都是普通读,也就是读取的数据都是事务开始时那个状态的数据,普通读的幻读问题主要是通过MVCC来解决的,具体可以看上面的MVCC中的查询操作。 实时读 SELECT *** FOR UPDATE 在查询时会先申请X锁 SELECT *** IN SHARE MODE 在查询时会先申请S锁 就是实时读,就是读取的是实时的数据,而不快照数据,读的时候会加Next-Key Lock锁住当前的记录,以及左右两个区间的间隙,这样在读的时候就不能往我们的查询范围插入数据了。 就是对整个数据库加锁,让整个数据库处于只读状态,所有更新操作停止。(如果是主库就不能执行更新语句,从库也不能执行同步过来的bin log) 最常用的场景是对数据库加锁,让数据库只能读,然后对整个数据库做逻辑备份(就是将所有数据生成SQL写入备份文件。) 做逻辑备份有三种方式: 对数据库执行 就是通过官方自带的逻辑备份工具mysqldump来进行逻辑备份时,可以设置一个参数-single-transaction,这样导数据的时候就会开启一个事务,这样利用innodb的mvcc机制可以保证在事务执行过程中,读到的数据都跟事务开始时的一致,并且执行过程中,其他事务可以执行更新操作, 不会对他造成影响。这种方法必须要求数据库所有表的引擎都是innodb才行。 执行这个命令也可以让全库只能读,但是第一有些系统会使用readonly来做一个操作,例如根据readonly是否为true判断数据库是否是从库,第二是如果执行这个命令后,客户端断开连接后,数据库会一直处于只读状态,如果是FTWRL命令发送异常会释放全局锁。(如果是从库,设置read-only对super user权限无效) 表级别的锁有两种,一种是表锁,一种是元数据锁MDL。 就是使用lock table user_table read/write命令来对表进行加读锁或者写锁
加读锁后,表对所有线程都是只能读,即便是当前线程也只能读表,不然会数据不一致。
加写锁后,表是对当前线程写,其他线程不能读,不然会数据不一致。
可以通过unlock tables来解锁,客户端断开时也会自动释放锁,但是影响所有线程,影响面太大了。 分为读锁和写锁,加读锁时,所有的线程都可以读表,加写锁时,只能一个线程写,其他的不能读。
锁不用显式使用,是访问一个表时,自动加上的。
对表执行普通SQL语句对表数据进行增删改查时,会加读锁。
对表结构做修改时,会加写锁。 元数据锁是为了修改表结构不会出现问题而设计的,因为一边修改表结构一边读数据可能会读到脏数据,所以在增删改查时会申请读锁,在这个期间不能修改表结构,要修改表结构需要先申请写锁,申请成功后对表结构进行修改,在这个期间不能进行增删改查。 插入语句主要分为两种:
1.能确定插入行数的,例如插入一条或者多条数据,INSERT...
2.不能确定行数的,例如从一个表查询出满足条件的数据,然后插入另外一个表,INSERT...SELECT 在所有模式中,如果一个事务回滚,这些自增值将被“丢失”。 innodb_autoinc_lock_mode为0
这种是tradition模式,每次执行一条插入语句时都会去申请表级别的auto_increment锁 innodb_autoinc_lock_mode为1
这种是consecutive模式,执行不确定数量的插入语句时,才会去申请表级别的auto_increment锁,
执行确定数量的插入语句时,只需要执行前去获取 AUTO_INCREMENT 计数器的互斥锁并在获取主键后直接释放,
不需要等待当前语句执行完成。 innodb_autoinc_lock_mode为2
交叉模式 所有的插入语句都不需要获取表级别的 AUTO_INCREMENT 锁,
如果binlog_format为statement模式,如果从服务器上的计数器的值可能会与主服务器不一致,
可能会有同一行数据在主从数据库上id不一样的情况,如果binlog_format为row模式,那么就不影响。 意向锁定的主要目的是表明有人正在锁定表中的行,或者打算锁定表中的行。意向锁的作用主要在于,当一个事务去申请表级别的排斥锁X,共享锁S时,需要去判断是否有其他事务在修改数据行,或者让数据行处于只读状态。假如没有意向锁,可能需要查询每一行数据,判断是否加了行锁。而如果有意向锁的情况下,可以快速进行判断,只需要判断当前表是否有加意向锁就可以了,减小了性能开销。 意向共享锁(IS锁) 事务让一行数据只能读,需要申请对这行数据加行级别的锁共享锁S,在申请S锁之前会主动申请表级别的共享意向锁IS锁。 意向排斥锁(IX锁) 事务在更新某一行数据时,需要申请对这行数据加行级别的锁排斥锁X,在申请X锁之前会申请IX 意向锁之间是兼容的,IS锁和IX是兼容,因为可能我们对第一行数据加S锁,那么会申请IS锁,对第二行数据加X锁,此时跟第一行的数据的S锁不冲突,所以也会先申请IX锁,由此可见,IS锁和IX之间不冲突,IS锁,IX锁与行级别的S,行级别的X之间也不冲突。 意向锁只是跟表级别的S,X锁可能会冲突, 场景1:假设一个事务要加表级别的S锁,让整个表只能被读。那么如果当前有意向锁IX,说明有其他事务在改数据,那么不能加,只能进行等待,等事务改完是否意向锁IX。 场景2:假设当前事务要加表级别的S锁时,让整个表只能被读。只有IS意向锁,没有IX锁,说明只是有其他事务在让数据只能被读取,不能被修改,那么加表级别S锁,也不会其他事务造成影响。 场景3:假设当前事务要加表级别的X锁时,让整个表只能被这个事务写,不能被其他事务读。如果现在有其他事务加了意向读锁IS,说明有其他事务在让一些数据行只能被读,或者是一些写锁IX,说明其他事务让一些数据行正在被修改。那么当前要加表级别的X锁就不行,会跟其他事务冲突,只能等其他事务执行完毕才能申请成功。 假如没有意向锁,我们执行lock table read命令来申请表锁,让整个表只能读,在获得表级别的只读锁之前,需要执行的步骤是: 1.数据库会先判断当前表是否加了表级别的排斥锁,因为这个时候要是加了排斥锁,是只能由加了那个排斥锁的事务来更新数据,其他事务都不能读数据,只能阻塞等待。 2.如果当前表没有加表级别的排斥锁,那么就需要对每一行数据进行判断,判断是否加了行级别的X锁,如果加了只能阻塞等待,这样需要对一行进行判断,性能开销太大了。 所以才有了意向锁,在获得表级别的只读锁之前,需要执行的步骤是: 1.第一步还是跟上面的步骤一一样 2.第二步只需要判断当前锁是否加了表级别的意向排斥锁,因为如果加了意向排斥锁,说明正在有事务在对数据加行锁,对数据进行更新,这样避免了对每一行数据进行判断,判断是否加了行锁。 记录锁定是对单条索引记录的锁定。例如, 间隙锁就会对记录之间的间隙加锁,防止数据插入。就是我们在使用实时读(SELECT FOR … UPDATE)或者更新,为了防止读的过程中有新的数据插入,会对我们读的数据的左右区间进行加锁,防止其他事务插入数据,所以间隙锁之间是不排斥的,间隙锁排斥的只是插入数据的操作。 next-key lock就是会锁记录以及记录之间的间隙,就是 record lock 和 gap lock的组合,就是会对索引记录加记录锁 + 索引记录前面间隙上的锁”,就是对要更新的数据的左右两个端点加间隙锁, 例如num是一个普通索引,非唯一性索引,已有数据是1,5,10,20,30 那么 next-key lock可以锁定的区间是 如果num是唯一性索引,那么只需要对num为10的这条索引加锁就行了(就加一个Record lock锁),因为不用担心其他事务再插入一条num为10的数据,因为会有唯一性判断。但是如果num是非唯一性索引,为了防止事务执行过程中有num为10的数据插入,那么会对(5,10]和(10,20]这两个区间加锁。 平衡二叉树就是每个节点左右子树的高度差小于等于1,B树其实是一个平衡多路查找树,假设是M阶的, 1.根节点至少有一个关键字。(这里的关键字可以理解为每个节点的子节点) 2.非根非页节点的关键字数是 需要<=m-1并且>ceil(m/2)-1。 3.节点内的元素从左到右递增,左边节点的所有元素值<右边节点的所有元素值。 4.叶子节点在同一层,高度一致。 跟二叉树相比,因为每个节点关键字会多很多,所以相同的关键字数时,层级会少很多,会减少查找时间和复杂度。 https://segmentfault.com/a/1190000020416577 https://blog.csdn.net/chai471793/article/details/99563704 B+树是为磁盘存储专门设计的一M阶多路平衡查找树(阶数可以理解为每个节点最多的孩子节点的个数,二叉树就是2阶),所有记录节点都是按照从小到大顺序存放在最后一层的叶子节点上,由各叶子节点的指针相连接。可以认为一个叶子节点就是一个内存页(默认情况下,一个内存页大小为16K),每个内存页里面存储多个数据行,内存页直接通过指针连接,形成一个双向链表,所以叶子节点在逻辑上是连续的,在物理上不是连续存储的,就是每个叶子节点可以存储在不同地址上,通过指针相互连接。每个非叶子节点(也就是索引节点)也是一个内存页,里面存储了很多索引节点的值,但是B+树索引节点只存索引值,不存数据行的数据,这样可以让每个索引内存页存储更多的索引值,这样可以使得B+树的层数更少(这也是B+树比B树更优的地方)。B+树在数据库的中实现一般是只有2到4层,机械磁盘一般1秒可以进行100次IO,也意味着每次在B+树中的查询操作可以在20ms到40ms之间完成。 1.B树每个节点会保存关键字,索引和数据。而B+树只有叶子节点保存数据,其他节点只保存关键字和索引。所以相同的内存空间可以容纳更多的索引节点。 2.B+树的所有数据都存在叶子节点上,所以查询会更加稳定,而且相邻的叶子节点都是连接在一起的,更加适合区间查找和搜索。 红黑树是一个平衡的二叉查找树。有以下几个性质: 1.根节点和叶子节点都是黑色的(这里的叶子节点指的是普通的节点增加的一个黑色的空节点)。 2.红色节点的子节点必须是黑色的,也就是不能有两个红色节点连续。 3.黑色的节点可以连续,但是从根节点到叶子节点的所有路径包含的黑色节点的个数是一致的。(所以根节点到叶子节点的最长路径<=最短路径的两倍) 红黑树是二叉查找树(也就是每个节点的左子树<当前节点的值,右子树所有节点>=当前节点值),但不是严格意义上的平衡二叉树,因为平衡二叉树要求任何节点的左右子树高度差是<=1,红黑树根节点到叶子节点的最长路径会<=最短路径的两倍,所有他是大致意义上的平衡树。 相比于AV树(也就是自平衡的二叉查找树,左右子树高度差不超过1),红黑树插入,删除效率更高。因为不需要保证绝对的平衡,任何不平衡需要的旋转次数不超过3次,即便在最坏的情况下,红黑树能够以O(log(N))的时间复杂度进行搜索、插入、删除操作。 红黑树等平衡树也可以用来实现索引,但是文件系统及数据库系统普遍采用 B+ Tree 作为索引结构,主要有以下两个原因: (一)更少的查找次数 平衡树查找操作的时间复杂度和树高 h 相关,O(h)=O(logdN),其中 d 为每个节点的出度。 红黑树的出度为 2,而 B+ Tree 的出度一般都非常大,所以红黑树的树高 h 很明显比 B+ Tree 大非常多,查找的次数也就更多。 (二)利用磁盘预读特性 为了减少磁盘 I/O 操作,磁盘往往不是严格按需读取,而是每次都会预读。而B+数中存储的叶子节点在内存中是相邻的,这样可以读取会快一些。 (三)存储更多的索引节点 B+树跟B树的区别就是B+是叶子节点存储数据,非叶子节点(也就是索引节点)只存储索引项,B树是所有节点都存储数据,而每个节点都是磁盘的一个内存页,内存页大小是固定,B+树的每个索引节点可以容纳的索引值更多,与B树相比,B+树的层数更少。 索引可以让服务器快速定位到表的指定位置。 优点是 1.大大减少了服务器需要扫描的数据量。 2.帮助服务器避免排序带来的性能开销。 3.将随机IO变成顺序IO。 因为字符串索引在索引树上两个节点比较会比较慢,数字类型的索引会快一些, 如果非要用字符串索引可以采用以下解决方法。 1.对字符串的前n个字符建立前缀索引,前缀索引不能使用order by。 2.增加一列,对字符串转换为整型的hash值address_key=hashToInt(address),对address_key建立索引,查询时同时限定hash值也限定地址。可以用如下查询where address_key = hashToInt(‘beijing,china’) and address = ‘beijing,china’; 效率的话,100万的数据量,字符串索引查询600ms,数字查询20ms。 union就是将两个SELECT语句查询的结果集合并(两个SELECT可以是同一个表,也可以是不同表),如果需要排序,在第二个SELECT语句后加ORDER BY语句,会对所有结果进行排序。 union默认是会去除重复的数据的,会对结果集做去重处理,union all不会做去重处理。 所以union效率慢一些,如果能确定结果不会重复或者需要不去重的结果,那么应该使用union all,效率会高一些。 如果没有设置主键,innodb会选择第一个非空唯一索引作为聚集索引。 如果没有设置主键,也没有合适的唯一索引,那么会生成一个隐藏的id作为索引的主键,这个值会随着插入而自增。 主键如果是自增的,那么插入数据的位置是已知的,而且不用移动已有数据。如果是非自增的,首先需要查找到要插入的位置,近似于随机查找,然后将后面的数据向后移动。 聚集索引与非聚集索引的最主要的区别是:叶节点是否存放一整行记录 innodb的索引是聚集索引,就是所有数据都存在聚集索引的的叶子节点中,其他二级索引的的叶子节点值存储KEY字段加对应列的主键值,如果使用二级索引查找数据,先根据索引查到二级索引对应的行的主键id,然后根据主键id去聚集索引中查找对应的行的数据。(所以innodb必须要有主键)。 聚集索引示意图一: 聚集索引是依据B+树来实现的,索引节点(也就是非叶子节点)只存储索引值,叶子节点才会存具体的数据行,每个索引节点都是一个内存页(由于只存索引值,相比B树,B+树的每个索引节点的内存页可以存储更多的索引值),每个叶子节点也都是一个内存页,内存页里面数据行按主键id从小到大的顺序存储,然后叶子节点之间是通过指针连接的,形成一个双向链表。所以聚集索引的叶子节点在逻辑上是存储在一起的,在物理上是并不是连续的,而是通过双向链表连接的。假设说叶子节点在物理上的存储也是连续,那么如果中间的叶子节点中大量插入数据行,导致叶子节点的内存页容量不够时,需要后面的叶子节点全部后移,这样维护成本会很高。如果叶子节点只是通过双向链表进行连接,当中间的叶子节点容量不够时,可以新增一个内存页,插入在其中,作为一个叶子节点,只需要修改双向链表中的指针即可。 聚集索引示意图二: 1.对于聚集索引表来说(左图),表数据是和主键一起存储的,主键索引的叶结点存储行数据(包含了主键值),其他列,事务ID,回滚指针,二级索引的叶结点存储行的主键值。使用的是B+树作为索引的存储结构,非叶子节点都是索引关键字,但非叶子节点中的关键字中不存储对应记录的具体内容或内容地址。叶子节点上的数据是主键与具体记录(数据内容)。 2.对于MyISAM的非聚集索引表来说(右图),表数据和索引是分成两部分存储的,主键索引和二级索引存储上没有任何区别。使用的是B+树作为索引的存储结构,所有的节点都是索引,叶子节点存储的是索引+指向索引对应的记录的数据的指针。 1.当你需要取出一定范围内的数据时,用聚集索引也比用非聚集索引好。 2.当通过聚集索引查找目标数据时理论上比非聚集索引要快,因为非聚集索引定位到对应主键时还要多一次目标记录寻址,即多一次I/O。 3.使用覆盖索引扫描的查询可以直接使用页节点中的主键值。 1.随机插入容易造成页分裂,按照主键的顺序插入是最快的方式,否则将会出现页分裂(就是存储数据行的内存页容量不够,需要新申请一个内存页分担一部分数据行),影响性能。因此,对于InnoDB表,我们一般都会定义一个自增的ID列为主键。 2.更新主键的代价很高,因为将会导致被更新的行移动。因此,对于InnoDB表,我们一般定义主键为不可更新。 3.二级索引访问需要两次索引查找,第一次找到主键值,第二次根据主键值找到行数据。 二级索引的叶节点存储的是主键值,而不是行指针(非聚集索引存储的是指针或者说是地址),这是为了减少当出现行移动或数据页分裂时二级索引的维护工作,但会让二级索引占用更多的空间。 4.采用聚集索引插入新值比采用非聚集索引插入新值的速度要慢很多,因为插入要保证主键不能重复,判断主键不能重复,采用的方式在不同的索引下面会有很大的性能差距,聚集索引遍历所有的叶子节点,非聚集索引也判断所有的叶子节点,但是聚集索引的叶子节点除了带有主键还有记录值,记录的大小往往比主键要大的多。这样就会导致聚集索引在判定新记录携带的主键是否重复时进行昂贵的I/O代价。 联合索引就是多列索引,就是可以多个字段建立一个索引,并且是最左前缀匹配元素, 就是在非聚集索引对应的B+树中,索引的排序是先比较a的大小,再比较b的大小然后再比较c的大小。并且是遇到范围比较时就会停止匹配。 例如: 这样的语句可以走联合索引,但是不会走联合索引,因为符号这个范围的数据很多,查出之后,只能获得这些数据的主键,还需要根据主键去聚集索引中查,效率比较低,还不如直接全部扫描,所以直接去聚集索引下顺序得对全表进行扫描。 这些是可以走联合索引的, 这个也会走联合索引,查出age=1的索引,然后查出height>2的所有数据,因为height是一个范围查找,所以到weight就不会用索引,会将将这些数据载入内存,根据weight进行筛选。 1、根据搜索条件,找出所有可能使用的索引
2、计算全表扫描的代价
3、计算使用不同索引执行查询的代价
4、对比各种执行方案的代价,找出成本最低的那一个 。 就是假如有一个联合索引(a,b,c),如果我们只是需要a,b,c这几个字段的数据,查询时就不需要根据主键id去聚集索引里面回表查询了。 哪些情况需要建索引: 一个表中可以有多个唯一性索引,但只能有一个主键。 1.在查询时,如果是使用的是主键,或者是唯一性索引查询,查到后就返回了,普通索引还会继续向后遍历,直到第一个不满足条件的才会返回,普通索引会多检索几次。几乎没有什么影响。 2.更新时普通索引需要判断唯一性。 3.主键是聚集索引,普通所以是非聚集索引。 是 MySQL 默认的事务型存储引擎,只有在需要它不支持的特性时,才考虑使用其它存储引擎。 实现了四个标准的隔离级别,默认级别是可重复读(REPEATABLE READ)。在可重复读隔离级别下,通过多版本并发控制(MVCC)+ Next-Key Locking 防止幻影读。 主索引是聚集索引,在索引中保存了数据,从而避免直接读取磁盘,因此对查询性能有很大的提升。其次是聚集索引每个叶子节点按照主键id从小到大顺序存储了大量数据行,而每个叶子节点在实现上是一个内存页,磁盘IO读取时是读取一个内存页,会进行一定的预读,所以在进行范围查找时,InnoDB引擎效率更高,而MyISAM则需要对查找范围内所有数据行进行随机读取。(每条数据都是存储在不同地址上) 内部做了很多优化,包括从磁盘读取数据时采用的可预测性读、能够加快读操作并且自动创建的自适应哈希索引、能够加速插入操作的插入缓冲区等。 支持真正的在线热备份。其它存储引擎不支持在线热备份,要获取一致性视图需要停止对所有表的写入,而在读写混合场景中,停止写入可能也意味着停止读取。 不支持事务,不支持行级锁,只能全表加锁,读取时会对所有表加共享锁,写入时会对表加排他锁。 一般认为单表数据量在1000万时,查询效率是最合适的,如果超过1000万,执行性能就会下降,可以考虑分库分表。 就是根据列进行分表,例如根据业务,来对表进行拆分成不同的表,或者根据使用频率,将常用的列分在一个表里面,将不常用的列分在一个表里面。 将表根据行来进行分表,将一个表拆分成多个表结构相同的表。 第一种 一般是用主键ID对数据表的数量进行取模运算,得到的余数就是新表的位置。(如果是字段是字符串,那么就根据字符串计算出哈希值,然后除以表的数量,得到新库的位置) 第二种 根据时间来拆分,主表只存储最近两个月的数据,副表存储之前的数据。这种主要是适合哪种访问的数据跟时间相关性比较大的情况,例如统计,我有看某新闻网站他们的技介绍,他们的文章会有一个PV,UV统计表,就是每天大概有200万的文章有PV,UV,也就是数据库每天会新增200万行的数据,一般来说查文章近期的UV,PV会多一些,查昨日PV,一周PV,或者一个月的PV会多一些。所以是安装时间来划分热库和冷库,一月一个表,或者一天一表。 1.事务问题,如果在事务里面操作一个表,然后再操作另外一个表,效率会比较低,然后也比较麻烦。 2.跨库join的问题 在拆分之前,系统中很多列表和详情页所需的数据是可以通过sql join来完成的。而拆分后,数据库可能是分布式在不同实例和不同的主机上,join将变得非常麻烦。而且基于架构规范,性能,安全性等方面考虑,一般是禁止跨库join的。那该怎么办呢?首先要考虑下垂直分库的设计问题,如果可以调整,那就优先调整。(就是尽量不要去分库)如果无法调整的情况,下面有几种解决方案: 1.全局表 所谓全局表,就是有可能系统中所有模块都可能会依赖到的一些表。比较类似我们理解的“数据字典”。为了避免跨库join查询,我们可以将这类表在其他每个数据库中均保存一份。同时,这类数据通常也很少发生修改(甚至几乎不会),所以也不用太担心“一致性”问题。 1.停机迁移法 2.迁移历史数据,新的更新发kafka消息 就是对updatet_time小于某个时间点的数据全部拷贝出来,迁移到新的数据库,同时项目在执行增删改相关的SQL时,同时往Kafka中发一份,迁移结束后,用订阅程序消费kafka消息,更新新库,消费完之后,然后校验一致性切数据库。 缺点就算侵入性太强了,所有更新数据库的业务项目都需要改动,然后给kafka发消息。 3.迁移历史数据,订阅bin log接受更新 还是先迁移数据,迁移完之后用订阅程序消费bin log消息,更新新库,消费完之后,然后校验一致性,切数据库。 这里大概介绍一下吧,这篇的篇幅太长了,大家心里有底就行。
(1)先验数量是否一致,因为验数量比较快。
至于验具体的字段,有两种方法:
(2.1)有一种方法是,只验关键性的几个字段是否一致。 随机取小批量数据,编码后比较。 (2.2)还有一种是 ,一次取50条(不一定50条,具体自己定,我只是举例),然后像拼字符串一样,拼在一起。用md5进行加密,得到一串数值。新库一样如法炮制,也得到一串数值,比较两串数值是否一致。如果一致,继续比较下50条数据。如果发现不一致,用二分法确定不一致的数据在0-25条,还是26条-50条。以此类推,找出不一致的数据,进行记录即可。 就是例如要查询第三页的数据,那么把每个库里面前三页的数据都查询出来,然后排序, 优点是比较准确,也比较简单 问题就是每个库返回的页数很多,网络传输量很大,而且收到数据后的需要二次排序,排序的性能消耗也比较大。 就是禁止跳页查询,就是如果业务不需要跳页查询的话,一开始查第一页的时候,从每个库取一页数据回来进行排序后返回。 查第二页数据时根据第一页结果中最大的时间去每个库再取一页数据,然后进行排序得到第二页数据。 优点是是每次直插一页,传输数据量小,排序的数据量也小, 缺点是由于查第二页及以后的页数都需要知道上一页最大时间。 假设数据分布足够平均,每个库的数据分布都是平均的,假设有四个库,查第一页数据时,每个库都取前0.25页数据,然后合并后返回,取第二页数据时,每个库再都取0.25页。但是这样取得是不准的数据。 假如要取offset 为X,limitY的数据, 1.假设有四个库,需要去每个库查offset为X/4,limit为Y的数据,然后得到四个结果集,每个结果集的time都有一个时间最小的time_min,时间最大的time_max结果,取四个结果集中最小的time_min 2.然后去每个库去查between time_min到之前每个库的time_max的结果集, 3.因为之前每个库的time_max的offset都是X/4+Y,所以可以反推出time_min在每个库里的offset,然后得到全局offset, 4.然后根据全局offset可以计算我们想到的offset X后Y个数据,就是以time_min为起点到距离我们offset的差值。 关键在于两次查询中间,如果数据库删除过这个区间内的数据,time_min到time_max之间删除过数据,这样就不准, 首先需要查询两次,而且如果表数据是按照分段来查询的,会有问题。 参考链接: https://blog.csdn.net/uiuan00/article/details/102716457 例如像百度贴吧,假设一个吧里面允许跳页查询的页数为前100页,每页为20个,,每次顶贴都会把贴子顶到最前面,那么可以使用一个Zset来存储最近的2000个帖子的基本信息(id,标题,图片,等足够贴吧列表页展示的信息),每个帖子的score就是最近更新时间,帖子在Zset中按照更新时间排序。然后每次顶贴都来维护这个Zset就可以了。跳页也可以直接以Log(N)复杂度去Zset中查询到这个帖子。 假设说一个订单系统,用户发起一个订单后,在用户端的需要查看个人订单列表。在商家端也需要查看这个商家最近订单列表。如果用户量比较大肯定是会需要分库分表,比较好的方案是在用户订单表user_order里面存储一个订单表(主键id可以是每个分库自己自增的,也可以是使用snowflake算法生成的),但是用户订单表user_order会根据用户uid进行取模运算,进行分库分表。也就是同一个用户的所有订单都在一个数据库的表中,避免查询时需要多库多表查询。 但是此时商家去查询订单列表时,各个订单还是分布在每个分库的user_order表中,为了避免多库查询,还会维护一个商家表business_order,(主键id可以是每个分库自己自增的,也可以是使用snowflake算法生成的),但是商家订单表business_order会根据商家id进行取模运算,得到一个数字,每个商家的订单都存在同一个表中,以此实现分库分表。 一般来说user_order可以存所有的订单信息,business_order表只存储少量商家需要的订单信息。 就是将主节点的数据复制到从节点。 用途: 1.可以读写分离,主库用来写数据,从库用来读数据。在更新数据时,会对整个表加锁,如果是读写分离的,可以去从表读取数据,这样就不会有问题。 2.做备份,主库出故障后,进行故障转移,让从库代替主库,提供服务。 主节点日志发送线程 当主节点和从节点建立连接后,主服务器上会起一个bin log dump线程,用于给从节点发送bin log日志(日志所包含的信息之外,还包括本次返回的信息的bin-log file 的以及bin-log position),在读取bin log日志时,会对日志文件加锁,读取完成后会解锁。 从节点I/O线程 从节点与主节点建立连接后会起一个I/O线程来接受主节点发送过来的bin log日志内容,并且保存在从节点的relay log文件中,保存成功后就会给主节点回复ACK消息,表明接收成功。 从节点SQL线程 从节点同时会起一个SQL线程,来读取 relay log 中的内容,解析成SQL,并且在从节点上执行,保证和主节点的数据一致性。 复制模式 主节点不会主动push bin log给从节点,也不会管从节点的同步情况,默认就是这种模式。 主节点给从节点发送bin log 之后,会一直等待回应,只要一个从节点接受bin log,并且写入relay log 成功,给主节点返回接受成功的ACK信息,主节点就认为成功,提交事务。 就是需要所有的从节点接受日志,并且写入relay log 成功,给主节点返回接受成功的ACK信息,主节点才认为成功,提交事务。 Statement-base Replication (SBR)语句模式 就是执行什么更新的SQL,就将这些SQL保存到 bin log日志文件中。 缺点在于可能某些情况下导致数据不一致,例如根据now()当前服务器的时间,可能从节点执行语句时的时间跟主节点的语句时间不一样。 Row-based Relication(RBR) 数据行模式 就是更新那些数据行,将这些更新的数据行生成SQL,保存在bin log日志文件中。 优点是能确保数据的精准,缺点是会产生大量的日志,日志内容会变大,尤其是一行SQL对大量数据行更新时,而且也不能通过bin log解析当时执行的SQL语句。 Mixed-format Replication(MBR)混合模式 MySQL NDB cluster 7.3 和7.4 使用的MBR。是以上两种模式的混合,对于一般的复制使用STATEMENT模式保存到binlog,对于STATEMENT模式无法复制的操作则使用ROW模式来保存,MySQL会根据执行的SQL语句选择日志保存方式 支持版本 MySQL 5.1.5 之前 binlog 的格式只有 STATEMENT,5.1.5 开始支持 ROW 格式的 binlog,从 5.1.8 版本开始,MySQL 开始支持 MIXED 格式的 binlog。 MySQL 5.7.7 之前,binlog 的默认格式都是 STATEMENT。 在 5.7.7 及更高版本中,binlog 的默认格式才是 ROW。 要发生死锁,一般需要满足以下四个必要条件: 1.资源互斥:就是资源不能共享,提现在InnoDB中就是一个事务申请了锁,其他事务就不能申请。 2.不可抢占:就是一个事务没有获得锁,只能等待拥有锁的事务释放锁,而不能去直接抢占锁。 3.占有且等待:就是没有获得锁的事务只能进行等待,并且也不会释放自己已拥有的锁。 4.循环等待:就是事务之间拥有的资源必须形成了一个环,例如事务A拥有一些事务B需要的资源,同时事务A也在申请事务B当前拥有的一些资源。 一、预防死锁的方法: 预防死锁的思路主要还是从破坏死锁发生需要的必要条件入手,资源互斥这个条件没法去破坏, 1.破坏不可抢占条件:就是当一个进程发现自己申请不到某个资源时,那么就把当前持有的资源全部释放掉,待以后需要使用的时候再重新申请。这意味着进程已占有的资源会被短暂地释放或者说是被抢占了。 该种方法实现起来比较复杂,且代价也比较大。释放已经保持的资源很有可能会导致进程之前的工作白费了,反复的申请和释放资源会导致进程的执行被无限的推迟,这不仅会延长进程的周转周期,还会影响系统的吞吐量。 2.破坏占有且等待条件: 方法1:执行前申请所有资源 所有的进程在开始运行之前,必须一次性地申请其在整个运行过程中所需要的全部资源,申请成功,进程才能启动。 优点:简单易实施且安全。 缺点:因为某项资源不满足,进程无法启动,而其他已经满足了的资源也不会得到利用,严重降低了资源的利用率,可能会造成每次能启动并运行的进程过少,造成资源浪费。 方法2:边执行边释放资源 该方法是对第一种方法的改进,允许进程只获得运行初期需要的资源,便开始运行,在运行过程中逐步释放掉分配到的已经使用完毕的资源,然后再去请求新的资源。这样的话,资源的利用率会得到提高,也会减少进程的饥饿问题。 3.破坏“循环等待”条件 可将每个资源编号,当一个进程占有编号为i的资源时,那么它下一次申请资源只能申请编号>i的资源。这样资源之间就不会形成环。但是也会造成资源利用率的降低,例如有些进程一开始申请了资源2,哪怕不存在进程竞争,它后续如果需要资源1也申请不到。如下图所示: 二、避免死锁 ----- 在使用前进行判断,只允许不会产生死锁的进程申请资源 这种方法就是在进程申请资源时,系统首先判断当前可用资源是否够申请,不够就肯定没法让这个进程运行,就让进程继续等待。够的话继续进行判断,假设把这些资源分配给这个进程,然后通过银行家算法判断系统是否处于安全状态,不安全那就不分配,让进程继续等待。 银行家算法判断流程: 假设进程队列里面有P1,P2,P3三个队列,它们持有了一些资源,并且后续执行时还需要资源才能执行完成,假设此时来另一个进程P0,系统判断是否需要给P0分配资源银行家算法先试探的分配给它(当然先要看看当前资源池中的资源数量够不够),若申请的资源数量小于等于Available,然后接着判断分配给P0后剩余的资源,能不能使进程队列的某个进程执行完毕,若没有进程可执行完毕,则系统处于不安全状态(即此时没有一个进程能够完成并释放资源,随时间推移,系统终将处于死锁状态)。 若有进程可执行完毕,则假设这个进程执行完毕,然后释放已分配给它的资源(剩余资源数量增加),把这个进程标记为可完成,并继续判断队列中的其它进程能否在现有资源数量下执行完毕,若所有进程都可执行完毕,则系统处于安全状态,并根据可完成进程的分配顺序生成安全序列(如{P0,P3,P2,P1}表示将P0需要的资源先分配给P0–>P0执行完毕后,P0的资源被回收–>P3所需资源<现有资源,P3执行完毕–>P3的所有资源被回收–>分配给P2–>······满足所有进程执行完毕)。 死锁的检测及解除 死锁预防和避免都是对资源分配进行适当限制,属于事前措施,并不利于系统资源的充分共享。而死锁检测不会试图阻止死锁,即在死锁发生前不会做任何操作,只是通过设置的检测机制,检测当前是否发生死锁。若发生死锁,则采取一些措施来解除死锁。 判断死锁的法则主要基于第四条死锁的必要条件: 1.资源分配路径中没有环路,则系统不会出现死锁 2.资源分配路径中存在环路,则系统可能出现死锁(如果环路中每种资源只有一个,那么就肯定形成死锁了,如果每种资源有多个,就可能发生死锁) 解决死锁的方法: 1.资源剥夺法:剥夺陷入死锁的进程所占用的资源,但并不撤销此进程,再将这些资源分配给需要的进程,直至死锁解除。 2.进程撤销法 一次性撤销陷入死锁的所有进程,回收所有占用的资源,等死锁解除后,再重新运行进程。 逐个撤销陷入死锁的进程,依次回收其资源并重新分配,直至死锁解除。可以优先撤销优先级低、预计剩余执行时间最长、CPU消耗时间少的进程。 在MySQL中,死锁就是两个或多个事务在同一资源上相互占用,并且请求对方的占用的资源。InnoDB目前处理死锁的方法就是将持有最少行级排他锁的事务进行回滚。 除了单条更新语句外,事务获取行锁都是逐步获取的,所以有可能会造成死锁。
解决死锁有两种策略:
1.超时放弃等待
innodb_lock_wait_timeout,默认是50s,超时会报错。
2.死锁检测
innodb会有死锁检测,但是会消耗一些cpu资源,检测到死锁会让占有锁最少的事务回滚,然后释放锁。
3.控制并发度
就是控制访问相同资源的并发事务量。例如将长事务拆分成短事务,这样每次事务占用时间也少,也可以减少其他事务的等待时间,减少死锁发生的概率。 在innodb引擎下, SELECT Count(\*)其实是跟SELECT Count(id)是等价的,会去主键的聚集索引下扫描每一行,然后判断行是否为Null,不为Null计入Count。 也是全表扫描,判断这一行的col值是否为null,不为null,计入Count 可以使用查询一个非空的唯一索引键的数量来替代count(\),因为count(\)需要遍历主键的聚集索引的叶子节点,读取每一行的数据,而Count(unique_key)会去unique_key的索引下读取每个叶子的节点,因为每个叶子节点只包含unique_key和主键id,数据大小比聚集索引下的叶子节点下,IO会小一些。 因为innodb有事务的概念,如果是在PR的隔离级别下,每个事务查询的count应该等于事务开始时count+本事务执行过程中对count的改变,但是由于每个事务可以单独设置会话隔离级别,所以很难实现对count的缓存。 1.首先根据explain+SELECT语句执行,查看结果, https://blog.csdn.net/dennis211/article/details/78170079 主要分为以下几个方法: 1.减少请求的数据量 列方面,避免使用SELECT *,只返回必要的列。 行方面,使用limit语句来限制返回的数据行数。 对频繁访问的数据加缓存,存在redis中。 2.减少表扫描的行数 主要通过使用索引和命中索引来实现,例如如果需要根据发布时间查询最近一天的文章,那么可以根据postTime建立辅助索引,避免进行全表扫描。 对于一些常用的条件查询字段,建立联合索引,使用一些联合索引,可以减少查询次数,也可以减少磁盘空间占用。而且当查询的字段在索引中已经包含时,就会使用到覆盖索引,此时在辅助索引中查到需要的字段后就不用再根据主键id进行回表查询了。 4.避免在查询时,对索引字段进行计算和使用函数。 这样会导致不通过索引查询,将一些varchar类型的字段与整型数据进行比较时,会触发隐式类型转换,从而使用函数。 5.切分大查询 因为大查询在查询时可能会锁住很多数据,也需要获取到这些数据的行锁才能进行查询,切分成小查询可以减少锁竞争,减少等待获取锁的时间。 1.profiling配置默认是不开启的,可以使用set profiling = ON;命令将配置暂时打开。 2.执行一条查询SQL 3.使用show profiles可以查看最近15条查询SQL及对应的查询idquery id 4.假设查询id为9,使用这个命令show profile for query 9;可以查看每个步骤及其消耗的时间。 https://www.cnblogs.com/116970u/p/11004431.html https://www.jianshu.com/p/1efdddf3d461 char类型 char类型是定长的,在内部存储时实际使用长度较短时会在右边用空格填充,所以插入的数据如果右边有空格会自动截断,因为没有办法知道是自带的还是填充的。 对英文字符(ASCII)占用1个字节,对一个汉字占用两个字节。 适合每行数据的长度比较平均的情况,否则会造成存储空间的浪费。 varchar类型 是不定长的,有一个字节用来存储长度(当长度大于255时,使用两个字节来存储长度),内部存储时,使用多少长度,内存中就占用多少长度,不会有空余,所以比较节省空间。 varchar的存储方式是,对每个英文字符占用2个字节,汉字也占用2个字节。 效率上其实varchar会好一点,其实网上没有比较详尽的测试,看一个博客对1000w的数据进行测试时,varchar会略高一点。 首先对EXPLAIN 分析查询语句后extral字段中出现的一些参数进行说明: 使用了索引进行查询。 一般就是where条件中一些判断字段没有索引,那么这个条件的过滤就会在Server端进行 在innodb数据引擎将结果返回给Server层后,MySQL Server层对数据进行进一步的过滤,然后返回结果。 例如: 假设test表只有主键id有索引,name没有索引,那么查询时就是把所有满足id > 100的数据行返回给Server层,然后Server层根据name='123'进行过滤,所有使用explain时会发现extra那里显示的是Using where 这个就是在MySQL5.6以后,做的一个优化,例如有一个联合索引(a,b,c) 查询条件为where a = '123' AND b like '%aa% AND c like '%cc%'时,按照联合索引的最左匹配法则,只有a可以用上索引,以前版本的MySQL中,innodb存储引擎就会在联合索引把满足a = '123'的数据的主键id找出来,然后回表,然后把所有数据发送给Sever端,Server端根据b like '%aa% AND c like '%cc%'对数据进行过滤, 现在有这个push down优化,因为联合索引中有b和c两个字段的信息,innodb在联合索引查找时就会考虑到b like '%aa% AND c like '%cc%'条件,所有回表的数据就都会是满足这三个条件的,然后返回给Server端的也都是满足条件的数据行,Server端就不会再自己进行数据过滤了。 https://dev.mysql.com/doc/refman/5.7/en/index-condition-pushdown-optimization.html 如果在关联表查询时,Order By的所有字段都来自第一个表(也就是驱动表),那么在处理驱动表时,从驱动表中取出满足条件的结果集时就会进行排序,不需要使用临时表存储数据行进行重排序,extral那一列就会显示是Using index。如果Order By的字段不在索引中,那么就需要在查找出结果集后,进行重排序,就会显示Using filesort。 再进行关联表查询时,如果Order By中的字段不全是来自驱动表,也就是使用了被驱动表中的字段进行排序,那么会把关联结果全部查找出来,存放在临时表中,等所有的关联都结束后,再在内存中对数据行进行排序。 1.优化索引使用情况。使用explain SQL查看解析结果,首先看结果中Extra那一列是否有Using Index,如果没有看是否是where判断条件的字段没有添加索引,不能使用索引。如果出现的是Using Where,可能是where子句里面判断的字段没有加索引,这样innodb就会把所有数据行查询出来,返回给MySQL Server层,Server层做的过滤。 2.减少扫描的行数。查看explain SQL解析结果中rows那一列,看行数是不是特别多,通过添加索引的方式减少扫描的行数。 3.只查询我们需要的列。看SQL中的查询字段是不是都是我们需要的,只选取我们需要的字段,而不是所有查询SQL都是使用SELECT *,这些多的字段的存在,会增大查询的时间,以及网络传输的数据量。 4.优化join的方式,一般join的字段在被驱动表中有索引,那么join使用的算法就会是index Nested-Loop Join,如果没有索引那么就是block Nested-Loop Join。尽量让join的字段有索引可以使用,是在不行,可以增加join buffer Size的大小(默认是256K)。 5.如果单表数据量大于1000万,考虑进行分库分表。 通过ALTER TABLE ADD/DROP或者CREATE/DROP INDEX 可以创建和删除索引。 MySQL接受到创建索引的命令后,会进行创建索引 在MySQL 5.5之前创建索引主要是通过 1.创建临时表,表结构是添加索引后的表结构 2.将原表数据导入到临时表 3.删除原表 4.将临时表重命名成原来的表名 Innodb在1.0之后支持Fast Index Creation,就是添加辅助索引(主键以外的索引),不需要重建表,只需要对表加S锁(加锁期间表只能读,不能写),然后创建索引,对主键加索引还是需要重建表。 就是innodb在创建索引时,会将数据库的增删改命令写入缓存日志,创建完毕后通过重放日志来保持数据库的最终一致性。 1.什么是Nested-Loop Join?
2.Index Nested-Loop Join怎么优化连接?
3.Block Nested-Loop Join怎么优化连接? Nested-Loop Join
在Mysql中,使用Nested-Loop Join的算法思想去优化join,Nested-Loop Join翻译成中文则是“嵌套循环连接”。 举个例子: (1)t1称为外层表,也可称为驱动表。
(2)t2称为内层表,也可称为被驱动表。 //伪代码表示: 在Mysql的实现中,Nested-Loop Join具体有3种实现的算法: Simple Nested-Loop Join:SNLJ,简单嵌套循环连接
Index Nested-Loop Join:INLJ,索引嵌套循环连接
Block Nested-Loop Join:BNLJ,缓存块嵌套循环连接
在选择Join算法时,会有优先级,理论上会优先判断能否使用INLJ、BNLJ:
Index Nested-LoopJoin > Block Nested-Loop Join > Simple Nested-Loop Join 简单嵌套循环连接实际上就是简单粗暴的嵌套循环,如果table1有1万条数据,table2有1万条数据,那么数据比较的次数=1万 * 1万 =1亿次,这种查询效率会非常慢。实现伪代码就跟上面的一样。 所以Mysql继续优化,然后衍生出Index Nested-LoopJoin、Block Nested-Loop Join两种NLJ算法。在执行join查询时mysql会根据情况选择两种之一进行join查询。 索引嵌套循环连接是基于索引进行连接的算法,索引是基于内层表的,通过外层表匹配条件直接与内层表索引进行匹配,避免和内层表的每条记录进行比较, 从而利用索引的查询减少了对内层表的匹配次数,优势极大的提升了 join的性能:
**原来的匹配次数 = 外层表行数 * 内层表行数
优化后的匹配次数= 外层表的行数 内层表索引的高度* 伪代码实现: 使用场景:只有内层表join的列有索引时,才能用到Index Nested-Loop Join进行连接。 使用Index Nested-Loop Join算法时SQL的EXPLAIN结果extral列是Using index。 由于用到索引,如果索引是辅助索引而且返回的数据还包括内层表的其他数据,则会回内层表查询数据,多了一些IO操作。 当有时候Join字段没法使用索引的时候,那样就不能用Index Nested-Loop Join的时候,次数默认就会使用Block Nested-Loop Join。 大体的原理 Block Nested-Loop Join通过一次性缓存多条数据,把参与查询的列缓存到Join Buffer 里,然后拿join buffer里的数据批量与内层表的数据进行匹配,从而减少了内层循环的次数(遍历一次内层表就可以批量匹配一次Join Buffer里面的外层表数据)。 伪代码表示 使用Block Nested-Loop Join算法时SQL的EXPLAIN结果extral列是Using join buffer 什么是Join Buffer?
(1)Join Buffer会缓存所有参与查询的列而不是只有Join的列。
(2)可以通过调整join_buffer_size缓存大小
(3)join_buffer_size的默认值是256K,join_buffer_size的最大值在MySQL 5.1.22版本前是4G,而之后的版本才能在64位操作系统下申请大于4G的Join Buffer空间。
(4)使用Block Nested-Loop Join算法需要开启优化器管理配置的optimizer_switch的设置block_nested_loop为on,默认为开启。 https://blog.csdn.net/u010841296/article/details/89790399 https://mp.weixin.qq.com/s/8W3RzKE1HjKifGzJvzBYzA 1.用小结果集驱动大结果集,减少外层循环的数据量:
如果小结果集和大结果集连接的列都是索引列,mysql在内连接时也会选择用小结果集驱动大结果集,因为索引查询的成本是比较固定的,这时候外层的循环越少,join的速度便越快。
为匹配的条件增加索引:争取使用Index Nested-Loop Join,减少内层表的循环次数
2.增大join buffer size的大小:当使用BNLJ时,一次缓存的数据越多,那么外层表循环的次数就越少。
3.减少不必要的字段查询:
(1)当用到BNLJ时,字段越少,join buffer 所缓存的数据就越多,外层表的循环次数就越少;
(2)当用到INLJ时,如果可以不回表查询,即利用到覆盖索引,则可能可以提示速度。(未经验证,只是一个推论) 4.排序时尽量使用驱动表中的字段 因为如果使用的是非驱动表中的字段会对非驱动表(的字段排序)需要对循环查询的合并结果(临时表)进行排序,比较耗时,使用Explain时会发现出现Using temporary。 参考文档
https://www.wengbi.com/thread_99558_1.html
https://www.cnblogs.com/starhu/p/6418842.html
https://www.cnblogs.com/starhu/p/6418833.html full outer join 会包含两个表不满足条件的行 left join 会包含左边的表不满足条件的行,一般会使用左边的表作为驱动表。 right join 会包含右边的表不满足条件的行,一般会使用右边的表作为驱动表。 inner join 就是只包含满足条件的行 cross join 从表A循环取出每一条记录去表B匹配,cross join 后面不能跟on,只能跟where exists是拿外表作为驱动表,外表的数据做循环,每次循环去内表中查询数据,使用适内表比较大的情况 例如 select * from t1 where t1.tid exists (select t2.tid from t2) 转换为伪代码为: 而 in的话正好相反,是那内表作为驱动表,内表的数据做循环,每次循环去外表查询数据,适合内表比较小的情况。 not in 和not exists如果查询语句使用了not in 那么内外表都进行全表扫描,没有用到索引;而not extsts 的子查询依然能用到表上的索引。所以无论那个表大,用not exists都比not in要快。 join的实现其实是先从一个表中找出所有行(或者根据where子句查出符号条件的行),然后去下一个表中循环寻找匹配的行,依次下去,直到找到所有匹配的行,使用join不会去创建临时表,使用in的话会创建临时表,销毁临时表 所以不管是in子查询,exists子查询还是join连接查询,底层的实现原理都是一样的,本质上是没有任何区别的,关键的点在关联表的顺序,如果是join连接查询,MySQL会自动调整表之间的关联顺序,选择最好的一种关联方式。和上面in和exists比较的结论一样,小表驱动大表才是最优的选择方式。 MySQL 5.5以后,有一个 例如图中就是我们test数据库中有一个activity表有一个index索引没有使用到。 这个界面的数据来源也是来自于 这个是查询结果,可以看到idx_ipport这个索引在查询语句中用到了1次。 table_io_waits_summary_by_index_usage这个表里面还有更详细的统计数据,具体可以看看下面这个链接,里面有介绍 参考链接 https://www.cnblogs.com/cchust/p/5057498.html https://www.cnblogs.com/cchust/p/5061131.html 1.确保数据库表的每一列的原子性 保证每一列的值是原子性的,不可分割的,而不是在查询时需要分割使用函数来查询,降低查询效率。 例如说有一个列是存储地址,如果你要根据省份查询,直接从地址中查可能会使用到函数,降低查询效率,最好是单独将省份另外存一份。 2.确保数据库表的每一列都与主键相关 就是表里面只应该存储一种数据,而不是多种数据,例如订单表就应该存储订单,其中包含商品的id就行了,而不是存储一些商品的具体名称,价格等信息。避免数据冗余,增大维护成本。 3.确保数据库表的每一列直接依赖主键,而不是间接依赖主键。 这一条其实更第二范式差不多。 https://www.cnblogs.com/linjiqin/archive/2012/04/01/2428695.html 这篇文章主要是记录自己最近在真实工作中遇到的慢查询的案例,然后进行调优分析的过程,欢迎大家一起讨论调优经验。(以下出现的表名,列名都是化名,实际数据也进行过一点微调。) 首发于我的掘金博客:https://juejin.im/editor/posts/5eabd9735188256d8e654e74 PS:这篇文章由于写得比较贴近工作实践,已经被51CTO的编辑联系在51CTO公众号进行转载了。 有一个article表,用于存储文章的基本信息的,有文章id,作者id等一些属性,有一个content表,主要用于存储文章的内容,主键是article_id,需求需要将一些满足条件的作者发布的文章导入到另外一个库,所以我同事就在项目中先查询出了符合条件的作者id,然后开启了多个线程,每个线程每次取一个作者id,执行查询和导入工作。 查询出作者id是1111,名下的所有文章信息,文章内容相关的信息的SQL如下: 因为查询的这个数据库是机械硬盘的,在offset查询到20万时,查询时间已经特别长了,运维同事那边直接收到报警,说这个库已经IO阻塞了,已经多次进行主从切换了,我们就去navicat里面试着执行了一下这个语句,也是一直在等待, 然后对数据库执行show proceesslist 命令查看了一下,发现每个查询都是处于Writing to net的状态,没办法只能先把导入的项目暂时下线,然后执行kill命令将当前的查询都杀死进程(因为只是客户端Stop的话,MySQL服务端会继续查询)。 然后我们开始分析这条命令执行慢的原因: 当前是索引情况如下: 所以认为当前是执行流程是先去article表的普通索引author_id里面找到1111的所有文章id,然后根据这些文章id去article表的聚集索引中找到所有的文章,然后拿每个文章id去content表中找文章内容等信息,然后判断create_time是否满足要求,进行过滤,最终找到offset为20000后的100条数据。 所以我们就将article的author_id索引改成了联合索引(author_id,create_time),这样联合索引(author_id,create_time)中的B+树就是先安装author_id排序,再按照create_time排序,这样一开始在联合(author_id,create_time)查询出来的文章id就是满足create_time < '2020-04-29 00:00:00'条件的,后面就不用进行过滤了,就不会就是符合就不用对create_time过滤。 流程确实是这个流程,但是去查询时,如果limit还是210000, 100时,还是查不出数据,几分钟都没有数据,一直到navica提示超时,使用Explain看的话,确实命中索引了,如果将offset调小,调成6000, 100,勉强可以查出数据,但是需要46s,所以瓶颈不在这里。 真实原因如下: 先看关于深分页的两个查询,id是主键,val是普通索引 这两个查询的结果都是查询出offset是30000后的5条数据,区别在于第一个查询需要先去普通索引val中查询出300005个id,然后去聚集索引下读取300005个数据页,然后抛弃前面的300000个结果,只返回最后5个结果,过程中会产生了大量的随机I/O。第二个查询一开始在普通索引val下就只会读取后5个id,然后去聚集索引下读取5个数据页。 同理我们业务中那条查询其实是更加复杂的情况,因为我们业务的那条SQL不仅会读取article表中的210100条结果,而且会每条结果去content表中查询文章相关内容,而这张表有几个TEXT类型的字段,我们使用show table status命令查看表相关的信息发现 发现两个表的数据量都是200多万的量级,article表的行平均长度是266,content表的平均长度是16847,简单来说是当 InnoDB 使用 Compact 或者 Redundant 格式存储极长的 VARCHAR 或者 BLOB 这类大对象时,我们并不会直接将所有的内容都存放在数据页节点中,而是将行数据中的前 768 个字节存储在数据页中,后面会通过偏移量指向溢出页。 (详细了解可以看看这篇文章深度好文带你读懂MySQL和InnoDB) 这样再从content表里面查询连续的100行数据时,读取每行数据时,还需要去读溢出页的数据,这样就需要大量随机IO,因为机械硬盘的硬件特性,随机IO会比顺序IO慢很多。所以我们后来又进行了测试, 只是从article表里面查询limit 200000,100的数据,发现即便存在深分页的问题,查询时间只是0.5s,因为article表的平均列长度是266,所有数据都存在数据页节点中,不存在页溢出,所以都是顺序IO,所以比较快。 相反的,我们直接先找出100个article_id去content表里面查询数据,发现比较慢,第一次查询时需要3s左右(也就是这些id的文章内容相关的信息都没有过,没有缓存的情况),第二次查询时因为这些溢出页数据已经加载到buffer pool,所以大概0.04s。 所以针对这个问题的解决方案主要有两种: 非连续查询的情况下,也就是我们在查第100页的数据时,不一定查了第99页,也就是允许跳页查询的情况,那么就是使用先查主键再join这种方法对我们的业务SQL进行改写成下面这样,下查询出210000, 100时主键id,作为临时表temp_table,将article表与temp_table表进行inner join,查询出中文章相关的信息,并且去left Join content表查询文章内容相关的信息。 第一次查询大概1.11s,后面每次查询大概0.15s 优化前,offset达到20万的量级时,查询时间过长,一直到超时。 优化后,offset达到20万的量级时,查询时间为1.11s。 这种方法的大致思路如下,假设要查询test_table中offset为10000的后100条数据,假设我们事先已知第10000条数据的id,值为min_id_value 优化前,offset达到20万的量级时,查询时间过长,一直到超时。 优化后,offset达到20万的量级时,由于知道第20万条数据的id,查询时间为0.34s。 联合索引其实有两个作用: 例如我们需要查询以下语句: 如果对字段a建立单列索引,对b建立单列索引,那么在查询时,只能选择走索引a,查询所有a=1的主键id,然后进行回表,在回表的过程中,在聚集索引中读取每一行数据,然后过滤出b = 2结果集,或者走索引b,也是这样的过程。
如果对a,b建立了联合索引(a,b),那么在查询时,直接在联合索引中先查到a=1的节点,然后根据b=2继续往下查,查出符合条件的结果集,进行回表。 这种情况就是假如我们只查询某几个常用字段,例如查询a和b如下: 对字段a建立单列索引,对b建立单列索引就需要像上面所说的,查到符合条件的主键id集合后需要去聚集索引下回表查询,但是如果我们要查询的字段本身在联合索引中就都包含了,那么就不用回表了。 这种情况就是假如我们需要查询a>1并且b=2的数据 如果建立的是单列索引a,那么在查询时会在单列索引a中把a>1的主键id全部查找出来然后进行回表。
如果建立的是联合索引(a,b),基于最左前缀匹配原则,因为a的查询条件是一个范围查找(=或者in之外的查询条件都是范围查找),这样虽然在联合索引中查询时只能命中索引a的部分,b的部分命中不了,只能根据a>1进行查询,但是由于联合索引中每个叶子节点包含b的信息,在查询出所有a>1的主键id时,也会对b=2进行筛选,这样需要回表的主键id就只有a>1并且b=2这部分了,所以回表的数据量会变小。 我们业务中碰到的就是第3种情况,我们的业务SQL本来更加复杂,还会join其他表,但是由于优化的瓶颈在于建立联合索引,所以进行了一些简化,下面是简化后的SQL: 我们的需求其实就是从article表中查询出最近一个月,status为1的文章,我们本来就是针对create_time建了单列索引,结果在慢查询日志中发现了这条语句,查询时间需要0.91s左右,所以开始尝试着进行优化。 为了便于测试,我们在表中分别对create_time建立了单列索引create_time,对(create_time,status)建立联合索引idx_createTime_status。 强制使用idx_createTime进行查询 强制使用idx_createTime_status进行查询(即使不强制也是会选择这个索引) 优化前使用idx_createTime单列索引,查询时间为0.91s 优化前使用idx_createTime_status联合索引,查询时间为0.21s 先介绍一下EXPLAIN中Extra列的各种取值的含义 当Query 中包含 ORDER BY 操作,而且无法利用索引完成排序操作的时候,MySQL Query Optimizer 不得不选择相应的排序算法来实现。数据较少时从内存排序,否则从磁盘排序。Explain不会显示的告诉客户端用哪种排序。 仅使用索引树中的信息从表中检索列信息,而不需要进行附加搜索来读取实际行(使用二级覆盖索引即可获取数据)。 当查询仅使用作为单个索引的一部分的列时,可以使用此策略。 要解决查询,MySQL需要创建一个临时表来保存结果。 如果查询包含不同列的GROUP BY和ORDER BY子句,则通常会发生这种情况。官方解释:”为了解决查询,MySQL需要创建一个临时表来容纳结果。典型情况如查询包含可以按不同情况列出列的GROUP BY和ORDER BY子句时。很明显就是通过where条件一次性检索出来的结果集太大了,内存放不下了,只能通过加临时表来辅助处理。 表示当where过滤条件中的字段无索引时,MySQL Sever层接收到存储引擎(例如innodb)的结果集后,根据where条件中的条件进行过滤。 Using index condition 会先条件过滤索引,过滤完索引后找到所有符合索引条件的数据行,随后用 WHERE 子句中的其他条件去过滤这些数据行; 我们的实际案例中,其实就是走单个索引idx_createTime时,只能从索引中查出 满足 filtered字段表示存储引擎返回的数据在server层过滤后,剩下多少满足查询的记录数量的比例,这个是预估值,因为status取值是null,1,2,3,4,所以这里给的25%。 所以第二个查询与第一个查询的区别主要在于一开始去idx_createTime_status查到的结果集就是满足status是1的id,所以去聚集索引下进行回表查询时,扫描的行数会少很多(大概是2.7万行与15万行的区别),之后innodb返回给MySQL Server的数据就是满足条件status是1的结果集(2.7万行),不用再进行筛选了,所以第二个查询才会快这么多,时间是优化前的23%。(两种查询方式的EXPLAIN预估扫描行数都是30万行左右是因为idx_createTime_status只命中了createTime,因为createTime不是查单个值,查的是范围) 根据最左匹配的原则,因为我们的where查询条件是这样,如果是(createTime,status)那么索引就只能用到createTime,如果是(status,createTime),因为status是查询单个值,所以status,createTime都可以命中,在(status,createTime)索引中扫描行数会减少,但是由于(createTime,status)这个索引本身值包含createTime,status,id三个字段的信息,数据量比较小,而一个数据页是16k,可以存储1000个以上的索引数据节点,而且是查询到createTime后,进行的顺序IO,所以读取比较快,总得的查询时间两者基本是一致。下面是测试结果: 首先创建了(status,createTime)名叫idx_status_createTime, 查询时间是0.21,跟第二种方式(createTime,status)索引的查询时间基本一致。 扫描行数确实会少一些,因为在idx_status_createTime的索引中,一开始根据status = 1排除掉了status取值为其他值的情况。 (PS:扫描首页里面的二维码进群,分享我自己在看的技术资料给大家,希望和大家一起学习进步!) 目前还只是买了最新版的《深入理解JVM虚拟机 第三版》,还没有完全看完,看完之后会从网上的面经中找一些实际的面试题,然后自己通过翻书查资料,写面试题解答。 运行时数据区域包含以下五个区域:程序计数器,Java虚拟机栈,本地方法栈,堆,方法区(其中前三个区域各线程私有,相互独立,后面两个区域所有线程共享)
执行一个Java方法时,虚拟机都会创建一个栈帧,来存储局部变量表,操作数栈等,方法调用完毕后会对栈帧从虚拟机栈中移除。 局部变量表中存储了Java基本类型,对象引用(可以是对象的存储地址,也可以是代表对象的句柄等)和returnAddress类型(存储了一条字节码指令的地址)。 本地方法栈与Java虚拟机栈类似,只不过是执行Native方法(C++方法等)。 计数器存储了当前线程正在执行的字节码指令的地址(如果是当前执行的是Native方法,那么计数器为空),字节码解释器就是通过改变计数器的值来选取下一条需要执行的字节码指令。程序计数器是线程私有的,便于各个线程切换后,可以恢复到正确的执行位置。 堆存储了几乎所有对象实例和数组,是被所有线程进行共享的区域。在逻辑上是连续的,在物理上可以是不连续的内存空间(在存储一些类似于数组的这种大对象时,基于简单和性能考虑会使用连续的内存空间)。 存储了被虚拟机加载的类型信息,常量,静态变量等数据,在JDK8以后,存储在方法区的元空间中(以前是存储在堆中的永久代中,JDK8以后已经没有永久代了)。 运行时常量池是方法区的一部分,会存储各种字面量和符号引用。具备动态性,运行时也可以添加新的常量入池(例如调用String的intern()方法时,如果常量池没有相应的字符串,会将它添加到常量池)。 直接内存区不属于虚拟机运行时数据区的一部分。它指的是使用Native方法直接分配堆外内存,然后通过Java堆中的DirectByteBuffer来对内存的引用进行操作(可以避免Java堆与Native堆之间的数据复制,提升性能)。 这是网上看到的一张流程图: 首先代码中new关键字在编译后,会生成一条字节码new指令,当虚拟机遇到一条字节码new指令时,会根据类名去方法区运行时常量池找类的符号引用,检查符号引用代表的类是否已加载,解析和初始化过。如果没有就执行相应的类加载过程。 虚拟机从Java堆中分配一块大小确定的内存(因为类加载时,创建一个此类的实例对象的所需的内存大小就确定了),并且初始化为零值。内存分配的方式有指针碰撞和空闲列表两种,取决于虚拟机采用的垃圾回收期是否带有空间压缩整理的功能。 如果垃圾收集器是Serial,ParNew等带有空间压缩整理的功能时,Java堆是规整的,此时通过移动内存分界点的指针,就可以分配空闲内存。 如果垃圾收集器是CMS这种基于清除算法的收集器时,Java堆中的空闲内存和已使用内存是相互交错的,虚拟机会维护一个列表,记录哪些可用,哪些不可用,分配时从表中找到一块足够大的空闲内存分配给实例对象,并且更新表。 虚拟机会对对象进行必要的设置,将对象的一些信息存储在Obeject header 中。 在构造一个类的实例对象时,遵循的原则是先静后动,先父后子,先变量,后代码块,构造器。在Java程序层面会依次进行以下操作: 内存分配不是一个线程安全的操作,在多个线程进行内存分配是,可能会存在数据不同步的问题。所以有两种方法解决: ##### 添加CAS锁 对内存分配的操作进行同步处理,添加CAS锁,配上失败重试的方式来保证原子性。(默认使用这种方式)。 预先在Java堆中给各个线程分配一块TLAB(本地线程缓冲区)内存,每个线程先在各自的缓冲区中分配内存,使用完了再通过第一种添加CAS锁的方式来分配内存。(是否启动取决于-XX:+/-UseTLAB参数)。 对象在内存中存储布局主要分为对象头,实例数据和对齐填充三部分。 这是网上看到的一张图: 对象头主要包含对象自身的运行时数据(也就是图中Mark Word),类型指针(图中的Class Pointer,指向对象所属的类)。如果对象是数组,还需要包含数组长度(否则无法确定数组对象的大小)。 Mark Word:存储对象自身的运行时数据,例如hashCode,GC分代年龄,锁状态标志,线程持有的锁等等。在32位系统占4字节,在64位系统中占8字节。 Class Pointer:用来指向对象对应的Class对象(其对应的元数据对象)的内存地址。在开启了指针压缩时,占4字节。(默认是开启的) Length:如果是数组对象,还有一个保存数组长度的空间,占4个字节。 保存对象的非静态成员变量数据。实例数据存储的是真正的有效数据,即各个字段的值。无论是子类中定义的,还是从父类继承下来的都需要记录。这部分数据的存储顺序受到虚拟机的分配策略以及字段在类中的定义顺序的影响。 因为HotSpot虚拟机的自动内存管理系统要求对象起始地址是8字节的整数倍,所以任何对象的大小必须是8字节的整数倍,而对象头部分一般是8字节的倍数,如果实力数据部分不是8字节的整数倍,需要对齐填充来补全。 由于默认是开启了指针压缩的,现在普遍的机器位数都是64位,如果对象是普通对象,非数组类型,那么就是对象头部分就是12字节(类型指针4字节,Mark Word 8字节),假设这个对象只有一个Integer变量,那么在实例数据部分就是一个引用变量的空间4字节,总共是16字节,由于正好是8的倍数,就不需要进行对齐填充了。 垃圾回收具有以下特点: 1.只回收堆内存的对象,不回收其他物理资源(数据库连接等) 2.无法精准控制内存回收的时机,系统会在合适的时候进行内存回收。 3.在回收对象之前会调用对象的finalize()方法清理资源,这个方法有可能会让其他变量重新引用对象导致对象复活。 1.可达状态 有一个及以上的变量引用着对象。 2.可恢复状态 已经没有变量引用对象了,但是还没有被调用finalize()方法。系统在回收前会调用finalize()方法,如果在执行finalize()方法时,重新让一个变量引用了对象,那么对象会变成可达状态,否则会变成不可达状态。 3.不可达状态 执行finalize()方法后,对象还是没有被其他变量引用,那么对象就变成了不可达状态。 就是普通的变量对对象的引用,强引用的对象不会被系统回收。 当内存空间足够时,软引用的对象不会被系统回收。当内存空间不足时,软引用的对象可能被系统回收。通常用于内存敏感的程序中。 引用级别比软引用低,对于只有软引用的对象,不管内存是否足够,在垃圾回收时, 都可能会被系统回收。 虚引用主要用于跟踪对象被垃圾回收的状态,在垃圾回收时可以收到一个通知。 就是类加载器一共有三种: 启动类加载器:主要是在加载JAVA_HOME/lib目录下的特定名称jar包,例如rt.jar包,像java.lang就在这个jar包中。 扩展类加载器:主要是加载JAVA_HOME/lib/ext目录下的具备通用性的类库。 应用程序类加载器:加载用户类路径下所有的类库,也就是程序中默认的类加载器。 工作流程: 除启动类加载器以外,所有类加载器都有自己的父类加载器,类加载器收到一个类加载请求时,首先会判断类是否已经加载过了,没有的话会调用父类加载器的的loadClass方法,将请求委派为父加载器,当父类加载器无法完成类加载请求时,子加载器才尝试去加载这个类。
目的是为了保证每个类只加载一次,并且是由特定的类加载器进行加载(都是首先让启动类来进行加载)。 加载一个类时,一般是调用类加载器的loadClass()方法来加载一个类,loadClass()方法的工作流程如下: 1.先调用findLoadedClass(className)来获取这个类,判断类是否已加载。 2.如果未加载,如果父类加载器不为空,调用父类加载器的loadClass()来加载这个类,父类加载器为空,就调用父类加载器加载这个类。 3.父类加载器加载失败,那么调用该类加载器findClass(className)方法来加载这个类。 所以我们一般自定义类加载器都是继承ClassLoader,重写findClass()方法,来实现类加载,这样不会违背双亲委派类加载机制,也可以通过重写loadClass()方法进行类加载,但是这样会违背双亲委派类加载机制。 类加载器是 Java 运行时环境(Java Runtime Environment)的一部分,负责动态加载 Java 类到 Java 虚拟机的内存空间中。类通常是按需加载,即第一次使用该类时才加载。 由于有了类加载器,Java 运行时系统不需要知道文件与文件系统。每个 Java 类必须由某个类加载器装入到内存。 类装载器除了要定位和导入二进制 class 文件外,还必须负责验证被导入类的正确性,为变量分配初始化内存,以及帮助解析符号引用。这些动作必须严格按一下顺序完成: -验证:确保被导入类型的正确性
-准备:为类变量分配内存,并将其初始化为默认值。 在Java虚拟机中存在多个类装载器,Java应用程序可以使用两种类装载器: 在一个 JVM 系统中,至少有 3 种类加载器,那么这些类加载器如何配合工作?在 JVM 种类加载器通过 全盘负责双亲委托机制 来协调类加载器。 全盘负责双亲委托机制只是 Java 推荐的机制,并不是强制的机制。实现自己的类加载器时,如果想保持双亲委派模型,就应该重写 所有Java虚拟机实现必须在每个类或接口首次主动使用时初始化。以下六种情况符合主动使用的要求: 除以上六种情况,所有其他使用Java类型的方式都是被动的,它们不会导致Java类型的初始化。
当类是被动引用时,不会触发初始化: 1.通过子类去调用父类的静态变量,不会触发子类的初始化,只会触发包含这个静态变量的类初始化,例如执行这样的代码 2.通过数组定义类引用类,SuperClass[] array = new SuperClass[10]; 不会触发SuperClass类的初始化,但是执行字节码指令newarray会触发另外一个类[Lorg.fenixsoft.classloading.SuperClass的初始化,这个类继承于Object类,是一个包装类,里面包含了访问数组的所有方法, 3.只引用类的常量不会触发初始化,因为常量在编译阶段进入常量池 对于接口来说,只有在某个接口声明的非常量字段被使用时,该接口才会初始化,而不会因为事先这个接口的子接口或类要初始化而被初始化。 父类需要在子类初始化之前被初始化。当实现了接口的类被初始化的时候,不需要初始化父接口。然而,当实现了父接口的子类(或者是扩展了父接口的子接口)被装载时,父接口也要被装载。(只是被装载,没有初始化) 确认装载后的类型符合Java语言的语义,并且不会危及虚拟机的完整性。 在准备阶段,Java虚拟机为类变量分配内存,设置默认初始值。但在到到初始化阶段之前,类变量都没有被初始化为真正的初始值。 https://www.zhihu.com/question/30300585 解析的过程就是在类型的常量池总寻找类、接口、字段和方法的符号引用,把这些符号引用替换为直接引用的过程。 所有的类变量(即静态量)初始化语句和类型的静态初始化器都被Java编译器收集在一起,放到一个特殊的方法中,这个步骤就是初始化类静态变量和执行静态代码块。 对于类来说,这个方法被称作类初始化方法;对于接口来说,它被称为接口初始化方法。在类和接口的 class 文件中,这个方法被称为 这个步骤是递归执行的,即第一个初始化的类一定是 Java虚拟机必须确保初始化过程被正确地同步。 如果多个线程需要初始化一个类,仅仅允许一个线程来进行初始化,其他线程需等待。 Java虚拟机的内存区域主要分为虚拟机栈,本地方法栈,程序计数器,堆,方法区。垃圾回收主要是对堆中的对象进行回收,方法区里面也会进行一些垃圾回收,但是方法区中的内存回收出现的频率会比较低,主要是针对常量池的回收 和 对类型的卸载,判定一个常量是否是“废弃常量”比较简单,不被引用就行了,而要判定一个类是否是“无用的类”的条件则相对苛刻许多。类需要同时满足下面3个条件才能算是“无用的类”: 1.该类所有的实例都已经被回收,也就是Java堆中不存在该类的任何实例; 2.加载该类的ClassLoader已经被回收; 3.该类对应的 java.lang.Class 对象没有在任何地方被引用,无法在任何地方通过反射访问该类的方法; 是Java方法执行的内存模型,主要是用于方法执行的,每次执行方法时就会创建一个栈帧来压入栈中,每个栈帧存储了方法调用需要的数据,例如局部变量表,操作数栈等。 局部变量表主要是存储方法的参数和创建的局部变量(基本类型或者引用类型),它的大小在编译时就固定了,方法有一个Code属性记录了需要的局部变量表的大小。 操作数栈是一个栈,主要用来做算术运算及调用其他方法时存储传参,调用其他方法时,当前方法栈帧的操作数栈会跟其他方法的局部变量表有一定的重叠,主要便于共享这些传递参数,节约内存空间。(最大深度也是编译时就计算好的。) 线程在调用native方法时使用的栈。 跟虚拟机栈,本地方法栈一样,程序计数器也是线程私有的,主要用来记录当前线程执行的字节码指令的行号,字节码解释器通过改变这个计数器来选取下一条需要执行的字节码指令。 用来存储对象和数据的区域,被所有线程共享,在物理上可以是不连续的。 方法区也是被线程共享的,主要存放类型信息,常量,静态变量,方法去中有一个运行时常量池。 Java中的类在编译后会生成class文件,class文件除了包含变量,方法,接口信息外还包含一个常量池表,用于存放编译时生成的各种字面量和符号引用,在类加载后,字符流常量池会被存放在方法区中的运行时常量池中,运行期间也会可以将新的常量添加到运行时常量池,例如对String的实例调用intern方法。 垃圾回收算法一般有四种 就是对要回收的对象进行标记,标记完成后统一回收。(CMS垃圾收集器使用这种) 缺点: 效率不稳定 执行效率不稳定,有大量对象时,并且有大量对象需要回收时,执行效率会降低。 内存碎片化 内存碎片化,会产生大量不连续的内存碎片。(内存碎片只能通过使用分区空闲分配链表来分配内存) 就是将内存分为两块,每次只用其中一块,垃圾回收时将存活对象,拷贝到另一块内存。(serial new,parallel new和parallel scanvage垃圾收集器) 缺点: 不适合存活率高的老年代 存活率较高时需要很多复制操作,效率会降低,所以老年代一般不使用这种算法。 浪费内存 会浪费一半的内存, 解决方案是新生代的内存配比是Eden:From Survivor: To Survivor = 8比1比1 每次使用时,Eden用来分配新的对象,From Survivor存放上次垃圾回收后存活的对象,只使用Eden和From Survivor的空间,To Survivor是空的,垃圾回收时将存活对象拷贝到To Survivor,当空间不够时,从老年代进行分配担保。 标记-整理算法跟标记-清除算法适用的场景是一样的,都是用于老年代,也就是存活对象比较多的情况。标记-整理算法的流程就是让存活对象往内存空间一端移动,然后直接清理掉边界以外的内存。(parallel Old和Serial old收集器就是采用该算法进行回收的) 吞吐量高 移动时内存操作会比较复杂,需要移动存活对象并且更新所有对象的引用,会是一种比较重的操作,但是如果不移动的话,会有内存碎片,内存分配时效率会变低,所以由于内存分配的频率会比垃圾回收的频率高很多,所以从吞吐量方面看,标记-整理法高于标记-清除法。 延迟高 但是由于需要移动对象,停顿时间会比较长,垃圾回收时延迟会高一些,强调低延迟的CMS收集器一般是大部分时候用标记-清除算法,当内存碎片化程度达到一定程度时,触发Full GC,会使用标记-整理算法清理一次。 弱分代假说:就是绝大部分对象都是朝生夕灭。 强分代假说:熬过越多次垃圾收集的对象就越难以消忙。 就是现在的系统一般都比较复杂,堆中的对象也会比较多,如果使用对所有对象都分析是否需要回收,那么效率会比较低,所以有了分代收集算法,就是对熬过垃圾回收次数不同的对象进行分类,分为新生代和老年代,采用不同回收策略。 新生代存活率低,使用标记-复制算法。新生代发生的垃圾收集交Minor GC,发生频率较高 老年代存活率高,使用标记-清除算法,或者标记-整理算法。(CMS垃圾收集器一般是多数时间采用标记-清除算法,内存碎片化程度较高时,使用标记-整理算法收集一次)。老年代内存满时会触发Major GC(Full GC),一般触发的频率比较低。 有两种算法,一种是引用计数法,可以记录每个对象被引用的数量来确定,当被引用的数量为0时,代表可以回收。
一种是可达性分析法。就是判断对象的引用链是否可达来确定对象是否可以回收。就是把所有对象之间的引用关系看成是一个图,通过从一些GC Roots对象作为起点,根据这些对象的引用关系一直向下搜索,走过的路径就是引用链,当所有的GCRoots对象的引用链都到达不了这个对象,说明这个对象不可达,可以回收。
GCRoots对象一般是当前肯定不会被回收的对象,一般是虚拟机栈中局部变量表中的对象,方法区的类静态变量引用的对象,方法区常量引用的对象,本地方法栈中Native方法引用的对象。 Serial收集器中,新生代与老年代的内存分配是1:2,然后新生代分为Eden区,From区,To区,比例是8:1:1。 分为Eden,From Survivor,To Survivor,8:1:1 Eden用来分配新对象,满了时会触发Minor GC。 From Survivor是上次Minor GC后存活的对象。 To Survivor是用于下次Minor GC时存放存活的对象。 用于存放存活时间比较长的对象,大的对象,当容量满时会触发Major GC(Full GC) 当Eden区没有足够空间进行分配时,虚拟机将发起一次MinorGC。现在的商业虚拟机一般都采用复制算法来回收新生代,将内存分为一块较大的Eden空间和两块较小的Survivor空间,每次使用Eden和其中一块Survivor。 当进行垃圾回收时,将Eden和Survivor中还存活的对象一次性地复制到另外一块空闲的Survivor空间上,最后处理掉Eden和刚才的Survivor空间。(HotSpot虚拟机默认Eden和Survivor的大小比例是8:1)当Survivor空间不够用时,需要依赖老年代进行分配担保。 所谓的大对象是指,需要大量连续内存空间的Java对象,最典型的大对象就是那种很长的字符串以及数组,为了避免大对象在Eden和两个Survivor区之间进行来回复制,所以当对象超过-XX:+PrintTenuringDistribution参数设置的大小时,直接从老年代分配 当对象在新生代中经历过一定次数(XX:MaxTenuringThreshold参数设置的次数,默认为15)的Minor GC后,就会被晋升到老年代中。 为了更好地适应不同程序的内存状况,虚拟机并不是永远地要求对象年龄必须达到了MaxTenuringThreshold才能晋升老年代,如果在Survivor空间中某个年龄所有对象大小的总和>Survivor空间的50%,年龄大于或等于该年龄的对象就可以直接进入老年代,无须等到MaxTenuringThreshold中要求的年龄。 Minor GC:对新生代进行回收,不会影响到年老代。因为新生代的 Java 对象大多死亡频繁,所以 Minor GC 非常频繁,一般在这里使用速度快、效率高的算法,使垃圾回收能尽快完成。 Full GC:也叫 Major GC,对整个堆进行回收,包括新生代和老年代。由于Full GC需要对整个堆进行回收,所以比Minor GC要慢,因此应该尽可能减少Full GC的次数,导致Full GC的原因包括:老年代被写满和System.gc()被显式调用等。 1.为新对象分配内存时,新生代的Eden区空间不足。
新生代回收日志: 主要分为三种: 代码中调用system.gc()方法,建议JVM进行垃圾回收。 方法区中存放的是一些类的信息,当系统中要加载的类、反射的类和调用的方法较多时,方法区可能会被占满,触发 Full GC 而老年代空间不足又有很多种情况:
3.1 Minor GC后,老年代存放不下晋升对象
在进行 MinorGC 时, Survivor Space 放不下存活的对象,此时会让这些对象晋升,只能将它们放入老年代,而此时老年代也放不下时造成的。
还有一些情况也会导致新生代对象晋升,例如存活对象经历的垃圾回收次数超过一定次数(XX:MaxTenuringThreshold参数设置的次数,默认为15),那么会导致晋升,
或者在Survivor空间中相同年龄所有对象大小的总和大于Survivor空间的一半,年龄大于或等于该年龄的对象就可以直接进入老年代,无须等到MaxTenuringThreshold中要求的年龄。
3.2 Concurrent Mode Failure
在执行 CMS GC 的过程中,同时有对象要放入老年代,而此时老年代空间不足造成的。
3.3 历次晋升的对象平均大小>老年代的剩余空间
这是一个较为复杂的触发情况, HotSpot为了避免由于新生代对象晋升到老年代导致老年代空间不足的现象,
在进行 Minor GC时,做了一个判断,如果之前统计所得到的 MinorGC 晋升到老年代的平均大小大于老年代的剩余空间,那么就直接触发 Full GC。
3.4 老年代空间不足以为大对象分配内存
因为超过阀值(-XX:+PrintTenuringDistribution参数设置的大小时)的大对象,会直接分配到老年代,如果老年代空间不足,会触发Full GC。 一般老年代使用的就是标记-整理,或者标记-清除+标记-整理结合(例如CMS) 新生代就是标记-复制算法 就是最简单的垃圾收集器,也是目前 JVM 在 Client 模式默认的垃圾收集器,在进行垃圾收集时会停止用户线程,然后使用一个收集线程进行垃圾收集。主要用于新生代,使用标记-复制算法。 优点是简单高效(与其他收集器的单线程比),内存占用小,因为垃圾回收时就暂停所有用户线程,然后使用一个单线程进行垃圾回收,不用进行线程切换。 缺点是收集时必须停止其他用户线程。 跟Serial收集器一样,不过是应用于老年代,使用标记-整理算法。 ParNew收集器是Serial收集器的多线程并行版本,在进行垃圾收集时可以使用多个线程进行垃圾收集。 与Serial收集器主要区别就是支持多线程收集,ParNew收集器应用广泛(JDK9以前,服务端模式垃圾收集组合官方推荐的是ParNew+CMS),因为只有Serial和ParNew才能配合CMS收集器(应用于老年代的并发收集器)一起工作。 也支持多线程收集,它的目标是达到一个可控制的吞吐量,就是运行用户代码的时间/(运行用户代码的时间+垃圾回收的时间)比值。高吞吐量可以最高效率地利用处理器资源,尽快完成程序运算任务,适合不需要太多的交互分析任务。不支持并发收集,进行垃圾回收时会暂停用户线程,使用多个垃圾回收线程进行垃圾回收。 是Parallel Scanvenge老年代版本,支持多线程收集,使用标记整理法实现的。 CMS收集器是第一个支持并发收集的垃圾收集器,在垃圾收集时,用户线程可以和收集线程一起工作,它的执行目标是达到最短回收停顿时间,以获得更好的用户体验。 CMS英文是Concurrent Mark Sweep,是基于标记-清除法+标记-整理算法实现的,步骤如下: 标记那些GC Roots可以直接关联到的对象。 从GC Roots能关联到的对象直接向下遍历整个对象图,耗时较长,但是可以与用户线程并发执行。 整个标记过程是采用三色标记法来实现的: 白色:代表还没有遍历的对象。 灰色:代表已遍历到的对象,但是它直接引用的对象还没有遍历完。 黑色:代表已遍历到的对象,它直接引用的对象也都已经遍历完。 1.先将所有对象放到白色集合,然后将GC Roots能关联的对象添加到灰色集合。 2.对灰色集合中对象进行遍历,假设从灰色集合中取出的对象是A,将对象A引用的所有对象添加到灰色集合,全部添加完毕后,将A添加到黑色集合。 3.重复第2步,直到灰色集合为空。 对于这种漏标的情况,CMS垃圾收集器使用的是增量更新法,就是将引用变化后的引用情况进行记录,然后之后进行标记。也就是当E->G变成了E->null,D->G,会对更改后的引用D->G进行记录,用于在重新标记阶段对这种情况进行处理。 就是对于这种E->G,然后改成D->G,正常来说,应该可能会漏掉,因为D已经是黑色对象了,就不会遍历G了,G1垃圾收集器对这种情况的处理是保存原始快照,就是在并发标记过程中,引用的变动,都会对变动前的引用情况进行记录,会按照变动前的引用情况进行标记,也就是即便E->G变成了E->null,D->G变化了,还是会记录E->G的引用情况,用于在重新标记阶段对这种情况进行处理。 由于标记时,用户线程在运行,并发标记阶段存在一些标记变动的情况,这一阶段就是修正这些记录。(CMS采用增量更新算法来解决,主要是将更改后的引用关系记录,之后增量更新) 清除标记阶段判断的已经死亡的对象,由于不需要移动存活对象,这个阶段也可以与用户线程并发执行。 目标是在延迟可控(用户设定的延迟时间)的情况下获得尽可能高的吞吐量。 JDK9以前,服务端模式默认的收集器是Parallel Scavenge+Serial Old。JDK9及之后,默认收集器是G1。G1不按照新生代,老年代进行划分,而是将Java堆划分为多个大小相等的独立Region,每一个Region可以根据需要,扮演新生代的Eden空间,Survivor空间,老年代Old空间和用于分配大对象的Humongous区。回收思路是G1持续跟踪各个Region的回收价值(回收可释放的空间和回收所需时间),然后维护一个优先级列表,在用户设定的最大收集停顿时间内,优先回收那些价值大的Region。 JDK 8 和9中,Region的大小是通过(最大堆大小+最小堆大小)的平均值/2048,一般是需要在1到32M之间。G1认为2048是比较理想的Region数量 G1对象分配策略 说起对象的分配,我们不得不谈谈对象的分配策略。它分为4个阶段: 对象在分配之前会做逃逸分析,如果该对象只会被本线程使用,那么就将该对象在栈上分配。这样对象可以在函数调用后销毁,减轻堆的压力,避免不必要的gc。 如果对象在栈是上分配不成功,就会使用TLAB来分配。TLAB为线程本地分配缓冲区,它的目的为了使对象尽可能快的分配出来。如果对象在一个共享的空间中分配,我们需要采用一些同步机制来管理这些空间内的空闲空间指针。在Eden空间中,每一个线程都有一个固定的分区用于分配对象,即一个TLAB。分配对象时,线程之间不再需要进行任何的同步。 对TLAB空间中无法分配的对象,JVM会尝试在共享Eden空间中进行分配。如果是大对象,则直接在Humongous区分配。 最后,G1提供了两种GC模式,Young GC和Mixed GC,两种都是Stop The World(STW)的。下面我们将分别介绍一下这2种模式。 G1 Young GC Young GC主要是对Eden区进行GC,它在Eden空间耗尽时会被触发。在这种情况下,Eden空间的数据移动到Survivor空间中,如果Survivor空间不够,Eden空间的部分数据会直接晋升到年老代空间。Survivor区的数据移动到新的Survivor区中,也有部分数据晋升到老年代空间中。最终Eden空间的数据为空,GC停止工作,应用线程继续执行。 因为老年代old区也会存在对新生代Eden区的引用,如果只是为了收集Eden区而对整个老年代进行扫描,那样开销太大了,所以G1其实会将每个Region分为很多个区,每个区有一个下标,当这个区有对象被其他Region引用时,那么CardTable对应下标下值为0,然后使用一个Rset来存储老年代Region对当前这个新生代Region的引用,Key是别的Region的起始地址,Value是一个集合,里面的元素是Card Table的Index。对跨代引用的扫描,只需要扫描RSet就行了。 在CMS中,也有RSet的概念,在老年代中有一块区域用来记录指向新生代的引用。这是一种point-out,在进行Young GC时,扫描根时,仅仅需要扫描这一块区域,而不需要扫描整个老年代。 但在G1中,并没有使用point-out(就是记录当前Region对其他Region中对象的引用),这是由于一个Region太小,Region数量太多,如果是用point-out的话,如果需要计算一个Region的可回收的对象数量,需要把所有Region都是扫描一遍会造成大量的扫描浪费,有些根本不需要GC的分区引用也扫描了。于是G1中使用point-in来解决。point-in的意思是哪些Region引用了当前Region中的对象。这样只需要将当前Region中这些对象当做初始标记时的根对象来扫描就可以扫描出因为有跨代引用需要存活的对象,避免了无效的扫描。 这是不必要的,原因在于每次GC时,所有新生代都会被扫描,所以只需要记录老年代的Region对新生代的这个Region之间的引用即可。 需要注意的是,如果引用的对象很多,赋值器需要对每个引用做处理,赋值器开销会很大,为了解决赋值器开销这个问题,在G1 中又引入了另外一个概念,卡表(Card Table)。一个Card Table将一个分区在逻辑上划分为固定大小的连续区域,每个区域称之为卡。卡通常较小,介于128到512字节之间。CardTable通常为字节数组,由Card的索引(即数组下标)来标识每个分区的空间地址。默认情况下,每个卡都未引用。当一个地址空间有引用时,这个地址空间对应的数组索引的值被标记为"0",即标记为脏引用,此外RSet也将这个数组下标记录下来。一般情况下,这个RSet其实是一个Hash Table集合(每个线程对应一个Hash Table,主要是为了减少多线程并发更新RSet的竞争),每个哈希表的Key是别的Region的起始地址,Value是一个集合,里面的元素是Card Table的Index。 如果Rset是记录每个外来Region对当前Region中对象的引用,这样数量就太多了,所以Card Table只是有很多Byte字节,每个字节记录了Region对应的一个内存区域(卡页)是否是dirty的,为1代表dirty,也就是有其他Region对这个卡页中的对象进行引用。 G1 MixGC MixGC不仅进行正常的新生代垃圾收集,同时也回收部分后台扫描线程标记的老年代分区。Young GC回收是把新生代活着的对象都拷贝到Survivor的特定区域(Survivor to),剩下的Eden和Survivor from就可以全部回收清理了。那么,mixed GC就是把一部分老年区的region加到Eden和Survivor from的后面,合起来称为collection set, 就是将被回收的集合,下次mixed GC evacuation把他们所有都一并清理。选old region的顺序是垃圾多的(存活对象少)优先。 它的GC步骤分2步: 在进行Mix GC之前,会先进行global concurrent marking(全局并发标记)。 global concurrent marking的执行过程是怎样的呢? 在G1 GC中,它主要是为Mixed GC提供标记服务的,并不是一次GC过程的一个必须环节。global concurrent marking的执行过程分为五个步骤: 初始标记 只标记GC Roots直接引用的对象 并发标记 从GC Roots开始对堆中对象进行可达性分析,扫描整个对象图,找出要回收的对象。(可以与用户线程并发执行) 最终标记 对并发标记阶段,由于用户线程执行造成的改动进行修正,使用原始快照方法。 筛选回收 对Region进行排序,根据回收价值,选择任意多个Region构成回收集,将存活对象复制到空的Region中去,因为涉及到存活对象的移动,所以是暂停用户线程的。 相关资料: https://www.jianshu.com/p/aef0f4765098 三色标记法可以与用户线程并发执行。 引用计数法主要没有办法解决循环引用的问题。 标记清除法主要流程就是一开始认为所有对象是0,然后从GC Roots对象开始向下遍历,递归地遍历所有对象,将能遍历到的对象标记为1。然后遍历结束后,标记为0的对象被认为是可以被销毁的。主要问题在于标记过程需要Stop the world,也就是需要停止用户线程,只有标记线程能运行。 扩展阅读: https://zhuanlan.zhihu.com/p/87790329 -XX:+UseSerialGC,虚拟机运行在Client 模式下的默认值,打开此开关后,使用Serial + Serial Old 的收集器组合进行内存回收 -XX:+UseConcMarkSweepGC,打开此开关后,使用ParNew + CMS + Serial Old 的收集器组合进行内存回收。Serial Old 收集器将作为CMS 收集器出现Concurrent Mode Failure失败后的后备收集器使用。(我们的线上服务用的都是这个) -XX:+UseParallelGC,虚拟机运行在Server 模式下的默认值,打开此开关后,使用Parallel Scavenge + Serial Old(PS MarkSweep)的收集器组合进行内存回收。 -XX:+UseParallelOldGC,打开此开关后,使用Parallel Scavenge + Parallel Old 的收集器组合进行内存回收。 -XX:+UseG1GC,打开此开关后,采用 Garbage First (G1) 收集器 -XX:+UseParNewGC,在JDK1.8被废弃,在JDK1.7还可以使用。打开此开关后,使用ParNew + Serial Old 的收集器组合进行内存回收 参考链接: https://www.pianshen.com/article/7390335728/ 使用这个命令可以查询当前使用的垃圾收集器
另外这个命令可以查询到更加详细的信息 我们在IDEA中启动的一个Springboot的项目,默认使用的垃圾收集器参数是
-XX:+UseParallelGC JDK8默认情况下服务端模式下JVM垃圾回收参数是-XX:+UseParallelGC参数,也就是会使用Parallel Scavenge+Serial Old的收集器组合,进行内存回收。 但是一般如果我们的后端应用不是那种需要进行大量计算的应用,基于低延迟的考虑,可以考虑使用-XX:+UseConcMarkSweepGC进行垃圾收集,这种配置下会使用ParNew来收集新生代内存,CMS垃圾回收器收集老年代内存。 在JDK9时,默认的垃圾收集器是G1收集器,也可以使用-XX:+UseG1GC参数来启动G1垃圾收集器。 一般在使用容器部署Java应用时,一般为了充分利用物理机的资源,会在物理机上部署多个容器应用,然后对每个容器设置最大内存的限制,但是JVM的最大堆默认值一般取得的物理机最大内存的25%,一旦应用内存超出容器的最大内存限制,容器就会把应用进程kill掉,然后重启。为了解决这个问题,有3种解决方案: 1.在应用的JVM参数中添加-Xmx 最大堆内存的大小,可以设置为容器最大内存限制的75%。一旦你在修改了容器的最大内存限制,每个应用的JVM参数-Xmx 也许需要同步进行修改。 2.就是添加这几个参数可以让Java应用感知容器的内存限制,从而在设置最大堆内存大小时,根据容器的内存限制进行设置。
下面是MaxRAMFraction取不同的值时,最大堆内存与容器最大内存限制的比例。考虑到除了内存中除了最大堆内存以外,还有方法区,线程栈等需要需要占用内存,所以MaxRAMFraction一般至少取2会比较合适。如果取值为1,在最大堆内存占满时,可能Java应用占用的总内存会超过容器最大内存限制。 3.在JDK8以后,JVM增加了容器感知功能,就是如果不显示指定-Xmx2048m 最大堆内存大小, -Xms2048m最小堆内存大小,会取容器所在的物理机的内存的25%作为最大堆内存大小,也可以通过这几个参数来设置堆内存占容器内存的比例
-XX:MinRAMPercentage 最小堆内存大小占容器内存限制的比例
-XX:MaxRAMPercentage 最大堆内存大小占容器内存限制的比例
-XX:InitialRAMPercentage 初始堆内存大小占容器内存限制的比例 Max memory = [-Xmx] + [-XX:MaxPermSize] + number_of_threads * [-Xss] -Xss128k: 设置每个线程的堆栈大小.JDK5.0以后默认每个线程的栈大小为1M。 -Xms 堆内存的初始大小,默认为物理内存的1/64
-Xmx 堆内存的最大大小,默认为物理内存的1/4
-Xmn 堆内新生代的大小。通过这个值也可以得到老生代的大小:-Xmx减去-Xmn -Xss 设置每个线程可使用的内存大小,即栈的大小。在相同物理内存下,减小这个值能生成更多的线程,当然操作系统对一个进程内的线程数还是有限制的,不能无限生成。线程栈的大小是个双刃剑,如果设置过小,可能会出现栈溢出,特别是在该线程内有递归、大的循环时出现溢出的可能性更大,如果该值设置过大,就有影响到创建栈的数量,如果是多线程的应用,就会出现内存溢出的错误。 1.启动时配置,出现OOM问题时自动生成
JVM启动时增加两个参数: 2.执行jmap命令立即生成
发现程序异常前通过执行指令,直接生成当前JVM的dmp文件,6214是指JVM的进程号 获得heap.hprof以后,执行 由于第一种方式是一种事后方式,需要等待当前JVM出现问题后才能生成dmp文件,实时性不高,第二种方式在执行时,JVM是暂停服务的,所以对线上的运行会产生影响。所以建议第一种方式。 可以在启动Java应用的命令中添加这些参数,指定生成垃圾收集的日志的路径,可以记录垃圾收集的情况。 这是一条Minor GC的回收日志(一般GC (Allocation Failure)代表Minor GC,老年代垃圾回收一般打印的是Full GC (Metadata GC Threshold) ) GC (Allocation Failure) 代表Eden区分配内存失败触发Minor GC。
2020-05-07T16:28:02.845+0800: 78210.469 是发生的时间。
68553K->466K(76672K) 代表垃圾回收前新生代使用内存是68MB,剩余0.4MB,总内存是76MB。
0.0221963 secs 是垃圾回收耗时。
131148K->63062K(2088640K) 代表堆区回收前使用131MB,63MB,总内存是2088MB。 [Times: user=0.02 sys=0.00, real=0.02 secs] 用户态耗时0.02s,内核态耗时0s,总耗时0.02s PS:有一个网站,可以对上传GC.log的日志进行分析,解析日志文件,统计出垃圾收集总占用的时间,以及新生代,老年代的内存使用峰值,https://gceasy.io/ 1.首先使用 2.使用 3.使用 例如这个线程是在执行垃圾回收: 这种就是栈的空间不足,就会抛出这个异常,一般是递归执行一个方法时,执行方法深度太深时出现。Java执行一个方法时,会创建一个栈帧来存放局部变量表,操作数栈,如果分配栈帧时,栈空间不足,那么就会抛出这个异常。 (栈空间可以设置-Xss参数实现,默认为1M,如果参数) jstat可以打印出当前JVM运行的各种状态信息,例如新生代内存使用情况,老年代内存使用情况,以及垃圾回收的时间。Minor GC发生总次数,总耗时,Full GC发生总次数,总耗时。(jmap -heap命令也可以打印出堆中各个分区的内存使用情况,但是不能定时监测,持续打印。例如每1s打印当前的堆中各个分区的内存使用情况,一直打印100次。) 打印结果如下: 各个参数的含义如下: 一般还可以使用 例如,S0代表 新生代中第一个survivor区的空间使用了73.19%,E代表新生代Eden区使用了51%,O代表老年代食堂了98% jstack可以生成当前JVM的线程快照,也就是当前每个线程当前的状态及正在执行的方法,锁相关的信息。 例如在下面的例子中,第一个线程获取到lock1,再去获取lock2,第二个线程先获取到lock2,然后再去获取lock1。每个线程都只获得了一个锁,同时在获取另外一个锁,就会进入死锁状态。 使用 以及各个线程的状态,执行的方法(pool-1-thread-1和pool-1-thread-2分别代表线程池的第一个线程和第二个线程): 这个命令可以生成当前堆栈快照。使用 使用jmap -heap查看内存使用情况的案例 jmap -histo 进程id 打印出当前堆中的对象统计信息,包括类名,每个类的实例数量,总占用内存大小。 使用 也可以配置启动时的JVM参数,让发送内存溢出时,自动生成堆栈快照文件。 使用jmap -dump:format=b,file=/存放路径/heapdump.hprof 进程id就可以得到堆转储文件,然后执行jvisualvm命令就可以打开JDK自带的jvisualvm软件。 例如在这个例子中会造成OOM问题,通过生成heapdump.hprof文件,可以使用jvisualvm查看造成OOM问题的具体代码位置。 造成OOM问题的代码位置: 堆内对象列表 占用内存最多的实例对象就是这个placeholder对象 MAT主要可以用于分析内存泄露,可以查询dump堆转储文件中的对象列表,以及潜在的内存泄露的对象。 通过导入hprof文件,主页会展示潜在的内存泄露问题,比如下面这个例子中 在详情页面Shortest Paths To the Accumulation Point表示GC root对象到内存消耗聚集点的最短路径,内存聚集点的意思就是占用了大量内存的对象,也就是可能发生; 内存泄露的对象。 然后在主页点击Histogram,进入Histogram页面可以看到对象列表,with incomming references 也就是可以查看所有对这个对象的引用(思路一般优先看占用内存最大对象;其次看数量最多的对象。)。我们这个例子中主要是byte[]数组分配了占用了大量的内存空间,而byte[]主要来自于Test018类的静态变量arrayList的每个TestObject类型的元素的placeholder属性。 同时可以点击 内存快照对比 功能对两个dump文件进行对比,判断两个dump文件生成间隔期间,各个对象的数量变化,以此来判断内存泄露问题。 happens-before主要是为保证Java多线程操作时的有序性和可见性,防止了编译器重排序对程序结果的影响。
因为当一个变量出现一写多读,多读多写的情况时,就是多个线程读这个变量,然后至少一个线程写这个变量,因为编译器在编译时会对指令进行重排序,如果没有happens-before原则对重排序进行一些约束,就有可能造成程序执行不正确的情况。 具体有8条规则:
1.程序次序性规则:一个线程内,按照代码顺序,书写在前面的操作先行发生于书写在后面的操作。一段代码在单线程中执行的结果是有序的。(只在单线程有效,一写多读时,写的变量如果是没有使用volatile修饰时,是没法保证其他线程读到的变量是最新的值) 2.锁定规则:一个锁的解锁操作总是要在加锁操作之前。 3.volatile规则:如果一个写操作去写一个volatile变量,一个读操作去读volatile变量,那么写操作一定是在读操作之前。 4.传递规则:操作A happens before 操作B, B happens before C,那么A一定是happens before C的。 5.线程启动规则:线程A执行过程中修一些共享变量,然后再调用threadB.start()方法来启动线程B,那么A对那些变量的修改对线程B一定是可见的。 6.线程终结规则:线程A执行过程中调用了threadB.join()方法来等待线程B执行完毕,那么线程B在执行过程中对共享变量的修改,在join()方法返回后,对线程A可见。 7.线程中断规则:对线程interrupt()方法的调用先行发生于被中断线程的代码检测到中断事件的发生。 8.对象终结规则:一个对象的初始化完成先行发生于他的finalize()方法的开始; https://www.cnblogs.com/chenssy/p/6393321.html 1.首先一个kafka集群有很多个kafka的服务器,每个kafka服务器就是一个broker,每一类消息有一个topic,生产者将一个消息发送给broker。 2.每个topic会有一个或者多个分区,broker根据分发机制将这个消息分给这个topic下的某个分区的leader, 分发机制: 3.每个分区就是一个目录,目录名是topic+分区编号,在收到消息后会将消息写入到日志文件中,如果一个分区的消息都有存放在一个日志文件中,那么文件会比较大,查询时会比较慢,而且也不便于之后删除旧的消息。所以每个分区对应多个大小相等的segment文件,每个segment的名称是上一个segment最后一条消息的offset,一个segment有两个文件,一个是.index文件,记录了消息的offset及这条消息数据在log文件中的偏移量。一个是.log文件,实际存储每个消息数据,每条消息数据大小不一,每条消息数据包含offset,消息体大小,消息体等等内容。查的时候根据offset先去index文件找到偏移量,然后去log文件中读。 (具体的segment切分有很多个触发条件: 当log文件>log.segment.bytes时切分,默认是1G。 或者是segment文件中最早的消息距离现在的时间>log.roll.ms配置的时间,默认是7天。 或者是索引文件index>log.index.size.max.bytes的大小,默认是10M。) 4.分区leader将消息存储到日志文件中后还不能算是写成功,会把消息同步给所有follower,当follower同步好消息之后就会给leader发ack,leader收到所有follower返回的ack之后,这条才算是写成功,然后才会给生产者返回写成功。(依据ACK配置来决定多少follower同步成功才算生产者发送消息成功) 5.消费者读数据时就去分区的leader中去读,一个消费者可以消费多个分区,但是一个分区只能一个消费者来消费,默认消费者取完数据就会自动提交,一般会关闭自动提交,消费者消费成功后,进行手动提交,分区的offset才会向后移动。(默认是会自动提交,一般会关闭自动提交) 1.replication.factor>=2,也就是一个分区至少会有两个副本。 2.min.insync.replicas默认是1,leader至少要有一个follow跟自己保持联系没有掉线。(这个配置只有在ack为all或者-1时有用,也就是ack为all也只是要求生产者发送的消息,被leader以及ISR集合里面的从节点接收到,就算所有节点都接收到了。) 3.一般设置了ack=all就不会丢数据。因为会保证所有的follower都收到消息,才算broker接收成功,默认ack=1。 4.retries=,生产者写入消息失败后的重试次数。 5.每个partition有一个offset, 6.生产者ACK配置: 1(默认) 数据发送到Kafka后,经过leader成功接收消息的的确认,就算是发送成功了。在这种情况下,如果leader宕机了,则会丢失数据。 0 生产者将数据发送出去就不管了,不去等待任何返回。这种情况下数据传输效率最高,但是数据可靠性确是最低的。 -1 也就是all,producer需要等待ISR中的所有follower都确认接收到数据后才算一次发送完成,可靠性最高。 这块比较常见的一个场景,就是 此时一般是要求起码设置如下 4 个参数: 这样配置之后,至少在Kafka 如果按照上述的思路设置了 为了实现Producer的幂等语义,Kafka引入了 对于每个PID,该Producer发送数据的每个 类似地,Broker端也会为每个 上述设计解决了0.11.0.0之前版本中的两个问题: http://www.jasongj.com/kafka/transaction/ 只能自己从业务层面保证重复消费的幂等性,例如引入版本号机制。 上述幂等设计只能保证单个Producer对于同一个 另外,它并不能保证写操作的原子性——即多个写操作,要么全部被Commit要么全部不被Commit。 更不能保证多个读写操作的的原子性。尤其对于Kafka Stream应用而言,典型的操作即是从某个Topic消费数据,经过一系列转换后写回另一个Topic,保证从源Topic的读取与向目标Topic的写入的原子性有助于从故障中恢复。 事务保证可使得应用程序将生产数据和消费数据当作一个原子单元来处理,要么全部成功,要么全部失败,即使该生产或消费跨多个 另外,有状态的应用也可以保证重启后从断点处继续处理,也即事务恢复。 为了实现这种效果,应用程序必须提供一个稳定的(重启后不变)唯一的ID,也即 另外,为了保证新的Producer启动后,旧的具有相同 有了 需要注意的是,上述的事务保证是从Producer的角度去考虑的。从Consumer的角度来看,该保证会相对弱一些。尤其是不能保证所有被某事务Commit过的所有消息都被一起消费,因为: ISR(in-sync replica) 就是 Kafka 为某个分区维护的一组同步集合,即每个分区都有自己的一个 ISR 集合,就是从分区的从节点中找出一些节点加入到ISR集合(min.insync.replicas这个参数设定ISR中的最小副本数是多少,默认值为1)。处于 ISR 集合中的副本,意味着 follower 副本与 leader 副本保持同步状态,只有处于 ISR 集合中的副本才有资格被选举为 leader。follower从leader同步数据有一些延迟(延迟时间replica.lag.time.max.ms),一旦超过延迟时间,就会把这个这个follower从ISR列表中移除。被移除的followe会从leader复制数据进行追赶,一旦追赶上又可以重新进入ISR列表。一条 Kafka 消息,只有被 ISR 中的副本都接收到,才被视为“已同步”状态。这跟 zk 的同步机制不一样,zk 只需要超过半数节点写入,就可被视为已写入成功。 传统的IO接口像read和write系统调用,在执行过程中都是涉及到数据拷贝操作的,比如调用read()接口去读取一个文件时,首先需要将CPU由用户切换成内核态,然后把文件从磁盘读取到 read()系统调用的步骤:
1.会涉及到到一次用户态到内核态的切换,然后会发出 sys_read()系统调用,从文件读取数据。(一次上下文切换)
2.磁盘控制器会使用DMA技术将磁盘文件拷贝到内核内存空间的缓冲区。(一次DMA拷贝)
3.CPU会将数据从内核内存空间的缓冲区拷贝到用户进程内存空间的缓冲区。(一次CPU拷贝)
4.然后read()系统调用返回后,会进行内核态往用户态的切换,这样用户程序进程就可以修改数据了。(一次上下文切换) write()系统调用的步骤:
1.首先会涉及CPU从用户态切换到内核态,然后会将数据从用户程序的内存空间拷贝到内核内存空间中的Socket缓冲区。(一次上下文切换,一次CPU拷贝)
2.网卡会使用DMA技术,将数据从内核内存空间中的缓冲区拷贝到网卡。(一次DMA拷贝)
3.write()调用完成后会从内核态切换到用户态。(一次上下文切换) 1.CPU从用户态切换到内核态,磁盘控制器使用DMA技术将数据从磁盘拷贝到内核的内存空间。不会将数据拷贝到用户程序的内存空间,而是将一块物理内存让用户进程的空间与内核空间进行共享,将内核中的这部分内存空间映射到用户进程的内存空间,从而让用户进程可以直接访问这部分内存。(一次上下文切换,一次DMA拷贝) 2.mmap调用完毕后,CPU会从内核态切换到用户态。(一次上下文切换) mmap相比于read()系统调用还是会有2次上下文切换,但是可以减少一次CPU拷贝,因为数据是存在内核的内存空间中。 1.首先CPU从用户态切换到内核态,然后把数据从内核的内存空间拷贝到内核中Socket缓冲区。(一次上下文切换,一次CPU拷贝) 2.网卡使用DMA技术,将数据从Socket缓冲区拷贝到网卡。发送完毕后,从内核态切换为用户态。(一次上下文切换,一次DMA拷贝) https://mp.weixin.qq.com/s/xDZ9NnyUZSoR9npuMLdpWA
https://blog.csdn.net/choumu8867/article/details/100658332 这种方式只能用于发送文件,不能修改文件,在Kakfa发送消息给消费者时有用到。 读取时: 1.首先CPU从用户态切换成内核态,然后磁盘控制器使用DMA技术将文件从磁盘拷贝到内核空间的缓冲区中。 (一次上下文切换,一次DMA拷贝) 发送时: 2.早期的版本是将数据从内核空间中的缓存区拷贝到内核空间的Socket缓冲区,在Linux 2.4以后,是只需要将数据在内核空间的文件数据缓存中的位置和偏移量写入到Socket缓存中,然后网卡直接从Socket缓存中读取文件的位置和偏移量,使用DMA技术拷贝到网卡。发送完毕后,从内核态切换为用户态。 (一次上下文切换,一次DMA拷贝。) 传统read()和write()方案:数据拷贝了4次,CPU上下文切换了很多次 mmap和write()方案:数据拷贝了3次,会减少一次CPU拷贝,上下文切换了4次。(可以减少1次CPU拷贝) sendfile方案:数据拷贝了2次,上下文切换了2次。但是用户进程不能修改数据。(可以减少2次CPU拷贝,至少2次上下文切换) log.flush.interval.messages 最大刷盘消息数量
log.flush.interval.interval.ms 最大刷盘时间间隔
log.flush.scheduler.interval.ms 定期刷盘间隔
可以通过设置 最大刷盘消息数量 和 最大刷盘时间间隔 来控制fsync系统调用的时间,但是Kafka不推荐去设置这些参数,希望让操作系统来决定刷盘的时机,这样可以支持更高的吞吐量。而且Kafka保证可用性是通过多副本来实现的,一个机器挂掉了就会选举副本作为leader。 1.topic下分区的数量增加了或者减少了。(这个一般是我们手动触发的) 2.消费者的数量发生了改变,例如新增加了消费者或者有消费者挂掉了。
Kafka有一个session.timeout.ms,最大会话超时时间,最长是10s。就是如果broker与消费者之间的心跳包超过10s还没有收到回应,就会认为消费者掉线了。以及还有一个max.poll.interval.ms参数,消费者两次去broker拉取消息的间隔,默认是5分钟。如果消费者两次拉取消息的间隔超过了5分钟,就会认为消费者掉线了。 一旦发生rebalance了,有可能会导致重复消费的问题,就是消费者A拉取了100条消息,消费时间超过了5分钟,被broker认定下线,就会进行rebalance,把这个分区分配给其他消费者消费,其他消费者就会进行重复消费。 怎么解决rebalance带来的重复消费问题呢? 1.可以减少每批消息的处理时间,让每条消息的处理时间减少,或者是修改max.poll.records,减小每次拉取消息的数量。 2.可以自行在MySQL或者Redis里面存储每个分区消费的offset,然后消费者去一个新的分区拉取消息时先去读取上次消费的offset。 3.为消息分配一个唯一的消息id,通过消息id来判定是否重复消费了。 新版本新增了group.initial.rebalance.delay.ms参数。空消费组接受到成员加入请求时,不立即转化到PreparingRebalance状态来开启reblance。当时间超过group.initial.rebalance.delay.ms后,再把group状态改为PreparingRebalance(开启reblance),这样可以避免服务启动时,consumer陆续加入引起的频繁Rebalance。 但对于运行过程中,consumer超时或重启引起的reblance则无法避免,其中一个原因就是,consumer重启后,它的身份标识会变。简单说就是Kafka不确认新加入的consumer是否是之前挂掉的那个。 在Kafka2.0中引入了静态成员ID,使得consumer重新加入时,可以保持旧的标识,这样Kafka就知道之前挂掉的consumer又恢复了,从而不需要Reblance。这样做的好处有两个: https://blog.csdn.net/weixin_37968613/article/details/104607012 https://blog.csdn.net/z69183787/article/details/105138782 https://zhuanlan.zhihu.com/p/87577979 https://www.cnblogs.com/runnerjack/p/12108132.html https://blog.csdn.net/qq_37142346/article/details/91349100 https://honeypps.com/mq/kafka-basic-knowledge-of-selection/ (PS:扫描首页里面的二维码进群,分享我自己在看的技术资料给大家,希望和大家一起学习进步!) looking 正在参与竞选状态,会参与投票
leading 选举结束,主节点的状态
following 选举结束,从节点的状态
一开始所有节点都是looking状态,进行选举,选举出主节点后,
主节点的状态是leading,其他节点状态是following,主节点挂了之后,需要进行新一轮的选举,所有节点又变成looking。 所有节点都有两个属性,SID:节点ID,zoo.cfg中配置的myid,ZXID:节点当前的最大事务ID
选举的目的就是选目前所有节点中拥有最大ZXID的节点作为Leader,如果拥有的ZXID相同,就选取SID最大的节点作为Leader。 启动时,当集群没有leader时,每个机器会将票投给SID最大的机器(越晚加入的机器SID越大)
有leader时会将票投给leader。
假设有五个节点,一开始A启动时之会将票投给自己,B启动时之后将票投给B,A也投给B,C启动时,A,B,C都投个C
C得票超过半数,C成为leader,之后加入的D,E也只会投给C。 1.选epoch值大的,epoch值小的投票结果会被忽略掉。
2.epoch值相同时,把票投给ZXID大的节点。
3.ZXID相同时,把票投给SID(server id)大的节点。
得票超过半数的节点会成为leader。
通常是数据越新的节点越有可能成为主节点。 将逻辑时钟+1,初始化选票,
每个节点都会投给自己,然后选票发给其他节点 从其他节点B收到投票信息后,进行处理 2.1 如果本节点的逻辑时钟小于接受这条投票的逻辑时钟, 说明本节点之前错过了上一轮的投票,将当前存储的选票信息清空, 2.2 如果本节点的逻辑时钟大于接受的这条投票的逻辑时钟,那么忽略掉这条投票信息。 2.3 本节点的逻辑时钟等于接受的这条投票的逻辑时钟,那么进行处理,与本节点当前投票的结果进行比较
先比较ZXID(数据ID,越大代表数据越新),ZXID越大的应该当leader,ZXID相同比较SID,SID越大的当leader。 2.4如果比较的结果跟当前节点的投票结果不一致,那么需要更改选票,将更改后的选票结果发送给其他节点。 2.5 将其他节点B的投票结果记录下来 对当前收到的所有投票信息进行统计,看是否有节点获得半数以上的选票,有的话就将它设置为leader,然后终止投票,否则继续投票,继续步骤2。 所有follower会向leader发送epoch和ZXID(最大事务ID),然后leader选取最大的事务ID作为当前最新的ID 通知其他follower节点进行同步,将数据更新到最大的事务ID。 这时正式向客户端提供服务,leader接受客户端的写请求后,会将请求通过队列发送个每个节点,每个节点收到消息后将记录写到磁盘,
并且返回ACK给leader,当半数以上的从节点返回ACK后,leader才commit这条更新。 https://www.ymq.io/2018/05/23/zookeeper-election/ https://blog.csdn.net/MuErHuoXu/article/details/85864535 https://blog.csdn.net/hotchange/article/details/81192122 首先客户端连接zookeeper集群中的任何一个节点,可以是leader节点,也可以是follower节点,一旦连接,节点会给客户端分配会话ID,并向客户端发送确认,如果客户端收到确认,那么连接成功,客户端会有规律地给zookeeper发送心跳包,确保连接没有断开。 由此看来zookeeper没法保证客户端读取的都是最新的数据, 分布式最大的难点在于各个节点的状态怎么同步。 CAP理论 C是一致性,Consistency,就是各个节点保存的数据都是最新的。 A是Availability, 可用性,每次请求都可以获得响应,但是没法保证是最新的响应。 P是分区容错性(Partition tolerance),就是每个节点可能都存在于不同的子网络,也就是不同的分区,不同分区之间的通信总是有可能发生故障的,或者总是有可能存在一些节点挂了的情况。 可以认为P总是成立的,C和A是无法同时做到。所以一般对于数据一致性要求特别高的业务,例如支付,交易相关的业务,就是会优先保证一致性C和分区容错性P,就是保证数据一致性,例如让所有子节点都收到更新后才算提交成功,就像MySQL主从同步中的全同步模式一样。普通的业务是优先保证可用性A和分区容错性P,比如在MySQL主从同步时,默认就是异步的方式,我们执行一条更新SQL,只需要主节点更新成功就行就对事务进行提交,不需要等待从节点更新数据成功,主节点会异步把SQL发送给从节点。 https://mp.weixin.qq.com/s/32lWC4PA7nF13_2wRo6i3Q (PS:扫描首页里面的二维码进群,分享我自己在看的技术资料给大家,希望和大家一起学习进步!) 在发起连接之前,服务器会向证书机构申请SSL证书,流程是服务器将自己的公钥发给CA证书机构,CA证书机构会用自己的私钥对服务器的公钥加密,生成SSL证书给服务器,服务器将SSL证书存储后供之后建立安全连接使用。 1.客户端发起请求,TCP三次握手,跟服务器建立连接。
如上图所示,在第 ② 步时服务器发送了一个SSL证书给客户端,SSL 证书中包含的具体内容有: (1)证书的发布机构CA (2)证书的有效期 (3)服务器的公钥 (4)证书所有者 (5)签名 3、客户端在接受到服务端发来的SSL证书时,会对证书的真伪进行校验,以浏览器为例说明如下: (1)首先浏览器读取证书中的证书所有者、有效期等信息进行一一校验 (2)浏览器开始查找操作系统中已内置的受信任的证书发布机构CA证书,与服务器发来的证书中的颁发者CA比对,用于校验证书是否为合法机构颁发 。 (3)如果找不到,浏览器就会报错,说明服务器发来的证书是不可信任的。 (4)如果找到,那么浏览器就会从操作系统中取出 颁发者CA 的公钥,然后对服务器发来的证书里面的签名进行解密 (5)浏览器使用相同的hash算法计算出服务器发来的证书的hash值,将这个计算的hash值与证书中签名做对比 (6)对比结果一致,则证明服务器发来的证书合法,没有被冒充 (7)此时浏览器就可以读取证书中的公钥,用于后续加密了。 假设没有CA,那么如果服务器返回的包含公钥的包被hack截取,然后hack也生成一对公私钥,他将自己的公钥发给客户端。hack得到客户端数据后,解密,然后再通过服务器的公钥加密发给服务器,这样数据就被hack获取。
有了CA后,客户端根据内置的CA根证书,很容易识别出hack的公钥不合法,或者说hack的证书不合法。 HTTP 缓存主要分为强缓存和对比缓存两种,从优先级上看,强缓存大于对比缓存。 强缓缓存就是浏览器缓存数据库里有缓存数据就不再去向服务器发请求了 可以造成强制缓存的字段有Expires和Cache-Control两个: Expires:该字段标识缓存到期时间,是一个绝对时间,也就是服务器时间+缓存有效时间。
缺点:如果客户端修改了本地时间,会造成缓存失效。如果本地时间与服务器时间不一致,也会导致缓存失效。 Cache-Control:该字段表示缓存最大有效时间,该时间是一个相对时间。
使用相对时间的话,即使本地时间与服务器时间不一致,也不会导致缓存失效。
下面列举一下Cache-Control的字段可以带的值: 对比缓存的实现原理时,先给给服务器发请求,并且带上缓存的资源文件的缓存标识,让服务端进行对比,如果资源文件没有更改,就只返回header部分,body为空,状态码是304,浏览器使用缓存的资源文件。如果数据有更改,就返回更新后的资源文件。 可以实现对比缓存的机制有Last-Modified/If-Modified-Since和Etag/If-None-Match两种: 就是 请求的response header中会返回Last-Modified字段,代表资源文件最近的修改时间,发请求时 request header中会带上If-Modified-Since字段,代表上次获取的资源文件的最近修改时间,服务器判断资源文件是否有更新,来决定返回最新的资源文件(返回200),还是让浏览器使用缓存(返回304)。 缺点: 就是 response header中会返回Etag,代表资源文件的版本号,发请求时 request header中会加上If-None-Match字段,值是上次请求的资源的文件的版本号,代表上次请求的资源文件的版本号,服务器判断资源文件是否有更新,来决定返回最新的资源文件(返回200),还是让浏览器使用缓存(返回304)。 优先级方面排序是 强缓存(Cache-Control)> 强缓存(Expires)> 对比缓存(Etag/If-None-Match)> 对比缓存(Last-Modified/If-Modified-Since) TCP是一个面向连接的可靠的传输协议。建立连接前需要进行三次握手。 流程如下: 1.客户端首先会生成一个随机数J作为数据包的序号,给服务端发送一个SYN包,包的序号seq设置为J,发送成功后,自己进入SYN_SENT 状态,代表发送SYN包成功,等待服务端的确认。 2.服务端收到SYN包之后,会进入到SYN_RECV状态,同时为了检测服务端到客户端是否通畅,会给客户端发送一个SYN包,将ACK设置为1,并且会带上ack=J+1,生成随机数作为包的序号,seq=K,用于确认之前收到了客户端发送的SYN包。 3.客户端收到服务端发送的SYN包后,会检测ACK标志位是否为1,并且ack是否等于J+1,如果是的话,就说明之前服务器收到了客户端发送的SYN包,并且服务端发送给客户端的SYN包也是可以收到的,所以需要给服务端发送ACK包,ACK=1,ack=K+1。 4.服务端收到ACK回应后,检查ack是否为K+1,ACK是否为1,如果正确则连接建立成功,客户端和服务器端进入ESTABLISHED状态,完成三次握手,随后客户端与服务器端之间可以开始传输数据了。 TCP是全双工的连接,断开每一方向的连接都需要发送断开请求,断开确认。所以总共需要发送4个包才能确定连接的断开。 1.首先客户端给服务端发送一个FIN包,seq=J,客户端进入FIN_WAIT_1状态,代表客户端已经没有数据发送给服务端了。 2.服务端接收到FIN包之后,会给客户端发送一个ACK,ack=J+1,用于确认客户端-服务端这边的连接进行断开。同时会进入到CLOSE_WAIT状态,表示在等待关闭,因为服务端往客户端可能还在继续传输数据,暂时还不能断开。客户收到服务端返回的ACK回应后,会进入到FIN_WAIT_2状态,代表客户端-服务端的连接已经断开成功,等待服务端发送FIN包断开服务端-客户端的连接。 3.服务端发现没有数据发给客户端后,会发一个FIN包给客户端,并且进入LAST_ACK,代表等待客户端的ACK,一旦收到ACK,代表连接正式断开,服务端可以进入CLOSE状态。 4.客户端收到服务端发送的FIN包后,说明连接已经断开了,但是需要服务端知道,客户端会给服务端发送一个ACK包通知服务端,并且会进入TIME_WATING状态,代表超过超时时间后自动进入CLOSE状态,如果ACK包中途丢了,服务端会再发送FIN包,客户端会进行ACK包重发,这也是TIME_WAITING状态的意义。 TCP主要提供了检验和、序列号/确认应答、超时重传、最大消息长度、滑动窗口控制等方法实现了可靠性传输。 校验和 主要是将数据切分成若干个16位的二进制串,将每个二进制串看成一个二进制数,对这些数进行相加等运算得到一个校验和,然后接收方收到数据会使用同样的算法来对数据计算校验和,如果结果和发送端发过来的校验和一样,那么就校验成功。主要是为了防止接收方收到的是已经损坏的数据。 序列号/确认应答,超时重传 对发送的每个数据包都有一个序号,服务端收到数据包会返回一个ACK进行确认,如果在超过超时时间后,客户端还是没有收到服务端返回的ACK确认,就会对数据包进行超时重传。并且超时时间是动态变化的,初始值会大于正常的报文发送到接收到ACK回应的时间,重传后还没有得到回应会调大重传时间,然后进行重传。
例如:在Linux中,超时以500ms为单位进行控制,每次判定超时重发的超时时间都是500ms的整数倍。其规律为:如果重发一次仍得不到应答,就等待2500ms后再进行重传,如果仍然得不到应答就等待4500ms后重传,依次类推,以指数形式递增,重传次数累计到一定次数后,TCP认为网络或对端主机出现异常,就会强行关闭连接。 最大消息长度 在建立TCP连接的时候,双方约定一个最大的长度(MSS)作为发送的单位,重传的时候也是以这个单位来进行重传。理想的情况下是该长度的数据刚好不被网络层分块。 滑动窗口控制 就是发送方在发送一个包时,不需要等到收到接收方对上一个包的确认应答后,才能发。只需要当前发送的包在滑动窗口内就行了。发送方每接收到一个确认应答,就会向后移动一位。 对于接收方而言,只会给客户端返回当前需要的包的序号,也就是对目前已收到的包的确认应答。(在拥塞控制里面,一般判断是否是网络拥塞导致丢包,有两种机制,超时重传,超过重传时间,还没有收到回应,另一个是收到三个重复确认ACK,就是比如中间某个数据包N丢了,那么后面发送的3个数据包如果被服务端接收到了,返回的确认回答ACK=N,代表没有收到数据包N,需要发送方重传,重复确认ACK超过3个,就认为发送了网络拥塞) 因为滑动窗口设置得太大或太小都不易于数据传输,所以是根据接收端的反馈,发送端可以对滑动窗口大小进行动态调整的。发送端在发送的数据包的序号必须小于最大的滑动窗口值,所以当发送的数据包过多,导致接收端的缓冲区写满时,接收端会通知给客户端将滑动窗口设置为更小的值,减少发送的量,达到一个流量控制的效果。 拥塞控制主要由慢启动,拥塞避免,拥塞发生时算法,快速恢复四个算法组成。 慢启动 TCP连接刚建立,一点一点地提速,试探一下网络的承受能力,以免直接扰乱了网络通道的秩序,是呈指数增长的。一开始拥塞窗口cwnd大小是1,就是每收到一个ACK确认回答,就会把拥塞窗口cwnd的大小+1,这样在每个往返时延下,窗口cwnd大小都会变为原来的二倍,所以就会呈指数增长。 拥塞避免 因为慢启动的拥塞窗口cwnd呈指数增长的,一旦达到网络的最大承受能力时,有可能已经发出大量数据包了,造成网络拥塞了,所以为了避免网络拥塞,当拥塞窗口cwnd达到慢启动的阀值ssthresh的大小时,就会停止指数增长,进入线性增长状态,在每个往返时延下,窗口cwnd大小都+1。 拥塞发生时算法 一般认为,网络拥塞时就会发生网络丢包,所以判定拥塞发生就是以丢包为主。有两种判定方法,超时重传,在发送一个数据以后就开启一个计时器,在一定时间(RTO[Retransmission Timeout])内如果没有得到发送数据报的ACK报文,那么就重新发送数据,直到发送成功为止。另一个是收到三个重复确认ACK,就是比如中间某个数据包N丢了,那么后面发送的3个数据包如果被服务端接收到了,返回的确认回答ACK=N,代表没有收到数据包N,需要发送方重传,重复确认ACK超过3个,就认为发送了网络拥塞)。 一旦认定网络拥塞,就会将慢启动阀值ssthresh设置为发生拥塞时的窗口cwnd大小的一半。 PS:快重传是什么? 假设发送方发送了1,2,3,4个数据包,假设接收方收到1,2数据包,并且发送了ACK确认,没有收到3,但是收到了4。根据可靠性传输原理,由于没有收到3,即便接受到了4,它也是一个失序报文,接收方不能对它进行确认。只能等发送方在等待3的ACK的回应时间超过2MSL后,进行重发。但是在这里为了让发送方快速知道哪些数据报文丢失了,接收方在收到3时就会给他返回2的ACK,一旦收到3个重复的ACK回应,也就是2的ACK,发送方就会意识到数据包3丢了,就会进行快速重传,重发报文3。 快速恢复算法 发生网络拥塞后,慢启动阀值ssthresh设置为发生拥塞时的窗口cwnd大小的一半后, 如果是早期的算法TCP Tahoe,此时会将cwnd重置为1,重新开始慢启动的过程。 如果现在的TCP Reno算发,会将cwnd窗口设置为新的ssthresh值的大小,后续开始进入拥塞避免算法的流程,对cwnd窗口进入线性增长的状态。 close_wait 主要在TCP四次挥手时,服务端给客户端返回ACK应答后,由于自身还需要给客户端传输数据,所以会进入到close_wait状态,直到不需要给客户端发数据了,才会去给客户端发送FIN包,同时进入LAST_ACK状态。(被动关闭的一方没有及时发出 FIN 包就会导致自己一直处于close_wait状态。) tcp_keepalive_time默认是2个小时,也就是TCP空闲连接可以存活2个小时,在close_wait状态下,可以把这个时间调小,减少处于close_wait连接的数量 首先time_wait状态存在的意义是可以有效地终止TCP连接,因为主动关闭方发生ACK给被动关闭方后,需要等待2MSL的时间(MSL指的是报文最大有效存活时间,在linux下是60s),在这个时间内,如果没有收到被动关闭方重发的FIN包,就说明连接关闭完成了。
在高并发短连接的业务场景下,由于短连接的传输数据+业务处理的时间很短,所以服务器处理完请求就会立即主动关闭连接,并且进入TIME_WAITING状态,而端口处于有个0~65535的范围中,除去系统占用的,总的数量有限。所以持续的到达一定量的高并发短连接,会使服务器因端口资源不足而拒绝为一部分请求服务。
可以通过修改TCP的默认配置来改善这个问题。 https://www.cnblogs.com/dadonggg/p/8778318.html
https://segmentfault.com/a/1190000019292140 HTTP/2传输数据量的大幅减少,主要有两个原因:以二进制方式传输和Header 压缩。我们先来介绍二进制传输,HTTP/2 采用二进制格式传输数据,而非HTTP/1.x 里纯文本形式的报文 ,二进制协议解析起来更高效。HTTP/2 将请求和响应数据分割为更小的帧,并且它们采用二进制编码。
HTTP/2 中,同域名下所有通信都在单个连接上完成,该连接可以承载任意数量的双向数据流。每个数据流都以消息的形式发送,而消息又由一个或多个帧组成。多个帧之间可以乱序发送,根据帧首部的流标识可以重新组装。 HTTP/2并没有使用传统的压缩算法,而是开发了专门的"HPACK”算法,在客户端和服务器两端建立“字典”,用索引号表示重复的字符串,还采用哈夫曼编码来压缩整数和字符串,可以达到50%~90%的高压缩率。 具体来说: 在客户端和服务器端使用“首部表”来跟踪和存储之前发送的键-值对,对于相同的数据,不再通过每次请求和响应发送; 首部表在HTTP/2的连接存续期内始终存在,由客户端和服务器共同渐进地更新; 每个新的首部键-值对要么被追加到当前表的末尾,要么替换表中之前的值 例如下图中的两个请求, 请求一发送了所有的头部字段,第二个请求则只需要发送差异数据,这样可以减少冗余数据,降低开销。 在 HTTP/2 中引入了多路复用的技术。多路复用很好的解决了浏览器限制同一个域名下的请求数量的问题,同时也接更容易实现全速传输,毕竟新开一个 TCP 连接都需要慢慢提升传输速度。 https://my.oschina.net/u/4331678/blog/3628959 HTTP2还在一定程度上改变了传统的“请求-应答”工作模式,服务器不再是完全被动地响应请求,也可以新建“流”主动向客户端发送消息。比如,在浏览器刚请求HTML的时候就提前把可能会用到的JS、CSS文件发给客户端,减少等待的延迟,这被称为"服务器推送"( Server Push,也叫 Cache push) 出于兼容的考虑,HTTP/2延续了HTTP/1的“明文”特点,可以像以前一样使用明文传输数据,不强制使用加密通信,不过格式还是二进制,只是不需要解密。 但由于HTTPS已经是大势所趋,而且主流的浏览器Chrome、Firefox等都公开宣布只支持加密的HTTP/2,所以“事实上”的HTTP/2是加密的。也就是说,互联网上通常所能见到的HTTP/2都是使用"https”协议名,跑在TLS上面。HTTP/2协议定义了两个字符串标识符:“h2"表示加密的HTTP/2,“h2c”表示明文的HTTP/2。 请求报文结构如下: HTTP请求由请求行+请求header+空行+请求内容组成,第一行就是请求行,主要包含请求方法,URL,HTTP协议版本。第二行开始就是请求Header,请求Header后面会有一个空行,用于区分Header和请求内容。 由请求方法字段、URL字段、协议版本字段三部分构成,它们之间由空格隔开。常用的请求方法有:GET、POST、HEAD、PUT、DELETE、OPTIONS、TRACE、CONNECT。 请求头由key/value对组成,每行为一对,key和value之间通过冒号(:)分割。请求头的作用主要用于通知服务端有关于客户端的请求信息。 典型的请求头有: User-Agent:生成请求的浏览器类型 Accept:客户端可识别的响应内容类型列表;星号 Accept-Language: 客户端可接受的自然语言 Accept-Encoding: 客户端可接受的编码压缩格式 Accept-Charset: 可接受的字符集 Host: 请求的主机名,允许多个域名绑定同一IP地址 connection:连接方式(close或keeplive) Cookie: 存储在客户端的扩展字段 最后一个请求头之后就是空行,用于告诉服务端以下内容不再是请求头的内容了。 请求内容主要用于POST请求,与POST请求方法配套的请求头一般有Content-Type(标识请求内容的类型)和Content-Length(标识请求内容的长度) HTTP响应报文由状态行、响应头、空行和响应内容4个部分构成。第一行是状态行,由HTTP协议版本,状态码,状态描述组成,第二行开始是响应头,响应头后面是一个空行,用于区分响应头和响应内容。 由HTTP协议版本、状态码、状态码描述三部分构成,它们之间由空格隔开。 状态码由3位数字组成,第一位标识响应的类型,常用的5大类状态码如下: 1xx:表示服务器已接收了客户端的请求,客户端可以继续发送请求 2xx:表示服务器已成功接收到请求并进行处理 3xx:表示服务器要求客户端重定向 4xx:表示客户端的请求有非法内容 5xx:标识服务器未能正常处理客户端的请求而出现意外错误 常见状态码说明: 200 OK: 表示客户端请求成功 304 Not Modified:未修改。所请求的资源未修改,服务器返回此状态码时,不会返回任何资源。客户端通常会缓存访问过的资源,通过提供一个头信息指出客户端希望只返回在指定日期之后修改的资源。 400 Bad Request: 表示客户端请求有语法错误,不能被服务器端解析 401 Unauthorized: 表示请求未经授权,该状态码必须与WWW-Authenticate报文头一起使用 404 Not Found:请求的资源不存在,例如输入了错误的url 500 Internal Server Error: 表示服务器发生了不可预期的错误,导致无法完成客户端的请求 503 Service Unavailable:表示服务器当前不能处理客户端的请求,在一段时间后服务器可能恢复正常 一般情况下,响应头会包含以下,甚至更多的信息。 Location:服务器返回给客户端,用于重定向到新的位置 Server: 包含服务器用来处理请求的软件信息及版本信息 Vary:标识不可缓存的请求头列表 Connection: 连接方式。 对于请求端来讲:close是告诉服务端,断开连接,不用等待后续的求请了。keeplive则是告诉服务端,在完成本次请求的响应后,保持连接,等待本次连接后的后续请求。 对于响应端来讲:close表示连接已经关闭。keeplive则表示连接保持中,可以继续处理后续请求。Keep-Alive表示如果请求端保持连接,则该请求头部信息表明期望服务端保持连接多长时间(秒),例如300秒,应该这样写Keep-Alive: 300 最后一个响应头之后就是空行,用于告诉请求端以下内容不再是响应头的内容了。 服务端返回给请求端的文本信息。 下面是一个实际的例子: 502是指网关(一般是Nginx)从后端服务器接受到了无效的响应结果。通常是我们的后端服务器挂了之类的。 503是请求过载,就是请求超过了Nginx限流设置的阀值,就会返回503服务不可用。 504是指网关(一般是Nginx)从后端服务器接受的响应超时了。 (PS:扫描首页里面的二维码进群,分享我自己在看的技术资料给大家,希望和大家一起学习进步!) Spring Aop是一种可以减少大量重复代码的一种编程技术,可以设置一个切面,比如说是某个包下面的所有方法,这些方法在执行的时候就会调用我们写的拦截方法,我们可以做一些类似于日志打印等一些操作。 实现AOP有三种方式:静态代理,使用JDK的Proxy类实现动态代理,使用CGLIB实现动态代理。 就是在代码里面创建一个代理类,实现目标类的接口,目标对象是代理类的成员变量,外界需要执行方法时,调用代理类的方法,代理类的方法内部先执行额外的操作,日志记录等,然后再调用目标类的方法。 通过调用Proxy.newProxyInstance()方法可以为目标类创建一个代理类,然后调用代理类的方法时会调用InvocationHandler的invoke()方法,然后我们可以在invoke()方法里面做一些日志记录之类的额外操作,然后再调用真正的实现方法,也就是目标类的方法。 目标类必须有对应的接口类,我们拦截的方法必须是接口中定义的方法。 实现原理:就是在调用Proxy.newProxyInstance()时会根据类加载器和目标类Class对象动态创建一个代理类出来,动态代理类的所有方法的实现都是向下面这样,方法内部都是调用invocationHandler的invoke()方法 CGLIB主要是通过创建一个代理类,继承原来的类,并且重写父类的方法,然后将代理类实例返回,后续调用代理类的方法时,先执行一些额外的AOP相关的记录操作,然后再去执行父类的方法。(由于在Java中子类只能继承父类的非private的属性和方法,所以由CGLIB创建的代理类,不会包含父类中的final或者private修饰的方法,aop也无法捕获private相关的方法) 创建一个类,继承MethodInterceptor类,重写intercept方法,接受方法调用。创建一个Enhancer实例,设置代理类的父类为目标类,设置回调。 生成的代理类中,对于父类中每一个能够继承重写的方法,动态代理类都会生成两个相应的方法。一个是方法内是直接调用父类(也就是目标类的方法),一个是生成的对应的动态代理的方法,里面会先调用代理类设置的intercept回调方法,然后再调用父类的方法。在调用时,会直接先调用重写的方法。 目标类必须有对应的接口类,然后JDK动态代理动态创建了一个类,实现了接口中的方法,不能对没有接口类的普通的类进行代理(因为所有生成的代理类的父类为Proxy,Java类继承机制不允许多重继承);CGLIB能够代理普通类;
Java动态代理只能对有接口类的类进行代理,并且使用Java原生的反射API进行操作,在生成类上比较高效,但是执行会效率低一些。CGLIB使用ASM框架直接对字节码进行操作,在类的执行过程中比较高效。 参考链接: https://blog.csdn.net/gyshun/article/details/81000997 IOC就是invention of control,就是控制反转,将对象获取外界依赖资源的方式反转了。假设一个对象A依赖于对象B,在没有IOC以前,就是在对象A需要使用对象B时,去用代码显式地创建一个对象B。有了IOC以后,可以由Spring IOC容器来负责对象B的创建和销毁,创建后放在容器中,在对象A需要的时候再来取。
DI(Dependency Injection,依赖注入)其实就是IOC的另外一种说法,就是IOC是通过依赖注入技术实现的。
《跟我学spring3系列》https://www.iteye.com/blog/jinnianshilongnian-1413851
https://www.cnblogs.com/xdp-gacl/p/4249939.html Spring IOC只能解决属性注入之间的循环依赖问题,如果是构造器之间的循环依赖,只会抛出BeanCurrentlyInCreationException异常。 Spring使用了3个Map来保存Bean,俗称为三级依赖: singletonObjects 一级缓存,用于保存实例化、注入、初始化完成的bean实例,可以使用的。 earlySingletonObjects 二级缓存,bean刚刚构造完成,但是还没有进行属性填充。 singletonFactories 三级缓存,用于保存正在创建中的bean,以便于后面扩展有机会创建代理对象,此时的bean是没有完成属性填充的。 假设A类和B类相互依赖,A中有一个B类的属性,B中有一个A类的属性。那么在初始化A的Bean时,首先会依次去一级依赖,去二级依赖,三级依赖中去找,都没有就调用创建方法创建实例A,将A添加到三级依赖中,然后对A的属性进行依赖注入,填充属性时,发现B的Bean在各级依赖中都没有,就创建B的bean添加到三级依赖,然后对B的属性进行填充,填充B的属性A时,会从三级依赖中取出A,填充完放到二级依赖,然后对B进行初始化,初始化完成添加到一级依赖。B初始化完成后,将B从一级依赖中,填充到实例A,A可以进入到二级依赖,完全初始化完成后,A进入到一级依赖,供用户代码使用。 https://juejin.cn/post/6911692836714840077 https://segmentfault.com/a/1190000015221968 https://blog.csdn.net/qq_35165000/article/details/108185093?spm=1001.2014.3001.5501 Bean的生命周期主要分为以下四个阶段: 1.Bean的实例化阶段-主要是在createBeanInstance()方法中,调用类的构造器方法来创建一个Bean实例。用户可以自定义一个类,继承InstantiationAwareBeanPostProcessorAdapter,重写它的两个方法,对Bean的实例化前后做一些额外的操作,例如打印日志。 2.属性赋值阶段-主要是在populateBean()方法中,对Bean的各项属性进行赋值。 3.Bean的初始化阶段-主要调用用户自定义的初始化方法init-Method() 用户可以自定义一个类,继承BeanPostProcessor,重写它的两个方法,对Bean的初始化前后做一些额外的操作,例如打印日志。 4.Bean销毁阶段,用户可以自定义destroyMethod()方法,在Bean被销毁时被调用。 BeanFactory是一个接口,定义了IOC容器的最基本的规范,并提供了IOC容器应遵守的的最基本的方法。在Spring代码中,BeanFactory只是个接口,并不是IOC容器的具体实现,但是Spring容器给出了很多种实现,如 DefaultListableBeanFactory、XmlBeanFactory、ApplicationContext等,都是附加了某种功能的实现。 FactoryBean是一个接口,有一个创建bean对象的方法getObject(),当一些bean对象不能由ioc容器简单得调用类的构造器方法来创建实例对象时使用,可以将Bean类实现FactoryBean接口,实现getObject()方法,供ioc容器调用来创建bean对象。 https://www.cnblogs.com/aspirant/p/9082858.html 1.首先会调用SpringApplication的静态方法run(),在这个方法里面会调用构造器方法创建出一个SpringApplication实例,在构造器中会确定当前web应用类型,是reactive web类型,还是servlet web类型,还是none类型。以及设置监听器等等,完成一些初始化操作。(监听器就是来监听SpringApplication启动过程的,在开始启动,创建上下文,启动失败等生命周期事件时都会调用监听器相关的方法) 2.然后去执行实例的run()方法,首先会创建一个StopWatch计时器器,来统计run()方法的启动耗时,在日志里面会显示启动时间,那个时间就是在这里统计的。然后处理环境参数,就是 3.会创建出一个ApplicationContext,一般servlet的应用的context类型是AnnotationConfigServletWebServerApplicationContext。(可以认为beanFactory就是ioc容器,但是我们一般不直接使用beanFactory获取bean,而是通过applicationContext来获取,ioc容器beanFactory是应用上下文applicationContext的一个属性,applicationContext也实现了BeanFactory接口,可以认为applicationContext是一个高级容器,applicationContext支持国际化,默认是启动时加载所有bean,而不是用到时才进行懒加载,以及支持事件机制。) 4.然后会调用prepareContext()方法来为应用上下文做一些准备工作,会将运行时的参数封装成bean,注册到beanFactory中去,以及使用load方法加载启动类。 5.在这里会启动容器,也就是会为beanFactory做很多配置,注册BeanPostProcessors,设置类加载器等等。在这一步也会解析启动类中@SpringBootApplication这个组合注解。 6.这个方法里面会把容器里面所有ApplicationRunner自定义子类和CommandLineRunner自定义子类的Bean全部取出来,执行它们的run()方法。(就是有时候如果需要在应用启动后执行一些我们自定义的初始化操作,可以通过自定义一个类,继承ApplicationRunner类来实现。) 之后会调用listeners.started()方法,通知所有Listener,application已经启动完成了,以及调用listeners.running()方法通知所有Listener,application已经运行了。workQueue.take方法,这个take方法每种等待队列的实现各不相同,以LinkedBlockingQueue为例,null,Worker对象的run()方法循环体的判断为null,任务结束,然后线程被系统回收)2.maximumPoolSize 最大线程数
3.workQueue 等待队列
ArrayBlockingQueue 有界队列,一种使用数组实现的先进先出的有界阻塞队列。支持公平锁和非公平锁,底层数据结构是数组,需要指定队列的大小。 LinkedBlockingQueue 无界队列,一种使用链表实现的先进先出的有界阻塞队列。默认的容量是 Interge.MAX_VALUE,相比于ArrayBlockingQueue具有更高的吞吐量,但是却丢失了快速随机存取的特性。默认大小是Integer.MAX_VALUE,也可以指定大小。newFixedThreadPool()和newSingleThreadExecutor()的等待队列都是这个阻塞队列。LinkedBlockingDeque 一种使用链表实现的具有双向存取功能的有界阻塞队列。在高并发下,相比于 LinkedBlockingQueue可以将锁竞争降低最多一半PriorityBlockingQueue 一种提供了优先级排序的无界阻塞队列。如果没有提供具体的排列方法,那么将会使用自然排序进行排序,会抛出 OOM异常。SynchronousQueue SynchronousQueue一种不存储任务的同步队列,内部没有使用AQS。如果是公平锁模式,每次调用put方法往队列中添加一个线程后,线程先进行自旋,然后超时后就阻塞等待直到有提取线程把调用take方法把操作取出,这样之前调用put方法的线程才能继续执行。如果是非公平锁模式,每次添加任务就是就是把任务添加到栈中,这样就是先进后出,所以非公平。 LinkedTransferQueue 一种使用链表实现的无界阻塞队列。 DelayQueue 一种无界的延时队列,可以设置每个元素需要等待多久才能从队列中取出。 延迟队列,该队列中的元素只有当其指定的延迟时间到了,才能够从队列中获取到该元素 。底层数据数据结构是数组实现的堆结构。 6.ThreadFactory创建线程的工厂
public interface ThreadFactory {
    Thread newThread(Runnable r);
}
线程池执行任务的过程?
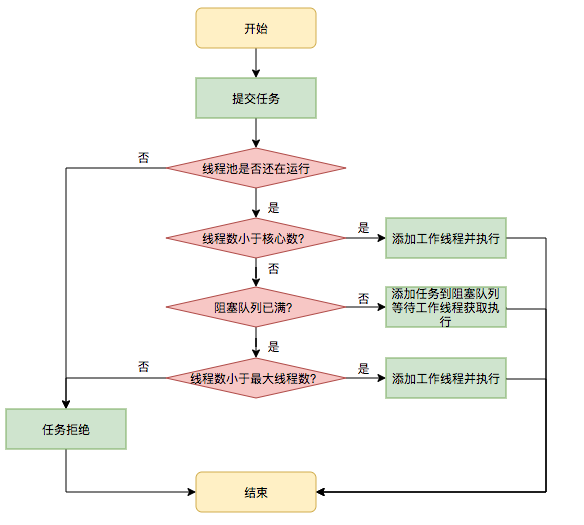
Executors提供的四种线程池的使用场景。
newFixedThreadPool 定长线程池
public static ExecutorService newFixedThreadPool(int nThreads) {
    return new ThreadPoolExecutor(nThreads, nThreads,
                                  0L, TimeUnit.MILLISECONDS,
                                  new LinkedBlockingQueue<Runnable>());
}
public LinkedBlockingQueue() {
    this(Integer.MAX_VALUE);
}newSingleThreadExecutor 单线程池
public static ExecutorService newSingleThreadExecutor() {
        return new FinalizableDelegatedExecutorService
            (new ThreadPoolExecutor(1, 1,
                                    0L, TimeUnit.MILLISECONDS,
                                    new LinkedBlockingQueue<Runnable>()));
}newCachedThreadPool可缓存线程池
public static ExecutorService newCachedThreadPool() {
        return new ThreadPoolExecutor(0, Integer.MAX_VALUE,
                                      60L, TimeUnit.SECONDS,
                                      new SynchronousQueue<Runnable>());
}CacheThreadPool的运行流程如下:newScheduledThreadPool定时执行线程池
public ScheduledThreadPoolExecutor(int corePoolSize,
                                   ThreadFactory threadFactory) {
    super(corePoolSize, Integer.MAX_VALUE, 0, NANOSECONDS,
          new DelayedWorkQueue(), threadFactory);
}
为什么不建议大家使用Executors的四种线程池呢?
线程池有哪些状态?
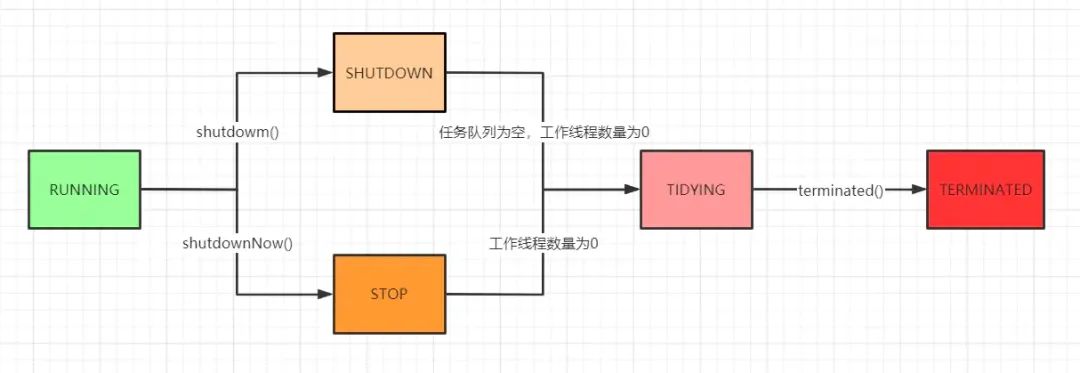
怎么根据业务场景确定线程池的参数corePoolSize和maximumPoolSize?
方法一 计算密集型任务
最佳线程数=CPU的数量+1 方法二 IO密集型任务
最佳线程数 = CPU数量/(每个任务中需要CPU执行的时间的比例)
= CPU数量/(CPU运行时间/任务执行总时间)=CPU数量/(CPU运行时间/(CPU运行时间+IO操作时间))
所以最终公式为
最佳线程数/CPU数量 = CPU运行时间/(CPU运行时间+IO操作时间)
不足
方法三 动态化线程池
追求响应时间的任务
追求高吞吐量的任务
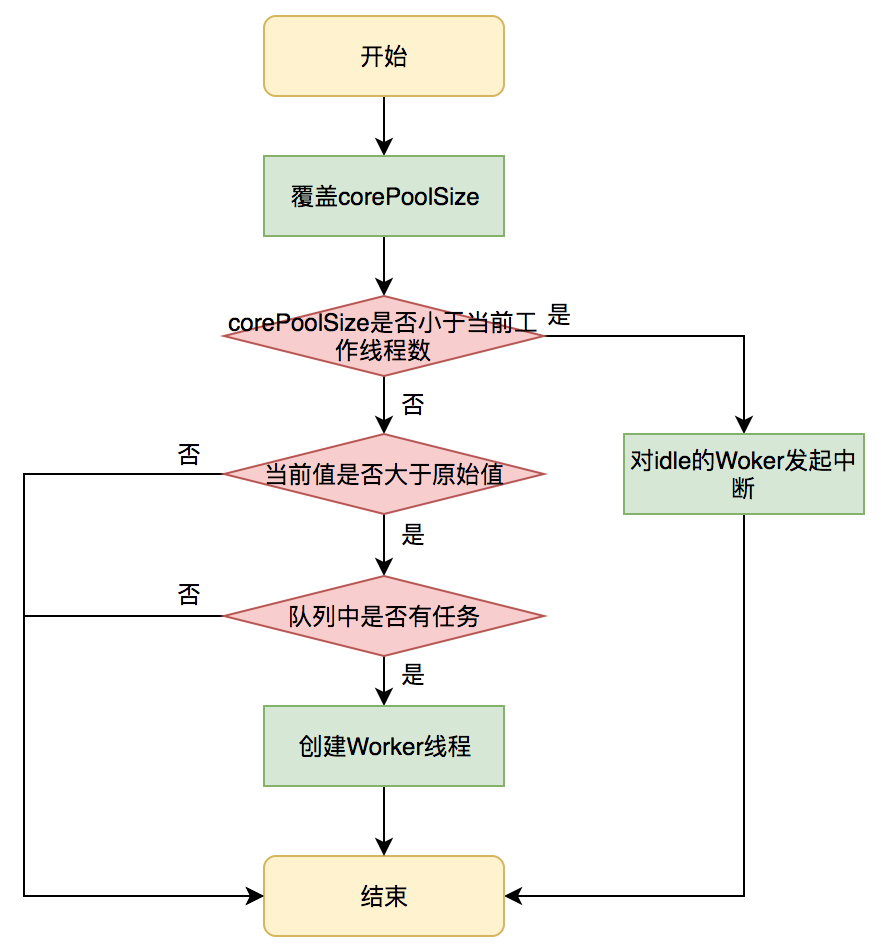
ThreadLocal是什么?怎么避免内存泄露?
使用场景:
public class A {
    // 每个线程本地副本初始化
    private static ThreadLocal <UserData> threadLocal = new ThreadLocal <>(). withInitial (() -> new UserData ());
    public static void setUser (UserLogin user){
        if (user == null )
            return ;
        UserData userData = threadLocal.get();
        userData. setUserLogin (user);
    }
    public static UserLogin getUser (){
        return threadLocal.get(). getUserLogin ();
    }
}
实现原理
//ThreadLocal实例的赋值方法
public void set(T value) {
  	//获取当前线程
    Thread t = Thread.currentThread();
  	//获取线程对应的Map
    ThreadLocalMap map = getMap(t);
  	//将值存入线程特有的Map中
    if (map != null)
      //key为this就是当前ThreadLocal引用变量的地址
      //value就是我们要存储的值
      map.set(this, value);
    else
      createMap(t, value);
}
ThreadLocalMap getMap(Thread t) {
  	//线程的threadLocals实例变量就是Map
    return t.threadLocals;
}
ThreadLocal中的Entry的key使用了弱引用,为什么使用弱引用?
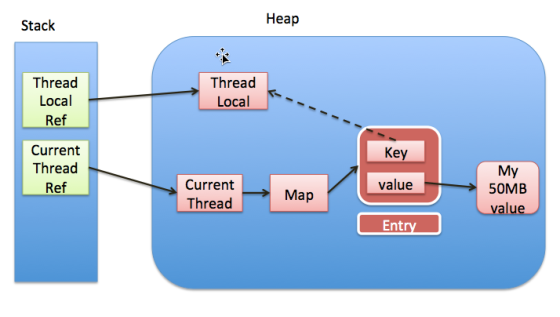
ThreadLocal变量所在的类的实例(代码中A的实例)->ThreadLocal
执行代码的线程->线程独有的ThreadLocalMap->引用的key就是ThreadLocalRandom类取随机数的原理是什么?
public Random() {
        this(seedUniquifier() ^ System.nanoTime());
    }

    private static long seedUniquifier() {
        // L'Ecuyer, "Tables of Linear Congruential Generators of
        // Different Sizes and Good Lattice Structure", 1999
        for (;;) {
            long current = seedUniquifier.get();
            long next = current * 181783497276652981L;
            if (seedUniquifier.compareAndSet(current, next))
                return next;
        }
} protected int next(int bits) {
long oldseed, nextseed;
AtomicLong seed = this.seed;
do {
oldseed = seed.get();
nextseed = (oldseed * multiplier + addend) & mask;
} while (!seed.compareAndSet(oldseed, nextseed));
return (int)(nextseed >>> (48 - bits));
}public static ThreadLocalRandom current() {
//判断这个线程是否生成种子
if (UNSAFE.getInt(Thread.currentThread(), PROBE) == 0)
localInit();
return instance;
}
//为这个线程生成一个种子seed,并且将种子seed,和线程已生成种子的标志 存储到Unsafe类中
static final void localInit() {
int p = probeGenerator.addAndGet(PROBE_INCREMENT);
int probe = (p == 0) ? 1 : p; // skip 0
long seed = mix64(seeder.getAndAdd(SEEDER_INCREMENT));
Thread t = Thread.currentThread();
UNSAFE.putLong(t, SEED, seed);
UNSAFE.putInt(t, PROBE, probe);
}
//获取随机数,根据当前种子计算随机数
public int nextInt(int origin, int bound) {
if (origin >= bound)
throw new IllegalArgumentException(BadRange);
return internalNextInt(origin, bound);
}
final int internalNextInt(int origin, int bound) {
int r = mix32(nextSeed());
if (origin < bound) {
int n = bound - origin, m = n - 1;
if ((n & m) == 0)
r = (r & m) + origin;
else if (n > 0) {
for (int u = r >>> 1;
u + m - (r = u % n) < 0;
u = mix32(nextSeed()) >>> 1)
;
r += origin;
}
else {
while (r < origin || r >= bound)
r = mix32(nextSeed());
}
}
return r;
}僵尸进程,孤儿进程,守护进程是什么?
BlockingQueue的原理是怎么样的?
进程间通信的方式
Lock
锁专题
1.sychronize的实现原理是怎么样的?
2.AbstractQueuedSynchronizer(缩写为AQS)是什么?是什么?)
3.悲观锁和乐观锁是什么?
sychronize的实现原理是怎么样的?
public class SyncTest {
    public void syncBlock(){
        synchronized (this){
            System.out.println("hello block");
        }
    }
    public synchronized void syncMethod(){
        System.out.println("hello method");
    }
}synchronized关键字和synchronized方法的字节码略有不同,我们可以用javap -v 命令查看class文件对应的JVM字节码信息,部分信息如下:{
public void syncBlock();
descriptor: ()V
flags: ACC_PUBLIC
Code:
stack=2, locals=3, args_size=1
0: aload_0
1: dup
2: astore_1
3: monitorenter // monitorenter指令进入同步块
4: getstatic #2 // Field java/lang/System.out:Ljava/io/PrintStream;
7: ldc #3 // String hello block
9: invokevirtual #4 // Method java/io/PrintStream.println:(Ljava/lang/String;)V
12: aload_1
13: monitorexit // monitorexit指令退出同步块
14: goto 22
17: astore_2
18: aload_1
19: monitorexit // monitorexit指令退出同步块
20: aload_2
21: athrow
22: return
Exception table:
from to target type
4 14 17 any
17 20 17 any
public synchronized void syncMethod();
descriptor: ()V
flags: ACC_PUBLIC, ACC_SYNCHRONIZED //添加了ACC_SYNCHRONIZED标记
Code:
stack=2, locals=1, args_size=1
0: getstatic #2 // Field java/lang/System.out:Ljava/io/PrintStream;
3: ldc #5 // String hello method
5: invokevirtual #4 // Method java/io/PrintStream.println:(Ljava/lang/String;)V
8: return
}synchronized关键字而言,javac在编译时,会生成对应的monitorenter和monitorexit指令分别对应synchronized同步块的进入和退出,有两个monitorexit指令的原因是为了保证抛异常的情况下也能释放锁,所以javac为同步代码块添加了一个隐式的try-finally,在finally中会调用monitorexit命令释放锁。synchronized方法而言,javac为其生成了一个ACC_SYNCHRONIZED关键字,在JVM进行方法调用时,发现调用的方法被ACC_SYNCHRONIZED修饰,则会先尝试获得锁。synchronized锁执行流程图
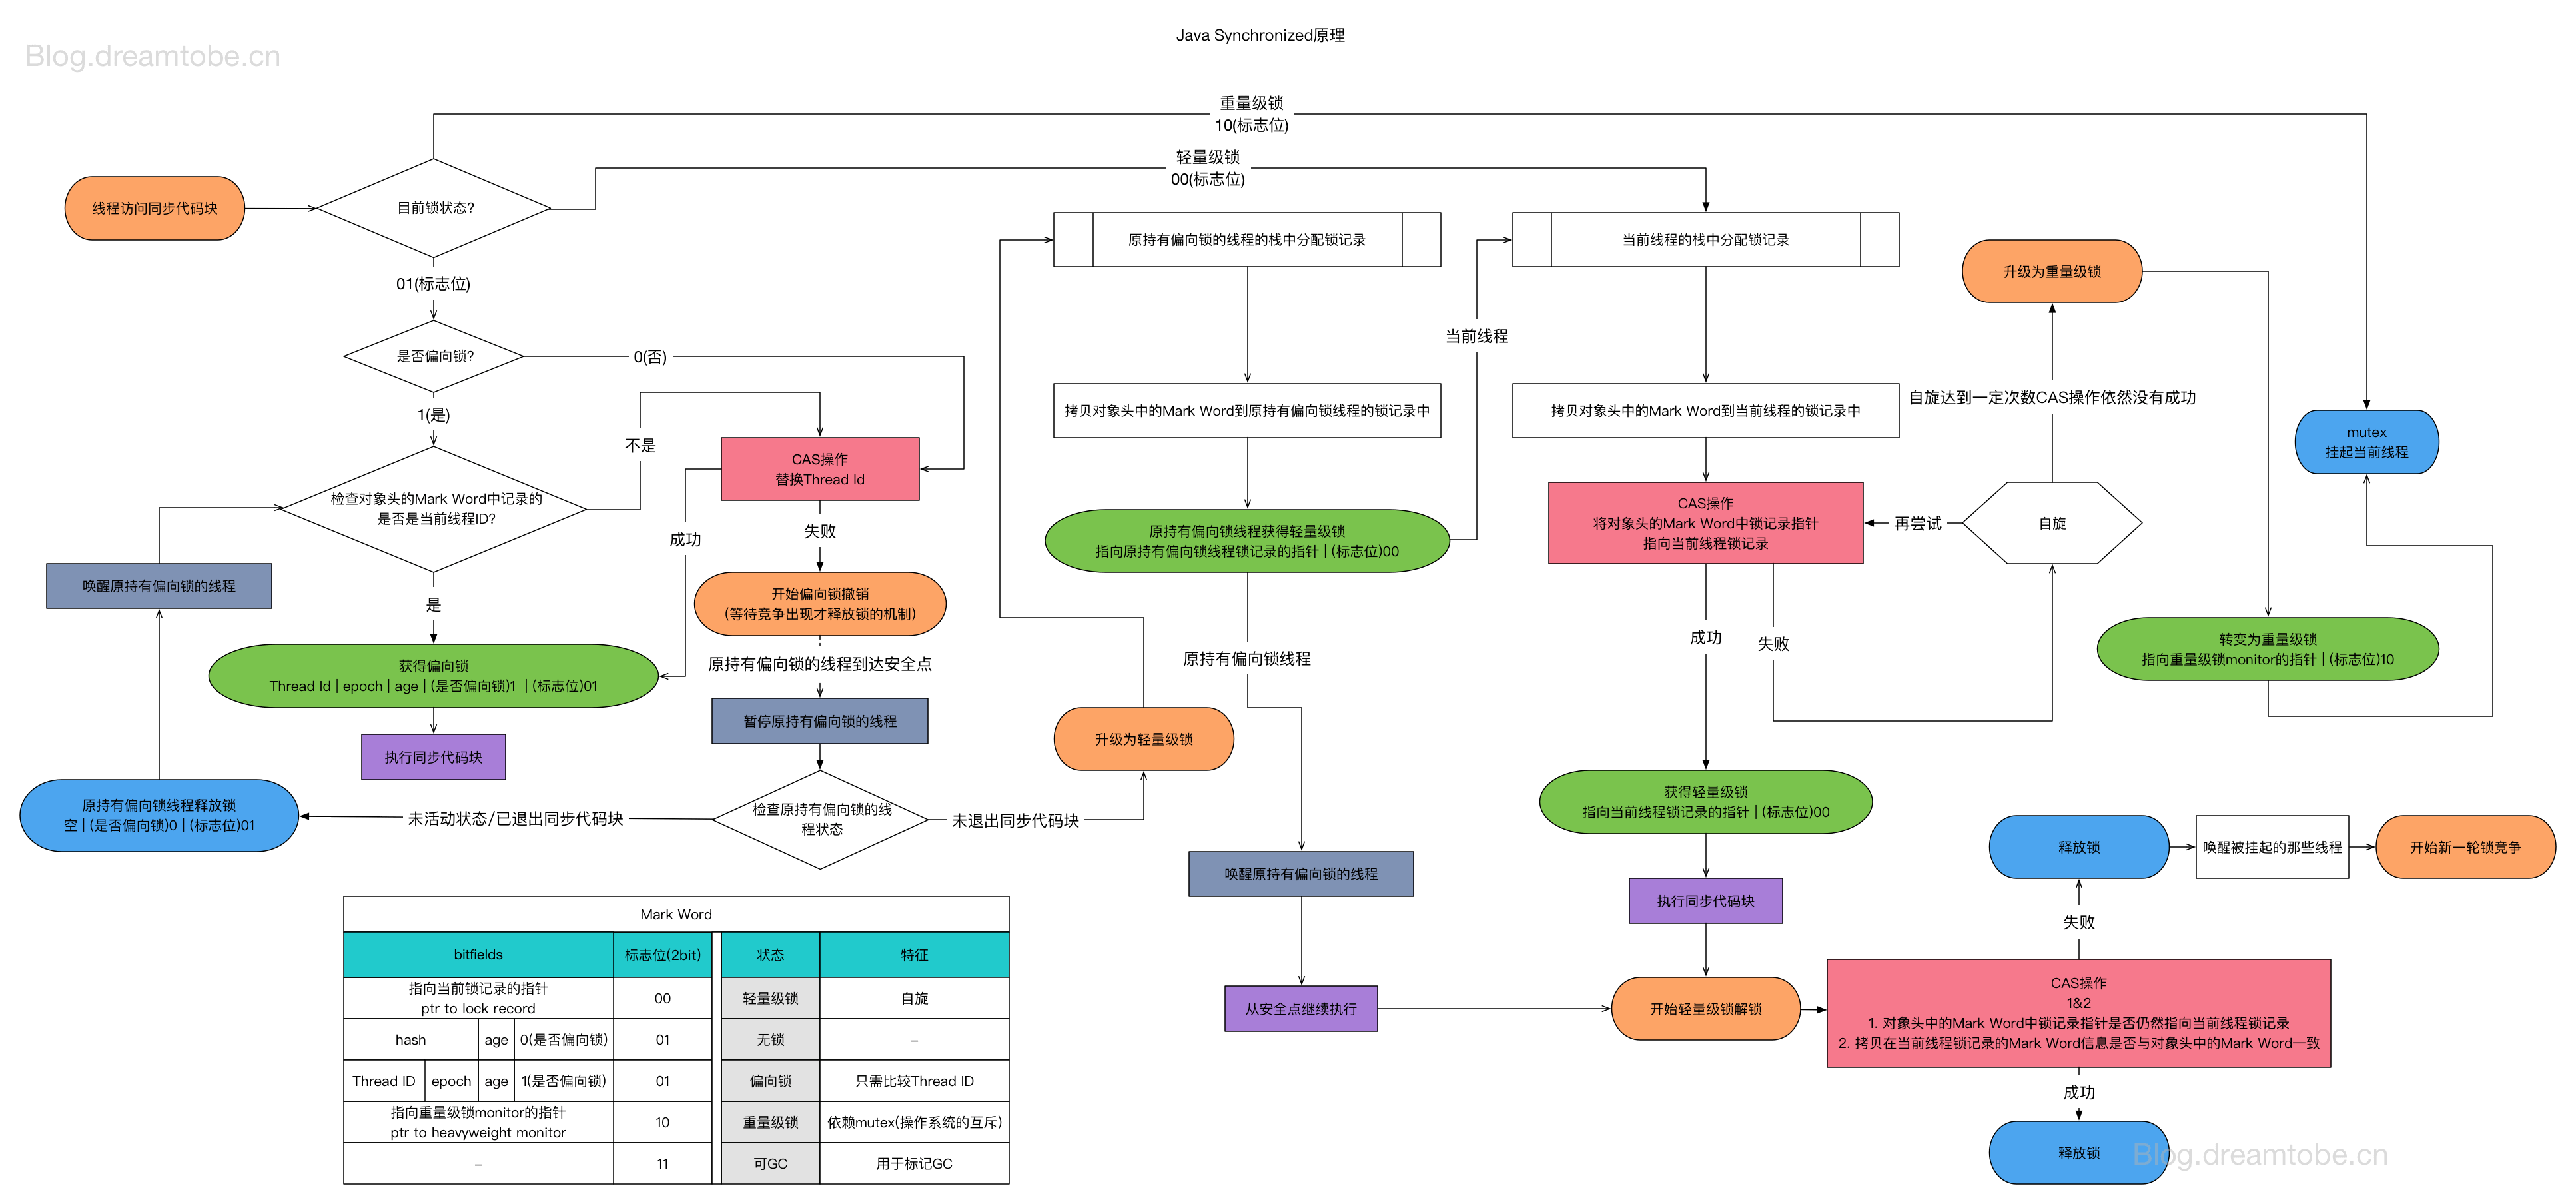

偏向锁
场景一:当锁对象第一次被线程获得锁的时候
mark word中的thread id由0改成当前线程Id。如果成功,则代表获得了偏向锁,继续执行同步块中的代码。否则,将偏向锁撤销,升级为轻量级锁。场景二:当获取偏向锁的线程再次进入同步块时
DisplacedMarkWord为空的 LockRecord中,然后继续执行同步块的代码,因为操纵的是线程私有的栈,因此不需要用到CAS指令;由此可见偏向锁模式下,当被偏向的线程再次尝试获得锁时,仅仅进行几个简单的操作就可以了,在这种情况下, synchronized关键字带来的性能开销基本可以忽略。场景二:当没有获得锁的线程进入同步块时
safepoint中去查看偏向的线程是否还存活mark word改为无锁状态(unlocked)偏向锁的解锁过程
lockrecord的 obj字段设置为null。需要注意的是,偏向锁的解锁步骤中并不会修改锁对象Mark Word中的thread id,简单的说就是锁对象处于偏向锁时,Mark Word中的thread id 可能是正在执行同步块的线程的id,也可能是上次执行完已经释放偏向锁的thread id,主要是为了上次持有偏向锁的这个线程在下次执行同步块时,判断Mark Word中的thread id相同就可以直接执行,而不用通过CAS操作去将自己的thread id设置到锁对象Mark Word中。这是偏向锁执行的大概流程:轻量级锁
轻量级锁的加锁过程
轻量级锁的释放流程
重量级锁
重量级锁执行流程:
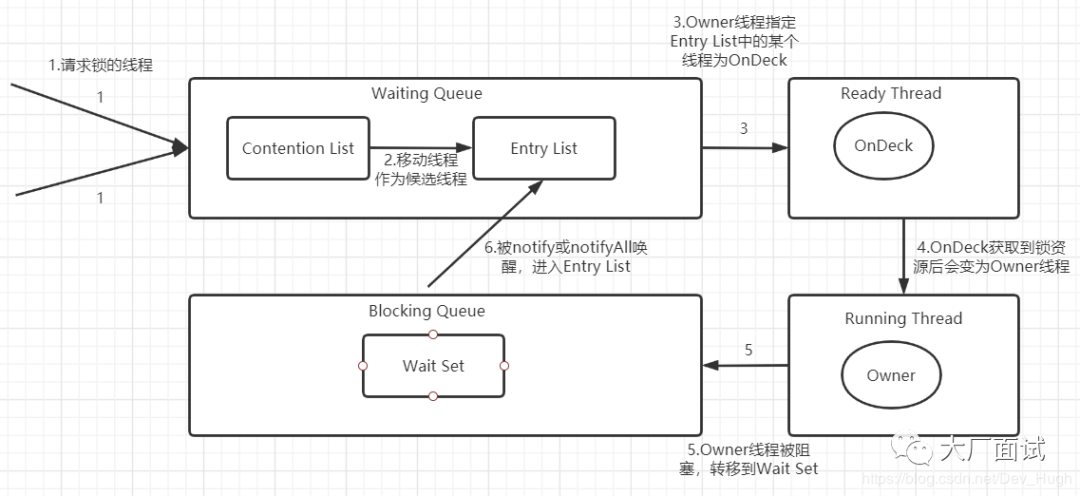
3.为什么说是轻量级,重量级锁是不公平的?
4.重量级锁为什么需要自旋操作?
5.什么时候会发生锁升级,锁降级?
6.偏向锁,轻量锁,重量锁的适用场景,优缺点是什么?
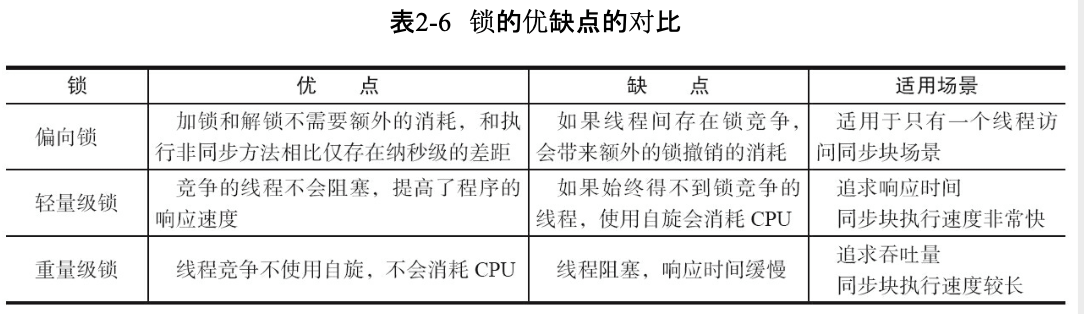
AbstractQueuedSynchronizer(缩写为AQS)是什么?
public class ReentrantLock implements Lock, java.io.Serializable {
			private final Sync sync;
}synchronized锁与ReentrantLock锁的区别?
ReentrantLock的加锁流程是怎么样的?
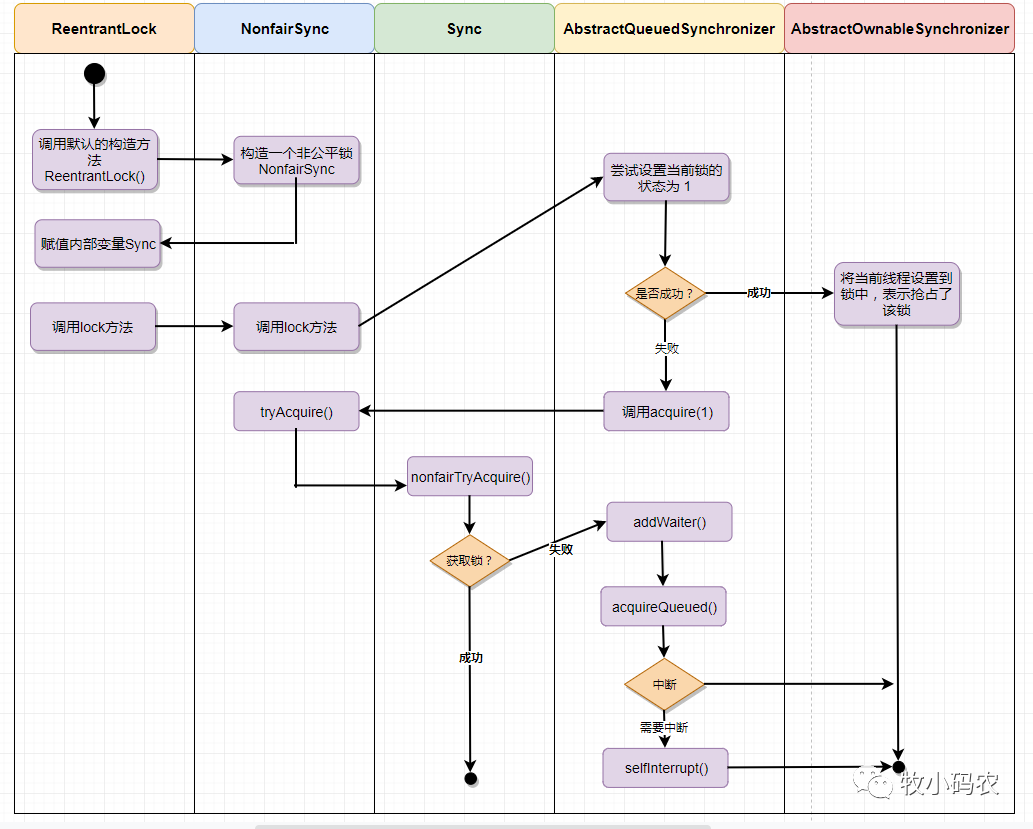
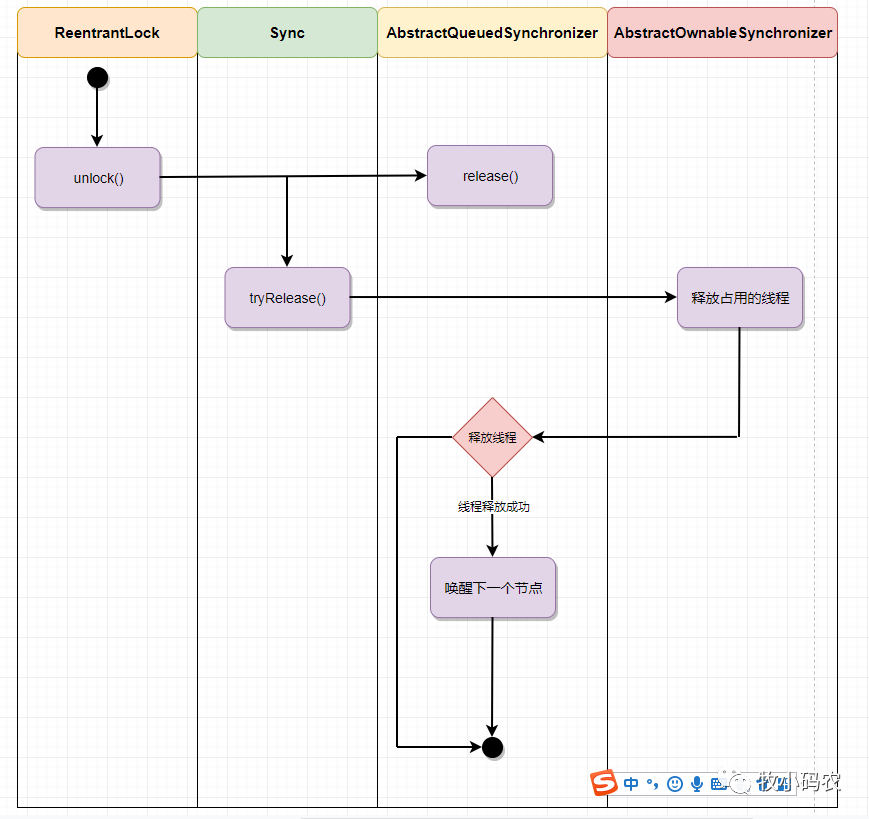
谈一谈你对AQS的理解?
ReentrantLock lock = new ReentrantLock();
lock.lock();//在我们代码中通过调用lock方法进行加锁
FairSync.lock();//lock方法中会调用公平锁类FairSync的lock方法
AbstractQueuedSynchronizer.acquire(1);//FairSync继承于Sync,而Sync继承于AQS,FairSync的lock方法中调用了acquire方法也就是去申请独占锁资源。
public final void acquire(int arg) {
        if (!tryAcquire(arg) &&
            acquireQueued(addWaiter(Node.EXCLUSIVE), arg))
            selfInterrupt();
}
FairSync.tryAcquire()//调用FairSync的tryAcquire去尝试着申请独占锁资源
AbstractQueuedSynchronizer.addWaiter()//申请失败就将线程添加到等待队列尾部
AbstractQueuedSynchronizer.acquireQueued()//并且让这个线程进入阻塞等待状态//公平锁的tryAcquire方法实现
protected final boolean tryAcquire(int acquires) {
final Thread current = Thread.currentThread();
int c = getState();
if (c == 0) {
//等待队列中没有线程,使用cas操作去抢锁,抢锁成功,就返回true
if (!hasQueuedPredecessors() &&
compareAndSetState(0, acquires)) {
setExclusiveOwnerThread(current);
return true;
}
}
//当前线程与持有锁的线程是同一个,那么进行重入
else if (current == getExclusiveOwnerThread()) {
int nextc = c + acquires;
if (nextc < 0)
throw new Error("Maximum lock count exceeded");
setState(nextc);
return true;
}
return false;
}ReentrantLock lock = new ReentrantLock();
lock.unlock();
AbstractQueuedSynchronizer.release(1);
//AbstractQueuedSynchronizer的release()方法
public final boolean release(int arg) {
if (tryRelease(arg)) {
Node h = head;
if (h != null && h.waitStatus != 0)
unparkSuccessor(h);
return true;
}
return false;
}
//ReentrantLock中Sync的tryRelease方法
protected final boolean tryRelease(int releases) {
int c = getState() - releases;
if (Thread.currentThread() != getExclusiveOwnerThread())
throw new IllegalMonitorStateException();
boolean free = false;
//state为0就释放锁,否则只是锁的state减去releases
if (c == 0) {
free = true;
setExclusiveOwnerThread(null);
}
setState(c);
return free;
}悲观锁和乐观锁是什么?
悲观锁
乐观锁和悲观锁的区别:
乐观锁
版本号机制
CAS操作
ABA问题怎么解决?
CAS操作的缺点有哪些?
AtomicReference类把多个共享变量合并成一个共享变量来操作Java的原子类
AtomicInteger
//compareAndSwapInt有四个参数,第一个是待运算的对象,第二个是对象中用于运算的属性的偏移量,第三个是期望值,第四个是更新的值。
unsafe.compareAndSwapInt(this, valueOffset, expect, update)
public class AtomicInteger extends Number implements java.io.Serializable {
private static final long serialVersionUID = 6214790243416807050L;
// setup to use Unsafe.compareAndSwapInt for updates
private static final Unsafe unsafe = Unsafe.getUnsafe();
private static final long valueOffset;
static {
try {
valueOffset = unsafe.objectFieldOffset
(AtomicInteger.class.getDeclaredField("value"));
} catch (Exception ex) { throw new Error(ex); }
}
private volatile int value;//使用volatiole来保证value的内存可见性
}public final int getAndAddInt(Object var1, long var2, int var4) {
int var5;
do {
//var1是对象,var2是对象上某个变量的偏移量,
//var5就是对象var1上偏移量为var2的一个变量
var5 = this.getIntVolatile(var1, var2);
//当var5的值没有变化时,就会进行加法操作,也就是var5 = var5 + var4
//如果var5的值变化了,就会取最新的var5的值,进行加法操作。
} while(!this.compareAndSwapInt(var1, var2, var5, var5 + var4));
return var5;
}
RedisBasic
1.Redis是什么?
2.Redis过期key是怎么样清理的?
3.Redis为什么是单线程的?
4.Redis的性能为什么这么高?
5.Linux中IO模型一共有哪些?
6.同步与异步的区别是什么?
7.阻塞与非阻塞的区别是什么?
8.如何解决Redis缓存穿透问题?
9.如何解决Redis缓存击穿问题?
10.如何解决Redis缓存雪崩问题?
11.如何解决缓存与数据库的数据一致性问题?
Redis是什么?
Redis过期key是怎么样清理的?
(1)惰性清除
(2)定时清理
(3)内存不够时清理
LRU算法
//双向链表
    public static class ListNode {
        String key;//这里存储key便于元素满时,删除尾节点时可以快速从HashMap删除键值对
        Integer value;
        ListNode pre = null;
        ListNode next = null;
        ListNode(String key, Integer value) {
            this.key = key;
            this.value = value;
        }
    }

    ListNode head;
    ListNode last;
    int limit=4;

    HashMap<String, ListNode> hashMap = new HashMap<String, ListNode>();

    public void add(String key, Integer val) {
        ListNode existNode = hashMap.get(key);
        if (existNode!=null) {
            //从链表中删除这个元素
            ListNode pre = existNode.pre;
            ListNode next = existNode.next;
            if (pre!=null) {
               pre.next = next;
            }
            if (next!=null) {
               next.pre = pre;
            }
            //更新尾节点
            if (last==existNode) {
                last = existNode.pre;
            }
            //移动到最前面
            head.pre = existNode;
            existNode.next = head;
            head = existNode;
            //更新值
            existNode.value = val;
        } else {
            //达到限制,先删除尾节点
            if (hashMap.size() == limit) {
                ListNode deleteNode = last;
                hashMap.remove(deleteNode.key);
              //正是因为需要删除,所以才需要每个ListNode保存key
                last = deleteNode.pre;
                deleteNode.pre = null;
                last.next = null;
            }
            ListNode node = new ListNode(key,val);
            hashMap.put(key,node);
            if (head==null) {
                head = node;
                last = node;
            } else {
                //插入头结点
                node.next = head;
                head.pre = node;
                head = node;
            }
        }

    }

    public ListNode get(String key) {
        return hashMap.get(key);
    }

    public void remove(String key) {
        ListNode deleteNode = hashMap.get(key);
        ListNode preNode = deleteNode.pre;
        ListNode nextNode = deleteNode.next;
        if (preNode!=null) {
            preNode.next = nextNode;
        }
        if (nextNode!=null) {
            nextNode.pre = preNode;
        }
        if (head==deleteNode) {
            head = nextNode;
        }
        if (last == deleteNode) {
            last = preNode;
        }
        hashMap.remove(key);
    }
LFU算法
Redis为什么是单线程的?
Redis采用单线程的优势:
Redis采用单线程的劣势:
Redis的性能为什么这么高?
Linux中IO模型一共有哪些?
阻塞式I/O模型(也就是BIO,Blocking IO)

非阻塞时I/O模型

I/O多路复用模型

信息驱动式I/O模型

异步I/O模型
epoll水平触发和边缘触发的区别?
epoll_wait 都会返回它的事件,提醒用户程序去操作,epoll_ctl注册fd,一旦该fd就绪,内核就会采用类似回调机制激活该fd,epoll_wait便可收到通知。同步与异步的区别是什么?
阻塞与非阻塞的区别是什么?
阻塞调用
非阻塞调用
BIO,NIO,AIO有什么区别?
如何解决Redis缓存穿透问题?
解决方案如下:
如何解决Redis缓存击穿问题?
解决方案:
如何解决Redis缓存雪崩问题?
解决方案:
如何解决缓存与数据库的数据一致性问题?
1.先更新数据库,后更新缓存
2.先删除缓存,在更新数据库
3.先更新数据库,再删除缓存
正确的方案
1.写请求串行化
2.先更新数据库,异步删除缓存,删除失败后重试
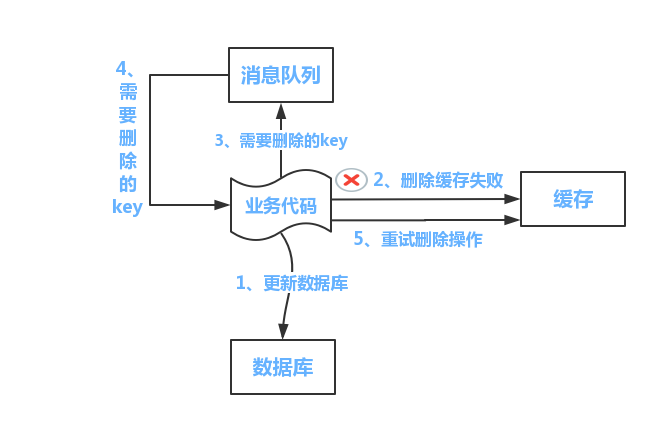
3.业务项目更新数据库,其他项目订阅binlog更新
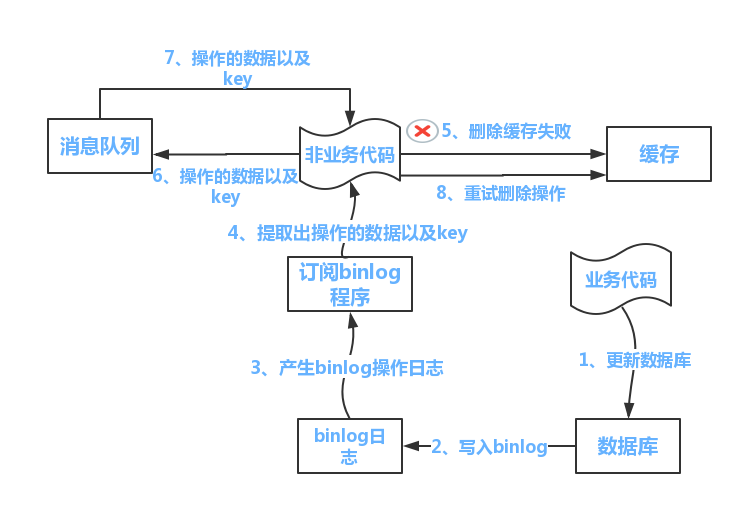
RedisDataStruct
1.Redis常见的数据结构有哪些?
2.谈一谈你对Redis中简单动态字符串的理解?
3.谈一谈你对Redis中hash对象的理解?
4.谈一谈你对Redis中List的理解?
5.谈一谈你对Redis中Set的理解?
6.谈一谈你对Redis中有序集合ZSet的理解?
Redis常见的数据结构有哪些?
谈一谈你对Redis中简单动态字符串的理解?
因为C语言的字符串有两个缺点:
字符串使用场景如下:
字符串的底层存储
struct RedisObject {
    int4 type; //类型
    int4 encoding; //编码
    int24 lru;
    int32 refcount;
    void *ptr;
} robj;int编码
embstr和raw编码
谈一谈你对Redis中hash对象的理解?
ziplist
hashtable
struct dict {
    int rehashindex;
    dictht ht[2];
}
struct dictht {
    dictEntry** table; // 二维
    long size; // 第一维数组的长度
    long used; // hash 表中的元素个数 ...
}
typedef struct dictEntry {
  //键
  void *key;
  //值,可以是一个指针,也可以是一个uint64_t整数,也可以是int64_t的整数
  union {
    void *val;
    uint64_tu64;
    int64_ts64;
  } v;
  //指向下一个节点的指针
  struct dictEntry *next;
} dictEntry;
渐进式rehash
初始化
转移
更改指针指向
谈一谈你对Redis中List的理解?
quicklist
谈一谈你对Redis中Set的理解?
inset
hashtable
谈一谈你对Redis中有序集合ZSet的理解?
ziplist
skiplist+dict
布隆过滤器是什么?
127.0.0.1:6379> bf.reserve userid 0.01 100000127.0.0.1:6379> bf.add userid '181920'
(integer) 1谈一谈你对跳跃表的理解?
假设h为层数,f(h)为该层索引节点数量。
f(h)=n/(2^h)
而最高层的索引节点会是只有两个索引节点。
也就是f(maxH)=n/(2^maxH)=2,所以最大层数maxH= log(n) - 1层 ,加上单链表的层数,总层数也就是log(n)层。
例如我们的单链表是1-19的,建立的多层索引如下,
如果我们要查找19,一开始在第四层遍历1,发现19>1,向右走,发现19>9,那么需要到上一级索引去找,然后发现19>13,继续到下一层,一直到第一层,发现19>17,然后往右走遍历17,18,19
所以每一层遍历的节点其实是
1 9
9 13
13 15 17
17 18 19
所以每一层最多遍历的节点数是<=3,这是由于每一层索引节点数是上一层的节点数的一半来得到的,每两个节点的区间,在上一层中都是两个区间,就是第三层的 1  5区间对应上一层的1  3 区间和3  5 区间。
所以时间复杂度=总层数*每层遍历节点数=3logN,去掉常数后是log(N)

第四层 1               9
第三层 1       5       9          13
第二层 1   3   5   7   9    11    13    15    17
第一层 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19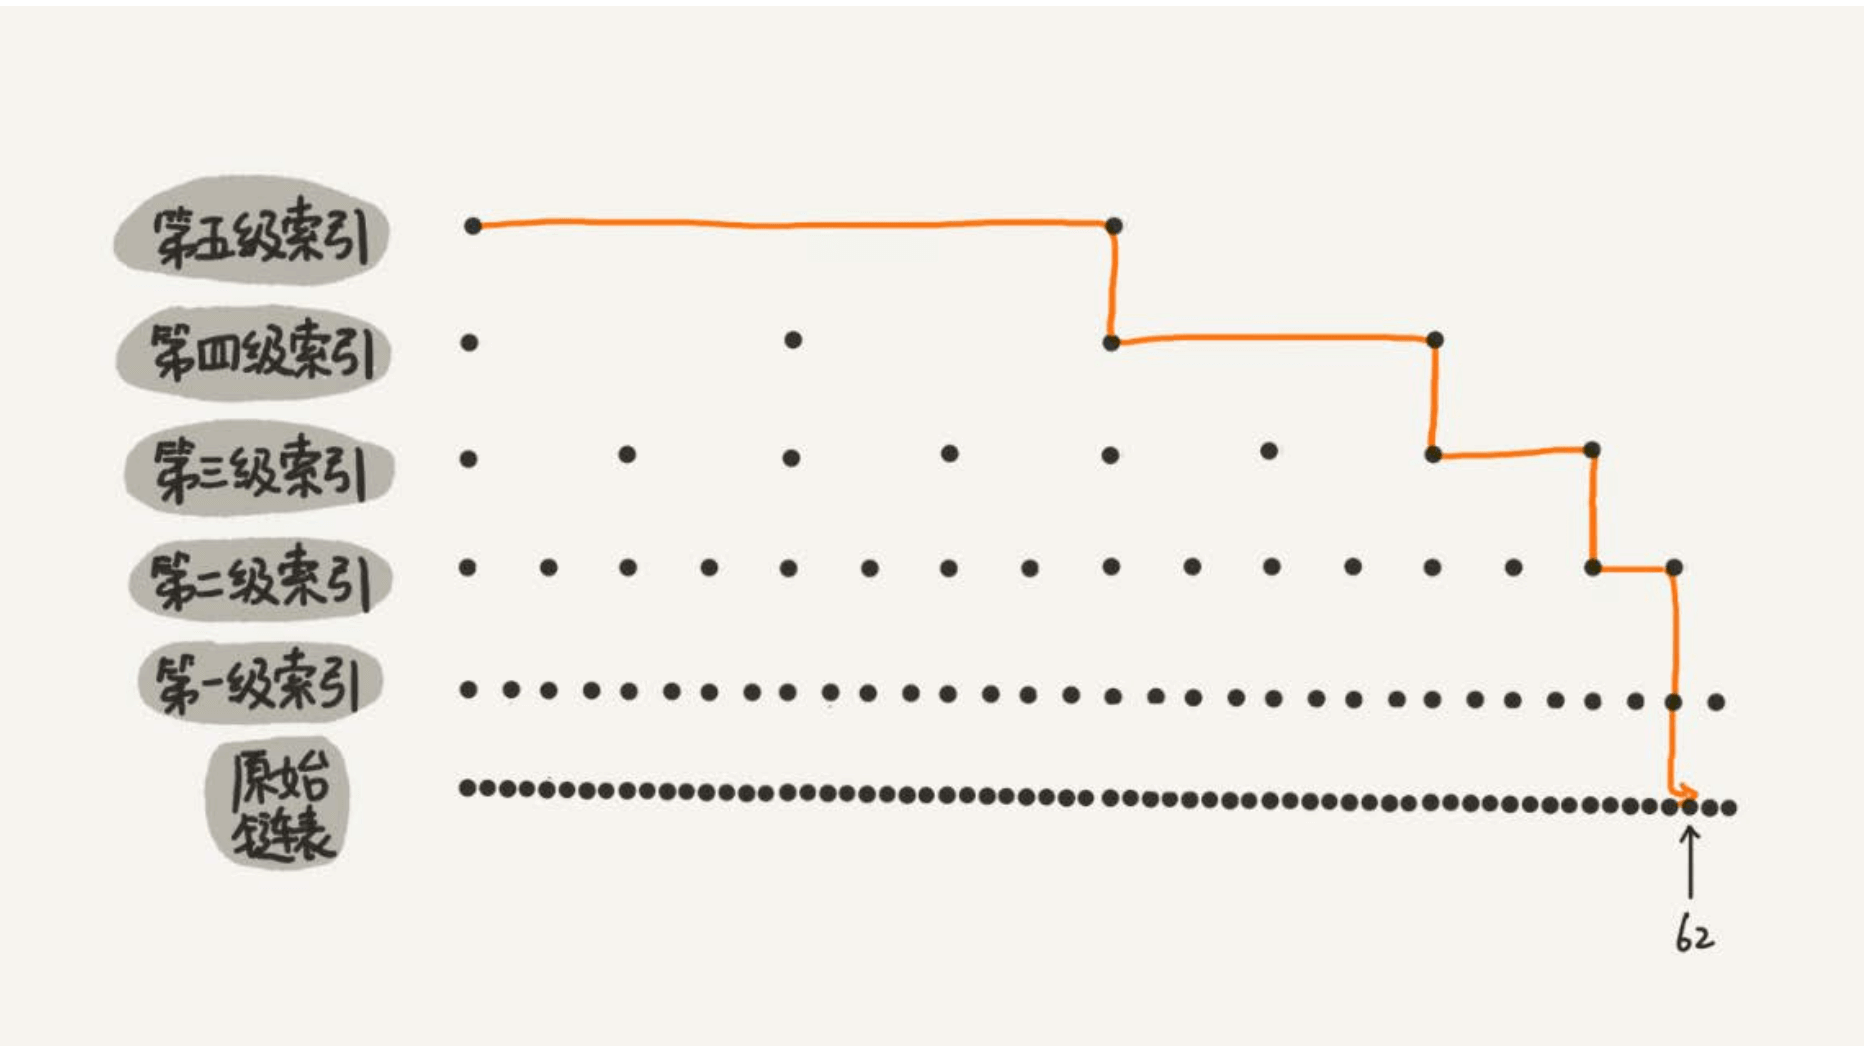

//ZSKIPLIST_P代表获取下一层的概率,是0.25
//ZSKIPLIST_MAXLEVEL代表是最大层数,是32层
int zslRandomLevel(void) {
    int level = 1;
    while ((random()&0xFFFF) < (ZSKIPLIST_P * 0xFFFF))
        level += 1;
    return (level<ZSKIPLIST_MAXLEVEL) ? level : ZSKIPLIST_MAXLEVEL;
}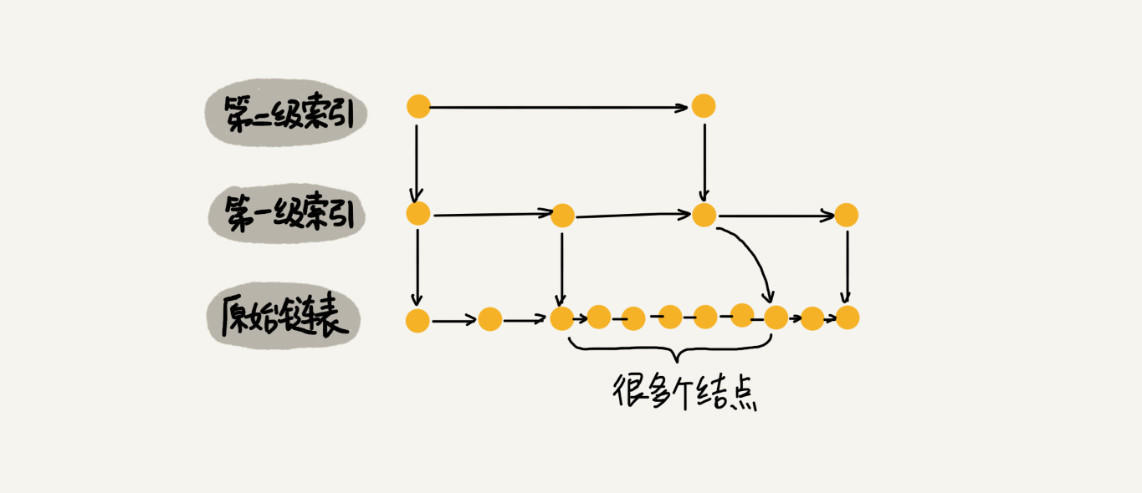
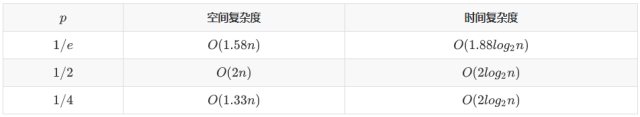
跳跃表与平衡树,哈希表的比较?
为什么MySQL不使用跳跃表作为索引?
为什么平衡二叉树也不适合作为索引?
跳跃表是怎么执行查询操作的?
RedisStore
1.Redis的持久化是怎么实现的?
2.AOF和RDB的区别是什么?
3.怎么防止AOF文件越来越大?
4.Redis持久化策略该如何进行选择?
Redis的持久化是怎么实现的?
AOF持久化
struct redisServer {
 /* AOF buffer, written before entering the event loop */
 sds aof_buf;//aof_buf缓冲区其实就是Redis的一个简单动态字符串
 }
struct sdshdr {
    unsigned int len;
    unsigned int free;
    char buf[];
};
RDB持久化
基本定义
实现原理
	//CopyOnWriteArrayList的添加元素的方法
	public boolean add(E e) {
        final ReentrantLock lock = this.lock;
        lock.lock();
        try {
            Object[] elements = getArray();
            int len = elements.length;
            Object[] newElements = Arrays.copyOf(elements, len + 1);
            newElements[len] = e;
            setArray(newElements);
            return true;
        } finally {
            lock.unlock();
        }
    }
AOF和RDB的区别是什么?
怎么防止AOF文件越来越大?
Redis持久化策略该如何进行选择?
以下是几种持久化方案选择的场景:
1.不需要考虑数据丢失的情况
2.单机实例情况下
3.在主从环境下
4.异地灾备
什么是AOF文件追加阻塞?
什么是RDB-AOF混合持久化?
开启混合持久化
混合持久化过程
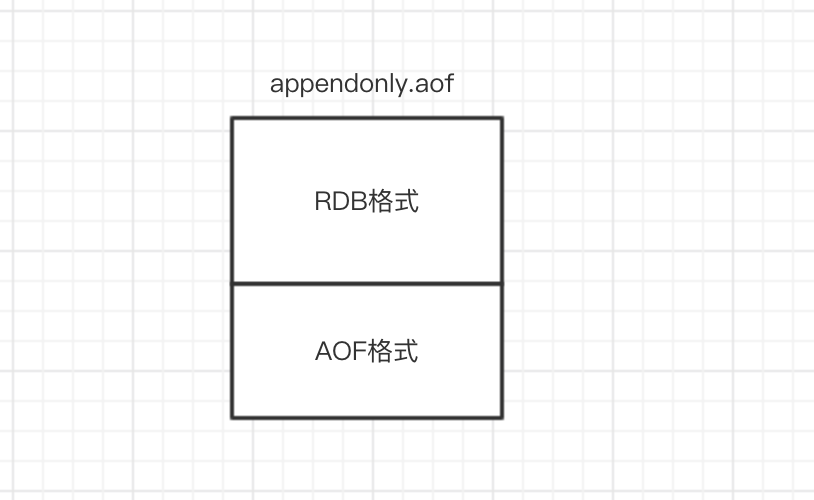
数据恢复
优缺点
RedisUserful
1.Redis主从同步是怎么实现的?
2.Redis中哨兵是什么?
3.客户端是怎么接入哨兵系统的?
4.Redis哨兵系统是怎么实现自动故障转移的?
5.谈一谈你对Redis Cluster的理解?
6.RedisCluster是怎么实现数据分片的?
7.RedisCluster是怎么做故障转移和发现的?
Redis主从同步是怎么实现的?
全量重同步
部分重同步
命令传播
Redis中哨兵是什么?
客户端是怎么接入哨兵系统的?
 String masterName = "mymaster";
 Set<String> sentinels = new HashSet<>();
 sentinels.add("192.168.92.128:26379");
 sentinels.add("192.168.92.128:26380");

 JedisSentinelPool pool = new JedisSentinelPool(masterName, sentinels); //初始化过程做了很多工作
 Jedis jedis = pool.getResource();
 jedis.set("key1", "value1");
pool.close();Redis哨兵系统是怎么实现自动故障转移的?
1.认定主节点主观下线
2.认定主节点客观下线
3.进行领导者哨兵选举
4.领导者哨兵进行故障转移
谈一谈你对RedisCluster的理解?
RedisCluster是怎么实现数据分片的?
Redis Cluster的节点扩容和下线
扩容
./redis-trib.rb add-node 127.0.0.1:7006 127.0.0.1:7000下线
RedisCluster是怎么做故障转移和发现的?
1.主观下线
2.客观下线:
3.资格检查
4.从节点触发选举
5.从节点发起选举
6.主节点为选举投票
7.选举完成
Redis Cluster的主从复制模型
Redis Cluster一致性
MySQLNote
1.一条MySQL更新语句的执行过程是什么样的?
2.脏页是什么?
3.Checkpoint是什么?
4.undo log,redo log,bin log是什么?
5.MySQL中的事务是什么?
6.MySQL的隔离级别是怎么样的?
7.MVCC的实现原理是怎么样的?
8.MySQL是怎么解决幻读的问题的?
9.MySQL中有哪些锁?
10.B树是什么?
11.B树与B+树的区别是什么?
12.索引是什么?
13.字符串索引和数字类型索引的区别?
14.union和union all的区别是什么?
15.Join的工作流程是怎么样的,怎么进行优化?
16.聚集索引是什么?
17.联合索引是什么?
18.覆盖索引是什么?
19.哪些情况不要建索引?
20.主键,唯一性索引,普通索引的区别是什么?
21.InnoDB和MyISAM的区别是什么?
22.什么是分库分表?
23.怎么实现跨库分页查询?
24.MySQL主从复制的工作流程是什么样的?
25.char类型与varchar类型的区别?
26.查询数量SELECT Count(*)怎么优化?
27.如何优化MySQL慢查询?
28.MySQL的join的实现是怎么样的?
一条MySQL更新语句的执行过程是什么样的?
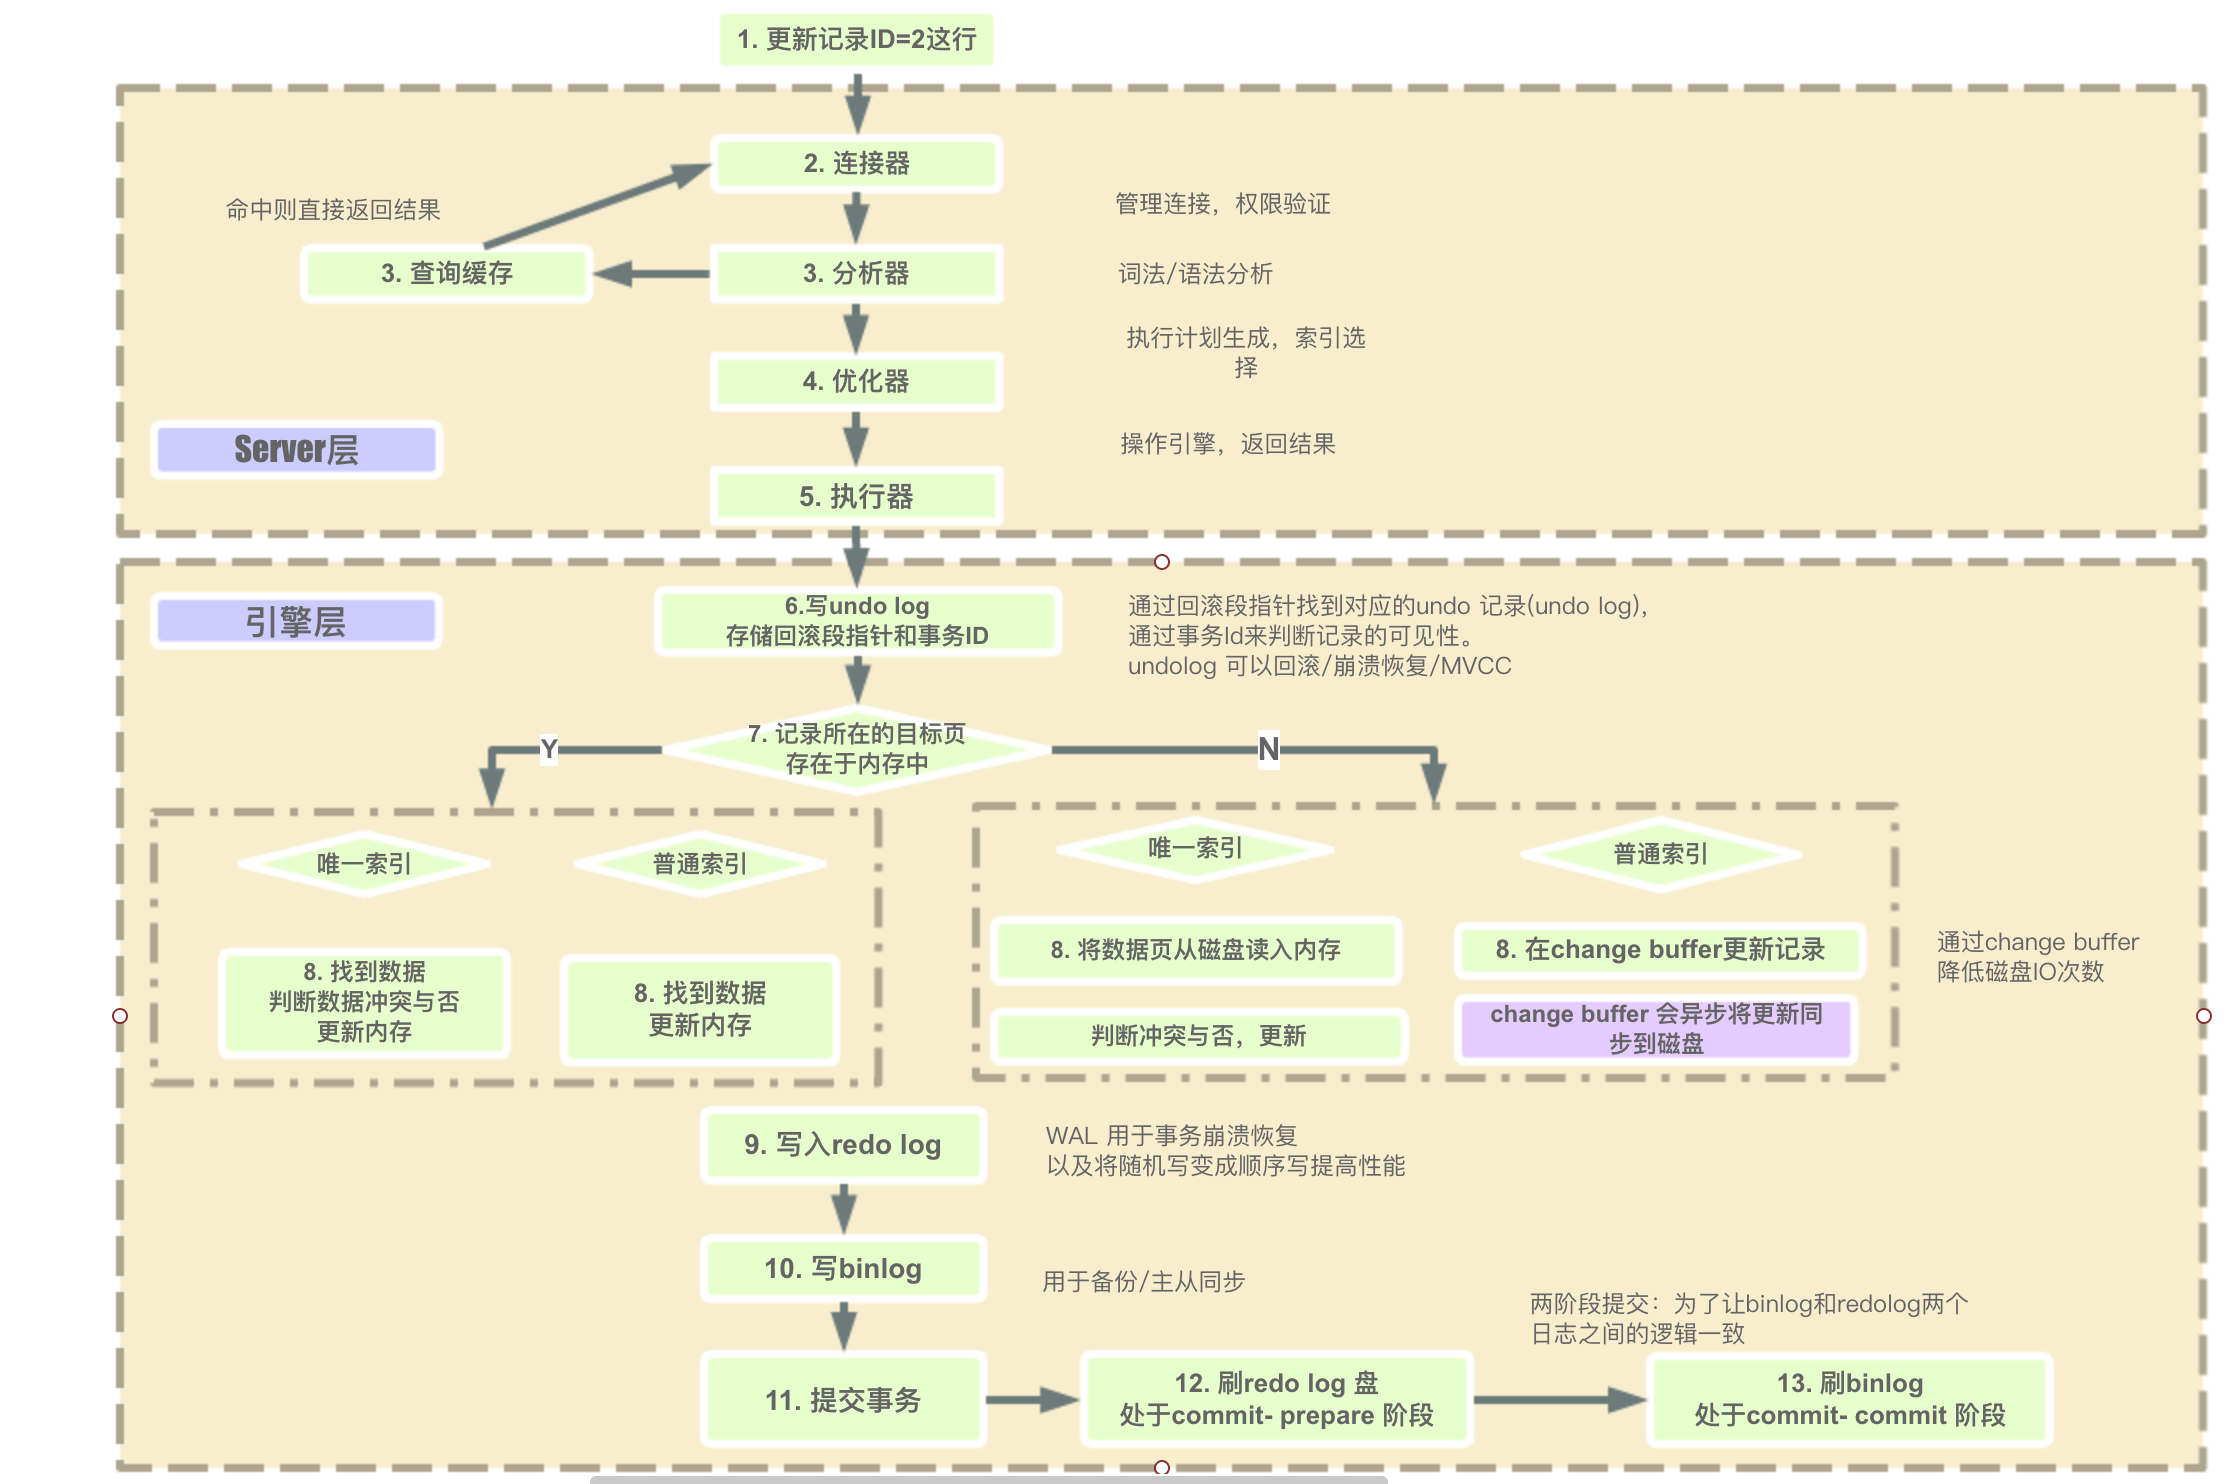
1.连接验证及解析
2.写undo log
3.从索引中查找数据
4.更新数据
4.1数据页在内存中
4.1.1普通索引
4.1.2唯一性索引
4.2 数据页不在内存中
4.2.1普通索引
4.2.2 唯一性索引
5.写redo log(prepare状态)
6.写bin log(同时将redo log设置为commit状态)
undo log
change buffer是什么?
redo log
二段提交制是什么?
崩溃恢复时的判断规则(以redolog是否commit或者binlog是否完整来确定)
脏页是什么?
Checkpoint是什么?
undolog,redolog,binlog是什么?
undo log 是什么?
redo log是什么?
Bin log 是什么?
MySQL中的事务是什么?
MySQL的隔离级别是怎么样的?
未提交读
提交读
可重复读
可串行化
MVCC的实现原理是怎么样的?
1.插入操作
2.删除操作
InnoDB只会在丢弃为删除而编写的undo log日志记录时,才物理删除相应的行及其索引记录。此删除操作称为purge,它非常快,通常花费与执行删除操作的SQL语句相同的时间顺序。)4.或更新操作
5.查询操作
MySQL是怎么解决幻读的问题的?
MySQL中有哪些锁?
全局锁
1.全局锁
Flush tables with read lock命令让整个库处于只读状态。2.利用innodb的事务隔离性(可重复读)
3.set global readonly=true
表级锁
表锁 lock table
元数据锁MDL(MetaData Lock)
自增锁
意向锁
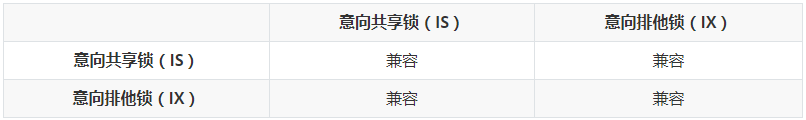
表级别的S锁 表级别的X锁 意向读锁IS 兼容 不兼容 意向写锁IX 不兼容 不兼容 那么意向锁的作用是什么呢?
Innodb的锁
行锁
记录锁 record lock
SELECT c1 FROM t WHERE c1 = 10 FOR UPDATE; 可以防止从插入,更新或删除行。间隙锁 gap lock
下一键锁 next-key lock
(负无穷,1]

(1,5]

(5,10]

(10,20]

(20,30]

(30,正无穷)
//更新操作
update table set note = '1' where num = 10;
//或者是使用实时读
SELECT * FROM table WHERE num = 10 for UPDATE;B树是什么?
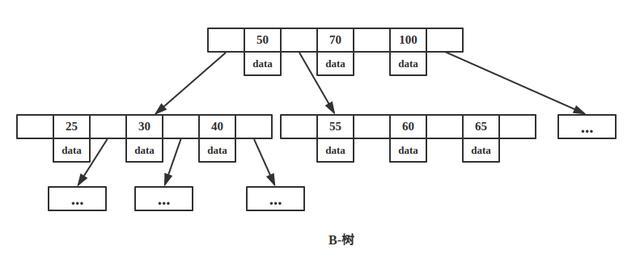
B树与B+树的区别是什么?
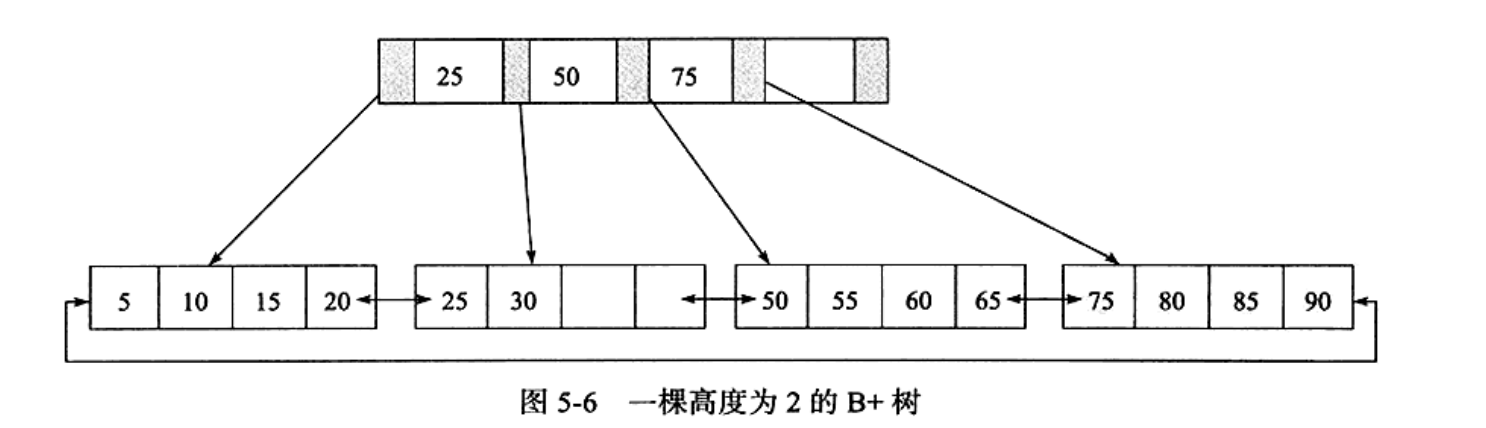
B+树与二叉树区别是什么?为什么不用红黑树?
与红黑树的比较
索引是什么?
字符串索引和数字类型索引的区别?
union和unionall的区别是什么?
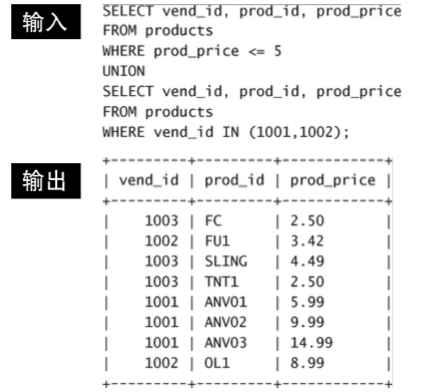
不设置MySQL主键会怎么样?
聚集索引是什么?
innodb的聚集索引
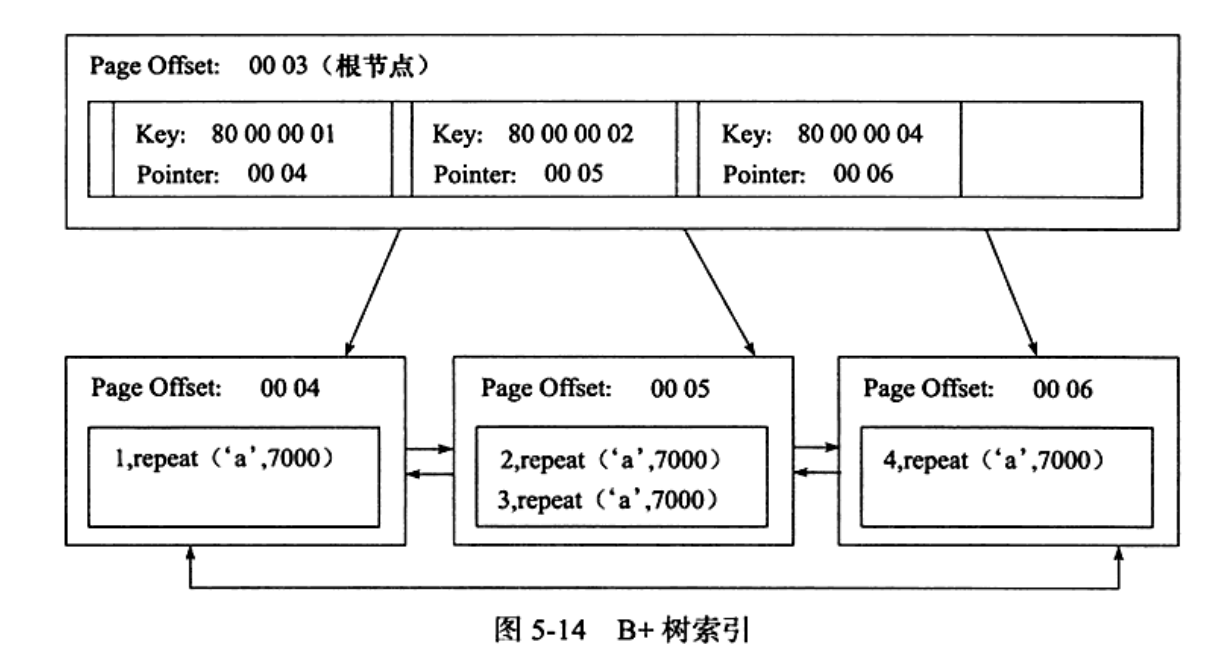
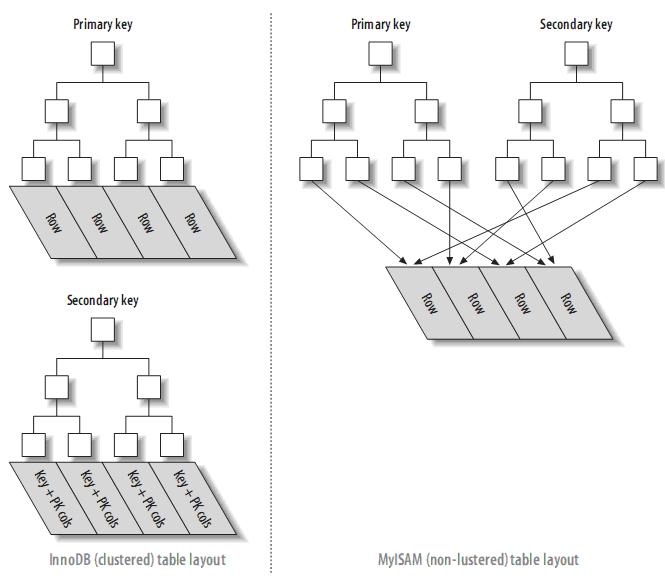
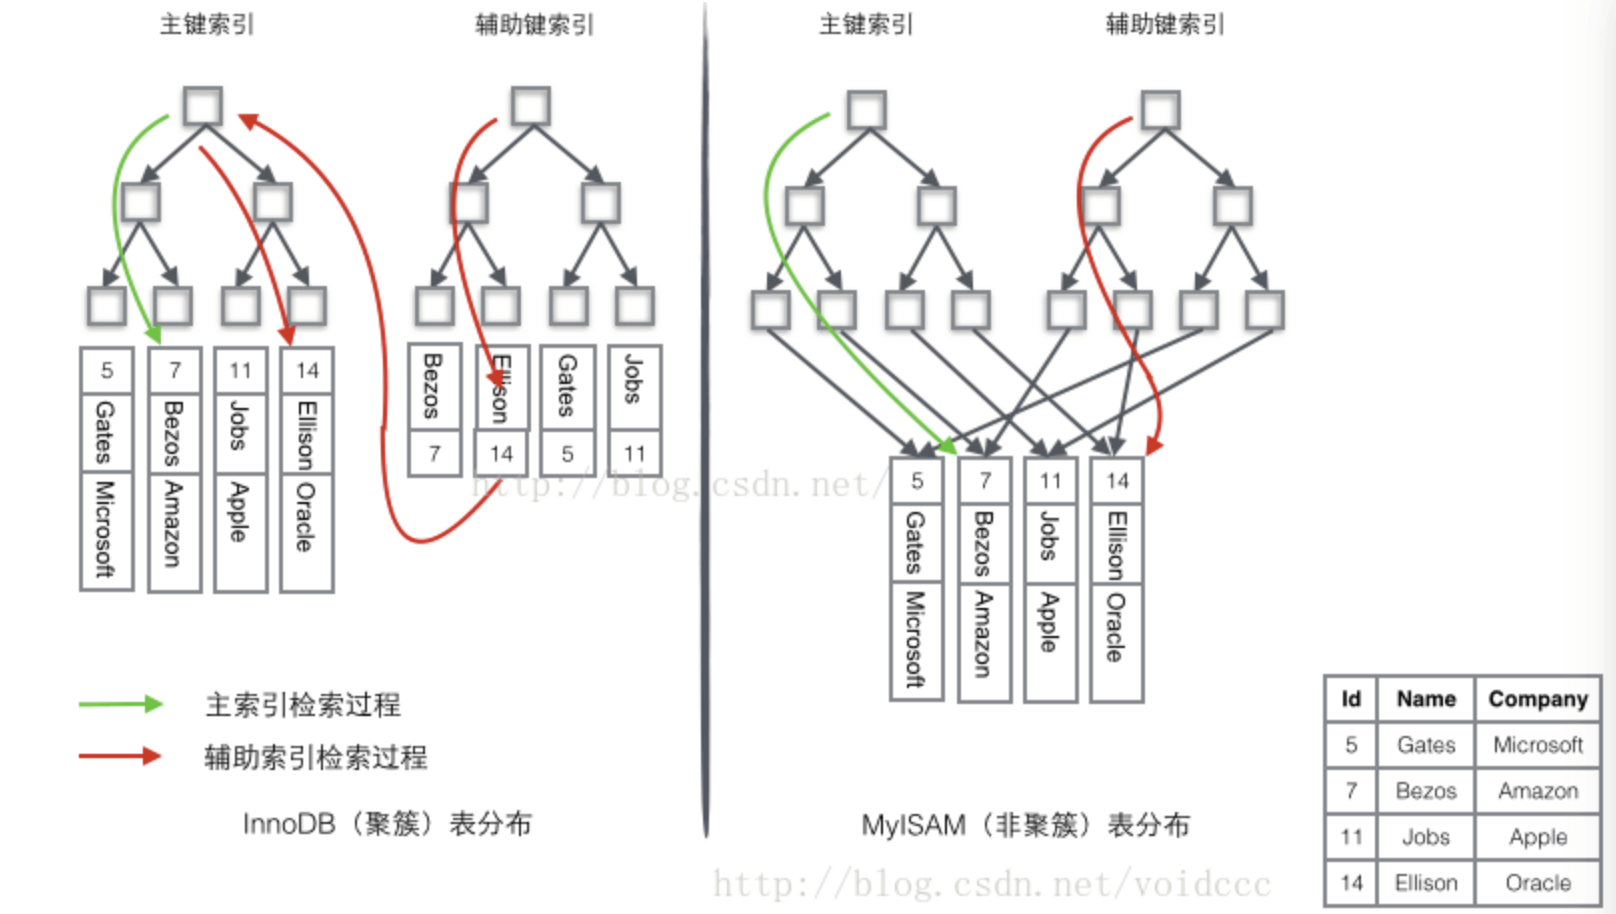
聚集索引的优点
聚集索引的缺点
联合索引是什么?
create index a_b_c on user(a,b,c)
这样相当于是创建三个索引
a
a,b
a,b,cselect * from user where a > 1;
SELECT * FROM user WHERE a='2222' OR b='13281899972'//这个就不会走联合索引,因为只是查询b时不能根究索引查询,所以还是需要全表扫描,所以干脆a也不用索引了。
如果a,b都有索引,那么会单独根据a,b来查询,然后将结果集合并
关于or查询的真相是:
所谓的索引失效指的是:假如or连接的俩个查询条件字段中有一个没有索引的话,引擎会放弃索引而产生全表扫描。SELECT * FROM user WHERE age=1 and height = 2
SELECT * FROM user WHERE age=1 and weight=7
SELECT * FROM user WHERE weight=7 and age=1SELECT * FROM user WEHRE age=1 and height>2 and weight=7索引没有被采用?
覆盖索引是什么?
SELECT a,b,c FROM user where a = 1哪些情况不要建索引?
主键,唯一性索引,普通索引的区别是什么?
InnoDB和MyISAM的区别是什么?
InnoDB
MyISAM
什么是分库分表?
垂直切分
水平切分
问题
分库分表具体实施
怎么验数据一致性
怎么实现跨库分页查询?
全局视野法
要查order by time offset offset_value limit num时
对每个库查 order by time offset 0 limit offset_value + num然后进行排序
最大时间法
要查order by time offset offset_value limit num时
获得上一页的最大时间
对每个库查 where time >lastTime order by time offset 0 limit num然后进行排序
每库平均取法
将order by time offset X limit Y,改写成order by time offset X/N limit Y/N二次查询法
(1)将order by time offset X limit Y,改写成order by time offset X/N limit Y

(2)找到最小值time_min

(3)between二次查询,order by time between time_min and time_i_max

(4)设置虚拟time_min,找到time_min在各个分库的offset,从而得到time_min在全局的offset

(5)得到了time_min在全局的offset,自然得到了全局的offset X limit YZset记录法
怎么为订单系统设计数据库的表?
MySQL主从复制的工作流程是什么样的?
实现原理
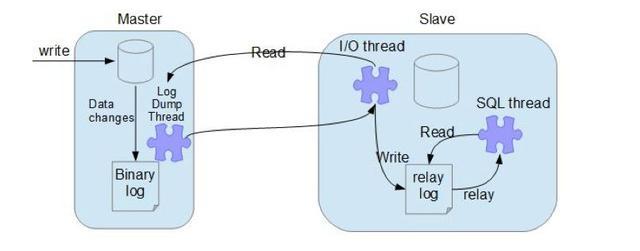
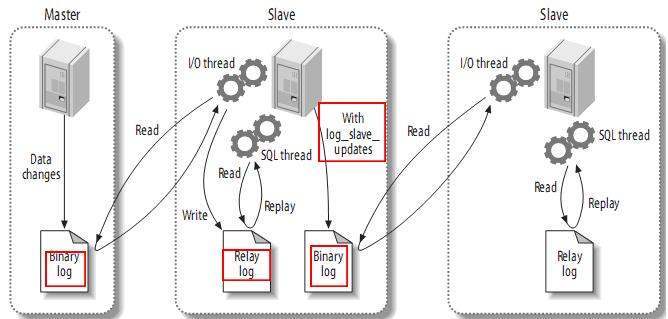
异步模式(默认的模式)
半同步模式(MySQL 5.5之后提供)
全同步模式
bin log格式
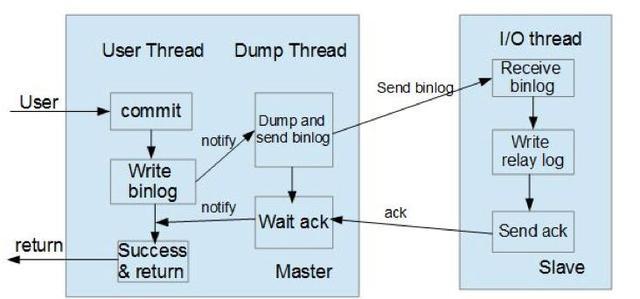
死锁
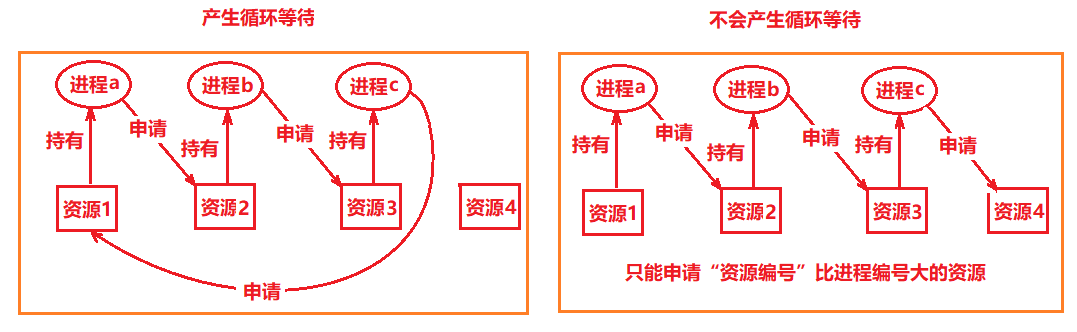
MySQL中的死锁
怎么优化数量查询?
COUNT(*)和Count(id)
Count(col)
怎么优化count(\*)?
Myisam可以缓存count,而innodb不能缓存count
怎么优化慢查询?
EXPLAIN SELECT * FROM res_user ORDER BYmodifiedtime LIMIT 0,1000
得到如下结果:

table |  type | possible_keys | key |key_len  | ref | rows | Extra  EXPLAIN列的解释:

- table   显示这一行的数据是关于哪张表的
- type    这是重要的列,显示连接使用了何种类型。从最好到最差的连接类型为const、eq_reg、ref、range、index和ALL
- ref    表里面的哪个索引被用到了
- rows   显示需要扫描行数
- key     使用的索引

   const就是针对主键或者唯一性索引的等值查询,通过索引查找一次就行了。仅仅是查一条数据。

   ref_eq 唯一性索引查询,一般使用一个表去join另外一个表的唯一性索引字段时,就是ref_eq

   ref 非唯一性索引查询,就是根据普通索引去查找数据,例如查询条件是where a = 1,a是普通索引,但是不是唯一性索引

   range: 表示有范围条件的全索引范围查询,跟index全索引扫描相比就是有查询条件,可以减少一些扫描的数据量。同时除了显而易见的between,and以及'>','<'外,in和or也是索引范围扫描。

   index: 表示全索引扫描(full index scan), 这是另外一种全表扫描,例如order by 字段是索引字段,如果是直接去聚集索引下全表扫描,那么查询出来的结果集还需要在内存中排序一边,如果是去非聚集索引下进行全表扫描,然后按照扫描顺序进行回表,回表的顺序就是order by的顺序,可以减少排序的时间,但是会有回表的开销。

all:这个就是全表扫描数据文件,然后再在server层进行过滤返回符合要求的记录。1.使用show profile对一条SQL查询分析当前会话中语句执行的资源消耗情况
mysql> show PROFILE for QUERY 9;
+----------------------+----------+
| Status               | Duration |
+----------------------+----------+
| starting             | 0.000054 |
| checking permissions | 0.000007 |
| Opening tables       | 0.000116 |
| init                 | 0.000019 |
| System lock          | 0.000009 |
| optimizing           | 0.000004 |
| statistics           | 0.000011 |
| preparing            | 0.000010 |
| executing            | 0.000002 |
| Sending data         | 0.000061 |
| end                  | 0.000005 |
| query end            | 0.000006 |
| closing tables       | 0.000006 |
| freeing items        | 0.000031 |
| cleaning up          | 0.000010 |
+----------------------+----------+char类型与varchar类型的区别?
如何优化MySQL慢查询?
Using index
Using where
SELECT * FROM test where id > 100 AND name = '123'Using index condition
Using filesort
Using temporary; Using fileSort
优化的方法:
索引的创建步骤是怎么样的?
//ALTER 命令可以为表增加主键索引,唯一性索引,普通索引
ALTER TABLE table_name add primary key (column_list) ;
ALTER TABLE table_name ADD INDEX index_name (column list);
ALTER TABLE table_name DROP INDEX index_name (column list);
//CREATE 命令可以为表增加唯一性索引,普通索引
CREATE index index_name on table_name (column_list);
DROP index index_name on table_name (column_list);Fast Index Creation
Online DDL
MySQL的join的实现是怎么样的?
select * from t1 inner join t2 on t1.id=t2.tidList<Row> result = new ArrayList<>();
for(Row r1 in List<Row> t1){
for(Row r2 in List<Row> t2){
if(r1.id = r2.tid){
result.add(r1.join(r2));
}
}
}一.Simple Nested-Loop
二.Index Nested-LoopJoin(减少内层表数据的匹配次数)
select * from t1 inner join t2 on t1.id=t2.tid
/*
假设要执行上面的这个查询,然后t1作为外层表(也就是驱动表),每次从t1表中取一行数据出来,然后根据t1.id去t2表的聚集索引下查询主键id等于t1.id的数据行,如果存在,就添加到结果集中,所以
每次查询的匹配次数=t2表的聚集索引的层数
总的查询匹配次数=外层表t1的行数 * t2表的聚集索引的层数
*/
List<Row> result = new ArrayList<>();
for(Row r1 in List<Row> t1){
Row> r2 = searchBTree(t1.id);
result.add(r1.join(r2));
}三.Block Nested-Loop Join(减少内层表数据的循环次数)
select * from t1 inner join t2 on t1.tid=t2.tid
假设字段tid在t1表,t2表中都没有建立索引,那么查找时就不能使用索引了,采用Block Nested-Loop Join算法就是每次从驱动表t1中加载一部分数据行到内存缓冲区Join Buffer 中来,然后对t2表进行全表扫描,扫描时每次拿t2表中的数据行与Join Buffer中的数据进行匹配,匹配完成就添加到结果集。
所以全表扫描的次数=驱动表t1的行数/Join Buffer的大小。
因为Join Buffer是内存缓冲区,在内存中进行元素比较是比较快的,而对t2表进行全表扫描是磁盘Io,是比较慢的,所以应该是尽可能减少全表扫描的次数。所以优化的方式一般是增大Join Buffer的大小,或者是选取数据量小的表作为驱动表,这样可以减少全表扫描的次数,减少磁盘IO。
List<Row> result = new ArrayList<>();
//可以把subList理解为每次从t1表中取出,加载到join buufer的那一部分数据
for( List<Row> subList in List<Row> t1){
for(Row r2 in List<Row> t2){
if(subList.contains(r2.tid){
result.add(r1.join(r2));
}
}
}怎么如何优化Join速度?
Join的工作流程是怎么样的,怎么进行优化?
join的大概使用是怎么样的?
exits 和in,join的区别是什么?
//就是t1作为驱动表
List<Row> result = new ArrayList<>();
for(Row r1 in List<Row> t1){
	for(Row r2 in List<Row> t2){
		if(r1.id = r2.tid){
			result.add(r1.join(r2));
		}
	}
}select * from A where cc in (select cc from B)
-- 效率低,用到了A表上cc列的索引;
select * from A where exists(select cc from B where cc=A.cc)
-- 效率高,用到了B表上cc列的索引。MySQL怎么排查使用率低的索引?
performance_schema的配置,默认为不开启,开启后,可以统计MySQL数据库的性能进行监测统计,会将内存使用情况,SQL语句使用情况,IO读取情况等等进行统计,并将统计结果写入到performance_schema这个数据库中,这个数据库里面有很多表,记录了性能统计结果。在MySQL bentch中有一个界面会展示出没有使用到索引的结果。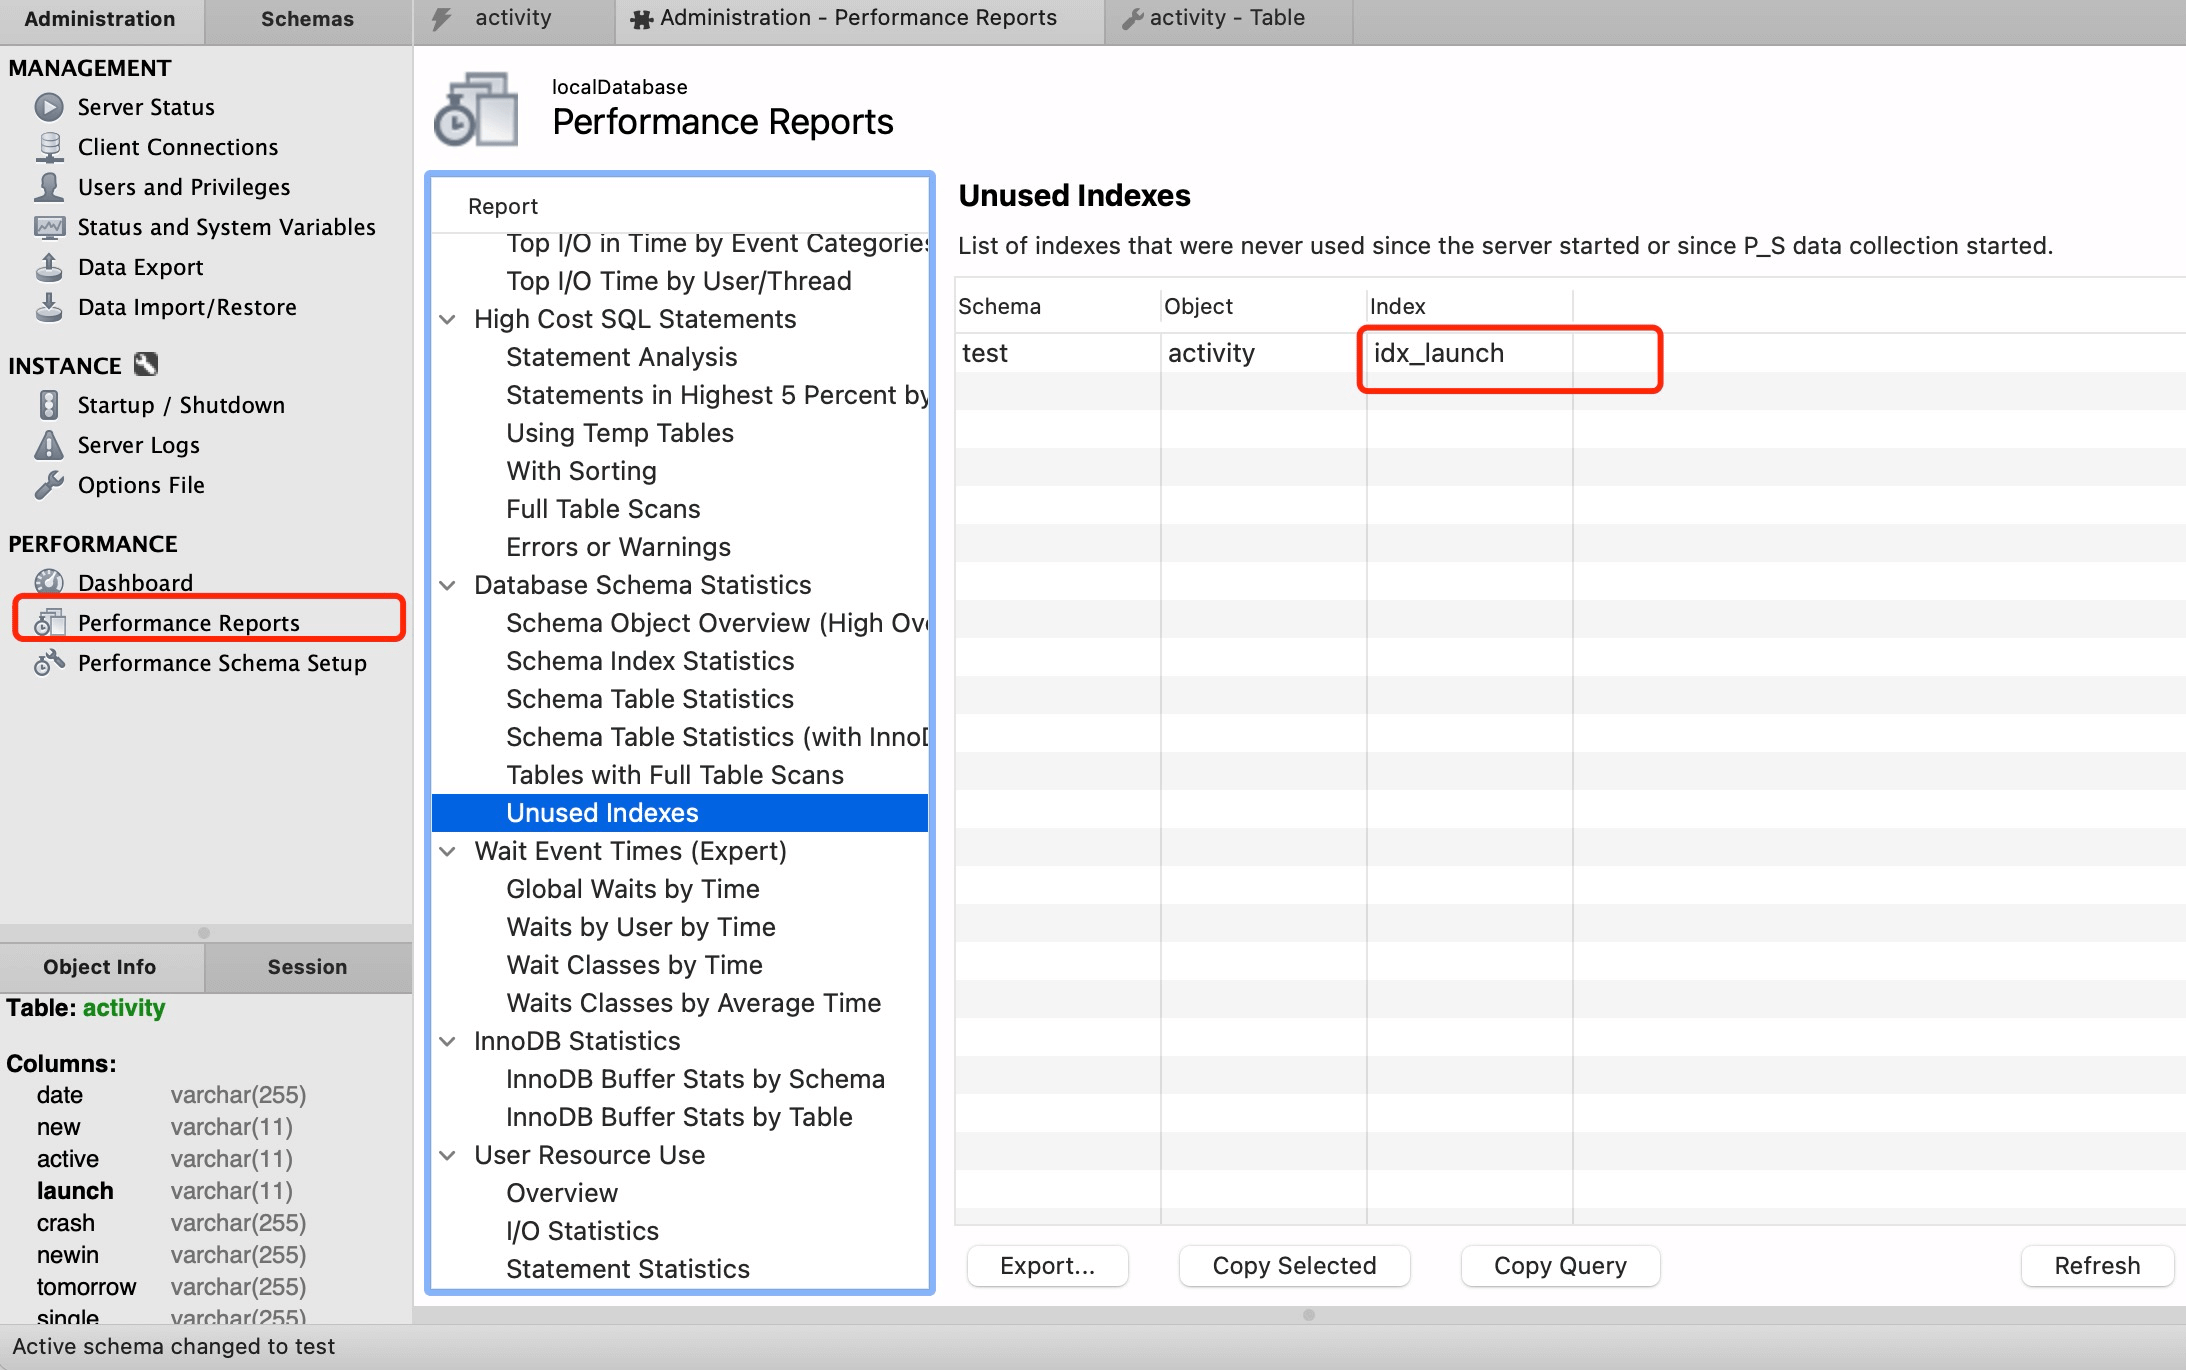
performance_schema这个数据库,里面总共有52个性能统计结果表,其中有一个table_io_waits_summary_by_index_usage表,里面统计了索引使用情况,里面有统计索引在查询,插入,更新,删除语句中使用到的次数。SELECT
object_type,//类型,这里是table
object_schema,//索引所在的数据库名
object_name,//索引所在的表名
index_name,//索引名称
COUNT_FETCH,//这个索引在查询语句中使用到的的次数
COUNT_INSERT,//这个索引在插入语句中使用到的的次数
COUNT_UPDATE,//这个索引在更新语句中使用到的的次数
COUNT_DELETE//这个索引在删除语句中使用到的的次数
FROM
PERFORMANCE_SCHEMA.table_io_waits_summary_by_index_usage;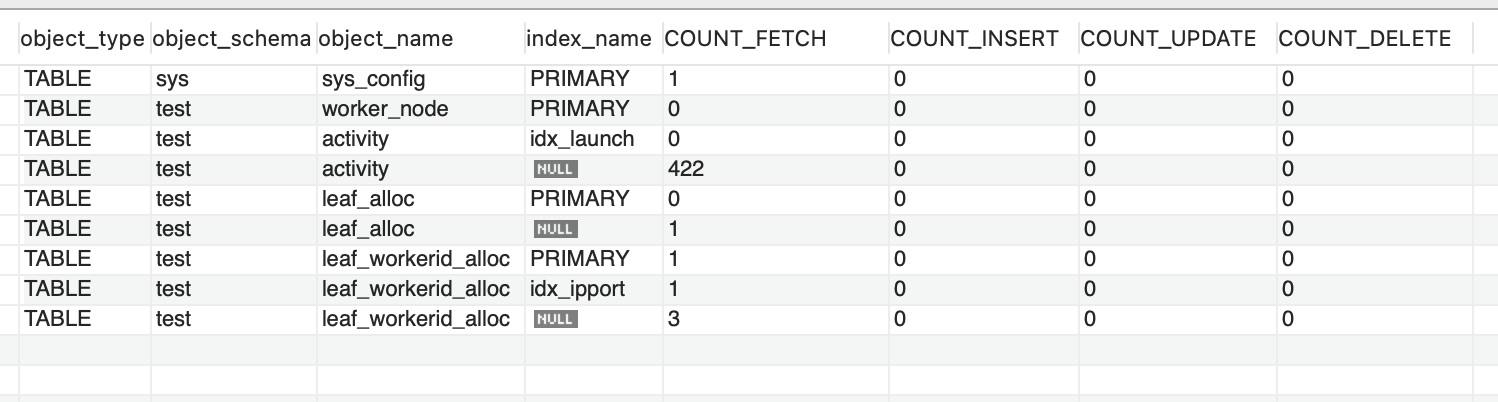
数据库设计的三大范式是什么?
MySQLWork
MySQL慢查询优化(线上案例调优)
文章说明
一.复杂的深分页问题优化
背景
SELECT
        a.*, c.*
FROM
        article a
LEFT JOIN content c ON a.id = c.article_id
WHERE
        a.author_id = 1111
AND a.create_time < '2020-04-29 00:00:00'
LIMIT 210000,100是否是联合索引的问题
article表的主键是id,author_id是一个普通索引
content表的主键是article_id直接查询法
select * from test where val=4 limit 300000,5;先查主键再join
select * from test a
inner join
(select id from test where val=4 limit 300000,5) as b
on a.id=b.id;Name Engine Row_format Rows Avg_Row_length article InnoDB Compact 2682682 266 content InnoDB Compact 2824768 16847 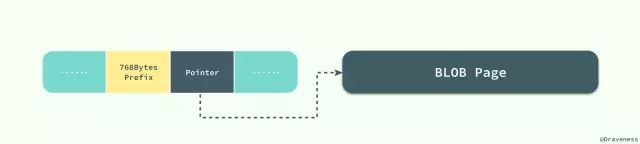
//查询时间0.51s
SELECT a.* FROM article a
WHERE a.author_id = 1111
AND a.create_time < '2020-04-29 00:00:00'
LIMIT 200100, 100SELECT SQL_NO_CACHE c.*
FROM article_content c
WHERE c.article_id in(100个article_id)解决方案
先查出主键id再inner join
SELECT
        a.*, c.*
FROM article a
INNER JOIN(
        SELECT  id FROM article a
        WHERE   a.author_id = 1111
        AND a.create_time < '2020-04-29 00:00:00'
        LIMIT 210000 ,
        100
) as temp_table ON a.id = temp_table.id
LEFT JOIN content c ON a.id = c.article_id
优化结果
利用范围查询条件来限制取出的数据
select * from test_table where id > min_id_value order by id limit 0, 100,就是即利用条件id > min_id_value在扫描索引是跳过10000条记录,然后取100条数据即可,这种处理方式的offset值便成为0了,但此种方式有限制,必须知道offset对应id,然后作为min_id_value,增加id > min_id_value的条件来进行过滤,如果是用于分页查找的话,也就是必须知道上一页的最大的id,所以只能一页一页得查,不能跳页,但是因为我们的业务需求就是每次100条数据,进行分批导数据,所以我们这种场景是可以使用。针对这种方法,我们的业务SQL改写如下://先查出最大和最小的id
SELECT min(a.id) as min_id , max(a.id) as max_id
FROM article a
WHERE a.author_id = 1111
AND a.create_time < '2020-04-29 00:00:00'
//然后每次循环查找
while(min_id<max_id) {
SELECT a.*, c.* FROM article a LEFT JOIN content c ON a.id = c.article_id WHERE a.author_id = 1111 AND a.id > min_id LIMIT 100
//这100条数据导入完毕后,将100条数据数据中最大的id赋值给min_id,以便导入下100条数据
}优化结果
二.联合索引问题优化
1.充分利用where条件,缩小范围
SELECT * FROM test WHERE a = 1 AND b = 22.避免回表(此时也叫覆盖索引)
SELECT a,b FROM test WHERE a = 1 AND b = 23.减少需要回表的数据的行数
SELECT * FROM test WHERE a > 1 AND b = 2SELECT
a.id as article_id ,
a.title as title ,
a.author_id as author_id
from
article a
where
a.create_time between '2020-03-29 03:00:00.003'
and '2020-04-29 03:00:00.003'
and a.status = 1SELECT
a.id as article_id ,
a.title as title ,
a.author_id as author_id
from
article a FORCE INDEX(idx_createTime)
where
  a.create_time between '2020-03-22 03:00:00.003'
and '2020-04-22 03:00:00.003'
and a.status = 1SELECT
a.id as article_id ,
a.title as title ,
a.author_id as author_id
from
article a FORCE INDEX(idx_createTime_status)
where
a.create_time between '2020-03-22 03:00:00.003'
and '2020-04-22 03:00:00.003'
and a.status = 1优化结果:
EXPLAIN的结果如下:
id type key key_len rows filtered Extra 1 range idx_createTime 4 311608 25.00 Using index condition; Using where 2 range idx_createTime_status 6 310812 100.00 Using index condition 原理分析
Using filesort
Using index
Using temporary
Using where
Using index condition
a.create_time between '2020-03-22 03:00:00.003' and '2020-04-22 03:00:00.003'条件的主键id,然后进行回表,因为idx_createTime索引中没有status的信息,只能回表后查出所有的主键id对应的行。然后innodb将结果集返回给MySQL Sever,MySQL Sever根据status字段进行过滤,筛选出status为1的字段,所以第一个查询的Explain结果中的Extra才会显示Using where。//查询结果行数是15万行左右
SELECT count(*) from article a
where a.post_time
between '2020-03-22 03:00:00.003' and '2020-04-22 03:00:00.003'
//查询结果行数是2万6行左右
SELECT count(*) from article a
where a.post_time
between '2020-03-22 03:00:00.003' and '2020-04-22 03:00:00.003'
and a.audit_status = 1发散思考:如果将联合索引(createTime,status)改成(status,createTime)会怎么样?
where
a.create_time between '2020-03-22 03:00:00.003'
and '2020-04-22 03:00:00.003'
and a.status = 1SELECT
a.id as article_id ,
a.title as title ,
a.author_id as author_id
from
article a FORCE INDEX(idx_status_createTime)
where
a.create_time between '2020-03-22 03:00:00.003'
and '2020-04-22 03:00:00.003'
and a.status = 1Explain结果对比:
id type key key_len rows filtered Extra 2 range idx_createTime_status 6 310812 100.00 Using index condition 3 range idx_status_createTime 6 52542 100.00 Using index condition
JavaJVM
1.Java内存区域怎么划分的?
2.Java中对象的创建过程是怎么样的?
3.Java对象的内存布局是怎么样的?
4.垃圾回收有哪些特点?
5.在垃圾回收机制中,对象在内存中的状态有哪几种?
6.对象的强引用,软引用,弱引用和虚引用的区别是什么?
7.双亲委派机制是什么?
8.怎么自定义一个类加载器?
9.垃圾回收算法有哪些?
10.Minor GC和Full GC是什么?
11.如何确定一个对象可以回收?
12.目前通常使用的是什么垃圾收集器?
Java内存区域怎么划分的?
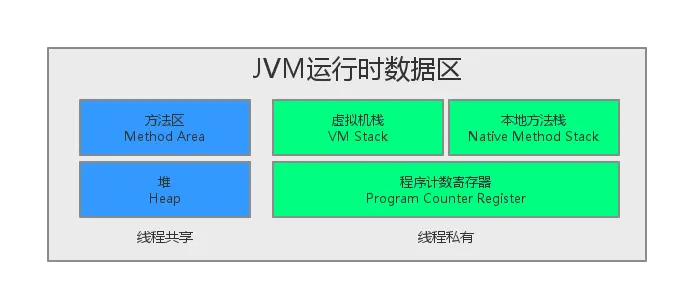
线程私用的部分(Java虚拟机栈,本地方法栈,程序计数器)
Java虚拟机栈
本地方法栈
程序计数器
线程共享的部分(堆,方法区)
Java 堆
方法区
直接内存区(不属于虚拟机运行时数据区)
Java中对象的创建过程是怎么样的?
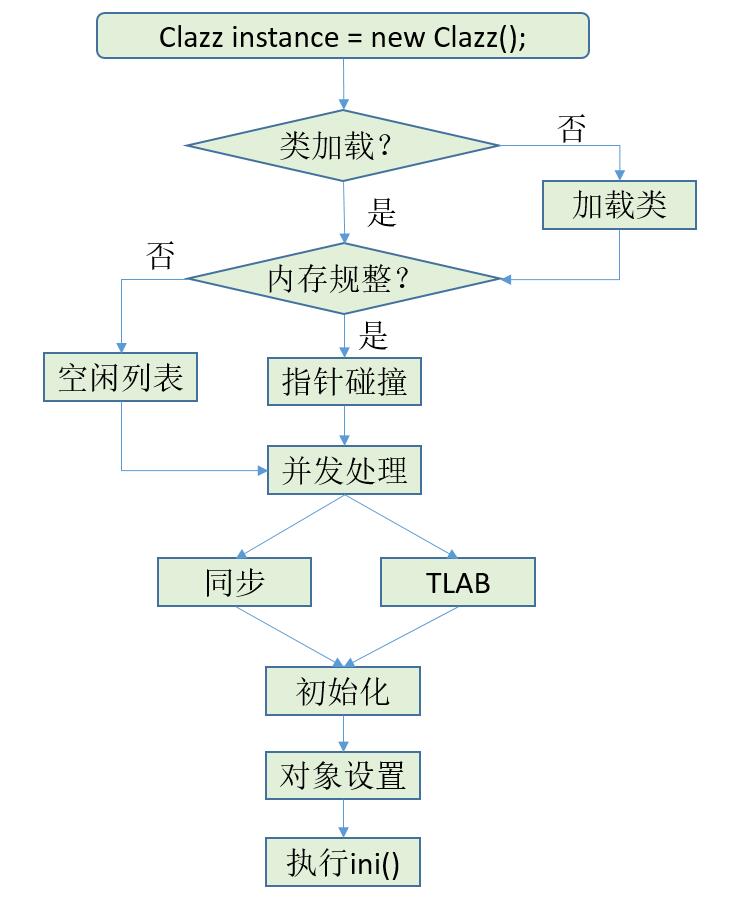
1.类加载检查
2.分配内存
指针碰撞
空闲列表
3.对象初始化(虚拟机层面)
4.对象初始化(Java程序层面)
PS:如何解决内存分配时的多线程并发竞争问题?
预先给各线程分配TLAB
Java对象的内存布局是怎么样的?
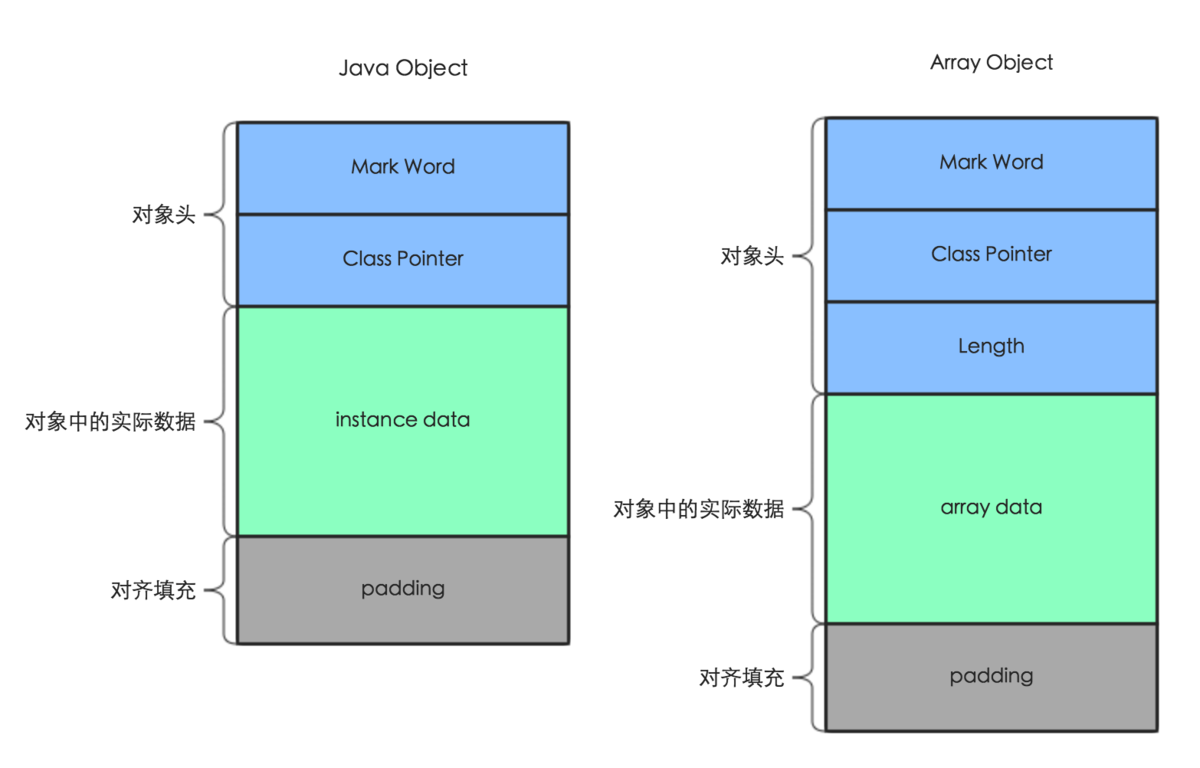
对象头

实例数据
对齐填充
如何计算一个对象在内存中占多少个字节?
垃圾回收有哪些特点?
在垃圾回收机制中,对象在内存中的状态有哪几种?
对象的强引用,软引用,弱引用和虚引用的区别是什么?
强引用
软引用
弱引用
虚引用
双亲委派机制是什么?
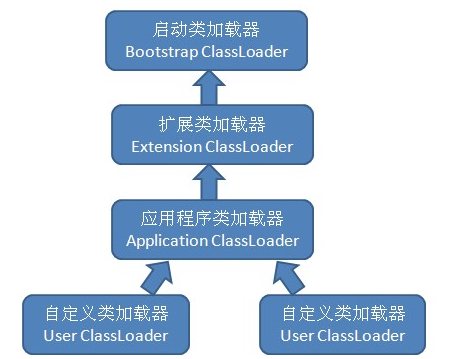
public abstract class ClassLoader {
    ...
    public Class<?> loadClass(String name) throws ClassNotFoundException {
        return loadClass(name, false);
    }
    protected Class<?> loadClass(String name, boolean resolve)
        throws ClassNotFoundException {
      	//使用synchronized加锁,保证不会重复加载
        synchronized (getClassLoadingLock(name)) {
          //判断这个类是否已加载
            Class<?> c = findLoadedClass(name);
            if (c == null) {
                ...
                try {
                    if (parent != null) {//有父类加载器,让父类加载器先尝试加载
                        c = parent.loadClass(name, false);
                    } else {
                        c = findBootstrapClassOrNull(name);
                    }
                } catch (ClassNotFoundException e) {
                }
								//使用当前类加载器进行类加载
                if (c == null) {
                    ...
                    c = findClass(name);
                    // do some stats
                    ...
                }
            }
            if (resolve) {
                resolveClass(c);
            }
            return c;
        }
    }
    protected Class<?> findClass(String name) throws ClassNotFoundException {
        throw new ClassNotFoundException(name);
    }
    ...
}
怎么自定义一个类加载器?
public class DelegationClassLoader extends ClassLoader {
  private String classpath;

  public DelegationClassLoader(String classpath, ClassLoader parent) {
    super(parent);
    this.classpath = classpath;
  }

  @Override
  protected Class<?> findClass(String name) throws ClassNotFoundException {
    InputStream is = null;
    try {
      String classFilePath = this.classpath + name.replace(".", "/") + ".class";
      is = new FileInputStream(classFilePath);
      byte[] buf = new byte[is.available()];
      is.read(buf);
      return defineClass(name, buf, 0, buf.length);
    } catch (IOException e) {
      throw new ClassNotFoundException(name);
    } finally {
      if (is != null) {
        try {
          is.close();
        } catch (IOException e) {
          throw new IOError(e);
        }
      }
    }
  }

  public static void main(String[] args)
      throws ClassNotFoundException, IllegalAccessException, InstantiationException,
      MalformedURLException {
    sun.applet.Main main1 = new sun.applet.Main();

    DelegationClassLoader cl = new DelegationClassLoader("java-study/target/classes/",
        getSystemClassLoader());
    String name = "sun.applet.Main";
    Class<?> clz = cl.loadClass(name);
    Object main2 = clz.newInstance();

    System.out.println("main1 class: " + main1.getClass());
    System.out.println("main2 class: " + main2.getClass());
    System.out.println("main1 classloader: " + main1.getClass().getClassLoader());
    System.out.println("main2 classloader: " + main2.getClass().getClassLoader());
    ClassLoader itrCl = cl;
    while (itrCl != null) {
      System.out.println(itrCl);
      itrCl = itrCl.getParent();
    }
  }
}
类加载的过程是什么样的?
类加载器
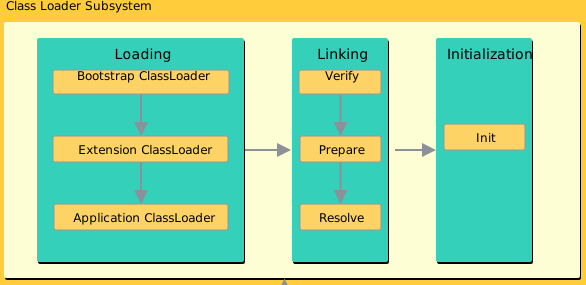
装载
类加载器分类
java.lang.ClassLoader 。负责加载核心 Java 库,启动类装载器通常使用某种默认的方式从本地磁盘中加载类,包括 Java API。<JAVA_HOME>/jre/lib/ext ,或 java.ext.dirs 中指明的目录中加载 Java 的扩展库。 Java 虚拟机的实现会提供一个扩展库目录。java.class.path 或 CLASSPATH 环境变量)来加载 Java 类。一般来说,Java 应用的类都是由它来完成加载的。可以通过 ClassLoader.getSystemClassLoader() 来获取它。java.lang.ClassLoader 类的方式实现自己的类加载器,以满足一些特殊的需求而不需要完全了解 Java 虚拟机的类加载的细节。全盘负责双亲委托机制
ClassLoader 装载一个类的时,除非显式地使用另一个 ClassLoader ,该类所依赖及引用的类也由这个 ClassLoader 载入。findClass(name) 方法;如果想破坏双亲委派模型,可以重写 loadClass(name) 方法。装载入口
SubClass.fatherStaticValue只会触发FatherClass的初始化,不会触发SubClass的初始化,因为fatherStaticValue是FatherClass的变量class SuperClass {
public static final String str = "hello";
}
//引用常量编译时会直接存入常量池
System.out.println(SuperClass.str);验证
准备
类型 默认值 int 0 long 0L short (short)0 char ’\u0000’ byte (byte)0 blooean false float 0.0f double 0.0d reference null 解析
类或接口的解析:判断所要转化成的直接引用是数组类型,还是普通的对象类型的引用,从而进行不同的解析。字段解析:对字段进行解析时,会先在本类中查找是否包含有简单名称和字段描述符都与目标相匹配的字段,如果有,则查找结束;如果没有,则会按照继承关系从上往下递归搜索该类所实现的各个接口和它们的父接口,还没有,则按照继承关系从上往下递归搜索其父类,直至查找结束,初始化
<clinit>。Object。这个特性可以用来写单例模式。
Clinit 方法
<clinit>()方法。如果类声明了类变量,但没有明确的使用类变量初始化语句或者静态代码块来初始化它们,也不会有<clinit>()方法。如果类仅包含静态final常量的类变量初始化语句,而且这些类变量初始化语句采用编译时常量表达式,类也不会有<clinit>()方法。只有那些需要执行Java代码来赋值的类才会有final常量:Java虚拟机在使用它们的任何类的常量池或字节码中直接存放的是它们表示的常量值。JVM 内存区域分布是什么样的?gc 发生在哪些部分?
虚拟机栈
本地方法栈
程序计数器
堆
方法区
垃圾回收算法有哪些?
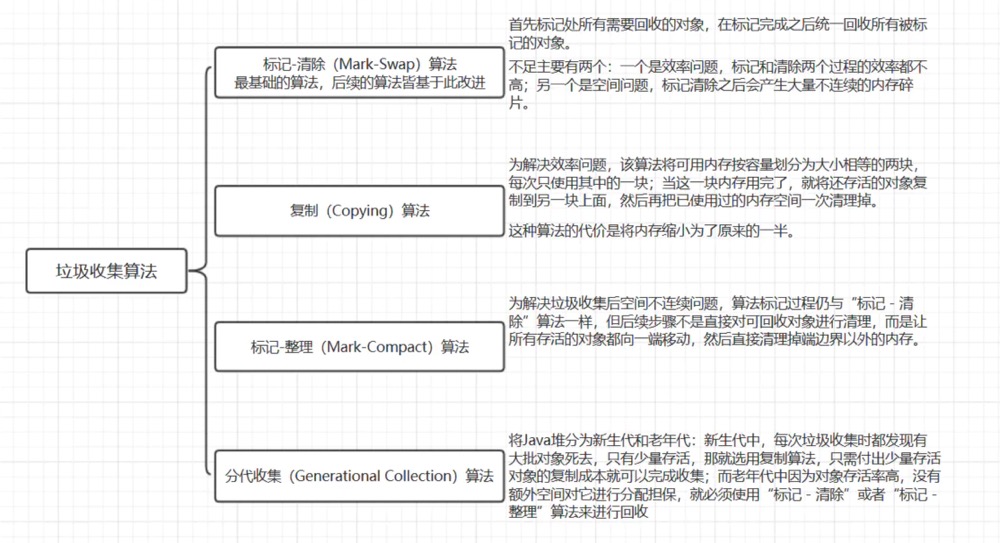
标记-清除算法(一般用于老年代)
标记-复制算法(一般用于新生代)
标记-整理算法(一般用于老年代)
分代收集算法
如何确定一个对象是否可以被回收?
内存分配策略有哪些?
内存划分策略:
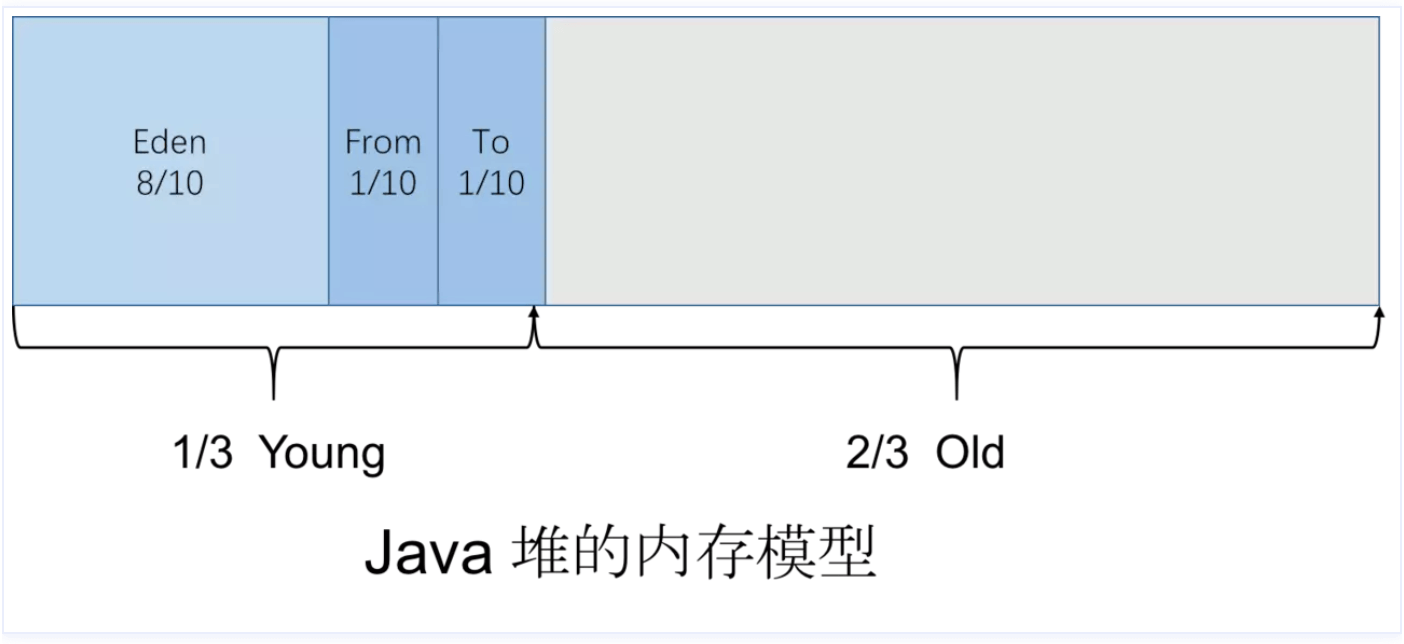
新生代
老年代
内存分配策略:
MinorGC和FullGC是什么?
触发Minor GC的条件有哪些?
2020-05-12T16:15:10.736+0800: 7.803: [GC (Allocation Failure) 2020-05-12T16:15:10.736+0800: 7.803: [ParNew: 838912K->22016K(943744K), 0.0982676 secs] 838912K->22016K(1992320K), 0.0983280 secs] [Times: user=0.19 sys=0.01, real=0.10 secs]触发Full GC的条件有哪些?
1.system.gc()
2.方法区空间不足
3.老年代空间不足
垃圾收集器有哪些?
垃圾收集器 特点 算法 适用内存区域 Serial 单个GC线程进行垃圾回收,简单高效 标记-复制 新生代 Serial Old 单个GC线程进行垃圾回收 标记-整理 老年代 ParNew 是Serial的改进版,就是可以多个GC线程一起进行垃圾回收 标记-复制 新生代 Parallel Scanvenge收集器(吞吐量优先收集器) 高吞吐量,吞吐量=执行用户线程的时间/CPU执行总时间 标记-复制 新生代 Parallel Old收集器 支持多线程收集 标记-整理 老年代 CMS收集器(并发低停顿收集器) 低停顿 标记-清除+标记-整理 老年代 G1收集器 低停顿,高吞吐量 标记-复制算法 老年代,新生代 Serial收集器(标记-复制算法)
Serial Old收集器(标记-整理算法)
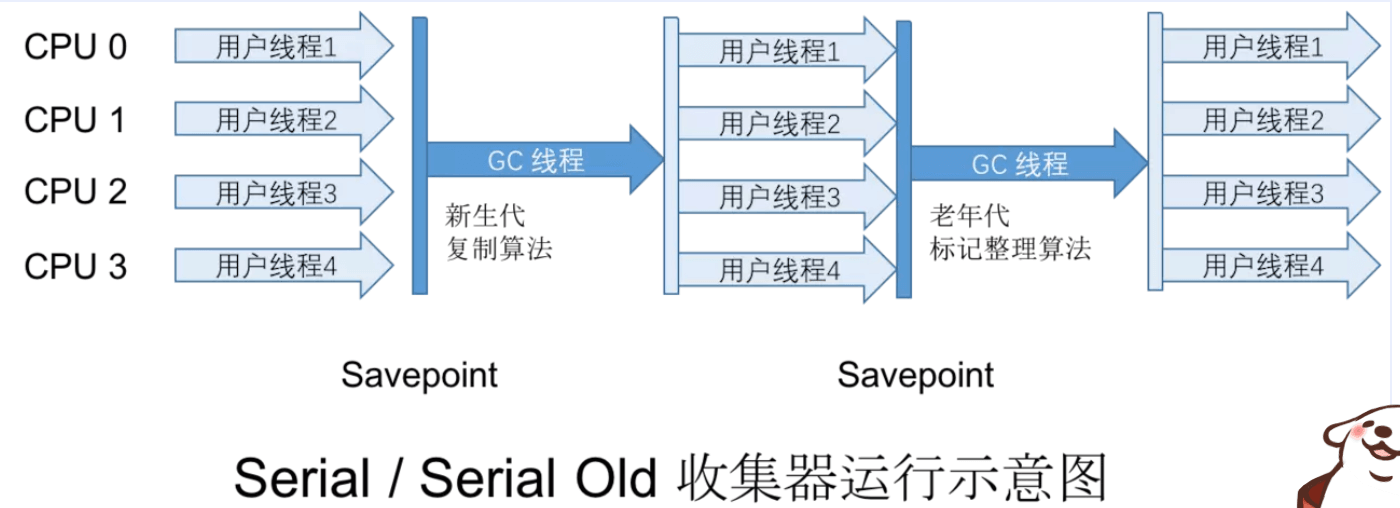
ParNew收集器(标记-复制算法)
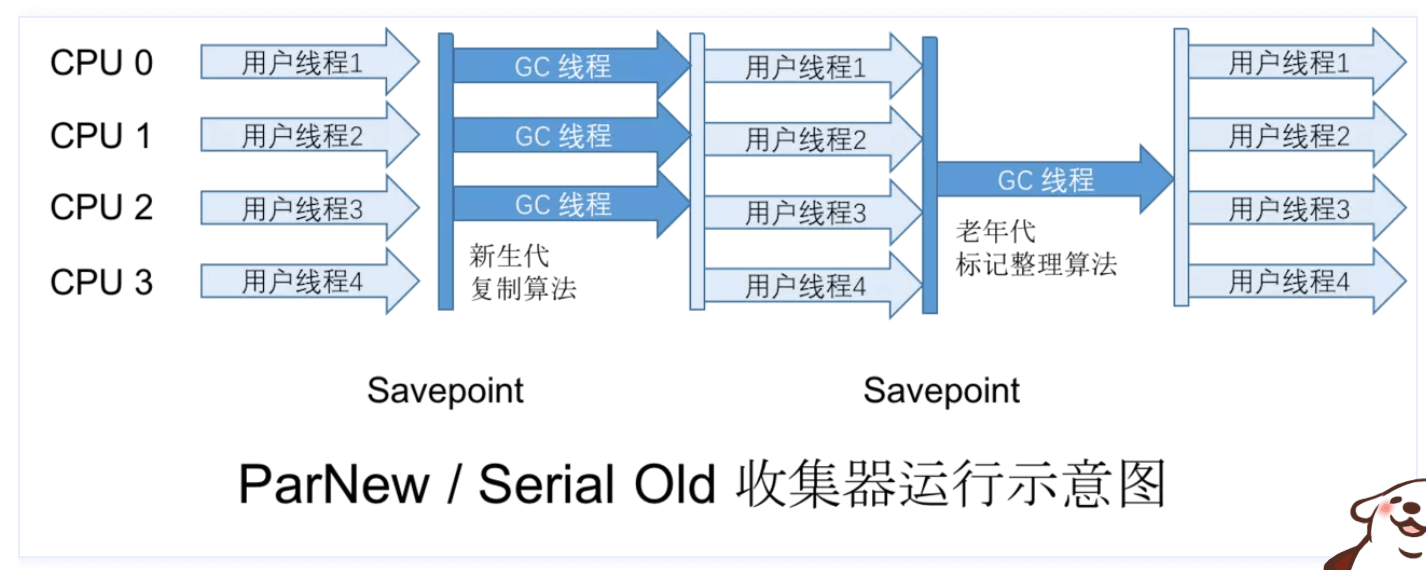
Parallel Scanvenge收集器(吞吐量优先收集器)
Parallel Old收集器
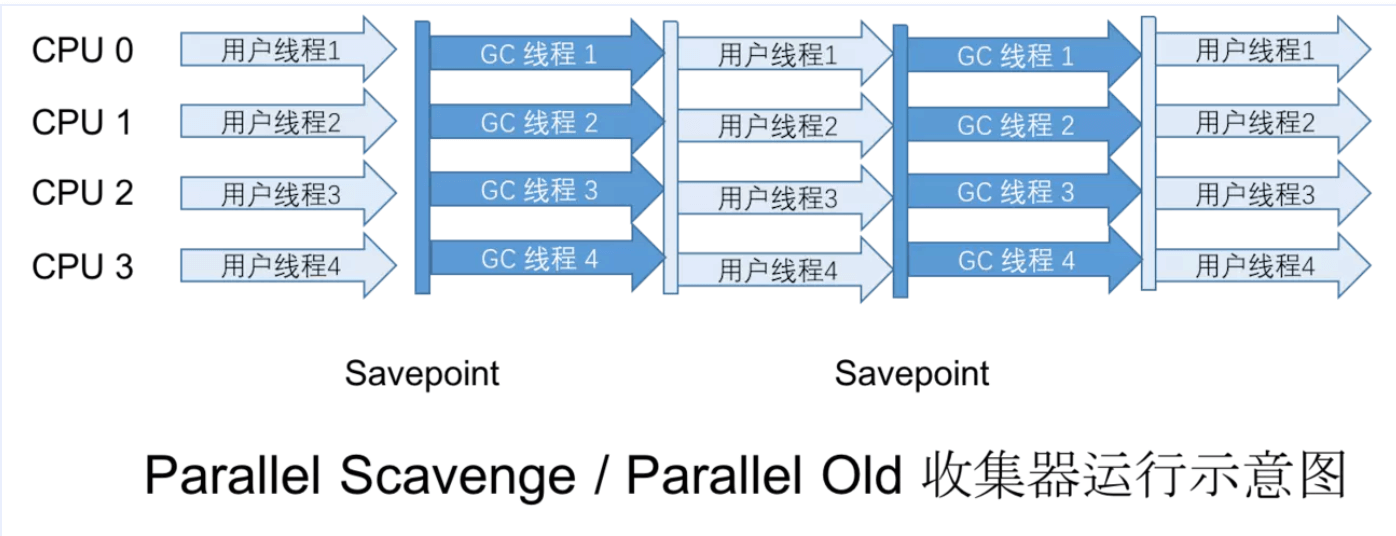
CMS 收集器(老年代并发低停顿收集器)
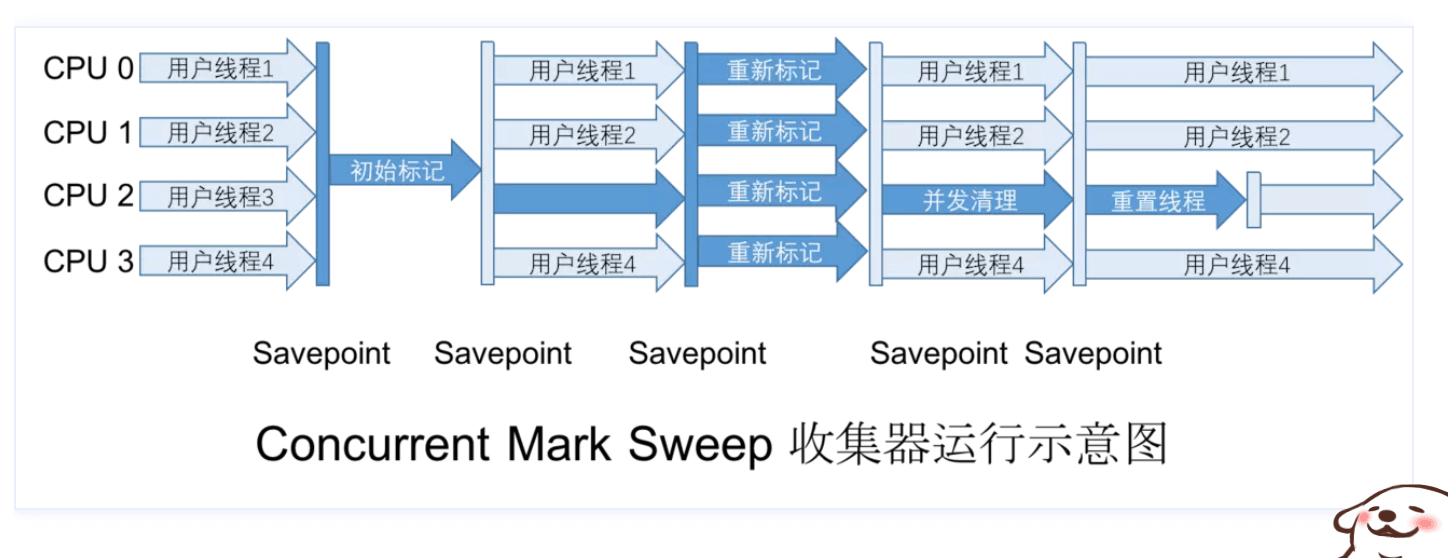
1.初始标记
2.并发标记(可以与用户线程并发执行)
执行流程:
三色标记法的一些问题:
1.对于多标的情况,会生成浮动垃圾
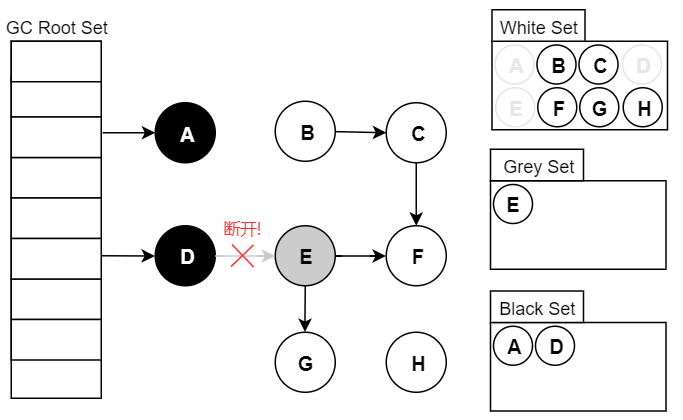 对于这种多标的情况,对象E/F/G是“应该”被回收的。然而因为E已经变为灰色了,其仍会被当作存活对象继续遍历下去。最终的结果是:这部分对象仍会被标记为存活,即本轮GC不会回收这部分内存。
这部分本应该回收 但是 没有回收到的内存,被称之为“浮动垃圾”。浮动垃圾并不会影响垃圾回收的正确性,只是需要等到下一轮垃圾回收中才被清除。
另外,针对并发标记开始后的新对象,通常的做法是直接全部当成黑色,本轮不会进行清除。这部分对象期间可能会变为垃圾,这也算是浮动垃圾的一部分。
2.对于引用变动后导致漏标情况的处理
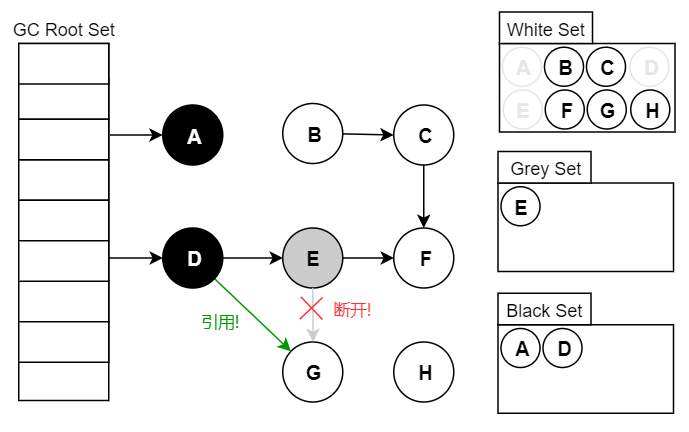
增量更新法
原始快照法
3.重新标记
4.并发清除
G1收集器(Garbage First收集器,标记-整理算法,老年代,新生代都进行回收)
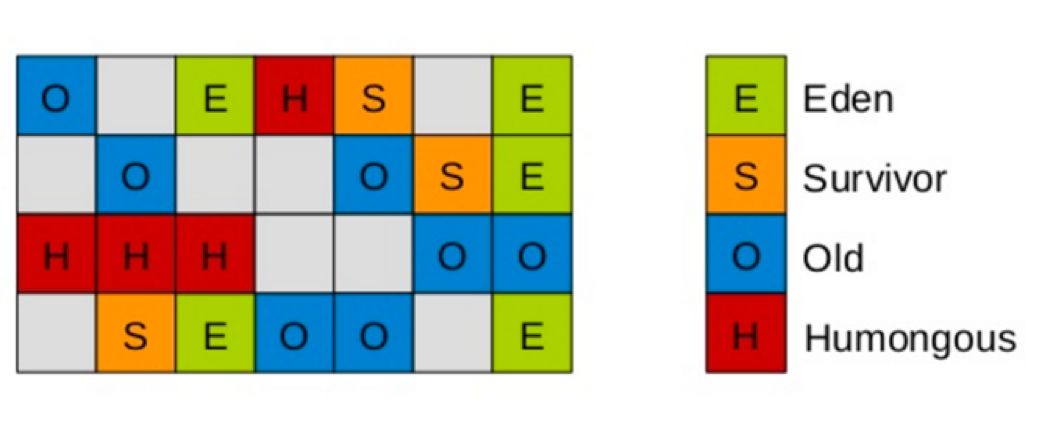
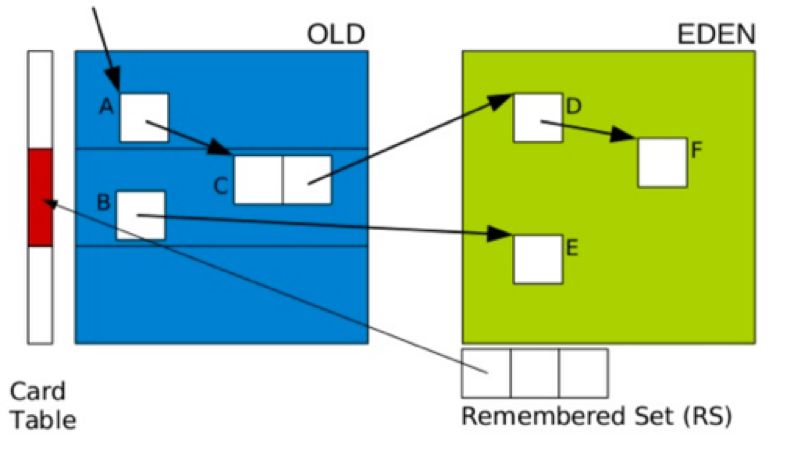
Region如何解决跨代指针?
由于新生代有多个,那么我们需要在新生代之间记录引用吗?
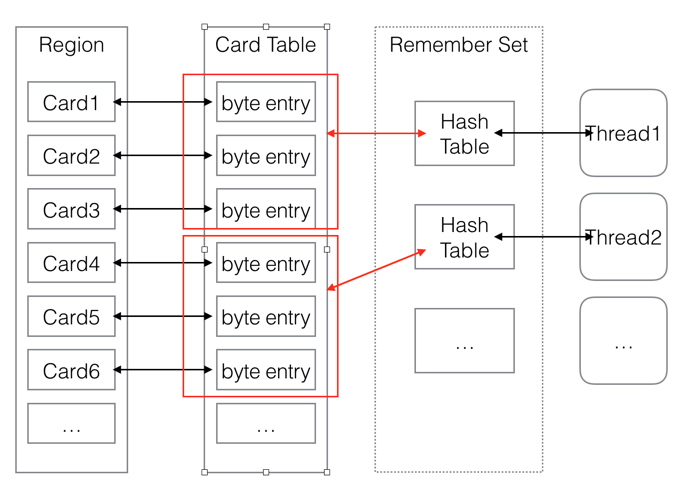
在此阶段,G1 GC 对根进行标记。该阶段与常规的(STW) 新生代垃圾回收密切相关。 G1 GC 在初始标记的存活区扫描对老年代的引用,并标记被引用的对象。该阶段与应用程序(非 STW)同时运行,并且只有完成该阶段后,才能开始下一次 STW 新生代垃圾回收。 G1 GC 在整个堆中查找可访问的(存活的)对象。该阶段与应用程序同时运行,可以被 STW 新生代垃圾回收中断 该阶段是 STW 回收,帮助完成标记周期。G1 GC清空 SATB 缓冲区,跟踪未被访问的存活对象,并执行引用处理。 在这个最后阶段,G1 GC 执行统计和 RSet 净化的 STW 操作。在统计期间,G1 GC 会识别完全空闲的区域和可供进行混合垃圾回收的区域。清理阶段在将空白区域重置并返回到空闲列表时为部分并发。收集步骤:
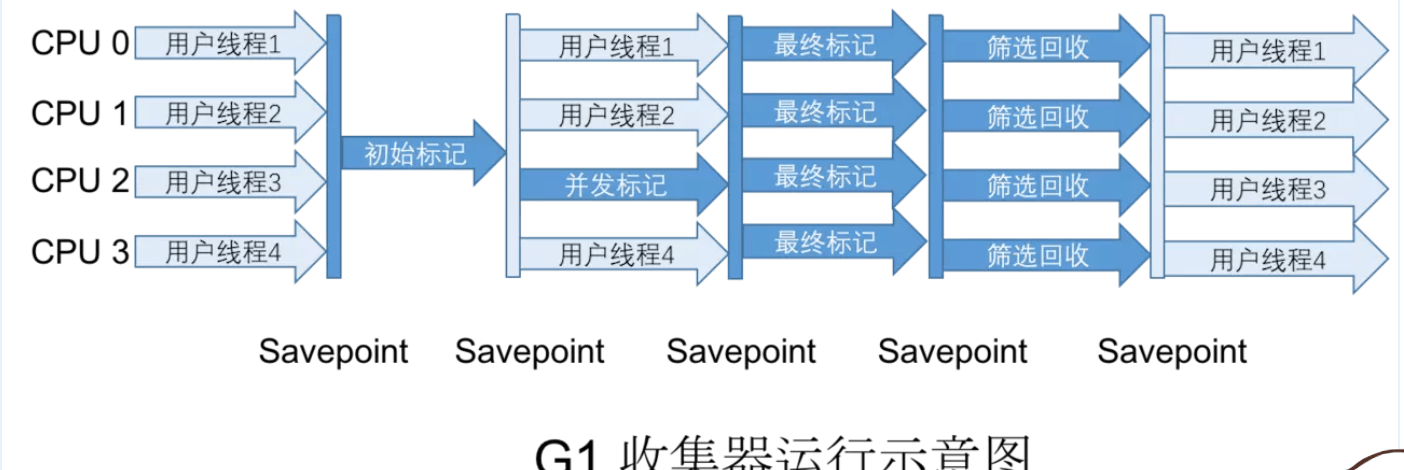
三色标记法,引用计数, Mark-Sweep法(标记清除法)三者的区别?
垃圾收集器相关的参数
目前通常使用的是什么垃圾收集器?
怎么查询当前JVM使用的垃圾收集器?
java -XX:+PrintCommandLineFlags -versionjava -XX:+PrintFlagsFinal -version | grep GC-XX:InitialHeapSize=134217728 -XX:MaxHeapSize=2147483648 -XX:+PrintCommandLineFlags -XX:+UseCompressedClassPointers -XX:+UseCompressedOops -XX:+UseParallelGC
java version "1.8.0_73"
Java(TM) SE Runtime Environment (build 1.8.0_73-b02)
Java HotSpot(TM) 64-Bit Server VM (build 25.73-b02, mixed mode)Parallel Scavenge+Serial Old
ParNew+CMS
G1
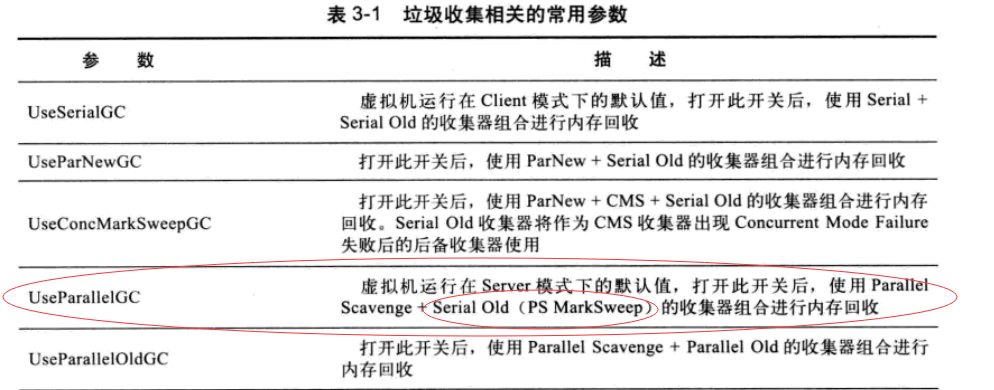
容器的内存和 jvm 的内存有什么关系?参数怎么配置?
-XX:+UnlockExperimentalVMOptions
-XX:+UseCGroupMemoryLimitForHeap
-XX:MaxRAMFraction=2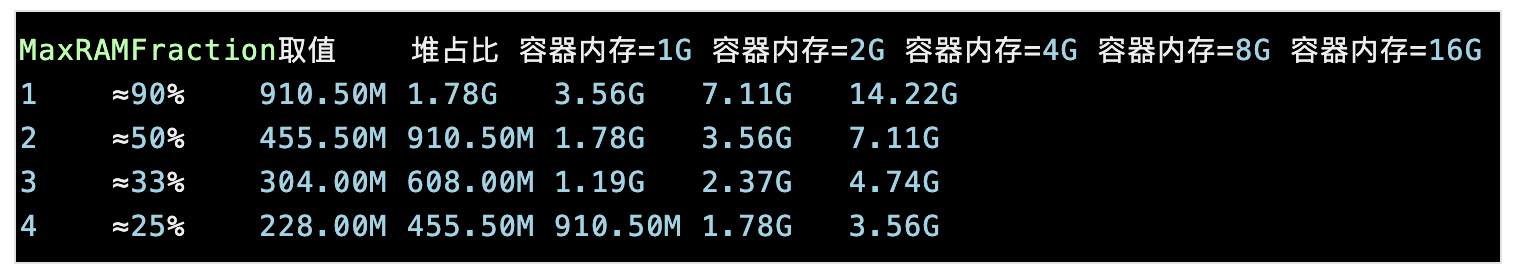
如何大体估算java进程使用的内存呢?
怎么获取 dump 文件?怎么分析?
//出现 OOME 时生成堆 dump:
-XX:+HeapDumpOnOutOfMemoryError
//生成堆文件地址:
-XX:HeapDumpPath=/home/liuke/jvmlogs/jmap -dump:format=b,file=/home/admin/logs/heap.hprof 6214jvisualvm命令打开使用Java自带的工具Java VisualVM来打开heap.hprof文件,就可以分析你的Java线程里面对象占用堆内存的情况了gc日志怎么看?
-XX:+PrintGCDetails
-XX:+PrintGCDateStamps
-Xloggc:/var/log/gc.log
2020-05-07T16:28:02.845+0800: 78210.469: [GC (Allocation Failure) 2020-05-07T16:28:02.845+0800: 78210.469: [ParNew: 68553K->466K(76672K), 0.0221963 secs] 131148K->63062K(2088640K), 0.0223082 secs] [Times: user=0.02 sys=0.00, real=0.02 secs] 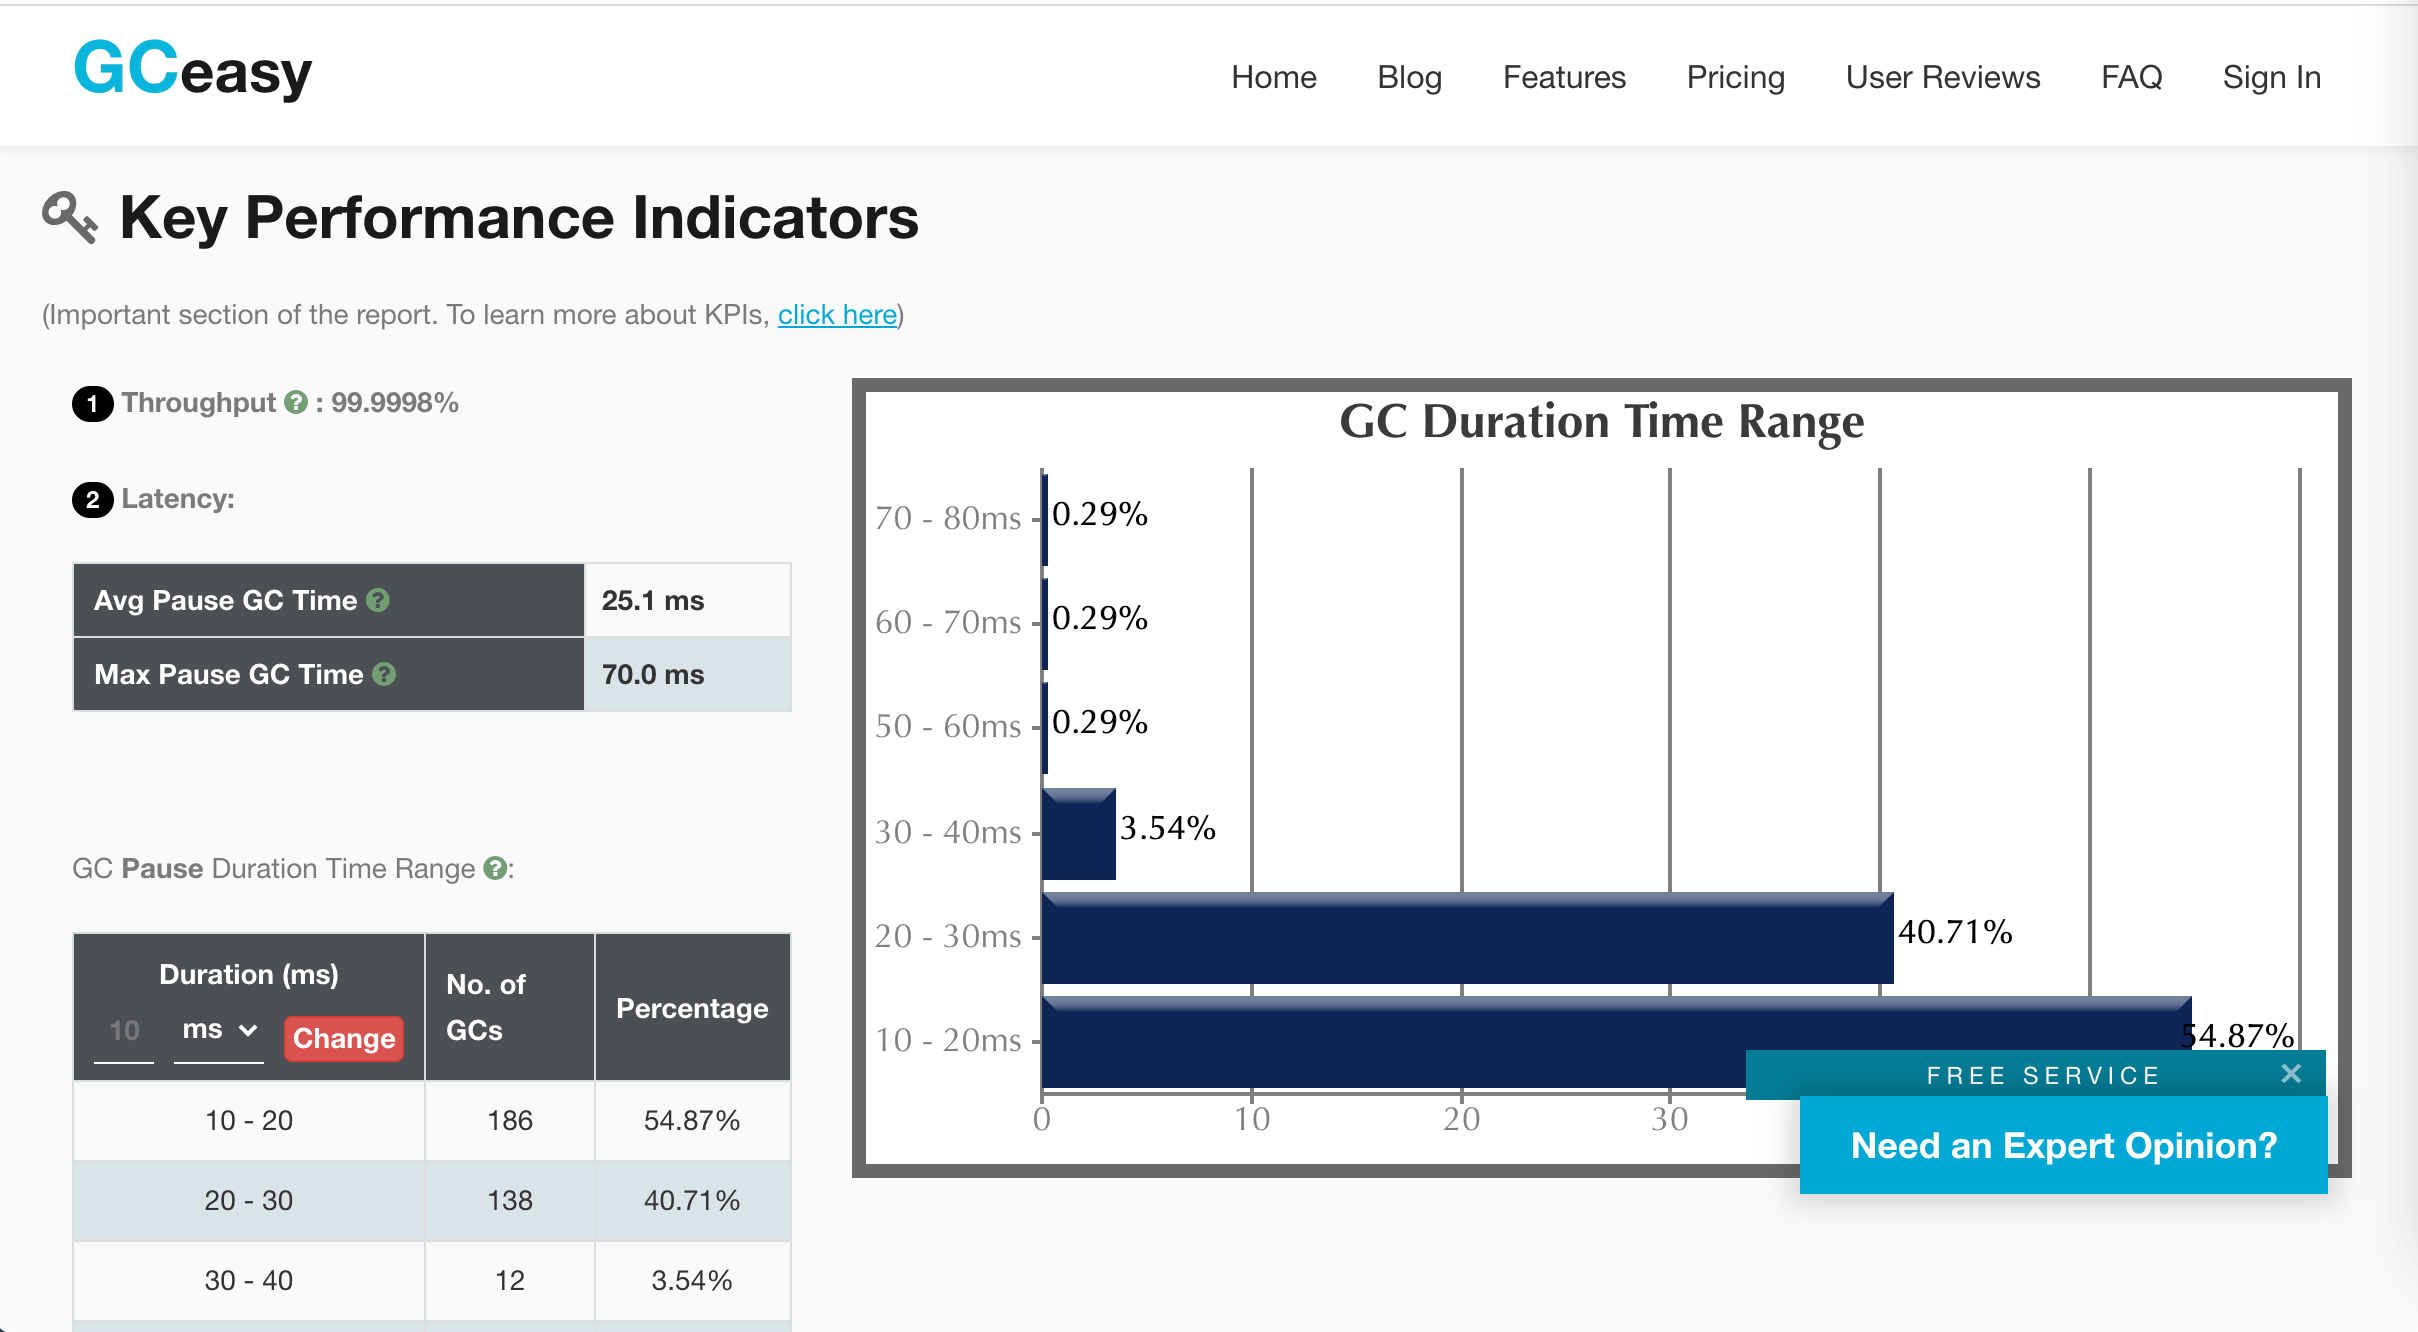
cpu 使用率特别高,怎么排查?通用方法?定位代码?cpu高的原因?
jstat -gcutil 29530 1000 10
垃圾回收信息统计,29530是pid,1000是每1秒打印一次最新信息,10是最多打印10次怎么排查CPU占用率过高的问题?
top命令查看CPU占用率高的进程的pid。top - 15:10:32 up 523 days, 3:47, 1 user, load average: 0.00, 0.01, 0.05
Tasks: 95 total, 1 running, 94 sleeping, 0 stopped, 0 zombie
%Cpu(s): 1.7 us, 0.5 sy, 0.0 ni, 95.7 id, 2.2 wa, 0.0 hi, 0.0 si, 0.0 st
KiB Mem : 16267904 total, 6940648 free, 2025316 used, 7301940 buff/cache
KiB Swap: 16777212 total, 16776604 free, 608 used. 13312484 avail Mem
PID USER PR NI VIRT RES SHR S %CPU %MEM TIME+ COMMAND
14103 hadoop 20 0 2832812 203724 18392 S 3.7 1.3 977:08.04 java
14010 hadoop 20 0 2897344 285392 18660 S 0.3 1.8 513:30.49 java
14284 hadoop 20 0 3052556 340436 18636 S 0.3 2.1 1584:47 java
14393 hadoop 20 0 2912460 504112 18632 S 0.3 3.1 506:43.68 java
1 root 20 0 190676 3404 2084 S 0.0 0.0 4:31.47 systemd
2 root 20 0 0 0 0 S 0.0 0.0 0:04.77 kthreadd
3 root 20 0 0 0 0 S 0.0 0.0 0:10.16 ksoftirqd/0top -Hp 进程id获得该进程下各个线程的CPU占用情况,找到占用率最高的线程的pid2,
使用printf "%x\n" pid2命令将pid2转换为16进制的数number。top - 15:11:01 up 523 days, 3:48, 1 user, load average: 0.00, 0.01, 0.05
Threads: 69 total, 0 running, 69 sleeping, 0 stopped, 0 zombie
%Cpu(s): 12.8 us, 0.1 sy, 0.0 ni, 87.0 id, 0.1 wa, 0.0 hi, 0.0 si, 0.0 st
KiB Mem : 16267904 total, 6941352 free, 2024612 used, 7301940 buff/cache
KiB Swap: 16777212 total, 16776604 free, 608 used. 13313188 avail Mem
PID USER PR NI VIRT RES SHR S %CPU %MEM TIME+ COMMAND
14393 hadoop 20 0 2912460 504112 18632 S 0.0 3.1 0:00.01 java
14411 hadoop 20 0 2912460 504112 18632 S 0.0 3.1 0:01.95 java
14412 hadoop 20 0 2912460 504112 18632 S 0.0 3.1 0:16.18 java
14413 hadoop 20 0 2912460 504112 18632 S 0.0 3.1 0:12.79 java
14414 hadoop 20 0 2912460 504112 18632 S 0.0 3.1 8:09.10 javajstack pid获得进程下各线程的堆栈信息,nid=0xnumber的线程即为占用率高的线程,查看它是在执行什么操作。(jstack 5521 | grep -20 0x1596可以获得堆栈信息中,会打印匹配到0x1596的上下20行的信息。)"GC task thread#0 (ParallelGC)" os_prio=0 tid=0x00007f338c01f000 nid=0x1593 runnableJVM相关的异常
1.stackoverflow
JVM调优有哪些工具?
jstat
//5828是java进程id,1000是打印间隔,每1000毫秒打印一次,100是总共打印100次
jstat -gc 5828 1000 100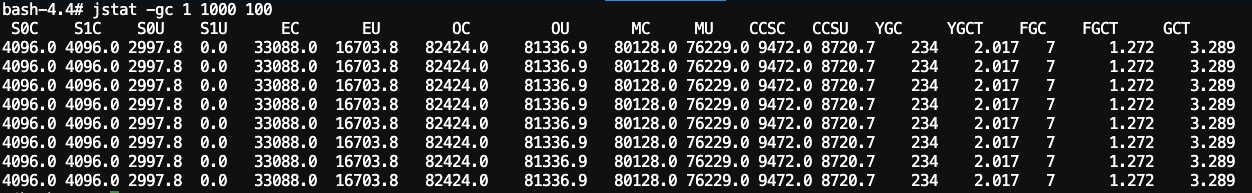
S0C 新生代中第一个survivor(幸存区)的总容量 (字节) S1C 新生代中第二个survivor(幸存区)的总容量 (字节) S0U 新生代中第一个survivor(幸存区)目前已使用空间 (字节) S1U 新生代中第二个survivor(幸存区)目前已使用空间 (字节) EC 新生代中Eden区的总容量 (字节) EU 新生代中Eden区目前已使用空间 (字节) OC 老年代的总容量 (字节) OU 老年代代目前已使用空间 (字节) YGC 目前新生代垃圾回收总次数 YGCT 目前新生代垃圾回收总消耗时间 FGC 目前full gc次数总次数FGCT 目前full gc次数总耗时,单位是秒GCT 垃圾回收总耗时jstat -gcutil <pid>:统计gc信息,这样打印出来的结果是百分比,而不是实际使用的空间,例如jstat -gcutil 1 1000 100
参数 描述 S0 年轻代中第一个survivor(幸存区)已使用的占当前容量百分比 s1 年轻代中第二个survivor(幸存区)已使用的占当前容量百分比 E 年轻代中Eden已使用的占当前容量百分比 O old代已使用的占当前容量百分比 M 元空间(MetaspaceSize)已使用的占当前容量百分比 CCS 压缩使用比例 YGC 年轻代垃圾回收次数 FGC 老年代垃圾回收次数 FGCT 老年代垃圾回收消耗时间 GCT 垃圾回收消耗总时间 
jstack
jstack -l 进程id ,-l代表除了堆栈信息外,还会打印锁的附加信息。jstack还会检测出死锁信息。一般可以用于定位线程长时间停顿,线程间死锁等问题。public static void main(String[] args) {
final Integer lock1 = new Integer(1);
final String lock2 = new String();
ExecutorService executorService = Executors.newCachedThreadPool();
executorService.execute(new Runnable() {
@Override
public void run() {
synchronized (lock1) {
System.out.println("线程1获得了lock1");
try {
Thread.sleep(1000);
} catch (InterruptedException e) {
e.printStackTrace();
}
System.out.println("线程1休眠结束");
System.out.println("线程1开始尝试获取lock2");
synchronized (lock2) {
System.out.println("线程1获得了lock2");
}
}
}
});
executorService.execute(new Runnable() {
@Override
public void run() {
synchronized (lock2) {
System.out.println("线程2获得了lock2");
System.out.println("线程2开始尝试获取lock1");
synchronized (lock1) {
System.out.println("线程2获得了lock2");
}
}
}
});
}jstack -l 进程id就可以打印出当前的线程信息
jmap
jmap -heap
jmap -heap 进程id可以打印出当前堆各分区内存使用情况的情况,新生代(Eden区,To Survivor区,From Survivor区),老年代区的内存使用情况。
jmap -histo
instances列:表示当前类有多少个实例。
bytes列:说明当前类的实例总共占用了多少个字节
class name列:表示的就是当前类的名称,class name 对于基本数据类型,使用的是缩写。解读:B代表byte ,C代表char ,D代表double, F代表float,I代表int,J代表long,Z代表boolean
前边有[代表数组,[I 就相当于int[]
对象数组用`[L+类名`表示 
jmap -dump
jmap -dump:format=b,file=dump.hprof 进程id可以生成当前的堆栈快照,堆快照和对象统计信息,对生成的堆快照进行分析,可以分析堆中对象所占用内存的情况,检查大对象等。执行jvisualvm命令打开使用Java自带的工具Java VisualVM来打开堆栈快照文件,进行分析。可以用于排查内存溢出,内存泄露问题。在Java VisualVM里面可以看到每个类的实例对象占用的内存大小,以及持有这个对象的实例所在的类等等信息。//出现 OOM 时生成堆 dump:
-XX:+HeapDumpOnOutOfMemoryError
//生成堆文件地址:
-XX:HeapDumpPath=/home/liuke/jvmlogs/public class Test018 {
ArrayList<TestObject> arrayList = new ArrayList<TestObject>();
public static void main(String[] args) {
Test018 test018 =new Test018();
Random random = new Random();
for (int i = 0; i < 10000000; i++) {
TestObject testObject = new TestObject();
test018.arrayList.add(testObject);
}
}
private static class TestObject {
public byte[] placeholder = new byte[64 * 1024];//每个变量是64k
}
}
-Xms20m -Xmx20m -verbose:gc -XX:+PrintGCDetails -XX:+HeapDumpOnOutOfMemoryError -XX:HeapDumpPath=/存放路径/heapdump.hprof
MAT
public class Test018 {
static ArrayList<TestObject> arrayList = new ArrayList<TestObject>();
public static void main(String[] args) {
Random random = new Random();
for (int i = 0; i < 10000000; i++) {
TestObject testObject = new TestObject();
Test018.arrayList.add(testObject);
}
}
private static class TestObject {
public byte[] placeholder = new byte[64 * 1024];
}
}
happens-before指的是什么?
Kafka
kafka的工作流程是怎么样的?
注意事项:
怎么防止Kafka 丢数据?
Kafka 某个 broker 宕机,然后重新选举 partition 的 leader 。大家想想,要是此时其他的 follower 刚好还有些数据没有同步,结果此时 leader 挂了,然后选举某个 follower 成 leader 之后,不就少了一些数据?这就丢了一些数据啊。topic 设置 replication.factor 参数:这个值必须大于 1,要求每个 partition 必须有 至少 2 个副本。Kafka 服务端设置 min.insync.replicas 参数:这个值必须大于 1,这个是 要求一个 leader 至少感知到有至少一个 follower 还跟自己保持联系,没掉队,这样才能确保 leader 挂了还有一个 follower 吧。producer 端设置 acks=all:这个是要求每条数据,必须是写入所有 replica 之后,才能认为是写成功了。producer 端设置 retries=MAX(很大很大很大的一个值,无限次重试的意思):这个是要求一旦写入失败,就无限重试,卡在这里了。broker 端就可以保证在leader 所在 broker 发生故障,进行leader 切换时,数据不会丢失。生产者会不会弄丢数据?
acks=all,一定不会丢,要求是,你的 leader 接收到消息,所有的follower 都同步到了消息之后,才认为本次写成功了。如果没满足这个条件,生产者可以自动不断的重试,重试无限次。怎么实现 Exactly-Once?
生产端幂等性发送
Producer ID(即PID)和Sequence Number。每个新的Producer在初始化的时候会被分配一个唯一的PID,该PID对用户完全透明而不会暴露给用户。<Topic, Partition>都对应一个从0开始单调递增的Sequence Number。<PID, Topic, Partition>维护一个序号,并且每次Commit一条消息时将其对应序号递增。对于接收的每条消息,如果其序号比Broker维护的序号(即最后一次Commit的消息的序号)大一,则Broker会接受它,否则将其丢弃:InvalidSequenceNumberDuplicateSequenceNumber消费端幂等性
事务性保证
<Topic, Partition>的Exactly Once语义。<Topic, Partition>。Transaction ID。Transactin ID与PID可能一一对应。区别在于Transaction ID由用户提供,而PID是内部的实现对用户透明。Transaction ID的Producer即失效,每次Producer通过Transaction ID拿到PID的同时,还会获取一个单调递增的epoch。由于旧的Producer的epoch比新Producer的epoch小,Kafka可以很容易识别出该Producer是老的Producer并拒绝其请求。Transaction ID后,Kafka可保证:Transaction ID的新的Producer实例被创建且工作时,旧的且拥有相同Transaction ID的Producer将不再工作。消息队列的使用场景有哪些?
MQ缺点
A 系统调用 BCD 三个系统的接口就好了, ABCD 四个系统好好的,没啥问题,你偏加个 MQ 进来,万一 MQ 挂了咋整,MQ 一挂,整套系统崩溃的,你不就完了?如何保证消息队列的高可用。MQ 进来,你怎么保证消息没有重复消费?怎么处理消息丢失的情况?怎么保证消息传递的顺序性?头大头大,问题一大堆,痛苦不已。A 系统处理完了直接返回成功了,人都以为你这个请求就成功了;但是问题是,要是 BCD 三个系统那里, BD 两个系统写库成功了,结果 C 系统写库失败了,咋整?你这数据就不一致了。ISR是什么?
什么是零拷贝技术?
read()和write()
2.MMAP和write()
mmap
write
sendfile
总结:
Kafka刷盘时机是怎么样的?
Kafka什么时候进行rebalance?
kafka 1.1的优化
Kafka2.3对reblance的优化
kafka的选举机制
ZooKeeper
1.Zookeeper是怎么进行选举的?
Zookeeper是怎么进行选举的?
节点的状态
全新的集群leader选举
非全新的集群leader选举
基本原则是
投票阶段
1.初始化选票
2.处理选票信息
3.统计选票
4.发现阶段
5.同步阶段
原子广播阶段
Zookeeper工作流程?
分布式
分布式锁
HTTP
1.HTTPS建立连接的过程是怎么样的?
2.HTTP的缓存策略是怎么样的?
3. TCP三次握手和四次挥手是怎么样的?
4.TCP怎么保证可靠性的?
5.TCP拥塞控制怎么实现?
6.close_wait太多怎么处理?
HTTPS建立连接的过程是怎么样的?

HTTP的缓存策略是怎么样的?
强缓存
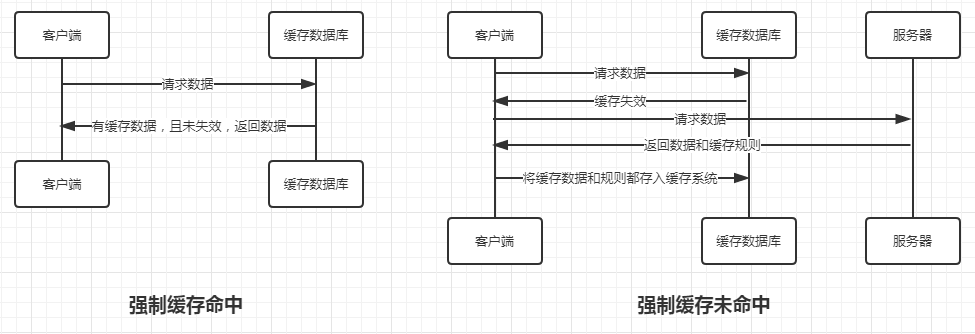
- max-age:即最大有效时间
- no-cache:表示没有缓存,即告诉浏览器该资源并没有设置缓存
- s-maxage:同max-age,但是仅用于共享缓存,如CDN缓存
- public:多用户共享缓存,默认设置
- private:不能够多用户共享,HTTP认证之后,字段会自动转换成private。
对比缓存
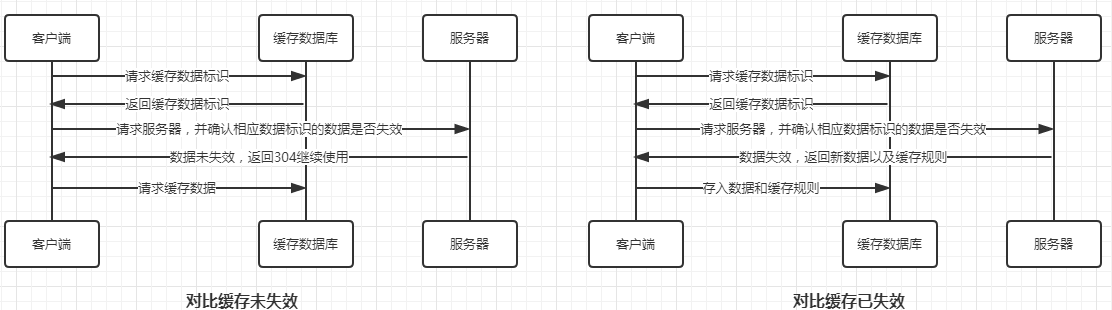
Last-Modified/If-Modified-Since
Etag/If-None-Match
优先级
TCP三次握手和四次挥手是怎么样的?
三次握手:
四次挥手
TCP怎么保证可靠性的?
流量控制是怎么实现的?
TCP拥塞控制怎么实现?
close_wait太多怎么处理?
time_wait太多是怎么造成的?
net.ipv4.tcp_syncookies = 1 表示开启SYN Cookies。当出现SYN等待队列溢出时,启用cookies来处理,可防范少量SYN攻击,默认为0,表示关闭;
net.ipv4.tcp_tw_reuse = 1 表示开启重用。允许将TIME-WAIT sockets重新用于新的TCP连接,默认为0,表示关闭;
net.ipv4.tcp_tw_recycle = 1 表示开启TCP连接中TIME-WAIT sockets的快速回收,默认为0,表示关闭。
net.ipv4.tcp_fin_timeout 修改系默认的 TIMEOUT 时间HTTP/2 有哪些新特性?
1.二进制传输
2.Header 压缩
3.多路复用
4.Server Push
5.提高安全性
HTTP报文结构是怎么样的?
请求报文
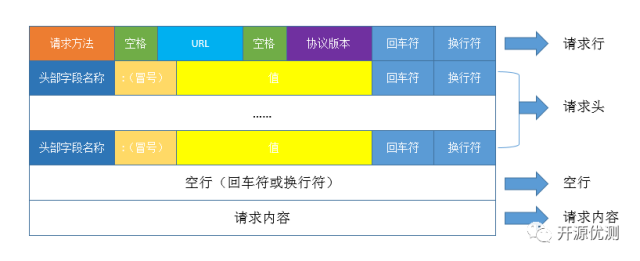
请求行
请求头
* 用于按范围将类型分组。*/*表示可接受全部类型,type/*表示可接受type类型的所有子类型。空行
请求内容
响应报文
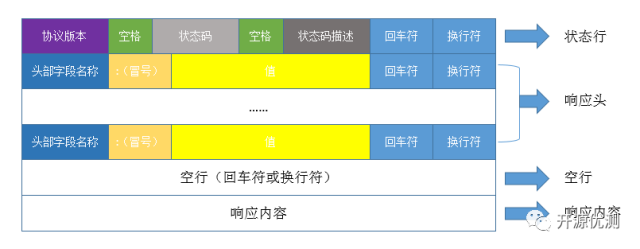
状态行
响应头
空行
响应内容
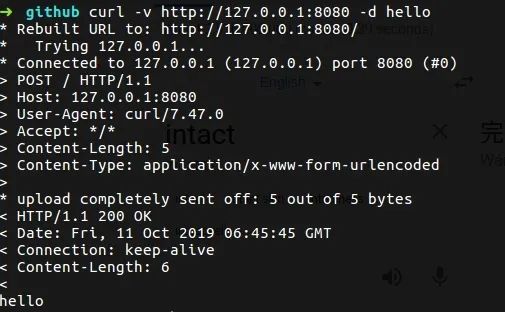
HTTP状态码502,503,504各自代表着什么?
Spring
1.SpringAOP是怎么实现的?
SpringAOP是怎么实现的?
静态代理
public interface IUserDao {
void save();
}
public class UserDao implements IUserDao {
public void save() {
System.out.println("已经保存数据...");
}
}
//代理类
public class UserDaoProxy implements IUserDao {
private IUserDao target;
public UserDaoProxy(IUserDao iuserDao) {
this.target = iuserDao;
}
public void save() {
System.out.println("开启事务...");
target.save();
System.out.println("关闭事务...");
}
}JDK动态代理
public class Test implements TestInterface {
public void test(Integer a) {
System.out.printf("111111");
}
}
public interface TestInterface {
void test(Integer a);
}
//创建一个类,继承InvocationHandler,重写invoke()方法,在这个方法里面做一些日志打印的操作后,然后通过反射的API调用method.invoke(target, args);本来的方法。
public static class CustomInvocationHandler implements InvocationHandler {
Object target;
public CustomInvocationHandler(Object target) {
this.target = target;
}
@Override
public Object invoke(Object proxy, Method method, Object[] args) throws Throwable {
System.out.println("before");
//调用本来的方法
Object result = method.invoke(target, args);
System.out.println("after");
return null;
}
}Test test = new Test();
TestInterface proxyInstance = (TestInterface) Proxy.newProxyInstance(test.getClass().getClassLoader(), test.getClass().getInterfaces(), new CustomInvocationHandler(test));
proxyInstance.test(11); public final void test(){
throws
{
try
{
/* h就是handler,m3是Method对象,在静态代码块里面有一行这样的代码
m3 = Class.forName("com.proxy.main.Test").getMethod("test", new Class[0]);
*/
this.h.invoke(this, m3, null);
return;
}
catch (RuntimeException localRuntimeException)
{
throw localRuntimeException;
}
catch (Throwable localThrowable)
{
}
throw new UndeclaredThrowableException(localThrowable);
}CGLIB动态代理
public static void main(final String[] args) {
System.setProperty(DebuggingClassWriter.DEBUG_LOCATION_PROPERTY, "/Users/ruiwendaier/Downloads/testaop");
Enhancer enhancer = new Enhancer();
enhancer.setSuperclass(Test.class);
enhancer.setCallback(new MyMethodInterceptor());
Test test1 = (Test)enhancer.create();
test1.test();
}
public static class MyMethodInterceptor implements MethodInterceptor {
@Override
public Object intercept(Object o, Method method, Object[] objects, MethodProxy methodProxy) throws Throwable {
System.out.println("Before: " + method.getName());
Object object = methodProxy.invokeSuper(o, objects);
System.out.println("After: " + method.getName());
return object;
}
}
public static class Test implements TestInterface {
public void test() {
System.out.printf("111111");
}
}//代理生成的方法 直接调用的父类(目标类的方法)
final String CGLIB$test$0(){
return super.test();
}
//方法重写 测试样例中就是调用的这里的test方法
public final String test()
{
//判断目标类是否有设置回调:enhancer.setCallback(this);
MethodInterceptor tmp4_1 = this.CGLIB$CALLBACK_0;
if (tmp4_1 == null){
tmp4_1;
CGLIB$BIND_CALLBACKS(this);
}
MethodInterceptor tmp17_14 = this.CGLIB$CALLBACK_0;
//设置了方法的回调则调用拦截器方法intercept
if (tmp17_14 != null)
return (String)tmp17_14.intercept(this, CGLIB$test$0$Method, CGLIB$emptyArgs, CGLIB$test$0$Proxy);
return super.test();
}区别
Spring IOC是什么?
Spring IOC是怎么解决循环依赖问题的?
Bean的生命周期是怎么样的?
public class MyInstantiationAwareBeanPostProcessorAdapter extends InstantiationAwareBeanPostProcessorAdapter {
@Override
public Object postProcessBeforeInstantiation(Class<?> beanClass, String beanName) throws BeansException {
if (beanName.equals("car")) {
System.out.println(beanName + "在实例化之前");
}
return super.postProcessBeforeInstantiation(beanClass, beanName);
}
@Override
public boolean postProcessAfterInstantiation(Object bean, String beanName) throws BeansException {
if (beanName.equals("car")) {
System.out.println(beanName + "在实例化之后");
}
return super.postProcessAfterInstantiation(bean, beanName);
}
}public class NdBeanPostProcessor implements BeanPostProcessor {
public Object postProcessBeforeInitialization(Object bean, String beanName) throws BeansException {
System.out.println("NdBeanPostProcessor 在" + beanName + "对象初始化之前调用......");
if (beanName.equals("car")) {
return new CglibInterceptor().getIntance(bean.getClass());
}
return bean;
}
public Object postProcessAfterInitialization(Object bean, String beanName) throws BeansException {
System.out.println("NdBeanPostProcessor 在" + beanName + "对象初始化之后调用......");
return bean;
}
}BeanFactory和FactoryBean有什么区别?
package org.springframework.beans.factory;
import org.springframework.beans.BeansException;
public interface BeanFactory {
String FACTORY_BEAN_PREFIX = "&";
Object getBean(String name) throws BeansException;
<T> T getBean(String name, Class<T> requiredType) throws BeansException;
<T> T getBean(Class<T> requiredType) throws BeansException;
Object getBean(String name, Object... args) throws BeansException;
boolean containsBean(String name);
boolean isSingleton(String name) throws NoSuchBeanDefinitionException;
boolean isPrototype(String name) throws NoSuchBeanDefinitionException;
boolean isTypeMatch(String name, Class<?> targetType) throws NoSuchBeanDefinitionException;
Class<?> getType(String name) throws NoSuchBeanDefinitionException;
String[] getAliases(String name);
} public interface FactoryBean<T> {
@Nullable
T getObject() throws Exception;
@Nullable
Class<?> getObjectType();
default boolean isSingleton() {
return true;
}
}Springboot启动过程
构造SpringApplication实例
执行run()方法
java -jar ***.jar启动命令中带的那些jvm参数。
创建applicationContext
执行prepareContext()方法
执行refreshContext()方法
afterRefresh()方法
//系统启动完可以做一些业务操作
@Component
//如果有多个runner需要指定一些顺序
@Order(1)
public class SimosApplicationRunner implements ApplicationRunner {
@Autowired
SystemInitService systemInitService;
@Override
public void run(ApplicationArguments args) throws Exception {
systemInitService.systemInit();
}
}