
👍《JavaGuide 面试突击版》PDF 版本 。图解计算机基础 PDF 版
书单已经被移动到awesome-cs 这个仓库。


开源的目的是为了大家能一起完善,如果你觉得内容有任何需要完善/补充的地方,欢迎提交 issue/pr。
- Github地址:https://github.com/CodingDocs/springboot-guide
- 码云地址:https://gitee.com/SnailClimb/springboot-guide(Github无法访问或者访问速度比较慢的小伙伴可以看码云上的对应内容)
重要知识点
基础
- Spring Boot 介绍
- 第一个 Hello World
- 第一个 RestFul Web 服务
- Spring 如何优雅读取配置文件?
- 异常处理 :Spring Boot 异常处理的几种方式、Spring Boot 异常处理在实际项目中的应用
- JPA : Spring Boot JPA 基础:常见操作解析 、 JPA 中非常重要的连表查询就是这么简单
- 拦截器和过滤器 :SpringBoot 实现过滤器 、SpringBoot 实现拦截器
- MyBatis :整合 SpringBoot+Mybatis 、SpirngBoot2.0+ 的 SpringBoot+Mybatis 多数据源配置 (TODO:早期文章,不建议阅读,待重构~)
- MyBatis-Plus 从入门到上手干事!
- SpringBoot 2.0+ 集成 Swagger 官方 Starter + knife4j 增强方案
进阶
- Bean映射工具 :Bean映射工具之Apache BeanUtils VS Spring BeanUtils 、5种常见Bean映射工具的性能比对
- 如何在 Spring/Spring Boot 中优雅地做参数校验?
- 使用 PowerMockRunner 和 Mockito 编写单元测试用例
- 5分钟搞懂如何在Spring Boot中Schedule Tasks
- 新手也能看懂的 Spring Boot 异步编程指南
- Kafka 入门+SpringBoot整合Kafka系列
- 超详细,新手都能看懂 !使用Spring Boot+Dubbo 搭建一个分布式服务
- 从零入门 !Spring Security With JWT(含权限验证)
补充
实战项目
- 使用 Spring Boot搭建一个在线文件预览系统!支持ppt、doc等多种类型文件预览
- SpringBoot 前后端分离后台管理系统分析!分模块开发、RBAC权限控制...
- 一个基于Spring Cloud 的面试刷题系统。
- 一个基于 Spring Boot 的在线考试系统
说明
- 项目 logo 由 logoly 生成。
- 利用 docsify 生成文档部署在 Github Pages 和 Gitee Pages: docsify 官网介绍
优质原创PDF资源
公众号
如果大家想要实时关注我更新的文章以及分享的干货的话,可以关注我的公众号。
《Java面试突击》: 由本文档衍生的专为面试而生的《Java面试突击》V2.0 PDF 版本公众号后台回复 "Java面试突击" 即可免费领取!
Java工程师必备学习资源: 一些Java工程师常用学习资源公众号后台回复关键字 “1” 即可免费无套路获取。
springboot introduction
1.SpringBoot 介绍
1.1 先从 Spring 谈起
Spring 是重量级企业开发框架 Enterprise JavaBean(EJB) 的替代品,Spring 为企业级 Java 开发提供了一种相对简单的方法,通过 依赖注入 和 面向切面编程 ,用简单的 Java 对象(Plain Old Java Object,POJO) 实现了 EJB 的功能
虽然 Spring 的组件代码是轻量级的,但它的配置却是重量级的(需要大量 XML 配置) 。
为此,Spring 2.5 引入了基于注解的组件扫描,这消除了大量针对应用程序自身组件的显式 XML 配置。Spring 3.0 引入了基于 Java 的配置,这是一种类型安全的可重构配置方式,可以代替 XML。
尽管如此,我们依旧没能逃脱配置的魔爪。开启某些 Spring 特性时,比如事务管理和 Spring MVC,还是需要用 XML 或 Java 进行显式配置。启用第三方库时也需要显式配置,比如基于 Thymeleaf 的 Web 视图。配置 Servlet 和过滤器(比如 Spring 的DispatcherServlet)同样需要在 web.xml 或 Servlet 初始化代码里进行显式配置。组件扫描减少了配置量,Java 配置让它看上去简洁不少,但 Spring 还是需要不少配置。
光配置这些 XML 文件都够我们头疼的了,占用了我们大部分时间和精力。除此之外,相关库的依赖非常让人头疼,不同库之间的版本冲突也非常常见。
不过,好消息是:Spring Boot 让这一切成为了过去。
1.2 再来谈谈 Spring Boot
最好直白的介绍莫过于官方的介绍:
Spring Boot makes it easy to create stand-alone, production-grade Spring based Applications that you can “just run”...Most Spring Boot applications need very little Spring configuration.(Spring Boot 可以轻松创建独立的生产级基于 Spring 的应用程序,只要通过 “just run”(可能是 run ‘Application’或 java -jar 或 tomcat 或 maven 插件 run 或 shell 脚本)便可以运行项目。大部分 Spring Boot 项目只需要少量的配置即可)
简而言之,从本质上来说,Spring Boot 就是 Spring,它做了那些没有它你自己也会去做的 Spring Bean 配置。
1.2.1 为什么需要 Spring Boot?
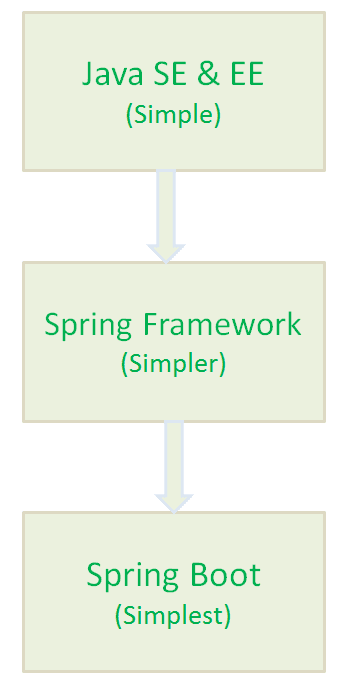
Spring Framework 旨在简化 J2EE 企业应用程序开发。Spring Boot Framework 旨在简化 Spring 开发。
1.2.2 Spring Boot 的主要优点
- 开发基于 Spring 的应用程序很容易。
- Spring Boot 项目所需的开发或工程时间明显减少,通常会提高整体生产力。
- Spring Boot 不需要编写大量样板代码、XML 配置和注释。
- Spring 引导应用程序可以很容易地与 Spring 生态系统集成,如 Spring JDBC、Spring ORM、Spring Data、Spring Security 等。
- Spring Boot 遵循“固执己见的默认配置”,以减少开发工作(默认配置可以修改)。
- Spring Boot 应用程序提供嵌入式 HTTP 服务器,如 Tomcat 和 Jetty,可以轻松地开发和测试 web 应用程序。(这点很赞!普通运行 Java 程序的方式就能运行基于 Spring Boot web 项目,省事很多)
- Spring Boot 提供命令行接口(CLI)工具,用于开发和测试 Spring Boot 应用程序,如 Java 或 Groovy。
- Spring Boot 提供了多种插件,可以使用内置工具(如 Maven 和 Gradle)开发和测试 Spring Boot 应用程序。
2.SpringBoot 开发环境要求
2.1 构建工具
构建工具(本项目涉及的代码大部分会采用 Maven 作为包管理工具):
| Build Tool | Version |
|---|---|
| Maven | 3.3+ |
| Gradle | 4.4+ |
2.2 开发工具推荐
推荐使用 IDEA 进行开发。最好的 Java 后台开发编辑器,没有之一!
2.3 Web 服务器
Spring Boot 支持以下嵌入式 servlet 容器:
| Name | Servlet Version |
|---|---|
| Tomcat 9.0 | 4.0 |
| Jetty 9.4 | 3.1 |
| Undertow 2.0 | 4.0 |
您还可以将 Spring 引导应用程序部署到任何 Servlet 3.1+兼容的 Web 容器中。
这就是你为什么可以通过直接像运行 普通 Java 项目一样运行 SpringBoot 项目。这样的确省事了很多,方便了我们进行开发,降低了学习难度。
springboot hello world
示例项目源代码地址:https://github.com/CodingDocs/springboot-guide/tree/master/source-code/hello-world 。
新建 Spring Boot 项目
1. 你可以通过 https://start.spring.io/ 这个网站来生成一个 Spring Boot 的项目。

注意勾选上 Spring Web 这个模块,这是我们所必需的一个依赖。当所有选项都勾选完毕之后,点击下方的按钮 Generate 下载这个 Spring Boot 的项目。下载完成并解压之后,我们直接使用 IDEA 打开即可。
另外,阿里也有一个类似的网站 https://start.aliyun.com/bootstrap.html ,功能甚至还要更强大点,支持生成特定应用架构的项目模板!
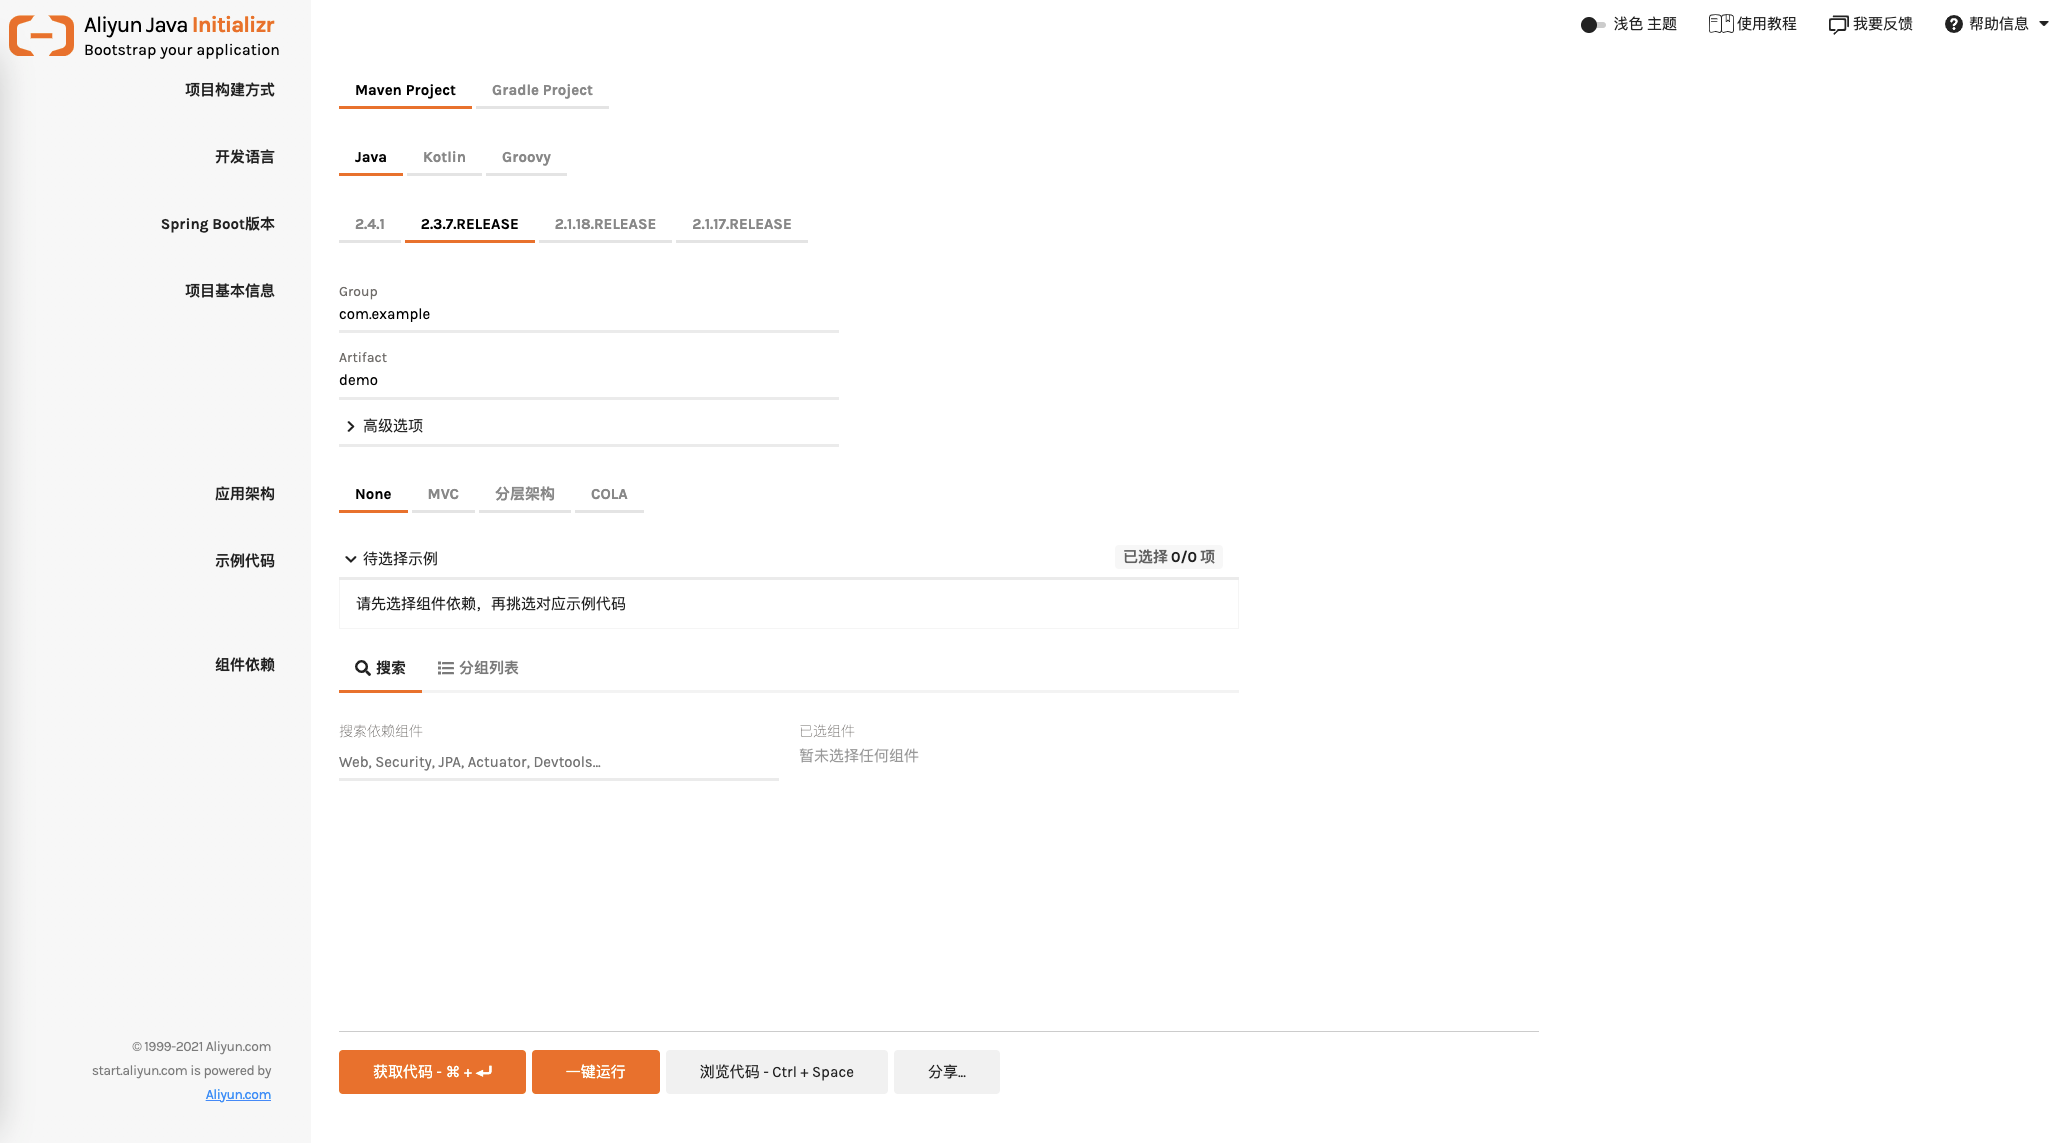
2.你也可以直接通过 IDEA 来生成一个 Spring Boot 的项目,具体方法和上面类似:File->New->Project->Spring Initializr。
Spring Boot 项目结构分析
成功打开项目之后,项目长下面这个样子:
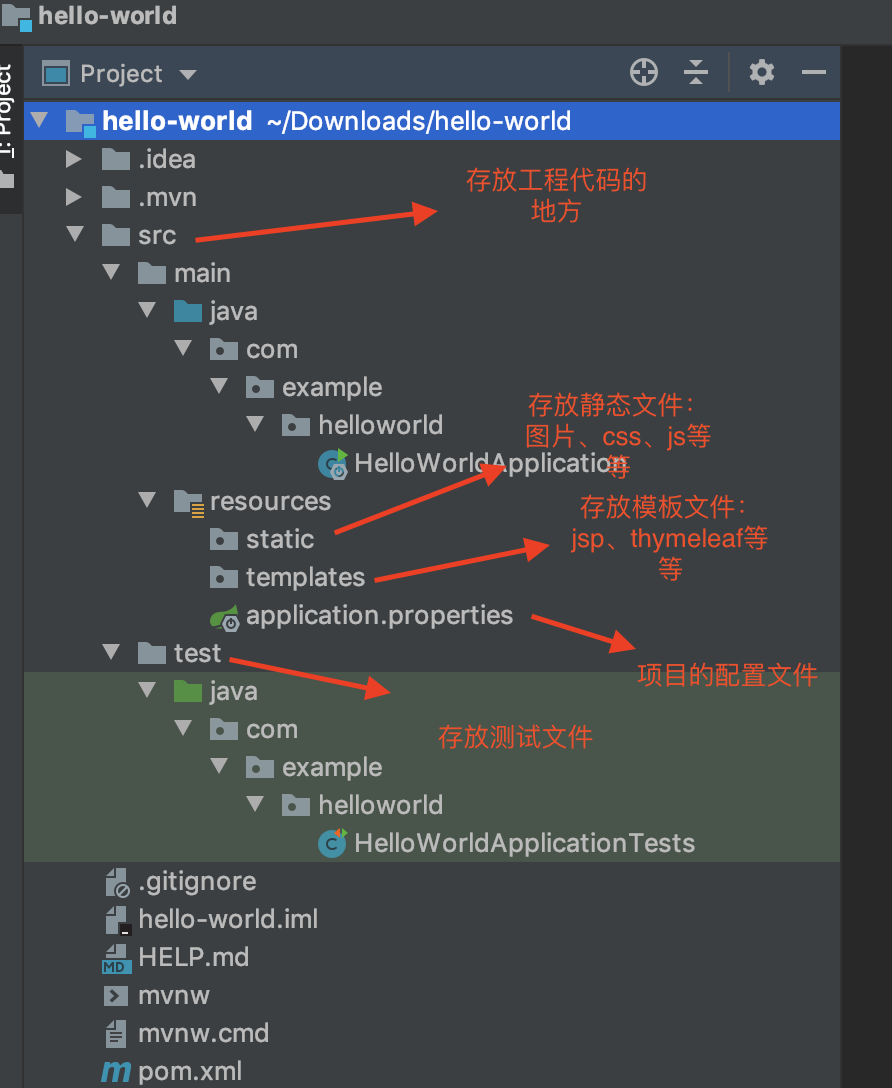
以 Application 为后缀名的 Java 类一般就是 Spring Boot 的启动类,比如本项目的启动项目就是HelloWorldApplication 。我们直接像运行普通 Java 程序一样运行它,由于 Spring Boot 本身就嵌入 servlet 容器的缘故,我们的 web 项目就运行成功了, 非常方便。
需要注意的一点是 Spring Boot 的启动类是需要最外层的,不然可能导致一些类无法被正确扫描到,导致一些奇怪的问题。 一般情况下 Spring Boot 项目结构类似下面这样
com
  +- example
    +- myproject
      +- Application.java
      |
      +- domain
      |  +- Customer.java
      |  +- CustomerRepository.java
      |
      +- service
      |  +- CustomerService.java
      |
      +- controller
      |  +- CustomerController.java
      |
      +- config
      |  +- swagerConfig.java
|Application.java是项目的启动类- domain 目录主要用于实体(Entity)与数据访问层(Repository)
- service 层主要是业务类代码
- controller 负责页面访问控制
- config 目录主要放一些配置类
@SpringBootApplication 注解分析
HelloWorldApplication
@SpringBootApplication
public class HelloWorldApplication {

	public static void main(String[] args) {
		SpringApplication.run(HelloWorldApplication.class, args);
	}

}
说到 Spring Boot 启动类就不得不介绍一下 @SpringBootApplication 注解了,这个注解的相关代码如下:
package org.springframework.boot.autoconfigure;
@Target(ElementType.TYPE)
@Retention(RetentionPolicy.RUNTIME)
@Documented
@Inherited
@SpringBootConfiguration
@EnableAutoConfiguration
@ComponentScan(excludeFilters = {
		@Filter(type = FilterType.CUSTOM, classes = TypeExcludeFilter.class),
		@Filter(type = FilterType.CUSTOM, classes = AutoConfigurationExcludeFilter.class) })
public @interface SpringBootApplication {
   ......
}
package org.springframework.boot;
@Target(ElementType.TYPE)
@Retention(RetentionPolicy.RUNTIME)
@Documented
@Configuration
public @interface SpringBootConfiguration {
}可以看出大概可以把 @SpringBootApplication看作是 @Configuration、@EnableAutoConfiguration、@ComponentScan 注解的集合。根据 SpringBoot 官网,这三个注解的作用分别是:
@EnableAutoConfiguration:启用 SpringBoot 的自动配置机制@ComponentScan: 扫描被@Component(@Service,@Controller)注解的 bean,注解默认会扫描该类所在的包下所有的类。@Configuration:允许在上下文中注册额外的 bean 或导入其他配置类。
所以说 @SpringBootApplication就是几个重要的注解的组合,为什么要有它?当然是为了省事,避免了我们每次开发 Spring Boot 项目都要写一些必备的注解。这一点在我们平时开发中也经常用到,比如我们通常会提一个测试基类,这个基类包含了我们写测试所需要的一些基本的注解和一些依赖。
新建一个 Controller
上面说了这么多,我们现在正式开始写 Spring Boot 版的 “Hello World” 吧。
新建一个 controller 文件夹,并在这个文件夹下新建一个名字叫做 HelloWorldController 的类。
@RestController是 Spring 4 之后新加的注解,如果在 Spring4 之前开发 RESTful Web 服务的话,你需要使用@Controller 并结合@ResponseBody注解,也就是说@Controller +@ResponseBody= @RestController。对于这两个注解,我在基础篇单独抽了一篇文章来介绍。
com.example.helloworld.controller
import org.springframework.web.bind.annotation.GetMapping;
import org.springframework.web.bind.annotation.RequestMapping;
import org.springframework.web.bind.annotation.RestController;

@RestController
@RequestMapping("test")
public class HelloWorldController {
    @GetMapping("hello")
    public String sayHello() {
        return "Hello World";
    }
}
默认情况下,Spring Boot 项目会使用 8080 作为项目的端口号。如果我们修改端口号的话,非常简单,直接修改
application.properties配置文件即可。
src/main/resources/application.properties
server.port=8333大功告成,运行项目
运行 HelloWorldApplication ,运行成功控制台会打印出一些消息,不要忽略这些消息,它里面会有一些比较有用的信息。
2019-10-03 09:24:47.757 INFO 26326 --- [ main] o.s.b.w.embedded.tomcat.TomcatWebServer : Tomcat started on port(s): 8333 (http) with context path ''上面是我截取的一段控制台打印出的内容,通过这段内容我们就知道了 Spring Boot 默认使用的 Tomact 内置 web 服务器,项目被运行在我们指定的 8333 端口上,并且项目根上下文路径是 "/"。
浏览器 http://localhost:8333/test/hello 如果你可以在页面正确得到 "Hello World" 的话,说明你已经成功完成了这部分内容。
总结
通过本文我们学到了如何新建 Spring Boot 项目、SpringBoot 项目常见的项目结构分析、@SpringBootApplication 注解分析,最后实现了 Spring Boot 版的 "Hello World"。
sringboot restful web service
RESTful Web 服务介绍
本节我们将开发一个简单的 RESTful Web 服务。
RESTful Web 服务与传统的 MVC 开发一个关键区别是返回给客户端的内容的创建方式:传统的 MVC 模式开发会直接返回给客户端一个视图,但是 RESTful Web 服务一般会将返回的数据以 JSON 的形式返回,这也就是现在所推崇的前后端分离开发。
为了节省时间,本篇内容的代码是在 Spring Boot 版 Hello World & Spring Boot 项目结构分析 基础上进行开发的。
内容概览
通过下面的内容你将学习到下面这些东西:
- Lombok 优化代码利器
@RestController@RequestParam以及@Pathvairable@RequestMapping、@GetMapping......Responsity
下载 Lombok 优化代码利器
因为本次开发用到了 Lombok 这个简化 Java 代码的工具,所以我们需要在 pom.xml 中添加相关依赖。如果对 Lombok 不熟悉的话,我强烈建议你去了解一下,可以参考这篇文章:《十分钟搞懂Java效率工具Lombok使用与原理》
		<dependency>
			<groupId>org.projectlombok</groupId>
			<artifactId>lombok</artifactId>
			<version>1.18.10</version>
		</dependency>
并且你需要下载 IDEA 中支持 lombok 的插件:

RESTful Web 服务开发
假如我们有一个书架,上面放了很多书。为此,我们需要新建一个 Book 实体类。
com.example.helloworld.entity
/**
 * @author shuang.kou
 */
@Data
public class Book {
    private String name;
    private String description;
}
我们还需要一个控制器对书架上进行添加、查找以及查看。为此,我们需要新建一个 BookController 。
import com.example.helloworld.entity.Book;
import org.springframework.http.ResponseEntity;
import org.springframework.web.bind.annotation.DeleteMapping;
import org.springframework.web.bind.annotation.GetMapping;
import org.springframework.web.bind.annotation.PathVariable;
import org.springframework.web.bind.annotation.PostMapping;
import org.springframework.web.bind.annotation.RequestBody;
import org.springframework.web.bind.annotation.RequestParam;
import org.springframework.web.bind.annotation.RestController;

import java.util.ArrayList;
import java.util.List;
import java.util.stream.Collectors;

@RestController
@RequestMapping("/api")
public class BookController {

    private List<Book> books = new ArrayList<>();

    @PostMapping("/book")
    public ResponseEntity<List<Book>> addBook(@RequestBody Book book) {
        books.add(book);
        return ResponseEntity.ok(books);
    }

    @DeleteMapping("/book/{id}")
    public ResponseEntity deleteBookById(@PathVariable("id") int id) {
        books.remove(id);
        return ResponseEntity.ok(books);
    }

    @GetMapping("/book")
    public ResponseEntity getBookByName(@RequestParam("name") String name) {
        List<Book> results = books.stream().filter(book -> book.getName().equals(name)).collect(Collectors.toList());
        return ResponseEntity.ok(results);
    }
}@RestController将返回的对象数据直接以 JSON 或 XML 形式写入 HTTP 响应(Response)中。绝大部分情况下都是直接以 JSON 形式返回给客户端,很少的情况下才会以 XML 形式返回。转换成 XML 形式还需要额为的工作,上面代码中演示的直接就是将对象数据直接以 JSON 形式写入 HTTP 响应(Response)中。关于@Controller和@RestController的对比,我会在下一篇文章中单独介绍到(@Controller+@ResponseBody=@RestController)。@RequestMapping:上面的示例中没有指定 GET 与 PUT、POST 等,因为@RequestMapping默认映射所有HTTP Action,你可以使用@RequestMapping(method=ActionType)来缩小这个映射。@PostMapping实际上就等价于@RequestMapping(method = RequestMethod.POST),同样的@DeleteMapping,@GetMapping也都一样,常用的 HTTP Action 都有一个这种形式的注解所对应。@PathVariable:取url地址中的参数。@RequestParamurl的查询参数值。@RequestBody:可以**将 HttpRequest body 中的 JSON 类型数据反序列化为合适的 Java 类型。**ResponseEntity: 表示整个HTTP Response:状态码,标头和正文内容。我们可以使用它来自定义HTTP Response 的内容。
运行项目并测试效果
这里我们又用到了开发 Web 服务必备的 Postman 来帮助我们发请求测试。
1.使用 post 请求给书架增加书籍
这里我模拟添加了 3 本书籍。

2.使用 Delete 请求删除书籍
这个就不截图了,可以参考上面发Post请求的方式来进行,请求的 url: localhost:8333/api/book/1。
3.使用 Get 请求根据书名获取特定的书籍
请求的 url:localhost:8333/api/book?name=book1
总结
通过本文我们需到了使用 Lombok 来优化 Java 代码,以及一些开发 RestFul Web 服务常用的注解:@RestController 、@RequestMapping、@PostMapping、@PathVariable、@RequestParam、@RequestBody以及和HTTP Response 有关的 Responsity类。关于这些知识点的用法,我在上面都有介绍到,更多用法还需要自己去查阅相关文档。
代码地址:
read config properties
很多时候我们需要将一些常用的配置信息比如阿里云oss配置、发送短信的相关信息配置等等放到配置文件中。
下面我们来看一下 Spring 为我们提供了哪些方式帮助我们从配置文件中读取这些配置信息。
application.yml 内容如下:
wuhan2020: 2020年初武汉爆发了新型冠状病毒,疫情严重,但是,我相信一切都会过去!武汉加油!中国加油!

my-profile:
  name: Guide哥
  email: koushuangbwcx@163.com

library:
  location: 湖北武汉加油中国加油
  books:
    - name: 天才基本法
      description: 二十二岁的林朝夕在父亲确诊阿尔茨海默病这天,得知自己暗恋多年的校园男神裴之即将出国深造的消息——对方考取的学校,恰是父亲当年为她放弃的那所。
    - name: 时间的秩序
      description: 为什么我们记得过去,而非未来?时间“流逝”意味着什么?是我们存在于时间之内,还是时间存在于我们之中?卡洛·罗韦利用诗意的文字,邀请我们思考这一亘古难题——时间的本质。
    - name: 了不起的我
      description: 如何养成一个新习惯?如何让心智变得更成熟?如何拥有高质量的关系? 如何走出人生的艰难时刻?
1.通过 @value 读取比较简单的配置信息
使用 @Value("${property}") 读取比较简单的配置信息:
@Value("${wuhan2020}")
String wuhan2020;
需要注意的是 @value这种方式是不被推荐的,Spring 比较建议的是下面几种读取配置信息的方式。
2.通过@ConfigurationProperties读取并与 bean 绑定
LibraryProperties类上加了@Component注解,我们可以像使用普通 bean 一样将其注入到类中使用。
import lombok.Getter;
import lombok.Setter;
import lombok.ToString;
import org.springframework.boot.context.properties.ConfigurationProperties;
import org.springframework.context.annotation.Configuration;
import org.springframework.stereotype.Component;

import java.util.List;

@Component
@ConfigurationProperties(prefix = "library")
@Setter
@Getter
@ToString
class LibraryProperties {
    private String location;
    private List<Book> books;

    @Setter
    @Getter
    @ToString
    static class Book {
        String name;
        String description;
    }
}
这个时候你就可以像使用普通 bean 一样,将其注入到类中使用:
package cn.javaguide.readconfigproperties;

import org.springframework.beans.factory.InitializingBean;
import org.springframework.boot.SpringApplication;
import org.springframework.boot.autoconfigure.SpringBootApplication;

/**
 * @author shuang.kou
 */
@SpringBootApplication
public class ReadConfigPropertiesApplication implements InitializingBean {

    private final LibraryProperties library;

    public ReadConfigPropertiesApplication(LibraryProperties library) {
        this.library = library;
    }

    public static void main(String[] args) {
        SpringApplication.run(ReadConfigPropertiesApplication.class, args);
    }

    @Override
    public void afterPropertiesSet() {
        System.out.println(library.getLocation());
        System.out.println(library.getBooks());    }
}
控制台输出:
湖北武汉加油中国加油
[LibraryProperties.Book(name=天才基本法, description........]3.通过@ConfigurationProperties读取并校验
我们先将application.yml修改为如下内容,明显看出这不是一个正确的 email 格式:
my-profile:
  name: Guide哥
email: koushuangbwcx@ProfileProperties类没有加@Component注解。我们在我们要使用ProfileProperties的地方使用@EnableConfigurationProperties注册我们的配置bean:
import lombok.Getter;
import lombok.Setter;
import lombok.ToString;
import org.springframework.boot.context.properties.ConfigurationProperties;
import org.springframework.stereotype.Component;
import org.springframework.validation.annotation.Validated;

import javax.validation.constraints.Email;
import javax.validation.constraints.NotEmpty;

/**
 * @author shuang.kou
 */
@Getter
@Setter
@ToString
@ConfigurationProperties("my-profile")
@Validated
public class ProfileProperties {
    @NotEmpty
    private String name;

    @Email
    @NotEmpty
    private String email;

    //配置文件中没有读取到的话就用默认值
    private Boolean handsome = Boolean.TRUE;

}
具体使用:
package cn.javaguide.readconfigproperties;

import org.springframework.beans.factory.InitializingBean;
import org.springframework.beans.factory.annotation.Value;
import org.springframework.boot.SpringApplication;
import org.springframework.boot.autoconfigure.SpringBootApplication;
import org.springframework.boot.context.properties.EnableConfigurationProperties;

/**
 * @author shuang.kou
 */
@SpringBootApplication
@EnableConfigurationProperties(ProfileProperties.class)
public class ReadConfigPropertiesApplication implements InitializingBean {
    private final ProfileProperties profileProperties;

    public ReadConfigPropertiesApplication(ProfileProperties profileProperties) {
        this.profileProperties = profileProperties;
    }

    public static void main(String[] args) {
        SpringApplication.run(ReadConfigPropertiesApplication.class, args);
    }

    @Override
    public void afterPropertiesSet() {
        System.out.println(profileProperties.toString());
    }
}
因为我们的邮箱格式不正确,所以程序运行的时候就报错,根本运行不起来,保证了数据类型的安全性:
```visual basic Binding to target org.springframework.boot.context.properties.bind.BindException: Failed to bind properties under 'my-profile' to cn.javaguide.readconfigproperties.ProfileProperties failed:
Property: my-profile.email
Value: koushuangbwcx@
Origin: class path resource [application.yml]:5:10
Reason: must be a well-formed email address
我们把邮箱测试改为正确的之后再运行,控制台就能成功打印出读取到的信息:ProfileProperties(name=Guide哥, email=koushuangbwcx@163.com, handsome=true)
### 4.`@PropertySource`读取指定 properties 文件java import lombok.Getter; import lombok.Setter; import org.springframework.beans.factory.annotation.Value; import org.springframework.context.annotation.PropertySource; import org.springframework.stereotype.Component;
@Component @PropertySource("classpath:website.properties") @Getter @Setter class WebSite {
@Value("${url}")
private String url;
}
使用:java @Autowired private WebSite webSite;
System.out.println(webSite.getUrl());//https://javaguide.cn/
### 5.题外话:Spring加载配置文件的优先级
Spring 读取配置文件也是有优先级的,直接上图:
<img src="https://my-blog-to-use.oss-cn-beijing.aliyuncs.com/2019-11/read-config-properties-priority.jpg" style="zoom:50%;" />
更对内容请查看官方文档:https://docs.spring.io/spring-boot/docs/current/reference/html/spring-boot-features.html#boot-features-external-config
> 本文源码:https://github.com/Snailclimb/springboot-guide/tree/master/source-code/basis/read-config-properties
---
## springboot handle exception plus
> 这篇文章鸽了很久,我在这篇文章 [《用好Java中的枚举,真的没有那么简单!》](https://mp.weixin.qq.com/s?__biz=Mzg2OTA0Njk0OA==&mid=2247486111&idx=2&sn=8299a42edc4733bdf012ebfe9ebf3fbb&chksm=cea24554f9d5cc42eac0e0ecd851c201831f3b149e64fe11f94b548031f10ff2dac1ea9743d3&token=1729829670&lang=zh_CN#rd) 中就提到要分享。还是昨天一个读者提醒我之后,我才发现自己没有将这篇文章发到公众号。说到这里,我发现自己一个很大的问题,就是有时候在文章里面说要更新什么,结果后面就忘记了,很多时候不是自己没写,就因为各种事情混杂导致忘记发了。以后要尽量改正这个问题!
在上一篇文章[《SpringBoot 处理异常的几种常见姿势》](https://mp.weixin.qq.com/s?__biz=Mzg2OTA0Njk0OA==&mid=2247485568&idx=2&sn=c5ba880fd0c5d82e39531fa42cb036ac&chksm=cea2474bf9d5ce5dcbc6a5f6580198fdce4bc92ef577579183a729cb5d1430e4994720d59b34&token=1729829670&lang=zh_CN#rd)中我介绍了:
1. 使用 `@ControllerAdvice` 和 `@ExceptionHandler` 处理全局异常
2. `@ExceptionHandler` 处理 Controller 级别的异常
3. `ResponseStatusException`
通过这篇文章,可以搞懂如何在 Spring Boot 中进行异常处理。但是,光是会用了还不行,我们还要思考如何把异常处理这部分的代码写的稍微优雅一点。下面我会以我在工作中学到的一点实际项目中异常处理的方式,来说说我觉得稍微优雅点的异常处理解决方案。
下面仅仅是我作为一个我个人的角度来看的,如果各位读者有更好的解决方案或者觉得本文提出的方案还有优化的余地的话,欢迎在评论区评论。
## 最终效果展示
下面先来展示一下完成后的效果,当我们定义的异常被系统捕捉后返回给客户端的信息是这样的:

返回的信息包含了异常下面 5 部分内容:
1. 唯一标示异常的 code
2. HTTP状态码
3. 错误路径
4. 发生错误的时间戳
5. 错误的具体信息
这样返回异常信息,更利于我们前端根据异常信息做出相应的表现。
## 异常处理核心代码
`ErrorCode.java` (此枚举类中包含了异常的唯一标识、HTTP状态码以及错误信息)
这个类的主要作用就是统一管理系统中可能出现的异常,比较清晰明了。但是,可能出现的问题是当系统过于复杂,出现的异常过多之后,这个类会比较庞大。有一种解决办法:将多种相似的异常统一为一个,比如将用户找不到异常和订单信息未找到的异常都统一为“未找到该资源”这一种异常,然后前端再对相应的情况做详细处理(我个人的一种处理方法,不敢保证是比较好的一种做法)。java import org.springframework.http.HttpStatus;
public enum ErrorCode {
RESOURCE_NOT_FOUND(1001, HttpStatus.NOT_FOUND, "未找到该资源"),
REQUEST_VALIDATION_FAILED(1002, HttpStatus.BAD_REQUEST, "请求数据格式验证失败");
private final int code;
private final HttpStatus status;private final String message;ErrorCode(int code, HttpStatus status, String message) {
this.code = code;
this.status = status;
this.message = message;
}public int getCode() {
return code;
}public HttpStatus getStatus() {
return status;
}public String getMessage() {
return message;
}@Override
public String toString() {
return "ErrorCode{" +
"code=" + code +
", status=" + status +
", message='" + message + '\'' +
'}';
}}
**`ErrorReponse.java`(返回给客户端具体的异常对象)**

这个类作为异常信息返回给客户端,里面包括了当出现异常时我们想要返回给客户端的所有信息。
java import org.springframework.util.ObjectUtils;
import java.time.Instant; import java.util.HashMap; import java.util.Map;
public class ErrorReponse {
private int code;
private int status;
private String message;
private String path;
private Instant timestamp;
private HashMap<String, Object> data = new HashMap<String, Object>();
public ErrorReponse() {
}public ErrorReponse(BaseException ex, String path) {
this(ex.getError().getCode(), ex.getError().getStatus().value(), ex.getError().getMessage(), path, ex.getData());
}public ErrorReponse(int code, int status, String message, String path, Map<String, Object> data) {
this.code = code;
this.status = status;
this.message = message;
this.path = path;
this.timestamp = Instant.now();
if (!ObjectUtils.isEmpty(data)) {
this.data.putAll(data);
}
}// 省略 getter/setter 方法
@Override
public String toString() {
    return "ErrorReponse{" +
            "code=" + code +
            ", status=" + status +
            ", message='" + message + '\'' +
            ", path='" + path + '\'' +
            ", timestamp=" + timestamp +
            ", data=" + data +
            '}';
}
}
**`BaseException.java`(继承自 `RuntimeException` 的抽象类,可以看做系统中其他异常类的父类)**

系统中的异常类都要继承自这个类。
java
public abstract class BaseException extends RuntimeException {
private final ErrorCode error;
private final HashMap<String, Object> data = new HashMap<>();
public BaseException(ErrorCode error, Map<String, Object> data) {
super(error.getMessage());
this.error = error;
if (!ObjectUtils.isEmpty(data)) {
this.data.putAll(data);
}
}protected BaseException(ErrorCode error, Map<String, Object> data, Throwable cause) {
super(error.getMessage(), cause);
this.error = error;
if (!ObjectUtils.isEmpty(data)) {
this.data.putAll(data);
}
}public ErrorCode getError() {
return error;
}public Map<String, Object> getData() {
return data;
}}
**`ResourceNotFoundException.java` (自定义异常)**

可以看出通过继承 `BaseException` 类我们自定义异常会变的非常简单!
java import java.util.Map;
public class ResourceNotFoundException extends BaseException {
public ResourceNotFoundException(Map<String, Object> data) {
    super(ErrorCode.RESOURCE_NOT_FOUND, data);
}
}
**`GlobalExceptionHandler.java`(全局异常捕获)**

我们定义了两个异常捕获方法。

这里再说明一下,实际上这个类只需要 `handleAppException()` 这一个方法就够了,因为它是本系统所有异常的父类。只要是抛出了继承 `BaseException` 类的异常后都会在这里被处理。
java import com.twuc.webApp.web.ExceptionController; import org.springframework.http.HttpHeaders; import org.springframework.http.HttpStatus; import org.springframework.http.ResponseEntity; import org.springframework.web.bind.annotation.ControllerAdvice; import org.springframework.web.bind.annotation.ExceptionHandler; import org.springframework.web.bind.annotation.ResponseBody; import javax.servlet.http.HttpServletRequest;
@ControllerAdvice(assignableTypes = {ExceptionController.class}) @ResponseBody public class GlobalExceptionHandler {
// 也可以将 BaseException 换为 RuntimeException
// 因为 RuntimeException 是 BaseException 的父类
@ExceptionHandler(BaseException.class)
public ResponseEntity<?> handleAppException(BaseException ex, HttpServletRequest request) {
    ErrorReponse representation = new ErrorReponse(ex, request.getRequestURI());
    return new ResponseEntity<>(representation, new HttpHeaders(), ex.getError().getStatus());
}
@ExceptionHandler(value = ResourceNotFoundException.class)
public ResponseEntity<ErrorReponse> handleResourceNotFoundException(ResourceNotFoundException ex, HttpServletRequest request) {
ErrorReponse errorReponse = new ErrorReponse(ex, request.getRequestURI());
return ResponseEntity.status(HttpStatus.BAD_REQUEST).body(errorReponse);
}}
**(重要)一点扩展:**

哈哈!实际上我多加了一个算是多余的异常捕获方法`handleResourceNotFoundException()` 主要是为了考考大家当我们抛出了 `ResourceNotFoundException`异常会被下面哪一个方法捕获呢?

答案:

会被`handleResourceNotFoundException()`方法捕获。因为 `@ExceptionHandler` 捕获异常的过程中,会优先找到最匹配的。

下面通过源码简单分析一下:

`ExceptionHandlerMethodResolver.java`中`getMappedMethod`决定了具体被哪个方法处理。
java
@Nullable
private Method getMappedMethod(Class<? extends Throwable> exceptionType) {
	List<Class<? extends Throwable>> matches = new ArrayList<>();
//找到可以处理的所有异常信息。mappedMethods 中存放了异常和处理异常的方法的对应关系
	for (Class<? extends Throwable> mappedException : this.mappedMethods.keySet()) {
		if (mappedException.isAssignableFrom(exceptionType)) {
			matches.add(mappedException);
		}
	}
// 不为空说明有方法处理异常
	if (!matches.isEmpty()) {
  // 按照匹配程度从小到大排序
		matches.sort(new ExceptionDepthComparator(exceptionType));
  // 返回处理异常的方法
		return this.mappedMethods.get(matches.get(0));
	}
	else {
		return null;
	}
}
从源代码看出:**`getMappedMethod()`会首先找到可以匹配处理异常的所有方法信息,然后对其进行从小到大的排序,最后取最小的那一个匹配的方法(即匹配度最高的那个)。**

## 写一个抛出异常的类测试

**`Person.java`**
java public class Person {
private Long id;
private String name;
// 省略 getter/setter 方法}
**`ExceptionController.java`(抛出异常的类)**java @RestController @RequestMapping("/api") public class ExceptionController {
@GetMapping("/resourceNotFound")
public void throwException() {
    Person p=new Person(1L,"SnailClimb");
    throw new ResourceNotFoundException(ImmutableMap.of("person id:", p.getId()));
}
}
源码地址:https://github.com/Snailclimb/springboot-guide/tree/master/source-code/basis/springboot-handle-exception-improved


---

## springboot jpa

# 一文搞懂如何在 Spring Boot 中正确使用 JPA

JPA 这部分内容上手很容易,但是涉及到的东西还是挺多的,网上大部分关于 JPA 的资料都不是特别齐全,大部分用的版本也是比较落后的。另外,我下面讲到了的内容也不可能涵盖所有 JPA 相关内容,我只是把自己觉得比较重要的知识点总结在了下面。我自己也是参考着官方文档写的,[官方文档](https://docs.spring.io/spring-data/jpa/docs/current/reference/html/#reference)非常详细了,非常推荐阅读一下。这篇文章可以帮助对 JPA 不了解或者不太熟悉的人来在实际项目中正确使用 JPA。

项目代码基于 Spring Boot 最新的 2.1.9.RELEASE 版本构建(截止到这篇文章写完),另外,新建项目就不多说了,前面的文章已经很详细介绍过。

## 1.相关依赖

我们需要下面这些依赖支持我们完成这部分内容的学习:
xml
## 2.配置数据库连接信息和JPA配置

由于使用的是 h2 内存数据库,所以你直接运行项目数据库就会自动创建好。

下面的配置中需要单独说一下 `spring.jpa.hibernate.ddl-auto=create`这个配置选项。

这个属性常用的选项有四种:

1. `create`:每次重新启动项目都会重新创新表结构,会导致数据丢失
2. `create-drop`:每次启动项目创建表结构,关闭项目删除表结构
3. `update`:每次启动项目会更新表结构
4. `validate`:验证表结构,不对数据库进行任何更改

但是,**一定要不要在生产环境使用 ddl 自动生成表结构,一般推荐手写 SQL 语句配合 Flyway 来做这些事情。**
properties
数据库url地址
spring.datasource.url=jdbc:h2:mem:jpa-demo spring.datasource.username=root spring.datasource.password=123456 spring.datasource.platform=h2 spring.datasource.driverClassName =org.h2.Driver
spring.jpa.properties.hibernate.enable_lazy_load_no_trans=true
打印出 sql 语句
spring.jpa.show-sql=true spring.jpa.hibernate.ddl-auto=update spring.jpa.open-in-view=false server.port=8080 #H2控制台 spring.h2.console.enabled=true
## 3.实体类

我们为这个类添加了 `@Entity` 注解代表它是数据库持久化类,还配置了主键 id。
java import lombok.Data; import lombok.NoArgsConstructor;
import javax.persistence.Column; import javax.persistence.Entity; import javax.persistence.GeneratedValue; import javax.persistence.GenerationType; import javax.persistence.Id;
@Entity @Data @NoArgsConstructor public class Person {
@Id
@GeneratedValue(strategy = GenerationType.IDENTITY)
private Long id;
@Column(unique = true)
private String name;
private Integer age;
public Person(String name, Integer age) {
this.name = name;
this.age = age;
}}
如何检验你是否正确完成了上面 3 步?很简单,运行项目,查看数据如果发现控制台打印出创建表的 sql 语句,并且数据库中表真的被创建出来的话,说明你成功完成前面 3 步。

控制台打印出来的 sql 语句类似下面这样:
sql
drop table if exists person
CREATE TABLE person (
id bigint(20) NOT NULL AUTO_INCREMENT,
age int(11) DEFAULT NULL,
name varchar(255) DEFAULT NULL,
PRIMARY KEY (id)
) ENGINE=InnoDB DEFAULT CHARSET=utf8;
alter table person add constraint UK_p0wr4vfyr2lyifm8avi67mqw5 unique (name)
## 4.创建操作数据库的 Repository 接口java
@Repository
public interface PersonRepository extends JpaRepository
首先这个接口加了 `@Repository` 注解,代表它和数据库操作有关。另外,它继承了 `JpaRepository<Person, Long>`接口,而`JpaRepository<Person, Long>`长这样:java
@NoRepositoryBean
public interface JpaRepository
List<T> findAll();List<T> findAll(Sort var1);List<T> findAllById(Iterable<ID> var1); List saveAll(Iterable var1);
void flush(); S saveAndFlush(S var1);
void deleteInBatch(Iterable<T> var1);void deleteAllInBatch();T getOne(ID var1); List findAll(Example var1);
List findAll(Example var1, Sort var2);
}
这表明我们只要继承了` JpaRepository<T, ID>` 就具有了 JPA 为我们提供好的增删改查、分页查询以及根据条件查询等方法。

### 4.1 JPA 自带方法实战

#### 1) 增删改查

**1.保存用户到数据库**
java
Person person = new Person("SnailClimb", 23);
personRepository.save(person);
`save()`方法对应 sql 语句就是:`insert into person (age, name) values (23,"snailclimb")`

**2.根据 id 查找用户**
java
Optional<Person> personOptional = personRepository.findById(id);
`findById()`方法对应 sql 语句就是:`select * from person p where p.id = id`

**3.根据 id 删除用户**
java
personRepository.deleteById(id);
`deleteById()`方法对应 sql 语句就是:`delete from person where id=id`

**4.更新用户**

更新操作也要通过 `save()`方法来实现,比如:
java
Person person = new Person("SnailClimb", 23);
Person savedPerson = personRepository.save(person);
// 更新 person 对象的姓名
savedPerson.setName("UpdatedName");
personRepository.save(savedPerson);
在这里 `save()`方法相当于 sql 语句:`update person set name="UpdatedName" where id=id`

#### 2) 带条件的查询

下面这些方法是我们根据 JPA 提供的语法自定义的,你需要将下面这些方法写到 `PersonRepository` 中。

假如我们想要根据 Name 来查找 Person ,你可以这样:
java
Optional<Person> findByName(String name);
如果你想要找到年龄大于某个值的人,你可以这样:java
List<Person> findByAgeGreaterThan(int age);
### 4.2 自定义 SQL 语句实战

很多时候我们自定义 sql 语句会非常有用。

根据 name 来查找 Person:
java
@Query("select p from Person p where p.name = :name")
Optional<Person> findByNameCustomeQuery(@Param("name") String name);
Person 部分属性查询,避免 `select *`操作: java
@Query("select p.name from Person p where p.id = :id")
String findPersonNameById(@Param("id") Long id);
根据 id 更新Person name:java
@Modifying
@Query("update Person p set p.name = ?1 where p.id = ?2")
void updatePersonNameById(String name, Long id);
### 4.3 创建异步方法

如果我们需要创建异步方法的话,也比较方便。

异步方法在调用时立即返回,然后会被提交给`TaskExecutor`执行。当然你也可以选择得出结果后才返回给客户端。如果对 Spring Boot 异步编程感兴趣的话可以看这篇文章:[《新手也能看懂的 SpringBoot 异步编程指南》](https://snailclimb.gitee.io/springboot-guide/#/./docs/advanced/springboot-async) 。
java
@Async
Future
@Async
CompletableFuture
## 5.测试类和源代码地址

测试类:
java
@SpringBootTest @RunWith(SpringRunner.class) public class PersonRepositoryTest {
@Autowired
private PersonRepository personRepository;
private Long id;
/**
* 保存person到数据库
*/
@Before
public void setUp() {
assertNotNull(personRepository);
Person person = new Person("SnailClimb", 23);
Person savedPerson = personRepository.saveAndFlush(person);// 更新 person 对象的姓名
savedPerson.setName("UpdatedName");
personRepository.save(savedPerson); id = savedPerson.getId();
}/**
* 使用 JPA 自带的方法查找 person
*/
@Test
public void should_get_person() {
Optional<Person> personOptional = personRepository.findById(id);
assertTrue(personOptional.isPresent());
assertEquals("SnailClimb", personOptional.get().getName());
assertEquals(Integer.valueOf(23), personOptional.get().getAge()); List<Person> personList = personRepository.findByAgeGreaterThan(18);
assertEquals(1, personList.size());
// 清空数据库
personRepository.deleteAll();
}/**
* 自定义 query sql 查询语句查找 person
*/@Test
public void should_get_person_use_custom_query() {
// 查找所有字段
Optional<Person> personOptional = personRepository.findByNameCustomeQuery("SnailClimb");
assertTrue(personOptional.isPresent());
assertEquals(Integer.valueOf(23), personOptional.get().getAge());
// 查找部分字段
String personName = personRepository.findPersonNameById(id);
assertEquals("SnailClimb", personName);
System.out.println(id);
// 更新
personRepository.updatePersonNameById("UpdatedName", id);
Optional<Person> updatedName = personRepository.findByNameCustomeQuery("UpdatedName");
assertTrue(updatedName.isPresent());
// 清空数据库
personRepository.deleteAll();
}}
源代码地址:https://github.com/Snailclimb/springboot-guide/tree/master/source-code/basis/jpa-demo

## 6. 总结

本文主要介绍了 JPA 的基本用法:

1. 使用 JPA 自带的方法进行增删改查以及条件查询。

2. 自定义 SQL  语句进行查询或者更新数据库。

3. 创建异步的方法。


在下一篇关于 JPA 的文章中我会介绍到非常重要的两个知识点:

1. 基本分页功能实现
2. 多表联合查询以及多表联合查询下的分页功能实现。


---

## springboot jpa lianbiao

# JPA 连表查询和分页

对于连表查询,在 JPA 中还是非常常见的,由于  JPA 可以在 respository 层自定义 SQL 语句,所以通过自定义 SQL 语句的方式实现连表还是挺简单。这篇文章是在上一篇[入门 JPA](https://raw.githubusercontent.com/CodingDocs/springboot-guide/HEAD/springboot-jpa.md)的文章的基础上写的,不了解 JPA 的可以先看上一篇文章。

在[上一节](https://raw.githubusercontent.com/CodingDocs/springboot-guide/HEAD/springboot-jpa.md)的基础上我们新建了两个实体类,如下:

## 相关实体类创建

`Company.java`
java @Entity @Data @NoArgsConstructor public class Company {
@Id
@GeneratedValue(strategy = GenerationType.IDENTITY)
private Long id;
@Column(unique = true)
private String companyName;
private String description;
public Company(String name, String description) {
this.companyName = name;
this.description = description;
}}
`School.java`java @Entity @Data @NoArgsConstructor @AllArgsConstructor public class School {
@Id
@GeneratedValue(strategy = GenerationType.IDENTITY)
private Long id;
@Column(unique = true)
private String name;
private String description;
}
## 自定义 SQL语句实现连表查询

假如我们当前要通过 person 表的 id 来查询 Person 的话,我们知道 Person 的信息一共分布在`Company`、`School`、`Person`这三张表中,所以,我们如果要把 Person 的信息都查询出来的话是需要进行连表查询的。

首先我们需要创建一个包含我们需要的 Person 信息的 DTO 对象,我们简单第将其命名为 `UserDTO`,用于保存和传输我们想要的信息。
java @Data @NoArgsConstructor @Builder(toBuilder = true) @AllArgsConstructor public class UserDTO {
private String name;
private int age;
private String companyName;
private String schoolName;
}
下面我们就来写一个方法查询出 Person 的基本信息。java
/**
 * 连表查询
 */
@Query(value = "select new github.snailclimb.jpademo.model.dto.UserDTO(p.name,p.age,c.companyName,s.name) " +
        "from Person p left join Company c on  p.companyId=c.id " +
        "left join School s on p.schoolId=s.id " +
        "where p.id=:personId")
Optional<UserDTO> getUserInformation(@Param("personId") Long personId);
可以看出上面的 sql 语句和我们平时写的没啥区别,差别比较大的就是里面有一个 new 对象的操作。

## 自定义 SQL 语句连表查询并实现分页操作

假如我们要查询当前所有的人员信息并实现分页的话,你可以按照下面这种方式来做。可以看到,为了实现分页,我们在`@Query`注解中还添加了 **countQuery** 属性。
java @Query(value = "select new github.snailclimb.jpademo.model.dto.UserDTO(p.name,p.age,c.companyName,s.name) " +
    "from Person p left join Company c on  p.companyId=c.id " +
    "left join School s on p.schoolId=s.id ",
    countQuery = "select count(p.id) " +
            "from Person p left join Company c on  p.companyId=c.id " +
            "left join School s on p.schoolId=s.id ")
Page
实际使用:java
//分页选项
PageRequest pageRequest = PageRequest.of(0, 3, Sort.Direction.DESC, "age");
Page
## 加餐:自定以SQL语句的其他用法

下面我只介绍两种比较常用的:

1. IN 查询
2. BETWEEN 查询

当然,还有很多用法需要大家自己去实践了。

### IN 查询

 在 sql 语句中加入我们需要筛选出符合几个条件中的一个的情况下,可以使用 IN 查询,对应到 JPA 中也非常简单。比如下面的方法就实现了,根据名字过滤需要的人员信息。
java @Query(value = "select new github.snailclimb.jpademo.model.dto.UserDTO(p.name,p.age,c.companyName,s.name) " +
    "from Person p left join Company c on  p.companyId=c.id " +
    "left join School s on p.schoolId=s.id " +
    "where p.name IN :peopleList")
List
实际使用:java
List
### BETWEEN 查询

查询满足某个范围的值。比如下面的方法就实现查询满足某个年龄范围的人员的信息。
java
@Query(value = "select new github.snailclimb.jpademo.model.dto.UserDTO(p.name,p.age,c.companyName,s.name) " +
        "from Person p left join Company c on  p.companyId=c.id " +
        "left join School s on p.schoolId=s.id " +
        "where p.age between :small and :big")
List<UserDTO> filterUserInfoByAge(int small,int big);
实际使用:java
List
## 总结

本节我们主要学习了下面几个知识点:

1. 自定义 SQL 语句实现连表查询;
2. 自定义 SQL 语句连表查询并实现分页操作;
3. 条件查询:IN 查询,BETWEEN查询。


---

## springboot filter

### 1. Filter 介绍

Filter 过滤器这个概念应该大家不会陌生,特别是对与从 Servlet 开始入门学 Java 后台的同学来说。那么这个东西我们能做什么呢?Filter 过滤器主要是用来过滤用户请求的,它允许我们对用户请求进行前置处理和后置处理,比如实现 URL 级别的权限控制、过滤非法请求等等。Filter 过滤器是面向切面编程——AOP 的具体实现(AOP切面编程只是一种编程思想而已)。

另外,Filter 是依赖于 Servlet 容器,`Filter`接口就在 Servlet 包下面,属于 Servlet 规范的一部分。所以,很多时候我们也称其为“增强版 Servlet”。

如果我们需要自定义 Filter 的话非常简单,只需要实现 `javax.Servlet.Filter` 接口,然后重写里面的 3 个方法即可!

`Filter.java`
java public interface Filter {
//初始化过滤器后执行的操作
default void init(FilterConfig filterConfig) throws ServletException {
}
// 对请求进行过滤
void doFilter(ServletRequest var1, ServletResponse var2, FilterChain var3) throws IOException, ServletException;// 销毁过滤器后执行的操作,主要用户对某些资源的回收
default void destroy() {
}
}
### 2. Filter是如何实现拦截的?
`Filter`接口中有一个叫做 `doFilter` 的方法,这个方法实现了对用户请求的过滤。具体流程大体是这样的:
1. 用户发送请求到 web 服务器,请求会先到过滤器;
2. 过滤器会对请求进行一些处理比如过滤请求的参数、修改返回给客户端的 response 的内容、判断是否让用户访问该接口等等。
3. 用户请求响应完毕。
4. 进行一些自己想要的其他操作。

### 3. 如何自定义Filter
下面提供两种方法。
#### 3.1自己手动注册配置实现
**自定义的 Filter 需要实现`javax.Servlet.Filter`接口,并重写接口中定义的3个方法。**
`MyFilter.java`java /**
- @author shuang.kou
*/ @Component public class MyFilter implements Filter {
private static final Logger logger = LoggerFactory.getLogger(MyFilter.class);@Override
public void init(FilterConfig filterConfig) {
logger.info("初始化过滤器:", filterConfig.getFilterName());
}@Override
public void doFilter(ServletRequest servletRequest, ServletResponse servletResponse, FilterChain filterChain) throws IOException, ServletException {
//对请求进行预处理
logger.info("过滤器开始对请求进行预处理:");
HttpServletRequest request = (HttpServletRequest) servletRequest;
String requestUri = request.getRequestURI();
System.out.println("请求的接口为:" + requestUri);
long startTime = System.currentTimeMillis();
//通过 doFilter 方法实现过滤功能
filterChain.doFilter(servletRequest, servletResponse);
// 上面的 doFilter 方法执行结束后用户的请求已经返回
long endTime = System.currentTimeMillis();
System.out.println("该用户的请求已经处理完毕,请求花费的时间为:" + (endTime - startTime));
}@Override
public void destroy() {
logger.info("销毁过滤器");
}}
`MyFilterConfig.java`

**在配置中注册自定义的过滤器。**
java @Configuration public class MyFilterConfig {
@Autowired
MyFilter myFilter;
@Bean
public FilterRegistrationBean<MyFilter> thirdFilter() {
    FilterRegistrationBean<MyFilter> filterRegistrationBean = new FilterRegistrationBean<>();
filterRegistrationBean.setFilter(myFilter); filterRegistrationBean.setUrlPatterns(new ArrayList<>(Arrays.asList("/api/*"))); return filterRegistrationBean;
}}
#### 3.2 通过提供好的一些注解实现
**在自己的过滤器的类上加上`@WebFilter` 然后在这个注解中通过它提供好的一些参数进行配置。**java @WebFilter(filterName = "MyFilterWithAnnotation", urlPatterns = "/api/*") public class MyFilterWithAnnotation implements Filter {
...... }
另外,为了能让 Spring 找到它,你需要在启动类上加上 `@ServletComponentScan` 注解。
### 4.定义多个拦截器,并决定它们的执行顺序
**假如我们现在又加入了一个过滤器怎么办?**
`MyFilter2.java`java @Component public class MyFilter2 implements Filter {
private static final Logger logger = LoggerFactory.getLogger(MyFilter2.class);@Override
public void init(FilterConfig filterConfig) {
logger.info("初始化过滤器2");
}@Override
public void doFilter(ServletRequest servletRequest, ServletResponse servletResponse, FilterChain filterChain) throws IOException, ServletException {
//对请求进行预处理
logger.info("过滤器开始对请求进行预处理2:");
HttpServletRequest request = (HttpServletRequest) servletRequest;
String requestUri = request.getRequestURI();
System.out.println("请求的接口为2:" + requestUri);
long startTime = System.currentTimeMillis();
//通过 doFilter 方法实现过滤功能
filterChain.doFilter(servletRequest, servletResponse);
// 上面的 doFilter 方法执行结束后用户的请求已经返回
long endTime = System.currentTimeMillis();
System.out.println("该用户的请求已经处理完毕,请求花费的时间为2:" + (endTime - startTime));
}@Override
public void destroy() {
logger.info("销毁过滤器2");
}}
**在配置中注册自定义的过滤器,通过`FilterRegistrationBean` 的`setOrder` 方法可以决定 Filter 的执行顺序。**java @Configuration public class MyFilterConfig {
@Autowired
MyFilter myFilter;@Autowired
MyFilter2 myFilter2;@Bean
public FilterRegistrationBean<MyFilter> setUpMyFilter() {
FilterRegistrationBean<MyFilter> filterRegistrationBean = new FilterRegistrationBean<>();
filterRegistrationBean.setOrder(2);
filterRegistrationBean.setFilter(myFilter);
filterRegistrationBean.setUrlPatterns(new ArrayList<>(Arrays.asList("/api/*"))); return filterRegistrationBean;
}@Bean
public FilterRegistrationBean<MyFilter2> setUpMyFilter2() {
FilterRegistrationBean<MyFilter2> filterRegistrationBean = new FilterRegistrationBean<>();
filterRegistrationBean.setOrder(1);
filterRegistrationBean.setFilter(myFilter2);
filterRegistrationBean.setUrlPatterns(new ArrayList<>(Arrays.asList("/api/*")));
    return filterRegistrationBean;
}
}
**自定义 Controller 验证过滤器**java import org.springframework.web.bind.annotation.GetMapping; import org.springframework.web.bind.annotation.RequestMapping; import org.springframework.web.bind.annotation.RestController;
@RestController @RequestMapping("/api") public class MyController {
@GetMapping("/hello")
public String getHello() throws InterruptedException {
    Thread.sleep(1000);
    return "Hello";
}
}
**实际测试效果如下:**shell 2019-10-22 22:32:15.569 INFO 1771 --- [ main] g.j.springbootfilter.filter.MyFilter2 : 初始化过滤器2 2019-10-22 22:32:15.569 INFO 1771 --- [ main] g.j.springbootfilter.filter.MyFilter : 初始化过滤器 2019-10-22 22:32:55.199 INFO 1771 --- [nio-8080-exec-1] g.j.springbootfilter.filter.MyFilter2 : 过滤器开始对请求进行预处理2: 请求的接口为2:/api/hello 2019-10-22 22:32:55.199 INFO 1771 --- [nio-8080-exec-1] g.j.springbootfilter.filter.MyFilter : 过滤器开始对请求进行预处理: 请求的接口为:/api/hello 该用户的请求已经处理完毕,请求花费的时间为:1037 该用户的请求已经处理完毕,请求花费的时间为2:1037
代码地址:https://github.com/Snailclimb/springboot-guide/tree/master/source-code/basis/springboot-filter-interceptor
---
## springboot mybatis
<!-- MarkdownTOC -->
- [一 开发前的准备](#一-开发前的准备)
- [1.1 环境参数](#11-环境参数)
- [1.2 创建工程](#12-创建工程)
- [1.3 创建数据库和 user 用户表](#13-创建数据库和-user-用户表)
- [1.4 配置 pom 文件中的相关依赖](#14-配置-pom-文件中的相关依赖)
- [1.5 配置 application.properties](#15-配置-applicationproperties)
- [1.6 创建用户类 Bean](#16-创建用户类-bean)
- [二 全注解的方式](#二-全注解的方式)
- [2.1 Dao 层开发](#21-dao-层开发)
- [2.2 service 层](#22-service-层)
- [2.3 Controller 层](#23-controller-层)
- [2.4 启动类](#24-启动类)
- [2.5 简单测试](#25-简单测试)
- [三 xml 的方式](#三-xml-的方式)
- [3.1 Dao 层的改动](#31-dao-层的改动)
- [3.2 配置文件的改动](#32-配置文件的改动)
<!-- /MarkdownTOC -->
SpringBoot 整合 Mybatis 有两种常用的方式,一种就是我们常见的 xml 的方式 ,还有一种是全注解的方式。我觉得这两者没有谁比谁好,在 SQL 语句不太长的情况下,我觉得全注解的方式一定是比较清晰简洁的。但是,复杂的 SQL 确实不太适合和代码写在一起。
下面就开始吧!
## 一 开发前的准备
### 1.1 环境参数
- 开发工具:IDEA
- 基础工具:Maven+JDK8
- 所用技术:SpringBoot+Mybatis
- 数据库:MySQL
- SpringBoot版本:2.1.0
### 1.2 创建工程
创建一个基本的 SpringBoot 项目,我这里就不多说这方面问题了,具体可以参考前面的文章。
### 1.3 创建数据库和 user 用户表
我们的用户表很简单,只有 4 个字段:用户 id、姓名、年龄、余额,如下图所示:

添加了“余额money”字段是为了给大家简单的演示一下事务管理的方式。
**建表语句:**sql
CREATE TABLE user (
id int(13) NOT NULL AUTO_INCREMENT COMMENT '主键',
name varchar(33) DEFAULT NULL COMMENT '姓名',
age int(3) DEFAULT NULL COMMENT '年龄',
money double DEFAULT NULL COMMENT '账户余额',
PRIMARY KEY (id)
) ENGINE=InnoDB AUTO_INCREMENT=5 DEFAULT CHARSET=utf8
### 1.4 配置 pom 文件中的相关依赖

由于要整合 springboot 和 mybatis 所以加入了artifactId 为 mybatis-spring-boot-starter 的依赖,由于使用了Mysql 数据库 所以加入了artifactId 为 mysql-connector-java 的依赖。
xml
### 1.5 配置 application.properties

由于我使用的是比较新的Mysql连接驱动,所以配置文件可能和之前有一点不同。
properties server.port=8333 spring.datasource.url=jdbc:mysql://127.0.0.1:3306/erp?useUnicode=true&characterEncoding=utf8&useSSL=false&serverTimezone=GMT%2B8 spring.datasource.username=root spring.datasource.password=root spring.datasource.driver-class-name=com.mysql.cj.jdbc.Driver
注意:我们使用的 mysql-connector-java 8+ ,JDBC 连接到mysql-connector-java 6+以上的需要指定时区 `serverTimezone=GMT%2B8`。另外我们之前使用配置 Mysql数据连接是一般是这样指定`driver-class-name=com.mysql.jdbc.Driver`,但是现在不可以必须为 否则控制台下面的异常:error
Loading class com.mysql.jdbc.Driver'. This is deprecated. The new driver class is com.mysql.cj.jdbc.Driver'. The driver is automatically registered via the SPI and manual loading of the driver class is generally unnecessary.
上面异常的意思是:`com.mysql.jdbc.Driver` 被弃用了。新的驱动类是 `com.mysql.cj.jdbc.Driver`。驱动程序通过SPI自动注册,手动加载类通常是不必要。

如果你非要写把`com.mysql.jdbc.Driver` 改为`com.mysql.cj.jdbc.Driver `即可。

### 1.6 创建用户类 Bean

User.java
java public class User {
private int id;
private String name;
private int age;
private double money;
...
此处省略getter、setter以及 toString方法
}
## 二 全注解的方式
先来看一下 全注解的方式,这种方式和后面提到的 xml 的方式的区别仅仅在于 一个将 sql 语句写在 java 代码中,一个写在 xml 配置文件中。全注方式解转换成 xml 方式仅需做一点点改变即可,我在后面会提到。
**项目结构:**

### 2.1 Dao 层开发
UserDao.javajava @Mapper public interface UserDao {
/**
 * 通过名字查询用户信息
 */
@Select("SELECT * FROM user WHERE name = #{name}")
User findUserByName(@Param("name") String name);
/**
* 查询所有用户信息
*/
@Select("SELECT * FROM user")
List<User> findAllUser();/**
* 插入用户信息
*/
@Insert("INSERT INTO user(name, age,money) VALUES(#{name}, #{age}, #{money})")
void insertUser(@Param("name") String name, @Param("age") Integer age, @Param("money") Double money);/**
* 根据 id 更新用户信息
*/
@Update("UPDATE user SET name = #{name},age = #{age},money= #{money} WHERE id = #{id}")
void updateUser(@Param("name") String name, @Param("age") Integer age, @Param("money") Double money,
@Param("id") int id);/**
* 根据 id 删除用户信息
*/
@Delete("DELETE from user WHERE id = #{id}")
void deleteUser(@Param("id") int id);}
### 2.2 service 层java @Service public class UserService {
@Autowired
private UserDao userDao;
/**
* 根据名字查找用户
*/
public User selectUserByName(String name) {
return userDao.findUserByName(name);
}/**
* 查找所有用户
*/
public List<User> selectAllUser() {
return userDao.findAllUser();
}/**
* 插入两个用户
*/
public void insertService() {
userDao.insertUser("SnailClimb", 22, 3000.0);
userDao.insertUser("Daisy", 19, 3000.0);
}/**
* 根据id 删除用户
*/public void deleteService(int id) {
userDao.deleteUser(id);
}/**
* 模拟事务。由于加上了 @Transactional注解,如果转账中途出了意外 SnailClimb 和 Daisy 的钱都不会改变。
*/
@Transactional
public void changemoney() {
userDao.updateUser("SnailClimb", 22, 2000.0, 3);
// 模拟转账过程中可能遇到的意外状况
int temp = 1 / 0;
userDao.updateUser("Daisy", 19, 4000.0, 4);
}}
### 2.3 Controller 层java @RestController @RequestMapping("/user") public class UserController {
@Autowired
private UserService userService;
@RequestMapping("/query")
public User testQuery() {
return userService.selectUserByName("Daisy");
}@RequestMapping("/insert")
public List<User> testInsert() {
userService.insertService();
return userService.selectAllUser();
}@RequestMapping("/changemoney")
public List<User> testchangemoney() {
userService.changemoney();
return userService.selectAllUser();
}@RequestMapping("/delete")
public String testDelete() {
userService.deleteService(3);
return "OK";
}}
### 2.4 启动类java //此注解表示SpringBoot启动类 @SpringBootApplication // 此注解表示动态扫描DAO接口所在包,实际上不加下面这条语句也可以找到 @MapperScan("top.snailclimb.dao") public class MainApplication {
public static void main(String[] args) {
    SpringApplication.run(MainApplication.class, args);
}
}
### 2.5 简单测试
上述代码经过测试都没问题,这里贴一下根据姓名查询的测试的结果。

## 三 xml 的方式
**项目结构:**

相比于注解的方式主要有以下几点改变,非常容易实现。
### 3.1 Dao 层的改动
我这里只演示一个根据姓名找人的方法。
**UserDao.java**java @Mapper public interface UserDao {
/**
 * 通过名字查询用户信息
 */
User findUserByName(String name);
}
**UserMapper.xml**xml
"http://mybatis.org/dtd/mybatis-3-mapper.dtd">
### 3.2 配置文件的改动
配置文件中加入下面这句话:
`mybatis.mapper-locations=classpath:mapper/*.xml`
代码地址:https://github.com/Snailclimb/springboot-guide/tree/master/source-code/basis/springboot-mybatis
---
## springboot mybatis mutipledatasource
在上一篇文章[《优雅整合 SpringBoot+Mybatis ,可能是你见过最详细的一篇》](https://github.com/Snailclimb/springboot-integration-examples/blob/master/md/springboot-mybatis.md)中,带着大家整合了 SpringBoot 和 Mybatis ,我们在当时使用的时单数据源的情况,这种情况下 Spring Boot的配置非常简单,只需要在 application.properties 文件中配置数据库的相关连接参数即可。但是往往随着业务量发展,我们通常会进行数据库拆分或是引入其他数据库,从而我们需要配置多个数据源。下面基于 SpringBoot+Mybatis ,带着大家看一下 SpringBoot 中如何配置多数据源。
这篇文章所涉及的代码其实是基于上一篇文章[《优雅整合 SpringBoot+Mybatis ,可能是你见过最详细的一篇》](https://github.com/Snailclimb/springboot-integration-examples/blob/master/md/springboot-mybatis.md) 的项目写的,但是为了考虑部分读者没有读过上一篇文章,所以我还是会一步一步带大家走完每一步,力争新手也能在看完之后独立实践。
**目录:**
<!-- MarkdownTOC -->
- [一 开发前的准备](#一-开发前的准备)
- [1.1 环境参数](#11-环境参数)
- [1.2 创建工程](#12-创建工程)
- [1.3 创建两个数据库和 user 用户表、money工资详情表](#13-创建两个数据库和-user-用户表、money工资详情表)
- [1.4 配置 pom 文件中的相关依赖](#14-配置-pom-文件中的相关依赖)
- [1.5 配置 application.properties](#15-配置-applicationproperties)
- [1.6 创建用户类 Bean和工资详情类 Bean](#16-创建用户类-bean和工资详情类-bean)
- [二 数据源配置](#二-数据源配置)
- [三 Dao 层开发和 Service 层开发](#三-dao-层开发和-service-层开发)
- [3.1 Dao 层](#31-dao-层)
- [3.2 Service 层](#32-service-层)
- [四 Controller层](#四-controller层)
- [五 启动类](#五-启动类)
<!-- /MarkdownTOC -->
## 一 开发前的准备
### 1.1 环境参数
- 开发工具:IDEA
- 基础工具:Maven+JDK8
- 所用技术:SpringBoot+Mybatis
- 数据库:MySQL
- SpringBoot版本:**2.1.0.** SpringBoot2.0之后会有一些小坑,这篇文章会给你介绍到。注意版本不一致导致的一些小问题。
### 1.2 创建工程
创建一个基本的 SpringBoot 项目,我这里就不多说这方面问题了,具体可以参考下面这篇文章:
[https://blog.csdn.net/qq_34337272/article/details/79563606](https://blog.csdn.net/qq_34337272/article/details/79563606)
本项目结构:

### 1.3 创建两个数据库和 user 用户表、money工资详情表
我们一共创建的两个数据库,然后分别在这两个数据库中创建了 user 用户表、money工资详情表。
我们的用户表很简单,只有 4 个字段:用户 id、姓名、年龄、余额。如下图所示:

添加了“余额money”字段是为了给大家简单的演示一下事务管理的方式。
我们的工资详情表也很简单,也只有 4 个字段: id、基本工资、奖金和惩罚金。如下图所示:

**建表语句:**
用户表:sql
CREATE TABLE user (
id int(13) NOT NULL AUTO_INCREMENT COMMENT '主键',
name varchar(33) DEFAULT NULL COMMENT '姓名',
age int(3) DEFAULT NULL COMMENT '年龄',
money double DEFAULT NULL COMMENT '账户余额',
PRIMARY KEY (id)
) ENGINE=InnoDB AUTO_INCREMENT=5 DEFAULT CHARSET=utf8
工资详情表:sql
CREATE TABLE money (
id int(33) NOT NULL AUTO_INCREMENT COMMENT '主键',
basic int(33) DEFAULT NULL COMMENT '基本工资',
reward int(33) DEFAULT NULL COMMENT '奖金',
punishment int(33) DEFAULT NULL COMMENT '惩罚金',
PRIMARY KEY (id)
) ENGINE=InnoDB AUTO_INCREMENT=2 DEFAULT CHARSET=utf8
### 1.4 配置 pom 文件中的相关依赖

由于要整合 springboot 和 mybatis 所以加入了artifactId 为 mybatis-spring-boot-starter 的依赖,由于使用了Mysql 数据库 所以加入了artifactId 为 mysql-connector-java 的依赖。
xml
### 1.5 配置 application.properties

配置两个数据源:数据库1和数据库2!

注意事项:

在1.0 配置数据源的过程中主要是写成:spring.datasource.url 和spring.datasource.driverClassName。
而在2.0升级之后需要变更成:spring.datasource.jdbc-url和spring.datasource.driver-class-name!不然在连接数据库时可能会报下面的错误:
Error querying database. Cause: java.lang.IllegalArgumentException: jdbcUrl is required with driverClassName.
另外在在2.0.2+版本后需要在datasource后面加上hikari,如果你没有加的话,同样可能会报错。properties server.port=8335
配置第一个数据源
spring.datasource.hikari.db1.jdbc-url=jdbc:mysql://127.0.0.1:3306/erp?useUnicode=true&characterEncoding=utf8&useSSL=true&serverTimezone=GMT%2B8 spring.datasource.hikari.db1.username=root spring.datasource.hikari.db1.password=153963 spring.datasource.hikari.db1.driver-class-name=com.mysql.cj.jdbc.Driver
配置第二个数据源
spring.datasource.hikari.db2.jdbc-url=jdbc:mysql://127.0.0.1:3306/erp2?useUnicode=true&characterEncoding=utf8&useSSL=true&serverTimezone=GMT%2B8 spring.datasource.hikari.db2.username=root spring.datasource.hikari.db2.password=153963 spring.datasource.hikari.db2.driver-class-name=com.mysql.cj.jdbc.Driver
### 1.6 创建用户类 Bean和工资详情类 Bean

User.java
java public class User {
private int id;
private String name;
private int age;
private double money;
...
此处省略getter、setter以及 toString方法
}
Money.javajava public class Money {
private int basic;
private int reward;
private int punishment;
...
此处省略getter、setter以及 toString方法
}
## 二 数据源配置

通过 Java 类来实现对两个数据源的配置,这一部分是最关键的部分了,这里主要提一下下面这几点:

- `@MapperScan` 注解中我们声明了使用数据库1的dao类所在的位置,还声明了 SqlSessionTemplate  。SqlSessionTemplate是MyBatis-Spring的核心。这个类负责管理MyBatis的SqlSession,调用MyBatis的SQL方法,翻译异常。SqlSessionTemplate是线程安全的,可以被多个DAO所共享使用。
- 由于我使用的是全注解的方式开发,所以下面这条找并且解析 mapper.xml 配置语句被我注释掉了
 `bean.setMapperLocations(new PathMatchingResourcePatternResolver().getResources("classpath:mybatis/mapper/db2/*.xml"));`
- 比如我们要声明使用数据1,直接在 dao 层的类上加上这样一个注释即可:`@Qualifier("db1SqlSessionTemplate")`
- 我们在数据库1配置类的每个方法前加上了 `@Primary` 注解来声明这个数据库时默认数据库,不然可能会报错。


DataSource1Config.java
java @Configuration @MapperScan(basePackages = "top.snailclimb.db1.dao", sqlSessionTemplateRef = "db1SqlSessionTemplate") public class DataSource1Config {
/**
 * 生成数据源.  @Primary 注解声明为默认数据源
 */
@Bean(name = "db1DataSource")
@ConfigurationProperties(prefix = "spring.datasource.hikari.db1")
@Primary
public DataSource testDataSource() {
    return DataSourceBuilder.create().build();
}
/**
* 创建 SqlSessionFactory
*/
@Bean(name = "db1SqlSessionFactory")
@Primary
public SqlSessionFactory testSqlSessionFactory(@Qualifier("db1DataSource") DataSource dataSource) throws Exception {
SqlSessionFactoryBean bean = new SqlSessionFactoryBean();
bean.setDataSource(dataSource);
// bean.setMapperLocations(new PathMatchingResourcePatternResolver().getResources("classpath:mybatis/mapper/db1/*.xml"));
return bean.getObject();
}/**
* 配置事务管理
*/
@Bean(name = "db1TransactionManager")
@Primary
public DataSourceTransactionManager testTransactionManager(@Qualifier("db1DataSource") DataSource dataSource) {
return new DataSourceTransactionManager(dataSource);
}@Bean(name = "db1SqlSessionTemplate")
@Primary
public SqlSessionTemplate testSqlSessionTemplate(@Qualifier("db1SqlSessionFactory") SqlSessionFactory sqlSessionFactory) throws Exception {
return new SqlSessionTemplate(sqlSessionFactory);
}}
DataSource2Config.javajava @Configuration @MapperScan(basePackages = "top.snailclimb.db2.dao", sqlSessionTemplateRef = "db2SqlSessionTemplate") public class DataSource2Config {
@Bean(name = "db2DataSource")
@ConfigurationProperties(prefix = "spring.datasource.hikari.db2")
public DataSource testDataSource() {
    return DataSourceBuilder.create().build();
}
@Bean(name = "db2SqlSessionFactory")
public SqlSessionFactory testSqlSessionFactory(@Qualifier("db2DataSource") DataSource dataSource) throws Exception {
SqlSessionFactoryBean bean = new SqlSessionFactoryBean();
bean.setDataSource(dataSource);
//bean.setMapperLocations(new PathMatchingResourcePatternResolver().getResources("classpath:mybatis/mapper/db2/*.xml"));
return bean.getObject();
}@Bean(name = "db2TransactionManager")
public DataSourceTransactionManager testTransactionManager(@Qualifier("db2DataSource") DataSource dataSource) {
return new DataSourceTransactionManager(dataSource);
}@Bean(name = "db2SqlSessionTemplate")
public SqlSessionTemplate testSqlSessionTemplate(@Qualifier("db2SqlSessionFactory") SqlSessionFactory sqlSessionFactory) throws Exception {
return new SqlSessionTemplate(sqlSessionFactory);
}}
## 三 Dao 层开发和 Service 层开发
新建两个不同的包存放两个不同数据库的 dao 和 service。

### 3.1 Dao 层
对于两个数据库,我们只是简单的测试一个查询这个操作。在上一篇文章[《优雅整合 SpringBoot+Mybatis ,可能是你见过最详细的一篇》](https://github.com/Snailclimb/springboot-integration-examples/blob/master/md/springboot-mybatis.md)中,我带着大家使用注解实现了数据库基本的增删改查操作。
UserDao.javajava @Qualifier("db1SqlSessionTemplate") public interface UserDao {
/**
 * 通过名字查询用户信息
 */
@Select("SELECT * FROM user WHERE name = #{name}")
User findUserByName(String name);
}
MoneyDao.javajava
@Qualifier("db2SqlSessionTemplate") public interface MoneyDao {
/**
 * 通过id 查看工资详情
 */
@Select("SELECT * FROM money WHERE id = #{id}")
Money findMoneyById(@Param("id") int id);
}
### 3.2 Service 层

Service 层很简单,没有复杂的业务逻辑。

UserService.java
java @Service public class UserService {
@Autowired
private UserDao userDao;
/**
* 根据名字查找用户
*/
public User selectUserByName(String name) {
return userDao.findUserByName(name);
}}
MoneyService.javajava @Service public class MoneyService {
@Autowired
private MoneyDao moneyDao;
/**
* 根据名字查找用户
*/
public Money selectMoneyById(int id) {
return moneyDao.findMoneyById(id);
}}
## 四 Controller层

Controller 层也非常简单。

UserController.java
java @RestController @RequestMapping("/user") public class UserController {
@Autowired
private UserService userService;
@RequestMapping("/query")
public User testQuery() {
return userService.selectUserByName("Daisy");
}}
MoneyController.javajava @RestController @RequestMapping("/money") public class MoneyController {
@Autowired
private MoneyService moneyService;
@RequestMapping("/query")
public Money testQuery() {
return moneyService.selectMoneyById(1);
}}
## 五 启动类java //此注解表示SpringBoot启动类 @SpringBootApplication public class MainApplication {
public static void main(String[] args) {
    SpringApplication.run(MainApplication.class, args);
}
}
这样基于SpirngBoot2.0+ 的 SpringBoot+Mybatis 多数据源配置就已经完成了, 两个数据库都可以被访问了。


---

## MyBatisPlus

`MyBatis` 是一款优秀的持久层框架,它支持定制化 SQL、存储过程以及高级映射,而实际开发中,我们都会选择使用 `MyBatisPlus`,它是对 `MyBatis` 框架的进一步增强,能够极大地简化我们的持久层代码,下面就一起来看看 `MyBatisPlus` 中的一些奇淫巧技吧。

> 说明:本篇文章需要一定的 `MyBatis` 与 `MyBatisPlus` 基础

MyBatis-Plus 官网地址 : https://baomidou.com/ 。

## CRUD

使用 `MyBatisPlus` 实现业务的增删改查非常地简单,一起来看看吧。

**1.首先新建一个 SpringBoot 工程,然后引入依赖:**
xml
**2.配置一下数据源:**yaml spring: datasource:
driver-class-name: com.mysql.cj.jdbc.Driver
username: root
url: jdbc:mysql:///mybatisplus?serverTimezone=UTC
password: 123456
**3.创建一下数据表:**sql
CREATE DATABASE mybatisplus;
USE mybatisplus;
DROP TABLE IF EXISTS tbl_employee;
CREATE TABLE tbl_employee (
id bigint(20) NOT NULL,
last_name varchar(255) DEFAULT NULL,
email varchar(255) DEFAULT NULL,
gender char(1) DEFAULT NULL,
age int(11) DEFAULT NULL,
PRIMARY KEY (id)
) ENGINE=InnoDB AUTO_INCREMENT=8 DEFAULT CHARSET=gbk;
insert into tbl_employee(id,last_name,email,gender,age) values (1,'jack','jack@qq.com','1',35),(2,'tom','tom@qq.com','1',30),(3,'jerry','jerry@qq.com','1',40);
**4.创建对应的实体类:**java @Data public class Employee {
private Long id;
private String lastName;
private String email;
private Integer age;
}
**4.编写 `Mapper` 接口:**java
public interface EmployeeMapper extends BaseMapper
我们只需继承 `MyBatisPlus` 提供的 `BaseMapper` 接口即可,现在我们就拥有了对 `Employee` 进行增删改查的 API,比如:java @SpringBootTest @MapperScan("com.wwj.mybatisplusdemo.mapper") class MybatisplusDemoApplicationTests {
@Autowired
private EmployeeMapper employeeMapper;
@Test
void contextLoads() {
List<Employee> employees = employeeMapper.selectList(null);
employees.forEach(System.out::println);
}}
运行结果:java org.springframework.jdbc.BadSqlGrammarException:
Error querying database. Cause: java.sql.SQLSyntaxErrorException: Table 'mybatisplus.employee' doesn't exist
程序报错了,原因是不存在 `employee` 表,这是因为我们的实体类名为 `Employee`,`MyBatisPlus` 默认是以类名作为表名进行操作的,可如果类名和表名不相同(实际开发中也确实可能不同),就需要在实体类中使用 `@TableName` 注解来声明表的名称:java @Data @TableName("tbl_employee") // 声明表名称 public class Employee {
private Long id;
private String lastName;
private String email;
private Integer age;
}
重新执行测试代码,结果如下:java Employee(id=1, lastName=jack, email=jack@qq.com, age=35) Employee(id=2, lastName=tom, email=tom@qq.com, age=30) Employee(id=3, lastName=jerry, email=jerry@qq.com, age=40)
`BaseMapper` 提供了常用的一些增删改查方法:
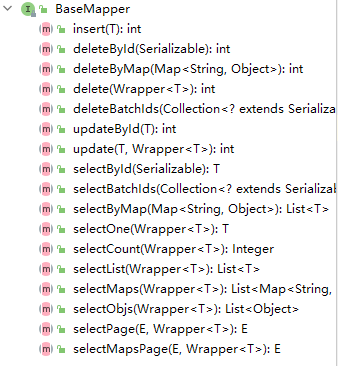
具体细节可以查阅其源码自行体会,注释都是中文的,非常容易理解。
在开发过程中,我们通常会使用 `Service` 层来调用 `Mapper` 层的方法,而 `MyBatisPlus` 也为我们提供了通用的 `Service`:java
public interface EmployeeService extends IService
@Service
public class EmployeeServiceImpl extends ServiceImpl
事实上,我们只需让 `EmployeeServiceImpl` 继承 `ServiceImpl` 即可获得 `Service` 层的方法,**那么为什么还需要实现 `EmployeeService` 接口呢?**

这是因为实现 `EmployeeService` 接口能够更方便地对业务进行扩展,一些复杂场景下的数据处理,`MyBatisPlus` 提供的 `Service` 方法可能无法处理,此时我们就需要自己编写代码,这时候只需在 `EmployeeService` 中定义自己的方法,并在 `EmployeeServiceImpl` 中实现即可。

先来测试一下 `MyBatisPlus` 提供的 `Service` 方法:
java @SpringBootTest @MapperScan("com.wwj.mybatisplusdemo.mapper") class MybatisplusDemoApplicationTests {
@Autowired
private EmployeeService employeeService;
@Test
void contextLoads() {
List<Employee> list = employeeService.list();
list.forEach(System.out::println);
}}
运行结果:java Employee(id=1, lastName=jack, email=jack@qq.com, age=35) Employee(id=2, lastName=tom, email=tom@qq.com, age=30) Employee(id=3, lastName=jerry, email=jerry@qq.com, age=40)
接下来模拟一个自定义的场景,我们来编写自定义的操作方法,首先在 `EmployeeMapper` 中进行声明:java
public interface EmployeeMapper extends BaseMapper
List<Employee> selectAllByLastName(@Param("lastName") String lastName);}
此时我们需要自己编写配置文件实现该方法,在 `resource` 目录下新建一个 `mapper` 文件夹,然后在该文件夹下创建 `EmployeeMapper.xml` 文件:xml
    PUBLIC "-//mybatis.org//DTD Mapper 3.0//EN"
    "http://mybatis.org/dtd/mybatis-3-mapper.dtd">
`MyBatisPlus` 默认扫描的是类路径下的 `mapper` 目录,这可以从源码中得到体现:
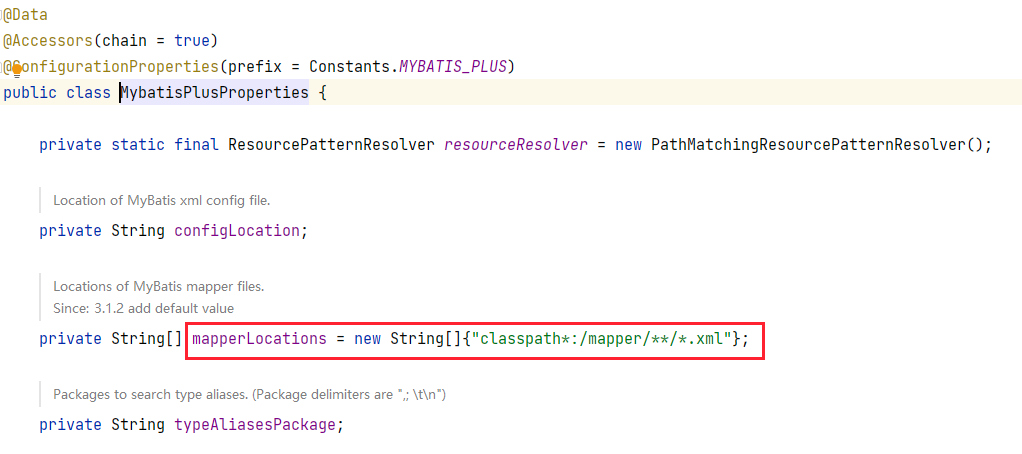
所以我们直接将 `Mapper` 配置文件放在该目录下就没有任何问题,可如果不是这个目录,我们就需要进行配置,比如:yaml mybatis-plus: mapper-locations: classpath:xml/*.xml
编写好 `Mapper` 接口后,我们就需要定义 `Service` 方法了:java
public interface EmployeeService extends IService
List<Employee> listAllByLastName(String lastName);}
@Service
public class EmployeeServiceImpl extends ServiceImpl
@Override
public List<Employee> listAllByLastName(String lastName) {
    return baseMapper.selectAllByLastName(lastName);
}
}
在 `EmployeeServiceImpl` 中我们无需将 `EmployeeMapper` 注入进来,而是使用 `BaseMapper`,查看 `ServiceImpl` 的源码:
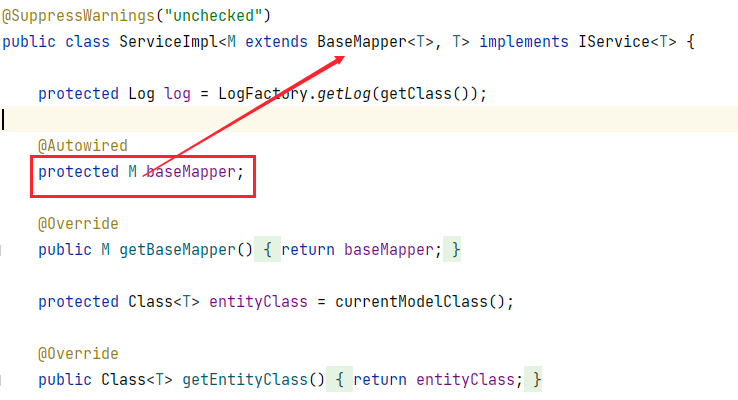
可以看到它为我们注入了一个 `BaseMapper` 对象,而它是第一个泛型类型,也就是 `EmployeeMapper` 类型,所以我们可以直接使用这个 `baseMapper` 来调用 `Mapper` 中的方法,此时编写测试代码:java @SpringBootTest @MapperScan("com.wwj.mybatisplusdemo.mapper") class MybatisplusDemoApplicationTests {
@Autowired
private EmployeeService employeeService;
@Test
void contextLoads() {
List<Employee> list = employeeService.listAllByLastName("tom");
list.forEach(System.out::println);
}}
运行结果:java Employee(id=2, lastName=tom, email=tom@qq.com, age=30)
## ID 策略

在创建表的时候我故意没有设置主键的增长策略,现在我们来插入一条数据,看看主键是如何增长的:
java @Test void contextLoads() {
Employee employee = new Employee();
employee.setLastName("lisa");
employee.setEmail("lisa@qq.com");
employee.setAge(20);
employeeService.save(employee);
}
插入成功后查询一下数据表:sql mysql> select * from tbl_employee; +---------------------+-----------+--------------+--------+------+ | id | last_name | email | gender | age | +---------------------+-----------+--------------+--------+------+ | 1 | jack | jack@qq.com | 1 | 35 | | 2 | tom | tom@qq.com | 1 | 30 | | 3 | jerry | jerry@qq.com | 1 | 40 | | 1385934720849584129 | lisa | lisa@qq.com | NULL | 20 | +---------------------+-----------+--------------+--------+------+ 4 rows in set (0.00 sec)
可以看到 id 是一串相当长的数字,这是什么意思呢?提前剧透一下,这其实是分布式 id,那又何为分布式 id 呢?
我们知道,对于一个大型应用,其访问量是非常巨大的,就比如说一个网站每天都有人进行注册,注册的用户信息就需要存入数据表,随着日子一天天过去,数据表中的用户越来越多,此时数据库的查询速度就会受到影响,所以一般情况下,当数据量足够庞大时,数据都会做分库分表的处理。
然而,一旦分表,问题就产生了,很显然这些分表的数据都是属于同一张表的数据,只是因为数据量过大而分成若干张表,那么这几张表的主键 id 该怎么管理呢?每张表维护自己的 id?那数据将会有很多的 id 重复,这当然是不被允许的,其实,我们可以使用算法来生成一个绝对不会重复的 id,这样问题就迎刃而解了,事实上,分布式 id 的解决方案有很多:
1. UUID
1. SnowFlake
1. TinyID
1. Uidgenerator
1. Leaf
6. Tinyid
7. ......
以 UUID 为例,它生成的是一串由数字和字母组成的字符串,显然并不适合作为数据表的 id,而且 id 保持递增有序会加快表的查询效率,基于此,`MyBatisPlus` 使用的就是 `SnowFlake`(雪花算法)。
`Snowflake` 是 Twitter 开源的分布式 ID 生成算法。`Snowflake` 由 64 bit 的二进制数字组成,这 64bit 的二进制被分成了几部分,每一部分存储的数据都有特定的含义:
- **第 0 位**: 符号位(标识正负),始终为 0,没有用,不用管。
- **第 1~41 位** :一共 41 位,用来表示时间戳,单位是毫秒,可以支撑 2 ^41 毫秒(约 69 年)
- **第 42~52 位** :一共 10 位,一般来说,前 5 位表示机房 ID,后 5 位表示机器 ID(实际项目中可以根据实际情况调整)。这样就可以区分不同集群/机房的节点。
- **第 53~64 位** :一共 12 位,用来表示序列号。 序列号为自增值,代表单台机器每毫秒能够产生的最大 ID 数(2^12 = 4096),也就是说单台机器每毫秒最多可以生成 4096 个 唯一 ID。
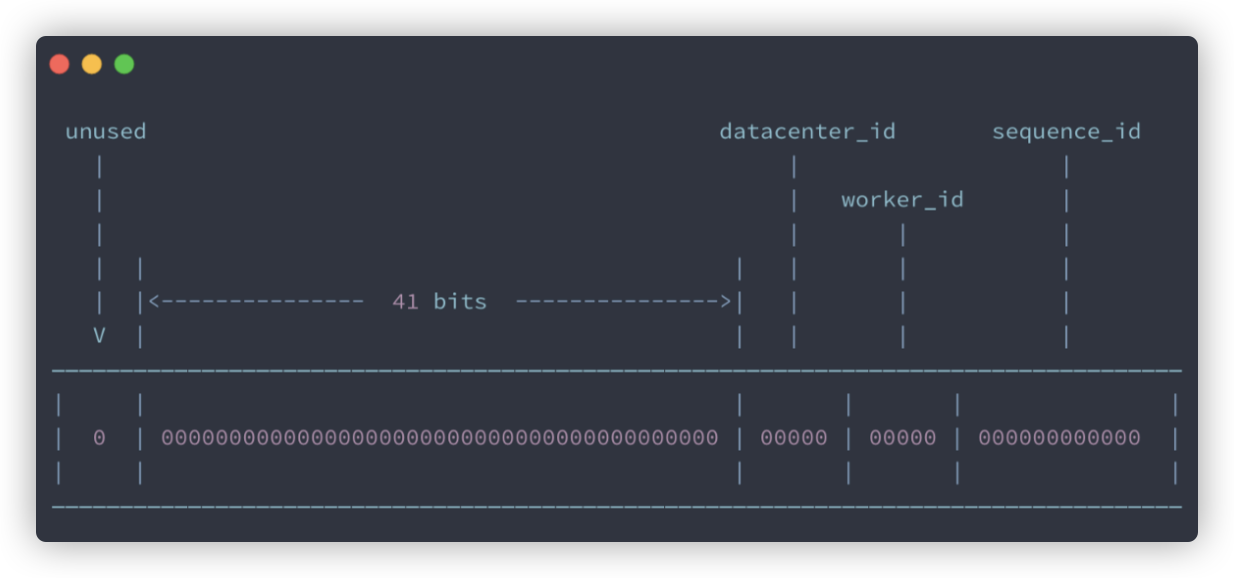
这也就是为什么插入数据后新的数据 id 是一长串数字的原因了,我们可以在实体类中使用 `@TableId` 来设置主键的策略:java @Data @TableName("tbl_employee") public class Employee {
@TableId(type = IdType.AUTO) // 设置主键策略
private Long id;
private String lastName;
private String email;
private Integer age;
}
`MyBatisPlus` 提供了几种主键的策略:
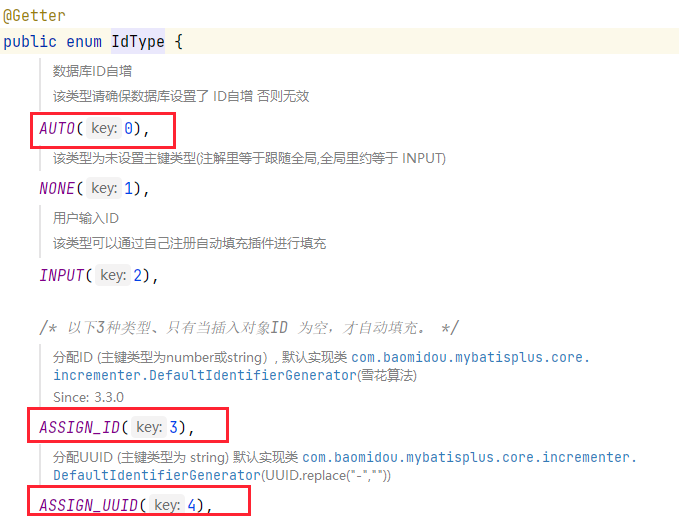
其中 `AUTO` 表示数据库自增策略,该策略下需要数据库实现主键的自增(auto_increment),`ASSIGN_ID` 是雪花算法,默认使用的是该策略,`ASSIGN_UUID` 是 UUID 策略,一般不会使用该策略。
这里多说一点, 当实体类的主键名为 id,并且数据表的主键名也为 id 时,此时 `MyBatisPlus` 会自动判定该属性为主键 id,倘若名字不是 id 时,就需要标注 `@TableId` 注解,若是实体类中主键名与数据表的主键名不一致,则可以进行声明:java @TableId(value = "uid",type = IdType.AUTO) // 设置主键策略 private Long id;
还可以在配置文件中配置全局的主键策略:yaml mybatis-plus: global-config:
db-config:
  id-type: auto
这样能够避免在每个实体类中重复设置主键策略。
## 属性自动填充
翻阅《阿里巴巴Java开发手册》,在第 5 章 MySQL 数据库可以看到这样一条规范:
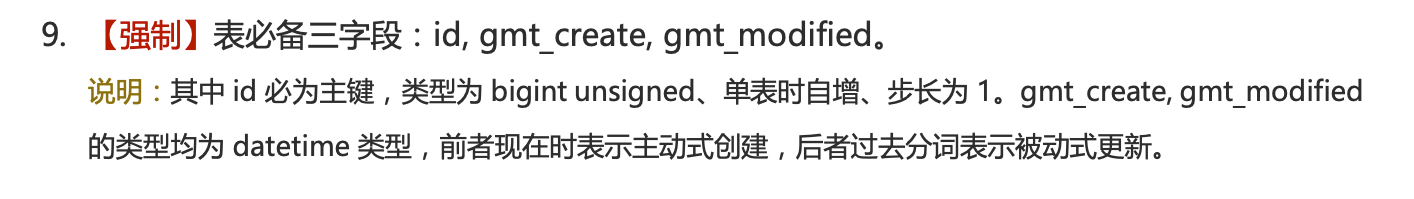
对于一张数据表,它必须具备三个字段:
- `id` : 唯一ID
- `gmt_create` : 保存的是当前数据创建的时间
- `gmt_modified` : 保存的是更新时间
我们改造一下数据表:sql alter table tbl_employee add column gmt_create datetime not null; alter table tbl_employee add column gmt_modified datetime not null;
然后改造一下实体类:java @Data @TableName("tbl_employee") public class Employee {
@TableId(type = IdType.AUTO) // 设置主键策略
private Long id;
private String lastName;
private String email;
private Integer age;
private LocalDateTime gmtCreate;
private LocalDateTime gmtModified;
}
此时我们在插入数据和更新数据的时候就需要手动去维护这两个属性:java @Test void contextLoads() {
Employee employee = new Employee();
employee.setLastName("lisa");
employee.setEmail("lisa@qq.com");
employee.setAge(20);
// 设置创建时间
employee.setGmtCreate(LocalDateTime.now());
employee.setGmtModified(LocalDateTime.now());
employeeService.save(employee);
}
@Test void contextLoads() {
Employee employee = new Employee();
employee.setId(1385934720849584130L);
employee.setAge(50);
// 设置创建时间
employee.setGmtModified(LocalDateTime.now());
employeeService.updateById(employee);
}
每次都需要维护这两个属性未免过于麻烦,好在 `MyBatisPlus` 提供了字段自动填充功能来帮助我们进行管理,需要使用到的是 `@TableField` 注解:java @Data @TableName("tbl_employee") public class Employee {
@TableId(type = IdType.AUTO)
private Long id;
private String lastName;
private String email;
private Integer age;
@TableField(fill = FieldFill.INSERT) // 插入的时候自动填充
private LocalDateTime gmtCreate;
@TableField(fill = FieldFill.INSERT_UPDATE) // 插入和更新的时候自动填充
private LocalDateTime gmtModified;
}
然后编写一个类实现 MetaObjectHandler 接口:java @Component @Slf4j public class MyMetaObjectHandler implements MetaObjectHandler {
/**
 * 实现插入时的自动填充
 * @param metaObject
 */
@Override
public void insertFill(MetaObject metaObject) {
    log.info("insert开始属性填充");
    this.strictInsertFill(metaObject,"gmtCreate", LocalDateTime.class,LocalDateTime.now());
    this.strictInsertFill(metaObject,"gmtModified", LocalDateTime.class,LocalDateTime.now());
}
/**
* 实现更新时的自动填充
* @param metaObject
*/
@Override
public void updateFill(MetaObject metaObject) {
log.info("update开始属性填充");
this.strictInsertFill(metaObject,"gmtModified", LocalDateTime.class,LocalDateTime.now());
}}
该接口中有两个未实现的方法,分别为插入和更新时的填充方法,在方法中调用 `strictInsertFill()` 方法 即可实现属性的填充,它需要四个参数:

1. `metaObject`:元对象,就是方法的入参
1. `fieldName`:为哪个属性进行自动填充
1. `fieldType`:属性的类型
1. `fieldVal`:需要填充的属性值

此时在插入和更新数据之前,这两个方法会先被执行,以实现属性的自动填充,通过日志我们可以进行验证:
java @Test void contextLoads() {
Employee employee = new Employee();
employee.setId(1385934720849584130L);
employee.setAge(15);
employeeService.updateById(employee);
}
运行结果:java INFO 15584 --- [ main] c.w.m.handler.MyMetaObjectHandler : update开始属性填充 2021-04-24 21:32:19.788 INFO 15584 --- [ main] com.zaxxer.hikari.HikariDataSource : HikariPool-1 - Starting... 2021-04-24 21:32:21.244 INFO 15584 --- [ main] com.zaxxer.hikari.HikariDataSource : HikariPool-1 - Start completed.
属性填充其实可以进行一些优化,考虑一些特殊情况,对于一些不存在的属性,就不需要进行属性填充,对于一些设置了值的属性,也不需要进行属性填充,这样可以提高程序的整体运行效率:java @Component @Slf4j public class MyMetaObjectHandler implements MetaObjectHandler {
@Override
public void insertFill(MetaObject metaObject) {
    boolean hasGmtCreate = metaObject.hasSetter("gmtCreate");
    boolean hasGmtModified = metaObject.hasSetter("gmtModified");
    if (hasGmtCreate) {
        Object gmtCreate = this.getFieldValByName("gmtCreate", metaObject);
        if (gmtCreate == null) {
            this.strictInsertFill(metaObject, "gmtCreate", LocalDateTime.class, LocalDateTime.now());
        }
    }
    if (hasGmtModified) {
        Object gmtModified = this.getFieldValByName("gmtModified", metaObject);
        if (gmtModified == null) {
            this.strictInsertFill(metaObject, "gmtModified", LocalDateTime.class, LocalDateTime.now());
        }
    }
}
@Override
public void updateFill(MetaObject metaObject) {
boolean hasGmtModified = metaObject.hasSetter("gmtModified");
if (hasGmtModified) {
Object gmtModified = this.getFieldValByName("gmtModified", metaObject);
if (gmtModified == null) {
this.strictInsertFill(metaObject, "gmtModified", LocalDateTime.class, LocalDateTime.now());
}
}
}}
## 逻辑删除
逻辑删除对应的是物理删除,分别介绍一下这两个概念:
1. **物理删除** :指的是真正的删除,即:当执行删除操作时,将数据表中的数据进行删除,之后将无法再查询到该数据
1. **逻辑删除** :并不是真正意义上的删除,只是对于用户不可见了,它仍然存在与数据表中
在这个数据为王的时代,数据就是财富,所以一般并不会有哪个系统在删除某些重要数据时真正删掉了数据,通常都是在数据库中建立一个状态列,让其默认为 0,当为 0 时,用户可见;当执行了删除操作,就将状态列改为 1,此时用户不可见,但数据还是在表中的。
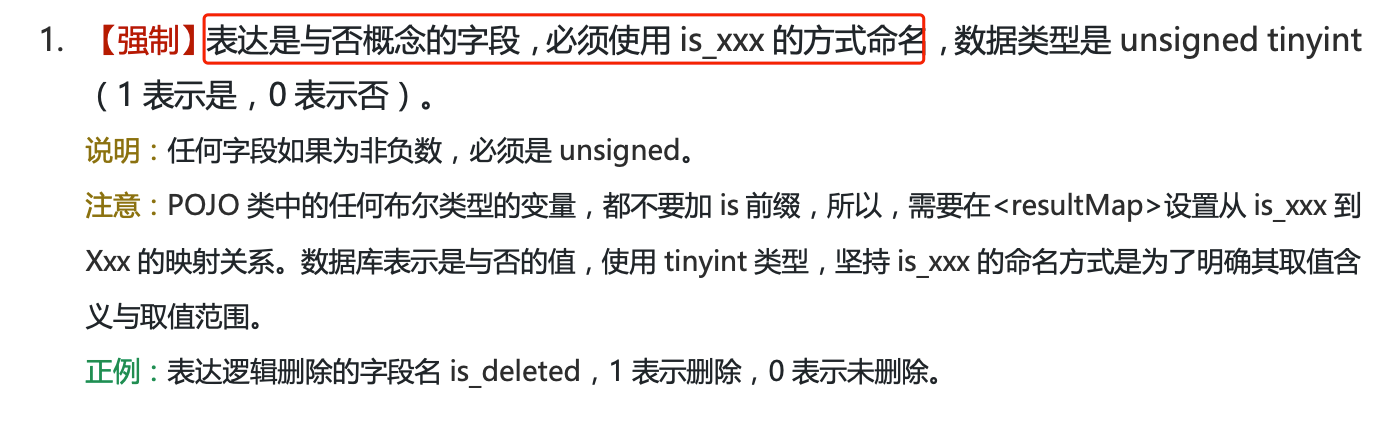
按照《阿里巴巴Java开发手册》第 5 章 MySQL 数据库相关的建议,我们来为数据表新增一个`is_deleted` 字段:sql alter table tbl_employee add column is_deleted tinyint not null;
在实体类中也要添加这一属性:java @Data @TableName("tbl_employee") public class Employee {
@TableId(type = IdType.AUTO)
private Long id;
private String lastName;
private String email;
private Integer age;
@TableField(fill = FieldFill.INSERT)
private LocalDateTime gmtCreate;
@TableField(fill = FieldFill.INSERT_UPDATE)
private LocalDateTime gmtModified;
/**
 * 逻辑删除属性
 */
@TableLogic
@TableField("is_deleted")
private Boolean deleted;
}
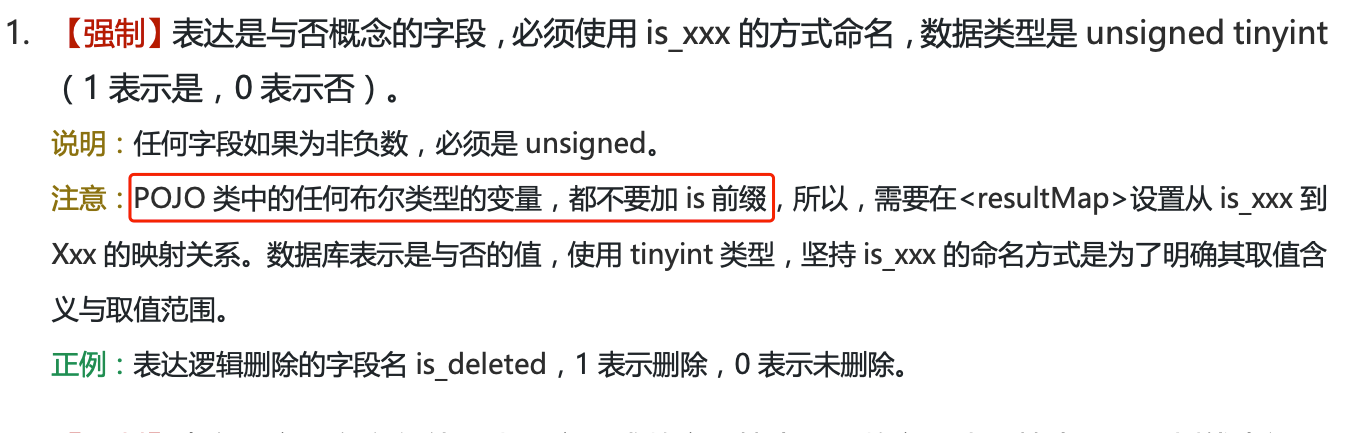
还是参照《阿里巴巴Java开发手册》第 5 章 MySQL 数据库相关的建议,对于布尔类型变量,不能加 is 前缀,所以我们的属性被命名为 `deleted`,但此时就无法与数据表的字段进行对应了,所以我们需要使用 `@TableField` 注解来声明一下数据表的字段名,而 `@TableLogin` 注解用于设置逻辑删除属性;此时我们执行删除操作:java @Test void contextLoads() {
employeeService.removeById(3);}
查询数据表:sql mysql> select * from tbl_employee; +---------------------+-----------+--------------+--------+------+---------------------+---------------------+------------+ | id | last_name | email | gender | age | gmt_create | gmt_modified | is_deleted | +---------------------+-----------+--------------+--------+------+---------------------+---------------------+------------+ | 1 | jack | jack@qq.com | 1 | 35 | 0000-00-00 00:00:00 | 0000-00-00 00:00:00 | 0 | | 2 | tom | tom@qq.com | 1 | 30 | 0000-00-00 00:00:00 | 0000-00-00 00:00:00 | 0 | | 3 | jerry | jerry@qq.com | 1 | 40 | 0000-00-00 00:00:00 | 0000-00-00 00:00:00 | 1 | | 1385934720849584129 | lisa | lisa@qq.com | NULL | 20 | 0000-00-00 00:00:00 | 0000-00-00 00:00:00 | 0 | | 1385934720849584130 | lisa | lisa@qq.com | NULL | 15 | 2021-04-24 21:14:18 | 2021-04-24 21:32:19 | 0 | +---------------------+-----------+--------------+--------+------+---------------------+---------------------+------------+ 5 rows in set (0.00 sec)
可以看到数据并没有被删除,只是 `is_deleted` 字段的属性值被更新成了 1,此时我们再来执行查询操作:java @Test void contextLoads() {
List<Employee> list = employeeService.list();
list.forEach(System.out::println);
}
执行结果:java Employee(id=1, lastName=jack, email=jack@qq.com, age=35, gmtCreate=2021-04-24T21:14:18, gmtModified=2021-04-24T21:14:18, deleted=false) Employee(id=2, lastName=tom, email=tom@qq.com, age=30, gmtCreate=2021-04-24T21:14:18, gmtModified=2021-04-24T21:14:18, deleted=false) Employee(id=1385934720849584129, lastName=lisa, email=lisa@qq.com, age=20, gmtCreate=2021-04-24T21:14:18, gmtModified=2021-04-24T21:14:18, deleted=false) Employee(id=1385934720849584130, lastName=lisa, email=lisa@qq.com, age=15, gmtCreate=2021-04-24T21:14:18, gmtModified=2021-04-24T21:32:19, deleted=false)
会发现第三条数据并没有被查询出来,它是如何实现的呢?我们可以输出 `MyBatisPlus` 生成的 SQL 来分析一下,在配置文件中进行配置:yaml mybatis-plus: configuration:
log-impl: org.apache.ibatis.logging.stdout.StdOutImpl # 输出SQL日志
运行结果:java ==> Preparing: SELECT id,last_name,email,age,gmt_create,gmt_modified,is_deleted AS deleted FROM tbl_employee WHERE is_deleted=0 ==> Parameters: <== Columns: id, last_name, email, age, gmt_create, gmt_modified, deleted <== Row: 1, jack, jack@qq.com, 35, 2021-04-24 21:14:18, 2021-04-24 21:14:18, 0 <== Row: 2, tom, tom@qq.com, 30, 2021-04-24 21:14:18, 2021-04-24 21:14:18, 0 <== Row: 1385934720849584129, lisa, lisa@qq.com, 20, 2021-04-24 21:14:18, 2021-04-24 21:14:18, 0 <== Row: 1385934720849584130, lisa, lisa@qq.com, 15, 2021-04-24 21:14:18, 2021-04-24 21:32:19, 0 <== Total: 4
原来它在查询时携带了一个条件: `is_deleted=0` ,这也说明了 `MyBatisPlus` 默认 0 为不删除,1 为删除。
若是你想修改这个规定,比如设置-1 为删除,1 为不删除,也可以进行配置:
yaml mybatis-plus: global-config:
db-config:
id-type: auto
logic-delete-field: deleted # 逻辑删除属性名
logic-delete-value: -1 # 删除值
logic-not-delete-value: 1 # 不删除值
但建议使用默认的配置,阿里巴巴开发手册也规定 1 表示删除,0 表示未删除。
## 分页插件
对于分页功能,`MyBatisPlus` 提供了分页插件,只需要进行简单的配置即可实现:java @Configuration public class MyBatisConfig {
/**
* 注册分页插件
* @return
*/
@Bean
public MybatisPlusInterceptor mybatisPlusInterceptor() {
MybatisPlusInterceptor interceptor = new MybatisPlusInterceptor();
interceptor.addInnerInterceptor(new PaginationInnerInterceptor(DbType.MYSQL));
return interceptor;
}}
接下来我们就可以使用分页插件提供的功能了:java @Test void contextLoads() {
Page<Employee> page = new Page<>(1,2);
employeeService.page(page, null);
List<Employee> employeeList = page.getRecords();
employeeList.forEach(System.out::println);
System.out.println("获取总条数:" + page.getTotal());
System.out.println("获取当前页码:" + page.getCurrent());
System.out.println("获取总页码:" + page.getPages());
System.out.println("获取每页显示的数据条数:" + page.getSize());
System.out.println("是否有上一页:" + page.hasPrevious());
System.out.println("是否有下一页:" + page.hasNext());}
其中的 `Page` 对象用于指定分页查询的规则,这里表示按每页两条数据进行分页,并查询第一页的内容,运行结果:java Employee(id=1, lastName=jack, email=jack@qq.com, age=35, gmtCreate=2021-04-24T21:14:18, gmtModified=2021-04-24T21:14:18, deleted=0) Employee(id=2, lastName=tom, email=tom@qq.com, age=30, gmtCreate=2021-04-24T21:14:18, gmtModified=2021-04-24T21:14:18, deleted=0) 获取总条数:4 获取当前页码:1 获取总页码:2 获取每页显示的数据条数:2 是否有上一页:false 是否有下一页:true
倘若在分页过程中需要限定一些条件,我们就需要构建 QueryWrapper 来实现:java @Test void contextLoads() {
Page<Employee> page = new Page<>(1, 2);
employeeService.page(page, new QueryWrapper<Employee>()
.between("age", 20, 50)
.eq("gender", 1));
List<Employee> employeeList = page.getRecords();
employeeList.forEach(System.out::println);}
此时分页的数据就应该是年龄在 20~50 岁之间,且 gender 值为 1 的员工信息,然后再对这些数据进行分页。
## 乐观锁
当程序中出现并发访问时,就需要保证数据的一致性。以商品系统为例,现在有两个管理员均想对同一件售价为 100 元的商品进行修改,A 管理员正准备将商品售价改为 150 元,但此时出现了网络问题,导致 A 管理员的操作陷入了等待状态;此时 B 管理员也进行修改,将商品售价改为了 200 元,修改完成后 B 管理员退出了系统,此时 A 管理员的操作也生效了,这样便使得 A 管理员的操作直接覆盖了 B 管理员的操作,B 管理员后续再进行查询时会发现商品售价变为了 150 元,这样的情况是绝对不允许发生的。
要想解决这一问题,可以给数据表加锁,常见的方式有两种:
1. 乐观锁
1. 悲观锁
悲观锁认为并发情况一定会发生,所以在某条数据被修改时,为了避免其它人修改,会直接对数据表进行加锁,它依靠的是数据库本身提供的锁机制(表锁、行锁、读锁、写锁)。
而乐观锁则相反,它认为数据产生冲突的情况一般不会发生,所以在修改数据的时候并不会对数据表进行加锁的操作,而是在提交数据时进行校验,判断提交上来的数据是否会发生冲突,如果发生冲突,则提示用户重新进行操作,一般的实现方式为 `设置版本号字段` 。
就以商品售价为例,在该表中设置一个版本号字段,让其初始为 1,此时 A 管理员和 B 管理员同时需要修改售价,它们会先读取到数据表中的内容,此时两个管理员读取到的版本号都为 1,此时 B 管理员的操作先生效了,它就会将当前数据表中对应数据的版本号与最开始读取到的版本号作一个比对,发现没有变化,于是修改就生效了,此时版本号加 1。
而 A 管理员马上也提交了修改操作,但是此时的版本号为 2,与最开始读取到的版本号并不对应,这就说明数据发生了冲突,此时应该提示 A 管理员操作失败,并让 A 管理员重新查询一次数据。
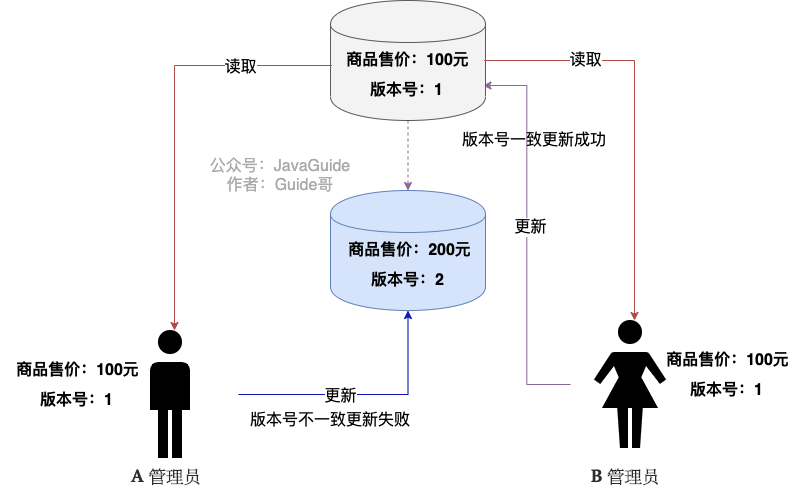
乐观锁的优势在于采取了更加宽松的加锁机制,能够提高程序的吞吐量,适用于读操作多的场景。
那么接下来我们就来模拟这一过程。
**1.创建一张新的数据表:**sql create table shop(
id bigint(20) not null auto_increment,name varchar(30) not null, price int(11) default 0, version int(11) default 1, primary key(id) );
insert into shop(id,name,price) values(1,'笔记本电脑',8000);
**2.创建实体类:**java @Data public class Shop {
private Long id;
private String name;
private Integer price;
private Integer version;}
**3.创建对应的 `Mapper` 接口:**java
public interface ShopMapper extends BaseMapper
**4.编写测试代码:**java @SpringBootTest @MapperScan("com.wwj.mybatisplusdemo.mapper") class MybatisplusDemoApplicationTests {
@Autowired
private ShopMapper shopMapper;/**
* 模拟并发场景
*/
@Test
void contextLoads() {
// A、B管理员读取数据
Shop A = shopMapper.selectById(1L);
Shop B = shopMapper.selectById(1L);
// B管理员先修改
B.setPrice(9000);
int result = shopMapper.updateById(B);
if (result == 1) {
System.out.println("B管理员修改成功!");
} else {
System.out.println("B管理员修改失败!");
}
// A管理员后修改
A.setPrice(8500);
int result2 = shopMapper.updateById(A);
if (result2 == 1) {
System.out.println("A管理员修改成功!");
} else {
System.out.println("A管理员修改失败!");
}
// 最后查询
System.out.println(shopMapper.selectById(1L));
}}
执行结果:java B管理员修改成功! A管理员修改成功! Shop(id=1, name=笔记本电脑, price=8500, version=1)
**问题出现了,B 管理员的操作被 A 管理员覆盖,那么该如何解决这一问题呢?**
其实 `MyBatisPlus` 已经提供了乐观锁机制,只需要在实体类中使用 `@Version` 声明版本号属性:java @Data public class Shop {
private Long id;
private String name;
private Integer price;
@Version // 声明版本号属性
private Integer version;}
然后注册乐观锁插件:java @Configuration public class MyBatisConfig {
/**
* 注册插件
* @return
*/
@Bean
public MybatisPlusInterceptor mybatisPlusInterceptor() {
MybatisPlusInterceptor interceptor = new MybatisPlusInterceptor();
// 分页插件
interceptor.addInnerInterceptor(new PaginationInnerInterceptor(DbType.MYSQL));
// 乐观锁插件
interceptor.addInnerInterceptor(new OptimisticLockerInnerInterceptor());
return interceptor;
}}
重新执行测试代码,结果如下:java B管理员修改成功! A管理员修改失败! Shop(id=1, name=笔记本电脑, price=9000, version=2)
此时 A 管理员的修改就失败了,它需要重新读取最新的数据才能再次进行修改。
## 条件构造器
在分页插件中我们简单地使用了一下条件构造器(`Wrapper`),下面我们来详细了解一下。
先来看看 `Wrapper` 的继承体系:
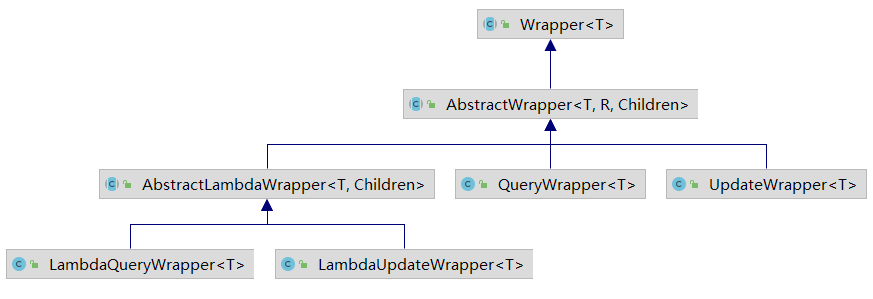
分别介绍一下它们的作用:
- `Wrapper`:条件构造器抽象类,最顶端的父类
- `AbstractWrapper`:查询条件封装抽象类,生成 SQL 的 where 条件
- `QueryWrapper`:用于对象封装
- `UpdateWrapper`:用于条件封装
- `AbstractLambdaWrapper`:Lambda 语法使用 Wrapper
- `LambdaQueryWrapper`:用于对象封装,使用 Lambda 语法
- `LambdaUpdateWrapper`:用于条件封装,使用 Lambda 语法
通常我们使用的都是 `QueryWrapper` 和 `UpdateWrapper`,若是想使用 Lambda 语法来编写,也可以使用 `LambdaQueryWrapper` 和 `LambdaUpdateWrapper`,通过这些条件构造器,我们能够很方便地来实现一些复杂的筛选操作,比如:java @SpringBootTest @MapperScan("com.wwj.mybatisplusdemo.mapper") class MybatisplusDemoApplicationTests {
@Autowired
private EmployeeMapper employeeMapper;@Test
void contextLoads() {
// 查询名字中包含'j',年龄大于20岁,邮箱不为空的员工信息
QueryWrapper<Employee> wrapper = new QueryWrapper<>();
wrapper.like("last_name", "j");
wrapper.gt("age", 20);
wrapper.isNotNull("email");
List<Employee> list = employeeMapper.selectList(wrapper);
list.forEach(System.out::println);
}}
运行结果:java Employee(id=1, lastName=jack, email=jack@qq.com, age=35, gmtCreate=2021-04-24T21:14:18, gmtModified=2021-04-24T21:14:18, deleted=0)
条件构造器提供了丰富的条件方法帮助我们进行条件的构造,比如 `like` 方法会为我们建立模糊查询,查看一下控制台输出的 SQL:sql ==> Preparing: SELECT id,last_name,email,age,gmt_create,gmt_modified,is_deleted AS deleted FROM tbl_employee WHERE is_deleted=0 AND (last_name LIKE ? AND age > ? AND email IS NOT NULL) ==> Parameters: %j%(String), 20(Integer)
可以看到它是对 `j` 的前后都加上了 `%` ,若是只想查询以 `j` 开头的名字,则可以使用 `likeRight` 方法,若是想查询以 `j` 结尾的名字,,则使用 `likeLeft` 方法。
年龄的比较也是如此, `gt` 是大于指定值,若是小于则调用 `lt` ,大于等于调用 `ge` ,小于等于调用 `le` ,不等于调用 `ne` ,还可以使用 `between` 方法实现这一过程,相关的其它方法都可以查阅源码进行学习。
因为这些方法返回的其实都是自身实例,所以可使用链式编程:java @Test void contextLoads() {
// 查询名字中包含'j',年龄大于20岁,邮箱不为空的员工信息
QueryWrapper<Employee> wrapper = new QueryWrapper<Employee>()
.likeLeft("last_name", "j")
.gt("age", 20)
.isNotNull("email");
List<Employee> list = employeeMapper.selectList(wrapper);
list.forEach(System.out::println);}
也可以使用 `LambdaQueryWrapper` 实现:java @Test void contextLoads() {
// 查询名字中包含'j',年龄大于20岁,邮箱不为空的员工信息
LambdaQueryWrapper<Employee> wrapper = new LambdaQueryWrapper<Employee>()
.like(Employee::getLastName,"j")
.gt(Employee::getAge,20)
.isNotNull(Employee::getEmail);
List<Employee> list = employeeMapper.selectList(wrapper);
list.forEach(System.out::println);}
这种方式的好处在于对字段的设置不是硬编码,而是采用方法引用的形式,效果与 `QueryWrapper` 是一样的。
`UpdateWrapper` 与 `QueryWrapper` 不同,它的作用是封装更新内容的,比如:java @Test void contextLoads() {
UpdateWrapper<Employee> wrapper = new UpdateWrapper<Employee>()
.set("age", 50)
.set("email", "emp@163.com")
.like("last_name", "j")
.gt("age", 20);
employeeMapper.update(null, wrapper);}
将名字中包含 `j` 且年龄大于 20 岁的员工年龄改为 50,邮箱改为 emp@163.com,`UpdateWrapper` 不仅能够封装更新内容,也能作为查询条件,所以在更新数据时可以直接构造一个 `UpdateWrapper` 来设置更新内容和条件。
---
## swagger
> 若图片无法显示,👉:[Swagger 官方 Starter 配上这个增强方案是真的香!](https://mp.weixin.qq.com/s?__biz=Mzg2OTA0Njk0OA==&mid=2247496557&idx=1&sn=77100461596999128e5d721e07f7fe3d&chksm=cea1bca6f9d635b01f45a68a6034faf76c2f5a54223b23b2dc5a0bdb15c7b7bfea0a20a76c1a&token=1835542145&lang=zh_CN#rd)
这篇文章,我就简单给大家聊聊项目必备的 Swagger 该怎么玩。
**何为 Swagger ?** 简单来说,Swagger 就是一套基于 OpenAPI 规范构建的开源工具,可以帮助我们设计、构建、记录以及使用 Rest API。
**为何要用 Swagger ?** 前后端分离的情况下,一份 Rest API 文档将会极大的提高我们的工作效率。前端小伙伴只需要对照着 Rest API 文档就可以搞清楚一个接口需要的参数以及返回值。通过 Swagger 我们只需要少量注解即可生成一份自带 UI 界面的 Rest API 文档,不需要我们后端手动编写。并且,通过 UI 界面,我们还可以直接对相应的 API 进行调试,省去了准备复杂的调用参数的过程。
这篇文章的主要内容:
1. SpringBoot 项目中如何使用?
2. Spring Security 项目中如何使用?
3. 使用 knife4j 增强 Swagger
以下演示所用代码,你可以在这个仓库找到:[https://github.com/Snailclimb/spring-security-jwt-guide](https://github.com/Snailclimb/spring-security-jwt-guide) (从零入门 !Spring Security With JWT(含权限验证)后端部分代码)
## SpringBoot 项目中如何使用?
Swagger3.0 官方已经有了自己的 Spring Boot Starter,只需要添加一个 jar 包即可(SpringBoot 版本 2.3.6.RELEASE)。。xml
什么都不用配置!直接在浏览器中访问 :[http://ip:port/swagger-ui/](http://ip:port/swagger-ui/) 即可。
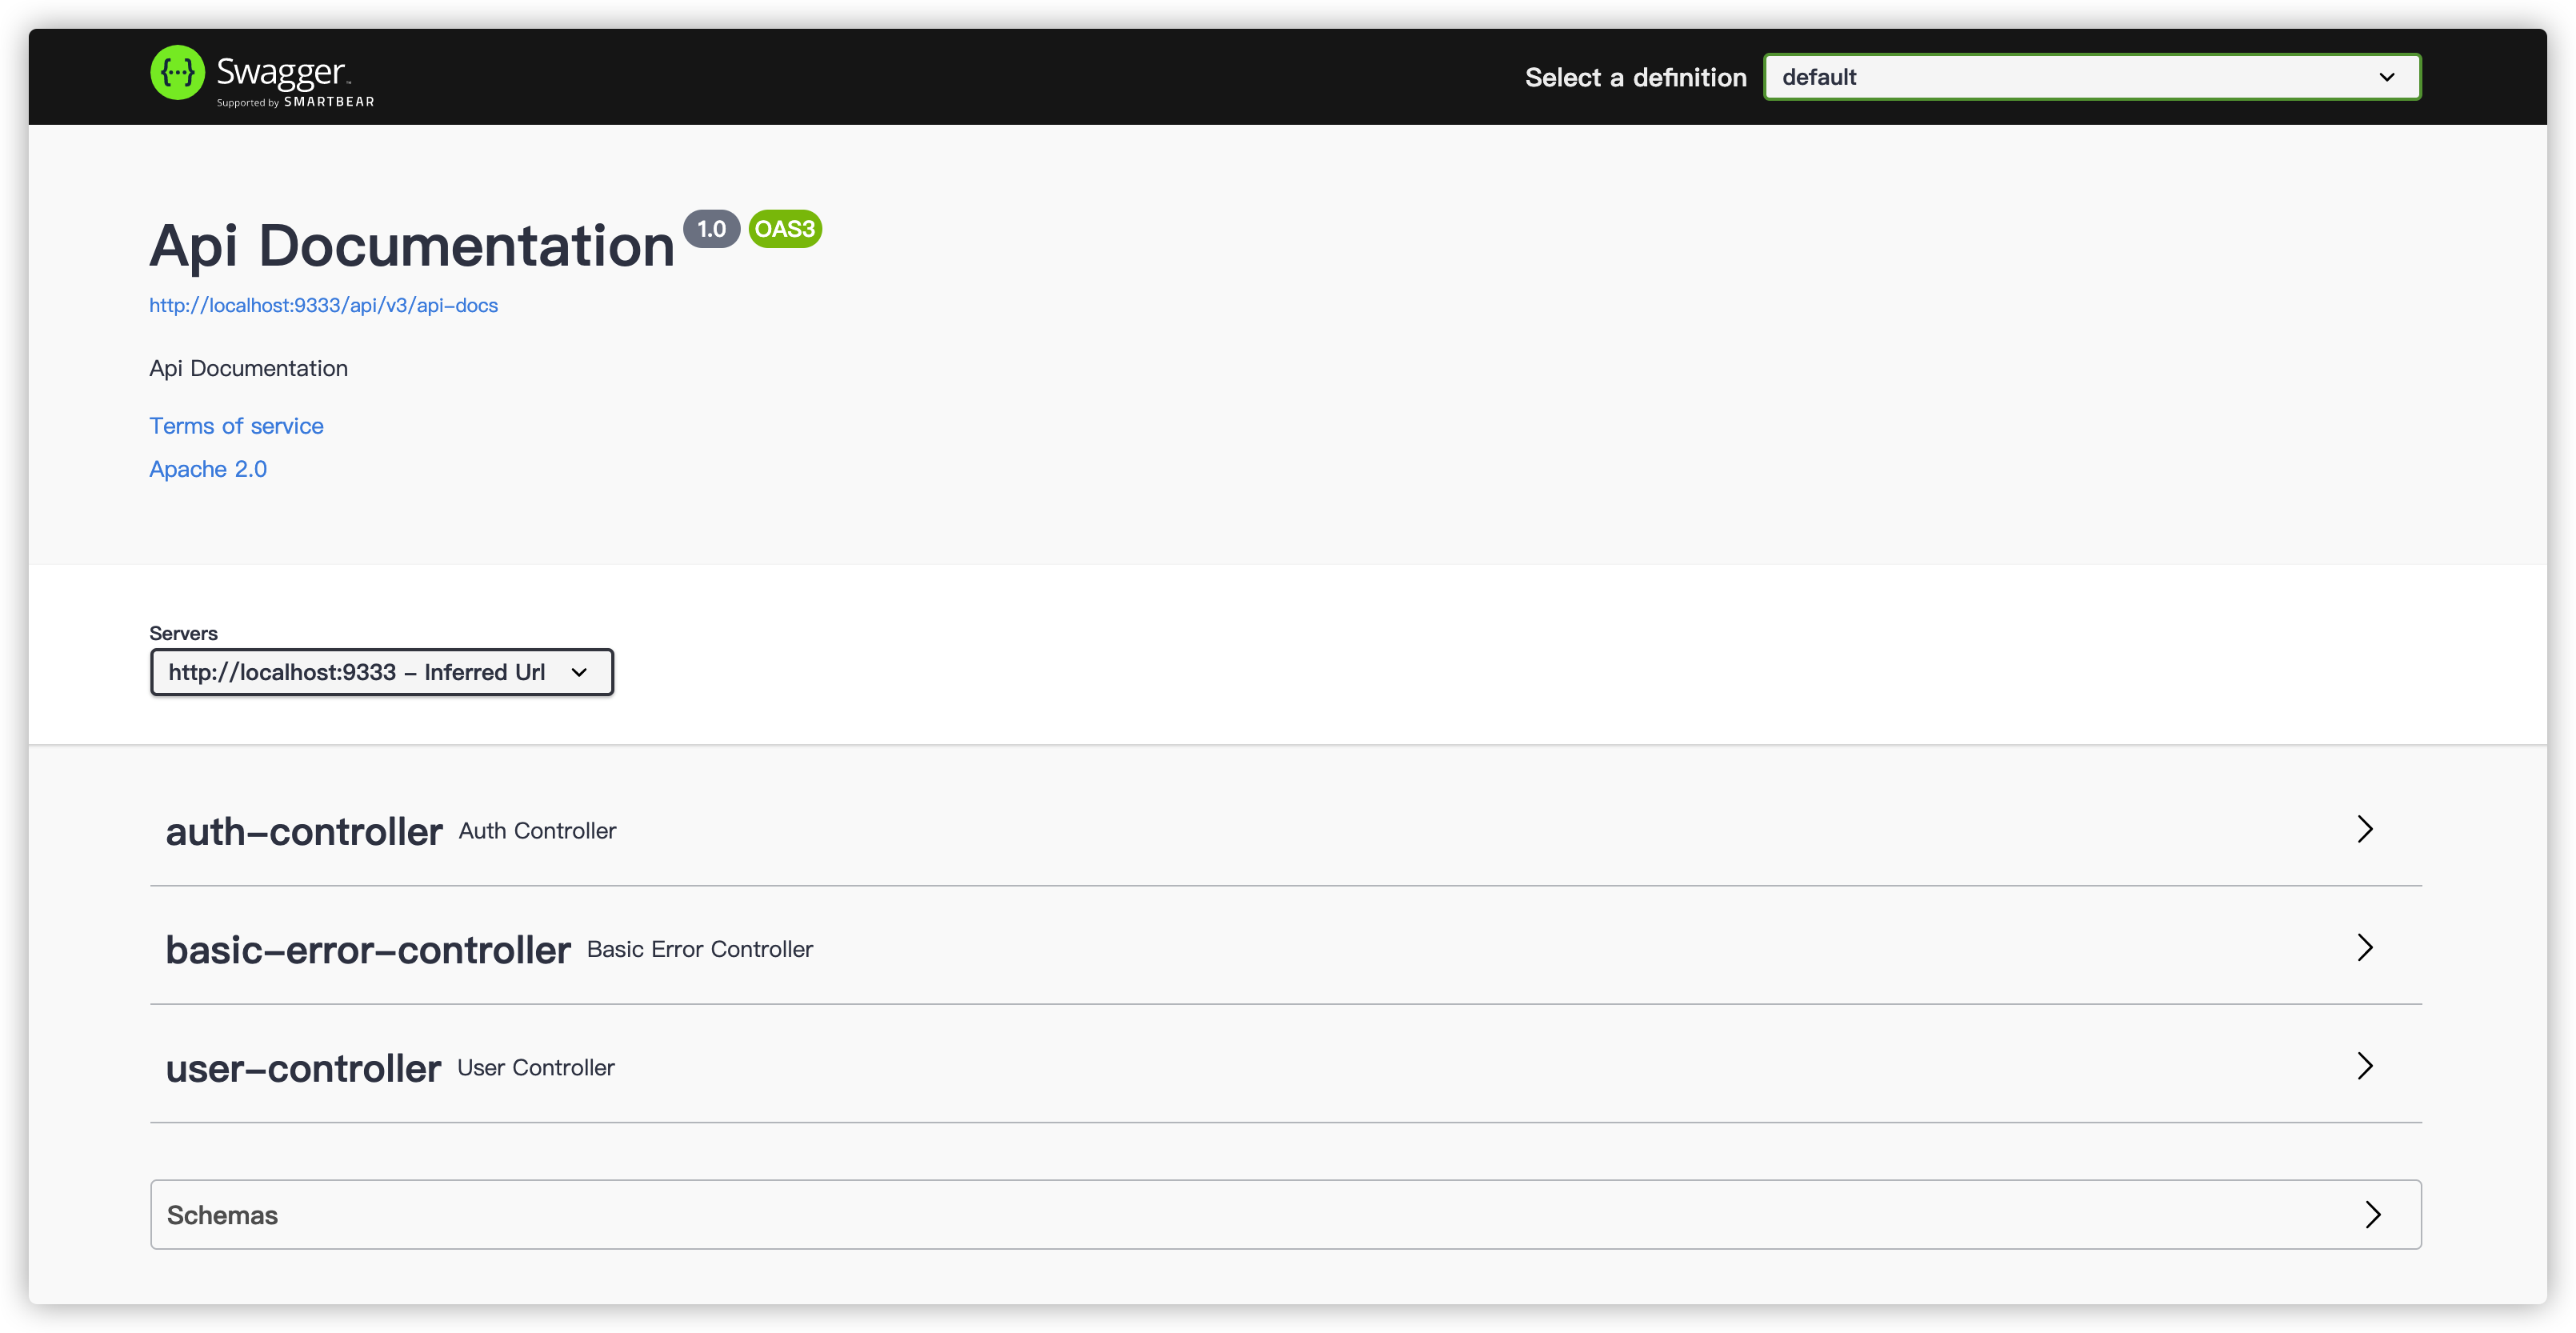
## Spring Security 项目中如何使用?
如果你的项目使用了 Spring Security 做权限认证的话,你需要为 Swagger 相关 url 添加白名单。java
String[] SWAGGER_WHITELIST = {
"/swagger-ui.html",
"/swagger-ui/*",
"/swagger-resources/**",
"/v2/api-docs",
"/v3/api-docs",
"/webjars/**"
};@Override
protected void configure(HttpSecurity http) throws Exception {
http.cors().and()
// 禁用 CSRF
.csrf().disable()
.authorizeRequests()
// swagger
.antMatchers(SWAGGER_WHITELIST).permitAll()
......
}
另外,某些请求需要认证之后才可以访问,为此,我们需要对 Swagger 做一些简单的配置。
配置的方式非常简单,我提供两种不同的方式给小伙伴们。
1. 登录后自动为请求添加 token。
2. 为请求的 Header 添加一个认证参数,每次请求的时候,我们需要手动输入 token。
### 登录后自动为请求添加 token
通过这种方式我们只需要授权一次即可使用所有需要授权的接口。
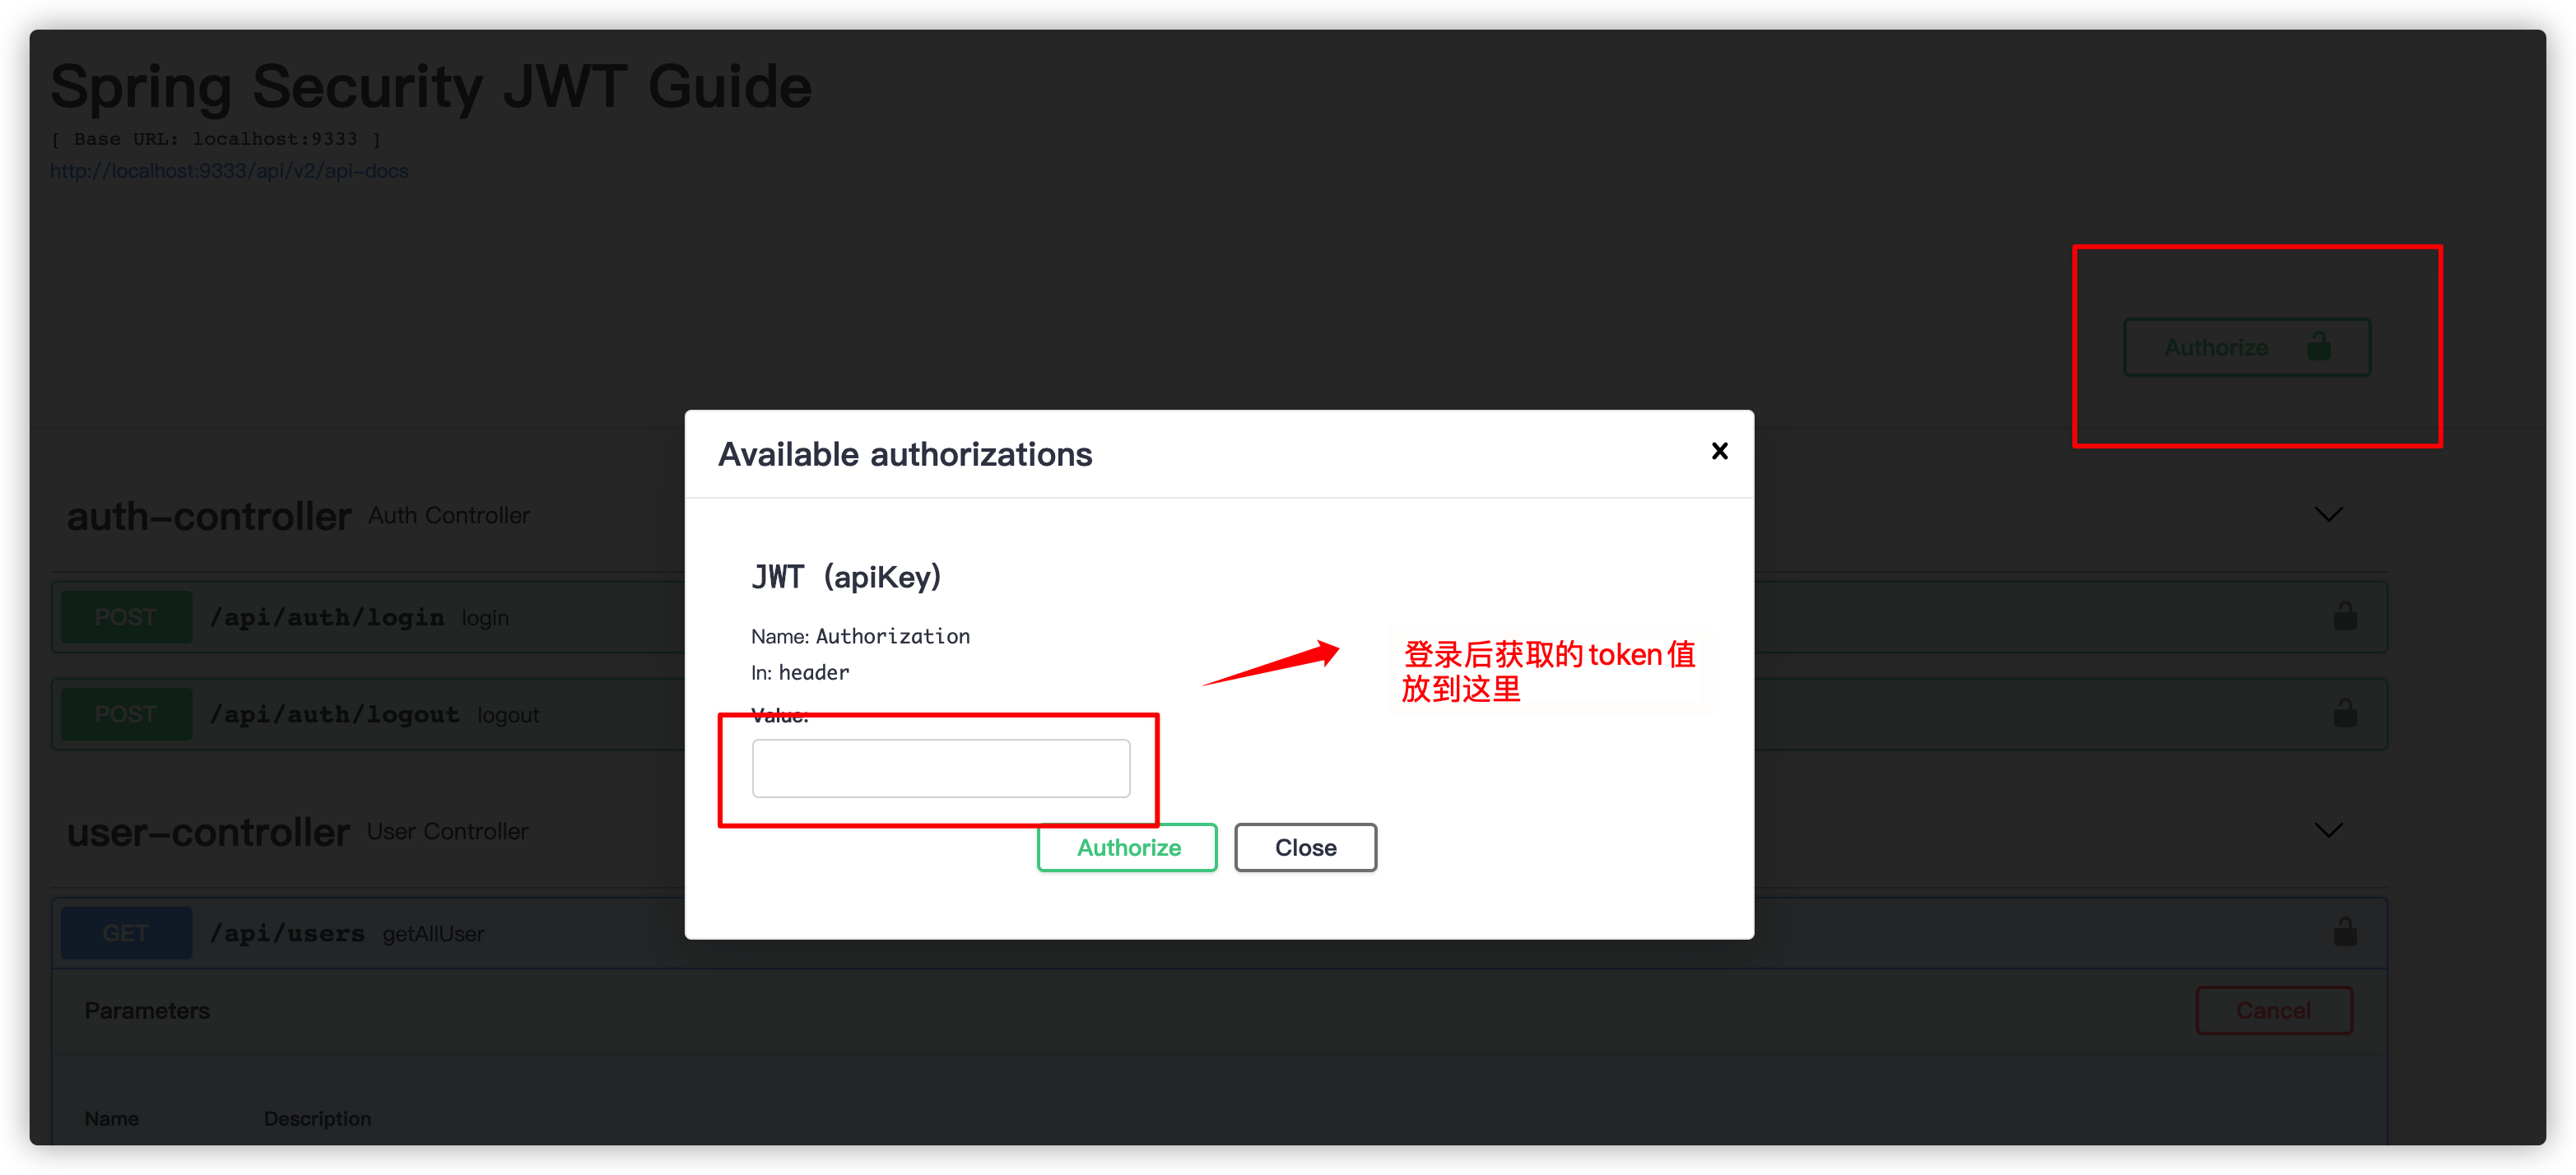java /**
- @author shuang.kou
- @description swagger 相关配置
*/ @Configuration public class SwaggerConfig {
@Bean
public Docket createRestApi() {
return new Docket(DocumentationType.SWAGGER_2)
.apiInfo(apiInfo())
.select()
.apis(RequestHandlerSelectors.basePackage("github.javaguide.springsecurityjwtguide"))
.paths(PathSelectors.any())
.build()
.securityContexts(securityContext())
.securitySchemes(securitySchemes());
}private List<SecurityScheme> securitySchemes() {
return Collections.singletonList(new ApiKey("JWT", SecurityConstants.TOKEN_HEADER, "header"));
}private List<SecurityContext> securityContext() {
SecurityContext securityContext = SecurityContext.builder()
.securityReferences(defaultAuth())
.build();
return Collections.singletonList(securityContext);
}List<SecurityReference> defaultAuth() {
AuthorizationScope authorizationScope
= new AuthorizationScope("global", "accessEverything");
AuthorizationScope[] authorizationScopes = new AuthorizationScope[1];
authorizationScopes[0] = authorizationScope;
return Collections.singletonList(new SecurityReference("JWT", authorizationScopes));
}private ApiInfo apiInfo() {
return new ApiInfoBuilder()
.title("Spring Security JWT Guide")
.build();
}}
**未登录前:**
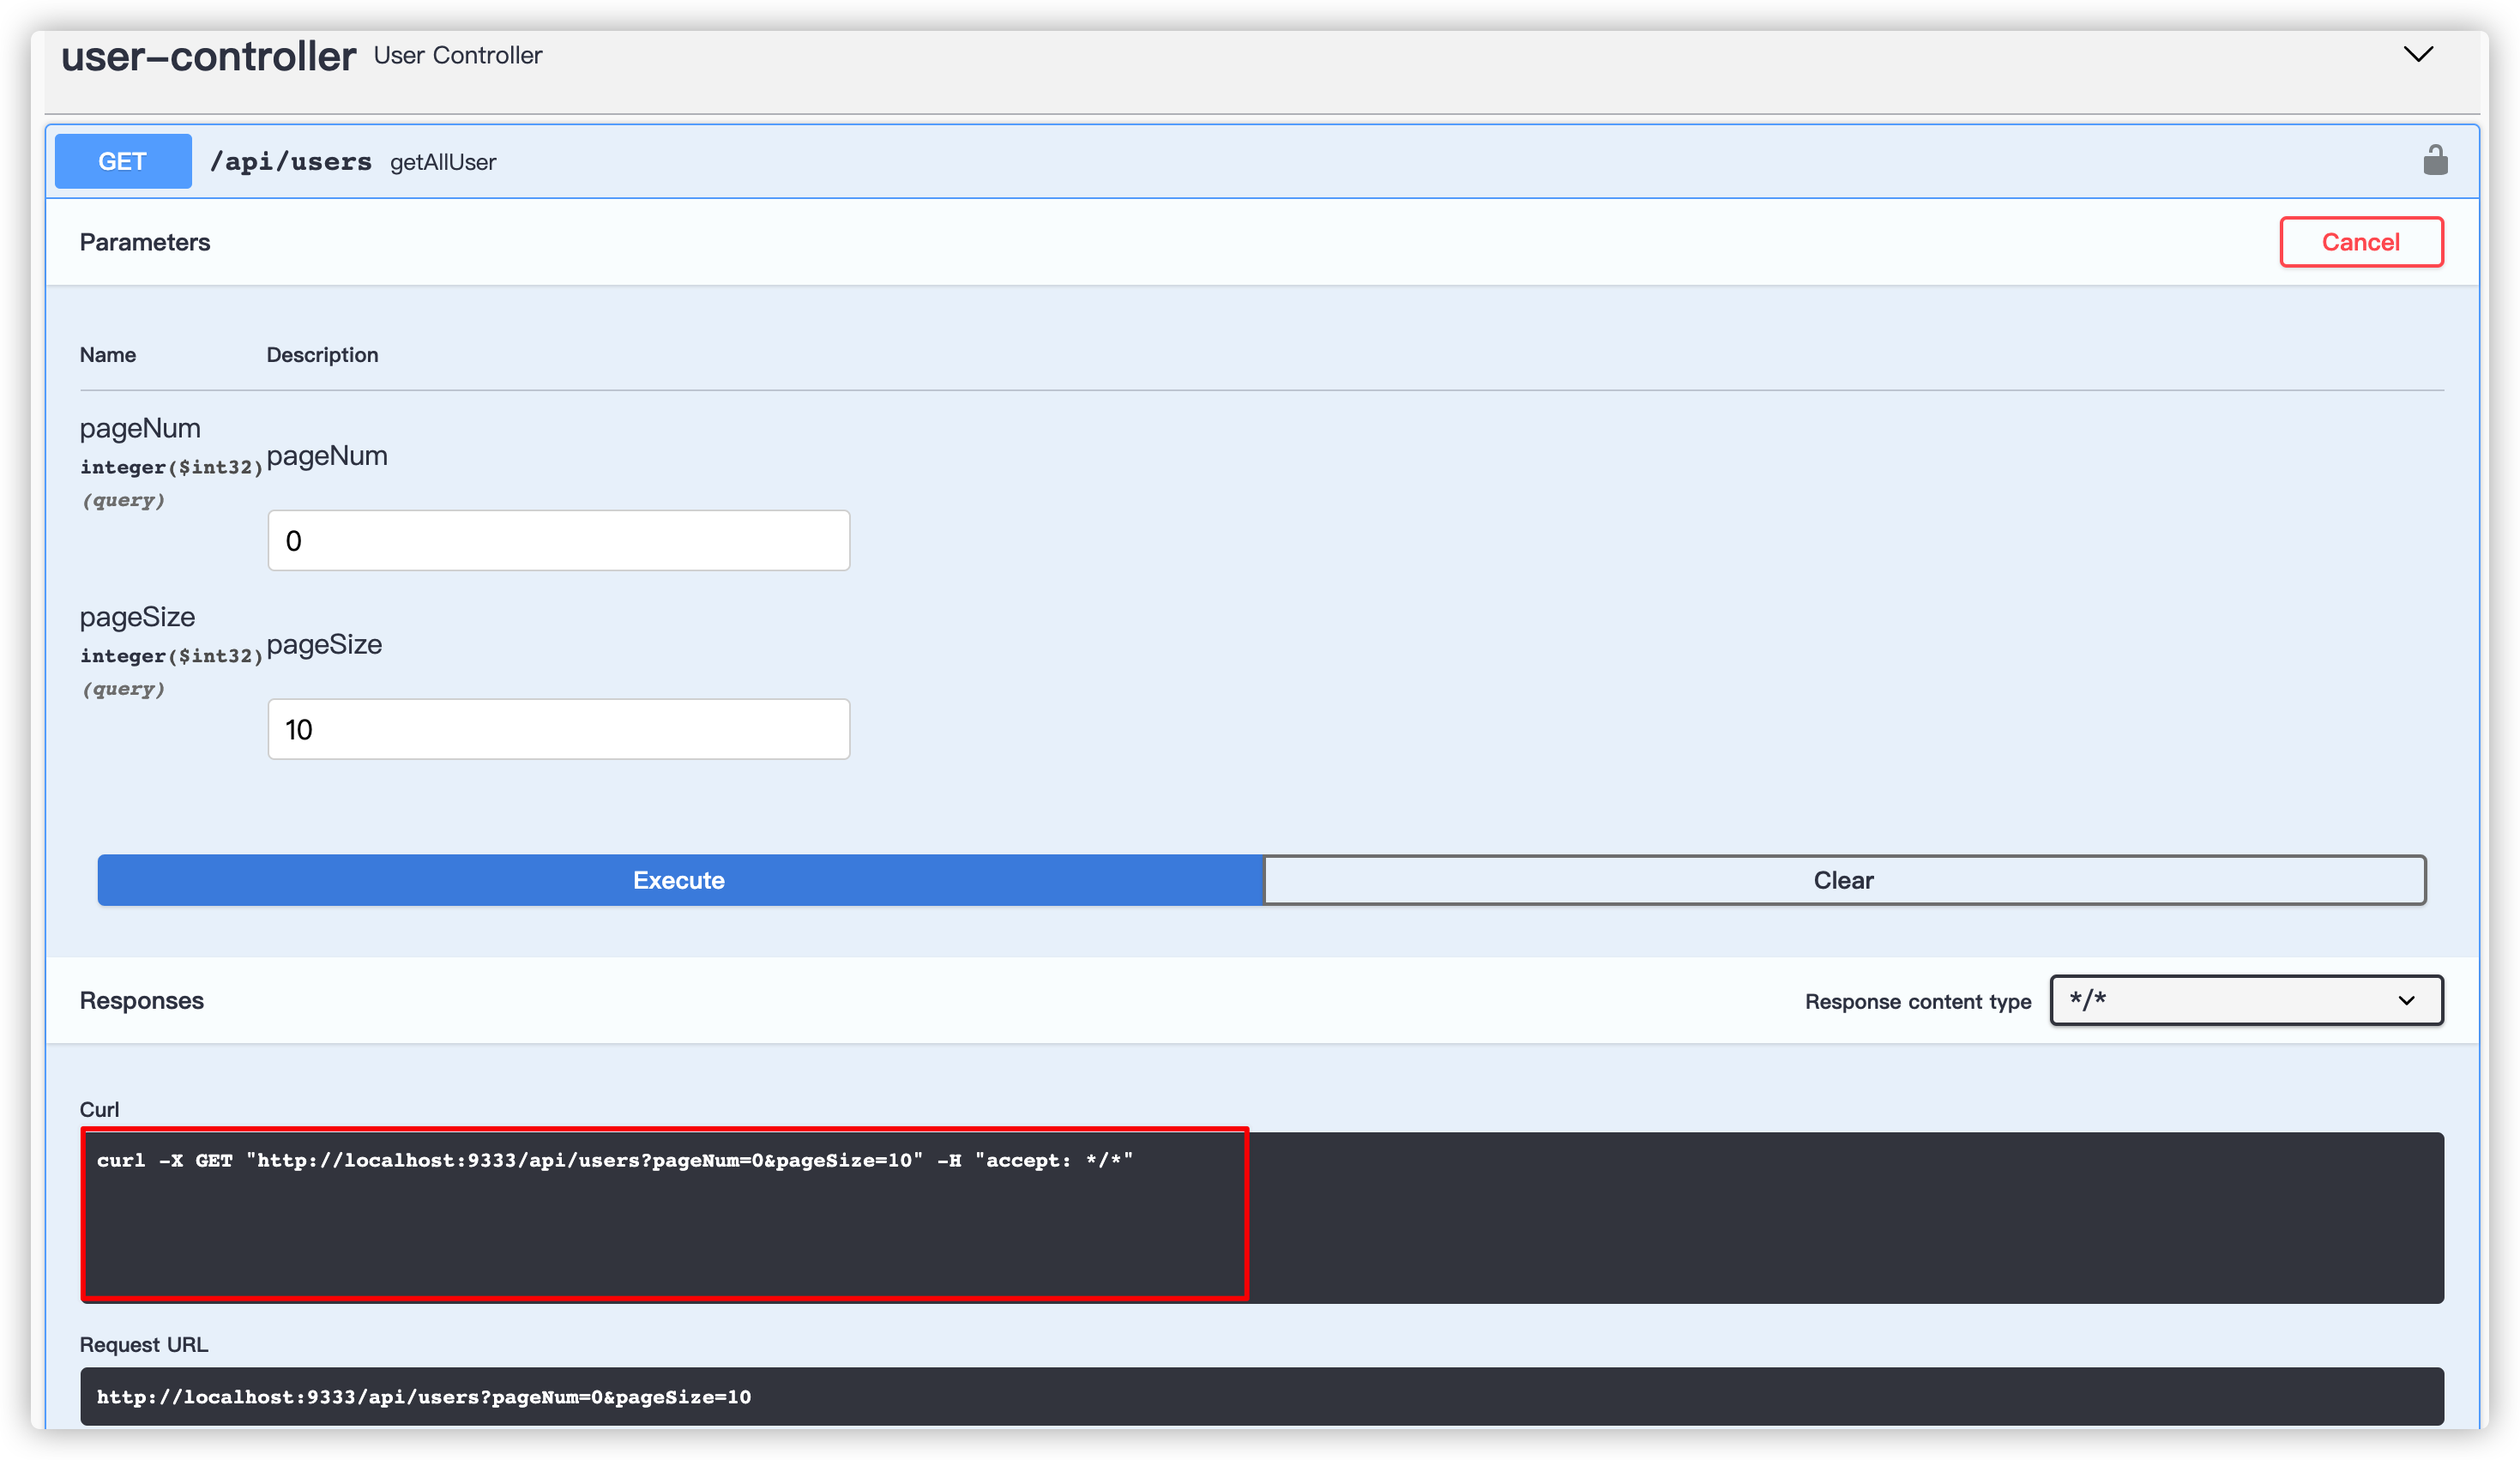
**登录后:**
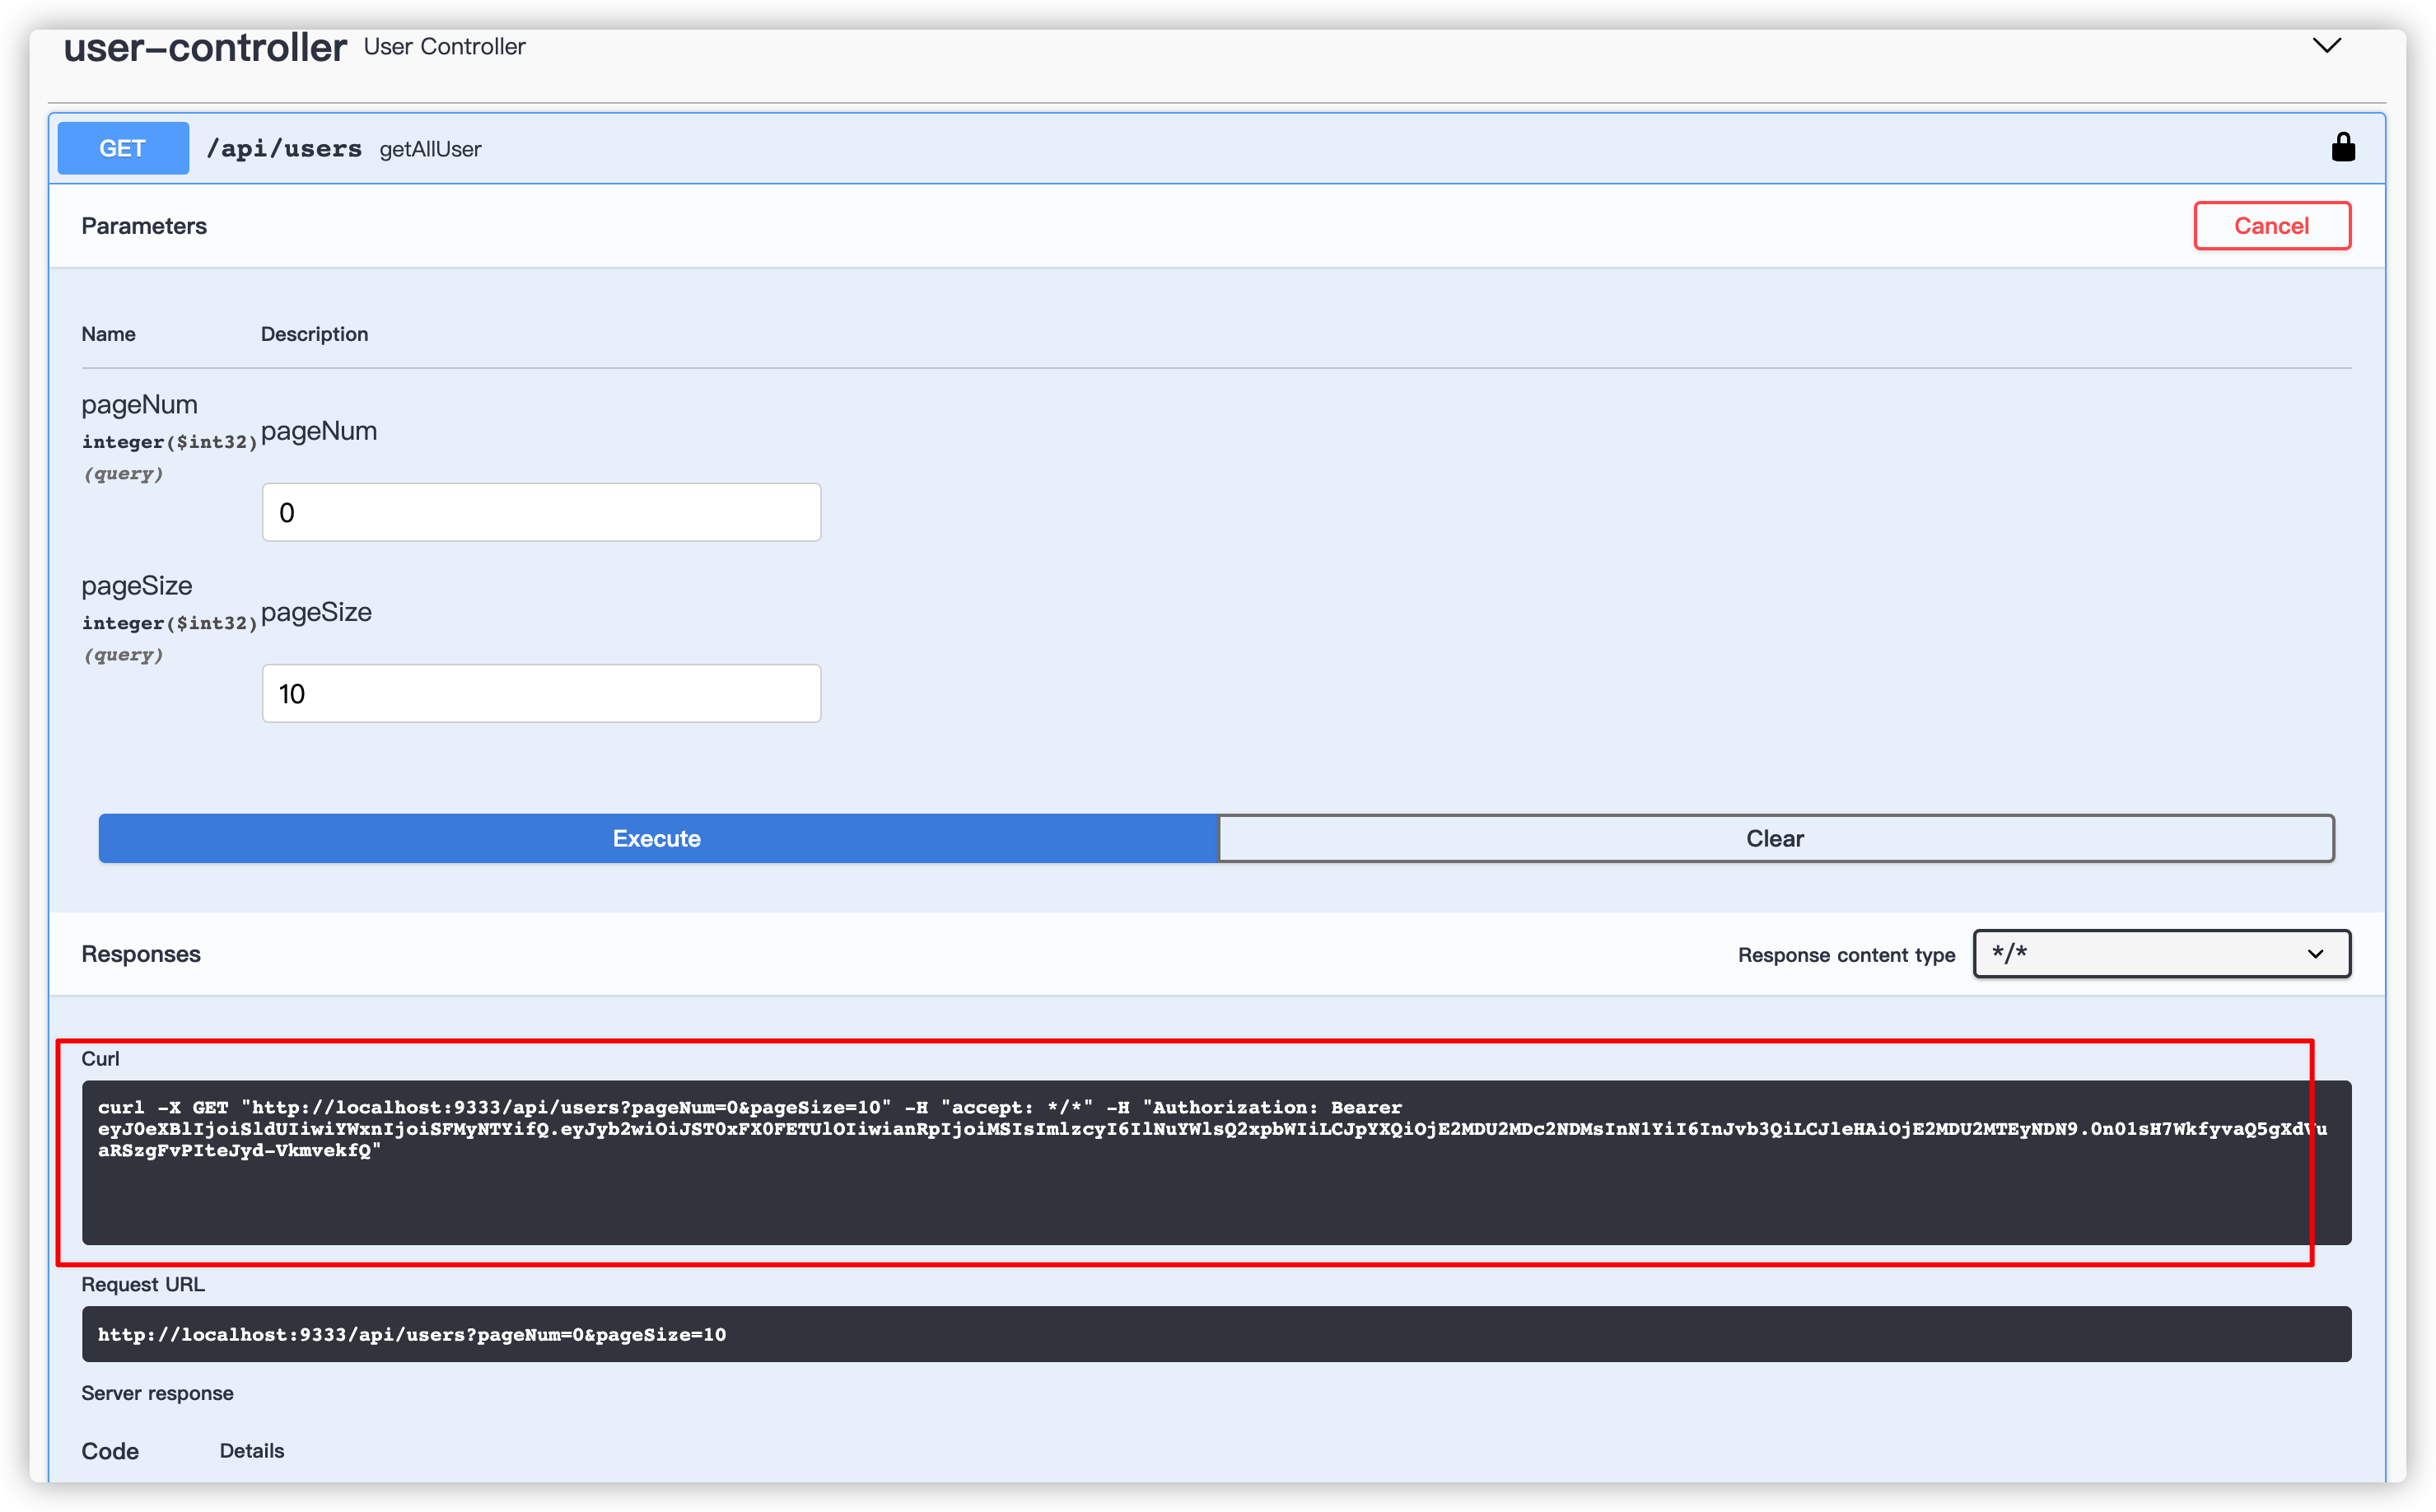
### 为请求的 Header 添加一个认证参数
每次请求的时候,我们需要手动输入 token 到指定位置。
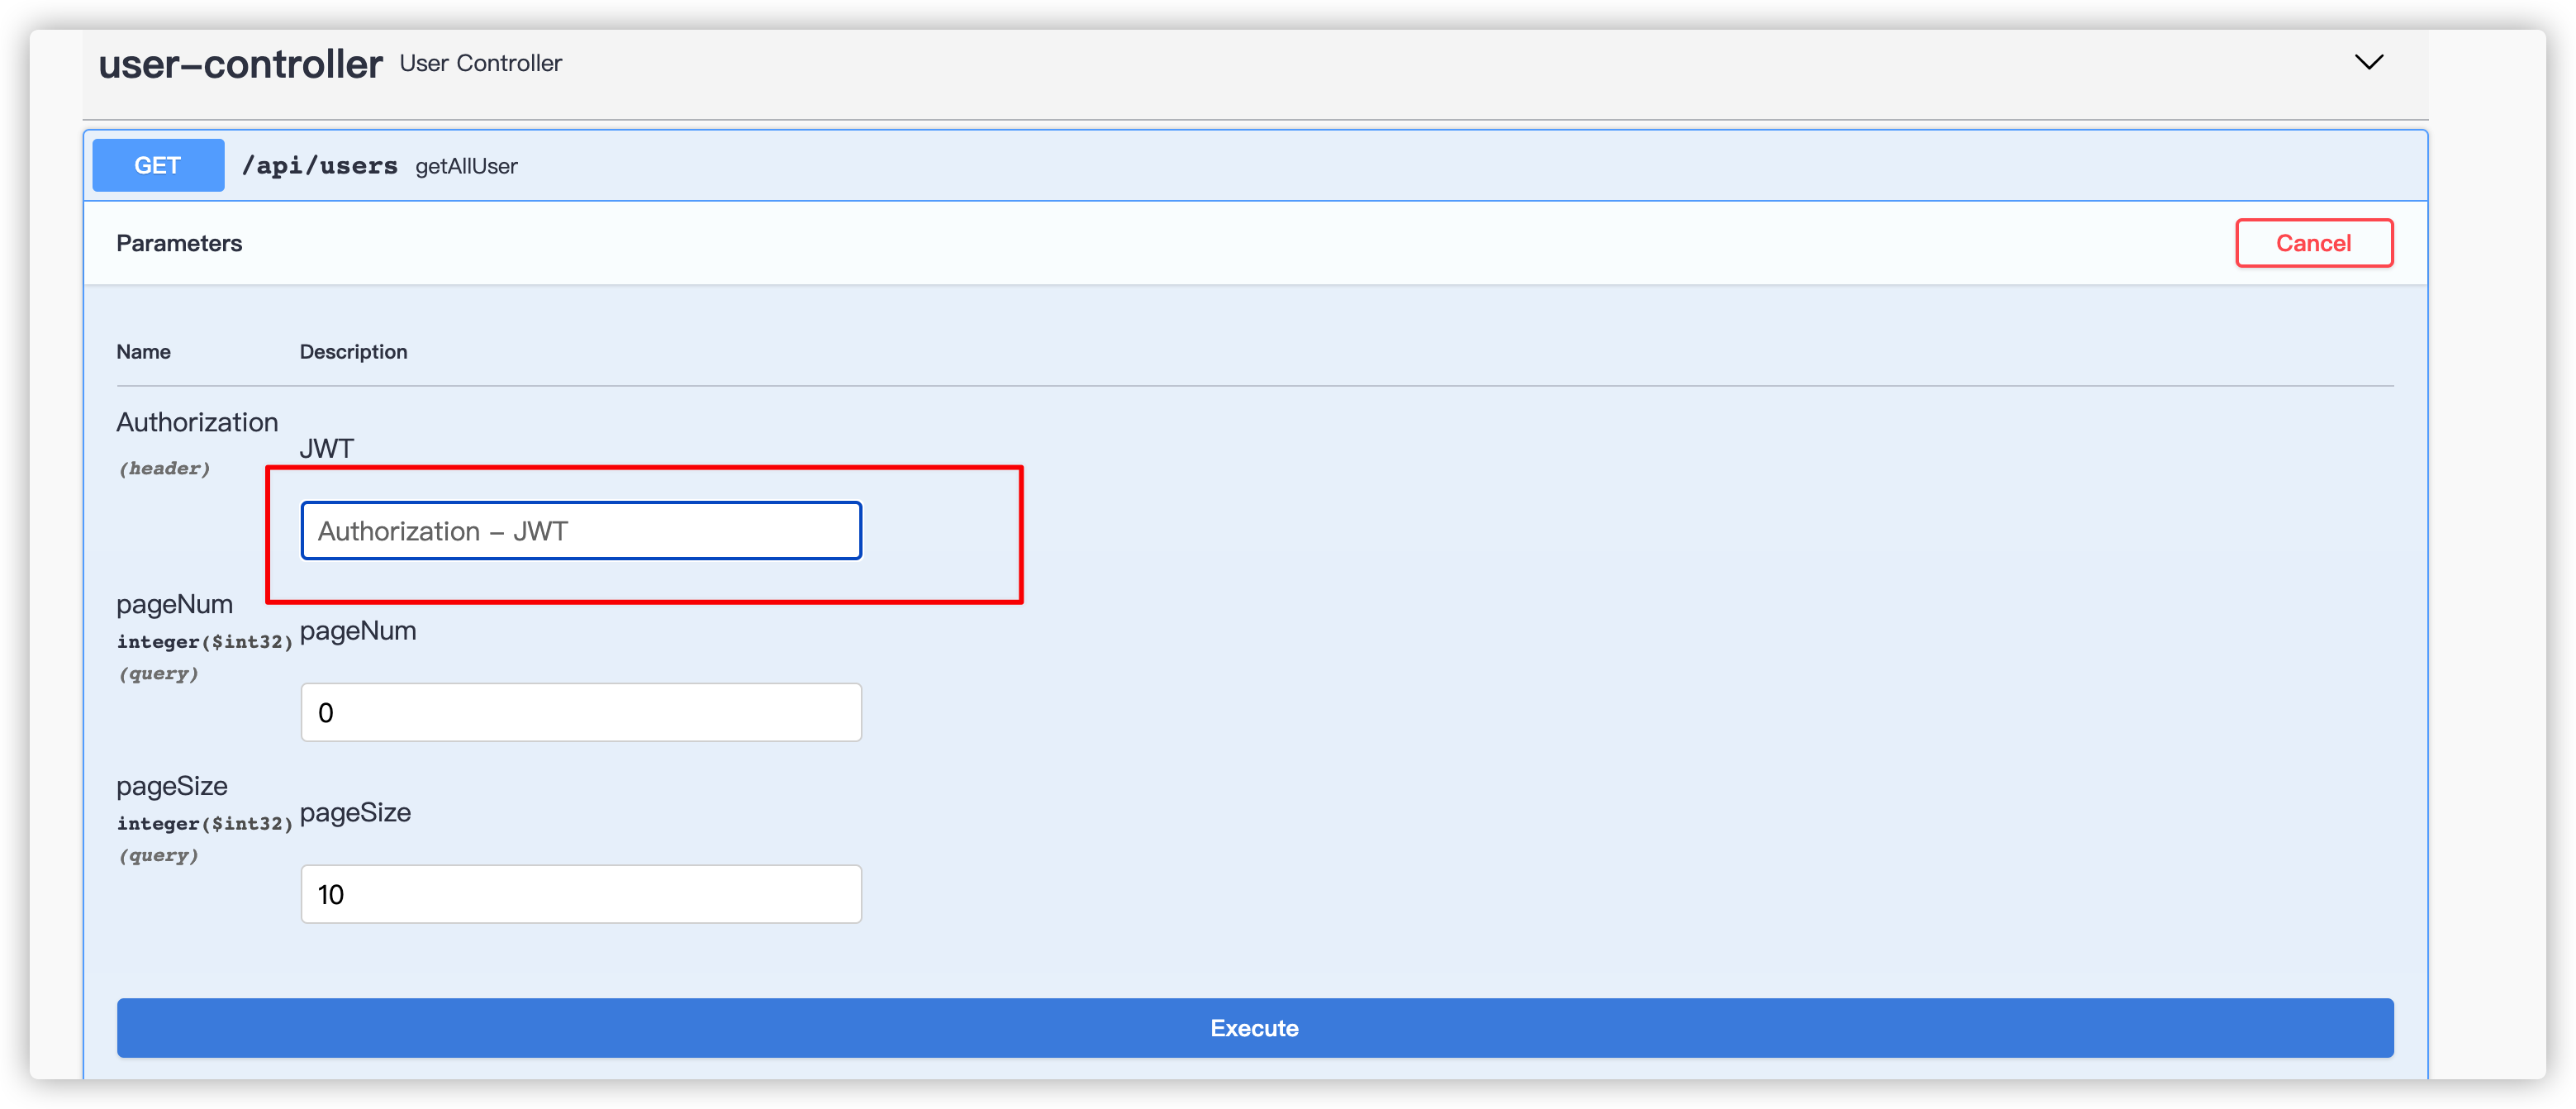java @Configuration public class SwaggerConfig {
@Bean
public Docket createRestApi() {
return new Docket(DocumentationType.SWAGGER_2)
.apiInfo(apiInfo())
.select()
.apis(RequestHandlerSelectors.basePackage("github.javaguide.springsecurityjwtguide"))
.paths(PathSelectors.any())
.build()
.globalRequestParameters(authorizationParameter())
.securitySchemes(securitySchemes());
}private List<SecurityScheme> securitySchemes() {
return Collections.singletonList(new ApiKey("JWT", SecurityConstants.TOKEN_HEADER, "header"));
}private List<RequestParameter> authorizationParameter() {
RequestParameterBuilder tokenBuilder = new RequestParameterBuilder();
tokenBuilder
.name("Authorization")
.description("JWT")
.required(false)
.in("header")
.accepts(Collections.singleton(MediaType.APPLICATION_JSON))
.build();
return Collections.singletonList(tokenBuilder.build());
}private ApiInfo apiInfo() {
return new ApiInfoBuilder()
.title("Spring Security JWT Guide")
.build();
}}
## 使用 knife4j 增强 Swagger
根据官网介绍,knife4j 是为 Java MVC 框架集成 Swagger 生成 Api 文档的增强解决方案。
项目地址:[https://gitee.com/xiaoym/knife4j](https://gitee.com/xiaoym/knife4j) 。
使用方式非常简单,添加到相关依赖即可(SpringBoot 版本 2.3.6.RELEASE)。xml
完成之后,访问:[http://ip:port/doc.html](http://ip:port/doc.html) 即可。
效果如下。可以看出,相比于 swagger 原生 ui 确实好看实用了很多。
除了 UI 上的增强之外,knife4j 还提供了一些开箱即用的功能。
比如:**搜索 API 接口** (`knife4j` 版本>2.0.1 )
再比如:**导出离线文档**
通过 `Knife4j` 我们可以非常方便地导出 Swagger 文档 ,并且支持多种格式。
> - markdown:导出当前逻辑分组下所有接口的 Markdown 格式的文档
> - Html:导出当前逻辑分组下所有接口的 Html 格式的文档
> - Word:导出当前逻辑分组下所有接口的 Word 格式的文档(自 2.0.5 版本开始)
> - OpenAPI:导出当前逻辑分组下的原始 OpenAPI 的规范 json 结构(自 2.0.6 版本开始)
> - PDF:未实现
以 HTML 格式导出的效果图如下。
还等什么?快去试试吧!
---
## Apache BeanUtils VS SpringBean Utils
>本文转载自:[https://pjmike.github.io/2018/11/03/Bean映射工具之Apache-BeanUtils-VS-Spring-BeanUtils/](https://pjmike.github.io/2018/11/03/Bean映射工具之Apache-BeanUtils-VS-Spring-BeanUtils/),作者 pjmike 。
## 前言
在我们实际项目开发过程中,我们经常需要将不同的两个对象实例进行属性复制,从而基于源对象的属性信息进行后续操作,而不改变源对象的属性信息,比如DTO数据传输对象和数据对象DO,我们需要将DO对象进行属性复制到DTO,但是对象格式又不一样,所以我们需要编写映射代码将对象中的属性值从一种类型转换成另一种类型。
## 对象拷贝
在具体介绍两种 BeanUtils 之前,先来补充一些基础知识。它们两种工具本质上就是对象拷贝工具,而对象拷贝又分为深拷贝和浅拷贝,下面进行详细解释。
### 什么是浅拷贝和深拷贝
在Java中,除了 **基本数据类型**之外,还存在 **类的实例对象**这个引用数据类型,而一般使用 “=”号做赋值操作的时候,对于基本数据类型,实际上是拷贝的它的值,但是对于对象而言,其实赋值的只是这个对象的引用,将原对象的引用传递过去,他们实际还是指向的同一个对象。
而浅拷贝和深拷贝就是在这个基础上做的区分,如果在拷贝这个对象的时候,只对基本数据类型进行了拷贝,而对引用数据类型只是进行引用的传递,而没有真实的创建一个新的对象,则认为是**浅拷贝**。反之,在对引用数据类型进行拷贝的时候,创建了一个新的对象,并且复制其内的成员变量,则认为是**深拷贝**。
简单来说:
- **浅拷贝**:对基本数据类型进行值传递,对引用数据类型进行引用传递般的拷贝,此为浅拷贝
- **深拷贝**: 对基本数据类型进行值传递,对引用数据类型,创建一个新的对象,并复制其内容,此为深拷贝。
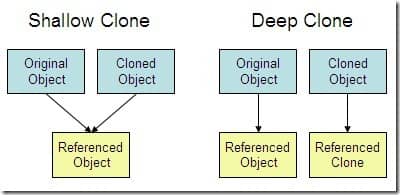
## BeanUtils
前面简单讲了一下对象拷贝的一些知识,下面就来具体看下两种 BeanUtils 工具
### Apache 的 BeanUtils
首先来看一个非常简单的BeanUtils的例子java public class PersonSource {
private Integer id;
private String username;
private String password;
private Integer age;
// getters/setters omiited} public class PersonDest {
private Integer id;
private String username;
private Integer age;
// getters/setters omiited} public class TestApacheBeanUtils {
public static void main(String[] args) throws InvocationTargetException, IllegalAccessException {
//下面只是用于单独测试
PersonSource personSource = new PersonSource(1, "pjmike", "12345", 21);
PersonDest personDest = new PersonDest();
BeanUtils.copyProperties(personDest,personSource);
System.out.println("persondest: "+personDest);
}} persondest: PersonDest{id=1, username='pjmike', age=21}
从上面的例子可以看出,对象拷贝非常简单,BeanUtils最常用的方法就是:java //将源对象中的值拷贝到目标对象 public static void copyProperties(Object dest, Object orig) throws IllegalAccessException, InvocationTargetException {
BeanUtilsBean.getInstance().copyProperties(dest, orig);}
默认情况下,使用`org.apache.commons.beanutils.BeanUtils`对复杂对象的复制是引用,这是一种**浅拷贝**
但是由于 Apache下的BeanUtils对象拷贝性能太差,不建议使用,而且在**阿里巴巴Java开发规约插件**上也明确指出:
> Ali-Check | 避免用Apache Beanutils进行属性的copy。
commons-beantutils 对于对象拷贝加了很多的检验,包括类型的转换,甚至还会检验对象所属的类的可访问性,可谓相当复杂,这也造就了它的差劲的性能,具体实现代码如下:java public void copyProperties(final Object dest, final Object orig)
throws IllegalAccessException, InvocationTargetException { // Validate existence of the specified beans
if (dest == null) {
throw new IllegalArgumentException
("No destination bean specified");
}
if (orig == null) {
throw new IllegalArgumentException("No origin bean specified");
}
if (log.isDebugEnabled()) {
log.debug("BeanUtils.copyProperties(" + dest + ", " +
orig + ")");
} // Copy the properties, converting as necessary
if (orig instanceof DynaBean) {
final DynaProperty[] origDescriptors =
((DynaBean) orig).getDynaClass().getDynaProperties();
for (DynaProperty origDescriptor : origDescriptors) {
final String name = origDescriptor.getName();
// Need to check isReadable() for WrapDynaBean
// (see Jira issue# BEANUTILS-61)
if (getPropertyUtils().isReadable(orig, name) &&
getPropertyUtils().isWriteable(dest, name)) {
final Object value = ((DynaBean) orig).get(name);
copyProperty(dest, name, value);
}
}
} else if (orig instanceof Map) {
@SuppressWarnings("unchecked")
final
// Map properties are always of type <String, Object>
Map<String, Object> propMap = (Map<String, Object>) orig;
for (final Map.Entry<String, Object> entry : propMap.entrySet()) {
final String name = entry.getKey();
if (getPropertyUtils().isWriteable(dest, name)) {
copyProperty(dest, name, entry.getValue());
}
}
} else /* if (orig is a standard JavaBean) */ {
final PropertyDescriptor[] origDescriptors =
getPropertyUtils().getPropertyDescriptors(orig);
for (PropertyDescriptor origDescriptor : origDescriptors) {
final String name = origDescriptor.getName();
if ("class".equals(name)) {
continue; // No point in trying to set an object's class
}
if (getPropertyUtils().isReadable(orig, name) &&
getPropertyUtils().isWriteable(dest, name)) {
try {
final Object value =
getPropertyUtils().getSimpleProperty(orig, name);
copyProperty(dest, name, value);
} catch (final NoSuchMethodException e) {
// Should not happen
}
}
}
}}
### Spring 的 BeanUtils
使用spring的BeanUtils进行对象拷贝:java public class TestSpringBeanUtils {
public static void main(String[] args) throws InvocationTargetException, IllegalAccessException { //下面只是用于单独测试
PersonSource personSource = new PersonSource(1, "pjmike", "12345", 21);
PersonDest personDest = new PersonDest();
BeanUtils.copyProperties(personSource,personDest);
System.out.println("persondest: "+personDest);
}}
spring下的BeanUtils也是使用 `copyProperties`方法进行拷贝,只不过它的实现方式非常简单,就是对两个对象中相同名字的属性进行简单的get/set,仅检查属性的可访问性。具体实现如下:Java private static void copyProperties(Object source, Object target, @Nullable Class editable,
@Nullable String... ignoreProperties) throws BeansException { Assert.notNull(source, "Source must not be null");
Assert.notNull(target, "Target must not be null"); Class<?> actualEditable = target.getClass();
if (editable != null) {
if (!editable.isInstance(target)) {
throw new IllegalArgumentException("Target class [" + target.getClass().getName() +
"] not assignable to Editable class [" + editable.getName() + "]");
}
actualEditable = editable;
}
PropertyDescriptor[] targetPds = getPropertyDescriptors(actualEditable);
List<String> ignoreList = (ignoreProperties != null ? Arrays.asList(ignoreProperties) : null); for (PropertyDescriptor targetPd : targetPds) {
Method writeMethod = targetPd.getWriteMethod();
if (writeMethod != null && (ignoreList == null || !ignoreList.contains(targetPd.getName()))) {
PropertyDescriptor sourcePd = getPropertyDescriptor(source.getClass(), targetPd.getName());
if (sourcePd != null) {
Method readMethod = sourcePd.getReadMethod();
if (readMethod != null &&
ClassUtils.isAssignable(writeMethod.getParameterTypes()[0], readMethod.getReturnType())) {
try {
if (!Modifier.isPublic(readMethod.getDeclaringClass().getModifiers())) {
readMethod.setAccessible(true);
}
Object value = readMethod.invoke(source);
if (!Modifier.isPublic(writeMethod.getDeclaringClass().getModifiers())) {
writeMethod.setAccessible(true);
}
writeMethod.invoke(target, value);
}
catch (Throwable ex) {
throw new FatalBeanException(
"Could not copy property '" + targetPd.getName() + "' from source to target", ex);
}
}
}
}
}
}
可以看到,成员变量赋值是基于目标对象的成员列表,并且会跳过ignore的以及在源对象中不存在,所以这个方法是安全的,不会因为两个对象之间的结构差异导致错误,但是**必须保证同名的两个成员变量类型相同**
## 小结
以上简要的分析两种BeanUtils,因为Apache下的BeanUtils性能较差,不建议使用,可以使用 Spring的BeanUtils ,或者使用其他拷贝框架,比如:**[Dozer](http://dozer.sourceforge.net/documentation/gettingstarted.html)**、**[ModelMapper](http://modelmapper.org/)**等等,在后面的文章中我会对这些拷贝框架进行介绍。
## 参考资料 & 鸣谢
- [谈谈 Java 开发中的对象拷贝](http://www.importnew.com/26306.html)
- [细说 Java 的深拷贝和浅拷贝](https://segmentfault.com/a/1190000010648514)
---
## Performance of Java Mapping Frameworks
> 本文由 JavaGuide 翻译自 https://www.baeldung.com/java-performance-mapping-frameworks 。转载请注明原文地址以及翻译作者。
## 1. 介绍
创建由多个层组成的大型 Java 应用程序需要使用多种领域模型,如持久化模型、领域模型或者所谓的 DTO。为不同的应用程序层使用多个模型将要求我们提供 bean 之间的映射方法。手动执行此操作可以快速创建大量样板代码并消耗大量时间。幸运的是,Java 有多个对象映射框架。在本教程中,我们将比较最流行的 Java 映射框架的性能。
> 综合日常使用情况和相关测试数据,个人感觉 MapStruct、ModelMapper 这两个 Bean 映射框架是最佳选择。
## 2. 常见 Bean 映射框架概览
### 2.1. Dozer
Dozer 是一个映射框架,它使用递归将数据从一个对象复制到另一个对象。框架不仅能够在 bean 之间复制属性,还能够在不同类型之间自动转换。
要使用 Dozer 框架,我们需要添加这样的依赖到我们的项目:xml
更多关于 Dozer 的内容可以在官方文档中找到: http://dozer.sourceforge.net/documentation/gettingstarted.html ,或者你也可以阅读这篇文章:https://www.baeldung.com/dozer 。
### 2.2. Orika
Orika 是一个 bean 到 bean 的映射框架,它递归地将数据从一个对象复制到另一个对象。
Orika 的工作原理与 Dozer 相似。两者之间的主要区别是 Orika 使用字节码生成。这允许以最小的开销生成更快的映射器。
要使用 Orika 框架,我们需要添加这样的依赖到我们的项目:xml
更多关于 Orika 的内容可以在官方文档中找到:https://orika-mapper.github.io/orika-docs/,或者你也可以阅读这篇文章:https://www.baeldung.com/orika-mapping。
### 2.3. MapStruct
MapStruct 是一个自动生成 bean mapper 类的代码生成器。MapStruct 还能够在不同的数据类型之间进行转换。Github 地址:https://github.com/mapstruct/mapstruct。
要使用 MapStruct 框架,我们需要添加这样的依赖到我们的项目:xml
更多关于 MapStruct 的内容可以在官方文档中找到:https://mapstruct.org/,或者你也可以阅读这篇文章:https://www.baeldung.com/mapstruct。
要使用 MapStruct 框架,我们需要添加这样的依赖到我们的项目:xml
### 2.4. ModelMapper
ModelMapper 是一个旨在简化对象映射的框架,它根据约定确定对象之间的映射方式。它提供了类型安全的和重构安全的 API。
更多关于 ModelMapper 的内容可以在官方文档中找到:http://modelmapper.org/ 。
要使用 ModelMapper 框架,我们需要添加这样的依赖到我们的项目:xml
### 2.5. JMapper
JMapper 是一个映射框架,旨在提供易于使用的、高性能的 Java bean 之间的映射。该框架旨在使用注释和关系映射应用 DRY 原则。该框架允许不同的配置方式:基于注释、XML 或基于 api。
更多关于 JMapper 的内容可以在官方文档中找到:https://github.com/jmapper-framework/jmapper-core/wiki。
要使用 JMapper 框架,我们需要添加这样的依赖到我们的项目:xml
## 3.测试模型
为了能够正确地测试映射,我们需要有一个源和目标模型。我们已经创建了两个测试模型。
第一个是一个只有一个字符串字段的简单 POJO,它允许我们在更简单的情况下比较框架,并检查如果我们使用更复杂的 bean 是否会发生任何变化。
简单的源模型如下:java public class SourceCode {
String code;
// getter and setter}
它的目标也很相似:java public class DestinationCode {
String code;
// getter and setter}
源 bean 的实际示例如下:java public class SourceOrder {
private String orderFinishDate;
private PaymentType paymentType;
private Discount discount;
private DeliveryData deliveryData;
private User orderingUser;
private List<Product> orderedProducts;
private Shop offeringShop;
private int orderId;
private OrderStatus status;
private LocalDate orderDate;
// standard getters and setters}
目标类如下图所示:java public class Order {
private User orderingUser;
private List<Product> orderedProducts;
private OrderStatus orderStatus;
private LocalDate orderDate;
private LocalDate orderFinishDate;
private PaymentType paymentType;
private Discount discount;
private int shopId;
private DeliveryData deliveryData;
private Shop offeringShop;
// standard getters and setters}
整个模型结构可以在这里找到:https://github.com/eugenp/tutorials/tree/master/performance-tests/src/main/java/com/baeldung/performancetests/model/source。
## 4. 转换器
为了简化测试设置的设计,我们创建了如下所示的转换器接口:java public interface Converter {
Order convert(SourceOrder sourceOrder);
DestinationCode convert(SourceCode sourceCode);}
我们所有的自定义映射器都将实现这个接口。
### 4.1. OrikaConverter
Orika 支持完整的 API 实现,这大大简化了 mapper 的创建:java public class OrikaConverter implements Converter{
private MapperFacade mapperFacade;public OrikaConverter() {
MapperFactory mapperFactory = new DefaultMapperFactory
.Builder().build(); mapperFactory.classMap(Order.class, SourceOrder.class)
.field("orderStatus", "status").byDefault().register();
mapperFacade = mapperFactory.getMapperFacade();
}@Override
public Order convert(SourceOrder sourceOrder) {
return mapperFacade.map(sourceOrder, Order.class);
}@Override
public DestinationCode convert(SourceCode sourceCode) {
return mapperFacade.map(sourceCode, DestinationCode.class);
}}
### 4.2. **DozerConverter**
Dozer 需要 XML 映射文件,有以下几个部分:xml
定义了 XML 映射后,我们可以从代码中使用它:java public class DozerConverter implements Converter {
private final Mapper mapper;public DozerConverter() {
DozerBeanMapper mapper = new DozerBeanMapper();
mapper.addMapping(
DozerConverter.class.getResourceAsStream("/dozer-mapping.xml"));
this.mapper = mapper;
}@Override
public Order convert(SourceOrder sourceOrder) {
return mapper.map(sourceOrder,Order.class);
}@Override
public DestinationCode convert(SourceCode sourceCode) {
return mapper.map(sourceCode, DestinationCode.class);
}}
### 4.3. MapStructConverter
Map 结构的定义非常简单,因为它完全基于代码生成:java @Mapper public interface MapStructConverter extends Converter {
MapStructConverter MAPPER = Mappers.getMapper(MapStructConverter.class);@Mapping(source = "status", target = "orderStatus")
@Override
Order convert(SourceOrder sourceOrder);@Override
DestinationCode convert(SourceCode sourceCode);}
### 4.4. **JMapperConverter**
JMapperConverter 需要做更多的工作。接口实现后:java public class JMapperConverter implements Converter {
JMapper realLifeMapper;
JMapper simpleMapper;public JMapperConverter() {
JMapperAPI api = new JMapperAPI()
.add(JMapperAPI.mappedClass(Order.class));
realLifeMapper = new JMapper(Order.class, SourceOrder.class, api);
JMapperAPI simpleApi = new JMapperAPI()
.add(JMapperAPI.mappedClass(DestinationCode.class));
simpleMapper = new JMapper(
DestinationCode.class, SourceCode.class, simpleApi);
}@Override
public Order convert(SourceOrder sourceOrder) {
return (Order) realLifeMapper.getDestination(sourceOrder);
}@Override
public DestinationCode convert(SourceCode sourceCode) {
return (DestinationCode) simpleMapper.getDestination(sourceCode);
}}
我们还需要向目标类的每个字段添加`@JMap`注释。此外,JMapper 不能在 enum 类型之间转换,它需要我们创建自定义映射函数:java @JMapConversion(from = "paymentType", to = "paymentType") public PaymentType conversion(com.baeldung.performancetests.model.source.PaymentType type) {
PaymentType paymentType = null;
switch(type) {
case CARD:
paymentType = PaymentType.CARD;
break; case CASH:
paymentType = PaymentType.CASH;
break; case TRANSFER:
paymentType = PaymentType.TRANSFER;
break;
}
return paymentType;}
### 4.5. **ModelMapperConverter**
ModelMapperConverter 只需要提供我们想要映射的类:java public class ModelMapperConverter implements Converter {
private ModelMapper modelMapper;public ModelMapperConverter() {
modelMapper = new ModelMapper();
}@Override
public Order convert(SourceOrder sourceOrder) {
return modelMapper.map(sourceOrder, Order.class);
}@Override
public DestinationCode convert(SourceCode sourceCode) {
return modelMapper.map(sourceCode, DestinationCode.class);
}}
```
5. 简单的模型测试
对于性能测试,我们可以使用 Java Microbenchmark Harness,关于如何使用它的更多信息可以在 这篇文章:https://www.baeldung.com/java-microbenchmark-harness 中找到。
我们为每个转换器创建了一个单独的基准测试,并将基准测试模式指定为 Mode.All。
5.1. 平均时间
对于平均运行时间,JMH 返回以下结果(越少越好):
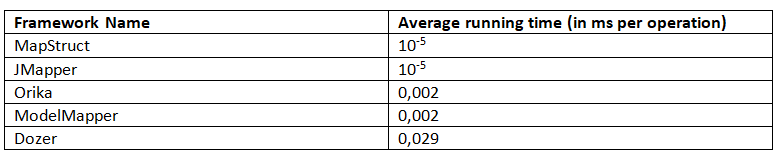
这个基准测试清楚地表明,MapStruct 和 JMapper 都有最佳的平均工作时间。
5.2. 吞吐量
在这种模式下,基准测试返回每秒的操作数。我们收到以下结果(越多越好):

在吞吐量模式中,MapStruct 是测试框架中最快的,JMapper 紧随其后。
5.3. SingleShotTime
这种模式允许测量单个操作从开始到结束的时间。基准给出了以下结果(越少越好):
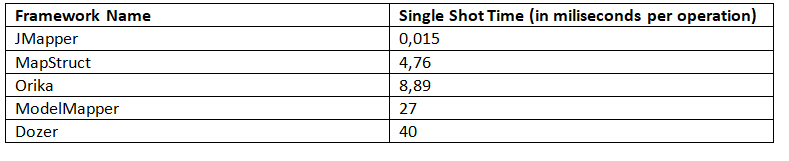
这里,我们看到 JMapper 返回的结果比 MapStruct 好得多。
5.4. 采样时间
这种模式允许对每个操作的时间进行采样。三个不同百分位数的结果如下:
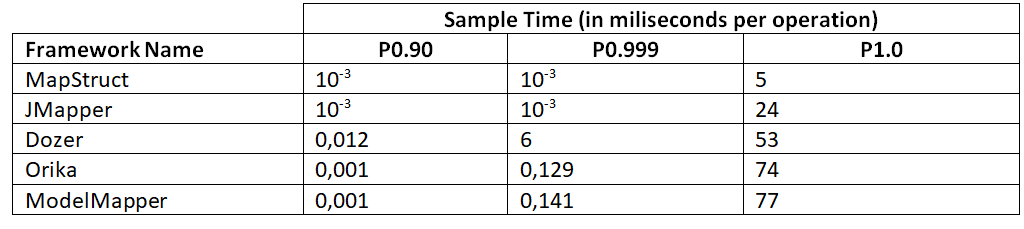
所有的基准测试都表明,根据场景的不同,MapStruct 和 JMapper 都是不错的选择,尽管 MapStruct 对 SingleShotTime 给出的结果要差得多。
6. 真实模型测试
对于性能测试,我们可以使用 Java Microbenchmark Harness,关于如何使用它的更多信息可以在 这篇文章:https://www.baeldung.com/java-microbenchmark-harness 中找到。
我们为每个转换器创建了一个单独的基准测试,并将基准测试模式指定为 Mode.All。
6.1. 平均时间
JMH 返回以下平均运行时间结果(越少越好):

该基准清楚地表明,MapStruct 和 JMapper 均具有最佳的平均工作时间。
6.2. 吞吐量
在这种模式下,基准测试返回每秒的操作数。我们收到以下结果(越多越好):
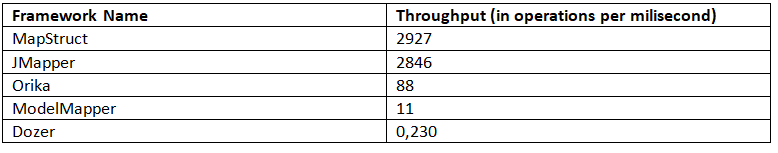
在吞吐量模式中,MapStruct 是测试框架中最快的,JMapper 紧随其后。
6.3. SingleShotTime
这种模式允许测量单个操作从开始到结束的时间。基准给出了以下结果(越少越好):
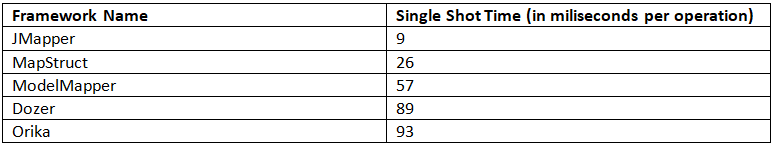
6.4. 采样时间
这种模式允许对每个操作的时间进行采样。三个不同百分位数的结果如下:
尽管简单示例和实际示例的确切结果明显不同,但是它们的趋势相同。在哪种算法最快和哪种算法最慢方面,两个示例都给出了相似的结果。
6.5. 结论
根据我们在本节中执行的真实模型测试,我们可以看出,最佳性能显然属于 MapStruct。在相同的测试中,我们看到 Dozer 始终位于结果表的底部。
7. 总结
在这篇文章中,我们已经进行了五个流行的 Java Bean 映射框架性能测试:ModelMapper , MapStruct , Orika ,Dozer, JMapper。
示例代码地址:https://github.com/eugenp/tutorials/tree/master/performance-tests。