
Nodejs学习笔记
阿里CBU技术部招前端实习生啦!2023届的同学看过来,专业过关、前端基础扎实即可,低代码/跨端/直播/VR/electron/nodejs ,总有一款适合你 👍 可点击这里投递简历,感兴趣的小伙伴也可以加我微信 casperchen 咨询,注明是否找实习哦~
Nodejs学习过程中的一些总结,可点击这里查看完整版。欢迎关注公众号 程序猿小卡。
- 基础:核心模块常用API 的使用、注意事项。(含可执行的demo)
- 进阶:项目实战经验总结,含常用框架、库介绍,从编码到服务端部署运维。
目录如下
- Introduction
- 内置模块
- 资源压缩-zlib\(ok\)
- 文件系统操作-fs
- 域名解析-dns\(ok\)
- 网络服务-http\(ok\)
- 网络服务-http-req\(ok\)
- 网络服务-http-res\(ok\)
- 网络服务-http-client\(ok\)
- 网络服务-http-server\(ok\)
- 网络服务-https(ok)
- 网络TCP-net\(ok\)
- 网络UDP-dgram(ok)
- 网络地址解析-url\(ok\)
- 数据加密-crypto(OK)
- URL查询字符串-querystring\(ok\)
- 二进制数据-buffer\(ok\)
- 子进程-child\_process
- 进程相关-process(ok)
- 集群-cluster(ok)
- 基础调试-console(ok)
- 进阶调试-debugger(ok)
- 错误处理-error
- 事件机制-events(ok)
- 全局对象-global
- 模块机制-module
- 本地路径处理-path\(ok\)
- 逐行读取-readline(ok)
- 命令行设计-repl
- 实用工具模块-util(ok)
- 流操作-stream(ok)
- 二进制解码-string\_decoder
- 定时器-timers
- 安全加密-tls
- 进阶使用
- Nodejs进阶:服务端字符编解码&乱码处理(ok)
- Nodejs进阶:MD5入门介绍及crypto模块的应用(ok)
- Nodejs 进阶:Express 常用中间件 body-parser 实现解析(ok)
- 基于express+muter的文件上传(ok)
- 将图片转成datauri嵌入到html(ok)
- 本地调试远程服务器上的Node代码(ok)
- express+session实现简易身份认证(ok)
- express+morgan:从入门使用到源码剖析(ok)
- express+cookie-parser:签名机制深入剖析(ok)
- Nodejs 进阶:log4js入门实例(ok)
- 调试日志打印:debug模块
- Nodejs进阶:crypto模块之理论篇
- Nodejs进阶:5分钟入门非对称加密用法
- express进阶:多模板引擎支持
- 基于 express + XHR 的跨域资源请求
微信公众号
zlib
概览
做过web性能优化的同学,对性能优化大杀器gzip应该不陌生。浏览器向服务器发起资源请求,比如下载一个js文件,服务器先对资源进行压缩,再返回给浏览器,以此节省流量,加快访问速度。
浏览器通过HTTP请求头部里加上Accept-Encoding,告诉服务器,“你可以用gzip,或者defalte算法压缩资源”。
Accept-Encoding:gzip, deflate
那么,在nodejs里,是如何对资源进行压缩的呢?答案就是Zlib模块。
入门实例:简单的压缩/解压缩
压缩的例子
非常简单的几行代码,就完成了本地文件的gzip压缩。
var fs = require('fs');
var zlib = require('zlib');

var gzip = zlib.createGzip();

var inFile = fs.createReadStream('./extra/fileForCompress.txt');
var out = fs.createWriteStream('./extra/fileForCompress.txt.gz');

inFile.pipe(gzip).pipe(out);
解压的例子
同样非常简单,就是个反向操作。
var fs = require('fs');
var zlib = require('zlib');

var gunzip = zlib.createGunzip();

var inFile = fs.createReadStream('./extra/fileForCompress.txt.gz');
var outFile = fs.createWriteStream('./extra/fileForCompress1.txt');

inFile.pipe(gunzip).pipe(outFile);
服务端gzip压缩
代码超级简单。首先判断 是否包含 accept-encoding 首部,且值为gzip。
- 否:返回未压缩的文件。
- 是:返回gzip压缩后的文件。
var http = require('http');
var zlib = require('zlib');
var fs = require('fs');
var filepath = './extra/fileForGzip.html';

var server = http.createServer(function(req, res){
    var acceptEncoding = req.headers['accept-encoding'];
    var gzip;

    if(acceptEncoding.indexOf('gzip')!=-1){ // 判断是否需要gzip压缩

        gzip = zlib.createGzip();

        // 记得响应 Content-Encoding,告诉浏览器:文件被 gzip 压缩过
        res.writeHead(200, {
            'Content-Encoding': 'gzip'
        });
        fs.createReadStream(filepath).pipe(gzip).pipe(res);

    }else{

        fs.createReadStream(filepath).pipe(res);
    }

});

server.listen('3000');
服务端字符串gzip压缩
代码跟前面例子大同小异。这里采用了 zlib.gzipSync(str) 对字符串进行gzip压缩。
var http = require('http');
var zlib = require('zlib');

var responseText = 'hello world';

var server = http.createServer(function(req, res){
    var acceptEncoding = req.headers['accept-encoding'];
    if(acceptEncoding.indexOf('gzip')!=-1){
        res.writeHead(200, {
            'content-encoding': 'gzip'
        });
        res.end( zlib.gzipSync(responseText) );
    }else{
        res.end(responseText);
    }

});

server.listen('3000');
写在后面
deflate压缩的使用也差不多,这里就不赘述。更多详细用法可参考官方文档。
fs
文件读取
普通读取
同步读取
var fs = require('fs');
var data;

try{
    data = fs.readFileSync('./fileForRead.txt', 'utf8');
    console.log('文件内容: ' + data);
}catch(err){
    console.error('读取文件出错: ' + err.message);
}
输出如下:
/usr/local/bin/node readFileSync.js
文件内容: hello world
异步读取
var fs = require('fs');

fs.readFile('./fileForRead.txt', 'utf8', function(err, data){
    if(err){
        return console.error('读取文件出错: ' + err.message);
    }
    console.log('文件内容: ' + data);
});
输出如下
/usr/local/bin/node readFile.js
文件内容: hello world
通过文件流读取
适合读取大文件
var fs = require('fs');
var readStream = fs.createReadStream('./fileForRead.txt', 'utf8');

readStream
    .on('data', function(chunk) {
        console.log('读取数据: ' + chunk);
    })
    .on('error', function(err){
        console.log('出错: ' + err.message);
    })
    .on('end', function(){  // 没有数据了
        console.log('没有数据了');
    })
    .on('close', function(){  // 已经关闭,不会再有事件抛出
        console.log('已经关闭');
    });
输出如下
/usr/local/bin/node createReadStream.js
读取数据: hello world
没有数据了
已经关闭
文件写入
备注:以下代码,如果文件不存在,则创建文件;如果文件存在,则覆盖文件内容;
异步写入
var fs = require('fs');

fs.writeFile('./fileForWrite.txt', 'hello world', 'utf8', function(err){
    if(err) throw err;
    console.log('文件写入成功');
});
同步写入
var fs = require('fs');

try{
    fs.writeFileSync('./fileForWrite1.txt', 'hello world', 'utf8');
    console.log('文件写入成功');
}catch(err){
    throw err;
}
通过文件流写入
var fs = require('fs');
var writeStream = fs.createWriteStream('./fileForWrite1.txt', 'utf8');

writeStream
    .on('close', function(){  // 已经关闭,不会再有事件抛出
        console.log('已经关闭');
    });

writeStream.write('hello');
writeStream.write('world');
writeStream.end('');
相对底层的接口
fs.write(fd, buffer, offset, length[, position], callback) fs.write(fd, data[, position[, encoding]], callback) fs.writeSync(fd, buffer, offset, length[, position]) fs.writeSync(fd, data[, position[, encoding]])
- fd:写入的文件句柄。
- buffer:写入的内容。
- offset:将buffer从offset位置开始,长度为length的内容写入。
- length:写入的buffer内容的长度。
- position:从打开文件的position处写入。
- callback:参数为
(err, written, buffer)。written表示有xx字节的buffer被写入。
备注:fs.write(fd, buffer, offset, length[, position], callback)跟fs.write(fd, data[, position[, encoding]], callback)的区别在于:后面的只能把所有的data写入,而前面的可以写入指定的data子串?
文件是否存在
fs.exists()已经是deprecated状态,现在可以通过下面代码判断文件是否存在。
var fs = require('fs');

fs.access('./fileForRead.txt', function(err){
    if(err) throw err;
    console.log('fileForRead.txt存在');
});

fs.access('./fileForRead2.txt', function(err){
    if(err) throw err;
    console.log('fileForRead2.txt存在');
});fs.access()除了判断文件是否存在(默认模式),还可以用来判断文件的权限。
备忘:fs.constants.F_OK等常量无法获取(node v6.1,mac 10.11.4下,fs.constants是undefined)
创建目录
异步版本(如果目录已存在,会报错)
var fs = require('fs');

fs.mkdir('./hello', function(err){
    if(err) throw err;
    console.log('目录创建成功');
});
同步版本
var fs = require('fs');

fs.mkdirSync('./hello');
删除文件
var fs = require('fs');

fs.unlink('./fileForUnlink.txt', function(err){
    if(err) throw err;
    console.log('文件删除成功');
});
var fs = require('fs');
fs.unlinkSync('./fileForUnlink.txt');创建目录
// fs.mkdir(path[, mode], callback)
var fs = require('fs');

fs.mkdir('sub', function(err){
    if(err) throw err;
    console.log('创建目录成功');
});
// fs.mkdirSync(path[, mode])
var fs = require('fs');
try{
fs.mkdirSync('hello');
console.log('创建目录成功');
}catch(e){
throw e;
}遍历目录
同步版本,注意:fs.readdirSync()只会读一层,所以需要判断文件类型是否目录,如果是,则进行递归遍历。
// fs.readdirSync(path[, options])

var fs = require('fs');
var path = require('path');

var getFilesInDir = function(dir){

    var results = [ path.resolve(dir) ];
    var files = fs.readdirSync(dir, 'utf8');

    files.forEach(function(file){

        file = path.resolve(dir, file);

        var stats = fs.statSync(file);

        if(stats.isFile()){
            results.push(file);
        }else if(stats.isDirectory()){
            results = results.concat( getFilesInDir(file) );
        }
    });

    return results;
};

var files = getFilesInDir('../');
console.log(files);
异步版本:(TODO)
文件重命名
// fs.rename(oldPath, newPath, callback)
var fs = require('fs');

fs.rename('./hello', './world', function(err){
    if(err) throw err;
    console.log('重命名成功');
});
fs.renameSync(oldPath, newPath)
var fs = require('fs');
fs.renameSync('./world', './hello');监听文件修改
fs.watch()比fs.watchFile()高效很多(why)
fs.watchFile()
实现原理:轮询。每隔一段时间检查文件是否发生变化。所以在不同平台上表现基本是一致的。
var fs = require('fs');

var options = {
    persistent: true,  // 默认就是true
    interval: 2000  // 多久检查一次
};

// curr, prev 是被监听文件的状态, fs.Stat实例
// 可以通过 fs.unwatch() 移除监听
fs.watchFile('./fileForWatch.txt', options, function(curr, prev){
    console.log('修改时间为: ' + curr.mtime);
});修改fileForWatch.txt,可以看到控制台下打印出日志
/usr/local/bin/node watchFile.js
修改时间为: Sat Jul 16 2016 19:03:57 GMT+0800 (CST)
修改时间为: Sat Jul 16 2016 19:04:05 GMT+0800 (CST)
为啥子?莫非单纯访问文件也会触发回调?
If you want to be notified when the file was modified, not just accessed, you need to compare curr.mtime and prev.mtime.
在 v0.10 之后的改动。如果监听的文件不存在,会怎么处理。如下
Note: when an fs.watchFile operation results in an ENOENT error, it will invoke the listener once, with all the fields zeroed (or, for dates, the Unix Epoch). In Windows, blksize and blocks fields will be undefined, instead of zero. If the file is created later on, the listener will be called again, with the latest stat objects. This is a change in functionality since v0.10.
fs.watch()
fs.watch(filename[, options][, listener]) fs.unwatchFile(filename[, listener])
这接口非常不靠谱(当前测试用的v6.1.0),参考 https://github.com/nodejs/node/issues/7420
fs.watch(filename[, options][, listener])#
注意:fs.watch()这个接口并不是在所有的平台行为都一致,并且在某些情况下是不可用的。recursive这个选项只在mac、windows下可用。
问题来了:
- 不一致的表现。
- 不可用的场景。
- linux上要recursive咋整。
The fs.watch API is not 100% consistent across platforms, and is unavailable in some situations. The recursive option is only supported on OS X and Windows.
备忘,不可用的场景。比如网络文件系统等。
For example, watching files or directories can be unreliable, and in some cases impossible, on network file systems (NFS, SMB, etc), or host file systems when using virtualization software such as Vagrant, Docker, etc.
另外,listener回调有两个参数,分别是event、filename。其中,filename仅在linux、windows上会提供,并且不是100%提供,所以,尽量不要依赖filename。
在linux、osx上,fs.watch()监听的是inode。如果文件被删除,并重新创建,那么删除事件会触发。同时,fs.watch()监听的还是最初的inode。(API的设计就是这样的)
结论:怎么看都感觉这个API很不靠谱,虽然性能比fs.watchFile()要高很多。
先来个例子,在osx下测试了一下,简直令人绝望。。。无论是创建、修改、删除文件,evt都是rename。。。
var fs = require('fs');

var options = {
    persistent: true,
    recursive: true,
    encoding: 'utf8'
};

fs.watch('../', options, function(event, filename){
    console.log('触发事件:' + event);
    if(filename){
        console.log('文件名是: ' + filename);
    }else{
        console.log('文件名是没有提供');
    }
});修改下fileForWatch.txt,看到下面输出。。。感觉打死也不想用这个API。。。
贴下环境:osx 10.11.4, node v6.1.0。
触发事件:rename
文件名是: fs/fileForWatch.txt___jb_bak___
触发事件:rename
文件名是: fs/fileForWatch.txt
触发事件:rename
文件名是: fs/fileForWatch.txt___jb_old___
触发事件:rename
文件名是: .idea/workspace.xml___jb_bak___
触发事件:rename
文件名是: .idea/workspace.xml
触发事件:rename
文件名是: .idea/workspace.xml___jb_old___
修改所有者
参考linux命令行,不举例子了。。。
fs.chown(path, uid, gid, callback) fs.chownSync(path, uid, gid) fs.fchown(fd, uid, gid, callback) fs.fchownSync(fd, uid, gid)
修改权限
可以用fs.chmod(),也可以用fs.fchmod()。两者的区别在于,前面传的是文件路径,后面传的的文件句柄。
fs.chmod)、fs.fchmod()区别:传的是文件路径,还是文件句柄。fs.chmod()、fs.lchmod()区别:如果文件是软连接,那么fs.chmod()修改的是软连接指向的目标文件;fs.lchmod()修改的是软连接。
fs.chmod(path, mode, callback) fs.chmodSync(path, mode)
fs.fchmod(fd, mode, callback) fs.fchmodSync(fd, mode)
fs.lchmod(path, mode, callback)# fs.lchmodSync(path, mode)
例子:
var fs = require('fs');

fs.chmod('./fileForChown.txt', '777', function(err){
    if(err) console.log(err);
    console.log('权限修改成功');
});
同步版本:
var fs = require('fs');

fs.chmodSync('./fileForChown.txt', '777');
获取文件状态
区别:
fs.stat()vsfs.fstat():传文件路径 vs 文件句柄。fs.stat()vsfs.lstat():如果文件是软链接,那么fs.stat()返回目标文件的状态,fs.lstat()返回软链接本身的状态。
fs.stat(path, callback) fs.statSync(path)
fs.fstat(fd, callback) fs.fstatSync(fd)
fs.lstat(path, callback) fs.lstatSync(path)
主要关注Class: fs.Stats。
首先是方法
- stats.isFile() -- 是否文件
- stats.isDirectory() -- 是否目录
- stats.isBlockDevice() -- 什么鬼
- stats.isCharacterDevice() -- 什么鬼
- stats.isSymbolicLink() (only valid with fs.lstat()) -- 什么鬼
- stats.isFIFO() -- 什么鬼
- stats.isSocket() -- 是不是socket文件
官网例子:
{
  dev: 2114,
  ino: 48064969,
  mode: 33188,
  nlink: 1,
  uid: 85,
  gid: 100,
  rdev: 0,
  size: 527,
  blksize: 4096,
  blocks: 8,
  atime: Mon, 10 Oct 2011 23:24:11 GMT, // 访问时间
  mtime: Mon, 10 Oct 2011 23:24:11 GMT,  // 文件内容修改时间
  ctime: Mon, 10 Oct 2011 23:24:11 GMT,  // 文件状态修改时间
  birthtime: Mon, 10 Oct 2011 23:24:11 GMT  // 创建时间
}- atime:Access Time // 访问时间
- mtime:: Modified Time // 文件内容修改时间
- ctime: Changed Time. // 文件状态修改时间,比如修改文件所有者、修改权限、重命名等
- birthtime: Birth Time // 创建时间。在某些系统上是不可靠的,因为拿不到。
例子:
var fs = require('fs');

var getTimeDesc = function(d){
    return [d.getFullYear(), d.getMonth()+1, d.getDate()].join('-') + ' ' + [d.getHours(), d.getMinutes(), d.getSeconds()].join(':');
};

fs.stat('./fileForStat.txt', function(err, stats){
    console.log('文件大小: ' + stats.size);
    console.log('创建时间: ' + getTimeDesc(stats.birthtime));
    console.log('访问时间: ' + getTimeDesc(stats.atime));
    console.log('修改时间: ' + getTimeDesc(stats.mtime));
});
输出如下:
/usr/local/bin/node stat.js
文件大小: 3613
创建时间: 2016-7-16 12:40:49
访问时间: 2016-7-16 12:40:49
修改时间: 2016-7-16 12:40:49

Process finished with exit code 0
同步的例子:
var fs = require('fs');

var getTimeDesc = function(d){
    return [d.getFullYear(), d.getMonth()+1, d.getDate()].join('-') + ' ' + [d.getHours(), d.getMinutes(), d.getSeconds()].join(':');
};

var stats = fs.statSync('./fileForStat.txt');

console.log('文件大小: ' + stats.size);
console.log('创建时间: ' + getTimeDesc(stats.birthtime));
console.log('访问时间: ' + getTimeDesc(stats.atime));
console.log('修改时间: ' + getTimeDesc(stats.mtime));
访问/权限检测
例子:
// fs.access(path[, mode], callback)
var fs = require('fs');

fs.access('./fileForAccess.txt', function(err){
    if(err) throw err;
    console.log('可以访问');
});
同步版本:
// fs.accessSync(path[, mode])
var fs = require('fs');

// 如果成功,则返回undefined,如果失败,则抛出错误(什么鬼)
try{
    fs.accessSync('./fileForAccess.txt');
}catch(e){
    throw(e);
}
文件打开/关闭
比较底层的接口,实际需要用到的机会不多。需要用到的时候看下文档就行。
- flags:文件打开模式,比如
r、r+、w、w+等。可选模式非常多。 - mode:默认是
666,可读+可写。
fs.open(path, flags[, mode], callback) fs.openSync(path, flags[, mode]) fs.close(fd, callback) fs.closeSync(fd)
文件读取(底层)
相对底层的读取接口,参数如下
- fd:文件句柄。
- buffer:将读取的文件内容写到buffer里。
- offset:buffer开始写入的位置。(在offset开始写入,还是offset+1?)
- length:要读取的字节数。
- position:文件从哪个位置开始读取。如果是null,那么就从当前位置开始读取。(读取操作会记录下上一个位置)
此外,callback的回调参数为(err, bytesRead, buffer)
fs.read(fd, buffer, offset, length, position, callback)
追加文件内容
fs.appendFile(file, data[, options], callback)
- file:可以是文件路径,也可以是文件句柄。(还可以是buffer?)
- data:要追加的内容。string或者buffer。
- options
* encoding:编码,默认是`utf8`
* mode:默认是`0o666`
* flag:默认是`a`注意:如果file是文件句柄,那么
- 开始追加数据前,file需要已经打开。
- file需要手动关闭。
var fs = require('fs');

fs.appendFile('./extra/fileForAppend.txt', 'hello', 'utf8', function(err){
    if(err) throw err;
    console.log('append成功');
});
文件内容截取
fs.truncate(path, len, callback) fs.truncateSync(path, len) fs.ftruncate(fd, len, callback) fs.ftruncateSync(fd, len)
用途参考linux说明文档。
要点:
offset不会变化。比如通过fs.read()读取文件内容,就需要特别注意。- 如果
len小于文件内容长度,剩余文件内容部分会丢失;如果len大于文件内容长度,那么超出的部分,会用\0进行填充。 - 如果传的是文件路径,需要确保文件是可写的;如果传的是文件句柄,需要确保文件句柄已经打开并且可写入。
The truncate() and ftruncate() functions cause the regular file named
by path or referenced by fd to be truncated to a size of precisely length bytes.
If the file previously was larger than this size, the extra data is
lost. If the file previously was shorter, it is extended, and the extended part reads as null bytes ('\0').
The file offset is not changed.
With ftruncate(), the file must be open for writing; with truncate(), the file must be writable.
修改文件属性(时间)
- path/fd:文件路径/文件句柄
- atime:Access Time。上一次访问文件数据的时间。
- mtime:Modified Time。修改时间。
fs.utimes(path, atime, mtime, callback) fs.utimesSync(path, atime, mtime)
fs.futimes(fd, atime, mtime, callback) fs.futimesSync(fd, atime, mtime)
备注,在命令行下可以
- 通过
stat查看文件的状态信息,包括了上面的atime、mtime。 - 通过
touch修改这几个时间。
创建文件链接
fs.symlink(target, path[, type], callback) fs.symlinkSync(target, path[, type]) fs.link(srcpath, dstpath, callback) fs.linkSync(srcpath, dstpath)
link() creates a new link (also known as a hard link) to an existing file.
软链接、硬链接区别:参考 或者 [这个]。(http://www.cnblogs.com/itech/archive/2009/04/10/1433052.html)
- 硬链接:inode相同,多个别名。删除一个硬链接文件,不会影响其他有相同inode的文件。
- 软链接:有自己的inode,用户数据块存放指向文件的inode。
参考这里。
创建临时目录
fs.mkdtemp(prefix, callback) fs.mkdtempSync(prefix)
备忘:跟普通的随便找个目录,创建个随机名字的文件夹,有什么区别?
代码示例如下:
var fs = require('fs');

fs.mkdtemp('/tmp/', function(err, folder){
    if(err) throw err;
    console.log('创建临时目录: ' + folder);
});
输出如下:
/usr/local/bin/node mkdtemp.js
创建临时目录: /tmp/Cxw51O
找出软连接指向的真实路径
fs.readlink(path[, options], callback) fs.readlinkSync(path[, options])
如下面例子,创建了个软链接指向fileForReadLink.txt,通过fs.readlink()就可以找出原始的路径。
var fs = require('fs');
var randomFileName = './extra/fileForReadLink-' + String(Math.random()).slice(2, 6) + '.txt';

fs.symlinkSync('./extra/fileForReadLink.txt', randomFileName);
fs.readlink(randomFileName, 'utf8', function(err, linkString){
    if(err) throw err;
    console.log('链接文件内容: ' + linkString);
});类似终端下直接运行readlink。对于软链接文件,效果同上面代码。对于硬链接,没有输出。
➜  extra git:(master) ✗ readlink fileForReadLink-9827.txt
./extra/fileForReadLink.txt
➜  extra git:(master) ✗ readlink fileForLinkHard.txt
➜  extra git:(master) ✗ readlink fileForLinkSoft.txt
./extra/fileForLink.txt
真实路径
fs.realpath(path[, options], callback) fs.realpathSync(path[, options])
例子:(不能作用于软链接?)
var fs = require('fs');
var path = require('path');

// fileForRealPath1.txt 是普通文件,正常运行
fs.realpath('./extra/inner/fileForRealPath1.txt', function(err, resolvedPath){
    if(err) throw err;
    console.log('fs.realpath: ' + resolvedPath);
});

// fileForRealPath.txt 是软链接, 会报错,提示找不到文件
fs.realpath('./extra/inner/fileForRealPath.txt', function(err, resolvedPath){
    if(err) throw err;
    console.log('fs.realpath: ' + resolvedPath);
});

console.log( 'path.resolve: ' + path.resolve('./extra/inner/fileForRealpath.txt') );
输出如下:
path.resolve: /Users/a/Documents/git-code/git-blog/demo/2015.05.21-node-basic/fs/extra/inner/fileForRealpath.txt
fs.realpath: /Users/a/Documents/git-code/git-blog/demo/2015.05.21-node-basic/fs/extra/inner/fileForRealPath1.txt
/Users/a/Documents/git-code/git-blog/demo/2015.05.21-node-basic/fs/realpath.js:12
    if(err) throw err;
            ^

Error: ENOENT: no such file or directory, realpath './extra/inner/fileForRealPath.txt'
    at Error (native)

Process finished with exit code 1
删除目录
fs.rmdir(path, callback) fs.rmdirSync(path)
例子如下:
var fs = require('fs');

fs.rmdir('./dirForRemove', function(err){
    if(err) throw err;
    console.log('目录删除成功');
});
不常用
缓冲区内容写到磁盘
fs.fdatasync(fd, callback) fs.fdatasyncSync(fd)
可以参考这里:
1、sync函数
sync函数只是将所有修改过的块缓冲区排入写队列,然后就返回,它并不等待实际写磁盘操作结束。 通常称为update的系统守护进程会周期性地(一般每隔30秒)调用sync函数。这就保证了定期冲洗内核的块缓冲区。命令sync(1)也调用sync函数。 2、fsync函数 fsync函数只对由文件描述符filedes指定的单一文件起作用,并且等待写磁盘操作结束,然后返回。 fsync可用于数据库这样的应用程序,这种应用程序需要确保将修改过的块立即写到磁盘上。 3、fdatasync函数 fdatasync函数类似于fsync,但它只影响文件的数据部分。而除数据外,fsync还会同步更新文件的属性。 对于提供事务支持的数据库,在事务提交时,都要确保事务日志(包含该事务所有的修改操作以及一个提交记录)完全写到硬盘上,才认定事务提交成功并返回给应用层。
待确认
- 通篇的
mode,待确认。 - fs.access()更多用法(涉及 fs.constants.F_OK等权限)
dns
域名解析:dns.lookup()
比如我们要查询域名 www.qq.com 对应的ip,可以通过 dns.lookup() 。
var dns = require('dns');

dns.lookup('www.qq.com', function(err, address, family){
    if(err) throw err;
    console.log('例子A: ' + address);
});
输出如下:
例子A: 182.254.34.74我们知道,同一个域名,可能对应多个不同的ip。那么,如何获取一个域名对应的多个ip呢?可以这样。
var dns = require('dns');
var options = {all: true};

dns.lookup('www.qq.com', options, function(err, address, family){
    if(err) throw err;
    console.log('例子B: ' + address);
});
输出如下:
例子B: [{"address":"182.254.34.74","family":4},{"address":"240e:e1:8100:28::2:16","family":6}]域名解析:dns.resolve4()
上文的例子,也可以通过 dns.resolve4() 来实现。
var dns = require('dns');

dns.resolve4('id.qq.com', function(err, address){
    if(err) throw err;
    console.log( JSON.stringify(address) );
});
输出如下:
["61.151.186.39","101.227.139.179"]如果要获取IPv6的地址,接口也差不多,不赘述。
dns.lookup()跟dns.resolve4()的区别
从上面的例子来看,两个方法都可以查询域名的ip列表。那么,它们的区别在什么地方呢?
可能最大的差异就在于,当配置了本地Host时,是否会对查询结果产生影响。
- dns.lookup():有影响。
- dns.resolve4():没有影响。
举例,在hosts文件里配置了如下规则。
127.0.0.1 www.qq.com
运行如下对比示例子,就可以看到区别。
var dns = require('dns');

dns.lookup('www.qq.com', function(err, address, family){
    if(err) throw err;
    console.log('配置host后,dns.lokup =>' + address);
});

dns.resolve4('www.qq.com', function(err, address, family){
    if(err) throw err;
    console.log('配置host后,dns.resolve4 =>' + address);
});
输出如下
➜  2016.11.03-node-dns git:(master) ✗ node lookup-vs-resolve4.js
配置host后,dns.resolve4 =>182.254.34.74
配置host后,dns.lookup =>127.0.0.1
其他接口
对DNS有了解的同学,应该对A记录、NS记录、CNAME等不陌生,同样可以通过相应的API进行查询,感兴趣的可以自行尝试下。
相关链接
官方文档:https://nodejs.org/api/dns.html#dns_dns_resolve4_hostname_callback
http
http模块概览
大多数nodejs开发者都是冲着开发web server的目的选择了nodejs。正如官网所展示的,借助http模块,可以几行代码就搞定一个超迷你的web server。
在nodejs中,http可以说是最核心的模块,同时也是比较复杂的一个模块。上手很简单,但一旦深入学习,不少初学者就会觉得头疼,不知从何入手。
本文先从一个简单的例子出发,引出http模块最核心的四个实例。看完本文,应该就能够对http模块有个整体的认识。
一个简单的例子
在下面的例子中,我们创建了1个web服务器、1个http客户端
- 服务器server:接收来自客户端的请求,并将客户端请求的地址返回给客户端。
- 客户端client:向服务器发起请求,并将服务器返回的内容打印到控制台。
代码如下所示,只有几行,但包含了不少信息量。下一小节会进行简单介绍。
var http = require('http');

// http server 例子
var server = http.createServer(function(serverReq, serverRes){
    var url = serverReq.url;
    serverRes.end( '您访问的地址是:' + url );
});

server.listen(3000);

// http client 例子
var client = http.get('http://127.0.0.1:3000', function(clientRes){
    clientRes.pipe(process.stdout);
});
例子解释
在上面这个简单的例子里,涉及了4个实例。大部分时候,serverReq、serverRes 才是主角。
- server:http.Server实例,用来提供服务,处理客户端的请求。
- client:http.ClientReques实例,用来向服务端发起请求。
- serverReq/clientRes:其实都是 http.IncomingMessage实。serverReq 用来获取客户端请求的相关信息,如request header;而clientRes用来获取服务端返回的相关信息,比如response header。
- serverRes:http.ServerResponse实例
关于http.IncomingMessage、http.ServerResponse
先讲下 http.ServerResponse 实例。作用很明确,服务端通过http.ServerResponse 实例,来个请求方发送数据。包括发送响应表头,发送响应主体等。
接下来是 http.IncomingMessage 实例,由于在 server、client 都出现了,初学者难免有点迷茫。它的作用是
在server端:获取请求发送方的信息,比如请求方法、路径、传递的数据等。 在client端:获取 server 端发送过来的信息,比如请求方法、路径、传递的数据等。
http.IncomingMessage实例 有三个属性需要注意:method、statusCode、statusMessage。
- method:只在 server 端的实例有(也就是 serverReq.method)
- statusCode/statusMessage:只在 client 端 的实例有(也就是 clientRes.method)
关于继承与扩展
http.Server
- http.Server 继承了 net.Server (于是顺带需要学一下 net.Server 的API、属性、相关事件)
- net.createServer(fn),回调中的
socket是个双工的stream接口,也就是说,读取发送方信息、向发送方发送信息都靠他。
备注:socket的客户端、服务端是相对的概念,所以其实 net.Server 内部也是用了 net.Socket(不负责任猜想)
// 参考:https://cnodejs.org/topic/4fb1c1fd1975fe1e1310490b
var net = require('net');

var PORT = 8989;
var HOST = '127.0.0.1';

var server = net.createServer(function(socket){
    console.log('Connected: ' + socket.remoteAddress + ':' + socket.remotePort);

    socket.on('data', function(data){
        console.log('DATA ' + socket.remoteAddress + ': ' + data);
        console.log('Data is: ' + data);

        socket.write('Data from you is  "' + data + '"');
    });

    socket.on('close', function(){
         console.log('CLOSED: ' +
            socket.remoteAddress + ' ' + socket.remotePort);
    });
});
server.listen(PORT, HOST);

console.log(server instanceof net.Server);  // true
http.ClientRequest
http.ClientRequest 内部创建了一个socket来发起请求,代码如下。
当你调用 http.request(options) 时,内部是这样的
self.onSocket(net.createConnection(options));http.ServerResponse
- 实现了 Writable Stream interface,内部也是通过socket来发送信息。
http.IncomingMessage
- 实现了 Readable Stream interface,参考这里
- req.socket --> 获得跟这次连接相关的socket
http.req
概览
本文的重点会放在req这个对象上。前面已经提到,它其实是http.IncomingMessage实例,在服务端、客户端作用略微有差异
- 服务端处:获取请求方的相关信息,如request header等。
- 客户端处:获取响应方返回的相关信息,如statusCode等。
服务端例子:
// 下面的 req
var http = require('http');
var server = http.createServer(function(req, res){
    console.log(req.headers);
    res.end('ok');
});
server.listen(3000);
客户端例子
// 下面的res
var http = require('http');
http.get('http://127.0.0.1:3000', function(res){
    console.log(res.statusCode);
});
属性/方法/事件 分类
http.IncomingMessage的属性/方法/事件 不是特别多,按照是否客户端/服务端 特有的,下面进行简单归类。可以看到
- 服务端处特有:url
- 客户端处特有:statusCode、statusMessage
| 类型 | 名称 | 服务端 | 客户端 |
|---|---|---|---|
| 事件 | aborted | ✓ | ✓ |
| 事件 | close | ✓ | ✓ |
| 属性 | headers | ✓ | ✓ |
| 属性 | rawHeaders | ✓ | ✓ |
| 属性 | statusCode | ✕ | ✓ |
| 属性 | statusMessage | ✕ | ✓ |
| 属性 | httpVersion | ✓ | ✓ |
| 属性 | url | ✓ | ✕ |
| 属性 | socket | ✓ | ✓ |
| 方法 | .destroy() | ✓ | ✓ |
| 方法 | .setTimeout() | ✓ | ✓ |
服务端的例子
例子一:获取httpVersion/method/url
下面是一个典型的HTTP请求报文,里面最重要的内容包括:HTTP版本、请求方法、请求地址、请求头部。
GET /hello HTTP/1.1
Host: 127.0.0.1:3000
Connection: keep-alive
Cache-Control: no-cache
那么,如何获取上面提到的信息呢?很简单,直接上代码
// getClientInfo.js
var http = require('http');

var server = http.createServer(function(req, res){
    console.log( '1、客户端请求url:' + req.url );
    console.log( '2、http版本:' + req.httpVersion );
    console.log( '3、http请求方法:' + req.method );
    console.log( '4、http请求头部' + JSON.stringify(req.headers) );

    res.end('ok');
});

server.listen(3000);
效果如下:
1、客户端请求url:/hello
2、http版本:1.1
3、http请求方法:GET
4、http headers:{"host":"127.0.0.1:3000","connection":"keep-alive","cache-control":"no-cache","user-agent":"Mozilla/5.0 (Macintosh; Intel Mac OS X 10_11_4) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/54.0.2840.71 Safari/537.36","postman-token":"1148986a-ddfb-3569-e2c0-585634655fe4","accept":"*/*","accept-encoding":"gzip, deflate, sdch, br","accept-language":"zh-CN,zh;q=0.8,en;q=0.6,zh-TW;q=0.4"}
例子二:获取get请求参数
服务端代码如下:
// getClientGetQuery.js
var http = require('http');
var url = require('url');
var querystring = require('querystring');

var server = http.createServer(function(req, res){
    var urlObj = url.parse(req.url);
    var query = urlObj.query;
    var queryObj = querystring.parse(query);

    console.log( JSON.stringify(queryObj) );

    res.end('ok');
});

server.listen(3000);
访问地址 http://127.0.0.1:3000/hello?nick=chyingp&hello=world
服务端输出如下
{"nick":"chyingp","hello":"world"}例子三:获取post请求参数
服务端代码如下
// getClientPostBody.js
var http = require('http');
var url = require('url');
var querystring = require('querystring');

var server = http.createServer(function(req, res){

    var body = '';
    req.on('data', function(thunk){
        body += thunk;
    });

    req.on('end', function(){
        console.log( 'post body is: ' + body );
        res.end('ok');
    });
});

server.listen(3000);
通过curl构造post请求:
curl -d 'nick=casper&hello=world' http://127.0.0.1:3000服务端打印如下:
post body is: nick=casper&hello=world备注:post请求中,不同的Content-type,post body有不小差异,感兴趣的同学可以研究下。
本例中的post请求,HTTP报文大概如下
POST / HTTP/1.1
Host: 127.0.0.1:3000
Content-Type: application/x-www-form-urlencoded
Cache-Control: no-cache

nick=casper&hello=world
客户端处例子
例子一:获取httpVersion/statusCode/statusMessage
代码如下:
var http = require('http');
var server = http.createServer(function(req, res){
    res.writeHead(200, {'content-type': 'text/plain'});
    res.end('from server');
});
server.listen(3000);

var client = http.get('http://127.0.0.1:3000', function(res){
    console.log('1、http版本:' + res.httpVersion);
    console.log('2、返回状态码:' + res.statusCode);
    console.log('3、返回状态描述信息:' + res.statusMessage);
    console.log('4、返回正文:');

    res.pipe(process.stdout);
});
控制台输出:
1、http版本:1.1
2、返回状态码:200
3、返回状态描述信息:OK
4、返回正文:
from server
事件对比:aborted、close
官方文档对这两个事件的解释是:当客户端终止请求时,触发aborted事件;当客户端连接断开时,触发close事件;官方文档传送们:地址
解释得比较含糊,从实际实验对比上来看,跟官方文档有不小出入。此外,客户端处、服务端处的表现也是不同的。
服务端表现
根据实际测试结果来看,当客户端:
- abort请求时,服务端req的aborted、close事件都会触发;(诡异)
- 请求正常完成时,服务端req的close事件不会触发;(也很诡异)
直接扒了下nodejs的源代码,发现的确是同时触发的,触发场景:请求正常结束前,客户端abort请求。
测试代码如下:
var http = require('http');

var server = http.createServer(function(req, res){

    console.log('1、收到客户端请求: ' + req.url);

    req.on('aborted', function(){
        console.log('2、客户端请求aborted');
    });

    req.on('close', function(){
        console.log('3、客户端请求close');
    });

    // res.end('ok'); 故意不返回,等着客户端中断请求
});

server.listen(3000, function(){
    var client = http.get('http://127.0.0.1:3000/aborted');
    setTimeout(function(){
        client.abort();  // 故意延迟100ms,确保请求发出
    }, 100);
});


// 输出如下
// 1、收到客户端请求: /aborted
// 2、客户端请求aborted
// 3、客户端请求close
以下代码来自nodejs源码(_http_server.js)
  function abortIncoming() {
    while (incoming.length) {
      var req = incoming.shift();
      req.emit('aborted');
      req.emit('close');
    }
    // abort socket._httpMessage ?
}再来一波对比,req.on('close')和req.socket.on('close')。
// reqSocketClose.js
var http = require('http');

var server = http.createServer(function(req, res){

    console.log('server: 收到客户端请求');

    req.on('close', function(){
        console.log('server: req close');
    });

    req.socket.on('close', function(){
        console.log('server: req.socket close');
    });

    res.end('ok');
});

server.listen(3000);

var client = http.get('http://127.0.0.1:3000/aborted', function(res){
    console.log('client: 收到服务端响应');
});
输出如下,正儿八经的close事件触发了。
server: 收到客户端请求
server: req.socket close
client: 收到服务端响应
客户端表现
猜测客户端的aborted、close也是在类似场景下触发,测试代码如下。发现一个比较有意思的情况,res.pipe(process.stdout) 这行代码是否添加,会影响close是否触发。
- 没有
res.pipe(process.stdout):close不触发。 - 有
res.pipe(process.stdout):close触发。
var http = require('http');

var server = http.createServer(function(req, res){

    console.log('1、服务端:收到客户端请求');

    res.flushHeaders();
    res.setTimeout(100);    // 故意不返回,3000ms后超时
});


server.on('error', function(){});

server.listen(3000, function(){

    var client = http.get('http://127.0.0.1:3000/aborted', function(res){

        console.log('2、客户端:收到服务端响应');

        // res.pipe(process.stdout); 注意这行代码

        res.on('aborted', function(){
            console.log('3、客户端:aborted触发!');
        });

        res.on('close', function(){
            console.log('4、客户端:close触发!');
        });
    });
});
信息量略大的 .destroy()
经过前面aborted、close的摧残,本能的觉得 .destroy() 方法的表现会有很多惊喜之处。
测试代码如下:
var http = require('http');

var server = http.createServer(function(req, res){

    console.log('服务端:收到客户端请求');

    req.destroy(new Error('测试destroy'));

    req.on('error', function(error){
        console.log('服务端:req error: ' + error.message);
    });

    req.socket.on('error', function(error){
        console.log('服务端:req socket error: ' + error.message);
    })
});

server.on('error', function(error){
    console.log('服务端:server error: ' + error.message);
});

server.listen(3000, function(){

    var client = http.get('http://127.0.0.1:3000/aborted', function(res){
        // do nothing
    });

    client.on('error', function(error){
        console.log('客户端:client error触发!' + error.message);
    });
});
输出如下。根据 .destroy() 调用的时机不同,error 触发的对象不同。(测试过程比较枯燥,有时间再总结一下)
服务端:收到客户端请求
服务端:req socket error: 测试destroy
客户端:client error触发!socket hang up
不常用属性
- rawHeaders:未解析前的request header。
- trailers:在分块传输编码(chunk)中用到,表示trailer后的header可分块传输。(感兴趣的可以研究下)
- rawTrailers:
关于trailers属性:
The request/response trailers object. Only populated at the 'end' event.
写在后面
一个貌似很简单的对象,实际比想的要复杂一些。做了不少对比实验,也发现了一些好玩的东西,打算深入学习的同学可以自己多动手尝试一下 :)
TODO:
- 对close、aborted进行更深入对比
- 对.destroy()进行更深入对比
相关链接
官方文档: https://nodejs.org/api/http.html#http_class_http_incomingmessage
http.res
概览
http模块四剑客之一的res,应该都不陌生了。一个web服务程序,接受到来自客户端的http请求后,向客户端返回正确的响应内容,这就是res的职责。
返回的内容包括:状态代码/状态描述信息、响应头部、响应主体。下文会举几个简单的例子。
var http = require('http');
var server = http.createServer(function(req, res){
    res.end('ok');
});
server.listen(3000);
例子
在下面的例子中,我们同时设置了 状态代码/状态描述信息、响应头部、响应主体,就是这么简单。
var http = require('http');

// 设置状态码、状态描述信息、响应主体
var server = http.createServer(function(req, res){
    res.writeHead(200, 'ok', {
        'Content-Type': 'text/plain'
    });
    res.end('hello');
});

server.listen(3000);
设置状态代码、状态描述信息
res提供了 res.writeHead()、res.statusCode/res.statusMessage 来实现这个目的。
举例,如果想要设置 200/ok ,可以
res.writeHead(200, 'ok');也可以
res.statusCode = 200;
res.statusMessage = 'ok';
两者差不多,差异点在于
- res.writeHead() 可以提供额外的功能,比如设置响应头部。
- 当响应头部发送出去后,res.statusCode/res.statusMessage 会被设置成已发送出去的 状态代码/状态描述信息。
设置响应头部
res提供了 res.writeHead()、response.setHeader() 来实现响应头部的设置。
举例,比如想把 Content-Type 设置为 text-plain,那么可以
// 方法一
res.writeHead(200, 'ok', {
    'Content-Type': 'text-plain'
});

// 方法二
res.setHeader('Content-Type', 'text-plain');
两者的差异点在哪里呢?
- res.writeHead() 不单单是设置header。
- 已经通过 res.setHeader() 设置了header,当通过 res.writeHead() 设置同名header,res.writeHead() 的设置会覆盖之前的设置。
关于第2点差异,这里举个例子。下面代码,最终的 Content-Type 为 text/plain。
var http = require('http');

var server = http.createServer(function(req, res){
    res.setHeader('Content-Type', 'text/html');
    res.writeHead(200, 'ok', {
        'Content-Type': 'text/plain'
    });
    res.end('hello');
});

server.listen(3000);
而下面的例子,则直接报错。报错信息为 Error: Can't set headers after they are sent.。
var http = require('http');

var server = http.createServer(function(req, res){
    res.writeHead(200, 'ok', {
        'Content-Type': 'text/plain'
    });
    res.setHeader('Content-Type', 'text/html');
    res.end('hello');
});

server.listen(3000);
其他响应头部操作
增、删、改、查 是配套的。下面分别举例说明下,例子太简单就直接上代码了。
// 增
res.setHeader('Content-Type', 'text/plain');

// 删
res.removeHeader('Content-Type');

// 改
res.setHeader('Content-Type', 'text/plain');
res.setHeader('Content-Type', 'text/html');  // 覆盖

// 查
res.getHeader('content-type');
其中略显不同的是 res.getHeader(name),name 用的是小写,返回值没做特殊处理。
res.setHeader('Content-Type', 'TEXT/HTML');
console.log( res.getHeader('content-type') );  // TEXT/HTML

res.setHeader('Content-Type', 'text/plain');
console.log( res.getHeader('content-type') );  // text/plain
此外,还有不那么常用的:
- res.headersSent:header是否已经发送;
- res.sendDate:默认为true。但为true时,会在response header里自动设置Date首部。
设置响应主体
主要用到 res.write() 以及 res.end() 两个方法。
res.write() API的信息量略大,建议看下官方文档。
response.write(chunk[, encoding][, callback])
- chunk:响应主体的内容,可以是string,也可以是buffer。当为string时,encoding参数用来指明编码方式。(默认是utf8)
- encoding:编码方式,默认是 utf8。
- callback:当响应体flushed时触发。(TODO 这里想下更好的解释。。。)
使用上没什么难度,只是有些注意事项:
- 如果 res.write() 被调用时, res.writeHead() 还没被调用过,那么,就会把header flush出去。
- res.write() 可以被调用多次。
- 当 res.write(chunk) 第一次被调用时,node 会将 header 信息 以及 chunk 发送到客户端。第二次调用 res.write(chunk) ,node 会认为你是要streaming data(WTF,该怎么翻译)。。。
Returns true if the entire data was flushed successfully to the kernel buffer. Returns false if all or part of the data was queued in user memory. 'drain' will be emitted when the buffer is free again.
response.end([data][, encoding][, callback])
掌握了 res.write() 的话,res.end() 就很简单了。res.end() 的用处是告诉nodejs,header、body都给你了,这次响应就到这里吧。
有点像个语法糖,可以看成下面两个调用的组合。至于callback,当响应传递结束后触发。
res.write(data, encoding);
res.end()
chunk数据
参考这里:http://stackoverflow.com/questions/6258210/how-can-i-output-data-before-i-end-the-response
也就是说,除了nodejs的特性,还需要了解 HTTP协议、浏览器的具体实现。(细思极恐)
如果是 text/html
var http = require('http');

http.createServer(function(req, res) {
    res.setHeader('Content-Type', 'text/html; charset=utf-8');
    res.write('hello');

    setTimeout(function() {
        res.write(' world!');
        res.end();
    }, 2000);

}).listen(3000);
如果是 text/plain
var http = require('http');

http.createServer(function (req, res) {
    res.writeHead(200, {
        'Content-Type': 'text/plain; charset=utf-8',
        'X-Content-Type-Options': 'nosniff'
    });
    res.write('hello');

    setTimeout(function(){
        res.write('world');
        res.end()
    }, 2000);

}).listen(3000);
失败例子
var http = require('http');

var server = http.createServer(function(req, res){
    res.writeHead(200, 'ok', {
        'Content-Type': 'text/html'
    });
    res.write('hello');

    setTimeout(function(){
        res.write('world');
        res.end();
    }, 2000);
});

server.listen(3000);
超时处理
接口:response.setTimeout(msecs, callback)
关于 timeout 事件的说明,同样是言简意赅(WTF),话少信息量大,最好来个demo TODO
If no 'timeout' listener is added to the request, the response, or the server, then sockets are destroyed when they time out. If you assign a handler on the request, the response, or the server's 'timeout' events, then it is your responsibility to handle timed out sockets.
事件 close/finish
- close:response.end() 被调用前,连接就断开了。此时会触发这个事件。
- finish:响应header、body都已经发送出去(交给操作系统,排队等候传输),但客户端是否实际收到数据为止。(这个事件后,res 上就不会再有其他事件触发)
其他不常用属性/方法
- response.finished:一开始是false,响应结束后,设置为true。
- response.sendDate:默认是true。是否自动设置Date头部。(按HTTP协议是必须要的,除非是调试用,不然不要设置为false)
- response.headersSent:只读属性。响应头部是否已发送。
- response.writeContinue():发送 HTTP/1.1 100 Continue 消息给客户端,提示说服务端愿意接受客户端的请求,请继续发送请求正文(body)。(TODO 做个demo啥的是大大的好)
相关链接
How can I output data before I end the response? http://stackoverflow.com/questions/6258210/how-can-i-output-data-before-i-end-the-response
8.2.3 Use of the 100 (Continue) Status http://greenbytes.de/tech/webdav/rfc2616.html#use.of.the.100.status
http.client
ClientRequest概览
当你调用 http.request(options) 时,会返回 ClientRequest实例,主要用来创建HTTP客户端请求。
在前面的章节里,已经对http模块的的其他方面进行了不少介绍,如http.Server、http.ServerResponse、http.IncomingMessage。
有了前面的基础,详细本文不难理解,本文更多的以例子为主。
简单的GET请求
下面构造了个GET请求,访问 http://id.qq.com/ ,并将返回的网页内容打印在控制台下。
var http = require('http');
var options = {
    protocol: 'http:',
    hostname: 'id.qq.com',
    port: '80',
    path: '/',
    method: 'GET'
};

var client = http.request(options, function(res){
    var data = '';
    res.setEncoding('utf8');
    res.on('data', function(chunk){
        data += chunk;
    });
    res.on('end', function(){
        console.log(data);
    });
});

client.end();
当然,也可以用便捷方法 http.get(options) 进行重写
var http = require('http');

http.get('http://id.qq.com/', function(res){
    var data = '';
    res.setEncoding('utf8');
    res.on('data', function(chunk){
        data += chunk;
    });
    res.on('end', function(){
        console.log(data);
    });
});
简单的post请求
在下面例子中,首先创建了个http server,负责将客户端发送过来的数据回传。
接着,创建客户端POST请求,向服务端发送数据。需要注意的点有:
- method 指定为 POST。
- headers 里声明了 content-type 为 application/x-www-form-urlencoded。
- 数据发送前,用 querystring.stringify(obj) 对传输的对象进行了格式化。
var http = require('http');
var querystring = require('querystring');

var createClientPostRequest = function(){
    var options = {
        method: 'POST',
        protocol: 'http:',
        hostname: '127.0.0.1',
        port: '3000',
        path: '/post',
        headers: {
            "connection": "keep-alive",
            "content-type": "application/x-www-form-urlencoded"
        }
    };

    // 发送给服务端的数据
    var postBody = {
        nick: 'chyingp'
    };

    // 创建客户端请求
    var client = http.request(options, function(res){
        // 最终输出:Server got client data: nick=chyingp
        res.pipe(process.stdout);
    });

    // 发送的报文主体,记得先用 querystring.stringify() 处理下
    client.write( querystring.stringify(postBody) );
    client.end();
};

// 服务端程序,只是负责回传客户端数据
var server = http.createServer(function(req, res){
    res.write('Server got client data: ');
    req.pipe(res);
});

server.listen(3000, createClientPostRequest);
各种事件
在官方文档里,http.RequestClient相关的事件共有7个。跟HTTP协议密切相关的有3个,分别是 connect、continue、upgrade,其他4个分别是 abort、aborted、socket、response。
- 其他:abort、aborted、socket、response
- 与HTTP协议相关:connect、continue、upgrade
跟HTTP协议相关的会相对复杂些,因为涉及HTTP协议的设计细节。其他3个相对简单。下面分别进行简单的介绍。
response事件
最容易理解的一个,当收到来自服务端的响应时触发,其实跟 http.get(url, cbk) 中的回调是一样的,看下程序运行的打印信息就知道。
var http = require('http');

var url = 'http://id.qq.com/';

var client = http.get(url, function(res){
    console.log('1. response event');
});

client.on('response', function(res){
    console.log('2. response event');
});

client.end();
打印信息:
1. response event
2. response event
socket事件
当给client分配socket的时候触发,如果熟悉net模块对这个事件应该不陌生。大部分时候并不需要关注这个事件,虽然内部其实挺复杂的。
abort/aborted 事件
这两个事件看着非常像,都是请求中断时触发,差异在于中断的发起方:
- abort:客户端主动中断请求(第一次调用 client.abort() 时触发)
- aborted:服务端主动中断请求,且请求已经中断时触发。
continue事件
当收到服务端的响应 100 Continue 时触发。熟悉HTTP协议的同学应该对 100 Continue 有所了解。当客户端向服务端发送首部 Expect: 100-continue ,服务端经过一定的校验后,决定对客户端的后续请求放行,于是返回返回 100 Continue,知会客户端,可以继续发送数据。(request body)
upgrade事件
同样是跟HTTP协议密切相关。当客户端向客户端发起请求时,可以在请求首部里声明 'Connection': 'Upgrade' ,以此要求服务端,将当前连接升级到新的协议。如果服务器同意,那么就升级协议继续通信。这里不打算展开太多细节,直接上官方文档的代码
const http = require('http');

// Create an HTTP server
var srv = http.createServer( (req, res) => {
  res.writeHead(200, {'Content-Type': 'text/plain'});
  res.end('okay');
});
srv.on('upgrade', (req, socket, head) => {
  socket.write('HTTP/1.1 101 Web Socket Protocol Handshake\r\n' +
               'Upgrade: WebSocket\r\n' +
               'Connection: Upgrade\r\n' +
               '\r\n');

  socket.pipe(socket); // echo back
});

// now that server is running
srv.listen(1337, '127.0.0.1', () => {

  // make a request
  var options = {
    port: 1337,
    hostname: '127.0.0.1',
    headers: {
      'Connection': 'Upgrade',
      'Upgrade': 'websocket'
    }
  };

  var req = http.request(options);
  req.end();

  req.on('upgrade', (res, socket, upgradeHead) => {
    console.log('got upgraded!');
    socket.end();
    process.exit(0);
  });
});
其他
除了上面讲解到的属性、方法、事件外,还有下面方法没有讲到。并不是它们不重要,篇幅有限,后面再展开。
- client.abort():中断请求;
- client.setTimeout(timeout):请求超时设置;
- client.flushHeaders() 及早将请求首部发送出去;
- client.setSocketKeepAlive():当内部分配 socket 并连接上时,就会内部调用 socket.keepAlive();
- client.setNoDelay([noDelay]):当内部分配 socket 并连接上时,就会内部调用 socket.setNoDelay();
参考链接
upgrade机制: https://developer.mozilla.org/en-US/docs/Web/HTTP/Protocol_upgrade_mechanism
官方文档: https://nodejs.org/api/http.html#http_class_http_clientrequest
nodejs源码: https://github.com/nodejs/node/blob/master/lib/_http_client.js
http.server
http服务端概览
创建server
几行代码搞定
var http = require('http');
var requestListener = function(req, res){
    res.end('ok');
};
var server = http.createServer(requestListener);
// var server = new http.Server(requestListener); 跟上面是等价的
server.listen(3000);
获取请求方信息
HTTP版本、HTTP method、headers、url
var http = require('http');

var server = http.createServer(function(req, res){
    console.log('客户端请求url:' + req.url);
    console.log('http版本:' + req.httpVersion);
    console.log('http请求方法:' + req.method);

    res.end('ok');
});

server.listen(3000);
效果如下:
客户端请求url:/hello
http版本:1.1
http请求方法:GET
http headers:{"host":"127.0.0.1:3000","connection":"keep-alive","cache-control":"max-age=0","upgrade-insecure-requests":"1","user-agent":"Mozilla/5.0 (Macintosh; Intel Mac OS X 10_11_4) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/54.0.2840.71 Safari/537.36","accept":"text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,*/*;q=0.8","accept-encoding":"gzip, deflate, sdch, br","accept-language":"zh-CN,zh;q=0.8,en;q=0.6,zh-TW;q=0.4"}
获取get请求参数
var http = require('http');
var url = require('url');
var querystring = require('querystring');

var server = http.createServer(function(req, res){
    var urlObj = url.parse(req.url);
    var query = urlObj.query;
    var queryObj = querystring.parse(query);

    console.log( JSON.stringify(queryObj) );

    res.end('ok');
});

server.listen(3000);
运行如下命令
curl http://127.0.0.1:3000/hello\?nick\=chyingp\&hello\=world服务端输出如下
{"nick":"chyingp","hello":"world"}获取post请求参数
代码如下
var http = require('http');
var url = require('url');
var querystring = require('querystring');

var server = http.createServer(function(req, res){

    var body = '';
    req.on('data', function(thunk){
        body += thunk;
    });

    req.on('end', function(){
        console.log( 'post body is: ' + body );
        res.end('ok');
    });
});

server.listen(3000);
通过curl构造极简post请求
curl -d 'nick=casper&hello=world' http://127.0.0.1:3000服务端打印如下。注意,在post请求中,不同的Content-type,post body有不小差异,感兴趣的同学可以自己试下。
post body is: nick=casper&hello=world比如本例中的post请求,HTTP报文大概如下
POST / HTTP/1.1
Host: 127.0.0.1:3000
Content-Type: application/x-www-form-urlencoded
Cache-Control: no-cache

nick=casper&hello=world
枯燥的事件
首先,我们来看下有哪些事件
checkContinue、checkExpectation、clientError、close、connect、connection、request、upgrade
error
var http = require('http');
var PORT = 3000;
var noop = function(){};

var svr = http.createServer(noop);
var anotherSvr = http.createServer(noop);

anotherSvr.on('error', function(e){
    console.error('出错啦!' + e.message);
});

svr.listen(PORT, function(){
    anotherSvr.listen(PORT);
});
运行代码,输出如下
出错啦!listen EADDRINUSE :::3000connect vs connection
两者差别非常大,虽然字眼看着有点像。
- connect:当客户端的HTTP method为connect时触发。
- connection:当TCP连接建立时触发,大部分时候可以忽略这个事件(目测模块内部自己用到而已)。此外,可以通过 req.connection 来获取这个socket(从nodejs源码来看,req.socket、req.connection 都指向了这个socket)。此外,socket上的readable事件不会触发(具体原因请看模块内部实现,反正我是还没研究)
大部分时候都不会用到,除非你要开发HTTP代理。当客户端发起 connect 请求时触发(注意绕过了 requestListener)
var http = require('http');
var PORT = 3000;

var server = http.createServer(function(req, res){
    res.end('ok');
});

// 注意:发起connect请求的例子在 ./httpServerEventConnectClient.js 里
server.on('connect', function(req, socket, head){
    console.log('connect事件触发');
    socket.end();   // 反正我就只想举个例子,没打算正经处理。。。
});

server.listen(PORT);
request
当有新的连接到来时触发。那跟 connection 有什么区别呢?
好了,keep-alive闪亮登场!在持久化连接的情况下,多个 request 可能对应的是 一个 connection。
先来看下没有keep-alive的场景
var http = require('http');
var PORT = 3000;
var requestIndex = 0;
var connectionIndex = 0;

var server = http.createServer(function(req, res){
    res.end('ok');
});

server.on('request', function(req, res){
    requestIndex++;
    console.log('request event: 第'+ requestIndex +'个请求!');
});

server.on('connection', function(req, res){
    connectionIndex++;
    console.log('connection event: 第'+ connectionIndex +'个请求!');
});

server.listen(PORT);
通过curl连续发送3个请求,看下效果
for i in `seq 1 3`; do curl http://127.0.0.1:3000; done服务端输出如下
connection event: 第1个请求!
request event: 第1个请求!
connection event: 第2个请求!
request event: 第2个请求!
connection event: 第3个请求!
request event: 第3个请求!然后,再来看下有keep-alive的场景。用 postman 构造包含 keep-alive 的请求,最终的HTTP请求报文如下
GET / HTTP/1.1
Host: 127.0.0.1:3000
Connection: keep-alive
Cache-Control: no-cache
Postman-Token: 6027fda7-f936-d3ac-e54f-dafcbf5e58ff
连续发送3个请求,服务端打印日志如下
connection event: 第1个请求!
request event: 第1个请求!
request event: 第2个请求!
request event: 第3个请求!
不常用接口
server.close([callback]);
关闭服务器。其实就是 (new net.Server()).close(),停止接受新的连接。 已经连接上的请求会继续处理,当所有连接结束的时候,server 正式关闭,并抛出 close 事件。 一般提供了callback,就不用监听close; 监听了close,就不用添加callback。
其他server.listen()
其实除了 server.listen(PORT) 这种监听方式外,还有以下几种相对不那么常用的监听方式。用到的时候看看文档就行了。
server.listen(handle[, callback]):监听本地文件描述符(fd)(windows不支持),或者server,或者socket server.listen(path[, callback]):监听本地socket,创建一个 UNIX socket server 。 server.listen([port][, hostname][, backlog][, callback])
网络超时 server.setTimeout(msecs, callback)
设置网络连接的超时时间。当超过 msecs 没有响应时,网络就会自动断开。
如果传了 callback,那么当 timeout 发生时,就会将timeout的socket作为参数传给callback。
注意,一般情况下超时的socket会自动销毁。但当你传了callback后,你就需要手动end或者destroy这个socket。
不常用属性
server.listening:是否在监听连接 server.timeout:设置超时时间(毫秒),注意,修改这个值,只会对新建立的连接产生影响。此外,将timeout设置为0,就会禁用自动超时行为。(目测不推荐) server.maxHeadersCount:客户端最多传送的header数量,默认是1000,如果设置为0,则没有限制。(问题:如果超过1000怎么办??)
https
模块概览
这个模块的重要性,基本不用强调了。在网络安全问题日益严峻的今天,网站采用HTTPS是个必然的趋势。
在nodejs中,提供了 https 这个模块来完成 HTTPS 相关功能。从官方文档来看,跟 http 模块用法非常相似。
本文主要包含两部分:
- 通过客户端、服务端的例子,对https模块进行入门讲解。
- 如何访问安全证书不受信任的网站。(以 12306 为例子)
篇幅所限,本文无法对 HTTPS协议 及 相关技术体系 做过多讲解,有问题欢迎留言交流。
客户端例子
跟http模块的用法非常像,只不过请求的地址是https协议的而已,代码如下:
var https = require('https');

https.get('https://www.baidu.com', function(res){
    console.log('status code: ' + res.statusCode);
    console.log('headers: ' + JSON.stringify(res.headers));

    res.on('data', function(data){
        process.stdout.write(data);
    });
}).on('error', function(err){
    console.error(err);
});
服务端例子
对外提供HTTPS服务,需要有HTTPS证书。如果你已经有了HTTPS证书,那么可以跳过证书生成的环节。如果没有,可以参考如下步骤
生成证书
1、创建个目录存放证书。
mkdir cert
cd cert
2、生成私钥。
openssl genrsa -out chyingp-key.pem 20483、生成证书签名请求(csr是 Certificate Signing Request的意思)。
openssl req -new \
  -sha256
  -key chyingp-key.key.pem \
  -out chyingp-csr.pem \
  -subj "/C=CN/ST=Guandong/L=Shenzhen/O=YH Inc/CN=www.chyingp.com"
4、生成证书。
openssl x509 \
  -req -in chyingp-csr.pem \
  -signkey chyingp-key.pem \
  -out chyingp-cert.pem
HTTPS服务端
代码如下:
var https = require('https');
var fs = require('fs');

var options = {
    key: fs.readFileSync('./cert/chyingp-key.pem'), // 私钥
    cert: fs.readFileSync('./cert/chyingp-cert.pem') // 证书
};

var server = https.createServer(options, function(req, res){
    res.end('这是来自HTTPS服务器的返回');
});

server.listen(3000);
由于我并没有 www.chyingp.com 这个域名,于是先配置本地host
127.0.0.1 www.chyingp.com启动服务,并在浏览器里访问 http://www.chyingp.com:3000。注意,浏览器会提示你证书不可靠,点击 信任并继续访问 就行了。
进阶例子:访问安全证书不受信任的网站
这里以我们最喜爱的12306最为例子。当我们通过浏览器,访问12306的购票页面 https://kyfw.12306.cn/otn/regist/init 时,chrome会阻止我们访问,这是因为,12306的证书是自己颁发的,chrome无法确认他的安全性。
对这种情况,可以有如下处理方式:
- 停止访问:着急抢票回家过年的老乡表示无法接受。
- 无视安全警告,继续访问:大部分情况下,浏览器是会放行的,不过安全提示还在。
- 导入12306的CA根证书:浏览器乖乖就范,认为访问是安全的。(实际上还是有安全提示,因为12306用的签名算法安全级别不够)
例子:触发安全限制
同样的,通过 node https client 发起请求,也会遇到同样问题。我们做下实验,代码如下:
var https = require('https');

https.get('https://kyfw.12306.cn/otn/regist/init', function(res){
    res.on('data', function(data){
        process.stdout.write(data);
    });
}).on('error', function(err){
    console.error(err);
});
运行上面代码,得到下面的错误提示,意思是 安全证书不可靠,拒绝继续访问。
{ Error: self signed certificate in certificate chain
    at Error (native)
    at TLSSocket.<anonymous> (_tls_wrap.js:1055:38)
    at emitNone (events.js:86:13)
    at TLSSocket.emit (events.js:185:7)
    at TLSSocket._finishInit (_tls_wrap.js:580:8)
    at TLSWrap.ssl.onhandshakedone (_tls_wrap.js:412:38) code: 'SELF_SIGNED_CERT_IN_CHAIN' }
ps:个人认为这里的错误提示有点误导人,12306网站的证书并不是自签名的,只是对证书签名的CA是12306自家的,不在可信列表里而已。自签名证书,跟自己CA签名的证书还是不一样的。
类似在浏览器里访问,我们可以采取如下处理:
- 不建议:忽略安全警告,继续访问;
- 建议:将12306的CA加入受信列表;
方法1:忽略安全警告,继续访问
非常简单,将 rejectUnauthorized 设置为 false 就行,再次运行代码,就可以愉快的返回页面了。
// 例子:忽略安全警告
var https = require('https');

var options = {
    hostname: 'kyfw.12306.cn',
    path: '/otn/leftTicket/init',
    rejectUnauthorized: false  // 忽略安全警告
};

var req = https.get(options, function(res){
    res.pipe(process.stdout);
});

req.on('error', function(err){
    console.error(err.code);
});
方法2:将12306的CA加入受信列表
这里包含3个步骤:
- 下载 12306 的CA证书
- 将der格式的CA证书,转成pem格式
- 修改node https的配置
1、下载 12306 的CA证书
在12306的官网上,提供了CA证书的下载地址,将它保存到本地,命名为 srca.cer。
2、将der格式的CA证书,转成pem格式
https初始化client时,提供了 ca 这个配置项,可以将 12306 的CA证书添加进去。当你访问 12306 的网站时,client就会用ca配置项里的 ca 证书,对当前的证书进行校验,于是就校验通过了。
需要注意的是,ca 配置项只支持 pem 格式,而从12306官网下载的是der格式的。需要转换下格式才能用。关于 pem、der的区别,可参考 这里。
openssl x509 -in srca.cer -inform der -outform pem -out srca.cer.pem3、修改node https的配置
修改后的代码如下,现在可以愉快的访问12306了。
// 例子:将12306的CA证书,加入我们的信任列表里
var https = require('https');
var fs = require('fs');
var ca = fs.readFileSync('./srca.cer.pem');

var options = {
  hostname: 'kyfw.12306.cn',
  path: '/otn/leftTicket/init',
  ca: [ ca ]
};

var req = https.get(options, function(res){
  res.pipe(process.stdout);
});

req.on('error', function(err){
  console.error(err.code);
});
相关链接
Why is my node.js SSL connection failing to connect?
DER vs. CRT vs. CER vs. PEM Certificates and How To Convert Them
Painless Self Signed Certificates in node.js
自签名证书和私有CA签名的证书的区别 创建自签名证书 创建私有CA 证书类型 证书扩展名
那些证书相关的玩意儿(SSL,X.509,PEM,DER,CRT,CER,KEY,CSR,P12等)
net
模块概览
net模块是同样是nodejs的核心模块。在http模块概览里提到,http.Server继承了net.Server,此外,http客户端与http服务端的通信均依赖于socket(net.Socket)。也就是说,做node服务端编程,net基本是绕不开的一个模块。
从组成来看,net模块主要包含两部分,了解socket编程的同学应该比较熟悉了:
- net.Server:TCP server,内部通过socket来实现与客户端的通信。
- net.Socket:tcp/本地 socket的node版实现,它实现了全双工的stream接口。
本文从一个简单的 tcp服务端/客户端 的例子开始讲解,好让读者有个概要的认识。接着再分别介绍 net.Server、net.Socket 比较重要的API、属性、事件。
对于初学者,建议把文中的例子本地跑一遍加深理解。
简单的 server+client 例子
tcp服务端程序如下:
var net = require('net');

var PORT = 3000;
var HOST = '127.0.0.1';

// tcp服务端
var server = net.createServer(function(socket){
    console.log('服务端:收到来自客户端的请求');

    socket.on('data', function(data){
        console.log('服务端:收到客户端数据,内容为{'+ data +'}');

        // 给客户端返回数据
        socket.write('你好,我是服务端');
    });

    socket.on('close', function(){
         console.log('服务端:客户端连接断开');
    });
});
server.listen(PORT, HOST, function(){
    console.log('服务端:开始监听来自客户端的请求');
});
tcp客户端如下:
var net = require('net');

var PORT = 3000;
var HOST = '127.0.0.1';

// tcp客户端
var client = net.createConnection(PORT, HOST);

client.on('connect', function(){
    console.log('客户端:已经与服务端建立连接');
});

client.on('data', function(data){
    console.log('客户端:收到服务端数据,内容为{'+ data +'}');
});

client.on('close', function(data){
    console.log('客户端:连接断开');
});

client.end('你好,我是客户端');
运行服务端、客户端代码,控制台分别输出如下:
服务端:
服务端:开始监听来自客户端的请求
服务端:收到来自客户端的请求
服务端:收到客户端数据,内容为{你好,我是客户端}
服务端:客户端连接断开
客户端:
客户端:已经与服务端建立连接
客户端:收到服务端数据,内容为{你好,我是服务端}
客户端:连接断开
服务端 net.Server
server.address()
返回服务端的地址信息,比如绑定的ip地址、端口等。
console.log( server.address() );
// 输出如下 { port: 3000, family: 'IPv4', address: '127.0.0.1' }
server.close(callback])
关闭服务器,停止接收新的客户端请求。有几点注意事项:
- 对正在处理中的客户端请求,服务器会等待它们处理完(或超时),然后再正式关闭。
- 正常关闭的同时,callback 会被执行,同时会触发 close 事件。
- 异常关闭的同时,callback 也会执行,同时将对应的 error 作为参数传入。(比如还没调用 server.listen(port) 之前,就调用了server.close())
下面会通过两个具体的例子进行对比,先把结论列出来
- 已调用server.listen():正常关闭,close事件触发,然后callback执行,error参数为undefined
- 未调用server.listen():异常关闭,close事件触发,然后callback执行,error为具体的错误信息。(注意,error 事件没有触发)
例子1:服务端正常关闭
var net = require('net');
var PORT = 3000;
var HOST = '127.0.0.1';
var noop = function(){};

// tcp服务端
var server = net.createServer(noop);

server.listen(PORT, HOST, function(){

    server.close(function(error){
        if(error){
            console.log( 'close回调:服务端异常:' + error.message );
        }else{
            console.log( 'close回调:服务端正常关闭' );
        }
    });
});

server.on('close', function(){
    console.log( 'close事件:服务端关闭' );
});

server.on('error', function(error){
    console.log( 'error事件:服务端异常:' + error.message );
});
输出为:
close事件:服务端关闭
close回调:服务端正常关闭
例子2:服务端异常关闭
代码如下
var net = require('net');
var PORT = 3000;
var HOST = '127.0.0.1';
var noop = function(){};

// tcp服务端
var server = net.createServer(noop);

// 没有正式启动请求监听
// server.listen(PORT, HOST);

server.on('close', function(){
    console.log( 'close事件:服务端关闭' );
});

server.on('error', function(error){
    console.log( 'error事件:服务端异常:' + error.message );
});

server.close(function(error){
    if(error){
        console.log( 'close回调:服务端异常:' + error.message );
    }else{
        console.log( 'close回调:服务端正常关闭' );
    }
});
输出为:
close事件:服务端关闭
close回调:服务端异常:Not running
server.ref()/server.unref()
了解node事件循环的同学对这两个API应该不陌生,主要用于将server 加入事件循环/从事件循环里面剔除,影响就在于会不会影响进程的退出。
对出学习net的同学来说,并不需要特别关注,感兴趣的自己做下实验就好。
事件 listening/connection/close/error
- listening:调用 server.listen(),正式开始监听请求的时候触发。
- connection:当有新的请求进来时触发,参数为请求相关的 socket。
- close:服务端关闭的时候触发。
- error:服务出错的时候触发,比如监听了已经被占用的端口。
几个事件都比较简单,这里仅举个 connection 的例子。
从测试结果可以看出,有新的客户端连接产生时,net.createServer(callback) 中的callback回调 会被调用,同时 connection 事件注册的回调函数也会被调用。
事实上,net.createServer(callback) 中的 callback 在node内部实现中 也是加入了做为 connection事件 的监听函数。感兴趣的可以看下node的源码。
var net = require('net');
var PORT = 3000;
var HOST = '127.0.0.1';
var noop = function(){};

// tcp服务端
var server = net.createServer(function(socket){
    socket.write('1. connection 触发\n');
});

server.on('connection', function(socket){
    socket.end('2. connection 触发\n');
});

server.listen(PORT, HOST);
通过下面命令测试下效果
curl http://127.0.0.1:3000输出:
1. connection 触发
2. connection 触发
客户端 net.Socket
在文章开头已经举过客户端的例子,这里再把例子贴一下。(备注:严格来说不应该把 net.Socket 叫做客户端,这里方便讲解而已)
单从node官方文档来看的话,感觉 net.Socket 比 net.Server 要复杂很多,有更多的API、事件、属性。但实际上,把 net.Socket 相关的API、事件、属性 进行归类下,会发现,其实也不是特别复杂。
具体请看下一小节内容。
var net = require('net');

var PORT = 3000;
var HOST = '127.0.0.1';

// tcp客户端
var client = net.createConnection(PORT, HOST);

client.on('connect', function(){
    console.log('客户端:已经与服务端建立连接');
});

client.on('data', function(data){
    console.log('客户端:收到服务端数据,内容为{'+ data +'}');
});

client.on('close', function(data){
    console.log('客户端:连接断开');
});

client.end('你好,我是客户端');
API、属性归类
以下对net.Socket的API跟属性,按照用途进行了大致的分类,方便读者更好的理解。大部分API跟属性都比较简单,看下文档就知道做什么的,这里就先不展开。
连接相关
- socket.connect():有3种不同的参数,用于不同的场景;
- socket.setTimeout():用来进行连接超时设置。
- socket.setKeepAlive():用来设置长连接。
- socket.destroy()、socket.destroyed:当错误发生时,用来销毁socket,确保这个socket上不会再有其他的IO操作。
数据读、写相关
socket.write()、socket.end()、socket.pause()、socket.resume()、socket.setEncoding()、socket.setNoDelay()
数据属性相关
socket.bufferSize、socket.bytesRead、socket.bytesWritten
事件循环相关
socket.ref()、socket.unref()
地址相关
- socket.address()
- socket.remoteAddress、socket.remoteFamily、socket.remotePort
- socket.localAddress/socket.localPort
事件简介
- data:当收到另一侧传来的数据时触发。
- connect:当连接建立时触发。
- close:连接断开时触发。如果是因为传输错误导致的连接断开,则参数为error。
- end:当连接另一侧发送了 FIN 包的时候触发(读者可以回顾下HTTP如何断开连接的)。默认情况下(allowHalfOpen == false),socket会完成自我销毁操作。但你也可以把 allowHalfOpen 设置为 true,这样就可以继续往socket里写数据。当然,最后你需要手动调用 socket.end()
- error:当有错误发生时,就会触发,参数为error。(官方文档基本一句话带过,不过考虑到出错的可能太多,也可以理解)
- timeout:提示用户,socket 已经超时,需要手动关闭连接。
- drain:当写缓存空了的时候触发。(不是很好描述,具体可以看下stream的介绍)
- lookup:域名解析完成时触发。
相关链接
官方文档: https://nodejs.org/api/net.html#net_socket_destroy_exception
url
模块概述
nodejs中,提供了url这个非常实用的模块,用来做URL的解析。在做node服务端的开发时会经常用到。使用很简单,总共只有3个方法。
正式讲解前,各位同学先把下面这个图记在心上(来自nodejs官网),先对URL有一个直观的认识。
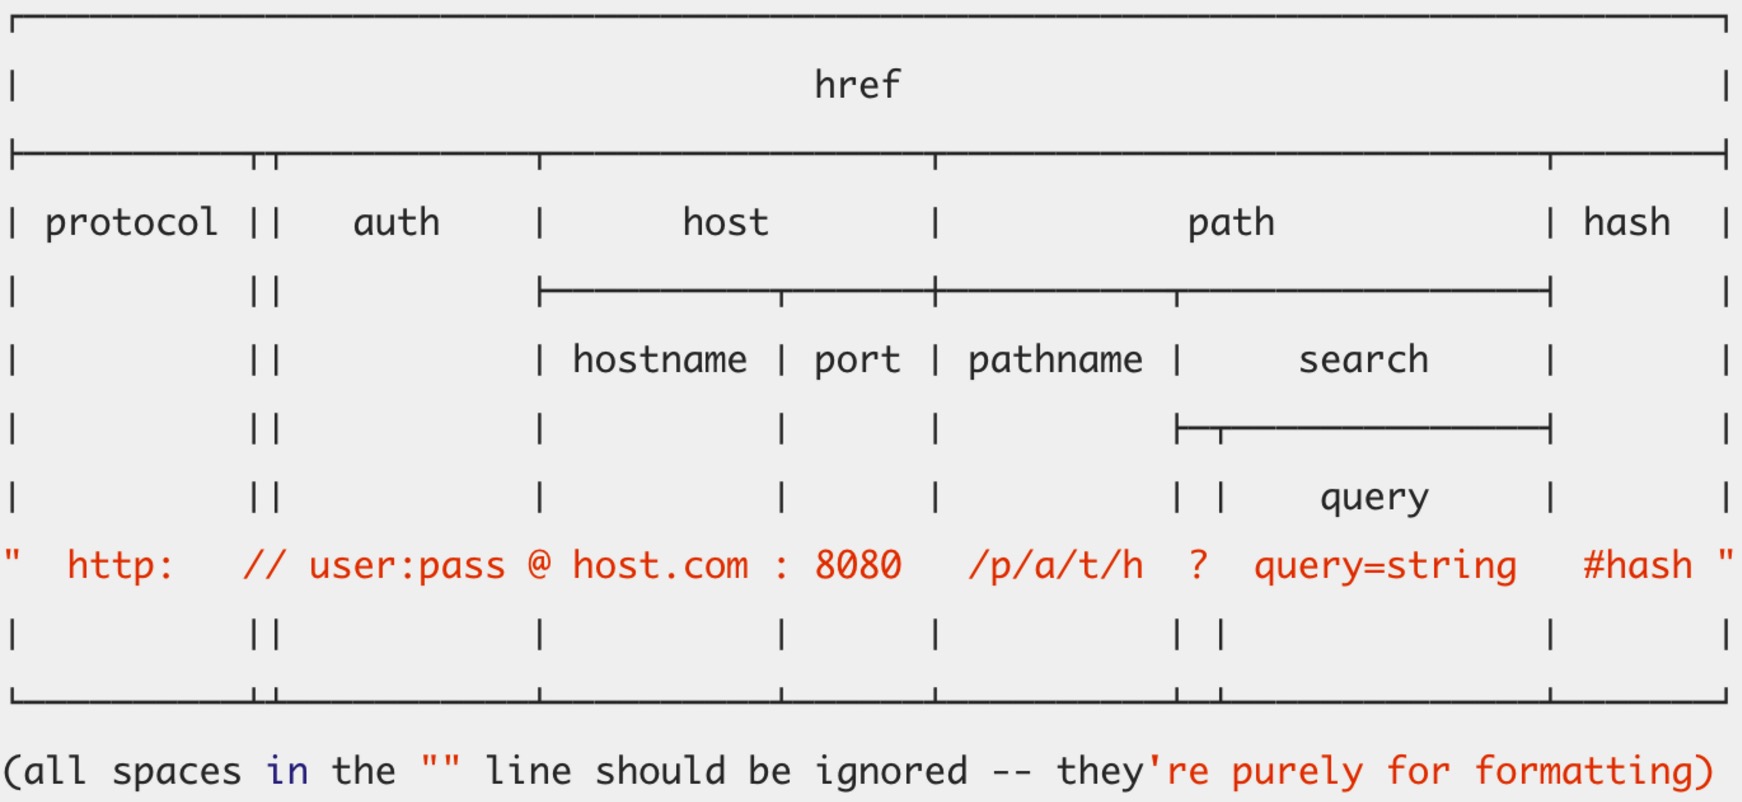
模块方法概述
url模块三个方法分别是:
- .parse\(urlString\):将url字符串,解析成object,便于开发者进行操作。
- .format\(urlObj\):.parse\(\) 方法的反向操作。
- .resove\(from, to\):以from作为起始地址,解析出完整的目标地址(还是看直接看例子好些)
url解析:url.parse\(\)
完整语法:url.parse\(urlString\[, parseQueryString\[, slashesDenoteHost\]\]\)
使用比较简单,几个要点备忘如下。
- parseQueryString:(默认为false)如为false,则
urlObject.query为未解析的字符串,比如nick=%E7%A8%8B%E5%BA%8F%E7%8C%BF%E5%B0%8F%E5%8D%A1,且对应的值不会decode;如果parseQueryString为true,则urlObject.query为object,比如{ nick: '程序猿小卡' },且值会被decode; - slashesDenoteHos:(默认为false)如果为true,那么类似
//foo/bar里的foo就会被认为是hostname;如果为false,则foo被认为是pathname的一部分。 - 关于解析得到的 urlObject ,会在下一小节进行详细介绍。
例子1:参数值不进行解析
代码如下:
var url = require('url');
var str = 'http://Chyingp:HelloWorld@ke.qq.com:8080/index.html?nick=%E7%A8%8B%E5%BA%8F%E7%8C%BF%E5%B0%8F%E5%8D%A1#part=1';

var obj = url.parse(str);
console.log(obj);
输出如下:
Url {
  protocol: 'http:',
  slashes: true,
  auth: 'Chyingp:HelloWorld',
  host: 'ke.qq.com:8080',
  port: '8080',
  hostname: 'ke.qq.com',
  hash: '#part=1',
  search: '?nick=%E7%A8%8B%E5%BA%8F%E7%8C%BF%E5%B0%8F%E5%8D%A1',
  query: 'nick=%E7%A8%8B%E5%BA%8F%E7%8C%BF%E5%B0%8F%E5%8D%A1',
  pathname: '/index.html',
  path: '/index.html?nick=%E7%A8%8B%E5%BA%8F%E7%8C%BF%E5%B0%8F%E5%8D%A1',
  href: 'http://Chyingp:HelloWorld@ke.qq.com:8080/index.html?nick=%E7%A8%8B%E5%BA%8F%E7%8C%BF%E5%B0%8F%E5%8D%A1#part=1' }
例子2:对参数值进行decode
代码如下:
var url = require('url');
var str = 'http://Chyingp:HelloWorld@ke.qq.com:8080/index.html?nick=%E7%A8%8B%E5%BA%8F%E7%8C%BF%E5%B0%8F%E5%8D%A1#part=1';

var obj = url.parse(str, true);
console.log(obj);输出如下,对比上面的例子会发现,query 字段被解析成了object,并且decode过。
Url {
  protocol: 'http:',
  slashes: true,
  auth: 'Chyingp:HelloWorld',
  host: 'ke.qq.com:8080',
  port: '8080',
  hostname: 'ke.qq.com',
  hash: '#part=1',
  search: '?nick=%E7%A8%8B%E5%BA%8F%E7%8C%BF%E5%B0%8F%E5%8D%A1',
  query: { nick: '程序猿小卡' },
  pathname: '/index.html',
  path: '/index.html?nick=%E7%A8%8B%E5%BA%8F%E7%8C%BF%E5%B0%8F%E5%8D%A1',
  href: 'http://Chyingp:HelloWorld@ke.qq.com:8080/index.html?nick=%E7%A8%8B%E5%BA%8F%E7%8C%BF%E5%B0%8F%E5%8D%A1#part=1' }
例子3:针对路径 \/\/foo\/bar 的处理
代码如下:
var url = require('url');
var str = '//foo/bar';

var obj = url.parse(str, true, false);
console.log(obj);

obj = url.parse(str, true, true);
console.log(obj);
输出如下,自行对比两者之间的差异:
Url {
  protocol: null,
  slashes: null,
  auth: null,
  host: null,
  port: null,
  hostname: null,
  hash: null,
  search: '',
  query: {},
  pathname: '//foo/bar',
  path: '//foo/bar',
  href: '//foo/bar' }
Url {
  protocol: null,
  slashes: true,
  auth: null,
  host: 'foo',
  port: null,
  hostname: 'foo',
  hash: null,
  search: '',
  query: {},
  pathname: '/bar',
  path: '/bar',
  href: '//foo/bar' }
关于urlObject
以上面的作为例子,粗略讲解下urlObject。更多细节可参考官方文档。
- protocol:协议,需要注意的是包含了
:,并且是小写的。 - slashes:如果
:后面跟了两个//,那么为true。 - auth:认证信息,如果有密码,为
usrname:passwd,如果没有,则为usrname。注意,这里区分大小写。 - host:主机名。注意包含了端口,比如
ke.qq.com:8080,并且是小写的。 - hostname:主机名,不包含端口,并且是小写的。
- hash:哈希部分,注意包含了
#。 - search:查询字符串,注意,包含了
?,此外,值是没有经过decode的。 - query:字符串 或者 对象。如果是字符串,则是
search去掉?,其余一样;如果是对象,那么是decode过的。 - path:路径部分,包含search部分。
- pathname:路径部分,不包含search部分。
- href:原始的地址。不过需要注意的是,
protocol、host会被转成小写字母。
{
  protocol: 'http:',
  slashes: true,
  auth: 'Chyingp:HelloWorld',
  host: 'ke.qq.com:8080',
  port: '8080',
  hostname: 'ke.qq.com',
  hash: '#part=1',
  search: '?nick=%E7%A8%8B%E5%BA%8F%E7%8C%BF%E5%B0%8F%E5%8D%A1',
  query: { nick: '程序猿小卡' },
  pathname: '/index.html',
  path: '/index.html?nick=%E7%A8%8B%E5%BA%8F%E7%8C%BF%E5%B0%8F%E5%8D%A1',
  href: 'http://Chyingp:HelloWorld@ke.qq.com:8080/index.html?nick=%E7%A8%8B%E5%BA%8F%E7%8C%BF%E5%B0%8F%E5%8D%A1#part=1' }
url拼接:url.format\(urlObject\)
完整语法:url.format\(urlObject\)
url.parse(str)的反向操作,没什么好说的。urlObject包含了很多字段,比如protocol、slashes、protocol等,且不一定需要全部传,所以有一套解析逻辑。
过程比较冗长,大部分时候不需要用到,直接贴官方文档的链接,有需要再看。
url.resolve\(from, to\)
用法比较简单,直接贴官方文档的例子
url.resolve('/one/two/three', 'four')         // '/one/two/four'
url.resolve('http://example.com/', '/one')    // 'http://example.com/one'
url.resolve('http://example.com/one', '/two') // 'http://example.com/two'
非法字符转义
url字符如果有下面的字符会被转义(非法字符)
< > " \` \r \n \t { } \| \ ^ '
相关链接
官方文档:https:\/\/nodejs.org\/api\/url.html\#url\_url
crypto
写在前面
本章节写得差不多了,不过还需要再整理一下(TODO)。
hash例子
hash.digest([encoding]):计算摘要。encoding可以是hex、latin1或者base64。如果声明了encoding,那么返回字符串。否则,返回Buffer实例。注意,调用hash.digest()后,hash对象就作废了,再次调用就会出错。
hash.update(data[, input_encoding]):input_encoding可以是utf8、ascii或者latin1。如果data是字符串,且没有指定 input_encoding,则默认是utf8。注意,hash.update()方法可以调用多次。
var crypto = require('crypto');
var fs = require('fs');

var content = fs.readFileSync('./test.txt', {encoding: 'utf8'});
var hash = crypto.createHash('sha256');
var output;

hash.update(content);

output = hash.digest('hex');

console.log(output);
// 输出内容为:
// b94d27b9934d3e08a52e52d7da7dabfac484efe37a5380ee9088f7ace2efcde9
也可以这样:
var crypto = require('crypto');
var fs = require('fs');

var input = fs.createReadStream('./test.txt', {encoding: 'utf8'});
var hash = crypto.createHash('sha256');

hash.setEncoding('hex');

input.pipe(hash).pipe(process.stdout)

// 输出内容为:
// b94d27b9934d3e08a52e52d7da7dabfac484efe37a5380ee9088f7ace2efcde9
hash.digest()后,再次调用digest()或者update()
var crypto = require('crypto');
var fs = require('fs');

var content = fs.readFileSync('./test.txt', {encoding: 'utf8'});
var hash = crypto.createHash('sha256');
var output;

hash.update(content);
hash.digest('hex');

// 报错:Error: Digest already called
hash.update(content);

// 报错:Error: Digest already called
hash.digest('hex');
HMAC例子
HMAC的全称是Hash-based Message Authentication Code,也即在hash的加盐运算。
算法细节可以参考附录链接,具体到使用的话,跟hash模块差不多,选定hash算法,指定“盐”即可。
例子1:
var crypto = require('crypto');
var fs = require('fs');

var secret = 'secret';
var hmac = crypto.createHmac('sha256', secret);
var input = fs.readFileSync('./test.txt', {encoding: 'utf8'});

hmac.update(input);

console.log( hmac.digest('hex') );
// 输出:
// 734cc62f32841568f45715aeb9f4d7891324e6d948e4c6c60c0621cdac48623a
例子2:
var crypto = require('crypto');
var fs = require('fs');

var secret = 'secret';
var hmac = crypto.createHmac('sha256', secret);
var input = fs.createReadStream('./test.txt', {encoding: 'utf8'});

hmac.setEncoding('hex');

input.pipe(hmac).pipe(process.stdout)
// 输出:
// 734cc62f32841568f45715aeb9f4d7891324e6d948e4c6c60c0621cdac48623a
加密/解密
加解密主要用到下面两组方法:
加密:
- crypto.createCipher(algorithm, password)
- crypto.createCipheriv(algorithm, key, iv)
解密:
- crypto.createDecipher(algorithm, password)
- crypto.createDecipheriv(algorithm, key, iv)
crypto.createCipher(algorithm, password)
先来看下 crypto.createCipher(algorithm, password),两个参数分别是加密算法、密码
- algorithm:加密算法,比如
aes192,具体有哪些可选的算法,依赖于本地openssl的版本,可以通过openssl list-cipher-algorithms命令查看支持哪些算法。 - password:用来生成密钥(key)、初始化向量(IV)。
备注:这里nodejs屏蔽了AES的使用/实现细节,关于key、IV,感兴趣的同学可以自行谷歌下。
var crypto = require('crypto');
var secret = 'secret';

var cipher = crypto.createCipher('aes192', secret);
var content = 'hello';
var cryptedContent;

cipher.update(content);
cryptedContent = cipher.final('hex');
console.log(cryptedContent);
// 输出:
// 71d30ec9bc926b5dbbd5150bf9d3e5fb
crypto.createDecipher(algorithm, password)
可以看作 crypto.createCipher(algorithm, password) 逆向操作,直接看例子
var crypto = require('crypto');
var secret = 'secret';

var cipher = crypto.createCipher('aes192', secret);
var content = 'hello';
var cryptedContent;

cipher.update(content);
cryptedContent = cipher.final('hex');
console.log(cryptedContent);
// 输出:
// 71d30ec9bc926b5dbbd5150bf9d3e5fb

var decipher = crypto.createDecipher('aes192', secret);
var decryptedContent;

decipher.update(cryptedContent, 'hex');
decryptedContent = decipher.final('utf8');
console.log(decryptedContent);
// 输出:
// hello
crypto.createCipheriv(algorithm, key, iv)
相对于 crypto.createCipher() 来说,crypto.createCipheriv() 需要提供key和iv,而 crypto.createCipher() 是根据用户提供的 password 算出来的。
key、iv 可以是Buffer,也可以是utf8编码的字符串,这里需要关注的是它们的长度:
- key:根据选择的算法有关,比如 aes128、aes192、aes256,长度分别是128、192、256位(16、24、32字节)
- iv:都是128位(16字节)
var crypto = require('crypto');
var key = crypto.randomBytes(192/8);
var iv = crypto.randomBytes(128/8);
var algorithm = 'aes192';

function encrypt(text){
    var cipher = crypto.createCipheriv(algorithm, key, iv);
    cipher.update(text);
    return cipher.final('hex');
}

function decrypt(encrypted){
    var decipher = crypto.createDecipheriv(algorithm, key, iv);
    decipher.update(encrypted, 'hex');
    return decipher.final('utf8');
}

var content = 'hello';
var crypted = encrypt('hello');
console.log( crypted );

var decrypted = decrypt( crypted );
console.log( decrypted );  // 输出:utf8
数字签名/签名校验
假设:
1、服务端原始信息为M,摘要算法为Hash,Hash(M)得出的摘要是H。 2、公钥为Pub,私钥为Piv,非对称加密算法为Encrypt,非对称解密算法为Decrypt。 3、Encrypt(H)得到的结果是S。 4、客户端拿到的信息为M1,利用Hash(M1)得出的结果是H1。
数字签名的产生、校验步骤分别如下:
1、数字签名的产生步骤:利用摘要算法Hash算出M的摘要,即Hash(M) == H,利用非对称加密算法对摘要进行加密Encrypt( H, Piv ),得到数字签名S。 2、数字签名的校验步骤:利用解密算法D对数字签名进行解密,即Decrypt(S) == H,计算M1的摘要 Hash(M1) == H1,对比 H、H1,如果两者相同,则通过校验。
私钥如何生成不是这里的重点,这里采用网上的服务来生成,点击[这里](在线生成非对称加密公钥私钥对、在线生成公私钥对、RSA Key pair create、生成RSA密钥对)。
了解了数字签名产生、校验的原理后,相信下面的代码很容易理解:
var crypto = require('crypto');
var fs = require('fs');
var privateKey = fs.readFileSync('./private-key.pem');  // 私钥
var publicKey = fs.readFileSync('./public-key.pem');  // 公钥
var algorithm = 'RSA-SHA256';  // 加密算法 vs 摘要算法

// 数字签名
function sign(text){
    var sign = crypto.createSign(algorithm);
    sign.update(text);
    return sign.sign(privateKey, 'hex');
}

// 校验签名
function verify(oriContent, signature){
    var verifier = crypto.createVerify(algorithm);
    verifier.update(oriContent);
    return verifier.verify(publicKey, signature, 'hex');
}

// 对内容进行签名
var content = 'hello world';
var signature = sign(content);
console.log(signature);

// 校验签名,如果通过,返回true
var verified = verify(content, signature);
console.log(verified);
DiffieHellman
DiffieHellman:Diffie–Hellman key exchange,缩写为D-H,是一种安全协议,让通信双方在预先没有对方信息的情况下,通过不安全通信信道,创建一个密钥。这个密钥可以在后续的通信中,作为对称加密的密钥加密传递的信息。
代码如下,原理待补充 TODO
const crypto = require('crypto');
const assert = require('assert');

// Generate Alice's keys...
const alice = crypto.createDiffieHellman(2048);
const alice_key = alice.generateKeys();

// Generate Bob's keys...
const bob = crypto.createDiffieHellman(alice.getPrime(), alice.getGenerator());
const bob_key = bob.generateKeys();

// Exchange and generate the secret...
const alice_secret = alice.computeSecret(bob_key);
const bob_secret = bob.computeSecret(alice_key);

// OK
assert.equal(alice_secret.toString('hex'), bob_secret.toString('hex'));
ECDH:Elliptic Curve Diffie-Hellman
代码如下,原理待补充 TODO
const crypto = require('crypto');
const assert = require('assert');

// Generate Alice's keys...
const alice = crypto.createECDH('secp521r1');
const alice_key = alice.generateKeys();

// Generate Bob's keys...
const bob = crypto.createECDH('secp521r1');
const bob_key = bob.generateKeys();

// Exchange and generate the secret...
const alice_secret = alice.computeSecret(bob_key);
const bob_secret = bob.computeSecret(alice_key);

assert(alice_secret, bob_secret);
  // OK
证书
SPKAC:
SPKAC is an acronym that stands for Signed Public Key and Challenge, also known as Netscape SPKI.
SPKI:Simple public-key infrastructure
关键点
md5:固定长度(128bit)、不可逆(重要)、不同数据的散列值可能相同(重要)、高度离散型(原文细微的变化,会导致散列值差异巨大)
sha1:固定长度160bit,广泛使用(如TLS,目前安全性受到密码学家的质疑)
SHA-256/SHA-384/SHA-512:后面表示摘要的长度。
用途:数字签名、文件完整性校验
关系:sha1 基于 MD5,MD5 基于 MD4
md5(1991) -> SHA1
sha家族:由美国国家安全局(NSA)所设计,并由美国国家标准与技术研究院(NIST)发布;是美国的政府标准。
相关术语
SPKAC:Signed Public Key and Challenge
MD5:Message-Digest Algorithm 5,信息-摘要算法。
SHA:Secure Hash Algorithm,安全散列算法。
HMAC:Hash-based Message Authentication Code,密钥相关的哈希运算消息认证码。
SPKAC:
对称加密:比如AES、DES
非对称加密:比如RSA、DSA
AES:Advanced Encryption Standard(高级加密标准),密钥长度可以是128、192和256位。
DES:Data Encryption Standard,数据加密标准,对称密钥加密算法(现在认为不安全)。https://en.wikipedia.org/wiki/Data_Encryption_Standard
DiffieHellman:Diffie–Hellman key exchange,缩写为D-H,是一种安全协议,让通信双方在预先没有对方信息的情况下,通过不安全通信信道,创建一个密钥。这个密钥可以在后续的通信中,作为对称加密的密钥加密传递的信息。(备注,使是用协议的发明者命名)
相关链接
字符编码笔记:ASCII,Unicode和UTF-8 - 阮一峰的网络日志 http://www.ruanyifeng.com/blog/2007/10/ascii_unicode_and_utf-8.html
Unicode与JavaScript详解 http://www.ruanyifeng.com/blog/2014/12/unicode.html
Base64笔记 http://www.ruanyifeng.com/blog/2008/06/base64.html
MIME笔记 http://www.ruanyifeng.com/blog/2008/06/mime.html
SHA家族 https://zh.wikipedia.org/wiki/SHA%E5%AE%B6%E6%97%8F
加盐密码哈希:如何正确使用 http://blog.jobbole.com/61872/
HMAC-MD5算法原理及实现 http://www.jianshu.com/p/067f9eb6b252
Encrypting using AES-256, can I use 256 bits IV? http://security.stackexchange.com/questions/90848/encrypting-using-aes-256-can-i-use-256-bits-iv
分组对称加密模式:ECB/CBC/CFB/OFB http://blog.csdn.net/aaaaatiger/article/details/2525561
在线生成非对称加密公钥私钥对、在线生成公私钥对、RSA Key pair create、生成RSA密钥对 http://web.chacuo.net/netrsakeypair
Diffie–Hellman key exchange https://zh.wikipedia.org/wiki/%E8%BF%AA%E8%8F%B2-%E8%B5%AB%E7%88%BE%E6%9B%BC%E5%AF%86%E9%91%B0%E4%BA%A4%E6%8F%9B
理解 Deffie-Hellman 密钥交换算法 http://wsfdl.com/algorithm/2016/02/04/%E7%90%86%E8%A7%A3Diffie-Hellman%E5%AF%86%E9%92%A5%E4%BA%A4%E6%8D%A2%E7%AE%97%E6%B3%95.html
What is the difference between DHE and ECDH? http://stackoverflow.com/questions/2701294/how-does-the-elliptic-curve-version-of-diffie-hellman-cryptography-work?rq=1
Example application for working with SPKAC (signed public key & challege) data coming from the
Using Padding in Encryption http://www.di-mgt.com.au/cryptopad.html#randompadding
对称加密和分组加密中的四种模式(ECB、CBC、CFB、OFB) http://www.cnblogs.com/happyhippy/archive/2006/12/23/601353.html
为什么说密文链接模式已经丧失安全性? https://www.zhihu.com/question/26437065
Elliptic Curve Cryptography: a gentle introduction http://andrea.corbellini.name/2015/05/17/elliptic-curve-cryptography-a-gentle-introduction/
Elliptic Curve Cryptography: ECDH and ECDSA http://andrea.corbellini.name/2015/05/30/elliptic-curve-cryptography-ecdh-and-ecdsa/
为什么RSA公钥每次加密得到的结果都不一样? http://blog.csdn.net/guyongqiangx/article/details/74930951
querystring
模块概述
在nodejs中,提供了querystring这个模块,用来做url查询参数的解析,使用非常简单。
模块总共有四个方法,绝大部分时,我们只会用到 .parse()、 .stringify()两个方法。剩余的方法,感兴趣的同学可自行查看文档。
- .parse():对url查询参数(字符串)进行解析,生成易于分析的json格式。
- .stringif():跟.parse()相反,用于拼接查询查询。
querystring.parse(str[, sep[, eq[, options]]])
querystring.stringify(obj[, sep[, eq[, options]]])
查询参数解析:querystring.parse()
参数:querystring.parse(str[, sep[, eq[, options]]])
第四个参数几乎不会用到,直接不讨论. 第二个, 第三个其实也很少用到,但某些时候还是可以用一下。直接看例子
var querystring = require('querystring');
var str = 'nick=casper&age=24';
var obj = querystring.parse(str);
console.log(JSON.stringify(obj, null, 4));
输出如下
{
    "nick": "casper",
    "age": "24"
}再来看下sep、eq有什么作用。相当于可以替换&、=为自定义字符,对于下面的场景来说还是挺省事的。
var str1 = 'nick=casper&age=24&extra=name-chyingp|country-cn';
var obj1 = querystring.parse(str1);
var obj2 = querystring.parse(obj1.extra, '|', '-');
console.log(JSON.stringify(obj2, null, 4));
输出如下
{
    "name": "chyingp",
    "country": "cn"
}
查询参数拼接:querystring.stringify()
querystring.stringify(obj[, sep[, eq[, options]]])
没什么好说的,相当于parse的逆向操作。直接看代码
var querystring = require('querystring');

var obj1 = {
    "nick": "casper",
    "age": "24"
};
var str1 = querystring.stringify(obj1);
console.log(str1);

var obj2 = {
    "name": "chyingp",
    "country": "cn"
};
var str2 = querystring.stringify(obj2, '|', '-');
console.log(str2);
输出如下
nick=casper&age=24
name-chyingp|country-cn
相关链接
官方文档:https://nodejs.org/api/querystring.html
buffer
模块概览
Buffer是node的核心模块,开发者可以利用它来处理二进制数据,比如文件流的读写、网络请求数据的处理等。
Buffer的API非常多,本文仅挑选 比较常用/容易理解 的API进行讲解,包括Buffer实例的创建、比较、连接、拷贝、查找、遍历、类型转换、截取、编码转换等。
创建
- new Buffer(array)
- Buffer.alloc(length)
- Buffer.allocUnsafe(length)
- Buffer.from(array)
通过 new Buffer(array)
// Creates a new Buffer containing the ASCII bytes of the string 'buffer'
const buf = new Buffer([0x62, 0x75, 0x66, 0x66, 0x65, 0x72]);
验证下:
var array = 'buffer'.split('').map(function(v){
    return '0x' + v.charCodeAt(0).toString(16)
});

console.log( array.join() );
// 输出:0x62,0x75,0x66,0x66,0x65,0x72
通过 Buffer.alloc(length)
var buf1 = Buffer.alloc(10);  // 长度为10的buffer,初始值为0x0
var buf2 = Buffer.alloc(10, 1);  // 长度为10的buffer,初始值为0x1
var buf3 = Buffer.allocUnsafe(10); // 长度为10的buffer,初始值不确定var buf4 = Buffer.from([1, 2, 3]) // 长度为3的buffer,初始值为 0x01, 0x02, 0x03通过Buffer.from()
例子一:Buffer.from(array)
// [0x62, 0x75, 0x66, 0x66, 0x65, 0x72] 为字符串 "buffer"
// 0x62 为16进制,转成十进制就是 98,代表的就是字母 b
var buf = Buffer.from([0x62, 0x75, 0x66, 0x66, 0x65, 0x72]);
console.log(buf.toString());
例子二:Buffer.from(string[, encoding])
通过string创建buffer,跟将buffer转成字符串时,记得编码保持一致,不然会出现乱码,如下所示。
var buf = Buffer.from('this is a tést');  // 默认采用utf8

// 输出:this is a tést
console.log(buf.toString());  // 默认编码是utf8,所以正常打印

// 输出:this is a tC)st
console.log(buf.toString('ascii'));  // 转成字符串时,编码不是utf8,所以乱码
对乱码的分析如下:
var letter = 'é';
var buff = Buffer.from(letter);  // 默认编码是utf8,这里占据两个字节 <Buffer c3 a9>
var len = buff.length;  // 2
var code = buff[0]; // 第一个字节为0xc3,即195:超出ascii的最大支持范围
var binary = code.toString(2);  // 195的二进制:10101001
var finalBinary = binary.slice(1);  // 将高位的1舍弃,变成:0101001
var finalCode = parseInt(finalBinary, 2);  // 0101001 对应的十进制:67
var finalLetter = String.fromCharCode(finalCode);  // 67对应的字符:C

// 同理 0xa9最终转成的ascii字符为)
// 所以,最终输出为 this is a tC)st
例子三:Buffer.from(buffer)
创建新的Buffer实例,并将buffer的数据拷贝到新的实例子中去。
var buff = Buffer.from('buffer');
var buff2 = Buffer.from(buff);

console.log(buff.toString());  // 输出:buffer
console.log(buff2.toString());  // 输出:buffer

buff2[0] = 0x61;

console.log(buff.toString());  // 输出:buffer
console.log(buff2.toString());  // 输出:auffer
buffer比较
buf.equals(otherBuffer)
判断两个buffer实例存储的数据是否相同,如果是,返回true,否则返回false。
// 例子一:编码一样,内容相同
var buf1 = Buffer.from('A');
var buf2 = Buffer.from('A');

console.log( buf1.equals(buf2) );  // true

// 例子二:编码一样,内容不同
var buf3 = Buffer.from('A');
var buf4 = Buffer.from('B');

console.log( buf3.equals(buf4) );  // false

// 例子三:编码不一样,内容相同
var buf5 = Buffer.from('ABC');  // <Buffer 41 42 43>
var buf6 = Buffer.from('414243', 'hex');

console.log(buf5.equals(buf6));    //true

//只要比较的两者内容相同,`buf.equals(otherBuffer)` 就返回true
buf.compare(target[, targetStart[, targetEnd[, sourceStart[, sourceEnd]]]])
同样是对两个buffer实例进行比较,不同的是:
- 可以指定特定比较的范围(通过start、end指定)
- 返回值为整数,达标buf、target的大小关系
假设返回值为
0:buf、target大小相同。1:buf大于target,也就是说buf应该排在target之后。-1:buf小于target,也就是说buf应该排在target之前。
看例子,官方的例子挺好的,直接贴一下:
const buf1 = Buffer.from('ABC');
const buf2 = Buffer.from('BCD');
const buf3 = Buffer.from('ABCD');

// Prints: 0
console.log(buf1.compare(buf1));

// Prints: -1
console.log(buf1.compare(buf2));

// Prints: -1
console.log(buf1.compare(buf3));

// Prints: 1
console.log(buf2.compare(buf1));

// Prints: 1
console.log(buf2.compare(buf3));

// Prints: [ <Buffer 41 42 43>, <Buffer 41 42 43 44>, <Buffer 42 43 44> ]
// (This result is equal to: [buf1, buf3, buf2])
console.log([buf1, buf2, buf3].sort(Buffer.compare));
Buffer.compare(buf1, buf2)
跟 buf.compare(target) 大同小异,一般用于排序。直接贴官方例子:
const buf1 = Buffer.from('1234');
const buf2 = Buffer.from('0123');
const arr = [buf1, buf2];

// Prints: [ <Buffer 30 31 32 33>, <Buffer 31 32 33 34> ]
// (This result is equal to: [buf2, buf1])
console.log(arr.sort(Buffer.compare));
从Buffer.from([62])谈起
这里稍微研究下Buffer.from(array)。下面是官方文档对API的说明,也就是说,每个array的元素对应1个字节(8位),取值从0到255。
Allocates a new Buffer using an array of octets.
数组元素为数字
首先看下,传入的元素为数字的场景。下面分别是10进制、8进制、16进制,跟预期中的结果一致。
var buff = Buffer.from([62])
// <Buffer 3e>
// buff[0] === parseInt('3e', 16) === 62
var buff = Buffer.from([062])
// <Buffer 32>
// buff[0] === parseInt(62, 8) === parseInt(32, 16) === 50var buff = Buffer.from([0x62])
// <Buffer 62>
// buff[0] === parseInt(62, 16) === 98数组元素为字符串
再看下,传入的元素为字符串的场景。
0开头的字符串,在parseInt('062')时,可以解释为62,也可以解释为50(八进制),这里看到采用了第一种解释。- 字符串的场景,跟parseInt()有没有关系,暂未深入探究,只是这样猜想。TODO(找时间研究下)
var buff = Buffer.from(['62'])
// <Buffer 3e>
// buff[0] === parseInt('3e', 16) === parseInt('62') === 62
var buff = Buffer.from(['062'])
// <Buffer 3e>
// buff[0] === parseInt('3e', 16) === parseInt('062') === 62var buff = Buffer.from(['0x62'])
// <Buffer 62>
// buff[0] === parseInt('62', 16) === parseInt('0x62') === 98数组元素大小超出1个字节
感兴趣的同学自行探究。
var buff = Buffer.from([256])
// <Buffer 00>
Buffer.from('1')
一开始不自觉的会将Buffer.from('1')[0]跟"1"划等号,其实"1"对应的编码是49。
var buff = Buffer.from('1')  // <Buffer 31>
console.log(buff[0] === 1)  // false
这样对比就知道了,编码为1的是个控制字符,表示 Start of Heading。
console.log( String.fromCharCode(49) )  // '1'
console.log( String.fromCharCode(1) )  // '\u0001'
buffer连接:Buffer.concat(list[, totalLength])
备注:个人觉得totalLength这个参数挺多余的,从官方文档来看,是处于性能提升的角度考虑。不过内部实现也只是遍历list,将length累加得到totalLength,从这点来看,性能优化是几乎可以忽略不计的。
var buff1 = Buffer.alloc(10);
var buff2 = Buffer.alloc(20);

var totalLength = buff1.length + buff2.length;

console.log(totalLength);  // 30

var buff3 = Buffer.concat([buff1, buff2], totalLength);

console.log(buff3.length);  // 30
除了上面提到的性能优化,totalLength还有两点需要注意。假设list里面所有buffer的长度累加和为length
- totalLength > length:返回长度为totalLength的Buffer实例,超出长度的部分填充0。
- totalLength < length:返回长度为totalLength的Buffer实例,后面部分舍弃。
var buff4 = Buffer.from([1, 2]);
var buff5 = Buffer.from([3, 4]);

var buff6 = Buffer.concat([buff4, buff5], 5);

console.log(buff6.length);  //
console.log(buff6);  // <Buffer 01 02 03 04 00>

var buff7 = Buffer.concat([buff4, buff5], 3);

console.log(buff7.length);  // 3
console.log(buff7);  // <Buffer 01 02 03>
拷贝:buf.copy(target[, targetStart[, sourceStart[, sourceEnd]]])
使用比较简单,如果忽略后面三个参数,那就是将buf的数据拷贝到target里去,如下所示:
var buff1 = Buffer.from([1, 2]);
var buff2 = Buffer.alloc(2);

buff1.copy(buff2);

console.log(buff2);  // <Buffer 01 02>
另外三个参数比较直观,直接看官方例子
const buf1 = Buffer.allocUnsafe(26);
const buf2 = Buffer.allocUnsafe(26).fill('!');

for (let i = 0 ; i < 26 ; i++) {
  // 97 is the decimal ASCII value for 'a'
  buf1[i] = i + 97;
}

buf1.copy(buf2, 8, 16, 20);

// Prints: !!!!!!!!qrst!!!!!!!!!!!!!
console.log(buf2.toString('ascii', 0, 25));
查找:buf.indexOf(value[, byteOffset][, encoding])
跟数组的查找差不多,需要注意的是,value可能是String、Buffer、Integer中的任意类型。
- String:如果是字符串,那么encoding就是其对应的编码,默认是utf8。
- Buffer:如果是Buffer实例,那么会将value中的完整数据,跟buf进行对比。
- Integer:如果是数字,那么value会被当做无符号的8位整数,取值范围是0到255。
另外,可以通过byteOffset来指定起始查找位置。
直接上代码,官方例子妥妥的,耐心看完它基本就理解得差不多了。
const buf = Buffer.from('this is a buffer');

// Prints: 0
console.log(buf.indexOf('this'));

// Prints: 2
console.log(buf.indexOf('is'));

// Prints: 8
console.log(buf.indexOf(Buffer.from('a buffer')));

// Prints: 8
// (97 is the decimal ASCII value for 'a')
console.log(buf.indexOf(97));

// Prints: -1
console.log(buf.indexOf(Buffer.from('a buffer example')));

// Prints: 8
console.log(buf.indexOf(Buffer.from('a buffer example').slice(0, 8)));


const utf16Buffer = Buffer.from('\u039a\u0391\u03a3\u03a3\u0395', 'ucs2');

// Prints: 4
console.log(utf16Buffer.indexOf('\u03a3', 0, 'ucs2'));

// Prints: 6
console.log(utf16Buffer.indexOf('\u03a3', -4, 'ucs2'));
写:buf.write(string[, offset[, length]][, encoding])
将sring写入buf实例,同时返回写入的字节数。
参数如下:
- string:写入的字符串。
- offset:从buf的第几位开始写入,默认是0。
- length:写入多少个字节,默认是 buf.length - offset。
- encoding:字符串的编码,默认是utf8。
看个简单例子
var buff = Buffer.alloc(4);
buff.write('a');  // 返回 1
console.log(buff);  // 打印 <Buffer 61 00 00 00>

buff.write('ab');  // 返回 2
console.log(buff);  // 打印 <Buffer 61 62 00 00>
填充:buf.fill(value[, offset[, end]][, encoding])
用value填充buf,常用于初始化buf。参数说明如下:
- value:用来填充的内容,可以是Buffer、String或Integer。
- offset:从第几位开始填充,默认是0。
- end:停止填充的位置,默认是 buf.length。
- encoding:如果
value是String,那么为value的编码,默认是utf8。
例子:
var buff = Buffer.alloc(20).fill('a');

console.log(buff.toString());  // aaaaaaaaaaaaaaaaaaaa
转成字符串: buf.toString([encoding[, start[, end]]])
把buf解码成字符串,用法比较直观,看例子
var buff = Buffer.from('hello');

console.log( buff.toString() );  // hello

console.log( buff.toString('utf8', 0, 2) );  // he
转成JSON字符串:buf.toJSON()
var buff = Buffer.from('hello');

console.log( buff.toJSON() );  // { type: 'Buffer', data: [ 104, 101, 108, 108, 111 ] }
遍历:buf.values()、buf.keys()、buf.entries()
用于对buf进行for...of遍历,直接看例子。
var buff = Buffer.from('abcde');

for(const key of buff.keys()){
    console.log('key is %d', key);
}
// key is 0
// key is 1
// key is 2
// key is 3
// key is 4

for(const value of buff.values()){
    console.log('value is %d', value);
}
// value is 97
// value is 98
// value is 99
// value is 100
// value is 101

for(const pair of buff.entries()){
    console.log('buff[%d] === %d', pair[0], pair[1]);
}
// buff[0] === 97
// buff[1] === 98
// buff[2] === 99
// buff[3] === 100
// buff[4] === 101
截取:buf.slice([start[, end]])
用于截取buf,并返回一个新的Buffer实例。需要注意的是,这里返回的Buffer实例,指向的仍然是buf的内存地址,所以对新Buffer实例的修改,也会影响到buf。
var buff1 = Buffer.from('abcde');
console.log(buff1);  // <Buffer 61 62 63 64 65>

var buff2 = buff1.slice();
console.log(buff2);  // <Buffer 61 62 63 64 65>

var buff3 = buff1.slice(1, 3);
console.log(buff3);  // <Buffer 62 63>

buff3[0] = 97;  // parseInt(61, 16) ==> 97
console.log(buff1);  // <Buffer 62 63>
TODO
- 创建、拷贝、截取、转换、查找
- buffer、arraybuffer、dataview、typedarray
- buffer vs 编码
- Buffer.from()、Buffer.alloc()、Buffer.alocUnsafe()
- Buffer vs TypedArray
文档摘要
关于buffer内存空间的动态分配
Instances of the Buffer class are similar to arrays of integers but correspond to fixed-sized, raw memory allocations outside the V8 heap. The size of the Buffer is established when it is created and cannot be resized.
相关链接
unicode对照表 https://unicode-table.com/cn/#control-character
字符编码笔记:ASCII,Unicode和UTF-8 http://www.ruanyifeng.com/blog/2007/10/ascii_unicode_and_utf-8.html