
| 算法 | 操作系统 | 网络 | 面向对象 | 数据库 | Java | 系统设计 | 工具 | 编码实践 | 后记 |
|---|---|---|---|---|---|---|---|---|---|
| :pencil2: | :computer: | :cloud: | :art: | :floppy_disk: | :coffee: | :bulb: | :wrench: | :watermelon: | :memo: |
:pencil2: 算法
:computer: 操作系统
:cloud: 网络
:floppy_disk: 数据库
:coffee: Java
:bulb: 系统设计
:art: 面向对象
:wrench: 工具
:watermelon: 编码实践
:memo: 后记
排版
笔记内容按照 中文文案排版指北 进行排版,以保证内容的可读性。
不使用 ![]() 这种方式来引用图片,而是用 <img> 标签。一方面是为了能够控制图片以合适的大小显示,另一方面是因为 GFM 不支持 <center> ![]() </center> 这种方法让图片居中显示,只能使用 <div align="center"> <img src=""/> </div> 达到居中的效果。
在线排版工具:Text-Typesetting。
License
本仓库的内容不是将网上的资料随意拼凑而来,除了少部分引用书上和技术文档的原文(这部分内容都在末尾的参考链接中加了出处),其余都是我的原创。在您引用本仓库内容或者对内容进行修改演绎时,请署名并以相同方式共享,谢谢。
转载文章请在开头明显处标明该页面地址,公众号等其它转载请联系 zhengyc101@163.com。
Logo:logomakr

致谢
感谢以下人员对本仓库做出的贡献,当然不仅仅只有这些贡献者,这里就不一一列举了。如果你希望被添加到这个名单中,并且提交过 Issue 或者 PR,请与我联系。






Linux
Linux
* [前言](#前言)
* [一、常用操作以及概念](#一常用操作以及概念)
    * [快捷键](#快捷键)
    * [求助](#求助)
    * [关机](#关机)
    * [PATH](#path)
    * [sudo](#sudo)
    * [包管理工具](#包管理工具)
    * [发行版](#发行版)
    * [VIM 三个模式](#vim-三个模式)
    * [GNU](#gnu)
    * [开源协议](#开源协议)
* [二、磁盘](#二磁盘)
    * [磁盘接口](#磁盘接口)
    * [磁盘的文件名](#磁盘的文件名)
* [三、分区](#三分区)
    * [分区表](#分区表)
    * [开机检测程序](#开机检测程序)
* [四、文件系统](#四文件系统)
    * [分区与文件系统](#分区与文件系统)
    * [组成](#组成)
    * [文件读取](#文件读取)
    * [磁盘碎片](#磁盘碎片)
    * [block](#block)
    * [inode](#inode)
    * [目录](#目录)
    * [日志](#日志)
    * [挂载](#挂载)
    * [目录配置](#目录配置)
* [五、文件](#五文件)
    * [文件属性](#文件属性)
    * [文件与目录的基本操作](#文件与目录的基本操作)
    * [修改权限](#修改权限)
    * [默认权限](#默认权限)
    * [目录的权限](#目录的权限)
    * [链接](#链接)
    * [获取文件内容](#获取文件内容)
    * [指令与文件搜索](#指令与文件搜索)
* [六、压缩与打包](#六压缩与打包)
    * [压缩文件名](#压缩文件名)
    * [压缩指令](#压缩指令)
    * [打包](#打包)
* [七、Bash](#七bash)
    * [特性](#特性)
    * [变量操作](#变量操作)
    * [指令搜索顺序](#指令搜索顺序)
    * [数据流重定向](#数据流重定向)
* [八、管道指令](#八管道指令)
    * [提取指令](#提取指令)
    * [排序指令](#排序指令)
    * [双向输出重定向](#双向输出重定向)
    * [字符转换指令](#字符转换指令)
    * [分区指令](#分区指令)
* [九、正则表达式](#九正则表达式)
    * [grep](#grep)
    * [printf](#printf)
    * [awk](#awk)
* [十、进程管理](#十进程管理)
    * [查看进程](#查看进程)
    * [进程状态](#进程状态)
    * [SIGCHLD](#sigchld)
    * [wait()](#wait)
    * [waitpid()](#waitpid)
    * [孤儿进程](#孤儿进程)
    * [僵尸进程](#僵尸进程)
* [参考资料](#参考资料)
前言
为了便于理解,本文从常用操作和概念开始讲起。虽然已经尽量做到简化,但是涉及到的内容还是有点多。在面试中,Linux 知识点相对于网络和操作系统等知识点而言不是那么重要,只需要重点掌握一些原理和命令即可。为了方便大家准备面试,在此先将一些比较重要的知识点列出来:
- 能简单使用 cat,grep,cut 等命令进行一些操作;
- 文件系统相关的原理,inode 和 block 等概念,数据恢复;
- 硬链接与软链接;
- 进程管理相关,僵尸进程与孤儿进程,SIGCHLD 。
一、常用操作以及概念
快捷键
- Tab:命令和文件名补全;
- Ctrl+C:中断正在运行的程序;
- Ctrl+D:结束键盘输入(End Of File,EOF)
求助
1. --help
指令的基本用法与选项介绍。
2. man
man 是 manual 的缩写,将指令的具体信息显示出来。
当执行 man date 时,有 DATE(1) 出现,其中的数字代表指令的类型,常用的数字及其类型如下:
| 代号 | 类型 |
|---|---|
| 1 | 用户在 shell 环境中可以操作的指令或者可执行文件 |
| 5 | 配置文件 |
| 8 | 系统管理员可以使用的管理指令 |
3. info
info 与 man 类似,但是 info 将文档分成一个个页面,每个页面可以跳转。
4. doc
/usr/share/doc 存放着软件的一整套说明文件。
关机
1. who
在关机前需要先使用 who 命令查看有没有其它用户在线。
2. sync
为了加快对磁盘文件的读写速度,位于内存中的文件数据不会立即同步到磁盘,因此关机之前需要先进行 sync 同步操作。
3. shutdown
## shutdown [-krhc] 时间 [信息]
-k : 不会关机,只是发送警告信息,通知所有在线的用户
-r : 将系统的服务停掉后就重新启动
-h : 将系统的服务停掉后就立即关机
-c : 取消已经在进行的 shutdown
PATH
可以在环境变量 PATH 中声明可执行文件的路径,路径之间用 : 分隔。
/usr/local/bin:/usr/bin:/usr/local/sbin:/usr/sbin:/home/dmtsai/.local/bin:/home/dmtsai/binsudo
sudo 允许一般用户使用 root 可执行的命令,不过只有在 /etc/sudoers 配置文件中添加的用户才能使用该指令。
包管理工具
RPM 和 DPKG 为最常见的两类软件包管理工具:
- RPM 全称为 Redhat Package Manager,最早由 Red Hat 公司制定实施,随后被 GNU 开源操作系统接受并成为许多 Linux 系统的既定软件标准。YUM 基于 RPM,具有依赖管理和软件升级功能。
- 与 RPM 竞争的是基于 Debian 操作系统的 DEB 软件包管理工具 DPKG,全称为 Debian Package,功能方面与 RPM 相似。
发行版
Linux 发行版是 Linux 内核及各种应用软件的集成版本。
| 基于的包管理工具 | 商业发行版 | 社区发行版 |
|---|---|---|
| RPM | Red Hat | Fedora / CentOS |
| DPKG | Ubuntu | Debian |
VIM 三个模式
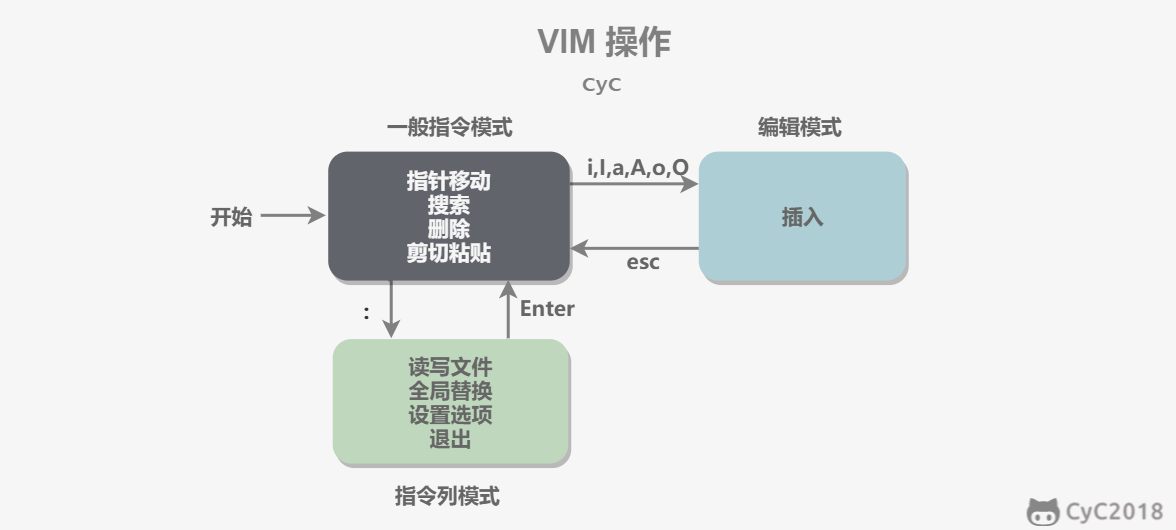
- 一般指令模式(Command mode):VIM 的默认模式,可以用于移动游标查看内容;
- 编辑模式(Insert mode):按下 "i" 等按键之后进入,可以对文本进行编辑;
- 指令列模式(Bottom-line mode):按下 ":" 按键之后进入,用于保存退出等操作。
在指令列模式下,有以下命令用于离开或者保存文件。
| 命令 | 作用 |
|---|---|
| :w | 写入磁盘 |
| :w! | 当文件为只读时,强制写入磁盘。到底能不能写入,与用户对该文件的权限有关 |
| :q | 离开 |
| :q! | 强制离开不保存 |
| :wq | 写入磁盘后离开 |
| :wq! | 强制写入磁盘后离开 |
GNU
GNU 计划,译为革奴计划,它的目标是创建一套完全自由的操作系统,称为 GNU,其内容软件完全以 GPL 方式发布。其中 GPL 全称为 GNU 通用公共许可协议(GNU General Public License),包含了以下内容:
- 以任何目的运行此程序的自由;
- 再复制的自由;
- 改进此程序,并公开发布改进的自由。
开源协议
二、磁盘
磁盘接口
1. IDE
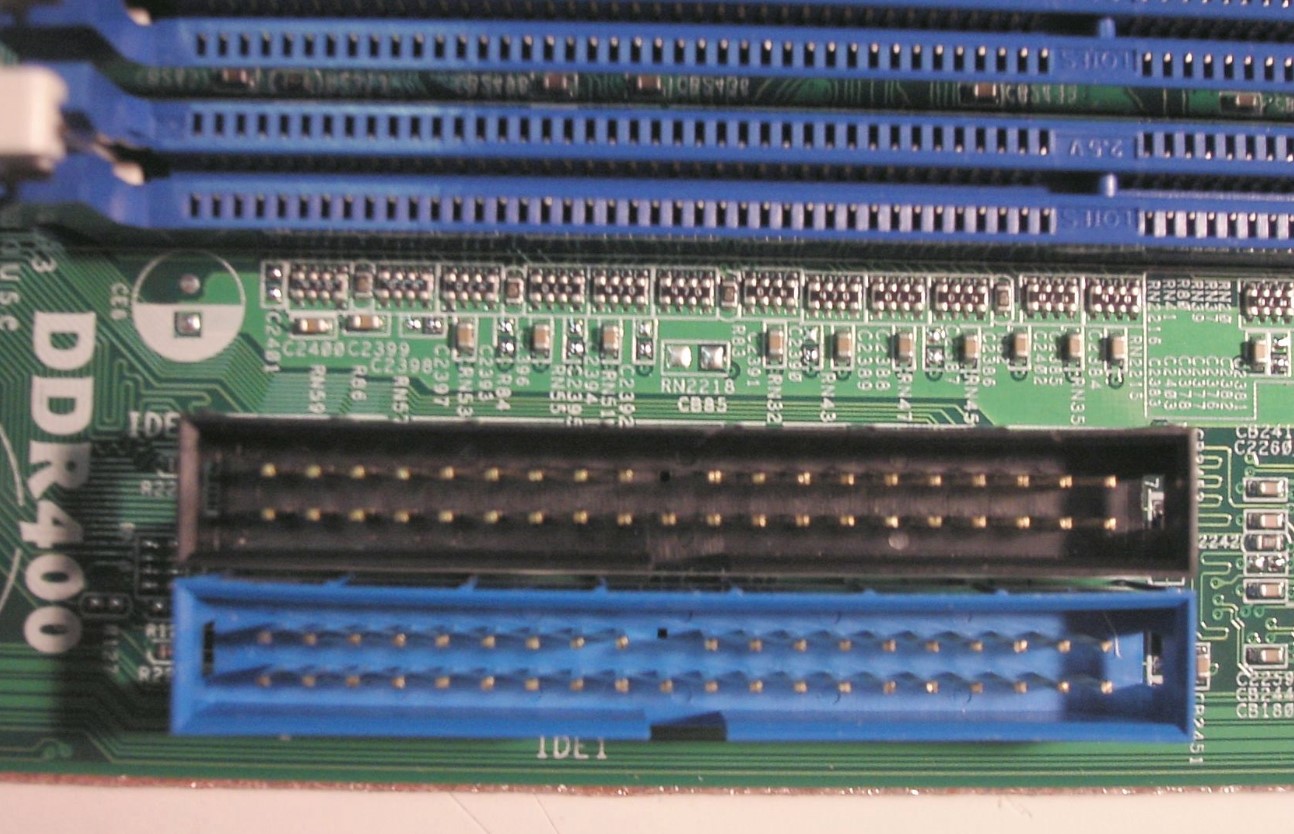
IDE(ATA)全称 Advanced Technology Attachment,接口速度最大为 133MB/s,因为并口线的抗干扰性太差,且排线占用空间较大,不利电脑内部散热,已逐渐被 SATA 所取代。
2. SATA
SATA 全称 Serial ATA,也就是使用串口的 ATA 接口,抗干扰性强,且对数据线的长度要求比 ATA 低很多,支持热插拔等功能。SATA-II 的接口速度为 300MB/s,而 SATA-III 标准可达到 600MB/s 的传输速度。SATA 的数据线也比 ATA 的细得多,有利于机箱内的空气流通,整理线材也比较方便。
3. SCSI
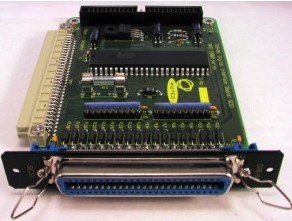
SCSI 全称是 Small Computer System Interface(小型机系统接口),SCSI 硬盘广为工作站以及个人电脑以及服务器所使用,因此会使用较为先进的技术,如碟片转速 15000rpm 的高转速,且传输时 CPU 占用率较低,但是单价也比相同容量的 ATA 及 SATA 硬盘更加昂贵。
4. SAS
SAS(Serial Attached SCSI)是新一代的 SCSI 技术,和 SATA 硬盘相同,都是采取序列式技术以获得更高的传输速度,可达到 6Gb/s。此外也通过缩小连接线改善系统内部空间等。
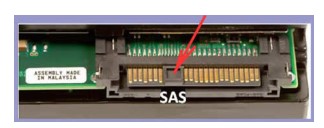
磁盘的文件名
Linux 中每个硬件都被当做一个文件,包括磁盘。磁盘以磁盘接口类型进行命名,常见磁盘的文件名如下:
- IDE 磁盘:/dev/hd[a-d]
- SATA/SCSI/SAS 磁盘:/dev/sd[a-p]
其中文件名后面的序号的确定与系统检测到磁盘的顺序有关,而与磁盘所插入的插槽位置无关。
三、分区
分区表
磁盘分区表主要有两种格式,一种是限制较多的 MBR 分区表,一种是较新且限制较少的 GPT 分区表。
1. MBR
MBR 中,第一个扇区最重要,里面有主要开机记录(Master boot record, MBR)及分区表(partition table),其中主要开机记录占 446 bytes,分区表占 64 bytes。
分区表只有 64 bytes,最多只能存储 4 个分区,这 4 个分区为主分区(Primary)和扩展分区(Extended)。其中扩展分区只有一个,它使用其它扇区来记录额外的分区表,因此通过扩展分区可以分出更多分区,这些分区称为逻辑分区。
Linux 也把分区当成文件,分区文件的命名方式为:磁盘文件名 + 编号,例如 /dev/sda1。注意,逻辑分区的编号从 5 开始。
2. GPT
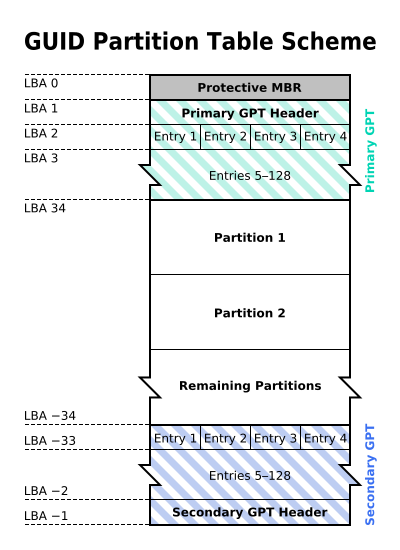
扇区是磁盘的最小存储单位,旧磁盘的扇区大小通常为 512 bytes,而最新的磁盘支持 4 k。GPT 为了兼容所有磁盘,在定义扇区上使用逻辑区块地址(Logical Block Address, LBA),LBA 默认大小为 512 bytes。
GPT 第 1 个区块记录了主要开机记录(MBR),紧接着是 33 个区块记录分区信息,并把最后的 33 个区块用于对分区信息进行备份。这 33 个区块第一个为 GPT 表头纪录,这个部份纪录了分区表本身的位置与大小和备份分区的位置,同时放置了分区表的校验码 (CRC32),操作系统可以根据这个校验码来判断 GPT 是否正确。若有错误,可以使用备份分区进行恢复。
GPT 没有扩展分区概念,都是主分区,每个 LBA 可以分 4 个分区,因此总共可以分 4 * 32 = 128 个分区。
MBR 不支持 2.2 TB 以上的硬盘,GPT 则最多支持到 233 TB = 8 ZB。
开机检测程序
1. BIOS
BIOS(Basic Input/Output System,基本输入输出系统),它是一个固件(嵌入在硬件中的软件),BIOS 程序存放在断电后内容不会丢失的只读内存中。
BIOS 是开机的时候计算机执行的第一个程序,这个程序知道可以开机的磁盘,并读取磁盘第一个扇区的主要开机记录(MBR),由主要开机记录(MBR)执行其中的开机管理程序,这个开机管理程序会加载操作系统的核心文件。
主要开机记录(MBR)中的开机管理程序提供以下功能:选单、载入核心文件以及转交其它开机管理程序。转交这个功能可以用来实现多重引导,只需要将另一个操作系统的开机管理程序安装在其它分区的启动扇区上,在启动开机管理程序时,就可以通过选单选择启动当前的操作系统或者转交给其它开机管理程序从而启动另一个操作系统。
下图中,第一扇区的主要开机记录(MBR)中的开机管理程序提供了两个选单:M1、M2,M1 指向了 Windows 操作系统,而 M2 指向其它分区的启动扇区,里面包含了另外一个开机管理程序,提供了一个指向 Linux 的选单。
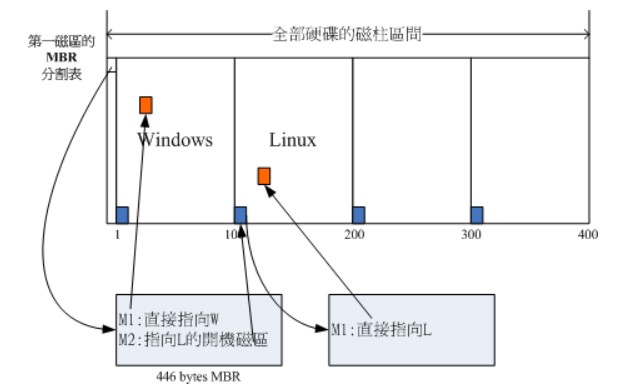
安装多重引导,最好先安装 Windows 再安装 Linux。因为安装 Windows 时会覆盖掉主要开机记录(MBR),而 Linux 可以选择将开机管理程序安装在主要开机记录(MBR)或者其它分区的启动扇区,并且可以设置开机管理程序的选单。
2. UEFI
BIOS 不可以读取 GPT 分区表,而 UEFI 可以。
四、文件系统
分区与文件系统
对分区进行格式化是为了在分区上建立文件系统。一个分区通常只能格式化为一个文件系统,但是磁盘阵列等技术可以将一个分区格式化为多个文件系统。
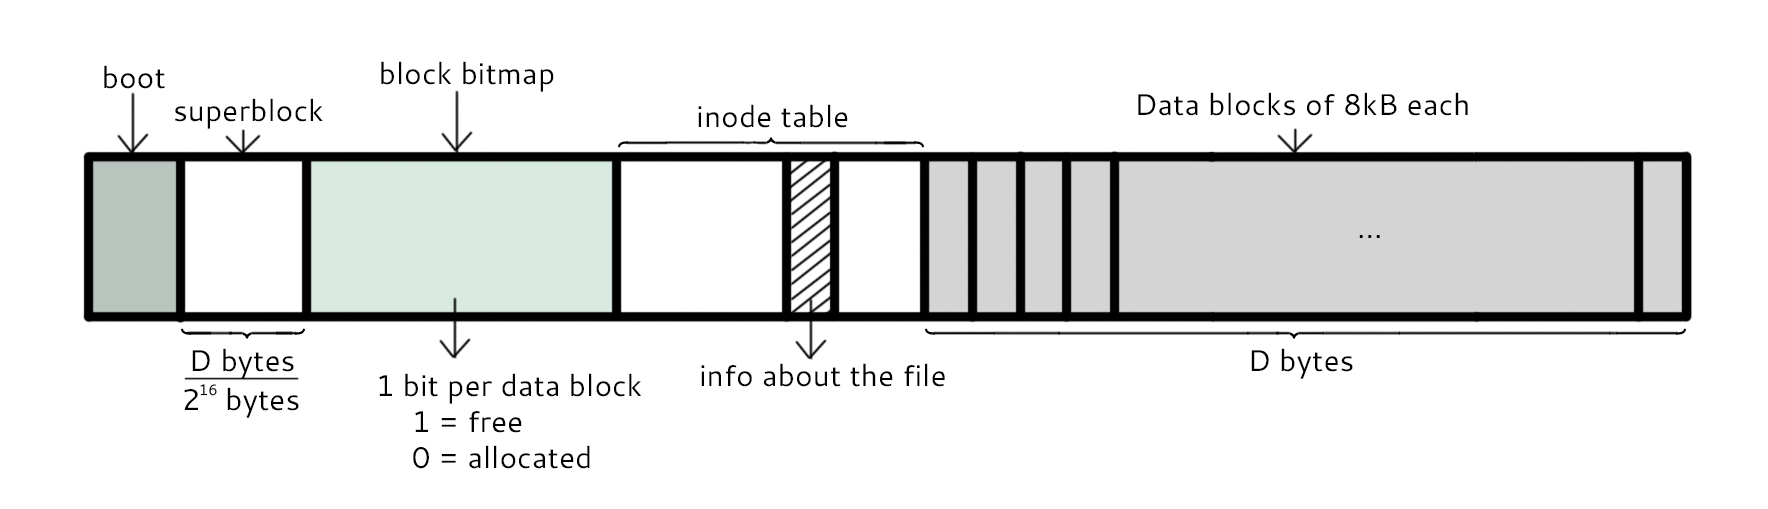
组成
最主要的几个组成部分如下:
- inode:一个文件占用一个 inode,记录文件的属性,同时记录此文件的内容所在的 block 编号;
- block:记录文件的内容,文件太大时,会占用多个 block。
除此之外还包括:
- superblock:记录文件系统的整体信息,包括 inode 和 block 的总量、使用量、剩余量,以及文件系统的格式与相关信息等;
- block bitmap:记录 block 是否被使用的位图。
文件读取
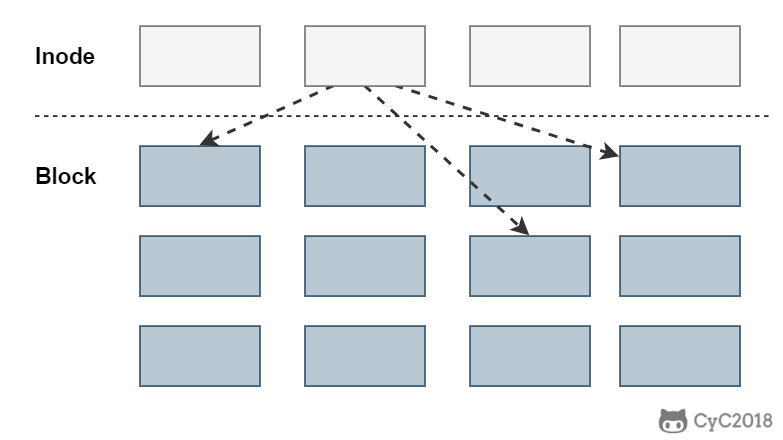
对于 Ext2 文件系统,当要读取一个文件的内容时,先在 inode 中查找文件内容所在的所有 block,然后把所有 block 的内容读出来。
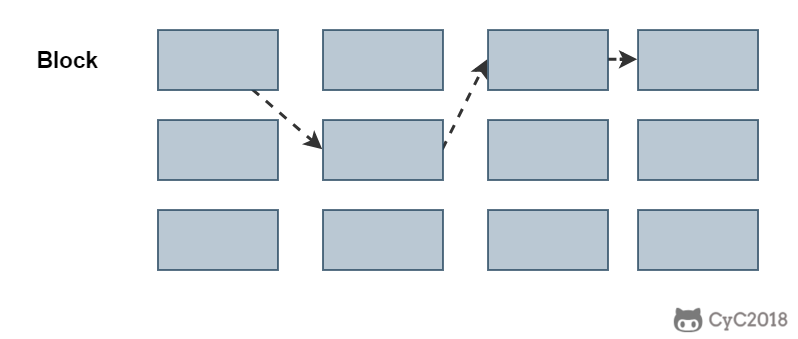
而对于 FAT 文件系统,它没有 inode,每个 block 中存储着下一个 block 的编号。
磁盘碎片
指一个文件内容所在的 block 过于分散,导致磁盘磁头移动距离过大,从而降低磁盘读写性能。
block
在 Ext2 文件系统中所支持的 block 大小有 1K,2K 及 4K 三种,不同的大小限制了单个文件和文件系统的最大大小。
| 大小 | 1KB | 2KB | 4KB |
|---|---|---|---|
| 最大单一文件 | 16GB | 256GB | 2TB |
| 最大文件系统 | 2TB | 8TB | 16TB |
一个 block 只能被一个文件所使用,未使用的部分直接浪费了。因此如果需要存储大量的小文件,那么最好选用比较小的 block。
inode
inode 具体包含以下信息:
- 权限 (read/write/excute);
- 拥有者与群组 (owner/group);
- 容量;
- 建立或状态改变的时间 (ctime);
- 最近读取时间 (atime);
- 最近修改时间 (mtime);
- 定义文件特性的旗标 (flag),如 SetUID...;
- 该文件真正内容的指向 (pointer)。
inode 具有以下特点:
- 每个 inode 大小均固定为 128 bytes (新的 ext4 与 xfs 可设定到 256 bytes);
- 每个文件都仅会占用一个 inode。
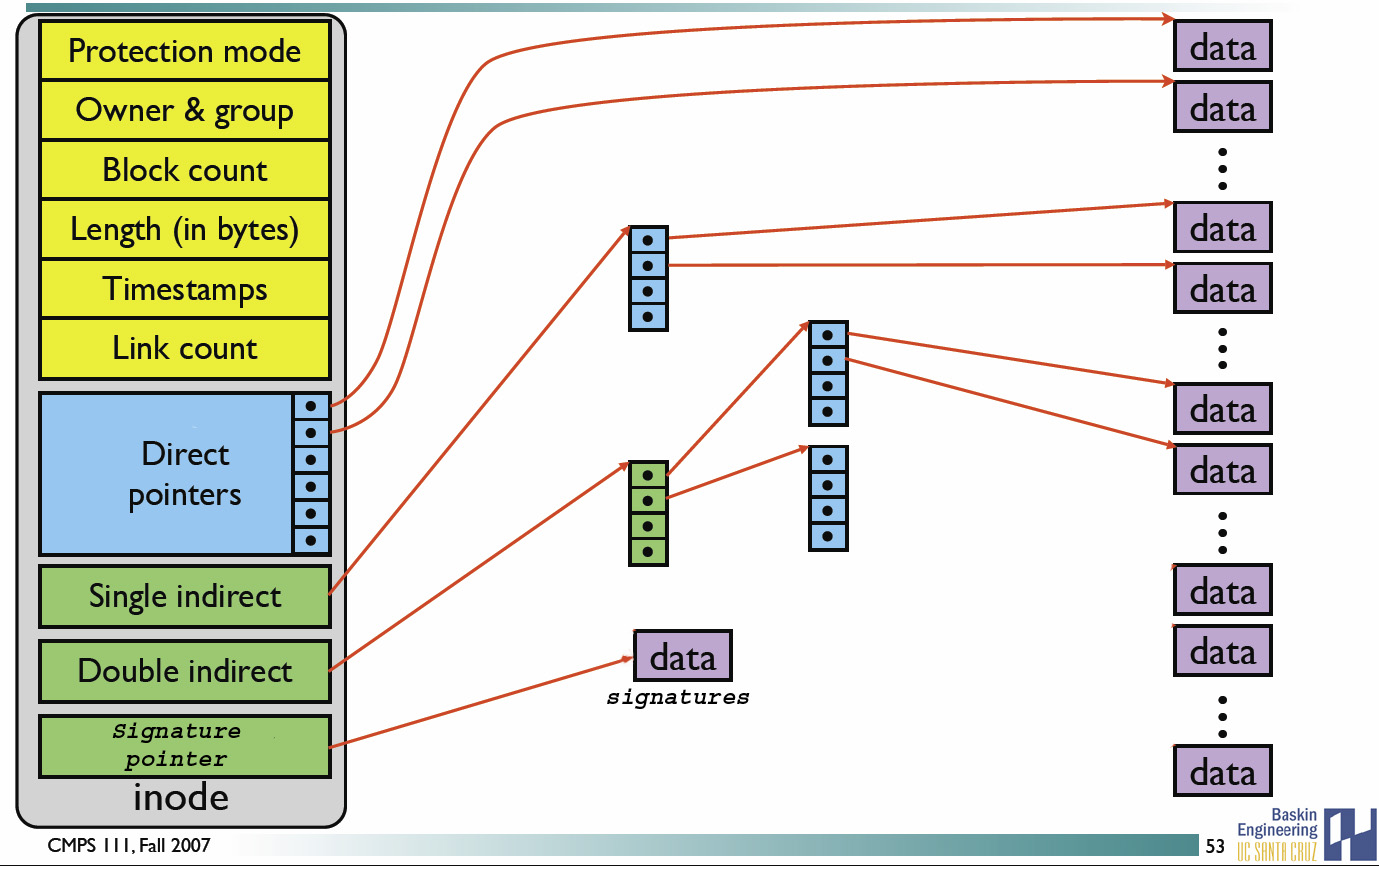
inode 中记录了文件内容所在的 block 编号,但是每个 block 非常小,一个大文件随便都需要几十万的 block。而一个 inode 大小有限,无法直接引用这么多 block 编号。因此引入了间接、双间接、三间接引用。间接引用让 inode 记录的引用 block 块记录引用信息。
目录
建立一个目录时,会分配一个 inode 与至少一个 block。block 记录的内容是目录下所有文件的 inode 编号以及文件名。
可以看到文件的 inode 本身不记录文件名,文件名记录在目录中,因此新增文件、删除文件、更改文件名这些操作与目录的写权限有关。
日志
如果突然断电,那么文件系统会发生错误,例如断电前只修改了 block bitmap,而还没有将数据真正写入 block 中。
ext3/ext4 文件系统引入了日志功能,可以利用日志来修复文件系统。
挂载
挂载利用目录作为文件系统的进入点,也就是说,进入目录之后就可以读取文件系统的数据。
目录配置
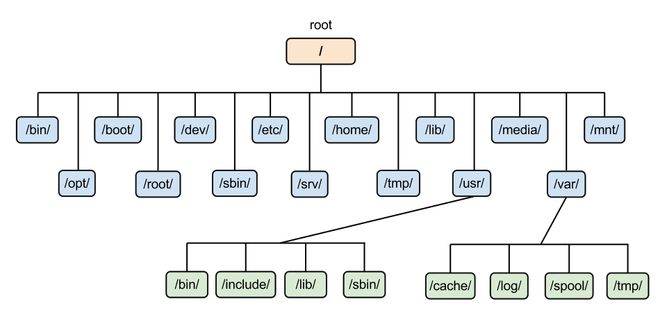
为了使不同 Linux 发行版本的目录结构保持一致性,Filesystem Hierarchy Standard (FHS) 规定了 Linux 的目录结构。最基础的三个目录如下:
- / (root, 根目录)
- /usr (unix software resource):所有系统默认软件都会安装到这个目录;
- /var (variable):存放系统或程序运行过程中的数据文件。
五、文件
文件属性
用户分为三种:文件拥有者、群组以及其它人,对不同的用户有不同的文件权限。
使用 ls 查看一个文件时,会显示一个文件的信息,例如 drwxr-xr-x 3 root root 17 May 6 00:14 .config,对这个信息的解释如下:
- drwxr-xr-x:文件类型以及权限,第 1 位为文件类型字段,后 9 位为文件权限字段
- 3:链接数
- root:文件拥有者
- root:所属群组
- 17:文件大小
- May 6 00:14:文件最后被修改的时间
- .config:文件名
常见的文件类型及其含义有:
- d:目录
- -:文件
- l:链接文件
9 位的文件权限字段中,每 3 个为一组,共 3 组,每一组分别代表对文件拥有者、所属群组以及其它人的文件权限。一组权限中的 3 位分别为 r、w、x 权限,表示可读、可写、可执行。
文件时间有以下三种:
- modification time (mtime):文件的内容更新就会更新;
- status time (ctime):文件的状态(权限、属性)更新就会更新;
- access time (atime):读取文件时就会更新。
文件与目录的基本操作
1. ls
列出文件或者目录的信息,目录的信息就是其中包含的文件。
## ls [-aAdfFhilnrRSt] file|dir
-a :列出全部的文件
-d :仅列出目录本身
-l :以长数据串行列出,包含文件的属性与权限等等数据
2. cd
更换当前目录。
cd [相对路径或绝对路径]3. mkdir
创建目录。
## mkdir [-mp] 目录名称
-m :配置目录权限
-p :递归创建目录
4. rmdir
删除目录,目录必须为空。
rmdir [-p] 目录名称
-p :递归删除目录
5. touch
更新文件时间或者建立新文件。
## touch [-acdmt] filename
-a : 更新 atime
-c : 更新 ctime,若该文件不存在则不建立新文件
-m : 更新 mtime
-d : 后面可以接更新日期而不使用当前日期,也可以使用 --date="日期或时间"
-t : 后面可以接更新时间而不使用当前时间,格式为[YYYYMMDDhhmm]
6. cp
复制文件。如果源文件有两个以上,则目的文件一定要是目录才行。
cp [-adfilprsu] source destination
-a :相当于 -dr --preserve=all
-d :若来源文件为链接文件,则复制链接文件属性而非文件本身
-i :若目标文件已经存在时,在覆盖前会先询问
-p :连同文件的属性一起复制过去
-r :递归复制
-u :destination 比 source 旧才更新 destination,或 destination 不存在的情况下才复制
--preserve=all :除了 -p 的权限相关参数外,还加入 SELinux 的属性, links, xattr 等也复制了
7. rm
删除文件。
## rm [-fir] 文件或目录
-r :递归删除
8. mv
移动文件。
## mv [-fiu] source destination
## mv [options] source1 source2 source3 .... directory
-f : force 强制的意思,如果目标文件已经存在,不会询问而直接覆盖
修改权限
可以将一组权限用数字来表示,此时一组权限的 3 个位当做二进制数字的位,从左到右每个位的权值为 4、2、1,即每个权限对应的数字权值为 r : 4、w : 2、x : 1。
## chmod [-R] xyz dirname/filename示例:将 .bashrc 文件的权限修改为 -rwxr-xr--。
## chmod 754 .bashrc也可以使用符号来设定权限。
## chmod [ugoa]  [+-=] [rwx] dirname/filename
- u:拥有者
- g:所属群组
- o:其他人
- a:所有人
- +:添加权限
- -:移除权限
- =:设定权限
示例:为 .bashrc 文件的所有用户添加写权限。
## chmod a+w .bashrc默认权限
- 文件默认权限:文件默认没有可执行权限,因此为 666,也就是 -rw-rw-rw- 。
- 目录默认权限:目录必须要能够进入,也就是必须拥有可执行权限,因此为 777 ,也就是 drwxrwxrwx。
可以通过 umask 设置或者查看默认权限,通常以掩码的形式来表示,例如 002 表示其它用户的权限去除了一个 2 的权限,也就是写权限,因此建立新文件时默认的权限为 -rw-rw-r--。
目录的权限
文件名不是存储在一个文件的内容中,而是存储在一个文件所在的目录中。因此,拥有文件的 w 权限并不能对文件名进行修改。
目录存储文件列表,一个目录的权限也就是对其文件列表的权限。因此,目录的 r 权限表示可以读取文件列表;w 权限表示可以修改文件列表,具体来说,就是添加删除文件,对文件名进行修改;x 权限可以让该目录成为工作目录,x 权限是 r 和 w 权限的基础,如果不能使一个目录成为工作目录,也就没办法读取文件列表以及对文件列表进行修改了。
链接
## ln [-sf] source_filename dist_filename
-s :默认是实体链接,加 -s 为符号链接
-f :如果目标文件存在时,先删除目标文件
1. 实体链接
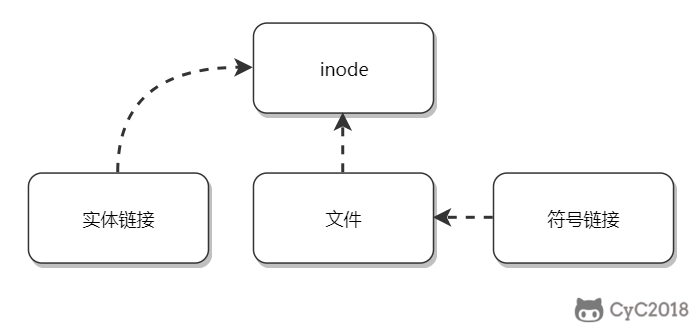
在目录下创建一个条目,记录着文件名与 inode 编号,这个 inode 就是源文件的 inode。
删除任意一个条目,文件还是存在,只要引用数量不为 0。
有以下限制:不能跨越文件系统、不能对目录进行链接。
## ln /etc/crontab .
## ll -i /etc/crontab crontab
34474855 -rw-r--r--. 2 root root 451 Jun 10 2014 crontab
34474855 -rw-r--r--. 2 root root 451 Jun 10 2014 /etc/crontab
2. 符号链接
符号链接文件保存着源文件所在的绝对路径,在读取时会定位到源文件上,可以理解为 Windows 的快捷方式。
当源文件被删除了,链接文件就打不开了。
因为记录的是路径,所以可以为目录建立符号链接。
## ll -i /etc/crontab /root/crontab2
34474855 -rw-r--r--. 2 root root 451 Jun 10 2014 /etc/crontab
53745909 lrwxrwxrwx. 1 root root 12 Jun 23 22:31 /root/crontab2 -> /etc/crontab
获取文件内容
1. cat
取得文件内容。
## cat [-AbEnTv] filename
-n :打印出行号,连同空白行也会有行号,-b 不会
2. tac
是 cat 的反向操作,从最后一行开始打印。
3. more
和 cat 不同的是它可以一页一页查看文件内容,比较适合大文件的查看。
4. less
和 more 类似,但是多了一个向前翻页的功能。
5. head
取得文件前几行。
## head [-n number] filename
-n :后面接数字,代表显示几行的意思
6. tail
是 head 的反向操作,只是取得是后几行。
7. od
以字符或者十六进制的形式显示二进制文件。
指令与文件搜索
1. which
指令搜索。
## which [-a] command
-a :将所有指令列出,而不是只列第一个
2. whereis
文件搜索。速度比较快,因为它只搜索几个特定的目录。
## whereis [-bmsu] dirname/filename3. locate
文件搜索。可以用关键字或者正则表达式进行搜索。
locate 使用 /var/lib/mlocate/ 这个数据库来进行搜索,它存储在内存中,并且每天更新一次,所以无法用 locate 搜索新建的文件。可以使用 updatedb 来立即更新数据库。
## locate [-ir] keyword
-r:正则表达式
4. find
文件搜索。可以使用文件的属性和权限进行搜索。
## find [basedir] [option]
example: find . -name "shadow*"
① 与时间有关的选项
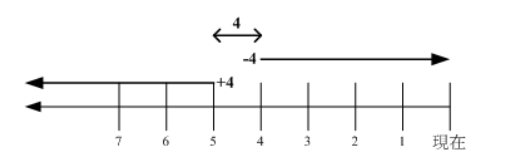
-mtime  n :列出在 n 天前的那一天修改过内容的文件
-mtime +n :列出在 n 天之前 (不含 n 天本身) 修改过内容的文件
-mtime -n :列出在 n 天之内 (含 n 天本身) 修改过内容的文件
-newer file : 列出比 file 更新的文件
+4、4 和 -4 的指示的时间范围如下:
② 与文件拥有者和所属群组有关的选项
-uid n
-gid n
-user name
-group name
-nouser :搜索拥有者不存在 /etc/passwd 的文件
-nogroup:搜索所属群组不存在于 /etc/group 的文件
③ 与文件权限和名称有关的选项
-name filename
-size [+-]SIZE:搜寻比 SIZE 还要大 (+) 或小 (-) 的文件。这个 SIZE 的规格有:c: 代表 byte,k: 代表 1024bytes。所以,要找比 50KB 还要大的文件,就是 -size +50k
-type TYPE
-perm mode  :搜索权限等于 mode 的文件
-perm -mode :搜索权限包含 mode 的文件
-perm /mode :搜索权限包含任一 mode 的文件
六、压缩与打包
压缩文件名
Linux 底下有很多压缩文件名,常见的如下:
| 扩展名 | 压缩程序 |
|---|---|
| \*.Z | compress |
| \*.zip | zip |
| \*.gz | gzip |
| \*.bz2 | bzip2 |
| \*.xz | xz |
| \*.tar | tar 程序打包的数据,没有经过压缩 |
| \*.tar.gz | tar 程序打包的文件,经过 gzip 的压缩 |
| \*.tar.bz2 | tar 程序打包的文件,经过 bzip2 的压缩 |
| \*.tar.xz | tar 程序打包的文件,经过 xz 的压缩 |
压缩指令
1. gzip
gzip 是 Linux 使用最广的压缩指令,可以解开 compress、zip 与 gzip 所压缩的文件。
经过 gzip 压缩过,源文件就不存在了。
有 9 个不同的压缩等级可以使用。
可以使用 zcat、zmore、zless 来读取压缩文件的内容。
$ gzip [-cdtv#] filename
-c :将压缩的数据输出到屏幕上
-d :解压缩
-t :检验压缩文件是否出错
-v :显示压缩比等信息
-# : # 为数字的意思,代表压缩等级,数字越大压缩比越高,默认为 6
2. bzip2
提供比 gzip 更高的压缩比。
查看命令:bzcat、bzmore、bzless、bzgrep。
$ bzip2 [-cdkzv#] filename
-k :保留源文件
3. xz
提供比 bzip2 更佳的压缩比。
可以看到,gzip、bzip2、xz 的压缩比不断优化。不过要注意的是,压缩比越高,压缩的时间也越长。
查看命令:xzcat、xzmore、xzless、xzgrep。
$ xz [-dtlkc#] filename打包
压缩指令只能对一个文件进行压缩,而打包能够将多个文件打包成一个大文件。tar 不仅可以用于打包,也可以使用 gzip、bzip2、xz 将打包文件进行压缩。
$ tar [-z|-j|-J] [cv] [-f 新建的 tar 文件] filename...  ==打包压缩
$ tar [-z|-j|-J] [tv] [-f 已有的 tar 文件]              ==查看
$ tar [-z|-j|-J] [xv] [-f 已有的 tar 文件] [-C 目录]    ==解压缩
-z :使用 zip;
-j :使用 bzip2;
-J :使用 xz;
-c :新建打包文件;
-t :查看打包文件里面有哪些文件;
-x :解打包或解压缩的功能;
-v :在压缩/解压缩的过程中,显示正在处理的文件名;
-f : filename:要处理的文件;
-C 目录 : 在特定目录解压缩。| 使用方式 | 命令 |
|---|---|
| 打包压缩 | tar -jcv -f filename.tar.bz2 要被压缩的文件或目录名称 |
| 查 看 | tar -jtv -f filename.tar.bz2 |
| 解压缩 | tar -jxv -f filename.tar.bz2 -C 要解压缩的目录 |
七、Bash
可以通过 Shell 请求内核提供服务,Bash 正是 Shell 的一种。
特性
- 命令历史:记录使用过的命令
- 命令与文件补全:快捷键:tab
- 命名别名:例如 ll 是 ls -al 的别名
- shell scripts
- 通配符:例如 ls -l /usr/bin/X\* 列出 /usr/bin 下面所有以 X 开头的文件
变量操作
对一个变量赋值直接使用 =。
对变量取用需要在变量前加上 \$ ,也可以用 \${} 的形式;
输出变量使用 echo 命令。
$ x=abc
$ echo $x
$ echo ${x}
变量内容如果有空格,必须使用双引号或者单引号。
- 双引号内的特殊字符可以保留原本特性,例如 x="lang is \$LANG",则 x 的值为 lang is zh_TW.UTF-8;
- 单引号内的特殊字符就是特殊字符本身,例如 x='lang is \$LANG',则 x 的值为 lang is \$LANG。
可以使用 \指令\ 或者 \$(指令) 的方式将指令的执行结果赋值给变量。例如 version=\$(uname -r),则 version 的值为 4.15.0-22-generic。
可以使用 export 命令将自定义变量转成环境变量,环境变量可以在子程序中使用,所谓子程序就是由当前 Bash 而产生的子 Bash。
Bash 的变量可以声明为数组和整数数字。注意数字类型没有浮点数。如果不进行声明,默认是字符串类型。变量的声明使用 declare 命令:
$ declare [-aixr] variable
-a : 定义为数组类型
-i : 定义为整数类型
-x : 定义为环境变量
-r : 定义为 readonly 类型
使用 [ ] 来对数组进行索引操作:
$ array[1]=a
$ array[2]=b
$ echo ${array[1]}
指令搜索顺序
- 以绝对或相对路径来执行指令,例如 /bin/ls 或者 ./ls ;
- 由别名找到该指令来执行;
- 由 Bash 内置的指令来执行;
- 按 \$PATH 变量指定的搜索路径的顺序找到第一个指令来执行。
数据流重定向
重定向指的是使用文件代替标准输入、标准输出和标准错误输出。
| 1 | 代码 | 运算符 |
|---|---|---|
| 标准输入 (stdin) | 0 | \< 或 \<\< |
| 标准输出 (stdout) | 1 | > 或 \>\> |
| 标准错误输出 (stderr) | 2 | 2\> 或 2\>\> |
其中,有一个箭头的表示以覆盖的方式重定向,而有两个箭头的表示以追加的方式重定向。
可以将不需要的标准输出以及标准错误输出重定向到 /dev/null,相当于扔进垃圾箱。
如果需要将标准输出以及标准错误输出同时重定向到一个文件,需要将某个输出转换为另一个输出,例如 2\>&1 表示将标准错误输出转换为标准输出。
$ find /home -name .bashrc > list 2>&1八、管道指令
管道是将一个命令的标准输出作为另一个命令的标准输入,在数据需要经过多个步骤的处理之后才能得到我们想要的内容时就可以使用管道。
在命令之间使用 | 分隔各个管道命令。
$ ls -al /etc | less提取指令
cut 对数据进行切分,取出想要的部分。
切分过程一行一行地进行。
$ cut
-d :分隔符
-f :经过 -d 分隔后,使用 -f n 取出第 n 个区间
-c :以字符为单位取出区间
示例 1:last 显示登入者的信息,取出用户名。
$ last
root pts/1 192.168.201.101 Sat Feb 7 12:35 still logged in
root pts/1 192.168.201.101 Fri Feb 6 12:13 - 18:46 (06:33)
root pts/1 192.168.201.254 Thu Feb 5 22:37 - 23:53 (01:16)

$ last | cut -d ' ' -f 1
示例 2:将 export 输出的信息,取出第 12 字符以后的所有字符串。
$ export
declare -x HISTCONTROL="ignoredups"
declare -x HISTSIZE="1000"
declare -x HOME="/home/dmtsai"
declare -x HOSTNAME="study.centos.vbird"
.....(其他省略).....

$ export | cut -c 12-
排序指令
sort 用于排序。
$ sort [-fbMnrtuk] [file or stdin]
-f :忽略大小写
-b :忽略最前面的空格
-M :以月份的名字来排序,例如 JAN,DEC
-n :使用数字
-r :反向排序
-u :相当于 unique,重复的内容只出现一次
-t :分隔符,默认为 tab
-k :指定排序的区间
示例:/etc/passwd 文件内容以 : 来分隔,要求以第三列进行排序。
$ cat /etc/passwd | sort -t ':' -k 3
root:x:0:0:root:/root:/bin/bash
dmtsai:x:1000:1000:dmtsai:/home/dmtsai:/bin/bash
alex:x:1001:1002::/home/alex:/bin/bash
arod:x:1002:1003::/home/arod:/bin/bash
uniq 可以将重复的数据只取一个。
$ uniq [-ic]
-i :忽略大小写
-c :进行计数
示例:取得每个人的登录总次数
$ last | cut -d ' ' -f 1 | sort | uniq -c
1
6 (unknown
47 dmtsai
4 reboot
7 root
1 wtmp
双向输出重定向
输出重定向会将输出内容重定向到文件中,而 tee 不仅能够完成这个功能,还能保留屏幕上的输出。也就是说,使用 tee 指令,一个输出会同时传送到文件和屏幕上。
$ tee [-a] file字符转换指令
tr 用来删除一行中的字符,或者对字符进行替换。
$ tr [-ds] SET1 ...
-d : 删除行中 SET1 这个字符串
示例,将 last 输出的信息所有小写转换为大写。
$ last | tr '[a-z]' '[A-Z]'col 将 tab 字符转为空格字符。
$ col [-xb]
-x : 将 tab 键转换成对等的空格键
expand 将 tab 转换一定数量的空格,默认是 8 个。
$ expand [-t] file
-t :tab 转为空格的数量
join 将有相同数据的那一行合并在一起。
$ join [-ti12] file1 file2
-t :分隔符,默认为空格
-i :忽略大小写的差异
-1 :第一个文件所用的比较字段
-2 :第二个文件所用的比较字段
paste 直接将两行粘贴在一起。
$ paste [-d] file1 file2
-d :分隔符,默认为 tab
分区指令
split 将一个文件划分成多个文件。
$ split [-bl] file PREFIX
-b :以大小来进行分区,可加单位,例如 b, k, m 等
-l :以行数来进行分区。
- PREFIX :分区文件的前导名称
九、正则表达式
grep
g/re/p(globally search a regular expression and print),使用正则表示式进行全局查找并打印。
$ grep [-acinv] [--color=auto] 搜寻字符串 filename
-c : 统计匹配到行的个数
-i : 忽略大小写
-n : 输出行号
-v : 反向选择,也就是显示出没有 搜寻字符串 内容的那一行
--color=auto :找到的关键字加颜色显示
示例:把含有 the 字符串的行提取出来(注意默认会有 --color=auto 选项,因此以下内容在 Linux 中有颜色显示 the 字符串)
$ grep -n 'the' regular_express.txt
8:I can't finish the test.
12:the symbol '*' is represented as start.
15:You are the best is mean you are the no. 1.
16:The world Happy is the same with "glad".
18:google is the best tools for search keyword
示例:正则表达式 a{m,n} 用来匹配字符 a m\~n 次,这里需要将 { 和 } 进行转义,因为它们在 shell 是有特殊意义的。
$ grep -n 'a\{2,5\}' regular_express.txtprintf
用于格式化输出。它不属于管道命令,在给 printf 传数据时需要使用 $( ) 形式。
$ printf '%10s %5i %5i %5i %8.2f \n' $(cat printf.txt)
    DmTsai    80    60    92    77.33
     VBird    75    55    80    70.00
       Ken    60    90    70    73.33
awk
是由 Alfred Aho,Peter Weinberger 和 Brian Kernighan 创造,awk 这个名字就是这三个创始人名字的首字母。
awk 每次处理一行,处理的最小单位是字段,每个字段的命名方式为:\$n,n 为字段号,从 1 开始,\$0 表示一整行。
示例:取出最近五个登录用户的用户名和 IP。首先用 last -n 5 取出用最近五个登录用户的所有信息,可以看到用户名和 IP 分别在第 1 列和第 3 列,我们用 \$1 和 \$3 就能取出这两个字段,然后用 print 进行打印。
$ last -n 5
dmtsai pts/0 192.168.1.100 Tue Jul 14 17:32 still logged in
dmtsai pts/0 192.168.1.100 Thu Jul 9 23:36 - 02:58 (03:22)
dmtsai pts/0 192.168.1.100 Thu Jul 9 17:23 - 23:36 (06:12)
dmtsai pts/0 192.168.1.100 Thu Jul 9 08:02 - 08:17 (00:14)
dmtsai tty1 Fri May 29 11:55 - 12:11 (00:15)
$ last -n 5 | awk '{print $1 "\t" $3}'
dmtsai 192.168.1.100
dmtsai 192.168.1.100
dmtsai 192.168.1.100
dmtsai 192.168.1.100
dmtsai Fri可以根据字段的某些条件进行匹配,例如匹配字段小于某个值的那一行数据。
$ awk '条件类型 1 {动作 1} 条件类型 2 {动作 2} ...' filename示例:/etc/passwd 文件第三个字段为 UID,对 UID 小于 10 的数据进行处理。
$ cat /etc/passwd | awk 'BEGIN {FS=":"} $3 < 10 {print $1 "\t " $3}'
root 0
bin 1
daemon 2
awk 变量:
| 变量名称 | 代表意义 |
|---|---|
| NF | 每一行拥有的字段总数 |
| NR | 目前所处理的是第几行数据 |
| FS | 目前的分隔字符,默认是空格键 |
示例:显示正在处理的行号以及每一行有多少字段
$ last -n 5 | awk '{print $1 "\t lines: " NR "\t columns: " NF}'
dmtsai lines: 1 columns: 10
dmtsai lines: 2 columns: 10
dmtsai lines: 3 columns: 10
dmtsai lines: 4 columns: 10
dmtsai lines: 5 columns: 9
十、进程管理
查看进程
1. ps
查看某个时间点的进程信息。
示例:查看自己的进程
## ps -l示例:查看系统所有进程
## ps aux示例:查看特定的进程
## ps aux | grep threadx2. pstree
查看进程树。
示例:查看所有进程树
## pstree -A3. top
实时显示进程信息。
示例:两秒钟刷新一次
## top -d 24. netstat
查看占用端口的进程
示例:查看特定端口的进程
## netstat -anp | grep port进程状态
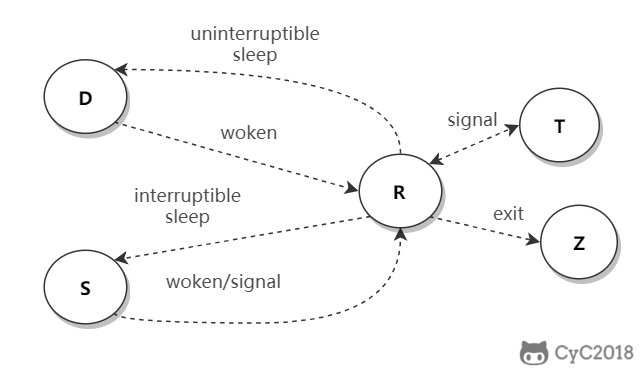
| 状态 | 说明 |
|---|---|
| R | running or runnable (on run queue) 正在执行或者可执行,此时进程位于执行队列中。 |
| D | uninterruptible sleep (usually I/O) 不可中断阻塞,通常为 IO 阻塞。 |
| S | interruptible sleep (waiting for an event to complete) 可中断阻塞,此时进程正在等待某个事件完成。 |
| Z | zombie (terminated but not reaped by its parent) 僵死,进程已经终止但是尚未被其父进程获取信息。 |
| T | stopped (either by a job control signal or because it is being traced) 结束,进程既可以被作业控制信号结束,也可能是正在被追踪。 |
SIGCHLD
当一个子进程改变了它的状态时(停止运行,继续运行或者退出),有两件事会发生在父进程中:
- 得到 SIGCHLD 信号;
- waitpid() 或者 wait() 调用会返回。
其中子进程发送的 SIGCHLD 信号包含了子进程的信息,比如进程 ID、进程状态、进程使用 CPU 的时间等。
在子进程退出时,它的进程描述符不会立即释放,这是为了让父进程得到子进程信息,父进程通过 wait() 和 waitpid() 来获得一个已经退出的子进程的信息。
wait()
pid_t wait(int *status)父进程调用 wait() 会一直阻塞,直到收到一个子进程退出的 SIGCHLD 信号,之后 wait() 函数会销毁子进程并返回。
如果成功,返回被收集的子进程的进程 ID;如果调用进程没有子进程,调用就会失败,此时返回 -1,同时 errno 被置为 ECHILD。
参数 status 用来保存被收集的子进程退出时的一些状态,如果对这个子进程是如何死掉的毫不在意,只想把这个子进程消灭掉,可以设置这个参数为 NULL。
waitpid()
pid_t waitpid(pid_t pid, int *status, int options)作用和 wait() 完全相同,但是多了两个可由用户控制的参数 pid 和 options。
pid 参数指示一个子进程的 ID,表示只关心这个子进程退出的 SIGCHLD 信号。如果 pid=-1 时,那么和 wait() 作用相同,都是关心所有子进程退出的 SIGCHLD 信号。
options 参数主要有 WNOHANG 和 WUNTRACED 两个选项,WNOHANG 可以使 waitpid() 调用变成非阻塞的,也就是说它会立即返回,父进程可以继续执行其它任务。
孤儿进程
一个父进程退出,而它的一个或多个子进程还在运行,那么这些子进程将成为孤儿进程。
孤儿进程将被 init 进程(进程号为 1)所收养,并由 init 进程对它们完成状态收集工作。
由于孤儿进程会被 init 进程收养,所以孤儿进程不会对系统造成危害。
僵尸进程
一个子进程的进程描述符在子进程退出时不会释放,只有当父进程通过 wait() 或 waitpid() 获取了子进程信息后才会释放。如果子进程退出,而父进程并没有调用 wait() 或 waitpid(),那么子进程的进程描述符仍然保存在系统中,这种进程称之为僵尸进程。
僵尸进程通过 ps 命令显示出来的状态为 Z(zombie)。
系统所能使用的进程号是有限的,如果产生大量僵尸进程,将因为没有可用的进程号而导致系统不能产生新的进程。
要消灭系统中大量的僵尸进程,只需要将其父进程杀死,此时僵尸进程就会变成孤儿进程,从而被 init 进程所收养,这样 init 进程就会释放所有的僵尸进程所占有的资源,从而结束僵尸进程。
参考资料
- 鸟哥. 鸟 哥 的 Linux 私 房 菜 基 础 篇 第 三 版[J]. 2009.
- Linux 平台上的软件包管理
- Linux 之守护进程、僵死进程与孤儿进程
- What is the difference between a symbolic link and a hard link?
- Linux process states
- GUID Partition Table
- 详解 wait 和 waitpid 函数
- IDE、SATA、SCSI、SAS、FC、SSD 硬盘类型介绍
- Akai IB-301S SCSI Interface for S2800,S3000
- Parallel ATA
- ADATA XPG SX900 256GB SATA 3 SSD Review – Expanded Capacity and SandForce Driven Speed
- Decoding UCS Invicta – Part 1
- 硬盘
- Difference between SAS and SATA
- BIOS
- File system design case studies
- Programming Project #4
- FILE SYSTEM DESIGN
HTTP
HTTP
* [一 、基础概念](#一-基础概念)
    * [请求和响应报文](#请求和响应报文)
    * [URL](#url)
* [二、HTTP 方法](#二http-方法)
    * [GET](#get)
    * [HEAD](#head)
    * [POST](#post)
    * [PUT](#put)
    * [PATCH](#patch)
    * [DELETE](#delete)
    * [OPTIONS](#options)
    * [CONNECT](#connect)
    * [TRACE](#trace)
* [三、HTTP 状态码](#三http-状态码)
    * [1XX 信息](#1xx-信息)
    * [2XX 成功](#2xx-成功)
    * [3XX 重定向](#3xx-重定向)
    * [4XX 客户端错误](#4xx-客户端错误)
    * [5XX 服务器错误](#5xx-服务器错误)
* [四、HTTP 首部](#四http-首部)
    * [通用首部字段](#通用首部字段)
    * [请求首部字段](#请求首部字段)
    * [响应首部字段](#响应首部字段)
    * [实体首部字段](#实体首部字段)
* [五、具体应用](#五具体应用)
    * [连接管理](#连接管理)
    * [Cookie](#cookie)
    * [缓存](#缓存)
    * [内容协商](#内容协商)
    * [内容编码](#内容编码)
    * [范围请求](#范围请求)
    * [分块传输编码](#分块传输编码)
    * [多部分对象集合](#多部分对象集合)
    * [虚拟主机](#虚拟主机)
    * [通信数据转发](#通信数据转发)
* [六、HTTPS](#六https)
    * [加密](#加密)
    * [认证](#认证)
    * [完整性保护](#完整性保护)
    * [HTTPS 的缺点](#https-的缺点)
* [七、HTTP/2.0](#七http20)
    * [HTTP/1.x 缺陷](#http1x-缺陷)
    * [二进制分帧层](#二进制分帧层)
    * [服务端推送](#服务端推送)
    * [首部压缩](#首部压缩)
* [八、HTTP/1.1 新特性](#八http11-新特性)
* [九、GET 和 POST 比较](#九get-和-post-比较)
    * [作用](#作用)
    * [参数](#参数)
    * [安全](#安全)
    * [幂等性](#幂等性)
    * [可缓存](#可缓存)
    * [XMLHttpRequest](#xmlhttprequest)
* [参考资料](#参考资料)
一 、基础概念
请求和响应报文
客户端发送一个请求报文给服务器,服务器根据请求报文中的信息进行处理,并将处理结果放入响应报文中返回给客户端。
请求报文结构:
- 第一行是包含了请求方法、URL、协议版本;
- 接下来的多行都是请求首部 Header,每个首部都有一个首部名称,以及对应的值。
- 一个空行用来分隔首部和内容主体 Body
- 最后是请求的内容主体
GET http://www.example.com/ HTTP/1.1
Accept: text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,image/apng,*/*;q=0.8,application/signed-exchange;v=b3;q=0.9
Accept-Encoding: gzip, deflate
Accept-Language: zh-CN,zh;q=0.9,en;q=0.8
Cache-Control: max-age=0
Host: www.example.com
If-Modified-Since: Thu, 17 Oct 2019 07:18:26 GMT
If-None-Match: "3147526947+gzip"
Proxy-Connection: keep-alive
Upgrade-Insecure-Requests: 1
User-Agent: Mozilla/5.0 xxx
param1=1¶m2=2响应报文结构:
- 第一行包含协议版本、状态码以及描述,最常见的是 200 OK 表示请求成功了
- 接下来多行也是首部内容
- 一个空行分隔首部和内容主体
- 最后是响应的内容主体
HTTP/1.1 200 OK
Age: 529651
Cache-Control: max-age=604800
Connection: keep-alive
Content-Encoding: gzip
Content-Length: 648
Content-Type: text/html; charset=UTF-8
Date: Mon, 02 Nov 2020 17:53:39 GMT
Etag: "3147526947+ident+gzip"
Expires: Mon, 09 Nov 2020 17:53:39 GMT
Keep-Alive: timeout=4
Last-Modified: Thu, 17 Oct 2019 07:18:26 GMT
Proxy-Connection: keep-alive
Server: ECS (sjc/16DF)
Vary: Accept-Encoding
X-Cache: HIT

<!doctype html>
<html>
<head>
    <title>Example Domain</title>
	// 省略...
</body>
</html>
URL
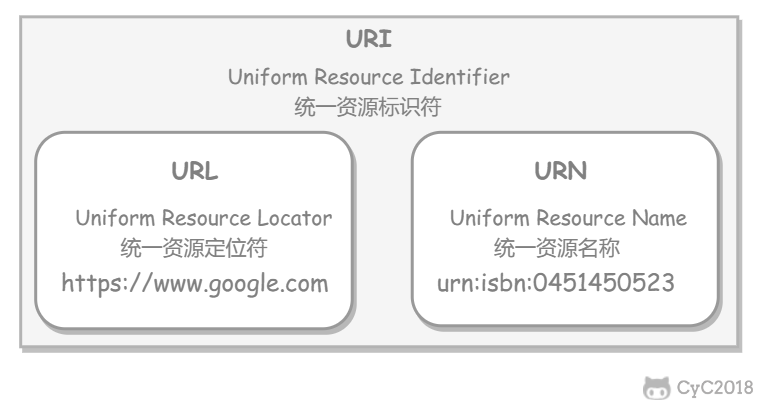
HTTP 使用 URL( U niform Resource Locator,统一资源定位符)来定位资源,它是 URI(Uniform Resource Identifier,统一资源标识符)的子集,URL 在 URI 的基础上增加了定位能力。URI 除了包含 URL,还包含 URN(Uniform Resource Name,统一资源名称),它只是用来定义一个资源的名称,并不具备定位该资源的能力。例如 urn:isbn:0451450523 用来定义一个书籍名称,但是却没有表示怎么找到这本书。
- wikipedia:统一资源标志符
- wikipedia: URL
- rfc2616:3.2.2 http URL
- What is the difference between a URI, a URL and a URN?
二、HTTP 方法
客户端发送的 请求报文 第一行为请求行,包含了方法字段。
GET
获取资源
当前网络请求中,绝大部分使用的是 GET 方法。
HEAD
获取报文首部
和 GET 方法类似,但是不返回报文实体主体部分。
主要用于确认 URL 的有效性以及资源更新的日期时间等。
POST
传输实体主体
POST 主要用来传输数据,而 GET 主要用来获取资源。
更多 POST 与 GET 的比较请见第九章。
PUT
上传文件
由于自身不带验证机制,任何人都可以上传文件,因此存在安全性问题,一般不使用该方法。
PUT /new.html HTTP/1.1
Host: example.com
Content-type: text/html
Content-length: 16

<p>New File</p>
PATCH
对资源进行部分修改
PUT 也可以用于修改资源,但是只能完全替代原始资源,PATCH 允许部分修改。
PATCH /file.txt HTTP/1.1
Host: www.example.com
Content-Type: application/example
If-Match: "e0023aa4e"
Content-Length: 100

[description of changes]
DELETE
删除文件
与 PUT 功能相反,并且同样不带验证机制。
DELETE /file.html HTTP/1.1OPTIONS
查询支持的方法
查询指定的 URL 能够支持的方法。
会返回 Allow: GET, POST, HEAD, OPTIONS 这样的内容。
CONNECT
要求在与代理服务器通信时建立隧道
使用 SSL(Secure Sockets Layer,安全套接层)和 TLS(Transport Layer Security,传输层安全)协议把通信内容加密后经网络隧道传输。
CONNECT www.example.com:443 HTTP/1.1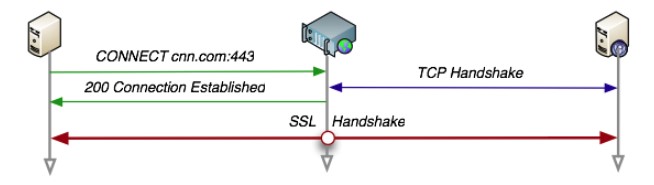
TRACE
追踪路径
服务器会将通信路径返回给客户端。
发送请求时,在 Max-Forwards 首部字段中填入数值,每经过一个服务器就会减 1,当数值为 0 时就停止传输。
通常不会使用 TRACE,并且它容易受到 XST 攻击(Cross-Site Tracing,跨站追踪)。
三、HTTP 状态码
服务器返回的 响应报文 中第一行为状态行,包含了状态码以及原因短语,用来告知客户端请求的结果。
| 状态码 | 类别 | 含义 |
|---|---|---|
| 1XX | Informational(信息性状态码) | 接收的请求正在处理 |
| 2XX | Success(成功状态码) | 请求正常处理完毕 |
| 3XX | Redirection(重定向状态码) | 需要进行附加操作以完成请求 |
| 4XX | Client Error(客户端错误状态码) | 服务器无法处理请求 |
| 5XX | Server Error(服务器错误状态码) | 服务器处理请求出错 |
1XX 信息
- 100 Continue :表明到目前为止都很正常,客户端可以继续发送请求或者忽略这个响应。
2XX 成功
- 200 OK
- 204 No Content :请求已经成功处理,但是返回的响应报文不包含实体的主体部分。一般在只需要从客户端往服务器发送信息,而不需要返回数据时使用。
- 206 Partial Content :表示客户端进行了范围请求,响应报文包含由 Content-Range 指定范围的实体内容。
3XX 重定向
- 301 Moved Permanently :永久性重定向
- 302 Found :临时性重定向
- 303 See Other :和 302 有着相同的功能,但是 303 明确要求客户端应该采用 GET 方法获取资源。
- 注:虽然 HTTP 协议规定 301、302 状态下重定向时不允许把 POST 方法改成 GET 方法,但是大多数浏览器都会在 301、302 和 303 状态下的重定向把 POST 方法改成 GET 方法。
- 304 Not Modified :如果请求报文首部包含一些条件,例如:If-Match,If-Modified-Since,If-None-Match,If-Range,If-Unmodified-Since,如果不满足条件,则服务器会返回 304 状态码。
- 307 Temporary Redirect :临时重定向,与 302 的含义类似,但是 307 要求浏览器不会把重定向请求的 POST 方法改成 GET 方法。
4XX 客户端错误
- 400 Bad Request :请求报文中存在语法错误。
- 401 Unauthorized :该状态码表示发送的请求需要有认证信息(BASIC 认证、DIGEST 认证)。如果之前已进行过一次请求,则表示用户认证失败。
- 403 Forbidden :请求被拒绝。
- 404 Not Found
5XX 服务器错误
- 500 Internal Server Error :服务器正在执行请求时发生错误。
- 503 Service Unavailable :服务器暂时处于超负载或正在进行停机维护,现在无法处理请求。
四、HTTP 首部
有 4 种类型的首部字段:通用首部字段、请求首部字段、响应首部字段和实体首部字段。
各种首部字段及其含义如下(不需要全记,仅供查阅):
通用首部字段
| 首部字段名 | 说明 |
|---|---|
| Cache-Control | 控制缓存的行为 |
| Connection | 控制不再转发给代理的首部字段、管理持久连接 |
| Date | 创建报文的日期时间 |
| Pragma | 报文指令 |
| Trailer | 报文末端的首部一览 |
| Transfer-Encoding | 指定报文主体的传输编码方式 |
| Upgrade | 升级为其他协议 |
| Via | 代理服务器的相关信息 |
| Warning | 错误通知 |
请求首部字段
| 首部字段名 | 说明 |
|---|---|
| Accept | 用户代理可处理的媒体类型 |
| Accept-Charset | 优先的字符集 |
| Accept-Encoding | 优先的内容编码 |
| Accept-Language | 优先的语言(自然语言) |
| Authorization | Web 认证信息 |
| Expect | 期待服务器的特定行为 |
| From | 用户的电子邮箱地址 |
| Host | 请求资源所在服务器 |
| If-Match | 比较实体标记(ETag) |
| If-Modified-Since | 比较资源的更新时间 |
| If-None-Match | 比较实体标记(与 If-Match 相反) |
| If-Range | 资源未更新时发送实体 Byte 的范围请求 |
| If-Unmodified-Since | 比较资源的更新时间(与 If-Modified-Since 相反) |
| Max-Forwards | 最大传输逐跳数 |
| Proxy-Authorization | 代理服务器要求客户端的认证信息 |
| Range | 实体的字节范围请求 |
| Referer | 对请求中 URI 的原始获取方 |
| TE | 传输编码的优先级 |
| User-Agent | HTTP 客户端程序的信息 |
响应首部字段
| 首部字段名 | 说明 |
|---|---|
| Accept-Ranges | 是否接受字节范围请求 |
| Age | 推算资源创建经过时间 |
| ETag | 资源的匹配信息 |
| Location | 令客户端重定向至指定 URI |
| Proxy-Authenticate | 代理服务器对客户端的认证信息 |
| Retry-After | 对再次发起请求的时机要求 |
| Server | HTTP 服务器的安装信息 |
| Vary | 代理服务器缓存的管理信息 |
| WWW-Authenticate | 服务器对客户端的认证信息 |
实体首部字段
| 首部字段名 | 说明 |
|---|---|
| Allow | 资源可支持的 HTTP 方法 |
| Content-Encoding | 实体主体适用的编码方式 |
| Content-Language | 实体主体的自然语言 |
| Content-Length | 实体主体的大小 |
| Content-Location | 替代对应资源的 URI |
| Content-MD5 | 实体主体的报文摘要 |
| Content-Range | 实体主体的位置范围 |
| Content-Type | 实体主体的媒体类型 |
| Expires | 实体主体过期的日期时间 |
| Last-Modified | 资源的最后修改日期时间 |
五、具体应用
连接管理
1. 短连接与长连接
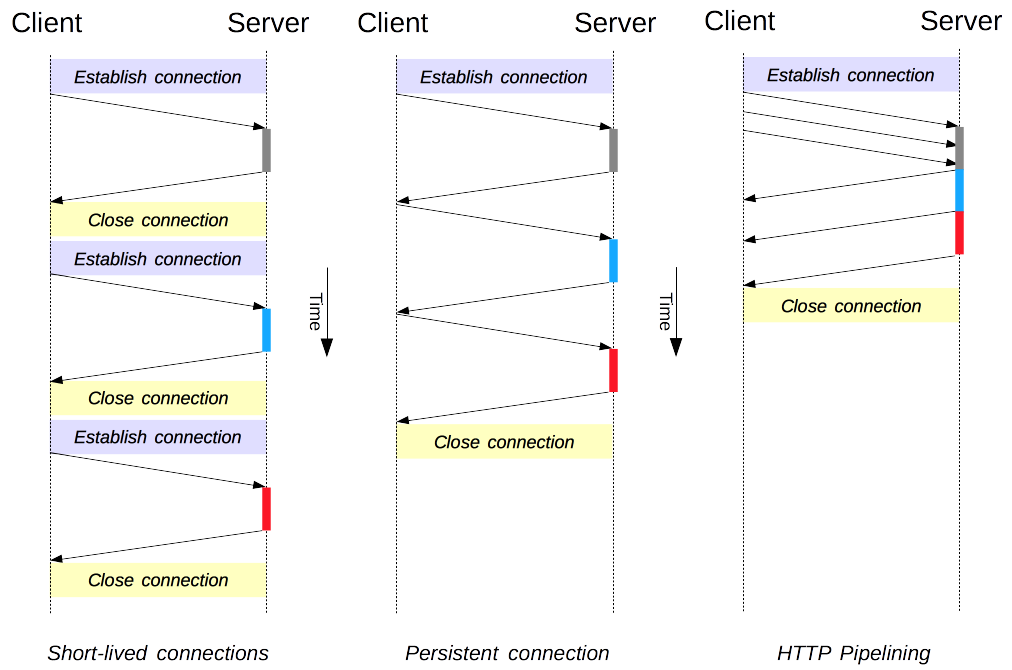
当浏览器访问一个包含多张图片的 HTML 页面时,除了请求访问的 HTML 页面资源,还会请求图片资源。如果每进行一次 HTTP 通信就要新建一个 TCP 连接,那么开销会很大。
长连接只需要建立一次 TCP 连接就能进行多次 HTTP 通信。
- 从 HTTP/1.1 开始默认是长连接的,如果要断开连接,需要由客户端或者服务器端提出断开,使用
Connection : close; - 在 HTTP/1.1 之前默认是短连接的,如果需要使用长连接,则使用
Connection : Keep-Alive。
2. 流水线
默认情况下,HTTP 请求是按顺序发出的,下一个请求只有在当前请求收到响应之后才会被发出。由于受到网络延迟和带宽的限制,在下一个请求被发送到服务器之前,可能需要等待很长时间。
流水线是在同一条长连接上连续发出请求,而不用等待响应返回,这样可以减少延迟。
Cookie
HTTP 协议是无状态的,主要是为了让 HTTP 协议尽可能简单,使得它能够处理大量事务。HTTP/1.1 引入 Cookie 来保存状态信息。
Cookie 是服务器发送到用户浏览器并保存在本地的一小块数据,它会在浏览器之后向同一服务器再次发起请求时被携带上,用于告知服务端两个请求是否来自同一浏览器。由于之后每次请求都会需要携带 Cookie 数据,因此会带来额外的性能开销(尤其是在移动环境下)。
Cookie 曾一度用于客户端数据的存储,因为当时并没有其它合适的存储办法而作为唯一的存储手段,但现在随着现代浏览器开始支持各种各样的存储方式,Cookie 渐渐被淘汰。新的浏览器 API 已经允许开发者直接将数据存储到本地,如使用 Web storage API(本地存储和会话存储)或 IndexedDB。
1. 用途
- 会话状态管理(如用户登录状态、购物车、游戏分数或其它需要记录的信息)
- 个性化设置(如用户自定义设置、主题等)
- 浏览器行为跟踪(如跟踪分析用户行为等)
2. 创建过程
服务器发送的响应报文包含 Set-Cookie 首部字段,客户端得到响应报文后把 Cookie 内容保存到浏览器中。
HTTP/1.0 200 OK
Content-type: text/html
Set-Cookie: yummy_cookie=choco
Set-Cookie: tasty_cookie=strawberry

[page content]
客户端之后对同一个服务器发送请求时,会从浏览器中取出 Cookie 信息并通过 Cookie 请求首部字段发送给服务器。
GET /sample_page.html HTTP/1.1
Host: www.example.org
Cookie: yummy_cookie=choco; tasty_cookie=strawberry
3. 分类
- 会话期 Cookie:浏览器关闭之后它会被自动删除,也就是说它仅在会话期内有效。
- 持久性 Cookie:指定过期时间(Expires)或有效期(max-age)之后就成为了持久性的 Cookie。
Set-Cookie: id=a3fWa; Expires=Wed, 21 Oct 2015 07:28:00 GMT;4. 作用域
Domain 标识指定了哪些主机可以接受 Cookie。如果不指定,默认为当前文档的主机(不包含子域名)。如果指定了 Domain,则一般包含子域名。例如,如果设置 Domain=mozilla.org,则 Cookie 也包含在子域名中(如 developer.mozilla.org)。
Path 标识指定了主机下的哪些路径可以接受 Cookie(该 URL 路径必须存在于请求 URL 中)。以字符 %x2F ("/") 作为路径分隔符,子路径也会被匹配。例如,设置 Path=/docs,则以下地址都会匹配:
- /docs
- /docs/Web/
- /docs/Web/HTTP
5. JavaScript
浏览器通过 document.cookie 属性可创建新的 Cookie,也可通过该属性访问非 HttpOnly 标记的 Cookie。
document.cookie = "yummy_cookie=choco";
document.cookie = "tasty_cookie=strawberry";
console.log(document.cookie);
6. HttpOnly
标记为 HttpOnly 的 Cookie 不能被 JavaScript 脚本调用。跨站脚本攻击 (XSS) 常常使用 JavaScript 的 document.cookie API 窃取用户的 Cookie 信息,因此使用 HttpOnly 标记可以在一定程度上避免 XSS 攻击。
Set-Cookie: id=a3fWa; Expires=Wed, 21 Oct 2015 07:28:00 GMT; Secure; HttpOnly7. Secure
标记为 Secure 的 Cookie 只能通过被 HTTPS 协议加密过的请求发送给服务端。但即便设置了 Secure 标记,敏感信息也不应该通过 Cookie 传输,因为 Cookie 有其固有的不安全性,Secure 标记也无法提供确实的安全保障。
8. Session
除了可以将用户信息通过 Cookie 存储在用户浏览器中,也可以利用 Session 存储在服务器端,存储在服务器端的信息更加安全。
Session 可以存储在服务器上的文件、数据库或者内存中。也可以将 Session 存储在 Redis 这种内存型数据库中,效率会更高。
使用 Session 维护用户登录状态的过程如下:
- 用户进行登录时,用户提交包含用户名和密码的表单,放入 HTTP 请求报文中;
- 服务器验证该用户名和密码,如果正确则把用户信息存储到 Redis 中,它在 Redis 中的 Key 称为 Session ID;
- 服务器返回的响应报文的 Set-Cookie 首部字段包含了这个 Session ID,客户端收到响应报文之后将该 Cookie 值存入浏览器中;
- 客户端之后对同一个服务器进行请求时会包含该 Cookie 值,服务器收到之后提取出 Session ID,从 Redis 中取出用户信息,继续之前的业务操作。
应该注意 Session ID 的安全性问题,不能让它被恶意攻击者轻易获取,那么就不能产生一个容易被猜到的 Session ID 值。此外,还需要经常重新生成 Session ID。在对安全性要求极高的场景下,例如转账等操作,除了使用 Session 管理用户状态之外,还需要对用户进行重新验证,比如重新输入密码,或者使用短信验证码等方式。
9. 浏览器禁用 Cookie
此时无法使用 Cookie 来保存用户信息,只能使用 Session。除此之外,不能再将 Session ID 存放到 Cookie 中,而是使用 URL 重写技术,将 Session ID 作为 URL 的参数进行传递。
10. Cookie 与 Session 选择
- Cookie 只能存储 ASCII 码字符串,而 Session 则可以存储任何类型的数据,因此在考虑数据复杂性时首选 Session;
- Cookie 存储在浏览器中,容易被恶意查看。如果非要将一些隐私数据存在 Cookie 中,可以将 Cookie 值进行加密,然后在服务器进行解密;
- 对于大型网站,如果用户所有的信息都存储在 Session 中,那么开销是非常大的,因此不建议将所有的用户信息都存储到 Session 中。
缓存
1. 优点
- 缓解服务器压力;
- 降低客户端获取资源的延迟:缓存通常位于内存中,读取缓存的速度更快。并且缓存服务器在地理位置上也有可能比源服务器来得近,例如浏览器缓存。
2. 实现方法
- 让代理服务器进行缓存;
- 让客户端浏览器进行缓存。
3. Cache-Control
HTTP/1.1 通过 Cache-Control 首部字段来控制缓存。
3.1 禁止进行缓存
no-store 指令规定不能对请求或响应的任何一部分进行缓存。
Cache-Control: no-store3.2 强制确认缓存
no-cache 指令规定缓存服务器需要先向源服务器验证缓存资源的有效性,只有当缓存资源有效时才能使用该缓存对客户端的请求进行响应。
Cache-Control: no-cache3.3 私有缓存和公共缓存
private 指令规定了将资源作为私有缓存,只能被单独用户使用,一般存储在用户浏览器中。
Cache-Control: privatepublic 指令规定了将资源作为公共缓存,可以被多个用户使用,一般存储在代理服务器中。
Cache-Control: public3.4 缓存过期机制
max-age 指令出现在请求报文,并且缓存资源的缓存时间小于该指令指定的时间,那么就能接受该缓存。
max-age 指令出现在响应报文,表示缓存资源在缓存服务器中保存的时间。
Cache-Control: max-age=31536000Expires 首部字段也可以用于告知缓存服务器该资源什么时候会过期。
Expires: Wed, 04 Jul 2012 08:26:05 GMT- 在 HTTP/1.1 中,会优先处理 max-age 指令;
- 在 HTTP/1.0 中,max-age 指令会被忽略掉。
4. 缓存验证
需要先了解 ETag 首部字段的含义,它是资源的唯一标识。URL 不能唯一表示资源,例如 http://www.google.com/ 有中文和英文两个资源,只有 ETag 才能对这两个资源进行唯一标识。
ETag: "82e22293907ce725faf67773957acd12"可以将缓存资源的 ETag 值放入 If-None-Match 首部,服务器收到该请求后,判断缓存资源的 ETag 值和资源的最新 ETag 值是否一致,如果一致则表示缓存资源有效,返回 304 Not Modified。
If-None-Match: "82e22293907ce725faf67773957acd12"Last-Modified 首部字段也可以用于缓存验证,它包含在源服务器发送的响应报文中,指示源服务器对资源的最后修改时间。但是它是一种弱校验器,因为只能精确到一秒,所以它通常作为 ETag 的备用方案。如果响应首部字段里含有这个信息,客户端可以在后续的请求中带上 If-Modified-Since 来验证缓存。服务器只在所请求的资源在给定的日期时间之后对内容进行过修改的情况下才会将资源返回,状态码为 200 OK。如果请求的资源从那时起未经修改,那么返回一个不带有实体主体的 304 Not Modified 响应报文。
Last-Modified: Wed, 21 Oct 2015 07:28:00 GMTIf-Modified-Since: Wed, 21 Oct 2015 07:28:00 GMT内容协商
通过内容协商返回最合适的内容,例如根据浏览器的默认语言选择返回中文界面还是英文界面。
1. 类型
1.1 服务端驱动型
客户端设置特定的 HTTP 首部字段,例如 Accept、Accept-Charset、Accept-Encoding、Accept-Language,服务器根据这些字段返回特定的资源。
它存在以下问题:
- 服务器很难知道客户端浏览器的全部信息;
- 客户端提供的信息相当冗长(HTTP/2 协议的首部压缩机制缓解了这个问题),并且存在隐私风险(HTTP 指纹识别技术);
- 给定的资源需要返回不同的展现形式,共享缓存的效率会降低,而服务器端的实现会越来越复杂。
1.2 代理驱动型
服务器返回 300 Multiple Choices 或者 406 Not Acceptable,客户端从中选出最合适的那个资源。
2. Vary
Vary: Accept-Language在使用内容协商的情况下,只有当缓存服务器中的缓存满足内容协商条件时,才能使用该缓存,否则应该向源服务器请求该资源。
例如,一个客户端发送了一个包含 Accept-Language 首部字段的请求之后,源服务器返回的响应包含 Vary: Accept-Language 内容,缓存服务器对这个响应进行缓存之后,在客户端下一次访问同一个 URL 资源,并且 Accept-Language 与缓存中的对应的值相同时才会返回该缓存。
内容编码
内容编码将实体主体进行压缩,从而减少传输的数据量。
常用的内容编码有:gzip、compress、deflate、identity。
浏览器发送 Accept-Encoding 首部,其中包含有它所支持的压缩算法,以及各自的优先级。服务器则从中选择一种,使用该算法对响应的消息主体进行压缩,并且发送 Content-Encoding 首部来告知浏览器它选择了哪一种算法。由于该内容协商过程是基于编码类型来选择资源的展现形式的,响应报文的 Vary 首部字段至少要包含 Content-Encoding。
范围请求
如果网络出现中断,服务器只发送了一部分数据,范围请求可以使得客户端只请求服务器未发送的那部分数据,从而避免服务器重新发送所有数据。
1. Range
在请求报文中添加 Range 首部字段指定请求的范围。
GET /z4d4kWk.jpg HTTP/1.1
Host: i.imgur.com
Range: bytes=0-1023
请求成功的话服务器返回的响应包含 206 Partial Content 状态码。
HTTP/1.1 206 Partial Content
Content-Range: bytes 0-1023/146515
Content-Length: 1024
...
(binary content)
2. Accept-Ranges
响应首部字段 Accept-Ranges 用于告知客户端是否能处理范围请求,可以处理使用 bytes,否则使用 none。
Accept-Ranges: bytes3. 响应状态码
- 在请求成功的情况下,服务器会返回 206 Partial Content 状态码。
- 在请求的范围越界的情况下,服务器会返回 416 Requested Range Not Satisfiable 状态码。
- 在不支持范围请求的情况下,服务器会返回 200 OK 状态码。
分块传输编码
Chunked Transfer Encoding,可以把数据分割成多块,让浏览器逐步显示页面。
多部分对象集合
一份报文主体内可含有多种类型的实体同时发送,每个部分之间用 boundary 字段定义的分隔符进行分隔,每个部分都可以有首部字段。
例如,上传多个表单时可以使用如下方式:
Content-Type: multipart/form-data; boundary=AaB03x

--AaB03x
Content-Disposition: form-data; name="submit-name"

Larry
--AaB03x
Content-Disposition: form-data; name="files"; filename="file1.txt"
Content-Type: text/plain

... contents of file1.txt ...
--AaB03x--
虚拟主机
HTTP/1.1 使用虚拟主机技术,使得一台服务器拥有多个域名,并且在逻辑上可以看成多个服务器。
通信数据转发
1. 代理
代理服务器接受客户端的请求,并且转发给其它服务器。
使用代理的主要目的是:
- 缓存
- 负载均衡
- 网络访问控制
- 访问日志记录
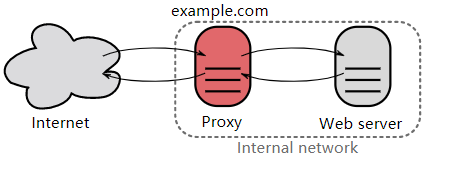
代理服务器分为正向代理和反向代理两种:
- 用户察觉得到正向代理的存在。
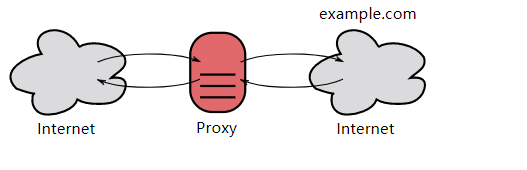
- 而反向代理一般位于内部网络中,用户察觉不到。
2. 网关
与代理服务器不同的是,网关服务器会将 HTTP 转化为其它协议进行通信,从而请求其它非 HTTP 服务器的服务。
3. 隧道
使用 SSL 等加密手段,在客户端和服务器之间建立一条安全的通信线路。
六、HTTPS
HTTP 有以下安全性问题:
- 使用明文进行通信,内容可能会被窃听;
- 不验证通信方的身份,通信方的身份有可能遭遇伪装;
- 无法证明报文的完整性,报文有可能遭篡改。
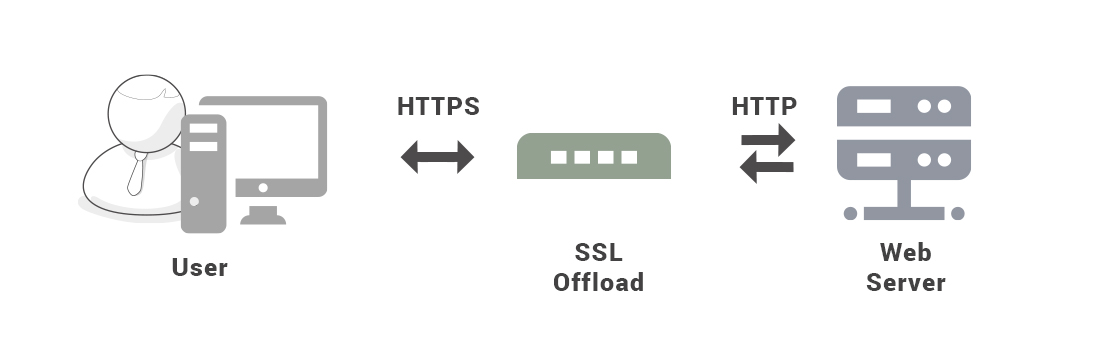
HTTPS 并不是新协议,而是让 HTTP 先和 SSL(Secure Sockets Layer)通信,再由 SSL 和 TCP 通信,也就是说 HTTPS 使用了隧道进行通信。
通过使用 SSL,HTTPS 具有了加密(防窃听)、认证(防伪装)和完整性保护(防篡改)。
加密
1. 对称密钥加密
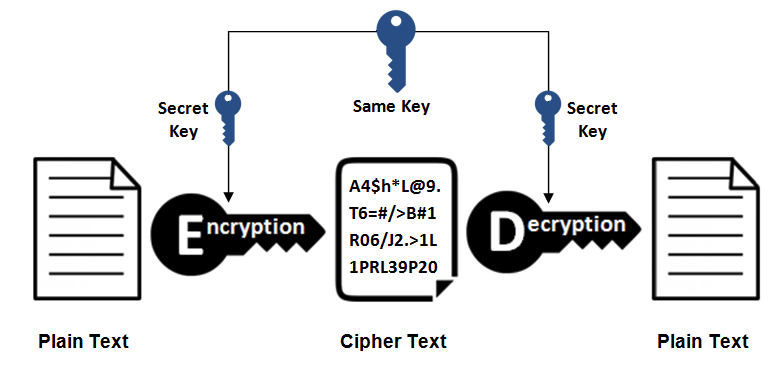
对称密钥加密(Symmetric-Key Encryption),加密和解密使用同一密钥。
- 优点:运算速度快;
- 缺点:无法安全地将密钥传输给通信方。
2.非对称密钥加密
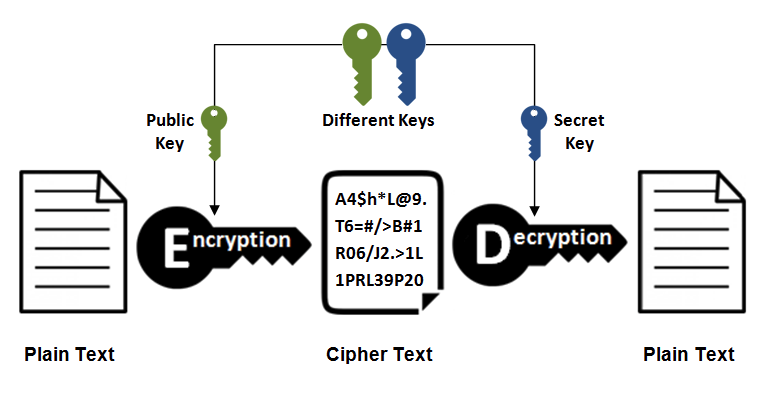
非对称密钥加密,又称公开密钥加密(Public-Key Encryption),加密和解密使用不同的密钥。
公开密钥所有人都可以获得,通信发送方获得接收方的公开密钥之后,就可以使用公开密钥进行加密,接收方收到通信内容后使用私有密钥解密。
非对称密钥除了用来加密,还可以用来进行签名。因为私有密钥无法被其他人获取,因此通信发送方使用其私有密钥进行签名,通信接收方使用发送方的公开密钥对签名进行解密,就能判断这个签名是否正确。
- 优点:可以更安全地将公开密钥传输给通信发送方;
- 缺点:运算速度慢。
3. HTTPS 采用的加密方式
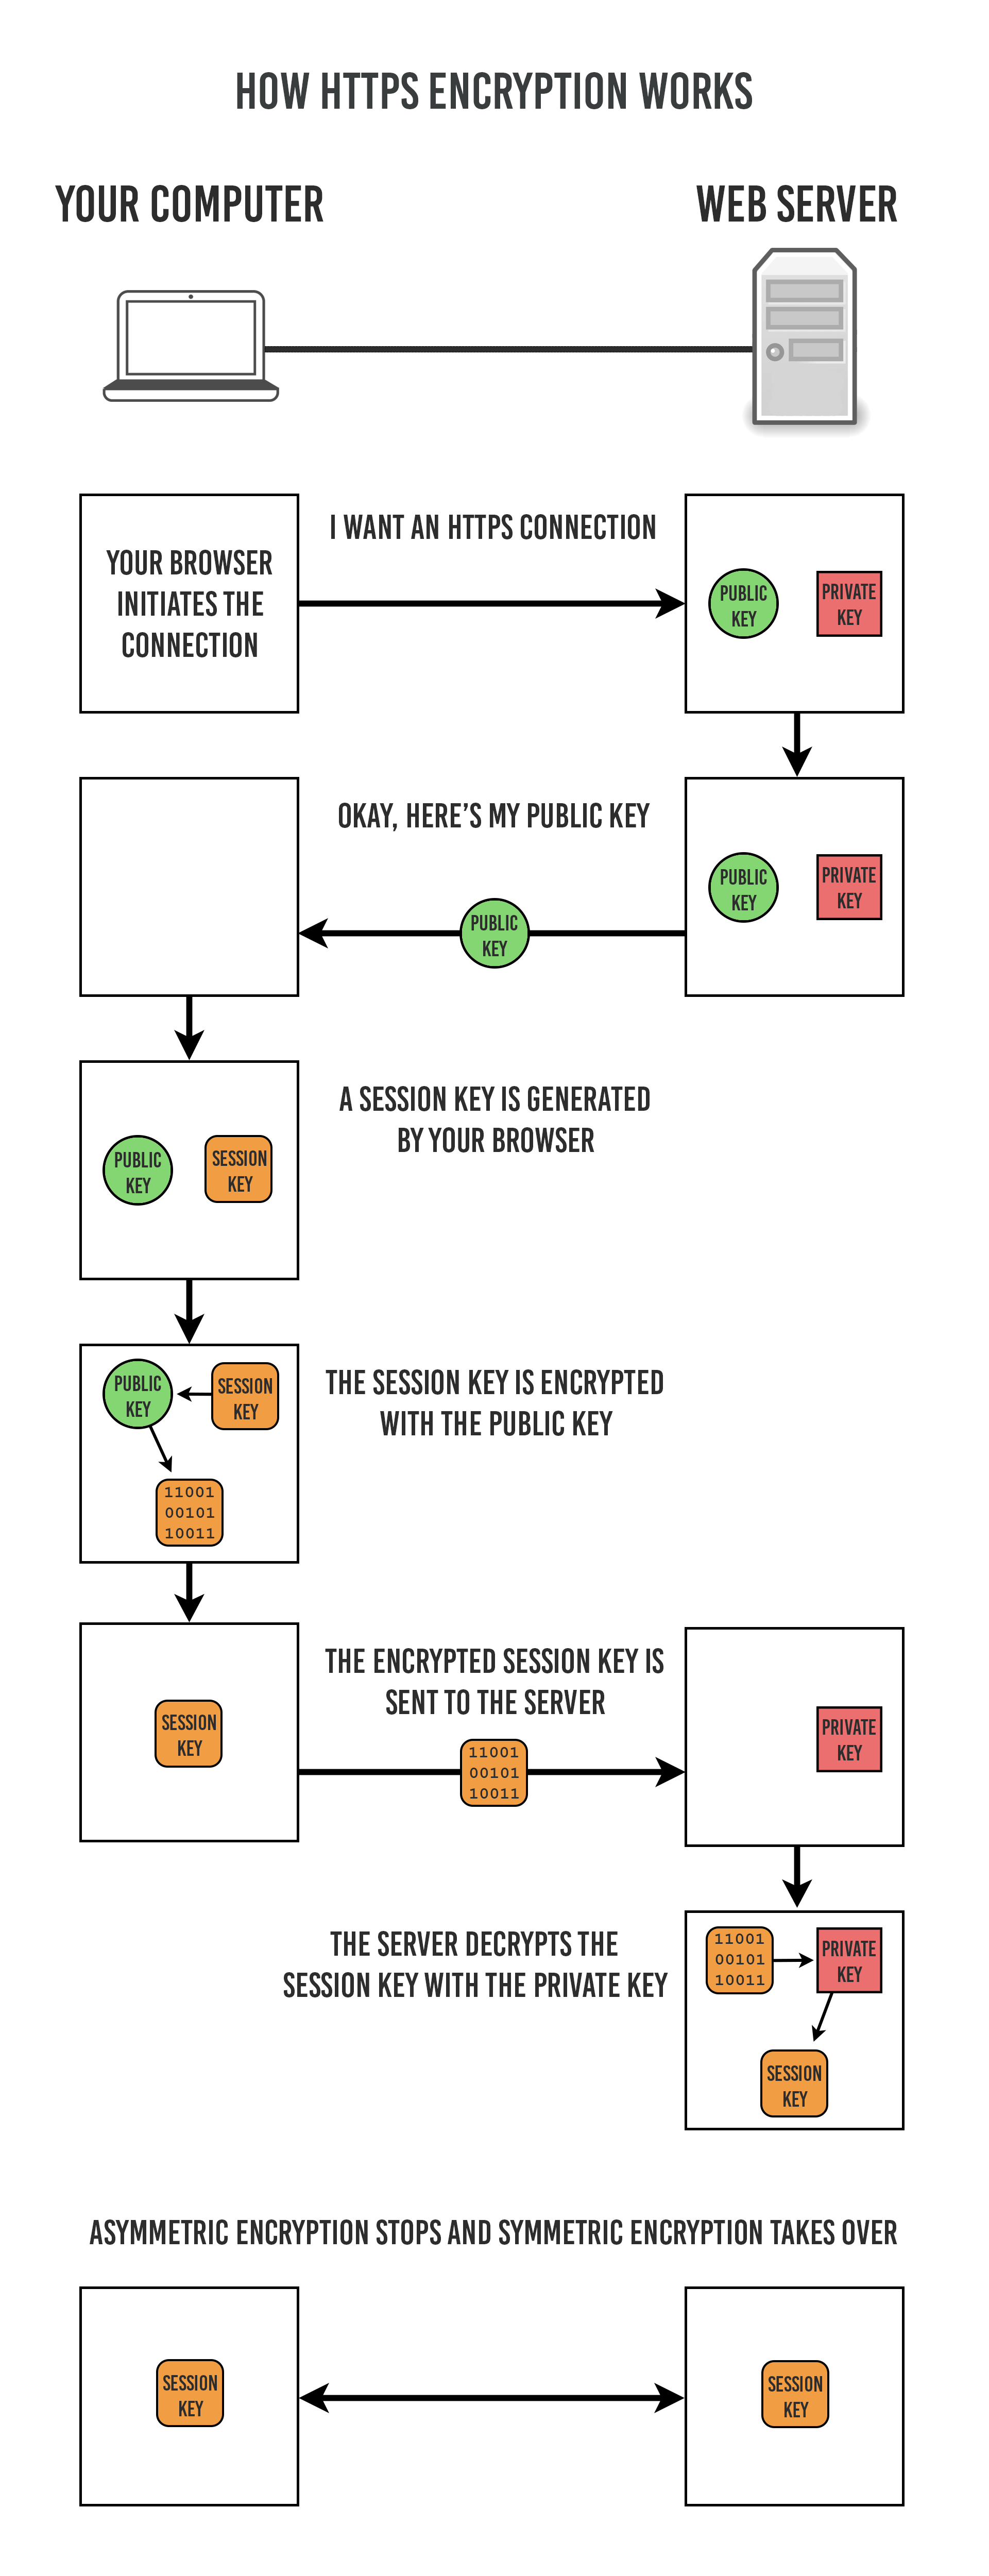
上面提到对称密钥加密方式的传输效率更高,但是无法安全地将密钥 Secret Key 传输给通信方。而非对称密钥加密方式可以保证传输的安全性,因此我们可以利用非对称密钥加密方式将 Secret Key 传输给通信方。HTTPS 采用混合的加密机制,正是利用了上面提到的方案:
- 使用非对称密钥加密方式,传输对称密钥加密方式所需要的 Secret Key,从而保证安全性;
- 获取到 Secret Key 后,再使用对称密钥加密方式进行通信,从而保证效率。(下图中的 Session Key 就是 Secret Key)
认证
通过使用 证书 来对通信方进行认证。
数字证书认证机构(CA,Certificate Authority)是客户端与服务器双方都可信赖的第三方机构。
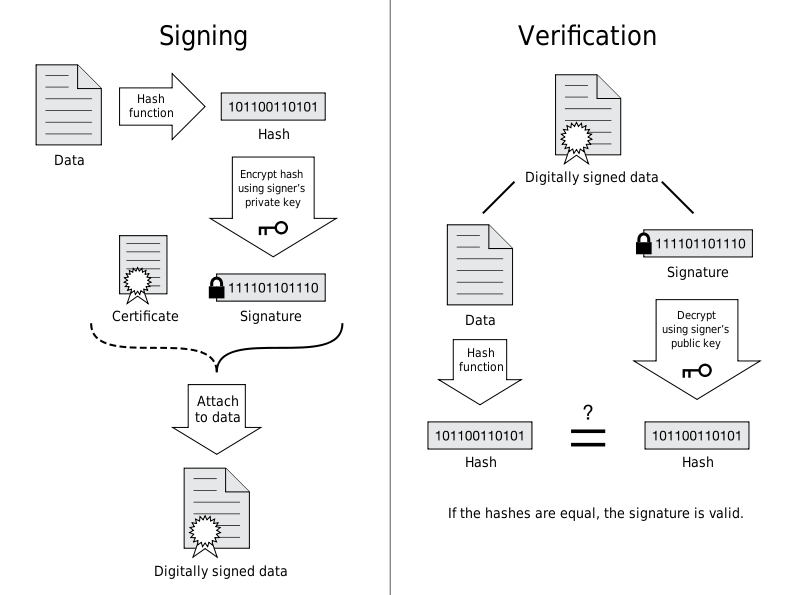
服务器的运营人员向 CA 提出公开密钥的申请,CA 在判明提出申请者的身份之后,会对已申请的公开密钥做数字签名,然后分配这个已签名的公开密钥,并将该公开密钥放入公开密钥证书后绑定在一起。
进行 HTTPS 通信时,服务器会把证书发送给客户端。客户端取得其中的公开密钥之后,先使用数字签名进行验证,如果验证通过,就可以开始通信了。
完整性保护
SSL 提供报文摘要功能来进行完整性保护。
HTTP 也提供了 MD5 报文摘要功能,但不是安全的。例如报文内容被篡改之后,同时重新计算 MD5 的值,通信接收方是无法意识到发生了篡改。
HTTPS 的报文摘要功能之所以安全,是因为它结合了加密和认证这两个操作。试想一下,加密之后的报文,遭到篡改之后,也很难重新计算报文摘要,因为无法轻易获取明文。
HTTPS 的缺点
- 因为需要进行加密解密等过程,因此速度会更慢;
- 需要支付证书授权的高额费用。
七、HTTP/2.0
HTTP/1.x 缺陷
HTTP/1.x 实现简单是以牺牲性能为代价的:
- 客户端需要使用多个连接才能实现并发和缩短延迟;
- 不会压缩请求和响应首部,从而导致不必要的网络流量;
- 不支持有效的资源优先级,致使底层 TCP 连接的利用率低下。
二进制分帧层
HTTP/2.0 将报文分成 HEADERS 帧和 DATA 帧,它们都是二进制格式的。
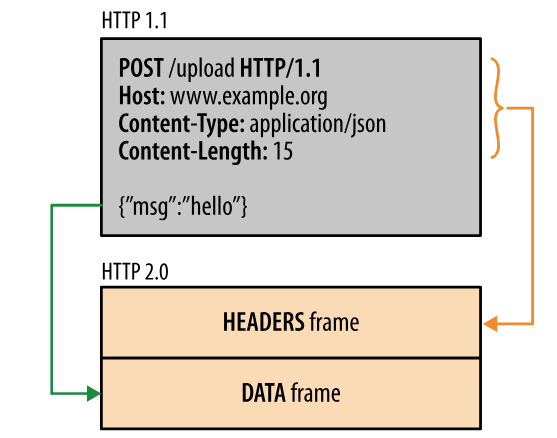
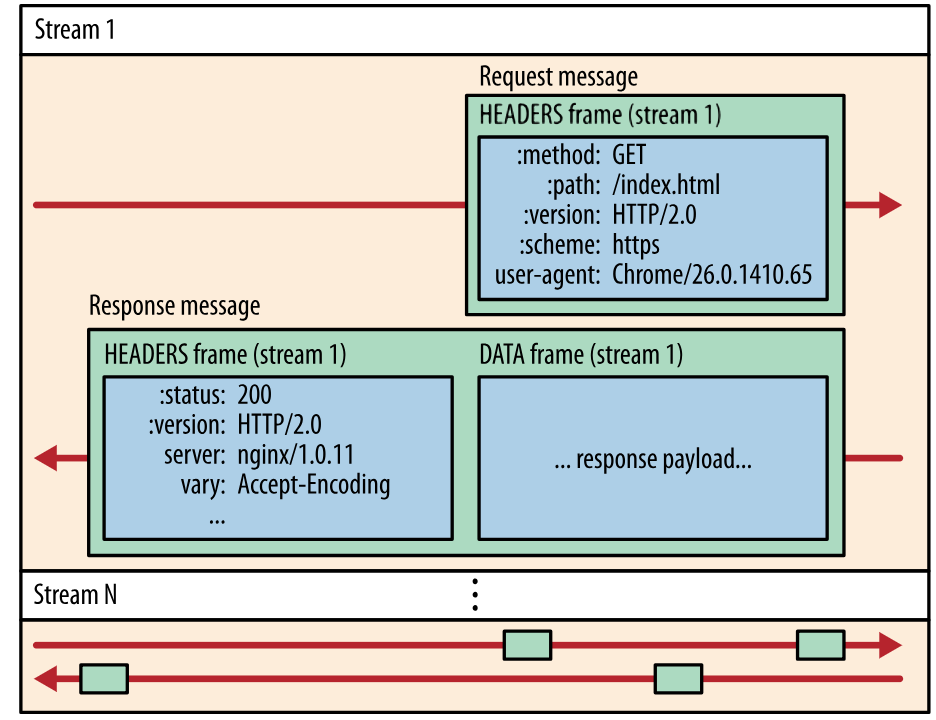
在通信过程中,只会有一个 TCP 连接存在,它承载了任意数量的双向数据流(Stream)。
- 一个数据流(Stream)都有一个唯一标识符和可选的优先级信息,用于承载双向信息。
- 消息(Message)是与逻辑请求或响应对应的完整的一系列帧。
- 帧(Frame)是最小的通信单位,来自不同数据流的帧可以交错发送,然后再根据每个帧头的数据流标识符重新组装。
服务端推送
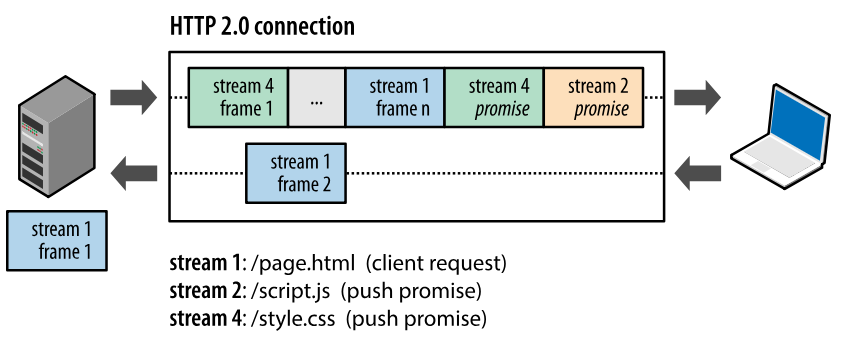
HTTP/2.0 在客户端请求一个资源时,会把相关的资源一起发送给客户端,客户端就不需要再次发起请求了。例如客户端请求 page.html 页面,服务端就把 script.js 和 style.css 等与之相关的资源一起发给客户端。
首部压缩
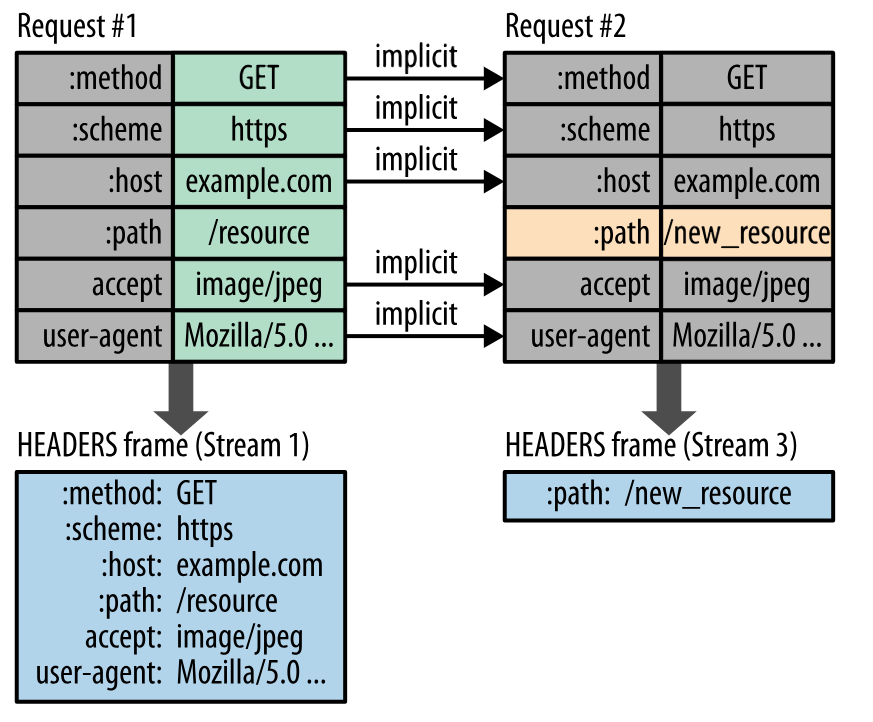
HTTP/1.1 的首部带有大量信息,而且每次都要重复发送。
HTTP/2.0 要求客户端和服务器同时维护和更新一个包含之前见过的首部字段表,从而避免了重复传输。
不仅如此,HTTP/2.0 也使用 Huffman 编码对首部字段进行压缩。
八、HTTP/1.1 新特性
详细内容请见上文
- 默认是长连接
- 支持流水线
- 支持同时打开多个 TCP 连接
- 支持虚拟主机
- 新增状态码 100
- 支持分块传输编码
- 新增缓存处理指令 max-age
九、GET 和 POST 比较
作用
GET 用于获取资源,而 POST 用于传输实体主体。
参数
GET 和 POST 的请求都能使用额外的参数,但是 GET 的参数是以查询字符串出现在 URL 中,而 POST 的参数存储在实体主体中。不能因为 POST 参数存储在实体主体中就认为它的安全性更高,因为照样可以通过一些抓包工具(Fiddler)查看。
因为 URL 只支持 ASCII 码,因此 GET 的参数中如果存在中文等字符就需要先进行编码。例如 中文 会转换为 %E4%B8%AD%E6%96%87,而空格会转换为 %20。POST 参数支持标准字符集。
GET /test/demo_form.asp?name1=value1&name2=value2 HTTP/1.1POST /test/demo_form.asp HTTP/1.1
Host: w3schools.com
name1=value1&name2=value2安全
安全的 HTTP 方法不会改变服务器状态,也就是说它只是可读的。
GET 方法是安全的,而 POST 却不是,因为 POST 的目的是传送实体主体内容,这个内容可能是用户上传的表单数据,上传成功之后,服务器可能把这个数据存储到数据库中,因此状态也就发生了改变。
安全的方法除了 GET 之外还有:HEAD、OPTIONS。
不安全的方法除了 POST 之外还有 PUT、DELETE。
幂等性
幂等的 HTTP 方法,同样的请求被执行一次与连续执行多次的效果是一样的,服务器的状态也是一样的。换句话说就是,幂等方法不应该具有副作用(统计用途除外)。
所有的安全方法也都是幂等的。
在正确实现的条件下,GET,HEAD,PUT 和 DELETE 等方法都是幂等的,而 POST 方法不是。
GET /pageX HTTP/1.1 是幂等的,连续调用多次,客户端接收到的结果都是一样的:
GET /pageX HTTP/1.1
GET /pageX HTTP/1.1
GET /pageX HTTP/1.1
GET /pageX HTTP/1.1
POST /add_row HTTP/1.1 不是幂等的,如果调用多次,就会增加多行记录:
POST /add_row HTTP/1.1   -> Adds a 1nd row
POST /add_row HTTP/1.1   -> Adds a 2nd row
POST /add_row HTTP/1.1   -> Adds a 3rd row
DELETE /idX/delete HTTP/1.1 是幂等的,即使不同的请求接收到的状态码不一样:
DELETE /idX/delete HTTP/1.1   -> Returns 200 if idX exists
DELETE /idX/delete HTTP/1.1   -> Returns 404 as it just got deleted
DELETE /idX/delete HTTP/1.1   -> Returns 404
可缓存
如果要对响应进行缓存,需要满足以下条件:
- 请求报文的 HTTP 方法本身是可缓存的,包括 GET 和 HEAD,但是 PUT 和 DELETE 不可缓存,POST 在多数情况下不可缓存的。
- 响应报文的状态码是可缓存的,包括:200, 203, 204, 206, 300, 301, 404, 405, 410, 414, and 501。
- 响应报文的 Cache-Control 首部字段没有指定不进行缓存。
XMLHttpRequest
为了阐述 POST 和 GET 的另一个区别,需要先了解 XMLHttpRequest:
XMLHttpRequest 是一个 API,它为客户端提供了在客户端和服务器之间传输数据的功能。它提供了一个通过 URL 来获取数据的简单方式,并且不会使整个页面刷新。这使得网页只更新一部分页面而不会打扰到用户。XMLHttpRequest 在 AJAX 中被大量使用。
- 在使用 XMLHttpRequest 的 POST 方法时,浏览器会先发送 Header 再发送 Data。但并不是所有浏览器会这么做,例如火狐就不会。
- 而 GET 方法 Header 和 Data 会一起发送。
参考资料
- 上野宣. 图解 HTTP[M]. 人民邮电出版社, 2014.
- MDN : HTTP
- HTTP/2 简介
- htmlspecialchars
- Difference between file URI and URL in java
- How to Fix SQL Injection Using Java PreparedStatement & CallableStatement
- 浅谈 HTTP 中 Get 与 Post 的区别
- Are http:// and www really necessary?
- HTTP (HyperText Transfer Protocol)
- Web-VPN: Secure Proxies with SPDY & Chrome
- File:HTTP persistent connection.svg
- Proxy server
- What Is This HTTPS/SSL Thing And Why Should You Care?
- What is SSL Offloading?
- Sun Directory Server Enterprise Edition 7.0 Reference - Key Encryption
- An Introduction to Mutual SSL Authentication
- The Difference Between URLs and URIs
- Cookie 与 Session 的区别
- COOKIE 和 SESSION 有什么区别
- Cookie/Session 的机制与安全
- HTTPS 证书原理
- What is the difference between a URI, a URL and a URN?
- XMLHttpRequest
- XMLHttpRequest (XHR) Uses Multiple Packets for HTTP POST?
- Symmetric vs. Asymmetric Encryption – What are differences?
- Web 性能优化与 HTTP/2
- HTTP/2 简介
Socket
Socket
* [一、I/O 模型](#一io-模型)
    * [阻塞式 I/O](#阻塞式-io)
    * [非阻塞式 I/O](#非阻塞式-io)
    * [I/O 复用](#io-复用)
    * [信号驱动 I/O](#信号驱动-io)
    * [异步 I/O](#异步-io)
    * [五大 I/O 模型比较](#五大-io-模型比较)
* [二、I/O 复用](#二io-复用)
    * [select](#select)
    * [poll](#poll)
    * [比较](#比较)
    * [epoll](#epoll)
    * [工作模式](#工作模式)
    * [应用场景](#应用场景)
* [参考资料](#参考资料)
一、I/O 模型
一个输入操作通常包括两个阶段:
- 等待数据准备好
- 从内核向进程复制数据
对于一个套接字上的输入操作,第一步通常涉及等待数据从网络中到达。当所等待数据到达时,它被复制到内核中的某个缓冲区。第二步就是把数据从内核缓冲区复制到应用进程缓冲区。
Unix 有五种 I/O 模型:
- 阻塞式 I/O
- 非阻塞式 I/O
- I/O 复用(select 和 poll)
- 信号驱动式 I/O(SIGIO)
- 异步 I/O(AIO)
阻塞式 I/O
应用进程被阻塞,直到数据从内核缓冲区复制到应用进程缓冲区中才返回。
应该注意到,在阻塞的过程中,其它应用进程还可以执行,因此阻塞不意味着整个操作系统都被阻塞。因为其它应用进程还可以执行,所以不消耗 CPU 时间,这种模型的 CPU 利用率会比较高。
下图中,recvfrom() 用于接收 Socket 传来的数据,并复制到应用进程的缓冲区 buf 中。这里把 recvfrom() 当成系统调用。
ssize_t recvfrom(int sockfd, void *buf, size_t len, int flags, struct sockaddr *src_addr, socklen_t *addrlen);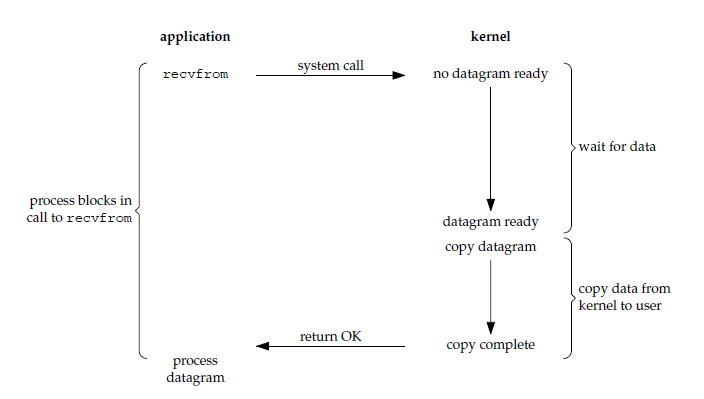
非阻塞式 I/O
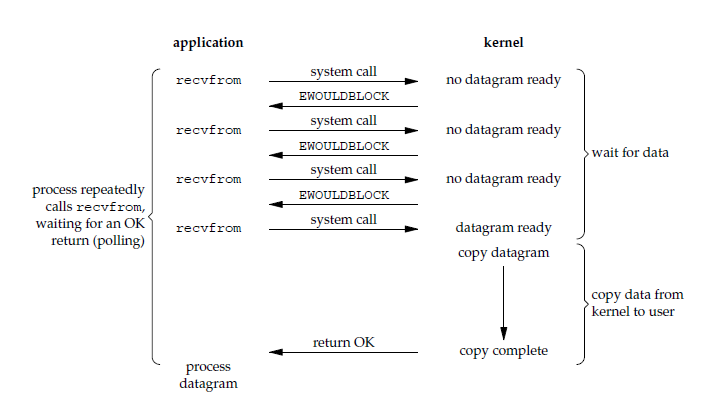
应用进程执行系统调用之后,内核返回一个错误码。应用进程可以继续执行,但是需要不断的执行系统调用来获知 I/O 是否完成,这种方式称为轮询(polling)。
由于 CPU 要处理更多的系统调用,因此这种模型的 CPU 利用率比较低。
I/O 复用
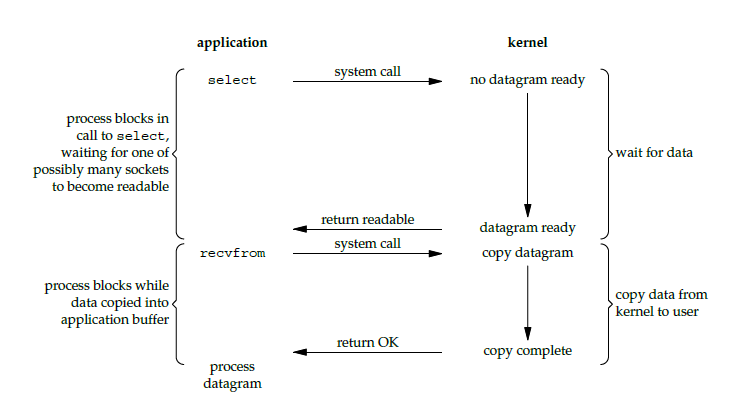
使用 select 或者 poll 等待数据,并且可以等待多个套接字中的任何一个变为可读。这一过程会被阻塞,当某一个套接字可读时返回,之后再使用 recvfrom 把数据从内核复制到进程中。
它可以让单个进程具有处理多个 I/O 事件的能力。又被称为 Event Driven I/O,即事件驱动 I/O。
如果一个 Web 服务器没有 I/O 复用,那么每一个 Socket 连接都需要创建一个线程去处理。如果同时有几万个连接,那么就需要创建相同数量的线程。相比于多进程和多线程技术,I/O 复用不需要进程线程创建和切换的开销,系统开销更小。
信号驱动 I/O
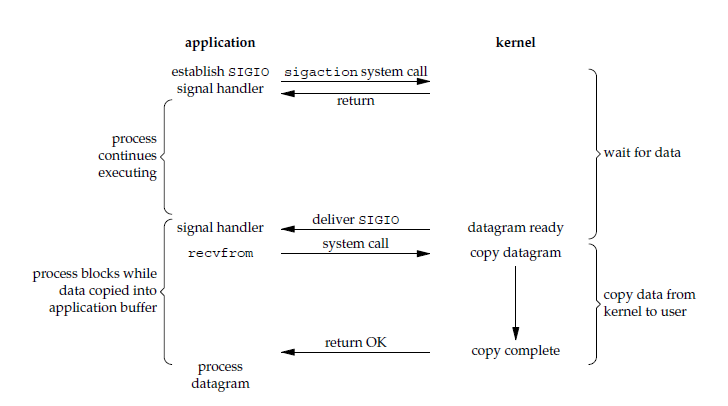
应用进程使用 sigaction 系统调用,内核立即返回,应用进程可以继续执行,也就是说等待数据阶段应用进程是非阻塞的。内核在数据到达时向应用进程发送 SIGIO 信号,应用进程收到之后在信号处理程序中调用 recvfrom 将数据从内核复制到应用进程中。
相比于非阻塞式 I/O 的轮询方式,信号驱动 I/O 的 CPU 利用率更高。
异步 I/O
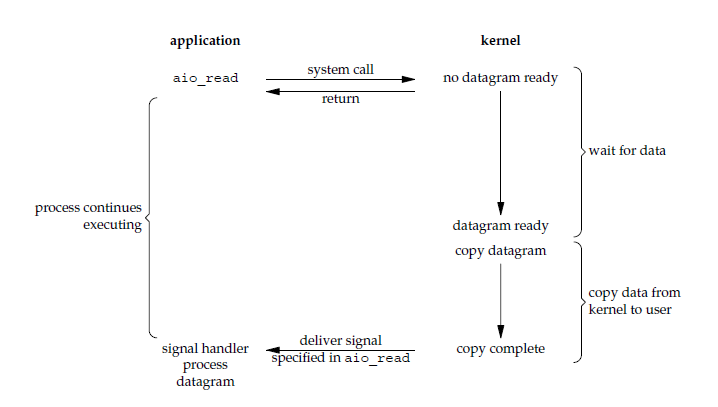
应用进程执行 aio_read 系统调用会立即返回,应用进程可以继续执行,不会被阻塞,内核会在所有操作完成之后向应用进程发送信号。
异步 I/O 与信号驱动 I/O 的区别在于,异步 I/O 的信号是通知应用进程 I/O 完成,而信号驱动 I/O 的信号是通知应用进程可以开始 I/O。
五大 I/O 模型比较
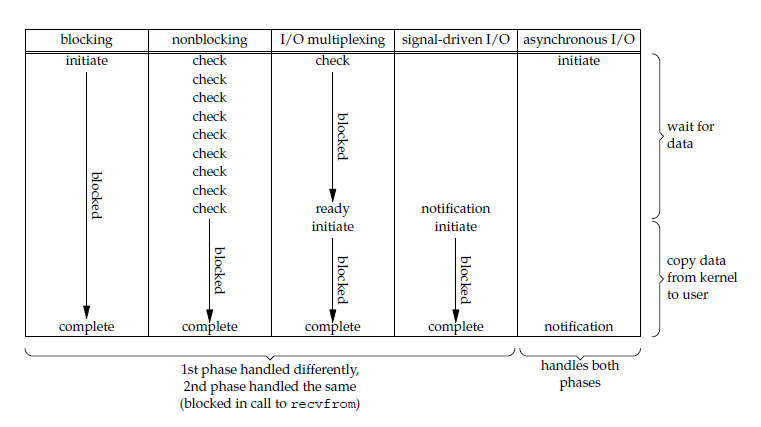
- 同步 I/O:将数据从内核缓冲区复制到应用进程缓冲区的阶段(第二阶段),应用进程会阻塞。
- 异步 I/O:第二阶段应用进程不会阻塞。
同步 I/O 包括阻塞式 I/O、非阻塞式 I/O、I/O 复用和信号驱动 I/O ,它们的主要区别在第一个阶段。
非阻塞式 I/O 、信号驱动 I/O 和异步 I/O 在第一阶段不会阻塞。
二、I/O 复用
select/poll/epoll 都是 I/O 多路复用的具体实现,select 出现的最早,之后是 poll,再是 epoll。
select
int select(int n, fd_set *readfds, fd_set *writefds, fd_set *exceptfds, struct timeval *timeout);select 允许应用程序监视一组文件描述符,等待一个或者多个描述符成为就绪状态,从而完成 I/O 操作。
- fd_set 使用数组实现,数组大小使用 FD_SETSIZE 定义,所以只能监听少于 FD_SETSIZE 数量的描述符。有三种类型的描述符类型:readset、writeset、exceptset,分别对应读、写、异常条件的描述符集合。
- timeout 为超时参数,调用 select 会一直阻塞直到有描述符的事件到达或者等待的时间超过 timeout。
- 成功调用返回结果大于 0,出错返回结果为 -1,超时返回结果为 0。
fd_set fd_in, fd_out;
struct timeval tv;

// Reset the sets
FD_ZERO( &fd_in );
FD_ZERO( &fd_out );

// Monitor sock1 for input events
FD_SET( sock1, &fd_in );

// Monitor sock2 for output events
FD_SET( sock2, &fd_out );

// Find out which socket has the largest numeric value as select requires it
int largest_sock = sock1 > sock2 ? sock1 : sock2;

// Wait up to 10 seconds
tv.tv_sec = 10;
tv.tv_usec = 0;

// Call the select
int ret = select( largest_sock + 1, &fd_in, &fd_out, NULL, &tv );

// Check if select actually succeed
if ( ret == -1 )
    // report error and abort
else if ( ret == 0 )
    // timeout; no event detected
else
{
    if ( FD_ISSET( sock1, &fd_in ) )
        // input event on sock1

    if ( FD_ISSET( sock2, &fd_out ) )
        // output event on sock2
}
poll
int poll(struct pollfd *fds, unsigned int nfds, int timeout);poll 的功能与 select 类似,也是等待一组描述符中的一个成为就绪状态。
poll 中的描述符是 pollfd 类型的数组,pollfd 的定义如下:
struct pollfd {
               int   fd;         /* file descriptor */
               short events;     /* requested events */
               short revents;    /* returned events */
           };
// The structure for two events
struct pollfd fds[2];
// Monitor sock1 for input
fds[0].fd = sock1;
fds[0].events = POLLIN;
// Monitor sock2 for output
fds[1].fd = sock2;
fds[1].events = POLLOUT;
// Wait 10 seconds
int ret = poll( &fds, 2, 10000 );
// Check if poll actually succeed
if ( ret == -1 )
// report error and abort
else if ( ret == 0 )
// timeout; no event detected
else
{
// If we detect the event, zero it out so we can reuse the structure
if ( fds[0].revents & POLLIN )
fds[0].revents = 0;
// input event on sock1
if ( fds[1].revents & POLLOUT )
fds[1].revents = 0;
// output event on sock2
}比较
1. 功能
select 和 poll 的功能基本相同,不过在一些实现细节上有所不同。
- select 会修改描述符,而 poll 不会;
- select 的描述符类型使用数组实现,FD_SETSIZE 大小默认为 1024,因此默认只能监听少于 1024 个描述符。如果要监听更多描述符的话,需要修改 FD_SETSIZE 之后重新编译;而 poll 没有描述符数量的限制;
- poll 提供了更多的事件类型,并且对描述符的重复利用上比 select 高。
- 如果一个线程对某个描述符调用了 select 或者 poll,另一个线程关闭了该描述符,会导致调用结果不确定。
2. 速度
select 和 poll 速度都比较慢,每次调用都需要将全部描述符从应用进程缓冲区复制到内核缓冲区。
3. 可移植性
几乎所有的系统都支持 select,但是只有比较新的系统支持 poll。
epoll
int epoll_create(int size);
int epoll_ctl(int epfd, int op, int fd, struct epoll_event *event);
int epoll_wait(int epfd, struct epoll_event * events, int maxevents, int timeout);
epoll_ctl() 用于向内核注册新的描述符或者是改变某个文件描述符的状态。已注册的描述符在内核中会被维护在一棵红黑树上,通过回调函数内核会将 I/O 准备好的描述符加入到一个链表中管理,进程调用 epoll_wait() 便可以得到事件完成的描述符。
从上面的描述可以看出,epoll 只需要将描述符从进程缓冲区向内核缓冲区拷贝一次,并且进程不需要通过轮询来获得事件完成的描述符。
epoll 仅适用于 Linux OS。
epoll 比 select 和 poll 更加灵活而且没有描述符数量限制。
epoll 对多线程编程更有友好,一个线程调用了 epoll_wait() 另一个线程关闭了同一个描述符也不会产生像 select 和 poll 的不确定情况。
// Create the epoll descriptor. Only one is needed per app, and is used to monitor all sockets.
// The function argument is ignored (it was not before, but now it is), so put your favorite number here
int pollingfd = epoll_create( 0xCAFE );

if ( pollingfd < 0 )
 // report error

// Initialize the epoll structure in case more members are added in future
struct epoll_event ev = { 0 };

// Associate the connection class instance with the event. You can associate anything
// you want, epoll does not use this information. We store a connection class pointer, pConnection1
ev.data.ptr = pConnection1;

// Monitor for input, and do not automatically rearm the descriptor after the event
ev.events = EPOLLIN | EPOLLONESHOT;
// Add the descriptor into the monitoring list. We can do it even if another thread is
// waiting in epoll_wait - the descriptor will be properly added
if ( epoll_ctl( epollfd, EPOLL_CTL_ADD, pConnection1->getSocket(), &ev ) != 0 )
    // report error

// Wait for up to 20 events (assuming we have added maybe 200 sockets before that it may happen)
struct epoll_event pevents[ 20 ];

// Wait for 10 seconds, and retrieve less than 20 epoll_event and store them into epoll_event array
int ready = epoll_wait( pollingfd, pevents, 20, 10000 );
// Check if epoll actually succeed
if ( ret == -1 )
    // report error and abort
else if ( ret == 0 )
    // timeout; no event detected
else
{
    // Check if any events detected
    for ( int i = 0; i < ready; i++ )
    {
        if ( pevents[i].events & EPOLLIN )
        {
            // Get back our connection pointer
            Connection * c = (Connection*) pevents[i].data.ptr;
            c->handleReadEvent();
         }
    }
}
工作模式
epoll 的描述符事件有两种触发模式:LT(level trigger)和 ET(edge trigger)。
1. LT 模式
当 epoll_wait() 检测到描述符事件到达时,将此事件通知进程,进程可以不立即处理该事件,下次调用 epoll_wait() 会再次通知进程。是默认的一种模式,并且同时支持 Blocking 和 No-Blocking。
2. ET 模式
和 LT 模式不同的是,通知之后进程必须立即处理事件,下次再调用 epoll_wait() 时不会再得到事件到达的通知。
很大程度上减少了 epoll 事件被重复触发的次数,因此效率要比 LT 模式高。只支持 No-Blocking,以避免由于一个文件句柄的阻塞读/阻塞写操作把处理多个文件描述符的任务饿死。
应用场景
很容易产生一种错觉认为只要用 epoll 就可以了,select 和 poll 都已经过时了,其实它们都有各自的使用场景。
1. select 应用场景
select 的 timeout 参数精度为微秒,而 poll 和 epoll 为毫秒,因此 select 更加适用于实时性要求比较高的场景,比如核反应堆的控制。
select 可移植性更好,几乎被所有主流平台所支持。
2. poll 应用场景
poll 没有最大描述符数量的限制,如果平台支持并且对实时性要求不高,应该使用 poll 而不是 select。
3. epoll 应用场景
只需要运行在 Linux 平台上,有大量的描述符需要同时轮询,并且这些连接最好是长连接。
需要同时监控小于 1000 个描述符,就没有必要使用 epoll,因为这个应用场景下并不能体现 epoll 的优势。
需要监控的描述符状态变化多,而且都是非常短暂的,也没有必要使用 epoll。因为 epoll 中的所有描述符都存储在内核中,造成每次需要对描述符的状态改变都需要通过 epoll_ctl() 进行系统调用,频繁系统调用降低效率。并且 epoll 的描述符存储在内核,不容易调试。
参考资料
- Stevens W R, Fenner B, Rudoff A M. UNIX network programming[M]. Addison-Wesley Professional, 2004.
- http://man7.org/linux/man-pages/man2/select.2.html
- http://man7.org/linux/man-pages/man2/poll.2.html
- Boost application performance using asynchronous I/O
- Synchronous and Asynchronous I/O.aspx)
- Linux IO 模式及 select、poll、epoll 详解
- poll vs select vs event-based
- select / poll / epoll: practical difference for system architects
- Browse the source code of userspace/glibc/sysdeps/unix/sysv/linux/ online
数据库系统原理
数据库系统原理
* [一、事务](#一事务)
    * [概念](#概念)
    * [ACID](#acid)
    * [AUTOCOMMIT](#autocommit)
* [二、并发一致性问题](#二并发一致性问题)
    * [丢失修改](#丢失修改)
    * [读脏数据](#读脏数据)
    * [不可重复读](#不可重复读)
    * [幻影读](#幻影读)
* [三、封锁](#三封锁)
    * [封锁粒度](#封锁粒度)
    * [封锁类型](#封锁类型)
    * [封锁协议](#封锁协议)
    * [MySQL 隐式与显式锁定](#mysql-隐式与显式锁定)
* [四、隔离级别](#四隔离级别)
    * [未提交读(READ UNCOMMITTED)](#未提交读read-uncommitted)
    * [提交读(READ COMMITTED)](#提交读read-committed)
    * [可重复读(REPEATABLE READ)](#可重复读repeatable-read)
    * [可串行化(SERIALIZABLE)](#可串行化serializable)
* [五、多版本并发控制](#五多版本并发控制)
    * [基本思想](#基本思想)
    * [版本号](#版本号)
    * [Undo 日志](#undo-日志)
    * [ReadView](#readview)
    * [快照读与当前读](#快照读与当前读)
* [六、Next-Key Locks](#六next-key-locks)
    * [Record Locks](#record-locks)
    * [Gap Locks](#gap-locks)
    * [Next-Key Locks](#next-key-locks)
* [七、关系数据库设计理论](#七关系数据库设计理论)
    * [函数依赖](#函数依赖)
    * [异常](#异常)
    * [范式](#范式)
* [八、ER 图](#八er-图)
    * [实体的三种联系](#实体的三种联系)
    * [表示出现多次的关系](#表示出现多次的关系)
    * [联系的多向性](#联系的多向性)
    * [表示子类](#表示子类)
* [参考资料](#参考资料)
一、事务
概念
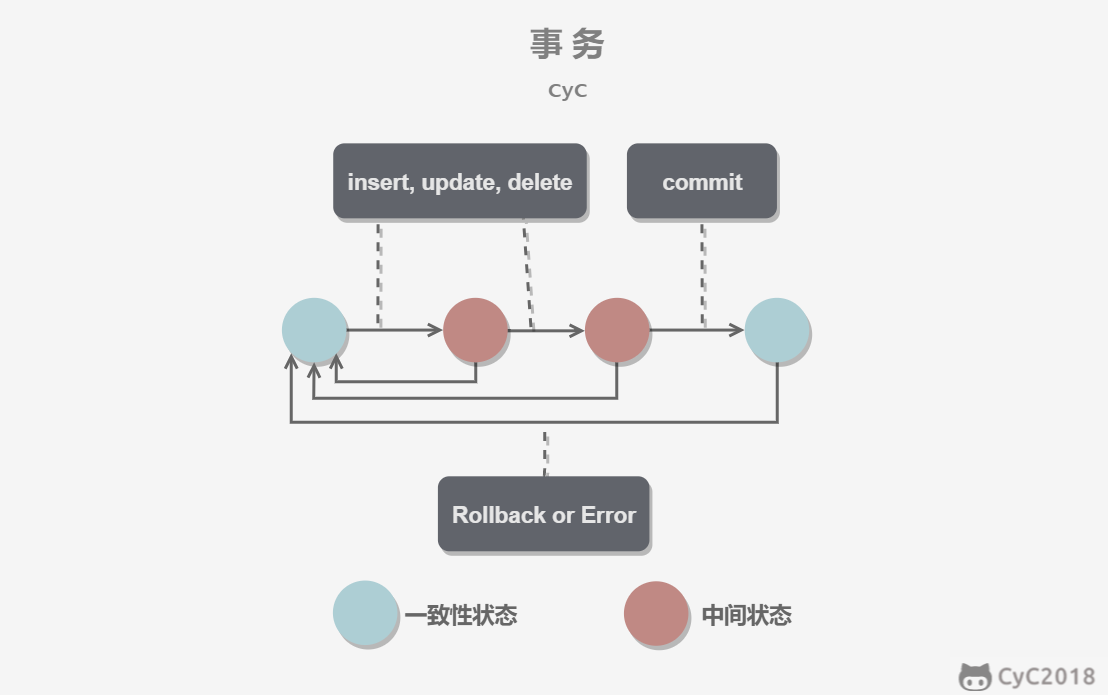
事务指的是满足 ACID 特性的一组操作,可以通过 Commit 提交一个事务,也可以使用 Rollback 进行回滚。
ACID
1. 原子性(Atomicity)
事务被视为不可分割的最小单元,事务的所有操作要么全部提交成功,要么全部失败回滚。
回滚可以用回滚日志(Undo Log)来实现,回滚日志记录着事务所执行的修改操作,在回滚时反向执行这些修改操作即可。
2. 一致性(Consistency)
数据库在事务执行前后都保持一致性状态。在一致性状态下,所有事务对同一个数据的读取结果都是相同的。
3. 隔离性(Isolation)
一个事务所做的修改在最终提交以前,对其它事务是不可见的。
4. 持久性(Durability)
一旦事务提交,则其所做的修改将会永远保存到数据库中。即使系统发生崩溃,事务执行的结果也不能丢失。
系统发生崩溃可以用重做日志(Redo Log)进行恢复,从而实现持久性。与回滚日志记录数据的逻辑修改不同,重做日志记录的是数据页的物理修改。
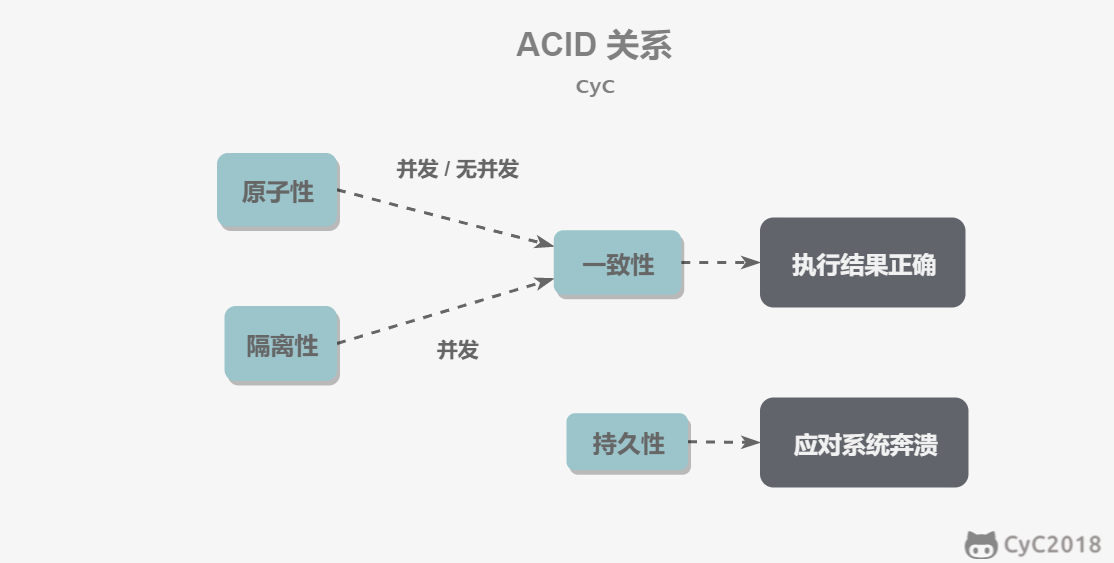
事务的 ACID 特性概念简单,但不是很好理解,主要是因为这几个特性不是一种平级关系:
- 只有满足一致性,事务的执行结果才是正确的。
- 在无并发的情况下,事务串行执行,隔离性一定能够满足。此时只要能满足原子性,就一定能满足一致性。
- 在并发的情况下,多个事务并行执行,事务不仅要满足原子性,还需要满足隔离性,才能满足一致性。
- 事务满足持久化是为了能应对系统崩溃的情况。
AUTOCOMMIT
MySQL 默认采用自动提交模式。也就是说,如果不显式使用START TRANSACTION语句来开始一个事务,那么每个查询操作都会被当做一个事务并自动提交。
二、并发一致性问题
在并发环境下,事务的隔离性很难保证,因此会出现很多并发一致性问题。
丢失修改
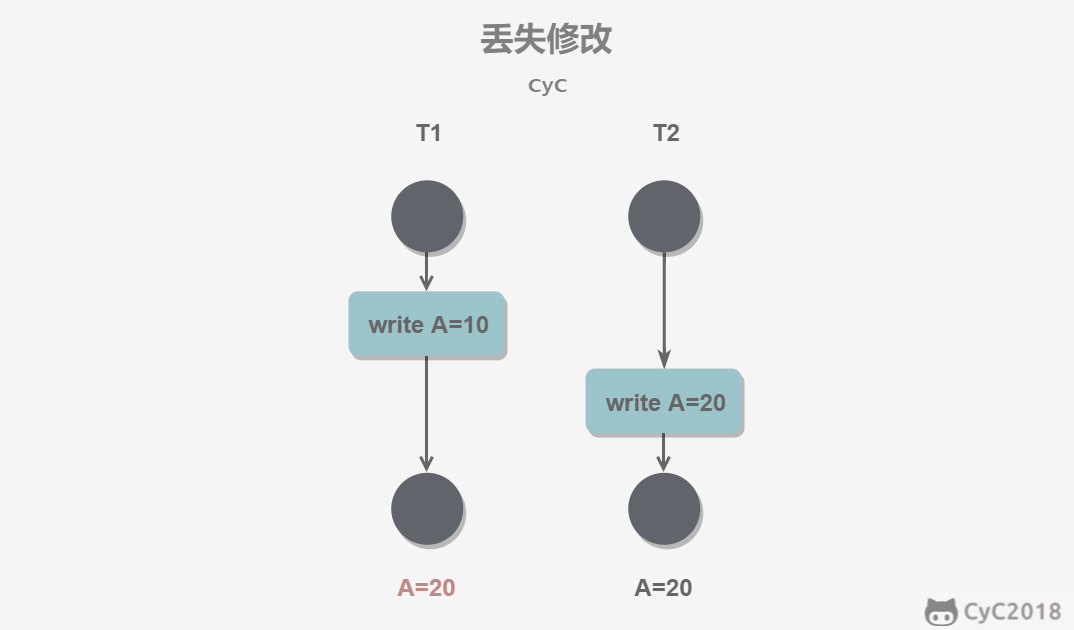
丢失修改指一个事务的更新操作被另外一个事务的更新操作替换。一般在现实生活中常会遇到,例如:T1 和 T2 两个事务都对一个数据进行修改,T1 先修改并提交生效,T2 随后修改,T2 的修改覆盖了 T1 的修改。
读脏数据
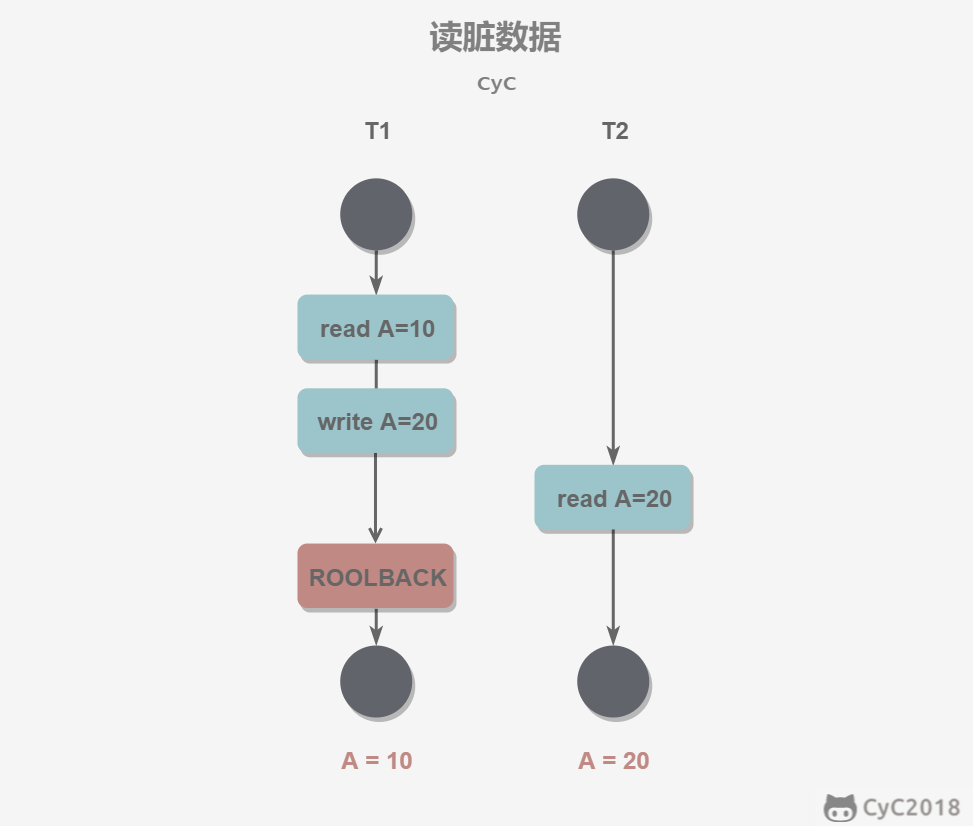
读脏数据指在不同的事务下,当前事务可以读到另外事务未提交的数据。例如:T1 修改一个数据但未提交,T2 随后读取这个数据。如果 T1 撤销了这次修改,那么 T2 读取的数据是脏数据。
不可重复读
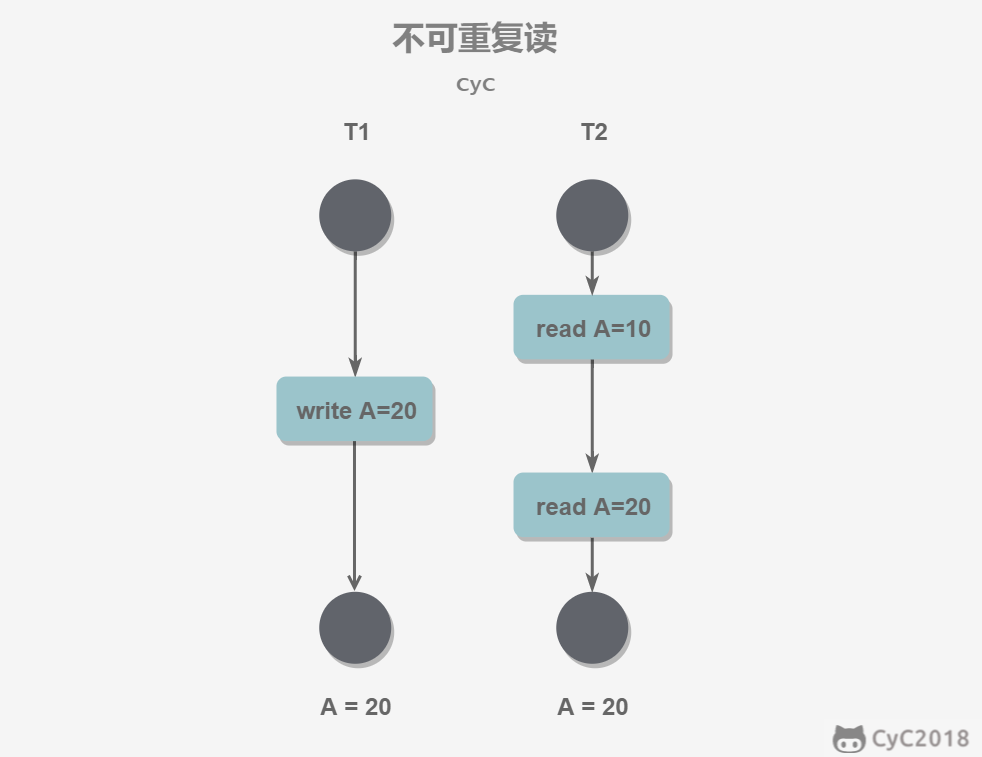
不可重复读指在一个事务内多次读取同一数据集合。在这一事务还未结束前,另一事务也访问了该同一数据集合并做了修改,由于第二个事务的修改,第一次事务的两次读取的数据可能不一致。例如:T2 读取一个数据,T1 对该数据做了修改。如果 T2 再次读取这个数据,此时读取的结果和第一次读取的结果不同。
幻影读
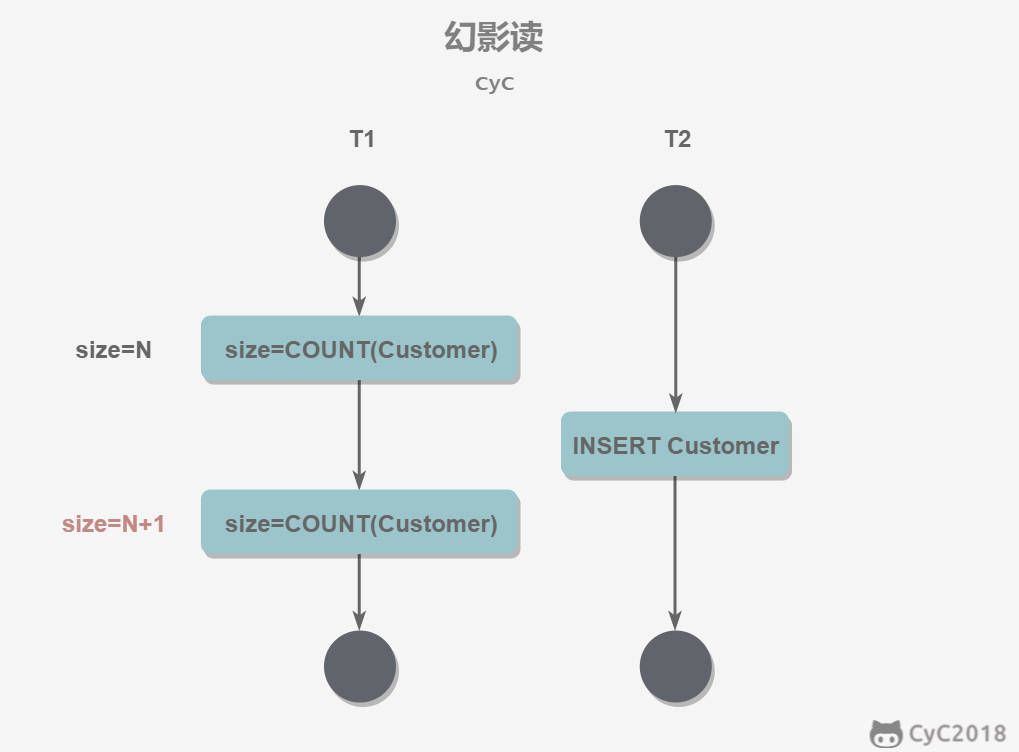
幻读本质上也属于不可重复读的情况,T1 读取某个范围的数据,T2 在这个范围内插入新的数据,T1 再次读取这个范围的数据,此时读取的结果和和第一次读取的结果不同。
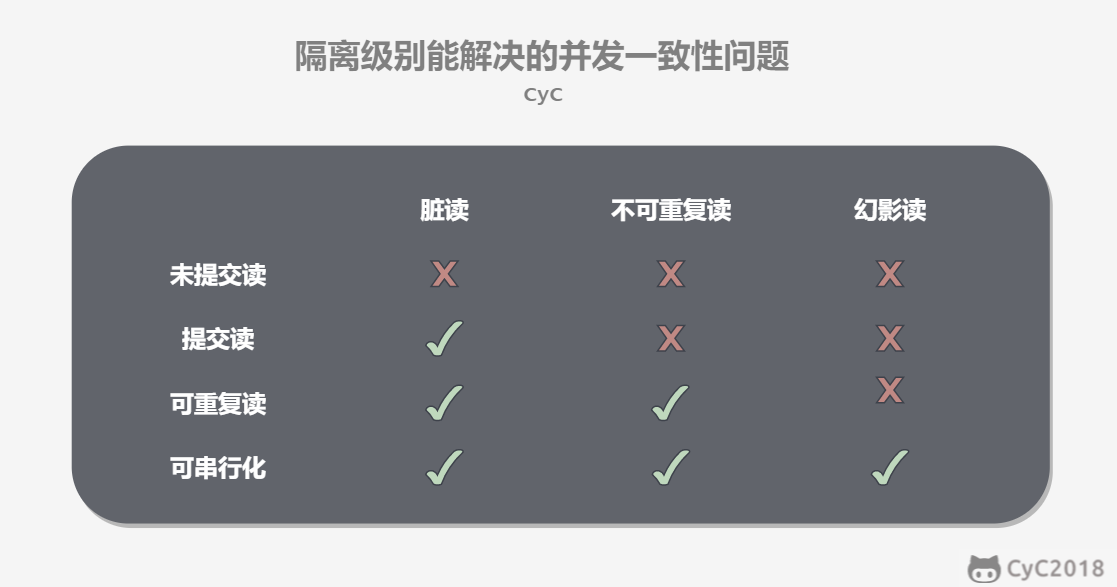
产生并发不一致性问题的主要原因是破坏了事务的隔离性,解决方法是通过并发控制来保证隔离性。并发控制可以通过封锁来实现,但是封锁操作需要用户自己控制,相当复杂。数据库管理系统提供了事务的隔离级别,让用户以一种更轻松的方式处理并发一致性问题。
三、封锁
封锁粒度
MySQL 中提供了两种封锁粒度:行级锁以及表级锁。
应该尽量只锁定需要修改的那部分数据,而不是所有的资源。锁定的数据量越少,发生锁争用的可能就越小,系统的并发程度就越高。
但是加锁需要消耗资源,锁的各种操作(包括获取锁、释放锁、以及检查锁状态)都会增加系统开销。因此封锁粒度越小,系统开销就越大。
在选择封锁粒度时,需要在锁开销和并发程度之间做一个权衡。
封锁类型
1. 读写锁
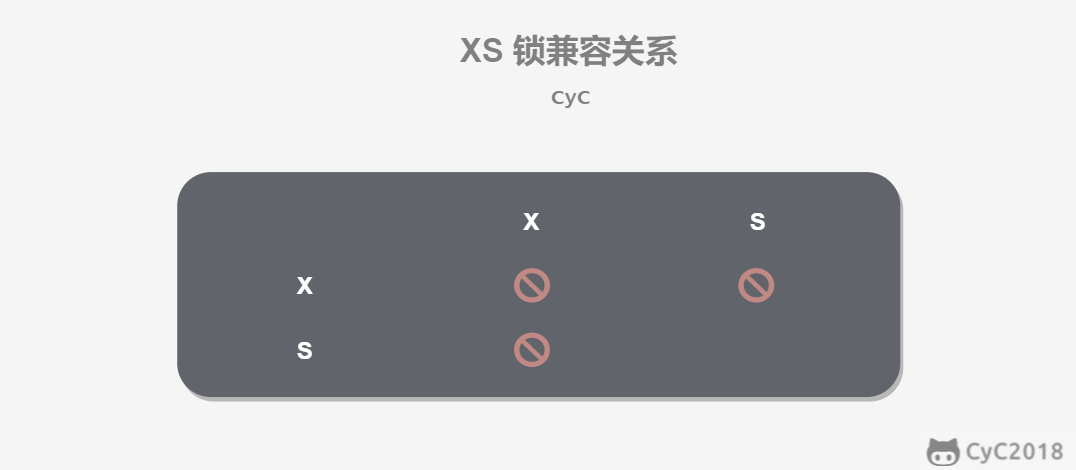
- 互斥锁(Exclusive),简写为 X 锁,又称写锁。
- 共享锁(Shared),简写为 S 锁,又称读锁。
有以下两个规定:
- 一个事务对数据对象 A 加了 X 锁,就可以对 A 进行读取和更新。加锁期间其它事务不能对 A 加任何锁。
- 一个事务对数据对象 A 加了 S 锁,可以对 A 进行读取操作,但是不能进行更新操作。加锁期间其它事务能对 A 加 S 锁,但是不能加 X 锁。
锁的兼容关系如下:
2. 意向锁
使用意向锁(Intention Locks)可以更容易地支持多粒度封锁。
在存在行级锁和表级锁的情况下,事务 T 想要对表 A 加 X 锁,就需要先检测是否有其它事务对表 A 或者表 A 中的任意一行加了锁,那么就需要对表 A 的每一行都检测一次,这是非常耗时的。
意向锁在原来的 X/S 锁之上引入了 IX/IS,IX/IS 都是表锁,用来表示一个事务想要在表中的某个数据行上加 X 锁或 S 锁。有以下两个规定:
- 一个事务在获得某个数据行对象的 S 锁之前,必须先获得表的 IS 锁或者更强的锁;
- 一个事务在获得某个数据行对象的 X 锁之前,必须先获得表的 IX 锁。
通过引入意向锁,事务 T 想要对表 A 加 X 锁,只需要先检测是否有其它事务对表 A 加了 X/IX/S/IS 锁,如果加了就表示有其它事务正在使用这个表或者表中某一行的锁,因此事务 T 加 X 锁失败。
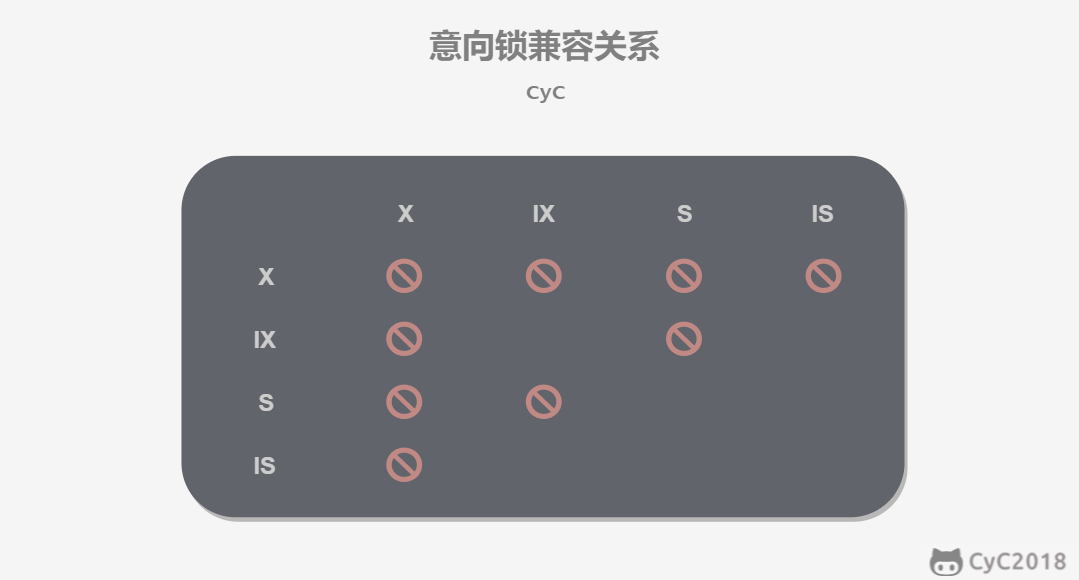
各种锁的兼容关系如下:
解释如下:
- 任意 IS/IX 锁之间都是兼容的,因为它们只表示想要对表加锁,而不是真正加锁;
- 这里兼容关系针对的是表级锁,而表级的 IX 锁和行级的 X 锁兼容,两个事务可以对两个数据行加 X 锁。(事务 T1 想要对数据行 R1 加 X 锁,事务 T2 想要对同一个表的数据行 R2 加 X 锁,两个事务都需要对该表加 IX 锁,但是 IX 锁是兼容的,并且 IX 锁与行级的 X 锁也是兼容的,因此两个事务都能加锁成功,对同一个表中的两个数据行做修改。)
封锁协议
1. 三级封锁协议
一级封锁协议
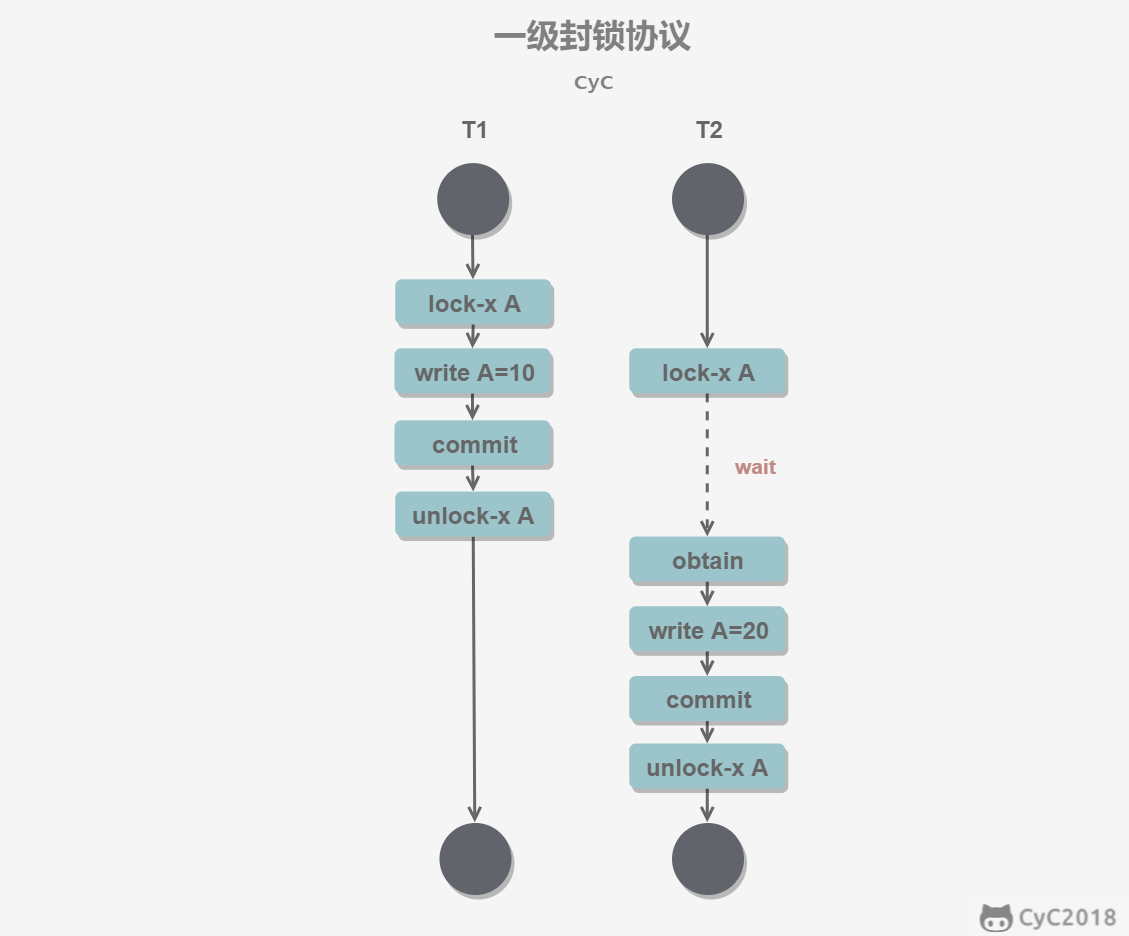
事务 T 要修改数据 A 时必须加 X 锁,直到 T 结束才释放锁。
可以解决丢失修改问题,因为不能同时有两个事务对同一个数据进行修改,那么事务的修改就不会被覆盖。
二级封锁协议
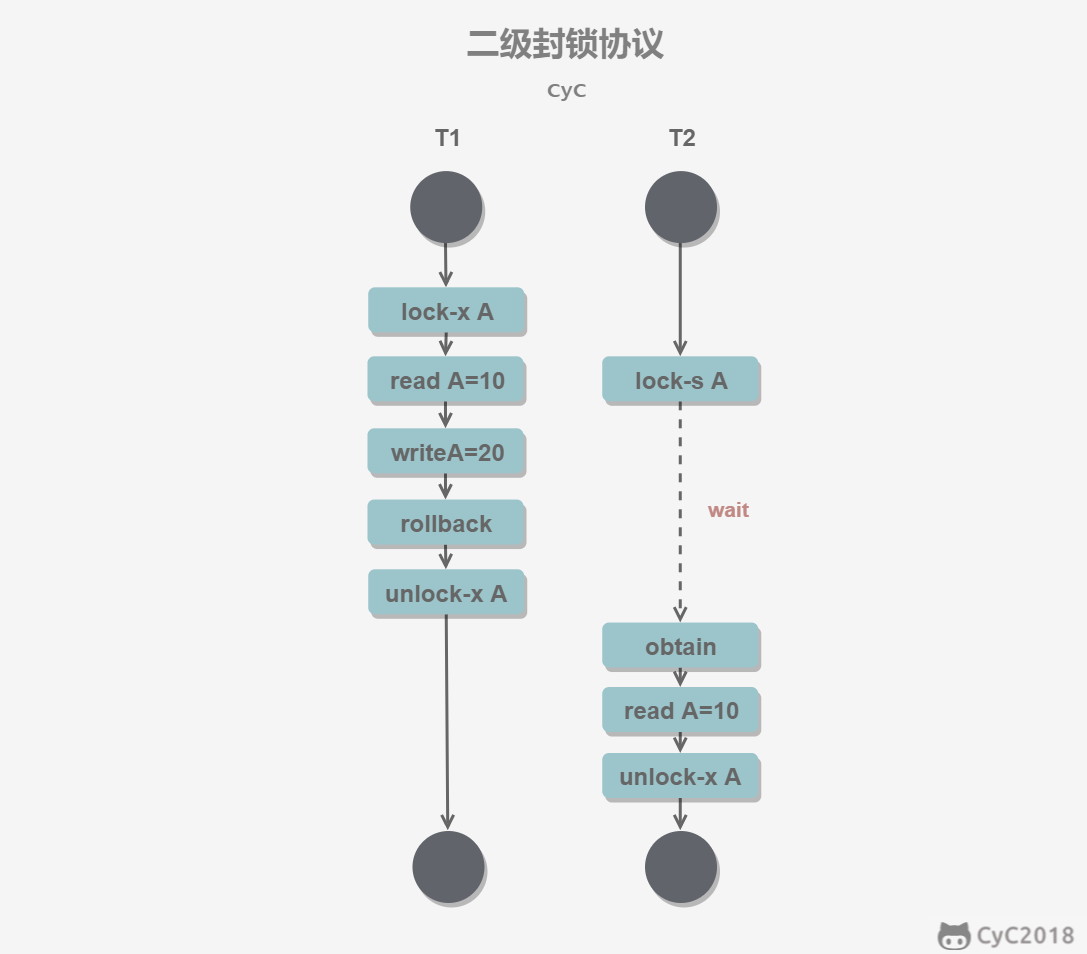
在一级的基础上,要求读取数据 A 时必须加 S 锁,读取完马上释放 S 锁。
可以解决读脏数据问题,因为如果一个事务在对数据 A 进行修改,根据 1 级封锁协议,会加 X 锁,那么就不能再加 S 锁了,也就是不会读入数据。
三级封锁协议
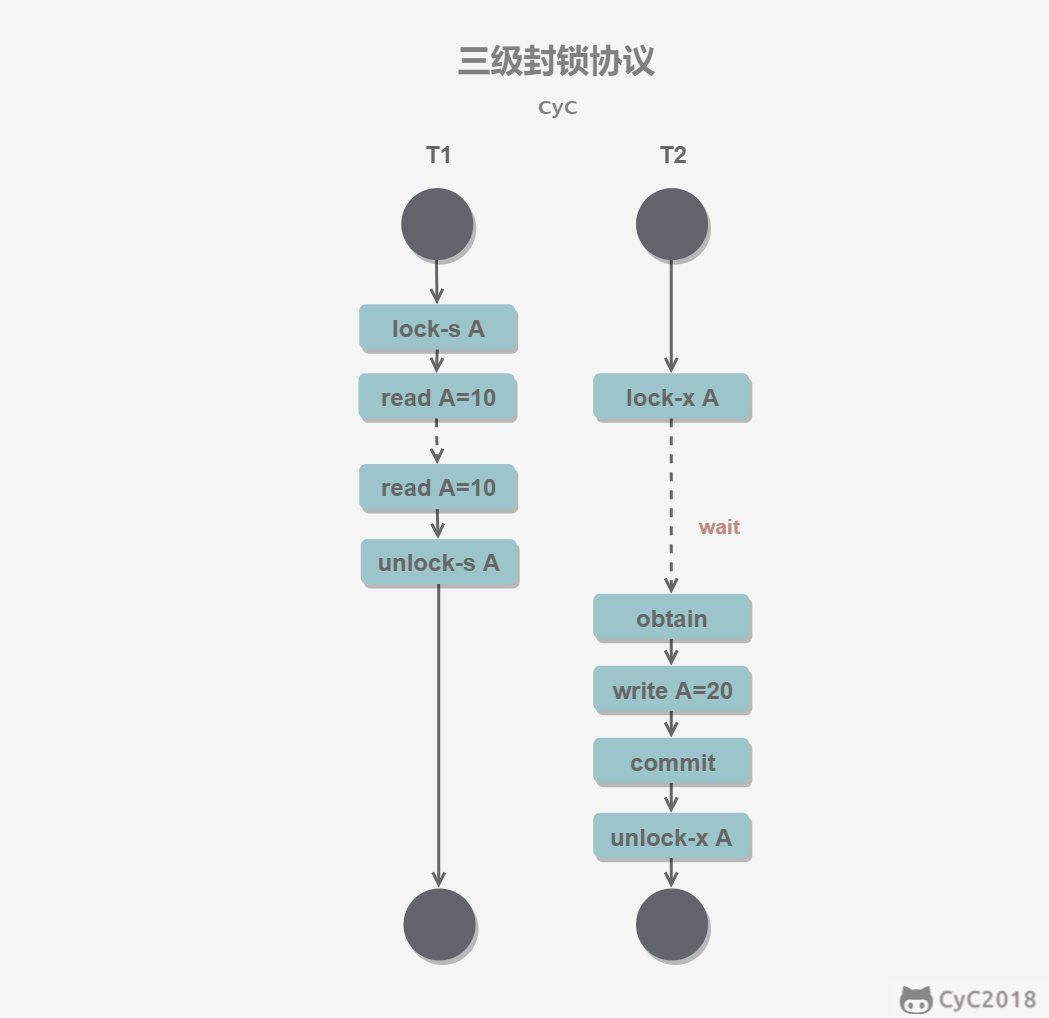
在二级的基础上,要求读取数据 A 时必须加 S 锁,直到事务结束了才能释放 S 锁。
可以解决不可重复读的问题,因为读 A 时,其它事务不能对 A 加 X 锁,从而避免了在读的期间数据发生改变。
2. 两段锁协议
加锁和解锁分为两个阶段进行。
可串行化调度是指,通过并发控制,使得并发执行的事务结果与某个串行执行的事务结果相同。串行执行的事务互不干扰,不会出现并发一致性问题。
事务遵循两段锁协议是保证可串行化调度的充分条件。例如以下操作满足两段锁协议,它是可串行化调度。
lock-x(A)...lock-s(B)...lock-s(C)...unlock(A)...unlock(C)...unlock(B)但不是必要条件,例如以下操作不满足两段锁协议,但它还是可串行化调度。
lock-x(A)...unlock(A)...lock-s(B)...unlock(B)...lock-s(C)...unlock(C)MySQL 隐式与显式锁定
MySQL 的 InnoDB 存储引擎采用两段锁协议,会根据隔离级别在需要的时候自动加锁,并且所有的锁都是在同一时刻被释放,这被称为隐式锁定。
InnoDB 也可以使用特定的语句进行显示锁定:
SELECT ... LOCK In SHARE MODE;
SELECT ... FOR UPDATE;
四、隔离级别
未提交读(READ UNCOMMITTED)
事务中的修改,即使没有提交,对其它事务也是可见的。
提交读(READ COMMITTED)
一个事务只能读取已经提交的事务所做的修改。换句话说,一个事务所做的修改在提交之前对其它事务是不可见的。
可重复读(REPEATABLE READ)
保证在同一个事务中多次读取同一数据的结果是一样的。
可串行化(SERIALIZABLE)
强制事务串行执行,这样多个事务互不干扰,不会出现并发一致性问题。
该隔离级别需要加锁实现,因为要使用加锁机制保证同一时间只有一个事务执行,也就是保证事务串行执行。
五、多版本并发控制
多版本并发控制(Multi-Version Concurrency Control, MVCC)是 MySQL 的 InnoDB 存储引擎实现隔离级别的一种具体方式,用于实现提交读和可重复读这两种隔离级别。而未提交读隔离级别总是读取最新的数据行,要求很低,无需使用 MVCC。可串行化隔离级别需要对所有读取的行都加锁,单纯使用 MVCC 无法实现。
基本思想
在封锁一节中提到,加锁能解决多个事务同时执行时出现的并发一致性问题。在实际场景中读操作往往多于写操作,因此又引入了读写锁来避免不必要的加锁操作,例如读和读没有互斥关系。读写锁中读和写操作仍然是互斥的,而 MVCC 利用了多版本的思想,写操作更新最新的版本快照,而读操作去读旧版本快照,没有互斥关系,这一点和 CopyOnWrite 类似。
在 MVCC 中事务的修改操作(DELETE、INSERT、UPDATE)会为数据行新增一个版本快照。
脏读和不可重复读最根本的原因是事务读取到其它事务未提交的修改。在事务进行读取操作时,为了解决脏读和不可重复读问题,MVCC 规定只能读取已经提交的快照。当然一个事务可以读取自身未提交的快照,这不算是脏读。
版本号
- 系统版本号 SYS_ID:是一个递增的数字,每开始一个新的事务,系统版本号就会自动递增。
- 事务版本号 TRX_ID :事务开始时的系统版本号。
Undo 日志
MVCC 的多版本指的是多个版本的快照,快照存储在 Undo 日志中,该日志通过回滚指针 ROLL_PTR 把一个数据行的所有快照连接起来。
例如在 MySQL 创建一个表 t,包含主键 id 和一个字段 x。我们先插入一个数据行,然后对该数据行执行两次更新操作。
INSERT INTO t(id, x) VALUES(1, "a");
UPDATE t SET x="b" WHERE id=1;
UPDATE t SET x="c" WHERE id=1;
因为没有使用 START TRANSACTION 将上面的操作当成一个事务来执行,根据 MySQL 的 AUTOCOMMIT 机制,每个操作都会被当成一个事务来执行,所以上面的操作总共涉及到三个事务。快照中除了记录事务版本号 TRX_ID 和操作之外,还记录了一个 bit 的 DEL 字段,用于标记是否被删除。
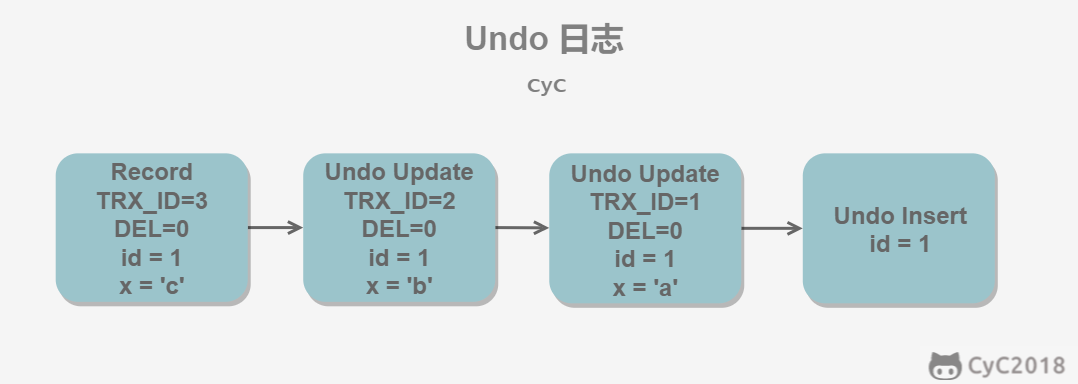
INSERT、UPDATE、DELETE 操作会创建一个日志,并将事务版本号 TRX_ID 写入。DELETE 可以看成是一个特殊的 UPDATE,还会额外将 DEL 字段设置为 1。
ReadView
MVCC 维护了一个 ReadView 结构,主要包含了当前系统未提交的事务列表 TRX_IDs {TRX_ID_1, TRX_ID_2, ...},还有该列表的最小值 TRX_ID_MIN 和 TRX_ID_MAX。
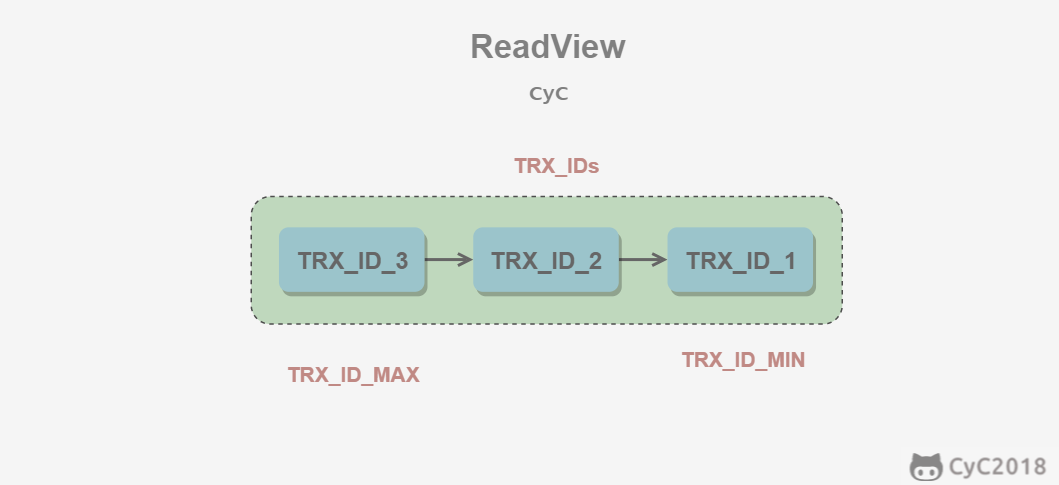
在进行 SELECT 操作时,根据数据行快照的 TRX_ID 与 TRX_ID_MIN 和 TRX_ID_MAX 之间的关系,从而判断数据行快照是否可以使用:
- TRX_ID \< TRX_ID_MIN,表示该数据行快照时在当前所有未提交事务之前进行更改的,因此可以使用。
- TRX_ID \> TRX_ID_MAX,表示该数据行快照是在事务启动之后被更改的,因此不可使用。
- TRX_ID_MIN \<= TRX_ID \<= TRX_ID_MAX,需要根据隔离级别再进行判断:
- 提交读:如果 TRX_ID 在 TRX_IDs 列表中,表示该数据行快照对应的事务还未提交,则该快照不可使用。否则表示已经提交,可以使用。
- 可重复读:都不可以使用。因为如果可以使用的话,那么其它事务也可以读到这个数据行快照并进行修改,那么当前事务再去读这个数据行得到的值就会发生改变,也就是出现了不可重复读问题。
在数据行快照不可使用的情况下,需要沿着 Undo Log 的回滚指针 ROLL_PTR 找到下一个快照,再进行上面的判断。
快照读与当前读
1. 快照读
MVCC 的 SELECT 操作是快照中的数据,不需要进行加锁操作。
SELECT * FROM table ...;2. 当前读
MVCC 其它会对数据库进行修改的操作(INSERT、UPDATE、DELETE)需要进行加锁操作,从而读取最新的数据。可以看到 MVCC 并不是完全不用加锁,而只是避免了 SELECT 的加锁操作。
INSERT;
UPDATE;
DELETE;
在进行 SELECT 操作时,可以强制指定进行加锁操作。以下第一个语句需要加 S 锁,第二个需要加 X 锁。
SELECT * FROM table WHERE ? lock in share mode;
SELECT * FROM table WHERE ? for update;
六、Next-Key Locks
Next-Key Locks 是 MySQL 的 InnoDB 存储引擎的一种锁实现。
MVCC 不能解决幻影读问题,Next-Key Locks 就是为了解决这个问题而存在的。在可重复读(REPEATABLE READ)隔离级别下,使用 MVCC + Next-Key Locks 可以解决幻读问题。
Record Locks
锁定一个记录上的索引,而不是记录本身。
如果表没有设置索引,InnoDB 会自动在主键上创建隐藏的聚簇索引,因此 Record Locks 依然可以使用。
Gap Locks
锁定索引之间的间隙,但是不包含索引本身。例如当一个事务执行以下语句,其它事务就不能在 t.c 中插入 15。
SELECT c FROM t WHERE c BETWEEN 10 and 20 FOR UPDATE;Next-Key Locks
它是 Record Locks 和 Gap Locks 的结合,不仅锁定一个记录上的索引,也锁定索引之间的间隙。它锁定一个前开后闭区间,例如一个索引包含以下值:10, 11, 13, and 20,那么就需要锁定以下区间:
(-∞, 10]
(10, 11]
(11, 13]
(13, 20]
(20, +∞)
七、关系数据库设计理论
函数依赖
记 A-\>B 表示 A 函数决定 B,也可以说 B 函数依赖于 A。
如果 {A1,A2,... ,An} 是关系的一个或多个属性的集合,该集合函数决定了关系的其它所有属性并且是最小的,那么该集合就称为键码。
对于 A-\>B,如果能找到 A 的真子集 A',使得 A'-\> B,那么 A-\>B 就是部分函数依赖,否则就是完全函数依赖。
对于 A-\>B,B-\>C,则 A-\>C 是一个传递函数依赖。
异常
以下的学生课程关系的函数依赖为 {Sno, Cname} -\> {Sname, Sdept, Mname, Grade},键码为 {Sno, Cname}。也就是说,确定学生和课程之后,就能确定其它信息。
| Sno | Sname | Sdept | Mname | Cname | Grade |
|---|---|---|---|---|---|
| 1 | 学生-1 | 学院-1 | 院长-1 | 课程-1 | 90 |
| 2 | 学生-2 | 学院-2 | 院长-2 | 课程-2 | 80 |
| 2 | 学生-2 | 学院-2 | 院长-2 | 课程-1 | 100 |
| 3 | 学生-3 | 学院-2 | 院长-2 | 课程-2 | 95 |
不符合范式的关系,会产生很多异常,主要有以下四种异常:
- 冗余数据:例如
学生-2出现了两次。 - 修改异常:修改了一个记录中的信息,但是另一个记录中相同的信息却没有被修改。
- 删除异常:删除一个信息,那么也会丢失其它信息。例如删除了
课程-1需要删除第一行和第三行,那么学生-1的信息就会丢失。 - 插入异常:例如想要插入一个学生的信息,如果这个学生还没选课,那么就无法插入。
范式
范式理论是为了解决以上提到四种异常。
高级别范式的依赖于低级别的范式,1NF 是最低级别的范式。
1. 第一范式 (1NF)
属性不可分。
2. 第二范式 (2NF)
每个非主属性完全函数依赖于键码。
可以通过分解来满足。
分解前
| Sno | Sname | Sdept | Mname | Cname | Grade |
|---|---|---|---|---|---|
| 1 | 学生-1 | 学院-1 | 院长-1 | 课程-1 | 90 |
| 2 | 学生-2 | 学院-2 | 院长-2 | 课程-2 | 80 |
| 2 | 学生-2 | 学院-2 | 院长-2 | 课程-1 | 100 |
| 3 | 学生-3 | 学院-2 | 院长-2 | 课程-2 | 95 |
以上学生课程关系中,{Sno, Cname} 为键码,有如下函数依赖:
- Sno -\> Sname, Sdept
- Sdept -\> Mname
- Sno, Cname-\> Grade
Grade 完全函数依赖于键码,它没有任何冗余数据,每个学生的每门课都有特定的成绩。
Sname, Sdept 和 Mname 都部分依赖于键码,当一个学生选修了多门课时,这些数据就会出现多次,造成大量冗余数据。
分解后
关系-1
| Sno | Sname | Sdept | Mname |
|---|---|---|---|
| 1 | 学生-1 | 学院-1 | 院长-1 |
| 2 | 学生-2 | 学院-2 | 院长-2 |
| 3 | 学生-3 | 学院-2 | 院长-2 |
有以下函数依赖:
- Sno -\> Sname, Sdept
- Sdept -\> Mname
关系-2
| Sno | Cname | Grade |
|---|---|---|
| 1 | 课程-1 | 90 |
| 2 | 课程-2 | 80 |
| 2 | 课程-1 | 100 |
| 3 | 课程-2 | 95 |
有以下函数依赖:
- Sno, Cname -\> Grade
3. 第三范式 (3NF)
非主属性不传递函数依赖于键码。
上面的 关系-1 中存在以下传递函数依赖:
- Sno -\> Sdept -\> Mname
可以进行以下分解:
关系-11
| Sno | Sname | Sdept |
|---|---|---|
| 1 | 学生-1 | 学院-1 |
| 2 | 学生-2 | 学院-2 |
| 3 | 学生-3 | 学院-2 |
关系-12
| Sdept | Mname |
|---|---|
| 学院-1 | 院长-1 |
| 学院-2 | 院长-2 |
八、ER 图
Entity-Relationship,有三个组成部分:实体、属性、联系。
用来进行关系型数据库系统的概念设计。
实体的三种联系
包含一对一,一对多,多对多三种。
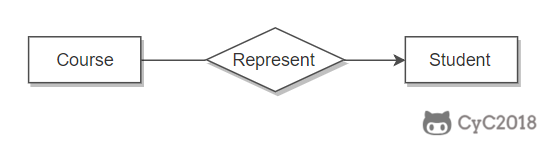
- 如果 A 到 B 是一对多关系,那么画个带箭头的线段指向 B;
- 如果是一对一,画两个带箭头的线段;
- 如果是多对多,画两个不带箭头的线段。
下图的 Course 和 Student 是一对多的关系。
表示出现多次的关系
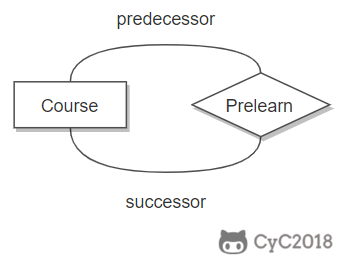
一个实体在联系出现几次,就要用几条线连接。
下图表示一个课程的先修关系,先修关系出现两个 Course 实体,第一个是先修课程,后一个是后修课程,因此需要用两条线来表示这种关系。
联系的多向性
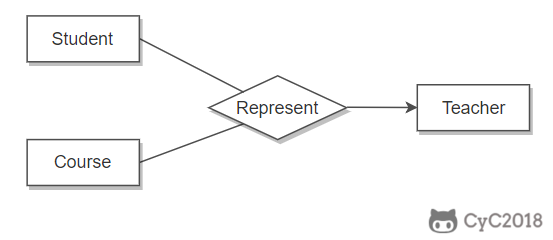
虽然老师可以开设多门课,并且可以教授多名学生,但是对于特定的学生和课程,只有一个老师教授,这就构成了一个三元联系。
表示子类
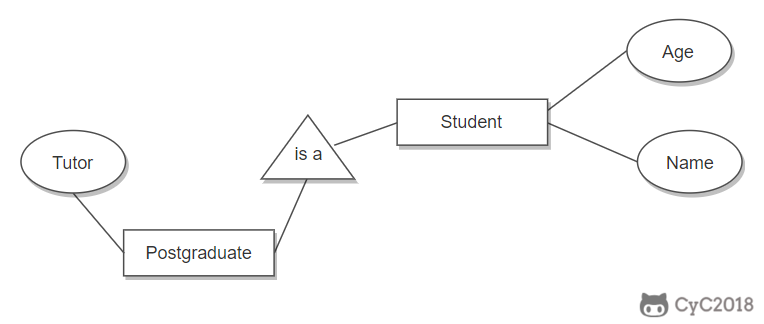
用一个三角形和两条线来连接类和子类,与子类有关的属性和联系都连到子类上,而与父类和子类都有关的连到父类上。
参考资料
- AbrahamSilberschatz, HenryF.Korth, S.Sudarshan, 等. 数据库系统概念 [M]. 机械工业出版社, 2006.
- 施瓦茨. 高性能 MYSQL(第3版)[M]. 电子工业出版社, 2013.
- 史嘉权. 数据库系统概论[M]. 清华大学出版社有限公司, 2006.
- The InnoDB Storage Engine
- Transaction isolation levels
- Concurrency Control
- The Nightmare of Locking, Blocking and Isolation Levels!
- Database Normalization and Normal Forms with an Example
- The basics of the InnoDB undo logging and history system
- MySQL locking for the busy web developer
- 浅入浅出 MySQL 和 InnoDB
- Innodb 中的事务隔离级别和锁的关系
SQL 语法
SQL 语法
* [一、基础](#一基础)
* [二、创建表](#二创建表)
* [三、修改表](#三修改表)
* [四、插入](#四插入)
* [五、更新](#五更新)
* [六、删除](#六删除)
* [七、查询](#七查询)
    * [DISTINCT](#distinct)
    * [LIMIT](#limit)
* [八、排序](#八排序)
* [九、过滤](#九过滤)
* [十、通配符](#十通配符)
* [十一、计算字段](#十一计算字段)
* [十二、函数](#十二函数)
    * [汇总](#汇总)
    * [文本处理](#文本处理)
    * [日期和时间处理](#日期和时间处理)
    * [数值处理](#数值处理)
* [十三、分组](#十三分组)
* [十四、子查询](#十四子查询)
* [十五、连接](#十五连接)
    * [内连接](#内连接)
    * [自连接](#自连接)
    * [自然连接](#自然连接)
    * [外连接](#外连接)
* [十六、组合查询](#十六组合查询)
* [十七、视图](#十七视图)
* [十八、存储过程](#十八存储过程)
* [十九、游标](#十九游标)
* [二十、触发器](#二十触发器)
* [二十一、事务管理](#二十一事务管理)
* [二十二、字符集](#二十二字符集)
* [二十三、权限管理](#二十三权限管理)
* [参考资料](#参考资料)
一、基础
模式定义了数据如何存储、存储什么样的数据以及数据如何分解等信息,数据库和表都有模式。
主键的值不允许修改,也不允许复用(不能将已经删除的主键值赋给新数据行的主键)。
SQL(Structured Query Language),标准 SQL 由 ANSI 标准委员会管理,从而称为 ANSI SQL。各个 DBMS 都有自己的实现,如 PL/SQL、Transact-SQL 等。
SQL 语句不区分大小写,但是数据库表名、列名和值是否区分依赖于具体的 DBMS 以及配置。
SQL 支持以下三种注释:
## 注释
SELECT *
FROM mytable; -- 注释
/* 注释1
   注释2 */
数据库创建与使用:
CREATE DATABASE test;
USE test;
二、创建表
CREATE TABLE mytable (
  # int 类型,不为空,自增
  id INT NOT NULL AUTO_INCREMENT,
  # int 类型,不可为空,默认值为 1,不为空
  col1 INT NOT NULL DEFAULT 1,
  # 变长字符串类型,最长为 45 个字符,可以为空
  col2 VARCHAR(45) NULL,
  # 日期类型,可为空
  col3 DATE NULL,
  # 设置主键为 id
  PRIMARY KEY (`id`));
三、修改表
添加列
ALTER TABLE mytable
ADD col CHAR(20);
删除列
ALTER TABLE mytable
DROP COLUMN col;
删除表
DROP TABLE mytable;四、插入
普通插入
INSERT INTO mytable(col1, col2)
VALUES(val1, val2);
插入检索出来的数据
INSERT INTO mytable1(col1, col2)
SELECT col1, col2
FROM mytable2;
将一个表的内容插入到一个新表
CREATE TABLE newtable AS
SELECT * FROM mytable;
五、更新
UPDATE mytable
SET col = val
WHERE id = 1;
六、删除
DELETE FROM mytable
WHERE id = 1;
TRUNCATE TABLE 可以清空表,也就是删除所有行。
TRUNCATE TABLE mytable;使用更新和删除操作时一定要用 WHERE 子句,不然会把整张表的数据都破坏。可以先用 SELECT 语句进行测试,防止错误删除。
七、查询
DISTINCT
相同值只会出现一次。它作用于所有列,也就是说所有列的值都相同才算相同。
SELECT DISTINCT col1, col2
FROM mytable;
LIMIT
限制返回的行数。可以有两个参数,第一个参数为起始行,从 0 开始;第二个参数为返回的总行数。
返回前 5 行:
SELECT *
FROM mytable
LIMIT 5;
SELECT *
FROM mytable
LIMIT 0, 5;返回第 3 \~ 5 行:
SELECT *
FROM mytable
LIMIT 2, 3;
八、排序
- ASC :升序(默认)
- DESC :降序
可以按多个列进行排序,并且为每个列指定不同的排序方式:
SELECT *
FROM mytable
ORDER BY col1 DESC, col2 ASC;
九、过滤
不进行过滤的数据非常大,导致通过网络传输了多余的数据,从而浪费了网络带宽。因此尽量使用 SQL 语句来过滤不必要的数据,而不是传输所有的数据到客户端中然后由客户端进行过滤。
SELECT *
FROM mytable
WHERE col IS NULL;
下表显示了 WHERE 子句可用的操作符
| 操作符 | 说明 |
|---|---|
| = | 等于 |
| < | 小于 |
| > | 大于 |
| <> != | 不等于 |
| <= !> | 小于等于 |
| >= !< | 大于等于 |
| BETWEEN | 在两个值之间 |
| IS NULL | 为 NULL 值 |
应该注意到,NULL 与 0、空字符串都不同。
AND 和 OR 用于连接多个过滤条件。优先处理 AND,当一个过滤表达式涉及到多个 AND 和 OR 时,可以使用 () 来决定优先级,使得优先级关系更清晰。
IN 操作符用于匹配一组值,其后也可以接一个 SELECT 子句,从而匹配子查询得到的一组值。
NOT 操作符用于否定一个条件。
十、通配符
通配符也是用在过滤语句中,但它只能用于文本字段。
- % 匹配 \>=0 个任意字符;
- \_ 匹配 ==1 个任意字符;
- [ ] 可以匹配集合内的字符,例如 [ab] 将匹配字符 a 或者 b。用脱字符 ^ 可以对其进行否定,也就是不匹配集合内的字符。
使用 Like 来进行通配符匹配。
SELECT *
FROM mytable
WHERE col LIKE '[^AB]%'; -- 不以 A 和 B 开头的任意文本
不要滥用通配符,通配符位于开头处匹配会非常慢。
十一、计算字段
在数据库服务器上完成数据的转换和格式化的工作往往比客户端上快得多,并且转换和格式化后的数据量更少的话可以减少网络通信量。
计算字段通常需要使用 AS 来取别名,否则输出的时候字段名为计算表达式。
SELECT col1 * col2 AS alias
FROM mytable;
CONCAT() 用于连接两个字段。许多数据库会使用空格把一个值填充为列宽,因此连接的结果会出现一些不必要的空格,使用 TRIM() 可以去除首尾空格。
SELECT CONCAT(TRIM(col1), '(', TRIM(col2), ')') AS concat_col
FROM mytable;
十二、函数
各个 DBMS 的函数都是不相同的,因此不可移植,以下主要是 MySQL 的函数。
汇总
| 函 数 | 说 明 |
|---|---|
| AVG() | 返回某列的平均值 |
| COUNT() | 返回某列的行数 |
| MAX() | 返回某列的最大值 |
| MIN() | 返回某列的最小值 |
| SUM() | 返回某列值之和 |
AVG() 会忽略 NULL 行。
使用 DISTINCT 可以汇总不同的值。
SELECT AVG(DISTINCT col1) AS avg_col
FROM mytable;
文本处理
| 函数 | 说明 |
|---|---|
| LEFT() | 左边的字符 |
| RIGHT() | 右边的字符 |
| LOWER() | 转换为小写字符 |
| UPPER() | 转换为大写字符 |
| LTRIM() | 去除左边的空格 |
| RTRIM() | 去除右边的空格 |
| LENGTH() | 长度 |
| SOUNDEX() | 转换为语音值 |
其中, SOUNDEX() 可以将一个字符串转换为描述其语音表示的字母数字模式。
SELECT *
FROM mytable
WHERE SOUNDEX(col1) = SOUNDEX('apple')
日期和时间处理
- 日期格式:YYYY-MM-DD
- 时间格式:HH:\
MM:SS
| 函 数 | 说 明 |
|---|---|
| ADDDATE() | 增加一个日期(天、周等) |
| ADDTIME() | 增加一个时间(时、分等) |
| CURDATE() | 返回当前日期 |
| CURTIME() | 返回当前时间 |
| DATE() | 返回日期时间的日期部分 |
| DATEDIFF() | 计算两个日期之差 |
| DATE_ADD() | 高度灵活的日期运算函数 |
| DATE_FORMAT() | 返回一个格式化的日期或时间串 |
| DAY() | 返回一个日期的天数部分 |
| DAYOFWEEK() | 对于一个日期,返回对应的星期几 |
| HOUR() | 返回一个时间的小时部分 |
| MINUTE() | 返回一个时间的分钟部分 |
| MONTH() | 返回一个日期的月份部分 |
| NOW() | 返回当前日期和时间 |
| SECOND() | 返回一个时间的秒部分 |
| TIME() | 返回一个日期时间的时间部分 |
| YEAR() | 返回一个日期的年份部分 |
mysql> SELECT NOW();2018-4-14 20:25:11数值处理
| 函数 | 说明 |
|---|---|
| SIN() | 正弦 |
| COS() | 余弦 |
| TAN() | 正切 |
| ABS() | 绝对值 |
| SQRT() | 平方根 |
| MOD() | 余数 |
| EXP() | 指数 |
| PI() | 圆周率 |
| RAND() | 随机数 |
十三、分组
把具有相同的数据值的行放在同一组中。
可以对同一分组数据使用汇总函数进行处理,例如求分组数据的平均值等。
指定的分组字段除了能按该字段进行分组,也会自动按该字段进行排序。
SELECT col, COUNT(*) AS num
FROM mytable
GROUP BY col;
GROUP BY 自动按分组字段进行排序,ORDER BY 也可以按汇总字段来进行排序。
SELECT col, COUNT(*) AS num
FROM mytable
GROUP BY col
ORDER BY num;
WHERE 过滤行,HAVING 过滤分组,行过滤应当先于分组过滤。
SELECT col, COUNT(*) AS num
FROM mytable
WHERE col > 2
GROUP BY col
HAVING num >= 2;
分组规定:
- GROUP BY 子句出现在 WHERE 子句之后,ORDER BY 子句之前;
- 除了汇总字段外,SELECT 语句中的每一字段都必须在 GROUP BY 子句中给出;
- NULL 的行会单独分为一组;
- 大多数 SQL 实现不支持 GROUP BY 列具有可变长度的数据类型。
十四、子查询
子查询中只能返回一个字段的数据。
可以将子查询的结果作为 WHRER 语句的过滤条件:
SELECT *
FROM mytable1
WHERE col1 IN (SELECT col2
               FROM mytable2);
下面的语句可以检索出客户的订单数量,子查询语句会对第一个查询检索出的每个客户执行一次:
SELECT cust_name, (SELECT COUNT(*)
                   FROM Orders
                   WHERE Orders.cust_id = Customers.cust_id)
                   AS orders_num
FROM Customers
ORDER BY cust_name;
十五、连接
连接用于连接多个表,使用 JOIN 关键字,并且条件语句使用 ON 而不是 WHERE。
连接可以替换子查询,并且比子查询的效率一般会更快。
可以用 AS 给列名、计算字段和表名取别名,给表名取别名是为了简化 SQL 语句以及连接相同表。
内连接
内连接又称等值连接,使用 INNER JOIN 关键字。
SELECT A.value, B.value
FROM tablea AS A INNER JOIN tableb AS B
ON A.key = B.key;
可以不明确使用 INNER JOIN,而使用普通查询并在 WHERE 中将两个表中要连接的列用等值方法连接起来。
SELECT A.value, B.value
FROM tablea AS A, tableb AS B
WHERE A.key = B.key;
自连接
自连接可以看成内连接的一种,只是连接的表是自身而已。
一张员工表,包含员工姓名和员工所属部门,要找出与 Jim 处在同一部门的所有员工姓名。
子查询版本
SELECT name
FROM employee
WHERE department = (
      SELECT department
      FROM employee
      WHERE name = "Jim");
自连接版本
SELECT e1.name
FROM employee AS e1 INNER JOIN employee AS e2
ON e1.department = e2.department
      AND e2.name = "Jim";
自然连接
自然连接是把同名列通过等值测试连接起来的,同名列可以有多个。
内连接和自然连接的区别:内连接提供连接的列,而自然连接自动连接所有同名列。
SELECT A.value, B.value
FROM tablea AS A NATURAL JOIN tableb AS B;
外连接
外连接保留了没有关联的那些行。分为左外连接,右外连接以及全外连接,左外连接就是保留左表没有关联的行。
检索所有顾客的订单信息,包括还没有订单信息的顾客。
SELECT Customers.cust_id, Customer.cust_name, Orders.order_id
FROM Customers LEFT OUTER JOIN Orders
ON Customers.cust_id = Orders.cust_id;
customers 表:
| cust_id | cust_name |
|---|---|
| 1 | a |
| 2 | b |
| 3 | c |
orders 表:
| order_id | cust_id |
|---|---|
| 1 | 1 |
| 2 | 1 |
| 3 | 3 |
| 4 | 3 |
结果:
| cust_id | cust_name | order_id |
|---|---|---|
| 1 | a | 1 |
| 1 | a | 2 |
| 3 | c | 3 |
| 3 | c | 4 |
| 2 | b | Null |
十六、组合查询
使用 UNION 来组合两个查询,如果第一个查询返回 M 行,第二个查询返回 N 行,那么组合查询的结果一般为 M+N 行。
每个查询必须包含相同的列、表达式和聚集函数。
默认会去除相同行,如果需要保留相同行,使用 UNION ALL。
只能包含一个 ORDER BY 子句,并且必须位于语句的最后。
SELECT col
FROM mytable
WHERE col = 1
UNION
SELECT col
FROM mytable
WHERE col =2;
十七、视图
视图是虚拟的表,本身不包含数据,也就不能对其进行索引操作。
对视图的操作和对普通表的操作一样。
视图具有如下好处:
- 简化复杂的 SQL 操作,比如复杂的连接;
- 只使用实际表的一部分数据;
- 通过只给用户访问视图的权限,保证数据的安全性;
- 更改数据格式和表示。
CREATE VIEW myview AS
SELECT Concat(col1, col2) AS concat_col, col3*col4 AS compute_col
FROM mytable
WHERE col5 = val;
十八、存储过程
存储过程可以看成是对一系列 SQL 操作的批处理。
使用存储过程的好处:
- 代码封装,保证了一定的安全性;
- 代码复用;
- 由于是预先编译,因此具有很高的性能。
命令行中创建存储过程需要自定义分隔符,因为命令行是以 ; 为结束符,而存储过程中也包含了分号,因此会错误把这部分分号当成是结束符,造成语法错误。
包含 in、out 和 inout 三种参数。
给变量赋值都需要用 select into 语句。
每次只能给一个变量赋值,不支持集合的操作。
delimiter //

create procedure myprocedure( out ret int )
    begin
        declare y int;
        select sum(col1)
        from mytable
        into y;
        select y*y into ret;
    end //

delimiter ;
call myprocedure(@ret);
select @ret;十九、游标
在存储过程中使用游标可以对一个结果集进行移动遍历。
游标主要用于交互式应用,其中用户需要对数据集中的任意行进行浏览和修改。
使用游标的四个步骤:
- 声明游标,这个过程没有实际检索出数据;
- 打开游标;
- 取出数据;
- 关闭游标;
delimiter //
create procedure myprocedure(out ret int)
    begin
        declare done boolean default 0;

        declare mycursor cursor for
        select col1 from mytable;
        # 定义了一个 continue handler,当 sqlstate '02000' 这个条件出现时,会执行 set done = 1
        declare continue handler for sqlstate '02000' set done = 1;

        open mycursor;

        repeat
            fetch mycursor into ret;
            select ret;
        until done end repeat;

        close mycursor;
    end //
 delimiter ;
二十、触发器
触发器会在某个表执行以下语句时而自动执行:DELETE、INSERT、UPDATE。
触发器必须指定在语句执行之前还是之后自动执行,之前执行使用 BEFORE 关键字,之后执行使用 AFTER 关键字。BEFORE 用于数据验证和净化,AFTER 用于审计跟踪,将修改记录到另外一张表中。
INSERT 触发器包含一个名为 NEW 的虚拟表。
CREATE TRIGGER mytrigger AFTER INSERT ON mytable
FOR EACH ROW SELECT NEW.col into @result;

SELECT @result; -- 获取结果
DELETE 触发器包含一个名为 OLD 的虚拟表,并且是只读的。
UPDATE 触发器包含一个名为 NEW 和一个名为 OLD 的虚拟表,其中 NEW 是可以被修改的,而 OLD 是只读的。
MySQL 不允许在触发器中使用 CALL 语句,也就是不能调用存储过程。
二十一、事务管理
基本术语:
- 事务(transaction)指一组 SQL 语句;
- 回退(rollback)指撤销指定 SQL 语句的过程;
- 提交(commit)指将未存储的 SQL 语句结果写入数据库表;
- 保留点(savepoint)指事务处理中设置的临时占位符(placeholder),你可以对它发布回退(与回退整个事务处理不同)。
不能回退 SELECT 语句,回退 SELECT 语句也没意义;也不能回退 CREATE 和 DROP 语句。
MySQL 的事务提交默认是隐式提交,每执行一条语句就把这条语句当成一个事务然后进行提交。当出现 START TRANSACTION 语句时,会关闭隐式提交;当 COMMIT 或 ROLLBACK 语句执行后,事务会自动关闭,重新恢复隐式提交。
设置 autocommit 为 0 可以取消自动提交;autocommit 标记是针对每个连接而不是针对服务器的。
如果没有设置保留点,ROLLBACK 会回退到 START TRANSACTION 语句处;如果设置了保留点,并且在 ROLLBACK 中指定该保留点,则会回退到该保留点。
START TRANSACTION
// ...
SAVEPOINT delete1
// ...
ROLLBACK TO delete1
// ...
COMMIT
二十二、字符集
基本术语:
- 字符集为字母和符号的集合;
- 编码为某个字符集成员的内部表示;
- 校对字符指定如何比较,主要用于排序和分组。
除了给表指定字符集和校对外,也可以给列指定:
CREATE TABLE mytable
(col VARCHAR(10) CHARACTER SET latin COLLATE latin1_general_ci )
DEFAULT CHARACTER SET hebrew COLLATE hebrew_general_ci;
可以在排序、分组时指定校对:
SELECT *
FROM mytable
ORDER BY col COLLATE latin1_general_ci;
二十三、权限管理
MySQL 的账户信息保存在 mysql 这个数据库中。
USE mysql;
SELECT user FROM user;
创建账户
新创建的账户没有任何权限。
CREATE USER myuser IDENTIFIED BY 'mypassword';修改账户名
RENAME USER myuser TO newuser;删除账户
DROP USER myuser;查看权限
SHOW GRANTS FOR myuser;授予权限
账户用 username@host 的形式定义,username@% 使用的是默认主机名。
GRANT SELECT, INSERT ON mydatabase.* TO myuser;删除权限
GRANT 和 REVOKE 可在几个层次上控制访问权限:
- 整个服务器,使用 GRANT ALL 和 REVOKE ALL;
- 整个数据库,使用 ON database.\*;
- 特定的表,使用 ON database.table;
- 特定的列;
- 特定的存储过程。
REVOKE SELECT, INSERT ON mydatabase.* FROM myuser;更改密码
必须使用 Password() 函数进行加密。
SET PASSWROD FOR myuser = Password('new_password');参考资料
- BenForta. SQL 必知必会 [M]. 人民邮电出版社, 2013.
MySQL
MySQL
* [一、索引](#一索引)
    * [B+ Tree 原理](#b-tree-原理)
    * [MySQL 索引](#mysql-索引)
    * [索引优化](#索引优化)
    * [索引的优点](#索引的优点)
    * [索引的使用条件](#索引的使用条件)
* [二、查询性能优化](#二查询性能优化)
    * [使用 Explain 进行分析](#使用-explain-进行分析)
    * [优化数据访问](#优化数据访问)
    * [重构查询方式](#重构查询方式)
* [三、存储引擎](#三存储引擎)
    * [InnoDB](#innodb)
    * [MyISAM](#myisam)
    * [比较](#比较)
* [四、数据类型](#四数据类型)
    * [整型](#整型)
    * [浮点数](#浮点数)
    * [字符串](#字符串)
    * [时间和日期](#时间和日期)
* [五、切分](#五切分)
    * [水平切分](#水平切分)
    * [垂直切分](#垂直切分)
    * [Sharding 策略](#sharding-策略)
    * [Sharding 存在的问题](#sharding-存在的问题)
* [六、复制](#六复制)
    * [主从复制](#主从复制)
    * [读写分离](#读写分离)
* [参考资料](#参考资料)
一、索引
B+ Tree 原理
1. 数据结构
B Tree 指的是 Balance Tree,也就是平衡树。平衡树是一颗查找树,并且所有叶子节点位于同一层。
B+ Tree 是基于 B Tree 和叶子节点顺序访问指针进行实现,它具有 B Tree 的平衡性,并且通过顺序访问指针来提高区间查询的性能。
在 B+ Tree 中,一个节点中的 key 从左到右非递减排列,如果某个指针的左右相邻 key 分别是 keyi 和 keyi+1,且不为 null,则该指针指向节点的所有 key 大于等于 keyi 且小于等于 keyi+1。
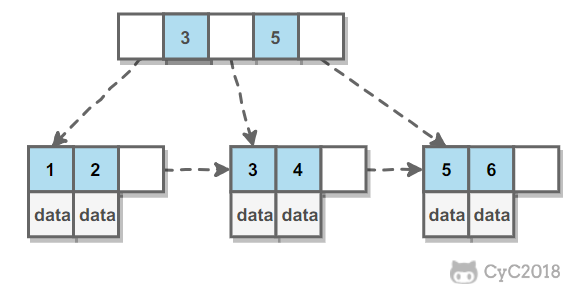
2. 操作
进行查找操作时,首先在根节点进行二分查找,找到一个 key 所在的指针,然后递归地在指针所指向的节点进行查找。直到查找到叶子节点,然后在叶子节点上进行二分查找,找出 key 所对应的 data。
插入删除操作会破坏平衡树的平衡性,因此在进行插入删除操作之后,需要对树进行分裂、合并、旋转等操作来维护平衡性。
3. 与红黑树的比较
红黑树等平衡树也可以用来实现索引,但是文件系统及数据库系统普遍采用 B+ Tree 作为索引结构,这是因为使用 B+ 树访问磁盘数据有更高的性能。
(一)B+ 树有更低的树高
平衡树的树高 O(h)=O(logdN),其中 d 为每个节点的出度。红黑树的出度为 2,而 B+ Tree 的出度一般都非常大,所以红黑树的树高 h 很明显比 B+ Tree 大非常多。
(二)磁盘访问原理
操作系统一般将内存和磁盘分割成固定大小的块,每一块称为一页,内存与磁盘以页为单位交换数据。数据库系统将索引的一个节点的大小设置为页的大小,使得一次 I/O 就能完全载入一个节点。
如果数据不在同一个磁盘块上,那么通常需要移动制动手臂进行寻道,而制动手臂因为其物理结构导致了移动效率低下,从而增加磁盘数据读取时间。B+ 树相对于红黑树有更低的树高,进行寻道的次数与树高成正比,在同一个磁盘块上进行访问只需要很短的磁盘旋转时间,所以 B+ 树更适合磁盘数据的读取。
(三)磁盘预读特性
为了减少磁盘 I/O 操作,磁盘往往不是严格按需读取,而是每次都会预读。预读过程中,磁盘进行顺序读取,顺序读取不需要进行磁盘寻道,并且只需要很短的磁盘旋转时间,速度会非常快。并且可以利用预读特性,相邻的节点也能够被预先载入。
MySQL 索引
索引是在存储引擎层实现的,而不是在服务器层实现的,所以不同存储引擎具有不同的索引类型和实现。
1. B+Tree 索引
是大多数 MySQL 存储引擎的默认索引类型。
因为不再需要进行全表扫描,只需要对树进行搜索即可,所以查找速度快很多。
因为 B+ Tree 的有序性,所以除了用于查找,还可以用于排序和分组。
可以指定多个列作为索引列,多个索引列共同组成键。
适用于全键值、键值范围和键前缀查找,其中键前缀查找只适用于最左前缀查找。如果不是按照索引列的顺序进行查找,则无法使用索引。
InnoDB 的 B+Tree 索引分为主索引和辅助索引。主索引的叶子节点 data 域记录着完整的数据记录,这种索引方式被称为聚簇索引。因为无法把数据行存放在两个不同的地方,所以一个表只能有一个聚簇索引。
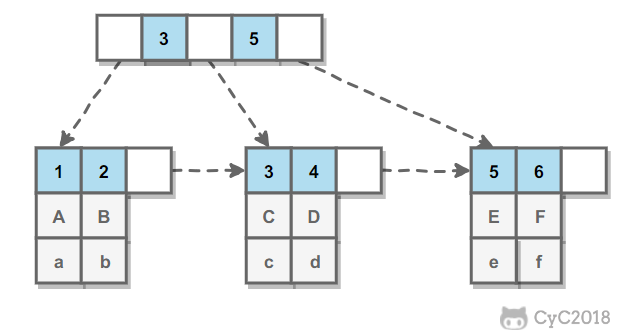
辅助索引的叶子节点的 data 域记录着主键的值,因此在使用辅助索引进行查找时,需要先查找到主键值,然后再到主索引中进行查找。
2. 哈希索引
哈希索引能以 O(1) 时间进行查找,但是失去了有序性:
- 无法用于排序与分组;
- 只支持精确查找,无法用于部分查找和范围查找。
InnoDB 存储引擎有一个特殊的功能叫“自适应哈希索引”,当某个索引值被使用的非常频繁时,会在 B+Tree 索引之上再创建一个哈希索引,这样就让 B+Tree 索引具有哈希索引的一些优点,比如快速的哈希查找。
3. 全文索引
MyISAM 存储引擎支持全文索引,用于查找文本中的关键词,而不是直接比较是否相等。
查找条件使用 MATCH AGAINST,而不是普通的 WHERE。
全文索引使用倒排索引实现,它记录着关键词到其所在文档的映射。
InnoDB 存储引擎在 MySQL 5.6.4 版本中也开始支持全文索引。
4. 空间数据索引
MyISAM 存储引擎支持空间数据索引(R-Tree),可以用于地理数据存储。空间数据索引会从所有维度来索引数据,可以有效地使用任意维度来进行组合查询。
必须使用 GIS 相关的函数来维护数据。
索引优化
1. 独立的列
在进行查询时,索引列不能是表达式的一部分,也不能是函数的参数,否则无法使用索引。
例如下面的查询不能使用 actor_id 列的索引:
SELECT actor_id FROM sakila.actor WHERE actor_id + 1 = 5;2. 多列索引
在需要使用多个列作为条件进行查询时,使用多列索引比使用多个单列索引性能更好。例如下面的语句中,最好把 actor_id 和 film_id 设置为多列索引。
SELECT film_id, actor_ id FROM sakila.film_actor
WHERE actor_id = 1 AND film_id = 1;
3. 索引列的顺序
让选择性最强的索引列放在前面。
索引的选择性是指:不重复的索引值和记录总数的比值。最大值为 1,此时每个记录都有唯一的索引与其对应。选择性越高,每个记录的区分度越高,查询效率也越高。
例如下面显示的结果中 customer_id 的选择性比 staff_id 更高,因此最好把 customer_id 列放在多列索引的前面。
SELECT COUNT(DISTINCT staff_id)/COUNT(*) AS staff_id_selectivity,
COUNT(DISTINCT customer_id)/COUNT(*) AS customer_id_selectivity,
COUNT(*)
FROM payment;
staff_id_selectivity: 0.0001
customer_id_selectivity: 0.0373
COUNT(*): 160494. 前缀索引
对于 BLOB、TEXT 和 VARCHAR 类型的列,必须使用前缀索引,只索引开始的部分字符。
前缀长度的选取需要根据索引选择性来确定。
5. 覆盖索引
索引包含所有需要查询的字段的值。
具有以下优点:
- 索引通常远小于数据行的大小,只读取索引能大大减少数据访问量。
- 一些存储引擎(例如 MyISAM)在内存中只缓存索引,而数据依赖于操作系统来缓存。因此,只访问索引可以不使用系统调用(通常比较费时)。
- 对于 InnoDB 引擎,若辅助索引能够覆盖查询,则无需访问主索引。
索引的优点
- 大大减少了服务器需要扫描的数据行数。
- 帮助服务器避免进行排序和分组,以及避免创建临时表(B+Tree 索引是有序的,可以用于 ORDER BY 和 GROUP BY 操作。临时表主要是在排序和分组过程中创建,不需要排序和分组,也就不需要创建临时表)。
- 将随机 I/O 变为顺序 I/O(B+Tree 索引是有序的,会将相邻的数据都存储在一起)。
索引的使用条件
- 对于非常小的表、大部分情况下简单的全表扫描比建立索引更高效;
- 对于中到大型的表,索引就非常有效;
- 但是对于特大型的表,建立和维护索引的代价将会随之增长。这种情况下,需要用到一种技术可以直接区分出需要查询的一组数据,而不是一条记录一条记录地匹配,例如可以使用分区技术。
二、查询性能优化
使用 Explain 进行分析
Explain 用来分析 SELECT 查询语句,开发人员可以通过分析 Explain 结果来优化查询语句。
比较重要的字段有:
- select_type : 查询类型,有简单查询、联合查询、子查询等
- key : 使用的索引
- rows : 扫描的行数
优化数据访问
1. 减少请求的数据量
- 只返回必要的列:最好不要使用 SELECT * 语句。
- 只返回必要的行:使用 LIMIT 语句来限制返回的数据。
- 缓存重复查询的数据:使用缓存可以避免在数据库中进行查询,特别在要查询的数据经常被重复查询时,缓存带来的查询性能提升将会是非常明显的。
2. 减少服务器端扫描的行数
最有效的方式是使用索引来覆盖查询。
重构查询方式
1. 切分大查询
一个大查询如果一次性执行的话,可能一次锁住很多数据、占满整个事务日志、耗尽系统资源、阻塞很多小的但重要的查询。
DELETE FROM messages WHERE create < DATE_SUB(NOW(), INTERVAL 3 MONTH);rows_affected = 0
do {
rows_affected = do_query(
"DELETE FROM messages WHERE create < DATE_SUB(NOW(), INTERVAL 3 MONTH) LIMIT 10000")
} while rows_affected > 02. 分解大连接查询
将一个大连接查询分解成对每一个表进行一次单表查询,然后在应用程序中进行关联,这样做的好处有:
- 让缓存更高效。对于连接查询,如果其中一个表发生变化,那么整个查询缓存就无法使用。而分解后的多个查询,即使其中一个表发生变化,对其它表的查询缓存依然可以使用。
- 分解成多个单表查询,这些单表查询的缓存结果更可能被其它查询使用到,从而减少冗余记录的查询。
- 减少锁竞争;
- 在应用层进行连接,可以更容易对数据库进行拆分,从而更容易做到高性能和可伸缩。
- 查询本身效率也可能会有所提升。例如下面的例子中,使用 IN() 代替连接查询,可以让 MySQL 按照 ID 顺序进行查询,这可能比随机的连接要更高效。
SELECT * FROM tag
JOIN tag_post ON tag_post.tag_id=tag.id
JOIN post ON tag_post.post_id=post.id
WHERE tag.tag='mysql';
SELECT * FROM tag WHERE tag='mysql';
SELECT * FROM tag_post WHERE tag_id=1234;
SELECT * FROM post WHERE post.id IN (123,456,567,9098,8904);三、存储引擎
InnoDB
是 MySQL 默认的事务型存储引擎,只有在需要它不支持的特性时,才考虑使用其它存储引擎。
实现了四个标准的隔离级别,默认级别是可重复读(REPEATABLE READ)。在可重复读隔离级别下,通过多版本并发控制(MVCC)+ Next-Key Locking 防止幻影读。
主索引是聚簇索引,在索引中保存了数据,从而避免直接读取磁盘,因此对查询性能有很大的提升。
内部做了很多优化,包括从磁盘读取数据时采用的可预测性读、能够加快读操作并且自动创建的自适应哈希索引、能够加速插入操作的插入缓冲区等。
支持真正的在线热备份。其它存储引擎不支持在线热备份,要获取一致性视图需要停止对所有表的写入,而在读写混合场景中,停止写入可能也意味着停止读取。
MyISAM
设计简单,数据以紧密格式存储。对于只读数据,或者表比较小、可以容忍修复操作,则依然可以使用它。
提供了大量的特性,包括压缩表、空间数据索引等。
不支持事务。
不支持行级锁,只能对整张表加锁,读取时会对需要读到的所有表加共享锁,写入时则对表加排它锁。但在表有读取操作的同时,也可以往表中插入新的记录,这被称为并发插入(CONCURRENT INSERT)。
可以手工或者自动执行检查和修复操作,但是和事务恢复以及崩溃恢复不同,可能导致一些数据丢失,而且修复操作是非常慢的。
如果指定了 DELAY_KEY_WRITE 选项,在每次修改执行完成时,不会立即将修改的索引数据写入磁盘,而是会写到内存中的键缓冲区,只有在清理键缓冲区或者关闭表的时候才会将对应的索引块写入磁盘。这种方式可以极大的提升写入性能,但是在数据库或者主机崩溃时会造成索引损坏,需要执行修复操作。
比较
- 事务:InnoDB 是事务型的,可以使用 Commit 和 Rollback 语句。
- 并发:MyISAM 只支持表级锁,而 InnoDB 还支持行级锁。
- 外键:InnoDB 支持外键。
- 备份:InnoDB 支持在线热备份。
- 崩溃恢复:MyISAM 崩溃后发生损坏的概率比 InnoDB 高很多,而且恢复的速度也更慢。
- 其它特性:MyISAM 支持压缩表和空间数据索引。
四、数据类型
整型
TINYINT, SMALLINT, MEDIUMINT, INT, BIGINT 分别使用 8, 16, 24, 32, 64 位存储空间,一般情况下越小的列越好。
INT(11) 中的数字只是规定了交互工具显示字符的个数,对于存储和计算来说是没有意义的。
浮点数
FLOAT 和 DOUBLE 为浮点类型,DECIMAL 为高精度小数类型。CPU 原生支持浮点运算,但是不支持 DECIMAl 类型的计算,因此 DECIMAL 的计算比浮点类型需要更高的代价。
FLOAT、DOUBLE 和 DECIMAL 都可以指定列宽,例如 DECIMAL(18, 9) 表示总共 18 位,取 9 位存储小数部分,剩下 9 位存储整数部分。
字符串
主要有 CHAR 和 VARCHAR 两种类型,一种是定长的,一种是变长的。
VARCHAR 这种变长类型能够节省空间,因为只需要存储必要的内容。但是在执行 UPDATE 时可能会使行变得比原来长,当超出一个页所能容纳的大小时,就要执行额外的操作。MyISAM 会将行拆成不同的片段存储,而 InnoDB 则需要分裂页来使行放进页内。
在进行存储和检索时,会保留 VARCHAR 末尾的空格,而会删除 CHAR 末尾的空格。
时间和日期
MySQL 提供了两种相似的日期时间类型:DATETIME 和 TIMESTAMP。
1. DATETIME
能够保存从 1000 年到 9999 年的日期和时间,精度为秒,使用 8 字节的存储空间。
它与时区无关。
默认情况下,MySQL 以一种可排序的、无歧义的格式显示 DATETIME 值,例如“2008-01-16 22:37:08”,这是 ANSI 标准定义的日期和时间表示方法。
2. TIMESTAMP
和 UNIX 时间戳相同,保存从 1970 年 1 月 1 日午夜(格林威治时间)以来的秒数,使用 4 个字节,只能表示从 1970 年到 2038 年。
它和时区有关,也就是说一个时间戳在不同的时区所代表的具体时间是不同的。
MySQL 提供了 FROM_UNIXTIME() 函数把 UNIX 时间戳转换为日期,并提供了 UNIX_TIMESTAMP() 函数把日期转换为 UNIX 时间戳。
默认情况下,如果插入时没有指定 TIMESTAMP 列的值,会将这个值设置为当前时间。
应该尽量使用 TIMESTAMP,因为它比 DATETIME 空间效率更高。
五、切分
水平切分
水平切分又称为 Sharding,它是将同一个表中的记录拆分到多个结构相同的表中。
当一个表的数据不断增多时,Sharding 是必然的选择,它可以将数据分布到集群的不同节点上,从而缓存单个数据库的压力。
垂直切分
垂直切分是将一张表按列切分成多个表,通常是按照列的关系密集程度进行切分,也可以利用垂直切分将经常被使用的列和不经常被使用的列切分到不同的表中。
在数据库的层面使用垂直切分将按数据库中表的密集程度部署到不同的库中,例如将原来的电商数据库垂直切分成商品数据库、用户数据库等。
Sharding 策略
- 哈希取模:hash(key) % N;
- 范围:可以是 ID 范围也可以是时间范围;
- 映射表:使用单独的一个数据库来存储映射关系。
Sharding 存在的问题
1. 事务问题
使用分布式事务来解决,比如 XA 接口。
2. 连接
可以将原来的连接分解成多个单表查询,然后在用户程序中进行连接。
3. ID 唯一性
- 使用全局唯一 ID(GUID)
- 为每个分片指定一个 ID 范围
- 分布式 ID 生成器 (如 Twitter 的 Snowflake 算法)
六、复制
主从复制
主要涉及三个线程:binlog 线程、I/O 线程和 SQL 线程。
- binlog 线程 :负责将主服务器上的数据更改写入二进制日志(Binary log)中。
- I/O 线程 :负责从主服务器上读取二进制日志,并写入从服务器的中继日志(Relay log)。
- SQL 线程 :负责读取中继日志,解析出主服务器已经执行的数据更改并在从服务器中重放(Replay)。

读写分离
主服务器处理写操作以及实时性要求比较高的读操作,而从服务器处理读操作。
读写分离能提高性能的原因在于:
- 主从服务器负责各自的读和写,极大程度缓解了锁的争用;
- 从服务器可以使用 MyISAM,提升查询性能以及节约系统开销;
- 增加冗余,提高可用性。
读写分离常用代理方式来实现,代理服务器接收应用层传来的读写请求,然后决定转发到哪个服务器。

参考资料
- BaronScbwartz, PeterZaitsev, VadimTkacbenko, 等. 高性能 MySQL[M]. 电子工业出版社, 2013.
- 姜承尧. MySQL 技术内幕: InnoDB 存储引擎 [M]. 机械工业出版社, 2011.
- 20+ 条 MySQL 性能优化的最佳经验
- 服务端指南 数据存储篇 | MySQL(09) 分库与分表带来的分布式困境与应对之策
- How to create unique row ID in sharded databases?
- SQL Azure Federation – Introduction
- MySQL 索引背后的数据结构及算法原理
- MySQL 性能优化神器 Explain 使用分析
- How Sharding Works
- 大众点评订单系统分库分表实践
- B + 树
Redis
Redis
* [一、概述](#一概述)
* [二、数据类型](#二数据类型)
    * [STRING](#string)
    * [LIST](#list)
    * [SET](#set)
    * [HASH](#hash)
    * [ZSET](#zset)
* [三、数据结构](#三数据结构)
    * [字典](#字典)
    * [跳跃表](#跳跃表)
* [四、使用场景](#四使用场景)
    * [计数器](#计数器)
    * [缓存](#缓存)
    * [查找表](#查找表)
    * [消息队列](#消息队列)
    * [会话缓存](#会话缓存)
    * [分布式锁实现](#分布式锁实现)
    * [其它](#其它)
* [五、Redis 与 Memcached](#五redis-与-memcached)
    * [数据类型](#数据类型)
    * [数据持久化](#数据持久化)
    * [分布式](#分布式)
    * [内存管理机制](#内存管理机制)
* [六、键的过期时间](#六键的过期时间)
* [七、数据淘汰策略](#七数据淘汰策略)
* [八、持久化](#八持久化)
    * [RDB 持久化](#rdb-持久化)
    * [AOF 持久化](#aof-持久化)
* [九、事务](#九事务)
* [十、事件](#十事件)
    * [文件事件](#文件事件)
    * [时间事件](#时间事件)
    * [事件的调度与执行](#事件的调度与执行)
* [十一、复制](#十一复制)
    * [连接过程](#连接过程)
    * [主从链](#主从链)
* [十二、Sentinel](#十二sentinel)
* [十三、分片](#十三分片)
* [十四、一个简单的论坛系统分析](#十四一个简单的论坛系统分析)
    * [文章信息](#文章信息)
    * [点赞功能](#点赞功能)
    * [对文章进行排序](#对文章进行排序)
* [参考资料](#参考资料)
一、概述
Redis 是速度非常快的非关系型(NoSQL)内存键值数据库,可以存储键和五种不同类型的值之间的映射。
键的类型只能为字符串,值支持五种数据类型:字符串、列表、集合、散列表、有序集合。
Redis 支持很多特性,例如将内存中的数据持久化到硬盘中,使用复制来扩展读性能,使用分片来扩展写性能。
二、数据类型
| 数据类型 | 可以存储的值 | 操作 |
|---|---|---|
| STRING | 字符串、整数或者浮点数 | 对整个字符串或者字符串的其中一部分执行操作\ 对整数和浮点数执行自增或者自减操作 |
| LIST | 列表 | 从两端压入或者弹出元素 \ 对单个或者多个元素进行修剪,\ 只保留一个范围内的元素 |
| SET | 无序集合 | 添加、获取、移除单个元素\ 检查一个元素是否存在于集合中\ 计算交集、并集、差集\ 从集合里面随机获取元素 |
| HASH | 包含键值对的无序散列表 | 添加、获取、移除单个键值对\ 获取所有键值对\ 检查某个键是否存在 |
| ZSET | 有序集合 | 添加、获取、删除元素\ 根据分值范围或者成员来获取元素\ 计算一个键的排名 |
What Redis data structures look like
STRING

> set hello world
OK
> get hello
"world"
> del hello
(integer) 1
> get hello
(nil)
LIST
> rpush list-key item
(integer) 1
> rpush list-key item2
(integer) 2
> rpush list-key item
(integer) 3

> lrange list-key 0 -1
1) "item"
2) "item2"
3) "item"

> lindex list-key 1
"item2"

> lpop list-key
"item"

> lrange list-key 0 -1
1) "item2"
2) "item"
SET

> sadd set-key item
(integer) 1
> sadd set-key item2
(integer) 1
> sadd set-key item3
(integer) 1
> sadd set-key item
(integer) 0

> smembers set-key
1) "item"
2) "item2"
3) "item3"

> sismember set-key item4
(integer) 0
> sismember set-key item
(integer) 1

> srem set-key item2
(integer) 1
> srem set-key item2
(integer) 0

> smembers set-key
1) "item"
2) "item3"
HASH
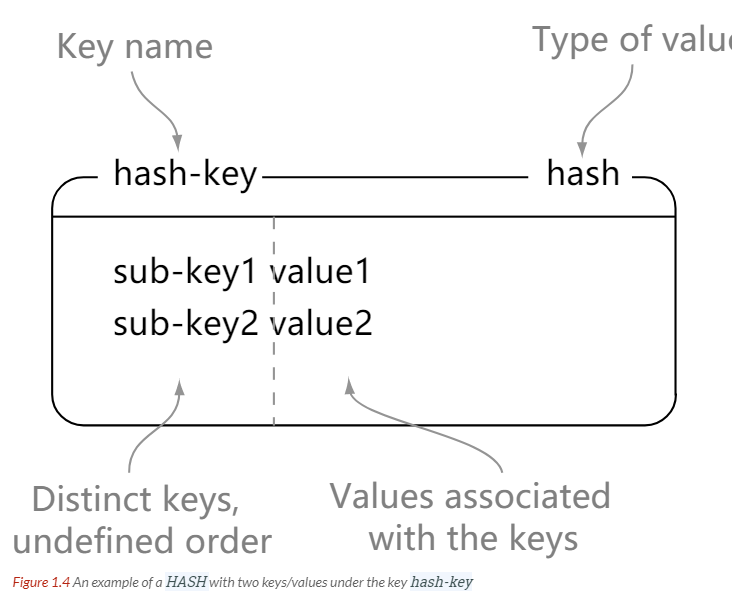
> hset hash-key sub-key1 value1
(integer) 1
> hset hash-key sub-key2 value2
(integer) 1
> hset hash-key sub-key1 value1
(integer) 0

> hgetall hash-key
1) "sub-key1"
2) "value1"
3) "sub-key2"
4) "value2"

> hdel hash-key sub-key2
(integer) 1
> hdel hash-key sub-key2
(integer) 0

> hget hash-key sub-key1
"value1"

> hgetall hash-key
1) "sub-key1"
2) "value1"
ZSET
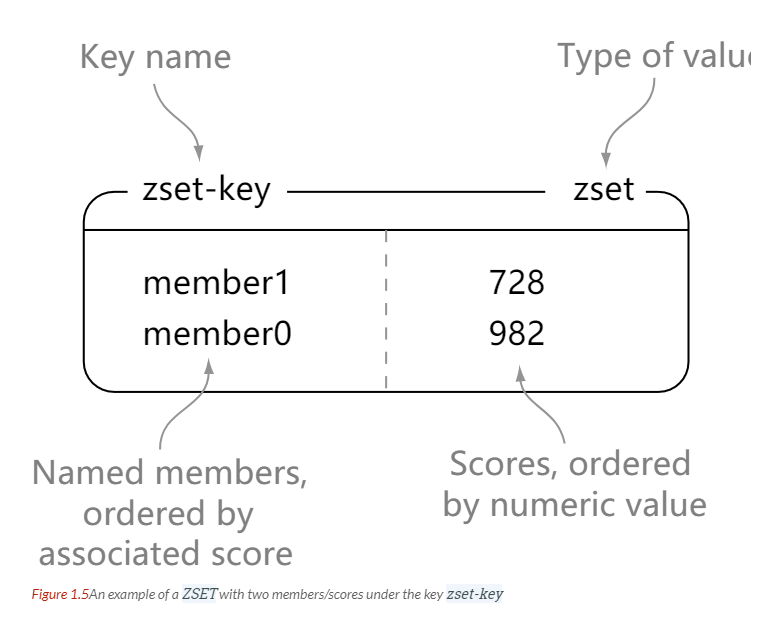
> zadd zset-key 728 member1
(integer) 1
> zadd zset-key 982 member0
(integer) 1
> zadd zset-key 982 member0
(integer) 0

> zrange zset-key 0 -1 withscores
1) "member1"
2) "728"
3) "member0"
4) "982"

> zrangebyscore zset-key 0 800 withscores
1) "member1"
2) "728"

> zrem zset-key member1
(integer) 1
> zrem zset-key member1
(integer) 0

> zrange zset-key 0 -1 withscores
1) "member0"
2) "982"
三、数据结构
字典
dictht 是一个散列表结构,使用拉链法解决哈希冲突。
/* This is our hash table structure. Every dictionary has two of this as we
 * implement incremental rehashing, for the old to the new table. */
typedef struct dictht {
    dictEntry **table;
    unsigned long size;
    unsigned long sizemask;
    unsigned long used;
} dictht;
typedef struct dictEntry {
void *key;
union {
void *val;
uint64_t u64;
int64_t s64;
double d;
} v;
struct dictEntry *next;
} dictEntry;Redis 的字典 dict 中包含两个哈希表 dictht,这是为了方便进行 rehash 操作。在扩容时,将其中一个 dictht 上的键值对 rehash 到另一个 dictht 上面,完成之后释放空间并交换两个 dictht 的角色。
typedef struct dict {
    dictType *type;
    void *privdata;
    dictht ht[2];
    long rehashidx; /* rehashing not in progress if rehashidx == -1 */
    unsigned long iterators; /* number of iterators currently running */
} dict;
rehash 操作不是一次性完成,而是采用渐进方式,这是为了避免一次性执行过多的 rehash 操作给服务器带来过大的负担。
渐进式 rehash 通过记录 dict 的 rehashidx 完成,它从 0 开始,然后每执行一次 rehash 都会递增。例如在一次 rehash 中,要把 dict[0] rehash 到 dict[1],这一次会把 dict[0] 上 table[rehashidx] 的键值对 rehash 到 dict[1] 上,dict[0] 的 table[rehashidx] 指向 null,并令 rehashidx++。
在 rehash 期间,每次对字典执行添加、删除、查找或者更新操作时,都会执行一次渐进式 rehash。
采用渐进式 rehash 会导致字典中的数据分散在两个 dictht 上,因此对字典的查找操作也需要到对应的 dictht 去执行。
/* Performs N steps of incremental rehashing. Returns 1 if there are still
 * keys to move from the old to the new hash table, otherwise 0 is returned.
 *
 * Note that a rehashing step consists in moving a bucket (that may have more
 * than one key as we use chaining) from the old to the new hash table, however
 * since part of the hash table may be composed of empty spaces, it is not
 * guaranteed that this function will rehash even a single bucket, since it
 * will visit at max N*10 empty buckets in total, otherwise the amount of
 * work it does would be unbound and the function may block for a long time. */
int dictRehash(dict *d, int n) {
    int empty_visits = n * 10; /* Max number of empty buckets to visit. */
    if (!dictIsRehashing(d)) return 0;

    while (n-- && d->ht[0].used != 0) {
        dictEntry *de, *nextde;

        /* Note that rehashidx can't overflow as we are sure there are more
         * elements because ht[0].used != 0 */
        assert(d->ht[0].size > (unsigned long) d->rehashidx);
        while (d->ht[0].table[d->rehashidx] == NULL) {
            d->rehashidx++;
            if (--empty_visits == 0) return 1;
        }
        de = d->ht[0].table[d->rehashidx];
        /* Move all the keys in this bucket from the old to the new hash HT */
        while (de) {
            uint64_t h;

            nextde = de->next;
            /* Get the index in the new hash table */
            h = dictHashKey(d, de->key) & d->ht[1].sizemask;
            de->next = d->ht[1].table[h];
            d->ht[1].table[h] = de;
            d->ht[0].used--;
            d->ht[1].used++;
            de = nextde;
        }
        d->ht[0].table[d->rehashidx] = NULL;
        d->rehashidx++;
    }

    /* Check if we already rehashed the whole table... */
    if (d->ht[0].used == 0) {
        zfree(d->ht[0].table);
        d->ht[0] = d->ht[1];
        _dictReset(&d->ht[1]);
        d->rehashidx = -1;
        return 0;
    }

    /* More to rehash... */
    return 1;
}
跳跃表
是有序集合的底层实现之一。
跳跃表是基于多指针有序链表实现的,可以看成多个有序链表。

在查找时,从上层指针开始查找,找到对应的区间之后再到下一层去查找。下图演示了查找 22 的过程。
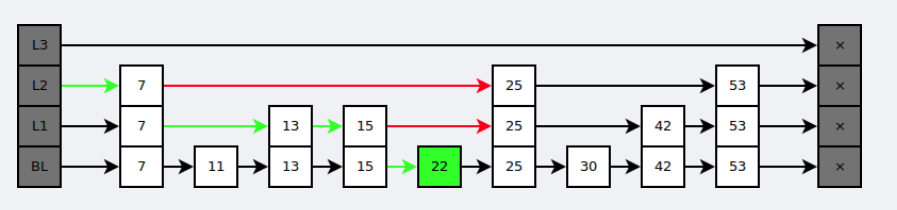
与红黑树等平衡树相比,跳跃表具有以下优点:
- 插入速度非常快速,因为不需要进行旋转等操作来维护平衡性;
- 更容易实现;
- 支持无锁操作。
四、使用场景
计数器
可以对 String 进行自增自减运算,从而实现计数器功能。
Redis 这种内存型数据库的读写性能非常高,很适合存储频繁读写的计数量。
缓存
将热点数据放到内存中,设置内存的最大使用量以及淘汰策略来保证缓存的命中率。
查找表
例如 DNS 记录就很适合使用 Redis 进行存储。
查找表和缓存类似,也是利用了 Redis 快速的查找特性。但是查找表的内容不能失效,而缓存的内容可以失效,因为缓存不作为可靠的数据来源。
消息队列
List 是一个双向链表,可以通过 lpush 和 rpop 写入和读取消息
不过最好使用 Kafka、RabbitMQ 等消息中间件。
会话缓存
可以使用 Redis 来统一存储多台应用服务器的会话信息。
当应用服务器不再存储用户的会话信息,也就不再具有状态,一个用户可以请求任意一个应用服务器,从而更容易实现高可用性以及可伸缩性。
分布式锁实现
在分布式场景下,无法使用单机环境下的锁来对多个节点上的进程进行同步。
可以使用 Redis 自带的 SETNX 命令实现分布式锁,除此之外,还可以使用官方提供的 RedLock 分布式锁实现。
其它
Set 可以实现交集、并集等操作,从而实现共同好友等功能。
ZSet 可以实现有序性操作,从而实现排行榜等功能。
五、Redis 与 Memcached
两者都是非关系型内存键值数据库,主要有以下不同:
数据类型
Memcached 仅支持字符串类型,而 Redis 支持五种不同的数据类型,可以更灵活地解决问题。
数据持久化
Redis 支持两种持久化策略:RDB 快照和 AOF 日志,而 Memcached 不支持持久化。
分布式
Memcached 不支持分布式,只能通过在客户端使用一致性哈希来实现分布式存储,这种方式在存储和查询时都需要先在客户端计算一次数据所在的节点。
Redis Cluster 实现了分布式的支持。
内存管理机制
- 在 Redis 中,并不是所有数据都一直存储在内存中,可以将一些很久没用的 value 交换到磁盘,而 Memcached 的数据则会一直在内存中。
- Memcached 将内存分割成特定长度的块来存储数据,以完全解决内存碎片的问题。但是这种方式会使得内存的利用率不高,例如块的大小为 128 bytes,只存储 100 bytes 的数据,那么剩下的 28 bytes 就浪费掉了。
六、键的过期时间
Redis 可以为每个键设置过期时间,当键过期时,会自动删除该键。
对于散列表这种容器,只能为整个键设置过期时间(整个散列表),而不能为键里面的单个元素设置过期时间。
七、数据淘汰策略
可以设置内存最大使用量,当内存使用量超出时,会施行数据淘汰策略。
Redis 具体有 6 种淘汰策略:
| 策略 | 描述 |
|---|---|
| volatile-lru | 从已设置过期时间的数据集中挑选最近最少使用的数据淘汰 |
| volatile-ttl | 从已设置过期时间的数据集中挑选将要过期的数据淘汰 |
| volatile-random | 从已设置过期时间的数据集中任意选择数据淘汰 |
| allkeys-lru | 从所有数据集中挑选最近最少使用的数据淘汰 |
| allkeys-random | 从所有数据集中任意选择数据进行淘汰 |
| noeviction | 禁止驱逐数据 |
作为内存数据库,出于对性能和内存消耗的考虑,Redis 的淘汰算法实际实现上并非针对所有 key,而是抽样一小部分并且从中选出被淘汰的 key。
使用 Redis 缓存数据时,为了提高缓存命中率,需要保证缓存数据都是热点数据。可以将内存最大使用量设置为热点数据占用的内存量,然后启用 allkeys-lru 淘汰策略,将最近最少使用的数据淘汰。
Redis 4.0 引入了 volatile-lfu 和 allkeys-lfu 淘汰策略,LFU 策略通过统计访问频率,将访问频率最少的键值对淘汰。
八、持久化
Redis 是内存型数据库,为了保证数据在断电后不会丢失,需要将内存中的数据持久化到硬盘上。
RDB 持久化
将某个时间点的所有数据都存放到硬盘上。
可以将快照复制到其它服务器从而创建具有相同数据的服务器副本。
如果系统发生故障,将会丢失最后一次创建快照之后的数据。
如果数据量很大,保存快照的时间会很长。
AOF 持久化
将写命令添加到 AOF 文件(Append Only File)的末尾。
使用 AOF 持久化需要设置同步选项,从而确保写命令同步到磁盘文件上的时机。这是因为对文件进行写入并不会马上将内容同步到磁盘上,而是先存储到缓冲区,然后由操作系统决定什么时候同步到磁盘。有以下同步选项:
| 选项 | 同步频率 |
|---|---|
| always | 每个写命令都同步 |
| everysec | 每秒同步一次 |
| no | 让操作系统来决定何时同步 |
- always 选项会严重减低服务器的性能;
- everysec 选项比较合适,可以保证系统崩溃时只会丢失一秒左右的数据,并且 Redis 每秒执行一次同步对服务器性能几乎没有任何影响;
- no 选项并不能给服务器性能带来多大的提升,而且也会增加系统崩溃时数据丢失的数量。
随着服务器写请求的增多,AOF 文件会越来越大。Redis 提供了一种将 AOF 重写的特性,能够去除 AOF 文件中的冗余写命令。
九、事务
一个事务包含了多个命令,服务器在执行事务期间,不会改去执行其它客户端的命令请求。
事务中的多个命令被一次性发送给服务器,而不是一条一条发送,这种方式被称为流水线,它可以减少客户端与服务器之间的网络通信次数从而提升性能。
Redis 最简单的事务实现方式是使用 MULTI 和 EXEC 命令将事务操作包围起来。
十、事件
Redis 服务器是一个事件驱动程序。
文件事件
服务器通过套接字与客户端或者其它服务器进行通信,文件事件就是对套接字操作的抽象。
Redis 基于 Reactor 模式开发了自己的网络事件处理器,使用 I/O 多路复用程序来同时监听多个套接字,并将到达的事件传送给文件事件分派器,分派器会根据套接字产生的事件类型调用相应的事件处理器。
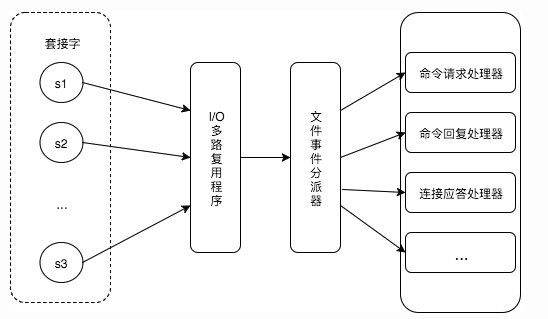
时间事件
服务器有一些操作需要在给定的时间点执行,时间事件是对这类定时操作的抽象。
时间事件又分为:
- 定时事件:是让一段程序在指定的时间之内执行一次;
- 周期性事件:是让一段程序每隔指定时间就执行一次。
Redis 将所有时间事件都放在一个无序链表中,通过遍历整个链表查找出已到达的时间事件,并调用相应的事件处理器。
事件的调度与执行
服务器需要不断监听文件事件的套接字才能得到待处理的文件事件,但是不能一直监听,否则时间事件无法在规定的时间内执行,因此监听时间应该根据距离现在最近的时间事件来决定。
事件调度与执行由 aeProcessEvents 函数负责,伪代码如下:
def aeProcessEvents():
    # 获取到达时间离当前时间最接近的时间事件
    time_event = aeSearchNearestTimer()
    # 计算最接近的时间事件距离到达还有多少毫秒
    remaind_ms = time_event.when - unix_ts_now()
    # 如果事件已到达,那么 remaind_ms 的值可能为负数,将它设为 0
    if remaind_ms < 0:
        remaind_ms = 0
    # 根据 remaind_ms 的值,创建 timeval
    timeval = create_timeval_with_ms(remaind_ms)
    # 阻塞并等待文件事件产生,最大阻塞时间由传入的 timeval 决定
    aeApiPoll(timeval)
    # 处理所有已产生的文件事件
    procesFileEvents()
    # 处理所有已到达的时间事件
    processTimeEvents()
将 aeProcessEvents 函数置于一个循环里面,加上初始化和清理函数,就构成了 Redis 服务器的主函数,伪代码如下:
def main():
    # 初始化服务器
    init_server()
    # 一直处理事件,直到服务器关闭为止
    while server_is_not_shutdown():
        aeProcessEvents()
    # 服务器关闭,执行清理操作
    clean_server()
从事件处理的角度来看,服务器运行流程如下:
十一、复制
通过使用 slaveof host port 命令来让一个服务器成为另一个服务器的从服务器。
一个从服务器只能有一个主服务器,并且不支持主主复制。
连接过程
- 主服务器创建快照文件,发送给从服务器,并在发送期间使用缓冲区记录执行的写命令。快照文件发送完毕之后,开始向从服务器发送存储在缓冲区中的写命令;
- 从服务器丢弃所有旧数据,载入主服务器发来的快照文件,之后从服务器开始接受主服务器发来的写命令;
- 主服务器每执行一次写命令,就向从服务器发送相同的写命令。
主从链
随着负载不断上升,主服务器可能无法很快地更新所有从服务器,或者重新连接和重新同步从服务器将导致系统超载。为了解决这个问题,可以创建一个中间层来分担主服务器的复制工作。中间层的服务器是最上层服务器的从服务器,又是最下层服务器的主服务器。
十二、Sentinel
Sentinel(哨兵)可以监听集群中的服务器,并在主服务器进入下线状态时,自动从从服务器中选举出新的主服务器。
十三、分片
分片是将数据划分为多个部分的方法,可以将数据存储到多台机器里面,这种方法在解决某些问题时可以获得线性级别的性能提升。
假设有 4 个 Redis 实例 R0,R1,R2,R3,还有很多表示用户的键 user:1,user:2,... ,有不同的方式来选择一个指定的键存储在哪个实例中。
- 最简单的方式是范围分片,例如用户 id 从 0\~1000 的存储到实例 R0 中,用户 id 从 1001\~2000 的存储到实例 R1 中,等等。但是这样需要维护一张映射范围表,维护操作代价很高。
- 还有一种方式是哈希分片,使用 CRC32 哈希函数将键转换为一个数字,再对实例数量求模就能知道应该存储的实例。
根据执行分片的位置,可以分为三种分片方式:
- 客户端分片:客户端使用一致性哈希等算法决定键应当分布到哪个节点。
- 代理分片:将客户端请求发送到代理上,由代理转发请求到正确的节点上。
- 服务器分片:Redis Cluster。
十四、一个简单的论坛系统分析
该论坛系统功能如下:
- 可以发布文章;
- 可以对文章进行点赞;
- 在首页可以按文章的发布时间或者文章的点赞数进行排序显示。
文章信息
文章包括标题、作者、赞数等信息,在关系型数据库中很容易构建一张表来存储这些信息,在 Redis 中可以使用 HASH 来存储每种信息以及其对应的值的映射。
Redis 没有关系型数据库中的表这一概念来将同种类型的数据存放在一起,而是使用命名空间的方式来实现这一功能。键名的前面部分存储命名空间,后面部分的内容存储 ID,通常使用 : 来进行分隔。例如下面的 HASH 的键名为 article:92617,其中 article 为命名空间,ID 为 92617。

点赞功能
当有用户为一篇文章点赞时,除了要对该文章的 votes 字段进行加 1 操作,还必须记录该用户已经对该文章进行了点赞,防止用户点赞次数超过 1。可以建立文章的已投票用户集合来进行记录。
为了节约内存,规定一篇文章发布满一周之后,就不能再对它进行投票,而文章的已投票集合也会被删除,可以为文章的已投票集合设置一个一周的过期时间就能实现这个规定。

对文章进行排序
为了按发布时间和点赞数进行排序,可以建立一个文章发布时间的有序集合和一个文章点赞数的有序集合。(下图中的 score 就是这里所说的点赞数;下面所示的有序集合分值并不直接是时间和点赞数,而是根据时间和点赞数间接计算出来的)
参考资料
- Carlson J L. Redis in Action[J]. Media.johnwiley.com.au, 2013.
- [黄健宏. Redis 设计与实现 [M]. 机械工业出版社, 2014.](http://redisbook.com/index.html)
- REDIS IN ACTION
- Skip Lists: Done Right
- 论述 Redis 和 Memcached 的差异
- Redis 3.0 中文版- 分片
- Redis 应用场景
- Using Redis as an LRU cache
Java 基础
Java 基础
* [一、数据类型](#一数据类型)
    * [基本类型](#基本类型)
    * [包装类型](#包装类型)
    * [缓存池](#缓存池)
* [二、String](#二string)
    * [概览](#概览)
    * [不可变的好处](#不可变的好处)
    * [String, StringBuffer and StringBuilder	](#string-stringbuffer-and-stringbuilder	)
    * [String Pool](#string-pool)
    * [new String("abc")](#new-stringabc)
* [三、运算](#三运算)
    * [参数传递](#参数传递)
    * [float 与 double](#float-与-double)
    * [隐式类型转换](#隐式类型转换)
    * [switch](#switch)
* [四、关键字](#四关键字)
    * [final](#final)
    * [static](#static)
* [五、Object 通用方法](#五object-通用方法)
    * [概览](#概览)
    * [equals()](#equals)
    * [hashCode()](#hashcode)
    * [toString()](#tostring)
    * [clone()](#clone)
* [六、继承](#六继承)
    * [访问权限](#访问权限)
    * [抽象类与接口](#抽象类与接口)
    * [super](#super)
    * [重写与重载](#重写与重载)
* [七、反射](#七反射)
* [八、异常](#八异常)
* [九、泛型](#九泛型)
* [十、注解](#十注解)
* [十一、特性](#十一特性)
    * [Java 各版本的新特性](#java-各版本的新特性)
    * [Java 与 C++ 的区别](#java-与-c-的区别)
    * [JRE or JDK](#jre-or-jdk)
* [参考资料](#参考资料)
一、数据类型
基本类型
- byte/8
- char/16
- short/16
- int/32
- float/32
- long/64
- double/64
- boolean/\~
boolean 只有两个值:true、false,可以使用 1 bit 来存储,但是具体大小没有明确规定。JVM 会在编译时期将 boolean 类型的数据转换为 int,使用 1 来表示 true,0 表示 false。JVM 支持 boolean 数组,但是是通过读写 byte 数组来实现的。
包装类型
基本类型都有对应的包装类型,基本类型与其对应的包装类型之间的赋值使用自动装箱与拆箱完成。
Integer x = 2;     // 装箱 调用了 Integer.valueOf(2)
int y = x; // 拆箱 调用了 X.intValue()缓存池
new Integer(123) 与 Integer.valueOf(123) 的区别在于:
- new Integer(123) 每次都会新建一个对象;
- Integer.valueOf(123) 会使用缓存池中的对象,多次调用会取得同一个对象的引用。
Integer x = new Integer(123);
Integer y = new Integer(123);
System.out.println(x == y);    // false
Integer z = Integer.valueOf(123);
Integer k = Integer.valueOf(123);
System.out.println(z == k);   // true
valueOf() 方法的实现比较简单,就是先判断值是否在缓存池中,如果在的话就直接返回缓存池的内容。
public static Integer valueOf(int i) {
    if (i >= IntegerCache.low && i <= IntegerCache.high)
        return IntegerCache.cache[i + (-IntegerCache.low)];
    return new Integer(i);
}
在 Java 8 中,Integer 缓存池的大小默认为 -128\~127。
static final int low = -128;
static final int high;
static final Integer cache[];

static {
    // high value may be configured by property
    int h = 127;
    String integerCacheHighPropValue =
        sun.misc.VM.getSavedProperty("java.lang.Integer.IntegerCache.high");
    if (integerCacheHighPropValue != null) {
        try {
            int i = parseInt(integerCacheHighPropValue);
            i = Math.max(i, 127);
            // Maximum array size is Integer.MAX_VALUE
            h = Math.min(i, Integer.MAX_VALUE - (-low) -1);
        } catch( NumberFormatException nfe) {
            // If the property cannot be parsed into an int, ignore it.
        }
    }
    high = h;

    cache = new Integer[(high - low) + 1];
    int j = low;
    for(int k = 0; k < cache.length; k++)
        cache[k] = new Integer(j++);

    // range [-128, 127] must be interned (JLS7 5.1.7)
    assert IntegerCache.high >= 127;
}
编译器会在自动装箱过程调用 valueOf() 方法,因此多个值相同且值在缓存池范围内的 Integer 实例使用自动装箱来创建,那么就会引用相同的对象。
Integer m = 123;
Integer n = 123;
System.out.println(m == n); // true
基本类型对应的缓冲池如下:
- boolean values true and false
- all byte values
- short values between -128 and 127
- int values between -128 and 127
- char in the range \u0000 to \u007F
在使用这些基本类型对应的包装类型时,如果该数值范围在缓冲池范围内,就可以直接使用缓冲池中的对象。
在 jdk 1.8 所有的数值类缓冲池中,Integer 的缓冲池 IntegerCache 很特殊,这个缓冲池的下界是 - 128,上界默认是 127,但是这个上界是可调的,在启动 jvm 的时候,通过 -XX:AutoBoxCacheMax=<size> 来指定这个缓冲池的大小,该选项在 JVM 初始化的时候会设定一个名为 java.lang.IntegerCache.high 系统属性,然后 IntegerCache 初始化的时候就会读取该系统属性来决定上界。
StackOverflow : Differences between new Integer(123), Integer.valueOf(123) and just 123
二、String
概览
String 被声明为 final,因此它不可被继承。(Integer 等包装类也不能被继承)
在 Java 8 中,String 内部使用 char 数组存储数据。
public final class String
    implements java.io.Serializable, Comparable<String>, CharSequence {
    /** The value is used for character storage. */
    private final char value[];
}
在 Java 9 之后,String 类的实现改用 byte 数组存储字符串,同时使用 coder 来标识使用了哪种编码。
public final class String
    implements java.io.Serializable, Comparable<String>, CharSequence {
    /** The value is used for character storage. */
    private final byte[] value;

    /** The identifier of the encoding used to encode the bytes in {@code value}. */
    private final byte coder;
}
value 数组被声明为 final,这意味着 value 数组初始化之后就不能再引用其它数组。并且 String 内部没有改变 value 数组的方法,因此可以保证 String 不可变。
不可变的好处
1. 可以缓存 hash 值
因为 String 的 hash 值经常被使用,例如 String 用做 HashMap 的 key。不可变的特性可以使得 hash 值也不可变,因此只需要进行一次计算。
2. String Pool 的需要
如果一个 String 对象已经被创建过了,那么就会从 String Pool 中取得引用。只有 String 是不可变的,才可能使用 String Pool。
3. 安全性
String 经常作为参数,String 不可变性可以保证参数不可变。例如在作为网络连接参数的情况下如果 String 是可变的,那么在网络连接过程中,String 被改变,改变 String 的那一方以为现在连接的是其它主机,而实际情况却不一定是。
4. 线程安全
String 不可变性天生具备线程安全,可以在多个线程中安全地使用。
Program Creek : Why String is immutable in Java?
String, StringBuffer and StringBuilder
1. 可变性
- String 不可变
- StringBuffer 和 StringBuilder 可变
2. 线程安全
- String 不可变,因此是线程安全的
- StringBuilder 不是线程安全的
- StringBuffer 是线程安全的,内部使用 synchronized 进行同步
StackOverflow : String, StringBuffer, and StringBuilder
String Pool
字符串常量池(String Pool)保存着所有字符串字面量(literal strings),这些字面量在编译时期就确定。不仅如此,还可以使用 String 的 intern() 方法在运行过程将字符串添加到 String Pool 中。
当一个字符串调用 intern() 方法时,如果 String Pool 中已经存在一个字符串和该字符串值相等(使用 equals() 方法进行确定),那么就会返回 String Pool 中字符串的引用;否则,就会在 String Pool 中添加一个新的字符串,并返回这个新字符串的引用。
下面示例中,s1 和 s2 采用 new String() 的方式新建了两个不同字符串,而 s3 和 s4 是通过 s1.intern() 和 s2.intern() 方法取得同一个字符串引用。intern() 首先把 "aaa" 放到 String Pool 中,然后返回这个字符串引用,因此 s3 和 s4 引用的是同一个字符串。
String s1 = new String("aaa");
String s2 = new String("aaa");
System.out.println(s1 == s2);           // false
String s3 = s1.intern();
String s4 = s2.intern();
System.out.println(s3 == s4);           // true
如果是采用 "bbb" 这种字面量的形式创建字符串,会自动地将字符串放入 String Pool 中。
String s5 = "bbb";
String s6 = "bbb";
System.out.println(s5 == s6);  // true
在 Java 7 之前,String Pool 被放在运行时常量池中,它属于永久代。而在 Java 7,String Pool 被移到堆中。这是因为永久代的空间有限,在大量使用字符串的场景下会导致 OutOfMemoryError 错误。
new String("abc")
使用这种方式一共会创建两个字符串对象(前提是 String Pool 中还没有 "abc" 字符串对象)。
- "abc" 属于字符串字面量,因此编译时期会在 String Pool 中创建一个字符串对象,指向这个 "abc" 字符串字面量;
- 而使用 new 的方式会在堆中创建一个字符串对象。
创建一个测试类,其 main 方法中使用这种方式来创建字符串对象。
public class NewStringTest {
    public static void main(String[] args) {
        String s = new String("abc");
    }
}
使用 javap -verbose 进行反编译,得到以下内容:
// ...
Constant pool:
// ...
   #2 = Class              #18            // java/lang/String
   #3 = String             #19            // abc
// ...
  #18 = Utf8               java/lang/String
  #19 = Utf8               abc
// ...

  public static void main(java.lang.String[]);
    descriptor: ([Ljava/lang/String;)V
    flags: ACC_PUBLIC, ACC_STATIC
    Code:
      stack=3, locals=2, args_size=1
         0: new           #2                  // class java/lang/String
         3: dup
         4: ldc           #3                  // String abc
         6: invokespecial #4                  // Method java/lang/String."<init>":(Ljava/lang/String;)V
         9: astore_1
// ...
在 Constant Pool 中,#19 存储这字符串字面量 "abc",#3 是 String Pool 的字符串对象,它指向 #19 这个字符串字面量。在 main 方法中,0: 行使用 new #2 在堆中创建一个字符串对象,并且使用 ldc #3 将 String Pool 中的字符串对象作为 String 构造函数的参数。
以下是 String 构造函数的源码,可以看到,在将一个字符串对象作为另一个字符串对象的构造函数参数时,并不会完全复制 value 数组内容,而是都会指向同一个 value 数组。
public String(String original) {
    this.value = original.value;
    this.hash = original.hash;
}
三、运算
参数传递
Java 的参数是以值传递的形式传入方法中,而不是引用传递。
以下代码中 Dog dog 的 dog 是一个指针,存储的是对象的地址。在将一个参数传入一个方法时,本质上是将对象的地址以值的方式传递到形参中。
public class Dog {

    String name;

    Dog(String name) {
        this.name = name;
    }

    String getName() {
        return this.name;
    }

    void setName(String name) {
        this.name = name;
    }

    String getObjectAddress() {
        return super.toString();
    }
}
在方法中改变对象的字段值会改变原对象该字段值,因为引用的是同一个对象。
class PassByValueExample {
    public static void main(String[] args) {
        Dog dog = new Dog("A");
        func(dog);
        System.out.println(dog.getName());          // B
    }

    private static void func(Dog dog) {
        dog.setName("B");
    }
}
但是在方法中将指针引用了其它对象,那么此时方法里和方法外的两个指针指向了不同的对象,在一个指针改变其所指向对象的内容对另一个指针所指向的对象没有影响。
public class PassByValueExample {
    public static void main(String[] args) {
        Dog dog = new Dog("A");
        System.out.println(dog.getObjectAddress()); // Dog@4554617c
        func(dog);
        System.out.println(dog.getObjectAddress()); // Dog@4554617c
        System.out.println(dog.getName());          // A
    }

    private static void func(Dog dog) {
        System.out.println(dog.getObjectAddress()); // Dog@4554617c
        dog = new Dog("B");
        System.out.println(dog.getObjectAddress()); // Dog@74a14482
        System.out.println(dog.getName());          // B
    }
}
StackOverflow: Is Java “pass-by-reference” or “pass-by-value”?
float 与 double
Java 不能隐式执行向下转型,因为这会使得精度降低。
1.1 字面量属于 double 类型,不能直接将 1.1 直接赋值给 float 变量,因为这是向下转型。
// float f = 1.1;1.1f 字面量才是 float 类型。
float f = 1.1f;隐式类型转换
因为字面量 1 是 int 类型,它比 short 类型精度要高,因此不能隐式地将 int 类型向下转型为 short 类型。
short s1 = 1;
// s1 = s1 + 1;
但是使用 += 或者 ++ 运算符会执行隐式类型转换。
s1 += 1;
s1++;
上面的语句相当于将 s1 + 1 的计算结果进行了向下转型:
s1 = (short) (s1 + 1);StackOverflow : Why don't Java's +=, -=, *=, /= compound assignment operators require casting?
switch
从 Java 7 开始,可以在 switch 条件判断语句中使用 String 对象。
String s = "a";
switch (s) {
    case "a":
        System.out.println("aaa");
        break;
    case "b":
        System.out.println("bbb");
        break;
}
switch 不支持 long、float、double,是因为 switch 的设计初衷是对那些只有少数几个值的类型进行等值判断,如果值过于复杂,那么还是用 if 比较合适。
// long x = 111;
// switch (x) { // Incompatible types. Found: 'long', required: 'char, byte, short, int, Character, Byte, Short, Integer, String, or an enum'
//     case 111:
//         System.out.println(111);
//         break;
//     case 222:
//         System.out.println(222);
//         break;
// }
StackOverflow : Why can't your switch statement data type be long, Java?
四、关键字
final
1. 数据
声明数据为常量,可以是编译时常量,也可以是在运行时被初始化后不能被改变的常量。
- 对于基本类型,final 使数值不变;
- 对于引用类型,final 使引用不变,也就不能引用其它对象,但是被引用的对象本身是可以修改的。
final int x = 1;
// x = 2;  // cannot assign value to final variable 'x'
final A y = new A();
y.a = 1;
2. 方法
声明方法不能被子类重写。
private 方法隐式地被指定为 final,如果在子类中定义的方法和基类中的一个 private 方法签名相同,此时子类的方法不是重写基类方法,而是在子类中定义了一个新的方法。
3. 类
声明类不允许被继承。
static
1. 静态变量
- 静态变量:又称为类变量,也就是说这个变量属于类的,类所有的实例都共享静态变量,可以直接通过类名来访问它。静态变量在内存中只存在一份。
- 实例变量:每创建一个实例就会产生一个实例变量,它与该实例同生共死。
public class A {

    private int x;         // 实例变量
    private static int y;  // 静态变量

    public static void main(String[] args) {
        // int x = A.x;  // Non-static field 'x' cannot be referenced from a static context
        A a = new A();
        int x = a.x;
        int y = A.y;
    }
}
2. 静态方法
静态方法在类加载的时候就存在了,它不依赖于任何实例。所以静态方法必须有实现,也就是说它不能是抽象方法。
public abstract class A {
    public static void func1(){
    }
    // public abstract static void func2();  // Illegal combination of modifiers: 'abstract' and 'static'
}
只能访问所属类的静态字段和静态方法,方法中不能有 this 和 super 关键字,因为这两个关键字与具体对象关联。
public class A {

    private static int x;
    private int y;

    public static void func1(){
        int a = x;
        // int b = y;  // Non-static field 'y' cannot be referenced from a static context
        // int b = this.y;     // 'A.this' cannot be referenced from a static context
    }
}
3. 静态语句块
静态语句块在类初始化时运行一次。
public class A {
    static {
        System.out.println("123");
    }

    public static void main(String[] args) {
        A a1 = new A();
        A a2 = new A();
    }
}1234. 静态内部类
非静态内部类依赖于外部类的实例,也就是说需要先创建外部类实例,才能用这个实例去创建非静态内部类。而静态内部类不需要。
public class OuterClass {

    class InnerClass {
    }

    static class StaticInnerClass {
    }

    public static void main(String[] args) {
        // InnerClass innerClass = new InnerClass(); // 'OuterClass.this' cannot be referenced from a static context
        OuterClass outerClass = new OuterClass();
        InnerClass innerClass = outerClass.new InnerClass();
        StaticInnerClass staticInnerClass = new StaticInnerClass();
    }
}
静态内部类不能访问外部类的非静态的变量和方法。
5. 静态导包
在使用静态变量和方法时不用再指明 ClassName,从而简化代码,但可读性大大降低。
import static com.xxx.ClassName.*6. 初始化顺序
静态变量和静态语句块优先于实例变量和普通语句块,静态变量和静态语句块的初始化顺序取决于它们在代码中的顺序。
public static String staticField = "静态变量";static {
System.out.println("静态语句块");
}public String field = "实例变量";{
System.out.println("普通语句块");
}最后才是构造函数的初始化。
public InitialOrderTest() {
    System.out.println("构造函数");
}
存在继承的情况下,初始化顺序为:
- 父类(静态变量、静态语句块)
- 子类(静态变量、静态语句块)
- 父类(实例变量、普通语句块)
- 父类(构造函数)
- 子类(实例变量、普通语句块)
- 子类(构造函数)
五、Object 通用方法
概览
public native int hashCode()

public boolean equals(Object obj)

protected native Object clone() throws CloneNotSupportedException

public String toString()

public final native Class<?> getClass()

protected void finalize() throws Throwable {}

public final native void notify()

public final native void notifyAll()

public final native void wait(long timeout) throws InterruptedException

public final void wait(long timeout, int nanos) throws InterruptedException

public final void wait() throws InterruptedException
equals()
1. 等价关系
两个对象具有等价关系,需要满足以下五个条件:
Ⅰ 自反性
x.equals(x); // trueⅡ 对称性
x.equals(y) == y.equals(x); // trueⅢ 传递性
if (x.equals(y) && y.equals(z))
    x.equals(z); // true;
Ⅳ 一致性
多次调用 equals() 方法结果不变
x.equals(y) == x.equals(y); // trueⅤ 与 null 的比较
对任何不是 null 的对象 x 调用 x.equals(null) 结果都为 false
x.equals(null); // false;2. 等价与相等
- 对于基本类型,== 判断两个值是否相等,基本类型没有 equals() 方法。
- 对于引用类型,== 判断两个变量是否引用同一个对象,而 equals() 判断引用的对象是否等价。
Integer x = new Integer(1);
Integer y = new Integer(1);
System.out.println(x.equals(y)); // true
System.out.println(x == y);      // false
3. 实现
- 检查是否为同一个对象的引用,如果是直接返回 true;
- 检查是否是同一个类型,如果不是,直接返回 false;
- 将 Object 对象进行转型;
- 判断每个关键域是否相等。
public class EqualExample {

    private int x;
    private int y;
    private int z;

    public EqualExample(int x, int y, int z) {
        this.x = x;
        this.y = y;
        this.z = z;
    }

    @Override
    public boolean equals(Object o) {
        if (this == o) return true;
        if (o == null || getClass() != o.getClass()) return false;

        EqualExample that = (EqualExample) o;

        if (x != that.x) return false;
        if (y != that.y) return false;
        return z == that.z;
    }
}
hashCode()
hashCode() 返回哈希值,而 equals() 是用来判断两个对象是否等价。等价的两个对象散列值一定相同,但是散列值相同的两个对象不一定等价,这是因为计算哈希值具有随机性,两个值不同的对象可能计算出相同的哈希值。
在覆盖 equals() 方法时应当总是覆盖 hashCode() 方法,保证等价的两个对象哈希值也相等。
HashSet 和 HashMap 等集合类使用了 hashCode() 方法来计算对象应该存储的位置,因此要将对象添加到这些集合类中,需要让对应的类实现 hashCode() 方法。
下面的代码中,新建了两个等价的对象,并将它们添加到 HashSet 中。我们希望将这两个对象当成一样的,只在集合中添加一个对象。但是 EqualExample 没有实现 hashCode() 方法,因此这两个对象的哈希值是不同的,最终导致集合添加了两个等价的对象。
EqualExample e1 = new EqualExample(1, 1, 1);
EqualExample e2 = new EqualExample(1, 1, 1);
System.out.println(e1.equals(e2)); // true
HashSet<EqualExample> set = new HashSet<>();
set.add(e1);
set.add(e2);
System.out.println(set.size());   // 2
理想的哈希函数应当具有均匀性,即不相等的对象应当均匀分布到所有可能的哈希值上。这就要求了哈希函数要把所有域的值都考虑进来。可以将每个域都当成 R 进制的某一位,然后组成一个 R 进制的整数。
R 一般取 31,因为它是一个奇素数,如果是偶数的话,当出现乘法溢出,信息就会丢失,因为与 2 相乘相当于向左移一位,最左边的位丢失。并且一个数与 31 相乘可以转换成移位和减法:31*x == (x<<5)-x,编译器会自动进行这个优化。
@Override
public int hashCode() {
    int result = 17;
    result = 31 * result + x;
    result = 31 * result + y;
    result = 31 * result + z;
    return result;
}
toString()
默认返回 ToStringExample@4554617c 这种形式,其中 @ 后面的数值为散列码的无符号十六进制表示。
public class ToStringExample {

    private int number;

    public ToStringExample(int number) {
        this.number = number;
    }
}
ToStringExample example = new ToStringExample(123);
System.out.println(example.toString());ToStringExample@4554617cclone()
1. cloneable
clone() 是 Object 的 protected 方法,它不是 public,一个类不显式去重写 clone(),其它类就不能直接去调用该类实例的 clone() 方法。
public class CloneExample {
    private int a;
    private int b;
}
CloneExample e1 = new CloneExample();
// CloneExample e2 = e1.clone(); // 'clone()' has protected access in 'java.lang.Object'重写 clone() 得到以下实现:
public class CloneExample {
    private int a;
    private int b;

    @Override
    public CloneExample clone() throws CloneNotSupportedException {
        return (CloneExample)super.clone();
    }
}
CloneExample e1 = new CloneExample();
try {
CloneExample e2 = e1.clone();
} catch (CloneNotSupportedException e) {
e.printStackTrace();
}java.lang.CloneNotSupportedException: CloneExample以上抛出了 CloneNotSupportedException,这是因为 CloneExample 没有实现 Cloneable 接口。
应该注意的是,clone() 方法并不是 Cloneable 接口的方法,而是 Object 的一个 protected 方法。Cloneable 接口只是规定,如果一个类没有实现 Cloneable 接口又调用了 clone() 方法,就会抛出 CloneNotSupportedException。
public class CloneExample implements Cloneable {
    private int a;
    private int b;

    @Override
    public Object clone() throws CloneNotSupportedException {
        return super.clone();
    }
}
2. 浅拷贝
拷贝对象和原始对象的引用类型引用同一个对象。
public class ShallowCloneExample implements Cloneable {

    private int[] arr;

    public ShallowCloneExample() {
        arr = new int[10];
        for (int i = 0; i < arr.length; i++) {
            arr[i] = i;
        }
    }

    public void set(int index, int value) {
        arr[index] = value;
    }

    public int get(int index) {
        return arr[index];
    }

    @Override
    protected ShallowCloneExample clone() throws CloneNotSupportedException {
        return (ShallowCloneExample) super.clone();
    }
}
ShallowCloneExample e1 = new ShallowCloneExample();
ShallowCloneExample e2 = null;
try {
e2 = e1.clone();
} catch (CloneNotSupportedException e) {
e.printStackTrace();
}
e1.set(2, 222);
System.out.println(e2.get(2)); // 2223. 深拷贝
拷贝对象和原始对象的引用类型引用不同对象。
public class DeepCloneExample implements Cloneable {

    private int[] arr;

    public DeepCloneExample() {
        arr = new int[10];
        for (int i = 0; i < arr.length; i++) {
            arr[i] = i;
        }
    }

    public void set(int index, int value) {
        arr[index] = value;
    }

    public int get(int index) {
        return arr[index];
    }

    @Override
    protected DeepCloneExample clone() throws CloneNotSupportedException {
        DeepCloneExample result = (DeepCloneExample) super.clone();
        result.arr = new int[arr.length];
        for (int i = 0; i < arr.length; i++) {
            result.arr[i] = arr[i];
        }
        return result;
    }
}
DeepCloneExample e1 = new DeepCloneExample();
DeepCloneExample e2 = null;
try {
e2 = e1.clone();
} catch (CloneNotSupportedException e) {
e.printStackTrace();
}
e1.set(2, 222);
System.out.println(e2.get(2)); // 24. clone() 的替代方案
使用 clone() 方法来拷贝一个对象即复杂又有风险,它会抛出异常,并且还需要类型转换。Effective Java 书上讲到,最好不要去使用 clone(),可以使用拷贝构造函数或者拷贝工厂来拷贝一个对象。
public class CloneConstructorExample {

    private int[] arr;

    public CloneConstructorExample() {
        arr = new int[10];
        for (int i = 0; i < arr.length; i++) {
            arr[i] = i;
        }
    }

    public CloneConstructorExample(CloneConstructorExample original) {
        arr = new int[original.arr.length];
        for (int i = 0; i < original.arr.length; i++) {
            arr[i] = original.arr[i];
        }
    }

    public void set(int index, int value) {
        arr[index] = value;
    }

    public int get(int index) {
        return arr[index];
    }
}
CloneConstructorExample e1 = new CloneConstructorExample();
CloneConstructorExample e2 = new CloneConstructorExample(e1);
e1.set(2, 222);
System.out.println(e2.get(2)); // 2六、继承
访问权限
Java 中有三个访问权限修饰符:private、protected 以及 public,如果不加访问修饰符,表示包级可见。
可以对类或类中的成员(字段和方法)加上访问修饰符。
- 类可见表示其它类可以用这个类创建实例对象。
- 成员可见表示其它类可以用这个类的实例对象访问到该成员;
protected 用于修饰成员,表示在继承体系中成员对于子类可见,但是这个访问修饰符对于类没有意义。
设计良好的模块会隐藏所有的实现细节,把它的 API 与它的实现清晰地隔离开来。模块之间只通过它们的 API 进行通信,一个模块不需要知道其他模块的内部工作情况,这个概念被称为信息隐藏或封装。因此访问权限应当尽可能地使每个类或者成员不被外界访问。
如果子类的方法重写了父类的方法,那么子类中该方法的访问级别不允许低于父类的访问级别。这是为了确保可以使用父类实例的地方都可以使用子类实例去代替,也就是确保满足里氏替换原则。
字段决不能是公有的,因为这么做的话就失去了对这个字段修改行为的控制,客户端可以对其随意修改。例如下面的例子中,AccessExample 拥有 id 公有字段,如果在某个时刻,我们想要使用 int 存储 id 字段,那么就需要修改所有的客户端代码。
public class AccessExample {
    public String id;
}
可以使用公有的 getter 和 setter 方法来替换公有字段,这样的话就可以控制对字段的修改行为。
public class AccessExample {

    private int id;

    public String getId() {
        return id + "";
    }

    public void setId(String id) {
        this.id = Integer.valueOf(id);
    }
}
但是也有例外,如果是包级私有的类或者私有的嵌套类,那么直接暴露成员不会有特别大的影响。
public class AccessWithInnerClassExample {

    private class InnerClass {
        int x;
    }

    private InnerClass innerClass;

    public AccessWithInnerClassExample() {
        innerClass = new InnerClass();
    }

    public int getValue() {
        return innerClass.x;  // 直接访问
    }
}
抽象类与接口
1. 抽象类
抽象类和抽象方法都使用 abstract 关键字进行声明。如果一个类中包含抽象方法,那么这个类必须声明为抽象类。
抽象类和普通类最大的区别是,抽象类不能被实例化,只能被继承。
public abstract class AbstractClassExample {

    protected int x;
    private int y;

    public abstract void func1();

    public void func2() {
        System.out.println("func2");
    }
}
public class AbstractExtendClassExample extends AbstractClassExample {
@Override
public void func1() {
System.out.println("func1");
}
}// AbstractClassExample ac1 = new AbstractClassExample(); // 'AbstractClassExample' is abstract; cannot be instantiated
AbstractClassExample ac2 = new AbstractExtendClassExample();
ac2.func1();2. 接口
接口是抽象类的延伸,在 Java 8 之前,它可以看成是一个完全抽象的类,也就是说它不能有任何的方法实现。
从 Java 8 开始,接口也可以拥有默认的方法实现,这是因为不支持默认方法的接口的维护成本太高了。在 Java 8 之前,如果一个接口想要添加新的方法,那么要修改所有实现了该接口的类,让它们都实现新增的方法。
接口的成员(字段 + 方法)默认都是 public 的,并且不允许定义为 private 或者 protected。从 Java 9 开始,允许将方法定义为 private,这样就能定义某些复用的代码又不会把方法暴露出去。
接口的字段默认都是 static 和 final 的。
public interface InterfaceExample {

    void func1();

    default void func2(){
        System.out.println("func2");
    }

    int x = 123;
    // int y;               // Variable 'y' might not have been initialized
    public int z = 0;       // Modifier 'public' is redundant for interface fields
    // private int k = 0;   // Modifier 'private' not allowed here
    // protected int l = 0; // Modifier 'protected' not allowed here
    // private void fun3(); // Modifier 'private' not allowed here
}
public class InterfaceImplementExample implements InterfaceExample {
@Override
public void func1() {
System.out.println("func1");
}
}// InterfaceExample ie1 = new InterfaceExample(); // 'InterfaceExample' is abstract; cannot be instantiated
InterfaceExample ie2 = new InterfaceImplementExample();
ie2.func1();
System.out.println(InterfaceExample.x);3. 比较
- 从设计层面上看,抽象类提供了一种 IS-A 关系,需要满足里式替换原则,即子类对象必须能够替换掉所有父类对象。而接口更像是一种 LIKE-A 关系,它只是提供一种方法实现契约,并不要求接口和实现接口的类具有 IS-A 关系。
- 从使用上来看,一个类可以实现多个接口,但是不能继承多个抽象类。
- 接口的字段只能是 static 和 final 类型的,而抽象类的字段没有这种限制。
- 接口的成员只能是 public 的,而抽象类的成员可以有多种访问权限。
4. 使用选择
使用接口:
- 需要让不相关的类都实现一个方法,例如不相关的类都可以实现 Comparable 接口中的 compareTo() 方法;
- 需要使用多重继承。
使用抽象类:
- 需要在几个相关的类中共享代码。
- 需要能控制继承来的成员的访问权限,而不是都为 public。
- 需要继承非静态和非常量字段。
在很多情况下,接口优先于抽象类。因为接口没有抽象类严格的类层次结构要求,可以灵活地为一个类添加行为。并且从 Java 8 开始,接口也可以有默认的方法实现,使得修改接口的成本也变的很低。
- Abstract Methods and Classes
- 深入理解 abstract class 和 interface
- When to Use Abstract Class and Interface
- Java 9 Private Methods in Interfaces
super
- 访问父类的构造函数:可以使用 super() 函数访问父类的构造函数,从而委托父类完成一些初始化的工作。应该注意到,子类一定会调用父类的构造函数来完成初始化工作,一般是调用父类的默认构造函数,如果子类需要调用父类其它构造函数,那么就可以使用 super() 函数。
- 访问父类的成员:如果子类重写了父类的某个方法,可以通过使用 super 关键字来引用父类的方法实现。
public class SuperExample {

    protected int x;
    protected int y;

    public SuperExample(int x, int y) {
        this.x = x;
        this.y = y;
    }

    public void func() {
        System.out.println("SuperExample.func()");
    }
}
public class SuperExtendExample extends SuperExample {
private int z;
public SuperExtendExample(int x, int y, int z) {
super(x, y);
this.z = z;
}
@Override
public void func() {
super.func();
System.out.println("SuperExtendExample.func()");
}
}SuperExample e = new SuperExtendExample(1, 2, 3);
e.func();SuperExample.func()
SuperExtendExample.func()重写与重载
1. 重写(Override)
存在于继承体系中,指子类实现了一个与父类在方法声明上完全相同的一个方法。
为了满足里式替换原则,重写有以下三个限制:
- 子类方法的访问权限必须大于等于父类方法;
- 子类方法的返回类型必须是父类方法返回类型或为其子类型。
- 子类方法抛出的异常类型必须是父类抛出异常类型或为其子类型。
使用 @Override 注解,可以让编译器帮忙检查是否满足上面的三个限制条件。
下面的示例中,SubClass 为 SuperClass 的子类,SubClass 重写了 SuperClass 的 func() 方法。其中:
- 子类方法访问权限为 public,大于父类的 protected。
- 子类的返回类型为 ArrayList\
- 子类抛出的异常类型为 Exception,是父类抛出异常 Throwable 的子类。
- 子类重写方法使用 @Override 注解,从而让编译器自动检查是否满足限制条件。
class SuperClass {
    protected List<Integer> func() throws Throwable {
        return new ArrayList<>();
    }
}

class SubClass extends SuperClass {
    @Override
    public ArrayList<Integer> func() throws Exception {
        return new ArrayList<>();
    }
}
在调用一个方法时,先从本类中查找看是否有对应的方法,如果没有再到父类中查看,看是否从父类继承来。否则就要对参数进行转型,转成父类之后看是否有对应的方法。总的来说,方法调用的优先级为:
- this.func(this)
- super.func(this)
- this.func(super)
- super.func(super)
/*
    A
    |
    B
    |
    C
    |
    D
 */


class A {

    public void show(A obj) {
        System.out.println("A.show(A)");
    }

    public void show(C obj) {
        System.out.println("A.show(C)");
    }
}

class B extends A {

    @Override
    public void show(A obj) {
        System.out.println("B.show(A)");
    }
}

class C extends B {
}

class D extends C {
}
public static void main(String[] args) {
A a = new A();
B b = new B();
C c = new C();
D d = new D();
// 在 A 中存在 show(A obj),直接调用
a.show(a); // A.show(A)
// 在 A 中不存在 show(B obj),将 B 转型成其父类 A
a.show(b); // A.show(A)
// 在 B 中存在从 A 继承来的 show(C obj),直接调用
b.show(c); // A.show(C)
// 在 B 中不存在 show(D obj),但是存在从 A 继承来的 show(C obj),将 D 转型成其父类 C
b.show(d); // A.show(C)
// 引用的还是 B 对象,所以 ba 和 b 的调用结果一样
A ba = new B();
ba.show(c); // A.show(C)
ba.show(d); // A.show(C)
}2. 重载(Overload)
存在于同一个类中,指一个方法与已经存在的方法名称上相同,但是参数类型、个数、顺序至少有一个不同。
应该注意的是,返回值不同,其它都相同不算是重载。
class OverloadingExample {
public void show(int x) {
System.out.println(x);
}
public void show(int x, String y) {
System.out.println(x + " " + y);
}
}public static void main(String[] args) {
OverloadingExample example = new OverloadingExample();
example.show(1);
example.show(1, "2");
}七、反射
每个类都有一个 Class 对象,包含了与类有关的信息。当编译一个新类时,会产生一个同名的 .class 文件,该文件内容保存着 Class 对象。
类加载相当于 Class 对象的加载,类在第一次使用时才动态加载到 JVM 中。也可以使用 Class.forName("com.mysql.jdbc.Driver") 这种方式来控制类的加载,该方法会返回一个 Class 对象。
反射可以提供运行时的类信息,并且这个类可以在运行时才加载进来,甚至在编译时期该类的 .class 不存在也可以加载进来。
Class 和 java.lang.reflect 一起对反射提供了支持,java.lang.reflect 类库主要包含了以下三个类:
- Field :可以使用 get() 和 set() 方法读取和修改 Field 对象关联的字段;
- Method :可以使用 invoke() 方法调用与 Method 对象关联的方法;
- Constructor :可以用 Constructor 的 newInstance() 创建新的对象。
反射的优点:
- 可扩展性 :应用程序可以利用全限定名创建可扩展对象的实例,来使用来自外部的用户自定义类。
- 类浏览器和可视化开发环境 :一个类浏览器需要可以枚举类的成员。可视化开发环境(如 IDE)可以从利用反射中可用的类型信息中受益,以帮助程序员编写正确的代码。
- 调试器和测试工具 : 调试器需要能够检查一个类里的私有成员。测试工具可以利用反射来自动地调用类里定义的可被发现的 API 定义,以确保一组测试中有较高的代码覆盖率。
反射的缺点:
尽管反射非常强大,但也不能滥用。如果一个功能可以不用反射完成,那么最好就不用。在我们使用反射技术时,下面几条内容应该牢记于心。
- 性能开销 :反射涉及了动态类型的解析,所以 JVM 无法对这些代码进行优化。因此,反射操作的效率要比那些非反射操作低得多。我们应该避免在经常被执行的代码或对性能要求很高的程序中使用反射。
- 安全限制 :使用反射技术要求程序必须在一个没有安全限制的环境中运行。如果一个程序必须在有安全限制的环境中运行,如 Applet,那么这就是个问题了。
- 内部暴露 :由于反射允许代码执行一些在正常情况下不被允许的操作(比如访问私有的属性和方法),所以使用反射可能会导致意料之外的副作用,这可能导致代码功能失调并破坏可移植性。反射代码破坏了抽象性,因此当平台发生改变的时候,代码的行为就有可能也随着变化。
八、异常
Throwable 可以用来表示任何可以作为异常抛出的类,分为两种: Error 和 Exception。其中 Error 用来表示 JVM 无法处理的错误,Exception 分为两种:
- 受检异常 :需要用 try...catch... 语句捕获并进行处理,并且可以从异常中恢复;
- 非受检异常 :是程序运行时错误,例如除 0 会引发 Arithmetic Exception,此时程序崩溃并且无法恢复。
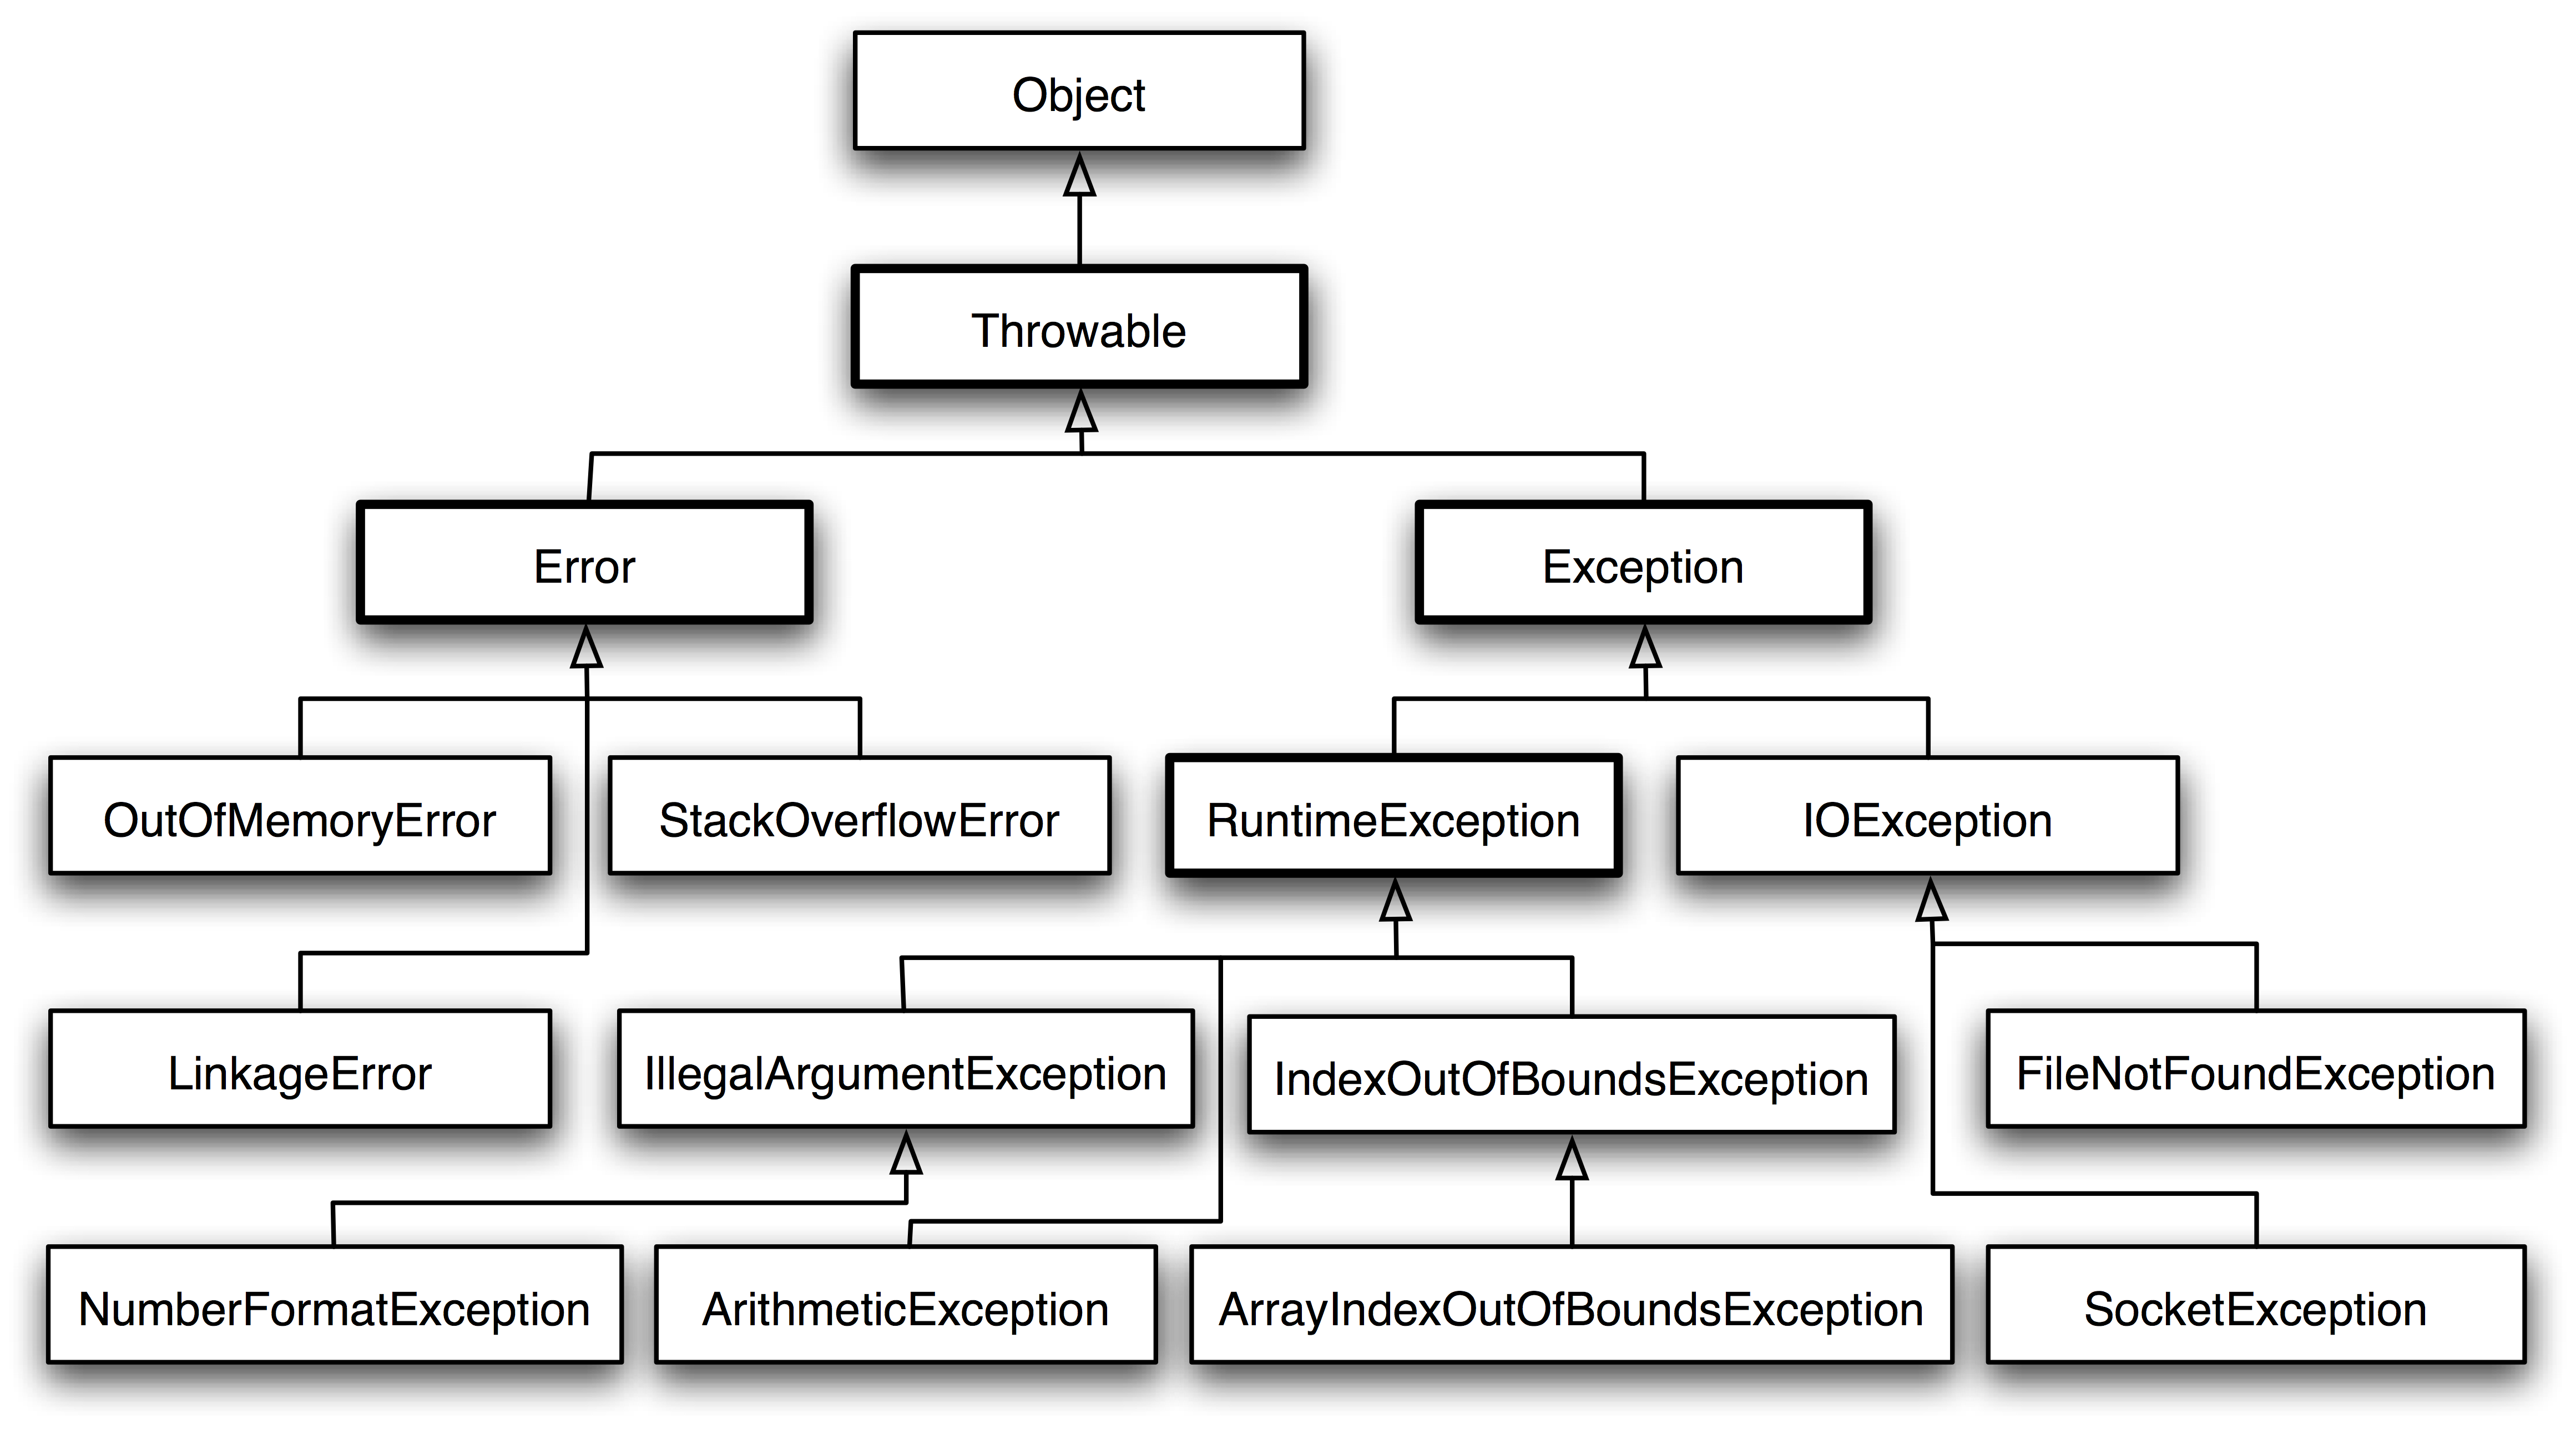
九、泛型
public class Box<T> {
// T stands for "Type"
private T t;
public void set(T t) { this.t = t; }
public T get() { return t; }
}十、注解
Java 注解是附加在代码中的一些元信息,用于一些工具在编译、运行时进行解析和使用,起到说明、配置的功能。注解不会也不能影响代码的实际逻辑,仅仅起到辅助性的作用。
十一、特性
Java 各版本的新特性
New highlights in Java SE 8
- Lambda Expressions
- Pipelines and Streams
- Date and Time API
- Default Methods
- Type Annotations
- Nashhorn JavaScript Engine
- Concurrent Accumulators
- Parallel operations
- PermGen Error Removed
New highlights in Java SE 7
- Strings in Switch Statement
- Type Inference for Generic Instance Creation
- Multiple Exception Handling
- Support for Dynamic Languages
- Try with Resources
- Java nio Package
- Binary Literals, Underscore in literals
- Diamond Syntax
Java 与 C++ 的区别
- Java 是纯粹的面向对象语言,所有的对象都继承自 java.lang.Object,C++ 为了兼容 C 即支持面向对象也支持面向过程。
- Java 通过虚拟机从而实现跨平台特性,但是 C++ 依赖于特定的平台。
- Java 没有指针,它的引用可以理解为安全指针,而 C++ 具有和 C 一样的指针。
- Java 支持自动垃圾回收,而 C++ 需要手动回收。
- Java 不支持多重继承,只能通过实现多个接口来达到相同目的,而 C++ 支持多重继承。
- Java 不支持操作符重载,虽然可以对两个 String 对象执行加法运算,但是这是语言内置支持的操作,不属于操作符重载,而 C++ 可以。
- Java 的 goto 是保留字,但是不可用,C++ 可以使用 goto。
What are the main differences between Java and C++?
JRE or JDK
- JRE:Java Runtime Environment,Java 运行环境的简称,为 Java 的运行提供了所需的环境。它是一个 JVM 程序,主要包括了 JVM 的标准实现和一些 Java 基本类库。
- JDK:Java Development Kit,Java 开发工具包,提供了 Java 的开发及运行环境。JDK 是 Java 开发的核心,集成了 JRE 以及一些其它的工具,比如编译 Java 源码的编译器 javac 等。
参考资料
- Eckel B. Java 编程思想[M]. 机械工业出版社, 2002.
- Bloch J. Effective java[M]. Addison-Wesley Professional, 2017.
Java 容器
Java 容器
* [一、概览](#一概览)
* [Collection](#collection)
* [Map](#map)
* [二、容器中的设计模式](#二容器中的设计模式)
* [迭代器模式](#迭代器模式)
* [适配器模式](#适配器模式)
* [三、源码分析](#三源码分析)
* [ArrayList](#arraylist)
* [Vector](#vector)
* [CopyOnWriteArrayList](#copyonwritearraylist)
* [LinkedList](#linkedlist)
* [HashMap](#hashmap)
* [ConcurrentHashMap](#concurrenthashmap)
* [LinkedHashMap](#linkedhashmap)
* [WeakHashMap](#weakhashmap)
* [参考资料](#参考资料)一、概览
容器主要包括 Collection 和 Map 两种,Collection 存储着对象的集合,而 Map 存储着键值对(两个对象)的映射表。
Collection
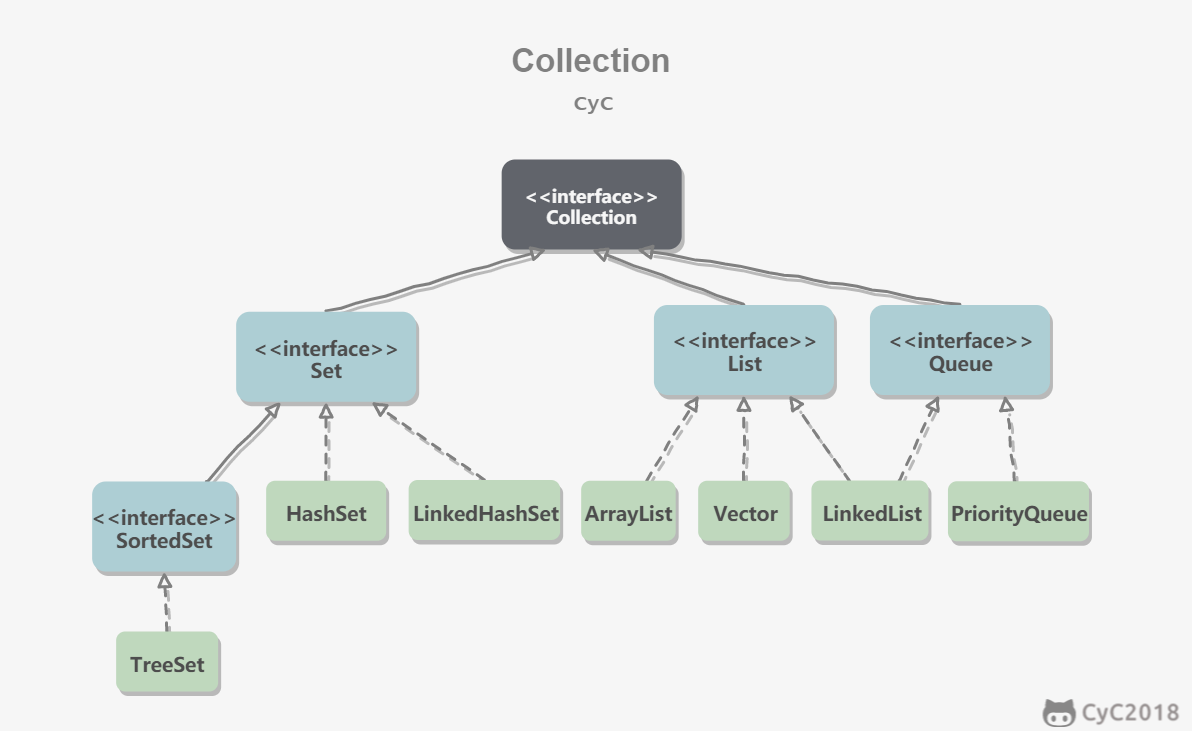
1. Set
- TreeSet:基于红黑树实现,支持有序性操作,例如根据一个范围查找元素的操作。但是查找效率不如 HashSet,HashSet 查找的时间复杂度为 O(1),TreeSet 则为 O(logN)。
- HashSet:基于哈希表实现,支持快速查找,但不支持有序性操作。并且失去了元素的插入顺序信息,也就是说使用 Iterator 遍历 HashSet 得到的结果是不确定的。
- LinkedHashSet:具有 HashSet 的查找效率,并且内部使用双向链表维护元素的插入顺序。
2. List
- ArrayList:基于动态数组实现,支持随机访问。
- Vector:和 ArrayList 类似,但它是线程安全的。
- LinkedList:基于双向链表实现,只能顺序访问,但是可以快速地在链表中间插入和删除元素。不仅如此,LinkedList 还可以用作栈、队列和双向队列。
3. Queue
- LinkedList:可以用它来实现双向队列。
- PriorityQueue:基于堆结构实现,可以用它来实现优先队列。
Map
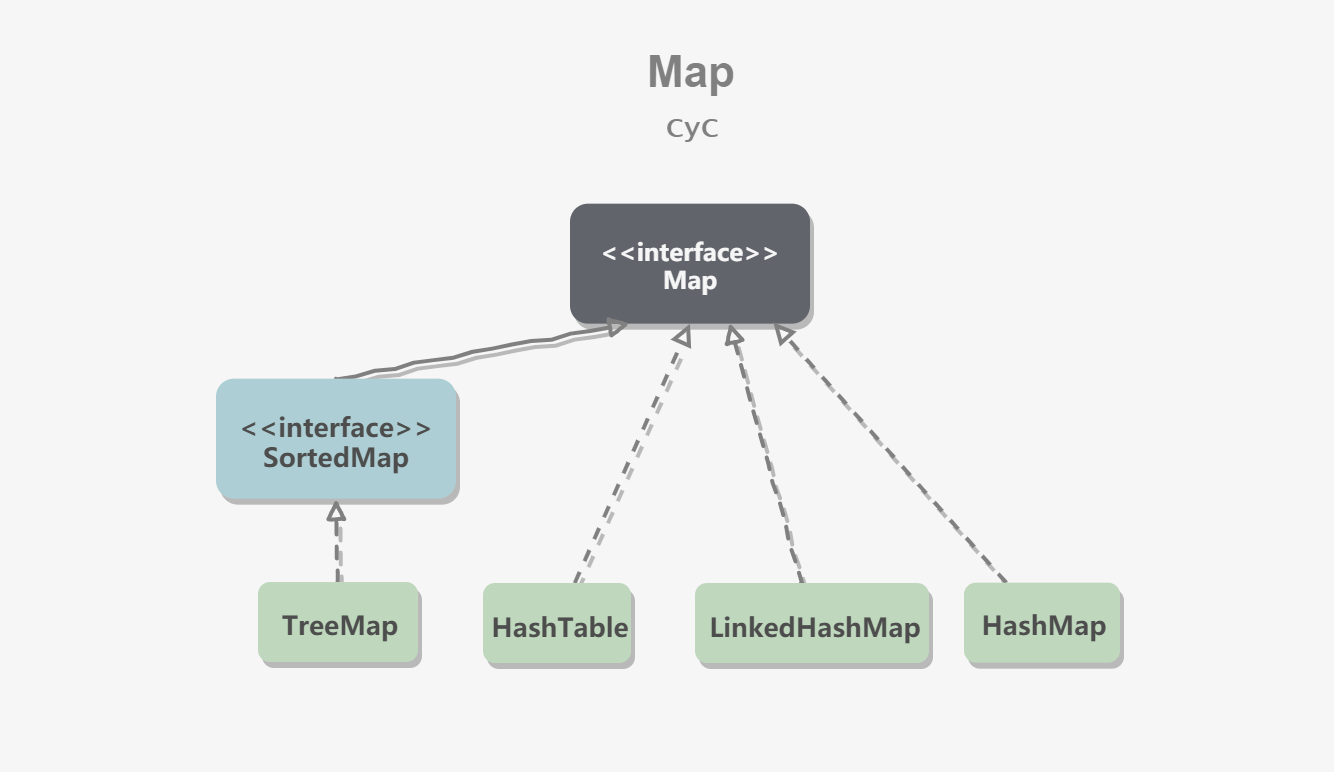
- TreeMap:基于红黑树实现。
- HashMap:基于哈希表实现。
- HashTable:和 HashMap 类似,但它是线程安全的,这意味着同一时刻多个线程同时写入 HashTable 不会导致数据不一致。它是遗留类,不应该去使用它,而是使用 ConcurrentHashMap 来支持线程安全,ConcurrentHashMap 的效率会更高,因为 ConcurrentHashMap 引入了分段锁。
- LinkedHashMap:使用双向链表来维护元素的顺序,顺序为插入顺序或者最近最少使用(LRU)顺序。
二、容器中的设计模式
迭代器模式
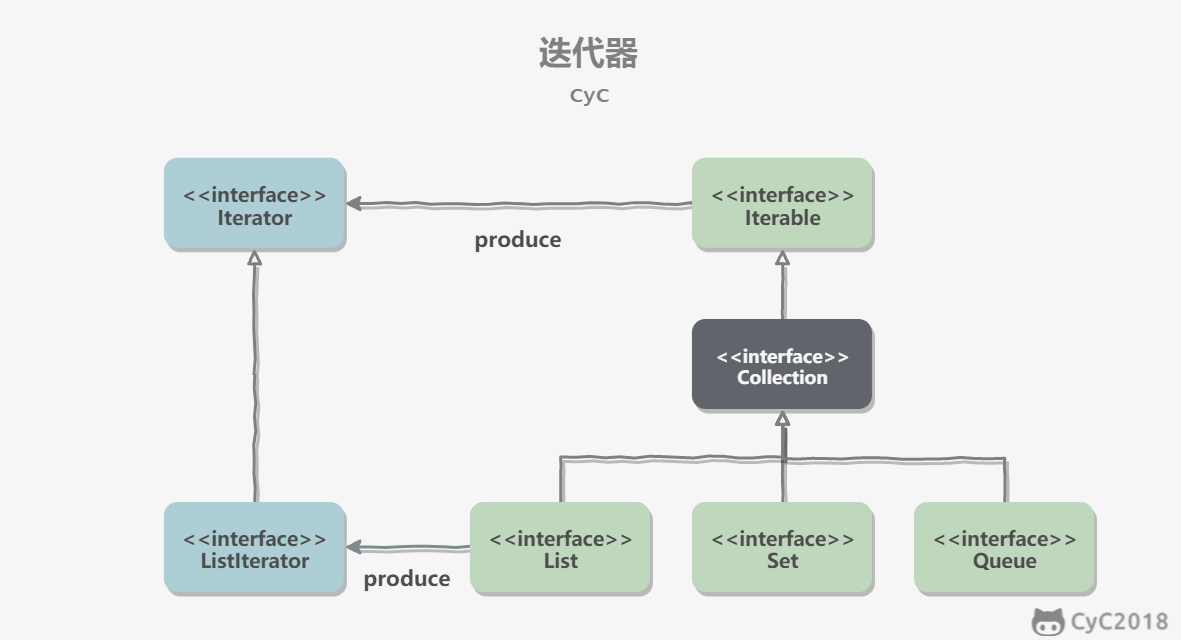
Collection 继承了 Iterable 接口,其中的 iterator() 方法能够产生一个 Iterator 对象,通过这个对象就可以迭代遍历 Collection 中的元素。
从 JDK 1.5 之后可以使用 foreach 方法来遍历实现了 Iterable 接口的聚合对象。
List<String> list = new ArrayList<>();
list.add("a");
list.add("b");
for (String item : list) {
System.out.println(item);
}适配器模式
java.util.Arrays#asList() 可以把数组类型转换为 List 类型。
@SafeVarargs
public static <T> List<T> asList(T... a)应该注意的是 asList() 的参数为泛型的变长参数,不能使用基本类型数组作为参数,只能使用相应的包装类型数组。
Integer[] arr = {1, 2, 3};
List list = Arrays.asList(arr);也可以使用以下方式调用 asList():
List list = Arrays.asList(1, 2, 3);三、源码分析
如果没有特别说明,以下源码分析基于 JDK 1.8。
在 IDEA 中 double shift 调出 Search EveryWhere,查找源码文件,找到之后就可以阅读源码。
ArrayList
1. 概览
因为 ArrayList 是基于数组实现的,所以支持快速随机访问。RandomAccess 接口标识着该类支持快速随机访问。
public class ArrayList<E> extends AbstractList<E>
implements List<E>, RandomAccess, Cloneable, java.io.Serializable数组的默认大小为 10。
private static final int DEFAULT_CAPACITY = 10;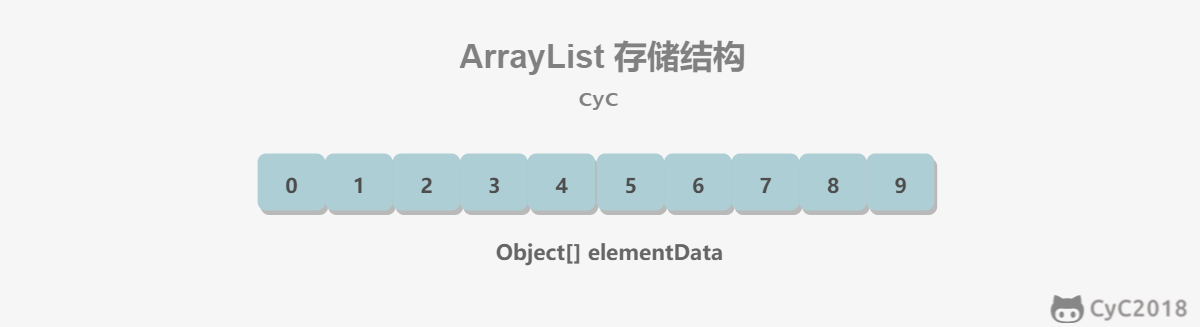
2. 扩容
添加元素时使用 ensureCapacityInternal() 方法来保证容量足够,如果不够时,需要使用 grow() 方法进行扩容,新容量的大小为 oldCapacity + (oldCapacity >> 1),即 oldCapacity+oldCapacity/2。其中 oldCapacity >> 1 需要取整,所以新容量大约是旧容量的 1.5 倍左右。(oldCapacity 为偶数就是 1.5 倍,为奇数就是 1.5 倍-0.5)
扩容操作需要调用 Arrays.copyOf() 把原数组整个复制到新数组中,这个操作代价很高,因此最好在创建 ArrayList 对象时就指定大概的容量大小,减少扩容操作的次数。
public boolean add(E e) {
ensureCapacityInternal(size + 1); // Increments modCount!!
elementData[size++] = e;
return true;
}
private void ensureCapacityInternal(int minCapacity) {
if (elementData == DEFAULTCAPACITY_EMPTY_ELEMENTDATA) {
minCapacity = Math.max(DEFAULT_CAPACITY, minCapacity);
}
ensureExplicitCapacity(minCapacity);
}
private void ensureExplicitCapacity(int minCapacity) {
modCount++;
// overflow-conscious code
if (minCapacity - elementData.length > 0)
grow(minCapacity);
}
private void grow(int minCapacity) {
// overflow-conscious code
int oldCapacity = elementData.length;
int newCapacity = oldCapacity + (oldCapacity >> 1);
if (newCapacity - minCapacity < 0)
newCapacity = minCapacity;
if (newCapacity - MAX_ARRAY_SIZE > 0)
newCapacity = hugeCapacity(minCapacity);
// minCapacity is usually close to size, so this is a win:
elementData = Arrays.copyOf(elementData, newCapacity);
}3. 删除元素
需要调用 System.arraycopy() 将 index+1 后面的元素都复制到 index 位置上,该操作的时间复杂度为 O(N),可以看到 ArrayList 删除元素的代价是非常高的。
public E remove(int index) {
rangeCheck(index);
modCount++;
E oldValue = elementData(index);
int numMoved = size - index - 1;
if (numMoved > 0)
System.arraycopy(elementData, index+1, elementData, index, numMoved);
elementData[--size] = null; // clear to let GC do its work
return oldValue;
}4. 序列化
ArrayList 基于数组实现,并且具有动态扩容特性,因此保存元素的数组不一定都会被使用,那么就没必要全部进行序列化。
保存元素的数组 elementData 使用 transient 修饰,该关键字声明数组默认不会被序列化。
transient Object[] elementData; // non-private to simplify nested class accessArrayList 实现了 writeObject() 和 readObject() 来控制只序列化数组中有元素填充那部分内容。
private void readObject(java.io.ObjectInputStream s)
throws java.io.IOException, ClassNotFoundException {
elementData = EMPTY_ELEMENTDATA;
// Read in size, and any hidden stuff
s.defaultReadObject();
// Read in capacity
s.readInt(); // ignored
if (size > 0) {
// be like clone(), allocate array based upon size not capacity
ensureCapacityInternal(size);
Object[] a = elementData;
// Read in all elements in the proper order.
for (int i=0; i<size; i++) {
a[i] = s.readObject();
}
}
}private void writeObject(java.io.ObjectOutputStream s)
throws java.io.IOException{
// Write out element count, and any hidden stuff
int expectedModCount = modCount;
s.defaultWriteObject();
// Write out size as capacity for behavioural compatibility with clone()
s.writeInt(size);
// Write out all elements in the proper order.
for (int i=0; i<size; i++) {
s.writeObject(elementData[i]);
}
if (modCount != expectedModCount) {
throw new ConcurrentModificationException();
}
}序列化时需要使用 ObjectOutputStream 的 writeObject() 将对象转换为字节流并输出。而 writeObject() 方法在传入的对象存在 writeObject() 的时候会去反射调用该对象的 writeObject() 来实现序列化。反序列化使用的是 ObjectInputStream 的 readObject() 方法,原理类似。
ArrayList list = new ArrayList();
ObjectOutputStream oos = new ObjectOutputStream(new FileOutputStream(file));
oos.writeObject(list);5. Fail-Fast
modCount 用来记录 ArrayList 结构发生变化的次数。结构发生变化是指添加或者删除至少一个元素的所有操作,或者是调整内部数组的大小,仅仅只是设置元素的值不算结构发生变化。
在进行序列化或者迭代等操作时,需要比较操作前后 modCount 是否改变,如果改变了需要抛出 ConcurrentModificationException。代码参考上节序列化中的 writeObject() 方法。
Vector
1. 同步
它的实现与 ArrayList 类似,但是使用了 synchronized 进行同步。
public synchronized boolean add(E e) {
modCount++;
ensureCapacityHelper(elementCount + 1);
elementData[elementCount++] = e;
return true;
}
public synchronized E get(int index) {
if (index >= elementCount)
throw new ArrayIndexOutOfBoundsException(index);
return elementData(index);
}2. 扩容
Vector 的构造函数可以传入 capacityIncrement 参数,它的作用是在扩容时使容量 capacity 增长 capacityIncrement。如果这个参数的值小于等于 0,扩容时每次都令 capacity 为原来的两倍。
public Vector(int initialCapacity, int capacityIncrement) {
super();
if (initialCapacity < 0)
throw new IllegalArgumentException("Illegal Capacity: "+
initialCapacity);
this.elementData = new Object[initialCapacity];
this.capacityIncrement = capacityIncrement;
}private void grow(int minCapacity) {
// overflow-conscious code
int oldCapacity = elementData.length;
int newCapacity = oldCapacity + ((capacityIncrement > 0) ?
capacityIncrement : oldCapacity);
if (newCapacity - minCapacity < 0)
newCapacity = minCapacity;
if (newCapacity - MAX_ARRAY_SIZE > 0)
newCapacity = hugeCapacity(minCapacity);
elementData = Arrays.copyOf(elementData, newCapacity);
}调用没有 capacityIncrement 的构造函数时,capacityIncrement 值被设置为 0,也就是说默认情况下 Vector 每次扩容时容量都会翻倍。
public Vector(int initialCapacity) {
this(initialCapacity, 0);
}
public Vector() {
this(10);
}3. 与 ArrayList 的比较
- Vector 是同步的,因此开销就比 ArrayList 要大,访问速度更慢。最好使用 ArrayList 而不是 Vector,因为同步操作完全可以由程序员自己来控制;
- Vector 每次扩容请求其大小的 2 倍(也可以通过构造函数设置增长的容量),而 ArrayList 是 1.5 倍。
4. 替代方案
可以使用 Collections.synchronizedList(); 得到一个线程安全的 ArrayList。
List<String> list = new ArrayList<>();
List<String> synList = Collections.synchronizedList(list);也可以使用 concurrent 并发包下的 CopyOnWriteArrayList 类。
List<String> list = new CopyOnWriteArrayList<>();CopyOnWriteArrayList
1. 读写分离
写操作在一个复制的数组上进行,读操作还是在原始数组中进行,读写分离,互不影响。
写操作需要加锁,防止并发写入时导致写入数据丢失。
写操作结束之后需要把原始数组指向新的复制数组。
public boolean add(E e) {
final ReentrantLock lock = this.lock;
lock.lock();
try {
Object[] elements = getArray();
int len = elements.length;
Object[] newElements = Arrays.copyOf(elements, len + 1);
newElements[len] = e;
setArray(newElements);
return true;
} finally {
lock.unlock();
}
}
final void setArray(Object[] a) {
array = a;
}@SuppressWarnings("unchecked")
private E get(Object[] a, int index) {
return (E) a[index];
}2. 适用场景
CopyOnWriteArrayList 在写操作的同时允许读操作,大大提高了读操作的性能,因此很适合读多写少的应用场景。
但是 CopyOnWriteArrayList 有其缺陷:
- 内存占用:在写操作时需要复制一个新的数组,使得内存占用为原来的两倍左右;
- 数据不一致:读操作不能读取实时性的数据,因为部分写操作的数据还未同步到读数组中。
所以 CopyOnWriteArrayList 不适合内存敏感以及对实时性要求很高的场景。
LinkedList
1. 概览
基于双向链表实现,使用 Node 存储链表节点信息。
private static class Node<E> {
E item;
Node<E> next;
Node<E> prev;
}每个链表存储了 first 和 last 指针:
transient Node<E> first;
transient Node<E> last;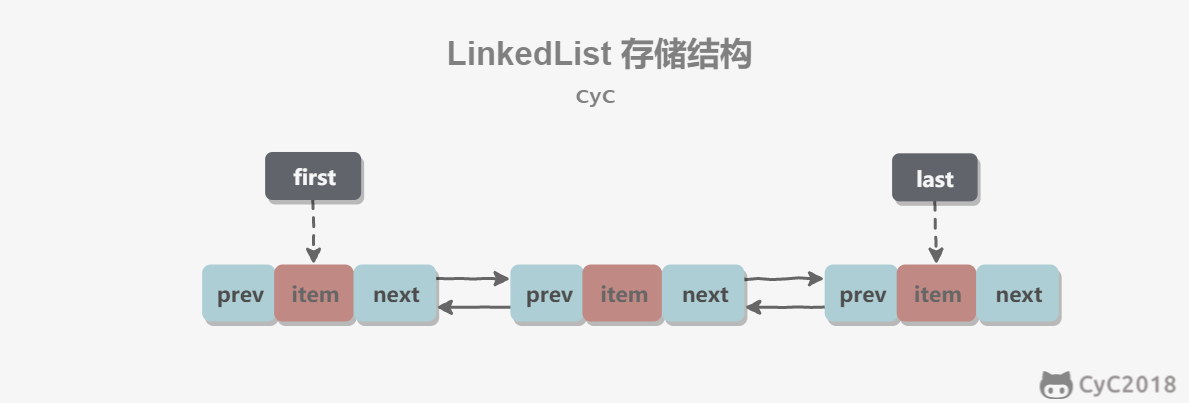
2. 与 ArrayList 的比较
ArrayList 基于动态数组实现,LinkedList 基于双向链表实现。ArrayList 和 LinkedList 的区别可以归结为数组和链表的区别:
- 数组支持随机访问,但插入删除的代价很高,需要移动大量元素;
- 链表不支持随机访问,但插入删除只需要改变指针。
HashMap
为了便于理解,以下源码分析以 JDK 1.7 为主。
1. 存储结构
内部包含了一个 Entry 类型的数组 table。Entry 存储着键值对。它包含了四个字段,从 next 字段我们可以看出 Entry 是一个链表。即数组中的每个位置被当成一个桶,一个桶存放一个链表。HashMap 使用拉链法来解决冲突,同一个链表中存放哈希值和散列桶取模运算结果相同的 Entry。
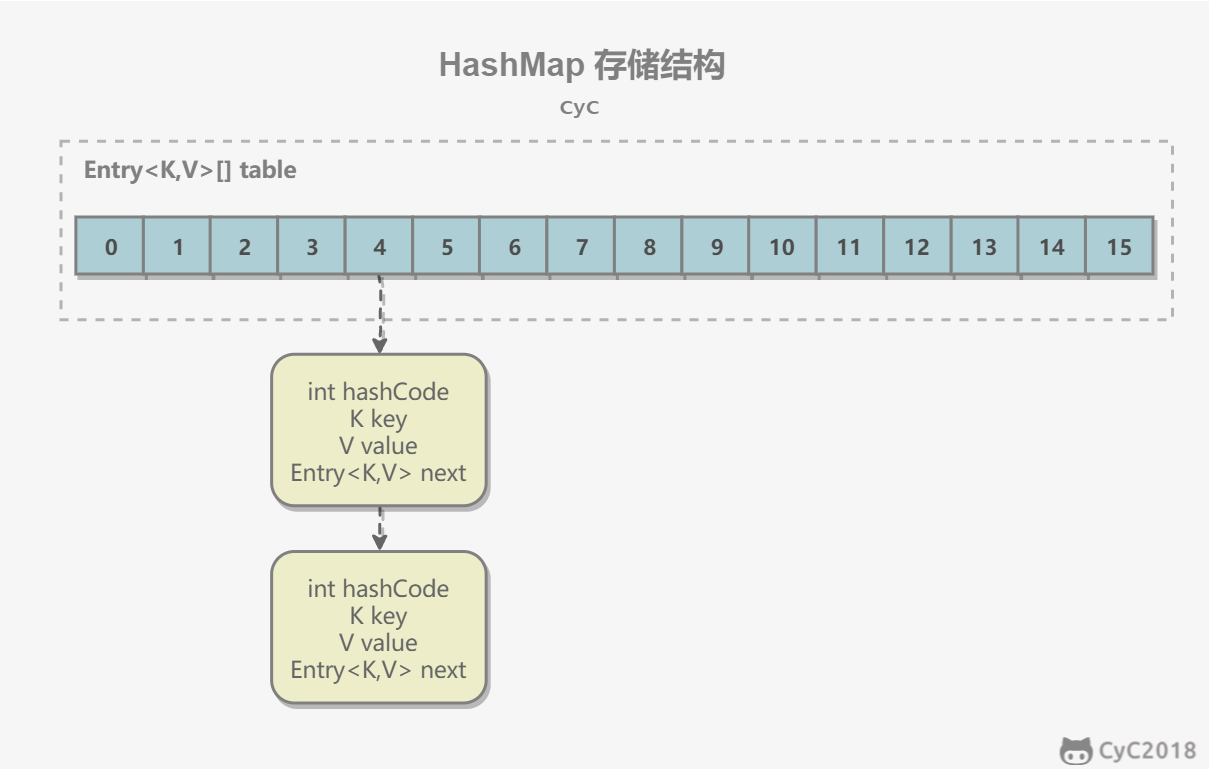
transient Entry[] table;static class Entry<K,V> implements Map.Entry<K,V> {
final K key;
V value;
Entry<K,V> next;
int hash;
Entry(int h, K k, V v, Entry<K,V> n) {
value = v;
next = n;
key = k;
hash = h;
}
public final K getKey() {
return key;
}
public final V getValue() {
return value;
}
public final V setValue(V newValue) {
V oldValue = value;
value = newValue;
return oldValue;
}
public final boolean equals(Object o) {
if (!(o instanceof Map.Entry))
return false;
Map.Entry e = (Map.Entry)o;
Object k1 = getKey();
Object k2 = e.getKey();
if (k1 == k2 || (k1 != null && k1.equals(k2))) {
Object v1 = getValue();
Object v2 = e.getValue();
if (v1 == v2 || (v1 != null && v1.equals(v2)))
return true;
}
return false;
}
public final int hashCode() {
return Objects.hashCode(getKey()) ^ Objects.hashCode(getValue());
}
public final String toString() {
return getKey() + "=" + getValue();
}
}2. 拉链法的工作原理
HashMap<String, String> map = new HashMap<>();
map.put("K1", "V1");
map.put("K2", "V2");
map.put("K3", "V3");- 新建一个 HashMap,默认大小为 16;
- 插入 <K1,V1\> 键值对,先计算 K1 的 hashCode 为 115,使用除留余数法得到所在的桶下标 115%16=3。
- 插入 <K2,V2\> 键值对,先计算 K2 的 hashCode 为 118,使用除留余数法得到所在的桶下标 118%16=6。
- 插入 <K3,V3\> 键值对,先计算 K3 的 hashCode 为 118,使用除留余数法得到所在的桶下标 118%16=6,插在 <K2,V2\> 前面。
应该注意到链表的插入是以头插法方式进行的,例如上面的 <K3,V3\> 不是插在 <K2,V2\> 后面,而是插入在链表头部。
查找需要分成两步进行:
- 计算键值对所在的桶;
- 在链表上顺序查找,时间复杂度显然和链表的长度成正比。
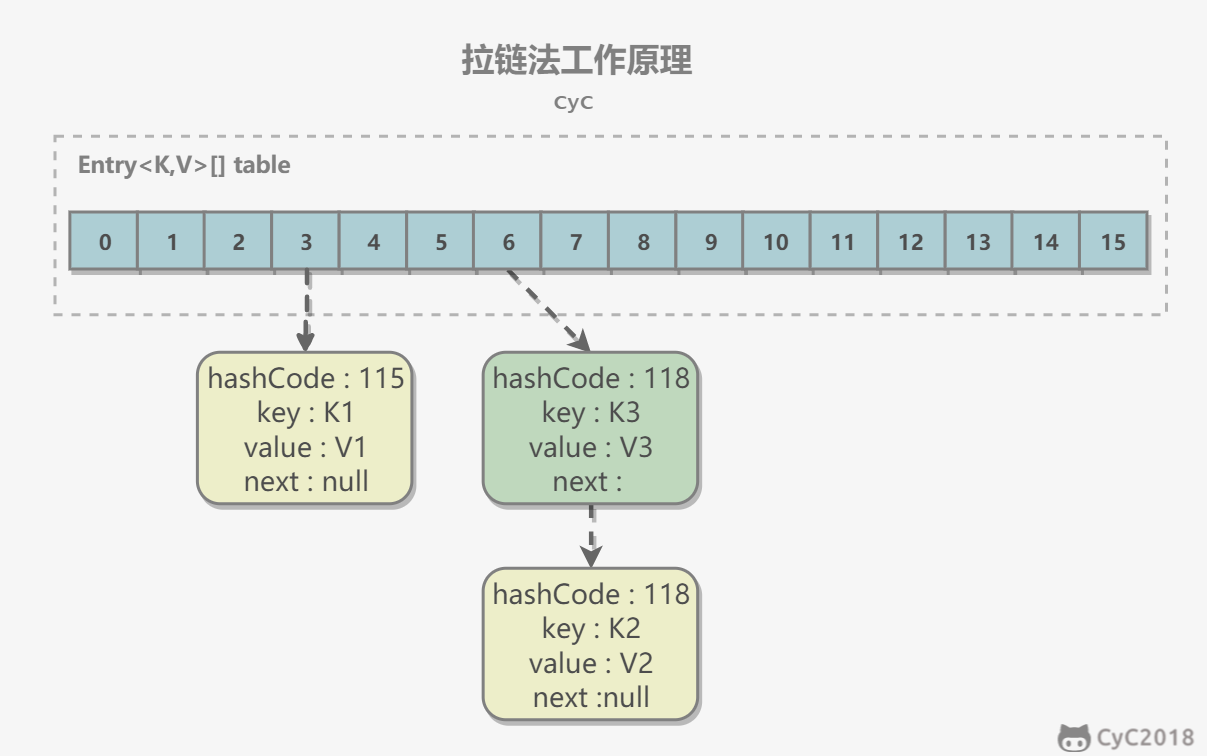
3. put 操作
public V put(K key, V value) {
if (table == EMPTY_TABLE) {
inflateTable(threshold);
}
// 键为 null 单独处理
if (key == null)
return putForNullKey(value);
int hash = hash(key);
// 确定桶下标
int i = indexFor(hash, table.length);
// 先找出是否已经存在键为 key 的键值对,如果存在的话就更新这个键值对的值为 value
for (Entry<K,V> e = table[i]; e != null; e = e.next) {
Object k;
if (e.hash == hash && ((k = e.key) == key || key.equals(k))) {
V oldValue = e.value;
e.value = value;
e.recordAccess(this);
return oldValue;
}
}
modCount++;
// 插入新键值对
addEntry(hash, key, value, i);
return null;
}HashMap 允许插入键为 null 的键值对。但是因为无法调用 null 的 hashCode() 方法,也就无法确定该键值对的桶下标,只能通过强制指定一个桶下标来存放。HashMap 使用第 0 个桶存放键为 null 的键值对。
private V putForNullKey(V value) {
for (Entry<K,V> e = table[0]; e != null; e = e.next) {
if (e.key == null) {
V oldValue = e.value;
e.value = value;
e.recordAccess(this);
return oldValue;
}
}
modCount++;
addEntry(0, null, value, 0);
return null;
}使用链表的头插法,也就是新的键值对插在链表的头部,而不是链表的尾部。
void addEntry(int hash, K key, V value, int bucketIndex) {
if ((size >= threshold) && (null != table[bucketIndex])) {
resize(2 * table.length);
hash = (null != key) ? hash(key) : 0;
bucketIndex = indexFor(hash, table.length);
}
createEntry(hash, key, value, bucketIndex);
}
void createEntry(int hash, K key, V value, int bucketIndex) {
Entry<K,V> e = table[bucketIndex];
// 头插法,链表头部指向新的键值对
table[bucketIndex] = new Entry<>(hash, key, value, e);
size++;
}Entry(int h, K k, V v, Entry<K,V> n) {
value = v;
next = n;
key = k;
hash = h;
}4. 确定桶下标
很多操作都需要先确定一个键值对所在的桶下标。
int hash = hash(key);
int i = indexFor(hash, table.length);4.1 计算 hash 值
final int hash(Object k) {
int h = hashSeed;
if (0 != h && k instanceof String) {
return sun.misc.Hashing.stringHash32((String) k);
}
h ^= k.hashCode();
// This function ensures that hashCodes that differ only by
// constant multiples at each bit position have a bounded
// number of collisions (approximately 8 at default load factor).
h ^= (h >>> 20) ^ (h >>> 12);
return h ^ (h >>> 7) ^ (h >>> 4);
}public final int hashCode() {
return Objects.hashCode(key) ^ Objects.hashCode(value);
}4.2 取模
令 x = 1\<\<4,即 x 为 2 的 4 次方,它具有以下性质:
x : 00010000
x-1 : 00001111令一个数 y 与 x-1 做与运算,可以去除 y 位级表示的第 4 位以上数:
y : 10110010
x-1 : 00001111
y&(x-1) : 00000010这个性质和 y 对 x 取模效果是一样的:
y : 10110010
x : 00010000
y%x : 00000010我们知道,位运算的代价比求模运算小的多,因此在进行这种计算时用位运算的话能带来更高的性能。
确定桶下标的最后一步是将 key 的 hash 值对桶个数取模:hash%capacity,如果能保证 capacity 为 2 的 n 次方,那么就可以将这个操作转换为位运算。
static int indexFor(int h, int length) {
return h & (length-1);
}5. 扩容-基本原理
设 HashMap 的 table 长度为 M,需要存储的键值对数量为 N,如果哈希函数满足均匀性的要求,那么每条链表的长度大约为 N/M,因此查找的复杂度为 O(N/M)。
为了让查找的成本降低,应该使 N/M 尽可能小,因此需要保证 M 尽可能大,也就是说 table 要尽可能大。HashMap 采用动态扩容来根据当前的 N 值来调整 M 值,使得空间效率和时间效率都能得到保证。
和扩容相关的参数主要有:capacity、size、threshold 和 load_factor。
| 参数 | 含义 |
|---|---|
| capacity | table 的容量大小,默认为 16。需要注意的是 capacity 必须保证为 2 的 n 次方。 |
| size | 键值对数量。 |
| threshold | size 的临界值,当 size 大于等于 threshold 就必须进行扩容操作。 |
| loadFactor | 装载因子,table 能够使用的比例,threshold = (int)(capacity* loadFactor)。 |
static final int DEFAULT_INITIAL_CAPACITY = 16;
static final int MAXIMUM_CAPACITY = 1 << 30;
static final float DEFAULT_LOAD_FACTOR = 0.75f;
transient Entry[] table;
transient int size;
int threshold;
final float loadFactor;
transient int modCount;从下面的添加元素代码中可以看出,当需要扩容时,令 capacity 为原来的两倍。
void addEntry(int hash, K key, V value, int bucketIndex) {
Entry<K,V> e = table[bucketIndex];
table[bucketIndex] = new Entry<>(hash, key, value, e);
if (size++ >= threshold)
resize(2 * table.length);
}扩容使用 resize() 实现,需要注意的是,扩容操作同样需要把 oldTable 的所有键值对重新插入 newTable 中,因此这一步是很费时的。
void resize(int newCapacity) {
Entry[] oldTable = table;
int oldCapacity = oldTable.length;
if (oldCapacity == MAXIMUM_CAPACITY) {
threshold = Integer.MAX_VALUE;
return;
}
Entry[] newTable = new Entry[newCapacity];
transfer(newTable);
table = newTable;
threshold = (int)(newCapacity * loadFactor);
}
void transfer(Entry[] newTable) {
Entry[] src = table;
int newCapacity = newTable.length;
for (int j = 0; j < src.length; j++) {
Entry<K,V> e = src[j];
if (e != null) {
src[j] = null;
do {
Entry<K,V> next = e.next;
int i = indexFor(e.hash, newCapacity);
e.next = newTable[i];
newTable[i] = e;
e = next;
} while (e != null);
}
}
}6. 扩容-重新计算桶下标
在进行扩容时,需要把键值对重新计算桶下标,从而放到对应的桶上。在前面提到,HashMap 使用 hash%capacity 来确定桶下标。HashMap capacity 为 2 的 n 次方这一特点能够极大降低重新计算桶下标操作的复杂度。
假设原数组长度 capacity 为 16,扩容之后 new capacity 为 32:
capacity : 00010000
new capacity : 00100000对于一个 Key,它的哈希值 hash 在第 5 位:
- 为 0,那么 hash%00010000 = hash%00100000,桶位置和原来一致;
- 为 1,hash%00010000 = hash%00100000 + 16,桶位置是原位置 + 16。
7. 计算数组容量
HashMap 构造函数允许用户传入的容量不是 2 的 n 次方,因为它可以自动地将传入的容量转换为 2 的 n 次方。
先考虑如何求一个数的掩码,对于 10010000,它的掩码为 11111111,可以使用以下方法得到:
mask |= mask >> 1 11011000
mask |= mask >> 2 11111110
mask |= mask >> 4 11111111mask+1 是大于原始数字的最小的 2 的 n 次方。
num 10010000
mask+1 100000000以下是 HashMap 中计算数组容量的代码:
static final int tableSizeFor(int cap) {
int n = cap - 1;
n |= n >>> 1;
n |= n >>> 2;
n |= n >>> 4;
n |= n >>> 8;
n |= n >>> 16;
return (n < 0) ? 1 : (n >= MAXIMUM_CAPACITY) ? MAXIMUM_CAPACITY : n + 1;
}8. 链表转红黑树
从 JDK 1.8 开始,一个桶存储的链表长度大于等于 8 时会将链表转换为红黑树。
9. 与 Hashtable 的比较
- Hashtable 使用 synchronized 来进行同步。
- HashMap 可以插入键为 null 的 Entry。
- HashMap 的迭代器是 fail-fast 迭代器。
- HashMap 不能保证随着时间的推移 Map 中的元素次序是不变的。
ConcurrentHashMap
1. 存储结构
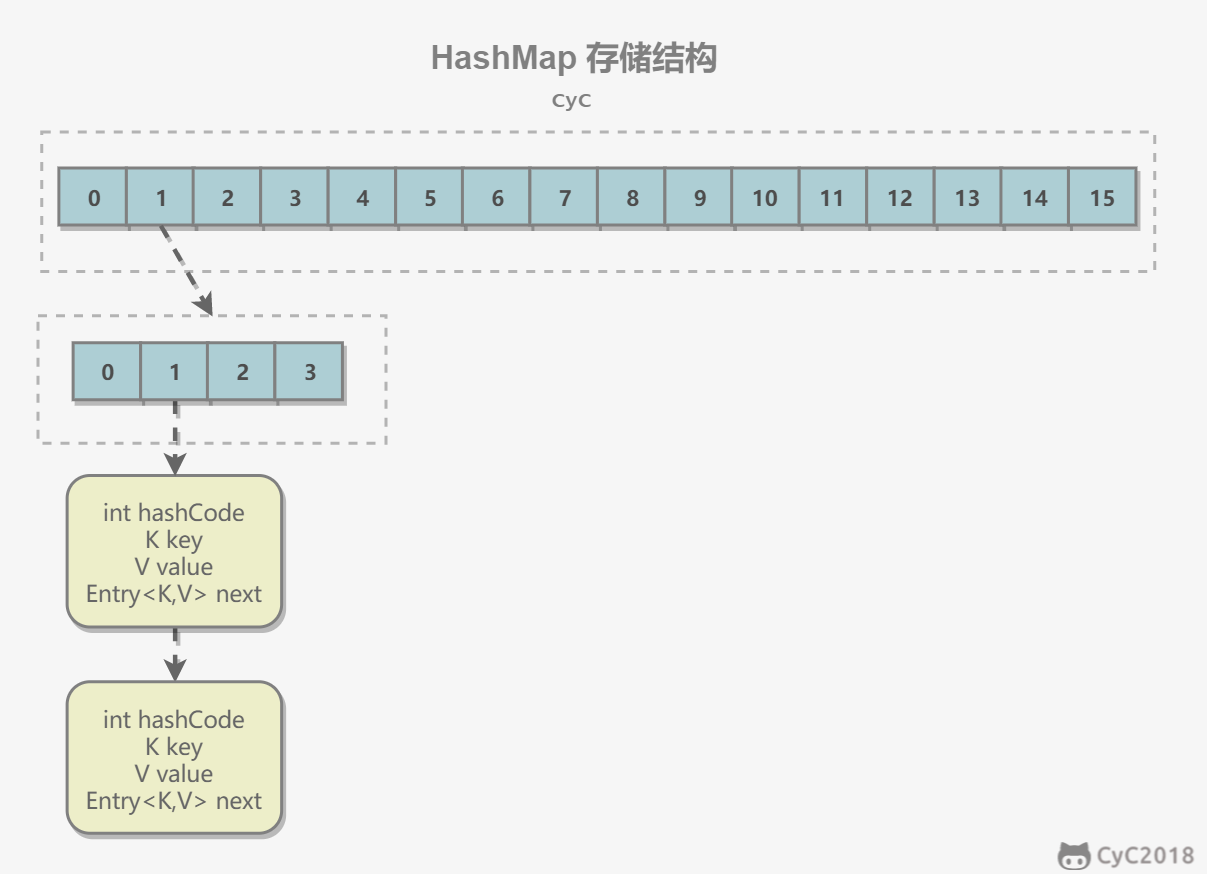
static final class HashEntry<K,V> {
final int hash;
final K key;
volatile V value;
volatile HashEntry<K,V> next;
}ConcurrentHashMap 和 HashMap 实现上类似,最主要的差别是 ConcurrentHashMap 采用了分段锁(Segment),每个分段锁维护着几个桶(HashEntry),多个线程可以同时访问不同分段锁上的桶,从而使其并发度更高(并发度就是 Segment 的个数)。
Segment 继承自 ReentrantLock。
static final class Segment<K,V> extends ReentrantLock implements Serializable {
private static final long serialVersionUID = 2249069246763182397L;
static final int MAX_SCAN_RETRIES =
Runtime.getRuntime().availableProcessors() > 1 ? 64 : 1;
transient volatile HashEntry<K,V>[] table;
transient int count;
transient int modCount;
transient int threshold;
final float loadFactor;
}final Segment<K,V>[] segments;默认的并发级别为 16,也就是说默认创建 16 个 Segment。
static final int DEFAULT_CONCURRENCY_LEVEL = 16;2. size 操作
每个 Segment 维护了一个 count 变量来统计该 Segment 中的键值对个数。
/**
* The number of elements. Accessed only either within locks
* or among other volatile reads that maintain visibility.
*/
transient int count;在执行 size 操作时,需要遍历所有 Segment 然后把 count 累计起来。
ConcurrentHashMap 在执行 size 操作时先尝试不加锁,如果连续两次不加锁操作得到的结果一致,那么可以认为这个结果是正确的。
尝试次数使用 RETRIES_BEFORE_LOCK 定义,该值为 2,retries 初始值为 -1,因此尝试次数为 3。
如果尝试的次数超过 3 次,就需要对每个 Segment 加锁。
/**
* Number of unsynchronized retries in size and containsValue
* methods before resorting to locking. This is used to avoid
* unbounded retries if tables undergo continuous modification
* which would make it impossible to obtain an accurate result.
*/
static final int RETRIES_BEFORE_LOCK = 2;
public int size() {
// Try a few times to get accurate count. On failure due to
// continuous async changes in table, resort to locking.
final Segment<K,V>[] segments = this.segments;
int size;
boolean overflow; // true if size overflows 32 bits
long sum; // sum of modCounts
long last = 0L; // previous sum
int retries = -1; // first iteration isn't retry
try {
for (;;) {
// 超过尝试次数,则对每个 Segment 加锁
if (retries++ == RETRIES_BEFORE_LOCK) {
for (int j = 0; j < segments.length; ++j)
ensureSegment(j).lock(); // force creation
}
sum = 0L;
size = 0;
overflow = false;
for (int j = 0; j < segments.length; ++j) {
Segment<K,V> seg = segmentAt(segments, j);
if (seg != null) {
sum += seg.modCount;
int c = seg.count;
if (c < 0 || (size += c) < 0)
overflow = true;
}
}
// 连续两次得到的结果一致,则认为这个结果是正确的
if (sum == last)
break;
last = sum;
}
} finally {
if (retries > RETRIES_BEFORE_LOCK) {
for (int j = 0; j < segments.length; ++j)
segmentAt(segments, j).unlock();
}
}
return overflow ? Integer.MAX_VALUE : size;
}3. JDK 1.8 的改动
JDK 1.7 使用分段锁机制来实现并发更新操作,核心类为 Segment,它继承自重入锁 ReentrantLock,并发度与 Segment 数量相等。
JDK 1.8 使用了 CAS 操作来支持更高的并发度,在 CAS 操作失败时使用内置锁 synchronized。
并且 JDK 1.8 的实现也在链表过长时会转换为红黑树。
LinkedHashMap
存储结构
继承自 HashMap,因此具有和 HashMap 一样的快速查找特性。
public class LinkedHashMap<K,V> extends HashMap<K,V> implements Map<K,V>内部维护了一个双向链表,用来维护插入顺序或者 LRU 顺序。
/**
* The head (eldest) of the doubly linked list.
*/
transient LinkedHashMap.Entry<K,V> head;
/**
* The tail (youngest) of the doubly linked list.
*/
transient LinkedHashMap.Entry<K,V> tail;accessOrder 决定了顺序,默认为 false,此时维护的是插入顺序。
final boolean accessOrder;LinkedHashMap 最重要的是以下用于维护顺序的函数,它们会在 put、get 等方法中调用。
void afterNodeAccess(Node<K,V> p) { }
void afterNodeInsertion(boolean evict) { }afterNodeAccess()
当一个节点被访问时,如果 accessOrder 为 true,则会将该节点移到链表尾部。也就是说指定为 LRU 顺序之后,在每次访问一个节点时,会将这个节点移到链表尾部,保证链表尾部是最近访问的节点,那么链表首部就是最近最久未使用的节点。
void afterNodeAccess(Node<K,V> e) { // move node to last
LinkedHashMap.Entry<K,V> last;
if (accessOrder && (last = tail) != e) {
LinkedHashMap.Entry<K,V> p =
(LinkedHashMap.Entry<K,V>)e, b = p.before, a = p.after;
p.after = null;
if (b == null)
head = a;
else
b.after = a;
if (a != null)
a.before = b;
else
last = b;
if (last == null)
head = p;
else {
p.before = last;
last.after = p;
}
tail = p;
++modCount;
}
}afterNodeInsertion()
在 put 等操作之后执行,当 removeEldestEntry() 方法返回 true 时会移除最晚的节点,也就是链表首部节点 first。
evict 只有在构建 Map 的时候才为 false,在这里为 true。
void afterNodeInsertion(boolean evict) { // possibly remove eldest
LinkedHashMap.Entry<K,V> first;
if (evict && (first = head) != null && removeEldestEntry(first)) {
K key = first.key;
removeNode(hash(key), key, null, false, true);
}
}removeEldestEntry() 默认为 false,如果需要让它为 true,需要继承 LinkedHashMap 并且覆盖这个方法的实现,这在实现 LRU 的缓存中特别有用,通过移除最近最久未使用的节点,从而保证缓存空间足够,并且缓存的数据都是热点数据。
protected boolean removeEldestEntry(Map.Entry<K,V> eldest) {
return false;
}LRU 缓存
以下是使用 LinkedHashMap 实现的一个 LRU 缓存:
- 设定最大缓存空间 MAX_ENTRIES 为 3;
- 使用 LinkedHashMap 的构造函数将 accessOrder 设置为 true,开启 LRU 顺序;
- 覆盖 removeEldestEntry() 方法实现,在节点多于 MAX_ENTRIES 就会将最近最久未使用的数据移除。
class LRUCache<K, V> extends LinkedHashMap<K, V> {
private static final int MAX_ENTRIES = 3;
protected boolean removeEldestEntry(Map.Entry eldest) {
return size() > MAX_ENTRIES;
}
LRUCache() {
super(MAX_ENTRIES, 0.75f, true);
}
}public static void main(String[] args) {
LRUCache<Integer, String> cache = new LRUCache<>();
cache.put(1, "a");
cache.put(2, "b");
cache.put(3, "c");
cache.get(1);
cache.put(4, "d");
System.out.println(cache.keySet());
}[3, 1, 4]WeakHashMap
存储结构
WeakHashMap 的 Entry 继承自 WeakReference,被 WeakReference 关联的对象在下一次垃圾回收时会被回收。
WeakHashMap 主要用来实现缓存,通过使用 WeakHashMap 来引用缓存对象,由 JVM 对这部分缓存进行回收。
private static class Entry<K,V> extends WeakReference implements Map.Entry<K,V>ConcurrentCache
Tomcat 中的 ConcurrentCache 使用了 WeakHashMap 来实现缓存功能。
ConcurrentCache 采取的是分代缓存:
- 经常使用的对象放入 eden 中,eden 使用 ConcurrentHashMap 实现,不用担心会被回收(伊甸园);
- 不常用的对象放入 longterm,longterm 使用 WeakHashMap 实现,这些老对象会被垃圾收集器回收。
- 当调用 get() 方法时,会先从 eden 区获取,如果没有找到的话再到 longterm 获取,当从 longterm 获取到就把对象放入 eden 中,从而保证经常被访问的节点不容易被回收。
- 当调用 put() 方法时,如果 eden 的大小超过了 size,那么就将 eden 中的所有对象都放入 longterm 中,利用虚拟机回收掉一部分不经常使用的对象。
public final class ConcurrentCache<K, V> {
private final int size;
private final Map<K, V> eden;
private final Map<K, V> longterm;
public ConcurrentCache(int size) {
this.size = size;
this.eden = new ConcurrentHashMap<>(size);
this.longterm = new WeakHashMap<>(size);
}
public V get(K k) {
V v = this.eden.get(k);
if (v == null) {
v = this.longterm.get(k);
if (v != null)
this.eden.put(k, v);
}
return v;
}
public void put(K k, V v) {
if (this.eden.size() >= size) {
this.longterm.putAll(this.eden);
this.eden.clear();
}
this.eden.put(k, v);
}
}参考资料
- Eckel B. Java 编程思想 [M]. 机械工业出版社, 2002.
- Java Collection Framework
- Iterator 模式
- Java 8 系列之重新认识 HashMap
- What is difference between HashMap and Hashtable in Java?
- Java 集合之 HashMap
- The principle of ConcurrentHashMap analysis
- 探索 ConcurrentHashMap 高并发性的实现机制
- HashMap 相关面试题及其解答
- Java 集合细节(二):asList 的缺陷
- Java Collection Framework – The LinkedList Class
Java 并发
Java 并发
* [一、使用线程](#一使用线程)
* [实现 Runnable 接口](#实现-runnable-接口)
* [实现 Callable 接口](#实现-callable-接口)
* [继承 Thread 类](#继承-thread-类)
* [实现接口 VS 继承 Thread](#实现接口-vs-继承-thread)
* [二、基础线程机制](#二基础线程机制)
* [Executor](#executor)
* [Daemon](#daemon)
* [sleep()](#sleep)
* [yield()](#yield)
* [三、中断](#三中断)
* [InterruptedException](#interruptedexception)
* [interrupted()](#interrupted)
* [Executor 的中断操作](#executor-的中断操作)
* [四、互斥同步](#四互斥同步)
* [synchronized](#synchronized)
* [ReentrantLock](#reentrantlock)
* [比较](#比较)
* [使用选择](#使用选择)
* [五、线程之间的协作](#五线程之间的协作)
* [join()](#join)
* [wait() notify() notifyAll()](#wait-notify-notifyall)
* [await() signal() signalAll()](#await-signal-signalall)
* [六、线程状态](#六线程状态)
* [新建(NEW)](#新建new)
* [可运行(RUNABLE)](#可运行runable)
* [阻塞(BLOCKED)](#阻塞blocked)
* [无限期等待(WAITING)](#无限期等待waiting)
* [限期等待(TIMED_WAITING)](#限期等待timed_waiting)
* [死亡(TERMINATED)](#死亡terminated)
* [七、J.U.C - AQS](#七juc---aqs)
* [CountDownLatch](#countdownlatch)
* [CyclicBarrier](#cyclicbarrier)
* [Semaphore](#semaphore)
* [八、J.U.C - 其它组件](#八juc---其它组件)
* [FutureTask](#futuretask)
* [BlockingQueue](#blockingqueue)
* [ForkJoin](#forkjoin)
* [九、线程不安全示例](#九线程不安全示例)
* [十、Java 内存模型](#十java-内存模型)
* [主内存与工作内存](#主内存与工作内存)
* [内存间交互操作](#内存间交互操作)
* [内存模型三大特性](#内存模型三大特性)
* [先行发生原则](#先行发生原则)
* [十一、线程安全](#十一线程安全)
* [不可变](#不可变)
* [互斥同步](#互斥同步)
* [非阻塞同步](#非阻塞同步)
* [无同步方案](#无同步方案)
* [十二、锁优化](#十二锁优化)
* [自旋锁](#自旋锁)
* [锁消除](#锁消除)
* [锁粗化](#锁粗化)
* [轻量级锁](#轻量级锁)
* [偏向锁](#偏向锁)
* [十三、多线程开发良好的实践](#十三多线程开发良好的实践)
* [参考资料](#参考资料)一、使用线程
有三种使用线程的方法:
- 实现 Runnable 接口;
- 实现 Callable 接口;
- 继承 Thread 类。
实现 Runnable 和 Callable 接口的类只能当做一个可以在线程中运行的任务,不是真正意义上的线程,因此最后还需要通过 Thread 来调用。可以理解为任务是通过线程驱动从而执行的。
实现 Runnable 接口
需要实现接口中的 run() 方法。
public class MyRunnable implements Runnable {
@Override
public void run() {
// ...
}
}使用 Runnable 实例再创建一个 Thread 实例,然后调用 Thread 实例的 start() 方法来启动线程。
public static void main(String[] args) {
MyRunnable instance = new MyRunnable();
Thread thread = new Thread(instance);
thread.start();
}实现 Callable 接口
与 Runnable 相比,Callable 可以有返回值,返回值通过 FutureTask 进行封装。
public class MyCallable implements Callable<Integer> {
public Integer call() {
return 123;
}
}public static void main(String[] args) throws ExecutionException, InterruptedException {
MyCallable mc = new MyCallable();
FutureTask<Integer> ft = new FutureTask<>(mc);
Thread thread = new Thread(ft);
thread.start();
System.out.println(ft.get());
}继承 Thread 类
同样也是需要实现 run() 方法,因为 Thread 类也实现了 Runable 接口。
当调用 start() 方法启动一个线程时,虚拟机会将该线程放入就绪队列中等待被调度,当一个线程被调度时会执行该线程的 run() 方法。
public class MyThread extends Thread {
public void run() {
// ...
}
}public static void main(String[] args) {
MyThread mt = new MyThread();
mt.start();
}实现接口 VS 继承 Thread
实现接口会更好一些,因为:
- Java 不支持多重继承,因此继承了 Thread 类就无法继承其它类,但是可以实现多个接口;
- 类可能只要求可执行就行,继承整个 Thread 类开销过大。
二、基础线程机制
Executor
Executor 管理多个异步任务的执行,而无需程序员显式地管理线程的生命周期。这里的异步是指多个任务的执行互不干扰,不需要进行同步操作。
主要有三种 Executor:
- CachedThreadPool:一个任务创建一个线程;
- FixedThreadPool:所有任务只能使用固定大小的线程;
- SingleThreadExecutor:相当于大小为 1 的 FixedThreadPool。
public static void main(String[] args) {
ExecutorService executorService = Executors.newCachedThreadPool();
for (int i = 0; i < 5; i++) {
executorService.execute(new MyRunnable());
}
executorService.shutdown();
}Daemon
守护线程是程序运行时在后台提供服务的线程,不属于程序中不可或缺的部分。
当所有非守护线程结束时,程序也就终止,同时会杀死所有守护线程。
main() 属于非守护线程。
在线程启动之前使用 setDaemon() 方法可以将一个线程设置为守护线程。
public static void main(String[] args) {
Thread thread = new Thread(new MyRunnable());
thread.setDaemon(true);
}sleep()
Thread.sleep(millisec) 方法会休眠当前正在执行的线程,millisec 单位为毫秒。
sleep() 可能会抛出 InterruptedException,因为异常不能跨线程传播回 main() 中,因此必须在本地进行处理。线程中抛出的其它异常也同样需要在本地进行处理。
public void run() {
try {
Thread.sleep(3000);
} catch (InterruptedException e) {
e.printStackTrace();
}
}yield()
对静态方法 Thread.yield() 的调用声明了当前线程已经完成了生命周期中最重要的部分,可以切换给其它线程来执行。该方法只是对线程调度器的一个建议,而且也只是建议具有相同优先级的其它线程可以运行。
public void run() {
Thread.yield();
}三、中断
一个线程执行完毕之后会自动结束,如果在运行过程中发生异常也会提前结束。
InterruptedException
通过调用一个线程的 interrupt() 来中断该线程,如果该线程处于阻塞、限期等待或者无限期等待状态,那么就会抛出 InterruptedException,从而提前结束该线程。但是不能中断 I/O 阻塞和 synchronized 锁阻塞。
对于以下代码,在 main() 中启动一个线程之后再中断它,由于线程中调用了 Thread.sleep() 方法,因此会抛出一个 InterruptedException,从而提前结束线程,不执行之后的语句。
public class InterruptExample {
private static class MyThread1 extends Thread {
@Override
public void run() {
try {
Thread.sleep(2000);
System.out.println("Thread run");
} catch (InterruptedException e) {
e.printStackTrace();
}
}
}
}public static void main(String[] args) throws InterruptedException {
Thread thread1 = new MyThread1();
thread1.start();
thread1.interrupt();
System.out.println("Main run");
}Main run
java.lang.InterruptedException: sleep interrupted
at java.lang.Thread.sleep(Native Method)
at InterruptExample.lambda$main$0(InterruptExample.java:5)
at InterruptExample$$Lambda$1/713338599.run(Unknown Source)
at java.lang.Thread.run(Thread.java:745)interrupted()
如果一个线程的 run() 方法执行一个无限循环,并且没有执行 sleep() 等会抛出 InterruptedException 的操作,那么调用线程的 interrupt() 方法就无法使线程提前结束。
但是调用 interrupt() 方法会设置线程的中断标记,此时调用 interrupted() 方法会返回 true。因此可以在循环体中使用 interrupted() 方法来判断线程是否处于中断状态,从而提前结束线程。
public class InterruptExample {
private static class MyThread2 extends Thread {
@Override
public void run() {
while (!interrupted()) {
// ..
}
System.out.println("Thread end");
}
}
}public static void main(String[] args) throws InterruptedException {
Thread thread2 = new MyThread2();
thread2.start();
thread2.interrupt();
}Thread endExecutor 的中断操作
调用 Executor 的 shutdown() 方法会等待线程都执行完毕之后再关闭,但是如果调用的是 shutdownNow() 方法,则相当于调用每个线程的 interrupt() 方法。
以下使用 Lambda 创建线程,相当于创建了一个匿名内部线程。
public static void main(String[] args) {
ExecutorService executorService = Executors.newCachedThreadPool();
executorService.execute(() -> {
try {
Thread.sleep(2000);
System.out.println("Thread run");
} catch (InterruptedException e) {
e.printStackTrace();
}
});
executorService.shutdownNow();
System.out.println("Main run");
}Main run
java.lang.InterruptedException: sleep interrupted
at java.lang.Thread.sleep(Native Method)
at ExecutorInterruptExample.lambda$main$0(ExecutorInterruptExample.java:9)
at ExecutorInterruptExample$$Lambda$1/1160460865.run(Unknown Source)
at java.util.concurrent.ThreadPoolExecutor.runWorker(ThreadPoolExecutor.java:1142)
at java.util.concurrent.ThreadPoolExecutor$Worker.run(ThreadPoolExecutor.java:617)
at java.lang.Thread.run(Thread.java:745)如果只想中断 Executor 中的一个线程,可以通过使用 submit() 方法来提交一个线程,它会返回一个 Future\ 对象,通过调用该对象的 cancel(true) 方法就可以中断线程。
Future<?> future = executorService.submit(() -> {
// ..
});
future.cancel(true);四、互斥同步
Java 提供了两种锁机制来控制多个线程对共享资源的互斥访问,第一个是 JVM 实现的 synchronized,而另一个是 JDK 实现的 ReentrantLock。
synchronized
1. 同步一个代码块
public void func() {
synchronized (this) {
// ...
}
}它只作用于同一个对象,如果调用两个对象上的同步代码块,就不会进行同步。
对于以下代码,使用 ExecutorService 执行了两个线程,由于调用的是同一个对象的同步代码块,因此这两个线程会进行同步,当一个线程进入同步语句块时,另一个线程就必须等待。
public class SynchronizedExample {
public void func1() {
synchronized (this) {
for (int i = 0; i < 10; i++) {
System.out.print(i + " ");
}
}
}
}public static void main(String[] args) {
SynchronizedExample e1 = new SynchronizedExample();
ExecutorService executorService = Executors.newCachedThreadPool();
executorService.execute(() -> e1.func1());
executorService.execute(() -> e1.func1());
}0 1 2 3 4 5 6 7 8 9 0 1 2 3 4 5 6 7 8 9对于以下代码,两个线程调用了不同对象的同步代码块,因此这两个线程就不需要同步。从输出结果可以看出,两个线程交叉执行。
public static void main(String[] args) {
SynchronizedExample e1 = new SynchronizedExample();
SynchronizedExample e2 = new SynchronizedExample();
ExecutorService executorService = Executors.newCachedThreadPool();
executorService.execute(() -> e1.func1());
executorService.execute(() -> e2.func1());
}0 0 1 1 2 2 3 3 4 4 5 5 6 6 7 7 8 8 9 92. 同步一个方法
public synchronized void func () {
// ...
}它和同步代码块一样,作用于同一个对象。
3. 同步一个类
public void func() {
synchronized (SynchronizedExample.class) {
// ...
}
}作用于整个类,也就是说两个线程调用同一个类的不同对象上的这种同步语句,也会进行同步。
public class SynchronizedExample {
public void func2() {
synchronized (SynchronizedExample.class) {
for (int i = 0; i < 10; i++) {
System.out.print(i + " ");
}
}
}
}public static void main(String[] args) {
SynchronizedExample e1 = new SynchronizedExample();
SynchronizedExample e2 = new SynchronizedExample();
ExecutorService executorService = Executors.newCachedThreadPool();
executorService.execute(() -> e1.func2());
executorService.execute(() -> e2.func2());
}0 1 2 3 4 5 6 7 8 9 0 1 2 3 4 5 6 7 8 94. 同步一个静态方法
public synchronized static void fun() {
// ...
}作用于整个类。
ReentrantLock
ReentrantLock 是 java.util.concurrent(J.U.C)包中的锁。
public class LockExample {
private Lock lock = new ReentrantLock();
public void func() {
lock.lock();
try {
for (int i = 0; i < 10; i++) {
System.out.print(i + " ");
}
} finally {
lock.unlock(); // 确保释放锁,从而避免发生死锁。
}
}
}public static void main(String[] args) {
LockExample lockExample = new LockExample();
ExecutorService executorService = Executors.newCachedThreadPool();
executorService.execute(() -> lockExample.func());
executorService.execute(() -> lockExample.func());
}0 1 2 3 4 5 6 7 8 9 0 1 2 3 4 5 6 7 8 9比较
1. 锁的实现
synchronized 是 JVM 实现的,而 ReentrantLock 是 JDK 实现的。
2. 性能
新版本 Java 对 synchronized 进行了很多优化,例如自旋锁等,synchronized 与 ReentrantLock 大致相同。
3. 等待可中断
当持有锁的线程长期不释放锁的时候,正在等待的线程可以选择放弃等待,改为处理其他事情。
ReentrantLock 可中断,而 synchronized 不行。
4. 公平锁
公平锁是指多个线程在等待同一个锁时,必须按照申请锁的时间顺序来依次获得锁。
synchronized 中的锁是非公平的,ReentrantLock 默认情况下也是非公平的,但是也可以是公平的。
5. 锁绑定多个条件
一个 ReentrantLock 可以同时绑定多个 Condition 对象。
使用选择
除非需要使用 ReentrantLock 的高级功能,否则优先使用 synchronized。这是因为 synchronized 是 JVM 实现的一种锁机制,JVM 原生地支持它,而 ReentrantLock 不是所有的 JDK 版本都支持。并且使用 synchronized 不用担心没有释放锁而导致死锁问题,因为 JVM 会确保锁的释放。
五、线程之间的协作
当多个线程可以一起工作去解决某个问题时,如果某些部分必须在其它部分之前完成,那么就需要对线程进行协调。
join()
在线程中调用另一个线程的 join() 方法,会将当前线程挂起,而不是忙等待,直到目标线程结束。
对于以下代码,虽然 b 线程先启动,但是因为在 b 线程中调用了 a 线程的 join() 方法,b 线程会等待 a 线程结束才继续执行,因此最后能够保证 a 线程的输出先于 b 线程的输出。
public class JoinExample {
private class A extends Thread {
@Override
public void run() {
System.out.println("A");
}
}
private class B extends Thread {
private A a;
B(A a) {
this.a = a;
}
@Override
public void run() {
try {
a.join();
} catch (InterruptedException e) {
e.printStackTrace();
}
System.out.println("B");
}
}
public void test() {
A a = new A();
B b = new B(a);
b.start();
a.start();
}
}public static void main(String[] args) {
JoinExample example = new JoinExample();
example.test();
}A
Bwait() notify() notifyAll()
调用 wait() 使得线程等待某个条件满足,线程在等待时会被挂起,当其他线程的运行使得这个条件满足时,其它线程会调用 notify() 或者 notifyAll() 来唤醒挂起的线程。
它们都属于 Object 的一部分,而不属于 Thread。
只能用在同步方法或者同步控制块中使用,否则会在运行时抛出 IllegalMonitorStateException。
使用 wait() 挂起期间,线程会释放锁。这是因为,如果没有释放锁,那么其它线程就无法进入对象的同步方法或者同步控制块中,那么就无法执行 notify() 或者 notifyAll() 来唤醒挂起的线程,造成死锁。
public class WaitNotifyExample {
public synchronized void before() {
System.out.println("before");
notifyAll();
}
public synchronized void after() {
try {
wait();
} catch (InterruptedException e) {
e.printStackTrace();
}
System.out.println("after");
}
}public static void main(String[] args) {
ExecutorService executorService = Executors.newCachedThreadPool();
WaitNotifyExample example = new WaitNotifyExample();
executorService.execute(() -> example.after());
executorService.execute(() -> example.before());
}before
afterwait() 和 sleep() 的区别
- wait() 是 Object 的方法,而 sleep() 是 Thread 的静态方法;
- wait() 会释放锁,sleep() 不会。
await() signal() signalAll()
java.util.concurrent 类库中提供了 Condition 类来实现线程之间的协调,可以在 Condition 上调用 await() 方法使线程等待,其它线程调用 signal() 或 signalAll() 方法唤醒等待的线程。
相比于 wait() 这种等待方式,await() 可以指定等待的条件,因此更加灵活。
使用 Lock 来获取一个 Condition 对象。
public class AwaitSignalExample {
private Lock lock = new ReentrantLock();
private Condition condition = lock.newCondition();
public void before() {
lock.lock();
try {
System.out.println("before");
condition.signalAll();
} finally {
lock.unlock();
}
}
public void after() {
lock.lock();
try {
condition.await();
System.out.println("after");
} catch (InterruptedException e) {
e.printStackTrace();
} finally {
lock.unlock();
}
}
}public static void main(String[] args) {
ExecutorService executorService = Executors.newCachedThreadPool();
AwaitSignalExample example = new AwaitSignalExample();
executorService.execute(() -> example.after());
executorService.execute(() -> example.before());
}before
after六、线程状态
一个线程只能处于一种状态,并且这里的线程状态特指 Java 虚拟机的线程状态,不能反映线程在特定操作系统下的状态。
新建(NEW)
创建后尚未启动。
可运行(RUNABLE)
正在 Java 虚拟机中运行。但是在操作系统层面,它可能处于运行状态,也可能等待资源调度(例如处理器资源),资源调度完成就进入运行状态。所以该状态的可运行是指可以被运行,具体有没有运行要看底层操作系统的资源调度。
阻塞(BLOCKED)
请求获取 monitor lock 从而进入 synchronized 函数或者代码块,但是其它线程已经占用了该 monitor lock,所以出于阻塞状态。要结束该状态进入从而 RUNABLE 需要其他线程释放 monitor lock。
无限期等待(WAITING)
等待其它线程显式地唤醒。
阻塞和等待的区别在于,阻塞是被动的,它是在等待获取 monitor lock。而等待是主动的,通过调用 Object.wait() 等方法进入。
| 进入方法 | 退出方法 |
|---|---|
| 没有设置 Timeout 参数的 Object.wait() 方法 | Object.notify() / Object.notifyAll() |
| 没有设置 Timeout 参数的 Thread.join() 方法 | 被调用的线程执行完毕 |
| LockSupport.park() 方法 | LockSupport.unpark(Thread) |
限期等待(TIMED_WAITING)
无需等待其它线程显式地唤醒,在一定时间之后会被系统自动唤醒。
| 进入方法 | 退出方法 |
|---|---|
| Thread.sleep() 方法 | 时间结束 |
| 设置了 Timeout 参数的 Object.wait() 方法 | 时间结束 / Object.notify() / Object.notifyAll() |
| 设置了 Timeout 参数的 Thread.join() 方法 | 时间结束 / 被调用的线程执行完毕 |
| LockSupport.parkNanos() 方法 | LockSupport.unpark(Thread) |
| LockSupport.parkUntil() 方法 | LockSupport.unpark(Thread) |
调用 Thread.sleep() 方法使线程进入限期等待状态时,常常用“使一个线程睡眠”进行描述。调用 Object.wait() 方法使线程进入限期等待或者无限期等待时,常常用“挂起一个线程”进行描述。睡眠和挂起是用来描述行为,而阻塞和等待用来描述状态。
死亡(TERMINATED)
可以是线程结束任务之后自己结束,或者产生了异常而结束。
七、J.U.C - AQS
java.util.concurrent(J.U.C)大大提高了并发性能,AQS 被认为是 J.U.C 的核心。
CountDownLatch
用来控制一个或者多个线程等待多个线程。
维护了一个计数器 cnt,每次调用 countDown() 方法会让计数器的值减 1,减到 0 的时候,那些因为调用 await() 方法而在等待的线程就会被唤醒。
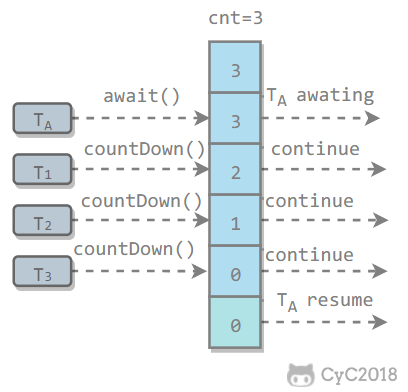
public class CountdownLatchExample {
public static void main(String[] args) throws InterruptedException {
final int totalThread = 10;
CountDownLatch countDownLatch = new CountDownLatch(totalThread);
ExecutorService executorService = Executors.newCachedThreadPool();
for (int i = 0; i < totalThread; i++) {
executorService.execute(() -> {
System.out.print("run..");
countDownLatch.countDown();
});
}
countDownLatch.await();
System.out.println("end");
executorService.shutdown();
}
}run..run..run..run..run..run..run..run..run..run..endCyclicBarrier
用来控制多个线程互相等待,只有当多个线程都到达时,这些线程才会继续执行。
和 CountdownLatch 相似,都是通过维护计数器来实现的。线程执行 await() 方法之后计数器会减 1,并进行等待,直到计数器为 0,所有调用 await() 方法而在等待的线程才能继续执行。
CyclicBarrier 和 CountdownLatch 的一个区别是,CyclicBarrier 的计数器通过调用 reset() 方法可以循环使用,所以它才叫做循环屏障。
CyclicBarrier 有两个构造函数,其中 parties 指示计数器的初始值,barrierAction 在所有线程都到达屏障的时候会执行一次。
public CyclicBarrier(int parties, Runnable barrierAction) {
if (parties <= 0) throw new IllegalArgumentException();
this.parties = parties;
this.count = parties;
this.barrierCommand = barrierAction;
}
public CyclicBarrier(int parties) {
this(parties, null);
}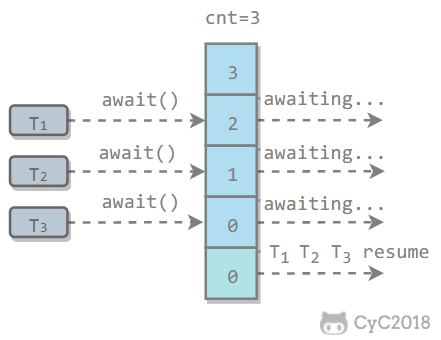
public class CyclicBarrierExample {
public static void main(String[] args) {
final int totalThread = 10;
CyclicBarrier cyclicBarrier = new CyclicBarrier(totalThread);
ExecutorService executorService = Executors.newCachedThreadPool();
for (int i = 0; i < totalThread; i++) {
executorService.execute(() -> {
System.out.print("before..");
try {
cyclicBarrier.await();
} catch (InterruptedException | BrokenBarrierException e) {
e.printStackTrace();
}
System.out.print("after..");
});
}
executorService.shutdown();
}
}before..before..before..before..before..before..before..before..before..before..after..after..after..after..after..after..after..after..after..after..Semaphore
Semaphore 类似于操作系统中的信号量,可以控制对互斥资源的访问线程数。
以下代码模拟了对某个服务的并发请求,每次只能有 3 个客户端同时访问,请求总数为 10。
public class SemaphoreExample {
public static void main(String[] args) {
final int clientCount = 3;
final int totalRequestCount = 10;
Semaphore semaphore = new Semaphore(clientCount);
ExecutorService executorService = Executors.newCachedThreadPool();
for (int i = 0; i < totalRequestCount; i++) {
executorService.execute(()->{
try {
semaphore.acquire();
System.out.print(semaphore.availablePermits() + " ");
} catch (InterruptedException e) {
e.printStackTrace();
} finally {
semaphore.release();
}
});
}
executorService.shutdown();
}
}2 1 2 2 2 2 2 1 2 2八、J.U.C - 其它组件
FutureTask
在介绍 Callable 时我们知道它可以有返回值,返回值通过 Future\
public class FutureTask<V> implements RunnableFuture<V>public interface RunnableFuture<V> extends Runnable, Future<V>FutureTask 可用于异步获取执行结果或取消执行任务的场景。当一个计算任务需要执行很长时间,那么就可以用 FutureTask 来封装这个任务,主线程在完成自己的任务之后再去获取结果。
public class FutureTaskExample {
public static void main(String[] args) throws ExecutionException, InterruptedException {
FutureTask<Integer> futureTask = new FutureTask<Integer>(new Callable<Integer>() {
@Override
public Integer call() throws Exception {
int result = 0;
for (int i = 0; i < 100; i++) {
Thread.sleep(10);
result += i;
}
return result;
}
});
Thread computeThread = new Thread(futureTask);
computeThread.start();
Thread otherThread = new Thread(() -> {
System.out.println("other task is running...");
try {
Thread.sleep(1000);
} catch (InterruptedException e) {
e.printStackTrace();
}
});
otherThread.start();
System.out.println(futureTask.get());
}
}other task is running...
4950BlockingQueue
java.util.concurrent.BlockingQueue 接口有以下阻塞队列的实现:
- FIFO 队列 :LinkedBlockingQueue、ArrayBlockingQueue(固定长度)
- 优先级队列 :PriorityBlockingQueue
提供了阻塞的 take() 和 put() 方法:如果队列为空 take() 将阻塞,直到队列中有内容;如果队列为满 put() 将阻塞,直到队列有空闲位置。
使用 BlockingQueue 实现生产者消费者问题
public class ProducerConsumer {
private static BlockingQueue<String> queue = new ArrayBlockingQueue<>(5);
private static class Producer extends Thread {
@Override
public void run() {
try {
queue.put("product");
} catch (InterruptedException e) {
e.printStackTrace();
}
System.out.print("produce..");
}
}
private static class Consumer extends Thread {
@Override
public void run() {
try {
String product = queue.take();
} catch (InterruptedException e) {
e.printStackTrace();
}
System.out.print("consume..");
}
}
}public static void main(String[] args) {
for (int i = 0; i < 2; i++) {
Producer producer = new Producer();
producer.start();
}
for (int i = 0; i < 5; i++) {
Consumer consumer = new Consumer();
consumer.start();
}
for (int i = 0; i < 3; i++) {
Producer producer = new Producer();
producer.start();
}
}produce..produce..consume..consume..produce..consume..produce..consume..produce..consume..ForkJoin
主要用于并行计算中,和 MapReduce 原理类似,都是把大的计算任务拆分成多个小任务并行计算。
public class ForkJoinExample extends RecursiveTask<Integer> {
private final int threshold = 5;
private int first;
private int last;
public ForkJoinExample(int first, int last) {
this.first = first;
this.last = last;
}
@Override
protected Integer compute() {
int result = 0;
if (last - first <= threshold) {
// 任务足够小则直接计算
for (int i = first; i <= last; i++) {
result += i;
}
} else {
// 拆分成小任务
int middle = first + (last - first) / 2;
ForkJoinExample leftTask = new ForkJoinExample(first, middle);
ForkJoinExample rightTask = new ForkJoinExample(middle + 1, last);
leftTask.fork();
rightTask.fork();
result = leftTask.join() + rightTask.join();
}
return result;
}
}public static void main(String[] args) throws ExecutionException, InterruptedException {
ForkJoinExample example = new ForkJoinExample(1, 10000);
ForkJoinPool forkJoinPool = new ForkJoinPool();
Future result = forkJoinPool.submit(example);
System.out.println(result.get());
}ForkJoin 使用 ForkJoinPool 来启动,它是一个特殊的线程池,线程数量取决于 CPU 核数。
public class ForkJoinPool extends AbstractExecutorServiceForkJoinPool 实现了工作窃取算法来提高 CPU 的利用率。每个线程都维护了一个双端队列,用来存储需要执行的任务。工作窃取算法允许空闲的线程从其它线程的双端队列中窃取一个任务来执行。窃取的任务必须是最晚的任务,避免和队列所属线程发生竞争。例如下图中,Thread2 从 Thread1 的队列中拿出最晚的 Task1 任务,Thread1 会拿出 Task2 来执行,这样就避免发生竞争。但是如果队列中只有一个任务时还是会发生竞争。

九、线程不安全示例
如果多个线程对同一个共享数据进行访问而不采取同步操作的话,那么操作的结果是不一致的。
以下代码演示了 1000 个线程同时对 cnt 执行自增操作,操作结束之后它的值有可能小于 1000。
public class ThreadUnsafeExample {
private int cnt = 0;
public void add() {
cnt++;
}
public int get() {
return cnt;
}
}public static void main(String[] args) throws InterruptedException {
final int threadSize = 1000;
ThreadUnsafeExample example = new ThreadUnsafeExample();
final CountDownLatch countDownLatch = new CountDownLatch(threadSize);
ExecutorService executorService = Executors.newCachedThreadPool();
for (int i = 0; i < threadSize; i++) {
executorService.execute(() -> {
example.add();
countDownLatch.countDown();
});
}
countDownLatch.await();
executorService.shutdown();
System.out.println(example.get());
}997十、Java 内存模型
Java 内存模型试图屏蔽各种硬件和操作系统的内存访问差异,以实现让 Java 程序在各种平台下都能达到一致的内存访问效果。
主内存与工作内存
处理器上的寄存器的读写的速度比内存快几个数量级,为了解决这种速度矛盾,在它们之间加入了高速缓存。
加入高速缓存带来了一个新的问题:缓存一致性。如果多个缓存共享同一块主内存区域,那么多个缓存的数据可能会不一致,需要一些协议来解决这个问题。
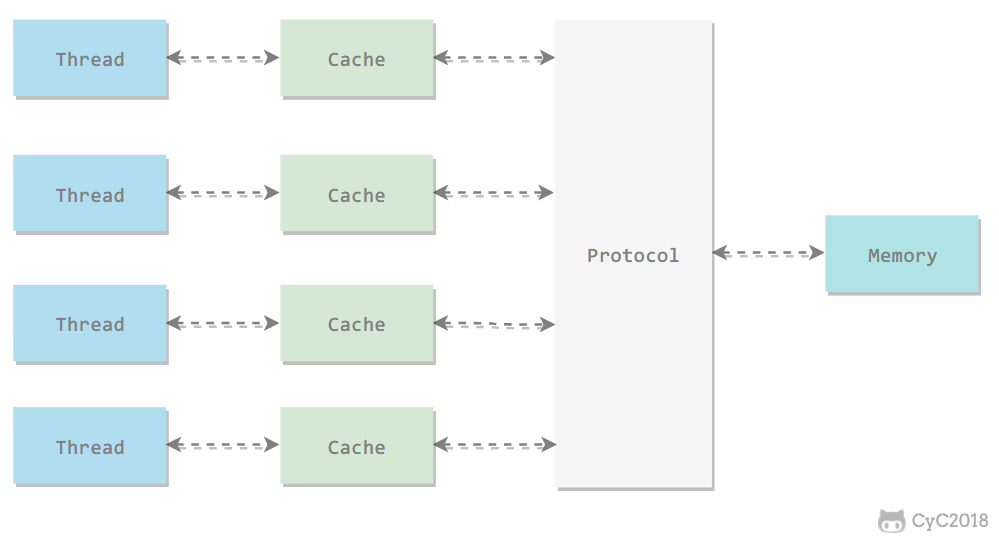
所有的变量都存储在主内存中,每个线程还有自己的工作内存,工作内存存储在高速缓存或者寄存器中,保存了该线程使用的变量的主内存副本拷贝。
线程只能直接操作工作内存中的变量,不同线程之间的变量值传递需要通过主内存来完成。
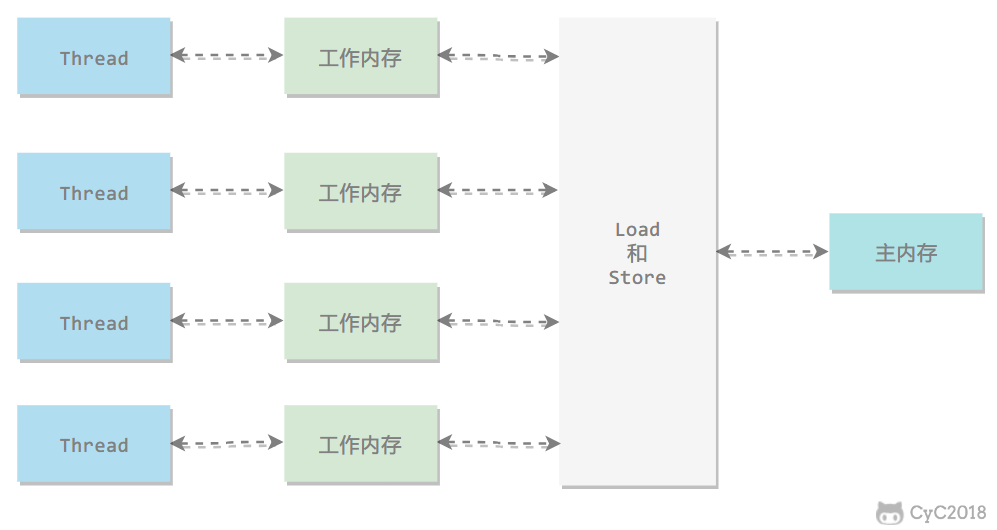
内存间交互操作
Java 内存模型定义了 8 个操作来完成主内存和工作内存的交互操作。
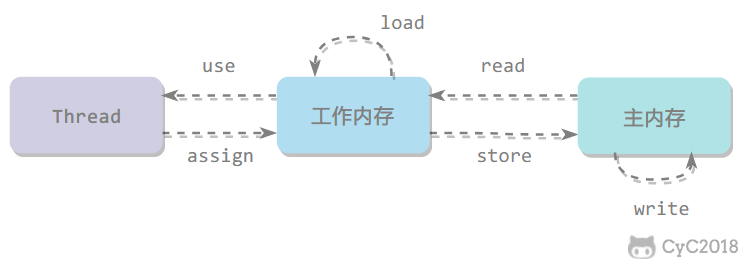
- read:把一个变量的值从主内存传输到工作内存中
- load:在 read 之后执行,把 read 得到的值放入工作内存的变量副本中
- use:把工作内存中一个变量的值传递给执行引擎
- assign:把一个从执行引擎接收到的值赋给工作内存的变量
- store:把工作内存的一个变量的值传送到主内存中
- write:在 store 之后执行,把 store 得到的值放入主内存的变量中
- lock:作用于主内存的变量
- unlock
内存模型三大特性
1. 原子性
Java 内存模型保证了 read、load、use、assign、store、write、lock 和 unlock 操作具有原子性,例如对一个 int 类型的变量执行 assign 赋值操作,这个操作就是原子性的。但是 Java 内存模型允许虚拟机将没有被 volatile 修饰的 64 位数据(long,double)的读写操作划分为两次 32 位的操作来进行,即 load、store、read 和 write 操作可以不具备原子性。
有一个错误认识就是,int 等原子性的类型在多线程环境中不会出现线程安全问题。前面的线程不安全示例代码中,cnt 属于 int 类型变量,1000 个线程对它进行自增操作之后,得到的值为 997 而不是 1000。
为了方便讨论,将内存间的交互操作简化为 3 个:load、assign、store。
下图演示了两个线程同时对 cnt 进行操作,load、assign、store 这一系列操作整体上看不具备原子性,那么在 T1 修改 cnt 并且还没有将修改后的值写入主内存,T2 依然可以读入旧值。可以看出,这两个线程虽然执行了两次自增运算,但是主内存中 cnt 的值最后为 1 而不是 2。因此对 int 类型读写操作满足原子性只是说明 load、assign、store 这些单个操作具备原子性。
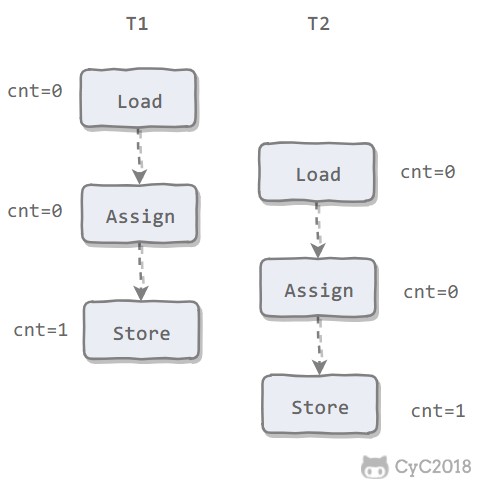
AtomicInteger 能保证多个线程修改的原子性。
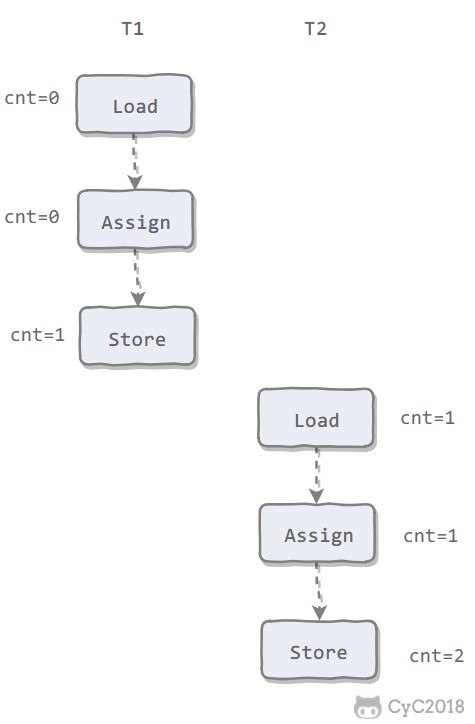
使用 AtomicInteger 重写之前线程不安全的代码之后得到以下线程安全实现:
public class AtomicExample {
private AtomicInteger cnt = new AtomicInteger();
public void add() {
cnt.incrementAndGet();
}
public int get() {
return cnt.get();
}
}public static void main(String[] args) throws InterruptedException {
final int threadSize = 1000;
AtomicExample example = new AtomicExample(); // 只修改这条语句
final CountDownLatch countDownLatch = new CountDownLatch(threadSize);
ExecutorService executorService = Executors.newCachedThreadPool();
for (int i = 0; i < threadSize; i++) {
executorService.execute(() -> {
example.add();
countDownLatch.countDown();
});
}
countDownLatch.await();
executorService.shutdown();
System.out.println(example.get());
}1000除了使用原子类之外,也可以使用 synchronized 互斥锁来保证操作的原子性。它对应的内存间交互操作为:lock 和 unlock,在虚拟机实现上对应的字节码指令为 monitorenter 和 monitorexit。
public class AtomicSynchronizedExample {
private int cnt = 0;
public synchronized void add() {
cnt++;
}
public synchronized int get() {
return cnt;
}
}public static void main(String[] args) throws InterruptedException {
final int threadSize = 1000;
AtomicSynchronizedExample example = new AtomicSynchronizedExample();
final CountDownLatch countDownLatch = new CountDownLatch(threadSize);
ExecutorService executorService = Executors.newCachedThreadPool();
for (int i = 0; i < threadSize; i++) {
executorService.execute(() -> {
example.add();
countDownLatch.countDown();
});
}
countDownLatch.await();
executorService.shutdown();
System.out.println(example.get());
}10002. 可见性
可见性指当一个线程修改了共享变量的值,其它线程能够立即得知这个修改。Java 内存模型是通过在变量修改后将新值同步回主内存,在变量读取前从主内存刷新变量值来实现可见性的。
主要有三种实现可见性的方式:
- volatile
- synchronized,对一个变量执行 unlock 操作之前,必须把变量值同步回主内存。
- final,被 final 关键字修饰的字段在构造器中一旦初始化完成,并且没有发生 this 逃逸(其它线程通过 this 引用访问到初始化了一半的对象),那么其它线程就能看见 final 字段的值。
对前面的线程不安全示例中的 cnt 变量使用 volatile 修饰,不能解决线程不安全问题,因为 volatile 并不能保证操作的原子性。
3. 有序性
有序性是指:在本线程内观察,所有操作都是有序的。在一个线程观察另一个线程,所有操作都是无序的,无序是因为发生了指令重排序。在 Java 内存模型中,允许编译器和处理器对指令进行重排序,重排序过程不会影响到单线程程序的执行,却会影响到多线程并发执行的正确性。
volatile 关键字通过添加内存屏障的方式来禁止指令重排,即重排序时不能把后面的指令放到内存屏障之前。
也可以通过 synchronized 来保证有序性,它保证每个时刻只有一个线程执行同步代码,相当于是让线程顺序执行同步代码。
先行发生原则
上面提到了可以用 volatile 和 synchronized 来保证有序性。除此之外,JVM 还规定了先行发生原则,让一个操作无需控制就能先于另一个操作完成。
1. 单一线程原则
Single Thread rule
在一个线程内,在程序前面的操作先行发生于后面的操作。
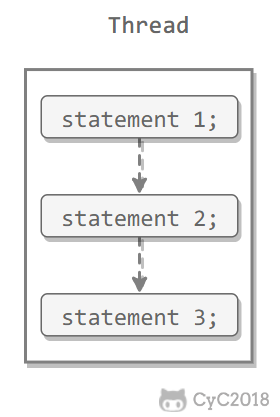
2. 管程锁定规则
Monitor Lock Rule
一个 unlock 操作先行发生于后面对同一个锁的 lock 操作。
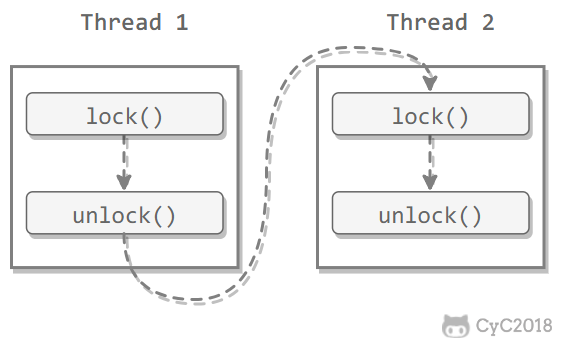
3. volatile 变量规则
Volatile Variable Rule
对一个 volatile 变量的写操作先行发生于后面对这个变量的读操作。
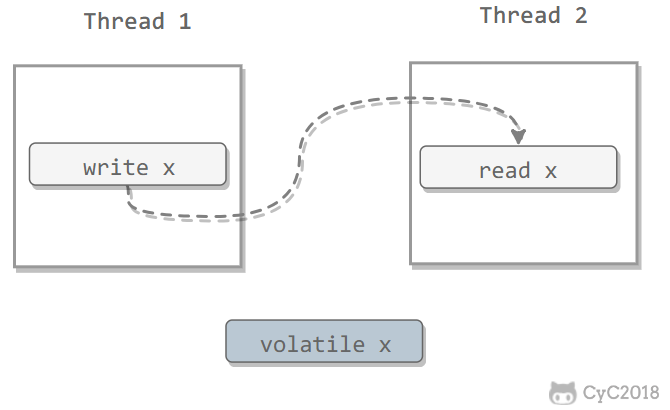
4. 线程启动规则
Thread Start Rule
Thread 对象的 start() 方法调用先行发生于此线程的每一个动作。
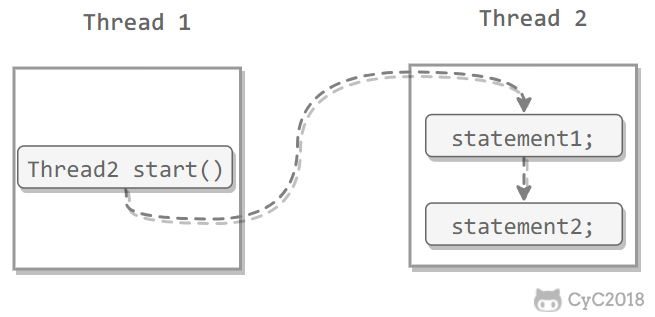
5. 线程加入规则
Thread Join Rule
Thread 对象的结束先行发生于 join() 方法返回。
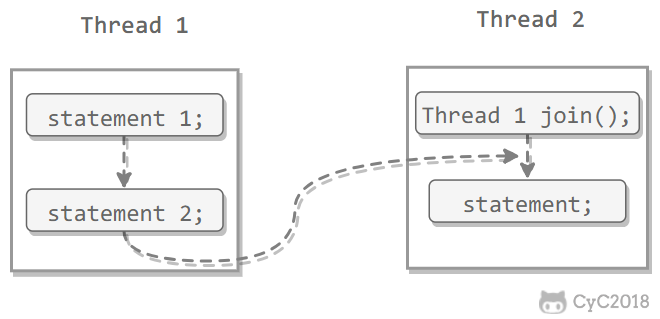
6. 线程中断规则
Thread Interruption Rule
对线程 interrupt() 方法的调用先行发生于被中断线程的代码检测到中断事件的发生,可以通过 interrupted() 方法检测到是否有中断发生。
7. 对象终结规则
Finalizer Rule
一个对象的初始化完成(构造函数执行结束)先行发生于它的 finalize() 方法的开始。
8. 传递性
Transitivity
如果操作 A 先行发生于操作 B,操作 B 先行发生于操作 C,那么操作 A 先行发生于操作 C。
十一、线程安全
多个线程不管以何种方式访问某个类,并且在主调代码中不需要进行同步,都能表现正确的行为。
线程安全有以下几种实现方式:
不可变
不可变(Immutable)的对象一定是线程安全的,不需要再采取任何的线程安全保障措施。只要一个不可变的对象被正确地构建出来,永远也不会看到它在多个线程之中处于不一致的状态。多线程环境下,应当尽量使对象成为不可变,来满足线程安全。
不可变的类型:
- final 关键字修饰的基本数据类型
- String
- 枚举类型
- Number 部分子类,如 Long 和 Double 等数值包装类型,BigInteger 和 BigDecimal 等大数据类型。但同为 Number 的原子类 AtomicInteger 和 AtomicLong 则是可变的。
对于集合类型,可以使用 Collections.unmodifiableXXX() 方法来获取一个不可变的集合。
public class ImmutableExample {
public static void main(String[] args) {
Map<String, Integer> map = new HashMap<>();
Map<String, Integer> unmodifiableMap = Collections.unmodifiableMap(map);
unmodifiableMap.put("a", 1);
}
}Exception in thread "main" java.lang.UnsupportedOperationException
at java.util.Collections$UnmodifiableMap.put(Collections.java:1457)
at ImmutableExample.main(ImmutableExample.java:9)Collections.unmodifiableXXX() 先对原始的集合进行拷贝,需要对集合进行修改的方法都直接抛出异常。
public V put(K key, V value) {
throw new UnsupportedOperationException();
}互斥同步
synchronized 和 ReentrantLock。
非阻塞同步
互斥同步最主要的问题就是线程阻塞和唤醒所带来的性能问题,因此这种同步也称为阻塞同步。
互斥同步属于一种悲观的并发策略,总是认为只要不去做正确的同步措施,那就肯定会出现问题。无论共享数据是否真的会出现竞争,它都要进行加锁(这里讨论的是概念模型,实际上虚拟机会优化掉很大一部分不必要的加锁)、用户态核心态转换、维护锁计数器和检查是否有被阻塞的线程需要唤醒等操作。
随着硬件指令集的发展,我们可以使用基于冲突检测的乐观并发策略:先进行操作,如果没有其它线程争用共享数据,那操作就成功了,否则采取补偿措施(不断地重试,直到成功为止)。这种乐观的并发策略的许多实现都不需要将线程阻塞,因此这种同步操作称为非阻塞同步。
1. CAS
乐观锁需要操作和冲突检测这两个步骤具备原子性,这里就不能再使用互斥同步来保证了,只能靠硬件来完成。硬件支持的原子性操作最典型的是:比较并交换(Compare-and-Swap,CAS)。CAS 指令需要有 3 个操作数,分别是内存地址 V、旧的预期值 A 和新值 B。当执行操作时,只有当 V 的值等于 A,才将 V 的值更新为 B。
2. AtomicInteger
J.U.C 包里面的整数原子类 AtomicInteger 的方法调用了 Unsafe 类的 CAS 操作。
以下代码使用了 AtomicInteger 执行了自增的操作。
private AtomicInteger cnt = new AtomicInteger();
public void add() {
cnt.incrementAndGet();
}以下代码是 incrementAndGet() 的源码,它调用了 Unsafe 的 getAndAddInt() 。
public final int incrementAndGet() {
return unsafe.getAndAddInt(this, valueOffset, 1) + 1;
}以下代码是 getAndAddInt() 源码,var1 指示对象内存地址,var2 指示该字段相对对象内存地址的偏移,var4 指示操作需要加的数值,这里为 1。通过 getIntVolatile(var1, var2) 得到旧的预期值,通过调用 compareAndSwapInt() 来进行 CAS 比较,如果该字段内存地址中的值等于 var5,那么就更新内存地址为 var1+var2 的变量为 var5+var4。
可以看到 getAndAddInt() 在一个循环中进行,发生冲突的做法是不断的进行重试。
public final int getAndAddInt(Object var1, long var2, int var4) {
int var5;
do {
var5 = this.getIntVolatile(var1, var2);
} while(!this.compareAndSwapInt(var1, var2, var5, var5 + var4));
return var5;
}3. ABA
如果一个变量初次读取的时候是 A 值,它的值被改成了 B,后来又被改回为 A,那 CAS 操作就会误认为它从来没有被改变过。
J.U.C 包提供了一个带有标记的原子引用类 AtomicStampedReference 来解决这个问题,它可以通过控制变量值的版本来保证 CAS 的正确性。大部分情况下 ABA 问题不会影响程序并发的正确性,如果需要解决 ABA 问题,改用传统的互斥同步可能会比原子类更高效。
无同步方案
要保证线程安全,并不是一定就要进行同步。如果一个方法本来就不涉及共享数据,那它自然就无须任何同步措施去保证正确性。
1. 栈封闭
多个线程访问同一个方法的局部变量时,不会出现线程安全问题,因为局部变量存储在虚拟机栈中,属于线程私有的。
public class StackClosedExample {
public void add100() {
int cnt = 0;
for (int i = 0; i < 100; i++) {
cnt++;
}
System.out.println(cnt);
}
}public static void main(String[] args) {
StackClosedExample example = new StackClosedExample();
ExecutorService executorService = Executors.newCachedThreadPool();
executorService.execute(() -> example.add100());
executorService.execute(() -> example.add100());
executorService.shutdown();
}100
1002. 线程本地存储(Thread Local Storage)
如果一段代码中所需要的数据必须与其他代码共享,那就看看这些共享数据的代码是否能保证在同一个线程中执行。如果能保证,我们就可以把共享数据的可见范围限制在同一个线程之内,这样,无须同步也能保证线程之间不出现数据争用的问题。
符合这种特点的应用并不少见,大部分使用消费队列的架构模式(如“生产者-消费者”模式)都会将产品的消费过程尽量在一个线程中消费完。其中最重要的一个应用实例就是经典 Web 交互模型中的“一个请求对应一个服务器线程”(Thread-per-Request)的处理方式,这种处理方式的广泛应用使得很多 Web 服务端应用都可以使用线程本地存储来解决线程安全问题。
可以使用 java.lang.ThreadLocal 类来实现线程本地存储功能。
对于以下代码,thread1 中设置 threadLocal 为 1,而 thread2 设置 threadLocal 为 2。过了一段时间之后,thread1 读取 threadLocal 依然是 1,不受 thread2 的影响。
public class ThreadLocalExample {
public static void main(String[] args) {
ThreadLocal threadLocal = new ThreadLocal();
Thread thread1 = new Thread(() -> {
threadLocal.set(1);
try {
Thread.sleep(1000);
} catch (InterruptedException e) {
e.printStackTrace();
}
System.out.println(threadLocal.get());
threadLocal.remove();
});
Thread thread2 = new Thread(() -> {
threadLocal.set(2);
threadLocal.remove();
});
thread1.start();
thread2.start();
}
}1为了理解 ThreadLocal,先看以下代码:
public class ThreadLocalExample1 {
public static void main(String[] args) {
ThreadLocal threadLocal1 = new ThreadLocal();
ThreadLocal threadLocal2 = new ThreadLocal();
Thread thread1 = new Thread(() -> {
threadLocal1.set(1);
threadLocal2.set(1);
});
Thread thread2 = new Thread(() -> {
threadLocal1.set(2);
threadLocal2.set(2);
});
thread1.start();
thread2.start();
}
}它所对应的底层结构图为:
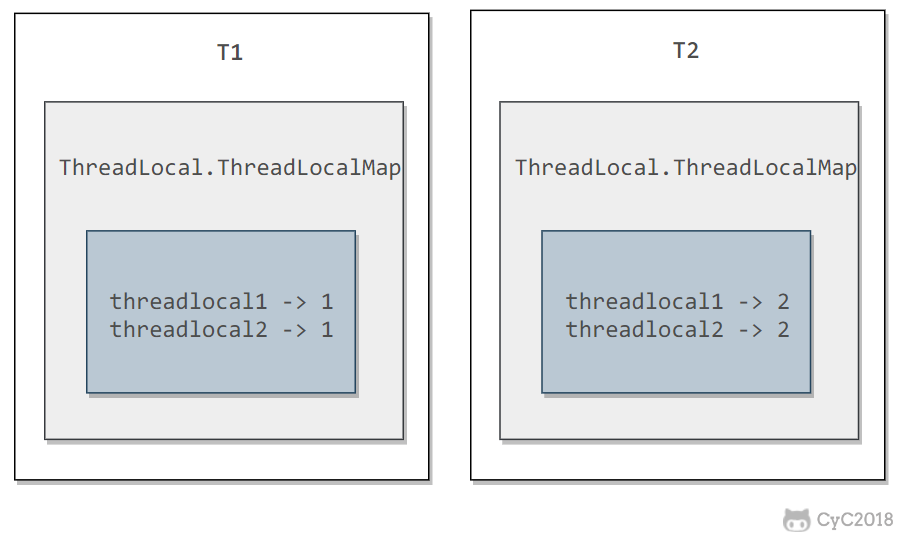
每个 Thread 都有一个 ThreadLocal.ThreadLocalMap 对象。
/* ThreadLocal values pertaining to this thread. This map is maintained
* by the ThreadLocal class. */
ThreadLocal.ThreadLocalMap threadLocals = null;当调用一个 ThreadLocal 的 set(T value) 方法时,先得到当前线程的 ThreadLocalMap 对象,然后将 ThreadLocal-\>value 键值对插入到该 Map 中。
public void set(T value) {
Thread t = Thread.currentThread();
ThreadLocalMap map = getMap(t);
if (map != null)
map.set(this, value);
else
createMap(t, value);
}get() 方法类似。
public T get() {
Thread t = Thread.currentThread();
ThreadLocalMap map = getMap(t);
if (map != null) {
ThreadLocalMap.Entry e = map.getEntry(this);
if (e != null) {
@SuppressWarnings("unchecked")
T result = (T)e.value;
return result;
}
}
return setInitialValue();
}ThreadLocal 从理论上讲并不是用来解决多线程并发问题的,因为根本不存在多线程竞争。
在一些场景 (尤其是使用线程池) 下,由于 ThreadLocal.ThreadLocalMap 的底层数据结构导致 ThreadLocal 有内存泄漏的情况,应该尽可能在每次使用 ThreadLocal 后手动调用 remove(),以避免出现 ThreadLocal 经典的内存泄漏甚至是造成自身业务混乱的风险。
3. 可重入代码(Reentrant Code)
这种代码也叫做纯代码(Pure Code),可以在代码执行的任何时刻中断它,转而去执行另外一段代码(包括递归调用它本身),而在控制权返回后,原来的程序不会出现任何错误。
可重入代码有一些共同的特征,例如不依赖存储在堆上的数据和公用的系统资源、用到的状态量都由参数中传入、不调用非可重入的方法等。
十二、锁优化
这里的锁优化主要是指 JVM 对 synchronized 的优化。
自旋锁
互斥同步进入阻塞状态的开销都很大,应该尽量避免。在许多应用中,共享数据的锁定状态只会持续很短的一段时间。自旋锁的思想是让一个线程在请求一个共享数据的锁时执行忙循环(自旋)一段时间,如果在这段时间内能获得锁,就可以避免进入阻塞状态。
自旋锁虽然能避免进入阻塞状态从而减少开销,但是它需要进行忙循环操作占用 CPU 时间,它只适用于共享数据的锁定状态很短的场景。
在 JDK 1.6 中引入了自适应的自旋锁。自适应意味着自旋的次数不再固定了,而是由前一次在同一个锁上的自旋次数及锁的拥有者的状态来决定。
锁消除
锁消除是指对于被检测出不可能存在竞争的共享数据的锁进行消除。
锁消除主要是通过逃逸分析来支持,如果堆上的共享数据不可能逃逸出去被其它线程访问到,那么就可以把它们当成私有数据对待,也就可以将它们的锁进行消除。
对于一些看起来没有加锁的代码,其实隐式的加了很多锁。例如下面的字符串拼接代码就隐式加了锁:
public static String concatString(String s1, String s2, String s3) {
return s1 + s2 + s3;
}String 是一个不可变的类,编译器会对 String 的拼接自动优化。在 JDK 1.5 之前,会转化为 StringBuffer 对象的连续 append() 操作:
public static String concatString(String s1, String s2, String s3) {
StringBuffer sb = new StringBuffer();
sb.append(s1);
sb.append(s2);
sb.append(s3);
return sb.toString();
}每个 append() 方法中都有一个同步块。虚拟机观察变量 sb,很快就会发现它的动态作用域被限制在 concatString() 方法内部。也就是说,sb 的所有引用永远不会逃逸到 concatString() 方法之外,其他线程无法访问到它,因此可以进行消除。
锁粗化
如果一系列的连续操作都对同一个对象反复加锁和解锁,频繁的加锁操作就会导致性能损耗。
上一节的示例代码中连续的 append() 方法就属于这类情况。如果虚拟机探测到由这样的一串零碎的操作都对同一个对象加锁,将会把加锁的范围扩展(粗化)到整个操作序列的外部。对于上一节的示例代码就是扩展到第一个 append() 操作之前直至最后一个 append() 操作之后,这样只需要加锁一次就可以了。
轻量级锁
JDK 1.6 引入了偏向锁和轻量级锁,从而让锁拥有了四个状态:无锁状态(unlocked)、偏向锁状态(biasble)、轻量级锁状态(lightweight locked)和重量级锁状态(inflated)。
以下是 HotSpot 虚拟机对象头的内存布局,这些数据被称为 Mark Word。其中 tag bits 对应了五个状态,这些状态在右侧的 state 表格中给出。除了 marked for gc 状态,其它四个状态已经在前面介绍过了。
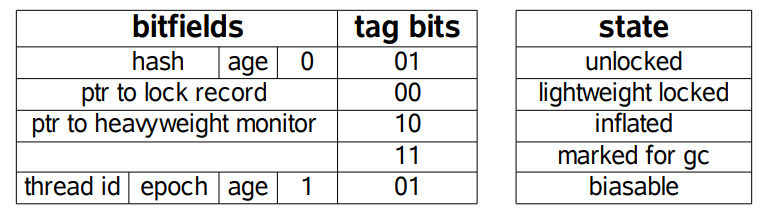
下图左侧是一个线程的虚拟机栈,其中有一部分称为 Lock Record 的区域,这是在轻量级锁运行过程创建的,用于存放锁对象的 Mark Word。而右侧就是一个锁对象,包含了 Mark Word 和其它信息。
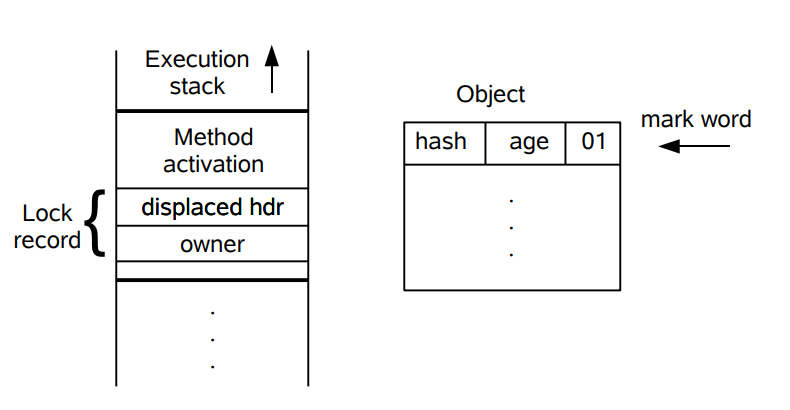
轻量级锁是相对于传统的重量级锁而言,它使用 CAS 操作来避免重量级锁使用互斥量的开销。对于绝大部分的锁,在整个同步周期内都是不存在竞争的,因此也就不需要都使用互斥量进行同步,可以先采用 CAS 操作进行同步,如果 CAS 失败了再改用互斥量进行同步。
当尝试获取一个锁对象时,如果锁对象标记为 0 01,说明锁对象的锁未锁定(unlocked)状态。此时虚拟机在当前线程的虚拟机栈中创建 Lock Record,然后使用 CAS 操作将对象的 Mark Word 更新为 Lock Record 指针。如果 CAS 操作成功了,那么线程就获取了该对象上的锁,并且对象的 Mark Word 的锁标记变为 00,表示该对象处于轻量级锁状态。
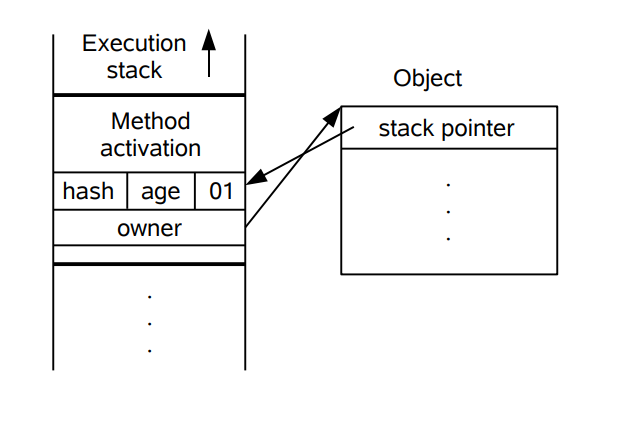
如果 CAS 操作失败了,虚拟机首先会检查对象的 Mark Word 是否指向当前线程的虚拟机栈,如果是的话说明当前线程已经拥有了这个锁对象,那就可以直接进入同步块继续执行,否则说明这个锁对象已经被其他线程线程抢占了。如果有两条以上的线程争用同一个锁,那轻量级锁就不再有效,要膨胀为重量级锁。
偏向锁
偏向锁的思想是偏向于让第一个获取锁对象的线程,这个线程在之后获取该锁就不再需要进行同步操作,甚至连 CAS 操作也不再需要。
当锁对象第一次被线程获得的时候,进入偏向状态,标记为 1 01。同时使用 CAS 操作将线程 ID 记录到 Mark Word 中,如果 CAS 操作成功,这个线程以后每次进入这个锁相关的同步块就不需要再进行任何同步操作。
当有另外一个线程去尝试获取这个锁对象时,偏向状态就宣告结束,此时撤销偏向(Revoke Bias)后恢复到未锁定状态或者轻量级锁状态。
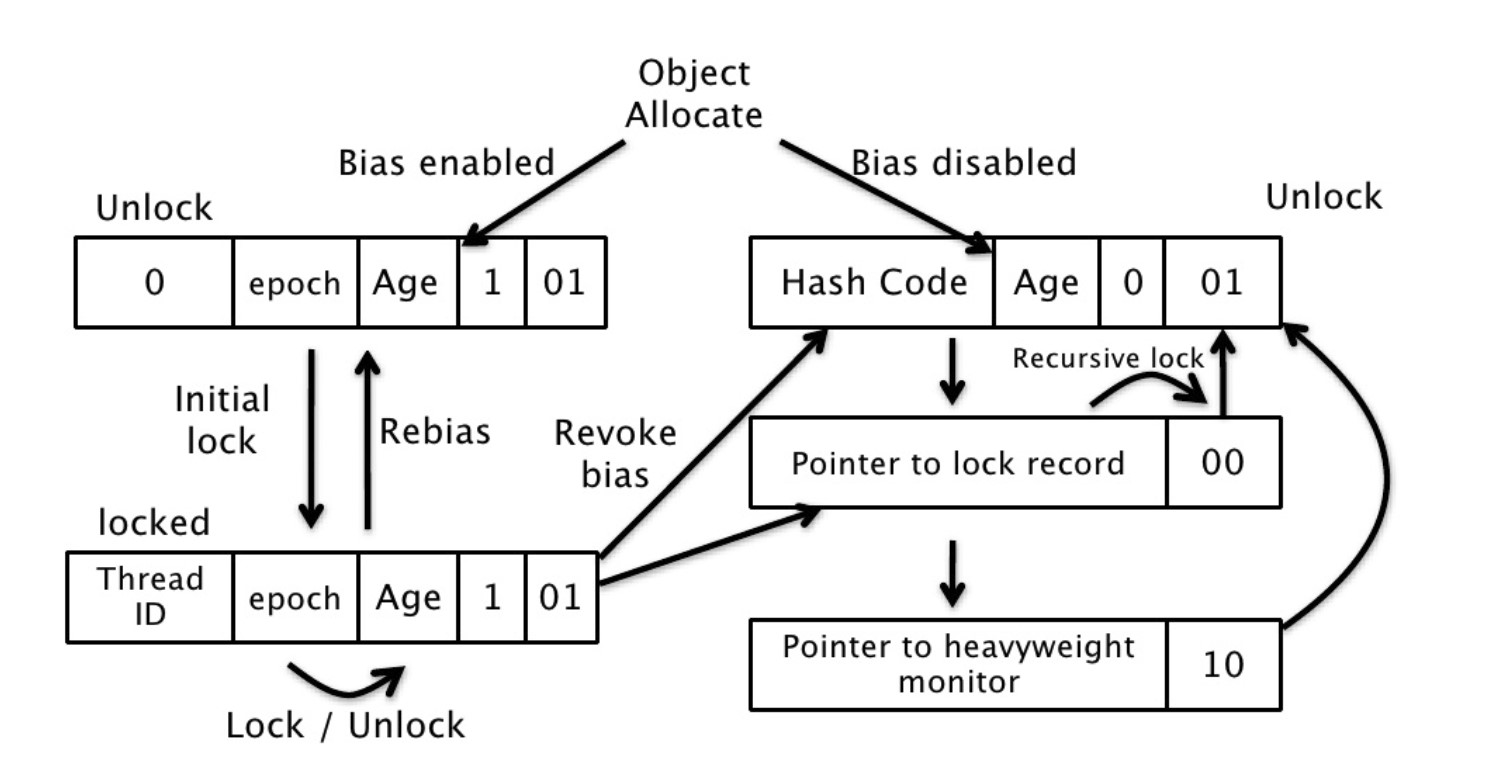
十三、多线程开发良好的实践
- 给线程起个有意义的名字,这样可以方便找 Bug。
- 缩小同步范围,从而减少锁争用。例如对于 synchronized,应该尽量使用同步块而不是同步方法。
- 多用同步工具少用 wait() 和 notify()。首先,CountDownLatch, CyclicBarrier, Semaphore 和 Exchanger 这些同步类简化了编码操作,而用 wait() 和 notify() 很难实现复杂控制流;其次,这些同步类是由最好的企业编写和维护,在后续的 JDK 中还会不断优化和完善。
- 使用 BlockingQueue 实现生产者消费者问题。
- 多用并发集合少用同步集合,例如应该使用 ConcurrentHashMap 而不是 Hashtable。
- 使用本地变量和不可变类来保证线程安全。
- 使用线程池而不是直接创建线程,这是因为创建线程代价很高,线程池可以有效地利用有限的线程来启动任务。
参考资料
- BruceEckel. Java 编程思想: 第 4 版 [M]. 机械工业出版社, 2007.
- 周志明. 深入理解 Java 虚拟机 [M]. 机械工业出版社, 2011.
- Threads and Locks
- 线程通信
- Java 线程面试题 Top 50
- BlockingQueue
- thread state java
- CSC 456 Spring 2012/ch7 MN
- Java - Understanding Happens-before relationship
- 6장 Thread Synchronization
- How is Java's ThreadLocal implemented under the hood?
- Concurrent
- JAVA FORK JOIN EXAMPLE
- 聊聊并发(八)——Fork/Join 框架介绍
- Eliminating SynchronizationRelated Atomic Operations with Biased Locking and Bulk Rebiasing
Java 虚拟机
Java 虚拟机
* [一、运行时数据区域](#一运行时数据区域)
* [程序计数器](#程序计数器)
* [Java 虚拟机栈](#java-虚拟机栈)
* [本地方法栈](#本地方法栈)
* [堆](#堆)
* [方法区](#方法区)
* [运行时常量池](#运行时常量池)
* [直接内存](#直接内存)
* [二、垃圾收集](#二垃圾收集)
* [判断一个对象是否可被回收](#判断一个对象是否可被回收)
* [引用类型](#引用类型)
* [垃圾收集算法](#垃圾收集算法)
* [垃圾收集器](#垃圾收集器)
* [三、内存分配与回收策略](#三内存分配与回收策略)
* [Minor GC 和 Full GC](#minor-gc-和-full-gc)
* [内存分配策略](#内存分配策略)
* [Full GC 的触发条件](#full-gc-的触发条件)
* [四、类加载机制](#四类加载机制)
* [类的生命周期](#类的生命周期)
* [类加载过程](#类加载过程)
* [类初始化时机](#类初始化时机)
* [类与类加载器](#类与类加载器)
* [类加载器分类](#类加载器分类)
* [双亲委派模型](#双亲委派模型)
* [自定义类加载器实现](#自定义类加载器实现)
* [参考资料](#参考资料)本文大部分内容参考 周志明《深入理解 Java 虚拟机》 ,想要深入学习的话请看原书。
一、运行时数据区域
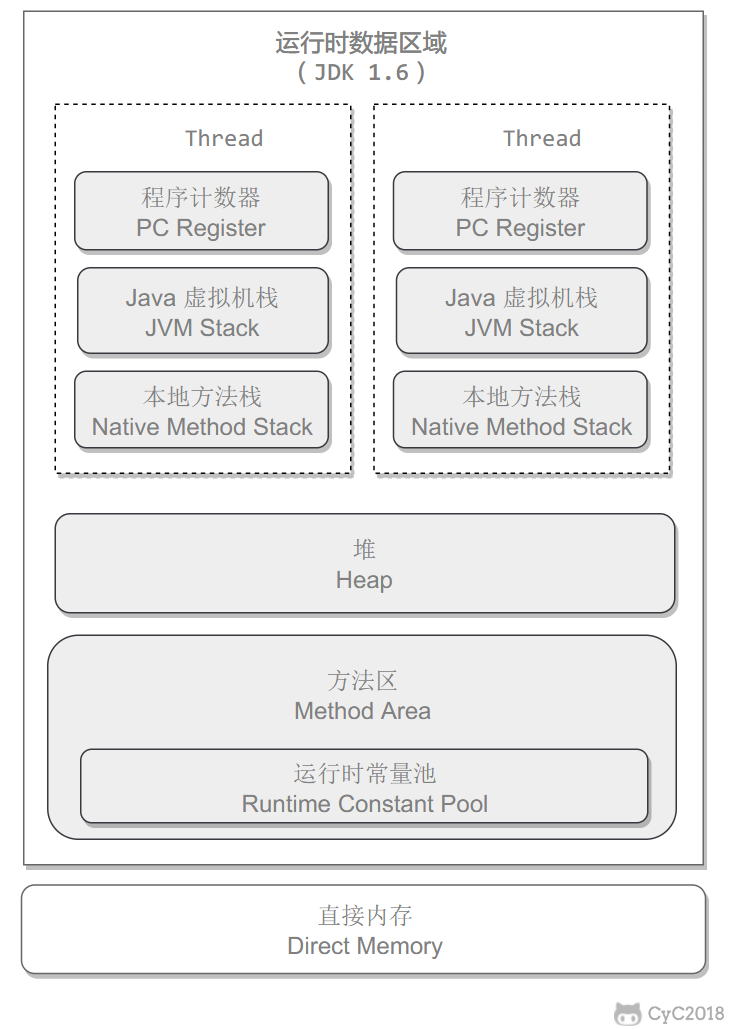
程序计数器
记录正在执行的虚拟机字节码指令的地址(如果正在执行的是本地方法则为空)。
Java 虚拟机栈
每个 Java 方法在执行的同时会创建一个栈帧用于存储局部变量表、操作数栈、常量池引用等信息。从方法调用直至执行完成的过程,对应着一个栈帧在 Java 虚拟机栈中入栈和出栈的过程。
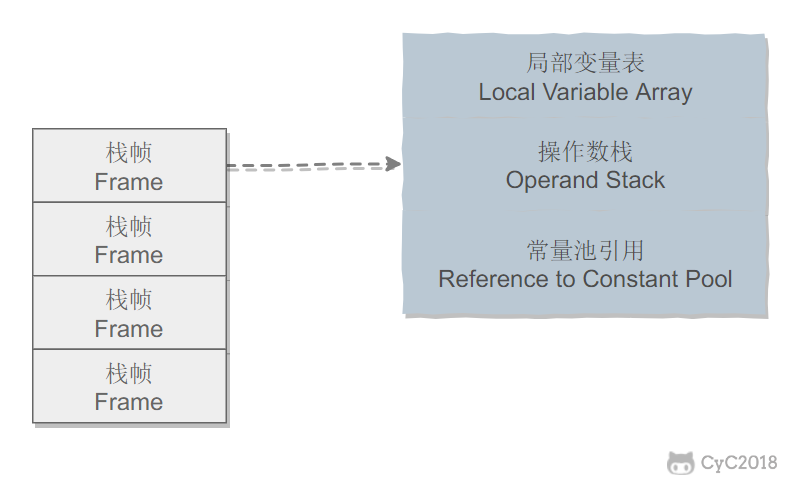
可以通过 -Xss 这个虚拟机参数来指定每个线程的 Java 虚拟机栈内存大小,在 JDK 1.4 中默认为 256K,而在 JDK 1.5+ 默认为 1M:
java -Xss2M HackTheJava该区域可能抛出以下异常:
- 当线程请求的栈深度超过最大值,会抛出 StackOverflowError 异常;
- 栈进行动态扩展时如果无法申请到足够内存,会抛出 OutOfMemoryError 异常。
本地方法栈
本地方法栈与 Java 虚拟机栈类似,它们之间的区别只不过是本地方法栈为本地方法服务。
本地方法一般是用其它语言(C、C++ 或汇编语言等)编写的,并且被编译为基于本机硬件和操作系统的程序,对待这些方法需要特别处理。
堆
所有对象都在这里分配内存,是垃圾收集的主要区域("GC 堆")。
现代的垃圾收集器基本都是采用分代收集算法,其主要的思想是针对不同类型的对象采取不同的垃圾回收算法。可以将堆分成两块:
- 新生代(Young Generation)
- 老年代(Old Generation)
堆不需要连续内存,并且可以动态增加其内存,增加失败会抛出 OutOfMemoryError 异常。
可以通过 -Xms 和 -Xmx 这两个虚拟机参数来指定一个程序的堆内存大小,第一个参数设置初始值,第二个参数设置最大值。
java -Xms1M -Xmx2M HackTheJava方法区
用于存放已被加载的类信息、常量、静态变量、即时编译器编译后的代码等数据。
和堆一样不需要连续的内存,并且可以动态扩展,动态扩展失败一样会抛出 OutOfMemoryError 异常。
对这块区域进行垃圾回收的主要目标是对常量池的回收和对类的卸载,但是一般比较难实现。
HotSpot 虚拟机把它当成永久代来进行垃圾回收。但很难确定永久代的大小,因为它受到很多因素影响,并且每次 Full GC 之后永久代的大小都会改变,所以经常会抛出 OutOfMemoryError 异常。为了更容易管理方法区,从 JDK 1.8 开始,移除永久代,并把方法区移至元空间,它位于本地内存中,而不是虚拟机内存中。
方法区是一个 JVM 规范,永久代与元空间都是其一种实现方式。在 JDK 1.8 之后,原来永久代的数据被分到了堆和元空间中。元空间存储类的元信息,静态变量和常量池等放入堆中。
运行时常量池
运行时常量池是方法区的一部分。
Class 文件中的常量池(编译器生成的字面量和符号引用)会在类加载后被放入这个区域。
除了在编译期生成的常量,还允许动态生成,例如 String 类的 intern()。
直接内存
在 JDK 1.4 中新引入了 NIO 类,它可以使用 Native 函数库直接分配堆外内存,然后通过 Java 堆里的 DirectByteBuffer 对象作为这块内存的引用进行操作。这样能在一些场景中显著提高性能,因为避免了在堆内存和堆外内存来回拷贝数据。
二、垃圾收集
垃圾收集主要是针对堆和方法区进行。程序计数器、虚拟机栈和本地方法栈这三个区域属于线程私有的,只存在于线程的生命周期内,线程结束之后就会消失,因此不需要对这三个区域进行垃圾回收。
判断一个对象是否可被回收
1. 引用计数算法
为对象添加一个引用计数器,当对象增加一个引用时计数器加 1,引用失效时计数器减 1。引用计数为 0 的对象可被回收。
在两个对象出现循环引用的情况下,此时引用计数器永远不为 0,导致无法对它们进行回收。正是因为循环引用的存在,因此 Java 虚拟机不使用引用计数算法。
public class Test {
public Object instance = null;
public static void main(String[] args) {
Test a = new Test();
Test b = new Test();
a.instance = b;
b.instance = a;
a = null;
b = null;
doSomething();
}
}在上述代码中,a 与 b 引用的对象实例互相持有了对象的引用,因此当我们把对 a 对象与 b 对象的引用去除之后,由于两个对象还存在互相之间的引用,导致两个 Test 对象无法被回收。
2. 可达性分析算法
以 GC Roots 为起始点进行搜索,可达的对象都是存活的,不可达的对象可被回收。
Java 虚拟机使用该算法来判断对象是否可被回收,GC Roots 一般包含以下内容:
- 虚拟机栈中局部变量表中引用的对象
- 本地方法栈中 JNI 中引用的对象
- 方法区中类静态属性引用的对象
- 方法区中的常量引用的对象
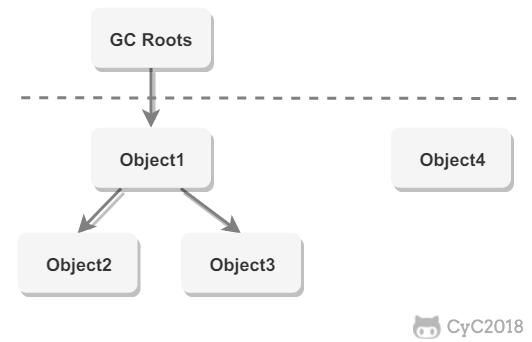
3. 方法区的回收
因为方法区主要存放永久代对象,而永久代对象的回收率比新生代低很多,所以在方法区上进行回收性价比不高。
主要是对常量池的回收和对类的卸载。
为了避免内存溢出,在大量使用反射和动态代理的场景都需要虚拟机具备类卸载功能。
类的卸载条件很多,需要满足以下三个条件,并且满足了条件也不一定会被卸载:
- 该类所有的实例都已经被回收,此时堆中不存在该类的任何实例。
- 加载该类的 ClassLoader 已经被回收。
- 该类对应的 Class 对象没有在任何地方被引用,也就无法在任何地方通过反射访问该类方法。
4. finalize()
类似 C++ 的析构函数,用于关闭外部资源。但是 try-finally 等方式可以做得更好,并且该方法运行代价很高,不确定性大,无法保证各个对象的调用顺序,因此最好不要使用。
当一个对象可被回收时,如果需要执行该对象的 finalize() 方法,那么就有可能在该方法中让对象重新被引用,从而实现自救。自救只能进行一次,如果回收的对象之前调用了 finalize() 方法自救,后面回收时不会再调用该方法。
引用类型
无论是通过引用计数算法判断对象的引用数量,还是通过可达性分析算法判断对象是否可达,判定对象是否可被回收都与引用有关。
Java 提供了四种强度不同的引用类型。
1. 强引用
被强引用关联的对象不会被回收。
使用 new 一个新对象的方式来创建强引用。
Object obj = new Object();2. 软引用
被软引用关联的对象只有在内存不够的情况下才会被回收。
使用 SoftReference 类来创建软引用。
Object obj = new Object();
SoftReference sf = new SoftReference(obj);
obj = null; // 使对象只被软引用关联3. 弱引用
被弱引用关联的对象一定会被回收,也就是说它只能存活到下一次垃圾回收发生之前。
使用 WeakReference 类来创建弱引用。
Object obj = new Object();
WeakReference wf = new WeakReference(obj);
obj = null;4. 虚引用
又称为幽灵引用或者幻影引用,一个对象是否有虚引用的存在,不会对其生存时间造成影响,也无法通过虚引用得到一个对象。
为一个对象设置虚引用的唯一目的是能在这个对象被回收时收到一个系统通知。
使用 PhantomReference 来创建虚引用。
Object obj = new Object();
PhantomReference pf = new PhantomReference(obj, null);
obj = null;垃圾收集算法
1. 标记 - 清除
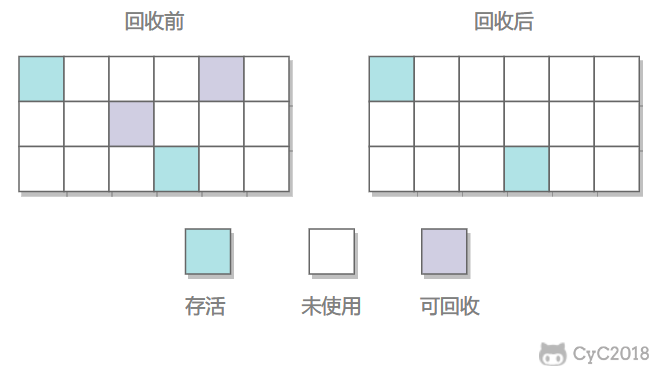
在标记阶段,程序会检查每个对象是否为活动对象,如果是活动对象,则程序会在对象头部打上标记。
在清除阶段,会进行对象回收并取消标志位,另外,还会判断回收后的分块与前一个空闲分块是否连续,若连续,会合并这两个分块。回收对象就是把对象作为分块,连接到被称为 “空闲链表” 的单向链表,之后进行分配时只需要遍历这个空闲链表,就可以找到分块。
在分配时,程序会搜索空闲链表寻找空间大于等于新对象大小 size 的块 block。如果它找到的块等于 size,会直接返回这个分块;如果找到的块大于 size,会将块分割成大小为 size 与 (block - size) 的两部分,返回大小为 size 的分块,并把大小为 (block - size) 的块返回给空闲链表。
不足:
- 标记和清除过程效率都不高;
- 会产生大量不连续的内存碎片,导致无法给大对象分配内存。
2. 标记 - 整理

让所有存活的对象都向一端移动,然后直接清理掉端边界以外的内存。
优点:
- 不会产生内存碎片
不足:
- 需要移动大量对象,处理效率比较低。
3. 复制
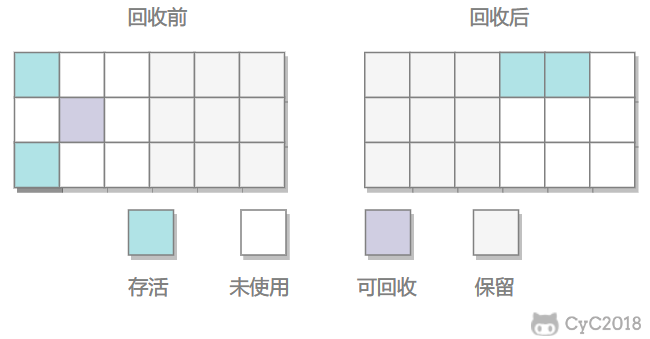
将内存划分为大小相等的两块,每次只使用其中一块,当这一块内存用完了就将还存活的对象复制到另一块上面,然后再把使用过的内存空间进行一次清理。
主要不足是只使用了内存的一半。
现在的商业虚拟机都采用这种收集算法回收新生代,但是并不是划分为大小相等的两块,而是一块较大的 Eden 空间和两块较小的 Survivor 空间,每次使用 Eden 和其中一块 Survivor。在回收时,将 Eden 和 Survivor 中还存活着的对象全部复制到另一块 Survivor 上,最后清理 Eden 和使用过的那一块 Survivor。
HotSpot 虚拟机的 Eden 和 Survivor 大小比例默认为 8:1,保证了内存的利用率达到 90%。如果每次回收有多于 10% 的对象存活,那么一块 Survivor 就不够用了,此时需要依赖于老年代进行空间分配担保,也就是借用老年代的空间存储放不下的对象。
4. 分代收集
现在的商业虚拟机采用分代收集算法,它根据对象存活周期将内存划分为几块,不同块采用适当的收集算法。
一般将堆分为新生代和老年代。
- 新生代使用:复制算法
- 老年代使用:标记 - 清除 或者 标记 - 整理 算法
垃圾收集器
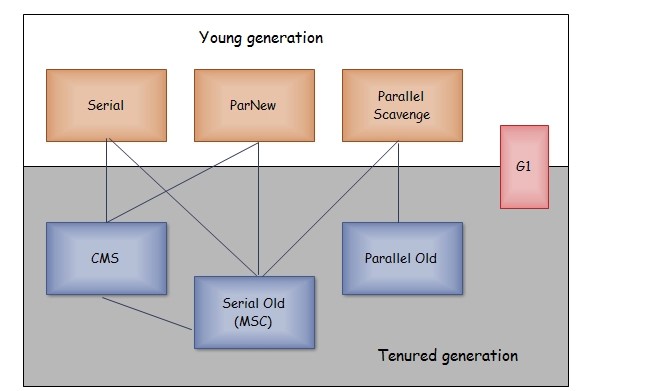
以上是 HotSpot 虚拟机中的 7 个垃圾收集器,连线表示垃圾收集器可以配合使用。
- 单线程与多线程:单线程指的是垃圾收集器只使用一个线程,而多线程使用多个线程;
- 串行与并行:串行指的是垃圾收集器与用户程序交替执行,这意味着在执行垃圾收集的时候需要停顿用户程序;并行指的是垃圾收集器和用户程序同时执行。除了 CMS 和 G1 之外,其它垃圾收集器都是以串行的方式执行。
1. Serial 收集器
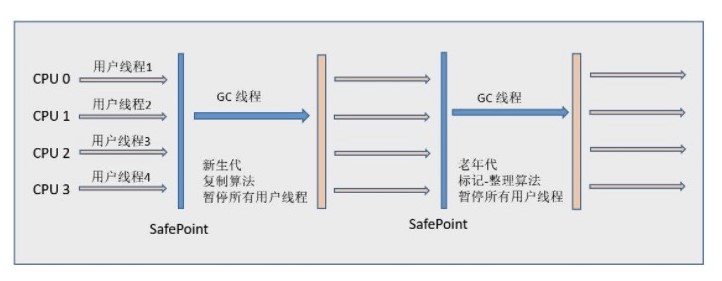
Serial 翻译为串行,也就是说它以串行的方式执行。
它是单线程的收集器,只会使用一个线程进行垃圾收集工作。
它的优点是简单高效,在单个 CPU 环境下,由于没有线程交互的开销,因此拥有最高的单线程收集效率。
它是 Client 场景下的默认新生代收集器,因为在该场景下内存一般来说不会很大。它收集一两百兆垃圾的停顿时间可以控制在一百多毫秒以内,只要不是太频繁,这点停顿时间是可以接受的。
2. ParNew 收集器
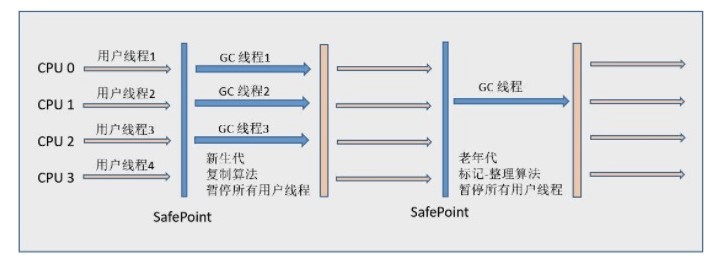
它是 Serial 收集器的多线程版本。
它是 Server 场景下默认的新生代收集器,除了性能原因外,主要是因为除了 Serial 收集器,只有它能与 CMS 收集器配合使用。
3. Parallel Scavenge 收集器
与 ParNew 一样是多线程收集器。
其它收集器目标是尽可能缩短垃圾收集时用户线程的停顿时间,而它的目标是达到一个可控制的吞吐量,因此它被称为“吞吐量优先”收集器。这里的吞吐量指 CPU 用于运行用户程序的时间占总时间的比值。
停顿时间越短就越适合需要与用户交互的程序,良好的响应速度能提升用户体验。而高吞吐量则可以高效率地利用 CPU 时间,尽快完成程序的运算任务,适合在后台运算而不需要太多交互的任务。
缩短停顿时间是以牺牲吞吐量和新生代空间来换取的:新生代空间变小,垃圾回收变得频繁,导致吞吐量下降。
可以通过一个开关参数打开 GC 自适应的调节策略(GC Ergonomics),就不需要手工指定新生代的大小(-Xmn)、Eden 和 Survivor 区的比例、晋升老年代对象年龄等细节参数了。虚拟机会根据当前系统的运行情况收集性能监控信息,动态调整这些参数以提供最合适的停顿时间或者最大的吞吐量。
4. Serial Old 收集器
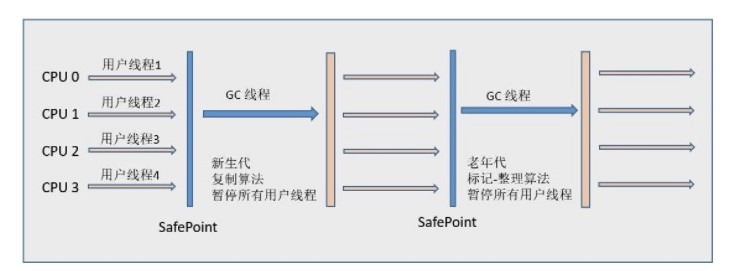
是 Serial 收集器的老年代版本,也是给 Client 场景下的虚拟机使用。如果用在 Server 场景下,它有两大用途:
- 在 JDK 1.5 以及之前版本(Parallel Old 诞生以前)中与 Parallel Scavenge 收集器搭配使用。
- 作为 CMS 收集器的后备预案,在并发收集发生 Concurrent Mode Failure 时使用。
5. Parallel Old 收集器
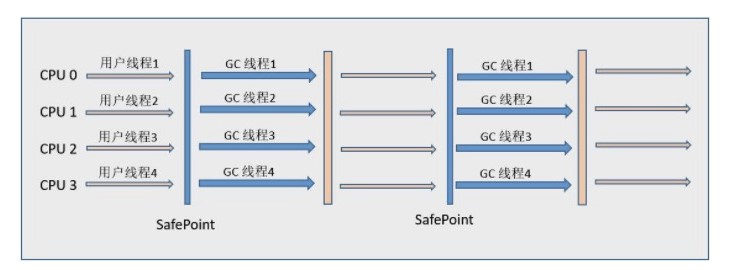
是 Parallel Scavenge 收集器的老年代版本。
在注重吞吐量以及 CPU 资源敏感的场合,都可以优先考虑 Parallel Scavenge 加 Parallel Old 收集器。
6. CMS 收集器
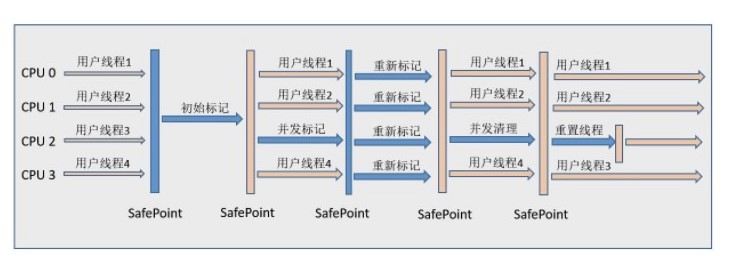
CMS(Concurrent Mark Sweep),Mark Sweep 指的是标记 - 清除算法。
分为以下四个流程:
- 初始标记:仅仅只是标记一下 GC Roots 能直接关联到的对象,速度很快,需要停顿。
- 并发标记:进行 GC Roots Tracing 的过程,它在整个回收过程中耗时最长,不需要停顿。
- 重新标记:为了修正并发标记期间因用户程序继续运作而导致标记产生变动的那一部分对象的标记记录,需要停顿。
- 并发清除:不需要停顿。
在整个过程中耗时最长的并发标记和并发清除过程中,收集器线程都可以与用户线程一起工作,不需要进行停顿。
具有以下缺点:
- 吞吐量低:低停顿时间是以牺牲吞吐量为代价的,导致 CPU 利用率不够高。
- 无法处理浮动垃圾,可能出现 Concurrent Mode Failure。浮动垃圾是指并发清除阶段由于用户线程继续运行而产生的垃圾,这部分垃圾只能到下一次 GC 时才能进行回收。由于浮动垃圾的存在,因此需要预留出一部分内存,意味着 CMS 收集不能像其它收集器那样等待老年代快满的时候再回收。如果预留的内存不够存放浮动垃圾,就会出现 Concurrent Mode Failure,这时虚拟机将临时启用 Serial Old 来替代 CMS。
- 标记 - 清除算法导致的空间碎片,往往出现老年代空间剩余,但无法找到足够大连续空间来分配当前对象,不得不提前触发一次 Full GC。
7. G1 收集器
G1(Garbage-First),它是一款面向服务端应用的垃圾收集器,在多 CPU 和大内存的场景下有很好的性能。HotSpot 开发团队赋予它的使命是未来可以替换掉 CMS 收集器。
堆被分为新生代和老年代,其它收集器进行收集的范围都是整个新生代或者老年代,而 G1 可以直接对新生代和老年代一起回收。
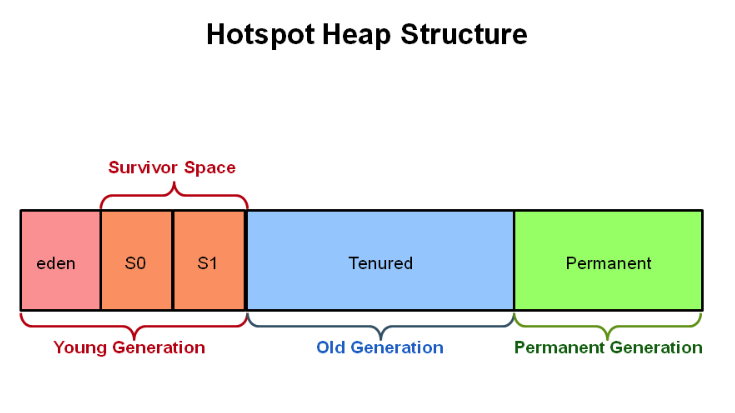
G1 把堆划分成多个大小相等的独立区域(Region),新生代和老年代不再物理隔离。
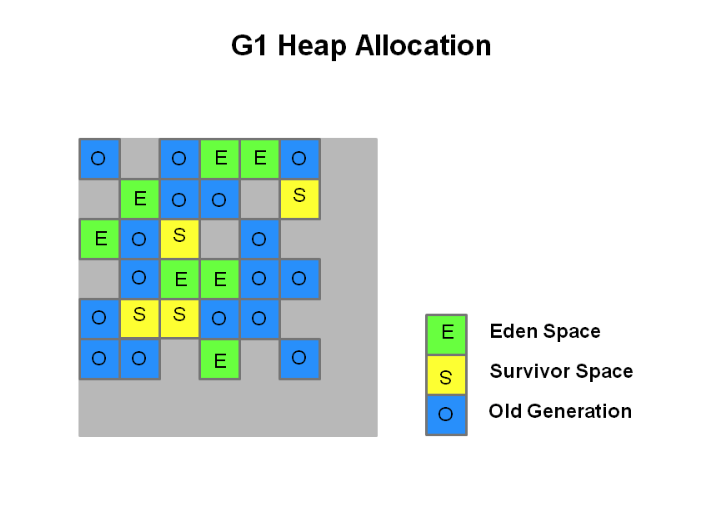
通过引入 Region 的概念,从而将原来的一整块内存空间划分成多个的小空间,使得每个小空间可以单独进行垃圾回收。这种划分方法带来了很大的灵活性,使得可预测的停顿时间模型成为可能。通过记录每个 Region 垃圾回收时间以及回收所获得的空间(这两个值是通过过去回收的经验获得),并维护一个优先列表,每次根据允许的收集时间,优先回收价值最大的 Region。
每个 Region 都有一个 Remembered Set,用来记录该 Region 对象的引用对象所在的 Region。通过使用 Remembered Set,在做可达性分析的时候就可以避免全堆扫描。
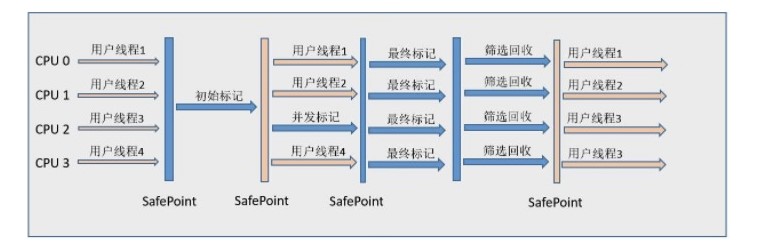
如果不计算维护 Remembered Set 的操作,G1 收集器的运作大致可划分为以下几个步骤:
- 初始标记
- 并发标记
- 最终标记:为了修正在并发标记期间因用户程序继续运作而导致标记产生变动的那一部分标记记录,虚拟机将这段时间对象变化记录在线程的 Remembered Set Logs 里面,最终标记阶段需要把 Remembered Set Logs 的数据合并到 Remembered Set 中。这阶段需要停顿线程,但是可并行执行。
- 筛选回收:首先对各个 Region 中的回收价值和成本进行排序,根据用户所期望的 GC 停顿时间来制定回收计划。此阶段其实也可以做到与用户程序一起并发执行,但是因为只回收一部分 Region,时间是用户可控制的,而且停顿用户线程将大幅度提高收集效率。
具备如下特点:
- 空间整合:整体来看是基于“标记 - 整理”算法实现的收集器,从局部(两个 Region 之间)上来看是基于“复制”算法实现的,这意味着运行期间不会产生内存空间碎片。
- 可预测的停顿:能让使用者明确指定在一个长度为 M 毫秒的时间片段内,消耗在 GC 上的时间不得超过 N 毫秒。
三、内存分配与回收策略
Minor GC 和 Full GC
- Minor GC:回收新生代,因为新生代对象存活时间很短,因此 Minor GC 会频繁执行,执行的速度一般也会比较快。
- Full GC:回收老年代和新生代,老年代对象其存活时间长,因此 Full GC 很少执行,执行速度会比 Minor GC 慢很多。
内存分配策略
1. 对象优先在 Eden 分配
大多数情况下,对象在新生代 Eden 上分配,当 Eden 空间不够时,发起 Minor GC。
2. 大对象直接进入老年代
大对象是指需要连续内存空间的对象,最典型的大对象是那种很长的字符串以及数组。
经常出现大对象会提前触发垃圾收集以获取足够的连续空间分配给大对象。
-XX:PretenureSizeThreshold,大于此值的对象直接在老年代分配,避免在 Eden 和 Survivor 之间的大量内存复制。
3. 长期存活的对象进入老年代
为对象定义年龄计数器,对象在 Eden 出生并经过 Minor GC 依然存活,将移动到 Survivor 中,年龄就增加 1 岁,增加到一定年龄则移动到老年代中。
-XX:MaxTenuringThreshold 用来定义年龄的阈值。
4. 动态对象年龄判定
虚拟机并不是永远要求对象的年龄必须达到 MaxTenuringThreshold 才能晋升老年代,如果在 Survivor 中相同年龄所有对象大小的总和大于 Survivor 空间的一半,则年龄大于或等于该年龄的对象可以直接进入老年代,无需等到 MaxTenuringThreshold 中要求的年龄。
5. 空间分配担保
在发生 Minor GC 之前,虚拟机先检查老年代最大可用的连续空间是否大于新生代所有对象总空间,如果条件成立的话,那么 Minor GC 可以确认是安全的。
如果不成立的话虚拟机会查看 HandlePromotionFailure 的值是否允许担保失败,如果允许那么就会继续检查老年代最大可用的连续空间是否大于历次晋升到老年代对象的平均大小,如果大于,将尝试着进行一次 Minor GC;如果小于,或者 HandlePromotionFailure 的值不允许冒险,那么就要进行一次 Full GC。
Full GC 的触发条件
对于 Minor GC,其触发条件非常简单,当 Eden 空间满时,就将触发一次 Minor GC。而 Full GC 则相对复杂,有以下条件:
1. 调用 System.gc()
只是建议虚拟机执行 Full GC,但是虚拟机不一定真正去执行。不建议使用这种方式,而是让虚拟机管理内存。
2. 老年代空间不足
老年代空间不足的常见场景为前文所讲的大对象直接进入老年代、长期存活的对象进入老年代等。
为了避免以上原因引起的 Full GC,应当尽量不要创建过大的对象以及数组。除此之外,可以通过 -Xmn 虚拟机参数调大新生代的大小,让对象尽量在新生代被回收掉,不进入老年代。还可以通过 -XX:MaxTenuringThreshold 调大对象进入老年代的年龄,让对象在新生代多存活一段时间。
3. 空间分配担保失败
使用复制算法的 Minor GC 需要老年代的内存空间作担保,如果担保失败会执行一次 Full GC。具体内容请参考上面的第 5 小节。
4. JDK 1.7 及以前的永久代空间不足
在 JDK 1.7 及以前,HotSpot 虚拟机中的方法区是用永久代实现的,永久代中存放的为一些 Class 的信息、常量、静态变量等数据。
当系统中要加载的类、反射的类和调用的方法较多时,永久代可能会被占满,在未配置为采用 CMS GC 的情况下也会执行 Full GC。如果经过 Full GC 仍然回收不了,那么虚拟机会抛出 java.lang.OutOfMemoryError。
为避免以上原因引起的 Full GC,可采用的方法为增大永久代空间或转为使用 CMS GC。
5. Concurrent Mode Failure
执行 CMS GC 的过程中同时有对象要放入老年代,而此时老年代空间不足(可能是 GC 过程中浮动垃圾过多导致暂时性的空间不足),便会报 Concurrent Mode Failure 错误,并触发 Full GC。
四、类加载机制
类是在运行期间第一次使用时动态加载的,而不是一次性加载所有类。因为如果一次性加载,那么会占用很多的内存。
类的生命周期

包括以下 7 个阶段:
- 加载(Loading)
- 验证(Verification)
- 准备(Preparation)
- 解析(Resolution)
- 初始化(Initialization)
- 使用(Using)
- 卸载(Unloading)
类加载过程
包含了加载、验证、准备、解析和初始化这 5 个阶段。
1. 加载
加载是类加载的一个阶段,注意不要混淆。
加载过程完成以下三件事:
- 通过类的完全限定名称获取定义该类的二进制字节流。
- 将该字节流表示的静态存储结构转换为方法区的运行时存储结构。
- 在内存中生成一个代表该类的 Class 对象,作为方法区中该类各种数据的访问入口。
其中二进制字节流可以从以下方式中获取:
- 从 ZIP 包读取,成为 JAR、EAR、WAR 格式的基础。
- 从网络中获取,最典型的应用是 Applet。
- 运行时计算生成,例如动态代理技术,在 java.lang.reflect.Proxy 使用 ProxyGenerator.generateProxyClass 的代理类的二进制字节流。
- 由其他文件生成,例如由 JSP 文件生成对应的 Class 类。
2. 验证
确保 Class 文件的字节流中包含的信息符合当前虚拟机的要求,并且不会危害虚拟机自身的安全。
3. 准备
类变量是被 static 修饰的变量,准备阶段为类变量分配内存并设置初始值,使用的是方法区的内存。
实例变量不会在这阶段分配内存,它会在对象实例化时随着对象一起被分配在堆中。应该注意到,实例化不是类加载的一个过程,类加载发生在所有实例化操作之前,并且类加载只进行一次,实例化可以进行多次。
初始值一般为 0 值,例如下面的类变量 value 被初始化为 0 而不是 123。
public static int value = 123;如果类变量是常量,那么它将初始化为表达式所定义的值而不是 0。例如下面的常量 value 被初始化为 123 而不是 0。
public static final int value = 123;4. 解析
将常量池的符号引用替换为直接引用的过程。
其中解析过程在某些情况下可以在初始化阶段之后再开始,这是为了支持 Java 的动态绑定。
5. 初始化
初始化阶段才真正开始执行类中定义的 Java 程序代码。初始化阶段是虚拟机执行类构造器 <clinit\>() 方法的过程。在准备阶段,类变量已经赋过一次系统要求的初始值,而在初始化阶段,根据程序员通过程序制定的主观计划去初始化类变量和其它资源。<clinit\>() 是由编译器自动收集类中所有类变量的赋值动作和静态语句块中的语句合并产生的,编译器收集的顺序由语句在源文件中出现的顺序决定。特别注意的是,静态语句块只能访问到定义在它之前的类变量,定义在它之后的类变量只能赋值,不能访问。例如以下代码:
public class Test {
static {
i = 0; // 给变量赋值可以正常编译通过
System.out.print(i); // 这句编译器会提示“非法向前引用”
}
static int i = 1;
}由于父类的 <clinit\>() 方法先执行,也就意味着父类中定义的静态语句块的执行要优先于子类。例如以下代码:
static class Parent {
public static int A = 1;
static {
A = 2;
}
}
static class Sub extends Parent {
public static int B = A;
}
public static void main(String[] args) {
System.out.println(Sub.B); // 2
}接口中不可以使用静态语句块,但仍然有类变量初始化的赋值操作,因此接口与类一样都会生成 <clinit\>() 方法。但接口与类不同的是,执行接口的 <clinit\>() 方法不需要先执行父接口的 <clinit\>() 方法。只有当父接口中定义的变量使用时,父接口才会初始化。另外,接口的实现类在初始化时也一样不会执行接口的 <clinit\>() 方法。
虚拟机会保证一个类的 <clinit\>() 方法在多线程环境下被正确的加锁和同步,如果多个线程同时初始化一个类,只会有一个线程执行这个类的 <clinit\>() 方法,其它线程都会阻塞等待,直到活动线程执行 <clinit\>() 方法完毕。如果在一个类的 <clinit\>() 方法中有耗时的操作,就可能造成多个线程阻塞,在实际过程中此种阻塞很隐蔽。
类初始化时机
1. 主动引用
虚拟机规范中并没有强制约束何时进行加载,但是规范严格规定了有且只有下列五种情况必须对类进行初始化(加载、验证、准备都会随之发生):
- 遇到 new、getstatic、putstatic、invokestatic 这四条字节码指令时,如果类没有进行过初始化,则必须先触发其初始化。最常见的生成这 4 条指令的场景是:使用 new 关键字实例化对象的时候;读取或设置一个类的静态字段(被 final 修饰、已在编译期把结果放入常量池的静态字段除外)的时候;以及调用一个类的静态方法的时候。
- 使用 java.lang.reflect 包的方法对类进行反射调用的时候,如果类没有进行初始化,则需要先触发其初始化。
- 当初始化一个类的时候,如果发现其父类还没有进行过初始化,则需要先触发其父类的初始化。
- 当虚拟机启动时,用户需要指定一个要执行的主类(包含 main() 方法的那个类),虚拟机会先初始化这个主类;
- 当使用 JDK 1.7 的动态语言支持时,如果一个 java.lang.invoke.MethodHandle 实例最后的解析结果为 REF_getStatic, REF_putStatic, REF_invokeStatic 的方法句柄,并且这个方法句柄所对应的类没有进行过初始化,则需要先触发其初始化;
2. 被动引用
以上 5 种场景中的行为称为对一个类进行主动引用。除此之外,所有引用类的方式都不会触发初始化,称为被动引用。被动引用的常见例子包括:
- 通过子类引用父类的静态字段,不会导致子类初始化。
System.out.println(SubClass.value); // value 字段在 SuperClass 中定义- 通过数组定义来引用类,不会触发此类的初始化。该过程会对数组类进行初始化,数组类是一个由虚拟机自动生成的、直接继承自 Object 的子类,其中包含了数组的属性和方法。
SuperClass[] sca = new SuperClass[10];- 常量在编译阶段会存入调用类的常量池中,本质上并没有直接引用到定义常量的类,因此不会触发定义常量的类的初始化。
System.out.println(ConstClass.HELLOWORLD);类与类加载器
两个类相等,需要类本身相等,并且使用同一个类加载器进行加载。这是因为每一个类加载器都拥有一个独立的类名称空间。
这里的相等,包括类的 Class 对象的 equals() 方法、isAssignableFrom() 方法、isInstance() 方法的返回结果为 true,也包括使用 instanceof 关键字做对象所属关系判定结果为 true。
类加载器分类
从 Java 虚拟机的角度来讲,只存在以下两种不同的类加载器:
- 启动类加载器(Bootstrap ClassLoader),使用 C++ 实现,是虚拟机自身的一部分;
- 所有其它类的加载器,使用 Java 实现,独立于虚拟机,继承自抽象类 java.lang.ClassLoader。
从 Java 开发人员的角度看,类加载器可以划分得更细致一些:
- 启动类加载器(Bootstrap ClassLoader)此类加载器负责将存放在 <JRE_HOME\>\lib 目录中的,或者被 -Xbootclasspath 参数所指定的路径中的,并且是虚拟机识别的(仅按照文件名识别,如 rt.jar,名字不符合的类库即使放在 lib 目录中也不会被加载)类库加载到虚拟机内存中。启动类加载器无法被 Java 程序直接引用,用户在编写自定义类加载器时,如果需要把加载请求委派给启动类加载器,直接使用 null 代替即可。
- 扩展类加载器(Extension ClassLoader)这个类加载器是由 ExtClassLoader(sun.misc.Launcher$ExtClassLoader)实现的。它负责将 <JAVA_HOME\>/lib/ext 或者被 java.ext.dir 系统变量所指定路径中的所有类库加载到内存中,开发者可以直接使用扩展类加载器。
- 应用程序类加载器(Application ClassLoader)这个类加载器是由 AppClassLoader(sun.misc.Launcher$AppClassLoader)实现的。由于这个类加载器是 ClassLoader 中的 getSystemClassLoader() 方法的返回值,因此一般称为系统类加载器。它负责加载用户类路径(ClassPath)上所指定的类库,开发者可以直接使用这个类加载器,如果应用程序中没有自定义过自己的类加载器,一般情况下这个就是程序中默认的类加载器。
双亲委派模型
应用程序是由三种类加载器互相配合从而实现类加载,除此之外还可以加入自己定义的类加载器。
下图展示了类加载器之间的层次关系,称为双亲委派模型(Parents Delegation Model)。该模型要求除了顶层的启动类加载器外,其它的类加载器都要有自己的父类加载器。这里的父子关系一般通过组合关系(Composition)来实现,而不是继承关系(Inheritance)。
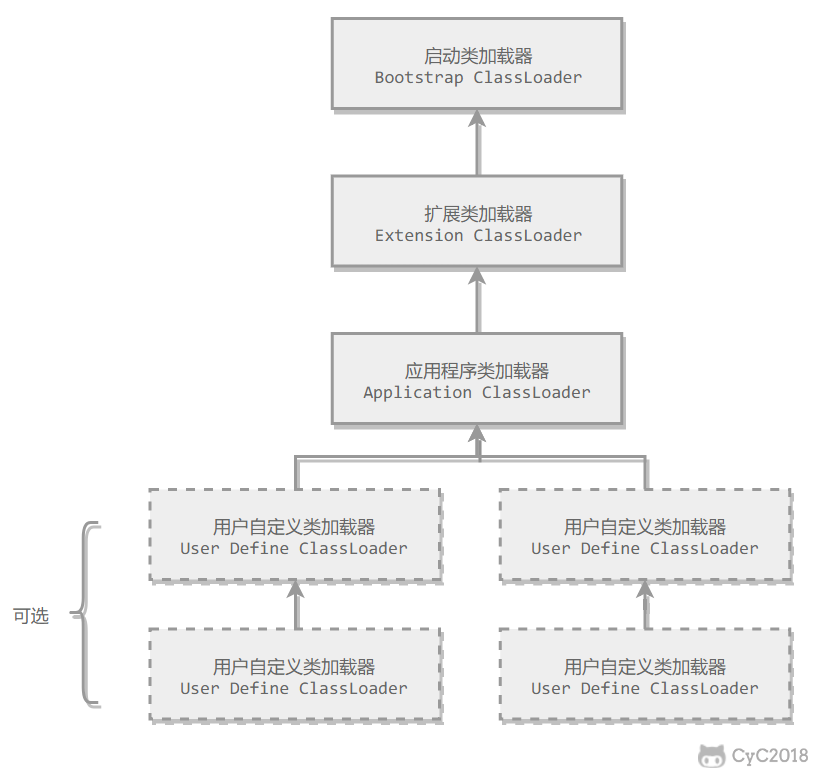
1. 工作过程
一个类加载器首先将类加载请求转发到父类加载器,只有当父类加载器无法完成时才尝试自己加载。
2. 好处
使得 Java 类随着它的类加载器一起具有一种带有优先级的层次关系,从而使得基础类得到统一。
例如 java.lang.Object 存放在 rt.jar 中,如果编写另外一个 java.lang.Object 并放到 ClassPath 中,程序可以编译通过。由于双亲委派模型的存在,所以在 rt.jar 中的 Object 比在 ClassPath 中的 Object 优先级更高,这是因为 rt.jar 中的 Object 使用的是启动类加载器,而 ClassPath 中的 Object 使用的是应用程序类加载器。rt.jar 中的 Object 优先级更高,那么程序中所有的 Object 都是这个 Object。
3. 实现
以下是抽象类 java.lang.ClassLoader 的代码片段,其中的 loadClass() 方法运行过程如下:先检查类是否已经加载过,如果没有则让父类加载器去加载。当父类加载器加载失败时抛出 ClassNotFoundException,此时尝试自己去加载。
public abstract class ClassLoader {
// The parent class loader for delegation
private final ClassLoader parent;
public Class<?> loadClass(String name) throws ClassNotFoundException {
return loadClass(name, false);
}
protected Class<?> loadClass(String name, boolean resolve) throws ClassNotFoundException {
synchronized (getClassLoadingLock(name)) {
// First, check if the class has already been loaded
Class<?> c = findLoadedClass(name);
if (c == null) {
try {
if (parent != null) {
c = parent.loadClass(name, false);
} else {
c = findBootstrapClassOrNull(name);
}
} catch (ClassNotFoundException e) {
// ClassNotFoundException thrown if class not found
// from the non-null parent class loader
}
if (c == null) {
// If still not found, then invoke findClass in order
// to find the class.
c = findClass(name);
}
}
if (resolve) {
resolveClass(c);
}
return c;
}
}
protected Class<?> findClass(String name) throws ClassNotFoundException {
throw new ClassNotFoundException(name);
}
}自定义类加载器实现
以下代码中的 FileSystemClassLoader 是自定义类加载器,继承自 java.lang.ClassLoader,用于加载文件系统上的类。它首先根据类的全名在文件系统上查找类的字节代码文件(.class 文件),然后读取该文件内容,最后通过 defineClass() 方法来把这些字节代码转换成 java.lang.Class 类的实例。
java.lang.ClassLoader 的 loadClass() 实现了双亲委派模型的逻辑,自定义类加载器一般不去重写它,但是需要重写 findClass() 方法。
public class FileSystemClassLoader extends ClassLoader {
private String rootDir;
public FileSystemClassLoader(String rootDir) {
this.rootDir = rootDir;
}
protected Class<?> findClass(String name) throws ClassNotFoundException {
byte[] classData = getClassData(name);
if (classData == null) {
throw new ClassNotFoundException();
} else {
return defineClass(name, classData, 0, classData.length);
}
}
private byte[] getClassData(String className) {
String path = classNameToPath(className);
try {
InputStream ins = new FileInputStream(path);
ByteArrayOutputStream baos = new ByteArrayOutputStream();
int bufferSize = 4096;
byte[] buffer = new byte[bufferSize];
int bytesNumRead;
while ((bytesNumRead = ins.read(buffer)) != -1) {
baos.write(buffer, 0, bytesNumRead);
}
return baos.toByteArray();
} catch (IOException e) {
e.printStackTrace();
}
return null;
}
private String classNameToPath(String className) {
return rootDir + File.separatorChar
+ className.replace('.', File.separatorChar) + ".class";
}
}参考资料
- 周志明. 深入理解 Java 虚拟机 [M]. 机械工业出版社, 2011.
- Chapter 2. The Structure of the Java Virtual Machine
- Jvm memory
Getting Started with the G1 Garbage Collector
- JNI Part1: Java Native Interface Introduction and “Hello World” application
- Memory Architecture Of JVM(Runtime Data Areas)
- JVM Run-Time Data Areas
- Android on x86: Java Native Interface and the Android Native Development Kit
- 深入理解 JVM(2)——GC 算法与内存分配策略
- 深入理解 JVM(3)——7 种垃圾收集器
- JVM Internals
- 深入探讨 Java 类加载器
- Guide to WeakHashMap in Java
- Tomcat example source code file (ConcurrentCache.java)
Java IO
Java IO
* [一、概览](#一概览)
* [二、磁盘操作](#二磁盘操作)
* [三、字节操作](#三字节操作)
* [实现文件复制](#实现文件复制)
* [装饰者模式](#装饰者模式)
* [四、字符操作](#四字符操作)
* [编码与解码](#编码与解码)
* [String 的编码方式](#string-的编码方式)
* [Reader 与 Writer](#reader-与-writer)
* [实现逐行输出文本文件的内容](#实现逐行输出文本文件的内容)
* [五、对象操作](#五对象操作)
* [序列化](#序列化)
* [Serializable](#serializable)
* [transient](#transient)
* [六、网络操作](#六网络操作)
* [InetAddress](#inetaddress)
* [URL](#url)
* [Sockets](#sockets)
* [Datagram](#datagram)
* [七、NIO](#七nio)
* [流与块](#流与块)
* [通道与缓冲区](#通道与缓冲区)
* [缓冲区状态变量](#缓冲区状态变量)
* [文件 NIO 实例](#文件-nio-实例)
* [选择器](#选择器)
* [套接字 NIO 实例](#套接字-nio-实例)
* [内存映射文件](#内存映射文件)
* [对比](#对比)
* [八、参考资料](#八参考资料)一、概览
Java 的 I/O 大概可以分成以下几类:
- 磁盘操作:File
- 字节操作:InputStream 和 OutputStream
- 字符操作:Reader 和 Writer
- 对象操作:Serializable
- 网络操作:Socket
- 新的输入/输出:NIO
二、磁盘操作
File 类可以用于表示文件和目录的信息,但是它不表示文件的内容。
递归地列出一个目录下所有文件:
public static void listAllFiles(File dir) {
if (dir == null || !dir.exists()) {
return;
}
if (dir.isFile()) {
System.out.println(dir.getName());
return;
}
for (File file : dir.listFiles()) {
listAllFiles(file);
}
}从 Java7 开始,可以使用 Paths 和 Files 代替 File。
三、字节操作
实现文件复制
public static void copyFile(String src, String dist) throws IOException {
FileInputStream in = new FileInputStream(src);
FileOutputStream out = new FileOutputStream(dist);
byte[] buffer = new byte[20 * 1024];
int cnt;
// read() 最多读取 buffer.length 个字节
// 返回的是实际读取的个数
// 返回 -1 的时候表示读到 eof,即文件尾
while ((cnt = in.read(buffer, 0, buffer.length)) != -1) {
out.write(buffer, 0, cnt);
}
in.close();
out.close();
}装饰者模式
Java I/O 使用了装饰者模式来实现。以 InputStream 为例,
- InputStream 是抽象组件;
- FileInputStream 是 InputStream 的子类,属于具体组件,提供了字节流的输入操作;
- FilterInputStream 属于抽象装饰者,装饰者用于装饰组件,为组件提供额外的功能。例如 BufferedInputStream 为 FileInputStream 提供缓存的功能。

实例化一个具有缓存功能的字节流对象时,只需要在 FileInputStream 对象上再套一层 BufferedInputStream 对象即可。
FileInputStream fileInputStream = new FileInputStream(filePath);
BufferedInputStream bufferedInputStream = new BufferedInputStream(fileInputStream);DataInputStream 装饰者提供了对更多数据类型进行输入的操作,比如 int、double 等基本类型。
四、字符操作
编码与解码
编码就是把字符转换为字节,而解码是把字节重新组合成字符。
如果编码和解码过程使用不同的编码方式那么就出现了乱码。
- GBK 编码中,中文字符占 2 个字节,英文字符占 1 个字节;
- UTF-8 编码中,中文字符占 3 个字节,英文字符占 1 个字节;
- UTF-16be 编码中,中文字符和英文字符都占 2 个字节。
UTF-16be 中的 be 指的是 Big Endian,也就是大端。相应地也有 UTF-16le,le 指的是 Little Endian,也就是小端。
Java 的内存编码使用双字节编码 UTF-16be,这不是指 Java 只支持这一种编码方式,而是说 char 这种类型使用 UTF-16be 进行编码。char 类型占 16 位,也就是两个字节,Java 使用这种双字节编码是为了让一个中文或者一个英文都能使用一个 char 来存储。
String 的编码方式
String 可以看成一个字符序列,可以指定一个编码方式将它编码为字节序列,也可以指定一个编码方式将一个字节序列解码为 String。
String str1 = "中文";
byte[] bytes = str1.getBytes("UTF-8");
String str2 = new String(bytes, "UTF-8");
System.out.println(str2);在调用无参数 getBytes() 方法时,默认的编码方式不是 UTF-16be。双字节编码的好处是可以使用一个 char 存储中文和英文,而将 String 转为 bytes[] 字节数组就不再需要这个好处,因此也就不再需要双字节编码。getBytes() 的默认编码方式与平台有关,一般为 UTF-8。
byte[] bytes = str1.getBytes();Reader 与 Writer
不管是磁盘还是网络传输,最小的存储单元都是字节,而不是字符。但是在程序中操作的通常是字符形式的数据,因此需要提供对字符进行操作的方法。
- InputStreamReader 实现从字节流解码成字符流;
- OutputStreamWriter 实现字符流编码成为字节流。
实现逐行输出文本文件的内容
public static void readFileContent(String filePath) throws IOException {
FileReader fileReader = new FileReader(filePath);
BufferedReader bufferedReader = new BufferedReader(fileReader);
String line;
while ((line = bufferedReader.readLine()) != null) {
System.out.println(line);
}
// 装饰者模式使得 BufferedReader 组合了一个 Reader 对象
// 在调用 BufferedReader 的 close() 方法时会去调用 Reader 的 close() 方法
// 因此只要一个 close() 调用即可
bufferedReader.close();
}五、对象操作
序列化
序列化就是将一个对象转换成字节序列,方便存储和传输。
- 序列化:ObjectOutputStream.writeObject()
- 反序列化:ObjectInputStream.readObject()
不会对静态变量进行序列化,因为序列化只是保存对象的状态,静态变量属于类的状态。
Serializable
序列化的类需要实现 Serializable 接口,它只是一个标准,没有任何方法需要实现,但是如果不去实现它的话而进行序列化,会抛出异常。
public static void main(String[] args) throws IOException, ClassNotFoundException {
A a1 = new A(123, "abc");
String objectFile = "file/a1";
ObjectOutputStream objectOutputStream = new ObjectOutputStream(new FileOutputStream(objectFile));
objectOutputStream.writeObject(a1);
objectOutputStream.close();
ObjectInputStream objectInputStream = new ObjectInputStream(new FileInputStream(objectFile));
A a2 = (A) objectInputStream.readObject();
objectInputStream.close();
System.out.println(a2);
}
private static class A implements Serializable {
private int x;
private String y;
A(int x, String y) {
this.x = x;
this.y = y;
}
@Override
public String toString() {
return "x = " + x + " " + "y = " + y;
}
}transient
transient 关键字可以使一些属性不会被序列化。
ArrayList 中存储数据的数组 elementData 是用 transient 修饰的,因为这个数组是动态扩展的,并不是所有的空间都被使用,因此就不需要所有的内容都被序列化。通过重写序列化和反序列化方法,使得可以只序列化数组中有内容的那部分数据。
private transient Object[] elementData;六、网络操作
Java 中的网络支持:
- InetAddress:用于表示网络上的硬件资源,即 IP 地址;
- URL:统一资源定位符;
- Sockets:使用 TCP 协议实现网络通信;
- Datagram:使用 UDP 协议实现网络通信。
InetAddress
没有公有的构造函数,只能通过静态方法来创建实例。
InetAddress.getByName(String host);
InetAddress.getByAddress(byte[] address);URL
可以直接从 URL 中读取字节流数据。
public static void main(String[] args) throws IOException {
URL url = new URL("http://www.baidu.com");
/* 字节流 */
InputStream is = url.openStream();
/* 字符流 */
InputStreamReader isr = new InputStreamReader(is, "utf-8");
/* 提供缓存功能 */
BufferedReader br = new BufferedReader(isr);
String line;
while ((line = br.readLine()) != null) {
System.out.println(line);
}
br.close();
}Sockets
- ServerSocket:服务器端类
- Socket:客户端类
- 服务器和客户端通过 InputStream 和 OutputStream 进行输入输出。
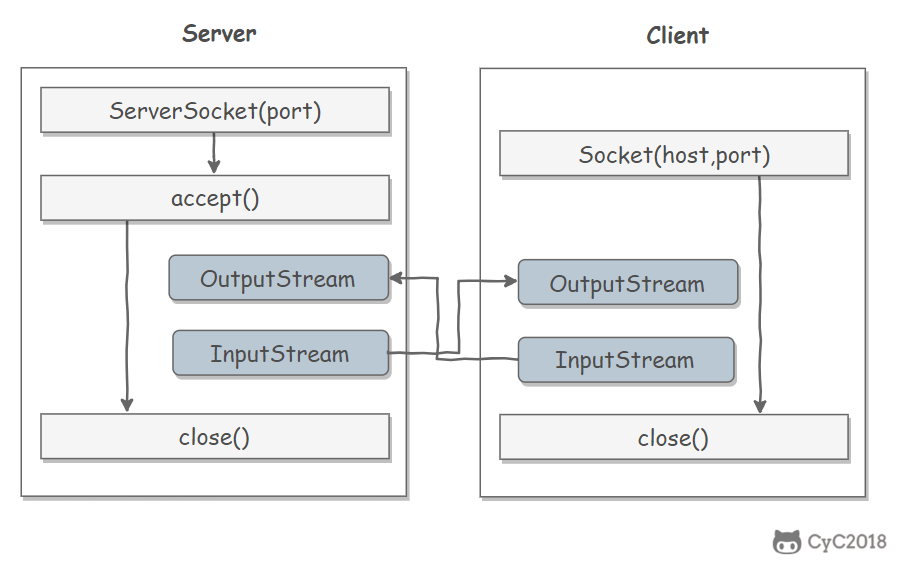
Datagram
- DatagramSocket:通信类
- DatagramPacket:数据包类
七、NIO
新的输入/输出 (NIO) 库是在 JDK 1.4 中引入的,弥补了原来的 I/O 的不足,提供了高速的、面向块的 I/O。
流与块
I/O 与 NIO 最重要的区别是数据打包和传输的方式,I/O 以流的方式处理数据,而 NIO 以块的方式处理数据。
面向流的 I/O 一次处理一个字节数据:一个输入流产生一个字节数据,一个输出流消费一个字节数据。为流式数据创建过滤器非常容易,链接几个过滤器,以便每个过滤器只负责复杂处理机制的一部分。不利的一面是,面向流的 I/O 通常相当慢。
面向块的 I/O 一次处理一个数据块,按块处理数据比按流处理数据要快得多。但是面向块的 I/O 缺少一些面向流的 I/O 所具有的优雅性和简单性。
I/O 包和 NIO 已经很好地集成了,java.io.\ 已经以 NIO 为基础重新实现了,所以现在它可以利用 NIO 的一些特性。例如,java.io.\ 包中的一些类包含以块的形式读写数据的方法,这使得即使在面向流的系统中,处理速度也会更快。
通道与缓冲区
1. 通道
通道 Channel 是对原 I/O 包中的流的模拟,可以通过它读取和写入数据。
通道与流的不同之处在于,流只能在一个方向上移动(一个流必须是 InputStream 或者 OutputStream 的子类),而通道是双向的,可以用于读、写或者同时用于读写。
通道包括以下类型:
- FileChannel:从文件中读写数据;
- DatagramChannel:通过 UDP 读写网络中数据;
- SocketChannel:通过 TCP 读写网络中数据;
- ServerSocketChannel:可以监听新进来的 TCP 连接,对每一个新进来的连接都会创建一个 SocketChannel。
2. 缓冲区
发送给一个通道的所有数据都必须首先放到缓冲区中,同样地,从通道中读取的任何数据都要先读到缓冲区中。也就是说,不会直接对通道进行读写数据,而是要先经过缓冲区。
缓冲区实质上是一个数组,但它不仅仅是一个数组。缓冲区提供了对数据的结构化访问,而且还可以跟踪系统的读/写进程。
缓冲区包括以下类型:
- ByteBuffer
- CharBuffer
- ShortBuffer
- IntBuffer
- LongBuffer
- FloatBuffer
- DoubleBuffer
缓冲区状态变量
- capacity:最大容量;
- position:当前已经读写的字节数;
- limit:还可以读写的字节数。
状态变量的改变过程举例:
① 新建一个大小为 8 个字节的缓冲区,此时 position 为 0,而 limit = capacity = 8。capacity 变量不会改变,下面的讨论会忽略它。
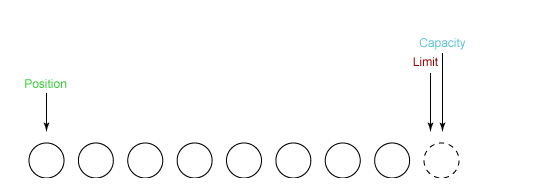
② 从输入通道中读取 5 个字节数据写入缓冲区中,此时 position 为 5,limit 保持不变。
③ 在将缓冲区的数据写到输出通道之前,需要先调用 flip() 方法,这个方法将 limit 设置为当前 position,并将 position 设置为 0。
④ 从缓冲区中取 4 个字节到输出缓冲中,此时 position 设为 4。
⑤ 最后需要调用 clear() 方法来清空缓冲区,此时 position 和 limit 都被设置为最初位置。
文件 NIO 实例
以下展示了使用 NIO 快速复制文件的实例:
public static void fastCopy(String src, String dist) throws IOException {
/* 获得源文件的输入字节流 */
FileInputStream fin = new FileInputStream(src);
/* 获取输入字节流的文件通道 */
FileChannel fcin = fin.getChannel();
/* 获取目标文件的输出字节流 */
FileOutputStream fout = new FileOutputStream(dist);
/* 获取输出字节流的文件通道 */
FileChannel fcout = fout.getChannel();
/* 为缓冲区分配 1024 个字节 */
ByteBuffer buffer = ByteBuffer.allocateDirect(1024);
while (true) {
/* 从输入通道中读取数据到缓冲区中 */
int r = fcin.read(buffer);
/* read() 返回 -1 表示 EOF */
if (r == -1) {
break;
}
/* 切换读写 */
buffer.flip();
/* 把缓冲区的内容写入输出文件中 */
fcout.write(buffer);
/* 清空缓冲区 */
buffer.clear();
}
}选择器
NIO 常常被叫做非阻塞 IO,主要是因为 NIO 在网络通信中的非阻塞特性被广泛使用。
NIO 实现了 IO 多路复用中的 Reactor 模型,一个线程 Thread 使用一个选择器 Selector 通过轮询的方式去监听多个通道 Channel 上的事件,从而让一个线程就可以处理多个事件。
通过配置监听的通道 Channel 为非阻塞,那么当 Channel 上的 IO 事件还未到达时,就不会进入阻塞状态一直等待,而是继续轮询其它 Channel,找到 IO 事件已经到达的 Channel 执行。
因为创建和切换线程的开销很大,因此使用一个线程来处理多个事件而不是一个线程处理一个事件,对于 IO 密集型的应用具有很好地性能。
应该注意的是,只有套接字 Channel 才能配置为非阻塞,而 FileChannel 不能,为 FileChannel 配置非阻塞也没有意义。

1. 创建选择器
Selector selector = Selector.open();2. 将通道注册到选择器上
ServerSocketChannel ssChannel = ServerSocketChannel.open();
ssChannel.configureBlocking(false);
ssChannel.register(selector, SelectionKey.OP_ACCEPT);通道必须配置为非阻塞模式,否则使用选择器就没有任何意义了,因为如果通道在某个事件上被阻塞,那么服务器就不能响应其它事件,必须等待这个事件处理完毕才能去处理其它事件,显然这和选择器的作用背道而驰。
在将通道注册到选择器上时,还需要指定要注册的具体事件,主要有以下几类:
- SelectionKey.OP_CONNECT
- SelectionKey.OP_ACCEPT
- SelectionKey.OP_READ
- SelectionKey.OP_WRITE
它们在 SelectionKey 的定义如下:
public static final int OP_READ = 1 << 0;
public static final int OP_WRITE = 1 << 2;
public static final int OP_CONNECT = 1 << 3;
public static final int OP_ACCEPT = 1 << 4;可以看出每个事件可以被当成一个位域,从而组成事件集整数。例如:
int interestSet = SelectionKey.OP_READ | SelectionKey.OP_WRITE;3. 监听事件
int num = selector.select();使用 select() 来监听到达的事件,它会一直阻塞直到有至少一个事件到达。
4. 获取到达的事件
Set<SelectionKey> keys = selector.selectedKeys();
Iterator<SelectionKey> keyIterator = keys.iterator();
while (keyIterator.hasNext()) {
SelectionKey key = keyIterator.next();
if (key.isAcceptable()) {
// ...
} else if (key.isReadable()) {
// ...
}
keyIterator.remove();
}5. 事件循环
因为一次 select() 调用不能处理完所有的事件,并且服务器端有可能需要一直监听事件,因此服务器端处理事件的代码一般会放在一个死循环内。
while (true) {
int num = selector.select();
Set<SelectionKey> keys = selector.selectedKeys();
Iterator<SelectionKey> keyIterator = keys.iterator();
while (keyIterator.hasNext()) {
SelectionKey key = keyIterator.next();
if (key.isAcceptable()) {
// ...
} else if (key.isReadable()) {
// ...
}
keyIterator.remove();
}
}套接字 NIO 实例
public class NIOServer {
public static void main(String[] args) throws IOException {
Selector selector = Selector.open();
ServerSocketChannel ssChannel = ServerSocketChannel.open();
ssChannel.configureBlocking(false);
ssChannel.register(selector, SelectionKey.OP_ACCEPT);
ServerSocket serverSocket = ssChannel.socket();
InetSocketAddress address = new InetSocketAddress("127.0.0.1", 8888);
serverSocket.bind(address);
while (true) {
selector.select();
Set<SelectionKey> keys = selector.selectedKeys();
Iterator<SelectionKey> keyIterator = keys.iterator();
while (keyIterator.hasNext()) {
SelectionKey key = keyIterator.next();
if (key.isAcceptable()) {
ServerSocketChannel ssChannel1 = (ServerSocketChannel) key.channel();
// 服务器会为每个新连接创建一个 SocketChannel
SocketChannel sChannel = ssChannel1.accept();
sChannel.configureBlocking(false);
// 这个新连接主要用于从客户端读取数据
sChannel.register(selector, SelectionKey.OP_READ);
} else if (key.isReadable()) {
SocketChannel sChannel = (SocketChannel) key.channel();
System.out.println(readDataFromSocketChannel(sChannel));
sChannel.close();
}
keyIterator.remove();
}
}
}
private static String readDataFromSocketChannel(SocketChannel sChannel) throws IOException {
ByteBuffer buffer = ByteBuffer.allocate(1024);
StringBuilder data = new StringBuilder();
while (true) {
buffer.clear();
int n = sChannel.read(buffer);
if (n == -1) {
break;
}
buffer.flip();
int limit = buffer.limit();
char[] dst = new char[limit];
for (int i = 0; i < limit; i++) {
dst[i] = (char) buffer.get(i);
}
data.append(dst);
buffer.clear();
}
return data.toString();
}
}public class NIOClient {
public static void main(String[] args) throws IOException {
Socket socket = new Socket("127.0.0.1", 8888);
OutputStream out = socket.getOutputStream();
String s = "hello world";
out.write(s.getBytes());
out.close();
}
}内存映射文件
内存映射文件 I/O 是一种读和写文件数据的方法,它可以比常规的基于流或者基于通道的 I/O 快得多。
向内存映射文件写入可能是危险的,只是改变数组的单个元素这样的简单操作,就可能会直接修改磁盘上的文件。修改数据与将数据保存到磁盘是没有分开的。
下面代码行将文件的前 1024 个字节映射到内存中,map() 方法返回一个 MappedByteBuffer,它是 ByteBuffer 的子类。因此,可以像使用其他任何 ByteBuffer 一样使用新映射的缓冲区,操作系统会在需要时负责执行映射。
MappedByteBuffer mbb = fc.map(FileChannel.MapMode.READ_WRITE, 0, 1024);对比
NIO 与普通 I/O 的区别主要有以下两点:
- NIO 是非阻塞的;
- NIO 面向块,I/O 面向流。
八、参考资料
- Eckel B, 埃克尔, 昊鹏, 等. Java 编程思想 [M]. 机械工业出版社, 2002.
- IBM: NIO 入门
- Java NIO Tutorial
- Java NIO 浅析
- IBM: 深入分析 Java I/O 的工作机制
- IBM: 深入分析 Java 中的中文编码问题
- IBM: Java 序列化的高级认识
- NIO 与传统 IO 的区别
- Decorator Design Pattern
- Socket Multicast
系统设计基础
系统设计基础
* [一、性能](#一性能)
* [二、伸缩性](#二伸缩性)
* [三、扩展性](#三扩展性)
* [四、可用性](#四可用性)
* [五、安全性](#五安全性)
* [参考资料](#参考资料)一、性能
性能指标
1. 响应时间
指某个请求从发出到接收到响应消耗的时间。
在对响应时间进行测试时,通常采用重复请求的方式,然后计算平均响应时间。
2. 吞吐量
指系统在单位时间内可以处理的请求数量,通常使用每秒的请求数来衡量。
3. 并发用户数
指系统能同时处理的并发用户请求数量。
在没有并发存在的系统中,请求被顺序执行,此时响应时间为吞吐量的倒数。例如系统支持的吞吐量为 100 req/s,那么平均响应时间应该为 0.01s。
目前的大型系统都支持多线程来处理并发请求,多线程能够提高吞吐量以及缩短响应时间,主要有两个原因:
- 多 CPU
- IO 等待时间
使用 IO 多路复用等方式,系统在等待一个 IO 操作完成的这段时间内不需要被阻塞,可以去处理其它请求。通过将这个等待时间利用起来,使得 CPU 利用率大大提高。
并发用户数不是越高越好,因为如果并发用户数太高,系统来不及处理这么多的请求,会使得过多的请求需要等待,那么响应时间就会大大提高。
性能优化
1. 集群
将多台服务器组成集群,使用负载均衡将请求转发到集群中,避免单一服务器的负载压力过大导致性能降低。
2. 缓存
缓存能够提高性能的原因如下:
- 缓存数据通常位于内存等介质中,这种介质对于读操作特别快;
- 缓存数据可以位于靠近用户的地理位置上;
- 可以将计算结果进行缓存,从而避免重复计算。
3. 异步
某些流程可以将操作转换为消息,将消息发送到消息队列之后立即返回,之后这个操作会被异步处理。
二、伸缩性
指不断向集群中添加服务器来缓解不断上升的用户并发访问压力和不断增长的数据存储需求。
伸缩性与性能
如果系统存在性能问题,那么单个用户的请求总是很慢的;
如果系统存在伸缩性问题,那么单个用户的请求可能会很快,但是在并发数很高的情况下系统会很慢。
实现伸缩性
应用服务器只要不具有状态,那么就可以很容易地通过负载均衡器向集群中添加新的服务器。
关系型数据库的伸缩性通过 Sharding 来实现,将数据按一定的规则分布到不同的节点上,从而解决单台存储服务器的存储空间限制。
对于非关系型数据库,它们天生就是为海量数据而诞生,对伸缩性的支持特别好。
三、扩展性
指的是添加新功能时对现有系统的其它应用无影响,这就要求不同应用具备低耦合的特点。
实现可扩展主要有两种方式:
- 使用消息队列进行解耦,应用之间通过消息传递进行通信;
- 使用分布式服务将业务和可复用的服务分离开来,业务使用分布式服务框架调用可复用的服务。新增的产品可以通过调用可复用的服务来实现业务逻辑,对其它产品没有影响。
四、可用性
冗余
保证高可用的主要手段是使用冗余,当某个服务器故障时就请求其它服务器。
应用服务器的冗余比较容易实现,只要保证应用服务器不具有状态,那么某个应用服务器故障时,负载均衡器将该应用服务器原先的用户请求转发到另一个应用服务器上,不会对用户有任何影响。
存储服务器的冗余需要使用主从复制来实现,当主服务器故障时,需要提升从服务器为主服务器,这个过程称为切换。
监控
对 CPU、内存、磁盘、网络等系统负载信息进行监控,当某个信息达到一定阈值时通知运维人员,从而在系统发生故障之前及时发现问题。
服务降级
服务降级是系统为了应对大量的请求,主动关闭部分功能,从而保证核心功能可用。
五、安全性
要求系统在应对各种攻击手段时能够有可靠的应对措施。
参考资料
- 大型网站技术架构:核心原理与案例分析
分布式
分布式
* [一、分布式锁](#一分布式锁)
* [数据库的唯一索引](#数据库的唯一索引)
* [Redis 的 SETNX 指令](#redis-的-setnx-指令)
* [Redis 的 RedLock 算法](#redis-的-redlock-算法)
* [Zookeeper 的有序节点](#zookeeper-的有序节点)
* [二、分布式事务](#二分布式事务)
* [2PC](#2pc)
* [本地消息表](#本地消息表)
* [三、CAP](#三cap)
* [一致性](#一致性)
* [可用性](#可用性)
* [分区容忍性](#分区容忍性)
* [权衡](#权衡)
* [四、BASE](#四base)
* [基本可用](#基本可用)
* [软状态](#软状态)
* [最终一致性](#最终一致性)
* [五、Paxos](#五paxos)
* [执行过程](#执行过程)
* [约束条件](#约束条件)
* [六、Raft](#六raft)
* [单个 Candidate 的竞选](#单个-candidate-的竞选)
* [多个 Candidate 竞选](#多个-candidate-竞选)
* [数据同步](#数据同步)
* [参考](#参考)一、分布式锁
在单机场景下,可以使用语言的内置锁来实现进程同步。但是在分布式场景下,需要同步的进程可能位于不同的节点上,那么就需要使用分布式锁。
阻塞锁通常使用互斥量来实现:
- 互斥量为 0 表示有其它进程在使用锁,此时处于锁定状态;
- 互斥量为 1 表示未锁定状态。
1 和 0 可以用一个整型值表示,也可以用某个数据是否存在表示。
数据库的唯一索引
获得锁时向表中插入一条记录,释放锁时删除这条记录。唯一索引可以保证该记录只被插入一次,那么就可以用这个记录是否存在来判断是否处于锁定状态。
存在以下几个问题:
- 锁没有失效时间,解锁失败的话其它进程无法再获得该锁;
- 只能是非阻塞锁,插入失败直接就报错了,无法重试;
- 不可重入,已经获得锁的进程也必须重新获取锁。
Redis 的 SETNX 指令
使用 SETNX(set if not exist)指令插入一个键值对,如果 Key 已经存在,那么会返回 False,否则插入成功并返回 True。
SETNX 指令和数据库的唯一索引类似,保证了只存在一个 Key 的键值对,那么可以用一个 Key 的键值对是否存在来判断是否存于锁定状态。
EXPIRE 指令可以为一个键值对设置一个过期时间,从而避免了数据库唯一索引实现方式中释放锁失败的问题。
Redis 的 RedLock 算法
使用了多个 Redis 实例来实现分布式锁,这是为了保证在发生单点故障时仍然可用。
- 尝试从 N 个互相独立 Redis 实例获取锁;
- 计算获取锁消耗的时间,只有时间小于锁的过期时间,并且从大多数(N / 2 + 1)实例上获取了锁,才认为获取锁成功;
- 如果获取锁失败,就到每个实例上释放锁。
Zookeeper 的有序节点
1. Zookeeper 抽象模型
Zookeeper 提供了一种树形结构的命名空间,/app1/p_1 节点的父节点为 /app1。
2. 节点类型
- 永久节点:不会因为会话结束或者超时而消失;
- 临时节点:如果会话结束或者超时就会消失;
- 有序节点:会在节点名的后面加一个数字后缀,并且是有序的,例如生成的有序节点为 /lock/node-0000000000,它的下一个有序节点则为 /lock/node-0000000001,以此类推。
3. 监听器
为一个节点注册监听器,在节点状态发生改变时,会给客户端发送消息。
4. 分布式锁实现
- 创建一个锁目录 /lock;
- 当一个客户端需要获取锁时,在 /lock 下创建临时的且有序的子节点;
- 客户端获取 /lock 下的子节点列表,判断自己创建的子节点是否为当前子节点列表中序号最小的子节点,如果是则认为获得锁;否则监听自己的前一个子节点,获得子节点的变更通知后重复此步骤直至获得锁;
- 执行业务代码,完成后,删除对应的子节点。
5. 会话超时
如果一个已经获得锁的会话超时了,因为创建的是临时节点,所以该会话对应的临时节点会被删除,其它会话就可以获得锁了。可以看到,这种实现方式不会出现数据库的唯一索引实现方式释放锁失败的问题。
6. 羊群效应
一个节点未获得锁,只需要监听自己的前一个子节点,这是因为如果监听所有的子节点,那么任意一个子节点状态改变,其它所有子节点都会收到通知(羊群效应,一只羊动起来,其它羊也会一哄而上),而我们只希望它的后一个子节点收到通知。
二、分布式事务
指事务的操作位于不同的节点上,需要保证事务的 ACID 特性。
例如在下单场景下,库存和订单如果不在同一个节点上,就涉及分布式事务。
分布式锁和分布式事务区别:
- 锁问题的关键在于进程操作的互斥关系,例如多个进程同时修改账户的余额,如果没有互斥关系则会导致该账户的余额不正确。
- 而事务问题的关键则在于事务涉及的一系列操作需要满足 ACID 特性,例如要满足原子性操作则需要这些操作要么都执行,要么都不执行。
2PC
两阶段提交(Two-phase Commit,2PC),通过引入协调者(Coordinator)来协调参与者的行为,并最终决定这些参与者是否要真正执行事务。
1. 运行过程
1.1 准备阶段
协调者询问参与者事务是否执行成功,参与者发回事务执行结果。询问可以看成一种投票,需要参与者都同意才能执行。
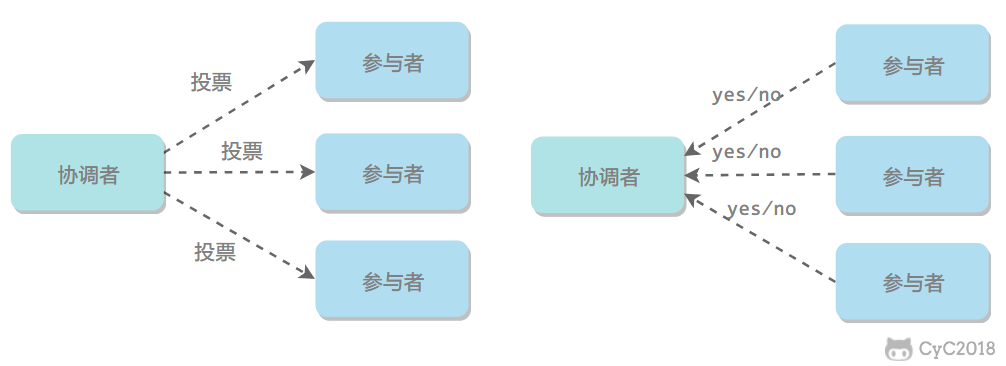
1.2 提交阶段
如果事务在每个参与者上都执行成功,事务协调者发送通知让参与者提交事务;否则,协调者发送通知让参与者回滚事务。
需要注意的是,在准备阶段,参与者执行了事务,但是还未提交。只有在提交阶段接收到协调者发来的通知后,才进行提交或者回滚。
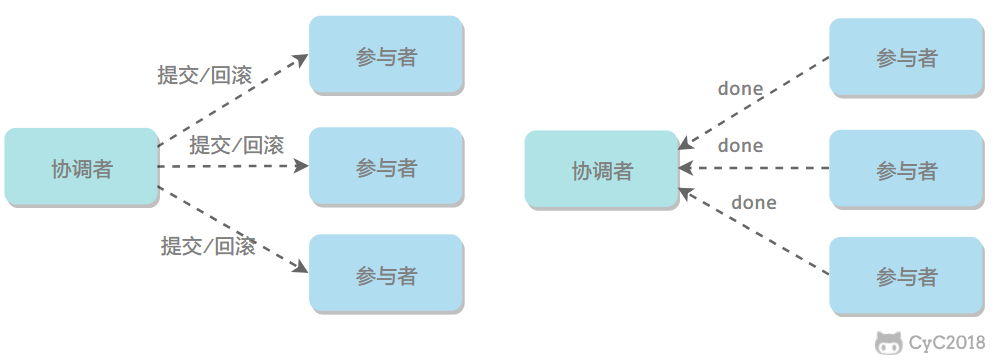
2. 存在的问题
2.1 同步阻塞
所有事务参与者在等待其它参与者响应的时候都处于同步阻塞等待状态,无法进行其它操作。
2.2 单点问题
协调者在 2PC 中起到非常大的作用,发生故障将会造成很大影响。特别是在提交阶段发生故障,所有参与者会一直同步阻塞等待,无法完成其它操作。
2.3 数据不一致
在提交阶段,如果协调者只发送了部分 Commit 消息,此时网络发生异常,那么只有部分参与者接收到 Commit 消息,也就是说只有部分参与者提交了事务,使得系统数据不一致。
2.4 太过保守
任意一个节点失败就会导致整个事务失败,没有完善的容错机制。
本地消息表
本地消息表与业务数据表处于同一个数据库中,这样就能利用本地事务来保证在对这两个表的操作满足事务特性,并且使用了消息队列来保证最终一致性。
- 在分布式事务操作的一方完成写业务数据的操作之后向本地消息表发送一个消息,本地事务能保证这个消息一定会被写入本地消息表中。
- 之后将本地消息表中的消息转发到消息队列中,如果转发成功则将消息从本地消息表中删除,否则继续重新转发。
- 在分布式事务操作的另一方从消息队列中读取一个消息,并执行消息中的操作。

三、CAP
分布式系统不可能同时满足一致性(C:Consistency)、可用性(A:Availability)和分区容忍性(P:Partition Tolerance),最多只能同时满足其中两项。
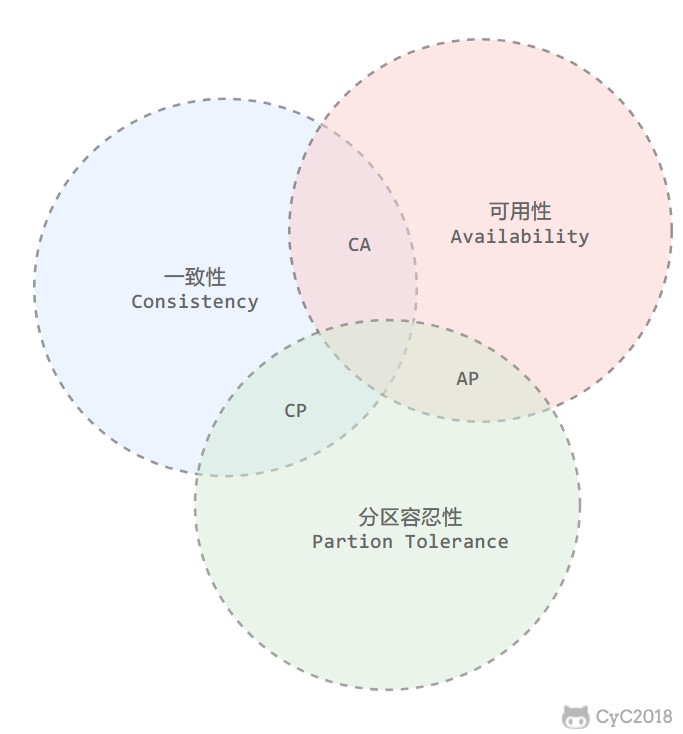
一致性
一致性指的是多个数据副本是否能保持一致的特性,在一致性的条件下,系统在执行数据更新操作之后能够从一致性状态转移到另一个一致性状态。
对系统的一个数据更新成功之后,如果所有用户都能够读取到最新的值,该系统就被认为具有强一致性。
可用性
可用性指分布式系统在面对各种异常时可以提供正常服务的能力,可以用系统可用时间占总时间的比值来衡量,4 个 9 的可用性表示系统 99.99% 的时间是可用的。
在可用性条件下,要求系统提供的服务一直处于可用的状态,对于用户的每一个操作请求总是能够在有限的时间内返回结果。
分区容忍性
网络分区指分布式系统中的节点被划分为多个区域,每个区域内部可以通信,但是区域之间无法通信。
在分区容忍性条件下,分布式系统在遇到任何网络分区故障的时候,仍然需要能对外提供一致性和可用性的服务,除非是整个网络环境都发生了故障。
权衡
在分布式系统中,分区容忍性必不可少,因为需要总是假设网络是不可靠的。因此,CAP 理论实际上是要在可用性和一致性之间做权衡。
可用性和一致性往往是冲突的,很难使它们同时满足。在多个节点之间进行数据同步时,
- 为了保证一致性(CP),不能访问未同步完成的节点,也就失去了部分可用性;
- 为了保证可用性(AP),允许读取所有节点的数据,但是数据可能不一致。
四、BASE
BASE 是基本可用(Basically Available)、软状态(Soft State)和最终一致性(Eventually Consistent)三个短语的缩写。
BASE 理论是对 CAP 中一致性和可用性权衡的结果,它的核心思想是:即使无法做到强一致性,但每个应用都可以根据自身业务特点,采用适当的方式来使系统达到最终一致性。
基本可用
指分布式系统在出现故障的时候,保证核心可用,允许损失部分可用性。
例如,电商在做促销时,为了保证购物系统的稳定性,部分消费者可能会被引导到一个降级的页面。
软状态
指允许系统中的数据存在中间状态,并认为该中间状态不会影响系统整体可用性,即允许系统不同节点的数据副本之间进行同步的过程存在时延。
最终一致性
最终一致性强调的是系统中所有的数据副本,在经过一段时间的同步后,最终能达到一致的状态。
ACID 要求强一致性,通常运用在传统的数据库系统上。而 BASE 要求最终一致性,通过牺牲强一致性来达到可用性,通常运用在大型分布式系统中。
在实际的分布式场景中,不同业务单元和组件对一致性的要求是不同的,因此 ACID 和 BASE 往往会结合在一起使用。
五、Paxos
用于达成共识性问题,即对多个节点产生的值,该算法能保证只选出唯一一个值。
主要有三类节点:
- 提议者(Proposer):提议一个值;
- 接受者(Acceptor):对每个提议进行投票;
- 告知者(Learner):被告知投票的结果,不参与投票过程。
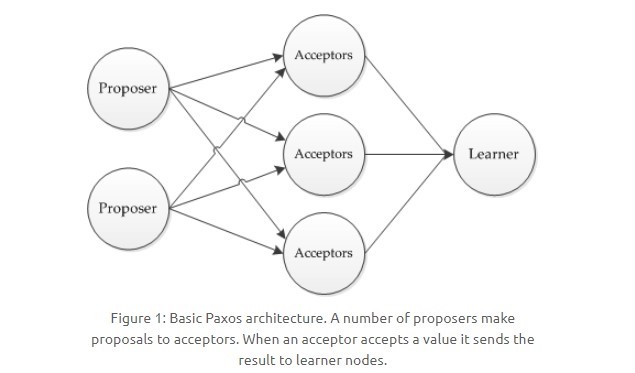
执行过程
规定一个提议包含两个字段:[n, v],其中 n 为序号(具有唯一性),v 为提议值。
1. Prepare 阶段
下图演示了两个 Proposer 和三个 Acceptor 的系统中运行该算法的初始过程,每个 Proposer 都会向所有 Acceptor 发送 Prepare 请求。
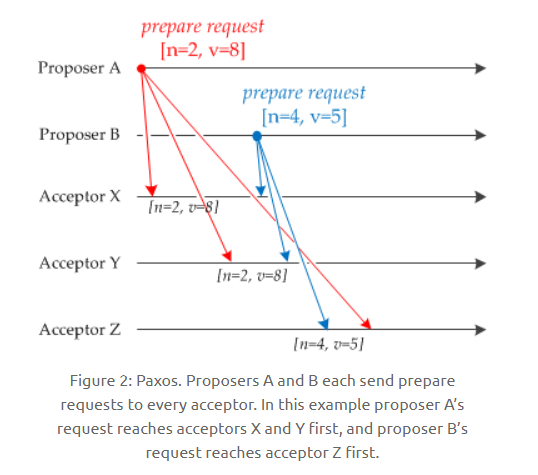
当 Acceptor 接收到一个 Prepare 请求,包含的提议为 [n1, v1],并且之前还未接收过 Prepare 请求,那么发送一个 Prepare 响应,设置当前接收到的提议为 [n1, v1],并且保证以后不会再接受序号小于 n1 的提议。
如下图,Acceptor X 在收到 [n=2, v=8] 的 Prepare 请求时,由于之前没有接收过提议,因此就发送一个 [no previous] 的 Prepare 响应,设置当前接收到的提议为 [n=2, v=8],并且保证以后不会再接受序号小于 2 的提议。其它的 Acceptor 类似。
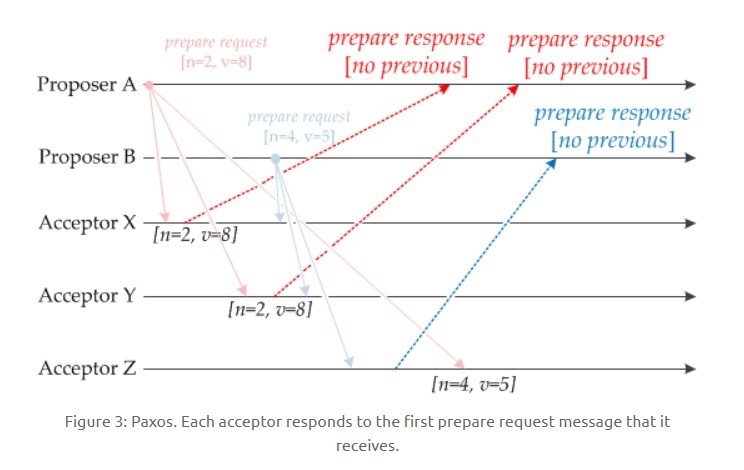
如果 Acceptor 接收到一个 Prepare 请求,包含的提议为 [n2, v2],并且之前已经接收过提议 [n1, v1]。如果 n1 \> n2,那么就丢弃该提议请求;否则,发送 Prepare 响应,该 Prepare 响应包含之前已经接收过的提议 [n1, v1],设置当前接收到的提议为 [n2, v2],并且保证以后不会再接受序号小于 n2 的提议。
如下图,Acceptor Z 收到 Proposer A 发来的 [n=2, v=8] 的 Prepare 请求,由于之前已经接收过 [n=4, v=5] 的提议,并且 n \> 2,因此就抛弃该提议请求;Acceptor X 收到 Proposer B 发来的 [n=4, v=5] 的 Prepare 请求,因为之前接收到的提议为 [n=2, v=8],并且 2 \<= 4,因此就发送 [n=2, v=8] 的 Prepare 响应,设置当前接收到的提议为 [n=4, v=5],并且保证以后不会再接受序号小于 4 的提议。Acceptor Y 类似。
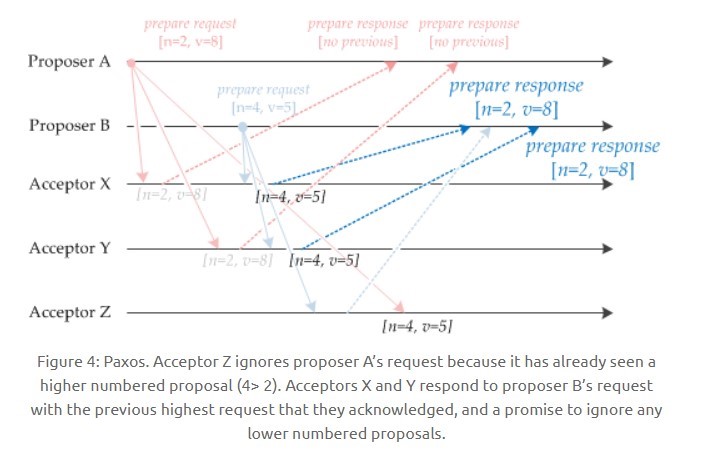
2. Accept 阶段
当一个 Proposer 接收到超过一半 Acceptor 的 Prepare 响应时,就可以发送 Accept 请求。
Proposer A 接收到两个 Prepare 响应之后,就发送 [n=2, v=8] Accept 请求。该 Accept 请求会被所有 Acceptor 丢弃,因为此时所有 Acceptor 都保证不接受序号小于 4 的提议。
Proposer B 过后也收到了两个 Prepare 响应,因此也开始发送 Accept 请求。需要注意的是,Accept 请求的 v 需要取它收到的最大提议编号对应的 v 值,也就是 8。因此它发送 [n=4, v=8] 的 Accept 请求。
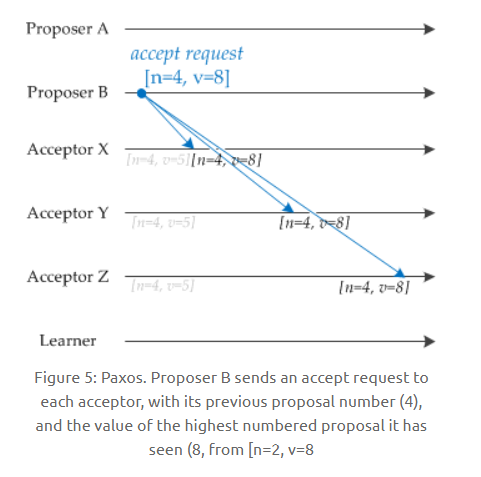
3. Learn 阶段
Acceptor 接收到 Accept 请求时,如果序号大于等于该 Acceptor 承诺的最小序号,那么就发送 Learn 提议给所有的 Learner。当 Learner 发现有大多数的 Acceptor 接收了某个提议,那么该提议的提议值就被 Paxos 选择出来。

约束条件
1\. 正确性
指只有一个提议值会生效。
因为 Paxos 协议要求每个生效的提议被多数 Acceptor 接收,并且 Acceptor 不会接受两个不同的提议,因此可以保证正确性。
2\. 可终止性
指最后总会有一个提议生效。
Paxos 协议能够让 Proposer 发送的提议朝着能被大多数 Acceptor 接受的那个提议靠拢,因此能够保证可终止性。
六、Raft
Raft 也是分布式一致性协议,主要是用来竞选主节点。
单个 Candidate 的竞选
有三种节点:Follower、Candidate 和 Leader。Leader 会周期性的发送心跳包给 Follower。每个 Follower 都设置了一个随机的竞选超时时间,一般为 150ms\~300ms,如果在这个时间内没有收到 Leader 的心跳包,就会变成 Candidate,进入竞选阶段。
- 下图展示一个分布式系统的最初阶段,此时只有 Follower 没有 Leader。Node A 等待一个随机的竞选超时时间之后,没收到 Leader 发来的心跳包,因此进入竞选阶段。
- 此时 Node A 发送投票请求给其它所有节点。
- 其它节点会对请求进行回复,如果超过一半的节点回复了,那么该 Candidate 就会变成 Leader。
- 之后 Leader 会周期性地发送心跳包给 Follower,Follower 接收到心跳包,会重新开始计时。
多个 Candidate 竞选
- 如果有多个 Follower 成为 Candidate,并且所获得票数相同,那么就需要重新开始投票。例如下图中 Node B 和 Node D 都获得两票,需要重新开始投票。
- 由于每个节点设置的随机竞选超时时间不同,因此下一次再次出现多个 Candidate 并获得同样票数的概率很低。
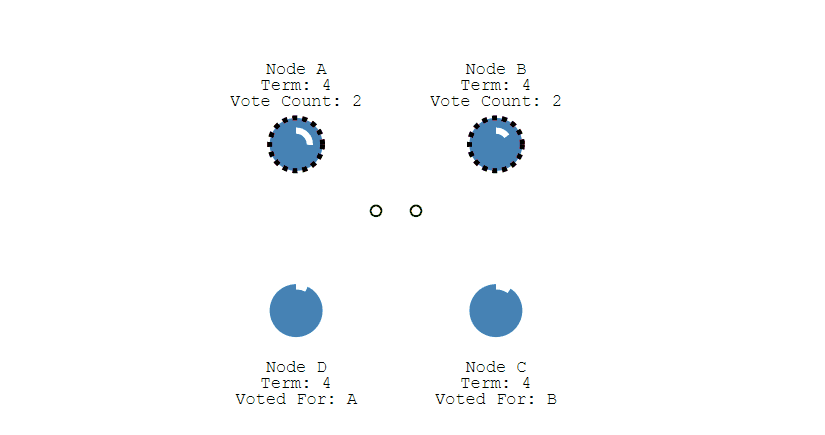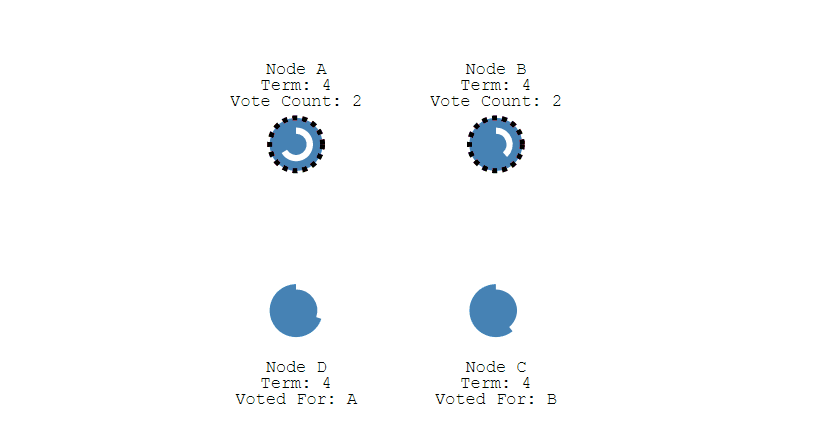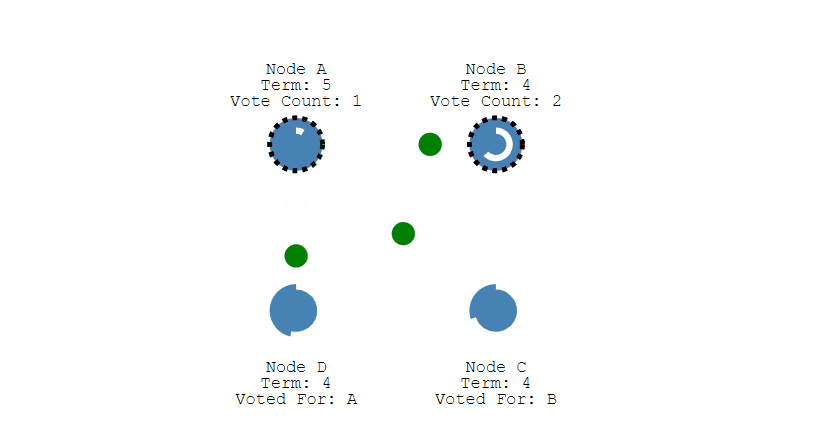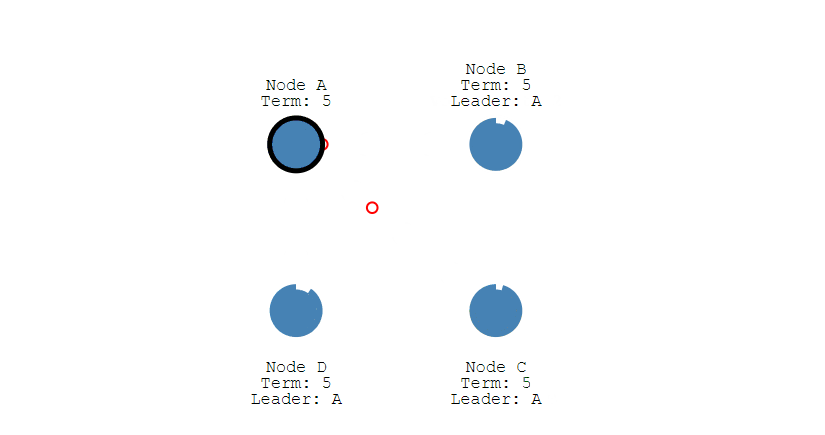
数据同步
- 来自客户端的修改都会被传入 Leader。注意该修改还未被提交,只是写入日志中。
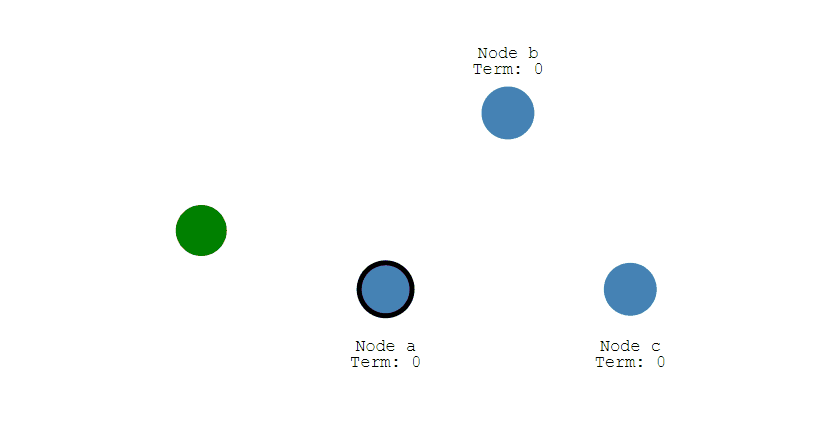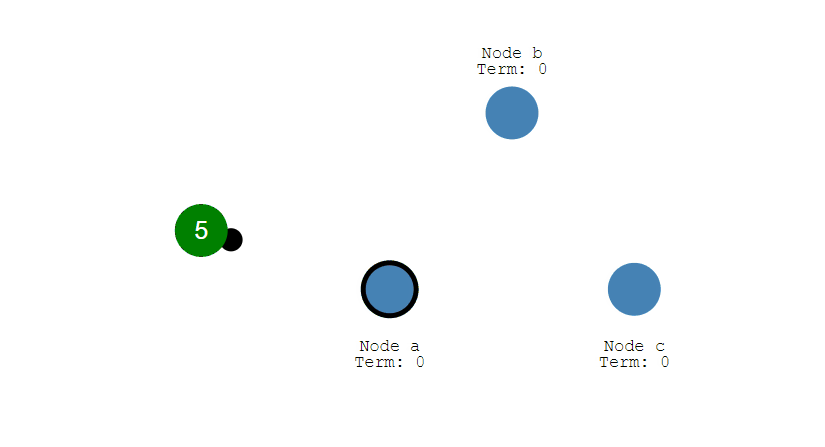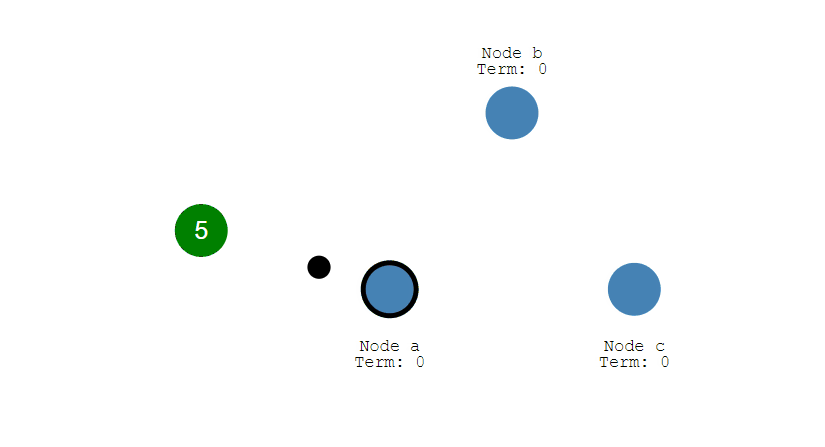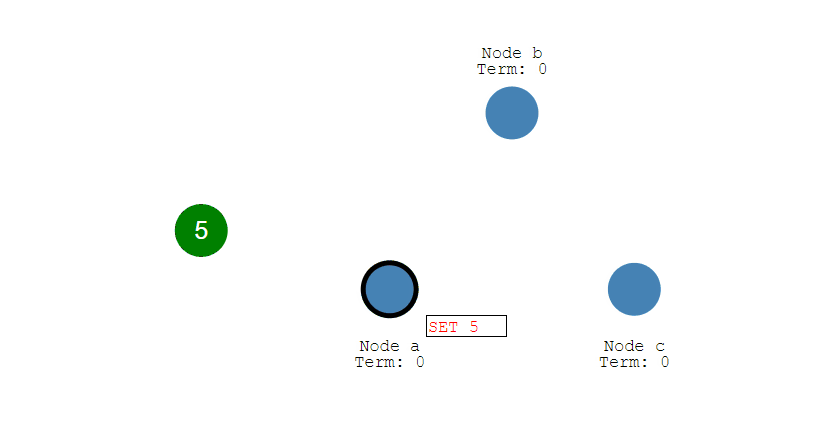
- Leader 会把修改复制到所有 Follower。
- Leader 会等待大多数的 Follower 也进行了修改,然后才将修改提交。
- 此时 Leader 会通知的所有 Follower 让它们也提交修改,此时所有节点的值达成一致。

参考
- 倪超. 从 Paxos 到 ZooKeeper : 分布式一致性原理与实践 [M]. 电子工业出版社, 2015.
- Distributed locks with Redis
- 浅谈分布式锁
- 基于 Zookeeper 的分布式锁
- 聊聊分布式事务,再说说解决方案
- 分布式系统的事务处理
- 深入理解分布式事务
- What is CAP theorem in distributed database system?
- NEAT ALGORITHMS - PAXOS
- Paxos By Example
集群
集群
* [一、负载均衡](#一负载均衡)
* [负载均衡算法](#负载均衡算法)
* [1. 轮询(Round Robin)](#1-轮询round-robin)
* [2. 加权轮询(Weighted Round Robbin)](#2-加权轮询weighted-round-robbin)
* [3. 最少连接(least Connections)](#3-最少连接least-connections)
* [4. 加权最少连接(Weighted Least Connection)](#4-加权最少连接weighted-least-connection)
* [5. 随机算法(Random)](#5-随机算法random)
* [6. 源地址哈希法 (IP Hash)](#6-源地址哈希法-ip-hash)
* [转发实现](#转发实现)
* [1. HTTP 重定向](#1-http-重定向)
* [2. DNS 域名解析](#2-dns-域名解析)
* [3. 反向代理服务器](#3-反向代理服务器)
* [4. 网络层](#4-网络层)
* [5. 链路层](#5-链路层)
* [二、集群下的 Session 管理](#二集群下的-session-管理)
* [Sticky Session](#sticky-session)
* [Session Replication](#session-replication)
* [Session Server](#session-server)一、负载均衡
集群中的应用服务器(节点)通常被设计成无状态,用户可以请求任何一个节点。
负载均衡器会根据集群中每个节点的负载情况,将用户请求转发到合适的节点上。
负载均衡器可以用来实现高可用以及伸缩性:
- 高可用:当某个节点故障时,负载均衡器会将用户请求转发到另外的节点上,从而保证所有服务持续可用;
- 伸缩性:根据系统整体负载情况,可以很容易地添加或移除节点。
负载均衡器运行过程包含两个部分:
- 根据负载均衡算法得到转发的节点;
- 进行转发。
负载均衡算法
1. 轮询(Round Robin)
轮询算法把每个请求轮流发送到每个服务器上。
下图中,一共有 6 个客户端产生了 6 个请求,这 6 个请求按 (1, 2, 3, 4, 5, 6) 的顺序发送。(1, 3, 5) 的请求会被发送到服务器 1,(2, 4, 6) 的请求会被发送到服务器 2。
该算法比较适合每个服务器的性能差不多的场景,如果有性能存在差异的情况下,那么性能较差的服务器可能无法承担过大的负载(下图的 Server 2)。
2. 加权轮询(Weighted Round Robbin)
加权轮询是在轮询的基础上,根据服务器的性能差异,为服务器赋予一定的权值,性能高的服务器分配更高的权值。
例如下图中,服务器 1 被赋予的权值为 5,服务器 2 被赋予的权值为 1,那么 (1, 2, 3, 4, 5) 请求会被发送到服务器 1,(6) 请求会被发送到服务器 2。
3. 最少连接(least Connections)
由于每个请求的连接时间不一样,使用轮询或者加权轮询算法的话,可能会让一台服务器当前连接数过大,而另一台服务器的连接过小,造成负载不均衡。
例如下图中,(1, 3, 5) 请求会被发送到服务器 1,但是 (1, 3) 很快就断开连接,此时只有 (5) 请求连接服务器 1;(2, 4, 6) 请求被发送到服务器 2,只有 (2) 的连接断开,此时 (6, 4) 请求连接服务器 2。该系统继续运行时,服务器 2 会承担过大的负载。

最少连接算法就是将请求发送给当前最少连接数的服务器上。
例如下图中,服务器 1 当前连接数最小,那么新到来的请求 6 就会被发送到服务器 1 上。
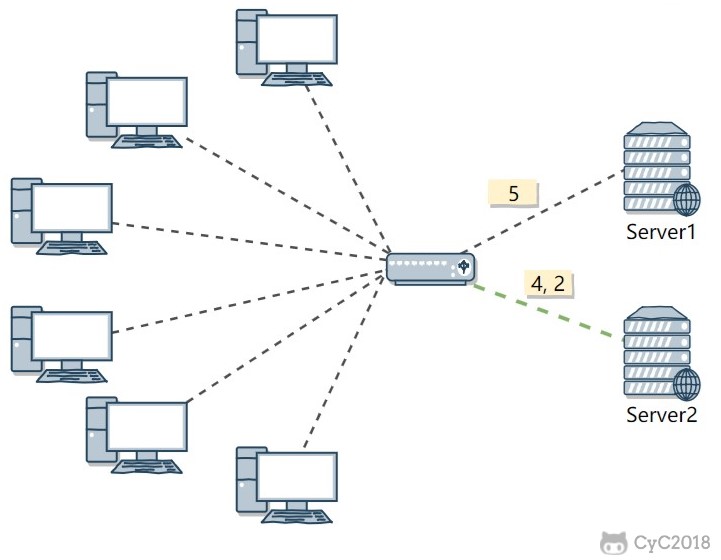
4. 加权最少连接(Weighted Least Connection)
在最少连接的基础上,根据服务器的性能为每台服务器分配权重,再根据权重计算出每台服务器能处理的连接数。
5. 随机算法(Random)
把请求随机发送到服务器上。
和轮询算法类似,该算法比较适合服务器性能差不多的场景。
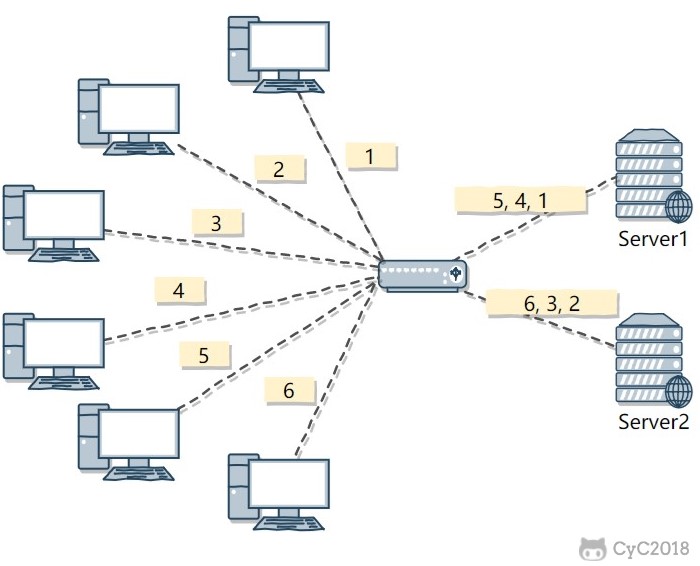
6. 源地址哈希法 (IP Hash)
源地址哈希通过对客户端 IP 计算哈希值之后,再对服务器数量取模得到目标服务器的序号。
可以保证同一 IP 的客户端的请求会转发到同一台服务器上,用来实现会话粘滞(Sticky Session)
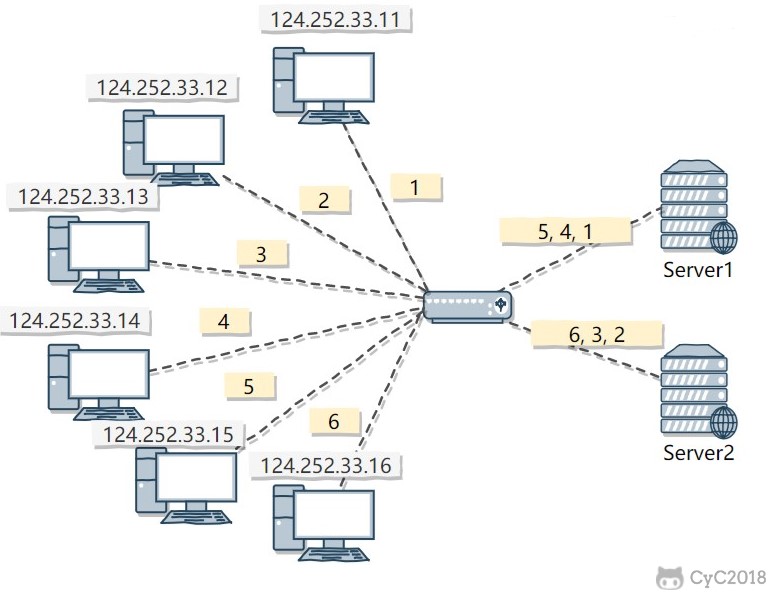
转发实现
1. HTTP 重定向
HTTP 重定向负载均衡服务器使用某种负载均衡算法计算得到服务器的 IP 地址之后,将该地址写入 HTTP 重定向报文中,状态码为 302。客户端收到重定向报文之后,需要重新向服务器发起请求。
缺点:
- 需要两次请求,因此访问延迟比较高;
- HTTP 负载均衡器处理能力有限,会限制集群的规模。
该负载均衡转发的缺点比较明显,实际场景中很少使用它。
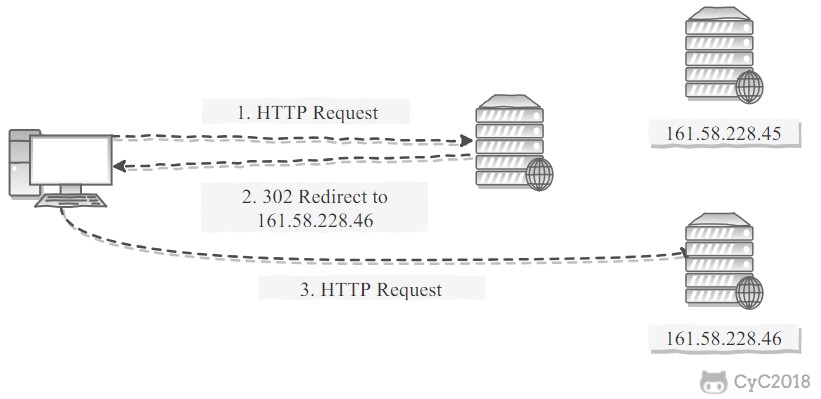
2. DNS 域名解析
在 DNS 解析域名的同时使用负载均衡算法计算服务器 IP 地址。
优点:
- DNS 能够根据地理位置进行域名解析,返回离用户最近的服务器 IP 地址。
缺点:
- 由于 DNS 具有多级结构,每一级的域名记录都可能被缓存,当下线一台服务器需要修改 DNS 记录时,需要过很长一段时间才能生效。
大型网站基本使用了 DNS 做为第一级负载均衡手段,然后在内部使用其它方式做第二级负载均衡。也就是说,域名解析的结果为内部的负载均衡服务器 IP 地址。

3. 反向代理服务器
反向代理服务器位于源服务器前面,用户的请求需要先经过反向代理服务器才能到达源服务器。反向代理可以用来进行缓存、日志记录等,同时也可以用来做为负载均衡服务器。
在这种负载均衡转发方式下,客户端不直接请求源服务器,因此源服务器不需要外部 IP 地址,而反向代理需要配置内部和外部两套 IP 地址。
优点:
- 与其它功能集成在一起,部署简单。
缺点:
- 所有请求和响应都需要经过反向代理服务器,它可能会成为性能瓶颈。
4. 网络层
在操作系统内核进程获取网络数据包,根据负载均衡算法计算源服务器的 IP 地址,并修改请求数据包的目的 IP 地址,最后进行转发。
源服务器返回的响应也需要经过负载均衡服务器,通常是让负载均衡服务器同时作为集群的网关服务器来实现。
优点:
- 在内核进程中进行处理,性能比较高。
缺点:
- 和反向代理一样,所有的请求和响应都经过负载均衡服务器,会成为性能瓶颈。
5. 链路层
在链路层根据负载均衡算法计算源服务器的 MAC 地址,并修改请求数据包的目的 MAC 地址,并进行转发。
通过配置源服务器的虚拟 IP 地址和负载均衡服务器的 IP 地址一致,从而不需要修改 IP 地址就可以进行转发。也正因为 IP 地址一样,所以源服务器的响应不需要转发回负载均衡服务器,可以直接转发给客户端,避免了负载均衡服务器的成为瓶颈。
这是一种三角传输模式,被称为直接路由。对于提供下载和视频服务的网站来说,直接路由避免了大量的网络传输数据经过负载均衡服务器。
这是目前大型网站使用最广负载均衡转发方式,在 Linux 平台可以使用的负载均衡服务器为 LVS(Linux Virtual Server)。
参考:
二、集群下的 Session 管理
一个用户的 Session 信息如果存储在一个服务器上,那么当负载均衡器把用户的下一个请求转发到另一个服务器,由于服务器没有用户的 Session 信息,那么该用户就需要重新进行登录等操作。
Sticky Session
需要配置负载均衡器,使得一个用户的所有请求都路由到同一个服务器,这样就可以把用户的 Session 存放在该服务器中。
缺点:
- 当服务器宕机时,将丢失该服务器上的所有 Session。
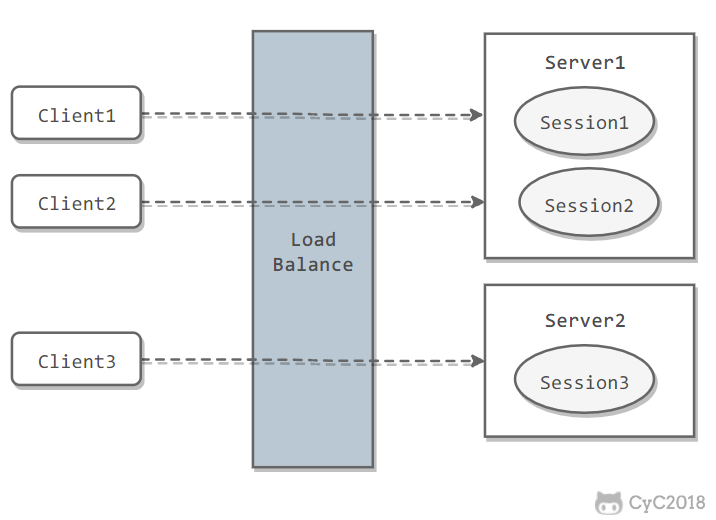
Session Replication
在服务器之间进行 Session 同步操作,每个服务器都有所有用户的 Session 信息,因此用户可以向任何一个服务器进行请求。
缺点:
- 占用过多内存;
- 同步过程占用网络带宽以及服务器处理器时间。
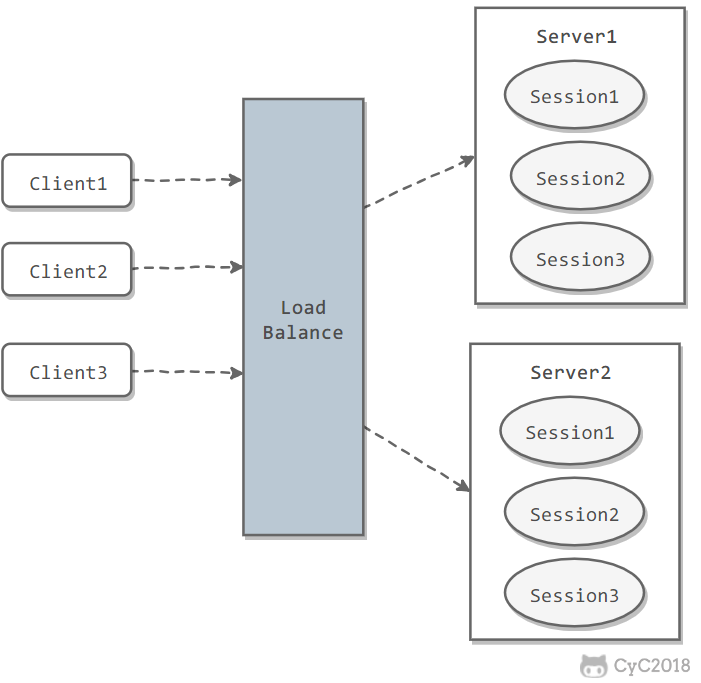
Session Server
使用一个单独的服务器存储 Session 数据,可以使用传统的 MySQL,也使用 Redis 或者 Memcached 这种内存型数据库。
优点:
- 为了使得大型网站具有伸缩性,集群中的应用服务器通常需要保持无状态,那么应用服务器不能存储用户的会话信息。Session Server 将用户的会话信息单独进行存储,从而保证了应用服务器的无状态。
缺点:
- 需要去实现存取 Session 的代码。
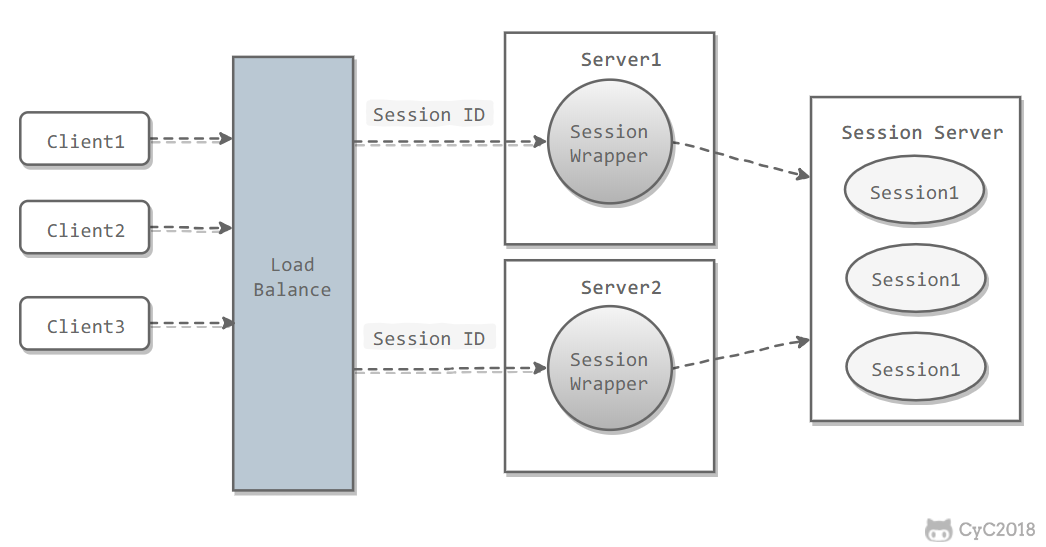
参考:
攻击技术
攻击技术
* [一、跨站脚本攻击](#一跨站脚本攻击)
* [二、跨站请求伪造](#二跨站请求伪造)
* [三、SQL 注入攻击](#三sql-注入攻击)
* [四、拒绝服务攻击](#四拒绝服务攻击)
* [参考资料](#参考资料)一、跨站脚本攻击
概念
跨站脚本攻击(Cross-Site Scripting, XSS),可以将代码注入到用户浏览的网页上,这种代码包括 HTML 和 JavaScript。
攻击原理
例如有一个论坛网站,攻击者可以在上面发布以下内容:
之后该内容可能会被渲染成以下形式:
<p></p>另一个用户浏览了含有这个内容的页面将会跳转到 domain.com 并携带了当前作用域的 Cookie。如果这个论坛网站通过 Cookie 管理用户登录状态,那么攻击者就可以通过这个 Cookie 登录被攻击者的账号了。
危害
- 窃取用户的 Cookie
- 伪造虚假的输入表单骗取个人信息
- 显示伪造的文章或者图片
防范手段
1. 设置 Cookie 为 HttpOnly
设置了 HttpOnly 的 Cookie 可以防止 JavaScript 脚本调用,就无法通过 document.cookie 获取用户 Cookie 信息。
2. 过滤特殊字符
例如将 < 转义为 <,将 > 转义为 >,从而避免 HTML 和 Jascript 代码的运行。
富文本编辑器允许用户输入 HTML 代码,就不能简单地将 < 等字符进行过滤了,极大地提高了 XSS 攻击的可能性。
富文本编辑器通常采用 XSS filter 来防范 XSS 攻击,通过定义一些标签白名单或者黑名单,从而不允许有攻击性的 HTML 代码的输入。
以下例子中,form 和 script 等标签都被转义,而 h 和 p 等标签将会保留。
<h1 id="title">XSS Demo</h1>
<p>123</p>
<form>
<input type="text" name="q" value="test">
</form>
<pre>hello</pre><h1>XSS Demo</h1>
<p>123</p>
<form>
<input type="text" name="q" value="test">
</form>
<pre>hello</pre>
<script type="text/javascript">
alert(/xss/);
</script>XSS 过滤在线测试
二、跨站请求伪造
概念
跨站请求伪造(Cross-site request forgery,CSRF),是攻击者通过一些技术手段欺骗用户的浏览器去访问一个自己曾经认证过的网站并执行一些操作(如发邮件,发消息,甚至财产操作如转账和购买商品)。由于浏览器曾经认证过,所以被访问的网站会认为是真正的用户操作而去执行。
XSS 利用的是用户对指定网站的信任,CSRF 利用的是网站对用户浏览器的信任。
攻击原理
假如一家银行用以执行转账操作的 URL 地址如下:
http://www.examplebank.com/withdraw?account=AccoutName&amount=1000&for=PayeeName。那么,一个恶意攻击者可以在另一个网站上放置如下代码:
<img src="http://www.examplebank.com/withdraw?account=Alice&amount=1000&for=Badman">。如果有账户名为 Alice 的用户访问了恶意站点,而她之前刚访问过银行不久,登录信息尚未过期,那么她就会损失 1000 美元。
这种恶意的网址可以有很多种形式,藏身于网页中的许多地方。此外,攻击者也不需要控制放置恶意网址的网站。例如他可以将这种地址藏在论坛,博客等任何用户生成内容的网站中。这意味着如果服务器端没有合适的防御措施的话,用户即使访问熟悉的可信网站也有受攻击的危险。
通过例子能够看出,攻击者并不能通过 CSRF 攻击来直接获取用户的账户控制权,也不能直接窃取用户的任何信息。他们能做到的,是欺骗用户浏览器,让其以用户的名义执行操作。
防范手段
1. 检查 Referer 首部字段
Referer 首部字段位于 HTTP 报文中,用于标识请求来源的地址。检查这个首部字段并要求请求来源的地址在同一个域名下,可以极大的防止 CSRF 攻击。
这种办法简单易行,工作量低,仅需要在关键访问处增加一步校验。但这种办法也有其局限性,因其完全依赖浏览器发送正确的 Referer 字段。虽然 HTTP 协议对此字段的内容有明确的规定,但并无法保证来访的浏览器的具体实现,亦无法保证浏览器没有安全漏洞影响到此字段。并且也存在攻击者攻击某些浏览器,篡改其 Referer 字段的可能。
2. 添加校验 Token
在访问敏感数据请求时,要求用户浏览器提供不保存在 Cookie 中,并且攻击者无法伪造的数据作为校验。例如服务器生成随机数并附加在表单中,并要求客户端传回这个随机数。
3. 输入验证码
因为 CSRF 攻击是在用户无意识的情况下发生的,所以要求用户输入验证码可以让用户知道自己正在做的操作。
三、SQL 注入攻击
概念
服务器上的数据库运行非法的 SQL 语句,主要通过拼接来完成。
攻击原理
例如一个网站登录验证的 SQL 查询代码为:
strSQL = "SELECT * FROM users WHERE (name = '" + userName + "') and (pw = '"+ passWord +"');"如果填入以下内容:
userName = "1' OR '1'='1";
passWord = "1' OR '1'='1";那么 SQL 查询字符串为:
strSQL = "SELECT * FROM users WHERE (name = '1' OR '1'='1') and (pw = '1' OR '1'='1');"此时无需验证通过就能执行以下查询:
strSQL = "SELECT * FROM users;"防范手段
1. 使用参数化查询
Java 中的 PreparedStatement 是预先编译的 SQL 语句,可以传入适当参数并且多次执行。由于没有拼接的过程,因此可以防止 SQL 注入的发生。
PreparedStatement stmt = connection.prepareStatement("SELECT * FROM users WHERE userid=? AND password=?");
stmt.setString(1, userid);
stmt.setString(2, password);
ResultSet rs = stmt.executeQuery();2. 单引号转换
将传入的参数中的单引号转换为连续两个单引号,PHP 中的 Magic quote 可以完成这个功能。
四、拒绝服务攻击
拒绝服务攻击(denial-of-service attack,DoS),亦称洪水攻击,其目的在于使目标电脑的网络或系统资源耗尽,使服务暂时中断或停止,导致其正常用户无法访问。
分布式拒绝服务攻击(distributed denial-of-service attack,DDoS),指攻击者使用两个或以上被攻陷的电脑作为“僵尸”向特定的目标发动“拒绝服务”式攻击。
参考资料
缓存
缓存
* [一、缓存特征](#一缓存特征)
* [二、缓存位置](#二缓存位置)
* [三、CDN](#三cdn)
* [四、缓存问题](#四缓存问题)
* [五、数据分布](#五数据分布)
* [六、一致性哈希](#六一致性哈希)
* [七、LRU](#七lru)
* [参考资料](#参考资料)一、缓存特征
命中率
当某个请求能够通过访问缓存而得到响应时,称为缓存命中。
缓存命中率越高,缓存的利用率也就越高。
最大空间
缓存通常位于内存中,内存的空间通常比磁盘空间小的多,因此缓存的最大空间不可能非常大。
当缓存存放的数据量超过最大空间时,就需要淘汰部分数据来存放新到达的数据。
淘汰策略
- FIFO(First In First Out):先进先出策略,在实时性的场景下,需要经常访问最新的数据,那么就可以使用 FIFO,使得最先进入的数据(最晚的数据)被淘汰。
- LRU(Least Recently Used):最近最久未使用策略,优先淘汰最久未使用的数据,也就是上次被访问时间距离现在最久的数据。该策略可以保证内存中的数据都是热点数据,也就是经常被访问的数据,从而保证缓存命中率。
- LFU(Least Frequently Used):最不经常使用策略,优先淘汰一段时间内使用次数最少的数据。
二、缓存位置
浏览器
当 HTTP 响应允许进行缓存时,浏览器会将 HTML、CSS、JavaScript、图片等静态资源进行缓存。
ISP
网络服务提供商(ISP)是网络访问的第一跳,通过将数据缓存在 ISP 中能够大大提高用户的访问速度。
反向代理
反向代理位于服务器之前,请求与响应都需要经过反向代理。通过将数据缓存在反向代理,在用户请求反向代理时就可以直接使用缓存进行响应。
本地缓存
使用 Guava Cache 将数据缓存在服务器本地内存中,服务器代码可以直接读取本地内存中的缓存,速度非常快。
分布式缓存
使用 Redis、Memcache 等分布式缓存将数据缓存在分布式缓存系统中。
相对于本地缓存来说,分布式缓存单独部署,可以根据需求分配硬件资源。不仅如此,服务器集群都可以访问分布式缓存,而本地缓存需要在服务器集群之间进行同步,实现难度和性能开销上都非常大。
数据库缓存
MySQL 等数据库管理系统具有自己的查询缓存机制来提高查询效率。
Java 内部的缓存
Java 为了优化空间,提高字符串、基本数据类型包装类的创建效率,设计了字符串常量池及 Byte、Short、Character、Integer、Long、Boolean 这六种包装类缓冲池。
CPU 多级缓存
CPU 为了解决运算速度与主存 IO 速度不匹配的问题,引入了多级缓存结构,同时使用 MESI 等缓存一致性协议来解决多核 CPU 缓存数据一致性的问题。
三、CDN
内容分发网络(Content distribution network,CDN)是一种互连的网络系统,它利用更靠近用户的服务器从而更快更可靠地将 HTML、CSS、JavaScript、音乐、图片、视频等静态资源分发给用户。
CDN 主要有以下优点:
- 更快地将数据分发给用户;
- 通过部署多台服务器,从而提高系统整体的带宽性能;
- 多台服务器可以看成是一种冗余机制,从而具有高可用性。
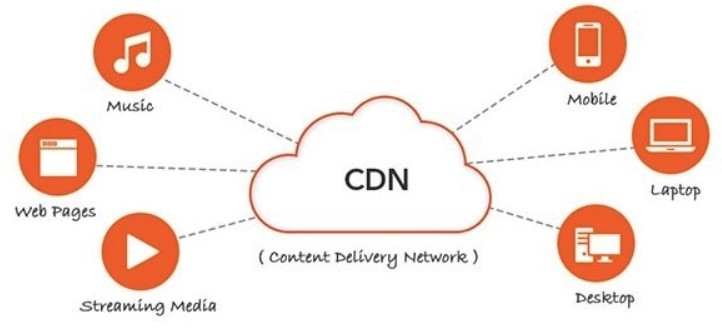
四、缓存问题
缓存穿透
指的是对某个一定不存在的数据进行请求,该请求将会穿透缓存到达数据库。
解决方案:
- 对这些不存在的数据缓存一个空数据;
- 对这类请求进行过滤。
缓存雪崩
指的是由于数据没有被加载到缓存中,或者缓存数据在同一时间大面积失效(过期),又或者缓存服务器宕机,导致大量的请求都到达数据库。
在有缓存的系统中,系统非常依赖于缓存,缓存分担了很大一部分的数据请求。当发生缓存雪崩时,数据库无法处理这么大的请求,导致数据库崩溃。
解决方案:
- 为了防止缓存在同一时间大面积过期导致的缓存雪崩,可以通过观察用户行为,合理设置缓存过期时间来实现;
- 为了防止缓存服务器宕机出现的缓存雪崩,可以使用分布式缓存,分布式缓存中每一个节点只缓存部分的数据,当某个节点宕机时可以保证其它节点的缓存仍然可用。
- 也可以进行缓存预热,避免在系统刚启动不久由于还未将大量数据进行缓存而导致缓存雪崩。
缓存一致性
缓存一致性要求数据更新的同时缓存数据也能够实时更新。
解决方案:
- 在数据更新的同时立即去更新缓存;
- 在读缓存之前先判断缓存是否是最新的,如果不是最新的先进行更新。
要保证缓存一致性需要付出很大的代价,缓存数据最好是那些对一致性要求不高的数据,允许缓存数据存在一些脏数据。
缓存 “无底洞” 现象
指的是为了满足业务要求添加了大量缓存节点,但是性能不但没有好转反而下降了的现象。
产生原因:缓存系统通常采用 hash 函数将 key 映射到对应的缓存节点,随着缓存节点数目的增加,键值分布到更多的节点上,导致客户端一次批量操作会涉及多次网络操作,这意味着批量操作的耗时会随着节点数目的增加而不断增大。此外,网络连接数变多,对节点的性能也有一定影响。
解决方案:
- 优化批量数据操作命令;
- 减少网络通信次数;
- 降低接入成本,使用长连接 / 连接池,NIO 等。
五、数据分布
哈希分布
哈希分布就是将数据计算哈希值之后,按照哈希值分配到不同的节点上。例如有 N 个节点,数据的主键为 key,则将该数据分配的节点序号为:hash(key)%N。
传统的哈希分布算法存在一个问题:当节点数量变化时,也就是 N 值变化,那么几乎所有的数据都需要重新分布,将导致大量的数据迁移。
顺序分布
将数据划分为多个连续的部分,按数据的 ID 或者时间分布到不同节点上。例如 User 表的 ID 范围为 1 \~ 7000,使用顺序分布可以将其划分成多个子表,对应的主键范围为 1 \~ 1000,1001 \~ 2000,...,6001 \~ 7000。
顺序分布相比于哈希分布的主要优点如下:
- 能保持数据原有的顺序;
- 并且能够准确控制每台服务器存储的数据量,从而使得存储空间的利用率最大。
六、一致性哈希
Distributed Hash Table(DHT) 是一种哈希分布方式,其目的是为了克服传统哈希分布在服务器节点数量变化时大量数据迁移的问题。
基本原理
将哈希空间 [0, 2n-1] 看成一个哈希环,每个服务器节点都配置到哈希环上。每个数据对象通过哈希取模得到哈希值之后,存放到哈希环中顺时针方向第一个大于等于该哈希值的节点上。
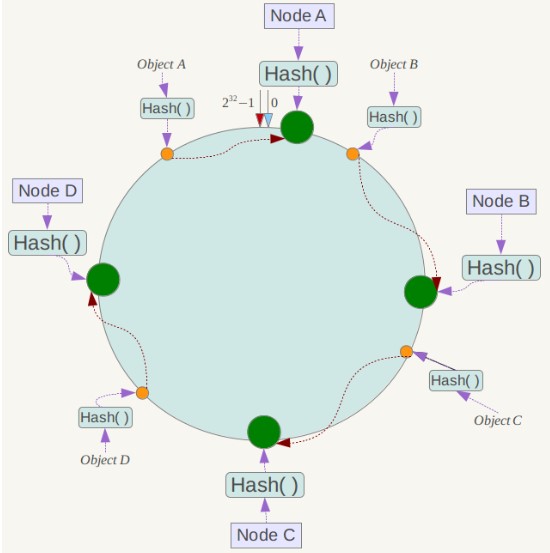
一致性哈希在增加或者删除节点时只会影响到哈希环中相邻的节点,例如下图中新增节点 X,只需要将它前一个节点 C 上的数据重新进行分布即可,对于节点 A、B、D 都没有影响。
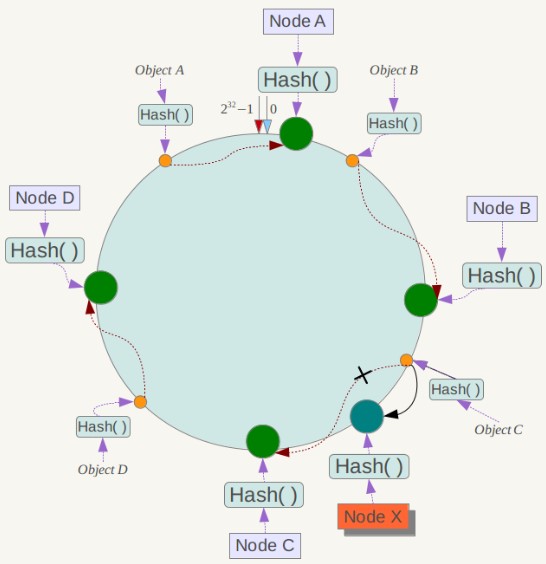
虚拟节点
上面描述的一致性哈希存在数据分布不均匀的问题,节点存储的数据量有可能会存在很大的不同。
数据不均匀主要是因为节点在哈希环上分布的不均匀,这种情况在节点数量很少的情况下尤其明显。
解决方式是通过增加虚拟节点,然后将虚拟节点映射到真实节点上。虚拟节点的数量比真实节点来得多,那么虚拟节点在哈希环上分布的均匀性就会比原来的真实节点好,从而使得数据分布也更加均匀。
七、LRU
以下是基于 双向链表 + HashMap 的 LRU 算法实现,对算法的解释如下:
- 访问某个节点时,将其从原来的位置删除,并重新插入到链表头部。这样就能保证链表尾部存储的就是最近最久未使用的节点,当节点数量大于缓存最大空间时就淘汰链表尾部的节点。
- 为了使删除操作时间复杂度为 O(1),就不能采用遍历的方式找到某个节点。HashMap 存储着 Key 到节点的映射,通过 Key 就能以 O(1) 的时间得到节点,然后再以 O(1) 的时间将其从双向队列中删除。
public class LRU<K, V> implements Iterable<K> {
private Node head;
private Node tail;
private HashMap<K, Node> map;
private int maxSize;
private class Node {
Node pre;
Node next;
K k;
V v;
public Node(K k, V v) {
this.k = k;
this.v = v;
}
}
public LRU(int maxSize) {
this.maxSize = maxSize;
this.map = new HashMap<>(maxSize * 4 / 3);
head = new Node(null, null);
tail = new Node(null, null);
head.next = tail;
tail.pre = head;
}
public V get(K key) {
if (!map.containsKey(key)) {
return null;
}
Node node = map.get(key);
unlink(node);
appendHead(node);
return node.v;
}
public void put(K key, V value) {
if (map.containsKey(key)) {
Node node = map.get(key);
unlink(node);
}
Node node = new Node(key, value);
map.put(key, node);
appendHead(node);
if (map.size() > maxSize) {
Node toRemove = removeTail();
map.remove(toRemove.k);
}
}
private void unlink(Node node) {
Node pre = node.pre;
Node next = node.next;
pre.next = next;
next.pre = pre;
node.pre = null;
node.next = null;
}
private void appendHead(Node node) {
Node next = head.next;
node.next = next;
next.pre = node;
node.pre = head;
head.next = node;
}
private Node removeTail() {
Node node = tail.pre;
Node pre = node.pre;
tail.pre = pre;
pre.next = tail;
node.pre = null;
node.next = null;
return node;
}
@Override
public Iterator<K> iterator() {
return new Iterator<K>() {
private Node cur = head.next;
@Override
public boolean hasNext() {
return cur != tail;
}
@Override
public K next() {
Node node = cur;
cur = cur.next;
return node.k;
}
};
}
}参考资料
消息队列
消息队列
* [一、消息模型](#一消息模型)
* [点对点](#点对点)
* [发布/订阅](#发布订阅)
* [二、使用场景](#二使用场景)
* [异步处理](#异步处理)
* [流量削锋](#流量削锋)
* [应用解耦](#应用解耦)
* [三、可靠性](#三可靠性)
* [发送端的可靠性](#发送端的可靠性)
* [接收端的可靠性](#接收端的可靠性)
* [参考资料](#参考资料)一、消息模型
点对点
消息生产者向消息队列中发送了一个消息之后,只能被一个消费者消费一次。
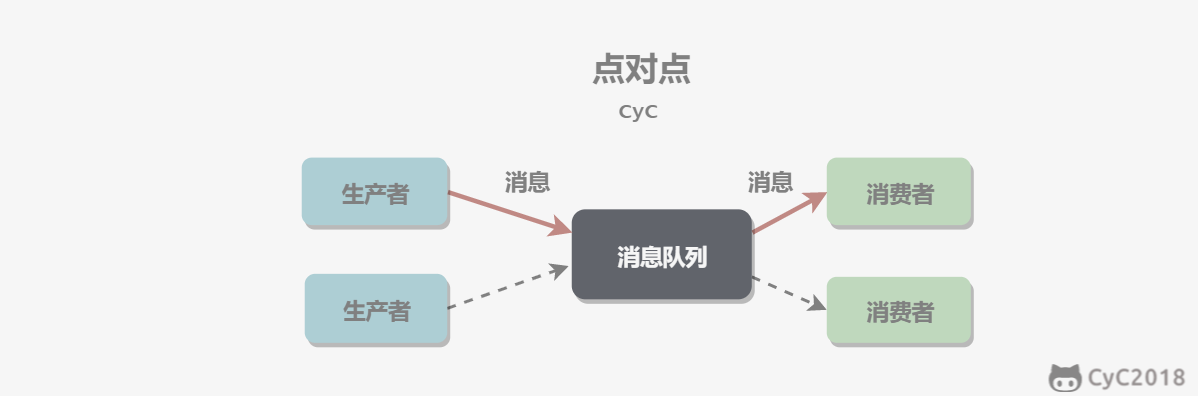
发布/订阅
消息生产者向频道发送一个消息之后,多个消费者可以从该频道订阅到这条消息并消费。
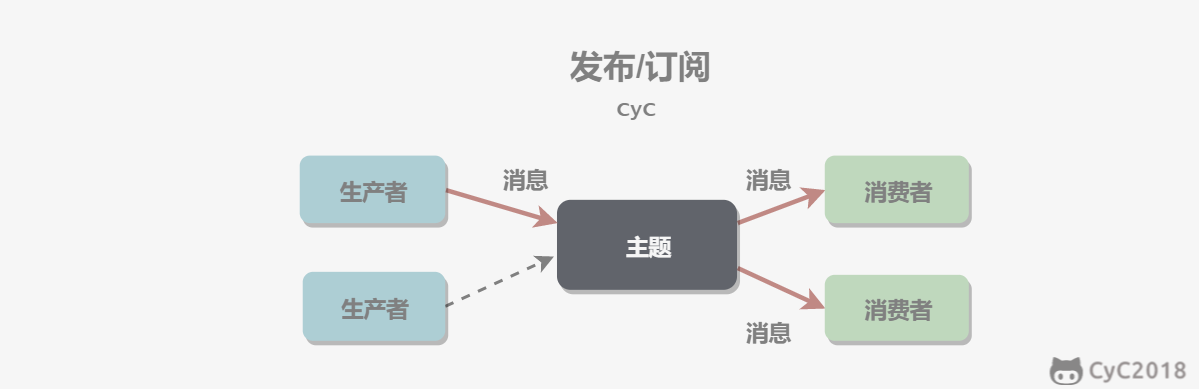
发布与订阅模式和观察者模式有以下不同:
- 观察者模式中,观察者和主题都知道对方的存在;而在发布与订阅模式中,生产者与消费者不知道对方的存在,它们之间通过频道进行通信。
- 观察者模式是同步的,当事件触发时,主题会调用观察者的方法,然后等待方法返回;而发布与订阅模式是异步的,生产者向频道发送一个消息之后,就不需要关心消费者何时去订阅这个消息,可以立即返回。
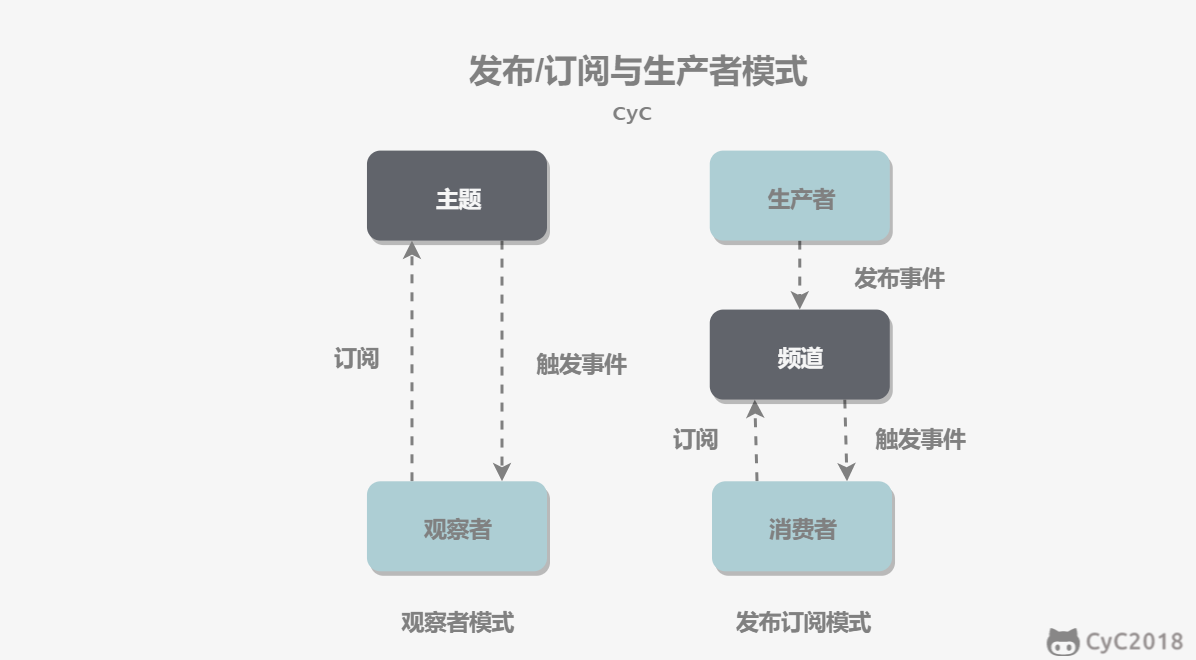
二、使用场景
异步处理
发送者将消息发送给消息队列之后,不需要同步等待消息接收者处理完毕,而是立即返回进行其它操作。消息接收者从消息队列中订阅消息之后异步处理。
例如在注册流程中通常需要发送验证邮件来确保注册用户身份的合法性,可以使用消息队列使发送验证邮件的操作异步处理,用户在填写完注册信息之后就可以完成注册,而将发送验证邮件这一消息发送到消息队列中。
只有在业务流程允许异步处理的情况下才能这么做,例如上面的注册流程中,如果要求用户对验证邮件进行点击之后才能完成注册的话,就不能再使用消息队列。
流量削锋
在高并发的场景下,如果短时间有大量的请求到达会压垮服务器。
可以将请求发送到消息队列中,服务器按照其处理能力从消息队列中订阅消息进行处理。
应用解耦
如果模块之间不直接进行调用,模块之间耦合度就会很低,那么修改一个模块或者新增一个模块对其它模块的影响会很小,从而实现可扩展性。
通过使用消息队列,一个模块只需要向消息队列中发送消息,其它模块可以选择性地从消息队列中订阅消息从而完成调用。
三、可靠性
发送端的可靠性
发送端完成操作后一定能将消息成功发送到消息队列中。
实现方法:在本地数据库建一张消息表,将消息数据与业务数据保存在同一数据库实例里,这样就可以利用本地数据库的事务机制。事务提交成功后,将消息表中的消息转移到消息队列中,若转移消息成功则删除消息表中的数据,否则继续重传。
接收端的可靠性
接收端能够从消息队列成功消费一次消息。
两种实现方法:
- 保证接收端处理消息的业务逻辑具有幂等性:只要具有幂等性,那么消费多少次消息,最后处理的结果都是一样的。
- 保证消息具有唯一编号,并使用一张日志表来记录已经消费的消息编号。
参考资料
面向对象思想
面向对象思想
* [一、三大特性](#一三大特性)
* [封装](#封装)
* [继承](#继承)
* [多态](#多态)
* [二、类图](#二类图)
* [泛化关系 (Generalization)](#泛化关系-generalization)
* [实现关系 (Realization)](#实现关系-realization)
* [聚合关系 (Aggregation)](#聚合关系-aggregation)
* [组合关系 (Composition)](#组合关系-composition)
* [关联关系 (Association)](#关联关系-association)
* [依赖关系 (Dependency)](#依赖关系-dependency)
* [三、设计原则](#三设计原则)
* [S.O.L.I.D](#solid)
* [其他常见原则](#其他常见原则)
* [参考资料](#参考资料)一、三大特性
封装
利用抽象数据类型将数据和基于数据的操作封装在一起,使其构成一个不可分割的独立实体。数据被保护在抽象数据类型的内部,尽可能地隐藏内部的细节,只保留一些对外的接口使其与外部发生联系。用户无需关心对象内部的细节,但可以通过对象对外提供的接口来访问该对象。
优点:
- 减少耦合:可以独立地开发、测试、优化、使用、理解和修改
- 减轻维护的负担:可以更容易被理解,并且在调试的时候可以不影响其他模块
- 有效地调节性能:可以通过剖析来确定哪些模块影响了系统的性能
- 提高软件的可重用性
- 降低了构建大型系统的风险:即使整个系统不可用,但是这些独立的模块却有可能是可用的
以下 Person 类封装 name、gender、age 等属性,外界只能通过 get() 方法获取一个 Person 对象的 name 属性和 gender 属性,而无法获取 age 属性,但是 age 属性可以供 work() 方法使用。
注意到 gender 属性使用 int 数据类型进行存储,封装使得用户注意不到这种实现细节。并且在需要修改 gender 属性使用的数据类型时,也可以在不影响客户端代码的情况下进行。
public class Person {
private String name;
private int gender;
private int age;
public String getName() {
return name;
}
public String getGender() {
return gender == 0 ? "man" : "woman";
}
public void work() {
if (18 <= age && age <= 50) {
System.out.println(name + " is working very hard!");
} else {
System.out.println(name + " can't work any more!");
}
}
}继承
继承实现了 IS-A 关系,例如 Cat 和 Animal 就是一种 IS-A 关系,因此 Cat 可以继承自 Animal,从而获得 Animal 非 private 的属性和方法。
继承应该遵循里氏替换原则,子类对象必须能够替换掉所有父类对象。
Cat 可以当做 Animal 来使用,也就是说可以使用 Animal 引用 Cat 对象。父类引用指向子类对象称为 向上转型 。
Animal animal = new Cat();多态
多态分为编译时多态和运行时多态:
- 编译时多态主要指方法的重载
- 运行时多态指程序中定义的对象引用所指向的具体类型在运行期间才确定
运行时多态有三个条件:
- 继承
- 覆盖(重写)
- 向上转型
下面的代码中,乐器类(Instrument)有两个子类:Wind 和 Percussion,它们都覆盖了父类的 play() 方法,并且在 main() 方法中使用父类 Instrument 来引用 Wind 和 Percussion 对象。在 Instrument 引用调用 play() 方法时,会执行实际引用对象所在类的 play() 方法,而不是 Instrument 类的方法。
public class Instrument {
public void play() {
System.out.println("Instument is playing...");
}
}public class Wind extends Instrument {
public void play() {
System.out.println("Wind is playing...");
}
}public class Percussion extends Instrument {
public void play() {
System.out.println("Percussion is playing...");
}
}public class Music {
public static void main(String[] args) {
List<Instrument> instruments = new ArrayList<>();
instruments.add(new Wind());
instruments.add(new Percussion());
for(Instrument instrument : instruments) {
instrument.play();
}
}
}Wind is playing...
Percussion is playing...二、类图
以下类图使用 PlantUML 绘制,更多语法及使用请参考:http://plantuml.com/ 。
泛化关系 (Generalization)
用来描述继承关系,在 Java 中使用 extends 关键字。
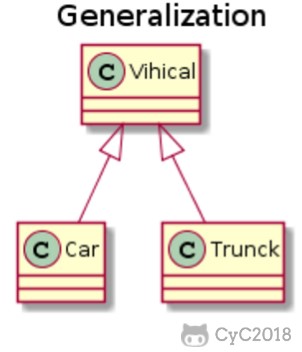
@startuml
title Generalization
class Vihical
class Car
class Trunck
Vihical <|-- Car
Vihical <|-- Trunck
@enduml实现关系 (Realization)
用来实现一个接口,在 Java 中使用 implements 关键字。
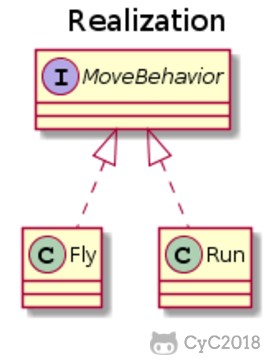
@startuml
title Realization
interface MoveBehavior
class Fly
class Run
MoveBehavior <|.. Fly
MoveBehavior <|.. Run
@enduml聚合关系 (Aggregation)
表示整体由部分组成,但是整体和部分不是强依赖的,整体不存在了部分还是会存在。
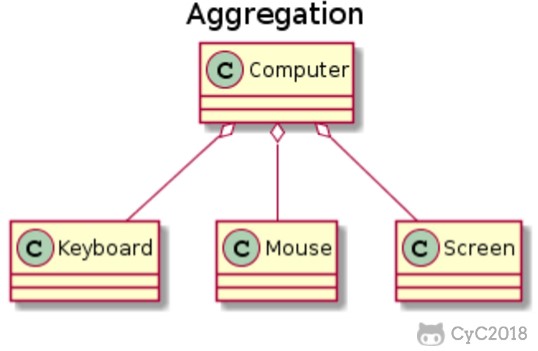
@startuml
title Aggregation
class Computer
class Keyboard
class Mouse
class Screen
Computer o-- Keyboard
Computer o-- Mouse
Computer o-- Screen
@enduml组合关系 (Composition)
和聚合不同,组合中整体和部分是强依赖的,整体不存在了部分也不存在了。比如公司和部门,公司没了部门就不存在了。但是公司和员工就属于聚合关系了,因为公司没了员工还在。

@startuml
title Composition
class Company
class DepartmentA
class DepartmentB
Company *-- DepartmentA
Company *-- DepartmentB
@enduml关联关系 (Association)
表示不同类对象之间有关联,这是一种静态关系,与运行过程的状态无关,在最开始就可以确定。因此也可以用 1 对 1、多对 1、多对多这种关联关系来表示。比如学生和学校就是一种关联关系,一个学校可以有很多学生,但是一个学生只属于一个学校,因此这是一种多对一的关系,在运行开始之前就可以确定。

@startuml
title Association
class School
class Student
School "1" - "n" Student
@enduml依赖关系 (Dependency)
和关联关系不同的是,依赖关系是在运行过程中起作用的。A 类和 B 类是依赖关系主要有三种形式:
- A 类是 B 类方法的局部变量;
- A 类是 B 类方法的参数;
- A 类向 B 类发送消息,从而影响 B 类发生变化。
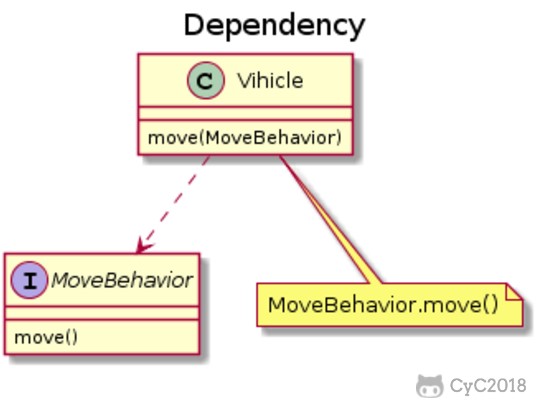
@startuml
title Dependency
class Vihicle {
move(MoveBehavior)
}
interface MoveBehavior {
move()
}
note "MoveBehavior.move()" as N
Vihicle ..> MoveBehavior
Vihicle .. N
@enduml三、设计原则
S.O.L.I.D
| 简写 | 全拼 | 中文翻译 |
|---|---|---|
| SRP | The Single Responsibility Principle | 单一责任原则 |
| OCP | The Open Closed Principle | 开放封闭原则 |
| LSP | The Liskov Substitution Principle | 里氏替换原则 |
| ISP | The Interface Segregation Principle | 接口分离原则 |
| DIP | The Dependency Inversion Principle | 依赖倒置原则 |
1. 单一责任原则
修改一个类的原因应该只有一个。
换句话说就是让一个类只负责一件事,当这个类需要做过多事情的时候,就需要分解这个类。
如果一个类承担的职责过多,就等于把这些职责耦合在了一起,一个职责的变化可能会削弱这个类完成其它职责的能力。
2. 开放封闭原则
类应该对扩展开放,对修改关闭。
扩展就是添加新功能的意思,因此该原则要求在添加新功能时不需要修改代码。
符合开闭原则最典型的设计模式是装饰者模式,它可以动态地将责任附加到对象上,而不用去修改类的代码。
3. 里氏替换原则
子类对象必须能够替换掉所有父类对象。
继承是一种 IS-A 关系,子类需要能够当成父类来使用,并且需要比父类更特殊。
如果不满足这个原则,那么各个子类的行为上就会有很大差异,增加继承体系的复杂度。
4. 接口分离原则
不应该强迫客户依赖于它们不用的方法。
因此使用多个专门的接口比使用单一的总接口要好。
5. 依赖倒置原则
高层模块不应该依赖于低层模块,二者都应该依赖于抽象;抽象不应该依赖于细节,细节应该依赖于抽象。
高层模块包含一个应用程序中重要的策略选择和业务模块,如果高层模块依赖于低层模块,那么低层模块的改动就会直接影响到高层模块,从而迫使高层模块也需要改动。
依赖于抽象意味着:
- 任何变量都不应该持有一个指向具体类的指针或者引用;
- 任何类都不应该从具体类派生;
- 任何方法都不应该覆写它的任何基类中的已经实现的方法。
其他常见原则
除了上述的经典原则,在实际开发中还有下面这些常见的设计原则。
| 简写 | 全拼 | 中文翻译 |
|---|---|---|
| LOD | The Law of Demeter | 迪米特法则 |
| CRP | The Composite Reuse Principle | 合成复用原则 |
| CCP | The Common Closure Principle | 共同封闭原则 |
| SAP | The Stable Abstractions Principle | 稳定抽象原则 |
| SDP | The Stable Dependencies Principle | 稳定依赖原则 |
1. 迪米特法则
迪米特法则又叫作最少知识原则(Least Knowledge Principle,简写 LKP),就是说一个对象应当对其他对象有尽可能少的了解,不和陌生人说话。
2. 合成复用原则
尽量使用对象组合,而不是通过继承来达到复用的目的。
3. 共同封闭原则
一起修改的类,应该组合在一起(同一个包里)。如果必须修改应用程序里的代码,我们希望所有的修改都发生在一个包里(修改关闭),而不是遍布在很多包里。
4. 稳定抽象原则
最稳定的包应该是最抽象的包,不稳定的包应该是具体的包,即包的抽象程度跟它的稳定性成正比。
5. 稳定依赖原则
包之间的依赖关系都应该是稳定方向依赖的,包要依赖的包要比自己更具有稳定性。
参考资料
- Java 编程思想
- 敏捷软件开发:原则、模式与实践
- 面向对象设计的 SOLID 原则
- 看懂 UML 类图和时序图
- UML 系列——时序图(顺序图)sequence diagram
- 面向对象编程三大特性 ------ 封装、继承、多态
Git
Git
* [集中式与分布式](#集中式与分布式)
* [中心服务器](#中心服务器)
* [工作流](#工作流)
* [分支实现](#分支实现)
* [冲突](#冲突)
* [Fast forward](#fast-forward)
* [储藏(Stashing)](#储藏stashing)
* [SSH 传输设置](#ssh-传输设置)
* [.gitignore 文件](#gitignore-文件)
* [Git 命令一览](#git-命令一览)
* [参考资料](#参考资料)集中式与分布式
Git 属于分布式版本控制系统,而 SVN 属于集中式。
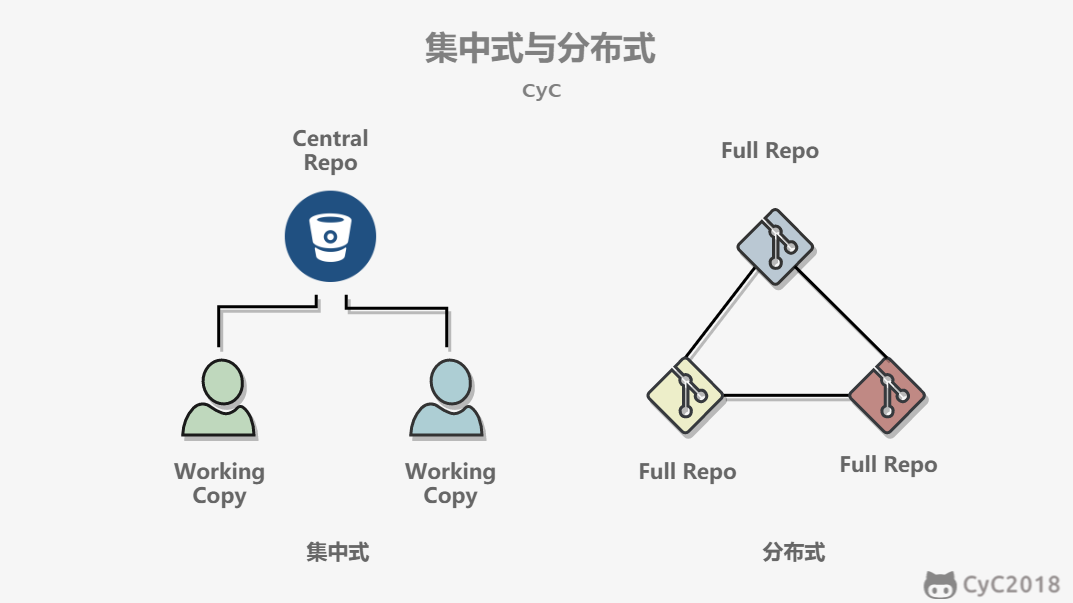
集中式版本控制只有中心服务器拥有一份代码,而分布式版本控制每个人的电脑上就有一份完整的代码。
集中式版本控制有安全性问题,当中心服务器挂了所有人都没办法工作了。
集中式版本控制需要连网才能工作,如果网速过慢,那么提交一个文件会慢的无法让人忍受。而分布式版本控制不需要连网就能工作。
分布式版本控制新建分支、合并分支操作速度非常快,而集中式版本控制新建一个分支相当于复制一份完整代码。
中心服务器
中心服务器用来交换每个用户的修改,没有中心服务器也能工作,但是中心服务器能够 24 小时保持开机状态,这样就能更方便的交换修改。
Github 就是一个中心服务器。
工作流
新建一个仓库之后,当前目录就成为了工作区,工作区下有一个隐藏目录 .git,它属于 Git 的版本库。
Git 的版本库有一个称为 Stage 的暂存区以及最后的 History 版本库,History 存储所有分支信息,使用一个 HEAD 指针指向当前分支。
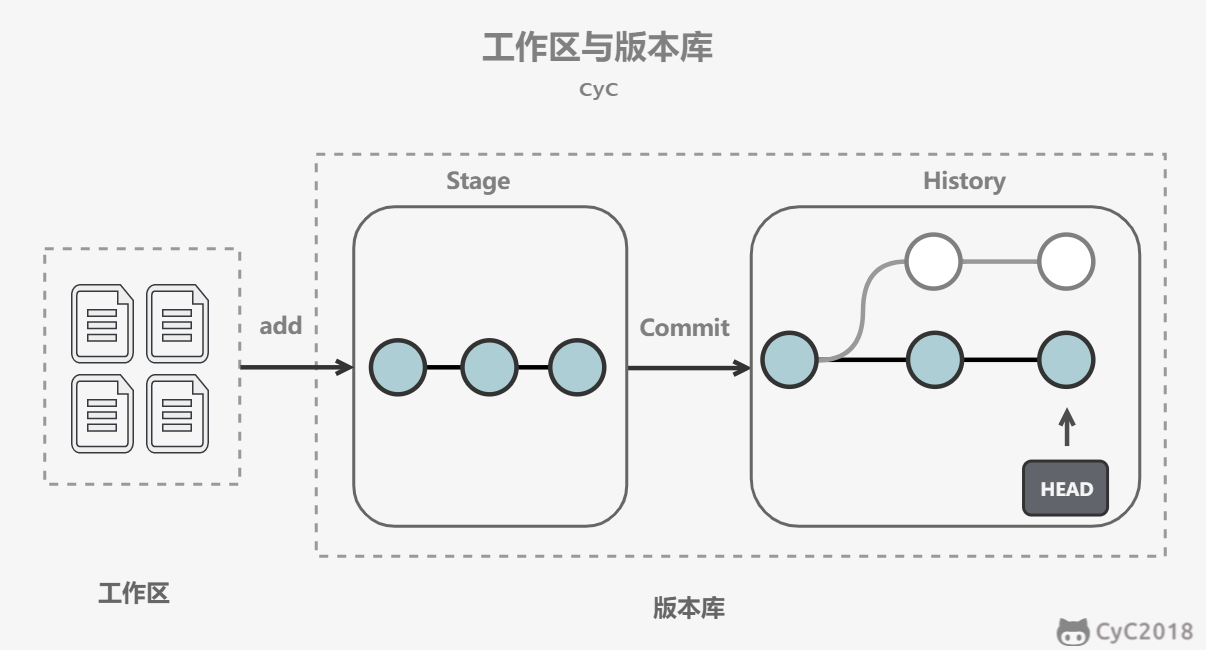
- git add files 把文件的修改添加到暂存区
- git commit 把暂存区的修改提交到当前分支,提交之后暂存区就被清空了
- git reset -- files 使用当前分支上的修改覆盖暂存区,用来撤销最后一次 git add files
- git checkout -- files 使用暂存区的修改覆盖工作目录,用来撤销本地修改
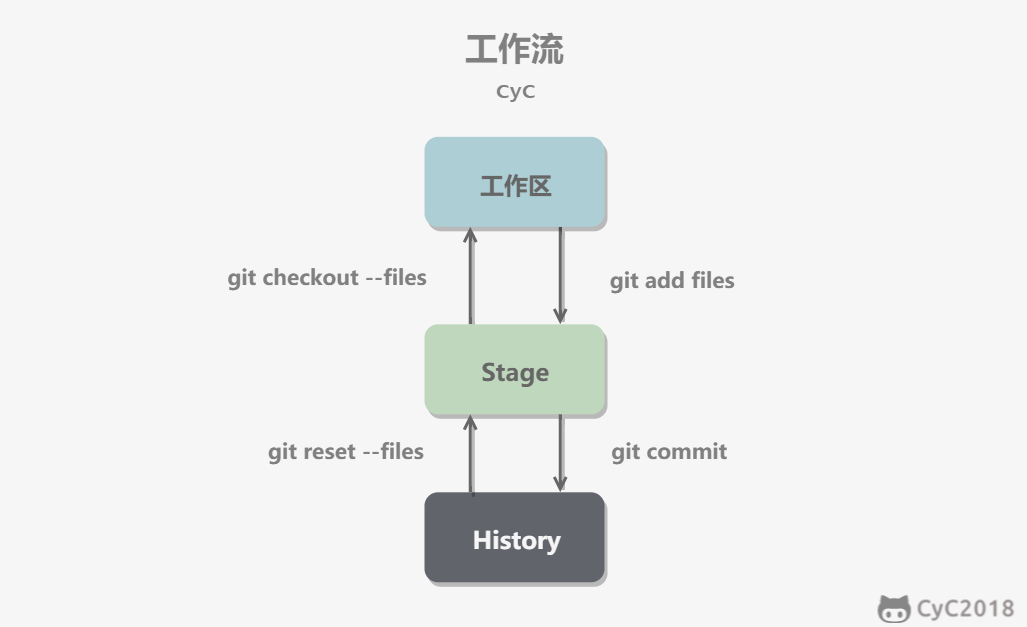
可以跳过暂存区域直接从分支中取出修改,或者直接提交修改到分支中。
- git commit -a 直接把所有文件的修改添加到暂存区然后执行提交
- git checkout HEAD -- files 取出最后一次修改,可以用来进行回滚操作
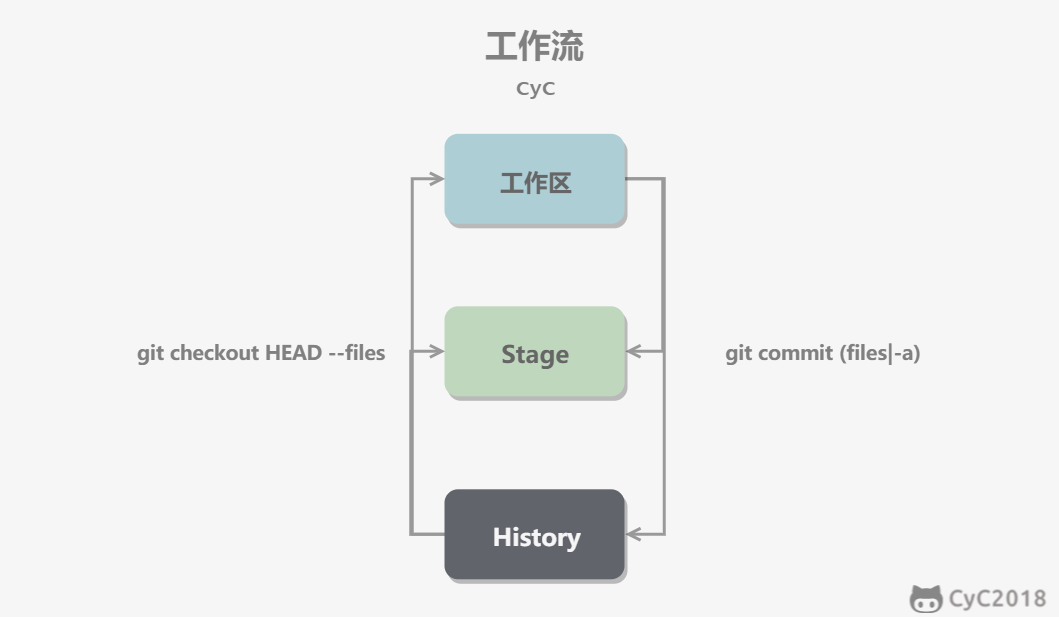
分支实现
使用指针将每个提交连接成一条时间线,HEAD 指针指向当前分支指针。
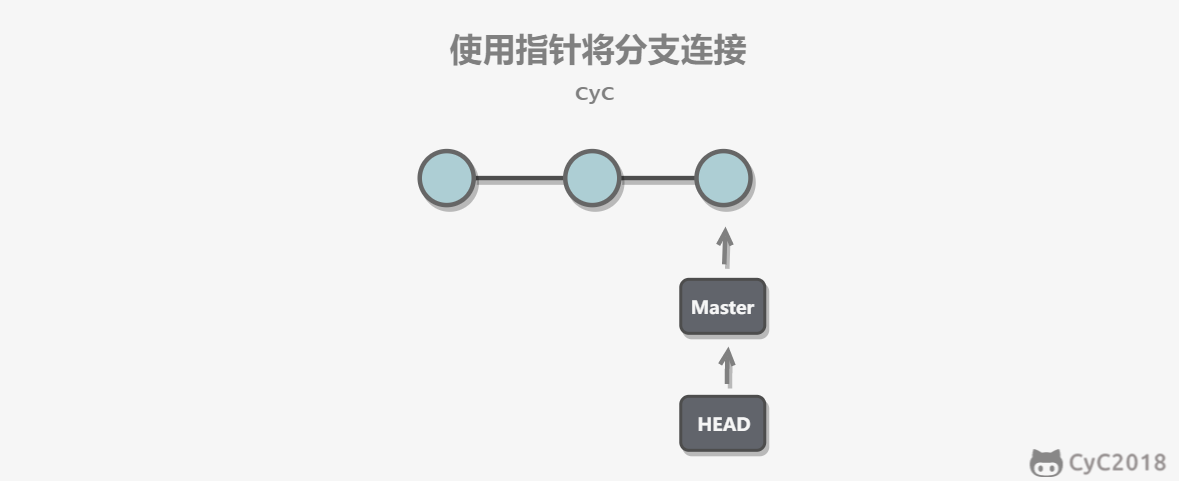
新建分支是新建一个指针指向时间线的最后一个节点,并让 HEAD 指针指向新分支,表示新分支成为当前分支。
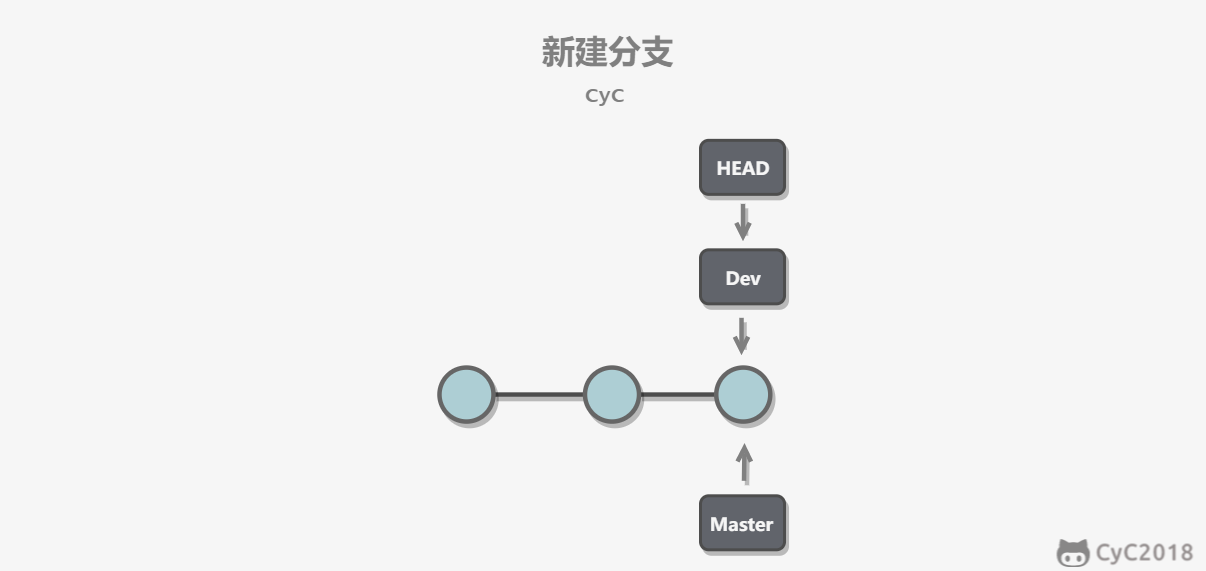
每次提交只会让当前分支指针向前移动,而其它分支指针不会移动。
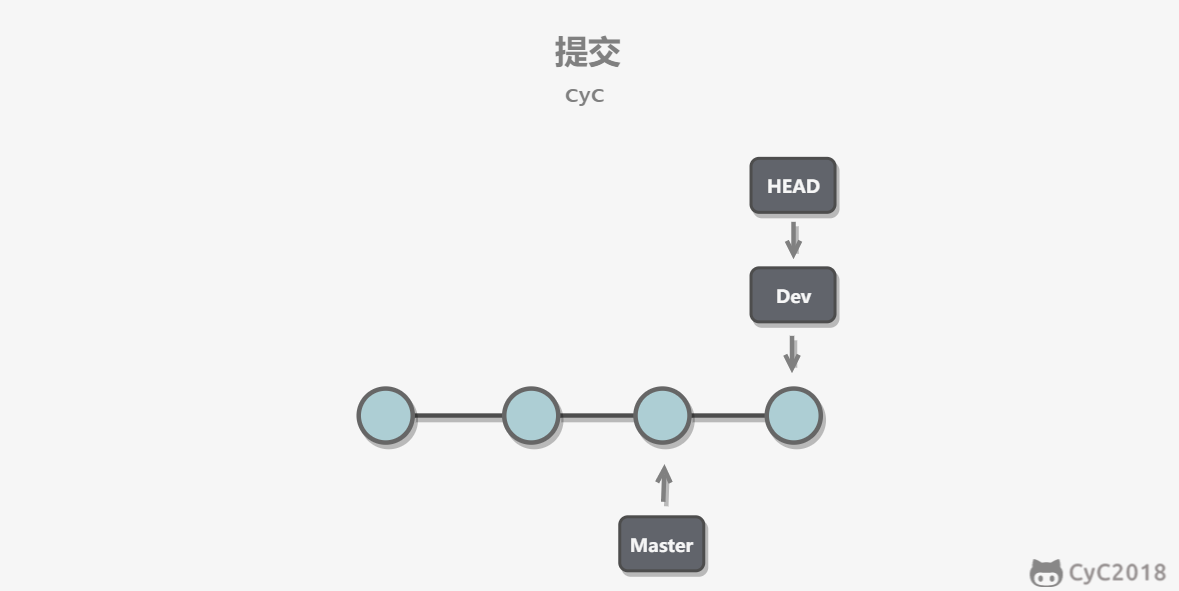
合并分支也只需要改变指针即可。
冲突
当两个分支都对同一个文件的同一行进行了修改,在分支合并时就会产生冲突。
Git 会使用 \<\<\<\<\<\<\< ,======= ,\>\>\>\>\>\>\> 标记出不同分支的内容,只需要把不同分支中冲突部分修改成一样就能解决冲突。
<<<<<<< HEAD
Creating a new branch is quick & simple.
=======
Creating a new branch is quick AND simple.
>>>>>>> feature1Fast forward
"快进式合并"(fast-farward merge),会直接将 master 分支指向合并的分支,这种模式下进行分支合并会丢失分支信息,也就不能在分支历史上看出分支信息。
可以在合并时加上 --no-ff 参数来禁用 Fast forward 模式,并且加上 -m 参数让合并时产生一个新的 commit。
$ git merge --no-ff -m "merge with no-ff" dev
储藏(Stashing)
在一个分支上操作之后,如果还没有将修改提交到分支上,此时进行切换分支,那么另一个分支上也能看到新的修改。这是因为所有分支都共用一个工作区的缘故。
可以使用 git stash 将当前分支的修改储藏起来,此时当前工作区的所有修改都会被存到栈中,也就是说当前工作区是干净的,没有任何未提交的修改。此时就可以安全的切换到其它分支上了。
$ git stash
Saved working directory and index state \ "WIP on master: 049d078 added the index file"
HEAD is now at 049d078 added the index file (To restore them type "git stash apply")该功能可以用于 bug 分支的实现。如果当前正在 dev 分支上进行开发,但是此时 master 上有个 bug 需要修复,但是 dev 分支上的开发还未完成,不想立即提交。在新建 bug 分支并切换到 bug 分支之前就需要使用 git stash 将 dev 分支的未提交修改储藏起来。
SSH 传输设置
Git 仓库和 Github 中心仓库之间的传输是通过 SSH 加密。
如果工作区下没有 .ssh 目录,或者该目录下没有 id_rsa 和 id_rsa.pub 这两个文件,可以通过以下命令来创建 SSH Key:
$ ssh-keygen -t rsa -C "youremail@example.com"然后把公钥 id_rsa.pub 的内容复制到 Github "Account settings" 的 SSH Keys 中。
.gitignore 文件
忽略以下文件:
- 操作系统自动生成的文件,比如缩略图;
- 编译生成的中间文件,比如 Java 编译产生的 .class 文件;
- 自己的敏感信息,比如存放口令的配置文件。
不需要全部自己编写,可以到 https://github.com/github/gitignore 中进行查询。
Git 命令一览
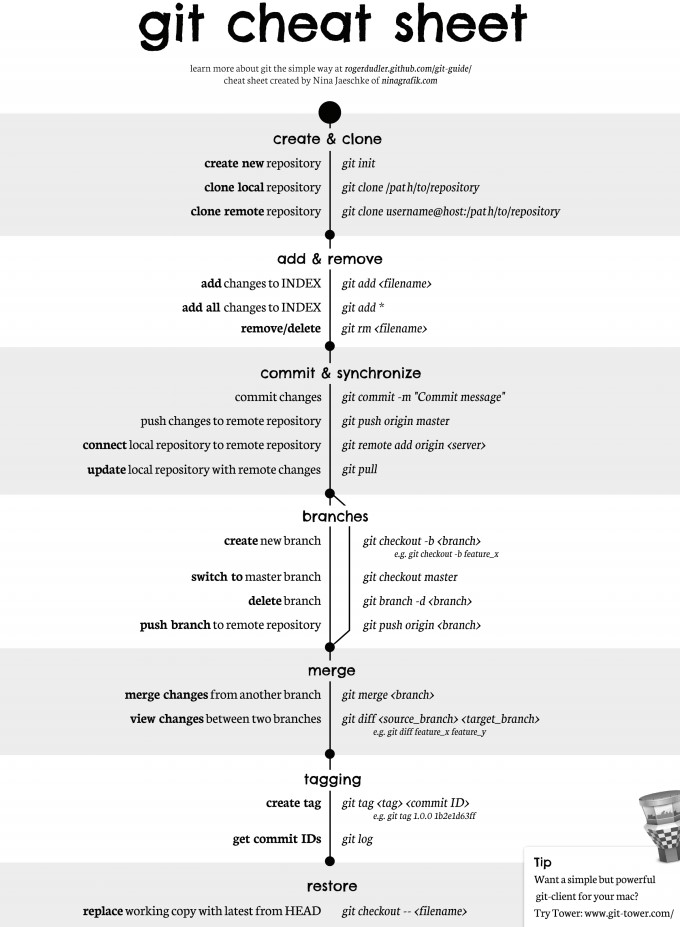
比较详细的地址:http://www.cheat-sheets.org/saved-copy/git-cheat-sheet.pdf
参考资料
Docker
Docker
* [一、解决的问题](#一解决的问题)
* [二、与虚拟机的比较](#二与虚拟机的比较)
* [三、优势](#三优势)
* [四、使用场景](#四使用场景)
* [五、镜像与容器](#五镜像与容器)
* [参考资料](#参考资料)一、解决的问题
由于不同的机器有不同的操作系统,以及不同的库和组件,在将一个应用部署到多台机器上需要进行大量的环境配置操作。
Docker 主要解决环境配置问题,它是一种虚拟化技术,对进程进行隔离,被隔离的进程独立于宿主操作系统和其它隔离的进程。使用 Docker 可以不修改应用程序代码,不需要开发人员学习特定环境下的技术,就能够将现有的应用程序部署在其它机器上。
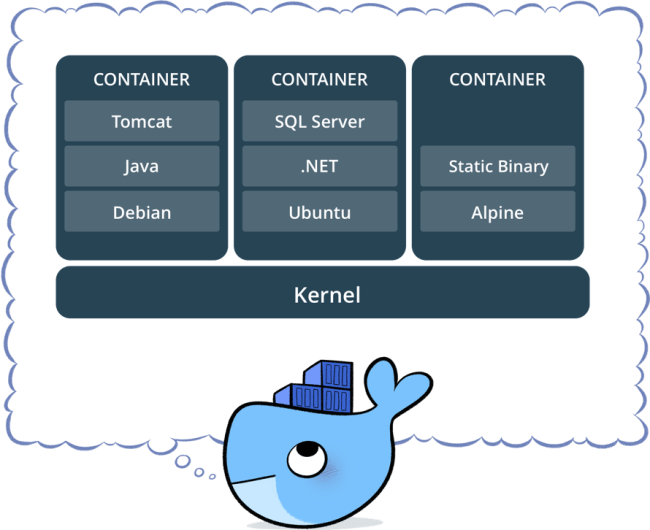
二、与虚拟机的比较
虚拟机也是一种虚拟化技术,它与 Docker 最大的区别在于它是通过模拟硬件,并在硬件上安装操作系统来实现。
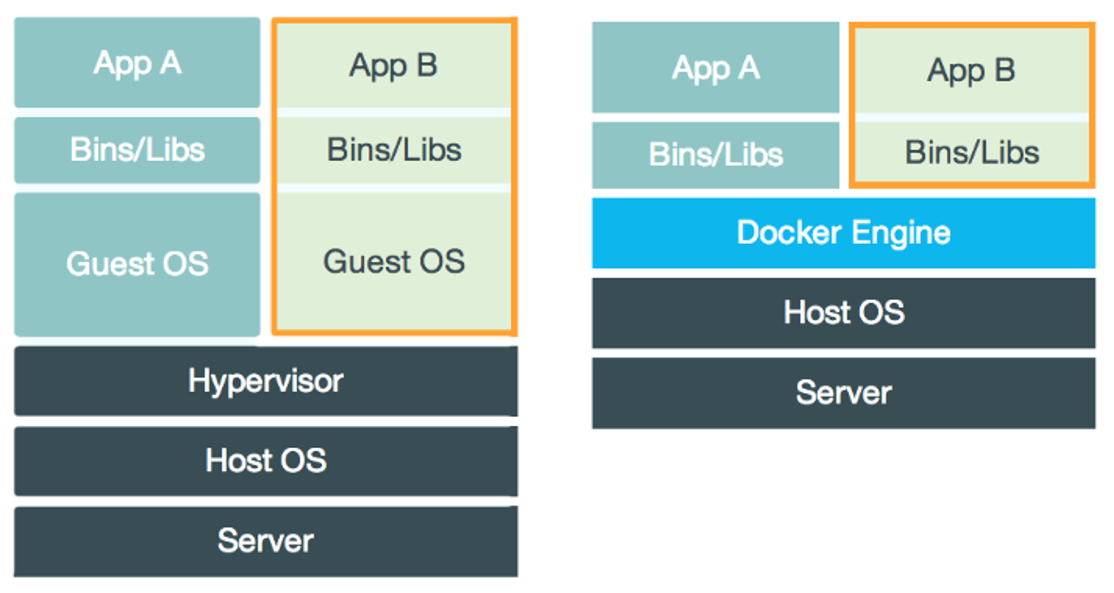
启动速度
启动虚拟机需要先启动虚拟机的操作系统,再启动应用,这个过程非常慢;
而启动 Docker 相当于启动宿主操作系统上的一个进程。
占用资源
虚拟机是一个完整的操作系统,需要占用大量的磁盘、内存和 CPU 资源,一台机器只能开启几十个的虚拟机。
而 Docker 只是一个进程,只需要将应用以及相关的组件打包,在运行时占用很少的资源,一台机器可以开启成千上万个 Docker。
三、优势
除了启动速度快以及占用资源少之外,Docker 具有以下优势:
更容易迁移
提供一致性的运行环境。已经打包好的应用可以在不同的机器上进行迁移,而不用担心环境变化导致无法运行。
更容易维护
使用分层技术和镜像,使得应用可以更容易复用重复的部分。复用程度越高,维护工作也越容易。
更容易扩展
可以使用基础镜像进一步扩展得到新的镜像,并且官方和开源社区提供了大量的镜像,通过扩展这些镜像可以非常容易得到我们想要的镜像。
四、使用场景
持续集成
持续集成指的是频繁地将代码集成到主干上,这样能够更快地发现错误。
Docker 具有轻量级以及隔离性的特点,在将代码集成到一个 Docker 中不会对其它 Docker 产生影响。
提供可伸缩的云服务
根据应用的负载情况,可以很容易地增加或者减少 Docker。
搭建微服务架构
Docker 轻量级的特点使得它很适合用于部署、维护、组合微服务。
五、镜像与容器
镜像是一种静态的结构,可以看成面向对象里面的类,而容器是镜像的一个实例。
镜像包含着容器运行时所需要的代码以及其它组件,它是一种分层结构,每一层都是只读的(read-only layers)。构建镜像时,会一层一层构建,前一层是后一层的基础。镜像的这种分层存储结构很适合镜像的复用以及定制。
构建容器时,通过在镜像的基础上添加一个可写层(writable layer),用来保存着容器运行过程中的修改。
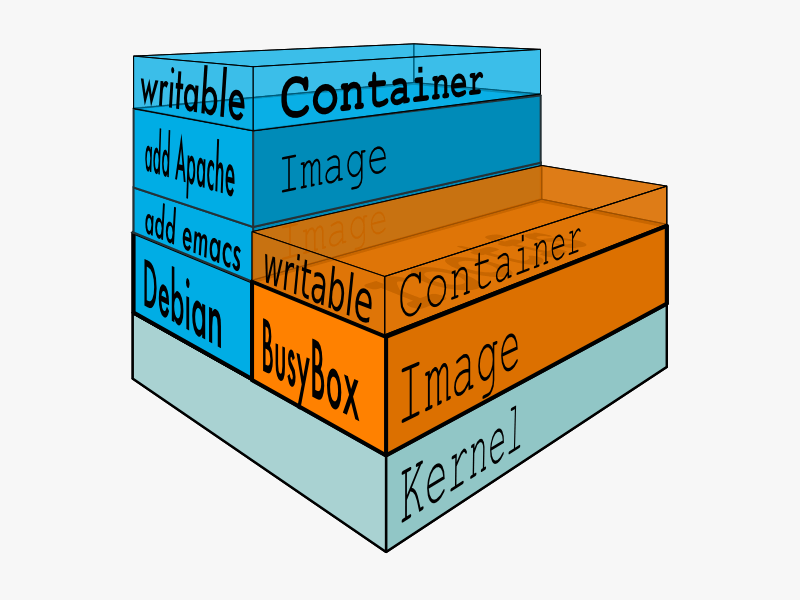
参考资料
- DOCKER 101: INTRODUCTION TO DOCKER WEBINAR RECAP
- Docker 入门教程
- Docker container vs Virtual machine
- How to Create Docker Container using Dockerfile
- 理解 Docker(2):Docker 镜像
- 为什么要使用 Docker?
- What is Docker
- 持续集成是什么?
构建工具
构建工具
* [一、构建工具的作用](#一构建工具的作用)
* [二、Java 主流构建工具](#二java-主流构建工具)
* [三、Maven](#三maven)
* [参考资料](#参考资料)一、构建工具的作用
构建一个项目通常包含了依赖管理、测试、编译、打包、发布等流程,构建工具可以自动化进行这些操作,从而为我们减少这些繁琐的工作。
其中构建工具提供的依赖管理能够可以自动处理依赖关系。例如一个项目需要用到依赖 A,A 又依赖于 B,那么构建工具就能帮我们导入 B,而不需要我们手动去寻找并导入。
在 Java 项目中,打包流程通常是将项目打包成 Jar 包。在没有构建工具的情况下,我们需要使用命令行工具或者 IDE 手动打包。而发布流程通常是将 Jar 包上传到服务器上。
二、Java 主流构建工具
Ant 具有编译、测试和打包功能,其后出现的 Maven 在 Ant 的功能基础上又新增了依赖管理功能,而最新的 Gradle 又在 Maven 的功能基础上新增了对 Groovy 语言的支持。
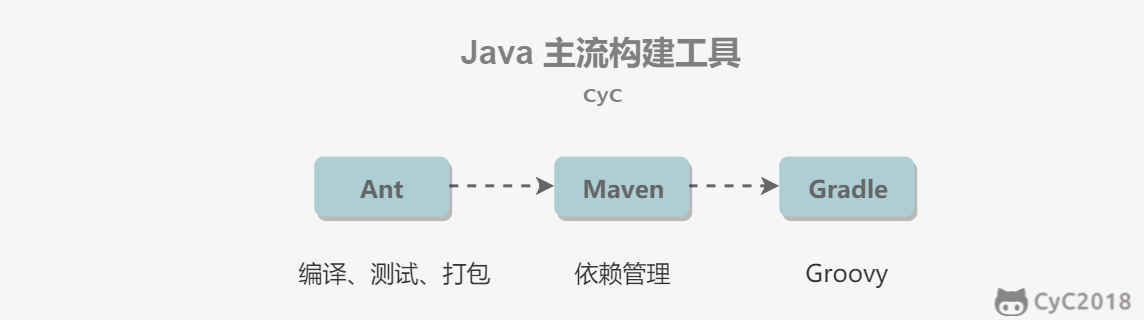
Gradle 和 Maven 的区别是,它使用 Groovy 这种特定领域语言(DSL)来管理构建脚本,而不再使用 XML 这种标记性语言。因为项目如果庞大的话,XML 很容易就变得臃肿。
例如要在项目中引入 Junit,Maven 的代码如下:
<?xml version="1.0" encoding="UTF-8"?>
<project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd">
<modelVersion>4.0.0</modelVersion>
<groupId>jizg.study.maven.hello</groupId>
<artifactId>hello-first</artifactId>
<version>0.0.1-SNAPSHOT</version>
<dependencies>
<dependency>
<groupId>junit</groupId>
<artifactId>junit</artifactId>
<version>4.10</version>
<scope>test</scope>
</dependency>
</dependencies>
</project>而 Gradle 只需要几行代码:
dependencies {
testCompile "junit:junit:4.10"
}三、Maven
概述
提供了项目对象模型(POM)文件来管理项目的构建。
仓库
仓库的搜索顺序为:本地仓库、中央仓库、远程仓库。
- 本地仓库用来存储项目的依赖库;
- 中央仓库是下载依赖库的默认位置;
- 远程仓库,因为并非所有的依赖库都在中央仓库,或者中央仓库访问速度很慢,远程仓库是中央仓库的补充。
POM
POM 代表项目对象模型,它是一个 XML 文件,保存在项目根目录的 pom.xml 文件中。
<dependency>
<groupId>junit</groupId>
<artifactId>junit</artifactId>
<version>4.12</version>
<scope>test</scope>
</dependency>[groupId, artifactId, version, packaging, classifier] 称为一个项目的坐标,其中 groupId、artifactId、version 必须定义,packaging 可选(默认为 Jar),classifier 不能直接定义的,需要结合插件使用。
- groupId:项目组 Id,必须全球唯一;
- artifactId:项目 Id,即项目名;
- version:项目版本;
- packaging:项目打包方式。
依赖原则
1. 依赖路径最短优先原则
A -> B -> C -> X(1.0)
A -> D -> X(2.0)由于 X(2.0) 路径最短,所以使用 X(2.0)。
2. 声明顺序优先原则
A -> B -> X(1.0)
A -> C -> X(2.0)在 POM 中最先声明的优先,上面的两个依赖如果先声明 B,那么最后使用 X(1.0)。
3. 覆写优先原则
子 POM 内声明的依赖优先于父 POM 中声明的依赖。
解决依赖冲突
找到 Maven 加载的 Jar 包版本,使用 mvn dependency:tree 查看依赖树,根据依赖原则来调整依赖在 POM 文件的声明顺序。
参考资料
- POM Reference
- What is a build tool?
- Java Build Tools Comparisons: Ant vs Maven vs Gradle
- maven 2 gradle
- 新一代构建工具 gradle
正则表达式
正则表达式
* [一、概述](#一概述)
* [二、匹配单个字符](#二匹配单个字符)
* [三、匹配一组字符](#三匹配一组字符)
* [四、使用元字符](#四使用元字符)
* [五、重复匹配](#五重复匹配)
* [六、位置匹配](#六位置匹配)
* [七、使用子表达式](#七使用子表达式)
* [八、回溯引用](#八回溯引用)
* [九、前后查找](#九前后查找)
* [十、嵌入条件](#十嵌入条件)
* [参考资料](#参考资料)一、概述
正则表达式用于文本内容的查找和替换。
正则表达式内置于其它语言或者软件产品中,它本身不是一种语言或者软件。
二、匹配单个字符
. 可以用来匹配任何的单个字符,但是在绝大多数实现里面,不能匹配换行符;
. 是元字符,表示它有特殊的含义,而不是字符本身的含义。如果需要匹配 . ,那么要用 \ 进行转义,即在 . 前面加上 \ 。
正则表达式一般是区分大小写的,但也有些实现不区分。
正则表达式
C.C2018匹配结果
My name is CyC2018 .
三、匹配一组字符
[ ] 定义一个字符集合;
0-9、a-z 定义了一个字符区间,区间使用 ASCII 码来确定,字符区间在 [ ] 中使用。
- 只有在 [ ] 之间才是元字符,在 [ ] 之外就是一个普通字符;
^ 在 [ ] 中是取非操作。
应用
匹配以 abc 为开头,并且最后一个字母不为数字的字符串:
正则表达式
abc[^0-9]匹配结果
- abcd
- abc1
- abc2
四、使用元字符
匹配空白字符
| 元字符 | 说明 |
|---|---|
| [\b] | 回退(删除)一个字符 |
| \f | 换页符 |
| \n | 换行符 |
| \r | 回车符 |
| \t | 制表符 |
| \v | 垂直制表符 |
\r\n 是 Windows 中的文本行结束标签,在 Unix/Linux 则是 \n。
\r\n\r\n 可以匹配 Windows 下的空白行,因为它匹配两个连续的行尾标签,而这正是两条记录之间的空白行;
匹配特定的字符
1. 数字元字符
| 元字符 | 说明 |
|---|---|
| \d | 数字字符,等价于 [0-9] |
| \D | 非数字字符,等价于 [^0-9] |
2. 字母数字元字符
| 元字符 | 说明 |
|---|---|
| \w | 大小写字母,下划线和数字,等价于 [a-zA-Z0-9\_] |
| \W | 对 \w 取非 |
3. 空白字符元字符
| 元字符 | 说明 |
|---|---|
| \s | 任何一个空白字符,等价于 [\f\n\r\t\v] |
| \S | 对 \s 取非 |
\x 匹配十六进制字符,\0 匹配八进制,例如 \xA 对应值为 10 的 ASCII 字符 ,即 \n。
五、重复匹配
- \+ 匹配 1 个或者多个字符
- \ * 匹配 0 个或者多个字符
- ? 匹配 0 个或者 1 个字符
应用
匹配邮箱地址。
正则表达式
[\w.]+@\w+\.\w+[\w.] 匹配的是字母数字或者 . ,在其后面加上 + ,表示匹配多次。在字符集合 [ ] 里,. 不是元字符;
匹配结果
abc.def\
- {n} 匹配 n 个字符
- {m,n} 匹配 m\~n 个字符
- {m,} 至少匹配 m 个字符
\ 和 + 都是贪婪型元字符,会匹配尽可能多的内容。在后面加 ? 可以转换为懒惰型元字符,例如 \?、+? 和 {m,n}? 。
正则表达式
a.+c匹配结果
abcabcabc
由于 + 是贪婪型的,因此 .+ 会匹配更可能多的内容,所以会把整个 abcabcabc 文本都匹配,而不是只匹配前面的 abc 文本。用懒惰型可以实现匹配前面的。
六、位置匹配
单词边界
\b 可以匹配一个单词的边界,边界是指位于 \w 和 \W 之间的位置;\B 匹配一个不是单词边界的位置。
\b 只匹配位置,不匹配字符,因此 \babc\b 匹配出来的结果为 3 个字符。
字符串边界
^ 匹配整个字符串的开头,$ 匹配结尾。
^ 元字符在字符集合中用作求非,在字符集合外用作匹配字符串的开头。
分行匹配模式(multiline)下,换行被当做字符串的边界。
应用
匹配代码中以 // 开始的注释行
正则表达式
^\s*\/\/.*$
匹配结果
- public void fun() {
- // 注释 1
- int a = 1;
- int b = 2;
- // 注释 2
- int c = a + b;
- }
七、使用子表达式
使用 ( ) 定义一个子表达式。子表达式的内容可以当成一个独立元素,即可以将它看成一个字符,并且使用 * 等元字符。
子表达式可以嵌套,但是嵌套层次过深会变得很难理解。
正则表达式
(ab){2,}匹配结果
ababab
| 是或元字符,它把左边和右边所有的部分都看成单独的两个部分,两个部分只要有一个匹配就行。
正则表达式
(19|20)\d{2}匹配结果
- 1900
- 2010
- 1020
应用
匹配 IP 地址。
IP 地址中每部分都是 0-255 的数字,用正则表达式匹配时以下情况是合法的:
- 一位数字
- 不以 0 开头的两位数字
- 1 开头的三位数
- 2 开头,第 2 位是 0-4 的三位数
- 25 开头,第 3 位是 0-5 的三位数
正则表达式
((25[0-5]|(2[0-4]\d)|(1\d{2})|([1-9]\d)|(\d))\.){3}(25[0-5]|(2[0-4]\d)|(1\d{2})|([1-9]\d)|(\d))匹配结果
- 192.168.0.1
- 00.00.00.00
- 555.555.555.555
八、回溯引用
回溯引用使用 \n 来引用某个子表达式,其中 n 代表的是子表达式的序号,从 1 开始。它和子表达式匹配的内容一致,比如子表达式匹配到 abc,那么回溯引用部分也需要匹配 abc 。
应用
匹配 HTML 中合法的标题元素。
正则表达式
\1 将回溯引用子表达式 (h[1-6]) 匹配的内容,也就是说必须和子表达式匹配的内容一致。
<(h[1-6])>\w*?<\/\1>匹配结果
- <h1\>x</h1\>
- <h2\>x</h2\>
- <h3\>x</h1\>
替换
需要用到两个正则表达式。
应用
修改电话号码格式。
文本
313-555-1234
查找正则表达式
(\d{3})(-)(\d{3})(-)(\d{4})替换正则表达式
在第一个子表达式查找的结果加上 () ,然后加一个空格,在第三个和第五个字表达式查找的结果中间加上 - 进行分隔。
($1) $3-$5结果
(313) 555-1234
大小写转换
| 元字符 | 说明 |
|---|---|
| \l | 把下个字符转换为小写 |
| \u | 把下个字符转换为大写 |
| \L | 把\L 和\E 之间的字符全部转换为小写 |
| \U | 把\U 和\E 之间的字符全部转换为大写 |
| \E | 结束\L 或者\U |
应用
把文本的第二个和第三个字符转换为大写。
文本
abcd
查找
(\w)(\w{2})(\w)替换
$1\U$2\E$3结果
aBCd
九、前后查找
前后查找规定了匹配的内容首尾应该匹配的内容,但是又不包含首尾匹配的内容。
向前查找使用 ?= 定义,它规定了尾部匹配的内容,这个匹配的内容在 ?= 之后定义。所谓向前查找,就是规定了一个匹配的内容,然后以这个内容为尾部向前面查找需要匹配的内容。向后匹配用 ?\<= 定义(注: JavaScript 不支持向后匹配,Java 对其支持也不完善)。
应用
查找出邮件地址 @ 字符前面的部分。
正则表达式
\w+(?=@)结果
abc @qq.com
对向前和向后查找取非,只要把 = 替换成 ! 即可,比如 (?=) 替换成 (?!) 。取非操作使得匹配那些首尾不符合要求的内容。
十、嵌入条件
回溯引用条件
条件为某个子表达式是否匹配,如果匹配则需要继续匹配条件表达式后面的内容。
正则表达式
子表达式 (\\() 匹配一个左括号,其后的 ? 表示匹配 0 个或者 1 个。 ?(1) 为条件,当子表达式 1 匹配时条件成立,需要执行 \) 匹配,也就是匹配右括号。
(\()?abc(?(1)\))结果
- (abc)
- abc
- (abc
前后查找条件
条件为定义的首尾是否匹配,如果匹配,则继续执行后面的匹配。注意,首尾不包含在匹配的内容中。
正则表达式
?(?=-) 为前向查找条件,只有在以 - 为前向查找的结尾能匹配 \d{5} ,才继续匹配 -\d{4} 。
\d{5}(?(?=-)-\d{4})结果
- 11111
- 22222-
- 33333-4444
参考资料
- BenForta. 正则表达式必知必会 [M]. 人民邮电出版社, 2007.
代码可读性
- 一、可读性的重要性
- 二、用名字表达代码含义
- 三、名字不能带来歧义
- 四、良好的代码风格
- 五、为何编写注释
- 六、如何编写注释
- 七、提高控制流的可读性
- 八、拆分长表达式
- 九、变量与可读性
- 十、抽取函数
- 十一、一次只做一件事
- 十二、用自然语言表述代码
- 十三、减少代码量
- 参考资料
一、可读性的重要性
编程有很大一部分时间是在阅读代码,不仅要阅读自己的代码,而且要阅读别人的代码。因此,可读性良好的代码能够大大提高编程效率。
可读性良好的代码往往会让代码架构更好,因为程序员更愿意去修改这部分代码,而且也更容易修改。
只有在核心领域为了效率才可以放弃可读性,否则可读性是第一位。
二、用名字表达代码含义
一些比较有表达力的单词:
| 单词 | 可替代单词 |
|---|---|
| send | deliver、dispatch、announce、distribute、route |
| find | search、extract、locate、recover |
| start | launch、create、begin、open |
| make | create、set up、build、generate、compose、add、new |
使用 i、j、k 作为循环迭代器的名字过于简单,user_i、member_i 这种名字会更有表达力。因为循环层次越多,代码越难理解,有表达力的迭代器名字可读性会更高。
为名字添加形容词等信息能让名字更具有表达力,但是名字也会变长。名字长短的准则是:作用域越大,名字越长。因此只有在短作用域才能使用一些简单名字。
三、名字不能带来歧义
起完名字要思考一下别人会对这个名字有何解读,会不会误解了原本想表达的含义。
布尔相关的命名加上 is、can、should、has 等前缀。
- 用 min、max 表示数量范围;
- 用 first、last 表示访问空间的包含范围;
- begin、end 表示访问空间的排除范围,即 end 不包含尾部。
四、良好的代码风格
适当的空行和缩进。
排列整齐的注释:
int a = 1; // 注释
int b = 11; // 注释
int c = 111; // 注释语句顺序不能随意,比如与 html 表单相关联的变量的赋值应该和表单在 html 中的顺序一致。
五、为何编写注释
阅读代码首先会注意到注释,如果注释没太大作用,那么就会浪费代码阅读的时间。那些能直接看出含义的代码不需要写注释,特别是不需要为每个方法都加上注释,比如那些简单的 getter 和 setter 方法,为这些方法写注释反而让代码可读性更差。
不能因为有注释就随便起个名字,而是争取起个好名字而不写注释。
可以用注释来记录采用当前解决办法的思考过程,从而让读者更容易理解代码。
注释用来提醒一些特殊情况。
用 TODO 等做标记:
| 标记 | 用法 |
|---|---|
| TODO | 待做 |
| FIXME | 待修复 |
| HACK | 粗糙的解决方案 |
| XXX | 危险!这里有重要的问题 |
六、如何编写注释
尽量简洁明了:
// The first String is student's name
// The Second Integer is student's score
Map<String, Integer> scoreMap = new HashMap<>();// Student's name -> Student's score
Map<String, Integer> scoreMap = new HashMap<>();添加测试用例来说明:
// ...
// Example: add(1, 2), return 3
int add(int x, int y) {
return x + y;
}使用专业名词来缩短概念上的解释,比如用设计模式名来说明代码。
七、提高控制流的可读性
条件表达式中,左侧是变量,右侧是常数。比如下面第一个语句正确:
if (len < 10)
if (10 > len)只有在逻辑简单的情况下使用 ? : 三目运算符来使代码更紧凑,否则应该拆分成 if / else;
do / while 的条件放在后面,不够简单明了,并且会有一些迷惑的地方,最好使用 while 来代替。
如果只有一个 goto 目标,那么 goto 尚且还能接受,但是过于复杂的 goto 会让代码可读性特别差,应该避免使用 goto。
在嵌套的循环中,用一些 return 语句往往能减少嵌套的层数。
八、拆分长表达式
长表达式的可读性很差,可以引入一些解释变量从而拆分表达式:
if line.split(':')[0].strip() == "root":
...username = line.split(':')[0].strip()
if username == "root":
...使用摩根定理简化一些逻辑表达式:
if (!a && !b) {
...
}if (!(a || b)) {
...
}九、变量与可读性
去除控制流变量 。在循环中通过使用 break 或者 return 可以减少控制流变量的使用。
boolean done = false;
while (/* condition */ && !done) {
...
if ( ... ) {
done = true;
continue;
}
}while(/* condition */) {
...
if ( ... ) {
break;
}
}减小变量作用域 。作用域越小,越容易定位到变量所有使用的地方。
JavaScript 可以用闭包减小作用域。以下代码中 submit_form 是函数变量,submitted 变量控制函数不会被提交两次。第一个实现中 submitted 是全局变量,第二个实现把 submitted 放到匿名函数中,从而限制了起作用域范围。
submitted = false;
var submit_form = function(form_name) {
if (submitted) {
return;
}
submitted = true;
};var submit_form = (function() {
var submitted = false;
return function(form_name) {
if(submitted) {
return;
}
submitted = true;
}
}()); // () 使得外层匿名函数立即执行JavaScript 中没有用 var 声明的变量都是全局变量,而全局变量很容易造成迷惑,因此应当总是用 var 来声明变量。
变量定义的位置应当离它使用的位置最近。
实例解析
在一个网页中有以下文本输入字段:
<input type = "text" id = "input1" value = "a">
<input type = "text" id = "input2" value = "b">
<input type = "text" id = "input3" value = "">
<input type = "text" id = "input4" value = "d">现在要接受一个字符串并把它放到第一个空的 input 字段中,初始实现如下:
var setFirstEmptyInput = function(new_alue) {
var found = false;
var i = 1;
var elem = document.getElementById('input' + i);
while (elem != null) {
if (elem.value === '') {
found = true;
break;
}
i++;
elem = document.getElementById('input' + i);
}
if (found) elem.value = new_value;
return elem;
}以上实现有以下问题:
- found 可以去除;
- elem 作用域过大;
- 可以用 for 循环代替 while 循环;
var setFirstEmptyInput = function(new_value) {
for (var i = 1; true; i++) {
var elem = document.getElementById('input' + i);
if (elem === null) {
return null;
}
if (elem.value === '') {
elem.value = new_value;
return elem;
}
}
};十、抽取函数
工程学就是把大问题拆分成小问题再把这些问题的解决方案放回一起。
首先应该明确一个函数的高层次目标,然后对于不是直接为了这个目标工作的代码,抽取出来放到独立的函数中。
介绍性的代码:
int findClostElement(int[] arr) {
int clostIdx;
int clostDist = Interger.MAX_VALUE;
for (int i = 0; i < arr.length; i++) {
int x = ...;
int y = ...;
int z = ...;
int value = x * y * z;
int dist = Math.sqrt(Math.pow(value, 2), Math.pow(arr[i], 2));
if (dist < clostDist) {
clostIdx = i;
clostDist = value;
}
}
return clostIdx;
}以上代码中循环部分主要计算距离,这部分不属于代码高层次目标,高层次目标是寻找最小距离的值,因此可以把这部分代替提取到独立的函数中。这样做也带来一个额外的好处有:可以单独进行测试、可以快速找到程序错误并修改。
public int findClostElement(int[] arr) {
int clostIdx;
int clostDist = Interger.MAX_VALUE;
for (int i = 0; i < arr.length; i++) {
int dist = computDist(arr, i);
if (dist < clostDist) {
clostIdx = i;
clostDist = value;
}
}
return clostIdx;
}并不是函数抽取的越多越好,如果抽取过多,在阅读代码的时候可能需要不断跳来跳去。只有在当前函数不需要去了解某一块代码细节而能够表达其内容时,把这块代码抽取成子函数才是好的。
函数抽取也用于减小代码的冗余。
十一、一次只做一件事
只做一件事的代码很容易让人知道其要做的事;
基本流程:列出代码所做的所有任务;把每个任务拆分到不同的函数,或者不同的段落。
十二、用自然语言表述代码
先用自然语言书写代码逻辑,也就是伪代码,然后再写代码,这样代码逻辑会更清晰。
十三、减少代码量
不要过度设计,编码过程会有很多变化,过度设计的内容到最后往往是无用的。
多用标准库实现。
参考资料
- Dustin, Boswell, Trevor, 等. 编写可读代码的艺术 [M]. 机械工业出版社, 2012.