GitVP开源文摘
全部文章/人工智能

computer-vision-in-action

A computer vision closed-loop learning platform where code can be run interactively online. 学习闭环《计算机视觉实战演练:算法与应用》中文电子书、源

作者Charmve 仓库Charmve/computer-vision-in-action ↗ 星标★ 2,869 字数72,063 许可NOASSERTION 阅读1
GitHub 原文 ↗
摘要作者系迈微AI研习社创始人、CSDN博客专家,主要分享机器学习算法、计算机视觉等相关内容,每周研读顶会论文,持续关注前沿技术动态。公众号底部有菜单分类,关注我们,一起学习成长。

"如果你只是看了这个项目的在线文档,那么你并没有利用好这个项目。太可惜!"

✨ 以用促学,先会后懂 ✨

L0CV 🔊   一种结合了代码、图示和HTML的在线学习媒介


全面 前沿 免费

计算机视觉实战演练:算法与应用 📌
Computer Vision in Action

作者:张伟(Charmve)

CircleCI Documentation status Code License 知识共享许可协议
Python version jupyter version PyTorch version
Binder Run on Colab Docker Gitpod Ready-to-Code Stars Forks

logo:L0CV


L0CV Website 中文电子书

跨平台,只需一个浏览器即可!


>

👉 在线阅读(优先更新实战篇和进阶篇)

> - 地址:https://charmve.github.io/computer-vision-in-action/

最新版PDF下载

- 地址:https://github.com/charmve/computer-vision-in-action/releases (马上来 ...)
分享 Scan QR 到 L0CV QR
QQ WeChat Weibo Twitter Zhihu CSDN

Index

L0CV architecture

:label: <code>sec_code</code> <b>图1 L0CV 结构图</b>

💠 全书组织

:label: fig_book_org

book_org.png

全书详细思维导图

本书详细介绍,请移步 序言。

  • 第一部分包括基础知识和预备知识。提供深度学习的入门课程,然后在理论篇中,将快速向你介绍实践计算机视觉所需的前提条件,例如如何存储和处理数据,以及如何应用基于线性代数、微积分和概率基本概念的各种数值运算,涵盖了深度学习的最基本概念和技术,例如线性回归、多层感知机和正则化。
  • 第二部分是本书涉及的计算机视觉基础理论,核心部分为神经网络模型,包括神经网络、卷积神经网络、循环神经网络理论讲解,以图像分类、模型拟合与优化作为其代码的实战项目。在模型拟合和优化章节中,着重分享梯度下降、随机梯度下降、动量法、AdaBoost等方法。
  • 接下来的七章集中讨论现代计算机视觉技术实战,也是本书的核心部分。围绕这样的组织逻辑:什么是计算机视觉?计算机视觉解决什么问题,都是怎么解决的?传统方法——以卷积神经网络为中心的神经网络;现代方法——Transformer、强化学习、迁移学习、生成对抗等。各种方法是如何实现的,用到了什么框架?在第7章中,描述了计算机视觉的经典卷积神经网络PyTorch实现,并为我们随后实现更复杂的模型奠定了基础。在随后的几个章节中,我们主要解决图像分类、目标检测、语义分割、3D重建等实际问题,并给出实战项目。
  • 该部分以项目为实战指导,给出详细的项目指导书和代码实现,更为特别的是,给出了notebook可以直接在线运行,跑通结果,免去了本地运行环境的搭建复杂性。于此同时,为了方便读者在本地调试,作者建立了一个名为 `L0CV 的第三方包,可以直接在代码中 import L0CV` 后使用。
  • 第三部分讨论最近几年出现的“网红”模型,诸如:Transformer、Attention、知识蒸馏、迁移学习、生成对抗模型等。这部分也是此份资料的力挺之作。最后,在 chap_optimization 中,我们讨论了用于训练深度学习模型的几种常用优化算法,如:模型压缩、模型剪枝、微调、蒸馏等。

Index

🌈 愿景

本开源项目代表了我们的一种尝试:我们将教给读者概念、背景知识和代码;我们将在同一个地方阐述剖析问题所需的批判性思维、解决问题所需的数学知识,以及实现解决方案所需的工程技能。

我们的目标是创建一个为实现以下目标的统一资源:

  1. 所有人均可在网上免费获取;
  2. 提供足够的技术深度,从而帮助读者实际成为计算机视觉应用科学家:既理解数学原理,又能够实现并不断改进方法;
  3. 包含可运行的代码,为读者展示如何在实际中解决问题。这样不仅直接将数学公式对应成实际代码,而且可以修改代码、观察结果并及时获取经验;
  4. 允许我们和整个社区不断快速迭代内容,从而紧跟仍在高速发展的计算机视觉领域;
  5. 由包含有关技术细节问答的论坛作为补充,使大家可以相互答疑并交换经验。

Index


📘 本书目录

👉 在线阅读(优先更新实战篇和进阶篇)

- 地址:https://charmve.github.io/computer-vision-in-action/
📘 详细目录(点击展开)
- 0.1 [概述](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/0_绪论/chapter0.1_概述.md)
  - 0.1.1 什么是计算机视觉
  - 0.1.2 计算机视觉解决什么问题
  - 0.1.3 行业应用
- 0.2 [计算机视觉基本概念](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/0_绪论/chapter0.2_计算机视觉基本概念.md)
- 0.3 [发展历史回顾](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/0_绪论/chapter0.3_发展历史回顾.md)
- 0.4 [典型的计算机视觉任务](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/0_绪论/chapter0.4_典型的计算机视觉任务.md)
  - 图像分类 
  - 目标识别与目标检测
  - 实例分割与语义分割
  - 3D 建模
- 0.5 [国内外优秀的计算机视觉团队汇总](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/0_绪论/chapter0.5_国内外优秀的计算机视觉团队汇总.md)
- 小练习
- 小结
- 参考文献
- 1.1 [线性回归](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/1_理论篇/chapter1_Neural-Networks/chapter1.1_line-regression.md)
  - 1.1.1 基本原理
  - 1.1.2 从零实现线性回归
  - 1.1.3 线性回归的简洁实现
- 1.2 [Softmax 回归](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/1_理论篇/chapter3_Image-Classification/chapter1.2_Softmax回归.md)
  - 1.2.1 softmax回归模型
  - 1.2.2 从零开始实现softmax回归
  - 1.2.3 softmax回归的简洁实现
- 1.3 [多层感知器](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/1_理论篇/chapter1_Neural-Networks/chapter1.3_多层感知器MLP.md)
  - 1.3.1 基本原理
  - 1.3.2 从零开始实现多层感知器
  - 1.3.3 多层感知器的简洁实现
- 1.4 [反向传播算法](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/1_理论篇/chapter1_Neural-Networks/chapter1.4_Back-Propagation.md)
- 1.5 [神经网络](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/1_理论篇/chapter1_Neural-Networks/chapter1.5_neural-networks.md)
  - 1.5.1 [神经学观点](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/1_理论篇/chapter1_Neural-Networks/chapter1.5.1_神经学观点.md)
  - 1.5.2 [神经网络1-建立神经网络架构](https://cs231n.github.io/neural-networks-1/)
  - 1.5.3 [神经网络2-设置数据和损失](https://cs231n.github.io/neural-networks-2/)
  - 1.5.4 [神经网络3-学习和评估](https://cs231n.github.io/neural-networks-3/)
  - 1.5.5 [案例分析-最小神经网络案例研究](https://cs231n.github.io/neural-networks-case-study/)
- 1.6 [实战项目 1 - 手写字分类](https://blog.csdn.net/Charmve/article/details/108531735)
- 小结
- 参考文献
- 2.1 [从神经网络到卷积神经网络](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/1_理论篇/chapter2_CNN/chapter2_CNN.md#21-从神经网络到卷积神经网络)
  - 2.1.1 [定义](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/1_理论篇/chapter2_CNN/chapter2_CNN.md#211-定义)
  - 2.1.2 [卷积神经网络的架构](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/1_理论篇/chapter2_CNN/chapter2_CNN.md#212-卷积神经网络的架构)
- 2.2 [卷积网络的层级结构](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/1_理论篇/chapter2_CNN/chapter2_CNN.md#22-卷积网络的层级结构)
  - 2.2.1 [数据输入层](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/1_理论篇/chapter2_CNN/chapter2_CNN.md#221-数据输入层)
  - 2.2.2 [卷积计算层](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/1_理论篇/chapter2_CNN/chapter2_CNN.md#222-卷积计算层)
  - 2.2.3 [非线性层(或激活层)](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/1_理论篇/chapter2_CNN/chapter2_CNN.md#223-非线性层或激活层)
  - 2.2.4 [池化层](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/1_理论篇/chapter2_CNN/chapter2_CNN.md#224-池化层)
  - 2.2.5 [全连接层](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/1_理论篇/chapter2_CNN/chapter2_CNN.md#225-全连接层)
- 2.3 [卷积神经网络的几点说明](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/1_理论篇/chapter2_CNN/chapter2_CNN.md#23-卷积神经网络的几点说明)
- 2.4 [实战项目 2 - 动手搭建一个卷积神经网络](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/1_理论篇/chapter2_CNN/chapter2_CNN-in-Action.md)
  - 2.4.1 [卷积神经网络的前向传播](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/1_理论篇/chapter2_CNN/chapter2_CNN-in-Action.md#271-卷积神经网络的前向传播)
  - 2.4.2 [卷积神经网络的反向传播](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/1_理论篇/chapter2_CNN/chapter2_CNN-in-Action.md#272-卷积神经网络的反向传播)
  - 2.4.3 [手写一个卷积神经网络](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/1_理论篇/chapter2_CNN/chapter2_CNN-in-Action.md#273-手写一个卷积神经网络)
    - [1. 定义一个卷积层](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/1_理论篇/chapter2_CNN/chapter2_CNN-in-Action.md#1-定义一个卷积层)
    - [2. 构造一个激活函数](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/1_理论篇/chapter2_CNN/chapter2_CNN-in-Action.md#2-构造一个激活函数)
    - [3. 定义一个类,保存卷积层的参数和梯度](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/1_理论篇/chapter2_CNN/chapter2_CNN-in-Action.md#3-定义一个类保存卷积层的参数和梯度)
    - [4. 卷积层的前向传播](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/1_理论篇/chapter2_CNN/chapter2_CNN-in-Action.md#4-卷积层的前向传播)
    - [5. 卷积层的反向传播](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/1_理论篇/chapter2_CNN/chapter2_CNN-in-Action.md#5-卷积层的反向传播)
    - [6. MaxPooling层的训练](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/1_理论篇/chapter2_CNN/chapter2_CNN-in-Action.md#6-MaxPooling层的训练)
  - 2.4.4 [PaddlePaddle卷积神经网络源码解析](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/1_理论篇/chapter2_CNN/chapter2_CNN-in-Action.md#274-PaddlePaddle卷积神经网络源码解析)
- [小结](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/1_理论篇/chapter2_CNN/chapter2_CNN.md#小结)
- [参考文献](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/1_理论篇/chapter2_CNN/chapter2_CNN.md#参考文献)
- 3.1 [数据驱动方法](https://cs231n.github.io/classification/)
  - 3.1.1 语义上的差别
  - 3.1.2 图像分类任务面临着许多挑战
  - 3.1.3 数据驱动的方法
- 3.2 [k 最近邻算法](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/1_理论篇/chapter3_Image-Classification/chapter3.2_knn.md)
  - 3.2.1 k 近邻模型
  - 3.2.2 k 近邻模型三个基本要素
  - 3.2.3 KNN算法的决策过程
  - 3.2.4 k 近邻算法Python实现
  - 小结
  - 参考文献
- 3.3 [支持向量机](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/1_理论篇/chapter3_Image-Classification/chapter3.3_支持向量机.md)
  - 3.3.1 概述
  - 3.3.2 线性支持向量机
  - 3.3.3 从零开始实现支持向量机
  - 3.3.4 支持向量机的简洁实现
- 3.4 [逻辑回归 LR](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/1_理论篇/chapter3_Image-Classification/chapter3.4_Logistic-Regression.md)
  - 3.4.1 逻辑回归模型
  - 3.4.2 从零开始实现逻辑回归
  - 3.4.3 逻辑回归的简洁实现
- 3.5 [实战项目 3 - 表情识别](https://blog.csdn.net/charmve/category_9754344.html)
- 3.6 [实战项目 4 - 使用卷积神经网络对CIFAR10图片进行分类](http://mp.weixin.qq.com/s?__biz=MzIxMjg1Njc3Mw%3D%3D&chksm=97bef597a0c97c813e185e1bbf987b93d496c6ead8371364fd175d9bac46e6dcf7059cf81cb2&idx=1&mid=2247487293&scene=21&sn=89684d1c107177983dc1b4dca8c20a5b#wechat_redirect)
- [小结](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/1_理论篇/chapter3_Image-Classification/README.md#小结)
- [参考文献](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/1_理论篇/chapter3_Image-Classification/README.md#参考文献)
  • 第 4 章 循环神经网络
- [4.1 循环神经网络 RNN](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/1_理论篇/chapter4_循环神经网络/chapter4.1_循环神经网络.md)
- [4.2 循环神经网络的从零开始实现](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/1_理论篇/chapter4_循环神经网络/chapter4.1_循环神经网络.md)
- [4.3 循环神经网络的简洁实现](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/1_理论篇/chapter4_循环神经网络/chapter4.1_循环神经网络.md)
- [4.4 长短期记忆人工神经网络 LSTM](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/1_理论篇/chapter4_循环神经网络/chapter4.4_长短期记忆人工神经网络LSTM.md)
- [4.5 门控循环单元(GRU)](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/1_理论篇/chapter4_循环神经网络/chapter4.5_门控循环单元.md)
- 小结
- 练习
- 参考文献
- 5.1 [历史脉络](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/1_理论篇/chapter5_图神经网络/chapter5_图神经网络.md#51-历史脉络)
- 5.2 [图神经网络(Graph Neural Network)](https://www.cnblogs.com/SivilTaram/p/graph_neural_network_1.html)
  - 5.2.1 [状态更新与输出](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/1_理论篇/chapter5_图神经网络/chapter5_图神经网络.md#51-常见数据集)
  - 5.2.2 [不动点理论](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/2_实战篇/chapter8_著名数据集及基准/chapter8.1_著名数据集.md#812-pytorch数据集及读取方法简介)
  - 5.2.3 [具体实现](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/2_实战篇/chapter8_著名数据集及基准/chapter8.1_著名数据集.md#813-数据增强简介)
  - 5.2.4 [模型学习]()
  - 5.2.5 [GNN与RNN](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/2_实战篇/chapter8_著名数据集及基准/chapter8.2_基准BenchMark.md)
  - 5.2.6 [GNN的局限]()
- 5.3 [门控图神经网络(Gated Graph Neural Network)]()
  - 5.3.1 状态更新
  - 5.3.2 实例1:到达判断
  - 5.3.3 实例2:语义解析
  - 5.3.4 GNN与GGNN
- 5.4 [图卷积神经网络(GCNN)](https://www.cnblogs.com/SivilTaram/p/graph_neural_network_2.html)
  - 5.4.1 图卷积缘起
  - 5.4.2 图卷积框架(Framework)
  - 5.4.3 再谈卷积
  - 5.4.4 空域卷积(Spatial Convolution)
  - 5.4.5 消息传递网络(Message Passing Neural Network)
  - 5.4.6 图采样与聚合(Graph Sample and Aggregate)
  - 5.4.7 图结构序列化(PATCHY-SAN)
  - 5.4.8 频域卷积(Spectral Convolution)
- 5.5 [生成图表示](https://www.cnblogs.com/SivilTaram/p/graph_neural_network_3.html)
  - 5.5.1 图读出操作(ReadOut)
  - 5.5.2 基于统计的方法(Statistics Category)
  - 5.5.3 基于学习的方法(Learning Category)
  - 5.5.4 其他方法
- 5.6 [图神经网络在计算机视觉上的应用](https://www.cnblogs.com/SivilTaram/p/graph_neural_network_3.html)
  - 5.6.1 [点云分割](https://arxiv.org/abs/1904.03751)
  - 5.6.2 [点云生成](https://openreview.net/forum?id=SJeXSo09FQ)
  - 5.6.3 [RGBD图像分割](https://www.cs.toronto.edu/~urtasun/publications/qi_etal_iccv17.pdf)
  - 5.6.4 [视觉问答VQA](https://visualqa.org/)
  - 5.6.5 [零次学习ZSL](https://arxiv.org/pdf/1803.08035.pdf)
- 小结
- 参考文献
- 5.1 [训练误差和泛化误差](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/notebooks/)
- 5.2 [模型选择](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/notebooks/)
- 5.3 [欠拟合和过拟合](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/notebooks/)
- 5.4 [多项式函数拟合实验](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/notebooks/)
- 5.5 [数值稳定性和模型初始化](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/notebooks/)
- 小结
- 参考文献
- 6.1 [优化与深度学习](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/notebooks/chapter07_optimization/7.1_optimization-intro.ipynb)
- 6.2 [梯度下降和随机梯度下降](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/notebooks/chapter07_optimization/7.2_gd-sgd.ipynb)
- 6.3 [小批量随机梯度下降](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/notebooks/chapter07_optimization/7.3_minibatch-sgd.ipynb)
- 6.4 [动量法](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/notebooks/chapter07_optimization/7.4_momentum.ipynb)
- 6.5 [AdaGrad算法](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/notebooks/chapter07_optimization/7.5_adagrad.ipynb)
- 6.6 [RMSProp算法](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/notebooks/chapter07_optimization/7.6_rmsprop.ipynb)
- 6.7 [AdaDelta算法](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/notebooks/chapter07_optimization/7.7_adadelta.ipynb)
- 6.8 [Adam算法](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/notebooks/chapter07_optimization/7.8_adam.ipynb)
- 小结
- 参考文献
- 6.1 [深度学习环境搭建指南](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/2_实战篇/chapter6_深度学习环境搭建/chapter6.1_深度学习环境搭建指南.md)
- 6.2 [Pytorch 基础使用介绍](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/2_实战篇/chapter6_深度学习环境搭建/chapter6.2_Pytorch-基础使用介绍.md)
  - 6.2.1 [Tensors](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/2_实战篇/chapter6_深度学习环境搭建/chapter6.2_Pytorch-基础使用介绍.md#621-tensors)
  - 6.2.2 [Operations](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/2_实战篇/chapter6_深度学习环境搭建/chapter6.2_Pytorch-基础使用介绍.md#622-operations)
  - 6.2.3 [Numpy桥梁](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/2_实战篇/chapter6_深度学习环境搭建/chapter6.2_Pytorch-基础使用介绍.md#623-numpy桥梁)
  - 6.2.4 [CUDA Tensors](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/2_实战篇/chapter6_深度学习环境搭建/chapter6.2_Pytorch-基础使用介绍.md#624-cuda-tensors)
- 6.3 [Python](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/notebooks/chapter08_environment-setup-and-tool-use/02_Python.ipynb)
- 6.4 [Numpy 基础使用](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/notebooks/chapter08_environment-setup-and-tool-use/03_NumPy.ipynb)
- 6.5 [Pandas 基础使用](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/notebooks/chapter08_environment-setup-and-tool-use/04_Pandas.ipynb)
- 6.6 [OpenCV 安装及基础使用](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/notebooks/chapter08_environment-setup-and-tool-use/OpenCV-ImageStitching.ipynb)
- 6.7 [Jupyter Notebook 配置及基础使用](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/notebooks/chapter08_environment-setup-and-tool-use/01_Notebooks.ipynb)
- 6.8 [基本的图像操作和处理](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/2_实战篇/chapter6_深度学习环境搭建/chapter6.8_基本的图像操作和处理.md)
  - 6.8.1 [PIL:Python图像处理类库](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/2_实战篇/chapter6_深度学习环境搭建/chapter6.8_基本的图像操作和处理.md#781-pil-python图像处理类库)
  - 6.8.2 [Matplotlib](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/2_实战篇/chapter6_深度学习环境搭建/chapter6.8_基本的图像操作和处理.md#782-matplotlib)
  - 6.8.3 [NumPy](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/2_实战篇/chapter6_深度学习环境搭建/chapter6.8_基本的图像操作和处理.md#783-numpy)
  - 6.8.4 [SciPy](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/2_实战篇/chapter6_深度学习环境搭建/chapter6.8_基本的图像操作和处理.md#784-scipy)
  - 6.8.5 [高级示例:图像去噪](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/2_实战篇/chapter6_深度学习环境搭建/chapter6.8_基本的图像操作和处理.md#785-高级示例-图像去噪)
- 6.9 [实战项目 5 - 使用OpenCV进行图像全景拼接](https://blog.csdn.net/Charmve/article/details/107897468)
- 小结
- 参考文献
- 7.1 [卷积神经网络(LeNet)](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/2_实战篇/chapter7_经典卷积神经网络架构-原理与PyTorch实现/7.1%20卷积神经网络(LeNet).md)
- 7.2 [深度卷积神经网络(AlexNet)](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/2_实战篇/chapter7_经典卷积神经网络架构-原理与PyTorch实现/7.2%20深度卷积神经网络(AlexNet).md)
- 7.3 [使用重复元素的网络(VGG)](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/2_实战篇/chapter7_经典卷积神经网络架构-原理与PyTorch实现/7.3%20使用重复元素的网络(VGG).md)
- 7.4 [含并行连结的网络(GoogLeNet)](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/2_实战篇/chapter7_经典卷积神经网络架构-原理与PyTorch实现/7.4%20含并行连结的网络(GoogLeNet).md)
- 7.5 [残差网络(ResNet)](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/2_实战篇/chapter7_经典卷积神经网络架构-原理与PyTorch实现/chapter7.6_残差网络-ResNet.md)
- 7.6 [二阶网络编码解码(U-Net)](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/2_实战篇/chapter7_经典卷积神经网络架构-原理与PyTorch实现/chapter7.7_二阶网络编码解码-UNet.md)
- 7.7 [稠密连接网络(DenseNet)](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/2_实战篇/chapter7_经典卷积神经网络架构-原理与PyTorch实现/chapter7.8_稠密连接网络-DenseNet.md)
- 7.8 [语义分割网络(SegNet)](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/2_实战篇/chapter7_经典卷积神经网络架构-原理与PyTorch实现/chapter7.9_语义分割网络-SegNet.md)
- 7.9 [实例分割网络(Mask-RCNN)](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/2_实战篇/chapter7_经典卷积神经网络架构-原理与PyTorch实现/chapter7.9_实例分割网络-Mask-RCNN.md)
- 7.10 [区域卷积神经网络(R-CNN)](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/2_实战篇/chapter7_经典卷积神经网络架构-原理与PyTorch实现/chapter7.10_区域卷积神经网络-RCNN.md)
- 7.11 [全卷积网络(FCN)](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/2_实战篇/chapter7_经典卷积神经网络架构-原理与PyTorch实现/chapter7.11_全卷积网络-FCN.md)
- 7.12 [YOLO: 实时目标检测](https://pjreddie.com/darknet/yolo/)
- 小结
- 参考文献
- 8.1 [数据集](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/2_实战篇/chapter8_著名数据集及基准/chapter8.1_著名数据集.md)
    - 8.1.1 [常见数据集](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/2_实战篇/chapter8_著名数据集及基准/chapter8.1_著名数据集.md#811-常见数据集)
      - 8.1.1.1 [ImageNet](https://image-net.org/)
      - 8.1.1.2 [MNIST](http://yann.lecun.com/exdb/mnist/)
      - 8.1.1.3 [COCO](https://cocodataset.org/)
      - 8.1.1.4 [CIFAR-10](http://www.cs.toronto.edu/~kriz/cifar.html)
    - 8.1.2 [Pytorch数据集及读取方法简介](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/2_实战篇/chapter8_著名数据集及基准/chapter8.1_著名数据集.md#812-pytorch数据集及读取方法简介)
    - 8.1.3 [数据增强简介](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/2_实战篇/chapter8_著名数据集及基准/chapter8.1_著名数据集.md#813-数据增强简介)
    - [总结](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/2_实战篇/chapter8_著名数据集及基准/chapter8.1_著名数据集.md#总结)
- 8.2 [基准测试](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/2_实战篇/chapter8_著名数据集及基准/chapter8.2_基准BenchMark.md)
- 8.3 [评价指标](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/chapter8.3_评价指标.md)
- 8.4 [实战项目 6 - Kaggle比赛:图像分类(CIFAR-10)](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/2_实战篇/chapter7_经典卷积神经网络架构-原理与PyTorch实现/7.12%20实战Kaggle比赛:图像分类(CIFAR-10).md)
- 8.5 [实战项目 7 - Kaggle比赛:狗的品种识别(ImageNet Dogs)](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/2_实战篇/chapter7_经典卷积神经网络架构-原理与PyTorch实现/7.13%20实战Kaggle比赛:狗的品种识别(ImageNet%20Dogs).md)
- 小结
- 参考文献
- 9.1 语义分割
  - 9.1.1 [语义分割 PyTorch 版](https://github.com/Charmve/Semantic-Segmentation-PyTorch)
  - 9.1.2 [实战项目 8 - 基于PolarNet的点云端到端语义分割项目实战]()
- 9.2 目标检测
  - 9.2.1 常用网络
  - 9.2.2 [实战项目 9 - 基于PyTorch的YOLO5目标检测项目实战]()
- 9.3 [实例分割](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/2_实战篇/chapter9_检测与分割实战项目/9.3%20实例分割.md)
  - 9.3.1 [常用网络](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/2_实战篇/chapter9_检测与分割实战项目/9.3%20实例分割.md#931-常用网络)
  - 9.3.2 [实战项目 10 - 实时高分辨率背景抠图](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/2_实战篇/chapter9_检测与分割实战项目/9.3%20实例分割.md#932-实战项目-8-实时高分辨率背景抠图)
  - 9.3.3 新方法:[滑动窗口](https://blog.csdn.net/Charmve/article/details/108915225), [PointRend](https://blog.csdn.net/Charmve/article/details/108892076), [PolarMask](https://github.com/xieenze/PolarMask)
- 小结
- 参考文献
- 10.1 [手写字识别](https://blog.csdn.net/Charmve/article/details/108531735)
- 10.2 [文本检测](https://github.com/Charmve/Scene-Text-Detection)
- 10.3 [车道线检测](https://github.com/Charmve/Awesome-Lane-Detection)
  - 10.3.1 [常用网络](https://github.com/Charmve/Awesome-Lane-Detection)
  - 10.3.2 [实战项目 11 - 车道线检测项目实战](https://blog.csdn.net/Charmve/article/details/116678477)
- 10.4 [镜面检测](https://github.com/Charmve/Mirror-Glass-Detection)
- 10.5 [图像抠图 Matting](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/2_实战篇/chapter10_计算机视觉课题研究初探/charpter10_5-图像抠图.md)
- 10.6 [图像超分辨率](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/2_实战篇/chapter10_计算机视觉课题研究初探/charpter10_6-图像超分辨率.md)
- 10.7 [3D 重建](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/2_实战篇/chapter10_计算机视觉课题研究初探/charpter10_7-3D重建.md)
- 小结
- 参考文献
- 11.1 特征可视化
- 11.2 倒置
- 11.3 可视化数据梯度
- 11.4 [Embeddings](https://nbviewer.jupyter.org/format/slides/github/Charmve/computer-vision-in-action/blob/main/notebooks/chapter13_Understanding-and-Visualizing/Embeddings.ipynb)
- 11.5 对抗样本
- 11.6 [DeepDream 和风格迁移](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter12-生成对抗模型/chapter12.3.3_neural-style.md)
- 11.7 [实战项目 12: PyTorch 如何使用TensorBoard](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter11-可视化和理解/chapter11-可视化和理解.md)
  - 11.4.1 [创建 TensorBoard](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter11-可视化和理解/chapter11-可视化和理解.md#1141-创建-tensorboard)
  - 11.4.2 [写入 TensorBoard](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter11-可视化和理解/chapter11-可视化和理解.md#1142-写入-tensorboard)
  - 11.4.3 [使用 TensorBoard 检查模型](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter11-可视化和理解/chapter11-可视化和理解.md#1143-使用-tensorboard-检查模型)
  - 11.4.4 [向 TensorBoard 添加 "Projector"](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter11-可视化和理解/chapter11-可视化和理解.md#1144-向-tensorboard-添加-projector)
  - 11.4.5 [使用 TensorBoard 跟踪模型训练](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter11-可视化和理解/chapter11-可视化和理解.md#1145-使用-tensorboard-跟踪模型训练)
  - 11.4.6 [使用 TensorBoard 评估训练好的模型](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter11-可视化和理解/chapter11-可视化和理解.md#1146-使用-tensorboard-评估训练好的模型)
  - 11.4.7 [案例总结](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter11-可视化和理解/chapter11-可视化和理解.md#小结)
- 小结
- 参考文献
- 12.1 Pixel RNN/CNN
- 12.2 [自编码器 Auto-encoder](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter12-生成对抗模型/chapter12_2-自编码器Auto-encoder.md)
- 12.3 [生成对抗网络 GAN](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter12-生成对抗模型/chapter12.3_生成对抗网络GAN.md)
  - 12.3.1 [概述](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter12-生成对抗模型/chapter12.3_生成对抗网络GAN.md#1231-概述)
  - 12.3.2 [GAN的基本思想](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter12-生成对抗模型/chapter12.3_生成对抗网络GAN.md#1232-gan的基本思想)
  - 12.3.3 [GAN浅析](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter12-生成对抗模型/chapter12.3_生成对抗网络GAN.md#1233-gan浅析)
    - 12.3.3.1 [GAN的基本结构](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter12-生成对抗模型/chapter12.3_生成对抗网络GAN.md#12331-gan的基本结构)
    - 12.3.3.2 [GAN的训练方式](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter12-生成对抗模型/chapter12.3_生成对抗网络GAN.md#12332-gan的训练方式)
      - [关于生成器](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter12-生成对抗模型/chapter12.3_生成对抗网络GAN.md#关于生成器)
      - [关于判别器](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter12-生成对抗模型/chapter12.3_生成对抗网络GAN.md#关于判别器)
      - [如何训练](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter12-生成对抗模型/chapter12.3_生成对抗网络GAN.md#如何训练)
  - 12.3.4 [训练相关理论基础](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter12-生成对抗模型/chapter12.3_生成对抗网络GAN.md#1234训练相关理论基础)
  - 12.3.5 项目实战案例StyleGAN
    - [StyleGAN](https://github.com/Charmve/VOGUE-Try-On)
    - [StyleGAN 2.0](https://blog.csdn.net/Charmve/article/details/115315353)
  - 12.3.6 [实战项目11 - 图像风格迁移](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter12-生成对抗模型/chapter12.3.3_neural-style.md)
  - [小结](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter12-生成对抗模型/chapter12.3_生成对抗网络GAN.md#小结)
  - [参考文献](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter12-生成对抗模型/chapter12.3_生成对抗网络GAN.md#参考文献)
- 12.4 [变分自编码器 Variational Auto-encoder, VAE](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter12-生成对抗模型/chapter12_4-变分自编码器VAE.md)
  - 12.4.1 [概述](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter12-生成对抗模型/chapter12_4-变分自编码器VAE.md#1241-概述)    
  - 12.4.2 [基本原理](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter12-生成对抗模型/chapter12_4-变分自编码器VAE.md#1242-基本原理)        
    - 12.4.2.1 [定义](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter12-生成对抗模型/chapter12_4-变分自编码器VAE.md#1-定义)        
    - 12.4.2.2 [理论基础:三要素](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter12-生成对抗模型/chapter12_4-变分自编码器VAE.md#2-理论基础三要素) 
    - 12.4.2.3 [推导过程](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter12-生成对抗模型/chapter12_4-变分自编码器VAE.md#3-推导过程)            
  - 12.4.3 [VAE v.s. AE 区别与联系](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter12-生成对抗模型/chapter12_4-变分自编码器VAE.md#1243-vae-vs-ae-区别与联系)    
  - 12.4.4 [变分自编码器的代码实现](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter12-生成对抗模型/chapter12_4-变分自编码器VAE.md#1244-变分自编码器的代码实现)    
  - 12.4.5 [卷积变分自编码器的实现与简单应用](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter12-生成对抗模型/chapter12_4-变分自编码器VAE.md#1245-卷积变分自编码器的实现与简单应用)  
  - 12.4.6 [实战项目 13 - 旧照片修复](https://github.com/microsoft/Bringing-Old-Photos-Back-to-Life) 
  - 小结     
  - [参考文献](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter12-生成对抗模型/chapter12_4-变分自编码器VAE.md#参考文献) 
- 参考文献
- 13.1 [引言-如何解决通用人工智能的难点](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter13-深度增强学习/chapter13-深度增强学习.md#141-引言-如何解决通用人工智能的难点)
- 13.2 [什么是深度增强学习](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter13-深度增强学习/chapter13-深度增强学习.md#142-什么是深度增强学习)
  - 13.2.1 [深度学习](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter13-深度增强学习/chapter13-深度增强学习.md#1421-深度学习)
  - 13.2.2 [增强学习](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter13-深度增强学习/chapter13-深度增强学习.md#1422-增强学习)
  - 13.2.3 [二者的融合](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter13-深度增强学习/chapter13-深度增强学习.md#1423-二者的融合)
- 13.3 [怎么利用深度增强学习解决问题](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter13-深度增强学习/chapter13-深度增强学习.md#143-怎么利用深度增强学习解决问题)
  - 13.3.1 [Policy-based DRL](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter13-深度增强学习/chapter13-深度增强学习.md#1431-policy-based-drl)
  - 13.3.2 [Value-based DRL](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter13-深度增强学习/chapter13-深度增强学习.md#1432-value-based-drl)
  - 13.3.3 [Model-based DRL](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter13-深度增强学习/chapter13-深度增强学习.md#1433-model-based-drl)
- 13.4 [深度增强学习在计算机视觉中的应用](#144-深度增强学习在计算机视觉中的应用)
- [小结](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter13-深度增强学习/chapter13-深度增强学习.md#小结)
- [参考文献](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter13-深度增强学习/chapter13-深度增强学习.md#参考文献)
- 14.1 [概述](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter14-视频理解/chapter14-视频理解.md#141-概述)
- 14.2 [视频理解场景中的主要问题](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter14-视频理解/chapter14-视频理解.md#142-视频理解场景中的主要问题)
- 14.3 [常用数据集](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter14-视频理解/chapter14-视频理解.md#143-常用数据集)
- 14.4 [主流方法与模型架构](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter14-视频理解/chapter14-视频理解.md#144-主流方法与模型架构)
- 14.5 [指标 METRICS](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter14-视频理解/chapter14-视频理解.md#145-指标-metrics)
- 14.6 [可能的未来方向](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter14-视频理解/chapter14-视频理解.md#146-可能的未来方向)
- [小结](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter14-视频理解/chapter14-视频理解.md#小结)
- [参考文献](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter14-视频理解/chapter14-视频理解.md#参考文献)
- 15.1 [概述](https://github.com/Charmve/computer-vision-in-action/tree/main/docs/3_进阶篇/chapter15_迁移学习/chapter15_迁移学习概述.md#151-迁移学习概述)
  - 15.1.1 [背景](https://github.com/Charmve/computer-vision-in-action/tree/main/docs/3_进阶篇/chapter15_迁移学习/chapter15_迁移学习概述.md#1511-背景)
  - 15.1.2 [定义及分类](https://github.com/Charmve/computer-vision-in-action/tree/main/docs/3_进阶篇/chapter15_迁移学习/chapter15_迁移学习概述.md#1512-定义及分类)
  - 15.1.3 [关键点](https://github.com/Charmve/computer-vision-in-action/tree/main/docs/3_进阶篇/chapter15_迁移学习/chapter15_迁移学习概述.md#1513-关键点)
- 15.2 [基于实例的迁移](https://github.com/Charmve/computer-vision-in-action/tree/main/docs/3_进阶篇/chapter15_迁移学习/chapter15_迁移学习概述.md#152-基于实例的迁移)
- 15.3 [基于特征的迁移](https://github.com/Charmve/computer-vision-in-action/tree/main/docs/3_进阶篇/chapter15_迁移学习/chapter15_迁移学习概述.md#153-基于特征的迁移)
- 15.4 [基于共享参数的迁移](https://github.com/Charmve/computer-vision-in-action/tree/main/docs/3_进阶篇/chapter15_迁移学习/chapter15_迁移学习概述.md#154-基于共享参数的迁移)
- 15.5 [深度学习和迁移学习结合](https://github.com/Charmve/computer-vision-in-action/tree/main/docs/3_进阶篇/chapter15_迁移学习/chapter15_迁移学习概述.md#155-深度学习和迁移学习结合)
- 15.7 [实战项目 14 - 蚂蚁和蜜蜂的分类问题](https://github.com/Charmve/computer-vision-in-action/tree/main/docs/3_进阶篇/chapter15_迁移学习/chapter15_迁移学习的应用.md)
  - 15.7.1 [迁移学习在计算机视觉领域的应用](https://github.com/Charmve/computer-vision-in-action/tree/main/docs/3_进阶篇/chapter15_迁移学习/chapter15_迁移学习的应用.md#1571-迁移学习在计算机视觉领域的应用)
  - 15.7.2 [实战项目: 蚂蚁和蜜蜂的分类问题](https://github.com/Charmve/computer-vision-in-action/tree/main/docs/3_进阶篇/chapter15_迁移学习/chapter15_迁移学习的应用.md#1572-实战项目-蚂蚁和蜜蜂的分类问题)
- [小结](#小结)
- [参考文献](#参考文献)
- 16.1 概述
- 16.2 Attention with RNNs
- 16.3 [Self-attention 自注意力](https://mp.weixin.qq.com/s/nUd7YtCci1_AwQ4nOwK9bA)
- 16.4 软注意力(soft-attention)
  - 16.4.1 空间域注意力
  - 16.4.2 通道注意力
  - 16.4.3 Positional encoding
  - 16.4.4 混合域模型
  - 16.4.5 Masked attention
  - 16.4.6 Multi-head attention
- 16.5 强注意力(hard attention)
- 16.6 [Attention九层塔 - 注意力机制的九重理解](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_进阶篇/chapter16-注意力机制%20Attention%20is%20All%20You%20Need/chapter16_Attention-is-All-You-Need.md)
- 小结
- 参考文献
- 17.1 [思想和框图](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_%E8%BF%9B%E9%98%B6%E7%AF%87/chapter17-%E8%B7%A8%E7%95%8C%E6%A8%A1%E5%9E%8B%20Transformer/chapter17_Transformer.md#%E4%B8%80%E6%80%9D%E6%83%B3%E5%92%8C%E6%A1%86%E5%9B%BE)
- 17.2 [实现细节](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_%E8%BF%9B%E9%98%B6%E7%AF%87/chapter17-%E8%B7%A8%E7%95%8C%E6%A8%A1%E5%9E%8B%20Transformer/chapter17_Transformer.md#二实现细节)
  - [17.2.1 Encoder](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_%E8%BF%9B%E9%98%B6%E7%AF%87/chapter17-%E8%B7%A8%E7%95%8C%E6%A8%A1%E5%9E%8B%20Transformer/chapter17_Transformer.md#2-1-Encoder)
  - [17.2.2 Decoder](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_%E8%BF%9B%E9%98%B6%E7%AF%87/chapter17-%E8%B7%A8%E7%95%8C%E6%A8%A1%E5%9E%8B%20Transformer/chapter17_Transformer.md#2-2-Decoder)
  - [17.2.3 Self-Attention](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_%E8%BF%9B%E9%98%B6%E7%AF%87/chapter17-%E8%B7%A8%E7%95%8C%E6%A8%A1%E5%9E%8B%20Transformer/chapter17_Transformer.md#2-3-Self-Attention)
  - [17.2.4 Multi-Headed Attention](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_%E8%BF%9B%E9%98%B6%E7%AF%87/chapter17-%E8%B7%A8%E7%95%8C%E6%A8%A1%E5%9E%8B%20Transformer/chapter17_Transformer.md#2-4-Multi-Headed-Attention)
  - [17.2.5 Positional Encoding](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_%E8%BF%9B%E9%98%B6%E7%AF%87/chapter17-%E8%B7%A8%E7%95%8C%E6%A8%A1%E5%9E%8B%20Transformer/chapter17_Transformer.md#2-5-Positional-Encoding)
- 17.3 [应用任务和结果](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_%E8%BF%9B%E9%98%B6%E7%AF%87/chapter17-%E8%B7%A8%E7%95%8C%E6%A8%A1%E5%9E%8B%20Transformer/chapter17_Transformer.md#三-应用任务和结果)
  - 17.3.1 [NLP领域](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_%E8%BF%9B%E9%98%B6%E7%AF%87/chapter17-%E8%B7%A8%E7%95%8C%E6%A8%A1%E5%9E%8B%20Transformer/chapter17_Transformer.md#3-1-NLP领域)
  - 17.3.2 [CV领域](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_%E8%BF%9B%E9%98%B6%E7%AF%87/chapter17-%E8%B7%A8%E7%95%8C%E6%A8%A1%E5%9E%8B%20Transformer/chapter17_Transformer.md#3-2-CV领域)
    - 17.3.2.1 [检测DETR](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_%E8%BF%9B%E9%98%B6%E7%AF%87/chapter17-%E8%B7%A8%E7%95%8C%E6%A8%A1%E5%9E%8B%20Transformer/chapter17_Transformer.md#3-2-1-检测DETR)
    - 17.3.2.2 [分类ViT](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_%E8%BF%9B%E9%98%B6%E7%AF%87/chapter17-%E8%B7%A8%E7%95%8C%E6%A8%A1%E5%9E%8B%20Transformer/chapter17_Transformer.md#3-2-2-分类ViT)
    - 17.3.2.3 [分割SETR](https://github.com/Charmve/computer-vision-in-action/blob/main/docs/3_%E8%BF%9B%E9%98%B6%E7%AF%87/chapter17-%E8%B7%A8%E7%95%8C%E6%A8%A1%E5%9E%8B%20Transformer/chapter17_Transformer.md#3-2-3-分割SETR)
    - 17.3.2.4 [Deformable-DETR](https://github.com/Charmve/computer-vision-in-action/blob/main/docs/3_%E8%BF%9B%E9%98%B6%E7%AF%87/chapter17-%E8%B7%A8%E7%95%8C%E6%A8%A1%E5%9E%8B%20Transformer/chapter17_Transformer.md#3-2-4-Deformable-DETR)
- 17.4 [优点及分析](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_%E8%BF%9B%E9%98%B6%E7%AF%87/chapter17-%E8%B7%A8%E7%95%8C%E6%A8%A1%E5%9E%8B%20Transformer/chapter17_Transformer.md#四-优点及分析)
- 17.5 [缺点及分析](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_%E8%BF%9B%E9%98%B6%E7%AF%87/chapter17-%E8%B7%A8%E7%95%8C%E6%A8%A1%E5%9E%8B%20Transformer/chapter17_Transformer.md#五-缺点及分析)
- [实战项目 15 - 基于Transformer的视频实例分割网络VisTR (CVPR2021)](https://blog.csdn.net/Charmve/article/details/115339803)
- 小结
- [参考文献](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/3_%E8%BF%9B%E9%98%B6%E7%AF%87/chapter17-%E8%B7%A8%E7%95%8C%E6%A8%A1%E5%9E%8B%20Transformer/chapter17_Transformer.md#六-参考文献)
- 18.1 概要
- 18.2 KD主要方法
  - 18.2.1 Logits(Response)-based Knowledge
  - 18.2.2 Feature-based Knowledge
  - 18.2.3 Relation-based Knowledge
- 18.3 知识蒸馏的应用 NLP-BERT
- 18.4 常见疑问解答
- [实战项目 16 - 支付宝CVPR细粒度视觉分类挑战赛夺冠方案解读](https://mp.weixin.qq.com/s/RTkBQJ7Uj86Wxt7HmwWKzA)
- 小结
- [参考文献](#参考文献)
- 19.1 从Mini-Batch SGD说起
- 19.2 Normalization到底是在做什么
- 19.3 Batch Normalization如何做
  - 19.3.1 前向神经网络中的BN
  - 19.3.2 CNN网络中的BN
  - 19.3.3 Batch Norm的四大罪状
- 19.4 Layer Normalization、Instance Normalization及Group Normalization
  - 19.4.1 Layer Normalization
  - 19.4.2 Instance Normalization
  - 19.4.3 Group Normalization
  - 19.4.4 用一个故事来总结
- 19.5 Normalization操作的Re-Scaling不变性
- 19.6 Batch Normalization为何有效
- 小结
- [参考文献](#参考文献)
- 20.1 概述
- 20.2 模型压缩
  - 20.2.1 线性或非线性量化(1990~2014 - 至今)
  - 20.2.2 结构或非结构剪枝(1989~2014 - 至今
  - 20.2.3 网络结构搜索(2016 - 至今)
  - 20.2.4 权重矩阵的低秩分解()
  - 20.2.5 知识蒸馏(2014-至今)
- 20.3 模型优化加速
  - 20.3.1 Op-Level 的快速算法
  - 20.3.2 Layer0-level 的快速算法
  - 20.3.3 硬件计算单元优化算法
  	- CPU、GPU和NPU
  	- ASIC 和 FPGA
  	- PIM(NDP)
- 20.4 优化工具与库
  - 20.4.1 TensorRT Nvidia)
  - 20.4.2 TVM (Tensor Virtual Machine)
  - 20.4.3 Tensor Comprehension  (Facebook)
  - 20.4.4 Distiller (Intel)
- 小结
- [参考文献](#六-参考文献)
  • 附录

- A 矩阵
- B [常用激活函数总结](https://mp.weixin.qq.com/s?__biz=MzIxMjg1Njc3Mw==&mid=2247484495&idx=1&sn=0bbb2094d93169baf20eedb284bc668f)
- C [梯度下降法](https://blog.csdn.net/Charmve/article/details/106089198)
- D [深度学习调参技巧总结](https://blog.csdn.net/Charmve/article/details/107650479)

- 更新中 ...
[收起](#-本书目录)

Index

🔍 文件浏览

按书中内容先后顺序逐章阅读,或者选取特定章节祥读 📁 docs/ 1,动手实践章节代码,在代码文件 📁 code/ 2 下找到对应代码,本地测试或者Colab 📁 notebooks/ 3 在线测试。

- 📁 L0CV/ - 专为本项目建立的 `💮 L0CV` 包 - 📁 code/ - 书中完整代码 - 📁 datasets/ - 本书所用数据集 - 📁 images/ - 经典图像处理图片 - 📁 docs/ - 全书按照一下几个篇目进行编写 - 📁 0_绪论/ - 全书绪论 - 📁 1_理论篇/ - 基本理论和算法基础 - 📁 2_实战篇/ - 项目实战教程 - 📁 3_进阶篇/ - 最新CV模型和算法 - 📁 附件/ - 所需数学和统计学知识 - 📁 img/ - 各章节所使用的插图 - 📁 models/ - 封装可用的预训练模型 - 📁 notebooks/ - 🚩 全书 Colab notebook,可在线测试 Binder - 📁 chapter01_neural-networks/ - 第 1 章 - 神经网络 Jupyter Notebook 实现 - 📁 chapter02_CNN/ - 第 2 章 - 卷积神经网络 Jupyter Notebook 实现 - 📁 chapter03_Image-Classification - 第 3 章 - 图像分类 Jupyter Notebook 实现 - 📁 chapter04_recurrent-neural-networks/ - 第 4 章 - 递归神经网络 Jupyter Notebook 实现 - 📁 chapter05_graph-neural-network/ - 第 5 章 - 图神经网络 Jupyter Notebook 实现 - 📁 chapter07_optimization/ - 第 6 章 - 模型拟合与优化算法 Jupyter Notebook 实现 - 📁 chapter08_environment-setup-and-tool-use/ - 第 7 章 - 软件环境搭建与工具使用 Jupyter Notebook 实现 - 📁 chapter09_convolutional-neural-networks/ - 第 8 章 - 经典神经网络架构:原理与PyTorch实现 Jupyter Notebook 实现 - 📁 chapter12_practice-projects - 第 12 章 - 计算机视觉课题研究初探 Jupyter Notebook 实现 - 📁 chapter13_Understanding-and-Visualizing/ - 第 13 章 - 可视化与理解卷积神经网络 Jupyter Notebook 实现 - 📁 chapter14_GAN/ - 第 14 章 - 生成对抗模型 Jupyter Notebook 实现 - 📁 chapter15_Transfer-Learning/ - 第 15 章 - 迁移学习 Jupyter Notebook 实现 - Go for it! - 📁 chapter16_Attention/ - 第 16 章 - 注意力机制 Jupyter Notebook 实现 - 📁 chapter17_Transformers/ - 第 17 章 - Transformers Jupyter Notebook 实现 - ... - 📁 imgs/ - Jupyter Notebook 中用到的图片 - 📁 docker/ - 为降低读者的学习成本,目前未进行搭建 - 📁 res/ - ui 图片及全书思维导图PDF - 📄 README.md - 全书介绍及目录

Index

L0CV DemoDay

L0CV-Universe

如果你也是从这里出发,在开源的项目中应用进去,并在标题下给出引用 L0CV,您的项目将会在这里展现!

以用促学,先会后懂。理解深度学习的最佳方法是学以致用。

《计算机视觉实战演练:算法与应用》V1.2 部分项目还在更新中*


实战项目章节BinderGoogle Colab
实战项目 1 - 手写字分类第 1 章 - 神经网络
实战项目 2 - 动手搭建一个卷积神经网络第 2 章 - 卷积神经网络
实战项目 3 - 基于卷积神经网络的人脸表情识别第 3 章 - 图像分类
实战项目 4 - 使用卷积神经网络对CIFAR10图片进行分类第 3 章 - 图像分类
实战项目 5 - 使用OpenCV进行图像全景拼接第 6 章 - 软件环境搭建与工具使用Binder
实战项目 6 - Kaggle比赛:图像分类(CIFAR-10)第 8 章 - 著名数据集及基准Binder
实战项目 7 - Kaggle比赛:狗的品种识别(ImageNet Dogs)第 8 章 - 著名数据集及基准Binder
[实战项目 8 - 基于PolarNet的点云端到端语义分割项目实战]()第 9 章 - 检测与分割实战项目
[实战项目 9 - 基于PyTorch的YOLO5目标检测项目实战]()第 9 章 - 检测与分割实战项目
实战项目 10 - 实时高分辨率背景抠图第 9 章 - 检测与分割实战项目
实战项目 11 - 车道线检测项目实战第 10 章 - 计算机视觉课题研究初探
实战项目 12 - PyTorch 如何使用TensorBoard第 13 章 - 可视化和理解
[实战项目 13 - 图像样式迁移]()第 14 章 生成对抗模型Binder
实战项目 14 - 旧照片修复第 14 章 - 生成对抗模型Binder
实战项目 15 - 动漫头像生成第 14 章 - 生成对抗模型Binder
项目实战 16 - 视频理解项目实战 SlowFast + Multi-Moments in Time第 16 章 - 视频理解Binder
实战项目 17 - 蚂蚁和蜜蜂的分类问题第 17 章 - 迁移学习 Binder
实战项目 18 - 基于Transformer的视频实例分割网络VisTR (CVPR2021)第 19 章 - 跨界模型 Transformer
实战项目 19 - 支付宝CVPR细粒度视觉分类挑战赛夺冠方案解读第 20 章 - 知识蒸馏
.........

Index

🔑 如何食用

🔎 详细攻略展开

方式一 Jupyter Notebook (推荐方式 ✨)

1. 本地运行

  • 依赖包安装
pip3 install -r requirements.txt
  • 安装 Jupyter
python3 -m pip install --upgrade pip
python3 -m pip install jupyter
  • 查看并运行jupyter

请在终端(Mac / Linux)或命令提示符(Windows)上运行以下命令:

cd notebooks
jupyter notesbook

2. 远程运行

  • 打开每章节首页,点击 可直接打开 Google Colab ,点击 Copy to Drive [Copy to Drive] 即可在线运行测试。
  • 点击 Binder 也可在 `mybinder` 查看和在线运行。

Run on Colab
图2 例子:12.3.3 样式迁移

点击 Copy to Drive
图3 例子:12.3.3 样式迁移 Colab 点击 Copy to Drive [Copy to Drive]

方式二 使用 `/code`

1. 运行环境 + L0CV 加载

  • 依赖包安装
sudo apt-get update
pip3 install -r requirements.txt
  • 创建 L0CV
python3 setup.py
  • 测试环境
cd code
python3 L0CV_test.py

2. 直接调用每个章节的代码测试

import L0CV

收起

Index

❓ 常见问题

  • 在线教程页面无法打开:
测试中存在部分人打不开在线教程的情况。
部分小伙伴反馈尝试切换浏览器后可以正常打开了,如果仍然不行,最有效的解决办法是科学上网。
  • 无法加载图片的解决办法:
根本解决办法还是科学上网,也可以尝试修改host文件看下是否能解决。
解决方案: 修改host文件 <code><a href="https://www.jianshu.com/p/25e5e07b2464"><img height="20" src="https://user-images.githubusercontent.com/29084184/126457822-d431fb90-6b9e-4a4e-bedc-3c598e9e2ee2.png" alt="Apple" title="Apple"></code> Mac</a> <code><a href="https://blog.csdn.net/u011583927/article/details/104384169"><img height="20" src="https://user-images.githubusercontent.com/29084184/126457902-0c1a71c2-f920-45a1-a143-ce8b5c435fe7.png" alt="Win10" title="Win10"></code> Windows</a>
  • 公式无法正常显示解决办法:
GitHub中的Markdown原生是不支持LATEX公式显示的,如果你喜欢在本项目中直接浏览教程,可以安装Chrome的`MathJax Plugin for Github`插件让大部分公式正常显示。而docs文件夹已经利用docsify被部署到了GitHub Pages上,包含公式的章节强力建议使用 [《计算机视觉实战演练:算法与应用》 在线阅读](https://charmve.github.io/computer-vision-in-action) 进行学习。

当然如果你还想跑一下运行相关代码的话还是得把本项目clone下来,然后运行code文件夹下相关代码。

Index

致谢

迈微AI研习社 Made With ML    异步社区    奇虎360

Index

参考文献

感谢前人的杰出工作,我才得以写出此书。感谢 参考文献 中列出及未列出的,所有对此开源工作有帮助的前辈!

Index

LICENSE

Code License 知识共享许可协议
  • `L0CV代码部分采用 [Apache 2.0协议](https://www.apache.org/licenses/LICENSE-2.0) 进行许可,包括名为 <b><em>L0CV</em></b> 的原创第三方库、/code和/notebook`下的源代码。遵循许可的前提下,你可以自由地对代码进行修改,再发布,可以将代码用作商业用途。但要求你:
    • 署名:在原有代码和衍生代码中,保留原作者署名及代码来源信息。
    • 保留许可证:在原有代码和衍生代码中,保留`Apache 2.0`协议文件。
  • `L0CV`文档部分采用 知识共享署名 4.0 国际许可协议 进行许可。 遵循许可的前提下,你可以自由地共享,包括在任何媒介上以任何形式复制、发行本作品,亦可以自由地演绎、修改、转换或以本作品为基础进行二次创作。但要求你:
    • 署名:应在使用本文档的全部或部分内容时候,注明原作者及来源信息。
    • 非商业性使用:不得用于商业出版或其他任何带有商业性质的行为。如需商业使用,请联系作者。
    • 相同方式共享的条件:在本文档基础上演绎、修改的作品,应当继续以知识共享署名 4.0国际许可协议进行许可。

Index

👥 社区互助

如果您在使用的过程中碰到问题,可以通过下面几个途径寻求帮助,同时我们也鼓励资深用户通过下面的途径给新人提供帮助。

  • 通过 GitHub Discuss 提问时,建议使用 Q&A 标签。
  • 通过 Stack Overflow 或者 Segment Fault 提问时,建议加上 L0CV 标签。
  • Segment Fault 微信、知乎、微博开话题可以生成tag,如微信聊天、朋友圈加 `#L0CV` 可话题交流。
  • L0CV 读者微信交流群 (加我微信Yida_Zhang2,备注:L0CV-高校/企业-称呼)

Index

💖 Support this project

Donating to help me continue working on this project. I'm appreciate all you in backer list. BuymeaCoffee

Buy Me A Coffee

CONTRIBUTION

作者会尽最大努力来确保书中内容的准确性,但难免会存在疏漏与不妥之处。欢迎您将发现的问题反馈给我们,帮助提升本开放资源的质量。

Help us make these docs great!

All VC-action docs are open source. See something that's wrong or unclear? Submit a pull request.

Make a contribution

Or, learn how to contribute.

Index

Citation

Use this bibtex to cite this repository:

@misc{computer-vision-in-action,
  title={计算机视觉实战演练:算法与应用(Computer Vision in Action)},
  author={Charmve},
  year={2021.06},
  publisher={Github},
  journal={GitHub repository},
  howpublished={\url{https://github.com/Charmve/computer-vision-in-action}},
}

Index

Stargazers Over Time

Awesome! Charmve/computer-vision-in-action was created 2 months ago and now has 1546 stars.

Stargazers over time


Go for it!

Feel free to ask any questions, open a PR if you feel something can be done differently!

🌟 Star this repository 🌟

Created by Charmve & maiwei.ai Community | Deployed on GitHub Page


book preface
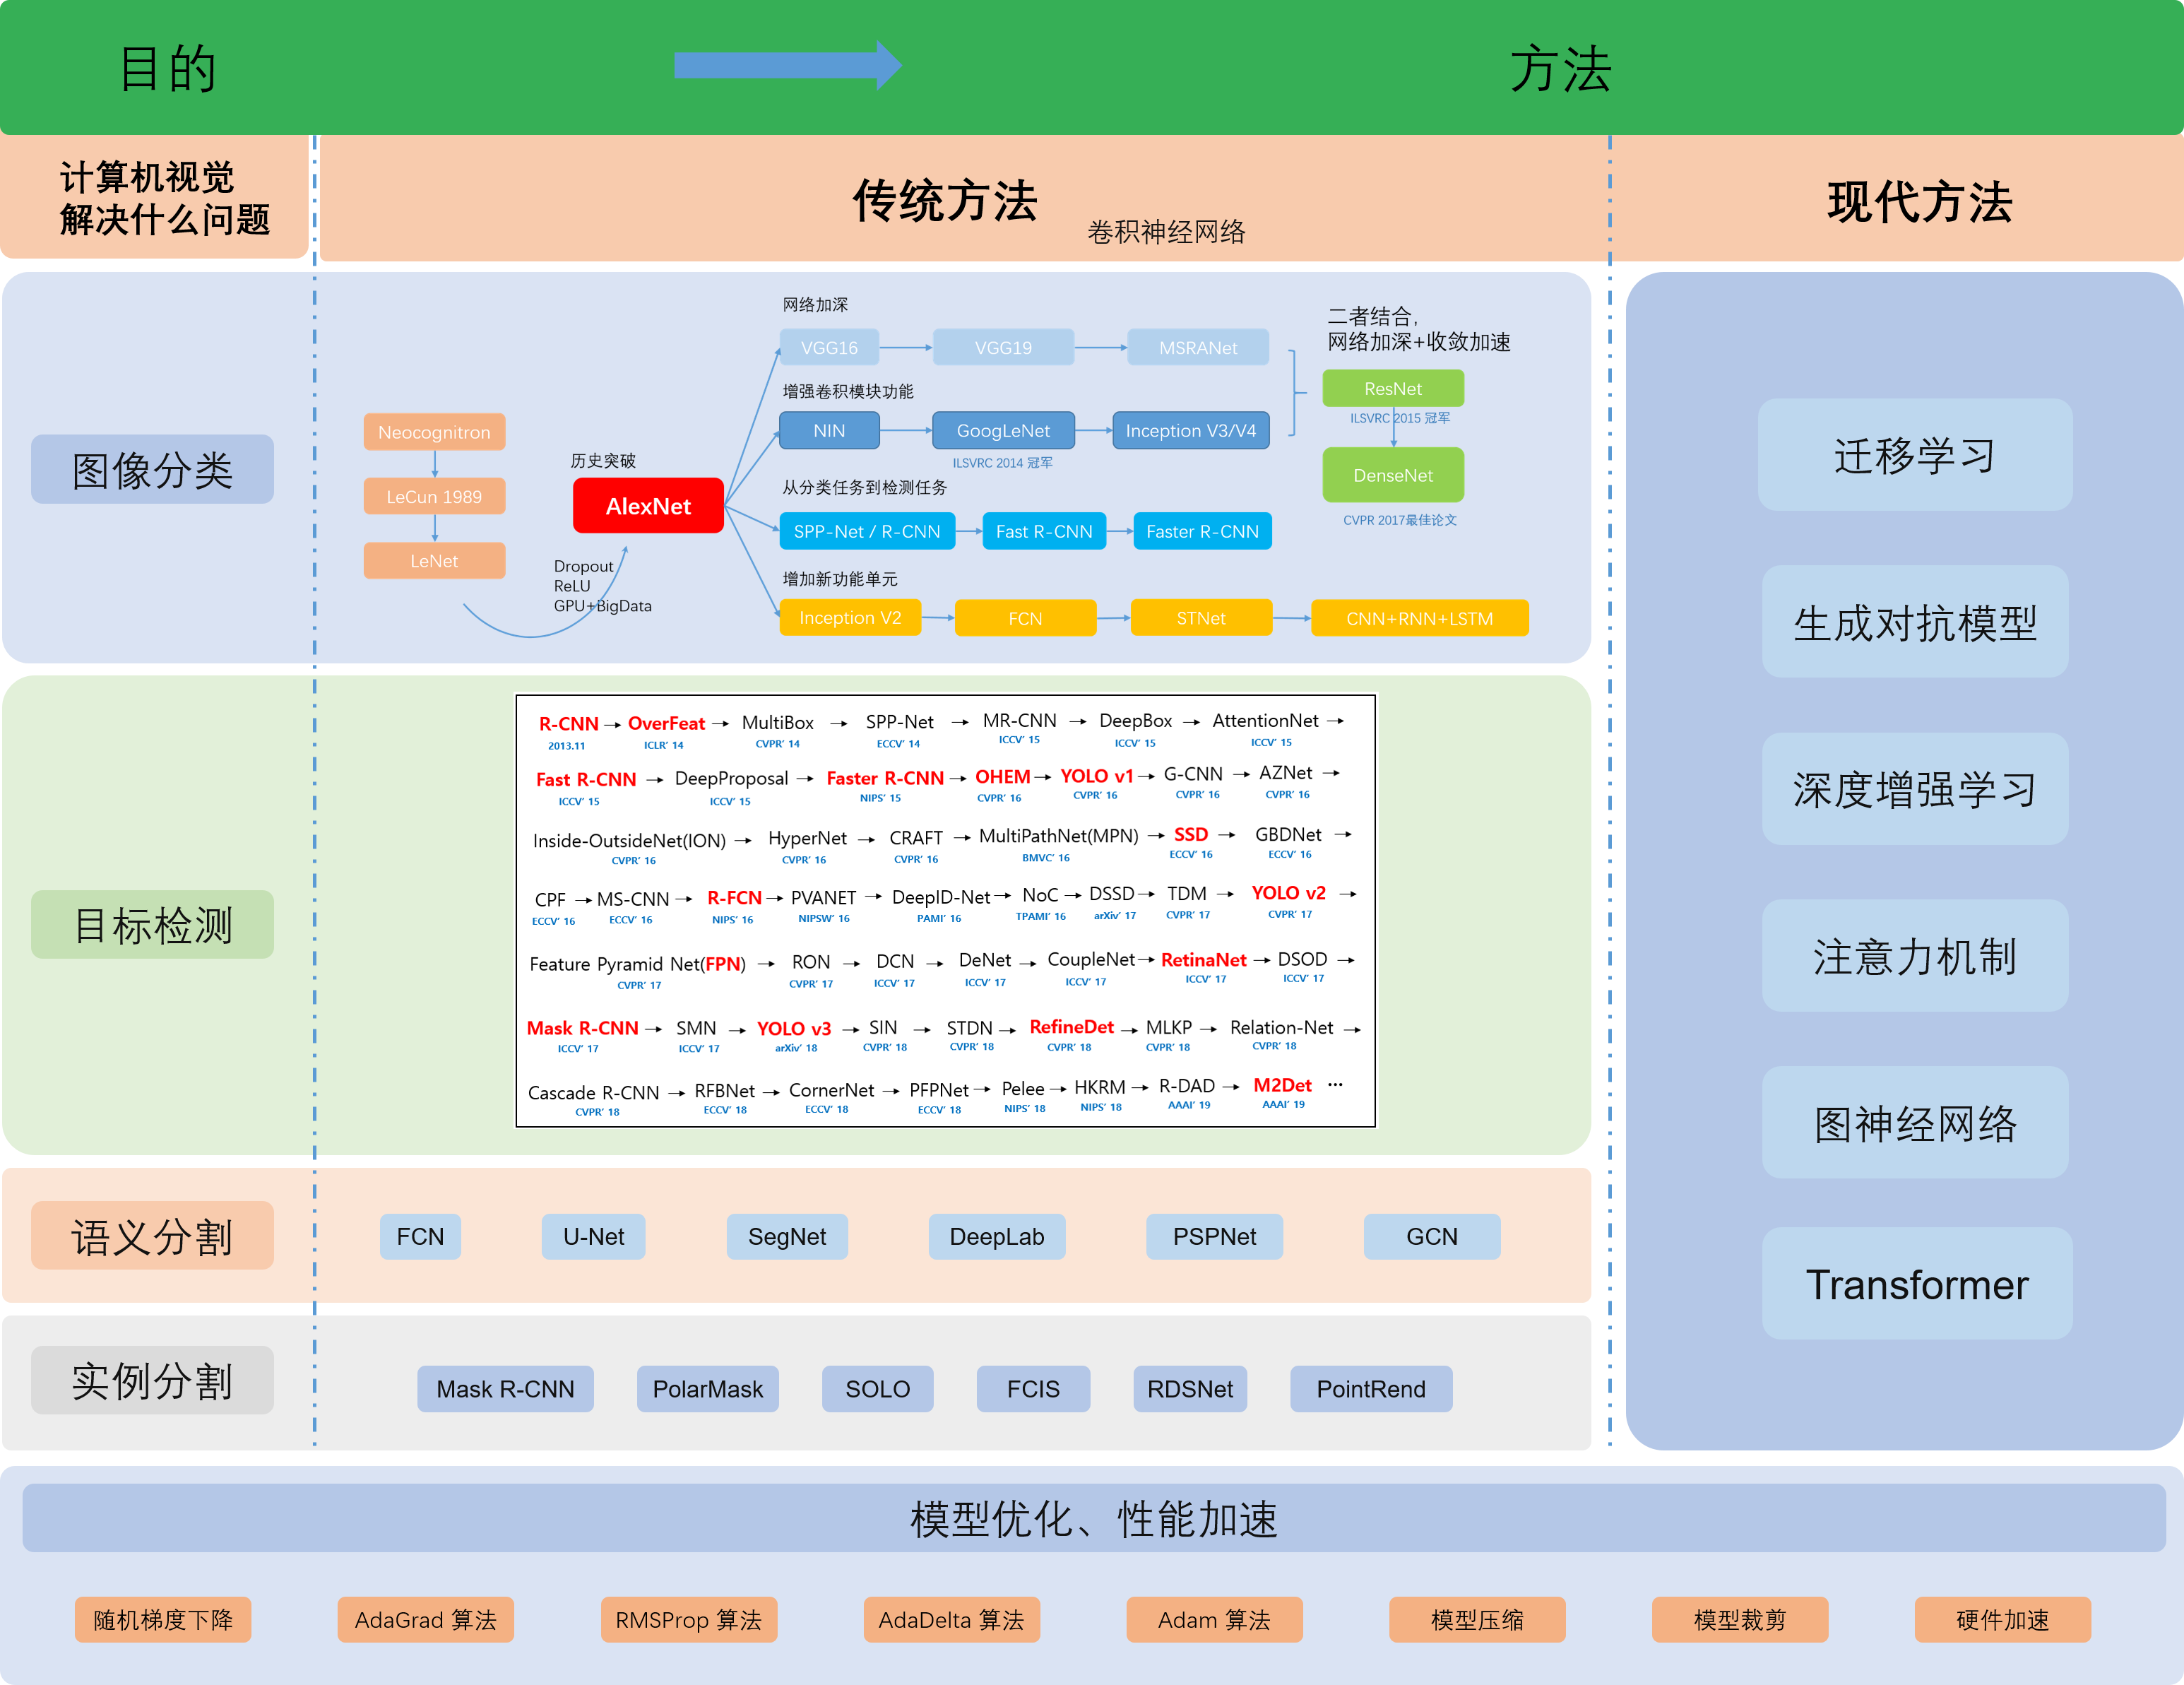
book_framework

🏷️ `fig_book_framework`

序言

就在过去的七八年时间里,深度学习给世界带来了惊喜,推动了计算机视觉、自然语言处理、自动语音识别、强化学习和统计建模等领域的快速发展。而计算机视觉又是受益颇深的一个领域,在诸多场景下收到了很好的效果。

关于本书

结合李沐老师团队的想法,这本书代表了作者新的尝试——让计算机视觉可平易近人,教会你 概念、场景 和 程序。

一种结合了代码、数据集和HTML的数字学习媒介

任何一种计算技术要想发挥其全部影响力,都必须得到充分的理解、充分的文档记录,并得到成熟的、维护良好的工具的支持。关键思想应该被清楚地提炼出来,尽可能减少需要让新的从业者跟上时代的入门时间。成熟的库应该自动化常见的任务,示例代码应该使从业者可以轻松地修改、应用和扩展常见的应用程序,以满足他们的需求。以动态网页应用为例。尽管许多公司,如亚马逊,在20世纪90年代开发了成功的数据库驱动网页应用程序。但在过去的10年里,这项技术在帮助创造性企业家方面的潜力已经得到了更大程度的发挥,部分原因是开发了功能强大、文档完整的框架。

测试深度学习的潜力带来了独特的挑战,因为任何一个应用都会将不同的学科结合在一起。应用深度学习需要同时了解:

  • (1)以特定方式提出问题的动机;
  • (2)给定建模方法的数学;
  • (3)将模型拟合数据的优化算法;
  • (4)能够有效训练模型、克服数值计算缺陷并最大限度地利用现有硬件的工程方法。同时教授表述问题所需的批判性思维技能、解决问题所需的数学知识,以及实现这些解决方案所需的软件工具,这是一个巨大的挑战。

在我们开始写这本书的时候,没有资源能够同时满足一些条件:

  • (1)是最新的;
  • (2)涵盖了现代机器学习的所有领域,技术深度丰富;
  • (3)在一本引人入胜的教科书中,你可以在实践教程中找到干净的可运行代码,并从中穿插高质量的阐述。

我们发现了大量关于如何使用给定的深度学习框架(例如,如何对TensorFlow中的矩阵进行基本的数值计算)或实现特定技术的代码示例(例如,LeNet、AlexNet、ResNet的代码片段),这些代码示例分散在各种博客帖子和GitHub库中。但是,这些示例通常关注如何实现给定的方法,但忽略了为什么做出某些算法决策的讨论。虽然一些互动资源已经零星地出现以解决特定主题。例如,在网站Distill上发布的引人入胜的博客帖子或个人博客,但它们仅覆盖深度学习中的选定主题,并且通常缺乏相关代码。另一方面,虽然已经出现了几本教科书,其中最著名的是:cite:Goodfellow.Bengio.Courville.2016(中文名《深度学习》),它对深度学习背后的概念进行了全面的调查,但这些资源并没有将这些概念的描述与这些概念的代码实现结合起来。有时会让读者对如何实现它们一无所知。此外,太多的资源隐藏在商业课程提供商的付费壁垒后面。

我们着手创建的资源可以:

  • (1)每个人都可以免费获得;
  • (2)提供足够的技术深度,为真正成为一名应用机器学习科学家提供起步;
  • (3)包括可运行的代码,向读者展示如何解决实践中的问题;
  • (4)允许我们和社区的快速更新;
  • (5)由一个论坛作为补充,用于技术细节的互动讨论和回答问题。

这些目标经常是相互冲突的。公式、定理和引用最好用LaTeX来管理和布局。代码最好用Python描述。网页原生是 HTML 和JavaScript的。此外,我们希望内容既可以作为可执行代码访问、作为纸质书访问,作为可下载的PDF访问,也可以作为网站在互联网上访问。目前还没有完全适合这些需求的工具和工作流程,所以我们不得不自行组装。我们在 :numref:sec_how_to_contribute 中详细描述了我们的方法。我们选择GitHub来共享源代码并允许编辑,选择Jupyter记事本来混合代码、公式和文本,选择Sphinx作为渲染引擎来生成多个输出,并为论坛提供讨论。虽然我们的体系尚不完善,但这些选择在相互冲突的问题之间提供了一个很好的妥协。我们相信,这可能是第一本使用这种集成工作流程出版的书。

在实践中学习

许多教科书教授一系列的主题,每一个都非常详细。例如,克里斯·毕晓普(Chris Bishop)的优秀教科书 :cite:Bishop.2006 ,对每个主题都教得很透彻,以至于要读到线性回归这一章需要大量的工作。虽然专家们喜欢这本书正是因为它的透彻性,但对于初学者来说,这一特性限制了它作为介绍性文本的实用性。

在这本书中,我们将适时教授大部分概念。换句话说,你将在实现某些实际目的所需的非常时刻学习概念。虽然我们在开始时花了一些时间来教授基础基础知识,如线性代数和概率,但我们希望你在担心更深奥的概率分布之前,先体会一下训练第一个模型的满足感。

除了提供基本数学背景速成课程的几节初步课程外,后续的每一章都介绍了合理数量的新概念,并提供一个独立工作的例子——使用真实的数据集。这带来了组织上的挑战。某些模型可能在逻辑上组合在单节中。而一些想法可能最好是通过连续允许几个模型来传授。另一方面,坚持“一个工作例子一节”的策略有一个很大的好处:这使你可以通过利用我们的代码尽可能轻松地启动你自己的研究项目。只需复制这一节的内容并开始修改即可。

我们将根据需要将可运行代码与背景材料交错。通常,在充分解释工具之前,我们常常会在提供工具这一方面犯错误(我们将在稍后解释背景)。例如,在充分解释随机梯度下降为什么有用或为什么有效之前,我们可以使用它。这有助于给从业者提供快速解决问题所需的弹药,同时需要读者相信我们的一些决定。

这本书将从头开始教授深度学习的概念。有时,我们想深入研究模型的细节,这些的细节通常会被深度学习框架的高级抽象隐藏起来。特别是在基础教程中,我们希望你了解在给定层或优化器中发生的一切。在这些情况下,我们通常会提供两个版本的示例:一个是我们从零开始实现一切,仅依赖于NumPy接口和自动微分;另一个是更实际的示例,我们使用深度学习框架的高级API编写简洁的代码。一旦我们教了您一些组件是如何工作的,我们就可以在随后的教程中使用高级API了。

内容和结构

全书大致可分为三个部分,在 🏷️ fig_book_org 中框图呈现:
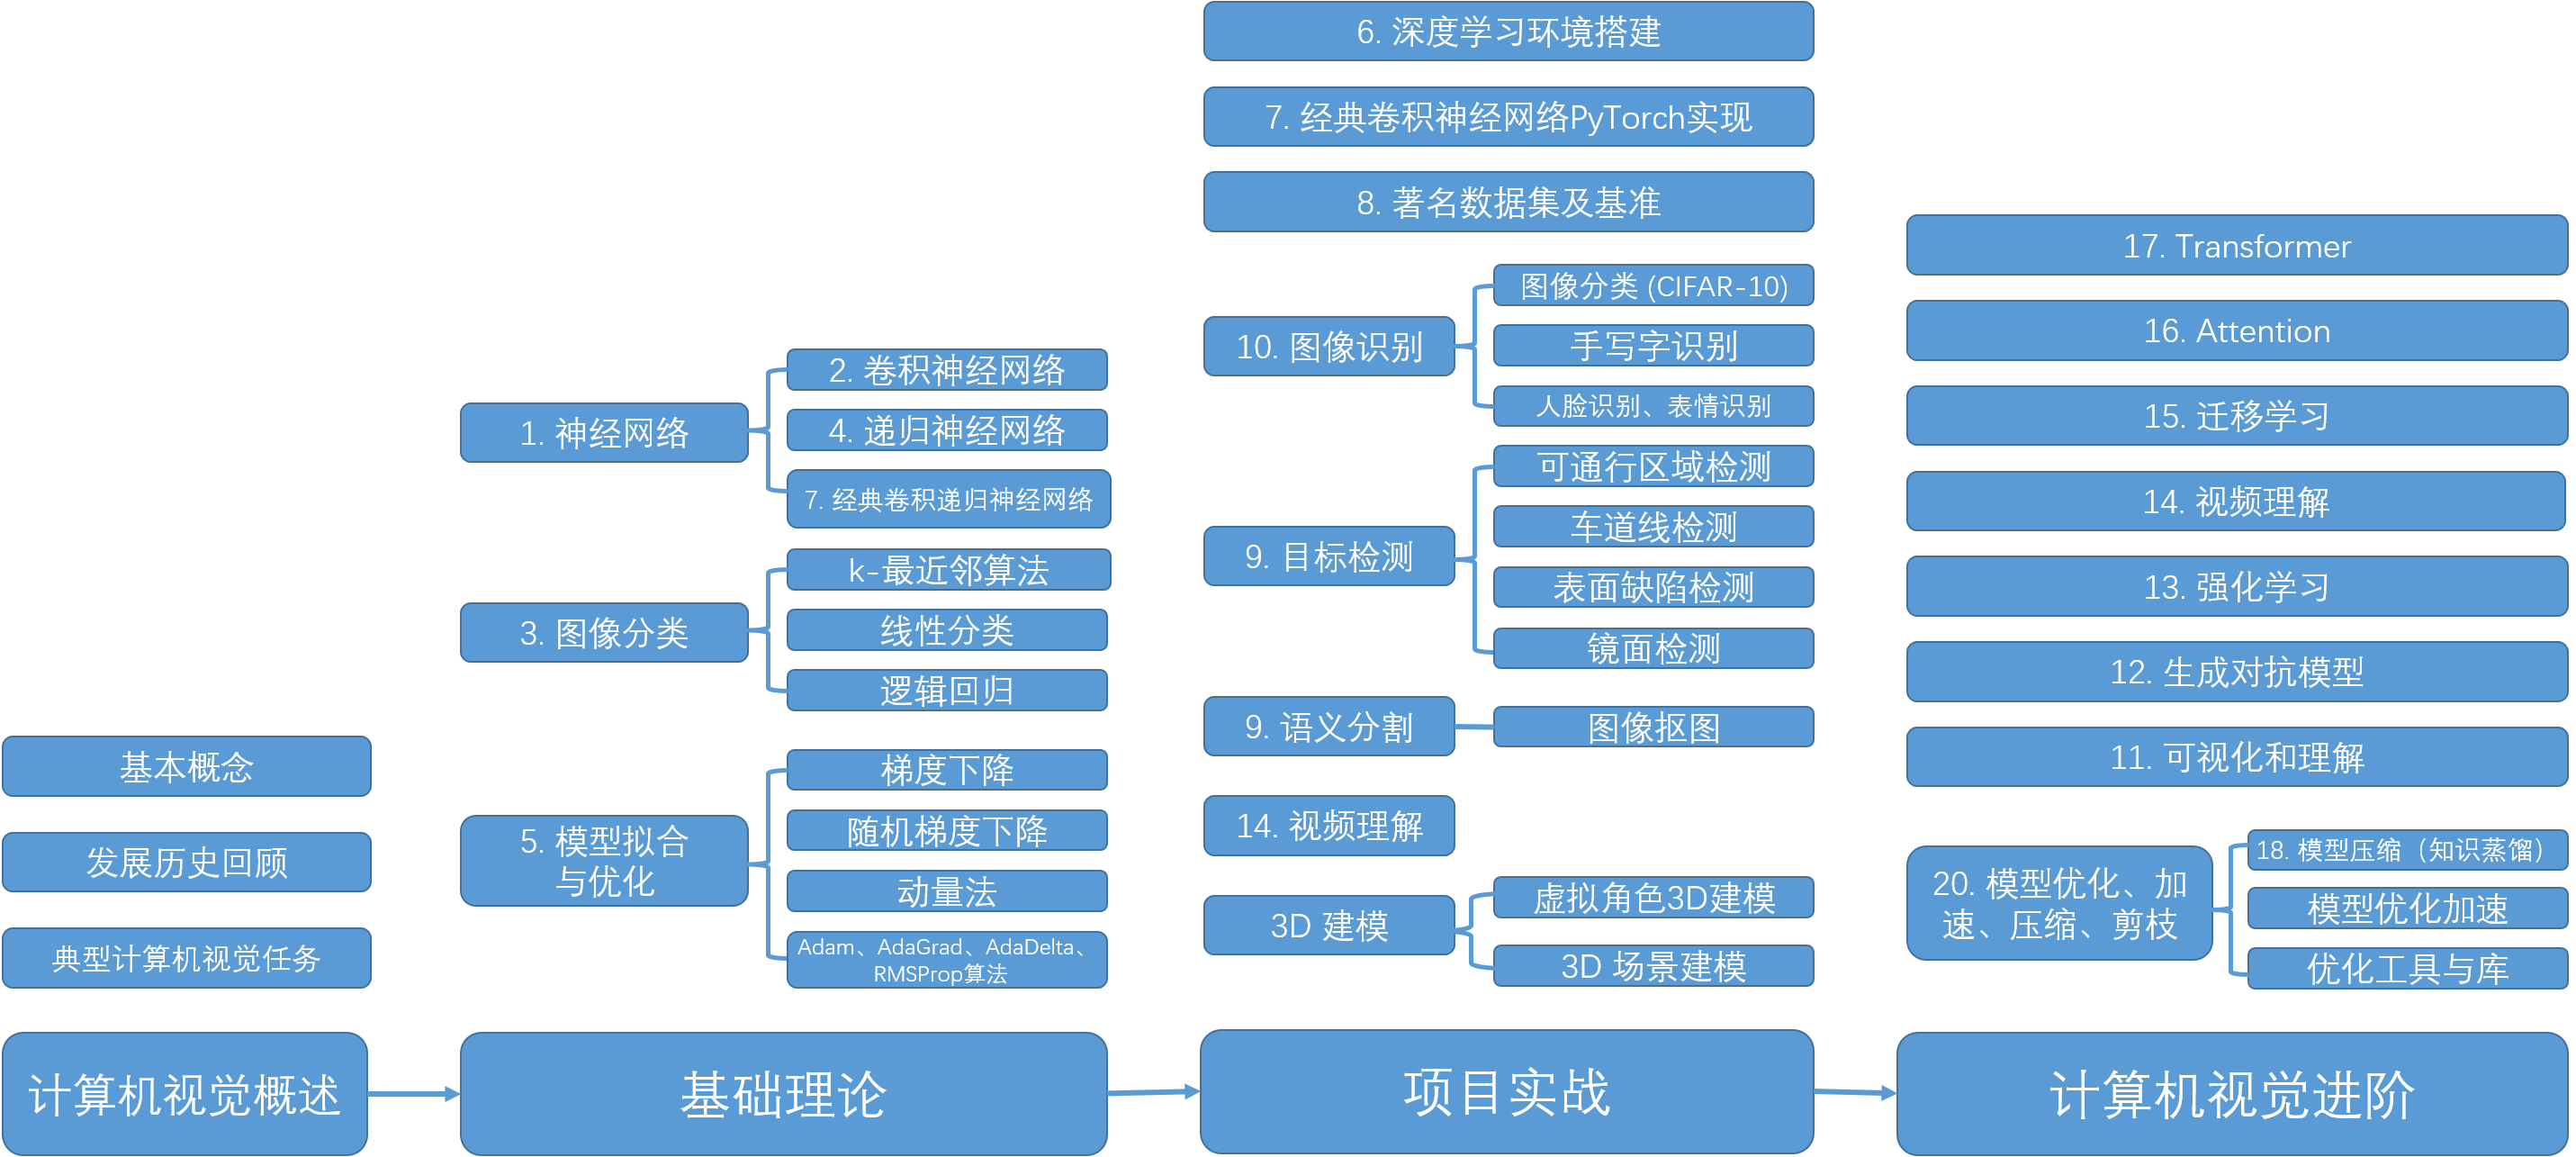
book_org.png

全书详细思维导图

  • 第一部分包括基础知识和预备知识。chap_introduction 提供深度学习的入门课程。然后在 chap_preliminaries 中,将快速向你介绍实践计算机视觉所需的前提条件,例如如何存储和处理数据,以及如何应用基于线性代数、微积分和概率基本概念的各种数值运算,涵盖了深度学习的最基本概念和技术,例如线性回归、多层感知机和正则化。
  • 第二部分是本书涉及的计算机视觉基础理论,核心部分为神经网络模型。包括神经网络、卷积神经网络、循环神经网络理论讲解,以图像分类、模型拟合与优化作为其代码的实战项目。在模型拟合和优化章节中,着重分享梯度下降、随机梯度下降、动量法、AdaBoost等方法。
  • 接下来的七章集中讨论现代计算机视觉技术实战。描述了计算机视觉的经典卷积神经网络PyTorch实现,并为我们随后实现更复杂的模型奠定了基础。接下来,在chap_cnn 和 chap_modern_cnn 中,我们介绍了卷积神经网络(convolutional neural network,CNN),这是构成大多数现代计算机视觉系统骨干的强大工具。随后,在 chap_rnn 和 chap_modern_rnn 中,我们引入了循环神经网络(recurrent neural network,RNN),这是一种利用数据中的时间或序列结构的模型,通常用于自然语言处理和时间序列预测,但在计算机视觉领域也表现出惊奇的效果。在chap_attention 中,我们介绍了一类新的模型,它采用了一种称为注意力机制的技术,最近它们已经开始在自然语言处理中取代循环神经网络。这一部分将帮助你快速了解大多数现代计算机视觉应用背后的基本工具。
  • 该部分以项目为实战指导,给出详细的项目指导书和代码实现,更为特别的是,给出了notebook可以直接在线运行,跑通结果,免去了本地运行环境的搭建复杂性。于此同时,为了方便读者在本地调试,作者建立了一个名为 L0CV 的第三方包,可以直接在代码中 `import L0CV` 后使用。
  • 第三部分讨论最近几年出现的“网红”模型,诸如:Transformer、Attention、知识蒸馏、迁移学习、生成对抗模型等。这部分也是此份资料的力挺之作。首先,在 chap_optimization 中,我们讨论了用于训练深度学习模型的几种常用优化算法。

代码

🏷️ sec_code
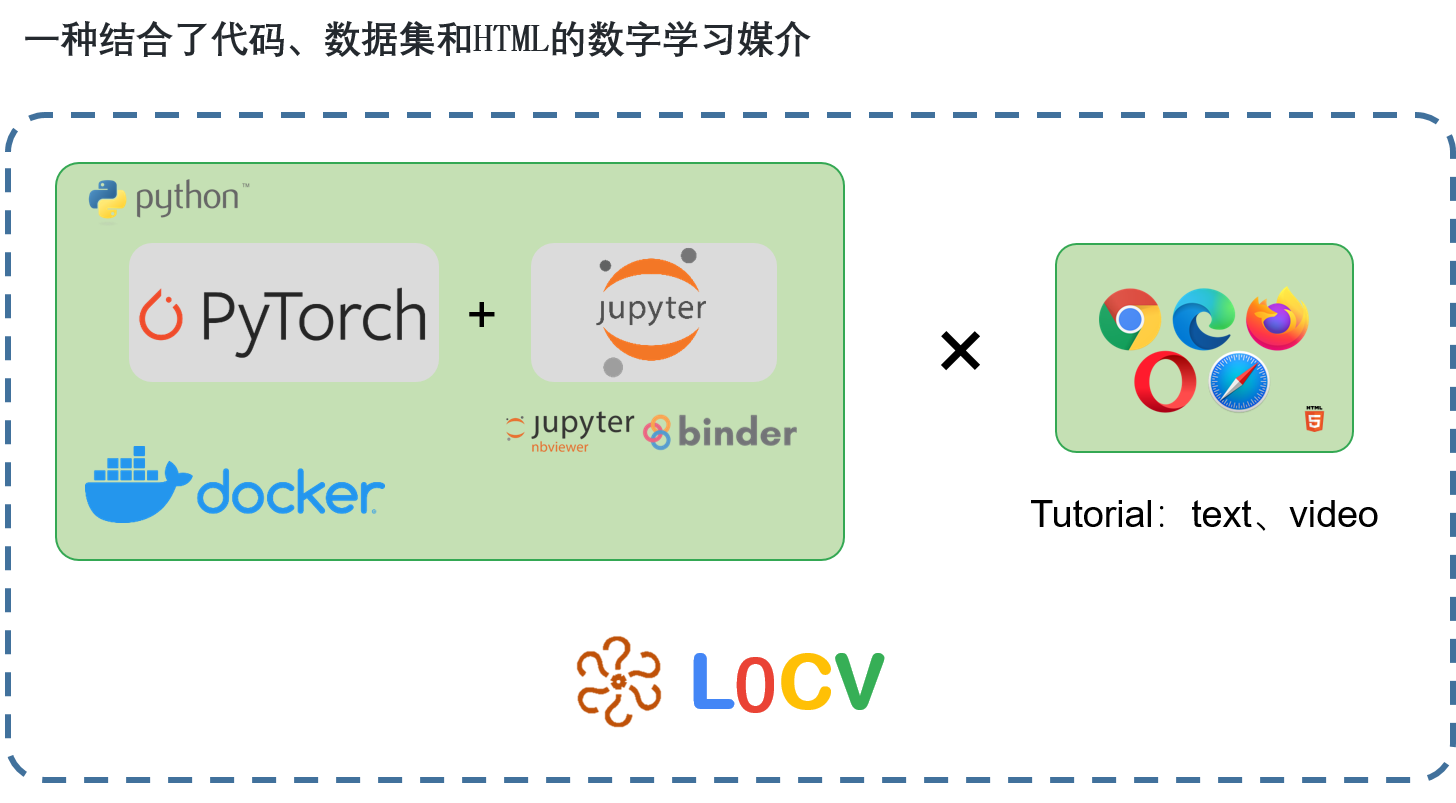
book_framework

本书的大部分章节都以可执行代码为特色,因为我们相信交互式学习体验在深度学习中的重要性。

有时,为了避免不必要的重复,我们将本书中经常导入和引用的函数、类等封装在L0CV包中。对于要保存到包中的任何代码块,比如一个函数、一个类或者多个导入,我们都会标记为#@save。我们在 sec_L0CV 中提供了这些函数和类的详细描述。L0CV 软件包是轻量级的,仅需要以下软件包和模块作为依赖项:

```{.python .input} #@tab all #@save import collections from collections import defaultdict from IPython import display import math from matplotlib import pyplot as plt import os import pandas as pd import random import re import shutil import sys import tarfile import time import requests import zipfile import hashlib L0CV = sys.modules[__name__]


``pytorch``

本书中的大部分代码都是基于PyTorch的。PyTorch是一个开源的深度学习框架,在研究界和产业界都非常受欢迎。本书中的所有代码都在最新版本的PyTorch下通过了测试。但是,由于深度学习的快速发展,一些在印刷版中代码可能在PyTorch的未来版本无法正常工作。

与此同时,在GitHub仓库中,我建立了一个L0CV的包,读者可以直接导入即可使用封装好的方法,``/notebook``文件夹下也同步了各章节中的``.ipynb``,你可以直接在**Colab**上运行代码,免去运行时环境的差异带来的不便。

但是,我们计划使在线版本保持最新。如果你遇到任何此类问题,请查看 `chap_installation` 以更新你的代码和运行时环境。

下面是我们如何从PyTorch导入模块。

{.python .input} #@tab pytorch #@save import numpy as np import torch import torchvision from torch import nn from torch.nn import functional as F from torch.utils import data from torchvision import transforms from PIL import Image


`tensorflow`

另外,我们也提供`tensorflow`版本,下面是我们如何从TensorFlow导入模块。

{.python .input} #@tab tensorflow #@save import numpy as np import tensorflow as tf ```

目标受众

本书面向学生(本科生或研究生)、工程师和研究人员,他们希望扎实掌握深度学习的实用技术,在计算机视觉领域得以应用。因为我们从头开始解释每个概念,所以不需要过往的深度学习或机器学习背景。更为特别的是,我在进阶篇中,解读了最新的cv研究成果,让学有余力或者想成为专业视觉算法工程师的小伙伴紧跟发展。如果你以前没有使用过Python语言,那也没关系,在第七章给出了基本的语法交互学习,numpy、Pandas 、Jupyter Notebook 基础使用。

论坛

与本书相关,我们已经启动了一个论坛,在Discuss.L0CV。当你对本书的任何一节有疑问时,你可以在每一节的末尾找到相关的讨论页链接。

致谢

还在汇总中。。。

小结

  • 深度学习已经彻底改变了模式识别,引入了一系列技术,包括计算机视觉、自然语言处理、自动语音识别。
  • 要成功地学习并掌握计算机视觉算法,你必须知道如何抛出一个问题、建模的数学方法、将模型与数据拟合的算法,以及实现所有这些的工程技术。
  • 这本书提供了一个全面的资源,包括文本、图表、数学和代码,都集中在一个地方。
  • 要回答与本书相关的问题,请访问我们的论坛 https://github.com/Charmve/computer-vision-in-action/discussions.
  • 所有Jupyter记事本都可以在GitHub上下载。

chapter0.1 概述

GitHub 微信公众号 知乎 B站 CSDN

第 0 章 计算机视觉概述

作者: 张伟 (Charmve)

日期: 2021/06/12

- 0.1 概述
  - 0.1.1 什么是计算机视觉
  - 0.1.2 计算机视觉解决什么问题
  - 0.1.3 行业应用
- 0.2 [计算机视觉基本概念](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/chapter0.2_计算机视觉基本概念.md)
- 0.3 [发展历史回顾](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/chapter0.3_发展历史回顾.md)
- 0.4 [典型的计算机视觉任务](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/chapter0.4_典型的计算机视觉任务.md)
  - 图像分类 
  - 目标识别与目标检测
  - 实例分割与语义分割
  - 3D 建模
- 0.5 [国内外优秀的计算机视觉团队汇总](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/chapter0.5_国内外优秀的计算机视觉团队汇总.md)
- 小练习
- 小结
- 参考文献

0.1 概述

「机器能够模拟人类视觉系统」的幻想已经过时了。自 1960 年代第一批学术论文出现以来,计算机视觉已经走了很远,现代系统已经出现,且它们可以集成到移动应用中。

今天,由于其广泛应用和巨大潜力,计算机视觉成为最热的人工智能和机器学习子领域之一。其目标是:复制人类视觉的强大能力。

但是,到底什么是计算机视觉?它在不同行业中的应用现状如何?知名的商业用例有哪些?典型的计算机视觉任务是什么?

本文将介绍计算机视觉的基础概念和现实应用,对任何听说过计算机视觉但不确定它是什么以及如何应用的人,本文是了解计算机视觉这一复杂问题的便捷途径。

0.1.1 什么是计算机视觉

0.1.2 计算机视觉解决什么问题

人类能够理解和描述图像中的场景。以下图0.1为例,人类能做到的不仅仅是检测到图像前景中有四个人、一条街道和几辆车。

image

图0.1 披头士专辑《艾比路》的封面。

(图源:https://liveforlivemusic.com/news/beatles-abbey-road/)

除了这些基本信息,人类还能够看出图像前景中的人正在走路,其中一人赤脚,我们甚至知道他们是谁。我们可以理性地推断出图中人物没有被车撞击的危险,白色的大众汽车没有停好。人类还可以描述图中人物的穿着,不止是衣服颜色,还有材质与纹理。

这也是计算机视觉系统需要的技能。简单来说,计算机视觉解决的主要问题是:

给出一张二维图像,计算机视觉系统必须识别出图像中的对象及其特征,如形状、纹理、颜色、大小、空间排列等,从而尽可能完整地描述该图像。

0.1.3 计算机视觉解决什么问题

计算机视觉完成的任务远超其他领域,如图像处理、机器视觉,尽管它们存在一些共同点。接下来,我们就来了解一下这些领域之间的差异。

  • 图像处理

图像处理旨在处理原始图像以应用某种变换。其目标通常是改进图像或将其作为某项特定任务的输入,而计算机视觉的目标是描述和解释图像。例如,降噪、对比度或旋转操作这些典型的图像处理组件可以在像素层面执行,无需对图像整体具备全面的了解。

  • 机器视觉

机器视觉是计算机视觉用于执行某些(生产线)动作的特例。在化工行业中,机器视觉系统可以检查生产线上的容器(是否干净、空置、无损)或检查成品是否恰当封装,从而帮助产品制造。

  • 计算机视觉

计算机视觉可以解决更复杂的问题,如人脸识别、详细的图像分析(可帮助实现视觉搜索,如 Google Images),或者生物识别方法。

0.1.4 行业应用

人类不仅能够理解图像中的场景,稍加训练,还能解释书法、印象派画家、抽象画,以及胎儿的二维超声图像。

从这个角度来看,计算机视觉领域尤其复杂,它拥有大量的实际应用。

从电商到传统行业,各种类型和规模的公司现在都可以利用计算机视觉的强大能力,这是依赖于人工智能和机器学习(更具体地说是计算机视觉)的创新所带来的利好。

下面我们就来看看,近年来受计算机视觉影响最大的行业应用。

零售业

近年来,计算机视觉在零售业的应用已成为最重要的技术趋势之一。下文将介绍一些常见的用例。如果你想对计算机视觉在零售业的潜在应用有更详细的了解,请参考:https://tryolabs.com/resources/retail-innovations-machine-learning/。

行为追踪

实体零售店利用计算机视觉算法和摄像头,了解顾客及其行为。

计算机视觉算法能够识别人脸,确定人物特征,如性别或年龄范围。此外,零售店还可以利用计算机视觉技术追踪顾客在店内的移动轨迹,分析其移动路线,检测行走模式,并统计零售店店面受到行人注意的次数。

image

图0.2 行为追踪

添加视线方向检测后,零售店能够回答这一重要问题:将店内商品放在哪个位置可以提升消费者体验,最大化销售额。

计算机视觉还是开发防盗窃机制的强大工具。人脸识别算法可用于识别已知的商店扒手,或检测出某位顾客将商品放入自己的背包。

库存管理

计算机视觉在库存管理方面有两个主要的应用。

通过安防摄像头图像分析,计算机视觉算法可以对店内剩余商品生成非常准确的估计。对于店铺管理者来说,这是非常宝贵的信息,它可以帮助管理者立即察觉不寻常的货物需求,并及早作出反应。

另一个常见应用是:分析货架空间利用情况,识别次优配置。除了发现被浪费的空间以外,此类算法还可以提供更好的货品摆放方案。

制造业

生产线上的主要问题是机器中断或残次品,这些问题会导致生产延迟和利润损失。

计算机视觉算法被证实是实施预测性维护的好方法。算法通过分析(来自机器人身上摄像头等的)视觉信息,预先发现机器的潜在问题。此类系统可以预测包装或汽车装配机器人是否会中断,这是一项巨大的贡献。

这同样可用于降低不良率,系统可以检测出整个生产线上各个组件中的缺陷。这使得制造商实时响应,采取解决办法。缺陷可能不那么严重,生产流程可以继续,但是产品以某种方式被标记,或者被指向特定的生产路径。但是,有时停止生产线是必要的。为了进一步的利益,此类系统可以针对每个用例进行训练,按类型和严重程度对缺陷进行分类。

医疗行业

在医疗行业中,现有计算机视觉应用的数量非常庞大。

毫无疑问,医疗图像分析是最著名的例子,它可以显著提升医疗诊断流程。此类系统对 MRI 图像、CT 扫描图像和 X 光图像进行分析,找出肿瘤等异常,或者搜索神经系统疾病的症状。

在很多情况下,图像分析技术从图像中提取特征,从而训练能够检测异常的分类器。但是,一些特定应用需要更细化的图像处理。例如,对结肠镜检查图像进行分析时,分割图像是必要的,这样才能找出肠息肉,防止结直肠癌。

图0.3 胸腔 3D 渲染 CT 扫描图像的体分割。

(图源:https://en.wikipedia.org/wiki/Image_segmentation)

上图是观察胸腔元素所需的图像分割结果。该系统分割每个重要部分并着色:肺动脉(蓝色)、肺静脉(红色)、纵膈(黄色)和横膈(紫色)。

目前大量此类应用已经投入使用,如估计产后出血量、量化冠状动脉钙化情况、在没有 MRI 的情况下测定人体内的血流量。

但是,医疗图像并非计算机视觉在医疗行业中唯一的用武之地。比如,计算机视觉技术为视障人士提供室内导航帮助。这些系统可以在楼层平面图中定位行人和周围事物等,以便实时提供视觉体验。视线追踪和眼部分析可用于检测早期认知障碍,如儿童自闭症或阅读障碍,这些疾病与异常注视行为高度相关。

自动驾驶

你是否思考过,自动驾驶汽车如何「看」路?计算机视觉在其中扮演核心角色,它帮助自动驾驶汽车感知和了解周围环境,进而恰当运行。

计算机视觉最令人兴奋的挑战之一是图像和视频目标检测。这包括对不同数量的对象进行定位和分类,以便区分某个对象是交通信号灯、汽车还是行人,如下图所示:

自动驾驶汽车目标检测

图0.4 自动驾驶汽车目标检测。

(图源:https://cdn-images-1.medium.com/max/1600/1*q1uVc-MU-tC-WwFp2yXJow.gif)

此类技术,加上对来自传感器和/或雷达等来源的数据进行分析,使得汽车能够「看见」。

图像目标检测是一项复杂的强大任务,之前我们曾经讨论过,参见:https://tryolabs.com/blog/2017/08/30/object-detection-an-overview-in-the-age-of-deep-learning/。

另一篇文章从人类-图像交互的角度探讨这一主题,参见:https://tryolabs.com/blog/2018/03/01/introduction-to-visual-question-answering/。

保险业

计算机视觉在保险业中的应用影响很大,尤其是在理赔处理中。

计算机视觉应用可以指导客户以视觉形式进行理赔文件处理。它可以实时分析图像并发送至适合的保险经纪人。同时,它可以估计和调整维护费用,确定是否在保险覆盖范围内,甚至检测是否存在保险欺诈。所有这些最大程度上缩短了索赔流程,为客户提供更好的体验。

从预防的角度来看,计算机视觉在避免意外事故方面用处极大。大量可用于阻止碰撞的计算机视觉应用被整合到工业机械、汽车和无人机中。这是风险管理的新时代,可能改变整个保险业。

农业

计算机视觉对农业有极大影响,尤其是精准农业。

在粮食生产这一全球经济活动中,存在一系列宝贵的计算机视觉应用。粮食生产面临一些反复出现的问题,之前这些问题通常由人类监控。而现在,计算机视觉算法可以检测或合理预测病虫害。此类早期诊断可帮助农民快速采取合适措施,减少损失,保证生产质量。

另一项长期挑战是除草,因为杂草对除草剂产生抗药性,可能给农民带来严重损失。现在出现了配备有计算机视觉技术的机器人,它们可以监控整片农田,精准喷洒除草剂。这极大地节约了使用农药量,为地球环境和生产成本均带来了极大的益处。

土壤质量也是农业中的一大主要因素。一些计算机视觉应用可以从手机拍摄的照片中识别出土壤的潜在缺陷和营养缺乏问题。分析之后,这些应用会针对检测出的土壤问题,提供土壤恢复技术和可能的解决方案。

计算机视觉还可用于分类。一些算法通过识别水果、蔬菜甚至花卉的主要特性(如大小、质量、重量、颜色、纹理等),对其进行分类。这些算法还能够检测缺陷,估计出哪些农产品保鲜期较长、哪些应该放置在本地市场售卖。这极大延长了农产品的保鲜期,减少了农产品上市前所需时间。

安防

与零售业类似,对安全具备高要求的企业(如银行或赌场)可从计算机视觉应用中获益,这些应用对安防摄像头拍摄的图像进行分析,从而识别顾客。

而从另一个层面上来讲,计算机视觉是国土安全任务中的强大工具。它可用于改进港口货物检验,或者监控敏感场所,如大使馆、发电站、医院、铁路和体育场。这里,计算机视觉不仅能够分析和分类图像,还能对场景提供详细且有意义的描述,为决策实时提供关键因素。

通常,计算机视觉广泛应用于国防任务,如侦察敌军地形、自动确认图像中的敌军、自动化车辆和机器移动,以及搜索援救。


chapter0.3 发展历史回顾

GitHub 微信公众号 知乎 B站 CSDN

第 0 章 计算机视觉概述

作者: 张伟 (Charmve)

日期: 2021/06/12

  - 图像分类 
  - 目标识别与目标检测
  - 实例分割与语义分割
  - 3D 建模


image

图1 Hubel and Wiesel Experiment

image

图2 LeCun等人用神经网络进行手写字识别

image

图3 (左)八张 ILSVRC-2010 测试图像和我们模型认为最有可能的五个标签。 正确的标签写在每张图像下,分配给正确标签的概率也用红色条显示(如果它恰好在前 5 个)。 (右)第一列中的五个 ILSVRC 2010 测试图像。 剩余的列显示了六个训练图像,它们在最后一个隐藏层中产生特征向量,与测试图像的特征向量的欧几里德距离最小。

0.3 发展历史回顾

作者: 张伟 (Charmve)

日期: 2021/04/29

年份事件相关论文/Reference
1959Hubel 和Wiesel 对猫进行了实验(为了研究视觉的工作方式)Hubel, D. H., & Wiesel, T. N. (1959). Receptive fields of single neurones in the cat's striate cortex. The Journal of physiology, 148(3), 574-591.
1963计算机视觉领域的先驱Larry Roberts 在他的博士论文中试图提取「积木世界(Block World)」的3D 几何信息Roberts, L. S. (1963).ERGASILUS NERKAE N. SP. (COPEPODA: CYCLOPOIDA) FROM BRITISH COLUMBIA WITH A DISCUSSION OF THE COPEPODS OF THE E. CAERULEUS GROUP.Journal of Zoology, 41:115-124.
1966Summer Vision 项目启动,人们普遍认为这就意味着计算机视觉的诞生Papert, S. A. (1966). The summer vision project.
1982David Marr 的《视觉(Vision)》一书影响和激励了这一领域的一代研究者,该书暗示了以「层」的方式看待图像的思想Marr, D., & Vision, A. (1982). A computational investigation into the human representation and processing of visual information. WH San Francisco: Freeman and Company, 1(2).
20世纪80年代光学字符识别(OCR)技术开始在工业应用中使用Tanaka H.; Hirakawa Y.; Kaneku S. (1982). Recognition of distorted patterns using Viterbi algorithm. IEEE T. Pattern Anal. Mach. lntell. 4, 18-25.//Shildhar M.; Badreldin A.(1985). A high accuracy syntactic recognition algorithm for handwritten numerals, IEEE T. Syst. Man Cyb. 15.//Tampi K.R.; Chetlur S. S. (1986). Segmentation of handwritten characters, Proc. 8th Int. J. Conf. Pattern Recognition. pp684-686.
1990神经网络技术(CNN)开始被用于手写识别LeCun, Y., Boser, B. E., Denker, J. S., Henderson, D., Howard, R. E., Hubbard, W. E., & Jackel, L. D. (1990). Handwritten digit recognition with a back-propagation network. In Advances in neural information processing systems (pp. 396-404).
2001Viola 和Jones 开始了面部检测研究;计算机视觉的研究重心发生转移,从建模物体的 3D 形状转向了识别物体是什么Viola, P., & Jones, M. (2001). Rapid object detection using a boosted cascade of simple features. In Computer Vision and Pattern Recognition, 2001. CVPR 2001. Proceedings of the 2001 IEEE Computer Society Conference on (Vol. 1, pp. I-I). IEEE.
2009ImageNet 建立Deng, J., Dong, W., Socher, R., Li, L. J., Li, K., & Fei-Fei, L. (2009, June). Imagenet: A large-scale hierarchical image database. In Computer Vision and Pattern Recognition, 2009. CVPR 2009. IEEE Conference on (pp. 248-255). IEEE.
2012AlexNet 在ImageNet 竞赛中获胜Krizhevsky, A., Sutskever, I., & Hinton, G. E. (2012). Imagenet classification with deep convolutional neural networks. In Advances in neural information processing systems (pp. 1097-1105).
2014Christian Szegedy等人提出了对抗样本(Adversarial Examples)这个概念Szegedy, C.; Zaremba, W. (2014).Intriguing properties of neural networks.arXiv:1312.6199v4.
2018加拿大约克大学、Ryerson 大学的研究者们提出了使用「双流卷积神经网络」的动画生成方法,其参考了人类感知动态纹理画面的双路径模式。Tesfaldet, M.; Brubaker, M. A.; Derpanis, K. G. (2018).Two-Stream Convolutional Networks for Dynamic Texture Synthesis.arXiv:1706.06982.

chapter0.4 典型的计算机视觉任务

GitHub 微信公众号 知乎 B站 CSDN

第 0 章 计算机视觉概述

作者: 张伟 (Charmve)

日期: 2021/06/12

  • 第 0 章 计算机视觉概述
- 0.1 [概述](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/chapter0.1_概述.md)
  - 0.1.1 什么是计算机视觉
  - 0.1.2 计算机视觉解决什么问题
  - 0.1.3 行业应用
- 0.2 [计算机视觉基本概念](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/0_绪论/chapter0.2_计算机视觉基本概念.md)
- 0.3 [发展历史回顾](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/0_绪论/chapter0.3_发展历史回顾.md)
- 0.4 [典型的计算机视觉任务](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/0_绪论/chapter0.4_典型的计算机视觉任务.md)
  - 0.4.1 图像分类 
  - 0.4.2 目标识别与目标检测
  - 0.4.3 实例分割与语义分割
  - 0.4.4 3D 建模
- 0.5 [国内外优秀的计算机视觉团队汇总](https://raw.githubusercontent.com/Charmve/computer-vision-in-action/HEAD/docs/0_绪论/chapter0.5_国内外优秀的计算机视觉团队汇总.md)
- 小练习
- 小结
- 参考文献

0.4 典型的计算机视觉任务

作者: 张伟 (Charmve)

日期: 2021/06/13

0.4.1 图像分类

0.4.2 目标识别与目标检测

(1) 目标识别

(2)训练目标检测模型

  • Viola–Jones 方法

有很多种方法可以解决目标检测问题。很多年来,Paul Viola 和 Michael Jones 在论文《Robust Real-time Object Detection》中提出的方法成为流行的方法。

尽管该方法可用来检测大量对象类别,但它最初是受人脸检测目标的启发。该方法快速、直接,是傻瓜相机中所使用的算法,它可以在几乎不浪费处理能力的情况下执行实时人脸检测。

该方法的核心特征是:基于哈尔特征与大量二分类器一起训练。哈尔特征表示边和线,计算简单。

image

图0.4 哈尔特征

(图源:https://docs.opencv.org/3.4.3/haar_features.jpg)

尽管比较基础,但在人脸检测这一特定案例下,这些特征可以捕捉到重要元素,如鼻子、嘴或眉间距。该监督方法需要很多正类和负类样本。

  • 基于卷积神经网络的方法

深度学习变革了机器学习,尤其是计算机视觉。目前基于深度学习的方法已经成为很多计算机视觉任务的前沿技术。

其中,R-CNN 易于理解,其作者提出了一个包含三个阶段的流程:

  1. 利用区域候选(region proposal)方法提取可能的对象。
  1. 使用 CNN 识别每个区域中的特征。
  1. 利用支持向量机(SVM)对每个区域进行分类。

image

图0.5 R-CNN 架构

(图源:https://arxiv.org/abs/1311.2524)

该区域候选方法最初由论文《Selective Search for Object Recognition》提出,尽管 R-CNN 算法并不在意使用哪种区域候选方法。步骤 3 非常重要,因为它减少了候选对象的数量,降低了计算成本。

这里提取的特征没有哈尔特征那么直观。总之,CNN 可用于从每个区域候选中提取 4096 维的特征向量。鉴于 CNN 的本质,输入应该具备同样的维度。这也是 CNN 的弱点之一,很多方法解决了这个问题。回到 R-CNN 方法,训练好的 CNN 架构要求输入为 227 × 227 像素的固定区域。由于候选区域的大小各有不同,R-CNN 作者通过扭曲图像的方式使其维度满足要求。

image

图0.6 满足 CNN 输入维度要求的扭曲图像示例。

0.4.3 实例分割与语义分割

0.4.4 3D 建模


chapter0.5 国内外优秀的计算机视觉团队汇总

GitHub 微信公众号 知乎 B站 CSDN

第 0 章 计算机视觉概述

作者: 张伟 (Charmve)

日期: 2021/06/12

  - 图像分类 
  - 目标识别与目标检测
  - 实例分割与语义分割
  - 3D 建模

0.5 国内外优秀的计算机视觉团队汇总
计算机视觉名人堂

本汇总还在更新中,国内外优秀的计算机视觉团队有很多,我这里只是列举了自己从知乎、CSDN等网站上收集到的,排名不分先后,如有遗漏,还请谅解。同时欢迎小伙伴提`国内外优秀的计算机视觉团队汇总增加补充`PR,我会及时更新,谢谢~

感谢极市平台微信公众号的粉丝 Alan、Andy、陈、蓝色格调、亚辉、邵帅、城邑、SuperMAN和知乎好友:Shihua Huang的补充贡献。

最后更新于2020/7/22,已累计更新 10次,材料整合自极市开发者社区@chengzi和知乎@Charles

以下团队近3年内基本上有3篇以上的CV顶会(CVPR ICCV ECCV NIPS),主要分布于:

  • 香港高校:港中文、港科大、港理工、港中文(深圳)
  • 内地高校:(不一而足)
  • 新兴大学:上科大、南科大、西湖大学
  • 中科院研究所:自动化所、计算所、信工所、深圳先进所
  • 工业界研究院:微软、腾讯、阿里、京东、旷视、商汤、依图、图森等

0.5.1 中国内地院校

清华大学

北京大学

  • 高文(工程院院士,ACM Fellow,IEEE Fellow) Wen Gao - Google Scholar Citations
  • 施柏鑫 www.shiboxin.com
  • 刘家瑛 Jiaying Liu
  • 黄铁军(长江学者) Tiejun Huang at PKU
  • 林宙辰(IEEE Fellow) Zhouchen Lin
  • 段凌宇 Lingyu Duan 段凌宇 - Google Scholar Citations
  • 郭宗明 Zongming Guo - Google Scholar
  • 连宙辉 Zhouhui Lian's Homepage
  • 张史梁 Welcome to Shiliang Zhang's Homepage

北京航空航天大学

  • 王蕴红 Prof. Yunhong Wang
  • 刘偲 CoLab
  • 李甲 Jia Li (李甲) - cvteam
  • 黄迪 Di Huang
  • 盛律 Lu Sheng's Homepage

北京理工大学

  • 沈建冰 iitlab.bit.edu.cn/mcislab/~shenjianbing/
  • 贾云得 Jia Yunde

北京邮电大学

  • 郭军 郭军 | 北邮模式识别实验室
  • 南开大学
  • 程明明 程明明 – 南开大学媒体计算实验室
  • 杨巨峰 计算机视觉实验室

上海交通大学

  • 卢策吾 Cewu Lu
  • 严骏驰 Junchi Yan - 上海交通大学
  • 张拳石 Quanshi Zhang | 张拳石

复旦大学

  • 姜育刚 Prof. Yu-Gang Jiang | Home Page
  • 薛向阳 Xiangyang Xue - Google Scholar Citations
  • 付彦伟 Yanwei Fu: EECS-QMUL

南京大学

  • 王利民 Limin Wang
  • 吴建鑫 Jianxin Wu's homepage
  • 曹汛 Xun Cao, Professor

南京理工大学

浙江大学

  • 庄越挺(长江学者) Yueting Zhuang - Google Scholar
  • 何晓飞 Xiaofei He
  • 宋明黎 Song, Mingli - Google Scholar Citations
  • 周晓巍 Xiaowei Zhou

中国科学技术大学

  • 周文罡 周文罡-个人主页
  • 张天柱 张天柱|中国科学技术大学信息科学技术学院自动化系
  • 查正军 查正军|中国科学技术大学信息科学技术学院自动化系

厦门大学

  • 纪荣嵘 纪荣嵘 @ 厦门大学
  • 丁兴号 丁兴号|厦门大学智能数据分析与处理实验室

中山大学

  • 林倞 On Journey... | Liang Lin's Website
  • 梁小丹 Xiaodan Liang
  • 郑伟诗 Wei-Shi Zheng(郑伟诗) - iSEE-SYSU
  • 张冬雨 张冬雨 | 数据科学与计算机学院
  • 李冠彬 Guanbin Li (李冠彬)

华南理工大学

  • 贾奎 Kui Jia (贾奎) - Google Scholar Citations
  • 金连文 www.hcii-lab.net/lianwen/
  • 谭明奎 Mingkui Tan's Homepage

华中科技大学

  • 白翔 Homepage of Xiang Bai
  • 王兴刚 Xinggang Wang, Associate Professor in Huazhong University of Sci. and Tech.
  • 桑农 桑农-人工智能与自动化学院

武汉大学

西安交通大学

  • 郑南宁(工程院院士,IEEE Fellow) 郑南宁-人工智能与机器人研究所
  • 龚怡宏(IEEE Fellow) 个人简介 - 西安交通大学教师个人主页
  • 薛建儒(长江学者) 西安交通大学教师个人主页 - Home
  • 孟德宇 西安交通大学教师个人主页 - Deyu Meng's Homepage (孟德宇的主页)
  • 王进军 西安交通大学教师个人主页 - 欢迎来到王进军教授的学校主页

西北工业大学

  • 戴玉超 戴玉超的个人主页 - 西北工业大学教师个人主页

西安电子科技大学

  • 高新波Xinbo Gao's Homepage
  • 邓成Welcome to Cheng Deng's Homepage

电子科技大学

  • 申恒涛 Professor Heng Tao SHEN

重庆大学

  • 张磊 Lei Zhang (张磊)

大连理工大学

  • 卢湖川 Welcome to our IIAU-LAB!
  • 李培华 欢迎访问李培华教授主页

哈尔滨工业大学

  • 左旺孟 Wangmeng Zuo - Google Scholar Citations

上海科技大学

  • 虞晶怡 Jingyi Yu
  • 何旭明 Xuming He
  • 高盛华 SVIP LAB
  • 屠可伟 Kewei Tu's Homepage | 屠可伟的主页

南方科技大学

  • 郑锋 南方科技大学教师个人主页

西湖大学

  • 李子青(IEEE Fellow) 李子青博士

中科院自动化所

  • 谭铁牛(科学院院士,IEEE Fellow) 智能感知与计算研究中心
  • 王亮(IEEE Fellow) lw-cripac
  • 兴军亮 个人主页
  • 程健 Jian Cheng's homepage
  • 董未名 个人主页
  • 黄凯奇 个人主页
  • 胡卫明 个人主页
  • 赫然 个人主页
  • 胡包钢 胡包钢 (Bao-Gang Hu)的学术主页
  • 雷震 Welcome to Zhen Lei's Homepage

中科院计算所

  • 陈熙霖(IEEE Fellow) 中科院计算所视觉信息处理与学习组
  • 山世光 中科院计算所视觉信息处理与学习组
  • 黄庆明(IEEE Fellow) Qingming Huang's Homepage
  • 阚美娜 Meina Kan
  • 王瑞平 Ruiping Wang's Home Page
  • 王树徽 中科院计算所视觉信息处理与学习组
  • 中科院信工所
  • 操晓春 个人主页

中科院深圳先进技术研究院

  • 乔宇 Welcome to Yu Qiao's homepage!

香港高校

香港中文大学

香港科技大学

香港理工大学

香港城市大学

香港中文大学(深圳)

0.5.2 中国内地企业研究院

MSRA

  • 王井东 Jingdong Wang
  • 曾文军(IEEE Fellow)Wenjun Zeng - Microsoft Research
  • 代季峰 Jifeng Dai

腾讯

  • 张正友(ACM Fellow,IEEE Fellow,腾讯Robotics X实验室负责人) Zhengyou Zhang - Google Scholar Citations

阿里

  • 任小枫(达摩院视觉智能实验室负责人) Xiaofeng Ren
  • 华先胜(达摩院机器智能实验室副主任) Xian-Sheng Hua - Google Scholar Citations

京东AI

  • 梅涛(IEEE Fellow,京东AI研究院副院长) Tao Mei, Ph.D. – Deputy Managing Director of JD AI Research

旷视科技

  • 孙剑(旷视研究院院长) Homepage of Jian Sun
  • 张祥雨 Xiangyu Zhang - Google Scholar Citations
  • 魏秀参 Xiu-Shen WEI (魏秀参)
  • 危夷晨 Yichen Wei
  • 俞刚 Gang Yu, Megvii Face++
  • 范浩强 Haoqiang Fan - Google Scholar Citations

商汤科技

  • 闫俊杰 Junjie Yan
  • 石建萍 Jianping Shi
  • 伊帅 Shuai Yi - Google Scholar Citations
  • 邵婧 Jing Shao's Homepage
  • 武伟 Wei Wu | Urban Computing Group, Sensetime
  • 赵瑞 Rui Zhao's Homepage
  • 张展鹏 Zhanpeng Zhang - Homepage
  • 任思捷 Jimmy S. Ren's Home Page
  • 孙文秀 Wenxiu Sun - Google Scholar Citations
  • 严琼 Qiong Yan - Google Scholar Citations

依图

  • 颜水成(IEEE Fellow) Shuicheng Yan, 颜水成 - Google Scholar Citations

图森

  • 侯晓迪 Xiaodi Hou's Homepage
  • 王乃岩 Naiyan Wang - Home

0.5.3 国外高校研究团队

美国

  • 加州大学伯克利分校:机器视觉小组
  • 加州大学洛杉矶分校 :VCLA研究小组
  • 加州大学河滨分校:视频计算小组
  • 加州大学圣塔芭芭拉分校:视觉研究实验室
  • 加州大学圣地亚哥分校:视觉与机器人研究实验室,机器视觉实验室,
  • 加州大学尔湾分校:机器视觉实验室
  • 加州大学圣克鲁兹分校:认知科学实验室
  • 加州理工学院:计算视觉实验室
  • 南加州大学:机器视觉小组
  • 德雷塞尔大学:生物医学计算小组
  • 卡耐基梅隆大学:机器人学院
  • 麻省理工学院:计算机科学与人工智能实验室,机器视觉实验室,生物与机器学习实验室,媒体实验室,认知科学实验室
  • 佐治亚理工学院:机器人技术与智能机器实验室,计算感知实验室
  • 佛罗里达大学:计算机视觉实验室
  • 科罗拉多州立大学:机器视觉实验室
  • 哥伦比亚大学:机器视觉实验室
  • 康奈尔大学:计算机视觉小组,机器人实验室
  • 佐治亚大学:视觉与并行计算实验室
  • 伊利诺伊大学芝加哥分校:机器人实验室
  • 马里兰大学:自动化研究中心
  • 麻省大学:机器视觉实验室
  • 密歇根大学安娜堡分校:人工智能实验室
  • 内华达大学雷诺分校:机器视觉实验室
  • 俄勒冈州立大学:医学工程医学图像研究组
  • 宾夕法尼亚大学:机器人自动化感知实验室,医学图像处理小组
  • 宾州州立大学:视觉感知,动作和认知实验室
  • 普渡大学机器人视觉实验室,视频和图像处理实验室
  • 斯坦福大学:视觉与图像科学实验室,视觉实验室
  • 德克萨斯大学奥斯汀分校:图像和视频工程实验室
  • 犹他大学:计算科学与图像学院
  • 威斯康星大学:机器视觉小组
  • 波士顿大学:图像与视频计算小组
  • 纽约州立大学布法罗分校:袁浚菘

加拿大

  • 多伦多大学:机器视觉小组
  • 不列颠哥伦比亚大学:人工智能实验室

巴西

  • 巴西圣保罗大学:视觉控制实验室

英国

  • 伦敦玛丽女王大学:机器视觉小组
  • 剑桥大学:视觉与机器人研究小组
  • 伦敦大学学院:视觉和图像研究小组
  • 邓迪大学:机器视觉与图像处理小组
  • 约克大学:视觉图像与机器人实验室,视觉研究中心
  • 雷丁大学:计算视觉小组
  • 普利茅斯大学:机器人与智能系统小组
  • 西英格兰大学:机器视觉中心
  • 曼切斯特大学:图像科学实验室
  • 牛津大学:视觉集合团队
  • 伦敦帝国学院:视觉研究小组
  • 南安普顿大学:VLC
  • 布里斯托大学:VILab
  • 爱丁堡大学:AIAI

爱尔兰

  • 都柏林城市大学:视觉系统小组

德国

  • 达姆施塔特工业大学:机器视觉研究小组
  • 莱布尼茨大学:信息处理所
  • 柏林工业大学:机器视觉与遥感小组
  • 亚琛工业大学:Computer Vision Group,The Institute of Imaging & Computer Vision

瑞士

  • 苏黎世联邦理工学院:机器视觉实验室

荷兰

  • 阿姆斯特丹大学:智能系统实验室
  • 乌得勒支大学:图像科学学院

瑞典

  • 林雪平大学:机器视觉实验室
  • 瑞典皇家理工学院:机器视觉与行动感知实验室

奥地利

  • 格拉茨技术大学:计算机图形与视觉实验室

西班牙

  • 马德里理工大学:机器视觉小组

意大利

  • 帕维亚大学:视觉与多媒体实验室
  • 维罗纳大学:视觉与图像处理实验室
  • 特伦托大学:Deep and Structured Machine Learning

澳大利亚

  • 阿德莱德大学:视觉技术实验室,沈春华

以色列

  • 以色列魏茨曼科技大学:机器视觉实验室

新加坡

  • 南洋理工大学:吴建鑫(MINIEYE首席科学家)
摘自知乎@Charles,正在进一步整理中。

参考资料

[1] 国内外优秀的计算机视觉团队汇总 @chengzi https://bbs.cvmart.net/articles/481/outstanding-Computer-Vision-Team

[2] 国内做计算机视觉或者机器学习比较好的实验室有哪些? @Charles. https://www.zhihu.com/question/61688385/answer/759134370

[3] https://www.zhihu.com/question/332075078/answer/734910130

[4] https://blog.csdn.net/zhang_zeng/article/details/56009580

[5] https://www.zhihu.com/question/332075078/answer/738194144


book postscript

后记

再次感谢李沐老师团队的《动手学深度学习》专著,受该工作的启发,我决定编写的此项计算机视觉学习资料。

在方向上,有诸多前辈的工作,如:《计算机视觉:算法与应用》、《Python 计算机视觉编程》等,相比本书在内容广度和深度上都更胜一筹,本书只是在其未尽之片角处给出补充和整理。因此,读者在学习过程中,可以根据自己的需求同时参考两本书的内容,以便最大化学习效果。更重要的是,一直强调本书的思想——学以致用,在实践中学习,我们不培养算法研究者。

同时,与国内外诸多学生和专家学者相比,笔者亦深感自己能力之不足。书中如有错误和疏忽之处,恳请广大读者批评指正。

米开朗琪罗在无数个日夜里雕琢大卫的雄姿,爱德蒙·唐泰斯在凄风苦雨中等待复仇的良机,史铁生在地坛里顽强地探寻生命的意义,哈罗德也在栉风沐雨里完成他的朝圣和自我实现。2020年对所有人而言都是不平凡的一年,笔者相信,经历过疫情的中华民族会愈加强大,科技也会蒸蒸日上。同时,聪明的读者们也必将会在你们的领域里,越来越杰出。

在这本书里,我们不谈风月,只谈干货。

希望能帮到每一个热爱学习的你。

祝君安!


--
张伟Charmve
2021年夏

本文由 GitVP 从 GitHub 收录并在站内全文呈现,版权归原作者所有(NOASSERTION)。

← 回到全部文章

同分类还有