
风险控制笔记
2014年6月我开始从事风控相关的工作,和几位优秀的工程师一起组建了唯品会的风控团队。2016-2020年在爱奇艺,负责业务安全运营、威胁情报工作。
这里是我这5年来风控经验的总结,希望可以帮助刚入风控行业的人了解一些基础,也希望谈一谈我对于风险控制独到的理解。
如果你是一个新人,可以先从基础篇看起,了解一些业务风控的基础概念和防控思路。如果你已经在这个行业多年,可以看看我筛选出来的精华文章,看看我是如何借用经济学、金融学、心理学理解风控,也许你也会有新的发现。
精华文章
- [决策的第一步-看得见](https://raw.githubusercontent.com/WalterInSH/risk-management-note/HEAD/决策的第一步-看得见.md)
- [决策的第二步-看得清](https://raw.githubusercontent.com/WalterInSH/risk-management-note/HEAD/决策的第二步-看得清.md)
- [影响量化评估的两个要素](https://raw.githubusercontent.com/WalterInSH/risk-management-note/HEAD/影响量化评估的两个要素.md)目录
基础篇
基础拓展篇
运营篇
2019年2月,我提出了“看得见、看得清、智能决策”的运营模型,结合卡普兰教授的“战略中心型组织”、卡尼曼的行为心理学知识框架,设计了我自己的需求平衡迭代模型。这个模型可以应用在很多领域,但是在本项目中,我将会围绕在风控领域进行介绍。

- [决策的第一步-看得见](https://raw.githubusercontent.com/WalterInSH/risk-management-note/HEAD/决策的第一步-看得见.md)
- [决策的第二步-看得清](https://raw.githubusercontent.com/WalterInSH/risk-management-note/HEAD/决策的第二步-看得清.md)- 数据量化和效果评估
- [影响量化评估的两个要素](https://raw.githubusercontent.com/WalterInSH/risk-management-note/HEAD/影响量化评估的两个要素.md)
- [风控效果量化评估](https://raw.githubusercontent.com/WalterInSH/risk-management-note/HEAD/风控效果量化评估.md)团队发展篇
案例篇
结束
共享你的力量
如果你也想分享你的知识,帮助更多人了解风控;或者你发现任何错误,可以提Issue,也可以发送邮件到 walterinsh@icloud.com
什么是风险
什么是风险
我们已经聊了很多做业务风控的手段和技术,可是到现在还没有说清楚“风险控制”中的“风险”是什么。
我一直在想应该从什么角度来写这个问题,最终我决定从金融行业借鉴一些内容。这个行业已经花了几十年研究风险,我们看看这个行业会带给我们什么启示。
橡树资本联合创始人Howard Marks在几篇备忘录中阐述了他对风险的看法,下面就围绕他写过的内容聊一聊。
风险来自不确定性
Investing requires us to decide how to position a portfolio for future developments, but the future isn’t knowable. 投资行业要求我们为未来发展设计一套投资组合,但是未来是不可知的。
简单来说,金融投资行业就是今天花一笔钱在一件事情上,未来获得一个结果。有难度的部分是:站在现在,未来是不可知的。
其实投资不是金融行业特有的行为,普通公司、每个人的生活都充满了投资,做一次广告活动、报考大学都是投资,都是花一笔钱或者几年时间在一件事上,未来获得一个结果。同样难的是:站在现在,未来是不可知的。
How can investors deal with the limitations on their ability to know the future? The answer lies in the fact that not being able to know the future doesn’t mean we can’t deal with it. It’s one thing to know what’s going to happen and something very different to have a feeling for the range of possible outcomes and the likelihood of each one happening. Saying we can’t do the former doesn’t mean we can’t do the latter.
那么我们站在现在,该用什么眼光看到未来的结果呢?
The future should be viewed not as a fixed outcome that’s destined to happen and capable of being predicted, but as a range of possibilities and, hopefully on the basis of insight into their respective likelihoods, as a probability distribution. 未来不应被视为一个注定发生、可被预测的结果,而应被视为一个可能性区间,寄希望于对各个可能性的洞悉,未来可以被看做一个概率分布。
拿金融投资来说,花几百万买了一家公司的股票。未来能不能盈利是不能预测的,结果可能是亏损、回本、盈利(当然你可以拆分的更细),每一种结果都有一个可能性区间。当你认真研究基本面后,再加上一些主观直觉,你就得到了一个概率分布。例如:90%的概率会盈利,5%的概率会亏损,还有5%概率不亏不赚。
考大学和金融投资类似,花几万学费和很长时间在大学的某个专业学习,几年后毕业的时候也会有很多结果。对于刚高考完的学生而言是无法预测的。我们站在2018年回首,即便同样是计算机专业的毕业生、同样的学校、同样的努力,毕业于14年和16年的两批学生面临的互联网就业环境是完全不一样的。
这和风险有什么关系呢?
This uncertainty as to which of the possibilities will occur is the source of risk in investing. 哪种可能会真正发生的不确定性,是投资风险的来源。
也就是说金融投资的风险来自于亏本还是盈利的不确定性,读大学的风险来自于最后是进BAT还是去搬砖的不确定性。
基于"风险来自不确定性",Howard Marks延伸出了几个很有意义的关键点。
Risk means more things can happen than will happen. —— Elroy Dimson 风险意味着可能发生的事总是多于确定发生的事
在评估业务风险时,除了那些大概率会发生的事情,还有更多小概率发生的事,有时那些负面的小概率事件才是风险的来源。所以事前评估风险时应该冷静、开放的思考各个方面,包括小概率事件,甚至将业务逻辑之外的东西也考虑进去。
某家公司曾经通过QQ群发现有人在卖自己网站的用户账号,但是风控系统显示最近撞库并没有异常,通过风控团队和用户团队的配合,发现用户登录量少于风控记录到的登录量。为什么有些用户登录没有进行风控判断呢?排查后发现:当系统判断到用户在请求接口https://example.com/login时会调用风控,黑产通过请求 //login(两个/)绕开了这个判断逻辑,且依然可以访问登录接口(HTTP路径中/和//指向的地址是一样的)。
类似的案例表明风险有时来自于我们很难想到的地方,我们总显得比黑产“笨”一些。所以在风险评估时,应该尽可能从多方面想想,必要时应假设我们的策略失败了,并设计兜底方案。
Knowing the probabilities doesn’t mean you know what’s going to happen. 知道发生的概率不意味着你知道接下来会发生什么
就像扔骰子,我们都知道扔一次每个面的概率是1/6,但是我们却无法准确预测某一次扔出的结果。即便我们通过分析,得出风险很低(或者很高),也不意味着未来真的是这样。
Even though many things can happen, only one will. 即便一件事有很多可能性,但最终只有一种会发生
在很多时候我们当然可以用均值作为判断,但是我们要谨记的是即便得出的均值是一个很好的结果,单次结果仍然有可能很差,甚至超过我们的承受能力。
I have no interest in being a skydiver who’s successful 95% of the time. 我没有兴趣成为一个成功率有95%的跳伞运动员
No ambiguity is evident when we view the past. Only the things that happened happened. But that definiteness doesn’t mean the process that creates outcomes is clear-cut and dependable. Many things could have happened in each case in the past, and the fact that only one did happen understates the variability that existed. 回顾过往时,模棱两可的事总是不清晰的。只有那些发生了的事情真正发生了。这不意味事情的发展注定如此,清晰且恒定。过去的每个案例都有可能发生很多事情,只是最终只有一种变成了现实,这让我们低估了历史中存在的多样性。
因为最后只有一个结果会发生,我们有时会进入一个误区:事后去评估事前发生的风险时,大大低估那些最后没发生的可能结果的概率。下面这些想法你也许听说过:
- 我就知道这个活动会失败!
- 之前分析报告已经写了,成功率80%,我们果然成功了
这个误区不仅会让我们看不清过去,也很容易导致我们过度自信,从而影响我们未来的决策。
风险的定义
我们说清了风险的来源,接着看看Howard Marks给风险的定义是什么:
The possibility of permanent loss. A downward fluctuation – which by definition is temporary – doesn’t present a big problem if the investor is able to hold on and come out the other side. 风险就是发生永久性损失的概率。一个暂时的向下波动并不是一个大问题,只要投资者可以承受,且之后可以翻盘。
业务方投入资源(包括时间和经费)去做拉新、促销,是为了获取回报,也就是更多用户、更多订单,当然说到底都是为了利润。对应Howard Marks给出的定义,业务方面临的永久性损失是什么?
一家成熟公司投入了10万元进行了一次为期1个月的促销活动,最后只多带来了1万元收入。那么差值(9万元)是永久性损失吗?
In the short run, it can be very hard to differentiate between a downward fluctuation and a permanent loss. Often this can really be done only in retrospect. Thus it’s clear that a professional investor may have to bear consequences for a temporary downward fluctuation simply because of its resemblance to a permanent loss. 短期来看是很难区分向下波动和永久性损失。经常我们只能事后复盘的时候区分出来。因为这种相似性,很显然一个专业投资者必须忍受向下波动的后果。
对于例子中的9万差值,简单来看,可以考虑这个促销活动是否有长期效应,例如大大提高了品牌知名度,只是知名度转化为顾客购买有滞后。如果有长期效应,且后续真的持续带来了大量顾客订单,那么这就是一次临时的向下波动;如果没有长期效应,那么这9万元就是永久性损失了。
上面是一个简化了的分析,实际上站在运营人员、企业老板、投资人的角度。即便活动没有长期效应,不同的人也会因为投入和报酬的方式不同而得出不同的结论。读者可以自己思考一下为什么。
风险控制是什么
In order to achieve superior results, an investor must be able – with some regularity – to find asymmetries: instances when the upside potential exceeds the downside risk. That’s what successful investing is all about. 为了能获得过人的回报,投资者必须能常态的找到不对称:向上潜力超过向下的风险。成功的投资不外乎这样。
和投资行业一样,成功的互联网企业想要盈利也应找到“向上潜力超过向下的风险”的情况。那么具体到风控是做什么呢?
Effective risk management requires deep insight and a deft touch. It has to be based on a superior understanding of the probability distributions that will govern future events. Those who would achieve it have to have a good sense for what the crucial moving parts are, what will influence them, what outcomes are possible, and how likely each one is. 高效的风险控制需要深入的洞见和灵敏的感知。这构建在对“未来是一个概率分布”这个观点出众的理解。成为风控专家的人必须能理解哪些是关键组件,知道什么会影响它们,有哪些可能结果,每个结果的概率是多少。
例如很多公司都有建立用户钱包的冲动,这样可以建立资金池,从而进一步获利。
风控专家应该在用户钱包业务上线前了解自己公司的各个业务流程,例如用户体系、充值、消费、退款。应该了解这些流程对钱包的影响,例如撞库、盗绑银行卡、信用卡套现、恶意退单等行为和钱包的关系。最后要清楚这些会导致用户账户损失、支付不合规等结果。当然还应结合主观经验和客观分析得出这些结果的概率。
风控专家也应该在这个业务上线后持续的运营,随着业务的发展进行新的判断。
风险控制是谁的责任?
当你找一家企业的员工,无论基层还是老板,无论是金融还是零售,问他们“风险控制在你们的流程中重要吗?”。你通常都会得到Yes的答复。但是在实际项目中,特别是早期,风控都被人抛之脑后。
The task of managing risk shouldn’t be left to designated risk managers. 风险管理的工作不应被丢弃给专职的风险经理们。
做风控的人可能都有一个感觉:向Passport、支付等部门推广风控是一件相对容易的事,但是向订单、售前等部门推广时就比较难。这主要是各个部门的职责不同导致风险不同,且在事后责任方有区别。
Passport部门有一个天生的职责就是保护用户密码,没做到这一点的passport系统是不完整的,所以passport部门会重视这个问题。
订单团队比较有趣,每家公司不同。我之前在和某公司订单部门初次接触时,对方总是支支吾吾,就是不允许我们在用户下单时对可疑用户进行拦截。最后订单部门的老板说出了实话:(这家公司)订单部门最重要的KPI是订单量,无论是季度、全年还是大促时,最看重的是下单量。如果我们在下单时拦截,担心会影响到这个KPI的完成。最后我们在下单后和物流部门中间找到了20分钟,插入了一段近实时审单逻辑,对于恶意订单在这个阶段进行砍单。
再来看售前部门,国内某现金贷公司的风控部门很难做,不停抱怨低质贷款申请太多,违约率降不下来。朋友抱怨道:售前部门的KPI是成单量、每日电话呼出次数等鼓励售前多拉单的KPI,没有一个是关于违约的。最后违约了由风控部门背锅,售前部门无需背责任,自然售前部门就可以忽视风险,尽量找成单难度低的用户,找了一堆自控力薄弱的大学生(国家禁止前)和生活不稳定人群。
由此可以看出:
- 成为风控专家的人必须能理解哪些是关键组件,知道什么会影响它们,有哪些可能结果,每个结果的概率是多少。并能在各个组件中找到合理的介入点。
- 在整个公司推广风险控制,除了通过培训、宣传提高大家风险意识这种途径外,也离不开自顶向下合理的目标体系、责任体系的支持。
风控是必要的吗
While risk should be dealt with constantly, investors are often tempted to do so only sporadically. Since risk only turns into loss when bad things happen, this can cause investors to apply risk control only when the future seems ominous. At other times they may opt to pile on risk in the expectation that good things lie ahead. But since we can’t predict the future, we never really know when risk control will be needed. Risk control is unnecessary in times when losses don’t occur, but that doesn’t mean it’s wrong to have it. The best analogy is to fire insurance: do you consider it a mistake to have paid the premium in a year in which your house didn’t burn 虽然对抗风险是一个持续的过程,但投资者通常是三天打鱼两天晒网。因为风险只在坏事发生时才会显现出真正的损失,这会导致投资者只在未来悲观时才想起风控。其他时候投资者会相信前景一片光明并忽视风险。但是因为我们不能预测未来,我们永远不知道何时需要风控。风控在损失未发生时是不必要的,但这不意味着进行风险控制是错的。最好的类比是火灾险:即便你的房子没着火,你会认为每年支付火灾险保费是一个错误吗?
Risk control may restrain results during a rebound from crisis conditions or extreme under-valuations, when those who take the most risk generally make the most money. But it will also extend an investment career and increase the likelihood of long-term success. That’s why Oaktree was built on the belief that risk control is “the most important thing.” 也许风控会制约你在危机或极度低估期回弹时的收益,眼看那些承受最大风险的公司这时赚了很多钱。但是风控会延长投资视野并且增长长期成功的可能性。这就是为什么橡树资本是建立在风控是“最重要的事”这个信念之上。
这两句十分朴实,却意义深刻。读者不妨自行参透,并应用到非经融领域中。
参考文献:
《Risk Management: History, Definition and Critique》(Georges Dionne)
《Risk Revisited》(Howard Marks)
致谢:
感谢上海工程技术大学翻译专业的Cecilia对本章内容的帮助。
精细化运营
精细化运营
精细化运营是个老词了,特别是在电商、社交这类大的、成熟的互联网领域。其实在业务安全领域,精细化运营的思想也是适用的。
我个人总结的精细化运营的核心问题就是要解决2个问题:
- 看得见
- 看得清
解决“看得见”这个问题,也就是解决数据的获取问题,分为3个子问题:
- 数据是否被存储了?
- 数据能否可以被快速、灵活的访问?
- 数据能否可以被关联分析?
解决“看得清”这个问题,也就是解决数据的理解问题
- 能否量化业务,从而尽量还原客观事实?
- 能否制定合理的核心指标,从而化繁为简、提高运营效率?
- 能否建立合理、灵活、快速的可视化体系,从而提高人的理解?
具体的参看章节:
决策的第一步 看得见
决策的第一步-看得见
开篇提到解决“看得见”这个问题,也就是解决数据的获取问题,分为3个子问题:
- 数据是否被存储了?
- 数据能否可以被快速、灵活的访问?
- 数据能否可以被关联分析?
数据的存储
请以自己的网站或应用为例,试着回答一下这几个问题:
- 你的网站或应用的登录失败率是多少?
- 登录量上升 + 登录成功率下降,让你很紧张,那么你是受到攻击了吗?
要回答上面的问题,至少你要有登录日志,我相信大部分公司都会存。但如果你只存了登录日志,而没有存验证日志,那你就很难回答第2个问题了。下面这2种可能都可能在特定时期导致登录量上升 + 登录成功率下降
- 黑产真的来撞库了
- 验证码服务升级,提高了验证难度
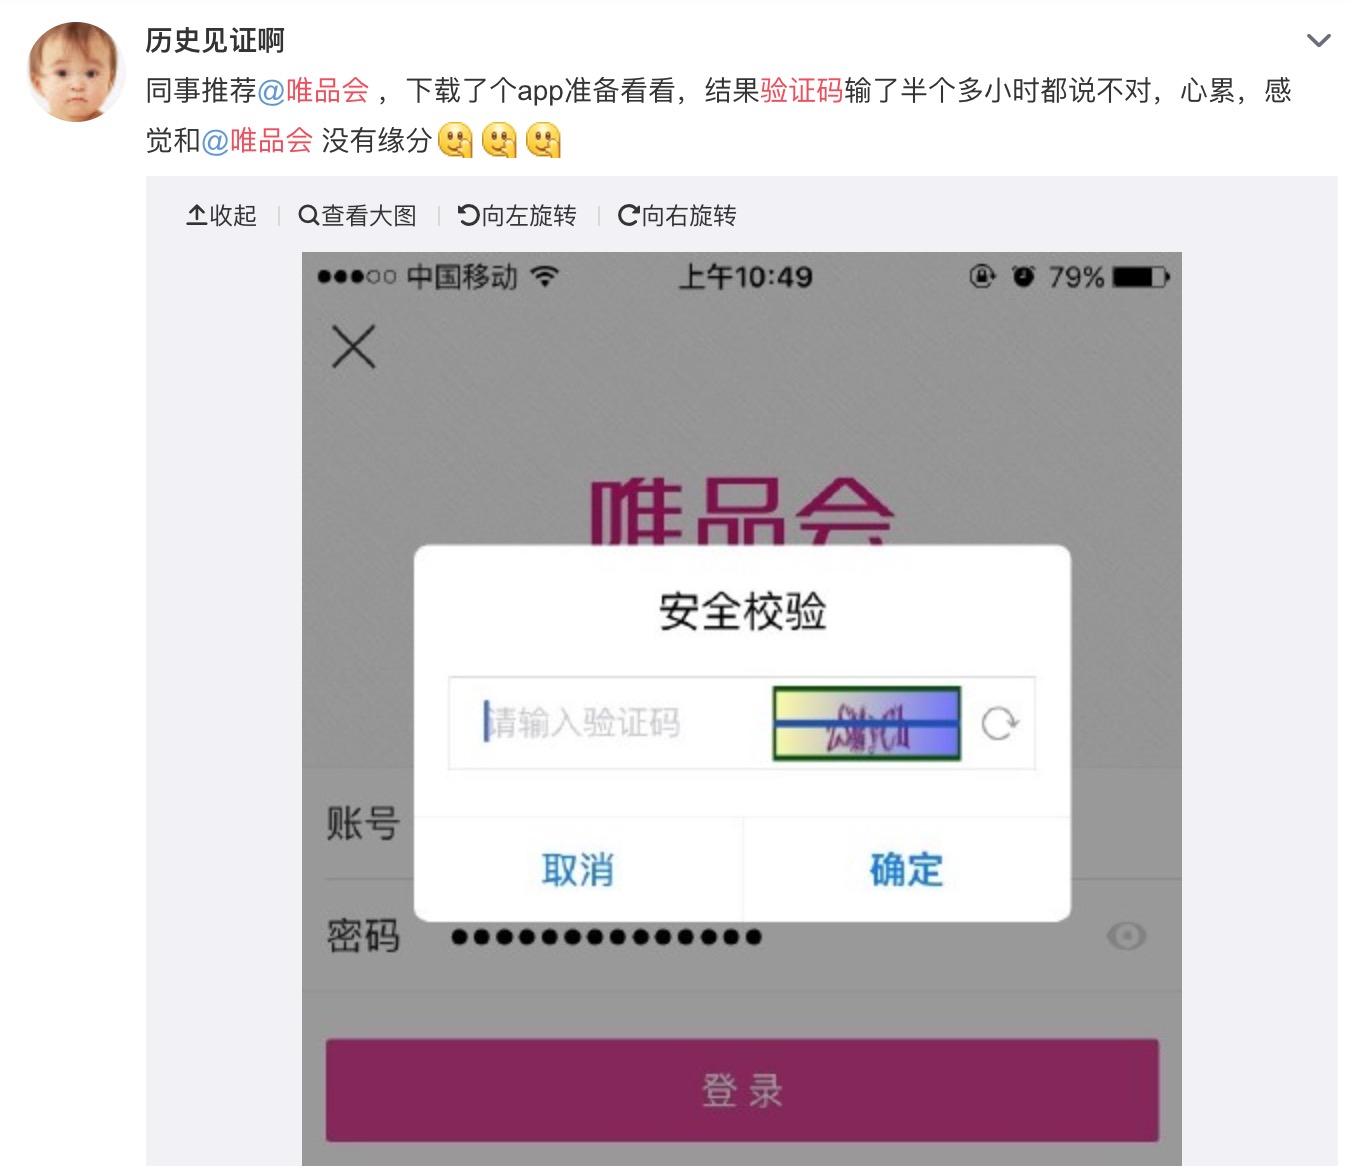
所以,如果你的数据一开始就没有被存下来,那么你就真的只能靠猜了。
数据的访问
除了存日志,你的日志还加了充足的字段,例如:IP、时间、验证码类型、验证码服务版本、客户端版本、设备号等等。这很好,给未来的分析开了个好头。可是这也带来了问题:我增加了日志,增加了字段,我的业务很好,可是数据量太大了,我用excel打不开
这里的excel是一个比喻,但也不是个比喻。
随着数据量增大,要想访问数据就需要大数据工具,例如Hive、Spark、Hbase、Cassandra、Elasticsearch。我相信稍微大一点的公司都有使用。但是 使用大数据技术不代表数据可以被快速、灵活的访问。
我见过拥有完备大数据体系的公司里,不少运营同事却无法方便的获取数据,只好请工程师导出数据样本后,本地excel人工分析。
常见问题一:数据没有被整理
很多重要的业务数据混杂在一个大的日志文件中,例如这样产生的日志
System.out.println("user " + userId + " logged in at " + time)
or
Logger.info("user {} uploaded a photo at {}", userId, time)
用户行为虽然记录到了日志中的,但是不同行为日志混在一起,甚至还包含代码的报错堆栈信息。如果日志格式没有规范,事后想要排查问题都很难,更不要提做分析。
常见方案:有价值的日志应该按照便于后期处理的格式打印到单独文件中。然后使用Apache Flume + Kafka + Spark转存到Hive中。

常见问题二:分析师没有入口可以查询
我见过太多的系统工程师忘了一件事情:不是每个人都会编程。
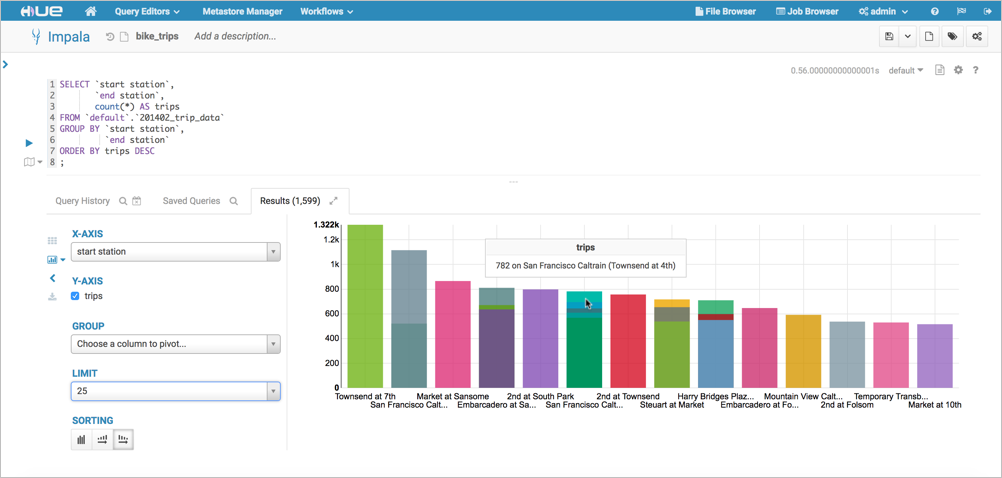
数据应该可以让团队中每一个需要的人方便获取到。通过ssh登录到服务器上,使用命令行读取很明显不是一个方便的方式。特别是当命令行查询出的数据是JSON格式时,大多数人都会是一头雾水。另外,使用Spark查询数据也不是一个好的方式,除了要写代码,spark代码发布到集群、启动任务都需要花不少时间,这会浪费分析师大量的时间。
常见方案:搭建或者开发GUI查询工具,不需要很漂亮,但要方便。这里推荐工具Hue。
数据的关联分析
数据量大了以后,数据之间的关联分析就变得困难。
常见问题一:存储不一样
基于业务的不同特性,数据可能会存在不同类型的数据库中,MySQL、MongoDB、Cassandra、Hbase等等。虽然你依然可以使用Spark从不同存储中读出数据,在内存中关联分析。但是如前文所述,不是一个易用的方案。
常见方案:采用统一数据仓库,例如Hive。每天将其他数据库中的数据同步到数据仓库中。
常见问题二:数据量大,关联耗时长
数据量大了以后,一条Join语句可能需要运行很久。
常见方案比较多,例如:
- 对数据合理分区
- 成本换时间。采用基于内存的分析引擎,如Impala、Presto
- 抽象数据聚合层,如果Join数据长耗时不可避免,那就避免重复进行。说直白一点,热数据提前Join,冗余常用的分析字段,构建大宽表。


总结
我认为所有的决策都要先解决“看的见、看得清”这个问题,而“看得见”是基础。首先需要我们合理设计数据内容,其次需要我们选取合适的数据存储分析技术。都不是容易的事。
影响量化评估的两个要素
影响量化评估的两个要素
前文介绍了“看得清”,你可能会想,看得多清才算是清呢?多清才足够呢?本文就聊一聊影响量化评估的两个要素。
一个案例
HR老板问:这个月招聘工作咋样啊?
HR:招了3个人(可计数的实物)
HR老板:对业务有什么帮助吗?(抽象的价值)
HR:帮助挺大的,解决了那个团队没有前端开发的问题
HR老板:我是问你价值,对项目有啥帮助吗?
HR:因为招的是还没经验的实习生,这个月还没什么明显产出,老员工带新员工自己效率还降低了,影响了项目进度
HR老板:你的意思是负价值吗?
HR:以后培养好了,肯定对团队有帮助的(一件事往往包含短期价值和长期价值)
HR老板:这个帮助的价值是多少?
HR:那个项目以后做完了可以盈利1个亿,没有这几个人,肯定做不完。招聘的价值就写1个亿吧。(确实能找到关联的数字)
HR老板:这怎么行?!哪部分是这几个新员工做的啊?
HR:我让他们写日报给我,让他们写清楚每个人产生的价值(写日报增加了成本)
实习生:我也不知道我做了个页面的价值啊,我觉得这个页面挺重要的,要么就5000元吧。
HR:隔壁团队花了3天做的页面,和我说5000元。你这个就花了一个上午,怎么就5000?(基于投入成本来评估价值)
实习生:两个系统不一样啊,这个系统用了新的技术,运行更快了。(基于效果来评估价值)
HR:更快了也不值这么多吧,你再想想(价值评估难以达成一致)
这里不是要黑HR(爱奇艺的HR、行政真的特别好),只是招聘是一个十分常见的事情,希望每个读者都可以理解量化评估的难点。大致有:
- 很多事情的价值是长期的,短期价值不明显,甚至有可能是负的。预测未来的成本很高,甚至是不可能的
- 很多事情的价值是通过价值网络产生的,也就是说一件事情本身独立存在时是没有价值的,当加入到另一个网络时就会产生价值,很难说一个节点的加入可以增加多少价值。例如一名出租车司机加入网约车平台,对平台的价值。
- 即便是同一个功能,不同人也会有不同的价值感受
概况来说分为两类。首先是量化评估受到成本的制约,其次是价值评估难以达成一致。接下来一个一个解释。
制约量化评估的首要问题是成本
KPI刚刚在国内流行的时候,我参加过一个公司培训。
讲师:KPI一定要可以衡量,不能是模糊的。例如“实现增长”就不是一个好的目标。 某位同事提问:我觉得有时候我做的事没办法评估,怎么办? 讲师:肯定是有办法评估的,没有什么是不能量化的。你不能量化是你没有好好思考。
这位同事还是一脸疑惑,但再接着问就很尴尬了,因为讲师的意思是“你不能是你水平不够”,再问问题更显得自己水平不够,而且还显得自己不愿意动脑。
之后的几年我一直在思考“没有什么是不能量化的”这句话,直到学了经济学之后,我得到的结论是:我不知道世间万物是不是都能量化,但是我确定量化是有成本的,很多时候还是容易被人忽略的交易成本。
拿量一个物品的长度为例。做一张桌子,你需要控制桌子腿的长度,用卷尺量误差在1-2毫米,这就足够了。但在生产线上生产iPhone,为了保证原器件长短误差在千分之三毫米(芯片要在纳米量级),就需要花大量的钱去提升工艺技术了。
如果没有成本这个因素,很多事情上人们可以为所欲为。但正因为有成本这个因素,所以:
- 即便我们很有钱,也不会用顶级数控机床去做张桌子,因为成本太高了,不划算
- 大家都想生产利润很高的高端产品,但是没有家家都是高端产品企业,因为成本太高了,体现在买不起高端产品的生产机器,或者雇不起高端产品的专家
不只是测量物体,衡量工作也是同理。量化评估需要调研、记录、分析、汇总,首先是需要花时间。特别是当评估需要依赖其他人或团队时(其他人又可能需要依赖其他更多的人),沟通讨论的时间更难把控。其次维护这套流程也要花时间,例如监督大家真的认真记录了工时。即便是采用自动化,开发和维护自动化系统也是需要花钱的。算一算量化评估的时间有可能已经超过了做事情的时间。
成本限制了你会怎么做,成本限制了你能做什么。
个人主义的主观价值论
我们的工作中除了量化实物,更多遇到的是量化做一件事的意义,或者说一件事的价值。
- 你提出了一个创意的价值是多少?
- 你帮助同事修复了一个故障的价值是多少?
- 你开发了一套风控系统的价值是多少?
如果你在思考这个问题,实际上你正是在估值。你估值的依据是什么呢?别人的估值结果和你一样吗?接下来我们介绍一下“个人主义的主观价值论”的观点。
主观价值理论(英语:subjective theory of value,简称STV)是经济学的价值理论,认为产品和服务本身并没有经济的价值,而是由于个人对它们的需求才有价值存在。而这些价值是依据购买者肯为此付出多少代价(如货币)来计算的。由于世界上每个人都有不同的需求和情况,因此,所谓“正确”的经济价值或价格在客观上是不存在的。 ————Wikipedia
主观价值理论认为:
- 个人估值是个人的估值,不是集体的估值。集体不会感受,不会思考,也不会评估,做出个人估值判断的一定是个人。我们要知道集体不会做任何的事情,机构也不会做任何的事情,学校、机关、民族都不会做任何的事情。我们所说的,我们口头上喜欢说的哪个集体、哪个机构、哪个组织做的什么事情,其实最后都是个人做的。
- 它是主观的,绝对主观的。并不存在什么客观的估值,如果没有了人,世界上的财富就没有价值,价值都是人赋予的。
- 个人估值不是以个人的愿望为基础的,而是以他所愿意放弃的其他商品的数量来计算的。这是以行动为基础的,而这些行动是可以观察到的。
一瓶600mL的纯净水的价值是多少?对于电脑前的你来说,可能2元吧。但假设你身处景区里,这瓶水价格变10元了,你口干舌燥,你会买吗?你可能不会买,因为你觉得不值10元,可以坚持一会儿,出了景区再买。但同时你看到也是有人买的,说明有人的想法和你不一样,他们觉得这瓶水的价值大于10元。那么这瓶水的客观价值到底是多少呢?
主观价值论认为这瓶水的客观价值是不存在的。主观价值论认为你花不花时间、用了多少心思、花了多大的投资,这本身并不重要,最关键的是你能不能把它卖出去,你能不能适销对路,有没有人需要你生产的产品。在商品经济里面,是结果导向、需求导向,如果你生产的产品没人要,那么不管你投入多少资源,花费多少劳动,它也是不值钱的。所以主观价值论能够更好地指导生产,减少浪费。
总结
我的意思就是别量化了吗?不是的,量化评估很有用,是工作中很重要的一部分。
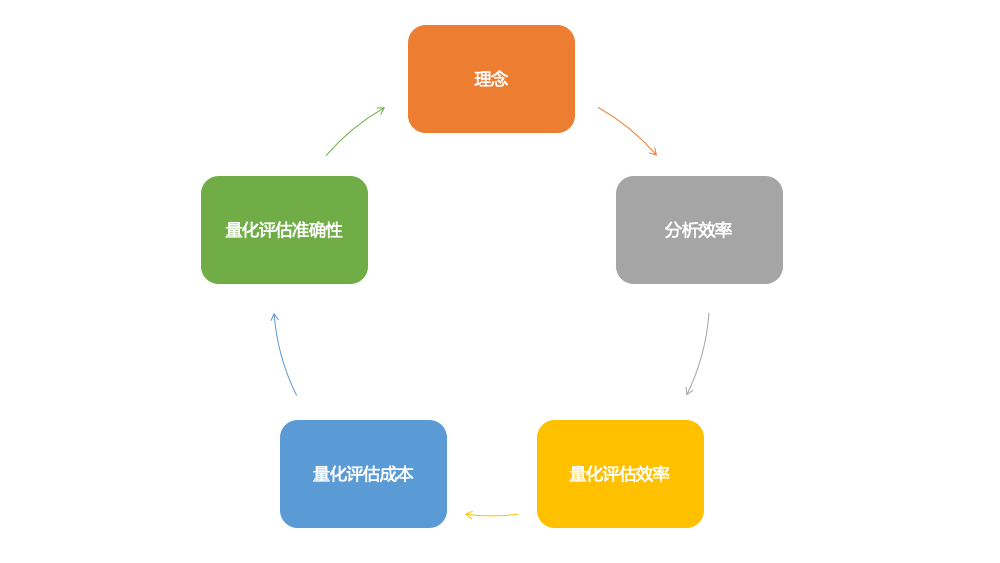
- 从产品、策略迭代的角度来看:更好的理念可以优化分析效率,优化量化评估效率,优化量化评估成本,优化量化评估准确性,又可以给我们带来新的理念。当然了“正反馈”也意味着如果你做的差,就会导致链条中其他步骤做的更差,形成恶性循环。
- 从资源配置角度来看:钱、人力、空间、时间资源是有限的,“我全都要”很多时候是不可能的。要想知道资源应该怎么分配、下一步怎么优化,就需要衡量手段,特别是衡量变化的手段。
技术可以提高,但理论的极限无法突破,不要做徒劳的事情。 我们所能做的事情,不过是在边界内找到相对好的答案。 ————吴军 《谷歌方法论》
参考 === 《薛兆丰的经济学课》第29讲:个人主义的主观价值论
建设风控大数据团队
风控数据分析
做风控十分依赖数据,所以以下三个事情将是很重要的:
- 合理的数据分析发展过程
- 合理的数据存储和ETL
- 强劲的分析工具
合理的数据分析发展过程
- 站在公司角度,业务有优先级,风险也有不同严重性。
- 站在团队角度,人力总是有限的,技术的积累也是有先后的。
所以一个公司风控的发展是有次序的,在数据分析的建设上也是有次序的。其实不仅风控数据分析是这样,大部分数据分析都是这样。
对于这个发展过程,我个人比较认同玖富数据总监孙微先生的总结,思考比我深入。会议上孙微先生是站在业务运营的角度来提的,但是大部分思想和风控运营是一样的。
_包含GrowingIO字样的截图取自于「 GrowingIO 2018 增长大会上海站」,已得到GrowingIO授权_

首先是团队组织,孙微先生列出的这些条都很好,我结合风控的特点补充一些。
务实:最近几年安全行业是一个热门的行业,各种新奇名词频出。对新趋势保持关注是必要的,但是数据分析并不是找几个模型这么简单,靠几个“微创新”就可以有大幅提高。耐心的梳理各业务数据、一步步推演整套分析架构这些略显“枯燥”的事目前仍是重要的事。
合作:安全风控部门往往需要对接很多业务,如果是大公司,有几十个大大小小的业务是很常见的。更不用说乙方公司要对接的是大量的公司。风控部门天然就是合作非常多的部门,沟通能力是招聘时一定要考虑的因素。


以下结合风控的特点补充一些:
打通数据链路、打破孤岛:风控刚开始的时候,往往每个业务的防控比较独立。稍微成熟一点之后肯定会出一些跨业务的策略,也就是说联防联控。例如“登录高危用户,在参加活动时也是高危”。要是想实现这种规则,那么就有以下要求:
- 宏观上,关联的业务数据应该可以关联分析
- 微观上,在行为链路中,后续的风险点应该可以关联之前风险点的情况(风险等级等)。
我认为这是实现精细化运营的必要步骤,技术上需要规则引擎、数据处理、缓存的顶层设计,逻辑上需要熟悉业务的专家耐心梳理。
需要指出的事,对安全部门而言“打通数据链路、打破孤岛”是一件辛苦的“脏活”,有时候对业务方而言是一件“添麻烦”的事。大家都认同价值,但是价值又很难评估。大家都认同这件事的专业性,但是又认为这件事很传统、没有创新。在普遍不踏实的互联网文化下,能做好这件事并不容易。
爱奇艺业务风控系统
案例:爱奇艺业务风控系统
_以下内容取自于“爱奇艺技术产品团队”微信公众号、中国系统架构师大会、唯品会SRC城市沙龙的公开内容_
业务风险点
爱奇艺作为国内领先的娱乐公司,以下是爱奇艺安全团队需要应对的业务风险点
- 会员:撞库盗号,账号分享,批量注册
- 视频:盗播盗看,广告屏蔽,刷量作弊
- 活动:薅羊毛
- 直播:挂站人气,恶意图文
- 电商:恶意下单,订单欺诈
- 支付:盗号盗卡,洗钱,恶意下单,恶意提现
- 其他:钓鱼邮件,恶意爆破,短信轰炸
问题——缺少统一完善的风控系统
一.各自为战
- 各业务方多以安全事件驱动, 多数仅做事前单点防御, 经验数据无法共享
- 单点防御容易被黑产各个击破,无法做到跨业务跨团队的联防联控
- 低水平重复建设, 平台资源浪费
二.拍脑袋"规则"
- 大量的风控规则是专家决策为主,阈值基本拍脑袋而定
- 没有引入数据分析或者机器学习等能力,对事件本质缺乏足够认识及数据支撑, 造成正常用户误杀, 损伤用户体验, 导致用户流失
三.反应过慢
- 不能快速识别攻击变化进行调整,无法进行积极对抗
- 业务代码耦合,依赖业务开发, 测试和上线,占用业务排期
- 某些前置/内置规则容易成为业务关键路径,对业务稳定性造成影响
四.手段单一
- 可用特征维度不多, 严重依赖于IP, 公共出口误杀严重,引发投诉 2. 以限频, 限流, 黑白名单, 图文验证为主, 黑白名单难以维护, 无生命周期
解决方案
一.联防联控
- 各业务联合, 在模型,规则,数据等方面进行共享, 联合布控协同防御
二.数据驱动, 智能对抗
- 全站全网数据支撑, 基于数据进行决策
- 利用机器学习实现智能异常特征发现
三.策略灵活, 有效对抗
- 独立服务, 快速迭代
- 支持业务的风险多样运营需求
- 模型,规则, 策略快速实施, 快速反应
四.维度和拦截手段多样
- 不依赖单一维度和单一行为
- 云和端结合, 多种拦截手段应对
五.延迟可控, 低耦合可降级
- 在实时风控场景下, 快速决策, 不能明显增加业务延迟, 自身有问题情况下, 不能影响业务
六.快速实现, 高效部署
- 能够快速完成架构. 实现和持续迭代
- 能够面向私有云的复杂拓扑, 快速部署
系统架构

我们的风控服务是由三大子服务组成:
麦哲伦 主要包括业务接入(接入层),三大服务引擎(数据查询,规则执行,模型调用),面向风控团队的管理平台(服务资源管理, 模型规则管理,生命周期管理,上下线管理,维度数据管理),面向业务方的运营平台(风险事件管理,仿真,风险处置,监控预警,数据查询和仪表盘,规则清单)。

哥伦布 主要面向对业务数据的特征工程,大规模异常检测和深度学习,知识图谱,实时特征,离线特征,环境特征以及安全画像,并对外提供模型可实时调用接口或者模型输出缓存。

郑和 是安全知识仓库,是面向业务风控和其他安全控制所需的各类安全基础数据和威胁情报。
多渠道业务数据采集和处理
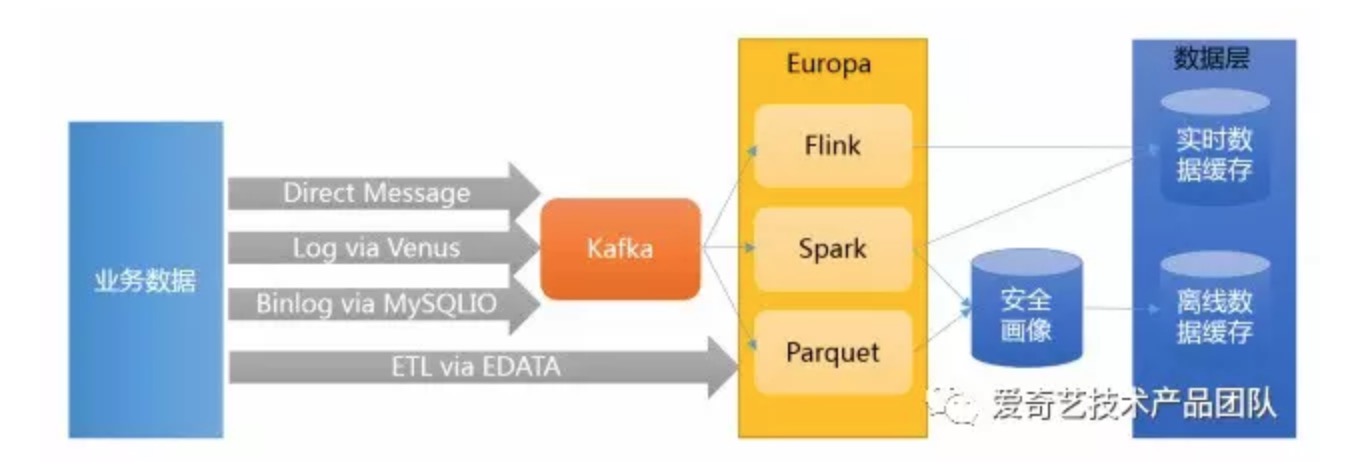
| 数据类型 | 技术选型 | 应用 | 延迟时间 |
|---|---|---|---|
| 实时数据 | Apache Flink | 图特征工程, 多维频次特征,多数据流Complex Event Processing | 毫秒级 |
| 近实时数据 | Apache Spark | 异常检测,流式特征工程 | 秒级 |
| 离线数据 | Apache Spark / Impala / Hive | 安全画像,用户画像,全业务数据 | 小时/天级 |
设备指纹

风控需要一个好的设备指纹的服务,要让所有的端都能够采集设备纬度,形成一个指纹,这个指纹多维签发的, 而且在云端会做大量的黑产分析,联合安全画像进行沉淀。
因为这些数据都是用户提供上来的,必须要做一个防伪的检测,从多维度数据里面查出提供的维度数据矛盾和不真实。
验证手段
- 图文验证码: 传统的复杂图文验证码
- 滑动验证码: 基于滑动的人机行为识别进行验证
- 上下行短信验证: 发送下行或者上行短信进行验证
- 基于信任设备的验证: 信任设备可以为其他端进行授权和验证
- 基于安全盾APP的验证: 安装爱奇艺安全盾APP可以为其他应用进行动态口令(OTP), 推送一键确认, 扫码确认
风控服务的心得
- 拥抱业务:安全只有拥抱业务才能体现价值
- 云端结合:立足于云,服务为云,结合与端
- 精细运营:业务安全需要持续运营
- 协同联动:多点多层次跨业务防御
- 二八原则:优先解决主要风险
- 数据驱动:充分挖掘数据价值
利益
黑产是谁
当我和别人说起来黑产的时候,大部分人都会想到电影里面的黑客,轻轻松松就可以黑近别人的电脑。虽然电影里的有点夸张,不过黑产中确实有很多在技术上有长处的人负责解决“技术问题”。
除了普通人脑海中的“黑客”,还有很多人负责体力活。下图就是很有名的App Store刷榜照片。在综艺活动投票、App评分这两个领域,有很多这样的人参与。

黑产从业者里有很多“兼职”,有学生也有无稳定工作的人,有时候你会发现这帮人很有分享精神,兼职论坛论坛也是红红火火。有一次我们被刷,监控到的时间和论坛的发帖时间只隔了3分钟,可见这种论坛的传播效率。
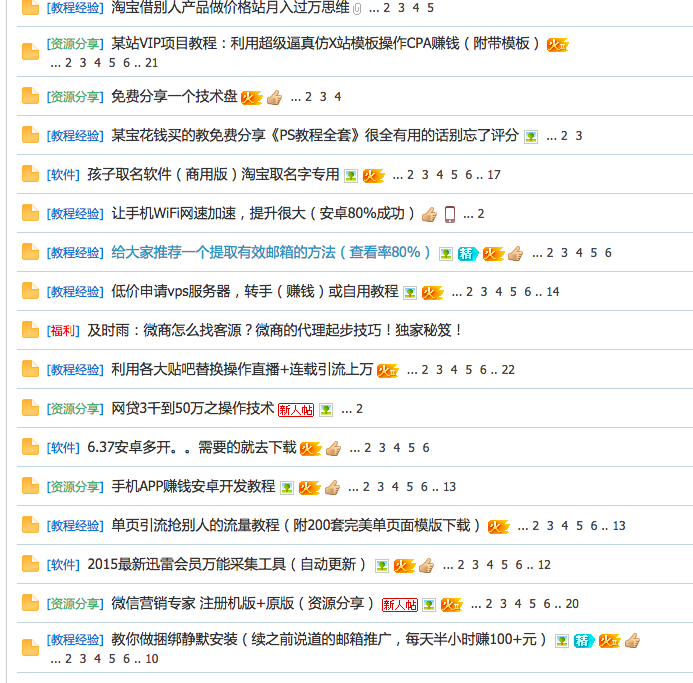
过年的时候我坐在亲戚家,一个亲戚知道我在互联网公司工作,便问我知不知道刷帖,QQ群说有人拉他干,问我是不是骗人的,是不是要管他要押金,是不是传销。我的这位亲戚是一个老实本分的人,只不过家里因为治病生活很拮据,又赶上工厂效益不好,想找个挣钱的事情。
很巧我读到过这样一篇新闻,以下是节选
要想成为一名刷手,必须经过两个小时的业务培训——
考试合格后,必须通过管理员身份认证,才能成为正式刷手。记者看到,在这个刷单群里共有十一个小组,人数超过了1万人。每天都会有大量刷单需求滚动出现在公告栏,提示刷手到相应的小组抢单。
每个小组都有几名主持,主持的主要工作就是放单和指导刷手如何做单。记者看到,一个为汽车用品在淘宝上刷销量的单子,短短几分钟就被刷手抢完。每名刷手根据自己淘宝账号的信用等级能挣到4元到6.5元不等的酬劳。一位从事刷单业务的主持小刘道出了其中的秘密。
小刘告诉记者,刷单群一般分三个等级,团长、主持和普通刷手,团长负责对外接单,然后分发给主持,主持再放单给普通刷手。
记者:“刷手的人数能达到多少?”
负责人:“每个平台流动的都有几十万,也形成了一个相当于正规的行业了差不多,对他们来说。
记者:“一年大概能有多少收入?”
负责人:“就反正是那个六位数。”
记者注意到,一个网站或APP一个人只能实名注册一次,因此,刷单群为了完成客户要求的注册量,就需要不停的招募新的刷手。
小刘告诉记者,为了吸引更多的人成为刷手,刷单群都会制定各自的拉人奖励机制。在群公告里记者看到,拉一个人缴费进群,就可以得到38元的奖励,两个人奖励80元,三个人120元。不仅如此,群里还设计了专门的赚钱宝典,指导成员如何通过社交平台吸引亲朋好友甚至陌生人前来加入
实际上参与黑产的人并不都是大奸大恶,有很多是普通人,因为没有稳定的经济来源只好做些临时工作。很多时候他们不知道这个是违法的,因为他们不知道整件事是怎么运转的,对于他们而言只是动了动鼠标、输了几个数字,这怎么能算违法。
利益
如果你还未经历很多安全事件,对黑产这个群体的感知还很模糊,没关系,先记住“利益”这个线索,这一点是我们分析一个事件的起点。黑产不停地在你的业务中发现漏洞,发现低成本获得利益的机会,而我们将从利益出发,寻找踪迹,并通过修复漏洞或压薄他们的利益来对抗他们。
一个直观的案例:盗号
盗号是一种常见的安全事件,黑产可以从盗号中直接获取利益吗?
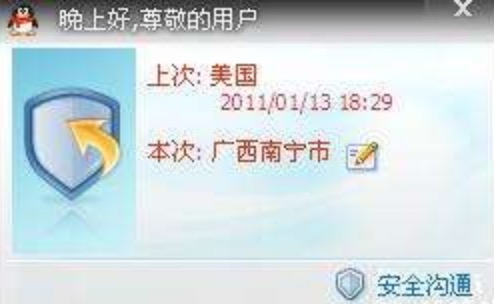
可以,2005年左右的时候还真的有很多盗取QQ号然后转手卖出去的,主要是通过病毒盗取用户密码,选一些太阳多的高等级号转手卖出去。这就是获益的手段。计算机病毒就是踪迹。后来腾讯在QQ里整合了病毒查杀模块,登录前需要扫描一遍,登录后还会提示用户上一次登录的地点。这种盗号情况才有所收敛。

一个不直观的案例:同卡进出欺诈
在某个真实案例中,接到大量用户投诉,说自己被诈骗了。用户的四要素(开户人姓名、身份证号码、银行卡号、银行预留号码)被骗子骗到后,绑定到了我们的系统,转走了几万元。我刚知道的时候很震惊,不是震惊被骗的额度大,而是震惊这是一个同卡进出理财的业务。也就是说:
- 这笔钱骗子无法消费,无法流出系统
- 产生的收益和本金只能通过同一张卡提现,也无法新绑一张卡提现到骗子的账户中
偶尔有一两个骗子不知道也情有可原,但是这么多欺诈案例是怎么回事?我们应该上什么对抗策略?
- 骗子和受害人是微信沟通,我们无法阻断
- 禁止新用户充值?不现实
- 禁止新设备充值?也不能不让用户换手机啊
否定了一大堆策略后,似乎很茫然。后来冷静的花了一个上午仔细的看了一遍客服反馈的投诉详情,终于恍然大悟。原来骗子并非是想把受害人的钱通过这个系统提走,而是想通过这个系统给受害人刷流水,赢得信任后再骗受害人微信转账。查明了骗子的目的后,我们也就好制定策略了。
从这个利益不直观的案例中可以发现,缺少对利益的分析会让我们疲于制定指标不治本的策略。
站在社会角度看这个问题(可跳过)
赔钱的生意没人做,杀头的生意有人做
现在的黑产已经形成了一个完整的产业链,里面有形形色色的人,有形形色色的分工,但是我们可以抓住他们的一个共性——利益。
一个人将他的时间花在什么事情上,是取决于哪件事情可以带来最大的回报。需要注意的是两点
- 并不是有利益就会有人干,要利益足够大
- 人们总是从多个有利益的选项中选取最优
假设一个人的普通工作可以给他带来2000元每月的回报,但是当从事黑产可以得到3000元每月的时候(两者都有利益),他还不至于放弃已有工作,因为换工作也需要成本(经济学成为交易费用)、入会也需要成本(经济学成为上头成本),假设从事的各种成本和费用是1000元,算一下从事黑产是并没有明显好处的。更别提还有比较严重的行为会受到法律的追求。
目前收入2000 + 各种成本和费用1000 + 法律追究? >= 从事黑产的利益3000
当从事黑产的回到达到10000元每月的时候,在不同程度的法律追究强度下,就可能促使这个人从事黑产
目前收入2000 + 各种成本和费用1000 + 法律追究? <= 从事黑产的利益10000
这个公式只是一个简化了的情况,里面也许还会涉及个人名誉等虚拟且价格因人而异的东西(不同人看待名誉的程度不同)。我们在这个公式基础上在简化一步就是
不做黑产收入 <=> 做黑产收入 - 可见和不可见的直接成本
从这个公式中,我们可以得出
- 消灭黑产并不需要迫使他们的利益为0,实际上也很难甚至做不到
- 消灭黑产应该尽量增大公式左边部分的利益,减少右边的利益。
对于第一条,需要个人和政府的双方努力,个人要提升自己的价值,政府也要提供一个就业、收入稳定的社会。人们可以通过努力获得精神和物质上的利益。这个已经超出了本文的范围。
接下来的内容将都是围绕"减少右边的利益"开始的。
异常发现
异常发现
风控的运作过程中,第一个需要了解的是“异常发现”。不是因为它最简单,而是因为
- 大部分时候异常发现是风控工作的起点
- 异常发现是非常重要的一步,风控大量系统、算法、时间都和异常发现有关。这一步就像是提出一个问题。如果你提不出问题,也就谈不到解决问题;其次,提出一个好问题可以让你更快的解决问题。准确的发现异常,就是提出一个好问题
异常可以有很多,例如:
- 昨天凌晨1点的订单比均值高
- 今天注册用户数突然上升
- 昨天验证码的请求量上升
建立监控
怎样发现异常呢?最容易想到的是做一个统计图表。这个确实是必要的。
用一个我真实用过的表格来距离,这个表格是为了监控刷单。这个表格统计每个设备登录过的用户数和下过的订单量。

一般一台手机只会被一个人使用,一个人一般在我们公司只会注册一个账号(不同业务具体分析,例如我妈注册了多个QQ号,因为她在玩斗地主,一个账号的欢乐豆不够),上图中可以清晰看出三台设备登录了几十个用户,人均下一单,符合刷单的情况。那么这就可以作为突破口继续查下去。
图中对可疑的数据会自动高亮,方便运营发现异常。当然了每天看表格比较麻烦,所以我们还会推送报警到管理员的手机,方便我们尽快解决问题。
除了对设备号做聚合统计,你还可以用IP、UID做聚合统计,当然也可以结合好几个一起聚合统计。如果你学过SQL,大致可以想到就是调整一下group by的字段,似乎很简单。
select ... group by device
select ... group by device, ip
select ... group by device, uid
select ... group by ip
select ... group by ip, uid
select ... group by uid
select ... group by device, uid, ip
可是当真的开始写SQL的时候就陷入了崩溃,因为:
- 日常需要监控的维度有很多,选哪几个呢?
- 多个维度的组合太多了,如上面的示例,如果想把device、ip、uid三个维度组合都统计出来,需要写7条SQL,如果维度再多一点,会很麻烦,很容易出错
这个时候我们就可以借助一点算法了。
使用频繁项集(Frequent Pattern)发现异常
首先介绍一个简单、上手容易的算法——频繁项集。
Frequent Pattern 可以理解为频繁出现的特征组合,例如在你的订单记录中来自IP 13.67.233.10 且安卓设备就是一个Pattern,如果这个Pattern频繁出现,例如超过总请求量的10%,就值得我们关注了。
听上去和刚才介绍的SQL是一回事,但是使用FP-Growth之类的频繁项集挖掘算法,我们只需要指定所有需要分析的维度即可,而不需要人工将它们排列组合。
具体的实现可以使用Spark ML FP-Growth
假设我们指定要分析的维度有api、UA、IP、客户端,使用Spark ML FP-Growth计算,重新将产出的结果格式化之后,类似这样:
| Pattern | Pattern 计数 |
|---|---|
| ip-223.88.67,,rf-https://www.baidu.com/api,,ua-Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/63.0.3239.132 Safari/537.36 | 7198 |
| api-/apis/reglogin/login.action,,ip-223.88.67,,ua-Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/63.0.3239.132 Safari/537.36 | 7198 |
| 客户端ID-1,,ip-223.88.67,,ua-Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/63.0.3239.132 Safari/537.36 | 7198 |
| ip-223.88.67,,ua-Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/63.0.3239.132 Safari/537.36 | 7198 |
| 客户端ID-1,,ip-,,ua-Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/63.0.3239.132 Safari/537.36 | 6973 |
| api-/apis/reglogin/login.action,,客户端ID-1,,ip-,,rf-https://www.baidu.com/api,,ua-Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/63.0.3239.132 Safari/537.36 | 6836 |
| 客户端ID-30,,ua-Some Client PC 6.7.82.6548 | 6702 |
| api-/apis/reglogin/pc_login.action,,ua-Some Client PC 6.7.82.6548 | 6702 |
| ua-Some Client PC 6.7.82.6548 | 6702 |
| api-/apis/reglogin/mobile_login.action,,客户端ID-34 | 6282 |
| 客户端ID-34 | 6282 |
实际应用中,频繁项可以作为核心,直接展示或者报警出来。也可以作为其他分析的第一步,需要结合业务进行设计。
时间序列检测
除了通过请求频率判断是否有异常,还可以通过请求的时间序列来发现异常(异常不代表有攻击)。
时间序列可以理解为指标随着时间变化的规律。用地铁客流量来举例,一天中客流量应该类似下图,会有明显的早晚高峰。

假设不考虑节假日,将多天的数据连起来看,差不多如下图。有明显的波动规律。所以如果某一天实际客流量不符合这个规律了,大概率是发生了什么事情,例如附近在举办大型的展览。

LSTM
简单的频率比较容易识别,使用SQL或者某种计数系统就可以实现。但是这种时间序列的异常应该怎么识别呢?这就要提到最近几年被广泛使用的LSTM模型。
Long Short Term Memory(LSTM)是 递归神经网络(Recurrent Neural Network)的一种,具体的原理可以自行Google。这里你需要知道的是使用LSTM可以很方便的对时间序列进行检测,特别是使用TensorFlow 2.0。
下图是使用TensorFlow预测的结果。
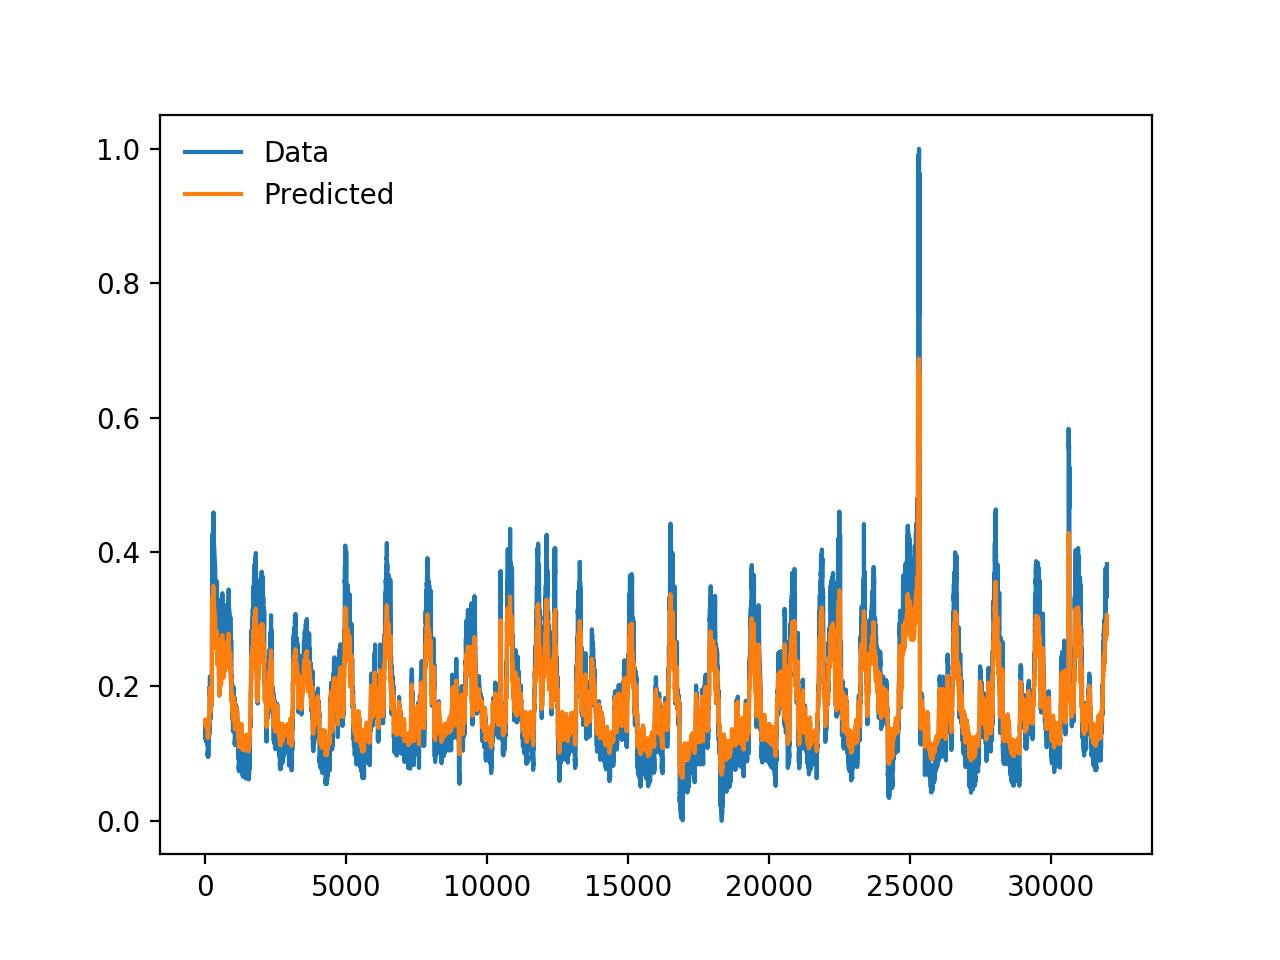
具体例子可以参考TensorFlow 时间序列预测的例子。
多维度判断
多维度判断
我们已经知道一些发现异常的方法了,下面介绍如何使用它们。
在法庭上,判定一个人有罪或是无罪,需要有多个证据。在风控中判定一次请求是正常或是恶意,也不能简单的只考虑一个证据。
按照维度整理数据
在上一章看到的例子中,通过观察在一台设备上登录的用户数和下单数来推测刷单,这对于一些简单场景也许足够了,但是对于大多数场景都是不够的。
我们通常将风控信息或者说风控数据按照不同维度组织。相同的一组数据按照不同维度整理,会有不同的结果。
以下是某网站的登陆记录,我们试着将数据从不同维度统计以下
| 用户ID | IP | 设备号 | 时间 |
|---|---|---|---|
| 1 | 50.0.0.0 | DeviceA | 2016-04-04 00:00:00 |
| 2 | 50.0.0.0 | DeviceB | 2016-04-04 00:00:00 |
| 3 | 50.0.0.0 | DeviceA | 2016-04-04 00:00:01 |
| 2 | 50.0.0.1 | DeviceB | 2016-04-05 00:00:00 |
用户维度
| 用户ID | 登陆次数 | 登陆设备数 |
|---|---|---|
| 1 | 1 | 1 |
| 2 | 2 | 2 |
| 3 | 1 | 1 |
设备维度
| 设备号 | 登陆次数 | 用户数 |
|---|---|---|
| DeviceA | 2 | 2 |
| DeviceB | 2 | 1 |
_你可以试着将IP维度的数据整理出来吗?_
将数据整理完成后,我们会从多个维度来验证一次交易、一个用户甚至是一次HTTP请求。
实例
一名用户正在登陆Jim的账号,我们希望判断出是不是真的是Jim本人。
从之前刷单的例子已经知道,限制单台设备的登陆次数和人数是个不错的主意,我们看看Jim过去1个月的设备统计
| 设备号 | 登陆次数 | 用户数 |
|---|---|---|
| DeviceA | 10 | 1 |
如果只从设备号维度看,一切正常,虽然登陆次数是10次,但是考虑到是一个月,也不会显得很频繁,但是我们不妨试试多维度交叉分析。
我们试试用户名(假设用户名和用户ID唯一)维度。
| 用户名 | 登陆次数 | 登陆设备数 |
|---|---|---|
| Jim | 10 | 10 |
天,这个人在干什么?!这个人虽然在设备A上只登陆了一次,但是他同时也在另外9个设备上登陆了。这个人很可疑,幸好我们没有只从一个维度考虑。不过,到底发生了什么呢?
不要急,后面的几章会慢慢解释。
限制频率
限制频率
在上一章中我们分维度统计数据的时候,是将不同维度的数据求和,然后看这个和的大小。但是我们仍不能忘了一个重要的前提,就是时间。
还是以用户登录为例,Jim想要登录自己的社交网站,我们可以因为他连续10次输错密码阻止他登录,但是不能因为他10个月里每个月都输错了一次密码。
换句话说,我们限制的是频率(次数/时间),而不是简单的总数。而限制频率也是最常使用的手段。
先列举一些常见的限制频率的场景:
- 限制每天用户输错密码的次数,用以控制密码暴力破解
- 限制每台设备领用优惠券的次数,用以控制普通用户注册多个账号刷券
- 限制每张银行卡每天的消费金额,用以控制盗号
优点
简单:无论从统计逻辑还是理解上,都是十分简单
快速:对频率的计算和比较,都是一些基础的计算。无论是数据库还是程序,对这类计算都很好的支持,且不需要很多高耗时的算法
应用范围广:你几乎可以在每一个场景下找到它的影子
实时性强:往往不需要大数据的离线计算,可以实时统计,实时使用
缺点
也有场景局限:对于利用漏洞导致的攻击,或者复杂的场景,限制频率的效果有限
可以减缓攻击,不能阻止攻击:虽然限制了频率(给定了一个阈值),但是在达到阈值之前的请求可能会被放过,例如限制每小时密码可以错10次,实际上每天还是可以尝试240次
绕过手段成熟: 通过批量注册、IP代理、多开虚拟机等手段可以削弱频率类规则的效果
多维度频率限制
你可能已经猜到了,很多场景下,我们通过限制一个指标的频率很难起到作用,很容易被绕过去。这个时候我们可以从多个维度入手,限制多个维度的频率。
单指标多个频率限制
除了多个维度的限制,在单个维度的单个指标上,也可以限制多个频率。
还是拿暴力破解密码的场景,限制“每小时密码可以错10次”的基础上我们增加一条“每天只能错15次”,这样虽然没有克服缺点中的第二条,但是比原来的方案更好的保护了用户。
我们认为不同的频率限制有不同的可疑程度,满足“每天只能错15次”的请求要比“每小时密码可以错10次”更可疑的,所以我们对前者的惩罚更重,或者验证更谨慎。
防范代理IP
IP维度的频率规则很常见,但很多时候并不好用。因为黑产通常会购买大量代理IP,通过一个代理IP请求几次,再换下一个代理IP。互联网上有大量代理IP,价格很便宜,很多甚至是免费的,所以这么做的成本很低。
对抗代理IP的方式主要是:
- 过滤海外IP。大量代理IP来自海外,例如委内瑞拉、荷兰、印度尼西亚、美国。对海外IP进行二次校验,可以快速增加黑产的成本
- 爬取公开代理IP。很多网站会提供免费的代理IP,我们可以用爬虫爬取这些IP,进行拦截
- 购买代理IP。和黑产一样,直接花钱购买代理IP。相比较第二步,我们无需开发爬虫,也可以快速获取大量代理IP
IP风险识别
IP风险识别
IP维度作为一个常见、容易理解、获取难度低的维度,经常是最先被想起来的一个维度。有时候参与业务需求讨论,产品经理会兴致勃勃给我讲他定的IP风控策略。但很多时候这些策略都不够专业,实际中不会有太大的作用。我这里举几个常见例子:
你们能不能把阿里云那种IP都封禁掉?
这种IP我们统称为IDC IP,有不少第三方公司都提供IDC IP库。大部分时候是挺准的,但是实际经验来看会有误杀。
我们想把每小时请求超过100次的IP都封禁掉,你看行不行?
技术上并不难。但是效果很有限,因为现在刚入行的黑产都知道IP要经常换一换,接入代理IP或者ADSL秒拨IP。
下图是某秒拨换IP工具截图,可以看出功能齐全、布点遍布全国。
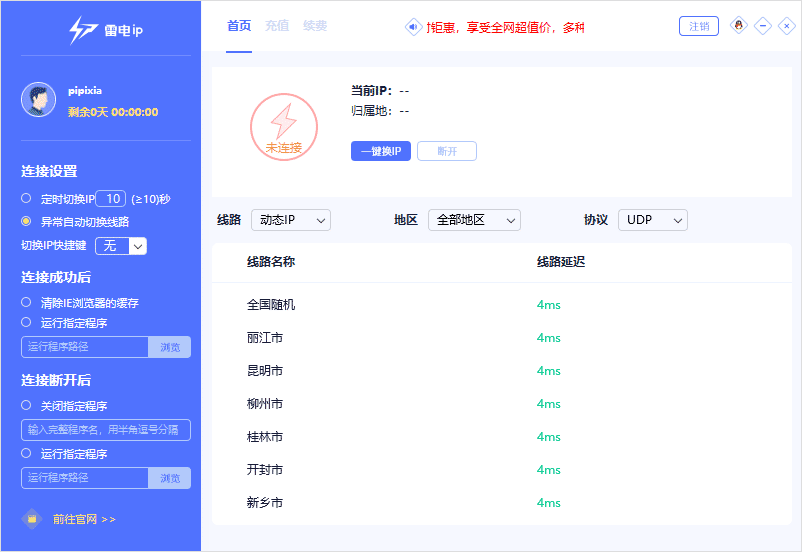
下图是类似服务的报价,价格还不贵。


所以黑产多换一换IP,就可以很轻松的绕过IP频率类的策略,这类策略的效果自然就不好了。
市面上有很多IP威胁标签,好用吗?
IP情报几乎是每一家威胁情报服务商的标配,分为代理、撞库、垃圾邮件、Web服务器、扫描器等标签。但也不能盲目使用,原因有二:
- 根据实际体验来看,不同标签“误杀”情况相差很大,不能直接拦截,需要仔细评估。
- 最主要的是这个“误杀”有时不是由于情报服务商搜集错了情报,而是用法的问题。往往服务商只会标记一个IP发生过哪些攻击,但是这并不意味着这个IP就是专门做这件事的。一个普通人用自己家的宽带做了几天坏事,这个宽带IP就会被标记。但很明显你不能把这个宽带IP给完全拦截,毕竟还有很多正常人在使用。
一个解决思路
不考虑IP的属性,单纯看一个IP的流量是否符合真人。于是接下来介绍我在爱奇艺设计的基于流量、行为的IP识别体系————IP信誉分。
_以下内容取自于唯品会SRC城市沙龙的公开内容,虽然有大量细节未公开,但是不影响大家理解背后的思想_
IP信誉分

融合爱奇艺内部多个系统的数据, 参考第三方数据,综合衡量一个IP的长期行为, 得到一个-100到100的信誉分.
IP信誉分特点
- 分数制
使用-100到+100的分数,表示一个访问爱奇艺的IP的威胁程度,0代表中性;正分表示有威胁,分数越高越有威胁;负分表示无威胁,分数越低越无威胁。
不仅直观,同时业务方可以结合自己的业务,决定规则的松紧程度。
- 引入负分
第三方情报服务,正常IP和无威胁情报的IP都是0分,无法区分。我们引入负分表示一个IP偏向正常。包含两类IP:
- 不仅无恶意行为,而且有正常行为
- 有恶意行为,但是有更多或者更置信的正常行为,总体偏向无恶意
主要应用在公共出口防误杀
- 只关注于访问爱奇艺的IP
因为:
- 不访问爱奇艺的IP对爱奇艺的威胁是0
- 对爱奇艺有威胁的IP都访问过爱奇艺
- 威胁越大的IP往往请求越多,产生的痕迹就越多,我们就可以做的越准确
- 更适合爱奇艺
绝大部分数据均来自爱奇艺的各个业务,分析指标结合了各个业务的特点,识别更精确
例如194.44.172.210这个IP
- A公司告知这是一个代理,并且给了50分
- B公司只告知这是一个HTTP代理
IP信誉分结合爱奇艺Passport业务,判断这个IP业务行为严重异常,给出了100分的满分,识别准确无误
- 公共出口识别更准确
不仅可以识别出公共出口,而且识别出了这个公共出口是什么,包括:企业、商场、酒店、机场、地铁、公交车等公共设施出口IP
_第三方威胁情报服务也许也能做到这一点,但是并没有开放出来_
IP信誉分研发过程

IP信誉分的特征提取

IP信誉分的特征交叉检测

IP信誉分的每日检测

设备风险识别
设备指纹
为什么要确定一台设备
先来看一个场景。
在游戏业务中,为了降低用户体验门槛,在打开游戏时可以不要求用户注册,也就是说拿不到账户角度的用户ID。这时确定用户设备就很重要,否则在后端无法分辨哪些是同一个用户的数据。
这是业务中必须要确定一台设备的场景,那风控中也是为了对未登录用户进行跟踪吗?是不是只要用户登录了,设备的识别就不重要了?
对匿名用户的跟踪
首先有一点和业务是一样的,要在未登录状态时追踪用户
识别设备风险
设备指纹的生成
生成一个设备指纹最简单的方法就是一个完全随机的字符串,例如UUID。好处是简单、快速。坏处也很明显:
- 不稳定,同一设备每次生成的设备指纹是不一样的
- 无法校验,攻击者可以随意生成格式一样的设备指纹,而服务器无法校验是否是自己签发的
稍微
| 采集信息 | 样例 |
|---|---|
| 设备型号 | iPhone X |
| 屏幕分辨率 | 2436X1125 |
| 操作系统 | iOS 11.1 |
| 运营商 | 中国电信 |
| 时区 | GMT+08:00, Asia/Shanghai |
<未完>
用户业务行为习惯
现在的大型网站都会记录用户的行为,例如用户的浏览记录、停留时长、输入密码的速度、按钮点击等。我们可以用这些数据佐证我们对用户的验证。
一个用户的历史行为
我们可以收集一个用户的历史的业务数据和行为数据,给这个用户打一些标签。例如
| 用户 | 历史数据 | 标签 |
|---|---|---|
| Jim | 用户购买了10次,平均每次花100元 | 每次消费能力较低 |
| Lily | 用户购买了15次,平均每次花1000元 | 每次消费能力较高 |
| Hunk | 10次下单中9次购买零食 | 大部分订单为食品类 |
| Hunk | 历史余额提现都提到了招商银行 | 用户习惯用招商银行 |
基于一个用户的历史得到标签后,我们假设用户很少改变自己的习惯,所以每当用户做出违反自己习惯的行为时,我们可以对用户的行为多一些验证。
例如上面的Hunk,Hunk要将余额提出来(提现),这次新绑定了一张工商银行的卡,我们发现他从来没有向这张卡提现过。有可能是盗号提现,也有可能Hunk刚刚办了一张新卡。我们不妨向Hunk绑定的邮箱或者手机发一个消息,提醒一下。
类似用户的通常行为
有时候形容一个用户的习惯很难,因为我们需要为这个用户积累一些数据之后才能给一个准确的标签。另外,我们虽然假设用户很少改变用户习惯,但是总是有善变的用户。这时我们可以试试给一类用户打标签。
| 用户群 | 标签 |
|---|---|
| 大部分用户 | 在下单前会在多个同类商品中比较一下 |
| 参加某次活动的用户 | 都是从B页面跳转过来的 |
同理,我们就可以基于这些标签,对违反用户习惯的请求进行验证。
例如“参加某次活动的用户,都是从B页面跳转过来的”,大部分黑产的人都带有极强的目标,刷活动的时候往往只关注活动页面,而且他们为了省时间会通过技术手段直接跳到活动页面。但是大部分正常用户会从一个宣传页跳转过来,例如从首页的广告跳到活动页面,再通过某个按钮参加。
实例
很多电商上面都会给商家评级,例如“皇冠”、“钻石”,不同评级的商家会有不同的曝光率,相应的收入也是天壤之别。评级的标准里订单量会是一个重要的指标。所以商家会联合专业刷单一起伪造很多订单。
很多防范商家刷单的原理就是从交易中找到那些违反正常用户习惯的交易,例如
- 用户是否是从搜索页面找到的商品
- 用户是否浏览了3个以上的商品
- 用户每个商品浏览的时间是否大于30秒
- 用户是否和商家有沟通
- 用户下了大量订单,但是均价极低
- 用户是否有申请过售后
- 用户是否评价过
如果系统检测到类似的交易,订单可能会被暂时冻结,进入一个更细致的分析阶段,甚至抽样进行人工审核。如果证实的用户、手机号、银行卡会被存入黑名单。
黑产的应对策略
类似的方法会给黑产制造很多麻烦,因为他们要尽量表现的向正常用户,这会让他们的动作变得慢下来,从而让他们相同时间内的获利减少。但是,这并不能完全阻止黑产,下图是从黑产流出的教程的截取。
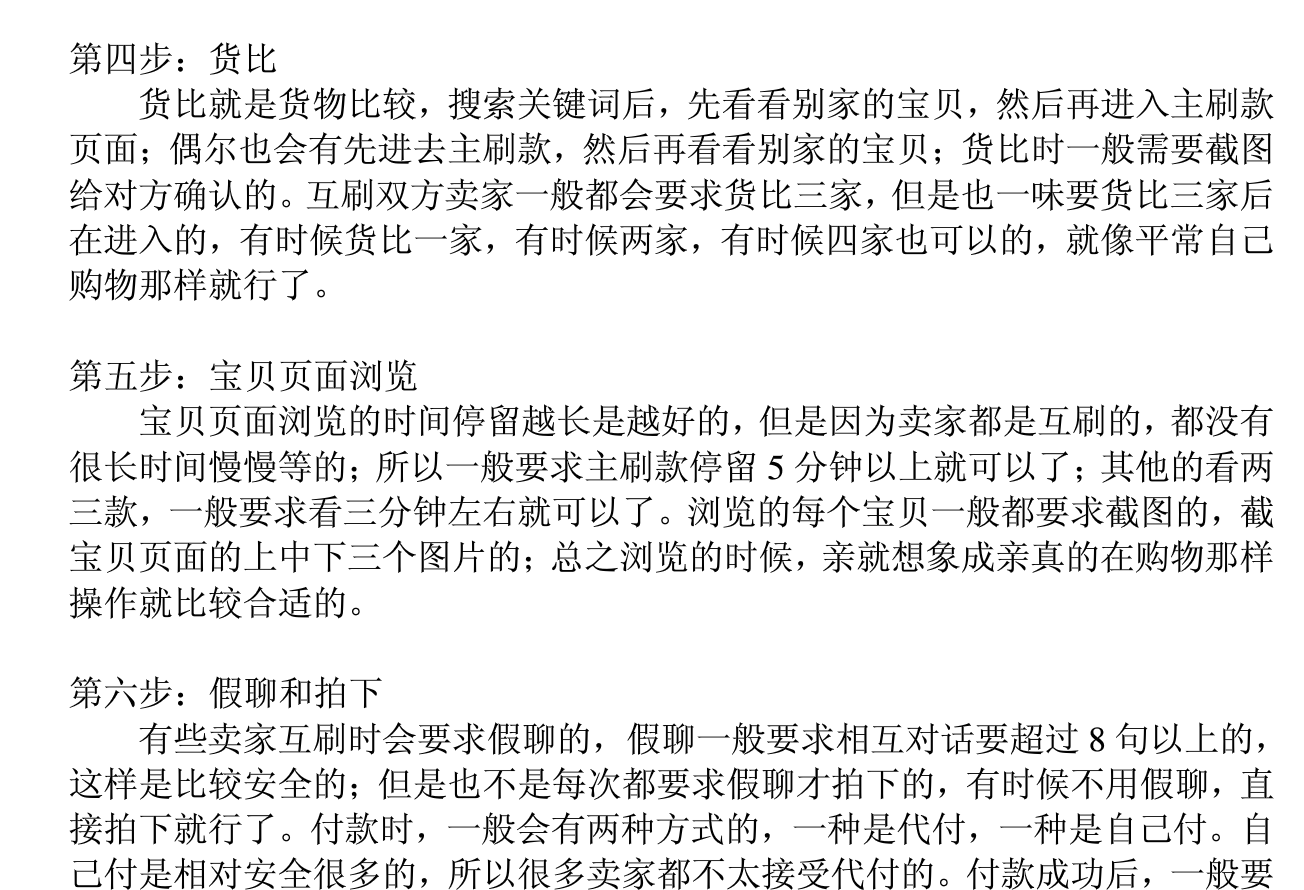
阈值的选取
阈值的选取
前文提到的很多类似“连续10次输错密码阻止登录”的规则很好理解,但是有一个问题,这个“10次”是怎么来的?
我们通常称这个值为阈值,读yù值可不是fá值。
一般这个值的选取是为了将正常行为和恶意行为区分开,那么我们就要找到两种行为的边界。
真实的案例

很多网站在登陆、注册的时候都会填验证码,目的是防止批量注册、撞库等攻击。实战中传统验证码的效果并不好,因为使用文字识别(OCR)可以轻松识别字母和数字的验证码,速度比正常人快很多。
于是我们决定增加一条规则,“识别验证码的时间少于X秒的时候,进入手机短信校验”。可是这个X定多少呢?我们来看一下用户识别、填写、提交一个验证码的总时间分布图。横轴是时间,纵轴是人数。灰色是实际曲线,红色是趋势曲线。
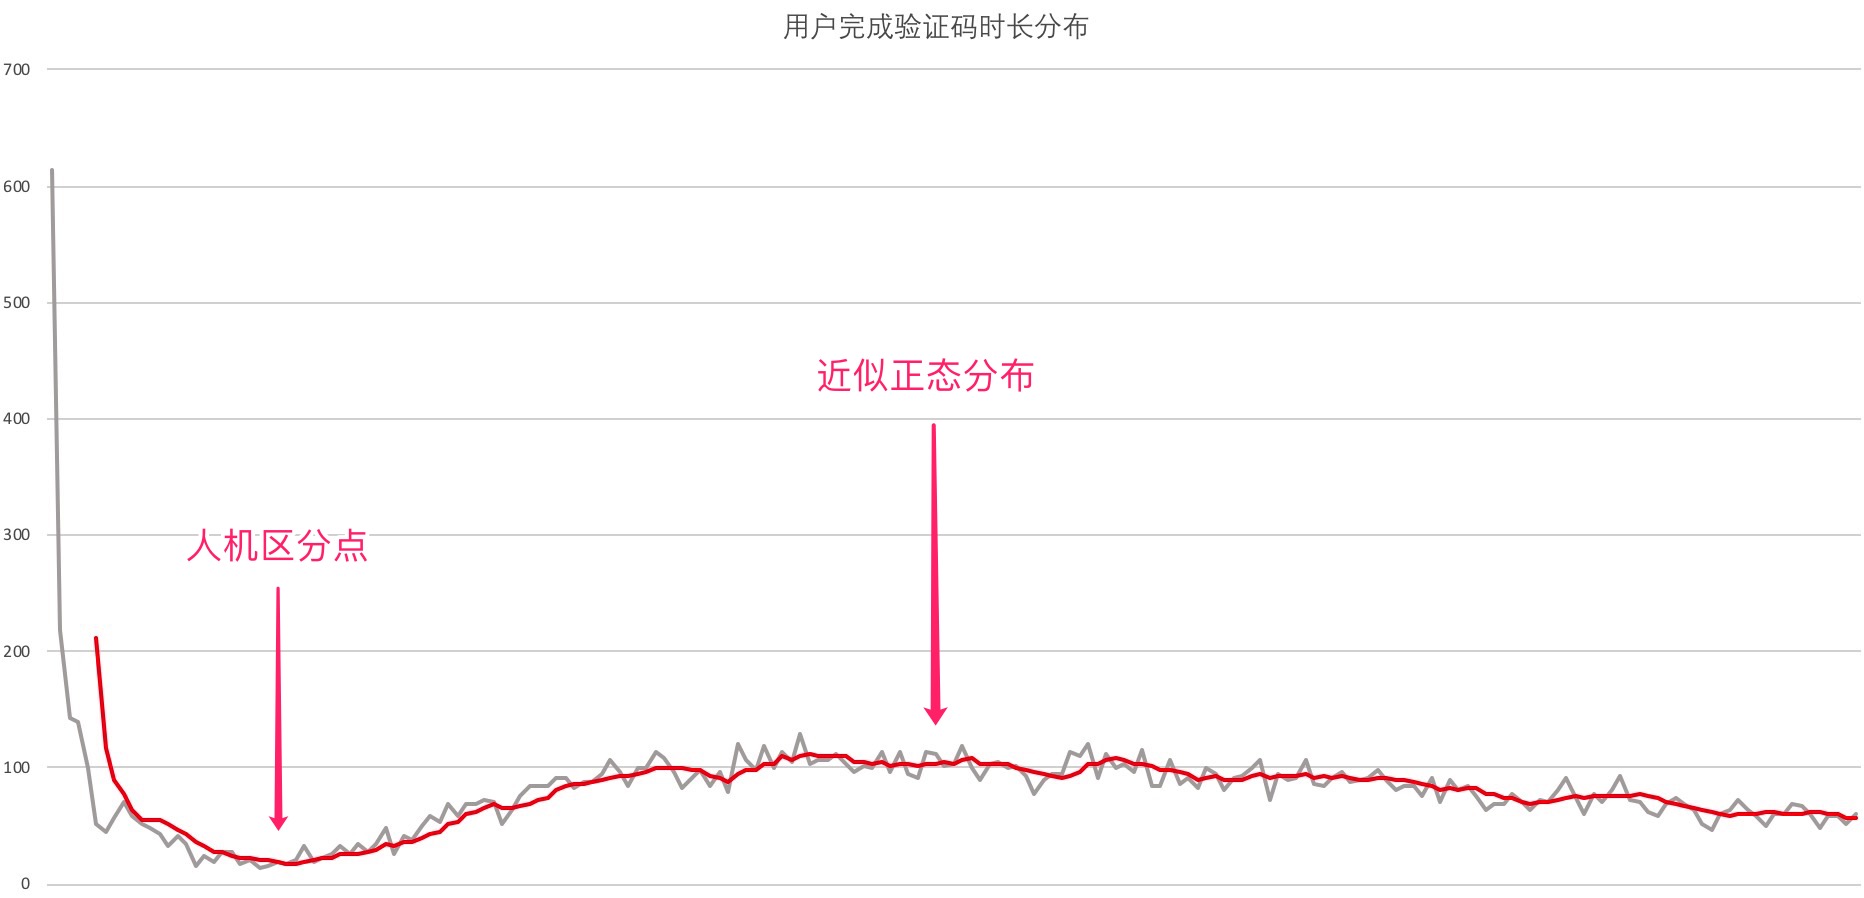
有些人手速很快,有些人手速很慢,但大部分应该中等快慢,直觉上应该是一个正态分布。从图上我们确实发现了一个类似正态分布的曲线。但是左边那个特别高的是怎么回事?手速特别快的人应该很少才对呀?为什么又多了起来?
其实,那就是机器攻击的部分。机器识别验证码的速度实在是太快了,快到比最快的真人还要快很多,导致了曲线在左侧的上升。我们最终选择了左侧箭头标记的地方作为我们这条规则的阈值。也就是说,我们认为这个标记左侧的很可能是机器,右侧的我们倾向认为是真人。
总结
选取一个阈值的大致步骤
- 要尽量搜集相关数据
- 观察数据分布
- 从分布中找到区分黑产和普通用户分界点
- 依据分界点和影响范围选取阈值
- 规则上线后的跟近