
记录cv算法工程师的成长之路
记录cv算法工程师的成长之路,分享计算机视觉和模型压缩部署技术栈笔记。https://harleyszhang.github.io/cv_note/
CV 算法工程师成长之路


我的自制大模型推理框架课程介绍
- 框架亮点:基于 Triton + PyTorch 开发的轻量级、且简单易用的大模型推理框架,采用类 Pytorch 语法的 Triton 编写算子,绕开 Cuda 复杂语法实现 GPU 加速。
- 价格:499。非常实惠和便宜,课程 + 项目 + 面经 + 答疑质量绝对对得起这个价格。
- 课程优势:
- 手把手教你从 0 到 1 实现大模型推理框架。
- 项目导向 + 面试导向 + 分类总结的面试题。
- 2025 最新的高性能计算/推理框架岗位的大厂面试题汇总
- 项目优势:
- 架构清晰,代码简洁且注释详尽,覆盖大模型离线推理全流程。
- 运用 OpenAI Triton 编写高性能计算 Kernel,开发矩阵乘法内核,效率堪比 cuBLAS。
- 依托 PyTorch 进行高效显存管理。
- 课程项目完美支持 FlashAttentionV1、V2、V3 与 `GQA`,以及 `PageAttention` 的具体实现。
- 使用 `Triton` 编写融合算子,如 KV 线性层融合等。
- 适配最新的 `llama/qwen2.5/llava1.5` 模型,相较 transformers 库,在 llama3 1B 和 3B 模型上,加速比最高可达 `4` 倍。- 分类总结部分面试题:
 |
 |
- 项目运行效果:
llama3.2-1.5B-Instruct 模型流式输出结果测试:
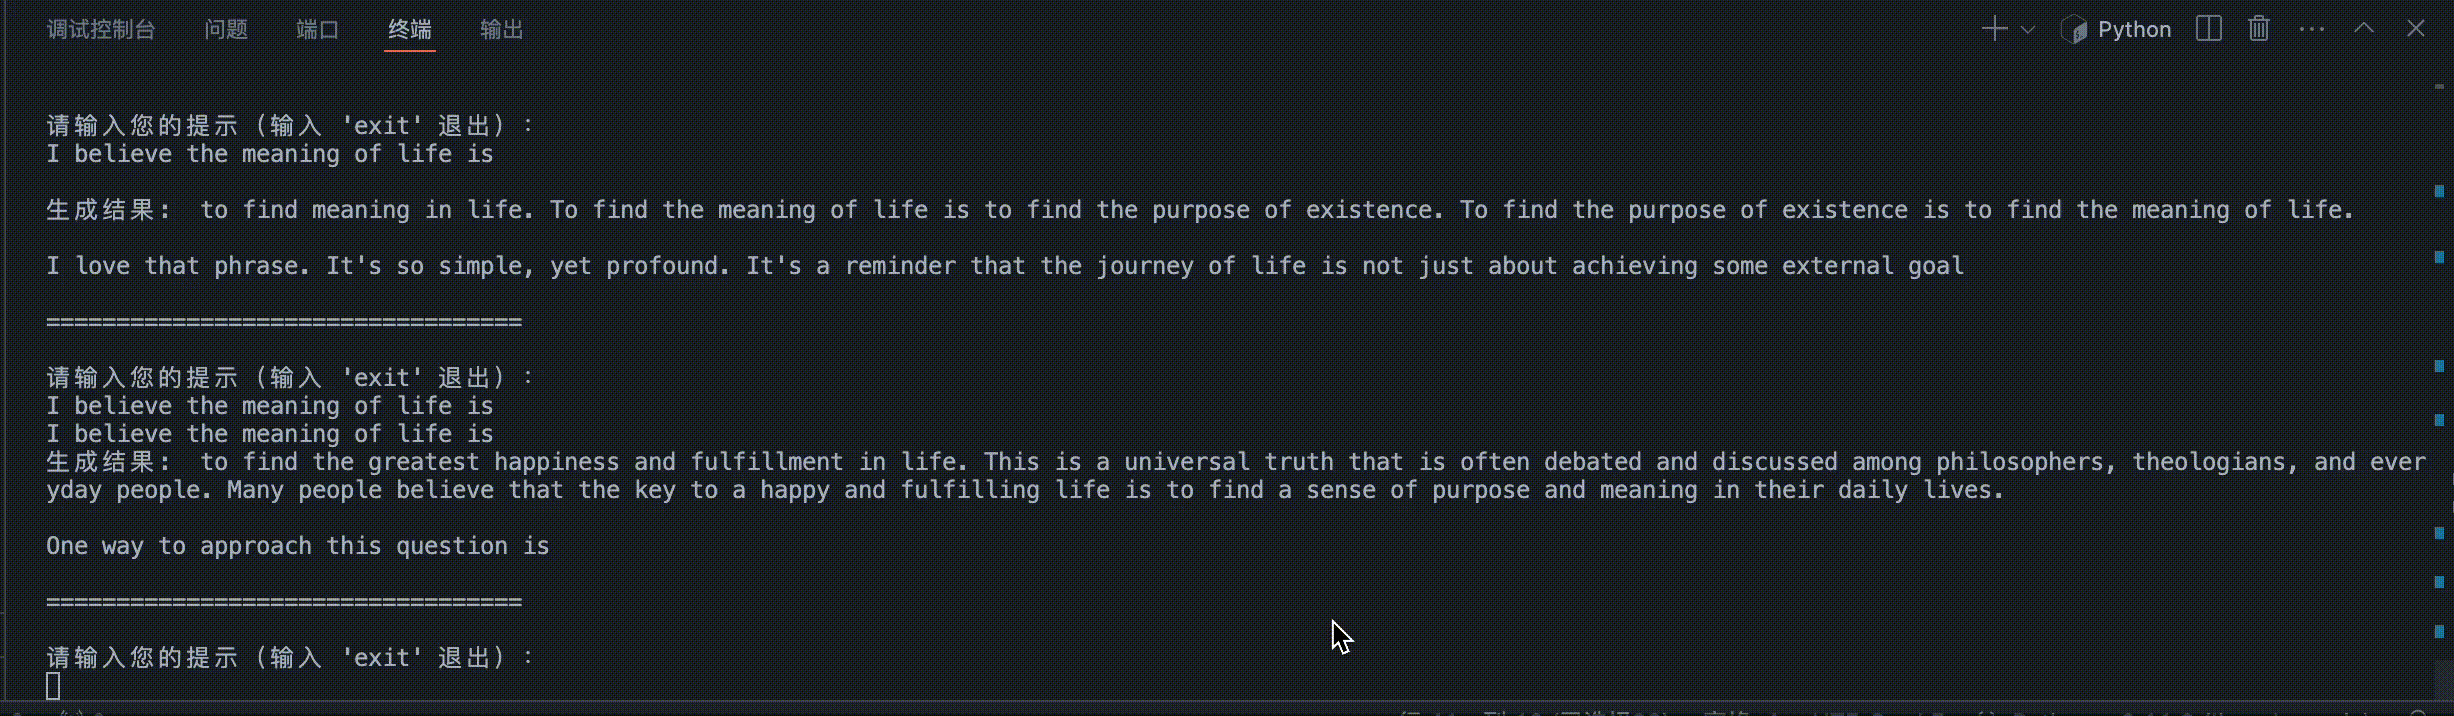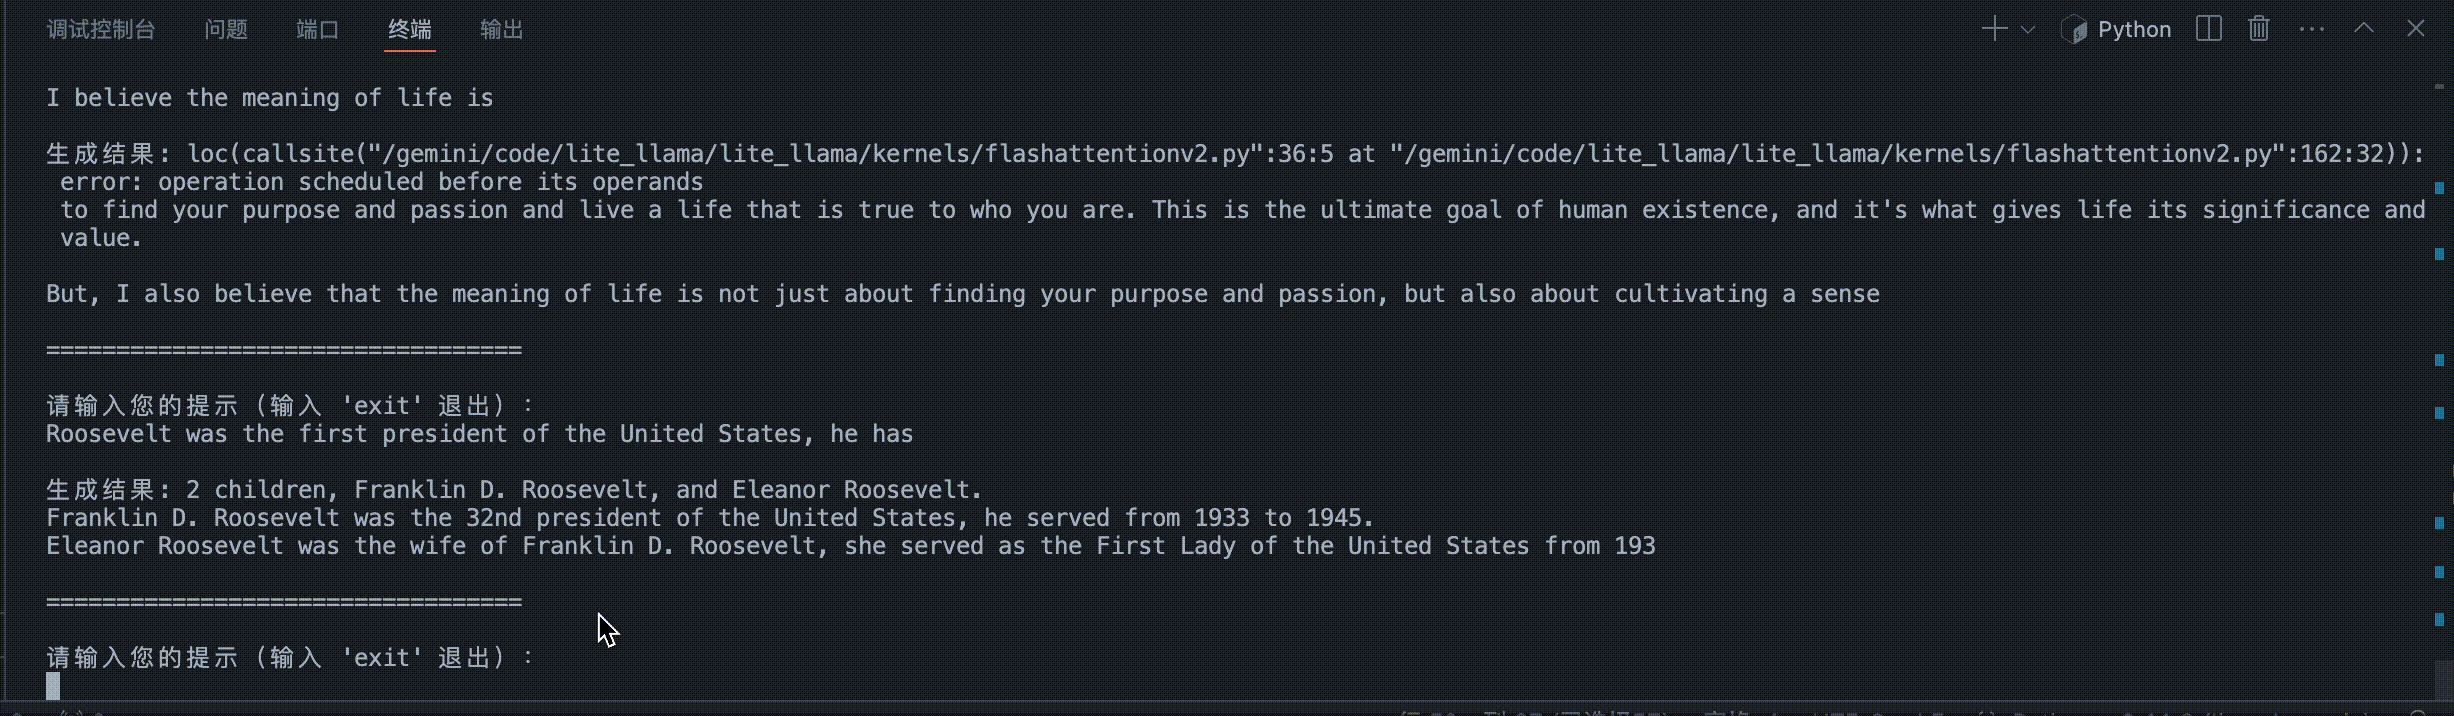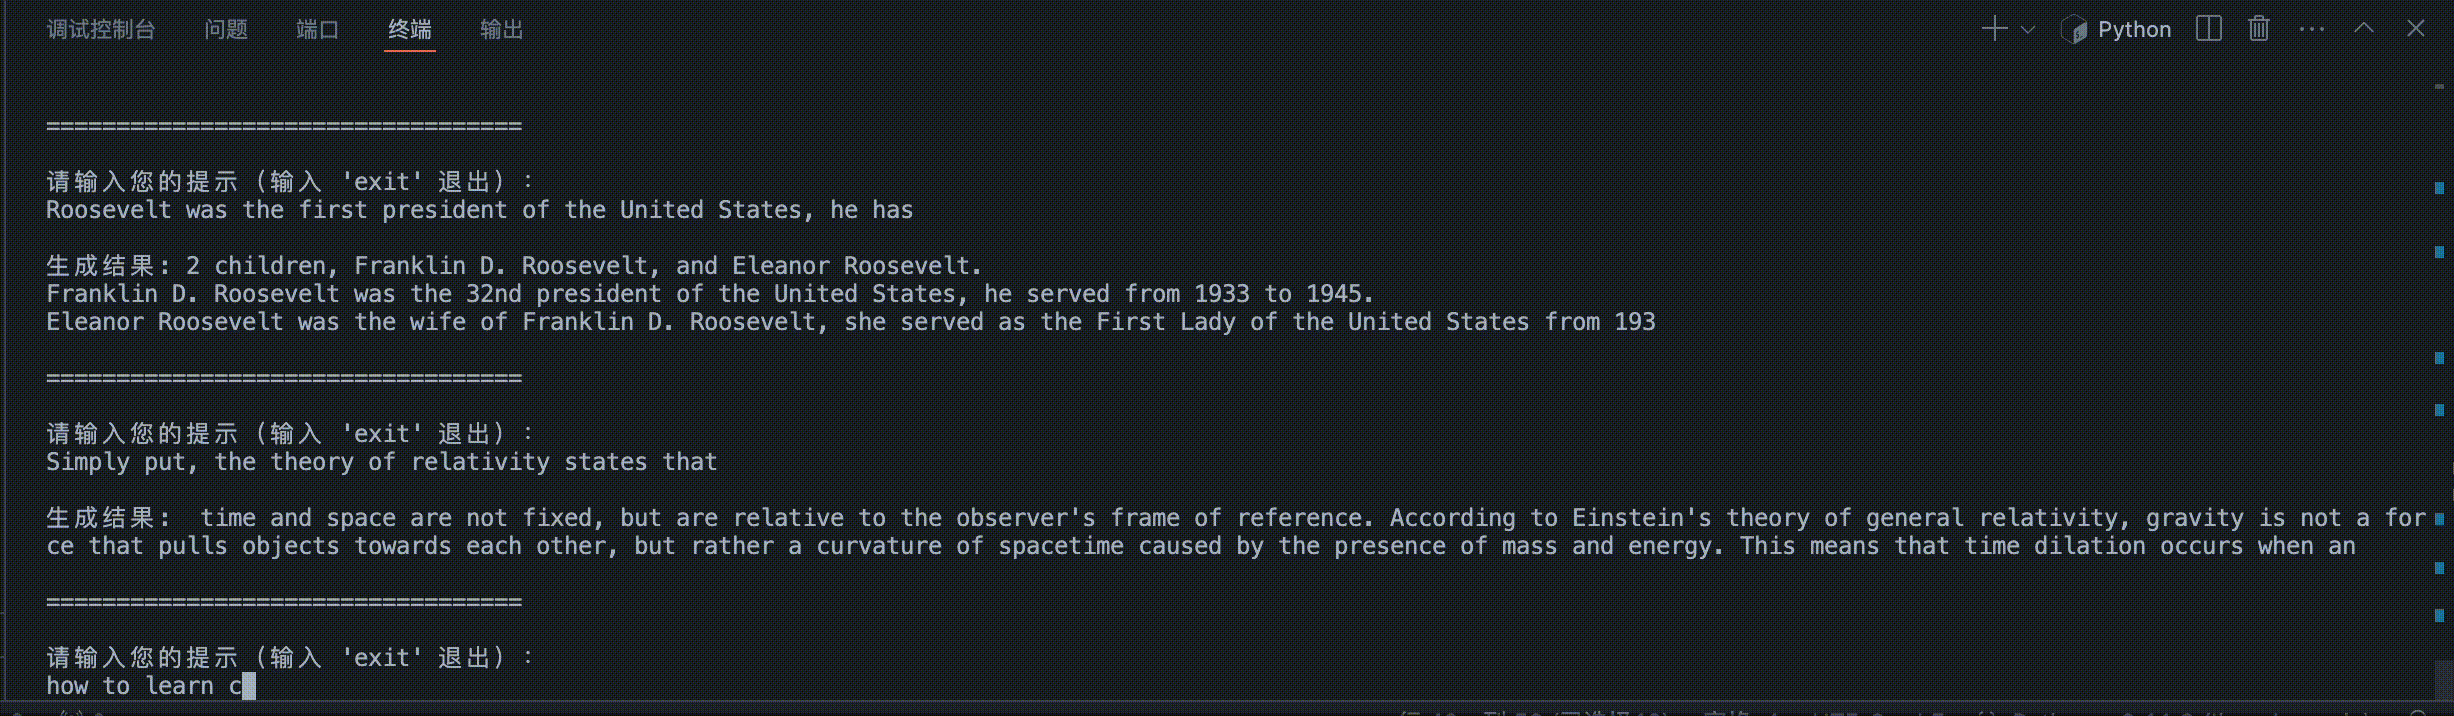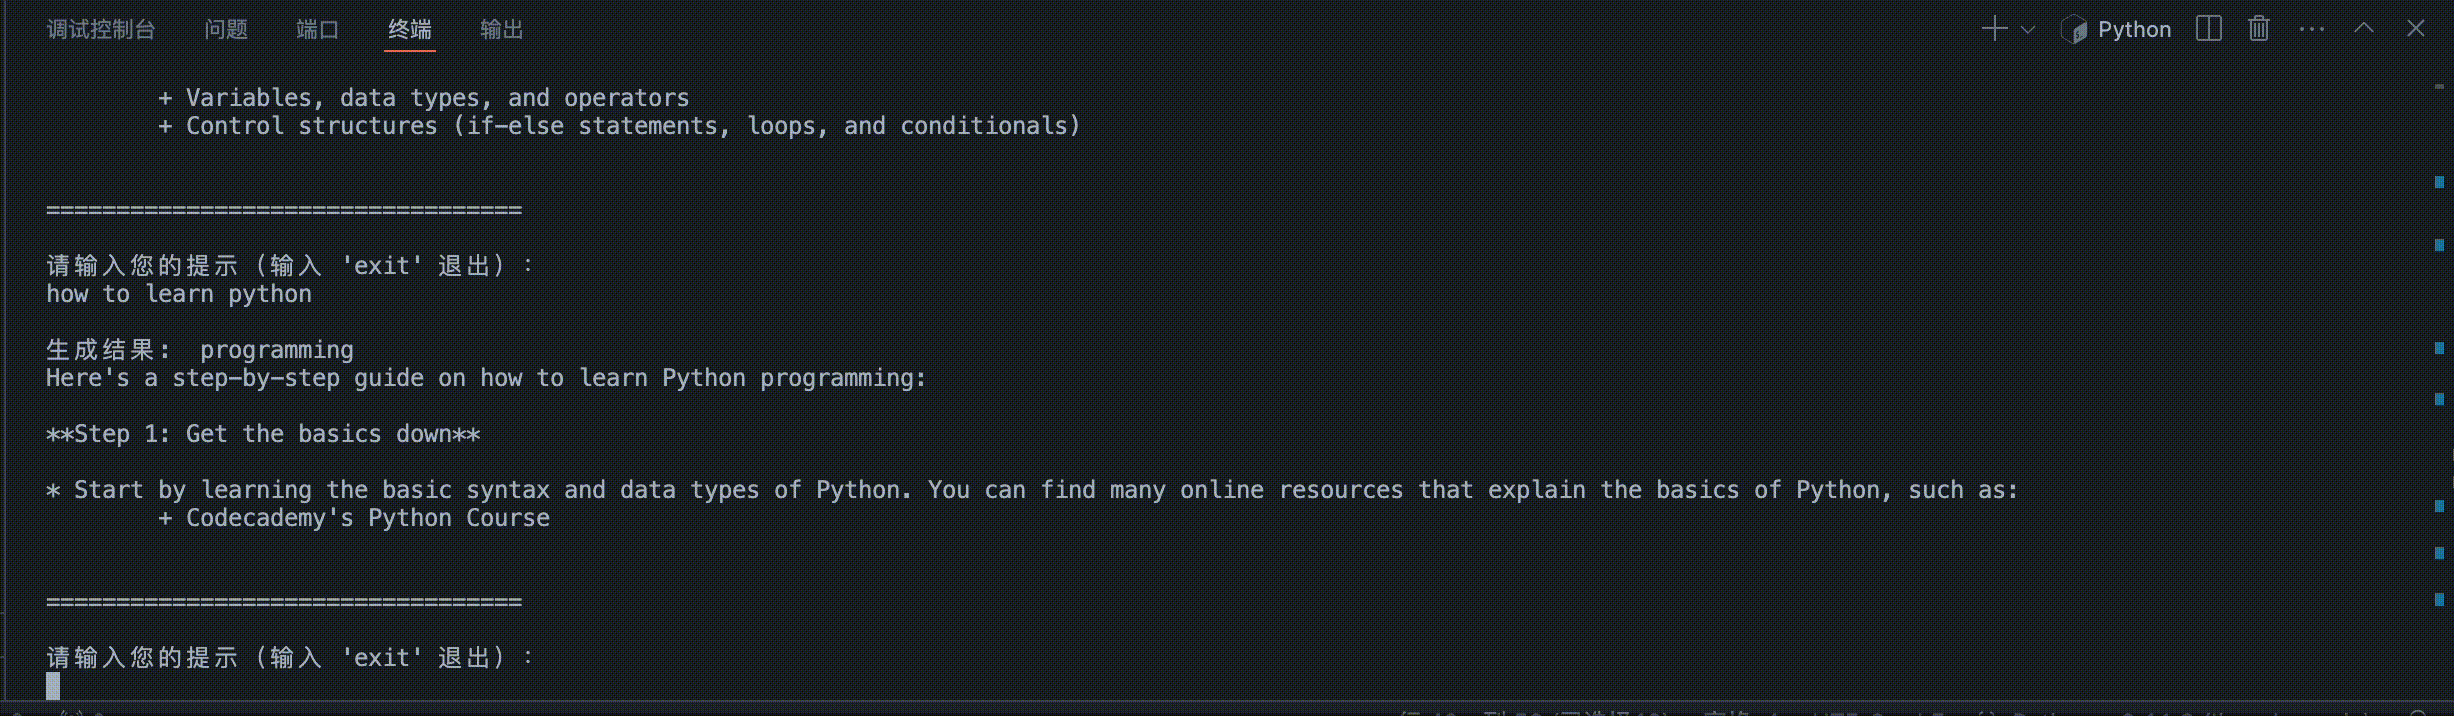
Qwen2.5-3B 模型(社区版本)流式输出结果测试:
Llava1.5-7b-hf 模型流式输出结果测试:
 |
 |
感兴趣的同学可以扫码联系课程购买,这个课程是我和《自制深度学习推理框架》作者一起合力打造的,内容也会持续更新优化。

前言
本项目最初是当作 cv 算法工程师实习内推表、校招可投递公司汇总以及个人面经的汇总,后面逐步转变为个人 cv 算法工程师成长之路所记录的技术栈笔记、以及少部分面经等内容。
项目部分内容参考自 github 项目/网络博客/书籍和 个人博客 等,由于时间和精力有限,有些知识点还没有没有完成,请见谅。
本项目正逐步废弃,大部分内容不再更新,关于深度学习、大模型推理以及大模型推理框架开发的知识,欢迎移步 dl_note、和 lite_llama 仓库阅读。
GitHub已经支持直接显示latex公式,部分公式如果显示不全,也可在谷歌浏览器安装 MathJax Plugin for Github 插件访问(需要翻墙下载安装),或者下载仓库到本地,使用Typora软件阅读,也可以使用安装了Markdown+Math插件的VSCode软件阅读。
目录
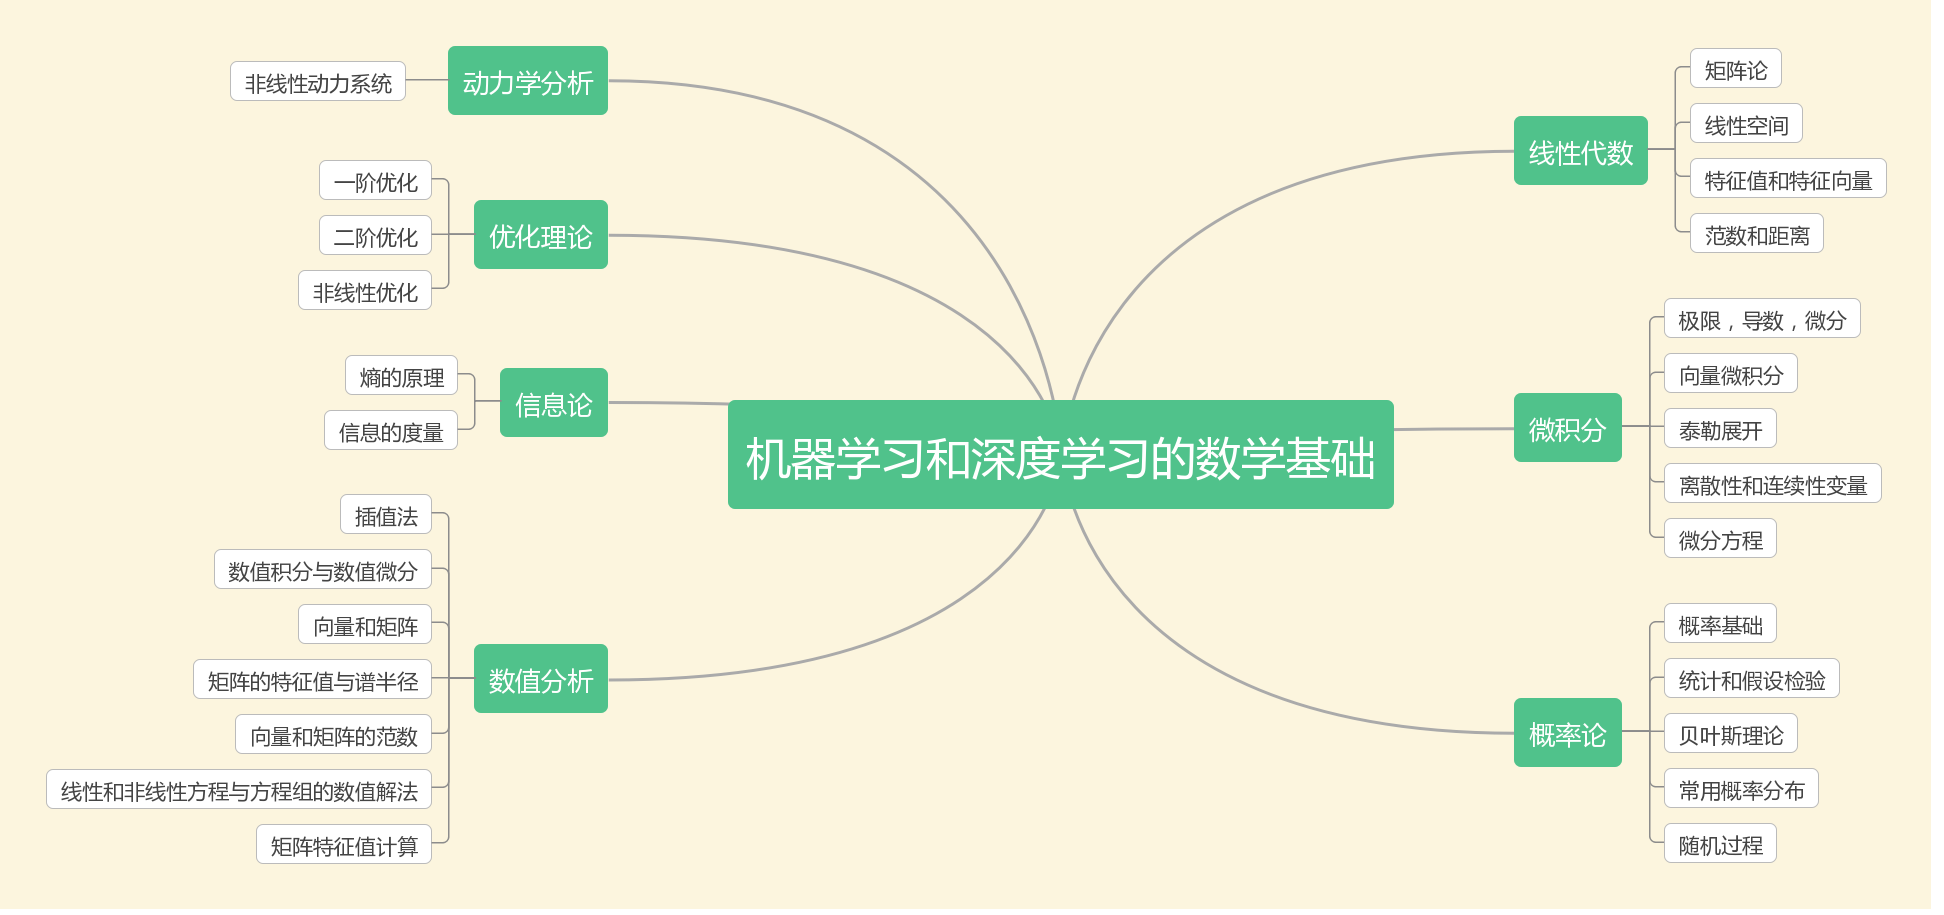
作为一个计算机视觉算法工程师,需要掌握的不仅是计算机编程知识,还需要掌握编程开发、机器学习/深度学习、图像识别/目标检测/语义分割、模型压缩、模型部署等知识点,我整理了一个 技术栈思维导图。
强调一下如何从“零”起步,首先确保基础打好。建议完整修完一门国外经典课程(从课程视频、作业到项目),然后完整阅读一本机器学习或者深度学习教科书,同时熟练掌握一门基本的编程语言以及深度学习框架。(参考 中国人民大学赵鑫:AI 科研入坑指南)
学习路线
算法基础
深度学习基础的和 Python 编程基础知识总结。
可投递公司
鉴于 2019 年写的春招算法实习岗位表绝大部分已经失效,本人也再无精力维护,故将其移除,故不在展示在仓库主页上。
虽然算法工程师可投递的公司是较多的,但是岗位提供的 hc 是不及开发多的,这点需要注意。以下表格侧重于计算机视觉算法和算法优化/部署工程师岗位。
top级公司 | 互联网公司 | AI独角兽公司 | 其他大公司 | |
|---|---|---|---|---|
| 百度 | 美团 | 地平线机器人 | 顺丰科技 | |
| 阿里巴巴 | 滴滴出行 | 图森未来 | 招银网络科技 | |
| 腾讯 | 拼多多/菜鸟网络 | momenta | 平安科技 | |
| 字节跳动 | 京东 | 小马智行 | cvte | |
| 微软 | 网易 | 蔚来汽车 | 海康威视 | |
| 谷歌 | 快手 | 小鹏汽车 | 虹软科技 | |
| 商汤 | 爱奇艺 | 科大讯飞 | 传音手机 | |
| 英伟达 | 小米 | 寒武纪/依图 | 大华 | |
| 博世 | 陌陌 | 旷视 | 荣耀手机 | |
| 大疆无人机 | 美图MTlab | 文远知行 | 联想 | |
| 蚂蚁金服 | 360安全 | 云天励飞 | 汇顶科技 | |
| Intel/亚马逊 | 搜狗 | 摩尔线程 | 美的中央研究院 | |
| 华为 | 猿辅导 | 思必驰 | 锐明技术 | |
| 无 | 新浪/搜狐/金山 | 奥比中光 | 联发科 | |
| 无 | YY/虎牙/BIGO/斗鱼 | 优必选 | 联影医疗 | |
| 无 | oppo/vivo/一加 | 度小满金融 | 戴尔 | |
| 无 | 贝壳找房 | 深睿医疗 | TP-LINK | |
| 无 | 携程/去哪儿/途家 | 镁佳科技 | ZOOM | |
| 无 | 瓜子二手车 | 猎豹移动 | 广联达 | |
| 无 | 作业帮/VIPKID/好未来 | 京东数科 | 深信服 | |
| 无 | 阅文集团/58集团 | 追一科技 | 中国电信云计算 | |
| 无 | B站 | 深兰科技 | 三星电子研究所 | |
| 无 | 小红书/英语流利说 | 明略科技 | 苏宁 | |
| 无 | 趣头条/一点资讯 | 数美科技 | 微众银行 | |
| 无 | 知乎 | 驭势科技 | 中国移动成研院 | |
| 无 | 蘑菇街 | 随手科技 | 远景智能 | |
| 无 | 转转 | 智加科技 | 牧原智能科技 | |
| 无 | 同花顺/老虎证券 | 壁仞科技 | 便利蜂 | |
| 无 | 乐信/有赞 | 趋势科技 | 中兴 | |
| 无 | 金蝶软件(中国) | 云从科技 | 航天二院706所 | |
| 无 | 汽车之家 | 第四范式 | 吉利汽车 | |
| 无 | 珍爱网/酷狗音乐 | 黑芝麻智能 | 碧桂园机器人 | |
| 无 | 巨人网络/盛大游戏 | 格灵深瞳 | 华米/极米 | 无 |
| 无 | 最右/快看漫画 | 码隆科技 | 无 | |
| 无 | 猫眼娱乐/多牛传媒 | 轻舟智航 | 无 | 无 |
我的公众号
更多知识和最新博客,欢迎扫码关注我的公众号-嵌入式视觉,记录 CV 算法工程师成长之路,分享技术总结、读书笔记和个人感悟。

Star History
cv算法工程师成长路线
- 前言
- 一,计算机系统
- 二,编程语言
- 三,数据结构与算法
- 四,机器学习
- 五,深度学习
- 六,计算机视觉
- 七,模型压缩
- 八,高性能计算
- 九,模型部署(算法SDK开发)
- 十,数据分析
- 效率工具
- 业余生活
- 博客阅读后的知识点总结
- 参考资料
文章同步发于 github 仓库 和 csdn 博客,最新版以 github 为主。如果看完文章有所收获,一定要先点赞后收藏。毕竟,赠人玫瑰,手有余香.
本文内容为 cv 算法工程师成长子路上的经典学习教材汇总,对于一些新兴领域则给出了较好的博客文章链接。本文列出的知识点目录是成系统且由浅至深的,可作为 cv 算法工程师的常备学习路线资料。
文章所涉知识点和参考资料内容很多也很广,建议先看目录,心中有个大概知识点结构,后面由浅入深,慢慢学习各个知识点,由浅入深,切忌浮躁。
部分学习资料存在离线 PDF 电子版,其可在 github仓库-cv_books 中下载。如果仓库失效,可以关注我的公众号-嵌入式视觉,后台回复对应关键字下载高清 PDF 电子书。

前言
课程学习方法,三句话总结:
- 看授课视频形成概念,发现个人感兴趣方向。
- 读课程笔记理解细节,夯实工程实现的基础。
- 码课程作业实现算法,积累实验技巧与经验。
再引用一下学习金字塔的图:
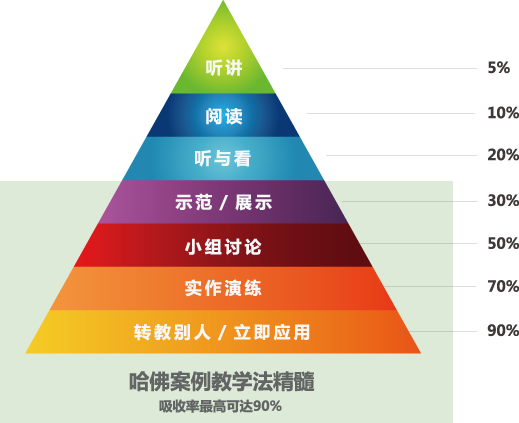
图片来源 github 仓库 DeepLearning Tutorial
关于科研和研发的思考,可参考文章-中国人民大学赵鑫:AI 科研入坑指南。
一,计算机系统
1.1,计算机系统书籍
- 《深入理解计算机系统第三版》: 网上有电子版,
PDF电子书下载方式在文章首页。
1.2,设计模式教程
- 设计模式: 内容很全,存在
C++示例代码。
二,编程语言
2.1,C++ 学习资料
- cpp reference:
C++库接口参考标准文档,官方文档,包含各个函数定义及使用example。 - http://www.cplusplus.com/reference/stl/
- Cpp Primer 学习: 《C++ Primer 中文版(第 5 版)》学习仓库,包括笔记和课后练习答案。
- C++ Tips of the Week: 谷歌出品的
C++编程技巧。
2.2,Python 学习资料
- 《廖雪峰-Python3教程》: 内容很全且通俗易懂,适合初学者,但代码示例不够丰富。描述的知识点有:Python 基础、函数、高级特性、函数式编程、模块、面向对象编程、面向对象高级编程、错误、调试和测试、IO 编程、进程和线程、正则表达式、常用内建模块、常用第三方模块、图形界面、网络编程、异步IO 等内容。电子书可在github仓库-cv_books 中下载。
- Python 工匠系列文章: 很适合深入理解 Python 面向对象编程、装饰器、模块、异常处理等内容。
2.3,Linux & Shell 学习
- 《鸟哥的Linux私房菜 基础篇 第四版》: 很经典的教材,虽然内容描述有些啰嗦,但是很多人推荐,应该还是很适合初学者的。存在开源 PDF,也有繁体中文在线网站。
- Linux 工具快速教程: 适合有一定 Linux 基础的同学,全书分为三个部分: 基础篇、进阶篇和工具参考篇。本书我看下来的感觉就是,目录和导航索引做的很好,但是部分知识点的描述很少或者不清晰,更偏向于实例使用教程的感觉,适合当作参考书使用。
三,数据结构与算法
3.1,数据结构与算法课程
- 《图解算法》:存在
PDF电子版,内容较为基础且通俗易懂,适合快速了解数据结构与算法的基础知识,但深度不够,示例代码为Python。 - 专栏-数据结构与算法之美: 学习数据结构与算法的知识点课程,内容全且深度足够。官方例子为
java代码,同时github仓库提供C/C++/GO/Python等代码。
3.2,算法题解
- LABULADONG 的算法网站: 主要传递了刷题的算法思维。
- 《剑指Offer》面试题: Python实现: 题目为《剑指Offer》书籍原题,代码实现为
Python,仓库简洁,阅读体验不错,无任何广告,适合刚学完数据结构与算法基础知识的同学。 - 力扣++-算法图解:
leetcode高频题图解,题解分析很多,部分题目有动画分析,提供Python/Java/C++实现,但也存在部分题解分析废话较多,不够精简的问题。 - 小浩算法: 一部图解算法题典,讲解
105道高频面试算法题目,go代码实现。 - LeetCode题解:
leetcode高频题题解,全书代码默认使用C++11语法编写,题解为文字性描述,题解分析较短且不够通俗易懂。本书的目标读者是准备去硅谷找工作的码农,也适用于在国内找工作的码农,以及刚接触ACM算法竞赛的新手。 - CodeTop 企业题库: 针对企业的刷题题库,但是个人觉得好像也没必要去这样刷。
四,机器学习
4.1,机器学习课程
- 《机器学习》-周志华(西瓜书):存在
PDF电子版,内容很全,很适合打下扎实的基础。 - 《李宏毅-机器学习课程》: 机器学习经典视频教程啊,非常适合初学者观看。
- 李宏毅机器学习笔记(LeeML-Notes): 可以在线阅读,很方便,内容完成度高。
- 《南瓜书PumpkinBook》: 南瓜书,是西瓜书的补充资料,包含了西瓜书的公式的详细推导,建议先看西瓜书,部分公式不会推导的情况下,可以查看南瓜书的对应内容。
- 机器学习数学基础: 黄海广博士翻译的
CS229机器学习课程的线性代数基础材料,英文好的建议看原版。
五,深度学习
想要快速入门神经网络(深度学习)或者重新复习基础的同学,推荐看这个文章合集Neural Networks From Scratch。文章内容由浅入深,既有公式推导,也有对应代码实现。
5.1,深度学习课程
- 《深度学习》(花书),存在英文和中文
PDF电子版,内容成系统,覆盖了深度学习的方方面面,强烈建议至少看完跟自己方向相关的章节,有利于打好扎实的基础。 - 《李宏毅-深度学习课程》: 经典视频教程,实例有趣(皮卡丘),内容讲解由浅至深,李宏毅老师个人官网也提供了视频链接、
PPT课件、代码资料。
5.2,深度学习基础文章
5.3,经典CNN分析文章
- 深度可分离卷积(Xception 与 MobileNet 的点滴)
- [[DL-架构-ResNet系] 002 ResNet-v2](https://zhuanlan.zhihu.com/p/29678910 "[DL-架构-ResNet系] 002 ResNet-v2")
- ResNet及其变种的结构梳理、有效性分析与代码解读
1,VGGNet 拥有 5 段 卷积,每一段有 2~3 个卷积层,同时每段尾部会连接一个最大池化层用来缩小图片尺寸,每段内的卷积核数量相同,越靠后的段的卷积核数量越多:64-128-256-512-512。ResNet 网络拥有 4 段卷积, 每段卷积代表一个 残差学习Blocks,根据网络层数的不同, Blocks 的单元数量不同,例如 ResNet18 的 Blocks 单元数量分别为2、2、2 和 2。越靠后的段的卷积核数量越多:64-128-256-512,残差学习Blocks内的卷积核通道数是相同的。
2,ResNet v2 创新点在于通过理论分析和实验证明恒等映射对于残差块的重要性,根据激活函数与相加操作的位置关系,我们称之前的组合方式(ResNet)为“后激活(post-activation)”,现在新的组合方式(ResNet v2)称之为“预激活(pre-activation)”。使用预激活有两个方面的优点:1)f变为恒等映射,使得网络更易于优化;2)使用BN作为预激活可以加强对模型的正则化。
5.4,PyTorch 框架学习文章
- PyTorch中文文档;PyTorch官方教程中文版;PyTorch 官方教程。
- PyTorch_tutorial_0.0.5_余霆嵩: 存在开源
PDF电子版,且提供较为清晰的代码,适合快速入门,教程目录结构清晰明了。
5.5,PyTorch/Caffe 框架分析文章
- pytorch自定义层如何实现?超简单!
- 【PyTorch】torch.nn.Module 源码分析
- 详解Pytorch中的网络构造,模型save和load,.pth权重文件解析
- 半小时学会 PyTorch Hook
- 详解Pytorch中的网络构造
- 深度学习与Pytorch入门实战(九)卷积神经网络&Batch Norm
- Pytorch 里 nn.AdaptiveAvgPool2d(output_size) 原理是什么?
- caffe源码解析-开篇
- 《Caffe官方教程中译本》:存在开源
PDF电子版。
六,计算机视觉
6.1,数字图像处理教程
- 《数字图像处理第四版》:存在开源
PDF电子版。成系统的介绍了数字图像的原理及应用,内容多且全、深度也足够,非常适合深入理解数学图像原理,可挑重点看。 - 桔子code-OpenCV-Python教程
6.2,计算机视觉基础课程
- 《CS231 课程》-李飞飞。b 站视频教程;CS231n官方笔记授权翻译总集。课程非常经典,内容深入浅出,每节课都有课后作业和对应学习笔记。
- 《动手学深度学习》-李沐,存在开源
PDF电子书,官方代码为MXNet框架实现,github上有开源的《动⼿手学深度学习 PYTORCH 版》。 - 《解析卷积神经网络-深度学习实践手册》-魏秀参:对
CNN对基础部件做了深入描述,本书内容全且成系统,适合想深入学习CNN的同学,唯一的缺点没有项目案例以供实践。本书提供开源PDF电子版。
6.3,深度学习模型和资源库
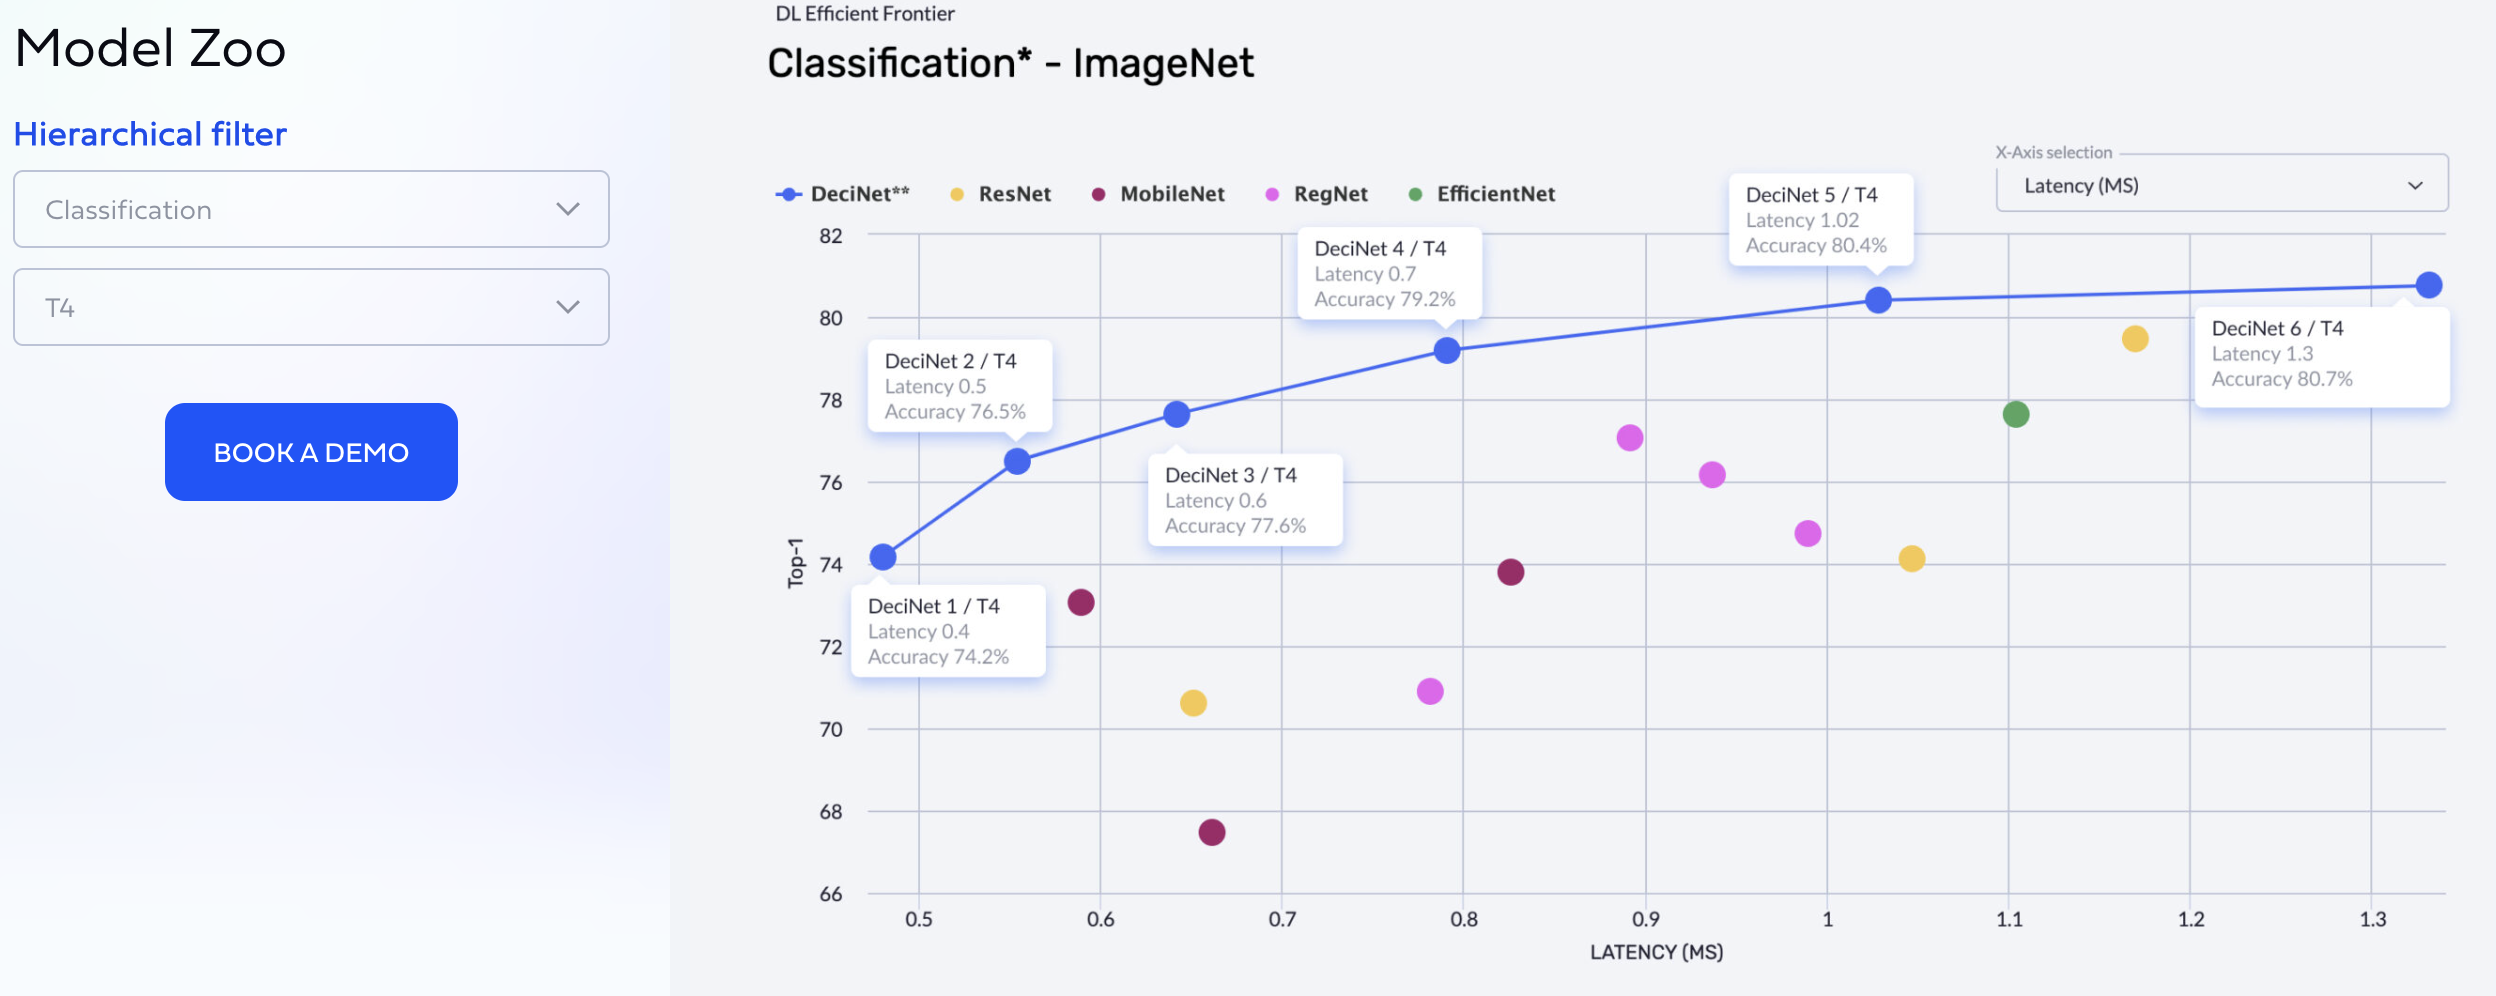
1.Papers with code是由Meta AI Research团队主导的一个开放资源的社区,汇集了深度学习论文、数据集、算法代码、模型以及评估表。 2.Jetson Zoo,是一个开源目录,其中包含在NVIDIA Jetson硬件平台上开发指南以及参考案例分享汇总。模型库资源里包括图像分类、目标检测、语义分割和姿势估计等方向的实践分享,提供开源代码和开发指南文章的链接。 3.Model Zoo包含了机器学习各领域的算法框架及预训练模型资源汇总,其中包括TensorFlow、PyTorch、Keras、Caffe等框架,作者是Jing Yu Koh构建。 4. MediaPipe 是一个为直播和流媒体提供跨平台、可定制的机器学习解决方案的框架。MediaPipe 提供了包括人脸检测、人脸网格、虹膜识别、手部关键点检测、人体姿态估计、人体+人脸+手部组合整体、头发分割、目标检测、Box 跟踪、即时运动追踪、3D 目标检测等解决方案。 5.Deci旨在使用AI构建更好的AI,使深度学习能够发挥其真正的潜力。借助该公司的端到端深度学习加速平台,人工智能开发人员可以为任何环境(包括云、边缘或移动)构建、优化和部署更快、更准确的模型。借助Deci的平台,开发人员可以在任何硬件上将深度学习模型推理性能提高3到15倍,同时仍然保持准确性。平台除了能够显示每个模型的准确性之外,还可以轻松选择目标推理硬件并查看模型的运行时性能结果,例如各种硬件的吞吐量、延迟、模型大小和内存占用。但是模型加速模块的demo是需要注册账户和购买的。
6.4,目标检测网络文章
- 一文读懂Faster RCNN
- 从编程实现角度学习Faster R-CNN(附极简实现)
- Mask RCNN学习笔记
- Mask RCNN 源代码解析 (1) - 整体思路
- 物体检测之Focal Loss及RetinaNet
- CVPR18 Detection文章选介(下)
- 2020首届海洋目标智能感知国际挑战赛 冠军方案分享
- 目标检测中的样本不平衡处理方法——OHEM, Focal Loss, GHM, PISA
6.5,语义分割文章
6.6,3D 视觉技术文章
6.7,深度学习的评价指标文章
- ROC和AUC介绍以及如何计算AUC
- COCO目标检测测评指标
- 如何评测AI系统?
- PLASTER:一个与深度学习性能有关的框架
- The Correct Way to Measure Inference Time of Deep Neural Networks
七,模型压缩
模型压缩与模型推理系统的知识,推荐看微软的《人工智能系统》教程资料,写的很全且容易理解,个人觉得是个非常不错的教程。
7.1,轻量级网络设计
网络结构碎片化更多是指网络中的多路径连接,类似于short-cut,bottle neck等不同层特征融合,还有如FPN等结构。拖慢并行的一个很主要因素是,运算快的模块总是要等待运算慢的模块执行完毕。
- ShuffleNet V2: Practical Guidelines for Efficient CNN Architecture Design
- ShufflenetV2_高效网络的4条实用准则
- 轻量级神经网络:ShuffleNetV2解读
7.2,模型压缩文章
- 解读模型压缩3:高效模型设计的自动机器学习流水线
- Deep compression: Compressing deep neural networks with pruning, trained quantization and huffman coding
- 韩松Deep compression论文讲解——PPT加说明文字
- 论文总结 - 模型剪枝 Model Pruning
- 编译器与IR的思考: LLVM IR,SPIR-V到MLIR
7.3,神经网络量化文章
1,量化是指用于执行计算并以低于浮点精度的位宽存储张量的技术,或者说量化就是将神经网络的浮点算法转换为定点。 量化模型对张量使用整数而不是浮点值执行部分或全部运算。
2,量化简单来说就是将浮点存储(运算)转换为整型存储(运算)的一种模型压缩技术。
3,虽然精心设计的MobileNet能在保持较小的体积时仍然具有与GoogleNet相当的准确度,不同大小的MobileNet本身就表明——也许一个好的模型设计可以改进准确度,但同类模型中仍然是更大的网络,更好的效果!
4,权重值域调整是另一个机器学习过程,学习的目标是一对能在量化后更准确地运行网络的超参数 min/max。
7.4,推理框架剖析文章
- 优化 TensorFlow Lite 推理运行环境内存占用
- ncnn源码解析(五):执行器Extractor
- 动手编写深度学习推理框架 Planer: 自制深度学习推理框架
demo实战。
八,高性能计算
8.1,CPU/GPU/AI 芯片科普
- 一文读懂 GPU 的发展历程
- CPU、GPU、NPU等芯片架构、特点研究
- 什么是异构并行计算?CPU与GPU的区别是什么?
- 看懂芯片原来这么简单(二):AI为什么聪明?什么是华为自研架构NPU?
- 【专利解密】如何提高AI资源利用率? 华为卷积运算芯片
- 嵌入式系统 内存模块设计
8.2,指令集(ISA)学习资料
Neon是ARM平台的向量化计算指令集,通过一条指令完成多个数据的运算达到加速的目的,或者说Neon是 ARM 平台的SIMD(Single Instruction Multiple Data,单指令多数据流)指令集实现。常用于AI、多媒体等计算密集型任务。
8.3,矩阵乘优化文章
- 移动端arm cpu优化学习笔记----一步步优化盒子滤波(Box Filter)
- OpenBLAS gemm从零入门
- 通用矩阵乘(GEMM)优化算法
- 卷积神经网络中的Winograd快速卷积算法
- 知乎专栏-深入浅出GPU优化
- CUDA GEMM 理论性能分析与 kernel 优化
- OpenPPL 中的卷积优化技巧:概述总结类文章,无代码,非专注时刻也能阅读。
- 【张先轶】BLISlab学习优化矩阵乘。第一课
- 矩阵乘法与 SIMD
Winograd 是一种快速卷积算法,适用于小卷积核,可以减少浮点乘法的次数。九,模型部署(算法SDK开发)
9.1,模型部署文章
- 海思AI芯片(Hi3519A/3559A)方案学习(二十五)初识 mapper_quant 和mapper_param
- 部署PyTorch模型到终端
- 多场景适配,TNN如何优化模型部署的存储与计算
- 模型转换、模型压缩、模型加速工具汇总
- 深度学习模型转换与部署那些事(含ONNX格式详细分析)
- ONNX初探
十,数据分析
- python-numpy-pandas-matplotlib-Cheatsheets: 编程备忘录,图片很好看,适合有一定基础的编程者总结回顾常用操作。
- Distill: 机器学习研究 应该清晰、动态和生动。
pandas
- 10 minutes to pandas.: 官方User Guide,10 分钟快速入门 pandas。
- 《利用Python进行数据分析 第二版 A5》:国外很经典的python数据分析教程,内容比较通俗易懂,网上有 PDF 电子版。
- 《Joyful Pandas》:国内教程,github 开源资料。
matplotlib
- Python绘图库Matplotlib入门教程: 中文版Matplotlib入门教程,文章较为容易理解,但深度和细节不够无法建立Matplotlib绘图的系统思维 ,适合快速阅览。
- matplotlib-tutorial: 初学者的 Matplotlib 教程,github stars 数高达 2.6k+。
- Matplotlib中文教程: Datawhale 数据可视化小组的一个开源项目,系统梳理了 matplotlib 的绘图接口,github stars 数高达 377。
还没来得及细看,后续看完更新阅读感受。
效率工具
外面的世界
- 还算不错的使用谷歌搜索工具: 非常稳定和快速的
IPLC工具("International Private Leased Circuit" 的缩写,即“国际私用出租线路”)。我已经稳定使用 2 年多了,可以考虑使用我的邀请码注册(VDHtU3A7),点击链接直接注册。
想要技术学的更好,会使用github、stack overflow等网站是基础技能。
快捷导航
- Quick Reference: 一些由开源天使贡献的代码备忘录和快速参考。
- Qwerty Learner: 适合用键盘学习单词的网站
- GitHub Readme Stats: 在你的 README 中获取动态生成的 GitHub 统计信息!
markdown/latex 写作
- markdown语法大全: 这篇文章对
markdown语法整理得很好,文章排版也做的好,读完很容易就掌握markdown语法。 - 通用 LaTeX 数学公式语法手册: 文章排版很好,目录结构清晰明了,阅读起来很舒服,推荐用来学习
latex语法内容。 - https://latex.codecogs.com/eqneditor/editor.php: 在线
latex语法。
业余生活
博客阅读后的知识点总结
1,为了尽可能地提高 MAC阵列 的利用率以及卷积运算效率,阵列控制模块会根据第一卷积参数矩阵的行数和第一卷积数据阵列的行数来确定第一乘法累加窗口的列数。
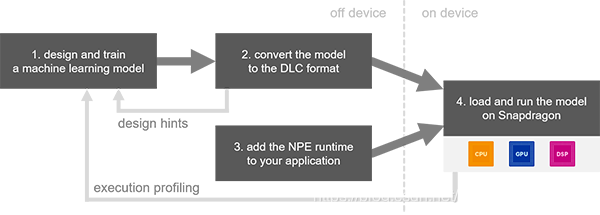
2,SNPE 开发流程:
3,目标检测模型效果提升方法:
- 以
Cascade RCNN作为baseline,以Res2Net101作为Backbone; Albumentation库做数据集增强-用在模型训练中;- 多尺度训练(
MSTMulti-scale training/testing)的升级版-SNIP方法(Scale Normalization for Image Pyramids),用在baseline模型训练和测试中:解决模板大小尺度不一的问题; DCN可变性卷积网络-用在baseline模型的backone中;soft-NMS:解决目标互相重叠的问题;HTC模型预训练,Adam优化算法可以较好的适应陌生数据集,学习率热身(warm-up)来稳定训练过程。
4,SNIP 论文解读:
SNIP 非常 solid 地证明了就算是数据相对充足的情况下,CNN 仍然很难使用所有 scale 的物体。个人猜测是由于 CNN 中没有对于 scale invariant 的结构,CNN 能检测不同 scale 的“假象”,更多是通过CNN 来通过 capacity 来强行 memorize 不同 scale 的物体来达到的,这其实浪费了大量的 capacity,而 SNIP 这样只学习同样的 scale 可以保障有限的 capacity 用于学习语义信息。论文的关键贡献:发现现在的 CNN 网络无法很好的解决 scale invariance 的问题,提出了一个治标不治本的方法。
5,高效模型设计(模型压缩)方法:
一般而言,高效模型的设计有 6 大基本思路:1)轻量级架构、2)模型裁剪、3)AutoML 和 NAS 模型搜索、4)低精度量化、5)知识蒸馏、6)高效实现。
来源旷世学术分享-张祥雨:高效轻量级深度模型的研究和实践。
6,网络深度与宽度的理解及意义
更多理解参考知乎网络宽度对深度学习模型性能有什么影响?
在一定的程度上,网络越深越宽,性能越好。宽度,即通道(channel)的数量,网络深度,及 layer 的层数,如 resnet18 有 18 层网络。注意我们这里说的和宽度学习一类的模型没有关系,而是特指深度卷积神经网络的(通道)宽度。
网络深度的意义:CNN 的网络层能够对输入图像数据进行逐层抽象,比如第一层学习到了图像边缘特征,第二层学习到了简单形状特征,第三层学习到了目标形状的特征,网络深度增加也提高了模型的抽象能力。网络宽度的意义:网络的宽度(通道数)代表了滤波器(3维)的数量,滤波器越多,对目标特征的提取能力越强,即让每一层网络学习到更加丰富的特征,比如不同方向、不同频率的纹理特征等。
7,所有 Inception 模型都具有一个重要的性质——都是遵循 拆分-变换-合并(split-transform-merge) 的设计策略。
8,对于某种指令,延迟 latency 主要关注单条该指令的最小执行时间,吞吐量 throughout 主要关注单位时间内系统(一个CPU核)最多执行多少条该指令。因为 AI 计算的数据量比较大,所以更关注吞吐量。
9,CPU 高性能通用优化方法包括:
- 编译选项优化
- 内存性能和耗电优化:内存复用原则,小块快跑是内存设计的重要原则。
- 循环展开:循环的每次迭代都有一定的性能损失(分支指令)。但是现代 ARM 处理器具有分支预测的能力,它可以在执行条件之前预测是否将进入分支,从而降低性能损耗,这种情况下全部循环展开的的优势就减弱了。
- 并行优化和流水线重排:并行优化分为多线程核与核之间数据处理,以及单核心内部并行处理。从本质上讲,流水线重排也是一种并行优化。
10,卷积性能优化方式:卷积的计算方式有很多种,通用矩阵运算(GEMM)方式有良好的通用性,但是仅使用 GEMM 无法实现性能最优。除 GEMM 外,常用的优化方法还包括滑窗(Sliding Window)、快速傅里叶变换(Fast Fourier Transform, FFT)、Winograd 等。不同的方法适合不同的输入输出场景,最佳的办法就是对算子加入逻辑判断,将不同大小的输入分别导向不同的计算方法,以最合适的方法进行卷积计算。
- 大多数情况下,使用滑窗方法的计算性能还是无法和
GEMM方法比较,但是一般当输入小于 $32\times 32$ 时,可以考虑采用滑窗的优化方式。 Winograd是存在已久的性能优化算法,在大多数场景中,Winograd算法都显示了较大的优势,其用更多的加法运算代替部分乘法运算,因为乘法运算耗时远高于加法运算。Winograd适用于乘法计算消耗的时钟周期数大于加法运算消耗的时钟周期数的场景,且常用于 $3\times 3$ 卷积计算中。对于CPU,一般来说,一次乘法计算消耗的时间是一次加法计算消耗时间的6倍。FFT方法不适合卷积核较小的CNN模型。
11,下图展示了如何在英伟达 GPU 架构发展史以及单块 GPU 上纵向扩展以满足深度学习的需求(截止2020年)。

12,Deep compression 论文阅读总结
deep compression是解决存储问题,对于速度问题几乎没获得改善;- 权值剪枝还得看另外一篇论文:learning both weights and connection for efficient neural network
- CNN 模型的存储空间问题,主要还是在全连接层,若要改善
inference速度,需要在卷积层下功夫。
13,Deep Compression 论文介绍的神经网络压缩方法,可分为三步:
- 剪枝:舍弃权重绝对值较小的权重,并将剩余权重以稀疏矩阵表示。
- 量化:将剪枝结果进行进一步量化,具体的是构建一组权值码本,使模型中的权值共享码本中的其中一个权重值,以减少每个权重保存所需的比特数。
- 霍夫曼编码(可选):通过霍夫曼编码,进一步地压缩索引值以及权重数值地存储空间。
参考资料
深度学习基础总结
layout: post title: 深度学习基础总结 date: 2021-10-10 12:00:00 summary: 深度学习基础知识总结。 categories: DeepLearning
- 一,滤波器与卷积核
- 二,卷积层和池化输出大小计算
- 三,深度学习框架的张量形状格式
- 四,Pytorch 、Keras 的池化层函数理解
- 五,Pytorch 和 Keras 的卷积层函数理解
- 六,softmax 回归
- 七,交叉熵损失函数
- 八,感受野理解
- 九,卷积和池化操作的作用
- 十,卷积层与全连接层的区别
- 十一,CNN 权值共享问题
- 十二,CNN 结构特点
- 十三,深度特征的层次性
- 十四,什么样的数据集不适合深度学习
- 十五,什么造成梯度消失问题
- 十六,Overfitting 和 Underfitting 问题
- 十七,L1 和 L2 区别
- 十八,TensorFlow计算图概念
- 十九,BN(批归一化)的作用
- 二十,什么是梯度消失和爆炸
- 二十一,RNN循环神经网络理解
- 二十二,训练过程中模型不收敛,是否说明这个模型无效,导致模型不收敛的原因
- 二十三,VGG 使用 2 个 3\*3 卷积的优势
- 二十四,Relu比Sigmoid效果好在哪里?
- 二十五,神经网络中权值共享的理解
- 二十六,对 fine-tuning(微调模型的理解),为什么要修改最后几层神经网络权值?
- 二十七,什么是 dropout?
- 二十八,HOG 算法原理描述
- 二十九,激活函数
- 三十,卷积层和池化层有什么区别
- 三十一,卷积层和池化层参数量计算
- 三十二,神经网络为什么用交叉熵损失函数
- 三十三,数据增强方法有哪些
- 三十四,ROI Pooling替换为ROI Align的效果,及各自原理
- 三十五,CNN的反向传播算法推导
- 三十六,Focal Loss 公式
- 三十七,快速回答
- 三十八,交叉验证的理解和作用
- 三十九,介绍一下NMS和IOU的原理
- Reference
一,滤波器与卷积核
在只有一个通道的情况下,“卷积核”(“kernel”)就相当于滤波器(“filter”),这两个概念是可以互换的。一个 “Kernel” 更倾向于是 2D 的权重矩阵。而 “filter” 则是指多个 kernel 堆叠的 3D 结构。如果是一个 2D 的 filter,那么两者就是一样的。但是一个3D filter,在大多数深度学习的卷积中,它是包含 kernel 的。每个卷积核都是独一无二的,主要在于强调输入通道的不同方面。
二,卷积层和池化输出大小计算
不管是TensorFlow、Keras、Caffe还是Pytorch,其卷积层和池化层的参数默认值可能有所不同,但是最终的卷积输出大小计算公式是一样的。
2.1,CNN 中术语解释
卷积层主要参数有下面这么几个:
- 卷积核
Kernel大小(在Tensorflow/keras框架中也称为filter); - 填充
Padding; - 滑动步长
Stride; - 输出通道数
Channels。
2.2,卷积输出大小计算(简化型)
1,在 Pytorch 框架中,图片(feature map)经卷积 Conv2D 后输出大小计算公式如下:$\left \lfloor N = \frac{W-F+2P}{S}+1 \right \rfloor$,其中 $\lfloor \rfloor$ 是向下取整符号,用于结果不是整数时进行向下取整(Pytorch 的 Conv2d 卷积函数的默认参数 ceil_mode = False,即默认向下取整, dilation = 1)。
- 输入图片大小
W×W(默认输入尺寸为正方形) Filter大小F×F- 步长
S - padding的像素数
P - 输出特征图大小
N×N
2,特征图经反卷积(也叫转置卷积) keras-Conv2DTranspose(pytorch-ConvTranspose2d) 后得到的特征图大小计算方式:$out = (in - 1)s -2p + k$,另外还有一个写法:$W = (N - 1)*S - 2P + F$,这可由卷积输出大小计算公式反推得到。$in$ 是输入大小, $k$ 是卷积核大小,$s$ 是滑动步长, padding 的像素数 $p$,$out$ 是输出大小。
反卷积也称为转置卷积,一般主要用来还原 feature map 的尺寸大小,在 cnn 可视化,fcn 中达到 pixel classification,以及 gan 中从特征生成图像都需要用到反卷积的操作。反卷积输出结果计算实例。例如,输入:2x2, 卷积核大小:4x4, 滑动步长:3,填充像素为 0, 输出:7x7 ,其计算过程就是, (2 - 1) * 3 + 4 = 7。
3,池化层如果设置为不填充像素(对于 Pytorch,设置参数padding = 0,对于 Keras/TensorFlow,设置参数padding="valid"),池化得到的特征图大小计算方式: $N=(W-F)/S+1$,这里公式表示的是除法结果向下取整再加 1。
总结:对于Pytorch 和 tensorflow 的卷积和池化函数,卷积函数 padding 参数值默认为 0/"valid"(即不填充),但在实际设计的卷积神经网络中,卷积层一般会填充像素(same),池化层一般不填充像素(valid),输出 shape 计算是向下取整。注意:当 stride为 1 的时候,kernel为 3、padding为 1 或者 kernel为 5、padding为 2,这两种情况可直接得出卷积前后特征图尺寸不变。
注意不同的深度学习框架,卷积/池化函数的输出 shape 计算会有和上述公式有所不同,我给出的公式是简化版,适合面试题计算,实际框架的计算比这复杂,因为参数更多。
2.3,理解边界效应与填充 padding
如果希望输出特征图的空间维度Keras/TensorFlow 设置卷积层的过程中可以设置 padding 参数值为 “valid” 或 “same”。“valid” 代表只进行有效的卷积,对边界数据不处理。“same” 代表 TensorFlow 会自动对原图像进行补零(表示卷积核可以停留在图像边缘),也就是自动设置 padding 值让输出与输入形状相同。
参考资料
三,深度学习框架的张量形状格式
- 图像张量的形状有两种约定,通道在前(
channel-first)和通道在后(channel-last)的约定,常用深度学习框架使用的数据张量形状总结如下:
+ `Pytorch/Caffe`: (`N, C, H, W`);
+ `TensorFlow/Keras`: (`N, H, W, C`)。- 举例理解就是
Pytorch的卷积层和池化层的输入shape格式为(N, C, H, W),Keras的卷积层和池化层的输入shape格式为(N, H, W, C)。
值得注意的是 OpenCV 读取图像后返回的矩阵 shape 的格式是 (H, W, C)格式。当 OpenCV 读取的图像为彩色图像时,返回的多通道的 BGR 格式的矩阵(HWC),在内存中的存储如下图:

四,Pytorch 、Keras 的池化层函数理解
注意:对于Pytorch、Keras的卷积层和池化层函数,其padding参数值都默认为不填充像素,默认值为0和valid。
4.1,torch.nn.MaxPool2d
class torch.nn.MaxPool2d(kernel_size, stride=None, padding=0, dilation=1, return_indices=False, ceil_mode=False)二维池化层,默认输入的尺度是(N, C_in,H,W),输出尺度(N,C_out,H_out,W_out)。池化层输出尺度的 Width 默认计算公式如下(ceil_mode= True 时是向上取整,Height 计算同理):
$$\left\lfloor \frac{W_{in} + 2 * \text{padding}[0] - \text{dilation}[0] \times (\text{kernel\_size}[0] - 1) - 1}{\text{stride[0]}} + 1 \right\rfloor$$
主要参数解释:
kernel_size(int or tuple):max pooling的窗口大小。stride(int or tuple,optional):max pooling的窗口移动的步长。默认值是kernel_size`。padding(int or tuple,optional):默认值为0,即不填充像素。输入的每一条边补充0的层数。dilation:滑动窗中各元素之间的距离。ceil_mode:默认值为False,即上述公式默认向下取整,如果设为True,计算输出信号大小的时候,公式会使用向上取整。
Pytorch中池化层默认ceil mode = false,而Caffe只实现了ceil mode= true的计算方式。
示例代码:
import torch
import torch.nn as nn
import torch.autograd as autograd
# 大小为3,步幅为2的正方形窗口池
m = nn.MaxPool2d(kernel_size=3, stride=2, padding=1)
# pool of non-square window
input = autograd.Variable(torch.randn(20, 16, 50, 32))
output = m(input)
print(output.shape)  # torch.Size([20, 16, 25, 16])
4.2,keras.layers.MaxPooling2D
keras.layers.MaxPooling2D(pool_size=(2, 2), strides=None, padding='valid', data_format=None)对于 2D 空间数据的最大池化。默认输入尺寸是 (batch_size, rows, cols, channels)/(N, H, W, C_in) 的 4D 张量,默认输出尺寸是 (batch_size, pooled_rows, pooled_cols, channels) 的 4D 张量。
padding = valid:池化层输出的特征图大小为:$N=(W-F)/S+1$,这里表示的是向下取整再加 1。padding = same: 池化层输出的特征图大小为 $N = W/S$,这里表示向上取整。
主要参数解释:
pool_size: 整数,或者2个整数表示的元组, 沿(垂直,水平)方向缩小比例的因数。(2,2)会把输入张量的两个维度都缩小一半。 如果只使用一个整数,那么两个维度都会使用同样的窗口长度。strides: 整数,2个整数表示的元组,或者是None。 表示步长值。 如果是None,那么默认值是pool_size。padding:"valid"或者"same"(区分大小写)。data_format: 字符串,channels_last(默认)或channels_first之一。 表示输入各维度的顺序。channels_last代表尺寸是(batch, height, width, channels)的输入张量, 而channels_first代表尺寸是(batch, channels, height, width)的输入张量。 默认值根据Keras配置文件~/.keras/keras.json中的image_data_format值来设置。如果还没有设置过,那么默认值就是"channels_last"。
五,Pytorch 和 Keras 的卷积层函数理解
5.1,torch.nn.Conv2d
注意,2D 卷积的卷积核权重是一个 4D 张量,包含输出通道,输入通道,高,宽。对于 Pytorch/Caffe 深度学习框架,其输入输出数据的尺寸都是 ((N, C, H, W)),卷积核权重 shape 如下:
- 常规卷积的卷积核权重
shape:(C_out, C_in, kernel_height, kernel_width) - 分组卷积的卷积核权重
shape:(C_out, C_in/g, kernel_height, kernel_width) DW卷积的卷积核权重shape:(C_in, 1, kernel_height, kernel_width)
Pytorch 框架中对应的 2D 卷积层 api 如下:
class torch.nn.Conv2d(in_channels, out_channels, kernel_size, stride=1, padding=0, dilation=1, groups=1, bias=True)二维卷积层, 输入的尺度是(N, C_in, H, W),输出尺度(N,C_out,H_out,W_out)。卷积层输出尺度的 Weight 计算公式如下(Height 同理):
$$\left\lfloor \frac{W_{in} + 2 \times \text{padding}[0] - \text{dilation}[0] \times (\text{kernel\_size}[0] - 1) - 1}{\text{stride}[0]} + 1\right\rfloor$$
kernel_size, stride, padding, dilation 参数可以是以下两种形式( Maxpool2D 也一样):
a single int:同样的参数值被应用与height和width两个维度。a tuple of two ints:第一个int值应用于height维度,第二个int值应用于width维度,也就是说卷积输出后的height和width值是不同的,要分别计算。
主要参数解释:
in_channels(int) – 输入信号的通道。out_channels(int) – 卷积产生的通道。kerner_size(int or tuple) - 卷积核的尺寸。stride(int or tuple,optional) - 卷积步长,默认值为1。padding(int or tuple,optional) - 输入的每一条边补充0的层数,默认不填充。dilation(int or tuple,optional) – 卷积核元素之间的间距,默认取值1。groups(int,optional) – 从输入通道到输出通道的阻塞连接数。bias(bool,optional) - 如果bias=True,添加偏置。
示例代码:
###### Pytorch卷积层输出大小验证
import torch
import torch.nn as nn
import torch.autograd as autograd
# With square kernels and equal stride
# output_shape: height = (50-3)/2+1 = 24.5,卷积向下取整,所以 height=24.
m = nn.Conv2d(16, 33, 3, stride=2)
# # non-square kernels and unequal stride and with padding
# m = nn.Conv2d(16, 33, (3, 5), stride=(2, 1), padding=(4, 2))  # 输出shape: torch.Size([20, 33, 28, 100])
# # non-square kernels and unequal stride and with padding and dilation
# m = nn.Conv2d(16, 33, (3, 5), stride=(2, 1), padding=(4, 2), dilation=(3, 1))  # 输出shape: torch.Size([20, 33, 26, 100])
input = autograd.Variable(torch.randn(20, 16, 50, 100))
output = m(input)

print(output.shape)  # 输出shape: torch.Size([20, 16, 24, 49])
5.2,keras.layers.Conv2D
keras.layers.Conv2D(filters, kernel_size, strides=(1, 1), padding='valid', data_format=None, dilation_rate=(1, 1), activation=None, use_bias=True, kernel_initializer='glorot_uniform', bias_initializer='zeros', kernel_regularizer=None, bias_regularizer=None, activity_regularizer=None, kernel_constraint=None, bias_constraint=None)2D 卷积层 (例如对图像的空间卷积)。输入输出尺寸格式要求和池化层函数一样。输入尺寸:(N, H, W, C),卷积核尺寸:(K, K, C_in, C_out)。
当使用该层作为模型第一层时,需要提供 input_shape 参数(整数元组,不包含 batch 轴),例如,input_shape=(128, 128, 3) 表示 128x128 的 RGB 图像,在 data_format="channels_last" 时。
主要参数解释:
filters: 整数,输出空间的维度 (即卷积中滤波器的输出数量)。kernel_size: 一个整数,或者2个整数表示的元组或列表,指明2D卷积窗口的宽度和高度。 可以是一个整数,为所有空间维度指定相同的值。strides: 一个整数,或者2个整数表示的元组或列表,指明卷积核模板沿宽度和高度方向的移动步长。 可以是一个整数,为所有空间维度指定相同的值。 指定任何 stride 值 != 1 与指定 dilation_rate 值 != 1 两者不兼容,默认取值 1,即代表会不遗漏的滑过输入图片(Feature Map)的每一个点。padding:"valid"或"same"(大小写敏感),默认valid,这里的"same"代表给边界加上Padding让卷积的输出和输入保持同样("same")的尺寸(即填充像素)。data_format: 字符串,channels_last (默认)或channels_first之一,表示输入中维度的顺序。channels_last对应输入尺寸为(batch_size, height, width, channels), channels_first 对应输入尺寸为(batch_size, channels, height, width)。 它默认为从Keras配置文件~/.keras/keras.json中 找到的image_data_format值。 如果你从未设置它,将使用channels_last。dilation_rate: 一个整数或2个整数的元组或列表, 指定膨胀卷积(空洞卷积dilated convolution)的膨胀率。 可以是一个整数,为所有空间维度指定相同的值。 当前,指定任何 dilation_rate 值 != 1 与 指定 stride 值 != 1 两者不兼容。
5.3,总结
Pytorch 的 Conv2d 函数不要求提供 输入数据的大小 (H,W),但是要提供输入深度,Keras 的 Conv2d 函数第一层要求提供 input_shape 参数 (H,W, C),其他层不需要。
## 六,softmax 回归
分类问题中,直接使用输出层的输出有两个问题:
- 神经网络输出层的输出值的范围不确定,我们难以直观上判断这些值的意义
- 由于真实标签是离散值,这些离散值与不确定范围的输出值之间的误差难以衡量
softmax 回归解决了以上两个问题,它将输出值变换为值为正且和为 1 的概率分布,公式如下:
$$
softmax(y)_{i} = y_{i}^{'} = \frac{e^{yi}}{\sum_{j=1}^{n}e^{yj}}
$$
七,交叉熵损失函数
交叉熵刻画了两个概率分布之间的距离,它是分类问题中使用比较广泛的一种损失函数,交叉熵一般会与 softmax 回归一起使用,公式如下:
$$L = -\sum_{c=1}^{M}y_{c}log(p_{c})或者H(p,q)=-\sum p(x)logq(x)$$
- $p$ ——代表正确答案;
- $q$ ——代表预测值;
- $M$ ——类别的数量;
- $y_{c}$ ——指示变量(
0或1),如果该类别和样本的类别相同就是1,否则是0; - $p_{c}$ ——对于观测样本属于类别 $c$ 的预测概率。
7.1,为什么交叉熵可以用作代价函数
从数学上来理解就是,为了让学到的模型分布更接近真实数据的分布,我们需要最小化模型数据分布与训练数据之间的 KL 散度,而因为训练数据的分布是固定的,因此最小化 KL 散度等价于最小化交叉熵,而且交叉熵计算更简单,所以机器/深度学习中常用交叉熵 cross-entroy 作为分类问题的损失函数。
7.2,优化算法理解
Adam、AdaGrad、RMSProp优化算法具有自适应性。
八,感受野理解
感受野理解(Receptive Field)是指后一层神经元在前一层神经元的感受空间,也可以定义为卷积神经网络中每层的特征图(Feature Map)上的像素点在原始图像中映射的区域大小,即如下图所示:
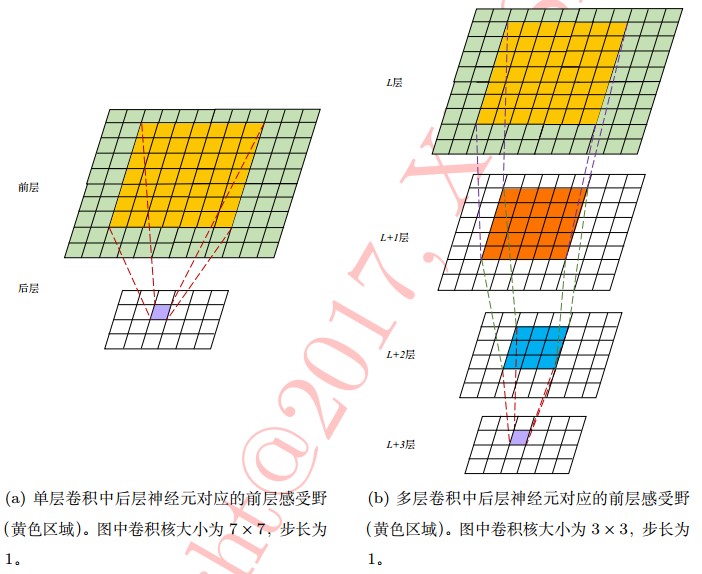
注意:感受野在 CNN 中是呈指数级增加的。小卷积核(如 3*3)通过多层叠加可取得与大卷积核(如 7*7)同等规模的感受野,此外采用小卷积核有两个优势:
- 小卷积核需多层叠加,加深了网络深度进而增强了网络容量(
model capacity)和复杂度(model complexity)。 - 增强了网络容量的同时减少了参数个数。
8.1,感受野大小计算
计算感受野时,我们需要知道:
参考 感受野(receptive file)计算
- 第一层卷积层的输出特征图像素的感受野的大小等于滤波器的大小;
- 深层卷积层的感受野大小和它之前所有层的滤波器大小和步长有关系;
- 计算感受野大小时,忽略了图像边缘的影响。
感受野的计算方式有两种:自底向上和自顶向下(top to down),这里只讲解后者。正常卷积(且不带 padding)感受野计算公式如下:
$$F(i, j-1) = (F(i, j)-1)*stride + kernel\_size$$
其中 $F(i, j)$ 表示第 i 层对第 j 层的局部感受野,所以这个公式是从上层向下层计算感受野的。仔细看这个公式会发现和反卷积输出大小计算公式一模一样,实际上感受野计算公式就是 feature_map 计算公式的反向推导。
以下 Python 代码可以实现计算 Alexnet zf-5 和 VGG16 网络每层输出 feature map 的感受野大小,卷积核大小和输入图像尺寸默认定义好了,代码如下:
# !/usr/bin/env python

# [filter size, stride, padding]
net_struct = {'alexnet': {'net':[[11,4,0],[3,2,0],[5,1,2],[3,2,0],[3,1,1],[3,1,1],[3,1,1],[3,2,0]],
                   'name':['conv1','pool1','conv2','pool2','conv3','conv4','conv5','pool5']},
       'vgg16': {'net':[[3,1,1],[3,1,1],[2,2,0],[3,1,1],[3,1,1],[2,2,0],[3,1,1],[3,1,1],[3,1,1],
                        [2,2,0],[3,1,1],[3,1,1],[3,1,1],[2,2,0],[3,1,1],[3,1,1],[3,1,1],[2,2,0]],
                 'name':['conv1_1','conv1_2','pool1','conv2_1','conv2_2','pool2','conv3_1','conv3_2',
                         'conv3_3', 'pool3','conv4_1','conv4_2','conv4_3','pool4','conv5_1','conv5_2','conv5_3','pool5']},
       'zf-5':{'net': [[7,2,3],[3,2,1],[5,2,2],[3,2,1],[3,1,1],[3,1,1],[3,1,1]],
               'name': ['conv1','pool1','conv2','pool2','conv3','conv4','conv5']}}


def outFromIn(isz, net, layernum):
    """
    计算feature map大小
    """
    totstride = 1
    insize = isz
    # for layer in range(layernum):
    fsize, stride, pad = net[layernum]
    outsize = (insize - fsize + 2*pad) / stride + 1
    insize = outsize
    totstride = totstride * stride
    return outsize, totstride

def inFromOut(net, layernum):
    """
    计算感受野receptive file大小
    """
    RF = 1
    for layer in reversed(range(layernum)):  # reversed 函数返回一个反向的迭代器
        fsize, stride, pad = net[layer]
        RF = ((RF -1)* stride) + fsize
    return RF

if __name__ == '__main__':
    imsize = 224
    feature_size = imsize
    print ("layer output sizes given image = %dx%d" % (imsize, imsize))

    for net in net_struct.keys():
        feature_size = imsize
        print ('************net structrue name is %s**************'% net)
        for i in range(len(net_struct[net]['net'])):
            feature_size, stride = outFromIn(feature_size, net_struct[net]['net'], i)
            rf = inFromOut(net_struct[net]['net'], i+1)
            print ("Layer Name = %s, Output size = %3d, Stride = % 3d, RF size = %3d" % (net_struct[net]['name'][i], feature_size, stride, rf))
程序输出结果如下:
layer output sizes given image = 224x224
************net structrue name is alexnet**************
Layer Name = conv1, Output size =  54, Stride =   4, RF size =  11
Layer Name = pool1, Output size =  26, Stride =   2, RF size =  19
Layer Name = conv2, Output size =  26, Stride =   1, RF size =  51
Layer Name = pool2, Output size =  12, Stride =   2, RF size =  67
Layer Name = conv3, Output size =  12, Stride =   1, RF size =  99
Layer Name = conv4, Output size =  12, Stride =   1, RF size = 131
Layer Name = conv5, Output size =  12, Stride =   1, RF size = 163
Layer Name = pool5, Output size =   5, Stride =   2, RF size = 195
************net structrue name is vgg16**************
Layer Name = conv1_1, Output size = 224, Stride =   1, RF size =   3
Layer Name = conv1_2, Output size = 224, Stride =   1, RF size =   5
Layer Name = pool1, Output size = 112, Stride =   2, RF size =   6
Layer Name = conv2_1, Output size = 112, Stride =   1, RF size =  10
Layer Name = conv2_2, Output size = 112, Stride =   1, RF size =  14
Layer Name = pool2, Output size =  56, Stride =   2, RF size =  16
Layer Name = conv3_1, Output size =  56, Stride =   1, RF size =  24
Layer Name = conv3_2, Output size =  56, Stride =   1, RF size =  32
Layer Name = conv3_3, Output size =  56, Stride =   1, RF size =  40
Layer Name = pool3, Output size =  28, Stride =   2, RF size =  44
Layer Name = conv4_1, Output size =  28, Stride =   1, RF size =  60
Layer Name = conv4_2, Output size =  28, Stride =   1, RF size =  76
Layer Name = conv4_3, Output size =  28, Stride =   1, RF size =  92
Layer Name = pool4, Output size =  14, Stride =   2, RF size = 100
Layer Name = conv5_1, Output size =  14, Stride =   1, RF size = 132
Layer Name = conv5_2, Output size =  14, Stride =   1, RF size = 164
Layer Name = conv5_3, Output size =  14, Stride =   1, RF size = 196
Layer Name = pool5, Output size =   7, Stride =   2, RF size = 212
************net structrue name is zf-5**************
Layer Name = conv1, Output size = 112, Stride =   2, RF size =   7
Layer Name = pool1, Output size =  56, Stride =   2, RF size =  11
Layer Name = conv2, Output size =  28, Stride =   2, RF size =  27
Layer Name = pool2, Output size =  14, Stride =   2, RF size =  43
Layer Name = conv3, Output size =  14, Stride =   1, RF size =  75
Layer Name = conv4, Output size =  14, Stride =   1, RF size = 107
Layer Name = conv5, Output size =  14, Stride =   1, RF size = 139
九,卷积和池化操作的作用
卷积核池化的定义核过程理解是不难的,但是其作用却没有一个标准的答案,我在网上看了众多博客和魏秀参博士的书籍,总结了以下答案。
卷积层和池化层的理解可参考魏秀参的《解析卷积神经网络》书籍,卷积(convolution )操作的作用如下:
局部感知,参数共享的特点大大降低了网络参数,保证了网络的稀疏性。- 通过卷积核的组合以及随着网络后续操作的进行,卷积操作可获取图像不同区域的不同类型特征;模型靠近底部的层提取的是局部的、高度通用的特征图,而更靠近顶部的层提取的是更加抽象的语义特征。
池化/汇合(pooling )操作作用如下:
- 特征不变性(feature invariant)。汇合操作使模型更关注是否存在某些特征而不是特征具体的位置可看作是一种很强的先验,使特征学习包含某种程度自由度,能容忍一些特征微小的位移。
- 特征降维。由于汇合操作的降采样作用,汇合结果中的一个元素对应于原输入数据的一个子区域(sub-region),因此汇合相当于在空间范围内做了维度约减(spatially dimension reduction),从而使模型可以抽取更广范围的特征。同时减小了下一层输入大小,进而减小计算量和参数个数。
- 在一定程度上能防止过拟合(overfitting),更方便优化。
参考资料
魏秀参-《解析卷积神经网络》
十,卷积层与全连接层的区别
- 卷积层学习到的是局部模式(对于图像,学到的就是在输入图像的二维小窗口中发现的模式)
- 全连接层学习到的是全局模式(全局模式就算设计所有像素)
十一,CNN 权值共享问题
首先权值共享就是滤波器共享,滤波器的参数是固定的,即是用相同的滤波器去扫一遍图像,提取一次特征特征,得到feature map。在卷积网络中,学好了一个滤波器,就相当于掌握了一种特征,这个滤波器在图像中滑动,进行特征提取,然后所有进行这样操作的区域都会被采集到这种特征,就好比上面的水平线。
十二,CNN 结构特点
典型的用于分类的CNN主要由卷积层+激活函数+池化层组成,最后用全连接层输出。卷积层负责提取图像中的局部特征;池化层用来大幅降低参数量级(降维);全连接层类似传统神经网络的部分,用来输出想要的结果。
CNN 具有局部连接、权值共享、池化操作(简单说就是下采样)和多层次结构的特点。
- 局部连接使网络可以提取数据的局部特征。
- 权值共享大大降低了网络的训练难度,一个Filter只提取一个特征,在整个图片(或者语音/文本) 中进行卷积。
- 池化操作与多层次结构一起,实现了数据的降维,将低层次的局部特征组合成为较高层次的特征,从而对整个图片进行表示。
- 卷积神经网络学到的模式具有平移不变性(
translation invariant),且可以学到模式的空间层次结构。
Reference
十三,深度特征的层次性
卷积操作可获取图像区域不同类型特征,而汇合等操作可对这些特征进行融合和抽象,随着若干卷积、汇合等操作的堆叠,各层得到的深度特征逐渐从泛化特征(如边缘、纹理等)过渡到高层语义表示(躯干、头部等模式)。
十四,什么样的数据集不适合深度学习
- 数据集太小,数据样本不足时,深度学习相对其它机器学习算法,没有明显优势。
- 数据集没有局部相关特性,目前深度学习表现比较好的领域主要是图像/语音/自然语言处理等领域,这些领域的一个共性是局部相关性。图像中像素组成物体,语音信号中音位组合成单词,文本数据中单词组合成句子,这些特征元素的组合一旦被打乱,表示的含义同时也被改变。对于没有这样的局部相关性的数据集,不适于使用深度学习算法进行处理。举个例子:预测一个人的健康状况,相关的参数会有年龄、职业、收入、家庭状况等各种元素,将这些元素打乱,并不会影响相关的结果。
十五,什么造成梯度消失问题
- 神经网络的训练中,通过改变神经元的权重,使网络的输出值尽可能逼近标签以降低误差值,训练普遍使用BP算法,核心思想是,计算出输出与标签间的损失函数值,然后计算其相对于每个神经元的梯度,进行权值的迭代。
- 梯度消失会造成权值更新缓慢,模型训练难度增加。造成梯度消失的一个原因是,许多激活函数将输出值挤压在很小的区间内,在激活函数两端较大范围的定义域内梯度为0,造成学习停止。
十六,Overfitting 和 Underfitting 问题
16.1,过拟合问题怎么解决
首先所谓过拟合,指的是一个模型过于复杂之后,它可以很好地“记忆”每一个训练数据中随机噪音的部分而忘记了去“训练”数据中的通用趋势。训练好后的模型过拟合具体表现在:模型在训练数据上损失函数较小,预测准确率较高;但是在测试数据上损失函数比较大,预测准确率较低。解决办法如下:
数据增强, 增加数据多样性;- 正则化策略:如 Parameter Norm Penalties(参数范数惩罚),
L1, L2正则化; dropout;- 模型融合, 比如Bagging 和其他集成方法;
BN,batch normalization;- Early Stopping(提前终止训练)。
16.2,如何判断深度学习模型是否过拟合
- 首先将训练数据划分为训练集和验证集,
80%用于训练集,20%用于验证集(训练集和验证集一定不能相交);训练都时候每隔一定Epoch比较验证集但指标和训练集是否一致,如果不一致,并且变坏了,那么意味着过拟合。 - 用学习曲线
learning curve来判别过拟合,参考此博客。
16.3,欠拟合怎么解决
underfitting 欠拟合的表现就是模型不收敛,原因有很多种,这里以神经网络拟合能力不足问题给出以下参考解决方法:
- 寻找最优的权重初始化方案:如 He正态分布初始化
he_normal,深度学习框架都内置了很多权重初始化方法; - 使用适当的激活函数:卷积层的输出使用的激活函数一般为
ReLu,循环神经网络中的循环层使用的激活函数一般为tanh,或者ReLu; - 选择合适的优化器和学习速率:
SGD优化器速度慢但是会达到最优.
16.4,如何判断模型是否欠拟合
神级网络欠拟合的特征就是模型训练了足够长但时间后, loss 值依然很大甚至与初始值没有太大区别,且精度很低,测试集亦如此。根据我的总结,原因一般有以下几种:
- 神经网络的拟合能力不足;
- 网络配置的问题;
- 数据集配置的问题;
- 训练方法出错(初学者经常碰到,原因千奇百怪)。
十七,L1 和 L2 区别
L1 范数(L1 norm)是指向量中各个元素绝对值之和,也有个美称叫“稀疏规则算子”(Lasso regularization)。 比如 向量 A=[1,-1,3], 那么 A 的 L1 范数为 |1|+|-1|+|3|。简单总结一下就是:
- L1 范数: 为向量 x 各个元素绝对值之和。
- L2 范数: 为向量 x 各个元素平方和的 1/2 次方,L2 范数又称 Euclidean 范数或 Frobenius 范数
- Lp 范数: 为向量 x 各个元素绝对值 $p$ 次方和的 $1/p$ 次方.
在支持向量机学习过程中,L1 范数实际是一种对于成本函数求解最优的过程,因此,L1 范数正则化通过向成本函数中添加 L1 范数,使得学习得到的结果满足稀疏化,从而方便人类提取特征。
L1 范数可以使权值参数稀疏,方便特征提取。 L2 范数可以防止过拟合,提升模型的泛化能力。
十八,TensorFlow计算图概念
Tensorflow 是一个通过计算图的形式来表述计算的编程系统,计算图也叫数据流图,可以把计算图看做是一种有向图,Tensorflow 中的每一个计算都是计算图上的一个节点,而节点之间的边描述了计算之间的依赖关系。
十九,BN(批归一化)的作用
在神经网络中间层也进行归一化处理,使训练效果更好的方法,就是批归一化Batch Normalization(BN)。
(1). 可以使用更高的学习率。如果每层的 scale 不一致,实际上每层需要的学习率是不一样的,同一层不同维度的 scale 往往也需要不同大小的学习率,通常需要使用最小的那个学习率才能保证损失函数有效下降,Batch Normalization 将每层、每维的 scale 保持一致,那么我们就可以直接使用较高的学习率进行优化。
(2). 移除或使用较低的 dropout。 dropout 是常用的防止 overfitting 的方法,而导致 overfitting 的位置往往在数据边界处,如果初始化权重就已经落在数据内部,overfitting现象就可以得到一定的缓解。论文中最后的模型分别使用10%、5%和0%的dropout训练模型,与之前的 40%-50% 相比,可以大大提高训练速度。
(3). 降低 L2 权重衰减系数。 还是一样的问题,边界处的局部最优往往有几维的权重(斜率)较大,使用 L2 衰减可以缓解这一问题,现在用了 Batch Normalization,就可以把这个值降低了,论文中降低为原来的 5 倍。
(4). 代替Local Response Normalization层。 由于使用了一种 Normalization,再使用 LRN 就显得没那么必要了。而且 LRN 实际上也没那么 work。
(5). Batch Normalization调整了数据的分布,不考虑激活函数,它让每一层的输出归一化到了均值为0方差为1的分布,这保证了梯度的有效性,可以解决反向传播过程中的梯度问题。目前大部分资料都这样解释,比如 BN 的原始论文认为的缓解了 Internal Covariate Shift(ICS) 问题。
关于训练阶段和推理阶段 BN 的不同可以参考 Batch Normalization详解 。
二十,什么是梯度消失和爆炸
- 梯度消失是指在深度学习训练的过程中,梯度随着
BP算法中的链式求导逐层传递逐层减小,最后趋近于0,导致对某些层的训练失效; - 梯度爆炸与梯度消失相反,梯度随着
BP算法中的链式求导逐层传递逐层增大,最后趋于无穷,导致某些层无法收敛;
在反向传播过程中需要对激活函数进行求导,如果导数大于 1,那么随着网络层数的增加,梯度更新将会朝着指数爆炸的方式增加这就是梯度爆炸。同样如果导数小于 1,那么随着网络层数的增加梯度更新信息会朝着指数衰减的方式减少这就是梯度消失。
梯度消失和梯度爆炸产生的原因
出现梯度消失和梯度爆炸的问题主要是因为参数初始化不当以及激活函数选择不当造成的。其根本原因在于反向传播训练法则,属于先天不足。当训练较多层数的模型时,一般会出现梯度消失问题(gradient vanishing problem)和梯度爆炸问题(gradient exploding problem)。注意在反向传播中,当网络模型层数较多时,梯度消失和梯度爆炸是不可避免的。
深度神经网络中的梯度不稳定性,根本原因在于前面层上的梯度是来自于后面层上梯度的乘积。当存在过多的层次时,就出现了内在本质上的不稳定场景。前面的层比后面的层梯度变化更小,故变化更慢,故引起了梯度消失问题。前面层比后面层梯度变化更快,故引起梯度爆炸问题。
如何解决梯度消失和梯度爆炸问题
常用的有以下几个方案:
- 预训练模型 + 微调
- 梯度剪切 + 正则化
relu、leakrelu等激活函数BN批归一化- 参数标准初始化函数如
xavier CNN中的残差结构LSTM结构
二十一,RNN循环神经网络理解
循环神经网络(recurrent neural network, RNN), 主要应用在语音识别、语言模型、机器翻译以及时序分析等问题上。 在经典应用中,卷积神经网络在不同的空间位置共享参数,循环神经网络是在不同的时间位置共享参数,从而能够使用有限的参数处理任意长度的序列。
RNN 可以看做作是同一神经网络结构在时间序列上被复制多次的结果,这个被复制多次的结构称为循环体,如何设计循环体的网络结构是 RNN 解决实际问题的关键。RNN 的输入有两个部分,一部分为上一时刻的状态,另一部分为当前时刻的输入样本。
二十二,训练过程中模型不收敛,是否说明这个模型无效,导致模型不收敛的原因
不一定。导致模型不收敛的原因有很多种可能,常见的有以下几种:
- 没有对数据做归一化。
- 没有检查过你的结果。这里的结果包括预处理结果和最终的训练测试结果。
- 忘了做数据预处理。
- 忘了使用正则化。
- Batch Size 设的太大。
- 学习率设的不对。
- 最后一层的激活函数用的不对。
- 网络存在坏梯度。比如 ReLu 对负值的梯度为 0,反向传播时,0 梯度就是不传播。
- 参数初始化错误。
- 网络太深。隐藏层神经元数量错误。
- 更多回答,参考此链接。
二十三,VGG 使用 2 个 3*3 卷积的优势
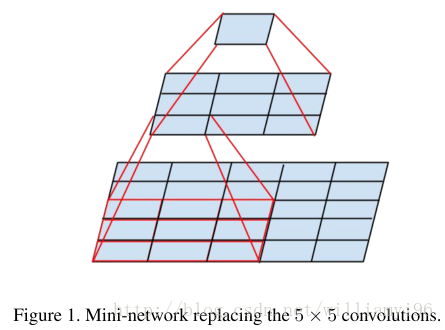
(1). 减少网络层参数。用两个 3\3 卷积比用 1 个 5\5 卷积拥有更少的参数量,只有后者的 2∗3∗3/5∗5=0.72。但是起到的效果是一样的,两个 3×3 的卷积层串联相当于一个 5×5 的卷积层,感受野的大小都是 5×5,即 1 个像素会跟周围 5×5 的像素产生关联。把下图当成动态图看,很容易看到两个 3×3 卷积层堆叠(没有空间池化)有 5×5 的有效感受野。
(2). 更多的非线性变换。2 个 3×3 卷积层拥有比 1 个 5×5 卷积层更多的非线性变换(前者可以使用两次 ReLU 激活函数,而后者只有一次),使得卷积神经网络对特征的学习能力更强。
paper中给出的相关解释:三个这样的层具有 7×7 的有效感受野。那么我们获得了什么?例如通过使用三个 3×3 卷积层的堆叠来替换单个 7×7 层。首先,我们结合了三个非线性修正层,而不是单一的,这使得决策函数更具判别性。其次,我们减少参数的数量:假设三层 3×3 卷积堆叠的输入和输出有 C 个通道,堆叠卷积层的参数为 3×(3×3C) = 27C 个权重;同时,单个 7×7 卷积层将需要 7×7×C = 49C 个参数,即参数多 81%。这可以看作是对 7×7 卷积滤波器进行正则化,迫使它们通过 3×3 滤波器(在它们之间注入非线性)进行分解。
此回答可以参考 TensorFlow 实战 p110,网上很多回答都说的不全。
23.1,1*1 卷积的主要作用
- 降维( dimension reductionality )。比如,一张500 \ 500且厚度depth为100 的图片在20个filter上做1\1的卷积,那么结果的大小为500\500\20。
- 加入非线性。卷积层之后经过激励层,1\*1的卷积在前一层的学习表示上添加了非线性激励( non-linear activation ),提升网络的表达能力;
二十四,Relu比Sigmoid效果好在哪里?
Sigmoid 函数公式如下:
$\sigma (x)=\frac{1}{1+exp(-x)}$
ReLU激活函数公式如下: $$f(x) = max(x, 0) = \begin{cases} x, & \text{if $x$ $\geq$ 0} \\ 0, & \text{if $x$ < 0} \end{cases}$$
ReLU 的输出要么是 0, 要么是输入本身。虽然方程简单,但实际上效果更好。在网上看了很多版本的解释,有从程序实例分析也有从数学上分析,我找了个相对比较直白的回答,如下:
ReLU函数计算简单,可以减少很多计算量。反向传播求误差梯度时,涉及除法,计算量相对较大,采用ReLU激活函数,可以节省很多计算量;- 避免梯度消失问题。对于深层网络,
sigmoid函数反向传播时,很容易就会出现梯度消失问题(在sigmoid接近饱和区时,变换太缓慢,导数趋于 0,这种情况会造成信息丢失),从而无法完成深层网络的训练。 - 可以缓解过拟合问题的发生。
ReLU会使一部分神经元的输出为 0,这样就造成了网络的稀疏性,并且减少了参数的相互依存关系,缓解了过拟合问题的发生。 - 相比
sigmoid型函数,ReLU函数有助于随机梯度下降方法收敛。
参考链接
二十五,神经网络中权值共享的理解
权值(权重)共享这个词是由 LeNet5 模型提出来的。以 CNN 为例,在对一张图偏进行卷积的过程中,使用的是同一个卷积核的参数。 比如一个 3×3×1 的卷积核,这个卷积核内 9 个的参数被整张图共享,而不会因为图像内位置的不同而改变卷积核内的权系数。说的再直白一些,就是用一个卷积核不改变其内权系数的情况下卷积处理整张图片(当然CNN中每一层不会只有一个卷积核的,这样说只是为了方便解释而已)。
参考资料
二十六,对 fine-tuning(微调模型的理解),为什么要修改最后几层神经网络权值?
使用预训练模型的好处,在于利用训练好的SOTA模型权重去做特征提取,可以节省我们训练模型和调参的时间。
至于为什么只微调最后几层神经网络权重,是因为:
(1). CNN 中更靠近底部的层(定义模型时先添加到模型中的层)编码的是更加通用的可复用特征,而更靠近顶部的层(最后添加到模型中的层)编码的是更专业业化的特征。微调这些更专业化的特征更加有用,它更代表了新数据集上的有用特征。 (2). 训练的参数越多,过拟合的风险越大。很多SOTA模型拥有超过千万的参数,在一个不大的数据集上训练这么多参数是有过拟合风险的,除非你的数据集像Imagenet那样大。
参考资料
Python深度学习p127.
二十七,什么是 dropout?
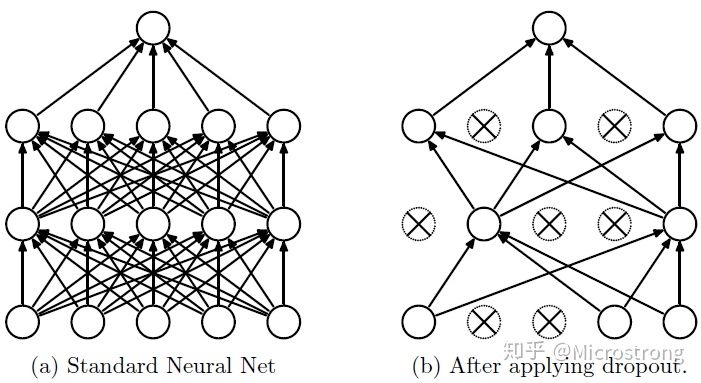
- dropout可以防止过拟合,dropout简单来说就是:我们在前向传播的时候,让某个神经元的激活值以一定的概率 p 停止工作,这样可以使模型的泛化性更强,因为它不会依赖某些局部的特征。
dropout效果跟bagging效果类似(bagging是减少方差variance,而boosting是减少偏差bias)- 加入dropout会使神经网络训练时间边长,模型预测时不需要dropout,记得关掉。
27.1,dropout具体工作流程
以 标准神经网络为例,正常的流程是:我们首先把输入数据x通过网络前向传播,然后把误差反向传播一决定如何更新参数让网络进行学习。使用dropout之后,过程变成如下:
1,首先随机(临时)删掉网络中一半的隐藏神经元,输入输出神经元保持不变(图3中虚线为部分临时被删除的神经元);
2,然后把输入x通过修改后的网络进行前向传播计算,然后把得到的损失结果通过修改的网络反向传播。一小批训练样本执行完这个过程后,在没有被删除的神经元上按照随机梯度下降法更新对应的参数(w,b);
3,然后重复这一过程:
- 恢复被删掉的神经元(此时被删除的神经元保持原样没有更新w参数,而没有被删除的神经元已经有所更新);
- 从隐藏层神经元中随机选择一个一半大小的子集临时删除掉(同时备份被删除神经元的参数);
- 对一小批训练样本,先前向传播然后反向传播损失并根据随机梯度下降法更新参数(w,b) (没有被删除的那一部分参数得到更新,删除的神经元参数保持被删除前的结果)。
27.2,dropout在神经网络中的应用
(1). 在训练模型阶段
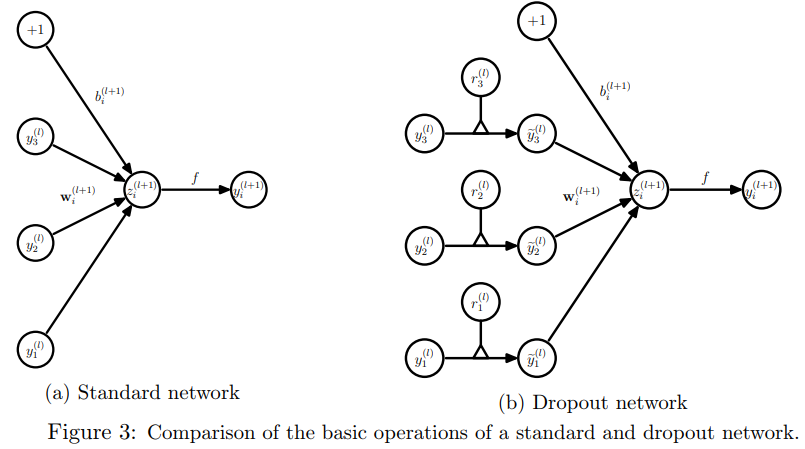
不可避免的,在训练网络中的每个单元都要添加一道概率流程,标准网络和带有dropout网络的比较图如下所示:
(2). 在测试模型阶段
预测模型的时候,输入是当前输入,每个神经单元的权重参数要乘以概率p。
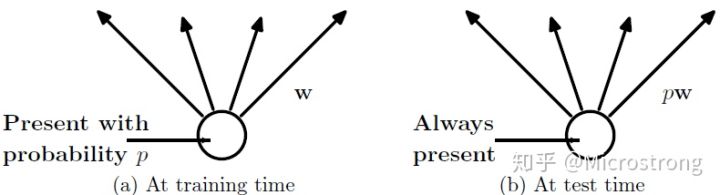
27.3,如何选择dropout 的概率
input 的 dropout 概率推荐是 0.8, hidden layer 推荐是0.5, 但是也可以在一定的区间上取值。(All dropout nets use p = 0.5 for hidden units and p = 0.8 for input units.)
参考资料
- [Dropout:A Simple Way to Prevent Neural Networks from Overfitting]
- 深度学习中Dropout原理解析
二十八,HOG 算法原理描述
方向梯度直方图(Histogram of Oriented Gradient, HOG)特征是一种在计算机视觉和图像处理中用来进行物体检测的特征描述子。它通过计算和统计图像局部区域的梯度方向直方图来构成特征。在深度学习取得成功之前,Hog特征结合SVM分类器被广泛应用于图像识别中,在行人检测中获得了较大的成功。
HOG特征原理
HOG 的核心思想是所检测的局部物体外形能够被光强梯度或边缘方向的分布所描述。通过将整幅图像分割成小的连接区域(称为cells),每个 cell 生成一个方向梯度直方图或者 cell 中pixel 的边缘方向,这些直方图的组合可表示(所检测目标的目标)描述子。
为改善准确率,局部直方图可以通过计算图像中一个较大区域(称为block)的光强作为 measure 被对比标准化,然后用这个值(measure)归一化这个 block 中的所有 cells 。这个归一化过程完成了更好的照射/阴影不变性。与其他描述子相比,HOG 得到的描述子保持了几何和光学转化不变性(除非物体方向改变)。因此HOG描述子尤其适合人的检测。
HOG 特征提取方法就是将一个image:
- 灰度化(将图像看做一个x,y,z(灰度)的三维图像)
- 划分成小
cells(2*2) - 计算每个 cell 中每个 pixel 的 gradient(即 orientation)
- 统计每个 cell 的梯度直方图(不同梯度的个数),即可形成每个 cell 的 descriptor。
HOG特征检测步骤
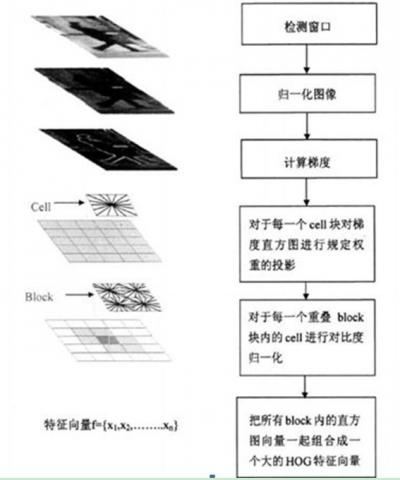
总结:颜色空间归一化——>梯度计算——>梯度方向直方图——>重叠块直方图归一化———>HOG特征
参考资料
二十九,激活函数
29.1,激活函数的作用
- 激活函数实现去线性化。激活函数的引入是为了增加整个网络的表达能力(引入非线性因素),否则若干线形层的堆叠仍然只能起到线性映射的作用,无法形成复杂的函数。如果将每一个神经元(也就是神经网络的节点)的输出通过一个非线性函数,那么整个神经网络的模型也就不再是线性的了,这个非线性函数就是激活函数。
- 激活函数可以把当前特征空间通过一定的线性映射转换到另一个空间,让数据能够更好的被分类。
- 激活函数对模型学习、理解非常复杂和非线性的函数具有重要作用。
29.2,常见的激活函数
激活函数也称非线性映射函数,常见的激活函数有:ReLU 函数、sigmoid 函数、tanh 函数等,其计算公式如下:
- ReLU函数:$f(x)=max(x,0)$
- sigmoid函数:$f(x)=\frac{1}{1+e^{-x}}$
- tanh函数:$f(x)=\frac{1+e^{-2x}}{1+e^{-2x}}=\frac{2}{1+e^{-2x}}-1 = 2sigmoid(2x)-1$
29.3,激活函数理解及函数梯度图
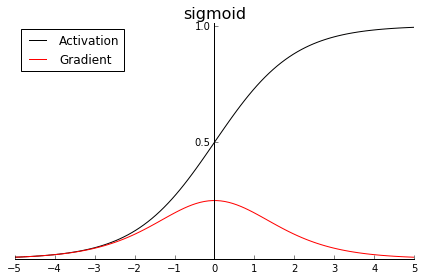
Sigmoid激活函数,可用作分类任务的输出层。可以看出经过sigmoid激活函数后,模型输出的值域被压缩到0到1区间(这和概率的取值范围一致),这正是分类任务中sigmoid很受欢迎的原因。
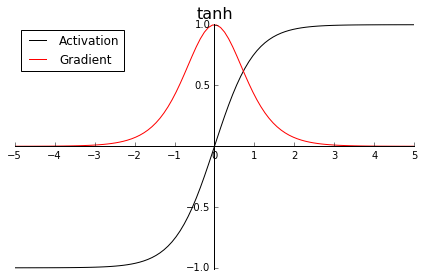
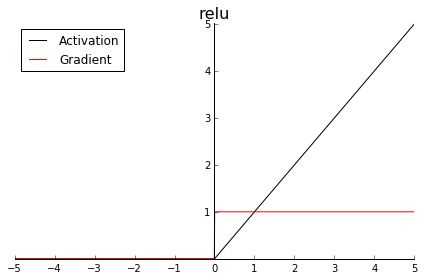
tanh(x)型函数是在sigmoid型函数基础上为解决均值问题提出的激活函数。tanh 的形状和 sigmoid 类似,只不过tanh将“挤压”输入至区间(-1, 1)。至于梯度,它有一个大得多的峰值1.0(同样位于z = 0处),但它下降得更快,当|x|的值到达 3 时就已经接近零了。这是所谓梯度消失(vanishing gradients)问题背后的原因,会导致网络的训练进展变慢。
ReLU处理了sigmoid、tanh中常见的梯度消失问题,同时也是计算梯度最快的激励函数。但是,ReLU函数也有自身缺陷,即在 x < 0 时,梯度便为 y。换句话说,对于小于 y 的这部分卷积结果响应,它们一旦变为负值将再无法影响网络训练——这种现象被称作“死区"。
三十,卷积层和池化层有什么区别
- 卷积层有参数,池化层没有参数;
- 经过卷积层节点矩阵深度会改变。池化层不会改变节点矩阵的深度,但是它可以缩小节点矩阵的大小。
三十一,卷积层和池化层参数量计算
参考 神经网络模型复杂度分析 文章。
三十二,神经网络为什么用交叉熵损失函数
判断一个输出向量和期望的向量有多接近,交叉熵(cross entroy)是常用的评判方法之一。交叉熵刻画了两个概率分布之间的距离,是分类问题中使用比较广泛的一种损失函数。给定两个概率分布 p 和 q ,通过 q 来表示 p 的交叉熵公式为:$H(p,q)=−∑p(x)logq(x)$
三十三,数据增强方法有哪些
常用数据增强方法:
- 翻转:
Fliplr,Flipud。不同于旋转180度,这是类似镜面的翻折,跟人在镜子中的映射类似,常用水平、上下镜面翻转。 - 旋转:
rotate。顺时针/逆时针旋转,最好旋转90-180度,否则会出现边缘缺失或者超出问题,如旋转45度。 - 缩放:
zoom。图像可以被放大或缩小,imgaug库可用Scal函数实现。 - 裁剪:
crop。一般叫随机裁剪,操作步骤是:随机从图像中选择一部分,然后降这部分图像裁剪出来,然后调整为原图像的大小。根本上理解,图像crop就是指从图像中移除不需要的信息,只保留需要的部分 - 平移:
translation。平移是将图像沿着x或者y方向(或者两个方向)移动。我们在平移的时候需对背景进行假设,比如说假设为黑色等等,因为平移的时候有一部分图像是空的,由于图片中的物体可能出现在任意的位置,所以说平移增强方法十分有用。 - 放射变换:
Affine。包含:平移(Translation)、旋转(Rotation)、放缩(zoom)、错切(shear)。 - 添加噪声:过拟合通常发生在神经网络学习高频特征的时候,为消除高频特征的过拟合,可以随机加入噪声数据来消除这些高频特征。
imgaug图像增强库使用GaussianBlur函数。 - 亮度、对比度增强:这是图像色彩进行增强的操作
- 锐化:
Sharpen。imgaug库使用Sharpen函数。
33.1,离线数据增强和在线数据增强有什么区别?
数据增强分两类,一类是离线增强,一类是在线增强:
- 离线增强 : 直接对硬盘上的数据集进行处理,并保存增强后的数据集文件。数据的数目会变成增强因子 x 原数据集的数目 ,这种方法常常用于数据集很小的时候
- 在线增强 : 这种增强的方法用于,获得 batch 数据之后,然后对这个batch的数据进行增强,如旋转、平移、翻折等相应的变化,由于有些数据集不能接受线性级别的增长,这种方法长用于大的数据集,很多机器学习框架已经支持了这种数据增强方式,并且可以使用GPU优化计算。
`
Reference
三十四,ROI Pooling替换为ROI Align的效果,及各自原理
faster rcnn 将 roi pooling 替换为 roi align 效果有所提升。
ROI Pooling原理
RPN 生成的 ROI 区域大小是对应与输入图像大小(每个roi区域大小各不相同),为了能够共享权重,所以需要将这些 ROI 映射回特征图上,并固定大小。ROI Pooling操作过程如下图:
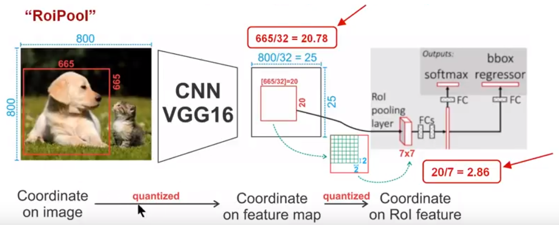
ROI Pooling 具体操作如下:
Conv layers使用的是VGG16,feat_stride=32(即表示,经过网络层后图片缩小为原图的 1/32),原图 $800\times 800$,最后一层特征图feature map大小: $25\times 25$- 假定原图中有一
region proposal,大小为 $665\times 665$,这样,映射到特征图中的大小:$665/32=20.78$,即大小为 $20.78\times 20.78$,源码中,在计算的时候会进行取整操作,于是,进行所谓的第一次量化,即映射的特征图大小为20*20; - 假定
pooled_w=7、pooled_h=7,即pooling后固定成 $7\times 7$ 大小的特征图,所以,将上面在feature map上映射的 $20\times 20$ 的region proposal划分成49个同等大小的小区域,每个小区域的大小 $20/7=2.86$,,即 $2.86\times 2.86$,此时,进行第二次量化,故小区域大小变成 $2\times 2$; - 每个 $2\times 2$ 的小区域里,取出其中最大的像素值,作为这一个区域的‘代表’,这样,49 个小区域就输出 49 个像素值,组成 $7\times 7$ 大小的
feature map。
所以,通过上面可以看出,经过两次量化,即将浮点数取整,原本在特征图上映射的 $20\times 20$ 大小的 region proposal,偏差成大小为 $7\times 7$ 的,这样的像素偏差势必会对后层的回归定位产生影响。所以,产生了后面的替代方案: RoiAlign。
ROI Align原理
ROI Align 的工作原理如下图。
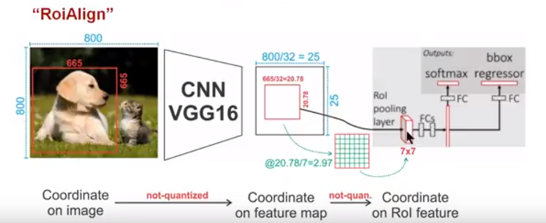
ROI Align 是在 Mask RCNN 中使用以便使生成的候选框region proposal 映射产生固定大小的 feature map 时提出的,根据上图,有着类似的映射:
Conv layers使用的是VGG16,feat_stride=32(即表示,经过网络层后图片缩小为原图的1/32),原图 $800\times 800$,最后一层特征图feature map大小: $25*\times 25$;- 假定原图中有一region proposal,大小为 $665*\times 665$,这样,映射到特征图中的大小:$665/32=20.78$,即大小为 $20.78\times 20.78$,此时,没有像
RoiPooling那样就行取整操作,保留浮点数; - 假定
pooled_w=7,pooled_h=7,即pooling后固定成 $7\times 7$ 大小的特征图,所以,将在feature map上映射的 $20.78\times 20.78$ 的region proposal划分成 49 个同等大小的小区域,每个小区域的大小 $20.78/7=2.97$,即 $2.97\times 2.97$; - 假定采样点数为
4,即表示,对于每个 $2.97\times 2.97$ 的小区域,平分四份,每一份取其中心点位置,而中心点位置的像素,采用双线性插值法进行计算,这样,就会得到四个点的像素值,如下图:
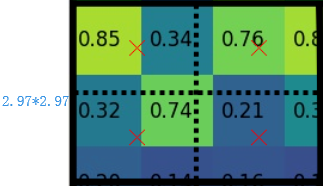
上图中,四个红色叉叉‘×’的像素值是通过双线性插值算法计算得到的。
最后,取四个像素值中最大值作为这个小区域(即:$2.97\times 2.97$ 大小的区域)的像素值,如此类推,同样是 49 个小区域得到 49 个像素值,组成 $7\times 7$ 大小的 feature map。
RoiPooling 和 RoiAlign 总结
总结:知道了 RoiPooling 和 RoiAlign 实现原理,在以后的项目中可以根据实际情况进行方案的选择;对于检测图片中大目标物体时,两种方案的差别不大,而如果是图片中有较多小目标物体需要检测,则优先选择 RoiAlign,更精准些。
Reference
三十五,CNN的反向传播算法推导
三十六,Focal Loss 公式
为了解决正负样本不平衡的问题,我们通常会在交叉熵损失的前面加上一个参数 $\alpha$ ,即: $$ CE = \left\{\begin{matrix} -\alpha log(p), & if \quad y=1\\ -(1-\alpha)log(1-p), & if\quad y=0 \end{matrix}\right. $$
尽管 $\alpha$ 平衡了正负样本,但对难易样本的不平衡没有任何帮助。因此,Focal Loss 被提出来了,即:
$$ CE = \left\{\begin{matrix} -\alpha (1-p)^\gamma log(p), & if \quad y=1\\ -(1-\alpha) p^\gamma log(1-p), & if\quad y=0 \end{matrix}\right. $$
实验表明 $\gamma$ 取 2, $\alpha$ 取 0.25 的时候效果最佳。
Focal loss成功地解决了在单阶段目标检测时,正负样本区域极不平衡而目标检测loss易被大批量负样本所左右的问题。RetinaNet达到更高的精度的原因不是网络结构的创新,而是损失函数的创新!
三十七,快速回答
37.1,为什么 Faster RCNN、Mask RCNN 需要使用 ROI Pooling、ROI Align?
为了使得最后面的两个全连接层能够共享 conv layers(VGG/ResNet) 权重。在所有的 RoIs 都被 pooling 成(512×7×7)的feature map后,将它 reshape 成一个一维的向量,就可以利用 VGG16 的预训练的权重来初始化前两层全连接。
37.2,softmax公式
$$softmax(y)_{i} = \frac{e^{y_{i}}}{\sum_{j=1}^{n}e^{y_j}}$$
37.3,上采样方法总结
上采样大致被总结成了三个类别:
- 基于线性插值的上采样:最近邻算法(
nearest)、双线性插值算法(bilinear)、双三次插值算法(bicubic)等,这是传统图像处理方法。 - 基于深度学习的上采样(转置卷积,也叫反卷积
Conv2dTranspose2d等) Unpooling的方法(简单的补零或者扩充操作)
计算效果:最近邻插值算法 < 双线性插值 < 双三次插值。计算速度:最近邻插值算法 > 双线性插值 > 双三次插值
37.4,移动端深度学习框架知道哪些,用过哪些?
知名的有TensorFlow Lite、小米MACE、腾讯的 ncnn 等,目前都没有用过。
37.5,如何提升网络的泛化能力
和防止模型过拟合的方法类似,另外还有模型融合方法。
37.6,BN算法,为什么要在后面加伽马和贝塔,不加可以吗?
最后的 scale and shift 操作则是为了让因训练所需而“刻意”加入的BN能够有可能还原最初的输入。不加也可以。
37.7,验证集和测试集的作用
- 验证集是在训练过程中用于检验模型的训练情况,从而确定合适的超参数;
- 测试集是在模型训练结束之后,测试模型的泛化能力。
三十八,交叉验证的理解和作用
参考知乎文章 N折交叉验证的作用(如何使用交叉验证),我的理解之后补充。
三十九,介绍一下NMS和IOU的原理
NMS全称是非极大值抑制,顾名思义就是抑制不是极大值的元素。在目标检测任务中,通常在解析模型输出的预测框时,预测目标框会非常的多,其中有很多重复的框定位到了同一个目标,NMS 的作用就是用来除去这些重复框,从而获得真正的目标框。而 NMS 的过程则用到了 IOU,IOU 是一种用于衡量真实和预测之间相关度的标准,相关度越高,该值就越高。IOU 的计算是两个区域重叠的部分除以两个区域的集合部分,简单的来说就是交集除以并集。
在 NMS 中,首先对预测框的置信度进行排序,依次取置信度最大的预测框与后面的框进行 IOU 比较,当 IOU 大于某个阈值时,可以认为两个预测框框到了同一个目标,而置信度较低的那个将会被剔除,依次进行比较,最终得到所有的预测框。
Reference
- 《Batch Normalization Accelerating Deep Network Training by Reducing Internal Covariate Shift》阅读笔记与实现
- 详解机器学习中的梯度消失、爆炸原因及其解决方法
- N折交叉验证的作用(如何使用交叉验证)
- 5分钟理解Focal Loss与GHM——解决样本不平衡利器
- 深度学习CV岗位面试问题总结(目标检测篇)
python3编程总结
- Python global 语句的作用
- lambda 匿名函数好处
- Python 错误处理
- Python 内置错误类型
- 简述 any() 和 all() 方法
- Python 中什么元素为假?
- 提高 Python 运行效率的方法
- Python 单例模式
- 为什么 Python 不提供函数重载
- 实例方法/静态方法/类方法
- \_\_new\_\_和 \_\_init \_\_方法的区别
- Python 的函数参数传递
- Python 实现对函参做类型检查
- 为什么说 Python 是动态语言
- Python 装饰器理解
- map 与 reduce 函数用法解释
- Python 深拷贝、浅拷贝区别
- Python 继承多态理解
- Python 面向对象的原则
- 参考资料
Python global 语句的作用
在编写程序的时候,如果想要改变(重新赋值)函数外部的变量,并且这个变量会作用于许多函数中,就需要告诉 Python 程序这个变量的作用域是全局变量,global 语句可以实现定义全局变量的作用。
lambda 匿名函数好处
精简代码,lambda省去了定义函数,map 省去了写 for 循环过程:
str_1 = ["中国", "美国", "法国", "", "", "英国"]
res = list(map(lambda x: "填充值" if x=="" else x, str_1))
print(res)  # ['中国', '美国', '法国', '填充值', '填充值', '英国']
Python 错误处理
和其他高级语言一样,Python 也内置了一套try...except...finally... 的错误处理机制。
当我们认为某些代码可能会出错时,就可以用 try 来运行这段代码,如果执行出错,则后续代码不会继续执行,而是直接跳转至跳转至错误处理代码,即 except 语句块,执行完 except 后,如果有 finally 语句块,则执行。至此,执行完毕。跳转至错误处理代码,
Python 内置错误类型
IOError:输入输出异常AttributeError:试图访问一个对象没有的属性ImportError:无法引入模块或包,基本是路径问题IndentationError:语法错误,代码没有正确的对齐IndexError:下标索引超出序列边界KeyError: 试图访问你字典里不存在的键SyntaxError: Python 代码逻辑语法出错,不能执行NameError: 使用一个还未赋予对象的变量
简述 any() 和 all() 方法
any(): 只要迭代器中有一个元素为真就为真;all(): 迭代器中所有的判断项返回都是真,结果才为真.
Python 中什么元素为假?
答案:(0,空字符串,空列表、空字典、空元组、None, False)
提高 Python 运行效率的方法
- 使用生成器,因为可以节约大量内存;
- 循环代码优化,避免过多重复代码的执行;
- 核心模块用
Cython PyPy等,提高效率; - 多进程、多线程、协程;
- 多个
if elif条件判断,可以把最有可能先发生的条件放到前面写,这样可以减少程序判断的次数,提高效率。
Python 单例模式
为什么 Python 不提供函数重载
参考知乎为什么 Python 不支持函数重载?其他函数大部分都支持的?
我们知道 函数重载 主要是为了解决两个问题。
- 可变参数类型。
- 可变参数个数。
另外,一个函数重载基本的设计原则是,仅仅当两个函数除了参数类型和参数个数不同以外,其功能是完全相同的,此时才使用函数重载,如果两个函数的功能其实不同,那么不应当使用重载,而应当使用一个名字不同的函数。
- 对于情况 1 ,函数功能相同,但是参数类型不同,Python 如何处理?答案是根本不需要处理,因为
Python可以接受任何类型的参数,如果函数的功能相同,那么不同的参数类型在 Python 中很可能是相同的代码,没有必要做成两个不同函数。 - 对于情况 2 ,函数功能相同,但参数个数不同,Python 如何处理?大家知道,答案就是缺省参数(默认参数)。对那些缺少的参数设定为缺省参数(默认参数)即可解决问题。因为你假设函数功能相同,那么那些缺少的参数终归是需要用的。所以,鉴于情况 1 跟 情况 2 都有了解决方案,Python 自然就不需要函数重载了。
实例方法/静态方法/类方法
Python 类语法中有三种方法,实例方法,静态方法,类方法,它们的区别如下:
- 实例方法只能被实例对象调用,静态方法(由
@staticmethod装饰器来声明)、类方法(由@classmethod装饰器来声明),可以被类或类的实例对象调用; 实例方法,第一个参数必须要默认传实例对象,一般习惯用self。静态方法,参数没有要求。类方法,第一个参数必须要默认传类,一般习惯用cls.
实例代码如下:
class Foo(object):
    """类三种方法语法形式
    """
    def instance_method(self):
        print("是类{}的实例方法,只能被实例对象调用".format(Foo))

    @staticmethod
    def static_method():
        print("是静态方法")

    @classmethod
    def class_method(cls):
        print("是类方法")


foo = Foo()
foo.instance_method()
foo.static_method()
foo.class_method()
print('##############')
Foo.static_method()
Foo.class_method()
程序执行后输出如下:
是类的实例方法,只能被实例对象调用
是静态方法 是类方法 ############## 是静态方法 是类方法
\_\_new\_\_和 \_\_init \_\_方法的区别
__init__方法并不是真正意义上的构造函数,__new__方法才是(类的构造函数是类的一种特殊的成员函数,它会在每次创建类的新对象时执行);__new__方法用于创建对象并返回对象,当返回对象时会自动调用__init__方法进行初始化,__new__方法比__init__方法更早执行;__new__方法是静态方法,而__init__是实例方法。
Python 的函数参数传递
参考这两个链接,stackoverflow的最高赞那个讲得很详细
How do I pass a variable by reference? Python 面试题
个人总结(有点不好):
- 将可变对象:列表list、字典dict、NumPy数组ndarray和用户定义的类型(类),作为参数传递给函数,函数内部将其改变后,函数外部这个变量也会改变(对变量进行重新赋值除外
rebind the reference in the method) - 将不可变对象:字符串string、元组tuple、数值numbers,作为参数传递给函数,函数内部将其改变后,函数外部这个变量不会改变
Python 实现对函参做类型检查
Python 自带的函数一般都会有对函数参数类型做检查,自定义的函数参数类型检查可以用函数 isinstance() 实现,例如:
def my_abs(x):
    """
    自定义的绝对值函数
    :param x: int or float
    :return: positive number, int or float
    """
    if not isinstance(x, (int, float)):
        raise TypeError('bad operand type')
    if x > 0:
        return x
    else:
        return -x
添加了参数检查后,如果传入错误的参数类型,函数就可以抛出一个 TypeError 错误。
为什么说 Python 是动态语言
在 Python 中,等号 = 是赋值语句,可以把任意数据类型赋值给变量,同样一个变量可以反复赋值,而且可以是不同类型的变量,例如:
a = 100 # a是int型变量
print(a)
a = 'ABC'  # a 是str型变量
print(a)
Pyhon 这种变量本身类型不固定,可以反复赋值不同类型的变量称为动态语言,与之对应的是静态语言。静态语言在定义变量时必须指定变量类型,如果赋值的时候类型不匹配,就会报错,Java/C++ 都是静态语言(int a; a = 100)
Python 装饰器理解
装饰器本质上是一个 Python 函数或类,它可以让其他函数或类在不需要做任何代码修改的前提下增加额外功能,装饰器的返回值也是一个函数/类对象。它经常用于有切面需求的场景,比如:插入日志、性能测试、事务处理、缓存、权限校验等场景,装饰器是解决这类问题的绝佳设计。有了装饰器,我们就可以抽离出大量与函数功能本身无关的雷同代码到装饰器中并继续重用。概括的讲,装饰器的作用就是为已经存在的对象添加额外的功能。
map 与 reduce 函数用法解释
1、map() 函数接收两个参数,一个是函数,一个是 Iterable,map 将传入的函数依次作用到序列的每个元素,并将结果作为新的 Iterator 返回,简单示例代码如下:
# 示例1
def square(x):
    return x ** 2
r = map(square, [1, 2, 3, 4, 5, 6, 7])
squareed_list = list(r)
print(squareed_list)  # [1, 4, 9, 16, 25, 36, 49]
# 使用lambda匿名函数简化为一行代码
list(map(lambda x: x * x, [1, 2, 3, 4, 5, 6, 7, 8, 9]))
# 示例2
list(map(str, [1, 2, 3, 4, 5, 6, 7, 8, 9])) # ['1', '2', '3', '4', '5', '6', '7', '8', '9']注意map函数返回的是一个Iterator(惰性序列),要通过list函数转化为常用列表结构。map()作为高阶函数,事实上它是把运算规则抽象了。
2、reduce() 函数也接受两个参数,一个是函数(两个参数),一个是序列,与 map 不同的是reduce 把结果继续和序列的下一个元素做累积计算,效果如下:
reduce(f, [x1, x2, x3, x4]) = f(f(f(x1, x2), x3), x4)
示例代码如下:
from functools import reduce
CHAR_TO_INT = {
    '0': 0,
    '1': 1,
    '2': 2,
    '3': 3,
    '4': 4,
    '5': 5,
    '6': 6,
    '7': 7,
    '8': 8,
    '9': 9
}
def str2int(str):
    ints = map(lambda x:CHAR_TO_INT[x], str)  # str对象是Iterable对象
    return reduce(lambda x,y:10*x + y, ints)
print(str2int('0'))
print(str2int('12300'))
print(str2int('0012345'))  # 0012345
Python 深拷贝、浅拷贝区别
Python 中的大多数对象,比如列表list、字典dict、集合set、numpy数组,和用户定义的类型(类),都是可变的。意味着这些对象或包含的值可以被修改。但也有些对象是不可变的,例如数值型int、字符串型str和元组tuple。
1、复制不可变数据类型:
复制不可变数据类型,不管 copy 还是 deepcopy, 都是同一个地址。当浅复制的值是不可变对象(数值,字符串,元组)时和=“赋值”的情况一样,对象的 id 值与浅复制原来的值相同。
2、复制可变数据类型:
- 直接赋值:其实就是对象的引用(别名)。
- 浅拷贝(
copy):拷贝父对象,不会拷贝对象内部的子对象(拷贝可以理解为创建内存)。产生浅拷贝的操作有以下几种:
+ 使用切片 `[:]` 操作
+ 使用工厂函数(如 `list/dir/set` ), 工厂函数看上去像函数,实质上是类,调用时实际上是生成了该类型的一个实例,就像工厂生产货物一样.
+ 使用`copy` 模块中的 `copy()` 函数,`b = a.copy()`, `a` 和 `b` 是一个独立的对象,**但他们的子对象还是指向统一对象(是引用)**。- 深拷贝(
deepcopy): copy 模块的deepcopy()方法,完全拷贝了父对象及其子对象,两者是完全独立的。深拷贝,包含对象里面的子对象的拷贝,所以原始对象的改变不会造成深拷贝里任何子元素的改变。
注意:浅拷贝和深拷贝的不同仅仅是对组合对象来说,所谓的组合对象(容器)就是包含了其它对象的对象,如列表,类实例。而对于数字、字符串以及其它“原子”类型(没有子对象),没有拷贝一说,产生的都是原对象的引用。更清晰易懂的理解,可以参考这篇文章。
看一个示例程序,就能明白浅拷贝与深拷贝的区别了:
#!/usr/bin/Python3
# -*-coding:utf-8 -*-

import copy
a = [1, 2, 3, ['a', 'b', 'c']]

b = a  # 赋值,传对象的引用
c = copy.copy(a)  # 浅拷贝
d = copy.deepcopy(a)  # 深拷贝

a.append(4)
a[3].append('d')

print(id(a), id(b), id(c), id(d))  # a 与 b 的内存地址相同
print('a = ', a)
print('b = ', b)
print('c = ', c)
print('d = ', d)  # [1, 2, 3, ['a', 'b', 'c']]
程序输出如下:
2061915781832 2061915781832 2061932431304 2061932811400 a = [1, 2, 3, ['a', 'b', 'c', 'd'], 4] b = [1, 2, 3, ['a', 'b', 'c', 'd'], 4] c = [1, 2, 3, ['a', 'b', 'c', 'd']] d = [1, 2, 3, ['a', 'b', 'c']]
Python 继承多态理解
- 多态是指对不同类型的变量进行相同的操作,它会根据对象(或类)类型的不同而表现出不同的行为。
- 继承可以拿到父类的所有数据和方法,子类可以重写父类的方法,也可以新增自己特有的方法。
- 先有继承,后有多态,不同类的对象对同一消息会作出不同的相应。