
统计学习方法
Statistical learning methods, 统计学习方法(第2版)[李航] [笔记, 代码, notebook, 参考文献, Errata, lihang]
统计学习方法


本书已经出第二版,2019年5月之后所有内容更新参考第二版第一次印刷。
[TOC]
工具包
为方便学习,整理一些工具说明。
- GitHub的markdown公式支持一般,推荐使用Chrome插件TeX All the Things来渲染TeX公式,,本地Markdown编辑器推荐Typora,注意Ctrl+, 打开Preferences,Syntax Support部分勾选inline Math。Ubuntu和Windows都正常。
- math_markdown.pdf为math_markdown.md的导出版本, 方便查看使用, markdown版本为最新版本,基本覆盖了书中用到的数学公式的$\LaTeX$表达方式。
- ref_downloader 是一个参考文献下载脚本,这本书一定要配合参考文献看,每章的大参考文献一定要看,对书的内容理解会很有帮助。
- glossary_index 是一个非正式的术语索引,这个书后面是有一个的,但是不方便展开,在这个部分添加了部分扩展的内容。
- symbol_index 是一个非正式的符号索引,第一版中有符号说明,第二版没有了,可能是无监督这部分涉及到的符号真的是太多了,总之,保留这部分,在感觉混淆的时候可以查下,看看是否有帮助。
- errata_se 非官方的errata,供参考。如果有内容感觉不清楚,可以参考看看,希望有帮助。
前前言
- 2019年5月,期待许久的第二版发布了,第一时间下了订单,预计母亲节这天可以发货。
- 5月13日新书到手,第二版配了一张新照片,短发,比之前显得年轻...
- 第二版修改了标点符号,第一版中逗号中文,句号英文。第二版将之前的英文句号更改成了中文句号。
- 第二版取消了符号表,可能是因为同一本书前后有些地方用了不同的符号?所以在这个repo里面,我们尝试加上符号表做说明,方便查询。
- 第二版增加了八个无监督的学习方法,至此,数据挖掘十大算法除了Apriori,全了。
如果需要引用这个Repo:
格式: SmirkCao, Lihang, (2018), GitHub repository, https://github.com/SmirkCao/Lihang
或者
@misc{SmirkCao,
  author = {SmirkCao},
  title = {Lihang},
  year = {2018},
  publisher = {GitHub},
  journal = {GitHub repository},
  howpublished = {\url{https://github.com/SmirkCao/Lihang}},
  commit = {c5624a9bd757a5cc88e78b85b89e9221deb08270}
}
前言
这部分内容并不对应《统计学习方法》中的前言,书中的前言写的也很好,引用如下:
1. 在内容选取上,侧重介绍那些最重要,最常用的方法,特别是关于分类与标注问题的方法. 1. 力图用统一框架来论述所有方法,使全书整体不失系统性。 1. 适用于信息检索及自然语言处理等专业大学生,研究生
另外还有一点要注意作者的工作背景
作者一直从事利用统计学习方法对文本数据进行各种智能性处理的研究, 包括自然语言处理、信息检索、文本数据挖掘。
- 每个人都有适合自己的理解方式,对同样的内容,会有不同的理解
- 书如数据,学如训练,人即模型。
如果用我这个模型来实现相似度查找,和李老师这本书神似的就是《半导体光电器件》了,只可惜昔时年少,未曾反复研读。
希望在反复研读的过程中,将整个这本书看厚,变薄。这个系列的所有的文档,以及代码,没有特殊说明的情况下"书中"这个描述指代的都是李航老师的《统计学习方法》。其他参考文献中的内容如果引用会给出链接。
在Refs中列出了部分参考文献,有些参考文献对于理解书中的内容是非常有帮助的。关于这些文件的描述和解释会在参考部分对应的Refs/README.md中补充。这个文档中也添加了其他参考文献的一些说明。
方便参考文献下载, 在review02的时候,添加了ref_downloader.sh,可以用来下载书中列举的参考文献,更新过程随着review02的进行逐渐完成。
另外,李航老师的这本书,真的很薄(第二版不薄了),但是几乎每句话都会带出很多点,值得反复研读。
书中在目录之后有个符号表,解释了符号定义,所以如果有不理解的符号可以过来查表;在本书后面有个索引,可以通过索引查找对应的符号表示的含义在书中出现的位置。在本Repo中,维护了一个glossary_index.md,目的是给对应的符号补充一些说明,以及直接标注符号对应的页码,进度随review更新。
每个算法,示例结束之后会有一个◼️,表示这个算法或者例子到此结束。这个叫证明结束符,看文献多了就知道了。
关于对数底数
读书的时候经常会有关于对数底数是多少的问题,有些比较重要的,书中都有强调。 有些没有强调的,通过上下文可以理解。另外,因为有换底公式,所以,底具体是什么关系不是太大,差异在于一个常系数。但是选用不同的底会有物理意义和处理问题方面的考虑,关于这个问题的分析,可以看PRML 1.6中关于熵的讨论去体会。
另外关于公式中常系数的问题,如果用迭代求解的方式,有时对公式做一定的简化,可能会改善收敛速度。个中细节可以实践中慢慢体会。
关于篇幅
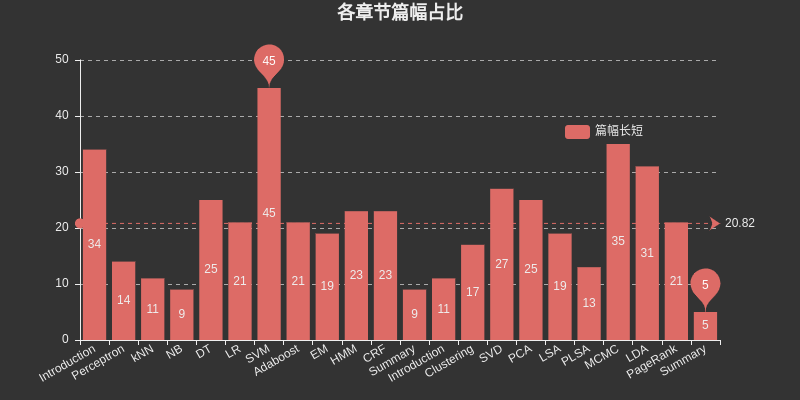
这里插入个图表,列举了各个章节所占篇幅,其中SVM是监督学习里面占用篇幅最大的,MCMC是无监督里面篇幅占用最大的,另外DT,HMM,CRF,SVD,PCA,LDA,PageRank也占了相对较大的篇幅。
章节之间彼此又有联系,比如NB和LR,DT和AdaBoost,Perceptron和SVM,HMM和CRF等等,如果有大章节遇到困难,可以回顾前面章节的内容,或查看具体章节的参考文献,一般都给出了对这个问题描述更详细的参考文献,可能会解释你卡住的地方。
CH01 统计学习及监督学习概论
统计学习方法三要素:
- 模型
- 策略
- 算法
第二版对这一章的目录结构重新梳理了,更清晰。
CH02 感知机
- 感知机是二类分类的线性分类模型
- 感知机对应于特征空间中将实例划分为正负两类的分离超平面.
CH03 k近邻法
- kNN是一种基本的分类与回归方法
- k值的选择, 距离度量及分类决策规则是kNN的三个基本要素.
CH04 朴素贝叶斯法
- 朴素贝叶斯法是基于贝叶斯定理与特征条件独立假设的分类方法.
- $IID\rightarrow$输入输出的联合概率分布
- $Bayes\rightarrow$后验概率最大的输出
- x的某种组合在先验中没有出现的情况, 会出现概率为0的情况, 对应平滑处理方案
$$P_\lambda(X^{(j)}=a_{jl}|Y=c_k)=\frac{\sum_{i=1}^{N}{I(x_i^{(j)}=a_{jl}, y_i=c_k)}+\lambda}{\sum_{i=1}^{N}{I(y_i=c_k)+S_j\lambda}}$$
- $\lambda = 0$ 对应极大似然估计
- $\lambda = 1$ 对应拉普拉斯平滑
- 朴素贝叶斯法实际上学习到生成数据的机制, 所以属于生成模型.
CH05 决策树
- 决策树是一种基本的分类与回归方法
CH06 逻辑斯谛回归与最大熵模型
- 逻辑斯谛回归是统计学中的经典分类方法
- 最大熵是概率模型学习的一个准则, 将其推广到分类问题得到最大熵模型
关于最大熵的学习,推荐阅读该章节的参考文献[1],Berger, 1996, 有益于书中例子的理解以及最大熵原理的把握。
那么, 为什么LR和Maxent要放在一章?
- 都属于对数线性模型
- 都可用于二分类和多分类
- 两种模型的学习方法一般采用极大似然估计, 或正则化的极大似然估计. 可以形式化为无约束最优化问题, 求解方法有IIS, GD, BFGS等
- 在Logistic regression中有如下描述,
Logistic regression, despite its name, is a linear model for classification rather than regression. Logistic regression is also known in the literature as logit regression, maximum-entropy classification (MaxEnt) or the log-linear classifier. In this model, the probabilities describing the possible outcomes of a single trial are modeled using a logistic function.
- 还有这样的描述
Logistic regression is a special case of maximum entropy with two labels +1 and −1.
这个章节的推导中用到了$y\in \mathcal{Y}=\{0,1\}$的性质
- 有时候我们会说,逻辑回归在NLP方面叫做Maxent
CH07 支持向量机
- 支持向量机是一种二分类模型。
- 基本模型是定义在特征空间上的间隔最大化的线性分类器, 间隔最大使他有别于感知机
- 这一章占了很大篇幅,因为margin这个思想几乎可以串起来整个分类问题。
CH08 提升方法
- 提升方法是一种常用的统计学习方法, 应用广泛且有效.
----分割线----
姑且在这里分一下,因为后面HMM和CRF通常会引出概率图模型的介绍,在《机器学习,周志华》里面更是用了一个单独的概率图模型章节来包含HMM,MRF,CRF等内容。另外从HMM到CRF本身也有很多相关的点。
在书中第一章有说明监督学习的三种应用:分类,标注和回归。在第十二章中有补充,本书主要考虑前两者的学习方法。据此, 在这里分割也是合适的,前面介绍分类模型, 少部分提到了回归,后面主要介绍标注问题。
CH09 EM算法及其推广
- EM算法是一种迭代算法,用于含有隐变量的概率模型参数极大似然估计,或者极大后验概率估计。(这里的极大似然估计和极大后验概率估计是学习策略)
- > 如果概率模型的变量都是观测变量,那么给定数据,可以直接用极大似然估计法,或贝叶斯估计法估计模型参数。
注意书上这个描述如果不理解,参考CH04中朴素贝叶斯法的参数估计部分。
- 这部分代码实现了BMM和GMM,值得看下
- 关于EM,这个章节写的不多,EM是十大算法之一,EM和Hinton关系紧密,Hinton在2018年ICLR上发表了Capsule Network的第二篇文章《Matrix Capsules with EM Routing》
- 在CH22中将EM算法归类于基础机器学习方法,不涉及具体的机器学习模型,可用于无监督学习也可用于监督学习,半监督学习。
CH10 隐马尔可夫模型
- 隐马尔可夫模型是可用于标注问题的统计学习模型,描述由隐藏的马尔可夫链随机生成观测序列的过程,属于生成模型。
- 隐马尔可夫模型是关于时序的概率模型,描述由一个隐藏的马尔可夫链随机生成不可观测的状态的序列,再由各个状态速记生成一个观测而产生观测的序列的过程。
- 可用于标注(Tagging)问题,状态对应标记。
- 三个基本问题:概率计算问题,学习问题,预测问题。
CH11 条件随机场
- 条件随机场是给定一组输入随机变量条件下另一组输出随机变量的条件概率分布模型,其特点是假设输出随机变量构成马尔可夫随机场。
- 概率无向图模型,又称为马尔可夫随机场,是一个可以由无向图表示的联合概率分布。
- 三个基本问题:概率计算问题,学习问题,预测问题
CH12 监督学习方法总结
这章就简单的几页,可以考虑如下阅读套路:
- 和第一章一起看
- 在前面的学习中遇到不清楚的问题的时候,过一遍这个章节。
- 将这一章看厚,从这一章展开到其他十个章节。
- 注意这一章有个图12.2,这里面提到了逻辑斯谛损失函数,这里的$y$应该是定义在$\cal{Y}=\{+1,-1\}$中的,在前面介绍LR的时候$y$定义在$\cal{Y}=\{0,1\}$,这里注意下。
李老师这本书真的是每次刷都会有新的收获。
----分割线----
第二版增加了八个无监督学习方法:聚类,奇异值分解,主成分分析,潜在语义分析,概率潜在语义分析,马尔可夫链蒙特卡罗法,潜在狄利克雷分配,PageRank。
CH13 无监督学习概论
- 无监督学习的基本问题:聚类,降维,话题分析和图分析。
- 横向结构和纵向结构这个问题,从存储的角度来考虑。
- 注意不同任务的策略:类别中心距离最小化,维度转换过程中信息损失的最小化,生成数据概率的最大化。
- 在无监督学习部分经常会提到数据中的结构, 是指数据中变量之间的关系。
CH14 聚类方法
- 例子14.2很好,建议画出来先自己展开思考下,再往后看
- 聚类可以用于图像压缩
CH15 奇异值分解
- 基本机器学习方法
- 奇异值分解定理保证分解存在
- 奇异值矩阵唯一,$U,V$不唯一
- 有明确的几何解释
CH16 主成分分析
- 利用正交变换将线性相关变量表示的观测数据转换为少数几个由线性无关变量表示的数据,线性无关的变量称为主成分
- 主成分分析之前,需要对给定数据规范化,使得每一个变量均值为0,方差为1。
- 主成分并不对应原始数据的某一个特征, 可以通过因子负荷量来观察主成分与原始特征之间的关系。
- 这部分内容,还没有提到话题这个概念,后面章节开始介绍了很多话题分析相关的内容,LSA,PLSA,LDA都是和话题有关,MCMC是在LDA中使用的一个工具。
- 提到了总体主成分和样本主成分,前者是后者的基础。主要体现在总体考虑期望,样本考虑均值。样本主成分具有和总体主成分一样的性质。
CH17 潜在语义分析
- 在sklearn的定义中,LSA就是截断奇异值分解。
- 注意体会LSA和PCA的区别,主要在于是不是去均值。
- 在LSA中,话题向量空间是$U$,DOC在话题向量空间的表示是$SV^\mathrm{T}$。但是在sklaern中,xtransformed是$U\mit\Sigma$
CH18 概率潜在语义分析
CH19 马尔可夫链蒙特卡罗法
CH20 潜在狄利克雷分配
CH21 PageRank算法
CH22 无监督学习方法总结
后记
整个这本书里面各章节也不是完全独立的,这部分希望整理章节之间的联系以及适用的数据集。算法到底实现到什么程度,能跑什么数据集也是一方面。
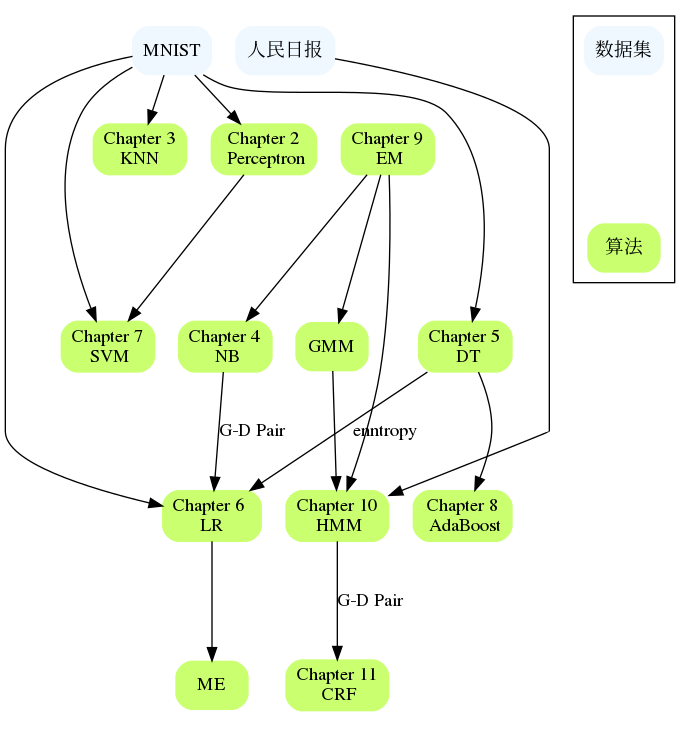
参考
[^1]: Matrix Capsules with EM Routing
glossary index
索引
[TOC]
前言
有时候读书会卡住,也许只是我们看问题的角度问题。同样的问题,在书中不同的地方会有提到,或相关,或无关。这个文档类似书中的最后的索引, 会加入一些个人的理解。
每个内容单独一条。
如果只有一个页码参考第二版2019.05第一次印刷,如果有两个页码,那么第一个对应第一版,第二个对应第二版。
Timeline
- PCA; Pearson; 1901
- PCA over random variable; Hotelling; 1933
- First pattern recognition althgrithm; Fisher; 1936
- Perceptron; Rosenblatt; 1957
- Kmeans; MacQueen; 1967
- KNN; Cover, Hart; 1967
- EM; Dempster; 1977
- DT: CART; Breiman; 1984
- DT: ID3; Quinlan; 1986
- BP; LeCun; 1987
- LSA; Deerwester; 1990
- SVM: Kernel; Boser, Guyon, Vapnik; 1992
- DT: C4.5; Quinlan; 1993
- SVM: Linear; Cortes, Vapnik; 1995
- AdaBoost; Freund, Schapire; 1995
- SVM: Regression; Drucker; 1996
- SMO; Platt; 1998
- Margin Theory; Schapire; 1998
- NMF; Lee; 1999
- PLSA; Hofmann; 1999
- Boosted Tree; Friedman; 2000
- CRF; Lafferty; 2001
- LDA; Blei; 2002
基本想法
无监督学习
对给定的数据进行某种”压缩“,从而找到数据的潜在结构。
主成分分析
- 将数据规范化为每个变量均值为0,方差为1。
- 对数据做正交变换,原来由线性相关的变量表示的数据,通过正交变换变成由若干个线性无关的新变量表示的数据。新变量是可能的正交变换中变量的方差的和最大的,方差表示在新变量上信息的大小。
概率潜在语义分析
发现由隐变量表示的话题,即潜在语义。一个文本的内容由其相关话题决定,一个话题的内容由其相关单词决定。
LDA的收缩吉布斯抽样算法
$P_{412}$
变分推理
$P_{412}$
PageRank算法
$P_{415}$ 在有向图上定义一个随机游走模型,即一阶马尔可夫链,描述随机游走者沿着有向图随机访问各个结点的行为。
PageRank一般定义
$P_{421}$ 基本定义的基础上导入平滑项
Topic Modeling
$P_{321}$ 试图从大量的文本数据中发现潜在的话题,以话题向量表示文本的语义内容,以话题向量空间的度量更准确的表示文本之间的语义相似度。这是话题分析(Topic Modeling)的基本想法。
Glossary
贝叶斯学习
$P_{391}$ LDA属于贝叶斯学习 $P_{369}$ 贝叶斯学习中经常需要进行三种积分运算:规范化,边缘化,数学期望。 $P_{401}$ 变分推理是贝叶斯学习中常用的含有隐变量模型的学习和推理方法。
信息
$P_{297}$ 新变量上信息的大小。
$P_{306}$ 信息是指原有变量的方差。
Gram矩阵
$P_{34}$,$P_{45}$ 在感知机中第一次提到
$P_{119}$,$P_{139}$ 讲核函数的时候也有用到
欧式空间
$P_{4}$ 输入输出空间可以是有限元素的集合,也可以是整个欧式空间。集合和欧式空间对应了两种情况,离散和连续。
凸优化
$P_{100}$
拉格朗日对偶性
$P_{225}$附录C
拉格朗日乘子法
$P_{182}$ BW算法中求Q函数极大化,因为$\pi,A,B$都满足等式约束条件
$P_{301}$ PCA中关于总体主成分的定理的证明。 $P_{346}$ EM算法M步
样本
$P_{4}$ 输入和输出对又称为样本
KKT 条件
见附录C
经验
提到经验,说的都是和训练数据集相关的 $P_{352}$ 从样本得到经验分布,从而估计总体分布;或者从样本计算样本均值,从而估计总体期望。
对偶
感知机里面有提到,支持向量机里面有提到
生成模型
$P_{339}$
共现模型
$P_{339}$ 概率潜在语义分析
图模型
$P_{341}$ 生成模型属于概率有向图模型 $P_{386}$ 潜在狄利克雷模型是含有隐变量的概率图模型。
随机游走
$P_{351}$
分离超平面
$P_{26}, P_{102}$ 支持向量机里面也有
内积
$P_{25}, P_{78}, P_{117}$在感知机、逻辑回归、支持向量机里面都有用到 $P_{323}$ 词向量的相似度
非负矩阵分解
$P_{331}$
满条件分布
$P_{372}$
指示函数
$P_{10}$ 讨论测试数据集中的误差率和准确率的时候,提到指示函数。
$P_{40}, P_{37}$
这个函数在不同的教材上有不同的表示方式,比如在《深度学习》中表示为$\mathbf 1_{condition}$
另外, 张潼老师在IBM时候的文章,定义的和书中不是太一样, 注意体会之间的差异。 $$ I(f(x),y)=\begin{cases} &1\ if\ yf(x)<0,\\ &1\ if\ f(x)=0\ and\ y=-1,\\ &0\ otherwise \end{cases} $$
指示函数还有一种表示空心方括号,这个在$LaTeX$里面要用个包来引用, 不写了。在AdaBoost参考文献[9]中用了这样的表达。
注意指示函数其实定义了0-1损失, 在AdaBoost算法的训练误差分析那部分,定理8.1实际上说的是指数损失是0-1损失的上界,然后用递推拿到了归一化系数连乘的形式。
$L_p$距离
$P_{38}$
启发式方法
$P_{57}$决策树学习通常采用启发式方法,得到的决策树是次最优的。
单纯形
$P_{81}$,$P_{96}$单纯形是$n$维欧式空间中的$n+1$个仿射无关的点的集合的凸包。 $P_{348}$ 模型的参数分布可以由参数空间中的单纯形表示。 $P_{344}$ 单词单纯形与话题单纯形
熵,条件熵
$P_{60}$在决策树中首先提到
$P_{80}$最大熵原理部分也有提到,并有引用到第五章中的内容
$P_{166}$ $F$函数的定义中,有定义分布$\hat P(Z)$的熵
KL散度
$P_{332}$ 或者相对熵
特征函数
$P_{82}$ $f(x,y)$描述输入$x$和输出$y$之间的某一事实。
$P_{196}$ 转移特征和状态特征
特征值分解
$P_{314}$ 将矩阵分解成特征值和特征向量。特征值说明特征的重要度,书中也说是主成分的方差贡献率。但是特征值分解要求矩阵是方阵。
动态规划
$P_{67}$决策树的剪枝算法可以由一种动态规划的算法实现。
$P_{184}$维特比算法实际上是用动态规划求解隐马尔可夫模型预测问题,即用动态规划求概率最大路径。
贝叶斯估计
$P_{59}$ 强调朴素贝叶斯和贝叶斯估计是不同的概念。
目标函数
$P_9$在经验风险最小化的策略或者结构风险最小化策略的情况下,经验或结构风险函数是最优化的目标函数
函数间隔
$P_{27},P_{97}$在感知机和支持向量机部分,都有函数间隔的概念,在AdaBoost部分,实际上也有间隔的概念在里面。
概率分布密度
$P_{162}$ 高斯分布密度, 书中的内容扩展下去看二维混合高斯模型, 对协方差矩阵的理解会有帮助.
多项分布
$P_{385}$ 多项分布定义 $P_{340}$ 条件概率分布属于多项分布
二项分布
$P_{388}$
指数族分布
$P_{389}$ 狄利克雷分布属于指数族分布
对数似然损失
$P_7$ 对数损失函数或者对数似然损失函数 $L(Y,P(Y|X))=-\log P(Y|X)$
对数似然函数
$P_{158}$ 面对一个含有隐变量的概率模型, 目标是极大化观测数据(不完全数据)Y关于参数$\theta$的对数似然函数, 即极大化 $$ \begin{aligned}L(\theta)=&\log P(Y|\theta)=\log \sum_Z P(Y, Z|\theta) \\ =&\log\left(\sum_ZP(Y|Z,\theta)P(Z|\theta)\right) \end{aligned} $$
对数线性模型
$P_{196}$ 线性链条件随机场是对数线性模型。
$P_{88}$ 最大熵模型与逻辑斯谛回归有类似的形式,它们又称为对数线性模型。
One-hot Encoding
$P_{163}$ 注意这里书中没有明确的说明$\gamma_{jk}$是One-hot encoding, 也叫做1-of-K representation
$\gamma_j=\sum_{k=1}^K\gamma_{jk}=1, j=1,2,3,\dots, n$
基函数
$P_{144}$
基本分类器
$P_{147}$ 上面这两个不是一个概念
琴声不等式
$P_{159}$ EM算法导出部分讨论收敛性 $P_{455}$ KL散度定义 $P_{90}$ IIS算法导出部分确定界
约束最优化问题
$P_{83}$ 最大熵模型的学习可以形式化为约束最优化问题。
$P_{302}$ 求解主成分的过程是求解约束最优化问题
广义拉格朗日函数
拉格朗日乘子法
$P_{301}$ 采用拉格朗日乘子法求主成分。
泛化误差上界
$P_{15}$
代理损失函数
$P_{115}$
$P_{213}$也有说明
$P_{206}$预测最优解,条件概率最大的输出序列(标记序列)$y^*$
极大似然估计
$P_{9}$ 极大似然估计是经验风险最小化的例子。这个书中没有太多的解释,在《深度学习》里面有讲解,其实挺多书上都有提到。扩展下这个点,最大似然这个思想最早是高斯提出来的,費希尔将其发扬光大。1922年的文章60多页,提出了最大似然估计这个思想,讨论了一些性质。文章可以找到,費希尔凭借这个方法彻底撼动了皮尔逊的统治地位。
費希尔是英国统计学家,生物进化学家,数学家,遗传学家和优生学家。看头像还真是个可以靠颜值度日却不小心坠入学术的帅哥。
充分统计量
$P_{456}$
无偏估计
$P_{320}$
向量空间模型
Vector Space Model, VSM
$P_{322}$
仿射函数
$P_{116}$
线性变换
$P_{279}$ 线性变换很重要,在SVD中第一次提到。 $P_{300}$ 在总体主成分的定义中也提到了线性变换,这真的是线性代数中一个非常重要的概念。
张成
$P_{451}$ 向量空间 $P_{325}$ 张成话题空间向量
因子负荷量
$P_{305}$ 第$k$个主成分$y_k$与变量$x_i$的相关系数$\rho(y_k,x_i)$称为因子负荷量,表示第$k$个主成分$y_k$与变量$x_i$的相关关系。
方差贡献率
$_{308}$ 第$k$主成分$y_k$的方差贡献率定义为$y_k$的方差与所有方差之和的比值,记作$\mu_k$
EM算法
$P_{345}$ PLSA也是含有隐变量的模型,通常使用EM算法求解。 $P_{401}$ 变分EM算法
文本集合
单词文本矩阵
词向量
$P_{321}$
非负矩阵分解
$P_{321}$
反射变换
$P_{279}$
正交变换
$P_{297}$ 把线性相关的变量表示的观测数据转换成少数几个线性无关变量表示的数据,线性无关的变量称为主成分。
正交矩阵
$P_{304}$ 正交矩阵满足$A^\mathrm{T}A=AA^\mathrm{T}=I$
分块
$P_{288}$
Manifold
$P_{247}$ 在降维部分有提到,但是没有展开
Definition, Theory, Algorithm
Definition
定义2.1 感知机
定义2.2 数据集的线性可分性
定义5.1 决策树
定义5.2 信息增益
定义5.3 信息增益比
定义5.4 基尼指数
定义6.1 逻辑斯谛分布
定义6.2 逻辑斯谛回归模型
定义6.3 最大熵模型
定义7.1 线性可分支持向量机
定义7.2 函数间隔
定义7.3 几何间隔
定义7.4 支持向量
定义7.5 线性支持向量机
定义7.6 核函数
定义7.7 正定核的等价定义
定义7.8 非线性支持向量机
定义9.1 Q函数
定义9.2 高斯混合模型
定义9.3 F函数
定义10.1 隐马尔可夫模型
定义10.2 前向概率
定义10.3 后向概率
定义11.1 概率无向图模型
定义11.2 团与最大团
定义11.3 条件随机场
定义11.4 线性链条件随机场
定义16.1 总体主成分 定义16.2 主成分的方差贡献率 定义16.3 主成分对原有变量的贡献率
Theory
定理2.1 Novikoff
定理7.1 最大间隔分离超平面的存在唯一性
定理7.2
定理7.3
定理7.4
定理7.5 正定核的充要条件
定理7.6
定理8.1 AdaBoost的训练误差界
定理8.2 二类分类问题AdaBoost的训练误差界
定理8.3
定理9.1
定理9.2
引理9.1
引理9.2
定理9.3
定理9.4
定理11.1 Hammersley-Clifford定理
定理11.2 线性链条件随机场的参数化形式 定理16.1
定理16.2
定理16.3
定理C.1
推论C.1
定理C.2
定理C.3
Algorithm
算法2.1 感知机学习算法的原始形式
算法3.1 k近邻算法
算法3.2 构造平衡kd树
算法3.3 用kd树的最近邻搜索
算法4.1 朴素贝叶斯算法
算法5.1 信息增益的算法
算法5.2 ID3算法
算法5.3 C4.5的生成算法
算法5.4 树的剪枝算法
算法5.5 最小二乘回归树生成算法
算法5.6 CART生成算法
算法5.7 CART剪枝算法
算法6.1 改进的迭代尺度算法 IIS
算法6.2 最大熵模型学习的BFGS算法
算法7.1 线性可分支持向量机学习算法-最大间隔法
算法7.2 线性可分支持向量机学习算法
算法7.3 线性支持向量机学习算法
算法7.4 非线性支持向量机学习算法
算法7.5 SMO算法
算法8.1 AdaBoost
算法8.2 前向分步算法
算法8.3 回归问题的提升树算法
算法8.4 梯度提升算法
算法9.1 EM算法
算法9.2 高斯混合模型参数估计的EM算法
算法9.3 GEM算法1
算法9.4 GEM算法2
算法9.5 GEM算法3
算法10.1 观测序列的生成
算法10.2 观测序列概率的前向算法
算法10.3 观测序列概率的后向算法
算法10.4 Baum-Welch算法
算法10.5 维特比算法
算法11.1 条件随机场模型学习的改进的迭代尺度法
算法11.2 条件随机场模型学习的BFGS算法
算法11.3 条件随机场预测的维特比算法
算法17.1 非负矩阵分解的迭代算法
算法A.1 梯度下降法
算法B.1 牛顿法
算法B.2 DFP算法
算法B.3 BFGS算法
symbol index
符号表
- $\{\}$ 集合 文本集合$D=\{d_1,d_2,\cdots,d_n\}$,单词集合$W=\{w_1,w_2,\cdots,w_m\}$ $P_{327}$
- $A_G$类的样本散布矩阵 $P_{259}$
- $C^*$ 最优划分 $P_{261}$
- $D_G$ 类的直径
- $D=[d_{ij}]_{n \times n}$ $n$个样本之间的距离矩阵$D$ $P_{261}$
- $D=\{d_1,d_2,\cdots,d_n\}$ $n$个文本的集合 $P_{322}$
- $D(A||B)=\sum\limits_{i,j}\left(a_{ij}\log\frac{a_{ij}}{b{ij}}-a_{ij}+b_{ij}\right)$ 散度损失函数$P_{322}$
- $J(W,H)$ 优化目标函数。$P_{334}$
- $\Lambda$ $n$阶对角矩阵
- $\mathcal{M}$是$\mathbf{R}^{m\times n}$中所有秩不超过$k$的矩阵集合,$0
- $m, M$ 样本特征数,维数 $P_{261}$
- $m$ 协方差矩阵的特征值之和 $P_{309}$
- $n,N,n_G$ 样本数,类的样本数
- $\theta$ 参数
- $R(A)$ $A$的值域 $P_{275}$
- $R(A)^\bot$ 表示$R(A)$的正交补 $P_{276}$
- $r$ 矩阵的秩 $P_{277}$
- $S_G$类的样本协方差矩阵 $P_{259}$
- $\mathcal{S}$ 状态空间 $P_{360}$
- $T$ 训练数据集 $P_{59}$
- $T$ 和$V$给定的两个正数 $P_{259}$
- $T$ 决策树 $P_{78}$
- $T:x\rightarrow Ax$ 线性变换 $P_{279}$
- $U$ 训练数据 $P_8, P_{248}, P_{245}$
- $U$ 表示$m$阶正交矩阵 ,$V$表示$n$阶正交矩阵,$\mit\Sigma$表示矩形对角矩阵,$P_{271}$
- $U_k=[u_1 u_2 \cdots u_k]$中的每一个列向量$u_1, u_2, \cdots, u_k$表示一个话题,称为话题向量。.
- $W$ 在非负矩阵分解中表示基矩阵 $P_{332}$
- $W(C)$ 能量,表示相同类中的样本的相似程度。越相似,越小。 $P_{264}$
- $W=A^\mathrm TA$ 对称矩阵 $P_{282}$
- $W=\{w_1,w_2,\cdots, w_m\}$ $m$个单词集合 $P_{322}$
- $\mathcal{W}=\{w_1,w_2,\cdots, w_k\}$ $k$个元素组成的集合 $P_{389}$
- $x_i^*$是$x_i$的规范化随机变量。 $P_{309}$
- $X=[x_{ij}]_{m\times n}$ 矩阵
- $X=\{x_1, x_2, \dots ,x_n\}$ $n$个样本的集合 $P_{263}$
- $X$ 定义在输入空间$\mathcal X$上的随机向量
- $X=\{X_0,X_1,\cdots,\X_t,\cdots\}$ 马尔可夫链 $P_{360}$
- $Y$ 定义在输出空间$\mathcal Y$上的随机向量
- $\mathcal{Z}$隐式结构空间 $P_8$
errata se
ERRATA
参考书版本为2019年05月第1次印刷,在这之后的印刷版本有可能进行过修订,愿本书越来越完善。
- $P_{14}$
贝叶斯估计与极大似然估计在思想上有很大的不同,代表着统计学中频率学派和贝叶斯学派对统计的不同认识,这里贝叶斯估计对应了贝叶斯学派,而极大似然估计对应的是频率派,应该把贝叶斯学派和频率学派换一下顺序。
- $P_{257}$$X=(x_{ij})_{m\times n}$应该是$X=[x_{ij}]_{m\times n}$
- $P_{246}$输入空间是欧氏空间$X\sube \mathbf R^d$其实这里用$X\sube \mathbf R^m$表示是不是更好一点,不容易乱,后面的空间都是$m$维,对应的还有$P_{247}$中$\mathbf R^d, \mathbf R^{d'}$
- $P_{49}$关于KNN提出的年限,实际上这个文献是1967年的,而书中说是1968年提出的。
- $P_{320}$ 参考文献4,应该是1404.1100不是14016.1100
- $P_{29}$ 精确率和召回率的定义(1.41)和(1.42) $$ P=\frac{TP}{TP+FP}\\ R=\frac{TP}{TP+FN} $$
- $P_{30}$ $F_1$定义,(1.44) $$ F_1=\frac{2TP}{2TP+FP+FN} $$
- $P_{245}$ $x \in X, z \in Z$这部分在第一章$P_8$的无监督学习部分定义是$x \in \mathcal{X}, z \in \mathcal{Z}$
- $P_{257}$ 公式14.6中,转置符号用了斜体$d_{ij}=\left[(x_i-x_j)^TS^{-1}(x_i-x_j)\right]^{\frac{1}{2}}$ 转置应该是和其他转置一样,是正体$d_{ij}=\left[(x_i-x_j)^\mathrm TS^{-1}(x_i-x_j)\right]^{\frac{1}{2}}$
- $P_{265}$ 算法14.2中描述的输出$C^\cdot$应该是$C^$, 因为算法描述中最后输出的是$C^$
- $P_{261}$ 算法14.1,
输入:n个样本组成的样本集合及样本之间的距离,其中样本之间的距离不应该是输入条件。
- $P_{452}$ 公式D.2上面一行,$R^n$中与$Y$中的每一向量正交的向量集合,应该是$\mathbf R^n$
- $P_{451}$ 关于张成,在第二小节之上的一行$span\{v_1,v_2,\cdots,v_n\}=V$用的是{},前面定义的是$span(v_1,v_2,\cdots,v_n)$,用()
- $P_{452}$ 公式D.1中$R^n$应为$\mathbf{R}^n$
- $P_{274}$ $V_1=[\begin{array}&\nu_1&\nu_2&\cdots&\nu_r\end{array}]$$V_2=[\begin{array}&\nu_{r+1}&\nu_{r+2}&\cdots&\nu_n\end{array}]$,这部分定义用的是$\nu$,而后面用到的时候用的都是$v$,比如公式15.8, 15.12, 15.15
- $P_{275}$ 公式15.14下面那行,$U_1$的列向量构成了一组标准$\color{red}正交集$
- $P_{279}$ 图15.1中标记的$\Sigma$ 应该是$\mit\Sigma$
- $P_{286}$ 公式15.25中$(a_{ij})^2$看起来不是很习惯,完全可以用$a_{ij}^2$表示,类似的还有$P_{293}$中总结的第7点
- $P_{293}$ $p=\min\{m,n\}$ 应该是$p=\min (m,n)$
- $P_{293}$ 第6点,奇异值$\sigma_i$应该是$\sigma_j$
- $P_{293}$ 第6点,从$AA^\mathrm{T}$的特征值这句,虽然$A^\mathrm{T}A$和$AA^\mathrm{T}$的特征值是一样的,但是不太理解这里为什么写成$AA^\mathrm{T}$,不知道是不是笔误。
- $P_{313}$ 求方差贡献率$\sum\limits_{i=1}^k\eta_i$达到预定值的主成分个数$k$,这个应该是累计方差贡献率
- $P_{316}$ 公式16.52,16.53, 以及$X^{\prime\mathbf{T}}X$,后面$X^{\prime}=\frac{1}{\sqrt{n-1}}X^\mathbf{T}$中的$X^\mathbf{T}$应该是$X^\mathrm{T}$
- $P_{310}$ 样本矩阵$\mit \boldsymbol{X}$,应该是$X$。或者说,写成$X$才和其他表达是一致的。
- $P_{327}$ 17.1节最后一句,
这一结果完全从话题-文本矩阵的信息中获得应该是单词-文本矩阵吧
- $P_{329}$ 这个例子并没有按照书中其他例子的格式编号,$P_{330}$中的表格,也没有表格编号和标题。下面截断奇异值分解的结果,其实应该算是个图。
27.